

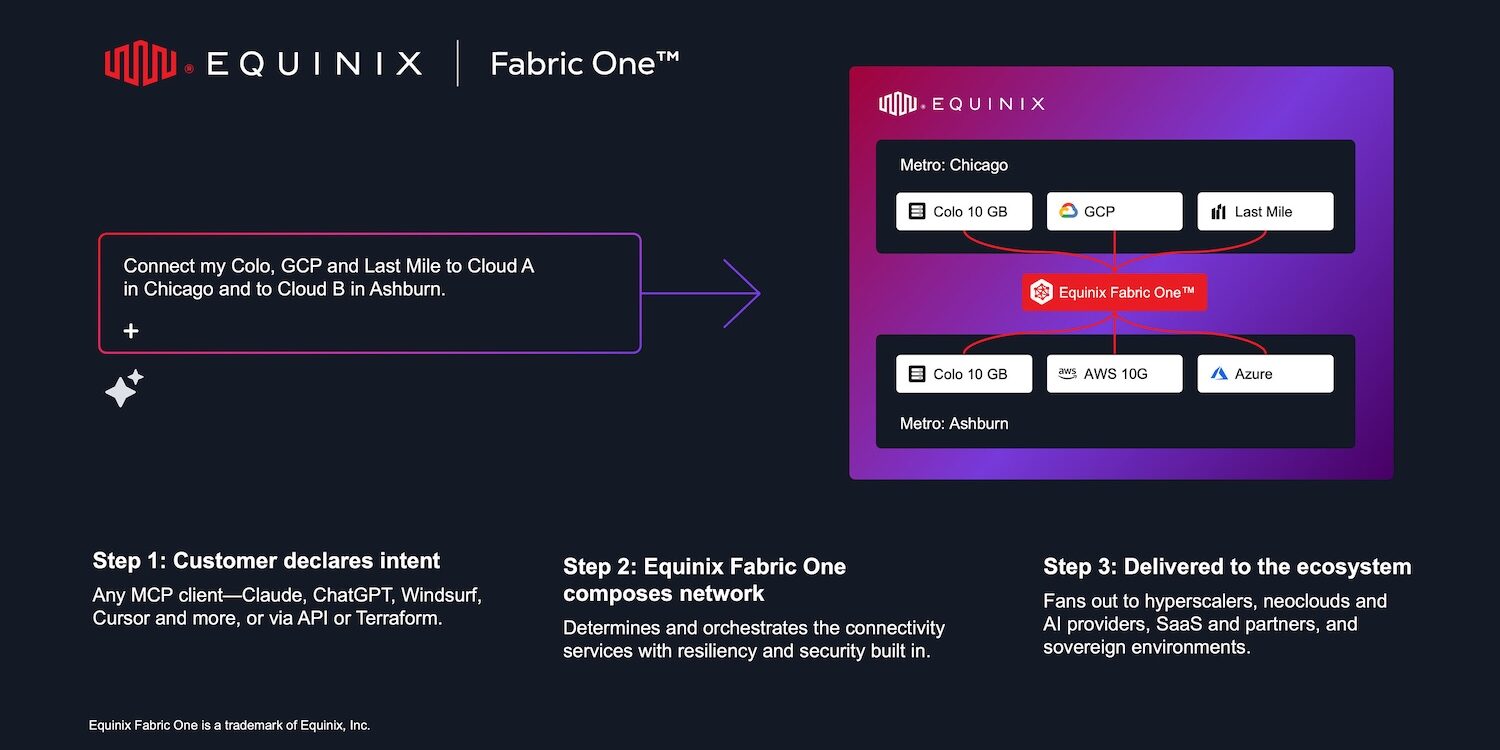
Equinix ha ampliato la sua partnership con NVIDIA e ha avviato una nuova collaborazione con Together AI per lanciare Equinix Inference Exchange. Progettata come architettura di inferenza AI distribuita per implementazioni aziendali, la piattaforma mira a spostare i carichi di lavoro di calcolo più vicino ai repository di dati principali, agli utenti finali e alle applicazioni operative. Annunciata insieme a Equinix Fabric One all'evento Equinix Horizon, l'iniziativa combina le architetture hardware enterprise di NVIDIA, la piattaforma di modelli open source di Together AI e l'infrastruttura di interconnessione globale di Equinix per affrontare i problemi di latenza, sovranità dei dati e colli di bottiglia di rete.
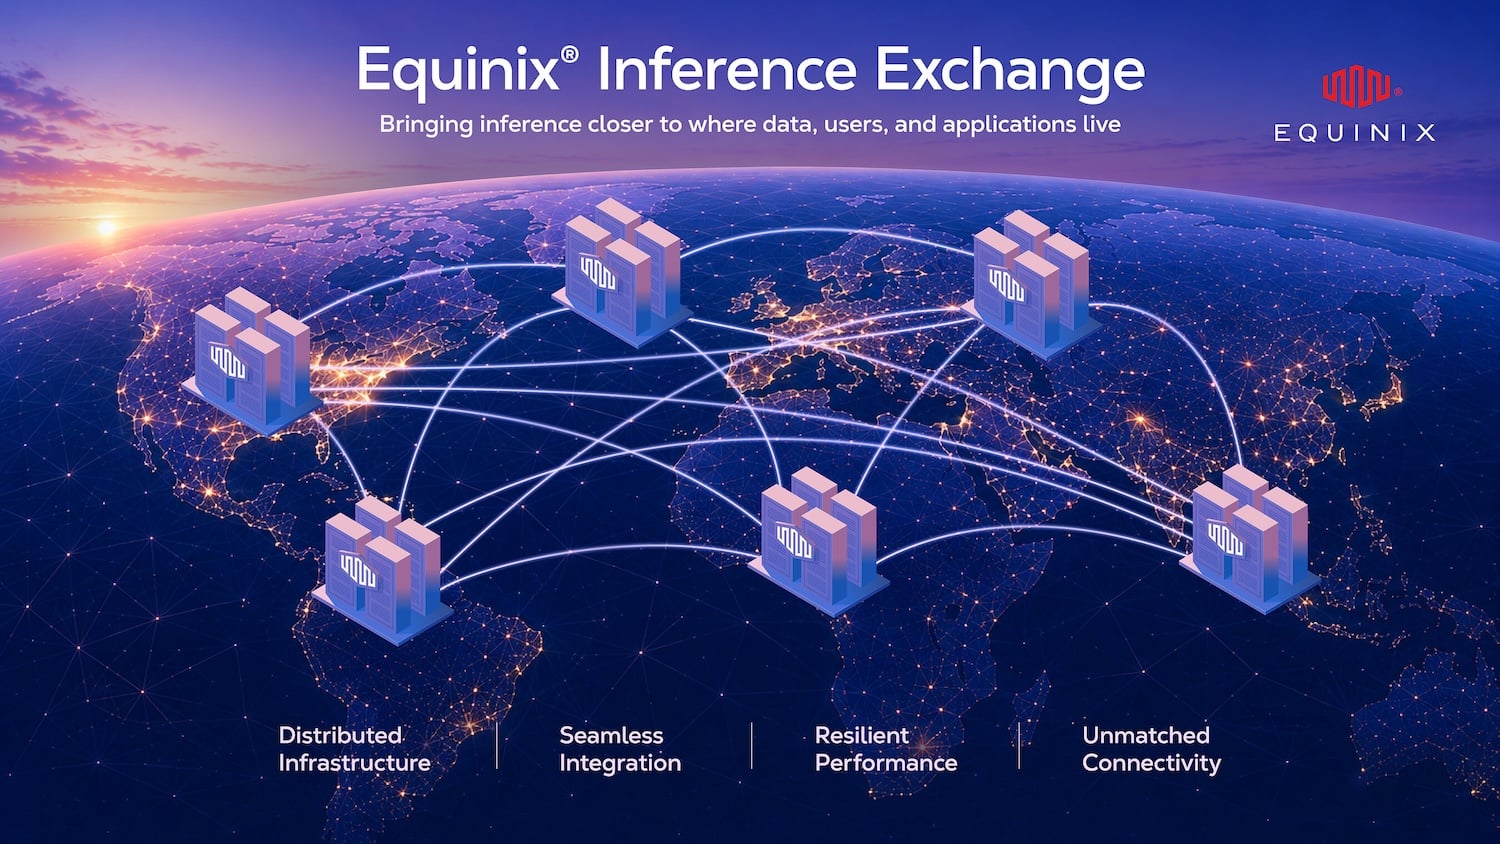
Affrontare i problemi di inferenza distribuita e gravità dei dati
Con il passaggio delle iniziative di IA aziendale dalla validazione del prototipo alla produzione ad alto rendimento, il posizionamento dell'inferenza determina i costi complessivi, la latenza di risposta e la conformità. Avvicinare l'esecuzione del modello alle fonti di dati riduce i costi di backhauling dei dati attraverso i cloud pubblici, garantendo al contempo profili di latenza deterministici. Tuttavia, la gestione di un'infrastruttura distribuita in ambienti eterogenei introduce overhead operativo e complessità di rete.
Equinix affronta questo ostacolo operativo sfruttando la sua infrastruttura capillare di oltre 280 data center distribuiti in 77 aree metropolitane, 230 punti di accesso al cloud e una rete di oltre 10,500 aziende interconnesse. Con otto dei dieci principali fornitori di modelli di intelligenza artificiale e nove dei dieci principali servizi cloud per l'IA già operativi all'interno delle strutture di Equinix, la piattaforma funge da livello di aggregazione neutrale per pipeline di intelligenza artificiale distribuite.
Integrazione dell'architettura e dello stack
L'infrastruttura di Equinix Inference Exchange è strutturata in tre livelli distinti che comprendono elaborazione, software e infrastruttura fisica:
Equinix gestisce l'infrastruttura fisica di base e le interconnessioni. Ciò include la fornitura di energia, funzionalità avanzate di raffreddamento a liquido, la gestione operativa quotidiana degli impianti e l'interconnettività privata a reti, cloud pubblici e piattaforme SaaS tramite Equinix Fabric.
NVIDIA fornisce il livello di calcolo e di convalida dei riferimenti, offrendo un'infrastruttura AI aziendale progettata per un'elevata velocità di elaborazione dei token e costi di inferenza ridotti per query.
Together AI fornisce il livello software per l'inferenza che supporta oltre 200 modelli open-source. La piattaforma supporta sia ambienti multi-tenant condivisi per un'efficienza di calcolo generale, sia topologie dedicate a singolo tenant per carichi di lavoro che richiedono capacità isolate.
Instradando il traffico attraverso Equinix Fabric, la piattaforma riduce i tempi di ottenimento del primo token (TTFT) per gli utenti regionali, stabilendo al contempo percorsi di peering privati tra lo storage locale e gli endpoint del modello.
Obiettivi di implementazione aziendale e disponibilità
La piattaforma si rivolge a tre topologie di implementazione principali. Per l'inferenza a livello metropolitano, le organizzazioni possono eseguire i modelli negli hub metropolitani locali, ottenendo risposte API a bassa latenza pur mantenendo la gestione centralizzata e le interconnessioni private. Per la migrazione di modelli open source, l'architettura offre un percorso agevole per il passaggio da API proprietarie chiuse a modelli open source di base, riducendo la dipendenza da un fornitore specifico e sfruttando le infrastrutture di rete esistenti. Per l'IA sovrana e i requisiti di conformità, la configurazione distribuita consente alle aziende che operano in settori regolamentati di mantenere l'esecuzione dell'inferenza e l'elaborazione dei dati entro specifici confini geografici, contribuendo a soddisfare i rigorosi requisiti di residenza e governance dei dati.
I vertici di Equinix, NVIDIA e Together AI hanno sottolineato che l'integrazione crea un'infrastruttura di inferenza ad alta velocità, indipendente dal fornitore, che bilancia le prestazioni di calcolo con l'agilità operativa.
Equinix Inference Exchange sarà disponibile per le aziende a partire dal primo trimestre del 2027.


 Amazon