

Everpure sta allineando la sua piattaforma FlashBlade//EXA con le architetture in continua evoluzione di NVIDIA AI Factory, presentando in anteprima un nuovo livello di automazione chiamato Everpure Data Stream. L'annuncio estende il supporto di Evergreen//One a EXA e introduce un servizio progettato per semplificare il flusso di dati tra le pipeline di intelligenza artificiale, affrontando una delle sfide più comuni dell'IA aziendale: i progetti che funzionano negli ambienti pilota ma si bloccano prima di raggiungere la scala di produzione.
FlashBlade//EXA si posiziona come infrastruttura dati ad alte prestazioni per queste implementazioni, supportando sessioni di addestramento di grandi dimensioni e carichi di lavoro di inferenza ad alta concorrenza. Il servizio Data Stream, di prossima uscita, si concentra sull'automazione dell'acquisizione, della preparazione e della distribuzione dei dati all'infrastruttura GPU, riducendo la complessità operativa che spesso rallenta i programmi di intelligenza artificiale nel passaggio dagli ambienti di sperimentazione a quelli di produzione.
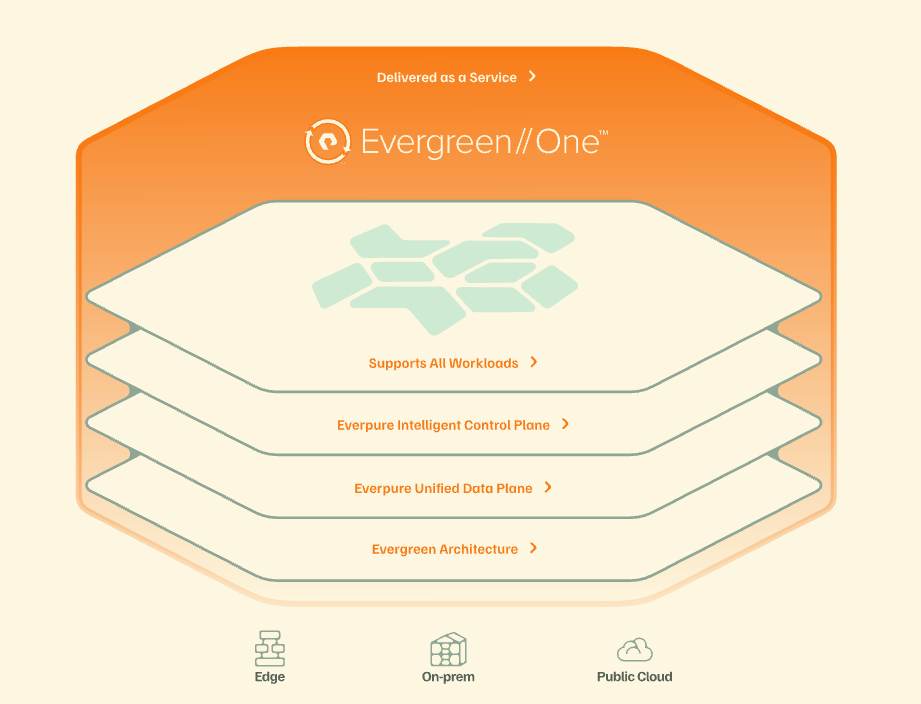
EG1 per l'IA ora si estende da FlashBlade//EXA per offrire le prestazioni, la scalabilità e la velocità di elaborazione necessarie per cicli di addestramento più ampi e inferenze ad alta concorrenza. Everpure Data Stream, che entrerà in versione beta entro la fine del 2026, è progettato per automatizzare il trasferimento dei dati dall'acquisizione all'esecuzione del modello, riducendo il lavoro manuale nelle pipeline e i ritardi operativi che spesso rallentano i progetti di IA.
Kaycee Lai, Vicepresidente AI di Everpure, inquadra il problema come la necessità di trattare l'IA come "un semplice carico di lavoro" piuttosto che come un sistema continuo e incentrato sui dati. Ha sottolineato che Everpure configura la sua piattaforma per eliminare i silos di dati e far passare i programmi di IA dalla fase sperimentale a risultati di produzione ripetibili, grazie a prestazioni prevedibili e flessibilità operativa.
Archiviazione e percorso dati per l'IA comprovati da benchmark
Per le implementazioni di intelligenza artificiale, l'infrastruttura di storage e dati deve garantire che le GPU ad alto valore operino quasi al massimo delle loro potenzialità. Everpure sta allineando FlashBlade//EXA all'architettura di riferimento modulare STX di NVIDIA per supportare i progetti di AI Factory di nuova generazione basati sulla piattaforma Vera Rubin.
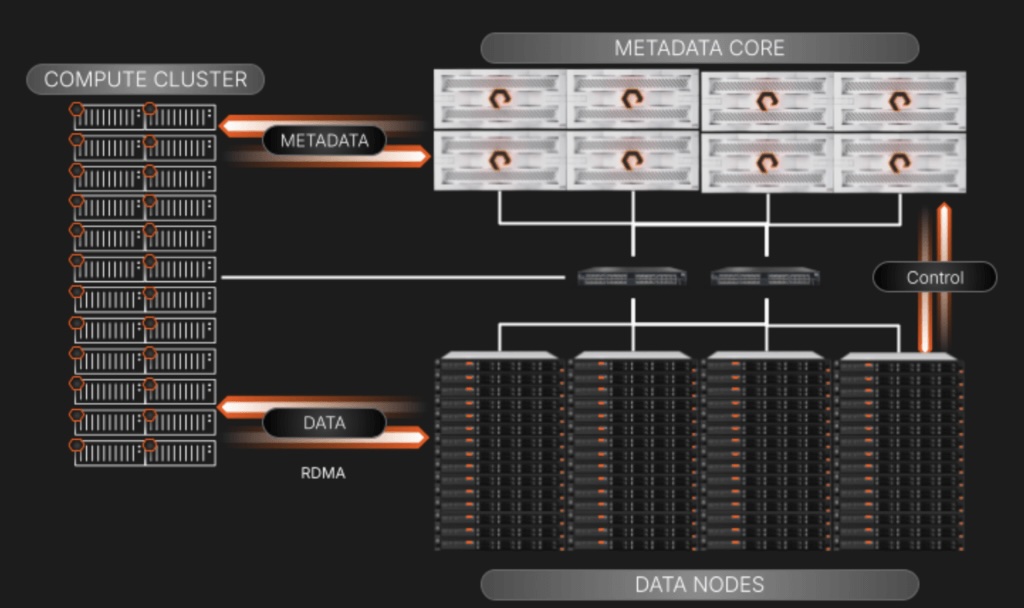
L'architettura combinata integra le prestazioni scalabili di file e oggetti di EXA con i componenti di STX, come i controller di storage abilitati per BlueField e le architetture di memoria di contesto. L'obiettivo è ottimizzare l'intera pipeline di dati per l'IA: preparazione dei dati, creazione di feature ed embedding e inferenza di contesto a lungo termine. Particolare enfasi è posta sulla memoria di contesto, poiché i sistemi di ragionamento multi-step, agentici e su larga scala si basano su un accesso rapido a finestre di contesto e cronologia estese. Il design EXA/STX risponde a queste esigenze di inferenza su scala gigabyte, fornendo una larghezza di banda sostenuta e riducendo al minimo la latenza di coda.
Recenti benchmark di settore convalidano il comportamento della piattaforma in presenza di carichi di lavoro di intelligenza artificiale realistici e ad alta concorrenza. I benchmark includono:
- Soluzione SPECstorage 2020 AI_Image: FlashBlade//EXA ha ottenuto il punteggio più alto mai registrato nel benchmark SPEC Storage AI_Image, gestendo 6,300 processi di intelligenza artificiale simultanei. Questo risultato dimostra la capacità del sistema di supportare un elevato numero di attività di training e pre-elaborazione simultanee a pieno regime, una pratica sempre più diffusa negli ambienti di intelligenza artificiale multi-tenant e multi-team.
- Utilizzo e throughput della GPU allineati a MLPerf: I carichi di lavoro interni basati su modelli, allineati con MLPerf, dimostrano che FlashBlade//EXA può trasferire dati quasi due volte più velocemente del suo concorrente più vicino, utilizzando meno della metà dello spazio di archiviazione di un rack. Nei test, la piattaforma ha mantenuto un utilizzo della GPU superiore al 90% su grandi cluster H100. Ciò suggerisce che è improbabile che il sistema di storage rappresenti un collo di bottiglia, consentendo agli acceleratori più costosi di rimanere occupati man mano che i dataset e i modelli crescono. L'architettura di EXA è scalabile linearmente, mantenendo questo livello di utilizzo con l'aggiunta di potenza di calcolo e storage.
Everpure sta inoltre estendendo la convalida NVIDIA-Certified Storage (NVCS) a FlashBlade//EXA. Questo impegno fornisce una base di riferimento più chiara per la compatibilità e le prestazioni e funge da trampolino di lancio per il livello di certificazione NVCS "NCP", allineato con le architetture di riferimento dei partner cloud di NVIDIA. Per le aziende che adottano soluzioni di intelligenza artificiale basate su NVIDIA, questo tipo di certificazione di storage contribuisce a ridurre il rischio di integrazione e semplifica l'adozione di progetti di riferimento.
Automazione dell'orchestrazione dei dati di IA
Prestazioni di archiviazione elevate da sole non garantiscono il successo dell'IA se le pipeline di dati verso lo stack di IA rimangono frammentate e manuali. Everpure Data Stream viene presentato come un livello di orchestrazione che automatizza le fasi chiave, dall'acquisizione dei dati alla loro preparazione e consegna all'infrastruttura GPU.
Il servizio si concentra sulla curatela e l'orchestrazione di dati "pronti per l'IA" in modo che i sistemi di addestramento e inferenza vengano alimentati continuamente con set di dati aggiornati senza richiedere un intervento operativo significativo. L'obiettivo è quello di ridurre i tempi tra l'esperimento iniziale e un'esecuzione stabile in produzione, minimizzando la creazione di script ad hoc, la preparazione manuale dei dati e le ripetute soluzioni alternative di ingegneria per l'aggiornamento dei set di dati.
Una piattaforma dati per l'intelligenza artificiale (AIDP) per Everpure Data Stream, progettata in collaborazione con Supermicro, offre un design di riferimento compatto per le organizzazioni che desiderano un ingombro iniziale ridotto. Questa combinazione integra l'hardware server e acceleratore di Supermicro con il livello di storage software-defined di Everpure, fornendo una soluzione pronta all'uso per l'implementazione di un piano dati che supporta sia le pipeline di training che quelle di inferenza.
Nell'ambito di questa strategia AIDP, Everpure supporta anche piattaforme accelerate, tra cui la NVIDIA RTX PRO 6000 Blackwell Server Edition, e prevede di estendere il supporto alla RTX PRO 4500 Blackwell Server Edition. Queste configurazioni sono pensate per i clienti che necessitano di potenti capacità di inferenza e di training edge o dipartimentale, senza dover investire immediatamente in grandi cluster GPU per data center.
Ottimizzazione continua dei dati
Everpure basa la sua piattaforma sull'idea che l'infrastruttura di intelligenza artificiale non sia un investimento una tantum, ma un processo continuo di miglioramento dei dati e di test delle prestazioni. In quest'ottica, la predisposizione all'IA non si limita all'implementazione della tecnologia, ma implica un ciclo continuo di raccolta di nuovi dati, riaddestramento o ottimizzazione dei modelli e verifica delle prestazioni al variare dei carichi di lavoro.
Integrando FlashBlade//EXA, il modello di consumo di Evergreen//One, l'automazione del flusso di dati e l'allineamento con le certificazioni NVIDIA STX e NVCS, Everpure mira ad aiutare le organizzazioni a passare da progetti pilota di IA isolati a ambienti di produzione di IA ripetibili, mantenendo al contempo l'attenzione sull'utilizzo delle GPU e sull'efficienza operativa.
Le misurazioni interne dei componenti MLPerf supportano alcune di queste affermazioni, sebbene non siano state presentate come risultati ufficiali di MLPerf. Da un punto di vista tecnico, i punti chiave sono la dimostrazione della concorrenza con SPECstorage AI_Image, i valori di utilizzo della GPU riportati negli ambienti H100 e il passaggio ad architetture di riferimento completamente validate e allineate a NVIDIA.


 Amazon