

NVIDIA GTC 2023 è iniziata con l'introduzione di nuovi prodotti, partner, innovazioni e software. Per darti un'idea dell'ampiezza degli annunci, il keynote è durato 78 minuti. Sono state annunciate quattro nuove piattaforme, ciascuna ottimizzata per uno specifico carico di lavoro di inferenza di intelligenza artificiale generativa e software specializzato.
Le piattaforme combinano l'intero stack di software di inferenza di NVIDIA con i più recenti processori NVIDIA Ada, Hopper e Grace Hopper. Oggi sono state lanciate due nuove GPU, la GPU NVIDIA L4 Tensor Core e la GPU H100 NVL.
La GPU NVIDIA L4 per video AI offre prestazioni video basate sull'intelligenza artificiale 120 volte superiori rispetto alle CPU, con un'efficienza energetica migliore del 99%. L4 funge da GPU universale per praticamente qualsiasi carico di lavoro, offrendo funzionalità avanzate di decodifica e transcodifica video, streaming video, realtà aumentata, video generativi basati sull'IA e molto altro.
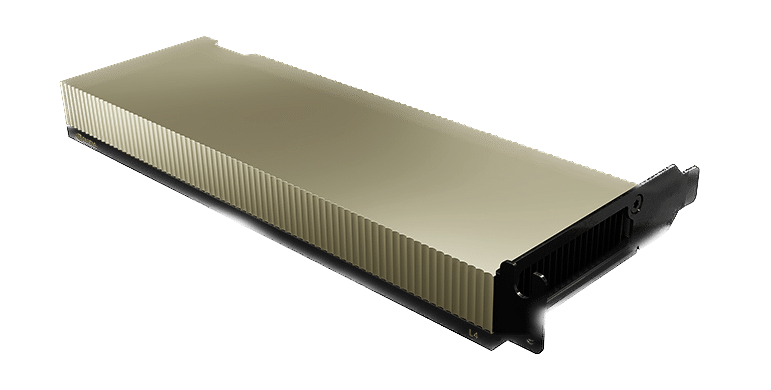
La GPU NVIDIA Ada Lovelace L4 Tensor Core offre accelerazione universale ed efficienza energetica per video, intelligenza artificiale, desktop virtualizzati e applicazioni grafiche in ambito aziendale, nel cloud e all'edge. Con la piattaforma AI di NVIDIA e lo stack completo
approccio, L4 è ottimizzato per l'inferenza su larga scala per un'ampia gamma di applicazioni IA, tra cui consigli, assistenti avatar AI basati sulla voce, IA generativa, ricerca visiva e automazione dei contact center.
L4 è l'acceleratore NVIDIA più efficiente per l'uso mainstream e i server dotati di L4 offrono prestazioni video AI fino a 120 volte superiori e prestazioni AI 2.7 volte più generative rispetto alle soluzioni CPU, nonché prestazioni grafiche oltre 4 volte superiori rispetto alla precedente generazione di GPU. NVIDIA L4 è un fattore di forma versatile, efficiente dal punto di vista energetico, a slot singolo e a basso profilo che lo rende ideale per implementazioni di grandi dimensioni e posizioni edge.
La piattaforma NVIDIA L40 per la generazione di immagini è ottimizzata per la grafica e la generazione di immagini 2D, video e 3D con supporto all'intelligenza artificiale. La piattaforma L40 funge da motore per NVIDIA Omniverse, una piattaforma per la creazione e la gestione di applicazioni metaverse nei data center, offrendo prestazioni di inferenza 7 volte superiori per Stable Diffusion e prestazioni Omniverse 12 volte superiori rispetto alla generazione precedente.
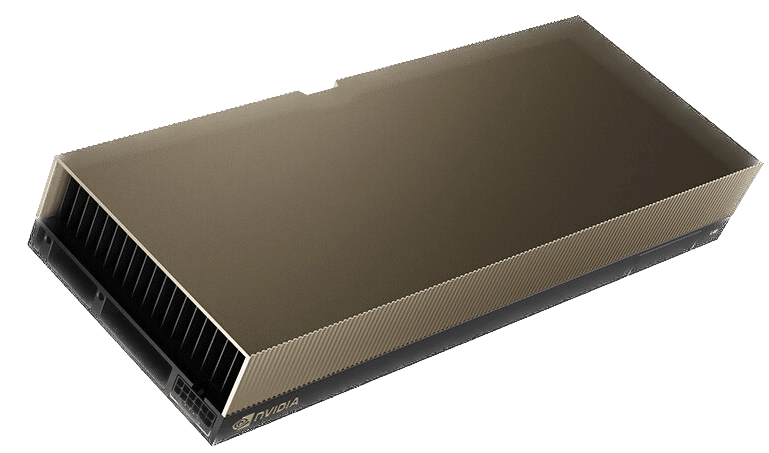
La GPU NVIDIA L40 offre visual computing ad alte prestazioni per il data center, con funzionalità grafiche, di elaborazione e IA di nuova generazione. Basato sull'architettura NVIDIA Ada Lovelace, L40 sfrutta la potenza dei core RT, Tensor e CUDA di ultima generazione per offrire prestazioni di visualizzazione e elaborazione per carichi di lavoro impegnativi dei data center.
L'L40 offre una maggiore produttività e funzionalità di ray-tracing e shading simultanee che migliorano le prestazioni di ray-tracing e accelerano i rendering per i flussi di lavoro di progettazione e architettura, ingegneria e costruzione del prodotto. La GPU L40 offre supporto hardware per la scarsità strutturale e formato TF32 ottimizzato per miglioramenti prestazionali pronti all'uso per un addestramento più rapido dei modelli di scienza dei dati e IA. Le funzionalità grafiche accelerate e potenziate dall'intelligenza artificiale, incluso DLSS, offrono una risoluzione migliorata con prestazioni migliori in applicazioni selezionate.
L'ampia memoria GPU dell'L40 affronta applicazioni e carichi di lavoro ad uso intensivo di memoria come scienza dei dati, simulazione, modellazione 3D e rendering con 48 GB di memoria GDDR6 ultraveloce. La memoria viene allocata a più utenti con il software vGPU per distribuire grandi carichi di lavoro tra team creativi, di data science e di progettazione.
Progettata per operazioni di data center aziendali 24 ore su 7, 40 giorni su 40 con hardware e componenti a risparmio energetico, NVIDIA L3 è ottimizzata per l'implementazione su larga scala e fornire le massime prestazioni per diversi carichi di lavoro di data center. L'LXNUMX include l'avvio sicuro con la tecnologia root of trust, che fornisce un ulteriore livello di sicurezza ed è conforme a NEBS Livello XNUMX per soddisfare gli standard dei data center.
La scheda grafica NVIDIA H100 NVL per la distribuzione di modelli linguistici di grandi dimensioni è ideale per implementare LLM di grandi dimensioni come ChatGPT su larga scala. La nuova H100 NVL è dotata di 94 GB di memoria con accelerazione Transformer Engine e offre prestazioni di inferenza fino a 12 volte più veloci in GPT-3 rispetto alla precedente generazione A100 su scala data center.
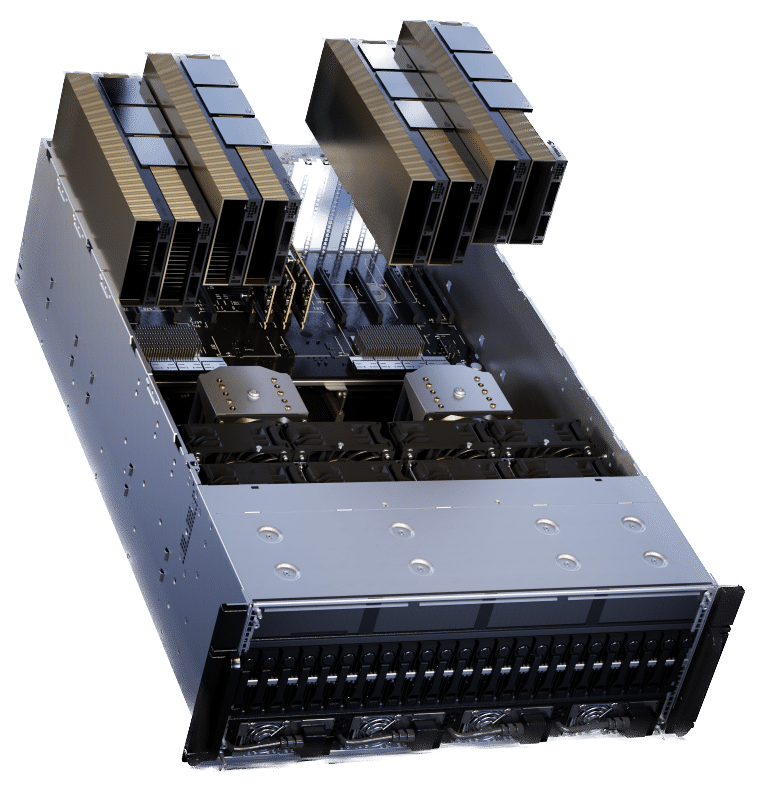
L'H100 NVL basato su PCIe con bridge NVLink utilizza Transformer Engine, NVLink e memoria HBM188 da 3 GB per offrire prestazioni e scalabilità ottimali tra i data center. L'H100 NVL supporta modelli linguistici di grandi dimensioni fino a 175 miliardi di parametri. I server dotati di GPU NVL H100 aumentano le prestazioni del modello GPT-175B fino a 12 volte rispetto ai sistemi NVIDIA DGX A100 mantenendo una bassa latenza in ambienti data center con limiti di potenza.
NVIDIA Grace Hopper per modelli di raccomandazione è ideale per modelli di raccomandazione basati su grafi, database vettoriali e reti neurali su grafi. Grazie alla connessione NVLink-C2C da 900 GB/s tra CPU e GPU, Grace Hopper offre trasferimenti di dati e query 7 volte più veloci rispetto a PCIe Gen 5.
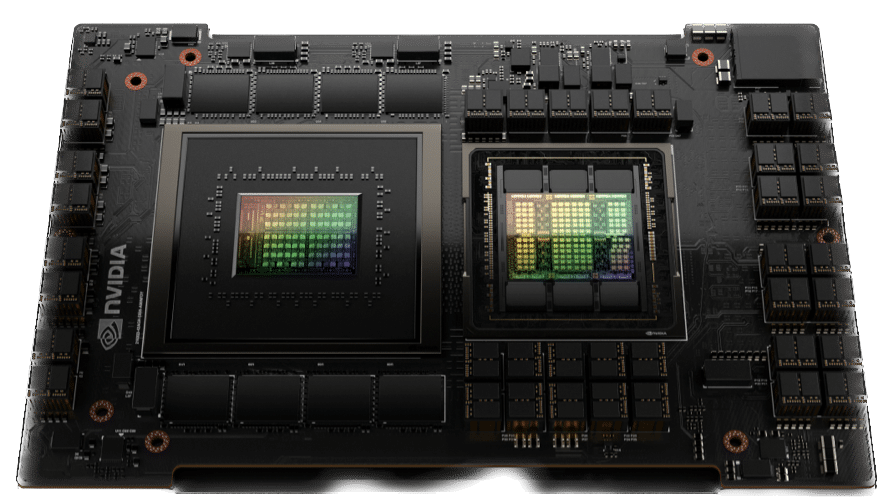
Il superchip NVIDIA Grace Hopper è una CPU accelerata innovativa progettata da zero per applicazioni AI su scala gigante e applicazioni HPC (High Performance Computing). Il superchip fornirà prestazioni fino a 10 volte superiori per le applicazioni che eseguono terabyte di dati, consentendo a scienziati e ricercatori di raggiungere soluzioni senza precedenti per i problemi più complessi del mondo.
Il superchip NVIDIA Grace Hopper combina le architetture Grace e Hopper utilizzando NVIDIA NVLink-C2C per fornire un modello di memoria coerente CPU+GPU per applicazioni AI e HPC accelerate. Grace Hopper include un'interfaccia coerente da 900 gigabyte al secondo (GB/s), è 7 volte più veloce di PCIe Gen5 e offre una larghezza di banda della memoria di sistema aggregata 30 volte superiore alla GPU rispetto a NVIDIA DGX A100. Oltre a tutto ciò, esegue tutti gli stack e le piattaforme software NVIDIA, inclusi NVIDIA HPC SDK, NVIDIA AI e NVIDIA Omniverse.
I moderni modelli di sistemi di raccomandazione richiedono notevoli quantità di memoria per l'archiviazione delle tabelle di incorporamento. Le tabelle di incorporamento contengono rappresentazioni semantiche degli articoli e delle funzionalità degli utenti, che aiutano a fornire consigli migliori ai consumatori.
In genere, questi incorporamenti seguono una distribuzione basata sulla legge di potenza per la frequenza di utilizzo poiché ad alcuni vettori di incorporamento si accede più frequentemente di altri. NVIDIA Grace Hopper consente pipeline di sistemi di raccomandazione ad alto rendimento che
memorizza i vettori di incorporamento utilizzati più frequentemente nella memoria HBM3 e i restanti vettori di incorporamento nella memoria LPDDR5X a capacità maggiore. L'interconnessione NVLink C2C fornisce alle GPU Hopper l'accesso a larghezza di banda elevata alla memoria LPDDR5X locale. Allo stesso tempo, il sistema di commutazione NVLink estende questo aspetto per fornire alle GPU Hopper l'accesso a larghezza di banda elevata a tutta la memoria LPDDR5X di tutti i superchip Grace Hopper nella rete NVLink.


 Amazon