

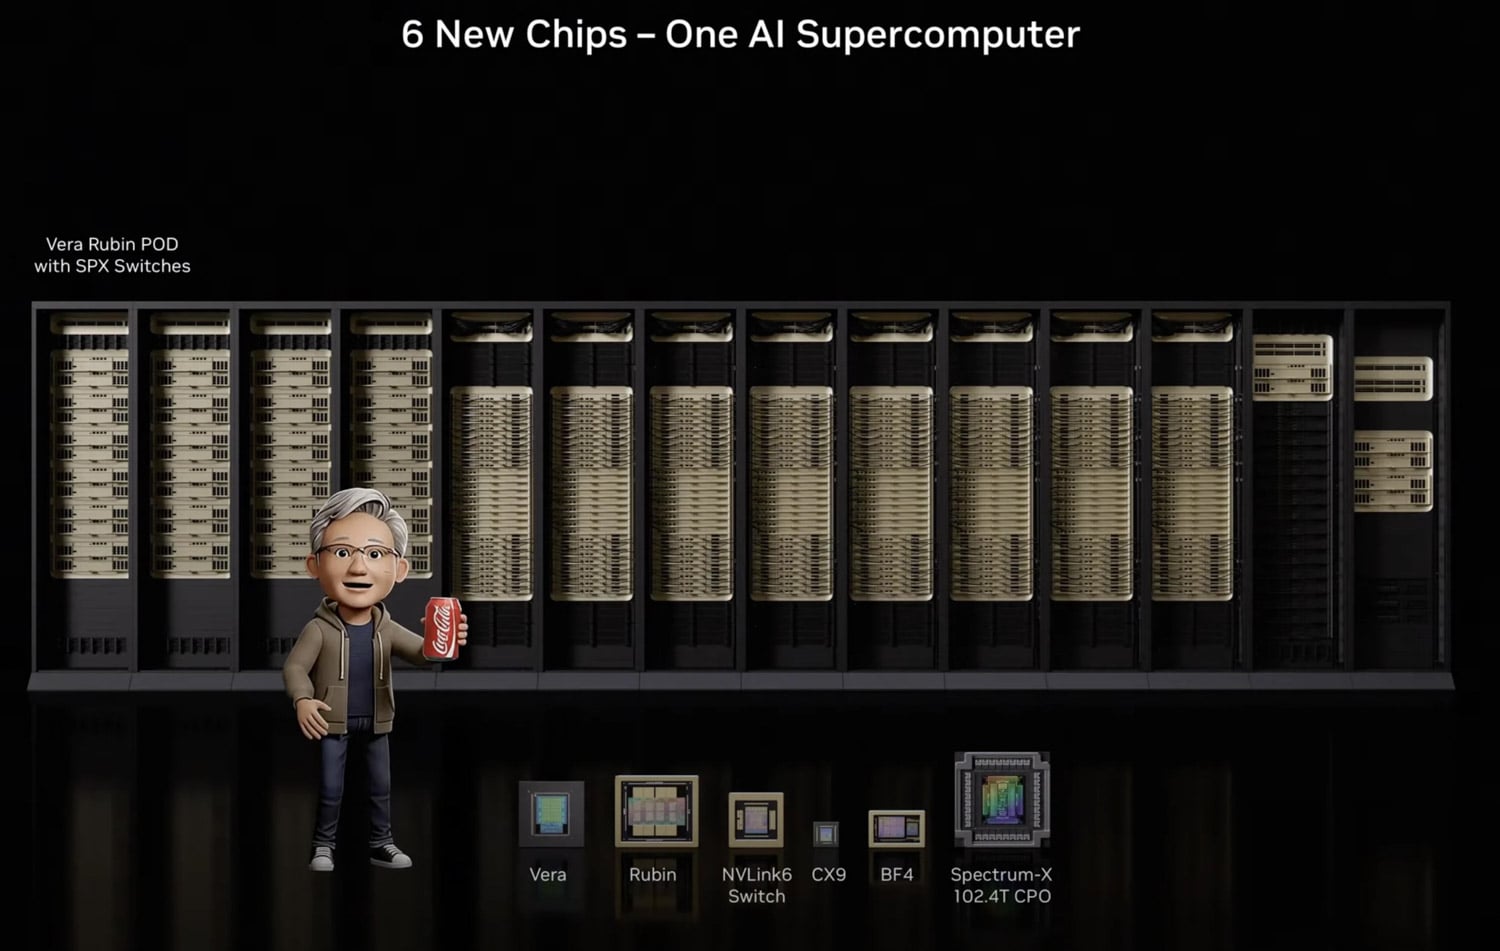
Al CES 2026, NVIDIA ha presentato la piattaforma Rubin, basata sul sistema rack-scale Vera Rubin NVL72. Si tratta dell'architettura rack-scale di terza generazione di NVIDIA, che combina sei chip co-progettati in un unico sistema unificato. La piattaforma sarà disponibile presso i partner nella seconda metà del 2026, con tutti e sei i chip già tornati dalla produzione e attualmente in fase di validazione con carichi di lavoro reali.
Vera Rubin NVL72: sei chip, un sistema unificato
Il Vera Rubin NVL72 sfrutta quello che NVIDIA definisce "co-design estremo", in cui sei chip distinti vengono sviluppati insieme per funzionare come un sistema unificato.
CPU Vera: ARM Silicon progettato per le fabbriche di intelligenza artificiale
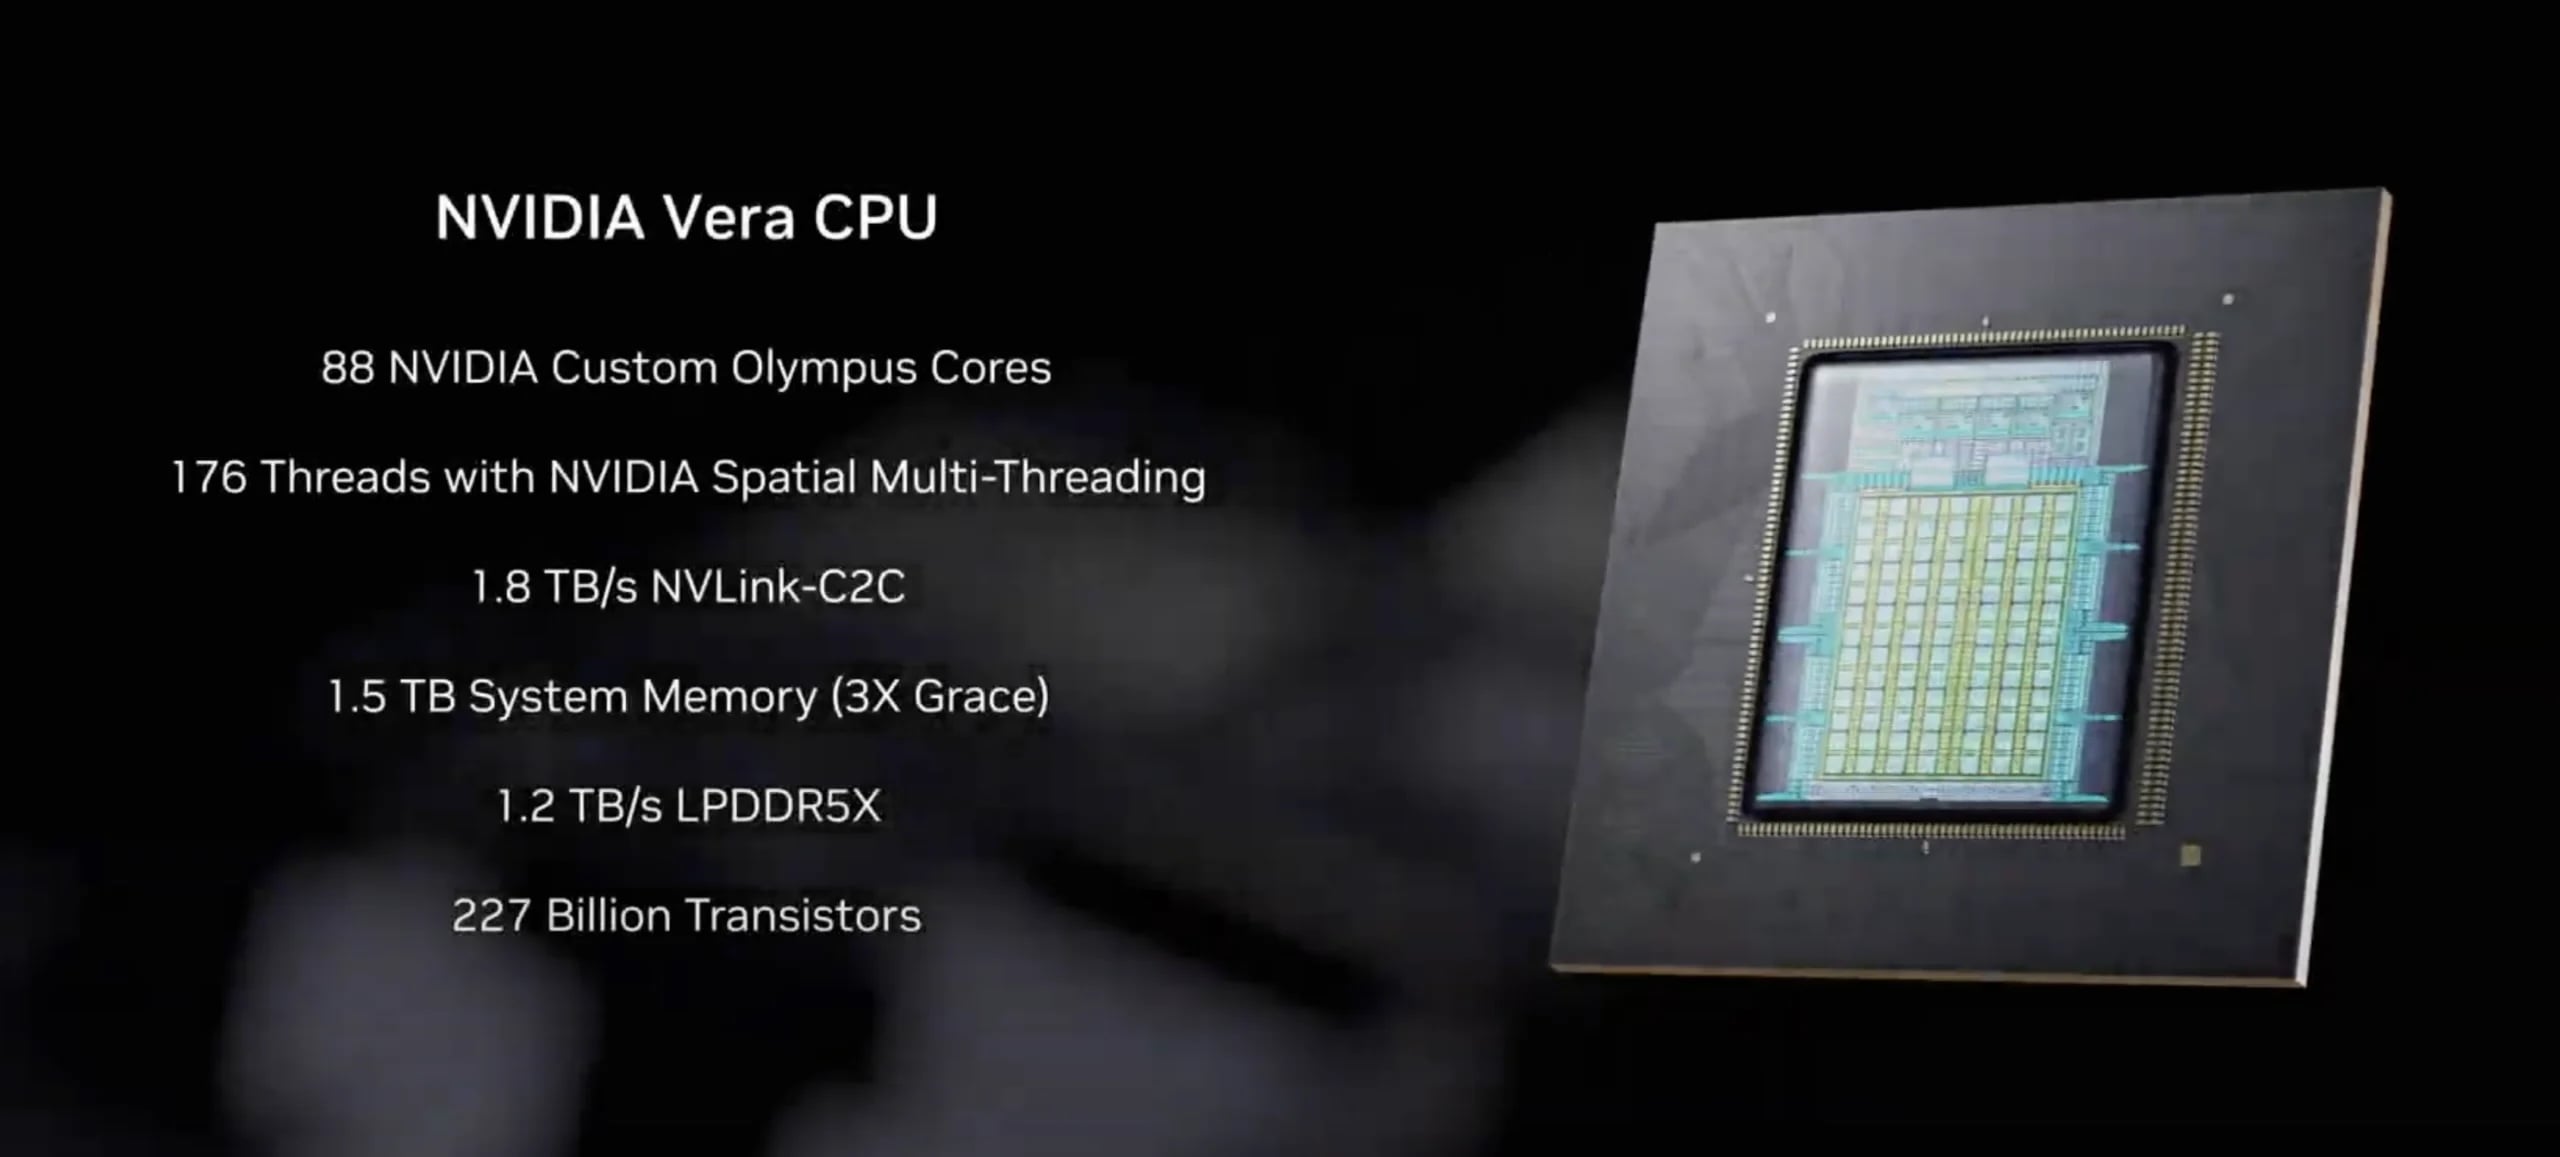
Il primo chip presentato è stata la CPU NVIDIA Vera, che continua a investire in silicio ARM personalizzato per i carichi di lavoro di intelligenza artificiale. Basata su 88 core ARM Olympus personalizzati con piena compatibilità con Armv9.2, Vera è progettata specificamente per le esigenze di trasferimento dati ed elaborazione agentica delle moderne fabbriche di intelligenza artificiale. È dotata di connettività NVLink-C2C, che fornisce 1.8 TB/s di larghezza di banda alle GPU Rubin, raddoppiando la larghezza di banda C2C rispetto alle generazioni precedenti e operando sette volte più velocemente di PCIe Gen 6. La CPU Vera raddoppia le prestazioni di elaborazione dati, compressione e compilazione del codice rispetto alla CPU Grace di precedente generazione.
Confronto generazionale: Blackwell Ultra vs. Vera Rubin NVL72
| Specificazione | GB300 NVL72 (Blackwell Ultra) | VR NVL72 (Vera Rubin) |
|---|---|---|
| Conteggio GPU | 72 GPU Blackwell Ultra | 72 GPU Rubin |
| Conteggio CPU | 36 CPU Grace | 36 CPU Vera |
| CPU Cores | 72 core ARM per CPU | 88 core Olympus ARM per CPU |
| Prestazioni di inferenza FP4 | 1.44 ExaFLOPS | 3.6 ExaFLOPS |
| NVFP4 per GPU (inferenza) | 20 PFLOP | 50 PFLOP |
| NVFP4 per GPU (addestramento) | 10 PFLOP | 35 PFLOP |
| Tipo di memoria GPU | HBM3e | HBM4 |
| Larghezza di banda della memoria della GPU | ~8 TB/s | ~22 TB/s |
| Generazione NVLink | NVLink 5 | NVLink 6 |
| Larghezza di banda NVLink (per GPU) | 1.8 TB / s | 3.6 TB / s |
| Larghezza di banda NVLink su scala rack | 130 TB / s | 260 TB / s |
| NIC scalabile | ConnectX-8 (800 Gb/s) | ConnectX-9 (1.6 TB/s) |
| Interconnessione CPU-GPU | NVLink-C2C (900 GB/s) | NVLink-C2C (1.8 TB/s) |
GPU Rubin: Transformer Engines, NVFP4 e HBM4
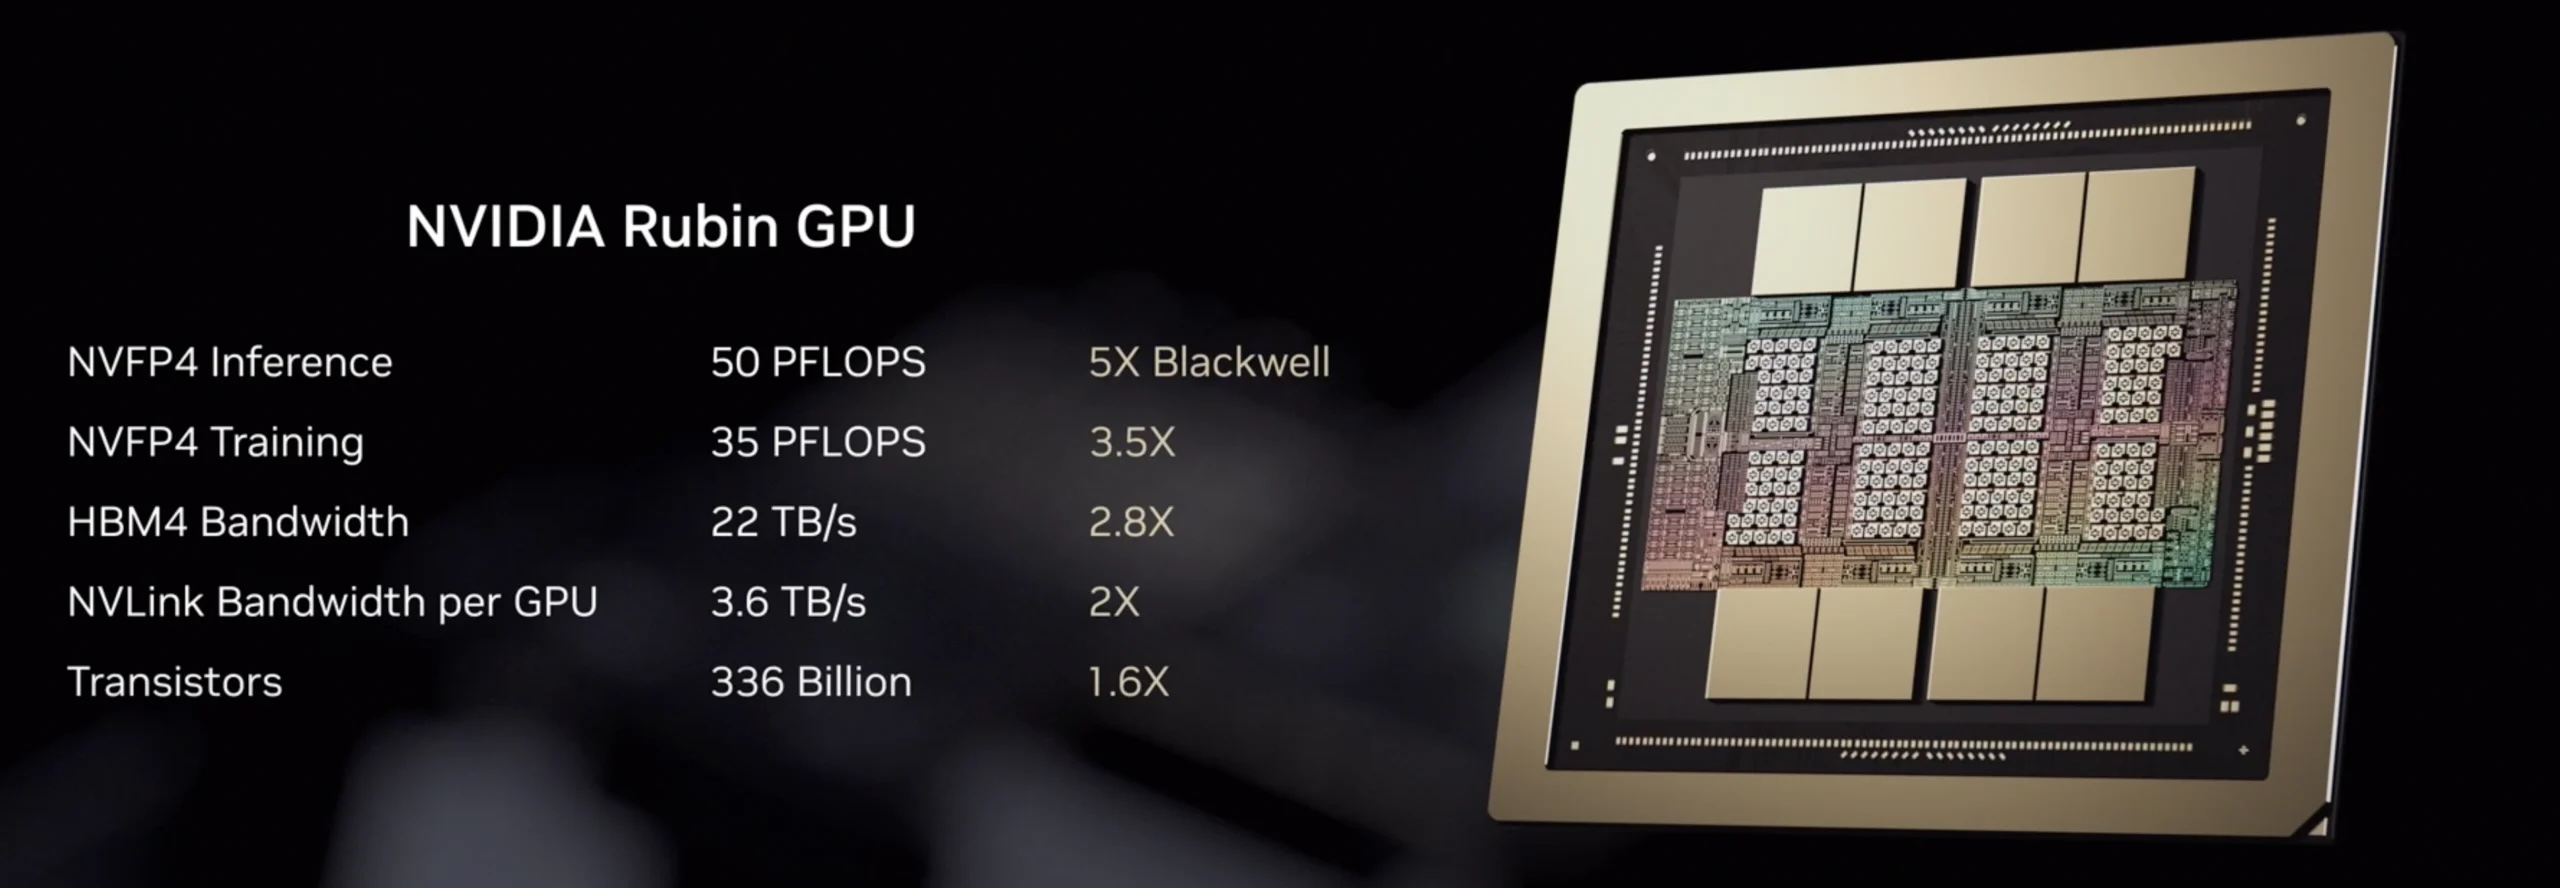
La successiva protagonista dello show è stata la GPU NVIDIA Rubin, dotata di un Transformer Engine di terza generazione con compressione adattiva accelerata tramite hardware. Questo sistema regola dinamicamente la precisione tra i vari livelli del trasformatore, ottenendo un throughput più elevato dove la precisione può essere ridotta, mantenendo al contempo l'accuratezza dove è più importante. Questa implementazione NVFP4 offre 50 petaflop di elaborazione per l'inferenza (5x Blackwell) e 35 petaflop per l'addestramento (3.5x Blackwell). La GPU Rubin è la prima a integrare memoria HBM4 con larghezza di banda fino a 22 TB/s, un salto significativo che risolve il problema della larghezza di banda di memoria che affligge i modelli MoE di grandi dimensioni.
NVLink 6: Comunicazione All-to-All su scala rack
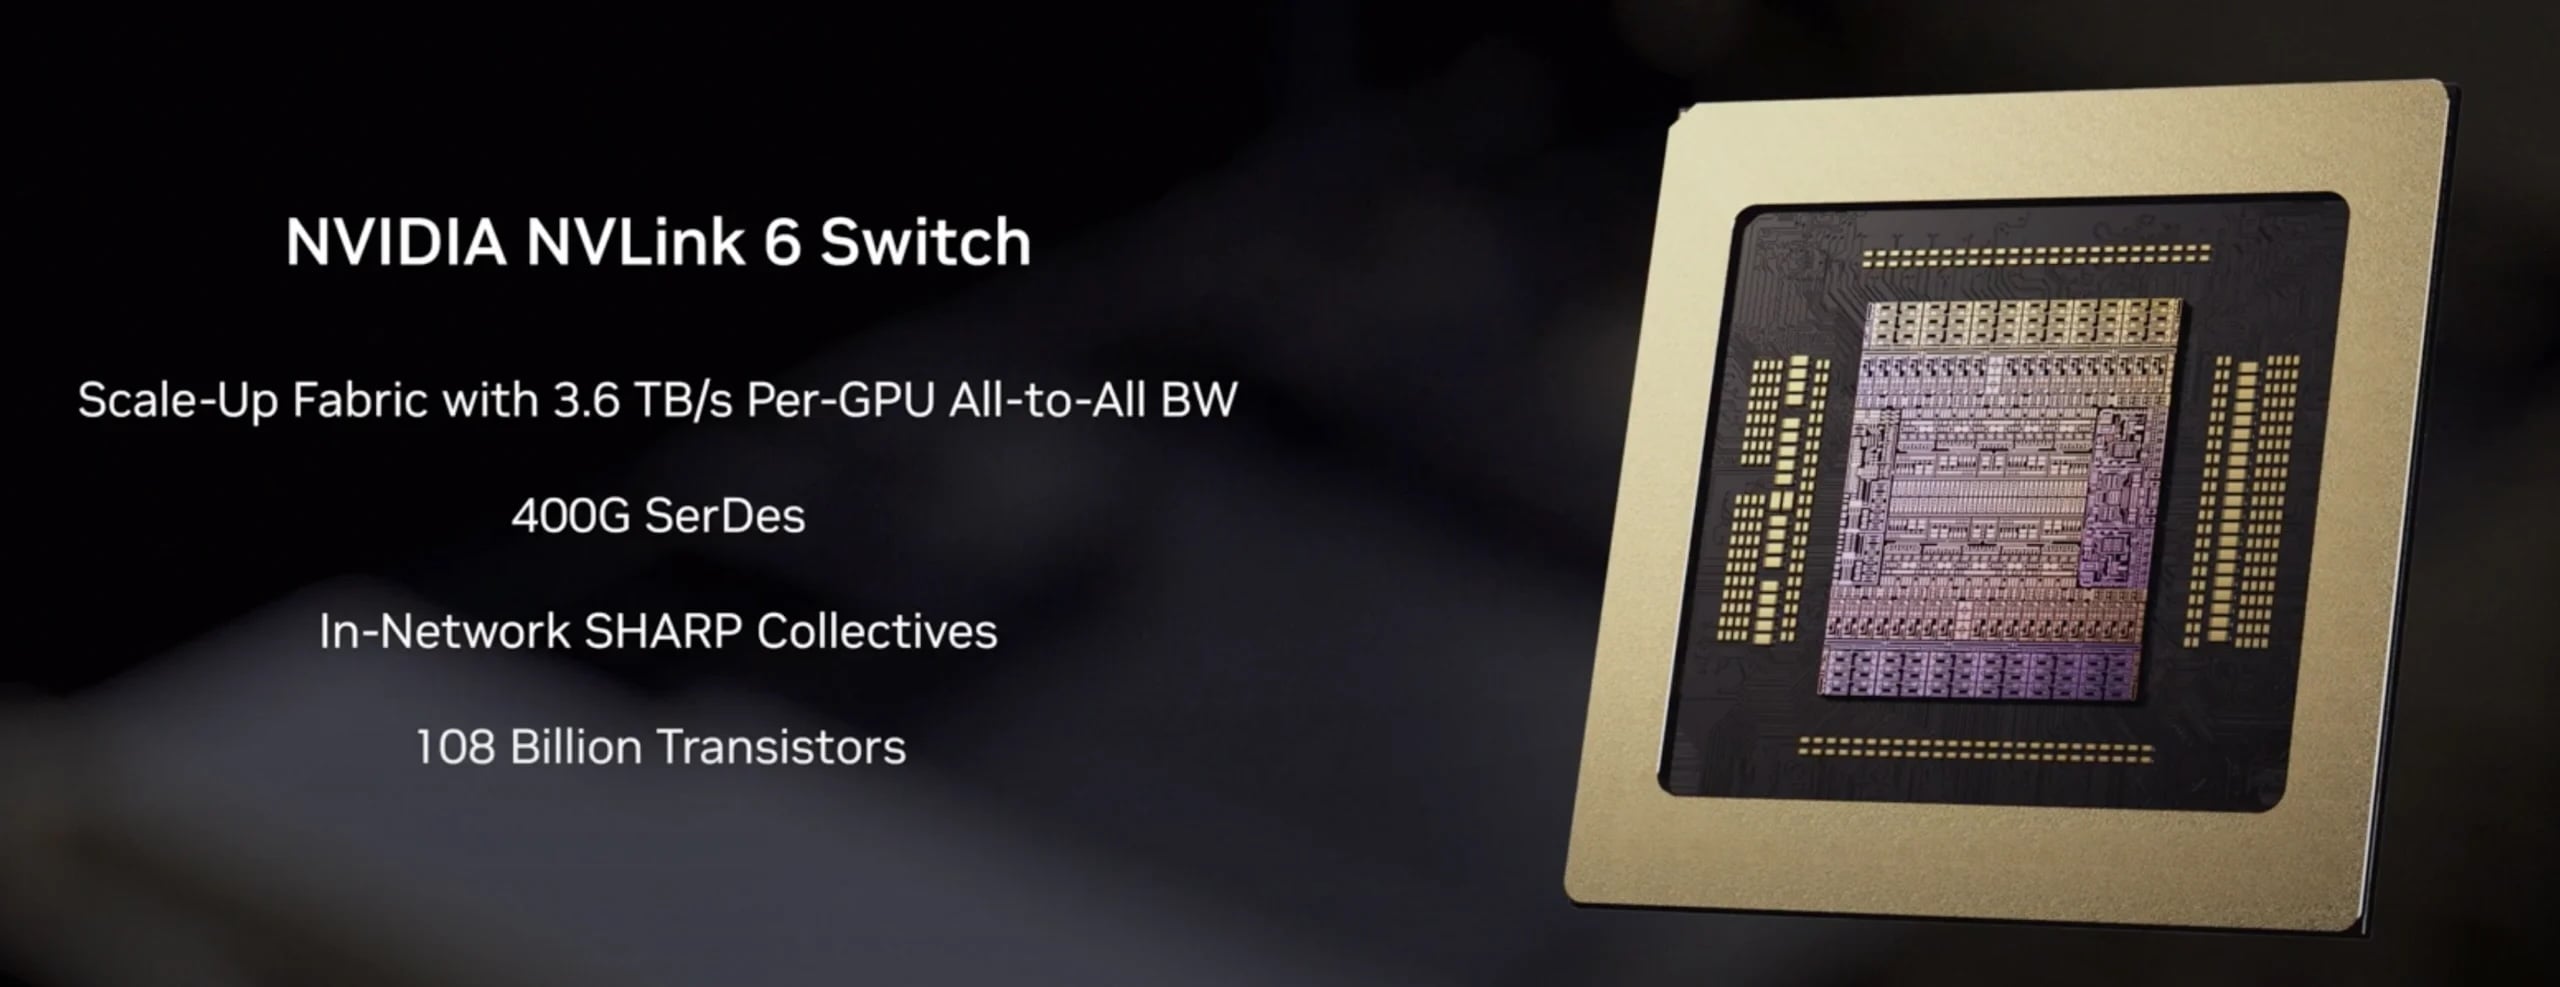
Lo switch NVIDIA NVLink 6 raddoppia la larghezza di banda per GPU a 3.6 TB/s, con l'intero rack che fornisce 260 TB/s di rete scalabile, più del doppio della larghezza di banda trasversale dell'Internet globale. Questa struttura scalabile consente a ogni GPU di comunicare con ogni altra GPU simultaneamente (un requisito per il parallelismo esperto del MoE), dove tutti gli esperti devono condividere i risultati all'interno del cluster. Il calcolo in rete integrato accelera le operazioni collettive e riduce la congestione, scaricando il lavoro che altrimenti consumerebbe cicli GPU.
ConnectX-9 SuperNIC: ridefinizione della rete scalabile
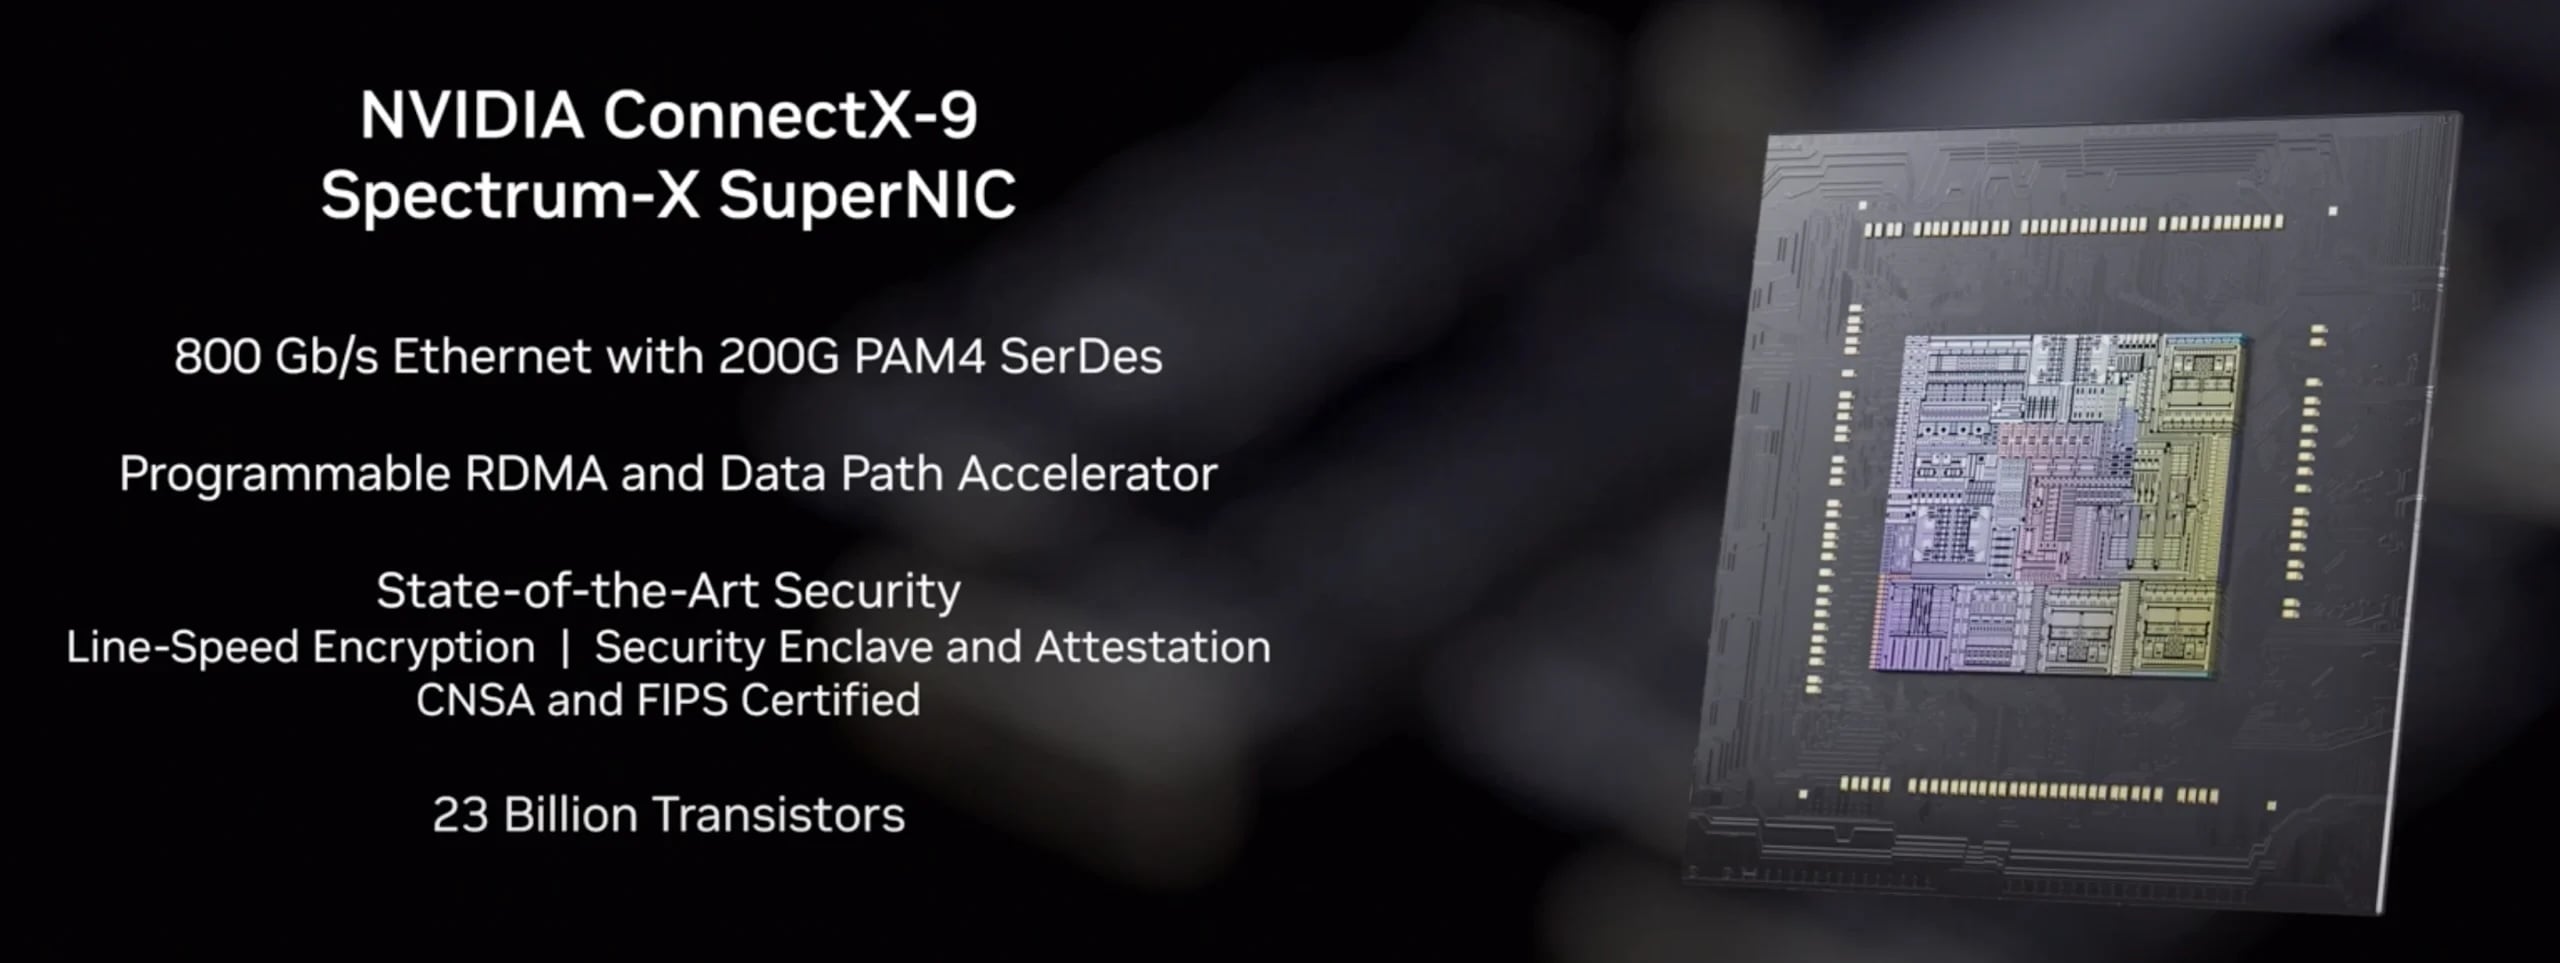
NVIDIA ConnectX-9 SuperNIC gestisce il networking scale-out, offrendo 1.6 TB/s di larghezza di banda RDMA per GPU per la comunicazione oltre il rack. ConnectX-9 è stato progettato in collaborazione con la CPU Vera per massimizzare l'efficienza del percorso dati e introduce un percorso dati accelerato, programmabile e completamente definito dal software che consente ai laboratori di intelligenza artificiale di implementare algoritmi di trasferimento dati personalizzati, ottimizzati per le loro specifiche architetture modello.
Architettura sicura BlueField-4 DPU e ASTRA
BlueField-4 è l'unità di elaborazione dati di quarta generazione di NVIDIA e rappresenta una radicale rivisitazione dello storage e del networking per i carichi di lavoro di intelligenza artificiale. La nuova DPU è dotata di una CPU a 64 core di livello NVIDIA, rispetto ai 16 core ARM Cortex-A78 di BlueField-3, offrendo prestazioni di elaborazione 6 volte superiori. Include una SuperNIC ConnectX-9 co-confezionata rispetto a ConnectX-7 in BlueField-3, raddoppiando la larghezza di banda di rete a 800 Gb/s. L'accesso GPU allo storage dati è 2 volte più veloce rispetto alla generazione precedente. Oltre ai miglioramenti delle specifiche, l'importanza di BlueField-4 risiede in ciò che abilita: un nuovo livello di infrastruttura di storage nativa per l'intelligenza artificiale che NVIDIA sta posizionando come essenziale per l'intelligenza artificiale agentica su larga scala.
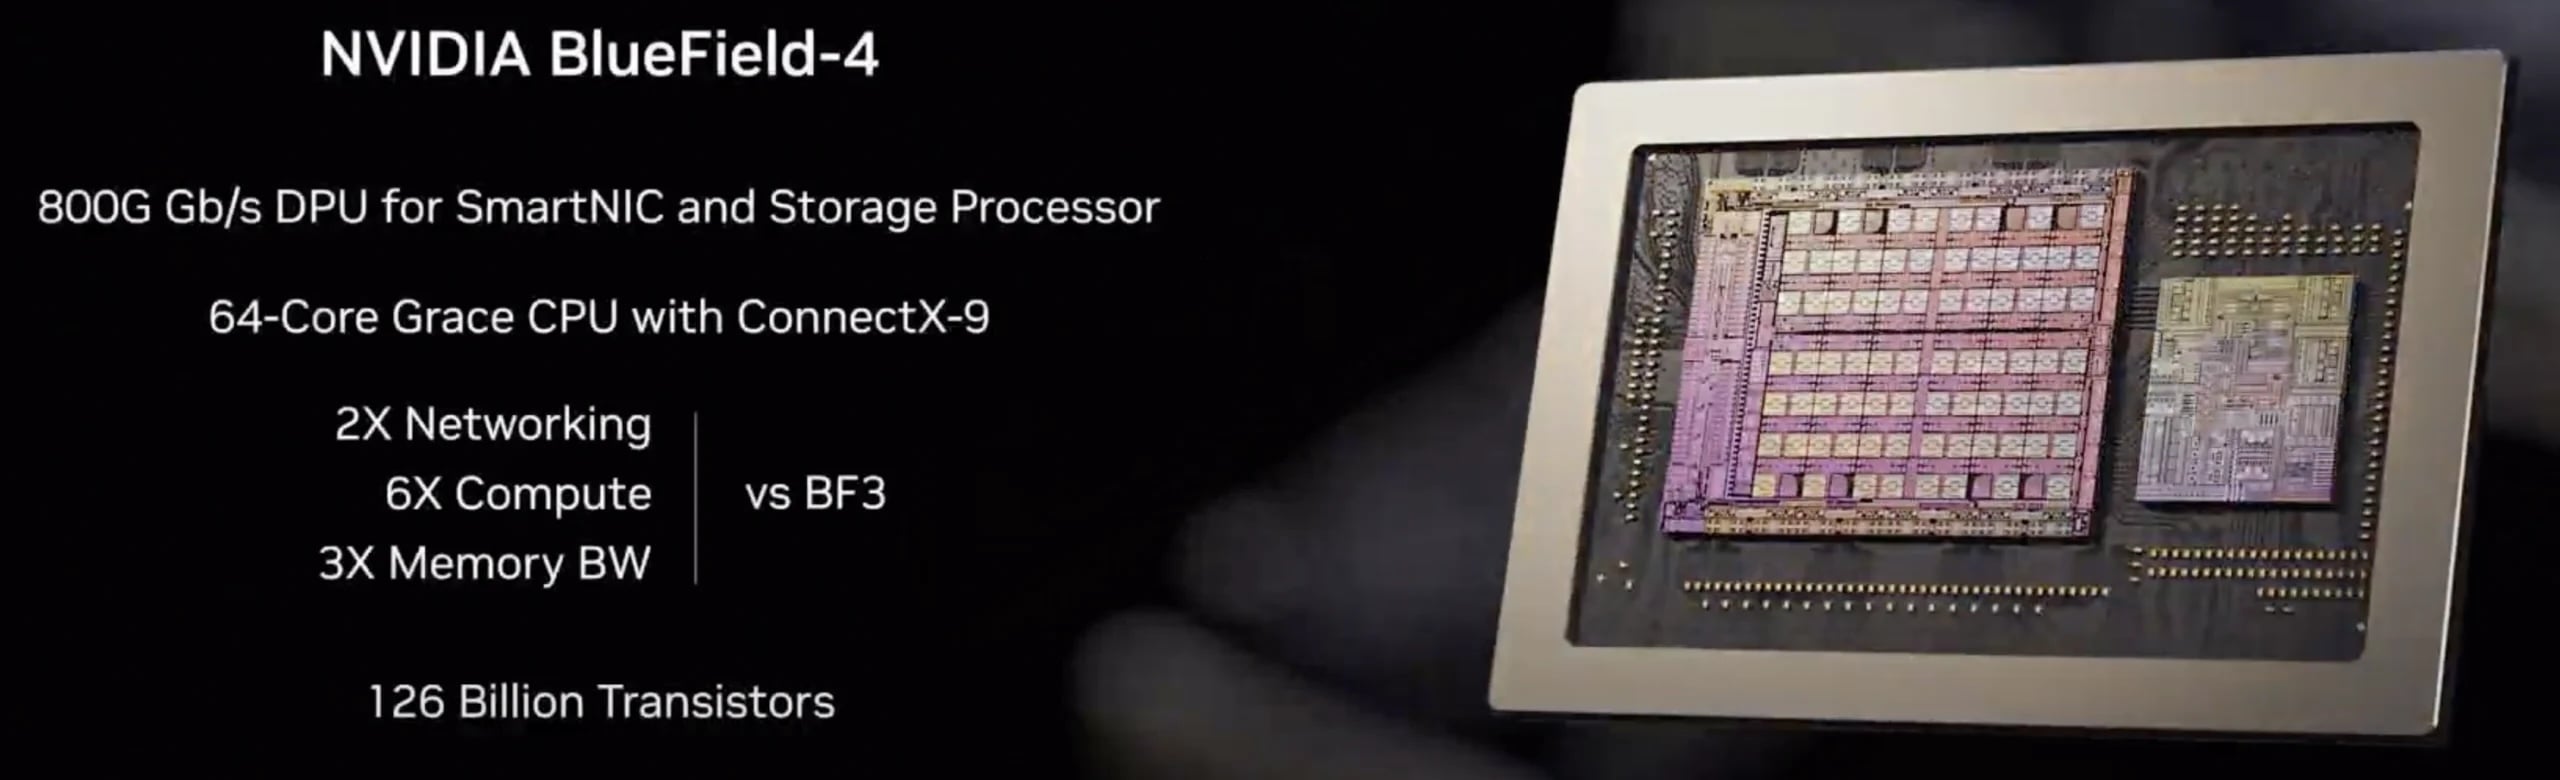
BlueField-4 alleggerisce il carico di elaborazione di rete, storage e sicurezza, consentendo alle GPU Rubin e alle CPU Vera di concentrarsi sull'esecuzione del modello. È completamente integrato nel design convalidato di NVIDIA Enterprise AI Factory, con il supporto dell'ecosistema di Red Hat, Palo Alto Networks, Fortinet e altri.
BlueField-4 introduce anche ASTRA (Advanced Secure Trusted Resource Architecture). Questa architettura di trust a livello di sistema fornisce un unico punto di controllo per il provisioning, l'isolamento e la gestione sicura di ambienti di intelligenza artificiale su larga scala, senza compromettere le prestazioni.
Elaborazione riservata sull'intero rack
Vera Rubin NVL72 è la prima piattaforma rack-scale a offrire NVIDIA Confidential Computing sull'intero sistema. Il confidential computing di terza generazione garantisce la sicurezza dei dati su CPU, GPU e sull'intero dominio NVLink, con ogni bus crittografato in transito. Questo risponde a una crescente preoccupazione tra le aziende e i laboratori di intelligenza artificiale che eseguono modelli proprietari su infrastrutture condivise: la capacità di garantire che modelli, dati di training e carichi di lavoro di inferenza rimangano protetti anche quando distribuiti su sistemi di terze parti.
Lo switch Ethernet NVIDIA Spectrum-6 alimenta le reti scale-out di NVIDIA. È basato sulla tecnologia SerDes 200G con ottica co-packaged (CPO), raggiungendo una capacità di switching di 102 TB/s e alimentando il traffico est-ovest su rack VR NVL72. Il passaggio alla CPO è significativo. Integrando l'ottica direttamente nel silicio dello switch, NVIDIA afferma un'affidabilità 10 volte maggiore, un uptime 5 volte superiore e un'efficienza energetica 5 volte superiore rispetto alle tradizionali ottiche collegabili.

Miglioramenti dei costi e dell'efficienza per i modelli MoE
NVIDIA afferma che il VR NVL72 offre un settimo del costo in token per l'inferenza di modelli Mixture-of-Experts di grandi dimensioni alla stessa latenza di Blackwell. Richiede solo un quarto delle GPU per addestrare lo stesso modello MoE di grandi dimensioni nello stesso lasso di tempo. La piattaforma raggiunge un'inferenza di calcolo per watt 8 volte superiore.
Questi miglioramenti soddisfano i requisiti dei modelli MoE, che attivano solo un sottoinsieme dei loro esperti per ogni token. Modelli come Kimi K2 Thinking impiegano 384 esperti ma ne attivano solo otto alla volta, richiedendo una massiccia comunicazione GPU all-to-all. La rete scalabile da 260 TB/s del VR NVL72 gestisce questo schema di comunicazione.
Un rack senza cavi progettato per grandi dimensioni
Il VR NVL72 introduce un design modulare, senza cavi, ventole e tubi flessibili, che utilizza solo PCB e connettori, anziché cavi interni. I vassoi di elaborazione si collegano tramite connettori blind-mate quando vengono inseriti nel rack, eliminando la necessità di instradare manualmente i cavi. Gli unici collegamenti esterni sono due tubi flessibili di ingresso e uscita del liquido che si collegano ai blocchi di raffreddamento a liquido.

I sistemi precedenti, come il GB300 NVL72, richiedevano circa 100 minuti per assemblare un singolo vassoio di elaborazione. Ogni collegamento via cavo rappresentava un potenziale punto di guasto, che diventa significativo su una scala di centinaia di migliaia di GPU. Il passaggio dei cavi limitava i percorsi di raffreddamento e occupava spazio, mentre le ventole aggiungevano complessità meccanica e rumore.
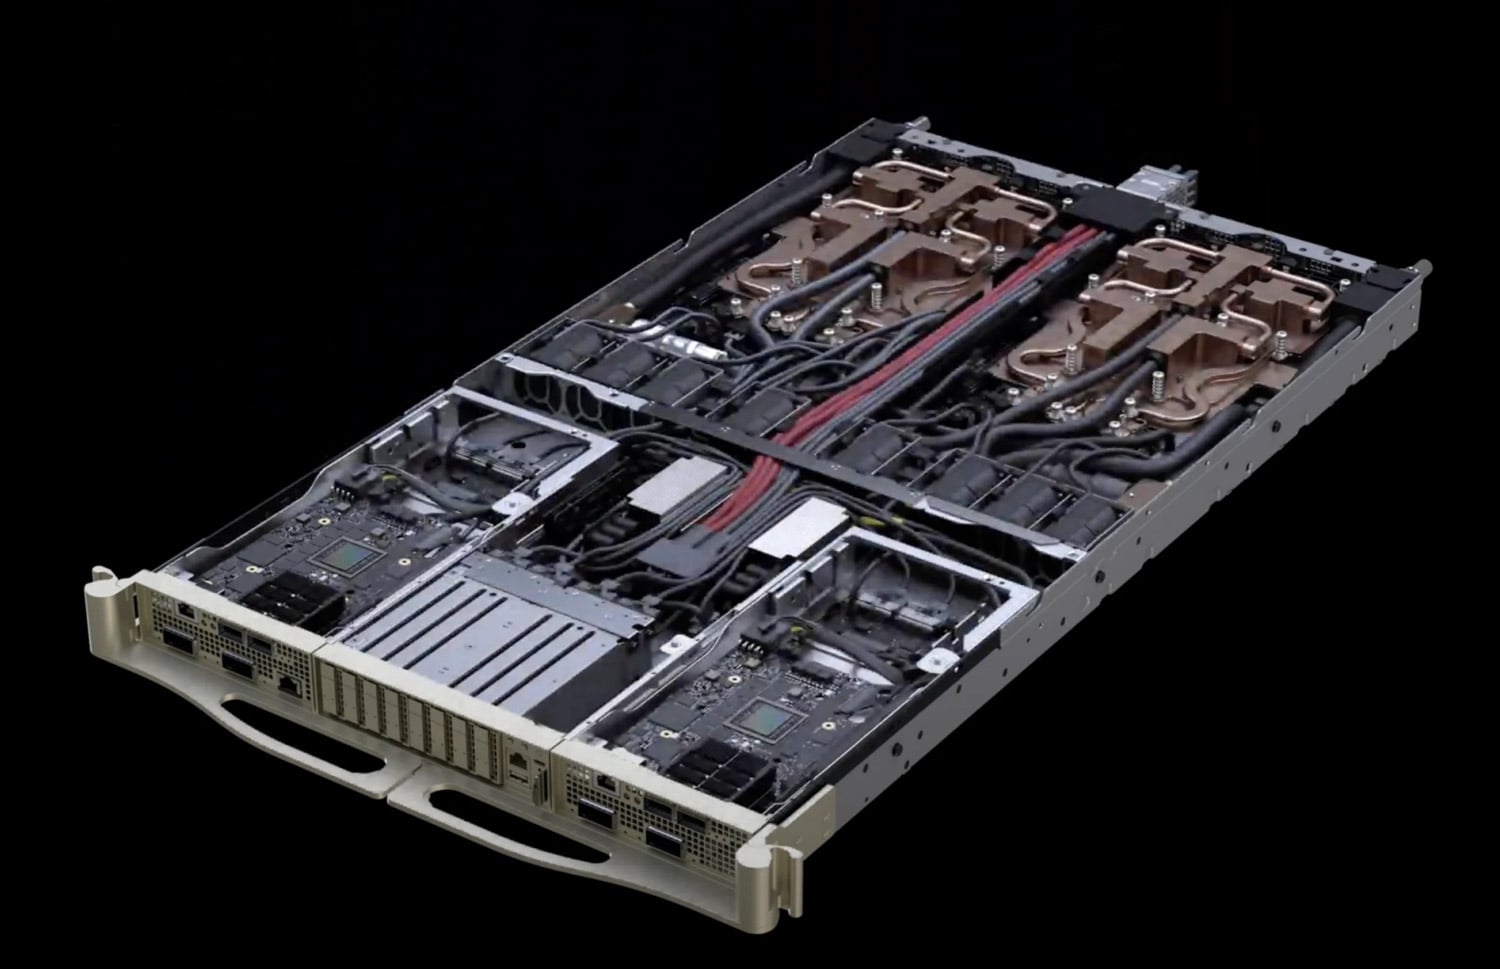
Il nuovo design riduce i tempi di assemblaggio e manutenzione di 18 volte. La piattaforma è inoltre dotata di un motore RAS (Reliability, Availability, Serviceability) di seconda generazione che copre GPU, CPU e NVLink, offrendo controlli di integrità in tempo reale, tolleranza ai guasti e manutenzione proattiva. I vassoi di switch NVLink ora supportano la manutenzione senza tempi di inattività, consentendo ai rack di rimanere operativi anche quando i vassoi di switch vengono rimossi o parzialmente popolati. Su scala di centinaia di migliaia di GPU, questi miglioramenti in termini di manutenibilità si traducono direttamente in uptime e goodput del cluster.
Questa architettura consente future configurazioni a densità più elevata. È inoltre fondamentale per rendere possibili i design dei rack Vera Rubin CPX, anticipati in precedenza e presentati all'AI Infra Summit , che aggiungono ulteriori GPU per l'elaborazione del contesto allo stesso modulo di calcolo in un design già di per sé denso.
Piattaforma di archiviazione della memoria del contesto di inferenza
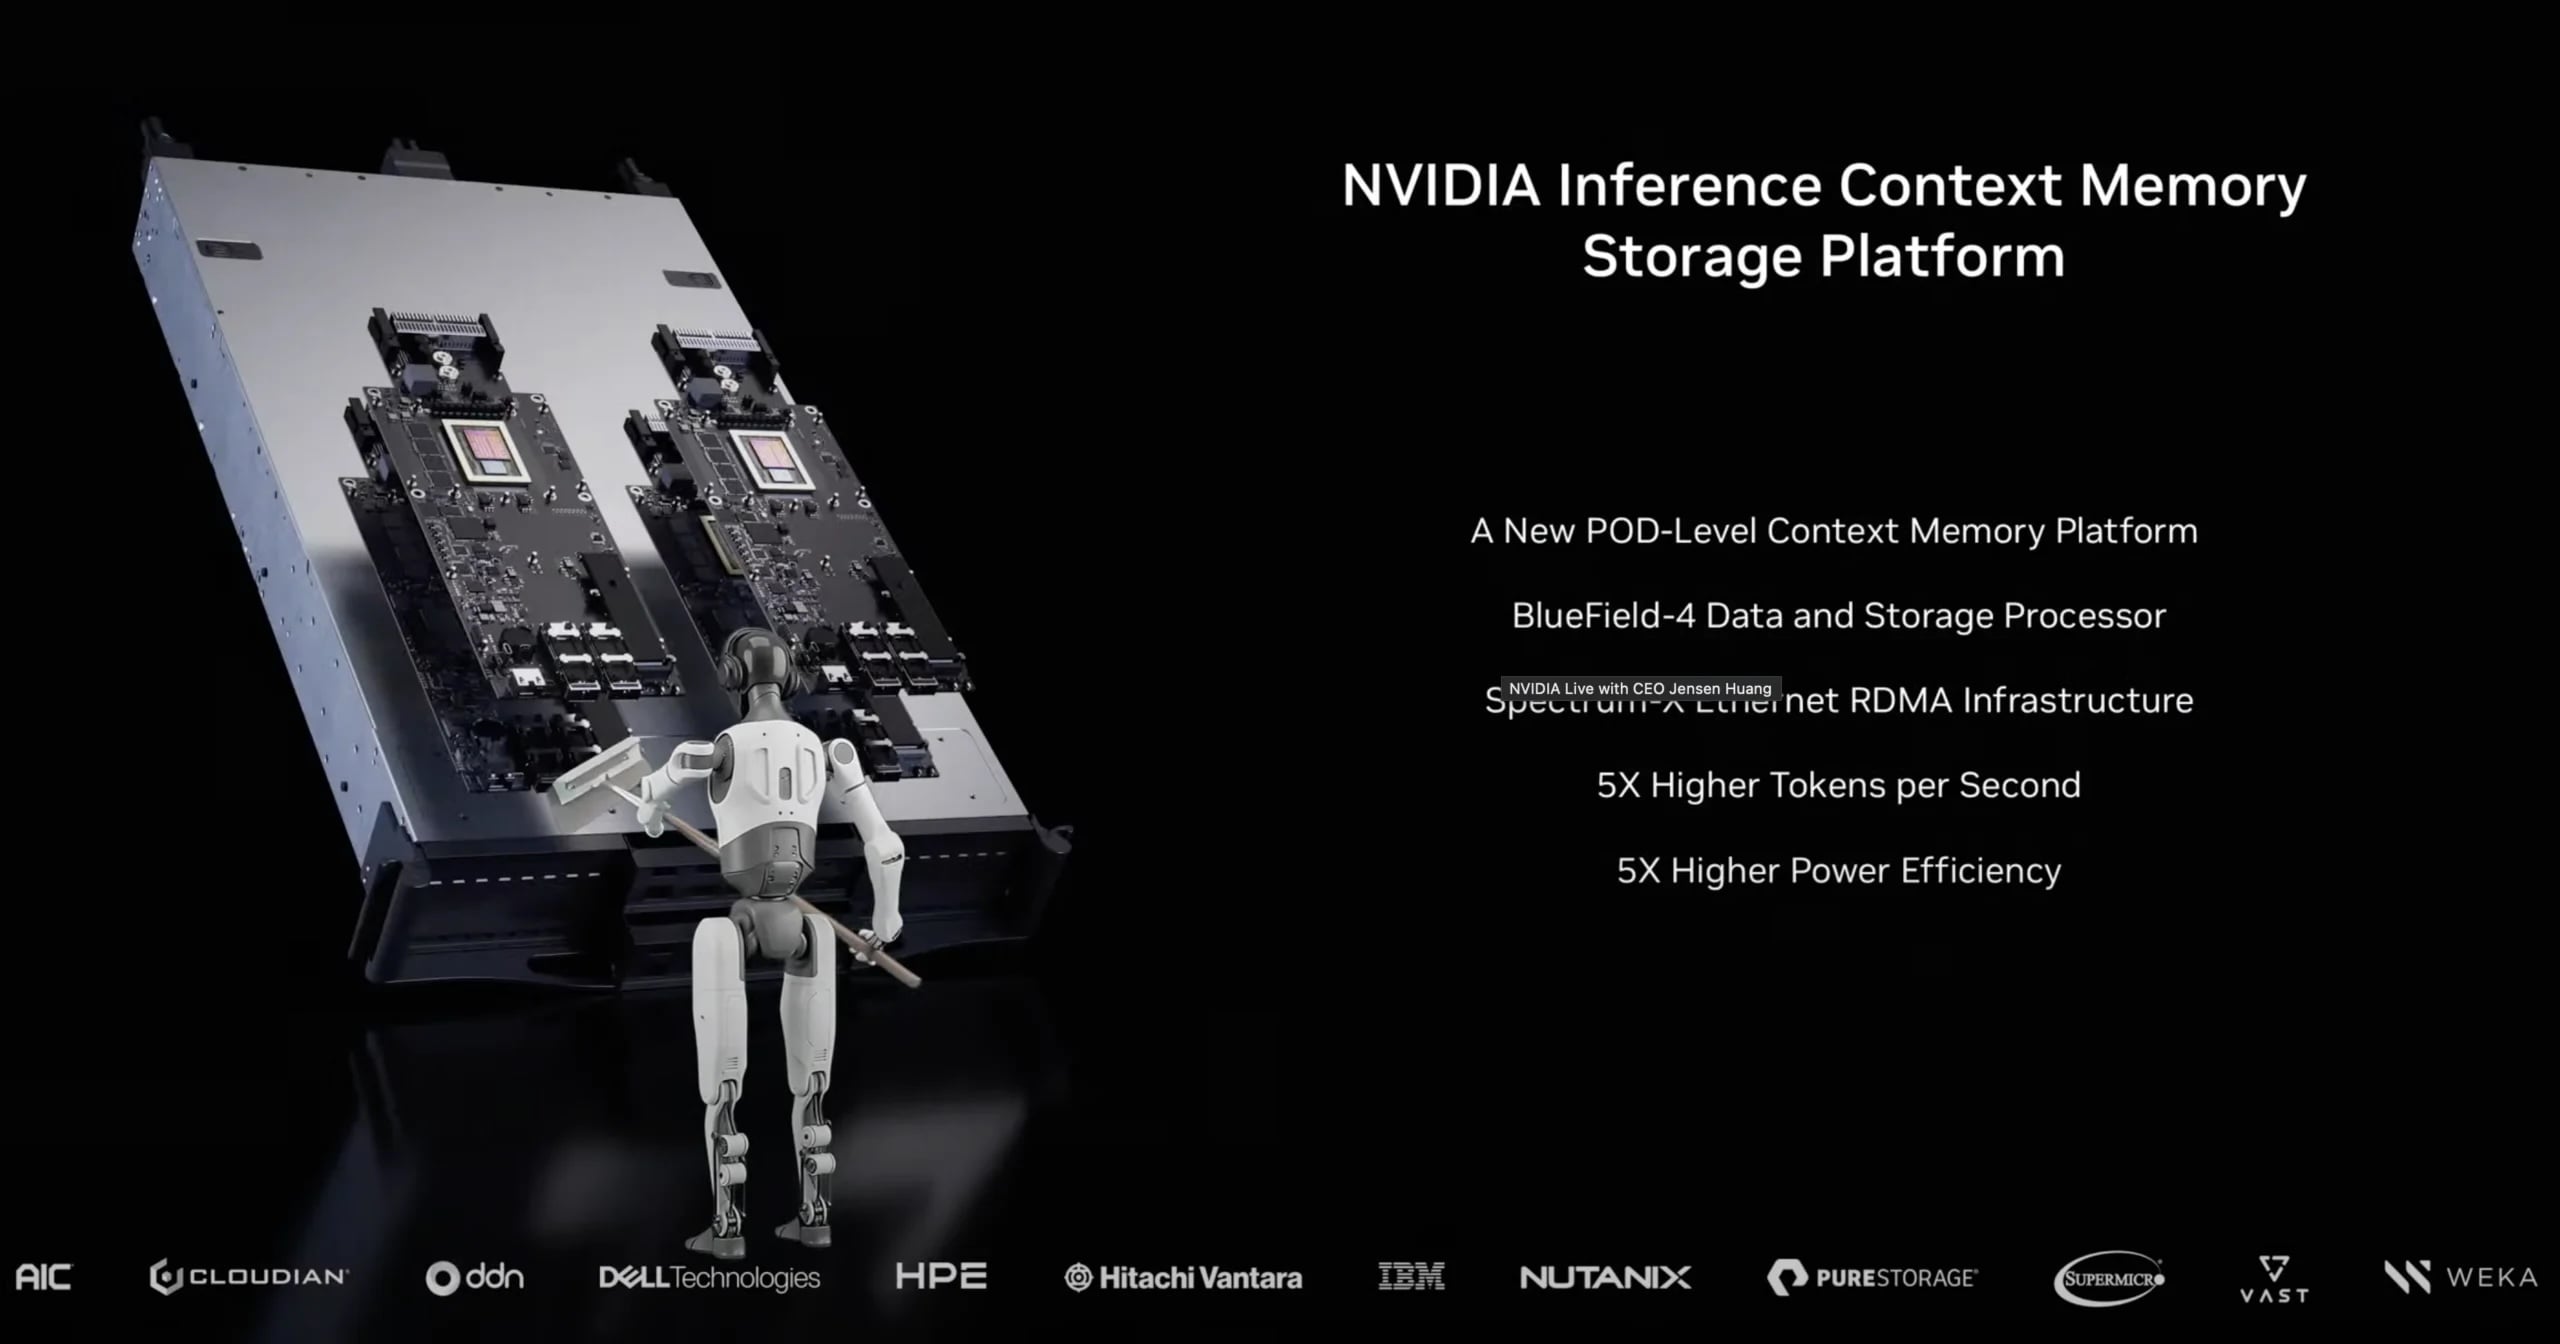
NVIDIA ha annunciato la piattaforma di storage in memoria per il contesto di inferenza al CES 2026, una nuova classe di infrastruttura di storage nativa per l'intelligenza artificiale, progettata specificamente per la cache KV. La piattaforma è basata su BlueField-4 e sulla rete Ethernet Spectrum-X. Offre token al secondo fino a 5 volte superiori rispetto allo storage di rete tradizionale utilizzato per il contesto di inferenza, prestazioni fino a 5 volte superiori per dollaro TCO, efficienza energetica fino a 5 volte superiore e un miglioramento di 20 volte del time-to-first token. Il posizionamento della cache KV con accelerazione hardware di BlueField-4 elimina il sovraccarico dei metadati e riduce lo spostamento dei dati, mentre la rete Ethernet Spectrum-X fornisce il fabric ad alta larghezza di banda e bassa latenza per l'accesso basato su RDMA.
Questa piattaforma risolve un crescente collo di bottiglia nell'inferenza LLM: la gestione della cache KV. I modelli Transformer utilizzano un meccanismo di attenzione in cui ogni token generato deve rispondere a tutti i token precedenti. Senza la memorizzazione nella cache, ciò richiede il ricalcolo dei vettori chiave-valore per ogni token, con conseguente complessità O(n²). La memorizzazione nella cache KV memorizza queste matrici precalcolate in memoria per il riutilizzo, riducendo la complessità a O(n). Il problema è che la dimensione della cache KV cresce linearmente con la lunghezza della sequenza e la dimensione del batch. Una singola conversazione di contesto lungo può consumare gigabyte di memoria. Negli ambienti multi-tenant, dove si gestiscono migliaia di richieste simultanee su finestre di contesto che si estendono a milioni di token, la GPU HBM si esaurisce. Gli operatori devono ridurre le dimensioni dei batch, accorciare le finestre di contesto o acquistare più GPU.
Lo storage di rete tradizionale non è stato progettato per i modelli di accesso alla cache KV, che richiedono un accesso casuale a bassa latenza a potenzialmente terabyte di dati transitori distribuiti su numerose sessioni simultanee. La piattaforma di storage in memoria contestuale inferenziale (Inference Context Memory Storage Platform) fornisce un livello di storage dedicato ottimizzato per questo carico di lavoro, posizionandosi tra l'HBM della GPU e lo storage convenzionale. Ciò consente alle fabbriche di intelligenza artificiale di scalare la capacità di contesto indipendentemente dal calcolo della GPU. In precedenza abbiamo spiegato come funziona l'offload della cache KV con NVIDIA Dynamo utilizzando un acceleratore di cache KV di Pliops. NVIDIA lo scala con la piattaforma di storage in memoria contestuale inferenziale (NVIDIA Inference Context Memory Storage Platform) e lo integra nel suo progetto Dynamo open source. Questo fornisce il framework software che collega le fasi di precompilazione/decodifica disaggregate, il routing intelligente e l'offload dello storage a livelli di questa nuova piattaforma.
I partner di storage, tra cui VAST Data, NetApp, DDN, Dell Technologies, HPE, Hitachi Vantara, IBM, Nutanix, Pure Storage e WEKA, stanno sviluppando piattaforme con BlueField-4. Queste saranno disponibili nella seconda metà del 2026.
Alpamayo: intelligenza artificiale fisica basata sul ragionamento per veicoli autonomi
NVIDIA ha annunciato la famiglia Alpamayo di modelli di intelligenza artificiale aperti, strumenti di simulazione e set di dati progettati per accelerare lo sviluppo di veicoli autonomi (AV) sicuri e basati sul ragionamento. La famiglia Alpamayo introduce modelli di visione-linguaggio-azione basati sulla catena di pensiero, che integrano il pensiero umano nel processo decisionale dei veicoli autonomi. Il sistema di sicurezza NVIDIA Halo è alla base di questi sistemi.
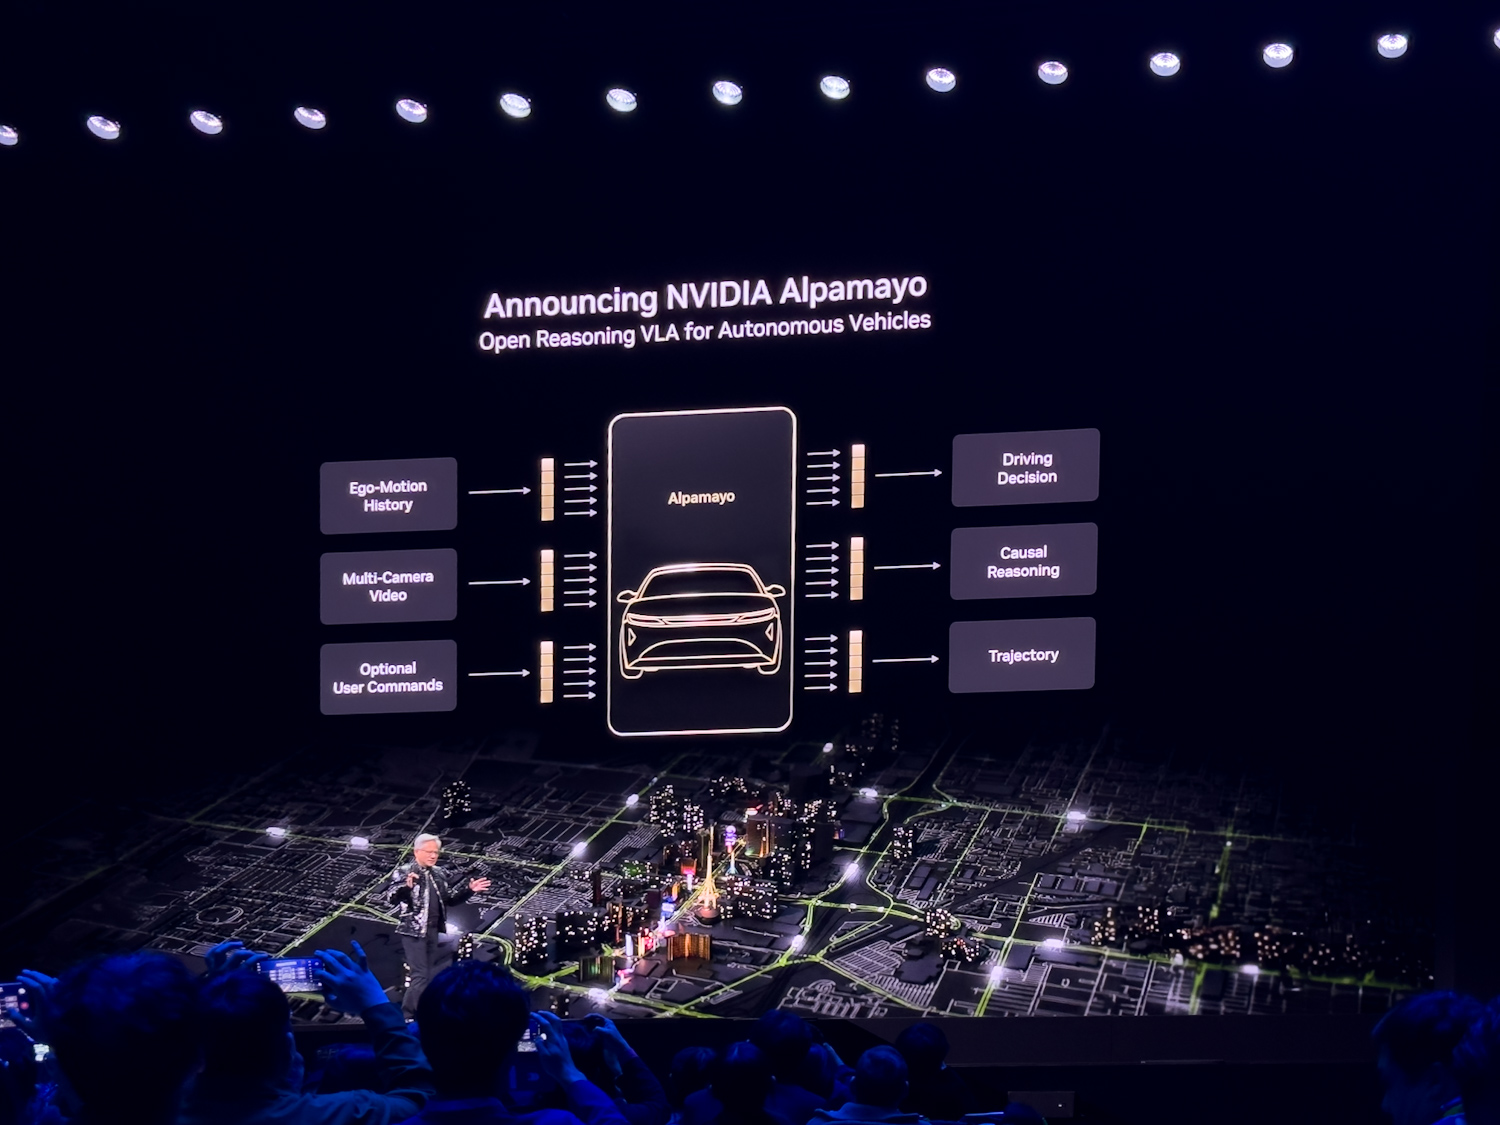
Le architetture AV tradizionali separano la percezione dalla pianificazione, il che può limitare la scalabilità quando si presentano situazioni nuove o insolite. La "coda lunga" di scenari rari e complessi rimane una delle sfide più ardue da gestire in sicurezza per i sistemi autonomi. Alpamayo affronta questo problema consentendo ai modelli di ragionare su cause ed effetti, analizzando nuovi scenari passo dopo passo per migliorare la capacità di guida e la spiegabilità.
Anziché essere eseguiti direttamente a bordo del veicolo, i modelli Alpamayo fungono da modelli didattici su larga scala che gli sviluppatori possono perfezionare e integrare nei sistemi portanti dei loro stack AV completi. Gli sviluppatori possono adattare Alpamayo a modelli runtime più piccoli per lo sviluppo di veicoli o utilizzarlo come base per strumenti di sviluppo AV come valutatori basati sul ragionamento e sistemi di auto-etichettatura.
Modelli, simulazioni e set di dati aperti di Alpamayo
Alpamayo 1 è il primo modello VLA basato su ragionamento a catena di pensiero del settore, progettato per la comunità di ricerca AV, disponibile su Hugging Face. Con un'architettura da 10 miliardi di parametri, Alpamayo 1 utilizza l'input video per generare traiettorie insieme a tracce di ragionamento, mostrando la logica alla base di ogni decisione. Alpamayo 1 fornisce pesi di modello e script di inferenza open source. I modelli futuri della famiglia presenteranno un numero maggiore di parametri, capacità di ragionamento più dettagliate, maggiore flessibilità di input e output e opzioni per uso commerciale.
AlpaSim è un framework di simulazione end-to-end completamente open source per lo sviluppo di sistemi AV ad alta fedeltà, disponibile su GitHub. Offre una modellazione realistica dei sensori, dinamiche di traffico configurabili e ambienti di test a ciclo chiuso scalabili, consentendo una rapida convalida e il perfezionamento delle policy.
I set di dati aperti di intelligenza artificiale fisica contengono oltre 1,700 ore di dati di guida raccolti nella più ampia gamma di aree geografiche e condizioni, coprendo casi limite rari e complessi del mondo reale, essenziali per lo sviluppo di architetture di ragionamento. Questi set di dati sono disponibili su Hugging Face.
Gli sviluppatori possono perfezionare le versioni del modello Alpamayo sui dati proprietari della flotta, integrarli nell'architettura NVIDIA DRIVE Hyperion realizzata con il calcolo accelerato NVIDIA DRIVE AGX Thor e convalidare le prestazioni nella simulazione prima della distribuzione commerciale.
NVIDIA DRIVE, stack AV ridondanti e Mercedes-Benz CLA
NVIDIA lavora sulle auto a guida autonoma da otto anni con un team di diverse migliaia di persone. L'azienda ha sviluppato l'intero stack: chip (dual Orin, dual Thor di nuova generazione), infrastruttura (Omniverse e Cosmos), modelli (Alpamayo) e il livello applicativo. Mercedes-Benz ha collaborato con NVIDIA cinque anni fa per implementare questo stack.
Il primo veicolo autonomo full-stack NVIDIA, la Mercedes-Benz CLA, verrà lanciato nel primo trimestre del 2026 negli Stati Uniti, nel secondo trimestre in Europa e nel terzo/quarto trimestre in Asia. Euro NCAP ha assegnato alla CLA il punteggio più alto in termini di sicurezza attiva tra tutte le auto presentate nel 2025. Ogni riga di codice e ogni chip del sistema è certificato per la sicurezza.

Il sistema gestisce due stack AV completi in parallelo. Lo stack Alpamayo utilizza un ragionamento a catena e gestisce scenari di guida complessi. Un secondo stack AV classico sottostante è completamente tracciabile e ha richiesto dai sei ai sette anni per essere sviluppato. Un valutatore di policy e sicurezza decide quale stack utilizzare in base al livello di confidenza. Se Alpamayo incontra uno scenario in cui non è affidabile, il sistema torna allo stack classico. Questa diversità e ridondanza nel software rispecchia il modo in cui i sistemi critici per la sicurezza gestiscono la ridondanza hardware.
NVIDIA continuerà ad aggiornare il sistema con nuove versioni di Alpamayo. Partner di mobilità, tra cui JLR, Lucid, Uber e Berkeley DeepDrive, stanno utilizzando Alpamayo per lo sviluppo di sistemi di guida autonoma di livello 4 basati sul ragionamento.
Nuovi modelli di intelligenza artificiale fisica e annunci di robotica
Oltre agli annunci relativi a infrastrutture e sistemi, NVIDIA ha sfruttato il CES 2026 anche per promuovere la sua strategia di intelligenza artificiale fisica, rilasciando nuovi modelli, framework e piattaforme edge aperti per accelerare lo sviluppo della robotica. L'azienda ha introdotto aggiornamenti ai suoi modelli Cosmos World e ai modelli di ragionamento GR00T per l'apprendimento robotico, insieme a nuovi strumenti open source (tra cui Isaac Lab-Arena) per la valutazione di robot su larga scala. OSMO è un framework di orchestrazione edge-to-cloud progettato per semplificare i flussi di lavoro di formazione in ambienti di elaborazione eterogenei.

NVIDIA ha evidenziato l'ampia adozione del suo stack robotico da parte del settore, con partner come Boston Dynamics, Caterpillar, LG Electronics e NEURA Robotics, che hanno presentato macchine autonome di nuova generazione basate sulle tecnologie NVIDIA. L'azienda ha inoltre annunciato una collaborazione più stretta con Hugging Face per integrare i modelli NVIDIA Isaac e GR00T nel framework open source LeRobot, ampliando ulteriormente l'accesso per la comunità globale di sviluppatori di robotica.
In ambito edge, NVIDIA ha confermato la disponibilità del modulo Jetson T4000 basato su Blackwell, che offre un significativo aumento dell'efficienza energetica e del calcolo AI per macchine autonome e robotica industriale. Insieme, questi annunci rafforzano l'impegno di NVIDIA nell'estendere la sua piattaforma AI full-stack oltre il data center, abbracciando simulazione, modelli, edge computing e implementazione nel mondo reale in robotica e sistemi autonomi.


 Amazon