

Le aziende hyperscaler e gli operatori di infrastrutture focalizzate sull'IA stanno sviluppando sempre più acceleratori AI e XPU proprietari per stare al passo con modelli linguistici di grandi dimensioni e carichi di lavoro di ragionamento complessi. Per affrontare le sfide fisiche, di memoria e di rete legate all'implementazione su larga scala di silicio proprietario, NVIDIA ha presentato in dettaglio la sua interconnessione NVLink Fusion e l'architettura di memoria personalizzata NVHBM . Il portfolio unificato è progettato per collegare il silicio personalizzato con le piattaforme di rete scale-up e le piattaforme rack-scale MGX di NVIDIA.
Il primo ad aderire è Annapurna Labs di Amazon, i cui piani NVHBM sono emersi contestualmente all'espansione a 2 milioni di GPU della partnership con AWS ; questo annuncio fornisce l'architettura alla base di tale collaborazione e nomina Trainium4 come la prima generazione di Trainium con supporto NVLink Fusion. Anche NVIDIA sta definendo un'implementazione standard di NVHBM disponibile da diversi fornitori di memoria, il che, a suo dire, riduce lo sforzo ingegneristico necessario per integrare e qualificare la memoria tra i vari fornitori. "NVHBM rappresenta un nuovo approccio architetturale per migliorare le prestazioni e l'efficienza della memoria ad alta larghezza di banda", ha affermato Nafea Bshara, vicepresidente di Annapurna Labs presso Amazon. "Siamo fiduciosi che questa collaborazione tecnologica porterà benefici alle future progettazioni dell'infrastruttura AWS."
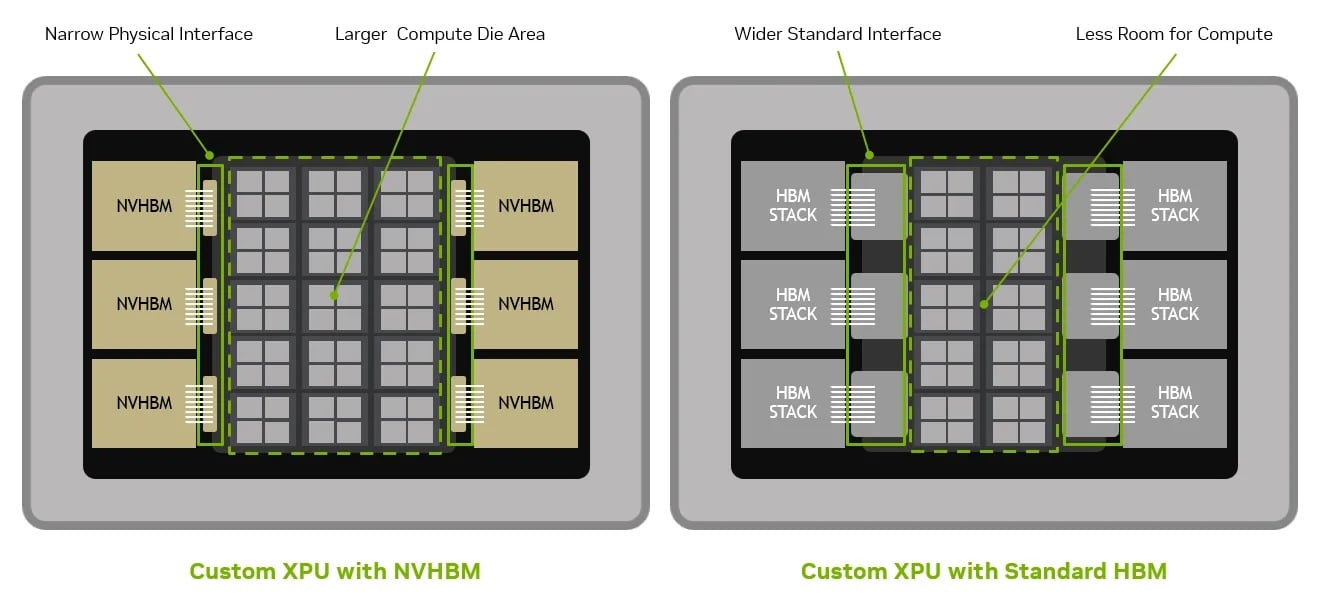
L'implementazione di XPU personalizzate in data center ad alta densità richiede un equilibrio tra logica di calcolo, distribuzione dell'alimentazione, gestione termica e memoria ad alta larghezza di banda. L'integrazione e la qualificazione di stack di memoria all'avanguardia spesso creano significativi colli di bottiglia in termini di packaging e sviluppo. Grazie a NVLink Fusion e NVHBM, i progettisti possono sfruttare die di base e IP di interfaccia pre-validati, riducendo la complessità dell'integrazione e accelerando il time-to-market.
Ottimizzazione della larghezza di banda e della latenza della memoria
I moderni carichi di lavoro di intelligenza artificiale, in particolare l'inferenza di modelli di grandi dimensioni e le pipeline agentiche, richiedono un'elevata velocità di trasmissione della memoria per la lettura dei pesi del modello, delle attivazioni e delle voci della cache chiave-valore (KV). NVHBM offre un die di base personalizzato sviluppato in collaborazione con i produttori di memorie, garantendo una larghezza di banda della memoria per stack fino al 30% superiore rispetto alla specifica standard JEDEC HBM4E.
| Caratteristica | Beneficio NVHBM |
| Larghezza di banda | Fino al 30% di larghezza di banda della memoria in più rispetto alla HBM4e standard. |
| Zona | Connessioni di interfaccia più efficienti consentono di ottenere fino al 25% in più di area del die di calcolo per funzionalità XPU aggiuntive. |
| Potenza | Un consumo energetico HBM inferiore fino al 15% rispetto allo standard HBM4e si traduce in risparmi su migliaia di XPU. |
Tabella 1. NVHBM offre tre principali vantaggi a livello di piattaforma per i programmi di accelerazione AI: maggiore larghezza di banda della memoria, maggiore area del package e del silicio e minore consumo energetico dell'HBM.
Questo incremento di larghezza di banda riduce al minimo i problemi di accesso alla memoria durante le fasi di esecuzione che richiedono un utilizzo intensivo della memoria. Accelerando i trasferimenti di dati tra gli stack HBM e la logica di calcolo integrata, gli acceleratori possono sostenere un utilizzo più elevato e migliorare i tassi di generazione di token per utente durante carichi di lavoro di inferenza intensivi.
Riallocazione dell'area del chip e ottimizzazione del PHY
Lo spazio disponibile sui chip di silicio dei moderni acceleratori è strettamente limitato, il che obbliga i progettisti a bilanciare lo spazio tra le ALU di calcolo, i motori di matrice, la SRAM on-chip e le interfacce periferiche. Le architetture HBM standard richiedono ampie interfacce fisiche che occupano una superficie considerevole del layout.
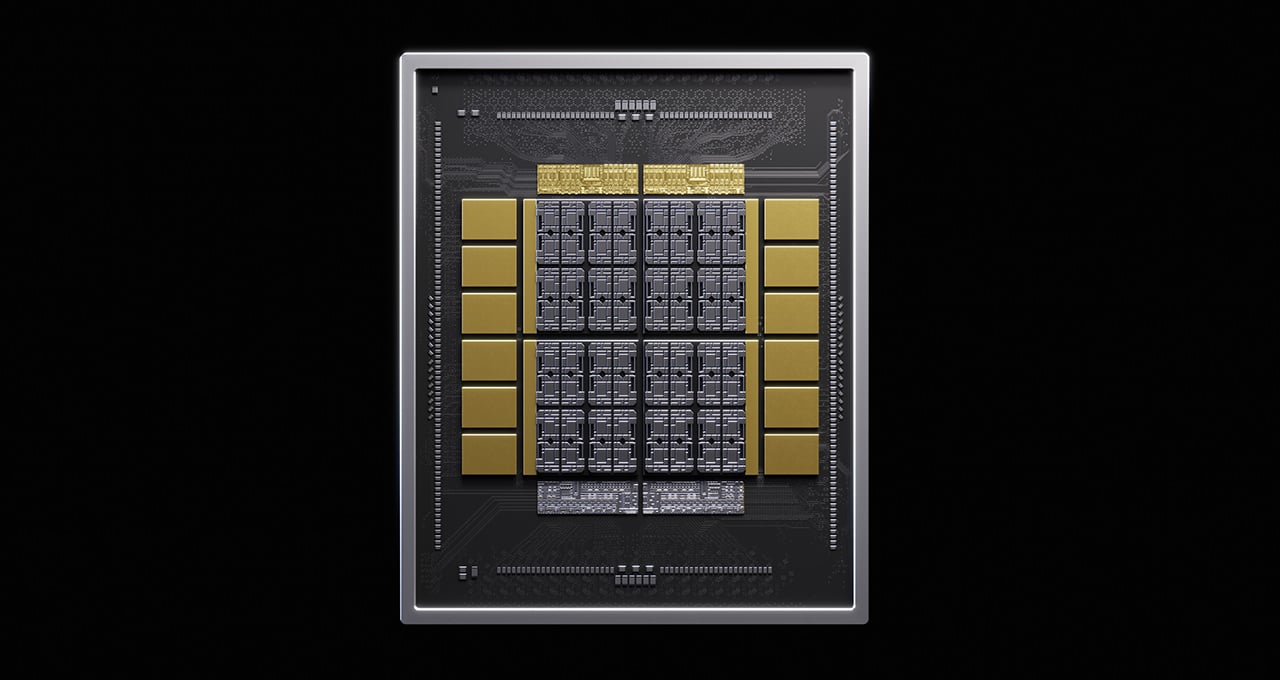
NVHBM risolve questo problema spostando il controller di memoria direttamente nello stack HBM 3D e utilizzando un livello fisico (PHY) personalizzato. Questo approccio consente una riduzione fino al 67% dell'area del PHY e del supporto periferico rispetto alle implementazioni HBM4E standard, semplificando al contempo il routing delle tracce dell'interposer per recuperare fino all'80% di silicio utilizzabile in più sull'intero layout. L'interfaccia di memoria più stretta libera spazio nel package, consentendo ai progettisti di espandere il die di calcolo AI centrale fino al 30% per aggiungere più core di matrice, unità vettoriali o gerarchie di cache all'interno di un involucro fisico fisso.
Efficienza energetica e margine di manovra a livello di impianto
La distribuzione dell'energia rimane uno dei vincoli più stringenti nelle operazioni dei data center hyperscale, con un impatto diretto sulla progettazione termica degli acceleratori e sui requisiti di raffreddamento. NVHBM riduce il consumo energetico di HBM del 15% rispetto allo standard HBM4E.
A livello di silicio, la riduzione del consumo energetico della memoria diminuisce la pressione termica, fornendo un margine elettrico aggiuntivo per alimentare i core di calcolo a frequenze sostenute più elevate. Su scala di infrastruttura, questi risparmi energetici si moltiplicano in modo significativo. In un ipotetico data center da 1 gigawatt con XPU da 2,000 watt, il profilo di consumo energetico ridotto della memoria può liberare capacità termica ed elettrica sufficiente a supportare fino a 15,000 XPU aggiuntive.
Integrazione su scala rack tramite NVLink Fusion
Mentre NVHBM ottimizza le prestazioni a livello di singolo pacchetto, NVLink Fusion funge da ponte a livello di sistema. Utilizzando chiplet NVLink Fusion dedicati, le XPU personalizzate possono connettersi direttamente alla struttura di scalabilità NVLink di sesta generazione , unendo tutti gli acceleratori all'interno di un rack in un unico dominio coerente di memoria e calcolo.
Questa infrastruttura di scalabilità è fondamentale per schemi di parallelizzazione avanzati come il parallelismo esperto (EP) e WideEP, in cui i modelli distribuiti a miscela di esperti richiedono la sincronizzazione a bassa latenza di attivazioni e stati nascosti su più dispositivi fisici. I processori personalizzati possono anche collegarsi alle CPU host tramite NVLink-C2C.
Integrando chip semi-personalizzati nell'ecosistema hardware e software NVIDIA, NVLink Fusion consente agli operatori di implementare ambienti eterogenei che combinano XPU personalizzate con GPU NVIDIA standard all'interno di un'architettura rack MGX standardizzata, semplificando le operazioni e il provisioning dei carichi di lavoro.


 Amazon