

Le infrastrutture di intelligenza artificiale sono notoriamente esigenti in termini di risorse e le aziende si confrontano costantemente con la sfida di ottimizzare l'utilizzo delle GPU. Dell Technologies, attraverso la sua piattaforma AI Factory, sta affrontando questa sfida integrando Run:ai , la soluzione di orchestrazione recentemente acquisita da NVIDIA . In un recente articolo sul blog di Dell , l'azienda ha evidenziato come Run:ai massimizzi l'utilizzo delle risorse e acceleri i risultati dell'IA, trasformando il modo in cui le aziende implementano e gestiscono le risorse GPU su larga scala.
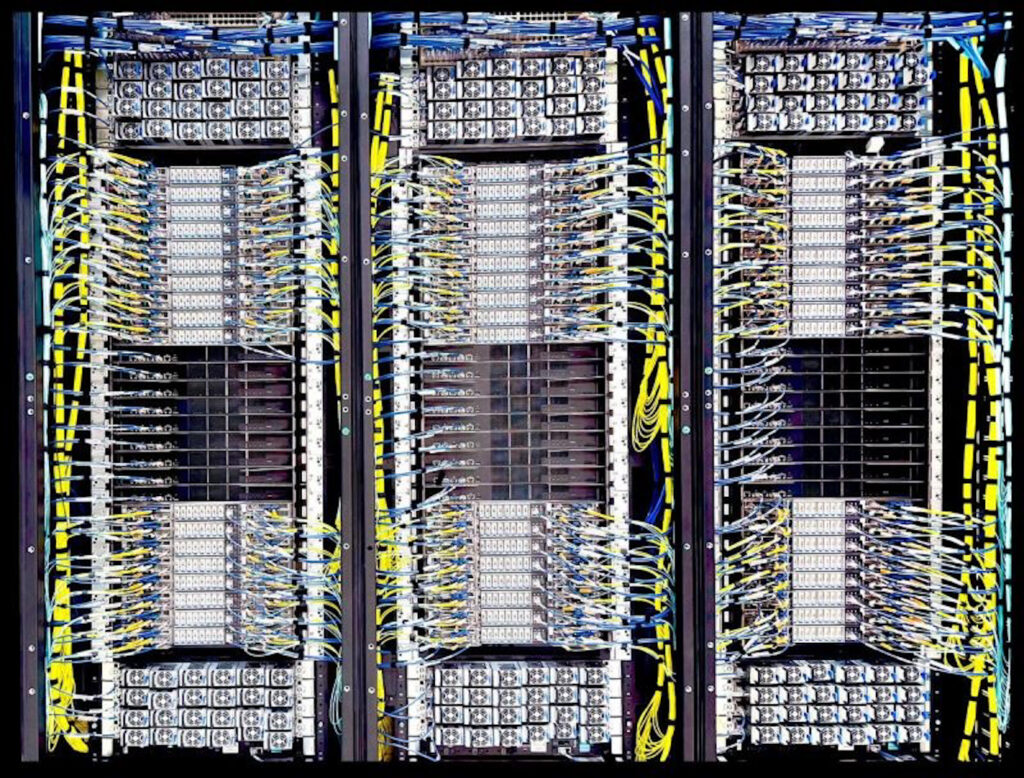
Cluster Dell NVL72
Cos'è esattamente Run:ai?
Run:ai è una piattaforma di orchestrazione basata su Kubernetes, progettata specificamente per carichi di lavoro incentrati sulla GPU. Fondata nel 2018, Run:ai ha guadagnato popolarità affrontando una sfida diffusa nel settore: l'uso inefficiente delle GPU. Tradizionalmente, le GPU assegnate ai carichi di lavoro di intelligenza artificiale spesso rimangono inutilizzate o sottoutilizzate. Run:ai risolve questo problema raggruppando dinamicamente e pianificando in modo intelligente le risorse GPU, consentendo l'allocazione frazionata delle GPU, distribuzioni multi-GPU efficienti e una gestione fluida in ambienti ibridi, cloud e on-premise.
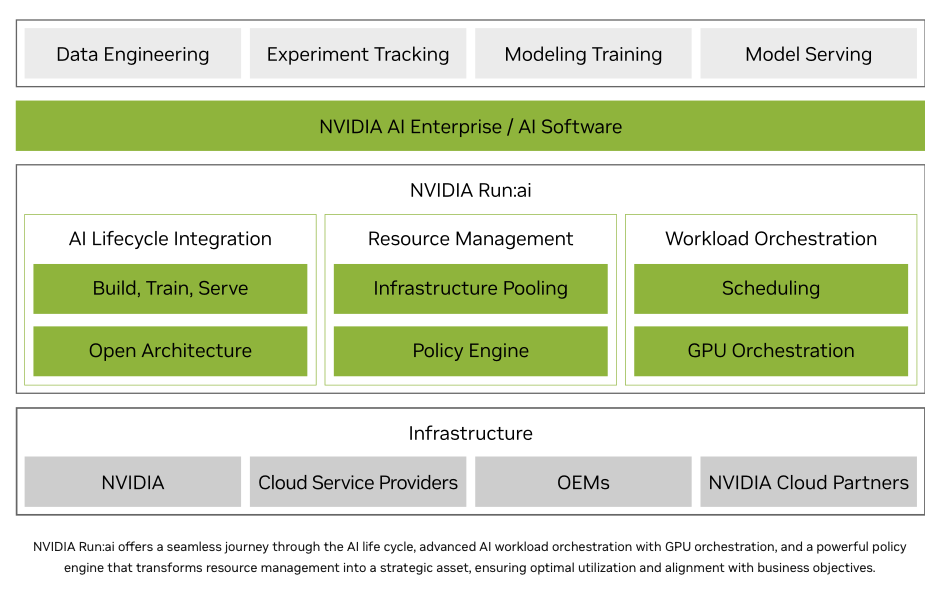
Riconoscendo il potenziale di Run:ai di rivoluzionare l'infrastruttura dell'IA, NVIDIA ha completato l'acquisizione dell'azienda nel dicembre 2024 per circa 700 milioni di dollari. È interessante notare che NVIDIA si è impegnata a rendere Run:ai open source in futuro, segnalando la sua intenzione di promuovere un'ampia adozione dell'ecosistema al di là delle sue piattaforme hardware. Si prevede che questa mossa accelererà ulteriormente l'innovazione e l'efficienza a livello di settore.
Per chi desidera una prospettiva tecnica più approfondita sulla gestione delle risorse, la documentazione di NVIDIA illustra in dettaglio come Run:ai sia essenziale per orchestrare i carichi di lavoro sui sistemi GB200 NVL72. Il documento evidenzia una lacuna critica: Kubernetes non riconosce nativamente l'architettura MNNVL di NVIDIA, il che rende più complessa la gestione e la pianificazione dei carichi di lavoro su questi domini ad alte prestazioni. Run:ai semplifica questa complessità rilevando automaticamente i domini NVLink e agevolando l'invio dei carichi di lavoro distribuiti. Ciò garantisce che i pod vengano posizionati correttamente sui nodi con interconnessioni NVLink, eliminando la necessità di una conoscenza approfondita dell'hardware o di una configurazione manuale per ogni job. Queste funzionalità dimostrano come la piattaforma ottimizzi le operazioni in ambienti di training ad alta densità, consentendo alle organizzazioni di sfruttare appieno la potenza di configurazioni hardware avanzate, come il GB200 NVL72.
Perché questo è importante per l'impresa
Per le organizzazioni che gestiscono carichi di lavoro ad alta intensità di GPU, in particolare quelli che coinvolgono l'intelligenza artificiale generativa e modelli linguistici complessi, il sottoutilizzo delle GPU rappresenta un rischio considerevole: uno spreco di investimenti. Run:ai affronta direttamente queste inefficienze e, secondo NVIDIA , le organizzazioni che utilizzano la piattaforma possono ottenere miglioramenti nell'utilizzo delle GPU fino a cinque volte superiori.
Questo livello di ottimizzazione non solo migliora il ROI, ma rimodella anche radicalmente l'efficienza operativa. I team precedentemente vincolati da risorse limitate e processi di pianificazione complessi ora dispongono degli strumenti per implementare più modelli contemporaneamente, scalare rapidamente e sperimentare in modo più aggressivo, il tutto senza ulteriori investimenti in hardware. Sebbene queste metodologie siano comuni nelle grandi implementazioni HPC, il livello di efficienza richiesto per massimizzare l'utilizzo della GPU è meno diffuso in ambito aziendale.
Ampio slancio del settore
Diversi importanti fornitori di infrastrutture stanno adottando la piattaforma, evidenziando un crescente slancio nel panorama IT aziendale.
Dell continua ad espandere il suo framework AI Factory, con le tecnologie NVIDIA al centro, tra cui Run:ai. L'utilizzo di Run:ai da parte di Dell dimostra come le aziende possano passare da un'allocazione manuale e frammentata delle risorse a una pianificazione più dinamica e automatizzata, che consente di ottenere una maggiore efficienza negli ambienti multi-tenant.
HPE offre Run:ai come parte del suo GreenLake Marketplace, integrandolo con la piattaforma Ezmeral per abilitare la pianificazione avanzata delle GPU, l'allocazione frazionaria e l'orchestrazione dell'infrastruttura ibrida. Ciò consente ai clienti di implementare e gestire carichi di lavoro di intelligenza artificiale con maggiore precisione e scalabilità.
Cisco integra Run:ai con i suoi server UCS serie X e la piattaforma di gestione cloud Intersight. La soluzione si distingue per la gestione delle quote, la condivisione frazionaria delle GPU e il monitoraggio in tempo reale, a supporto di implementazioni di intelligenza artificiale su larga scala in locale.
Abbiamo evidenziato solo alcuni dei partner di Run:ai. NVIDIA ha un ampio elenco di loghi, come mostrato sopra. In generale, i principali OEM e fornitori di piattaforme cloud si stanno allineando con Run:ai, nell'intento di offrire soluzioni infrastrutturali di intelligenza artificiale più innovative ed efficienti.



 Amazon