

Pliops ha annunciato una partnership strategica con vLLM Production Stack , un'implementazione di riferimento open-source a livello di cluster progettata per ottimizzare i carichi di lavoro di inferenza di modelli linguistici di grandi dimensioni (LLM). Questa partnership è fondamentale in vista della conferenza GTC 2025, che vedrà la comunità dell'IA riunirsi. Combinando l'avanzato backend di archiviazione chiave-valore (KV) di Pliops con la solida architettura di vLLM Production Stack, la collaborazione definisce un nuovo punto di riferimento per prestazioni, efficienza e scalabilità dell'IA.
Junchen Jiang, responsabile del laboratorio LMCache presso l'Università di Chicago, ha evidenziato il potenziale della collaborazione, sottolineandone la capacità di migliorare l'efficienza e le prestazioni dell'inferenza LLM. La soluzione congiunta offre funzionalità avanzate di ricerca e recupero di vettori introducendo un nuovo livello di memoria su scala petabyte al di sotto della memoria ad alta larghezza di banda (HBM). Le cache KV calcolate vengono conservate e recuperate in modo efficiente utilizzando un archivio intelligente disaggregato, accelerando l'inferenza vLLM.
Per un'introduzione a Pliope, consulta il nostro articolo di approfondimento.
A proposito di quel KVCache
La maggior parte dei modelli linguistici di grandi dimensioni utilizza architetture di trasformatori, che si basano su meccanismi di attenzione che coinvolgono matrici di query, chiave e valore. Quando si generano token in sequenza, i trasformatori calcolano ripetutamente l'attenzione, richiedendo il ricalcolo delle matrici chiave e valore (KV) precedenti, con conseguente aumento dei costi computazionali. La memorizzazione nella cache KV risolve questo problema memorizzando le matrici KV calcolate in precedenza, consentendo il riutilizzo nelle previsioni di token successive, migliorando significativamente l'efficienza di generazione e la produttività.
Tuttavia, ciò introduce nuove sfide. Le cache KV possono diventare piuttosto grandi, in particolare durante lunghe generazioni o inferenze batch con dimensioni batch tipiche di 32, superando alla fine la memoria disponibile. Per risolvere questa limitazione, diventa essenziale un backend di archiviazione cache KV.
Pliops XDP LightningAI
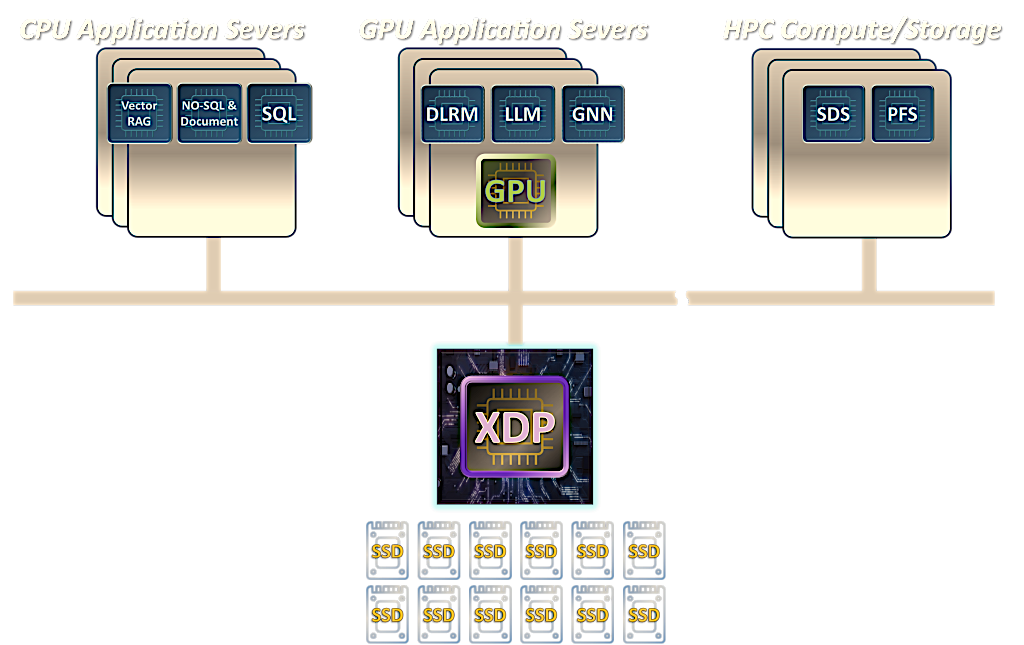
L'implementazione di XDP LightningAI di Pliops nei data center rappresenta un cambio di paradigma in termini di economicità, offrendo notevoli risparmi sui costi rispetto alle architetture tradizionali. Aggiungendo server XDP LightningAI dedicati insieme all'infrastruttura esistente, le organizzazioni possono ottenere notevoli risparmi, tra cui un'ottimizzazione del 67% nello spazio rack, una riduzione del 66% nel consumo energetico, un risparmio OpEx annuale del 58% e una riduzione del 69% nei costi di investimento iniziale.
Pliops continua a progredire con il suo Extreme Data Processor (XDP), l'ASIC XDP-PRO, completato da uno stack software AI completo e nodi distribuiti. Utilizzando un'interfaccia I/O Key-Value avviata da GPU, questa soluzione consente una scalabilità e prestazioni senza precedenti. XDP LightningAI di Pliops offre miglioramenti sostanziali delle prestazioni end-to-end, ottenendo guadagni fino a 8 volte superiori per l'inferenza vLLM, accelerando significativamente i carichi di lavoro di Generative AI (GenAI). Con l'integrazione di tendenze di settore all'avanguardia come DeepSeek, Pliops garantisce una solida adattabilità per i futuri sviluppi di AI.
Pliops ha presentato questi progressi ad AI DevWorld, evidenziando come XDP LightningAI rivoluziona le prestazioni LLM riducendo significativamente la potenza di calcolo e i costi. Questa dimostrazione ha illustrato l'impegno di Pliops nell'abilitare l'innovazione AI sostenibile su scala aziendale.
Collaborazione in corso
Pliops consente alle aziende di sfruttare al massimo il potenziale delle informazioni basate sull'intelligenza artificiale e di mantenere un vantaggio competitivo in un panorama tecnologico in rapida evoluzione, offrendo un accesso immediato a dati fruibili e garantendo un percorso di integrazione senza interruzioni.
La roadmap futura per la collaborazione include l'integrazione essenziale dello stack KV-IO di Pliops nello stack di produzione, progredendo verso funzionalità avanzate come la memorizzazione nella cache rapida su conversazioni multi-turn, l'offload scalabile della cache KV e strategie di routing semplificate.


 Amazon