

Qumulo ha annunciato Cloud AI Accelerator, una nuova architettura progettata per migliorare l'efficienza dell'infrastruttura AI aziendale eliminando i colli di bottiglia nel trasferimento dei dati. La piattaforma presenta set di dati distribuiti alle risorse GPU in tempo reale tra regioni, cloud e ambienti ibridi, senza richiedere replica o staging.
Il rilascio si basa su una ben documentata inefficienza nelle infrastrutture AI aziendali. Citando il report "State of Kubernetes Optimization Report 2026" di Cast AI, Qumulo evidenzia un utilizzo medio delle GPU aziendali di circa il 5%, con il restante 95% della potenza di calcolo accelerata inutilizzata perché i dati devono essere preparati, replicati e spostati nella posizione corretta prima che i carichi di lavoro possano iniziare. Il CEO di Qumulo, Doug Gourlay, ha inquadrato il problema nell'annuncio: "Ogni azienda con cui parliamo si concentra sulla disponibilità delle GPU, ma la disponibilità è solo metà del problema. Il problema più profondo è l'utilizzo, e il colpevole è la "gravità dei dati"."
Ripensare il posizionamento dei dati per i carichi di lavoro di intelligenza artificiale.
Gli approcci tradizionali all'infrastruttura di intelligenza artificiale prevedono la collocazione congiunta di storage e cluster GPU, spesso utilizzando sistemi flash ad alte prestazioni strettamente integrati con le risorse di calcolo. Sebbene efficace durante le fasi di training o inferenza, questo modello non gestisce i periodi di inattività dovuti alla preparazione dei dati. Inoltre, crea silos di storage frammentati, poiché le aziende replicano i set di dati in ambienti diversi per mantenerli vicini alle risorse di calcolo.
L'approccio di Qumulo modifica il modello disaccoppiando la posizione dei dati da quella di elaborazione. Invece di spostare i dati sulle GPU, Cloud AI Accelerator consente alle GPU di accedere ai dati direttamente sul posto. Ciò è possibile grazie a un'infrastruttura dati distribuita che fornisce un accesso coerente e in tempo reale ai set di dati, indipendentemente dalla loro posizione fisica.
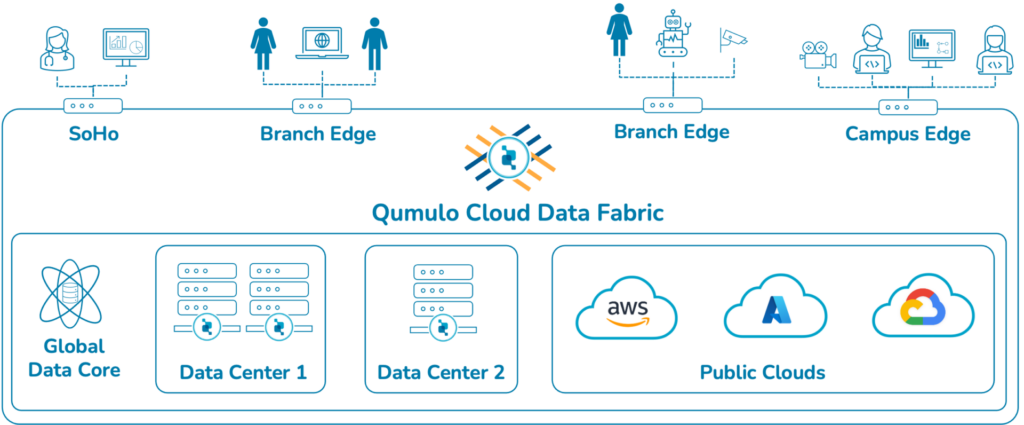
L'azienda definisce questa funzionalità come "fluidità GPU", che consente di pianificare i carichi di lavoro in base alla capacità di calcolo disponibile anziché ai vincoli di localizzazione dei dati. In pratica, ciò permette alle aziende di utilizzare le risorse GPU su più cloud o regioni senza dover pre-posizionare i dati.
Architettura: Data Fabric e livello di caching
Cloud AI Accelerator è un'integrazione di tre prodotti Qumulo precedentemente distribuiti separatamente. Cloud Native Qumulo (CNQ) è il file system di Qumulo che viene eseguito nativamente su AWS, Azure, Google Cloud e Oracle Cloud Infrastructure. Cloud Data Fabric (CDF), lanciato a febbraio 2025, fornisce un repository centrale di file e oggetti con cache coerenti all'edge. NeuralCache, aggiunto a CDF ad aprile 2025, applica l'apprendimento automatico alla cache predittiva di lettura e scrittura e, secondo Qumulo, riduce i tempi di caricamento dei dati GPU fino al 64%. Cloud AI Accelerator è stato presentato per la prima volta a novembre 2025; la versione del 26 maggio aggiunge la connettività diretta a Microsoft AI Foundry, AWS Bedrock e Google Vertex AI, formalizza il posizionamento di "liquidità GPU" e integra il prodotto con Cisco per implementazioni ibride.
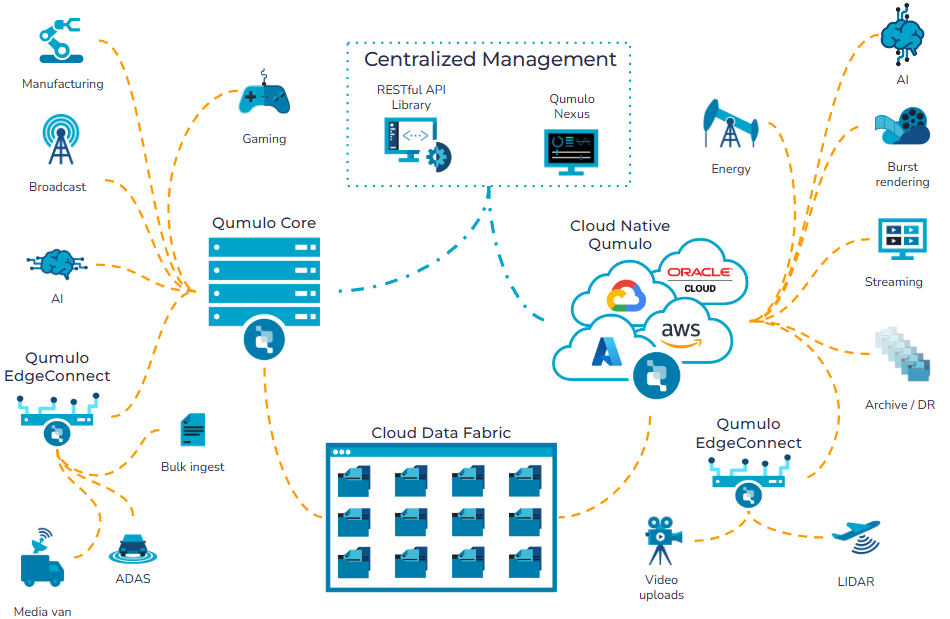
Il percorso dei dati si snoda a livello di blocco dai siti di origine (cluster on-premise, regioni cloud, repliche tra regioni o storage CNQ basato su S3) alla cache DRAM della CPU dell'acceleratore, quindi direttamente alle GPU. L'architettura mantiene un'unica fonte di verità in ambienti on-premise, edge e multi-cloud ed evita la replica in blocco, riducendo sia l'overhead di storage che la complessità della sincronizzazione.
Questa architettura supporta anche l'integrazione con servizi di intelligenza artificiale gestiti. Le aziende possono connettere i set di dati esistenti direttamente a piattaforme come Microsoft AI Foundry, AWS Bedrock e Google Vertex AI senza dover copiare i dati in tali ambienti.
Impatto operativo: riduzione dei tempi di inattività e della complessità.
Il principale vantaggio operativo è l'eliminazione dei ritardi dovuti alla preparazione dei dati. In molti flussi di lavoro di intelligenza artificiale, la preparazione dei dati può richiedere giorni o settimane, ritardando l'addestramento del modello e riducendo l'utilizzo effettivo della GPU. Consentendo l'accesso immediato ai set di dati, Cloud AI Accelerator permette di avviare i carichi di lavoro non appena la potenza di calcolo è disponibile.
Ciò riduce anche la necessità di gestire più ambienti di archiviazione. Invece di creare silos di dati separati per ogni cluster GPU o regione cloud, le organizzazioni possono operare da un unico set di dati logico. Questo semplifica la gestione dei dati e riduce la proliferazione dell'infrastruttura.
Dal punto di vista dei costi, il modello si concentra sulla spesa per GPU inattive. Eliminando la necessità di precaricare i dati nella memoria di archiviazione collegata alla GPU, le aziende possono ridurre il tempo in cui le GPU attendono i dati, migliorando il ritorno sull'investimento complessivo per il calcolo accelerato.
Integrazione Cisco per infrastrutture di intelligenza artificiale ibride
Cisco è il partner commerciale congiunto per la soluzione di implementazione ibrida, con Cisco UCS che fornisce l'infrastruttura di calcolo on-premise e Cisco che si occupa della rete e della sicurezza a supporto dell'infrastruttura dati. Insieme, Qumulo e Cisco presentano l'offerta come un'infrastruttura in grado di adattarsi in pochi minuti alla disponibilità variabile delle GPU, caratteristica che, a loro dire, rende la flessibilità delle GPU praticabile su scala aziendale.
Questa combinazione è fondamentale in entrambe le direzioni. Offre a Qumulo un percorso validato per l'integrazione negli ambienti Cisco UCS e fornisce a Cisco una soluzione di storage per i clienti di IA ibrida che desiderano che i dati rimangano on-premise mentre la potenza di calcolo si estende su hyperscaler. L'elemento portante è la rete ad alta velocità e bassa latenza, poiché l'accesso ai dati in loco dipende da un trasporto dati coerente tra i siti.
Modello di disponibilità e implementazione
Qumulo Cloud AI Accelerator è ora disponibile su AWS, Microsoft Azure, Google Cloud e Oracle Cloud Infrastructure, con supporto per implementazioni ibride in ambienti Cisco UCS. Qumulo e Cisco saranno presenti al Cisco Live 2026 di Las Vegas, presso lo stand n. 4018, dal 31 maggio al 4 giugno, dove verrà presentata l'offerta congiunta.
Questa release riflette un cambiamento più ampio nella progettazione delle infrastrutture di intelligenza artificiale, che si orientano verso architetture incentrate sui dati. Poiché la capacità di calcolo accelerato continua a superare la capacità dell'infrastruttura che la alimenta, il miglioramento dell'utilizzo dipenderà dalla riduzione del tempo che le GPU trascorrono in attesa dei dati. La scommessa di Qumulo è che rendere il dataset universalmente accessibile, piuttosto che mobile, sia l'approccio più duraturo rispetto all'aggiunta di ulteriore memoria flash a ogni cluster di GPU.


 Amazon