

Alla SC25, WEKA ha presentato la nuova generazione dei suoi dispositivi WEKApod, pensati per le aziende che necessitano di scalare l'intelligenza artificiale e l'elaborazione ad alte prestazioni, mantenendo al contempo un controllo rigoroso su costi, consumi e ingombro. Le nuove piattaforme WEKApod Prime e WEKApod Nitro sono progettate per affrontare una crescente crisi di efficienza infrastrutturale, in cui gli investimenti in GPU spesso superano i sistemi di storage e networking necessari per mantenerli pienamente utilizzati.
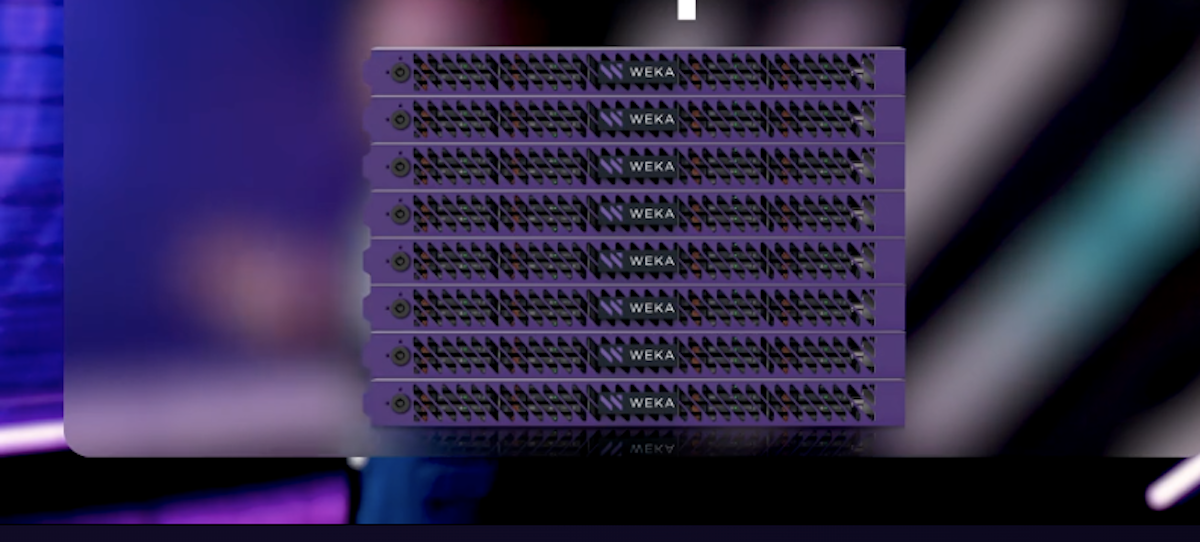
L'obiettivo di progettazione per questa generazione è chiaro: eliminare il tradizionale compromesso tra prestazioni e costi, aumentando al contempo densità ed efficienza, in modo che ogni unità rack e ogni kilowatt fornisca una maggiore capacità di intelligenza artificiale utilizzabile.
La crisi dell'efficienza delle infrastrutture
Le aziende e i provider di servizi cloud per l'intelligenza artificiale sono sotto pressione per dimostrare il ritorno sugli investimenti in infrastrutture di intelligenza artificiale in rapida crescita. Le GPU costose spesso rimangono sottoutilizzate a causa di colli di bottiglia nello storage, i cicli di training prolungati allungano il time-to-value, i costi di inferenza erodono i margini e la spesa per il cloud aumenta con l'aumento dei volumi di dati non strutturati.
Allo stesso tempo, i data center si trovano ad affrontare limiti rigorosi in termini di spazio rack, alimentazione e capacità di raffreddamento. Aggiungere semplicemente altro hardware non è una strategia sostenibile. I sistemi di storage che richiedono una scelta tra prestazioni estreme e costi gestibili non sono più in linea con i costi delle implementazioni di intelligenza artificiale su larga scala. Ogni nodo in una fabbrica di intelligenza artificiale deve contribuire a un maggiore utilizzo della GPU e a una riduzione dei costi per modello addestrato e gestito.
La famiglia WEKApod di nuova generazione è progettata per affrontare direttamente questo problema, combinando hardware denso ed efficiente dal punto di vista energetico con lo stack software NeuralMesh di WEKA per mantenere le GPU impegnate e i costi dell'infrastruttura sotto controllo.
WEKApod Prime: economia mista senza penalizzazioni sulle prestazioni
WEKApod Prime si posiziona come il principale strumento di lavoro per le organizzazioni che desiderano migliorare l'economia dello storage senza sacrificare le prestazioni. Offre un miglioramento del 65% nel rapporto prezzo/prestazioni, posizionando in modo intelligente i dati su un mix di supporti flash e ottimizzando le scritture in base alle caratteristiche del carico di lavoro.
Prime utilizza la tecnologia AlloyFlash di WEKA per combinare più classi di unità in un'unica configurazione. Invece di creare una tradizionale gerarchia di cache multilivello con spostamento esplicito dei dati e le consuete penalità di scrittura, AlloyFlash offre prestazioni costanti in tutte le operazioni. Le scritture sono progettate per sostenere le massime prestazioni anziché essere limitate sotto carico, il che è fondamentale per i checkpoint di training, la registrazione e altri flussi di lavoro di intelligenza artificiale ad alta intensità di scrittura.
Dal punto di vista della progettazione fisica, WEKApod Prime supporta fino a 20 unità in un server 1U o 40 unità in un fattore di forma 2U. Ciò consente un'elevata capacità e densità di prestazioni in spazi limitati. WEKA registra una densità di capacità 4.6 volte superiore rispetto alla generazione precedente, insieme a IOPS di scrittura per unità rack 5 volte superiori. Anche l'efficienza energetica è un aspetto fondamentale, offrendo una densità di potenza 4 volte superiore, pari a circa 23,000 IOPS per kW e circa 1.6 PB per kW, con una riduzione del 68% del consumo energetico per terabyte.
Per gli operatori che progettano cluster di intelligenza artificiale moderni, questo si traduce in un livello di storage in grado di tenere il passo con la produttività della GPU, pur rientrando nei limiti di potenza e spazio disponibili. Per attività ad alta intensità di scrittura come l'addestramento di modelli, il checkpointing e la pre-elaborazione dei dati, è meno probabile che il sistema di storage diventi un limite, lasciando gli acceleratori inattivi.
I primi ad adottare questa soluzione, come il Danish Centre for AI Innovation (DCAI), stanno utilizzando WEKApod Prime per raggiungere quella che descrivono come una produttività e un'efficienza di livello hyperscaler in un ingombro ridotto. DCAI sottolinea la possibilità di aumentare la capacità di intelligenza artificiale per kilowatt e per metro quadrato, contribuendo direttamente alla redditività economica della propria infrastruttura e a una più rapida implementazione dell'intelligenza artificiale per i clienti.
WEKApod Nitro: densità di prestazioni per fabbriche di intelligenza artificiale
Mentre Prime si concentra sul rapporto prezzo-prestazioni e sull'efficienza di capacità, WEKApod Nitro è progettato per le aziende che si occupano di intelligenza artificiale e che utilizzano centinaia o migliaia di GPU, le quali necessitano della massima densità di prestazioni. Nitro si basa su hardware aggiornato che offre prestazioni circa doppie e un rapporto prezzo-prestazioni migliore del 60% rispetto alla generazione precedente.
Le configurazioni Nitro includono NVIDIA ConnectX-8 SuperNIC, che fornisce 800 Gb/s di throughput di rete in un formato 1U con 20 SSD TLC. Questo design ad alta larghezza di banda è pensato per ambienti in cui la rete e lo storage devono soddisfare le caratteristiche di scalabilità dei cluster GPU per evitare colli di bottiglia durante l'addestramento su larga scala e l'inferenza ad alta velocità.
Sia Prime che Nitro sono disponibili come appliance chiavi in mano certificate NVIDIA DGX SuperPOD e NVIDIA Cloud Partner (NCP). Per i team di vendita tecnica e gli architetti di soluzioni, questo è significativo perché può ridurre i tempi di implementazione. Invece di dedicare settimane all'integrazione, all'ottimizzazione e alla convalida, i clienti possono utilizzare WEKApod come componente pre-validato in architetture basate su DGX e allineate a NCP, riducendo i tempi di produzione e accelerando il time-to-revenue per i nuovi servizi di intelligenza artificiale.
NVIDIA posiziona le sue reti Spectrum-X Ethernet e ConnectX-8 come fondamento fondamentale dell'architettura WEKApod. Dal punto di vista della progettazione del sistema, questo rafforza l'enfasi sulla rimozione dei colli di bottiglia tra storage, fabric e nodi GPU per ottimizzare le prestazioni complessive dell'intelligenza artificiale.
NeuralMesh e flessibilità definita dal software
Per quanto riguarda le piattaforme hardware, WEKApod è basato su NeuralMesh, che WEKA descrive come il primo sistema di storage progettato appositamente per accelerare l'intelligenza artificiale su larga scala. NeuralMesh è responsabile della fornitura del livello di storage definito dal software, insieme alle funzionalità aziendali previste negli ambienti moderni.
Le appliance WEKApod espongono le funzionalità di NeuralMesh attraverso configurazioni pre-validate e pronte all'uso, e un'utilità di configurazione avanzata, progettate per offrire un'esperienza plug-and-play anziché un complesso progetto di integrazione. Le organizzazioni possono iniziare con un minimo di otto server e aumentare fino a centinaia con l'aumentare della domanda, senza dover riprogettare l'ambiente di storage.
NeuralMesh include funzionalità aziendali fondamentali come protezione distribuita dei dati, snapshot istantanei, accesso multiprotocollo, tiering automatizzato, crittografia e supporto per cloud ibrido. Ciò significa che prestazioni e densità ottimizzate per l'intelligenza artificiale non vanno a scapito della resilienza dei dati, della governance o della flessibilità operativa.
Combinando queste capacità software con hardware ad alta densità, WEKApod mira a fungere non solo da archivio di file o oggetti ad alte prestazioni, ma anche da piattaforma dati fondamentale per fabbriche di intelligenza artificiale e distribuzioni di storage di oggetti su larga scala e data lake di intelligenza artificiale.
Affrontare i risultati aziendali per diversi segmenti di clientela
L'impatto aziendale della famiglia WEKApod di nuova generazione è strutturato in modo diverso per ciascun pubblico di destinazione, ma si concentra su un migliore ROI dell'infrastruttura e su un maggiore utilizzo degli investimenti esistenti.
Per i provider di cloud AI e i neocloud emergenti, il miglioramento del 65% nel rapporto prezzo/prestazioni si tradurrà direttamente in margini più elevati sulle offerte GPU-as-a-service. La possibilità di supportare più clienti sulla stessa infrastruttura mantenendo gli SLA sulle prestazioni migliora la redditività e la pianificazione della capacità. La natura "chiavi in mano" delle implementazioni WEKApod riduce inoltre i tempi di onboarding per i nuovi clienti, consentendo un time-to-revenue più rapido.
Per le aziende che implementano fabbriche di intelligenza artificiale interne, WEKApod si propone come una soluzione per comprimere i cicli di distribuzione da mesi a giorni. Integrazione chiavi in mano, pre-validazione e funzionalità aziendali consentono ai team IT di supportare lo storage per carichi di lavoro di intelligenza artificiale senza dover disporre di competenze approfondite e specializzate in file system paralleli o ottimizzazione delle prestazioni. Allo stesso tempo, densità ed efficienza migliorate possono ridurre il consumo energetico per terabyte fino al 68% ed evitare un ridimensionamento uno a uno dell'ingombro del data center con la crescita delle capacità di intelligenza artificiale.
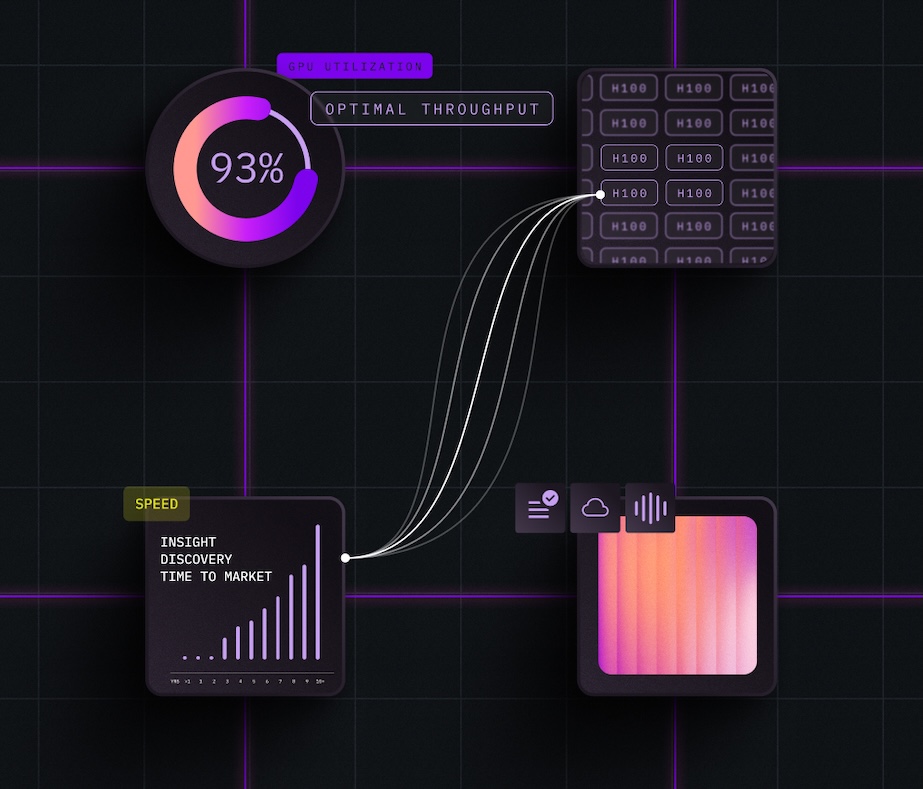
Per sviluppatori e ricercatori di intelligenza artificiale, la proposta di valore chiave è un maggiore utilizzo della GPU e cicli di addestramento più brevi. Il design di WEKApod mira a supportare tassi di utilizzo della GPU superiori al 90%, garantendo che il livello di storage e la struttura non costituiscano colli di bottiglia. Un addestramento più rapido dei modelli e tempi di iterazione ridotti offrono un vantaggio competitivo in ambienti in cui la velocità di sperimentazione determina i risultati aziendali. Costi di inferenza inferiori, supportati da storage e networking efficienti, possono anche rendere economicamente sostenibili nuove applicazioni di intelligenza artificiale che altrimenti potrebbero essere proibitive su larga scala.
Ajay Singh, Chief Product Officer di WEKA, definisce questi aggiornamenti come fondamentali per far sì che gli investimenti in intelligenza artificiale siano redditizi. A suo avviso, WEKApod Prime offre un rapporto prezzo/prestazioni significativamente migliore senza sacrificare la produttività, mentre WEKApod Nitro aumenta la densità delle prestazioni per un utilizzo migliore delle GPU. Nel complesso, questo supporta uno sviluppo più rapido dei modelli, una maggiore produttività inferenziale e un ROI migliorato sull'infrastruttura di elaborazione.
I nuovi dispositivi WEKApod Prime e Nitro posizionano saldamente WEKA nel mercato dello storage AI e HPC, puntando all'intersezione tra elevate prestazioni, densità ed efficienza. Prime si concentra sulla rottura del tradizionale legame tra prestazioni e costi utilizzando la gestione intelligente mixed-flash e AlloyFlash. Allo stesso tempo, Nitro si rivolge alle fabbriche AI ricche di GPU con networking ad alte prestazioni e fattori di forma compatti.
Insieme alla suite software NeuralMesh e alle configurazioni pronte all'uso certificate NVIDIA, WEKApod mira a risolvere sfide sia tecniche che aziendali: mantenere impegnate le GPU, gestire l'alimentazione e lo spazio del data center e ridurre i tempi necessari per fornire al mercato servizi basati sull'intelligenza artificiale. Per i team di vendita tecnica e gli architetti di soluzioni, la proposta di valore si concentra su un maggiore utilizzo, margini migliori e un'implementazione più rapida, supportata da guadagni misurabili in termini di densità, efficienza e rapporto prezzo/prestazioni.


 Amazon