

Alcuni server estendono ciò che già esiste, mentre altri ridefiniscono le aspettative. Il Dell PowerEdge R7725xd appartiene alla seconda categoria. Nei nostri recenti test, configurato con 24 SSD Micron 9550 PRO PCIe Gen5 NVMe e quattro NIC 2x 200GbE, questo server 2U ha raggiunto un throughput di storage raw superiore a qualsiasi sistema misurato in precedenza. Internamente, la piattaforma ha sostenuto oltre 300 GB/s nel pool NVMe. In rete, ha raggiunto 160 GB/s utilizzando RDMA standard, senza complessità aggiuntiva.
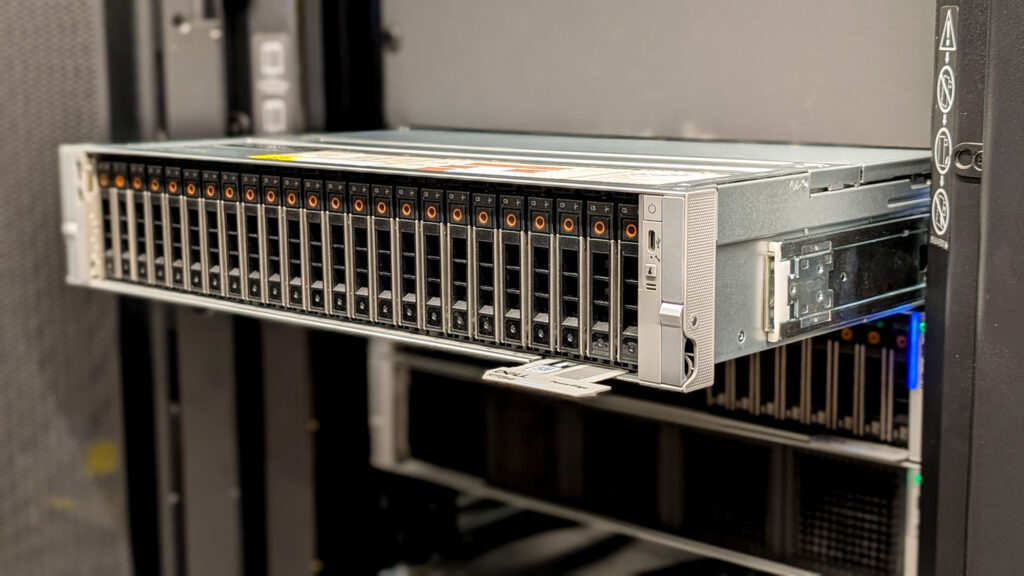
Non si tratta solo di un server di archiviazione più veloce. È un sistema che cambia il modo in cui viene architettato il computing ad alta intensità di dati. Le moderne pipeline di addestramento e inferenza dell'IA sono spesso limitate non dalla potenza della GPU, ma dalla velocità con cui i dati possono essere organizzati, trasmessi in streaming, mescolati e sottoposti a checkpoint. I nodi GPU di grandi dimensioni rimarranno inattivi se lo storage non riesce a tenere il passo. I team affrontano queste limitazioni utilizzando cache, sovradimensionamento e livelli complessi per garantire che gli acceleratori ricevano i dati con una velocità sufficiente a giustificarne i costi.
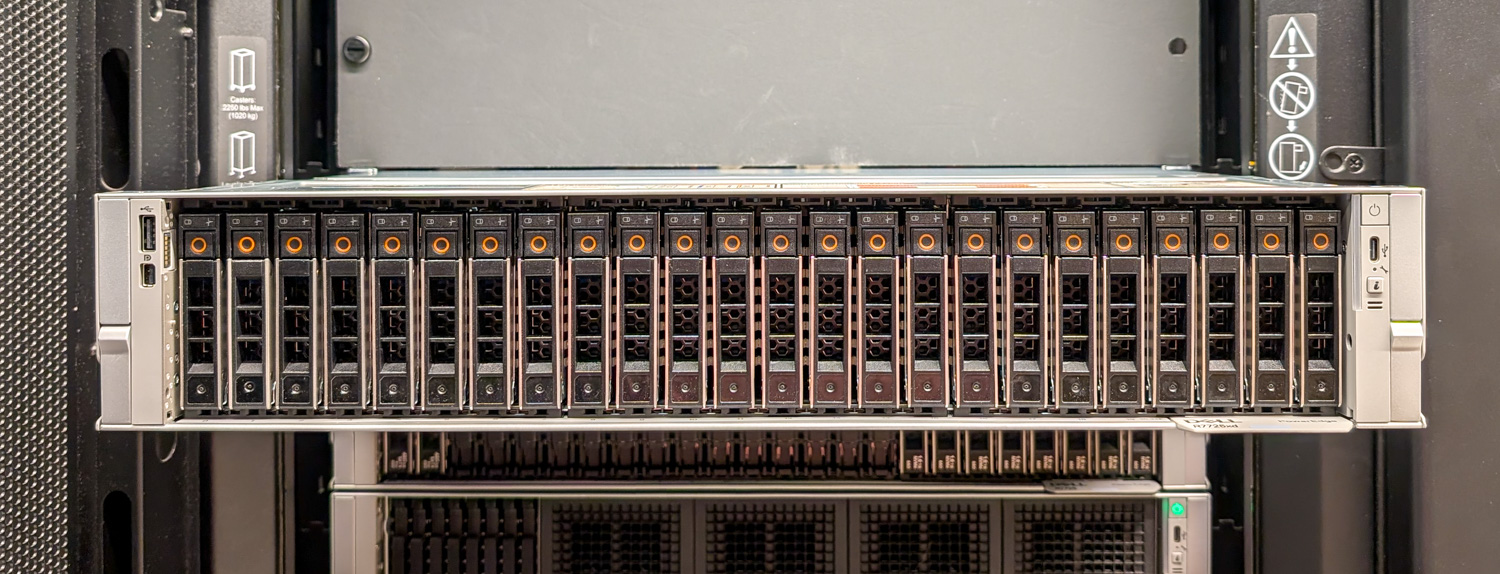
Il Dell PowerEdge R7725xd risolve il collo di bottiglia alla fonte. Il server è costruito attorno a un backplane U.2 a 24 alloggiamenti, con ogni unità che riceve un collegamento PCIe Gen5 x4 dedicato direttamente al complesso CPU AMD EPYC. Non è presente alcun fan-out di larghezza di banda e non viene utilizzato alcun espansore midplane per ridurre la concorrenza. Le prestazioni scalano in modo pulito perché l'hardware è progettato per aggregare il throughput senza conflitti. In una configurazione tradizionale a 2 socket, le CPU sono collegate da 4 collegamenti XGMI per la comunicazione tra socket. Nel modello R7725xd, uno di questi collegamenti è stato riadattato per ulteriori 16 corsie PCIe Gen5 per CPU, dando al server un totale di 160 corsie PCIe Gen5 (96 per gli SSD anteriori e 64 per i quattro slot PCIe posteriori). Se abbinato agli SSD 9550 PRO di Micron, progettati per carichi di lavoro di scrittura sostenuti e alta resistenza, il sistema diventa un motore dati ad alta capacità in grado di supportare carichi di lavoro di streaming continuo e con checkpoint intensivi.
Abbiamo integrato PEAK:AIO in questa architettura per sfruttare i percorsi di invio paralleli e mantenere l'efficienza all'aumentare della concorrenza. Il risultato non è stato solo un picco di prestazioni, ma anche prestazioni costanti sotto carico. La piattaforma può funzionare come nodo di esecuzione locale per la preelaborazione, l'addestramento o la trasformazione, oppure può fornire storage ad alta larghezza di banda su più sistemi GPU in rete. Se vi sentite avventurosi, potete fare entrambe le cose contemporaneamente.
Punti chiave
- Throughput senza precedenti in un singolo nodo: L'R7725xd ha sostenuto oltre 300 GB/s di larghezza di banda interna e 160 GB/s su NVMe-oF RDMA, rivaleggiando con i cluster di archiviazione multi-nodo all'interno di uno chassis 2U.
- Architettura Gen5 reale, senza switch, senza fan-out: Tutti i 24 SSD Micron 9550 PRO ricevono corsie PCIe Gen5 x4 dedicate direttamente dal complesso CPU, consentendo il ridimensionamento della velocità di linea senza conflitti.
- Basato sulla serie AMD EPYC 9005: I processori duali AMD EPYC 9575F forniscono il numero di corsie, la larghezza di banda della memoria e la topologia NUMA necessari per un I/O ad alta concorrenza sostenuto.
- Progettato per carichi di lavoro ad alta intensità di intelligenza artificiale, analisi e checkpoint: Il sistema elimina i colli di bottiglia I/O che bloccano le moderne pipeline GPU, consentendo la distribuzione continua dei dati a banda larga.
- PEAK:AIO sblocca il parallelismo completo: Lo stack software di PEAK:AIO mantiene le strutture delle code sature sotto carico, garantendo prestazioni aziendali a un rapporto dollaro per GB interessante.
Progettato appositamente per la velocità di trasmissione NVMe
Nell'ultima generazione di server, Dell ha abbandonato l'utilizzo di switch PCIe nelle configurazioni server ad alta densità di storage. Modelli come PowerEdge R770 o R7725 offrono 4 alloggiamenti PCIe Gen5, supportando fino a 16 configurazioni SSD, e passano a 2 alloggiamenti in configurazioni backplane di storage più ampie. I server di precedente generazione, come PowerEdge R760, includevano uno switch PCIe nelle configurazioni NVMe a 24 alloggiamenti. Per semplificare le build ed eliminare la complessità introdotta da uno switch PCIe, i nuovi server hanno adottato una strategia volta a ridurre il numero di linee PCIe nelle build ad alta densità di storage. Questo fino all'R7725xd.
La differenza tra l'R7725 standard e l'R7725xd risiede nel modo in cui le piattaforme allocano le risorse PCIe root-complex. L'R7725 base distribuisce le linee PCIe tra storage, espansione GPU e I/O generico. La variante "xd" rialloca tale budget in modo che il sottosistema NVMe diventi il principale consumatore di larghezza di banda PCIe. I 24 alloggiamenti U.2 sono cablati direttamente nelle root PCIe Gen5 della CPU, con ogni SSD che riceve il proprio endpoint x4, non un uplink condiviso esposto tramite uno switch PCIe o un albero di re-timer. Ciò fornisce a ogni unità strutture di coda indipendenti e percorsi DMA indipendenti per il ritorno al controller di memoria.
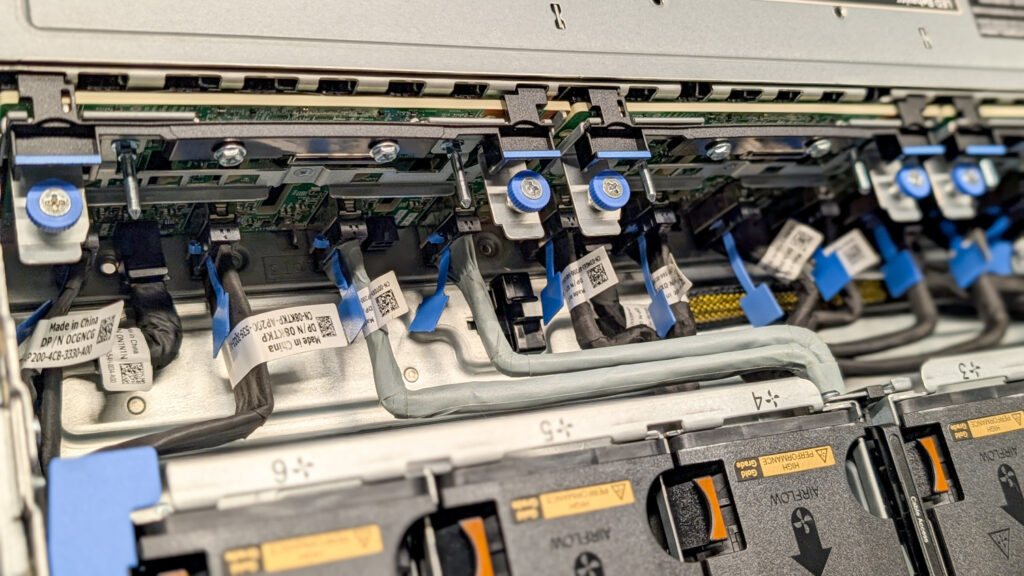
La topologia del backplane e del riser riflette questo impegno. Dell raggruppa i connettori NVMe e gli slot PCIe su entrambi i socket AMD EPYC, in modo che ogni processore abbia la proprietà diretta di una porzione del set di unità. In pratica, questo crea due domini NVMe simmetrici, ciascuno con caratteristiche di latenza locale e piena simultaneità di lettura/scrittura. Quando abbiamo installato quattro schede di rete Broadcom a doppia porta 200 GbE come schede aggiuntive, il posizionamento degli slot ha consentito a ciascuna scheda di rete di essere inserita in un dominio PCIe allineato al gruppo NVMe corrispondente. Con NVMe su RDMA, ciò significava che il traffico di rete rimaneva locale al socket che gestiva l'I/O dell'unità associata, evitando il salto Infinity Fabric tra socket che in genere aggiunge latenza e consuma larghezza di banda sotto carico.
Il comportamento termico supporta anche un throughput sostenuto. La tecnologia U.2 rimane vantaggiosa nelle configurazioni Gen5 ad alta densità perché fornisce un canale di flusso d'aria definito e una superficie di dissipazione del calore prevedibile per ciascun dispositivo. I moduli ventola ad alta pressione statica e i condotti dello chassis dell'R7725xd mantengono un flusso d'aria costante su tutti i 24 alloggiamenti, consentendo l'esecuzione continua di carichi di lavoro di scrittura a pieno disco senza limitazioni. Il design meccanico integra quello elettrico: ogni unità può mantenere le prestazioni a piena velocità perché la piattaforma è progettata per raffreddare 24 dispositivi Gen5 contemporaneamente sotto carico.
Questa combinazione di allineamento root-complex, layout coerente delle corsie NUMA (Non-Uniform Memory Access), posizionamento delle NIC basato sul socket e packaging U.2 termicamente stabile consente al sistema di raggiungere I/O a velocità di linea su larga scala. L'architettura evita colli di bottiglia e ottimizza le prestazioni.
Panoramica di Dell PowerEdge R7725xd iDRAC 10
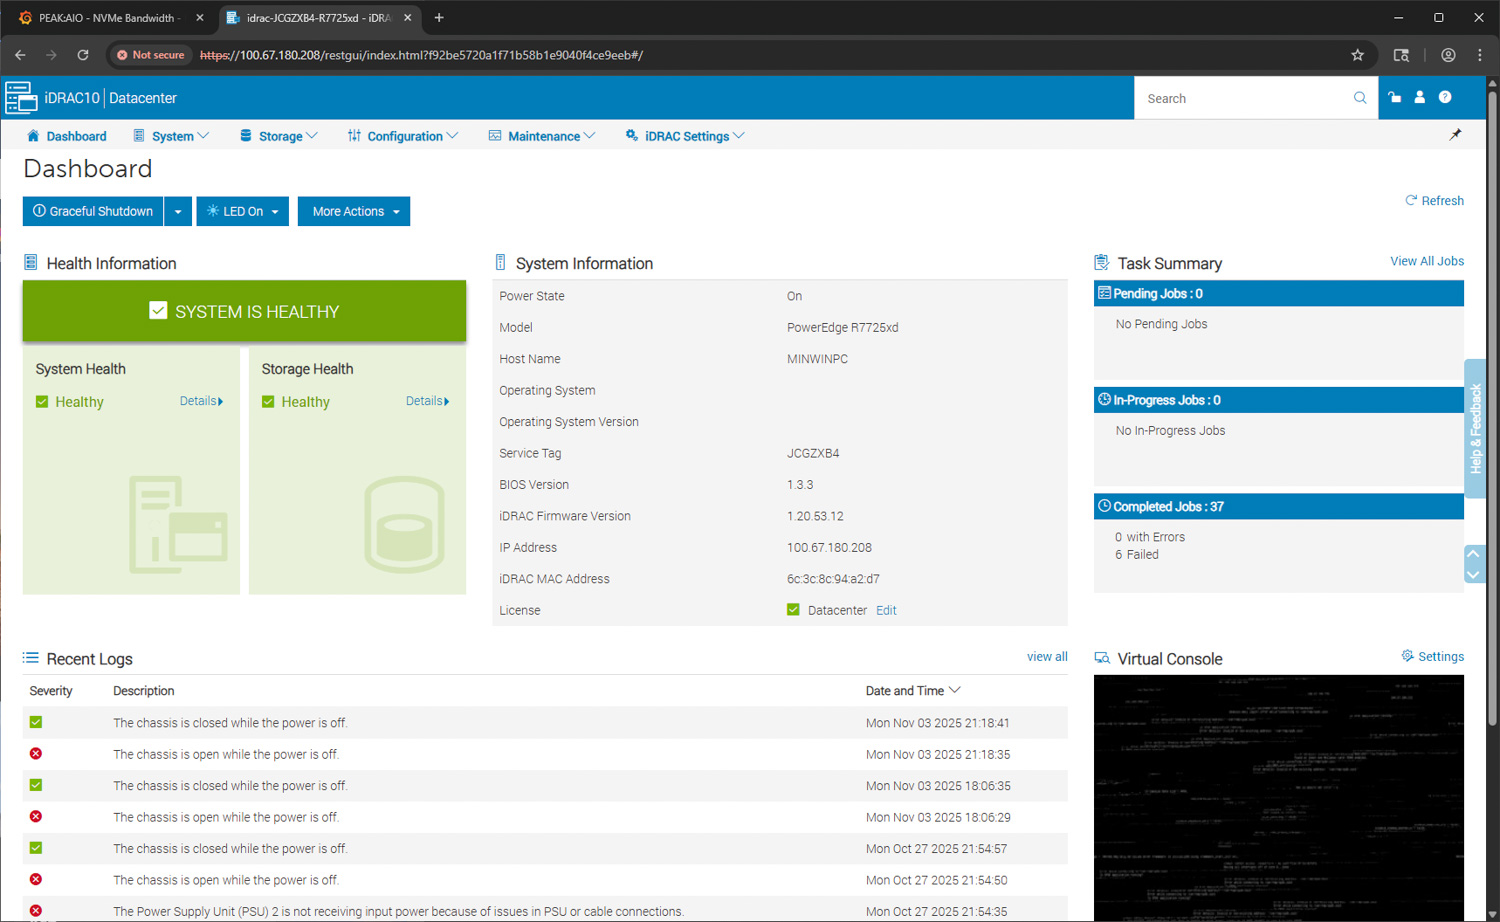
Questa generazione di R7725xd, come molte altre piattaforme di 17a generazione da noi valutate, è dotata della nuova piattaforma iDRAC 10 di Dell, che funge da punto centrale per la gestione remota, il monitoraggio dello stato e il controllo fuori banda. La dashboard fornisce un riepilogo immediato dello stato generale del sistema, dello stato dello storage e delle attività recenti. Per la nostra unità di test, il report sullo stato del sistema e dello storage è verde, a conferma del normale funzionamento del server. I dettagli chiave del sistema, come modello, nome host, versione del BIOS, livello del firmware iDRAC, indirizzo IP e informazioni sulla licenza, sono visualizzati sul lato destro dell'interfaccia.
La dashboard include anche un pannello di riepilogo delle attività che mostra le operazioni completate, in sospeso e in corso. Al di sotto, un elenco dei log recenti registra gli eventi di intrusione nello chassis e i messaggi di alimentazione, fornendo una rapida panoramica delle modifiche allo stato dell'hardware senza dover accedere a menu più complessi. Il pannello della console virtuale è disponibile nell'angolo in basso a destra per il controllo remoto completo del KVM.
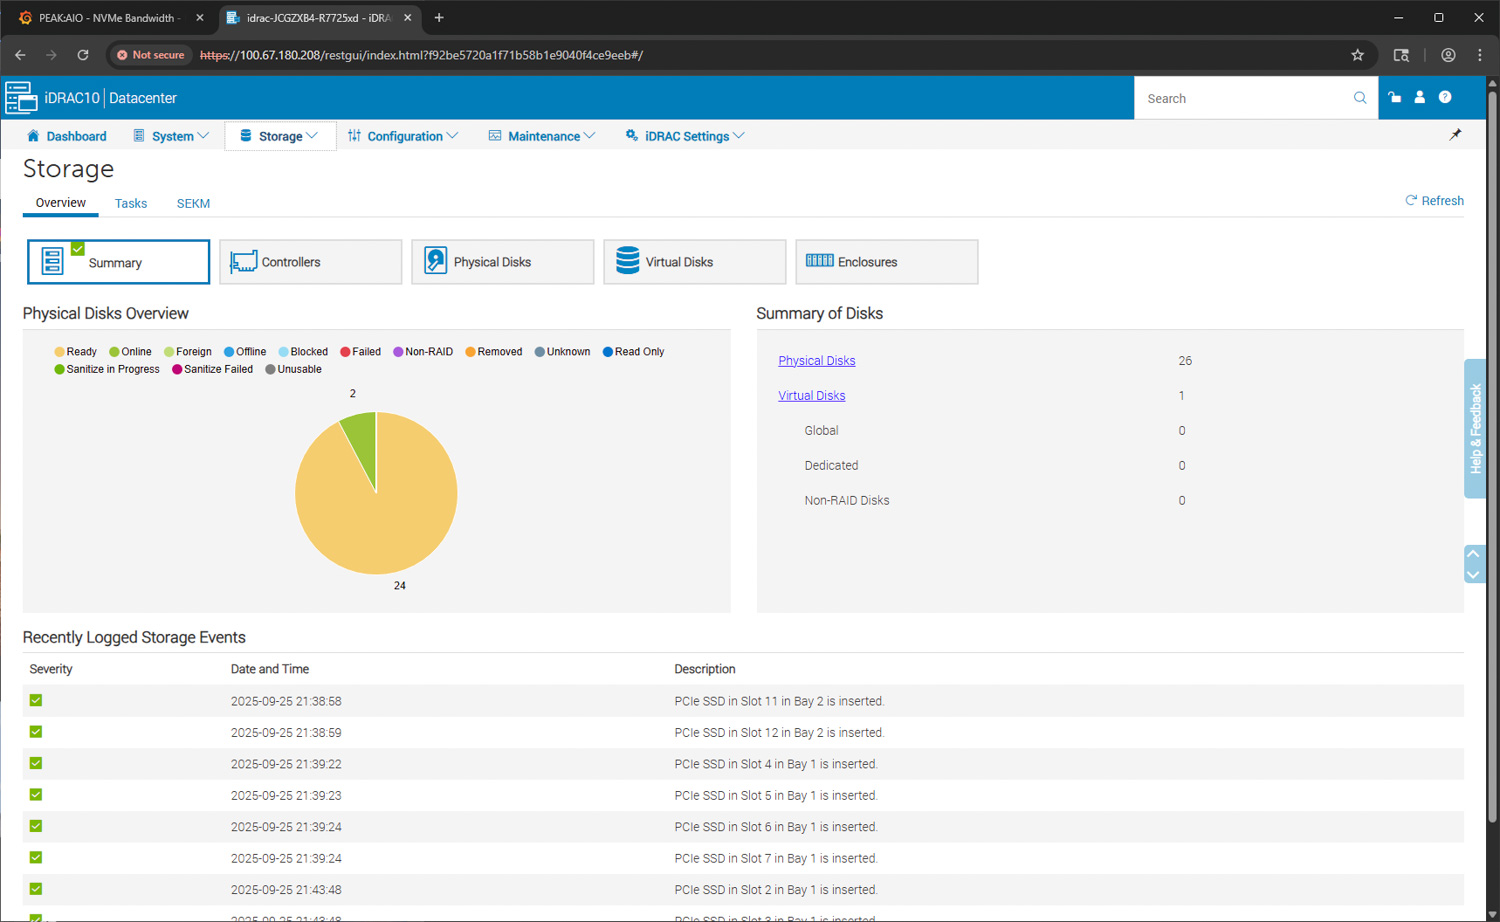
La sezione storage di iDRAC 10 presenta una panoramica completa di tutti i dischi fisici installati nel R7725xd. Il pannello di riepilogo mostra un conteggio dettagliato di tutte le unità connesse, accompagnato da un grafico a torta che illustra lo stato delle unità. In questa configurazione, 24 SSD NVMe sono attivi e segnalati come pronti, con due dispositivi di avvio aggiuntivi presenti nel sistema, separati dal banco NVMe anteriore principale.
Sulla destra, il pannello "Riepilogo dei dischi" li suddivide in dischi fisici e dischi virtuali associati. Poiché il modello R7725xd utilizza un'architettura NVMe diretta senza controller RAID tradizionali, tutte le unità vengono segnalate come Non-RAID e indirizzabili individualmente, in linea con la progettazione del sistema per grandi pool NVMe e piattaforme SDS.
Sotto il riepilogo dello stato, l'area Eventi di archiviazione registrati di recente elenca i log di inserimento per ogni SSD PCIe, organizzati per alloggiamento e slot. Questa registrazione conferma il corretto rilevamento in tutti gli alloggiamenti delle unità e aiuta a identificare eventuali problemi di posizionamento, cablaggio o attività di hot-swap. Per le distribuzioni di grandi dimensioni, questi log sono utili per monitorare il provisioning delle unità o verificare che la capacità sia stata riempita come previsto.
L'ultima schermata mostra la vista dettagliata del dispositivo NVMe all'interno di iDRAC10. Ogni unità NVMe installata nel sistema è elencata con il relativo stato, capacità e posizione dell'alloggiamento. Selezionando una singola unità si apre una descrizione completa delle sue caratteristiche.
In questo esempio, il pannello informativo dell'unità mostra la stringa completa del modello, il protocollo del dispositivo, il fattore di forma e le impostazioni PCIe negoziate. I dispositivi NVMe funzionano a una velocità di collegamento di 32 GT/s con una connessione x4 negoziata, a conferma che le unità funzionano a piena larghezza di banda sul backplane PCIe Gen5 del sistema. La sezione informativa riporta anche la percentuale di resistenza, lo stato della riserva disponibile e il tipo di protocollo, aiutando gli amministratori a monitorare lo stato di salute delle unità e le aspettative del ciclo di vita.
Questa reportistica granulare sulle unità è utile nelle configurazioni NVMe ad alta densità in cui la larghezza del collegamento, la velocità negoziata e lo stato dei supporti influenzano direttamente il comportamento del carico di lavoro e le prestazioni di archiviazione.
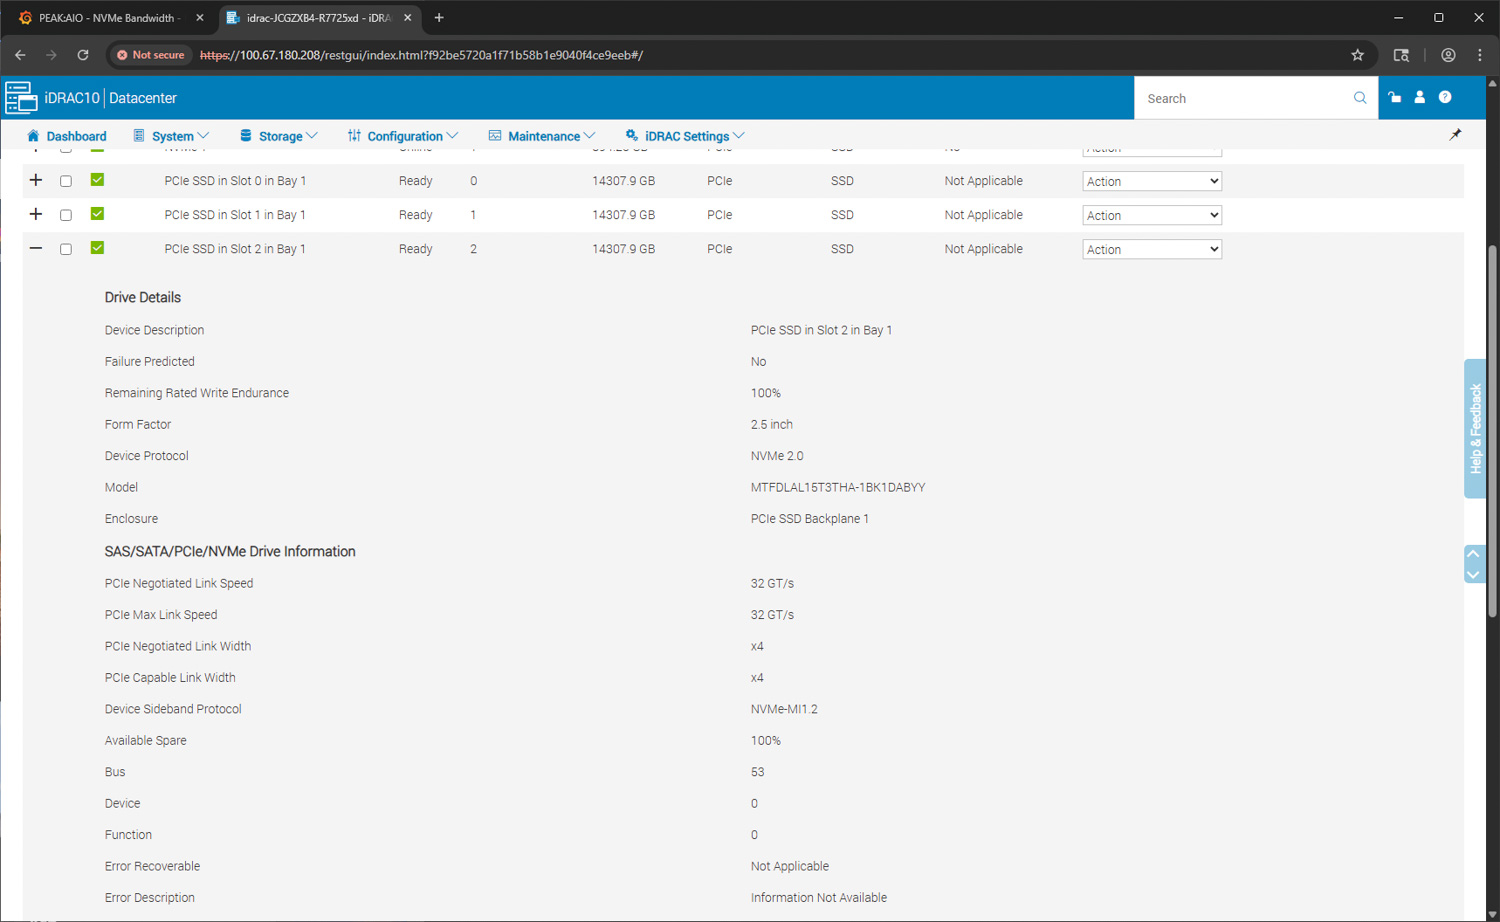
Nel complesso, l'interfaccia iDRAC 10 fornisce una visione chiara e incentrata sull'hardware dell'architettura di archiviazione NVMe dell'R7725xd, consentendo una facile convalida a colpo d'occhio dello stato del collegamento, dell'unità e dell'integrità del sistema.
Prestazioni Dell PowerEdge R7725xd
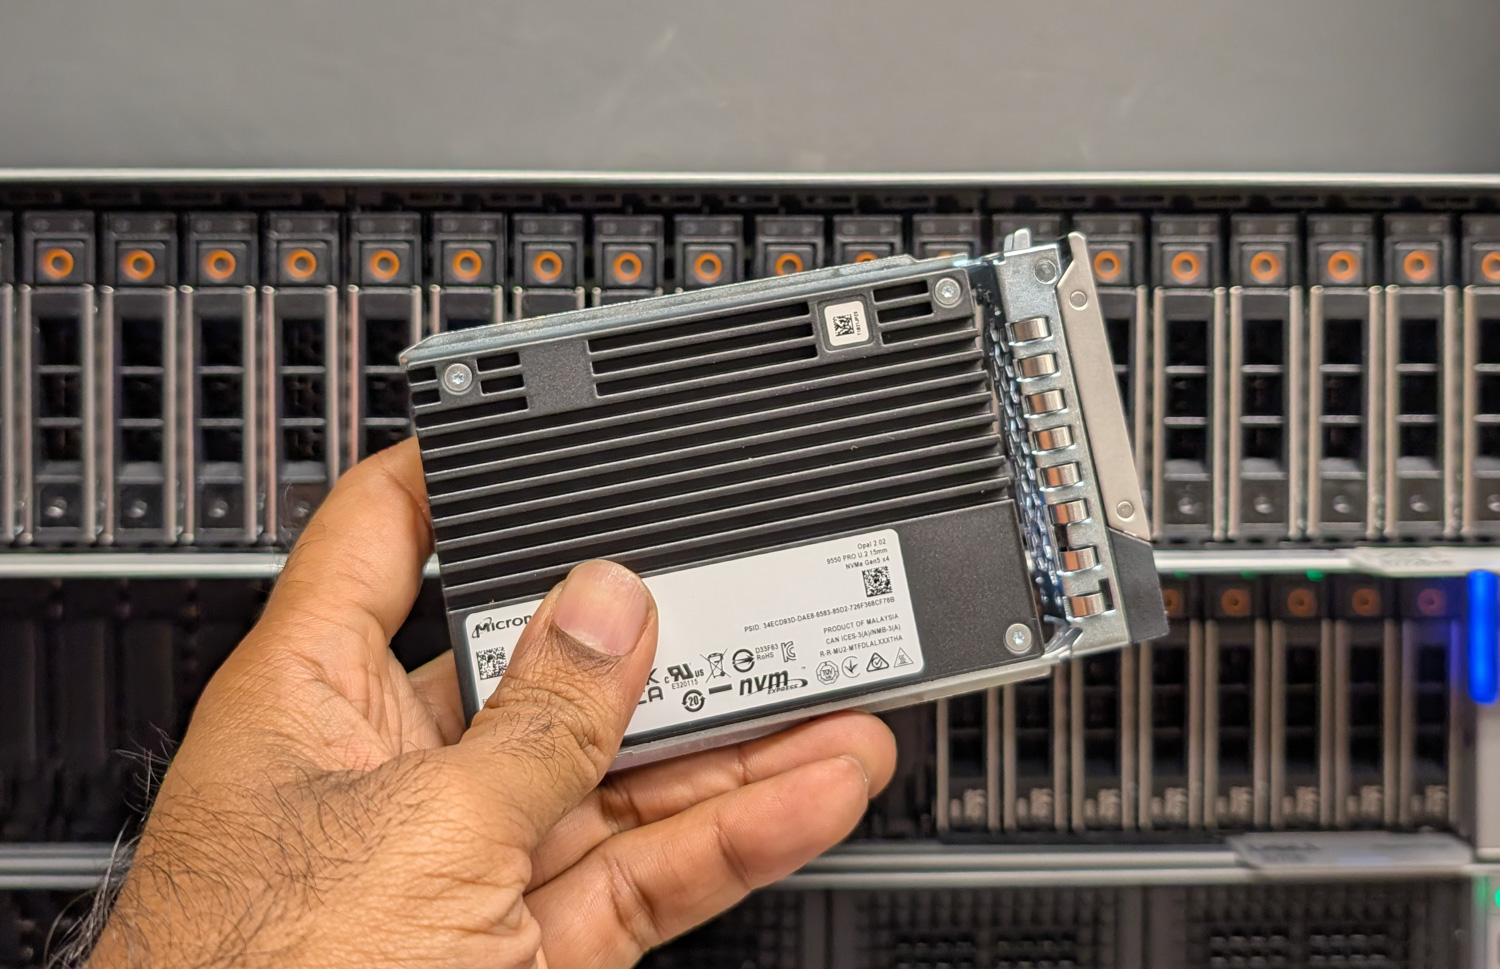
Prima dei test, il nostro sistema è stato configurato con un carico di lavoro bilanciato ma ad alte prestazioni. Il sistema è dotato di due processori AMD EPYC 9575F, ciascuno con 64 core ad alta frequenza, abbinati a 24 DIMM DDR5 da 32 GB che operano a 6400 MT/s. Per quanto riguarda l'archiviazione, lo chassis è completamente popolato con 24 SSD Micron 9550 PRO U.2 NVMe da 15.36 TB, ciascuno collegato tramite un collegamento PCIe Gen5 x4 dedicato. Ciò fornisce una capacità raw totale di 368.64 TB, con le unità Micron 9550 PRO che offrono velocità di lettura sequenziale fino a 14,000 MB/s e velocità di scrittura sequenziale fino a 10,000 MB/s. La rete è gestita da quattro adattatori Broadcom BCM57608 che forniscono un totale di otto porte da 200 Gb, insieme a una scheda di rete OCP BCM57412 che offre due porte aggiuntive da 10 Gigabit.
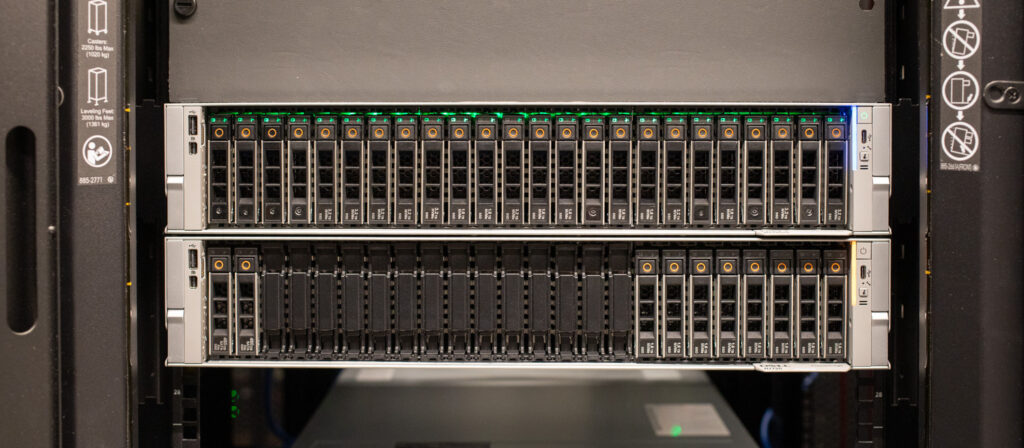
Test delle specifiche del sistema
- CPU: 2 processori AMD EPYC 9575F ad alta frequenza a 64 core
- Memoria: 24x 32 GB DDR5 a 6400 MT/s
- Memoria su disco: 24 unità Micron 9550 PRO U.2 da 15.36 TB (collegate a 4 corsie PCIe Gen5 ciascuna); supporta oggi unità fino a 128 TB con capacità maggiori all'orizzonte
- Network: 4 schede di rete Broadcom BCM57608 2x200G, 1 scheda di rete OCP BCM57412 2x10Gb
- Interruttore: Dell PowerSwitch Z9664
Benchmark delle prestazioni FIO
Per misurare le prestazioni di storage del PowerEdge R7725xd, abbiamo utilizzato metriche standard del settore e lo strumento FIO. In questa sezione, ci concentreremo sui seguenti benchmark FIO:
- Casuale 4K – 1M
- Sequenziale 4K – 1M
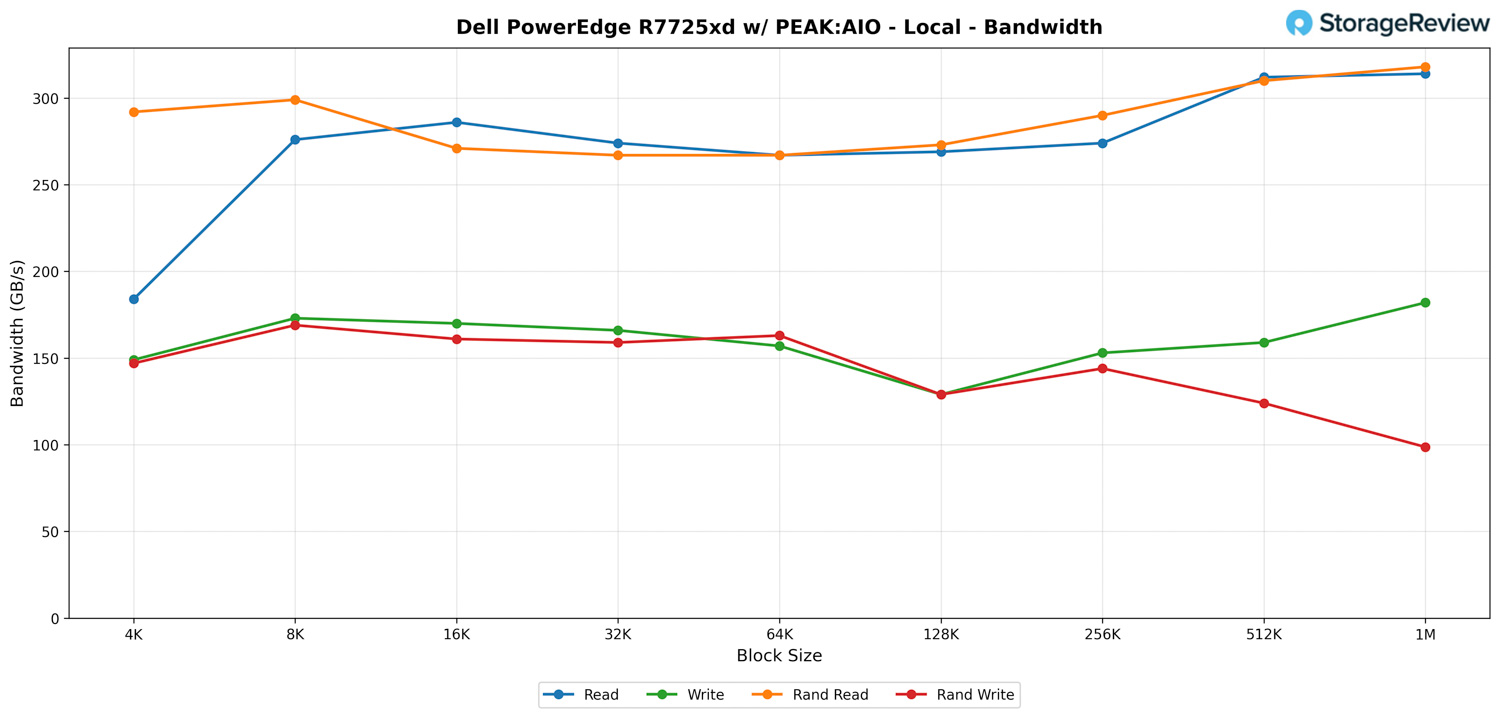
FIO – Locale – Larghezza di banda
Durante il test dell'accesso locale alle 24 unità PCIe Gen5 NVMe all'interno del Dell PowerEdge R7725xd, il sistema mostra esattamente ciò che ci si aspetterebbe da una piattaforma in cui ogni unità è collegata alle CPU tramite un collegamento PCIe Gen5 a 4 corsie completo. Senza alcun livello di rete coinvolto, questa è la pura produttività interna del layout di storage Gen5 di Dell e la larghezza di banda PCIe della piattaforma AMD EPYC che funziona senza restrizioni.
Le letture sequenziali partono da 184 GB/s con blocchi da 4K e scalano rapidamente all'aumentare delle dimensioni dei blocchi. Da 512K a 1M, il server mantiene una velocità costante di 312-314 GB/s, il che è un'indicazione significativa della capacità del sistema di aggregare tutte le 24 × 4 linee Gen5 in una larghezza di banda di lettura sostenuta senza colli di bottiglia a livello di controller.
Le scritture sequenziali seguono una curva diversa, ma rimangono saldamente nell'intervallo previsto. A partire da 149 GB/s, i risultati salgono fino a circa 100 GB/s e raggiungono i 182 GB/s a 1 milione. Questo è in linea con il comportamento in scrittura degli SSD Micron 9550 PRO e con il sovraccarico intrinseco delle scritture NVMe parallele su così tanti dispositivi indipendenti.
Un altro punto di forza sono le prestazioni in lettura casuale. Il sistema raggiunge velocità di quasi 300 GB/s con blocchi di dimensioni minime, scende leggermente nella fascia media e poi recupera fino a 200 GB/s e 300 GB/s con blocchi di dimensioni maggiori. A 1M, le letture casuali raggiungono un massimo di 318 GB/s, dimostrando la capacità della piattaforma di distribuire uniformemente le operazioni miste su tutte le 24 unità.
Le scritture casuali avvengono a una velocità inferiore, tipica delle attività di metadati e allocazione delle scritture distribuite su un ampio set NVMe. I risultati rimangono nell'intervallo 140-160 GB/s per la maggior parte del test e si riducono a poco meno di 100 GB/s a 1 M.
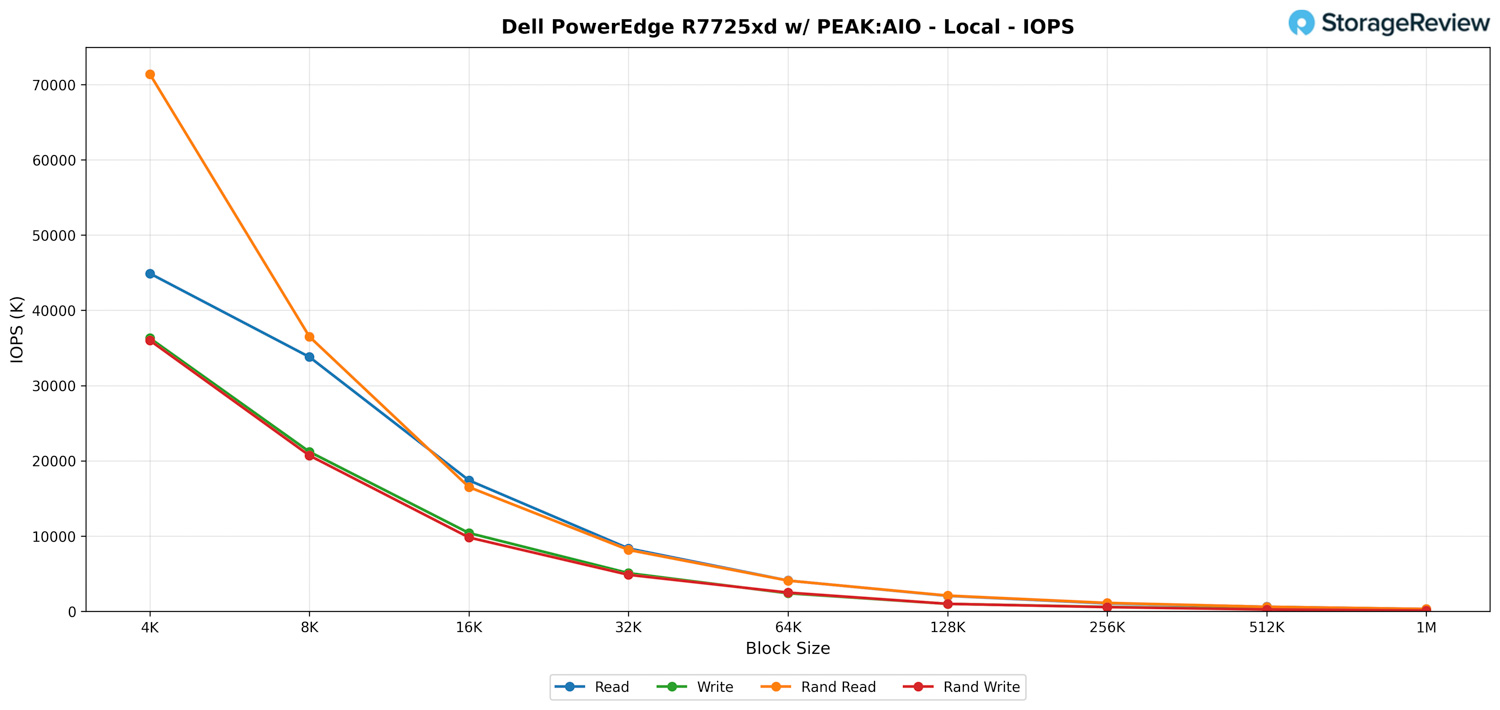
FIO – Locale – IOPS
Esaminando il lato IOPS, l'R7725xd dimostra solide prestazioni a blocchi di piccole dimensioni, con frequenze di richiesta che raggiungono decine di milioni prima che blocchi di dimensioni maggiori spostino il carico di lavoro verso un profilo basato sulla larghezza di banda.
A 4K, le letture raggiungono 44.9 milioni di IOPS e le scritture 36.3 milioni. Le letture casuali raggiungono livelli ancora più elevati, a 71.4 milioni di IOPS, a dimostrazione della capacità del sistema di distribuire in modo efficiente carichi di lavoro con code elevate su tutte le unità. Questi valori diminuiscono naturalmente all'aumentare delle dimensioni dei blocchi, ma la progressione rimane costante negli intervalli 8K, 16K e 32K.
Con blocchi da 16K e 32K, le letture si attestano rispettivamente a 17.4 milioni e 8.35 milioni di IOPS, con letture casuali che si attestano a circa 16.5 milioni e 8.15 milioni. Le scritture seguono il modello previsto, con un andamento inferiore ma rimanendo stabili sia con accessi sequenziali che casuali.
Passando a 64K e oltre, il test passa da IOPS puri a uno scenario più vincolato alla larghezza di banda. Gli IOPS si attestano su un intervallo di pochi milioni e infine su centinaia di migliaia. Con blocchi da 1M, gli IOPS in lettura si attestano intorno ai 300K, quelli in scrittura a circa 174K e le operazioni casuali terminano nello stesso intervallo.
Nel complesso, i risultati IOPS locali mostrano chiaramente la capacità del sistema di sostenere carichi di lavoro con profondità di coda molto elevata su piccoli blocchi, con un ridimensionamento prevedibile man mano che i trasferimenti aumentano e la larghezza di banda diventa il fattore dominante.
PEAK:AIO: perché il Dell PowerEdge R7725xd è adatto a questo carico di lavoro
PEAK:AIO è progettato per ambienti che richiedono un accesso estremamente rapido e a bassa latenza a grandi set di dati, in genere per l'addestramento dell'intelligenza artificiale, pipeline di inferenza, modellazione finanziaria e analisi in tempo reale. La piattaforma sfrutta al meglio l'archiviazione NVMe ad alta densità, la larghezza di banda PCIe bilanciata e la latenza prevedibile su larga scala. Per soddisfare questi requisiti, l'hardware sottostante deve offrire un throughput sostenuto, mantenendo al contempo prestazioni costanti e ripetibili in presenza di carichi di lavoro elevati simultanei.
È qui che il Dell PowerEdge R7725xd si allinea naturalmente con PEAK:AIO. L'architettura del sistema è progettata per massimizzare le risorse PCIe Gen5, esponendo l'intera larghezza di banda dei suoi 24 alloggiamenti U.2 NVMe frontali direttamente alle CPU, senza dover ricorrere ai tradizionali controller RAID. Questo layout conferisce a PEAK:AIO il parallelismo e il profilo di latenza che si aspetta dalle moderne pipeline di dati basate su NVMe. La configurazione del sistema ha suddiviso gli SSD NVMe in due gruppi RAID0.
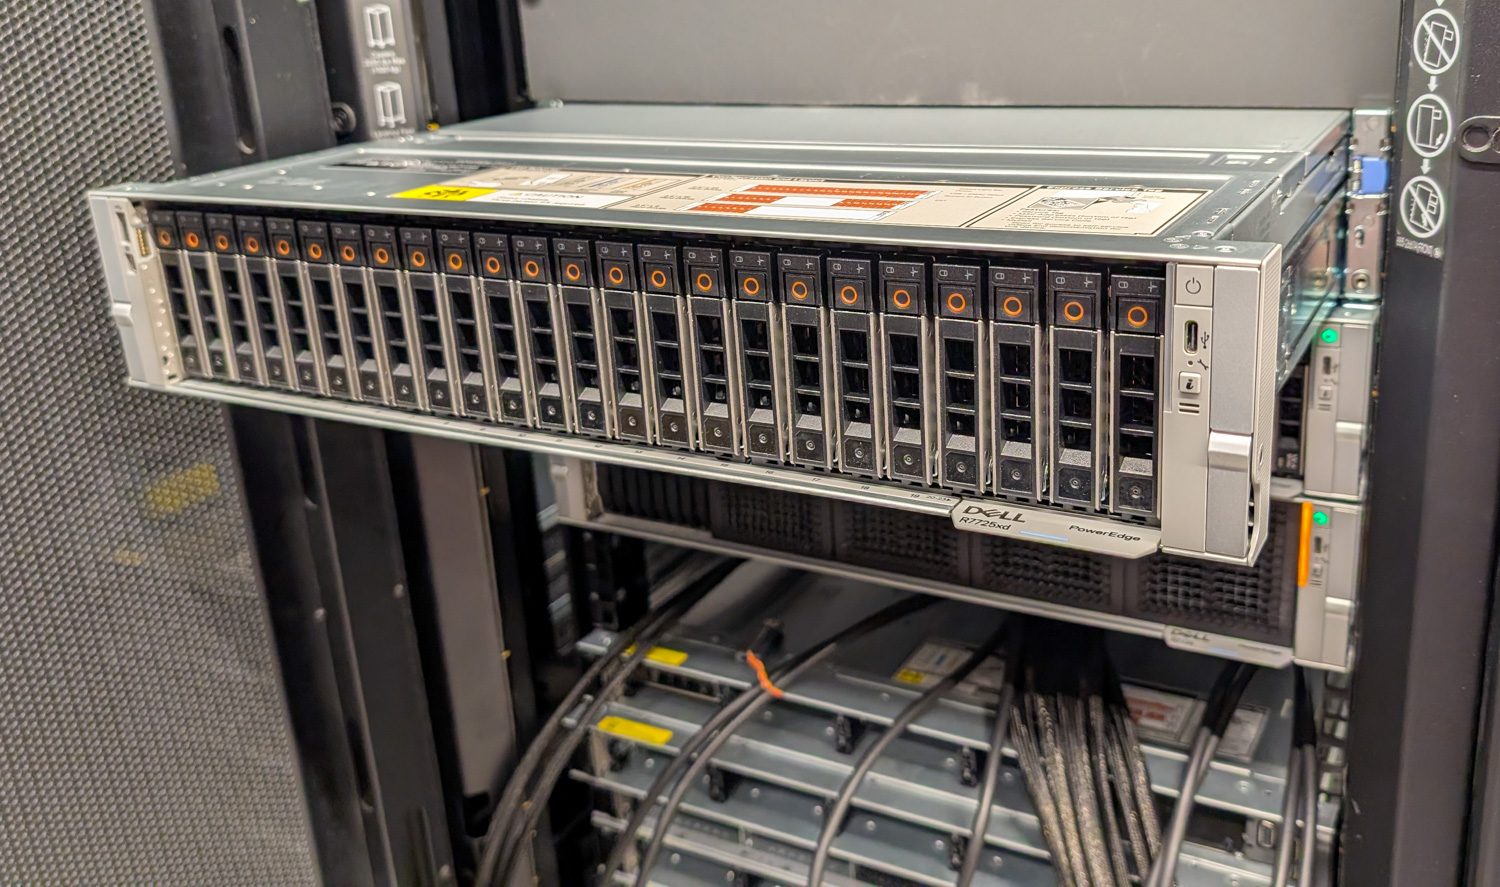
Nello scenario testato, abbiamo utilizzato due sistemi client connessi all'R7725xd, ciascuno dotato di schede di rete Broadcom BCM57608 2x 200G. Ciò ha creato un totale di quattro uplink da 200G che alimentano ciascun client, portando l'R7725xd in una configurazione realistica ad alte prestazioni che rispecchia quella osservata nelle implementazioni PEAK:AIO in produzione. Questo livello di larghezza di banda di rete ci ha fornito il margine necessario per sollecitare al massimo il sottosistema NVMe, la topologia PCIe e le interconnessioni della CPU senza creare colli di bottiglia a livello di scheda di rete.
Il risultato è una piattaforma che si allinea efficacemente ai carichi di lavoro PEAK:AIO. L'R7725xd offre capacità NVMe densa, throughput PCIe Gen5, due processori AMD EPYC 9005 per il parallelismo e la capacità di rete per supportare l'ingestione di dati multi-client a centinaia di gigabit per client. Tutte queste caratteristiche sono fondamentali per raggiungere le aspettative prestazionali di PEAK:AIO.
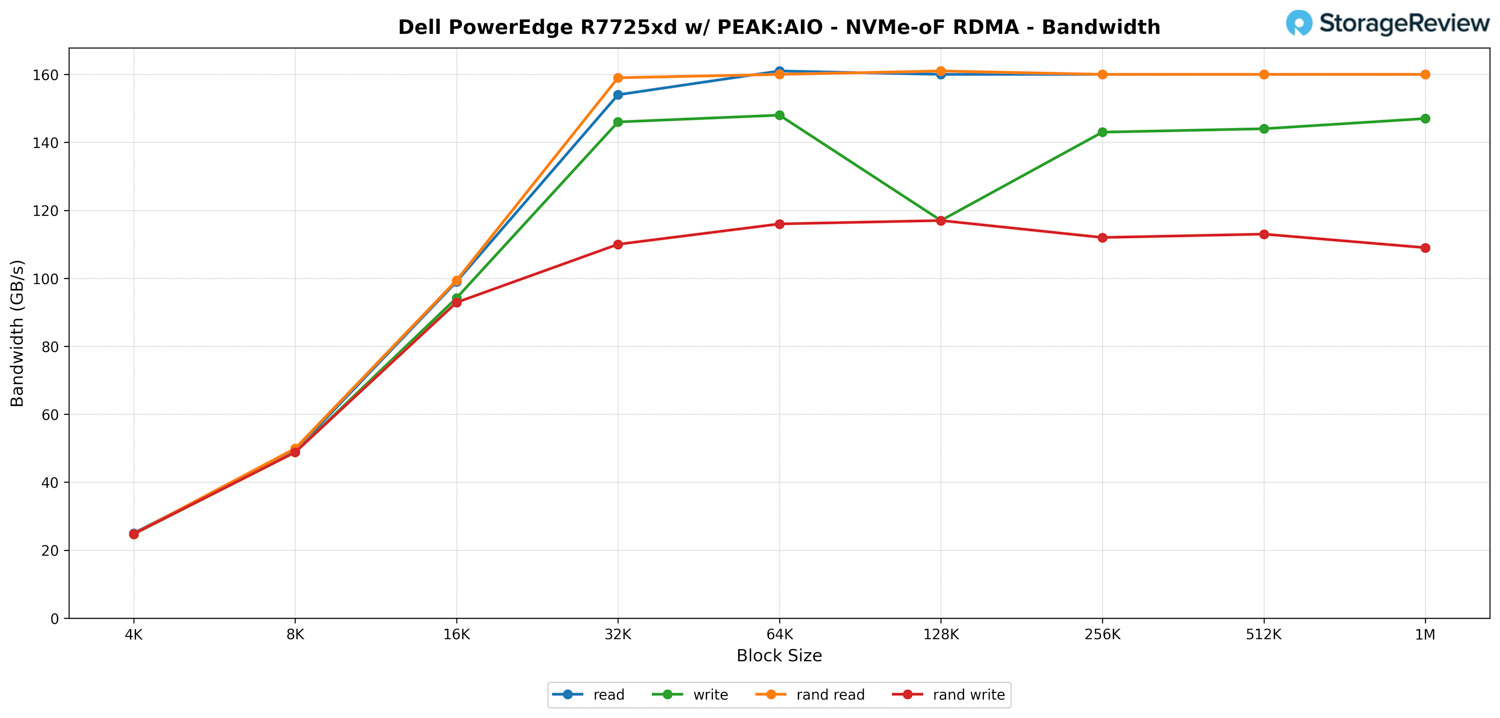
PEAK:AIO – NVMe-oF RDMA – Larghezza di banda
Esaminando i risultati della larghezza di banda RDMA NVMe-oF sul PowerEdge R7725xd con PEAK:AIO, la tendenza generale è esattamente quella che ci aspettiamo da un sistema con così tanta larghezza di banda PCIe e di rete. All'aumentare delle dimensioni dei blocchi, il throughput aumenta rapidamente fino a stabilizzarsi in prossimità del limite pratico della piattaforma.
Con blocchi di piccole dimensioni, le prestazioni partono da una media di 20 GB/s sia in lettura che in scrittura, il che è normale perché i trasferimenti a 4K e 8K sollecitano il percorso IOPS molto più del percorso di throughput. Una volta entrati nei blocchi da 16K e 32K, la pipeline si apre. Le letture salgono a circa 154 GB/s a 32K e continuano a salire fino a 160 GB/s, che è esattamente il livello in cui ci aspetteremmo da una configurazione dual-client su quattro link da 200 Gb/s.
Le prestazioni di lettura casuale rispecchiano quasi perfettamente quelle sequenziali. PEAK:AIO svolge un ottimo lavoro nel mantenere alimentate le code di comando, quindi la larghezza di banda in lettura casuale segue sostanzialmente quella in lettura sequenziale, attestandosi a circa 159-161 GB/s da 32K a 1M. Ciò indica che lo stack di archiviazione non crea colli di bottiglia in caso di modelli di accesso misti e che la topologia PCIe dell'R7725xd distribuisce il carico in modo uniforme sulle 24 unità NVMe Gen5.
Le prestazioni in scrittura seguono una curva simile, sebbene raggiungano un massimo leggermente inferiore rispetto alle letture. Le scritture sequenziali rimangono nell'intervallo 140-148 GB/s per i blocchi di medie dimensioni, scendendo a circa 117 GB/s a 128K, ma recuperando con l'aumentare delle dimensioni del blocco. Le scritture casuali si comportano diversamente e si stabilizzano intorno a 110-117 GB/s, il che è normale per i carichi di lavoro a coda mista che introducono un overhead aggiuntivo.
Il punto chiave di questa sezione è che l'R7725xd non ha problemi a sostenere una larghezza di banda estremamente elevata su NVMe-oF, anche con più client che spingono il sistema al limite. Una volta che le dimensioni dei blocchi raggiungono 32K o più, il server satura costantemente la larghezza di banda disponibile per la rete e lo storage. Questo è esattamente il tipo di prestazioni che PEAK:AIO è progettato per ottenere, rendendo questi risultati una solida convalida della capacità della piattaforma di scalare in condizioni reali.
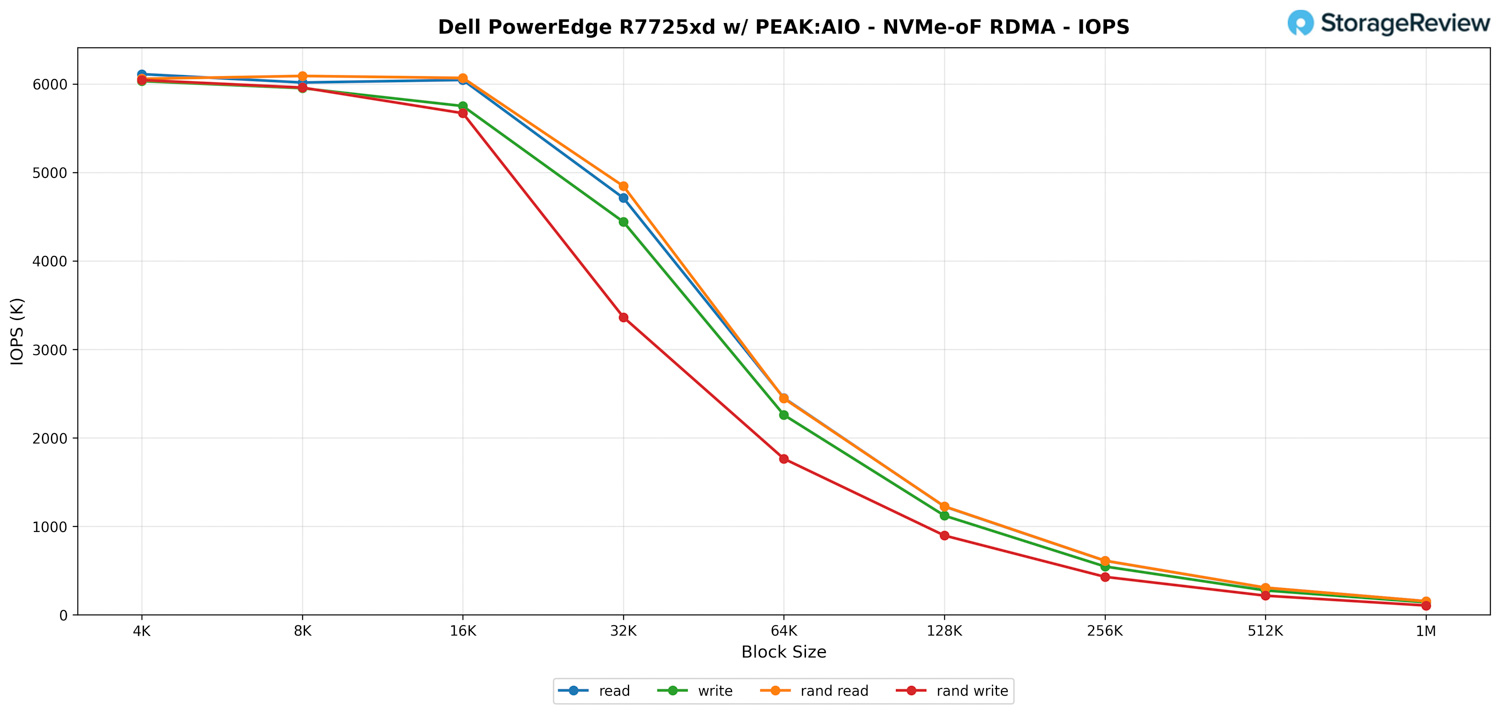
PEAK AIO – NVMe-oF RDMA IOPS
Sul fronte IOPS, il PowerEdge R7725xd offre ottime prestazioni su blocchi di piccole dimensioni, sebbene inizialmente abbiamo osservato numeri inferiori alle aspettative; si prevede che questo problema verrà risolto in futuro con un migliore supporto dei driver di rete. Nonostante ciò, la tendenza generale alla scalabilità si presenta esattamente come quella tipica di NVMe-oF RDMA quando le dimensioni dei blocchi aumentano.
Con la dimensione minima dei blocchi, il sistema può fornire oltre 6 milioni di IOPS su carichi di lavoro sia sequenziali che casuali. Lettura, scrittura, lettura casuale e scrittura casuale si collocano tutte all'incirca nello stesso intervallo, a 4K e 8K, il che indica che i client front-end, l'infrastruttura PCIe e le unità NVMe stesse non hanno problemi a tenere il passo con la frequenza delle richieste.
Con l'aumentare delle dimensioni dei blocchi, inizia il previsto calo degli IOPS. A 32K, le letture si attestano intorno ai 4.7 milioni di IOPS, mentre le scritture sono leggermente inferiori, a circa 4.4 milioni. Le scritture casuali subiscono il calo maggiore, scendendo a circa 3.3 milioni di IOPS, in linea con l'ulteriore sovraccarico di coda e CPU introdotto dai modelli di accesso misto.
Passando ai blocchi di grandi dimensioni, gli IOPS continuano a diminuire in modo lineare e prevedibile. Quando raggiungiamo i trasferimenti da 256 a 512, il throughput diventa la metrica dominante e gli IOPS scendono naturalmente a centinaia di migliaia. Con blocchi di dimensioni pari a 1M, tutti i carichi di lavoro convergono a 140-153 IOPS, in linea con i valori di larghezza di banda visti nella sezione precedente.
Prestazioni di archiviazione GPUDirect
Uno dei test che abbiamo condotto sul modello R7725xd è stato il test GPUDirect Storage (GDS) di Magnum IO. GDS è una funzionalità sviluppata da NVIDIA che consente alle GPU di bypassare la CPU quando accedono ai dati archiviati su unità NVMe o altri dispositivi di archiviazione ad alta velocità. Invece di instradare i dati attraverso la CPU e la memoria di sistema, GDS consente la comunicazione diretta tra la GPU e il dispositivo di archiviazione, riducendo significativamente la latenza e migliorando il throughput dei dati.
Come funziona GPUDirect Storage
Tradizionalmente, quando una GPU elabora i dati memorizzati su un'unità NVMe, i dati devono prima passare attraverso la CPU e la memoria di sistema prima di raggiungere la GPU. Questo processo introduce colli di bottiglia, poiché la CPU diventa un intermediario, aggiungendo latenza e consumando preziose risorse di sistema. GPUDirect Storage elimina questa inefficienza consentendo alla GPU di accedere ai dati direttamente dal dispositivo di archiviazione tramite il bus PCIe. Questo percorso diretto riduce il sovraccarico di trasferimento dei dati, consentendo trasferimenti più rapidi ed efficienti.
I carichi di lavoro di intelligenza artificiale, in particolare quelli che coinvolgono il deep learning, richiedono un elevato utilizzo di dati. L'addestramento di reti neurali di grandi dimensioni richiede l'elaborazione di terabyte di dati e qualsiasi ritardo nel trasferimento dei dati può portare a GPU sottoutilizzate e tempi di addestramento più lunghi. GPUDirect Storage affronta questa sfida garantendo che i dati vengano inviati alla GPU il più rapidamente possibile, riducendo al minimo i tempi di inattività e massimizzando l'efficienza computazionale.
Inoltre, GDS è particolarmente utile per carichi di lavoro che comportano lo streaming di grandi set di dati, come l'elaborazione video, l'elaborazione del linguaggio naturale o l'inferenza in tempo reale. Riducendo la dipendenza dalla CPU, GDS accelera lo spostamento dei dati e libera risorse della CPU per altre attività, migliorando ulteriormente le prestazioni complessive del sistema.
Oltre alla larghezza di banda pura, GPUDirect con NVMe-oF (TCP/RDMA) offre anche I/O a bassissima latenza. Questo garantisce che le GPU non siano mai a corto di dati, rendendo il sistema ideale per l'inferenza AI in tempo reale, le pipeline di analisi e la riproduzione video.
GDSIO Lettura sequenziale
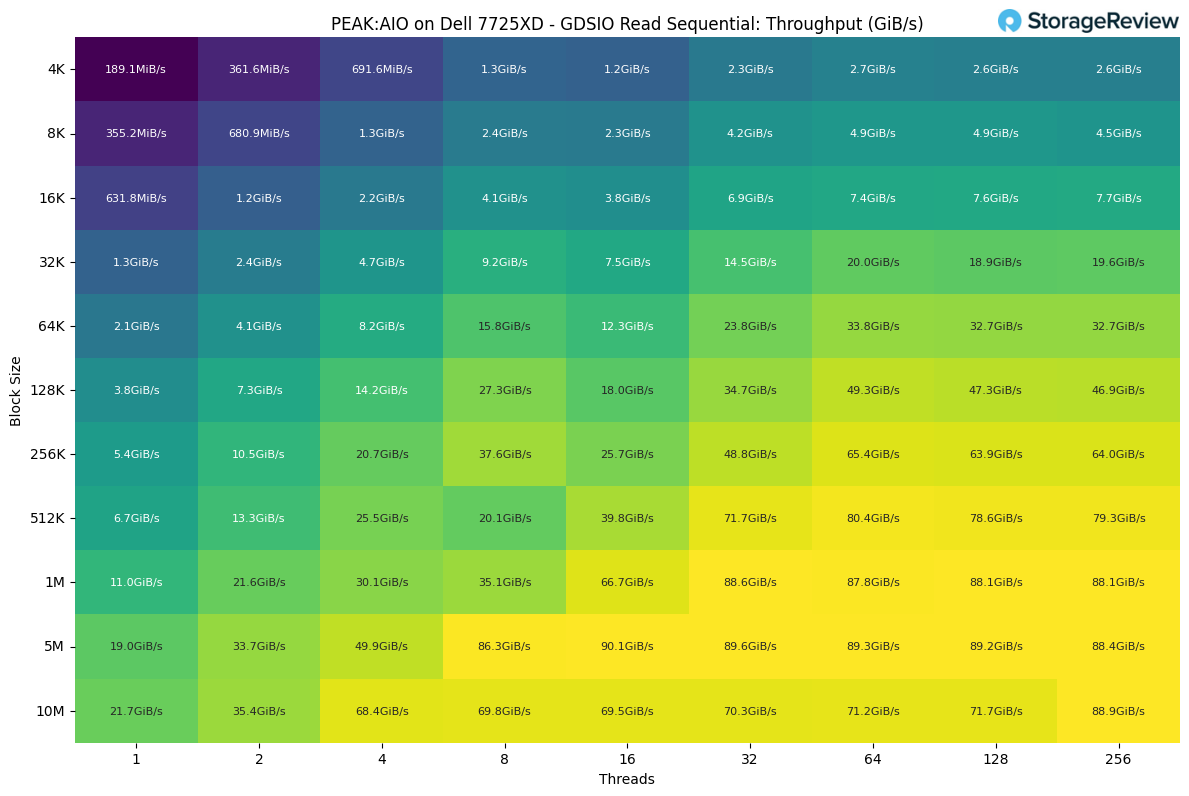
Esaminando PEAK:AIO con un client che utilizza GDSIO, la velocità di lettura mostra un chiaro andamento di scalabilità all'aumentare sia della dimensione dei blocchi che del numero di thread. Questo singolo client era connesso tramite due link da 400G, limitando il suo potenziale totale a 90 GB/s.
Con blocchi di dimensioni ridotte e un basso numero di thread, le prestazioni sono modeste, con letture da 4K che partono da circa 189 MiB/s a singolo thread. Non appena aumentiamo il parallelismo dei thread, il sistema risponde immediatamente, spingendo a 691 MiB/s a quattro thread e raggiungendo l'intervallo multi-GiB/s man mano che passiamo a blocchi più grandi.
Le dimensioni dei blocchi di fascia media mostrano la maggiore sensibilità al numero di thread. A 32K, la produttività aumenta da 1.3 GiB/s con un singolo thread a quasi 20 GiB/s con 64 thread, con solo una leggera riduzione oltre tale valore. Un andamento simile si riscontra a 64K e 128K, dove il sistema passa da GiB/s a una sola cifra con basso parallelismo a oltre 30 GiB/s con l'aumentare del carico di lavoro.
Una volta raggiunte le dimensioni dei blocchi più grandi, la velocità effettiva inizia a stabilizzarsi man mano che il sistema si avvicina al suo limite massimo di prestazioni per un singolo client. A 1 MiB, le prestazioni salgono da 11 GiB/s con un singolo thread a circa 88 GiB/s con un numero elevato di thread. I trasferimenti a 5 MiB e 10 MiB mostrano lo stesso plateau, raggiungendo un massimo di circa 89-90 GiB/s indipendentemente dal fatto che il test venga eseguito a 64, 128 o 256 thread.
GDSIO Scrivi sequenziale
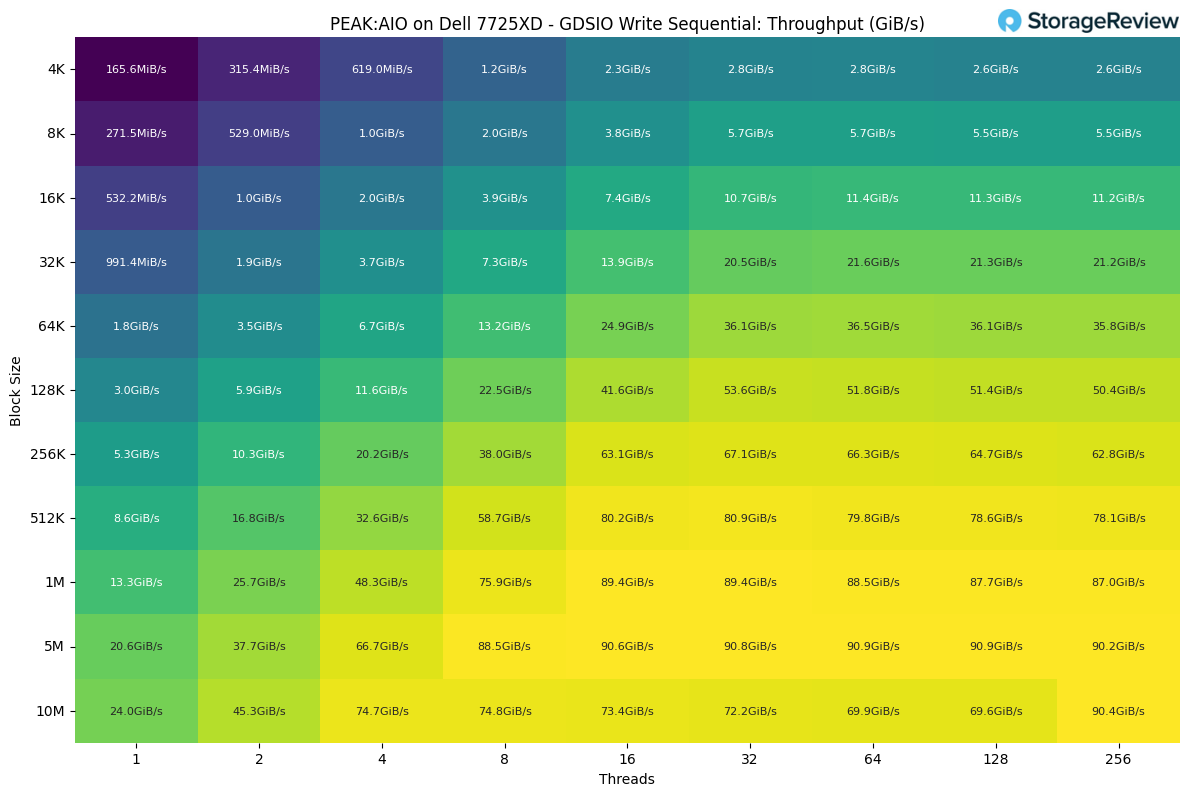
Sul lato scrittura, il comportamento di scalabilità segue uno schema simile a quello delle letture, ma con prestazioni leggermente inferiori per la maggior parte delle dimensioni dei blocchi, come previsto per i carichi di lavoro di scrittura sequenziale. Alle dimensioni dei blocchi più piccole, il throughput inizia a 165 MiB/s per un singolo thread a 4K e aumenta costantemente con l'aumentare del parallelismo. A quattro thread, questo valore cresce fino a poco più di 619 MiB/s prima di superare 1 GiB/s a otto thread.
Le dimensioni dei blocchi di fascia media mostrano guadagni più consistenti con l'aumentare del numero di thread. A 32K, la produttività parte da poco meno di 1 GiB/s e sale a oltre 21 GiB/s con livelli di thread più elevati. Gli intervalli da 64K e 128K proseguono la tendenza, passando da GiB/s a una sola cifra a valori medi di 30 GiB/s e 50 GiB/s man mano che il carico di lavoro diventa più parallelo.
I trasferimenti più grandi si verificano quando il sistema raggiunge il suo limite naturale di throughput in scrittura. A 1 MiB, le prestazioni salgono da 13.3 GiB/s con un singolo thread a poco meno di 90 GiB/s con un numero elevato di thread. I test a 5 MiB e 10 MiB seguono uno schema simile, con risultati che raggiungono un picco di circa 90 GiB/s indipendentemente dal fatto che il sistema funzioni a 64, 128 o 256 thread.
Ridefinire le prestazioni nell'era Gen5
Il Dell PowerEdge R7725xd è più di un server di storage: rappresenta un cambiamento nel modo in cui la larghezza di banda viene distribuita all'interno del rack. Eliminando gli switch PCIe e fornendo a ogni unità NVMe un percorso diretto alla CPU, Dell ha creato un sistema in cui il throughput scala in modo pulito, le temperature rimangono prevedibili e la concorrenza diventa una risorsa anziché una sfida.
Abbinato agli SSD 9550 PRO di Micron e al software di I/O parallelo PEAK:AIO, l'R7725xd si trasforma da un denso chassis NVMe in un vero e proprio motore dati. Può saturare la sua struttura PCIe locale, alimentare le GPU tramite RDMA a velocità di linea o fungere simultaneamente da unità di elaborazione e storage, il tutto in un ingombro di 2U.
Dell PowerEdge R7225xd
In termini pratici, questa configurazione offre oltre 300 GB/s di throughput locale e 160 GB/s in rete, rivaleggiando con le prestazioni dei cluster di storage multi-nodo a una frazione della complessità e dei costi. È una dimostrazione di cosa accade quando ogni livello dello stack, dal silicio al software, è allineato in termini di efficienza e larghezza di banda costante.
L'R7725xd stabilisce un nuovo punto di riferimento per le prestazioni di storage a nodo singolo nell'era Gen5. Per le organizzazioni che realizzano pipeline di intelligenza artificiale di nuova generazione, analisi ad alta velocità o ambienti di formazione con numerosi checkpoint, offre un assaggio di ciò che è possibile ottenere eliminando completamente i colli di bottiglia dal sistema.
Questo rapporto è sponsorizzato da Dell Technologies. Tutti i pareri e le opinioni espressi in questo rapporto si basano sulla nostra visione imparziale dei prodotti in esame.


 Amazon