

Il mercato delle infrastrutture per l'IA non si sta muovendo in un'unica direzione, ma si sta dividendo in due mondi distinti. Da un lato ci sono i cluster di training all'avanguardia, progettati per sviluppare modelli di base su vasta scala, strettamente legati a architetture proprietarie e a un set ristretto di acceleratori. Dall'altro lato c'è la realtà in rapida espansione dell'inferenza aziendale, in cui le organizzazioni implementano modelli per servire gli utenti, elaborare dati in tempo reale e generare valore aziendale misurabile. Il Dell PowerEdge XE7740 è progettato specificamente per questo secondo mondo.
Punti chiave
- Il PowerEdge XE7740 è progettato per l'inferenza aziendale, con sistema termico a doppia zona, topologia PCIe Gen5 strutturata e rete scalabile in base ai carichi di lavoro di produzione reali.
- L'equilibrio del sistema è intenzionale, Combinazione di densità di core Xeon 6, elevata larghezza di banda della memoria e PCIe Gen 5 E3.S NVMe per supportare l'offload della cache KV e l'orchestrazione.
- La flessibilità del silicio è fondamentale, Supporto per un'ampia gamma di acceleratori PCIe Gen5 senza necessità di riprogettare l'infrastruttura.
- La piattaforma si adatta in modo pulito nel tempo, Da un popolamento parziale di GPU in un singolo chassis all'inferenza distribuita su rack utilizzando otto slot di rete dedicati Gen5 x16 posteriori.
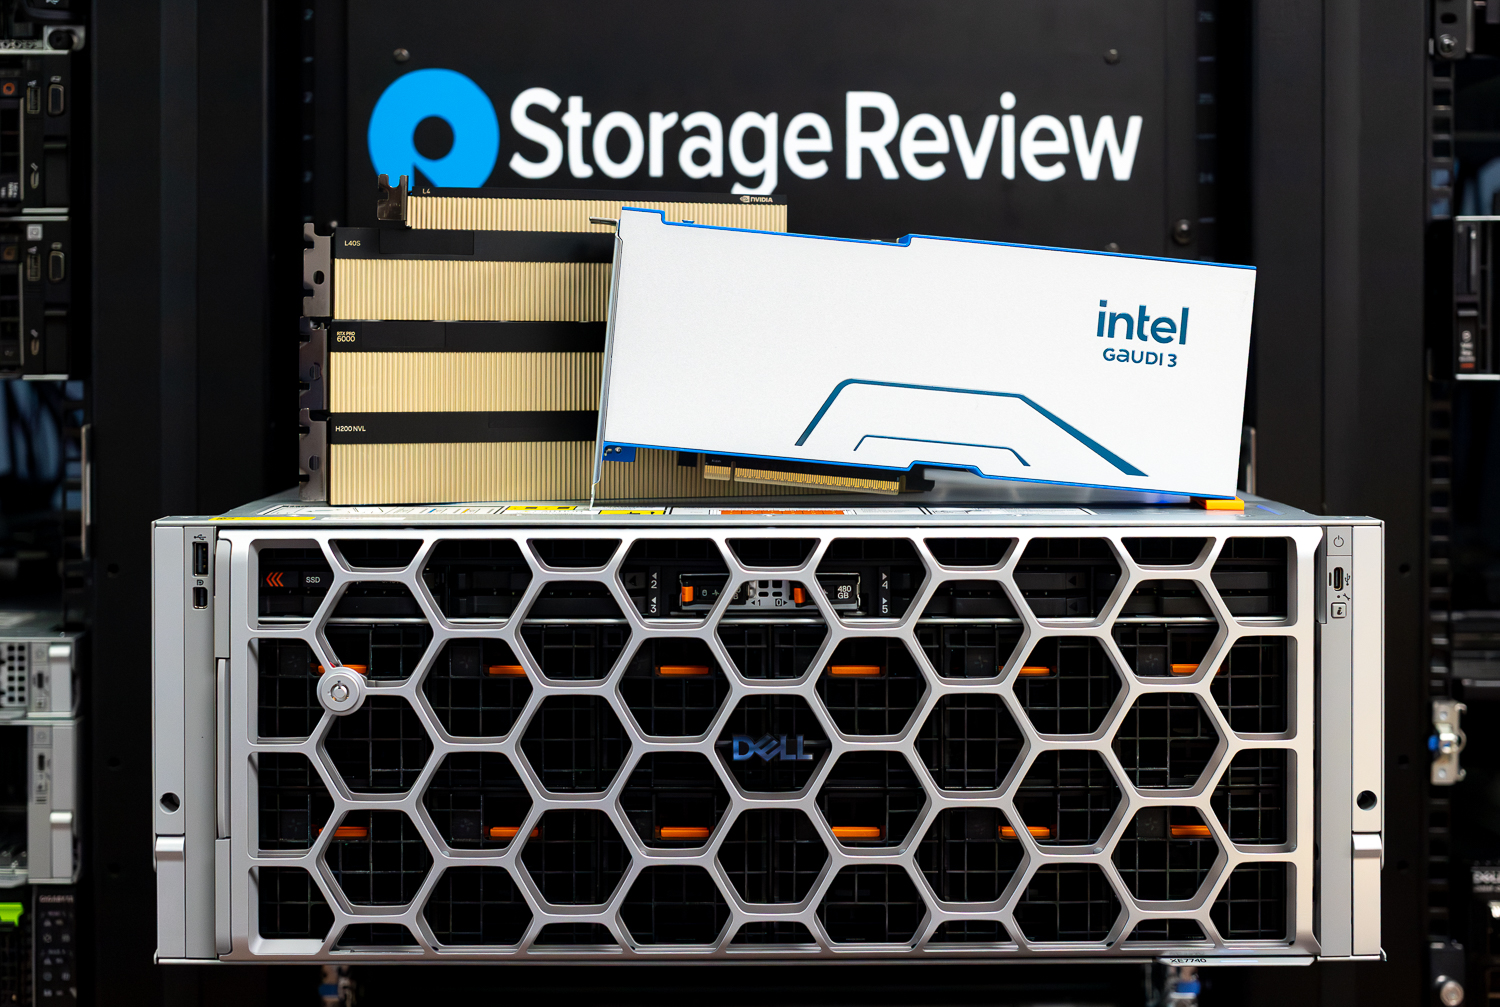
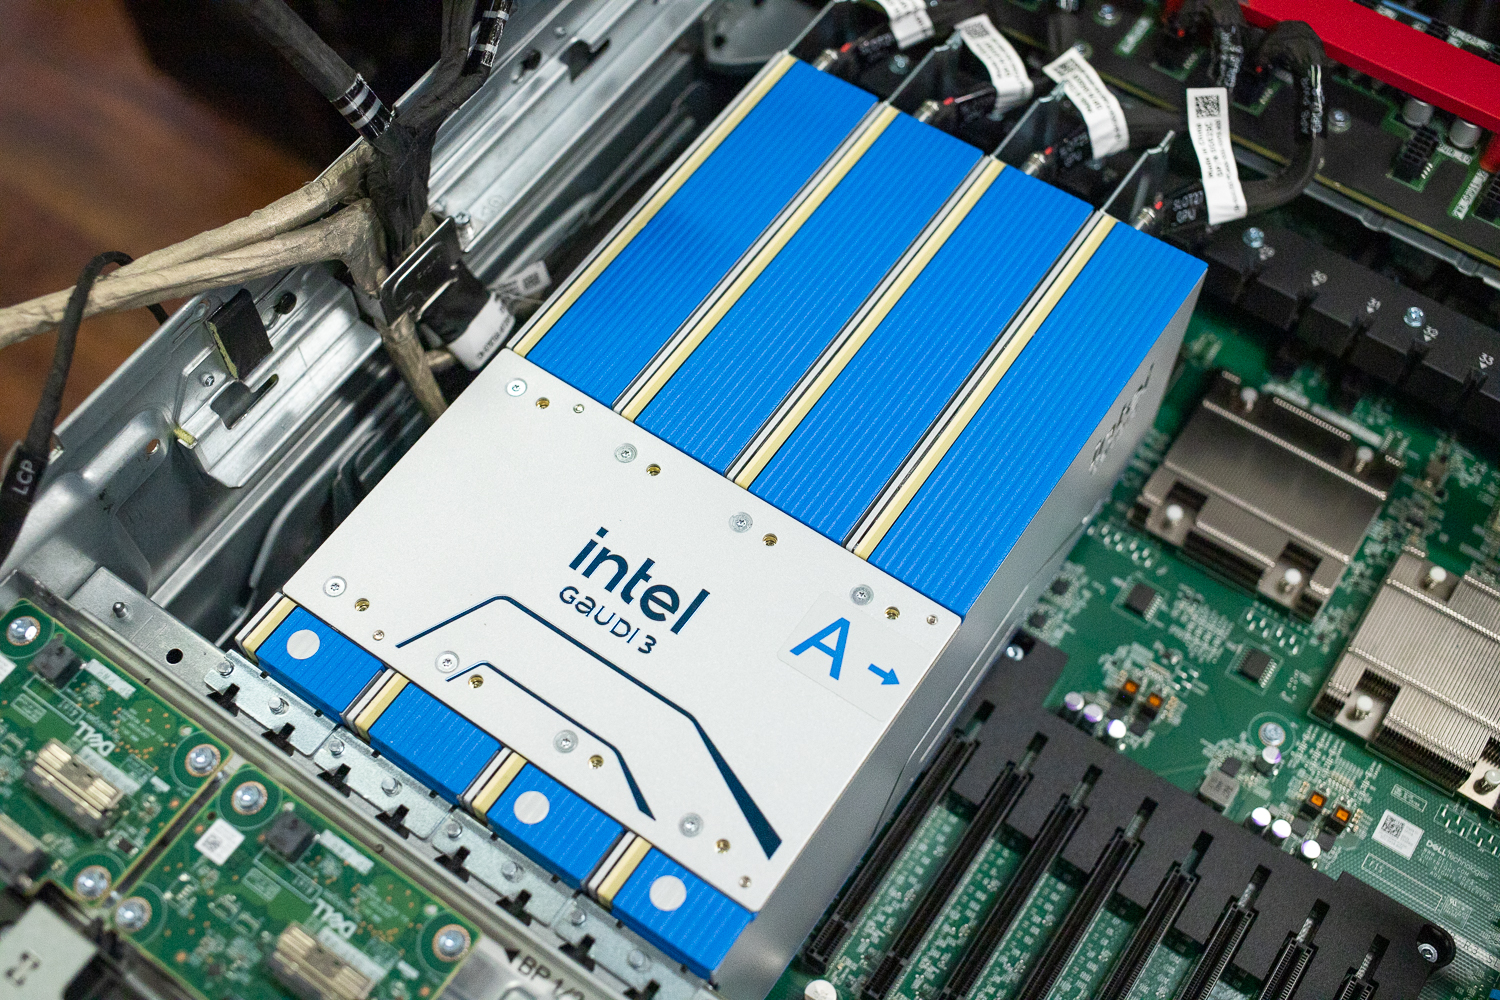
Al centro della piattaforma XE7740 c'è l'impegno per la diversità dei chip. Anziché vincolare la piattaforma a un'unica roadmap di acceleratori, Dell ha creato un sistema che si adatta alla disponibilità, ai costi e alle esigenze organizzative. La XE7740 supporta una gamma di acceleratori PCIe Gen5, tra cui le GPU NVIDIA RTX PRO 6000, H100/200, L40S, L4 e A16 per le organizzazioni che apprezzano un'ampia compatibilità con l'ecosistema, e Intel Gaudi 3 per i team che cercano un percorso di inferenza più economico e immediatamente disponibile. Gli acceleratori Gaudi 3 sono già disponibili, consentendo alle organizzazioni di passare dalla pianificazione all'implementazione senza i ritardi di approvvigionamento che spesso condizionano la strategia di accelerazione.
Poiché l'inferenza sta diventando il carico di lavoro dominante nell'IA, la disponibilità e la struttura dei costi diventano cruciali. La maggior parte delle aziende non addestra modelli di livello all'avanguardia, bensì esegue pipeline di inferenza, gestisce modelli linguistici di medie dimensioni, alimenta flussi di lavoro di generazione aumentata per il recupero di informazioni e implementa la visione artificiale in produzione. In questo contesto, Gaudi 3 si posiziona come uno degli acceleratori di inferenza moderni più convenienti sul mercato, offrendo un'architettura contemporanea con memoria ad alta larghezza di banda e scalabilità orizzontale basata su Ethernet, senza i costi elevati delle GPU di punta per l'addestramento. All'interno dell'XE7740, Gaudi 3 non si limita a sostituire le GPU esistenti, ma mira a consentire implementazioni di inferenza sostenibili.
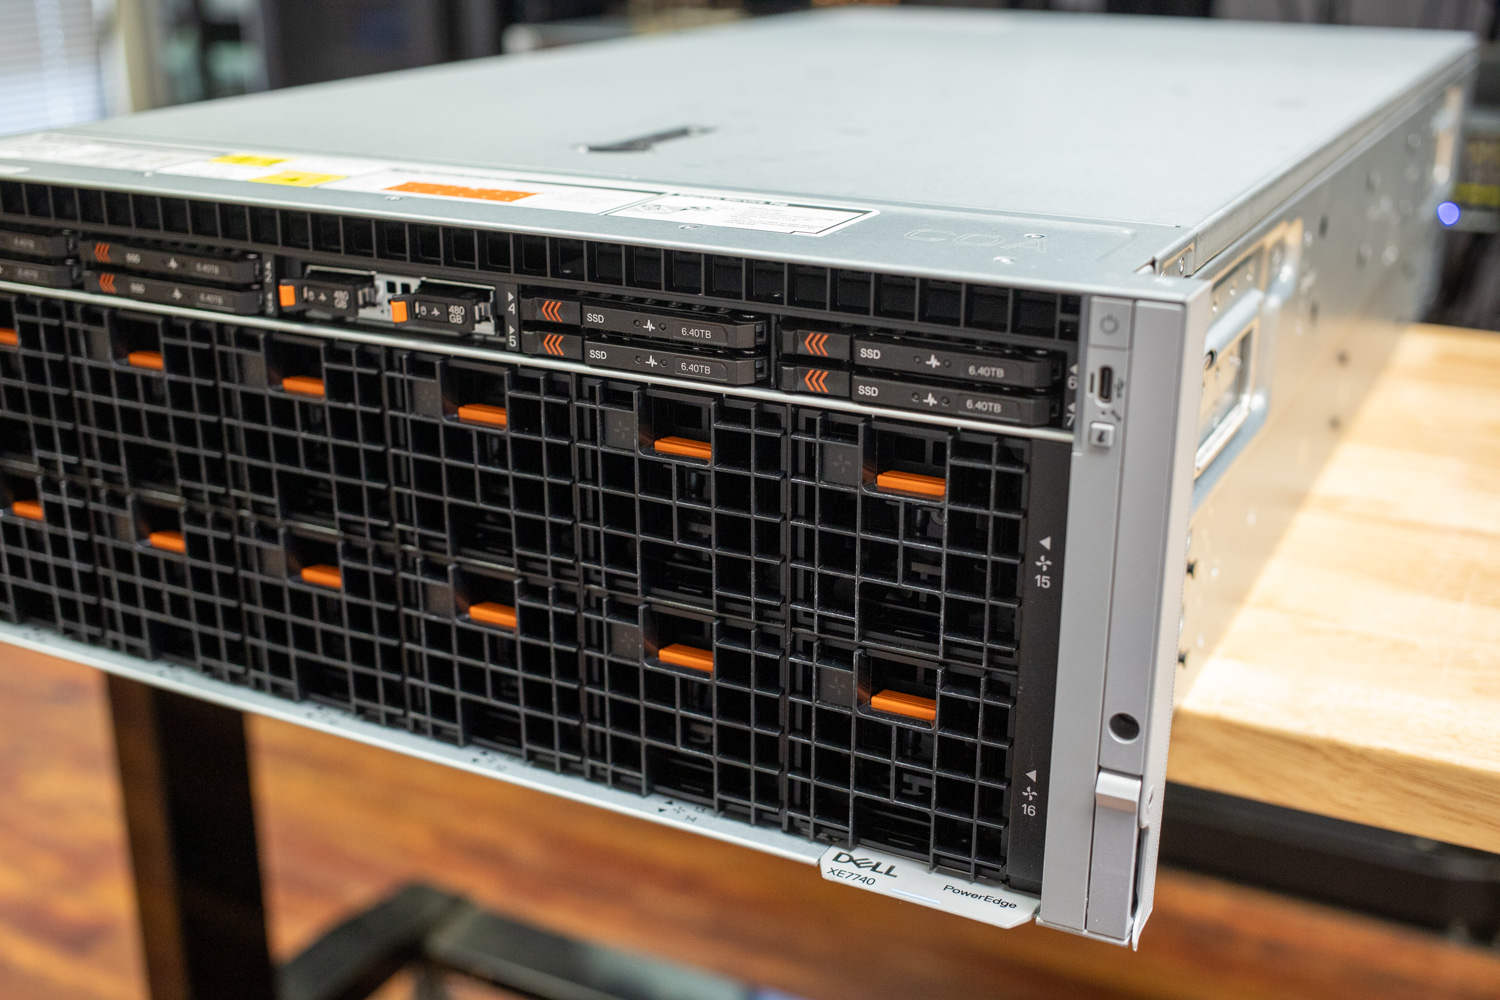
Anche la piattaforma che circonda gli acceleratori è stata progettata con cura. L'XE7740 si basa su processori Intel Xeon 6 e, nei sistemi focalizzati sull'inferenza, la CPU rimane un componente critico. L'elevato numero di core e la maggiore larghezza di banda della memoria forniscono il margine necessario per le attività di pianificazione, tokenizzazione, preelaborazione e orchestrazione che si trovano direttamente sul percorso critico dell'inferenza. Lo storage NVMe E3.S montato frontalmente supporta ulteriormente lo staging locale dei dati e l'offload della cache KV, riducendo il carico sugli acceleratori e migliorando l'efficienza complessiva del sistema. Questa progettazione bilanciata riflette la consapevolezza che le prestazioni di inferenza sono determinate dall'intero sistema, non solo dagli acceleratori.
L'XE7740 è progettato per scalare agevolmente nel tempo. Le organizzazioni possono iniziare con una configurazione modesta, ad esempio con due o quattro acceleratori, e ottenere subito un vantaggio senza dover riempire completamente lo chassis. Man mano che le esigenze crescono, la stessa piattaforma può scalare verticalmente o passare all'inferenza distribuita. Otto slot PCIe Gen5 x16 posteriori offrono una larghezza di banda dedicata per la rete ad alta velocità, consentendo all'XE7740 di fungere da elemento costitutivo per cluster di inferenza scalabili. Il supporto DPU opzionale estende ulteriormente questa flessibilità, alleggerendo il carico di lavoro relativo alla rete e alla comunicazione man mano che le implementazioni maturano.
Specifiche principali del Dell PowerEdge XE7740
| Specificazione | PowerEdge XE7740 |
|---|---|
| Caratteristiche del PowerEdge XE7740 | |
| Processore | Due processori Intel® Xeon® serie 6, con fino a 86 core per processore. |
| Slot machine | |
| Acceleratori PCIe | 8x PCIe Gen 5 x16 DW-FHFL fino a 600 W, oppure
16x PCIe Gen 5 x16 SW-FHFL fino a 75 W |
| Schede di rete PCIe |
|
| Fattore di forma | |
| Fattore di forma | Server rack 4U |
| Memorie | |
| velocità DIMM, capacità massima | Fino a 6400 MT/s, 4 TB max |
| Slot per moduli di memoria | 32 slot DIMM DDR5 Supporta solo moduli RDIMM ECC DDR5 registrati. |
| Archiviazione | |
| Baie anteriori | Fino a 8 NVMe (SSD) EDSFF E3.S Gen5, massimo 122.88 TB |
| Controller di archiviazione | |
| Avvio interno | Sottosistema di archiviazione ottimizzato per l'avvio (BOSS-N1 DC-MHS): HWRAID 1, 2 x M.2
SSD NVMe |
| Alimentazione elettrica | |
| Alimentazione elettrica | 3200 W Titanio 200-240 V CA o 240 V CC, ridondante hot swap
Multicapacità per alimentatore da 3200 W:
Multicapacità per alimentatore da 2400 W:
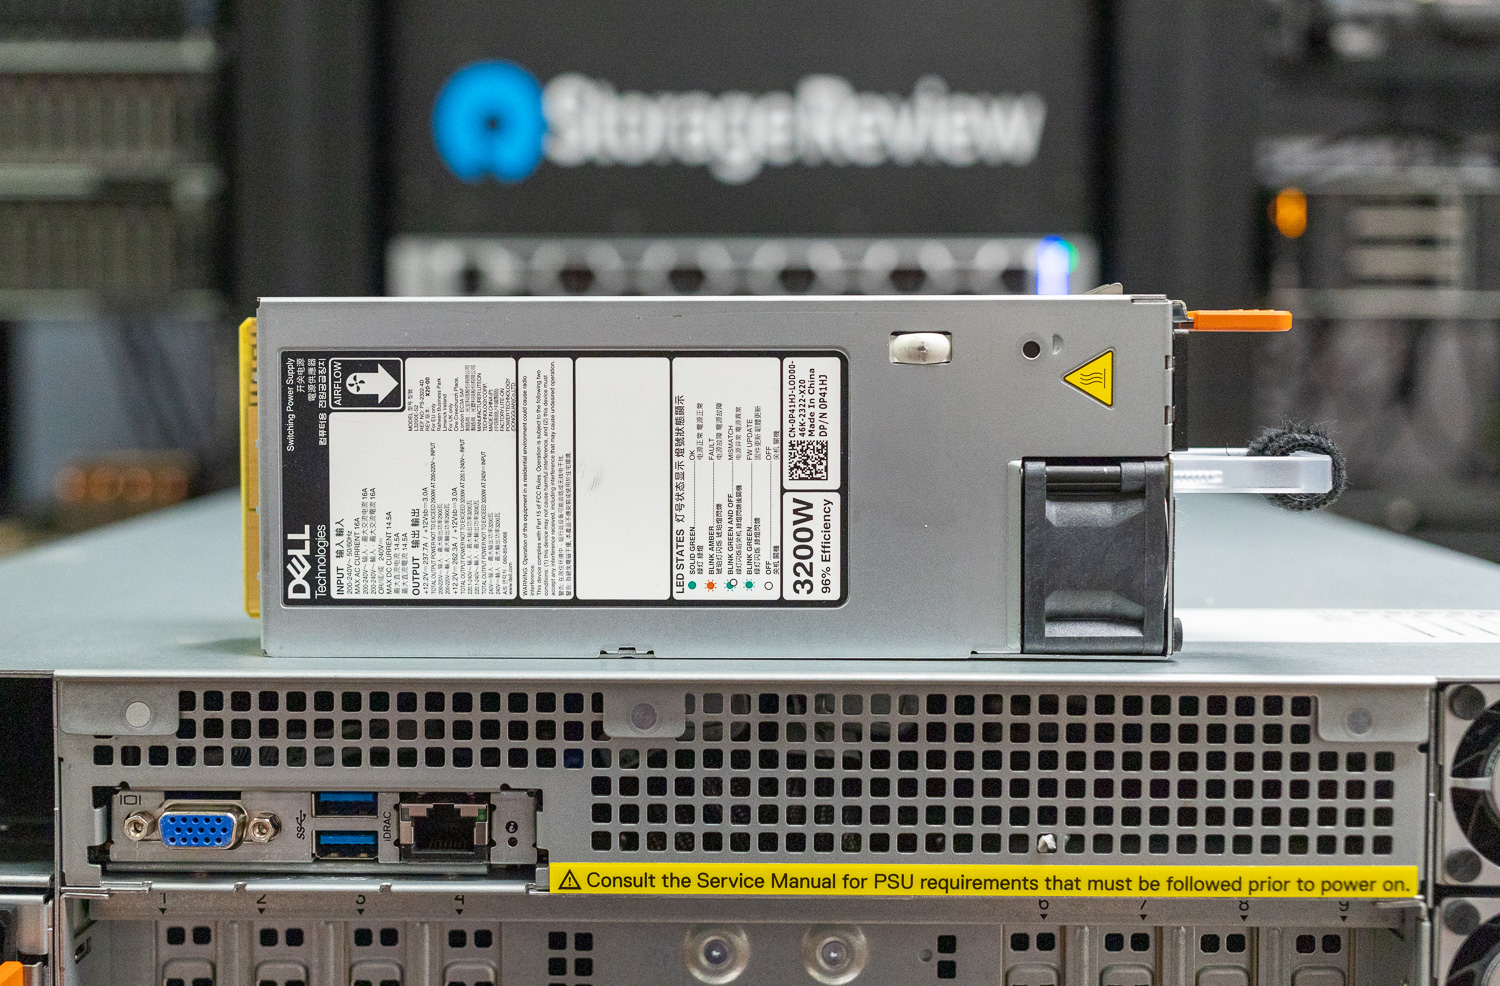
ATTENZIONE: Il sistema richiede almeno un alimentatore nella zona CPU e un alimentatore nella zona GPU per mantenere l'alimentazione del BMC e in modalità standby. Se nella zona GPU non è installato alcun alimentatore, il sistema rimarrà in standby. Per garantire la massima ridondanza, installare N+N alimentatori in ciascuna zona: 1+1 nella zona CPU e 3+3 nella zona GPU. La rimozione di tutti gli alimentatori dalla zona CPU mentre il sistema è acceso provocherà un arresto immediato e potrebbe causare la perdita di dati. |
| Opzioni di raffreddamento | |
| Opzioni di raffreddamento | Raffreddamento ad aria |
| Fan | Fino a quattro set di ventole ad alte prestazioni (HPR) di grado platino (modulo a doppia ventola) installabili nel vassoio centrale
Fino a dodici ventole ad alte prestazioni (HPR) di grado platino installate sulla parte anteriore del sistema Sono tutti fan dello scambio a caldo |
| porte | |
| Opzioni di rete | 1 I/O PCIe Gen 5 compatibile con OCP 3.0 (supportato da 8 linee PCIe) |
| Porte anteriori | 1 porta USB 2.0 di tipo A (opzionale) 1 porta Mini DisplayPort (opzionale) 1 porta USB 2.0 Type-C dual mode (Host/porta iDRAC Direct) |
| Porte posteriori | 1 porta Ethernet dedicata iDRAC/BMC Direct 2 porte USB 3.1 di tipo A 1 x VGA |
| Porte interne | 1 x USB 3.1 Tipo-A |
Progettazione e realizzazione del modello XE7740
Architettura a doppia zona: separazione di CPU e GPU
Una delle scelte di design più distintive dell'XE7740 è la sua separazione fisica in due zone termiche e di alimentazione separate. La sezione superiore da 1U ospita la zona CPU, che comprende entrambi i processori Xeon 6, tutti i 32 slot DIMM, lo storage e il modulo di gestione DC-SCM. La zona CPU utilizza quattro set di moduli a doppia ventola ad alte prestazioni (40×40×56 mm) che forniscono un flusso d'aria di 47.4 CFM.
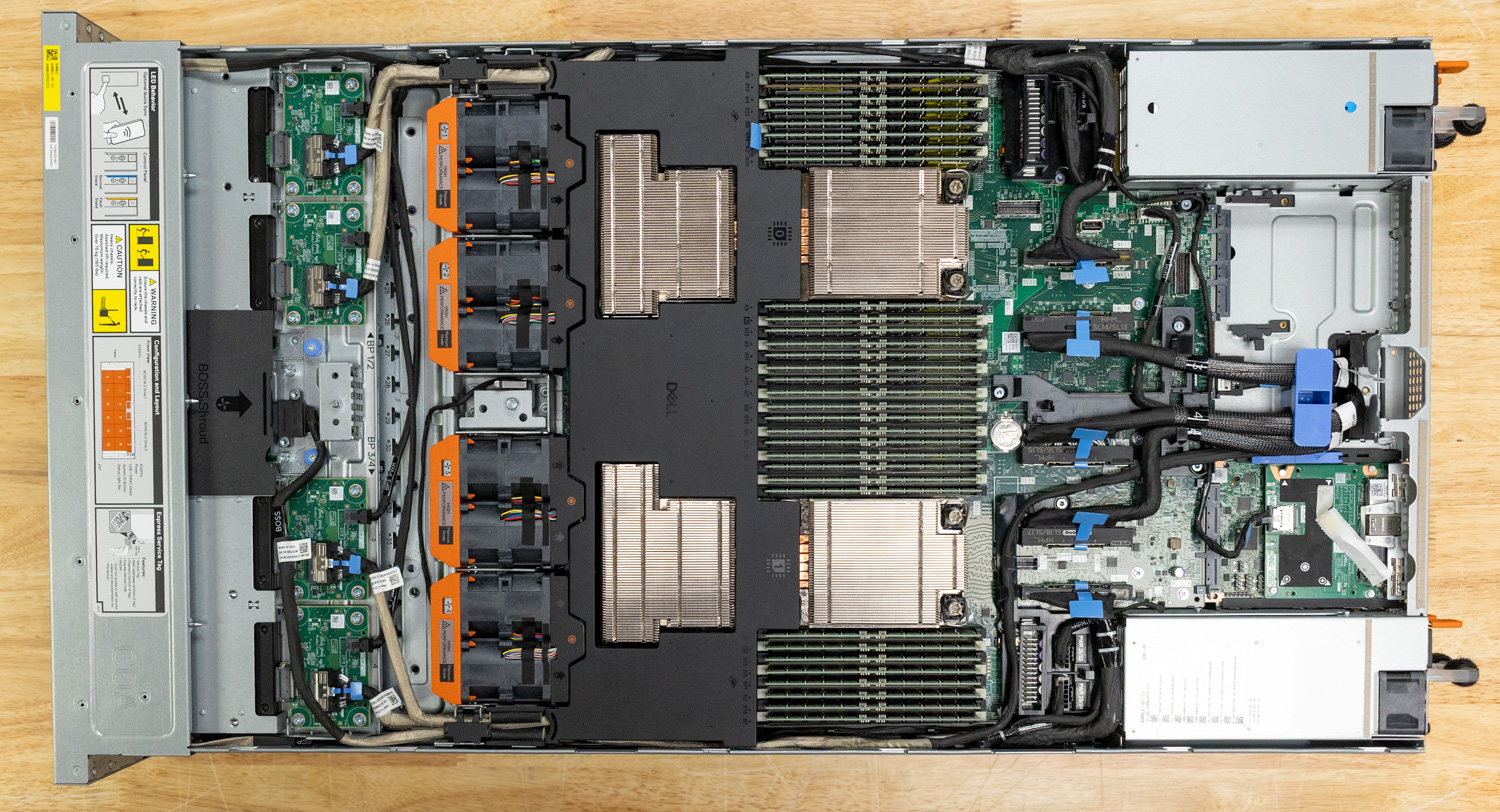
La sezione inferiore 3U è la zona GPU, che contiene tutti gli slot per acceleratori con la propria infrastruttura di raffreddamento dedicata, insieme alla scheda base PCIe (PBB), agli slot di espansione PCIe posteriori e alla connettività OCP NIC. La zona GPU utilizza dodici ventole ad alte prestazioni di grandi dimensioni (60×60×56 mm) con una capacità di flusso d'aria significativamente superiore, fino a 122.2 CFM per ventola, rispetto alle ventole della CPU. Tutte le ventole sono sostituibili a caldo. Questo approccio di raffreddamento a doppia zona significa che le esigenze termiche degli acceleratori ad alto TDP (fino a 600 W per scheda) non compromettono il raffreddamento di CPU e memoria, e viceversa, in un rack standard da 19 pollici.
Dell ha dedicato particolare attenzione all'ottimizzazione del flusso d'aria nel case XE7740. I sistemi con un'elevata densità di acceleratori richiedono intrinsecamente un cablaggio interno considerevole, inclusi i cavi di alimentazione ausiliaria della GPU, i cavi di segnale PCIe tra la scheda HPM e la PBB e i connettori per la scheda delle ventole. Nell'XE7740, questi cavi sono instradati lungo le pareti laterali dello chassis utilizzando apposite staffe e coperture per cavi. Ogni cavo è realizzato esattamente della lunghezza necessaria; non ci sono fasci di cavi in eccesso all'interno del sistema. Mantenendo i cavi al di fuori del canale centrale di flusso d'aria, il design preserva un percorso di flusso d'aria libero dalla parte anteriore a quella posteriore e riduce al minimo l'impedenza nelle zone di raffreddamento di CPU e GPU.
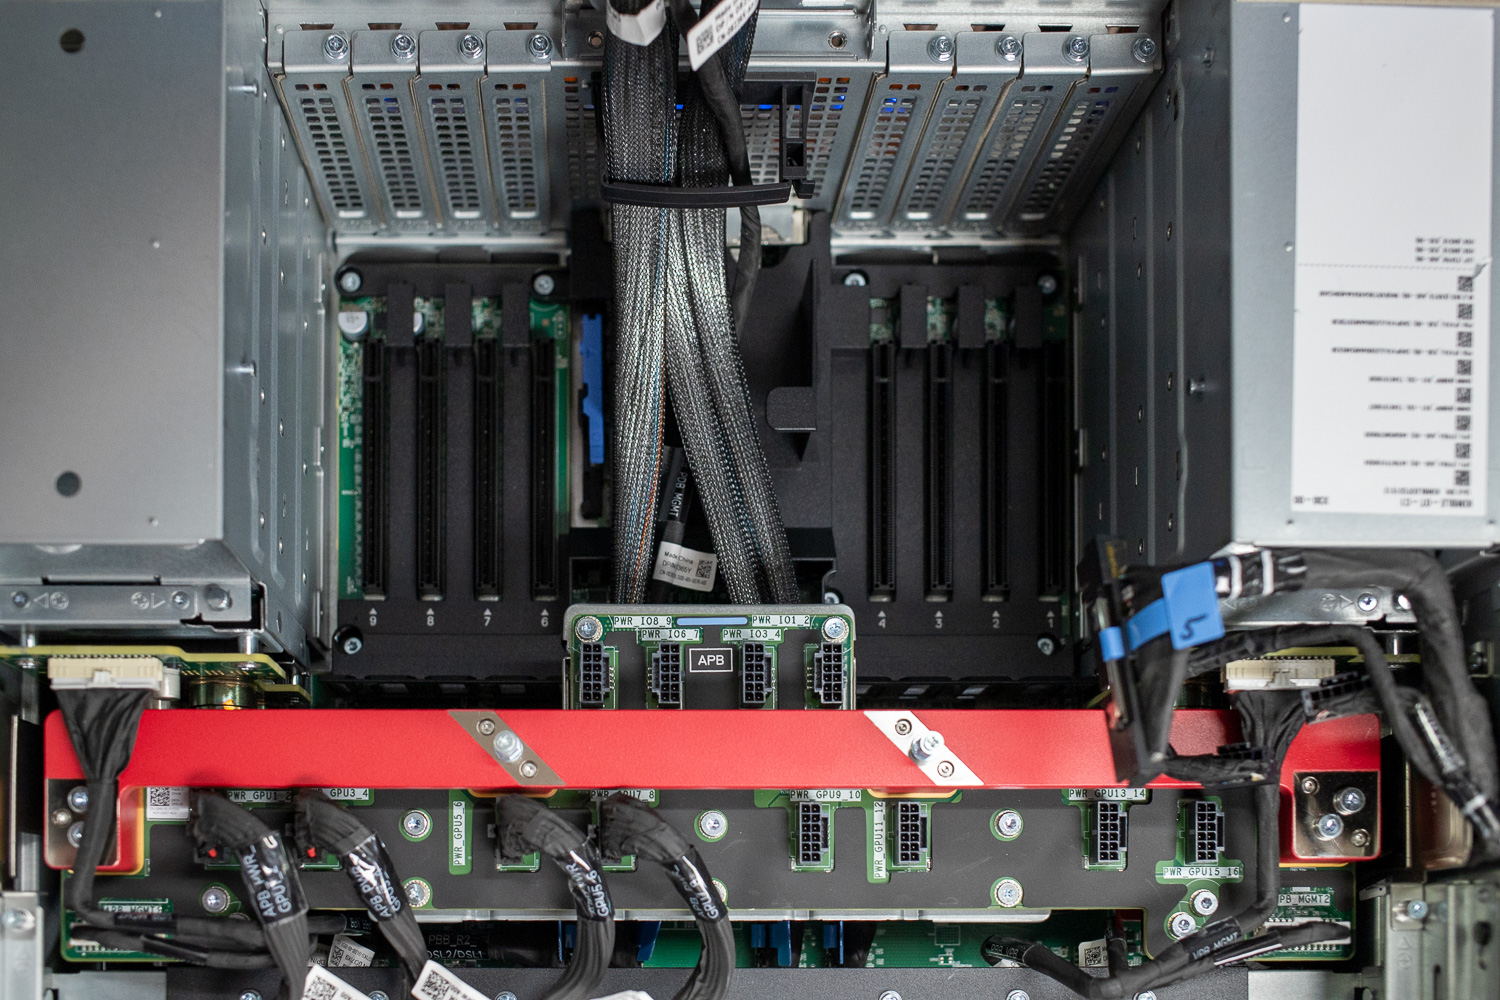
In uno chassis che ospita fino a otto acceleratori da 600 W, anche piccole ostruzioni nel flusso d'aria possono creare punti caldi localizzati e costringere le ventole a funzionare a velocità più elevate, aumentando sia il consumo energetico che la rumorosità. La soluzione di Dell per la gestione dei cavi mantiene libero il centro dello chassis, garantendo un flusso d'aria diretto e senza ostacoli sui componenti che ne hanno più bisogno.
Topologia e flusso di dati degli switch PCIe
Il sottosistema PCIe dell'XE7740 è costruito attorno a quattro switch PCIe Gen 5 sulla PBB (PCIe Base Board), denominati da SW1 a SW4. Questi switch costituiscono la spina dorsale dell'architettura I/O del sistema, collegando acceleratori, rete e storage ai due processori Xeon 6 in una topologia attentamente organizzata.
I 16 slot GPU interni sono suddivisi in due banchi da otto, ciascuno servito da una coppia di switch PCIe, ognuno collegato a monte a una CPU. All'interno di ciascun banco, coppie di slot GPU adiacenti a doppia larghezza si intersecano sui due switch. Sul lato CPU0, SW1 serve gli slot GPU 21 e 25, nonché gli slot PCIe posteriori 8 e 9, mentre SW2 serve gli slot GPU 23 e 27, nonché gli slot PCIe posteriori 6 e 7. Sul lato CPU1, SW3 serve gli slot GPU 29 e 33, nonché gli slot PCIe posteriori 3 e 4, mentre SW4 serve gli slot GPU 31 e 35, nonché gli slot PCIe posteriori 1 e 2.

Ciascun dominio CPU, pertanto, possiede quattro slot acceleratori a doppia larghezza, quattro slot NIC/I/O posteriori e quattro degli otto alloggiamenti di storage NVMe E3.S anteriori. Questa topologia di switch ha implicazioni significative per il flusso di dati, in particolare per il traffico basato su RDMA. Poiché ogni switch ospita sia slot acceleratori che slot NIC posteriori, un acceleratore e una scheda di rete sullo stesso switch possono eseguire trasferimenti RDMA interamente all'interno della struttura dello switch. I dati non devono mai attraversare il root complex della CPU, eliminando il buffer di rimbalzo della CPU che sarebbe altrimenti necessario quando un dispositivo PCIe su una porta root comunica con un dispositivo su un'altra. Ciò riduce la latenza, evita di consumare la preziosa larghezza di banda della memoria della CPU e libera cicli della CPU per altre attività.
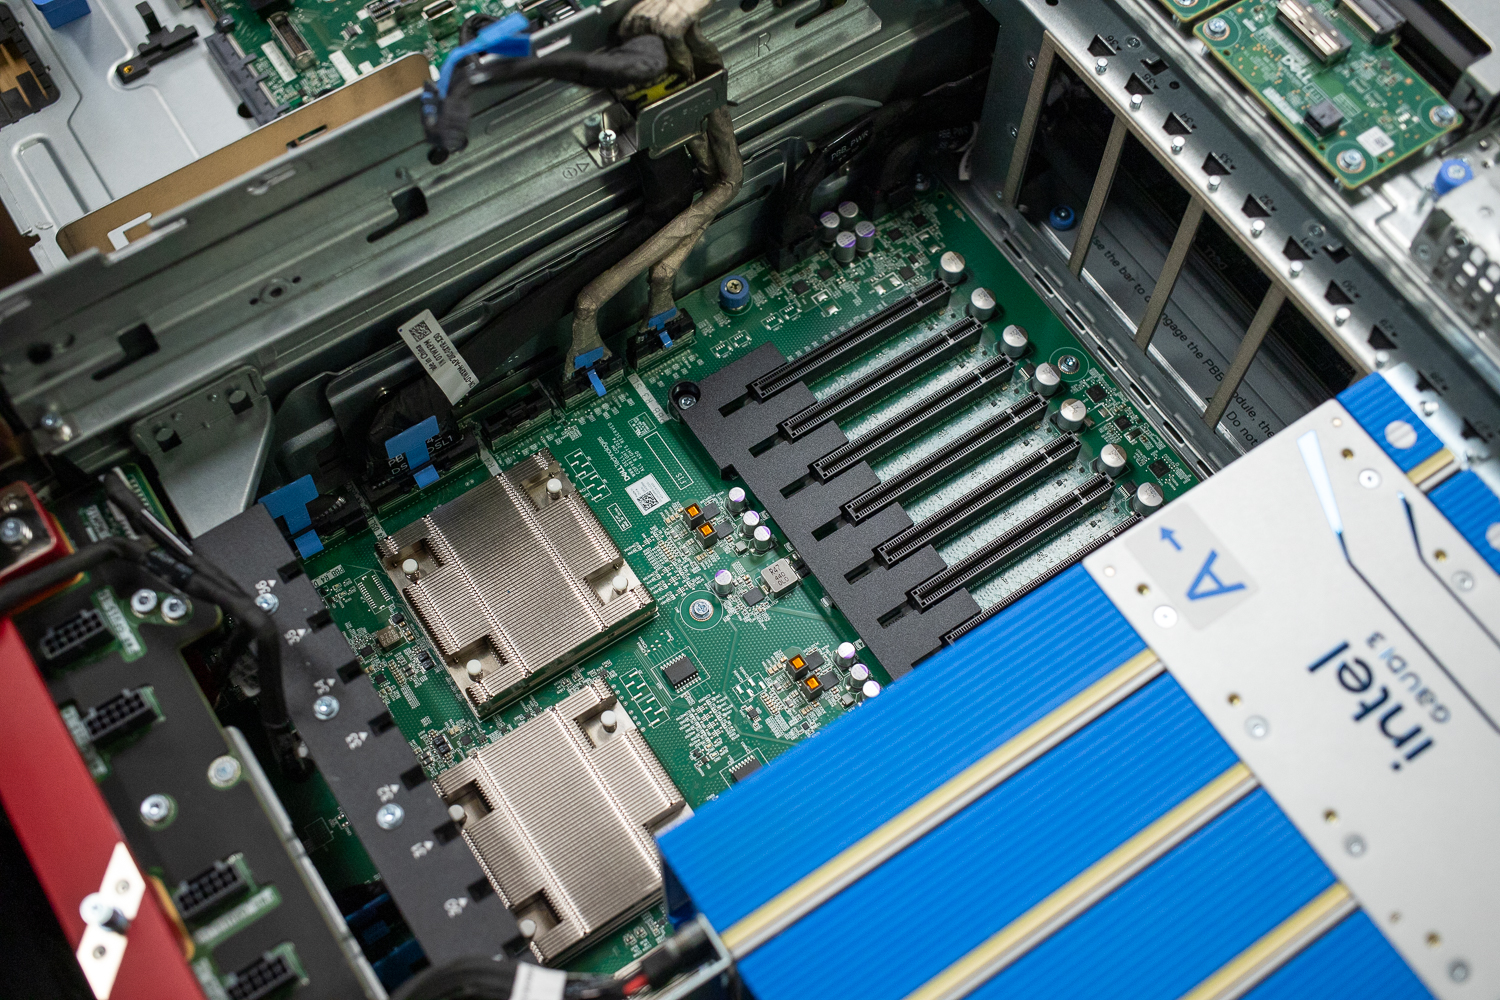
La comunicazione all'interno del dominio di una singola CPU tra i suoi due switch passa attraverso il root complex della CPU, ma rimane locale a quel socket. La comunicazione tra CPU diverse, tuttavia, deve attraversare i collegamenti UPI tra i due processori Xeon 6. Il 6787P offre quattro collegamenti UPI 2.0 a 24 GT/s ciascuno, garantendo una larghezza di banda inter-socket considerevole. Tuttavia, il traffico tra un acceleratore sul banco di switch della CPU0 e una scheda di rete sul banco di switch della CPU1 avrà intrinsecamente una latenza maggiore rispetto ai trasferimenti locali allo switch o allo stesso socket.
Gli switch stessi non sono direttamente interconnessi. Tutto il traffico tra gli switch passa attraverso il root complex della CPU, quindi è importante comprendere l'affinità tra slot GPU, slot NIC, storage e socket CPU. Per semplificare questa complessità per le organizzazioni, Dell offre configurazioni validate e ottimizzate per gli acceleratori più diffusi.
Alimentatore a doppia zona
Il sistema di alimentazione dell'XE7740 rispecchia la sua architettura termica con un design a doppia zona piuttosto insolito. Il sistema supporta fino a otto alimentatori sostituibili a caldo, suddivisi in due zone: la Zona 1 (zona CPU) ospita gli alimentatori 1 e 2, mentre la Zona 2 (zona GPU) ospita gli alimentatori da 3 a 8.
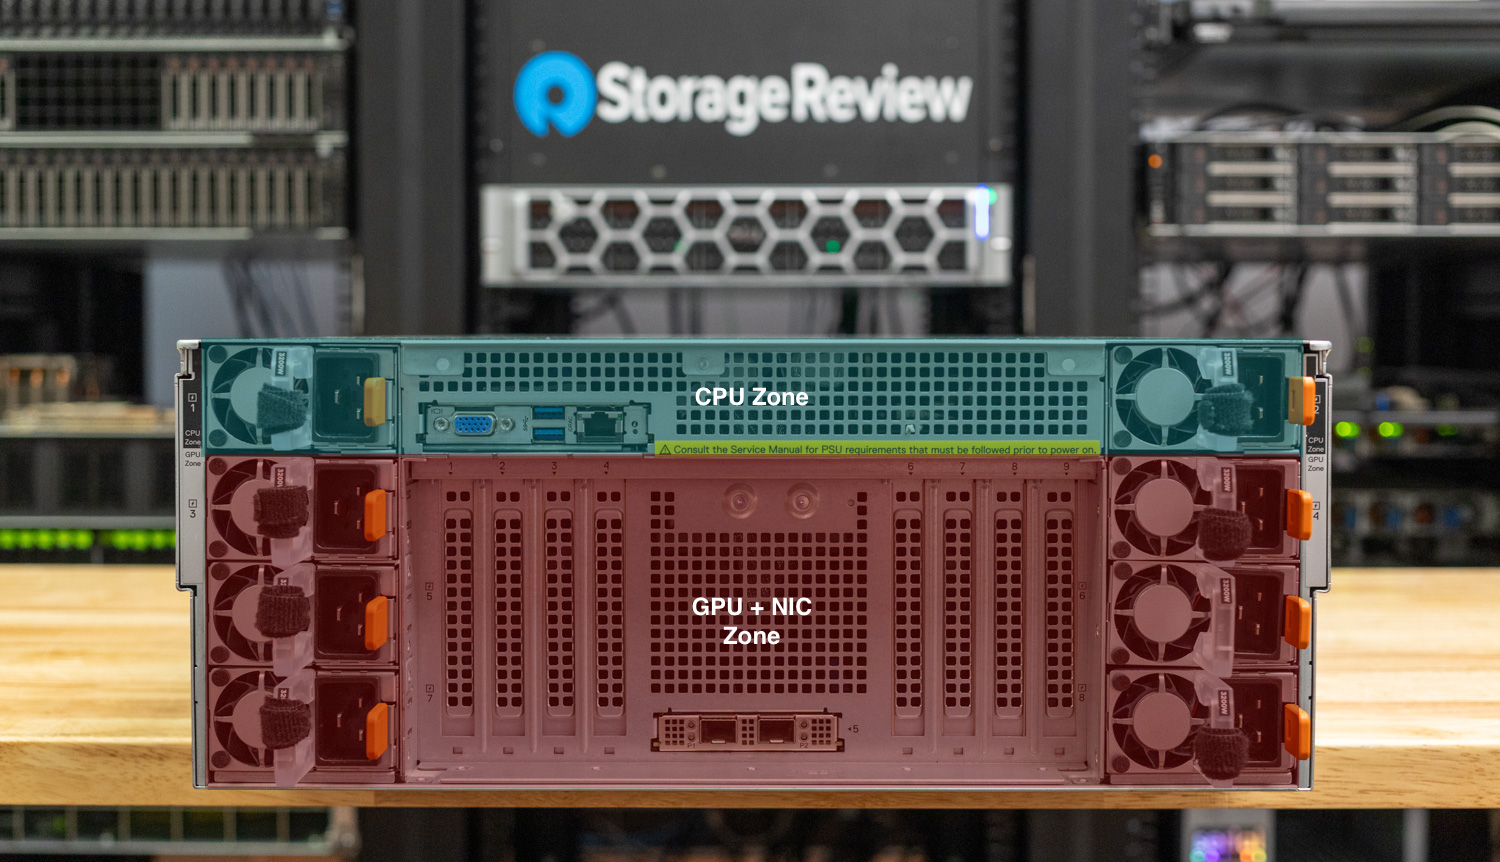
Il sistema richiede almeno un alimentatore in ciascuna zona per mantenere l'alimentazione del BMC e dello standby. Se una delle zone perde l'alimentazione CA mentre il sistema è in funzione, quest'ultimo si arresta immediatamente per evitare la perdita di dati. Le zone sono interdipendenti per il funzionamento, sebbene siano fisicamente ed elettricamente separate. Per una ridondanza completa, Dell raccomanda una configurazione 1+1 nella zona CPU e una configurazione 3+3 nella zona GPU, il che significa che tutti gli otto alloggiamenti per alimentatori devono essere occupati per una distribuzione completamente ridondante.
Dell AIOps, gestione e affidabilità aziendale
La piattaforma PowerEdge di Dell si è guadagnata una solida reputazione nel settore per affidabilità e facilità di manutenzione. I clienti aziendali sottolineano costantemente gli stessi aspetti: i sistemi PowerEdge sono costruiti per durare, l'assistenza clienti di Dell risolve rapidamente i problemi e gli strumenti di gestione sono maturi e ben integrati. L'XE7740 prosegue questa tradizione e Dell ha compiuto progressi significativi sia nella gestione hardware che nella sicurezza con questa generazione.
iDRAC10
Lo XE7740 è dotato del controller iDRAC 10 di nuova generazione di Dell, un sostanziale aggiornamento rispetto al già valido iDRAC 9 su cui i clienti Dell fanno affidamento da anni. Implementato come modulo di controllo sicuro per data center (DC-SCM) in conformità con lo standard OCP DC-MHS, iDRAC 10 non è un semplice aggiornamento del firmware, ma rappresenta un nuovo hardware. Il controller è dotato di quattro core da 1 GHz con architettura a 64 bit e 2 GB di memoria DDR4 (il doppio rispetto alla generazione precedente), offrendo prestazioni e reattività notevolmente migliorate per le operazioni di gestione.
Sul fronte della sicurezza, iDRAC 10 introduce diversi miglioramenti significativi. La piattaforma offre un supporto crittografico più robusto a 360 gradi, inclusi l'autenticazione SHA-384 e SHA-512 e la crittografia AES-256 a prova di computer quantistici, in quanto il settore si prepara alle minacce crittografiche post-quantistiche. Un'enclave di sicurezza integrata dedicata all'interno del chip iDRAC 10 gestisce le funzioni di resilienza informatica, tra cui l'attestazione a livello di dispositivo e la Root-of-Trust personalizzata di Dell. Questa Root-of-Trust basata su hardware garantisce che tutto il firmware (BIOS, iDRAC e firmware dei componenti) venga verificato crittograficamente prima dell'esecuzione, proteggendo dagli attacchi alla catena di fornitura e dalla manomissione del firmware.
La verifica sicura dei componenti (Secure Component Verification) garantisce che i sistemi consegnati dagli stabilimenti Dell arrivino con i componenti e le configurazioni esatte specificate dal cliente, mantenendo l'integrità dalla produzione fino all'installazione. Il firmware iDRAC 10 più recente offre inoltre un'interfaccia utente modulare rinnovata che migliora l'esperienza amministrativa quotidiana.
ApriGestisci impresa
Per la gestione di flotte su larga scala, Dell OpenManage Enterprise offre monitoraggio centralizzato, aggiornamenti del firmware e gestione della configurazione per intere implementazioni PowerEdge. Una recente e importante novità per le implementazioni incentrate sull'IA è la possibilità, offerta da OME, di visualizzare direttamente le statistiche di GPU e acceleratori: consumo energetico, temperatura, utilizzo, numero di errori e altro ancora, senza la necessità di strumenti specifici di alcun fornitore. Per le organizzazioni che gestiscono decine o centinaia di nodi XE7740 in un cluster di inferenza, questa piattaforma di gestione unificata rappresenta una significativa semplificazione operativa.
Intel Xeon 6
Il cuore del XE7740 è costituito da due processori Intel Xeon 6 6787P, il modello di punta della serie Xeon 6700P. Basato sull'architettura Granite Rapids con tecnologia Intel a 3 nm, il 6787P offre 86 core P (172 thread) per socket con un TDP di 350 W, una frequenza base di 2.0 GHz e una frequenza turbo di 3.8 GHz.
Ciò che rende Granite Rapids particolarmente rilevante per le infrastrutture di intelligenza artificiale è la combinazione tra l'elevato numero di core e il sottosistema di memoria. Ogni processore 6787P offre otto canali di memoria DDR5 fino a 6400 MT/s. Con un processore XE7740 a doppio socket dotato di 32 DIMM, il sistema può essere configurato per una memoria di sistema totale fino a 4 TB.
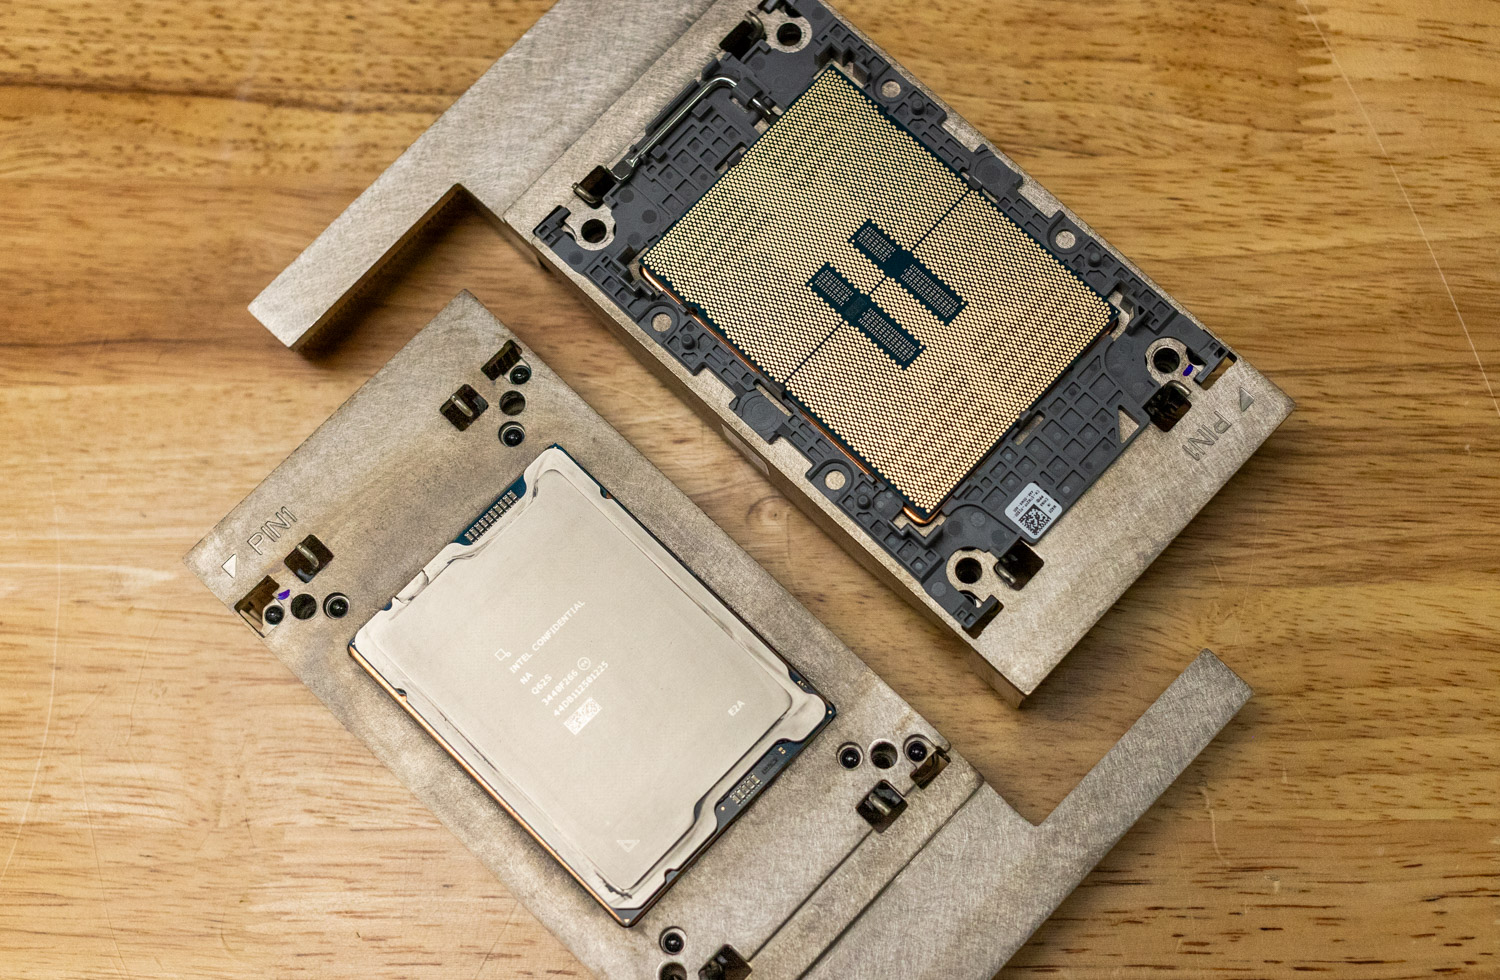
La capacità di memoria e la larghezza di banda sono fondamentali per i carichi di lavoro di intelligenza artificiale, soprattutto quando si utilizza l'offload della cache KV. Man mano che i modelli linguistici di grandi dimensioni aumentano la lunghezza del contesto, la cache KV si ridimensiona proporzionalmente e può consumare una quantità significativa di memoria dell'acceleratore. L'offload di porzioni della cache KV sulla memoria di sistema o su storage veloce consente di utilizzare la memoria HBM dell'acceleratore in modo più efficiente per i calcoli attivi, riducendo il tempo al primo token (TTFT) per le chat multi-turno.
Vale anche la pena menzionare le unità tensoriali AMX dello Xeon 6, che gestiscono una parte significativa del lavoro lato CPU. Queste includono la preelaborazione, la tokenizzazione e le attività di inferenza ibrida che coinvolgono operazioni matriciali. Ciò risulta particolarmente utile con framework di inferenza come SGLang, che utilizzano la CPU per Radix Tree per la gestione della cache KV e la pianificazione Zero Overhead.
Schede aggiuntive Intel Gaudi 3: inferenza competitiva su larga scala
Gaudi 3 di Intel è l'acceleratore AI di punta dell'azienda, lanciato nel quarto trimestre del 2024. Intel sta posizionando questi acceleratori in modo molto aggressivo, piuttosto che competere direttamente con gli acceleratori di training per data center di fascia alta. Gaudi 3 è pensato specificamente per il segmento dell'inferenza.
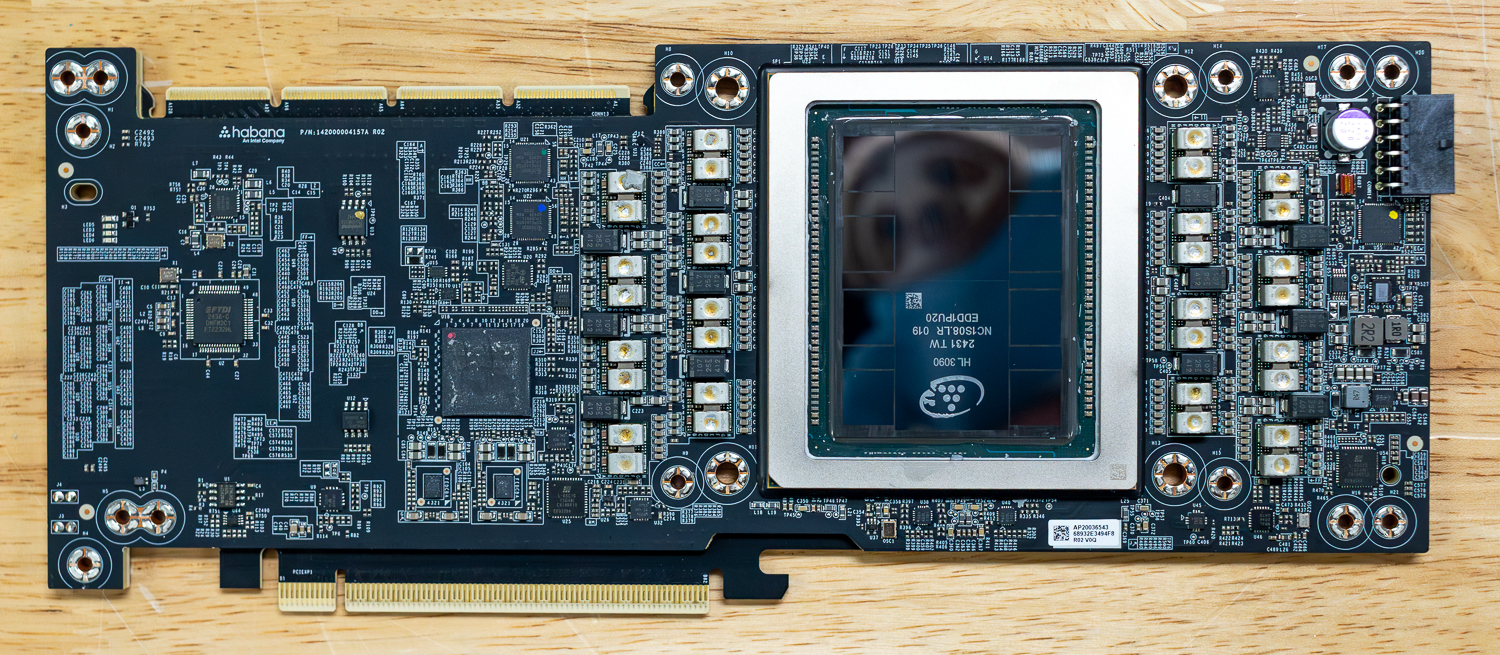
L'inferenza del modello basata su Transformer in tutti i modelli LLM più diffusi oggi è fondamentalmente limitata dalla memoria. Durante la fase di decodifica della generazione autoregressiva, il modello genera i token uno alla volta, leggendo i pesi del modello e le voci della cache KV per ogni token prodotto. Il collo di bottiglia non è la capacità di calcolo, bensì la larghezza di banda della memoria, ovvero la velocità con cui l'acceleratore può trasmettere i dati dall'HBM ai motori di calcolo.
Il Gaudi 3 è dotato di 128 GB di memoria HBM2e con una larghezza di banda di 3.7 TB/s. Dal punto di vista architetturale, il Gaudi 3 è realizzato con il processo a 5 nm di TSMC e utilizza un design a doppio chiplet: due chip di silicio identici uniti da un'interconnessione ad alta larghezza di banda, che si presentano al software come un singolo dispositivo unificato. L'elaborazione è organizzata in quattro Deep Learning Core (DCORE), ciascuno contenente 2 MME, 16 TPC e 24 MB di cache SRAM locale. I 96 MB totali di SRAM on-die forniscono una larghezza di banda interna di 12.8 TB/s. L'acceleratore integra anche 14 decoder multimediali dedicati (H.265, H.264, JPEG, VP9), consentendo una rapida preelaborazione delle immagini per carichi di lavoro multimodali.
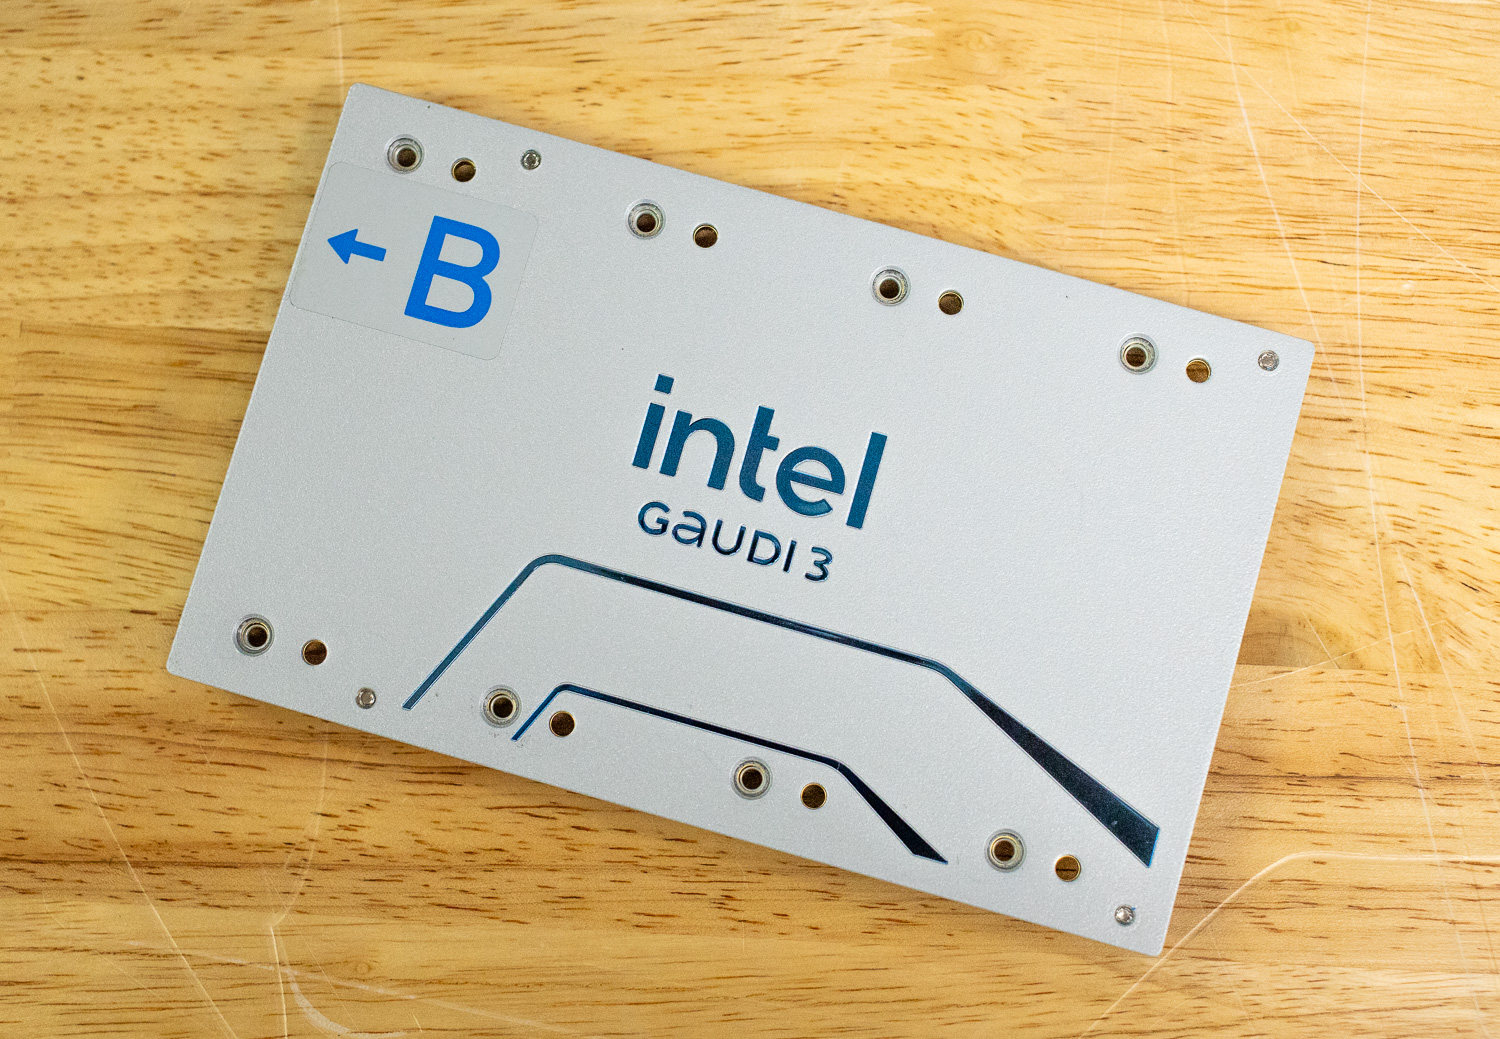
Gran parte dei modelli di intelligenza artificiale open-source all'avanguardia rilasciati oggi sono o modelli nativamente addestrati in FP8 o modelli ibridi che combinano pesi FP8 (E4M3) e BF16. Il Gaudi 3 offre un'accelerazione FP8 nativa per questi modelli grazie ai suoi 8 motori di moltiplicazione di matrici e 64 core di elaborazione tensoriale, fornendo 1.8 PFlops di calcolo FP8.
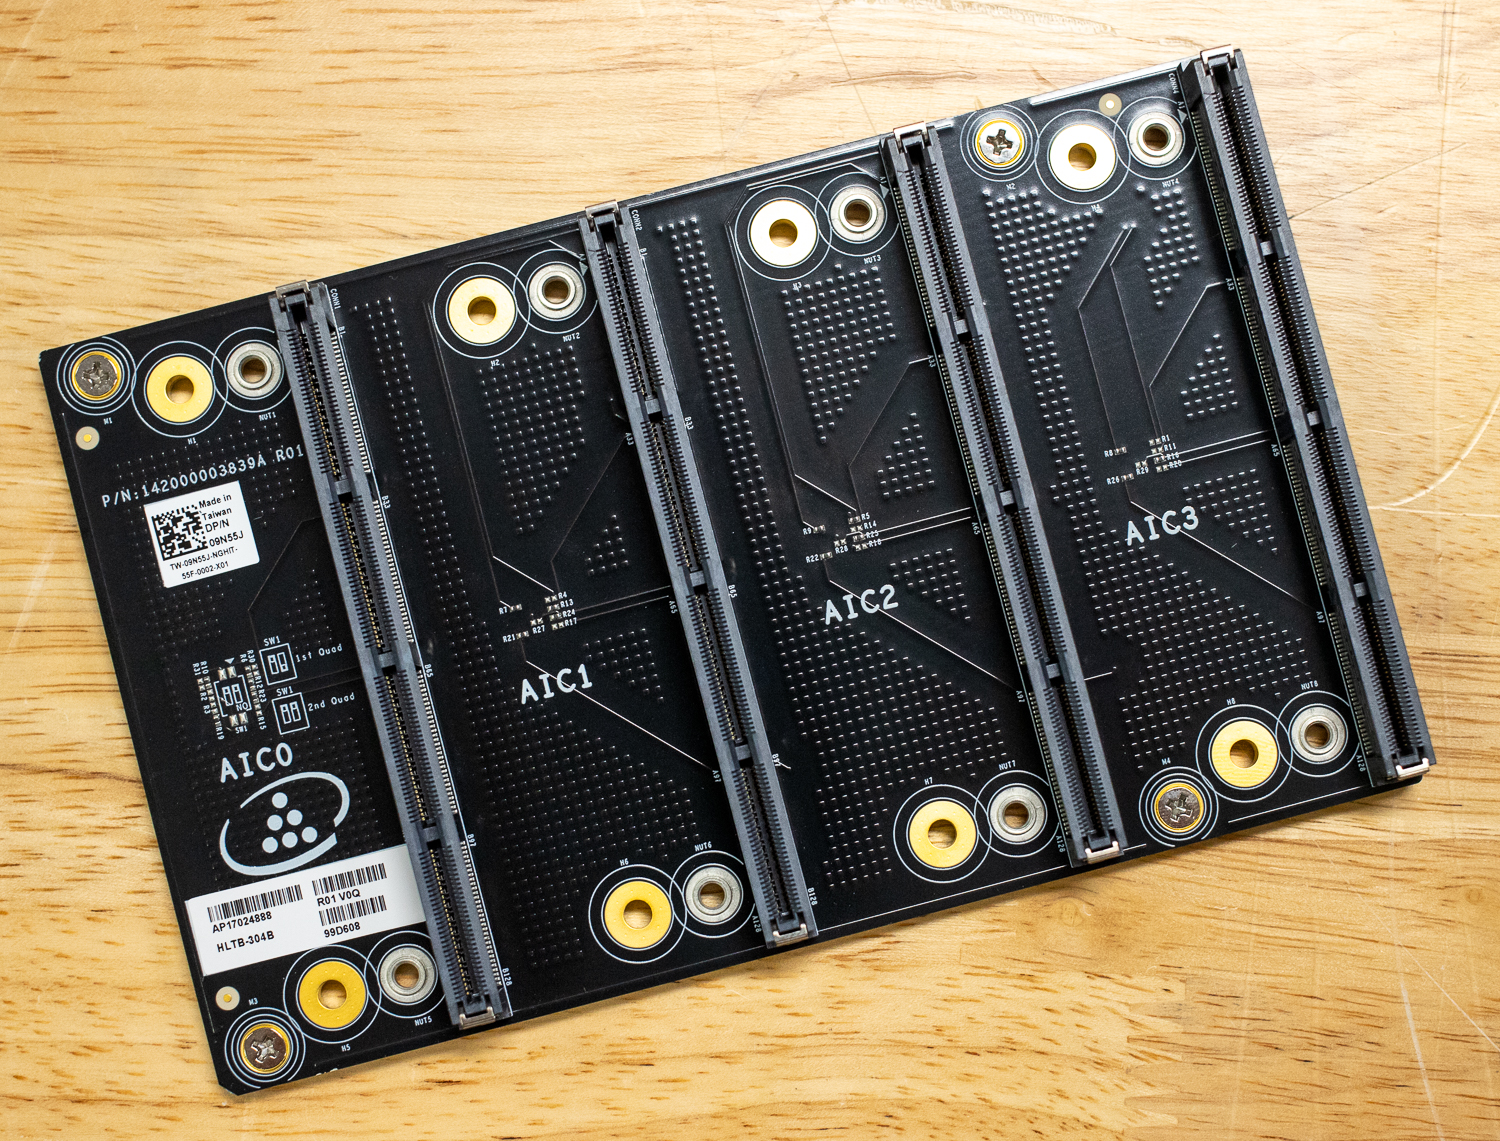
Il Gaudi 3 integra anche la rete RDMA over Converged Ethernet (RoCEv2) con 24 porte 200 GbE nella versione OAM, integrate direttamente nel chip. Sebbene la variante con scheda aggiuntiva PCIe utilizzata nell'XE7740 non esponga tutte queste porte allo stesso modo, le varianti con scheda aggiuntiva supportano il bridging di 4 schede per una comunicazione più veloce tra di esse.
Prestazioni e benchmark
Dettagli di configurazione dell'XE7740:
- 2 processori Intel Xeon 6787P (86 core, 2.00 GHz)
- 2 TB DDR5 (32 x 64 GB 5200 MT/s DDR5
- 4 x Intel Gaudi 3 PCIe AI Accelerator con 128 GB di HBM
- Ubuntu 24.04.5 Server
Prestazioni del servizio online vLLM
Per valutare le capacità di inferenza del Dell XE7740 con acceleratori Intel Gaudi 3, abbiamo eseguito un benchmark delle prestazioni di vLLM online serving su una serie di modelli diffusi, caratterizzati da diverse architetture, numero di parametri e formati di precisione. Ciascun modello è stato testato su tre profili di carico di lavoro con un numero di richieste simultanee variabile da 1 a 128.
L'inferenza LLM si compone di due fasi distinte. La fase di pre-riempimento elabora tutti i token di input in parallelo prima che possa essere generato qualsiasi token di output, rendendola un'operazione computazionalmente intensiva che scala linearmente con il numero di token di input. La fase di decodifica genera quindi i token di output uno alla volta (in modo autoregressivo), dove ogni nuovo token richiede la lettura dei pesi completi del modello dalla memoria, ma esegue un numero relativamente ridotto di calcoli per token, risultando quindi limitata dalla larghezza di banda della memoria.
Queste due fasi sollecitano parti fondamentalmente diverse dell'acceleratore, quindi testiamo tre profili di carico di lavoro che modificano l'equilibrio tra di esse:
- Un numero uguale di token (1024 in ingresso e 1024 in uscita) rappresenta interazioni di chat bilanciate.
- Prefill Heavy (8192 input/1024 output) simula la generazione aumentata tramite recupero o la sintesi di contesti lunghi, in cui il sistema deve elaborare ampi contesti di input.
- Decode Heavy (1024 input/8192 output) rappresenta la generazione di contenuti di lunga durata in cui la larghezza di banda della memoria sostenuta determina la velocità di elaborazione.
In questa sezione ci concentriamo su due metriche principali. Il throughput totale dei token, misurato in token al secondo, rappresenta la capacità di servizio complessiva del sistema sotto carico. Il tempo al primo token (TTFT) misura il ritardo tra l'invio di una richiesta e la ricezione del primo token generato. Poiché il modello deve completare l'intera fase di pre-riempimento prima di poter emettere il primo token, il TTFT è direttamente correlato al throughput di calcolo dell'acceleratore. Questo rende lo scenario con pre-riempimento intensivo (combinato con il TTFT) un indicatore particolarmente utile per comprendere le capacità di calcolo effettive degli acceleratori Gaudi 3, dato che il sistema deve elaborare tutti gli 8,192 token di input prima che l'utente visualizzi una qualsiasi risposta.
Al contrario, lo scenario con un elevato numero di decodifiche mette alla prova la larghezza di banda della memoria degli acceleratori, poiché il sistema deve mantenere un throughput elevato per migliaia di token generati. Il TTFT (Time To First Time) è fondamentale per le applicazioni interattive in cui gli utenti attendono una risposta prima che lo streaming possa iniziare. Un sistema può raggiungere un throughput eccellente con un'elaborazione batch intensiva, ma risultare comunque lento se il TTFT aumenta eccessivamente; pertanto, entrambe le metriche sono importanti per le implementazioni in produzione.
Una nota sui risultati di precisione FP8: sebbene gli acceleratori Intel Gaudi 3 includano l'accelerazione di calcolo FP8 nativa (e FP8 dovrebbe, in teoria, offrire una velocità di elaborazione superiore a BF16), i valori di prestazioni FP8 nei nostri benchmark sono inferiori a quelli di BF16. Non si tratta di una limitazione hardware, bensì di un problema di maturità del software nella versione di vLLM sviluppata da Intel. La versione che abbiamo testato (vLLM installer 2.7.1 su Gaudi Docker 1.22.2) non ha ancora ottimizzato completamente i percorsi del codice FP8. Intel ha una nuova versione di vLLM basata su plugin, attualmente in fase beta, che potrebbe risolvere molti di questi problemi di prestazioni.
Lama 3.1 8B Istruzioni
Llama 3.1 8B Instruct è un modello transformer denso di Meta, il che significa che ogni parametro è attivo per ogni token generato. Con 8 miliardi di parametri, è tra i modelli open-source più diffusi. I modelli di queste dimensioni sono popolari per attività quotidiane come riassumere documenti brevi, redigere email e messaggi, rispondere a domande semplici e alimentare interazioni chatbot basilari, dove velocità ed efficienza dei costi sono più importanti del ragionamento complesso.
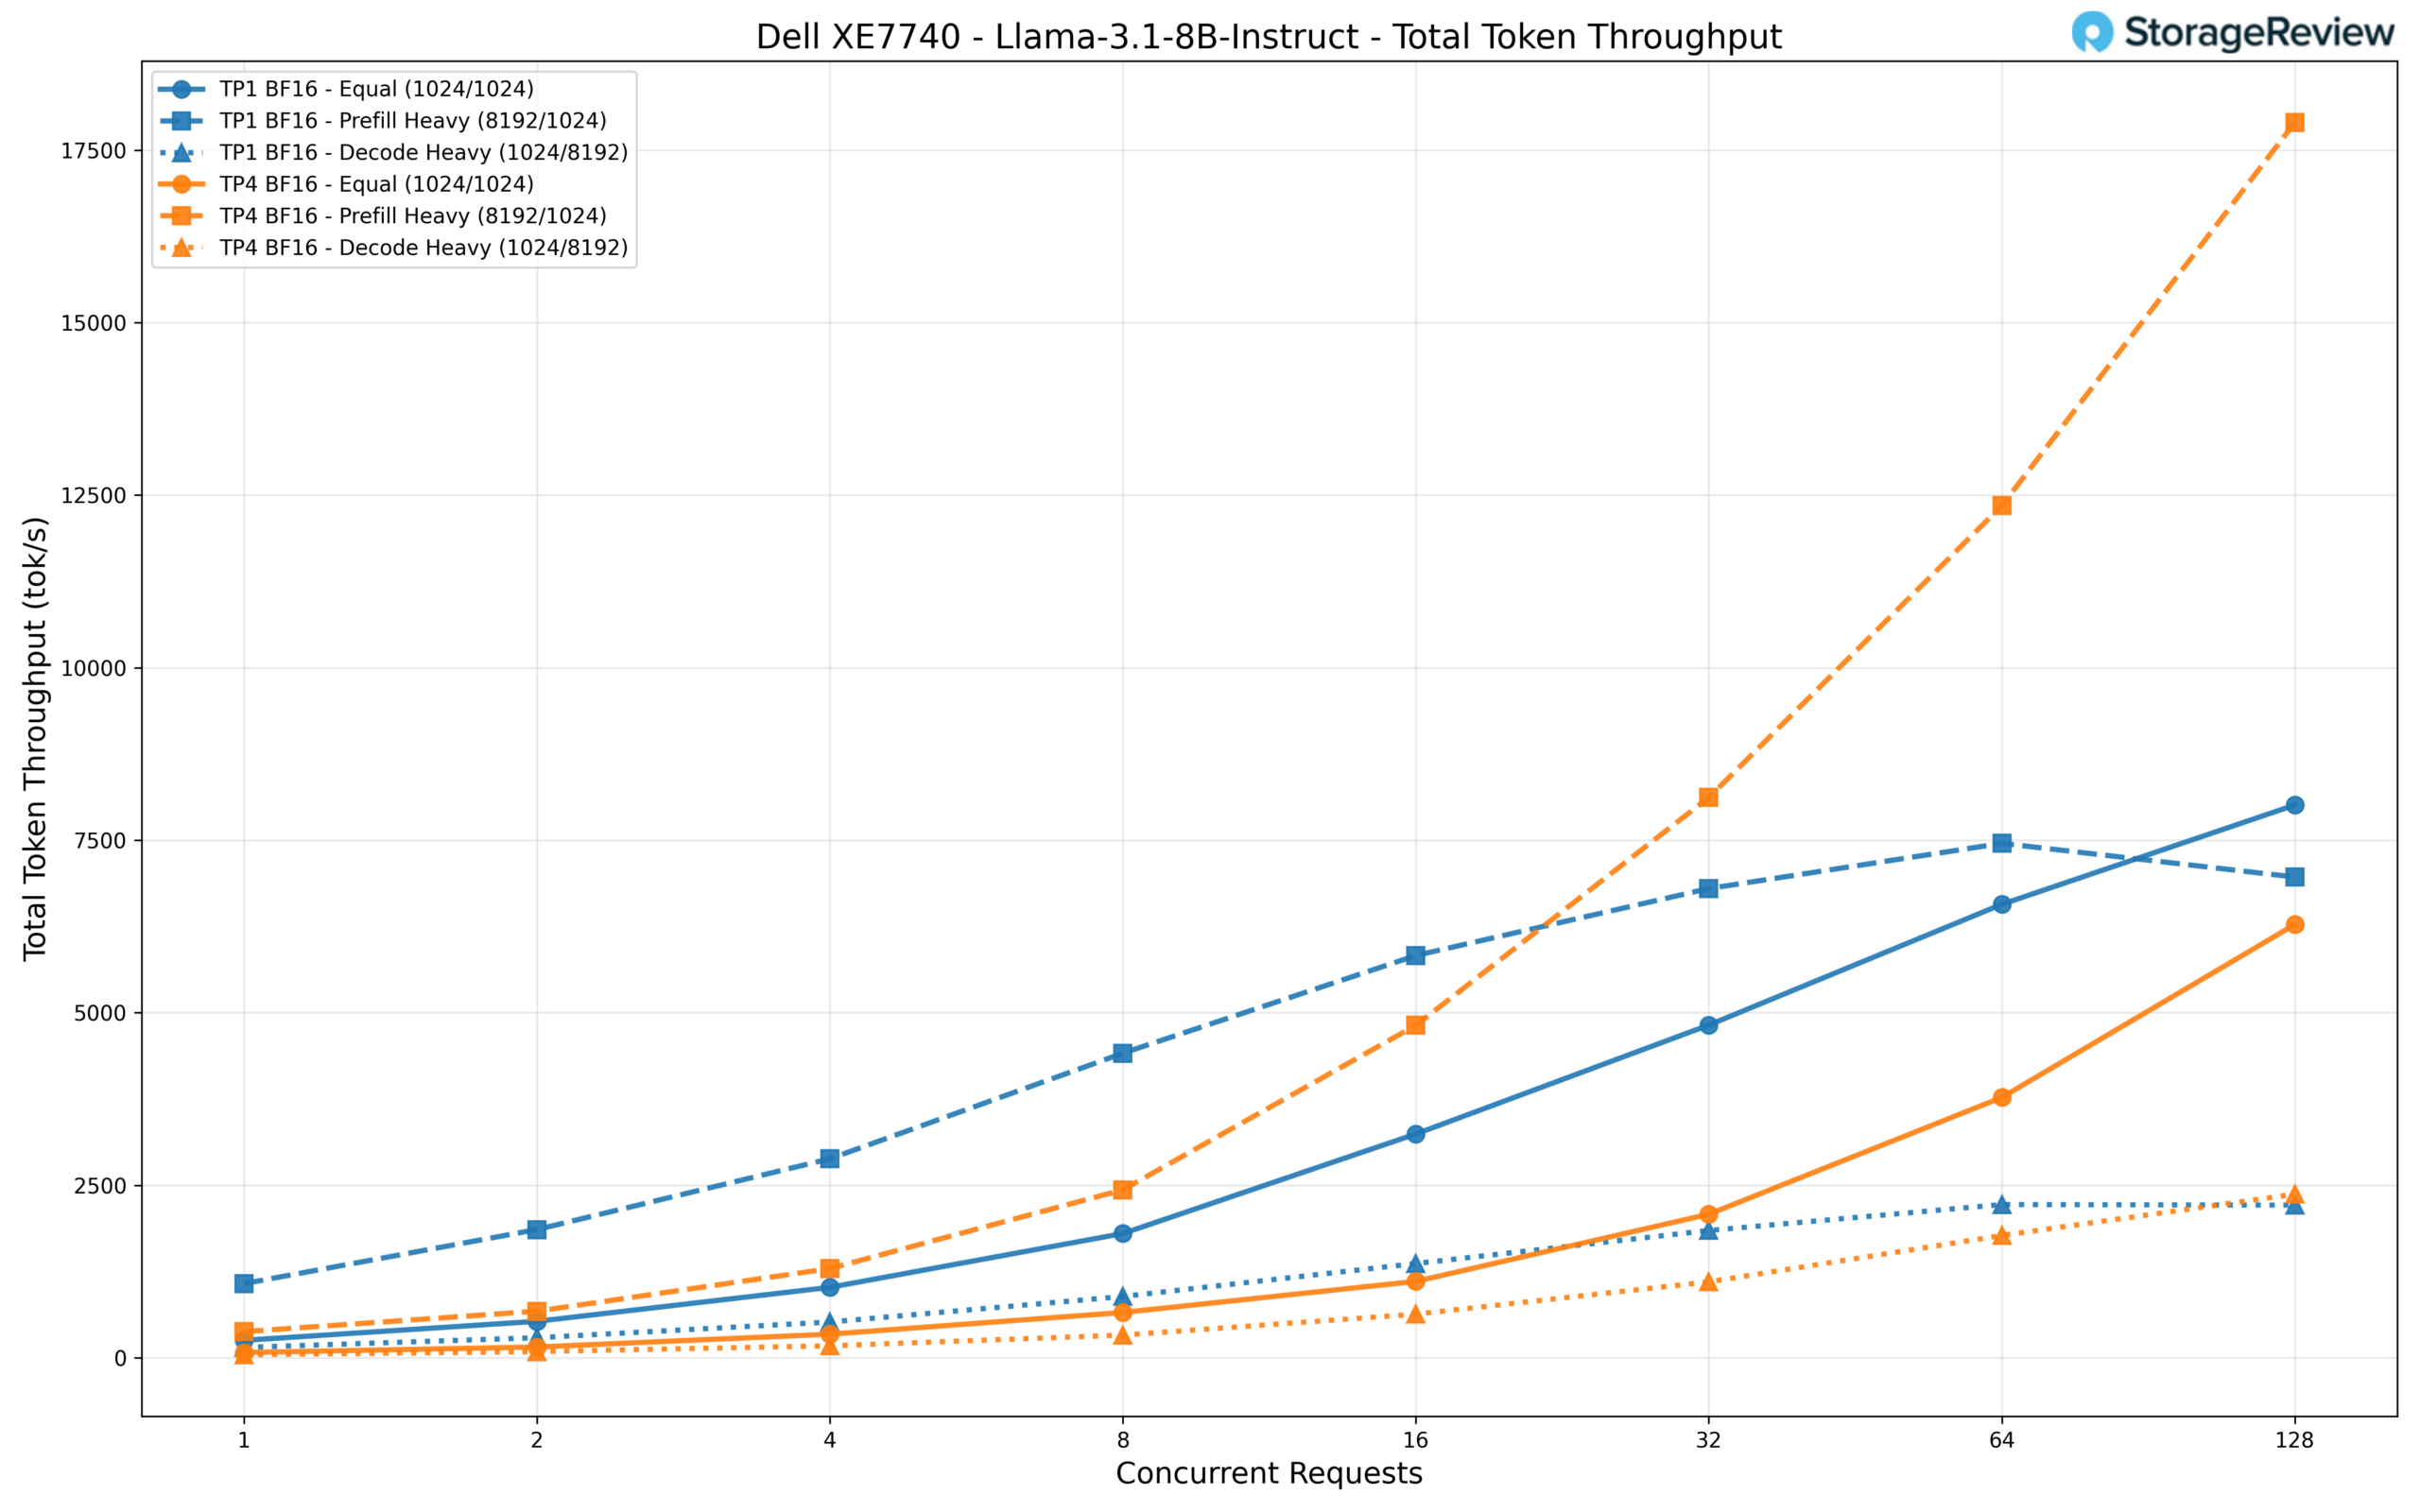
Abbiamo testato questo modello sia nella configurazione TP1 (un singolo acceleratore) che in quella TP4 (tutti e quattro gli acceleratori Gaudi 3). Eseguendo il modello su TP1, si ottiene una velocità di elaborazione totale di circa 8,000 tok/s con 128 richieste simultanee a parità di carico di lavoro, scalando in modo fluido a partire da circa 250 tok/s per singola richiesta. Lo scenario con precaricamento intensivo mostra un andamento interessante: mentre TP1 raggiunge un picco di circa 7,000 tok/s, TP4 arriva a oltre 17,900 tok/s con 128 richieste simultanee, sfruttando gli acceleratori aggiuntivi per elaborare il contesto di input di grandi dimensioni in modo più efficiente.
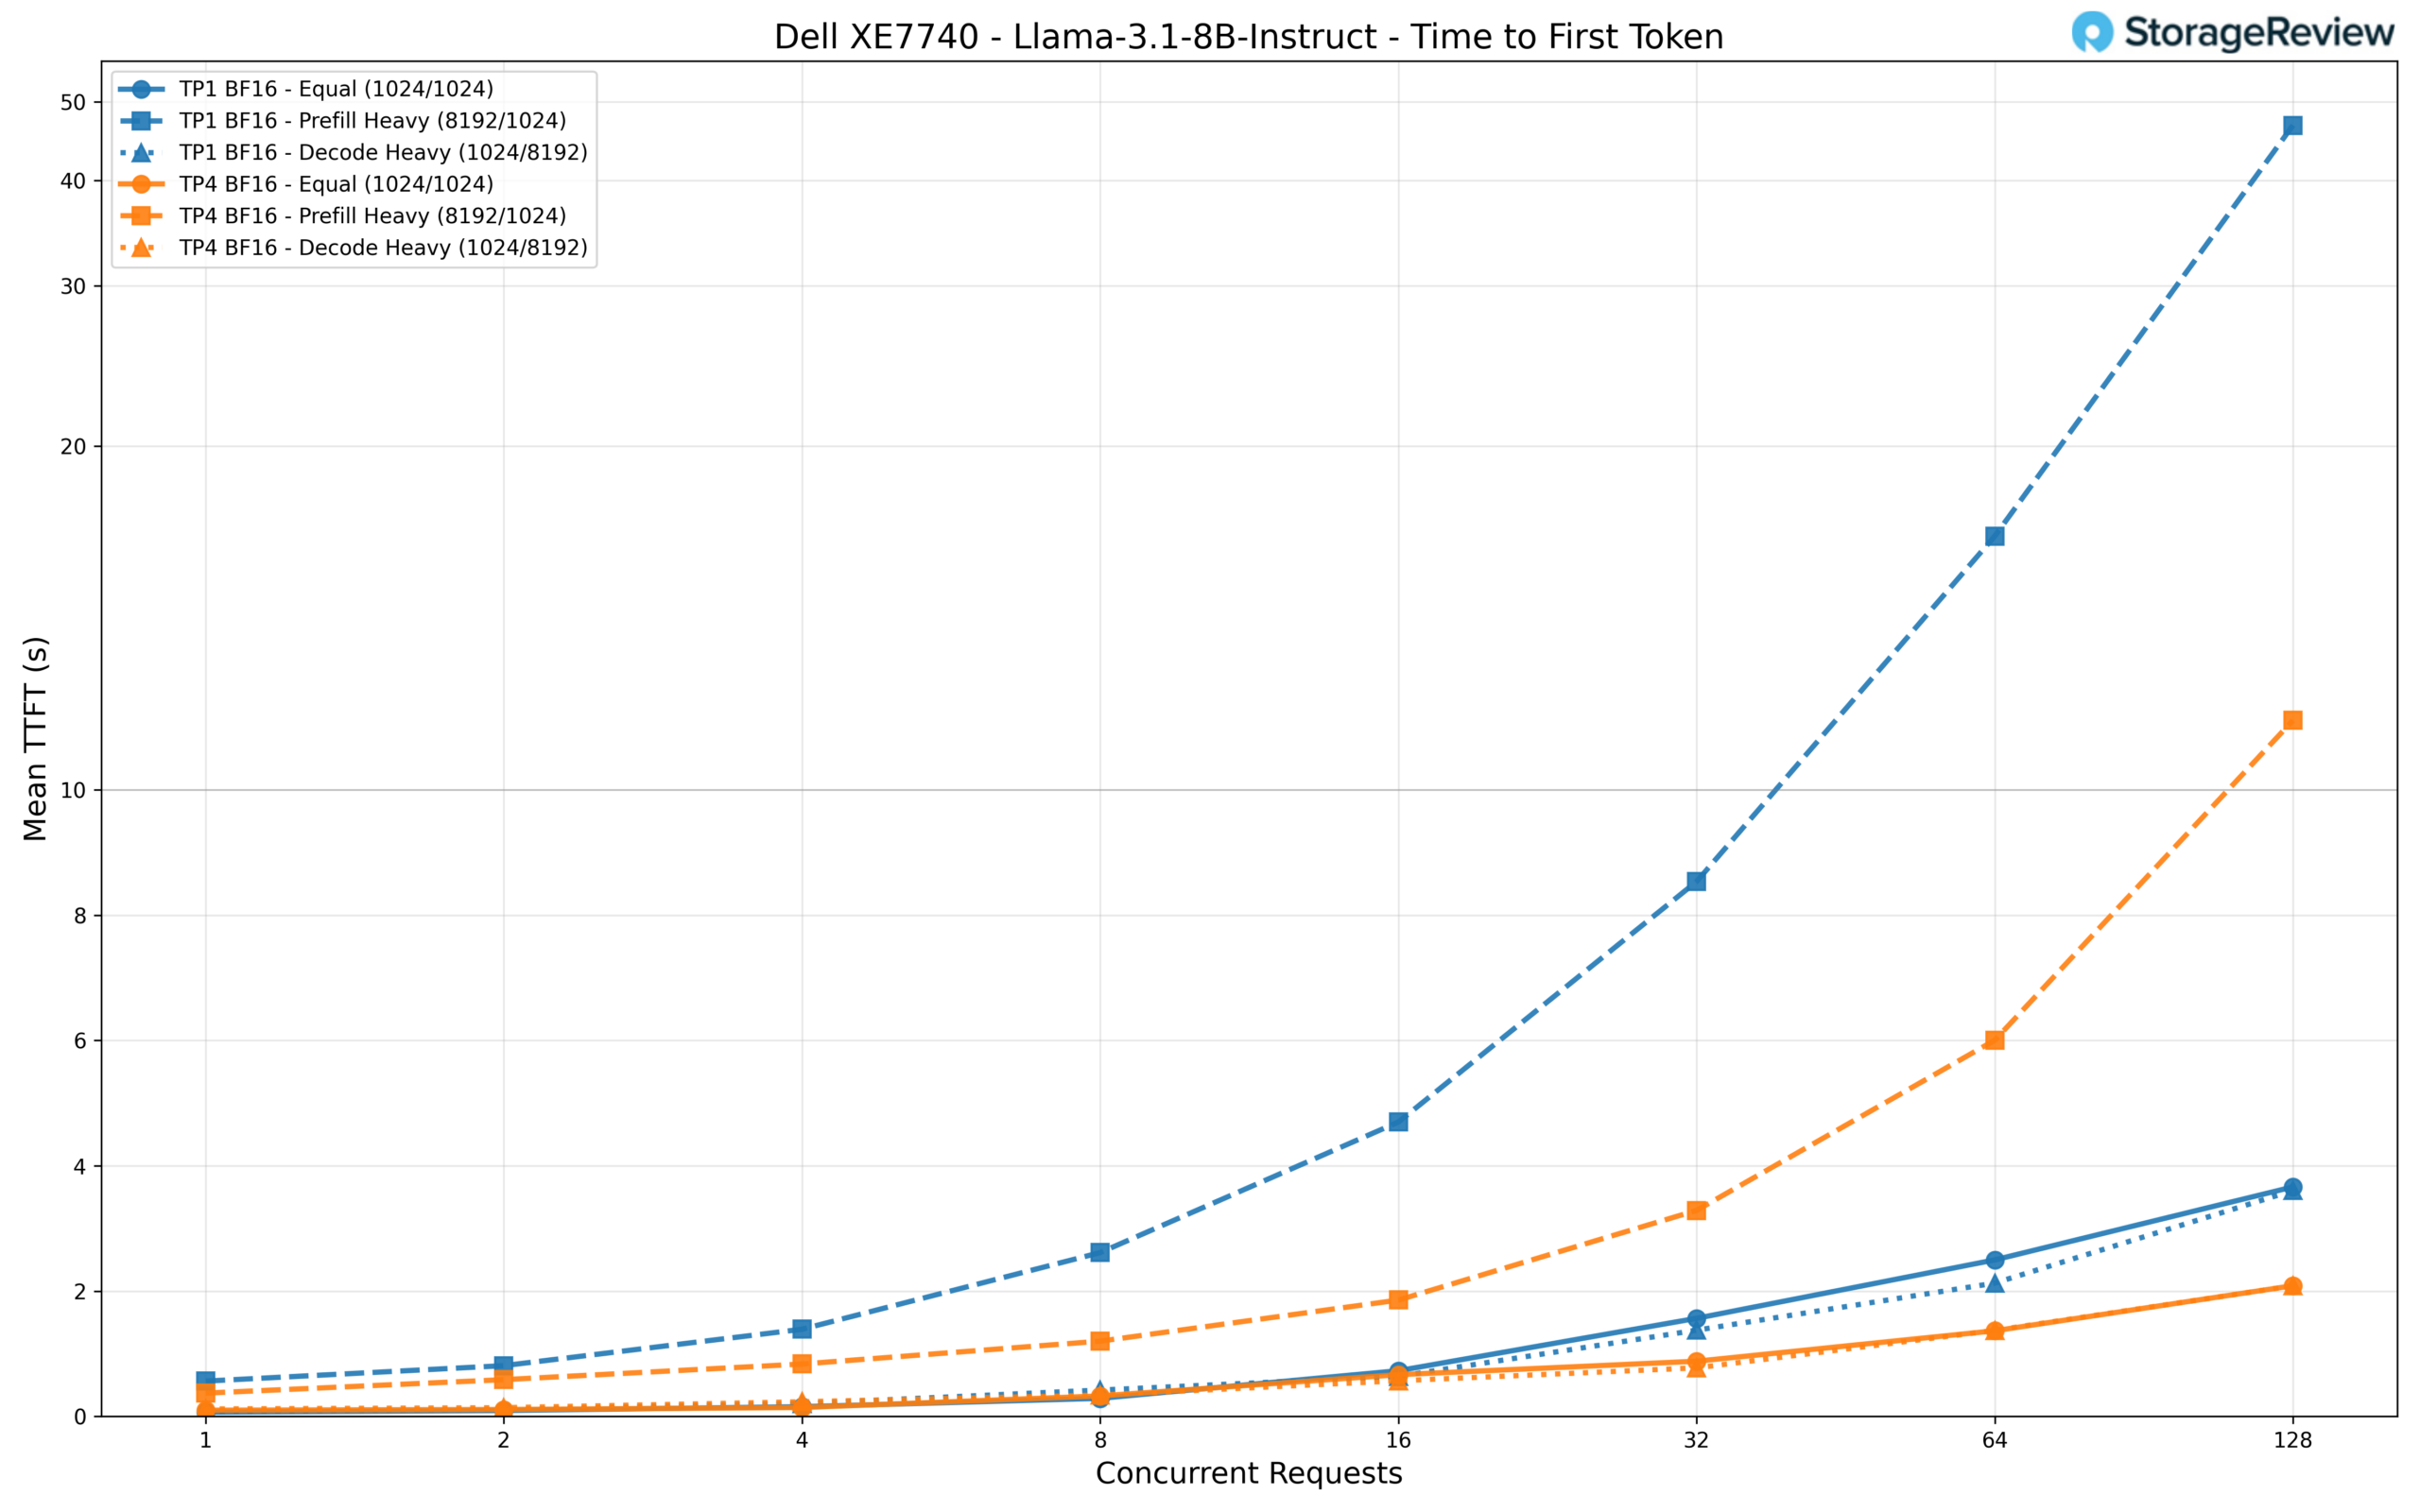
Per quanto riguarda la latenza a utente singolo, TP1 offre effettivamente un TTFT inferiore a bassa concorrenza (67 ms contro 98 ms per TP4), a causa del sovraccarico dovuto al coordinamento su quattro acceleratori per un modello che si adatta comodamente a uno solo. Tuttavia, con l'aumentare del carico, TP4 prende il sopravvento in modo decisivo. Con 128 richieste simultanee, TP4 mantiene il TTFT intorno ai 2 secondi per carichi di lavoro equal e decode, mentre TP1 sale rispettivamente a 3.7 secondi e 6.6 secondi. Lo scenario con prefill intensivo è dove il divario diventa più evidente: TP1 raggiunge quasi 47 secondi di TTFT con 128 richieste, mentre TP4 lo mantiene intorno agli 11 secondi.
Lama 3.1 70B Istruzioni
Llama 3.1 70B Instruct è il modello denso più grande della famiglia Llama 3.1 di Meta. Con 70 miliardi di parametri, offre capacità di seguire le istruzioni e multilingue nettamente superiori rispetto alla variante a 8 miliardi. I modelli di queste dimensioni sono particolarmente adatti a carichi di lavoro agentici più intensivi, come agenti di assistenza clienti, assistenti di ricerca multi-step, analisi di documenti complessi e attività che richiedono il mantenimento di un contesto coerente durante interazioni prolungate.
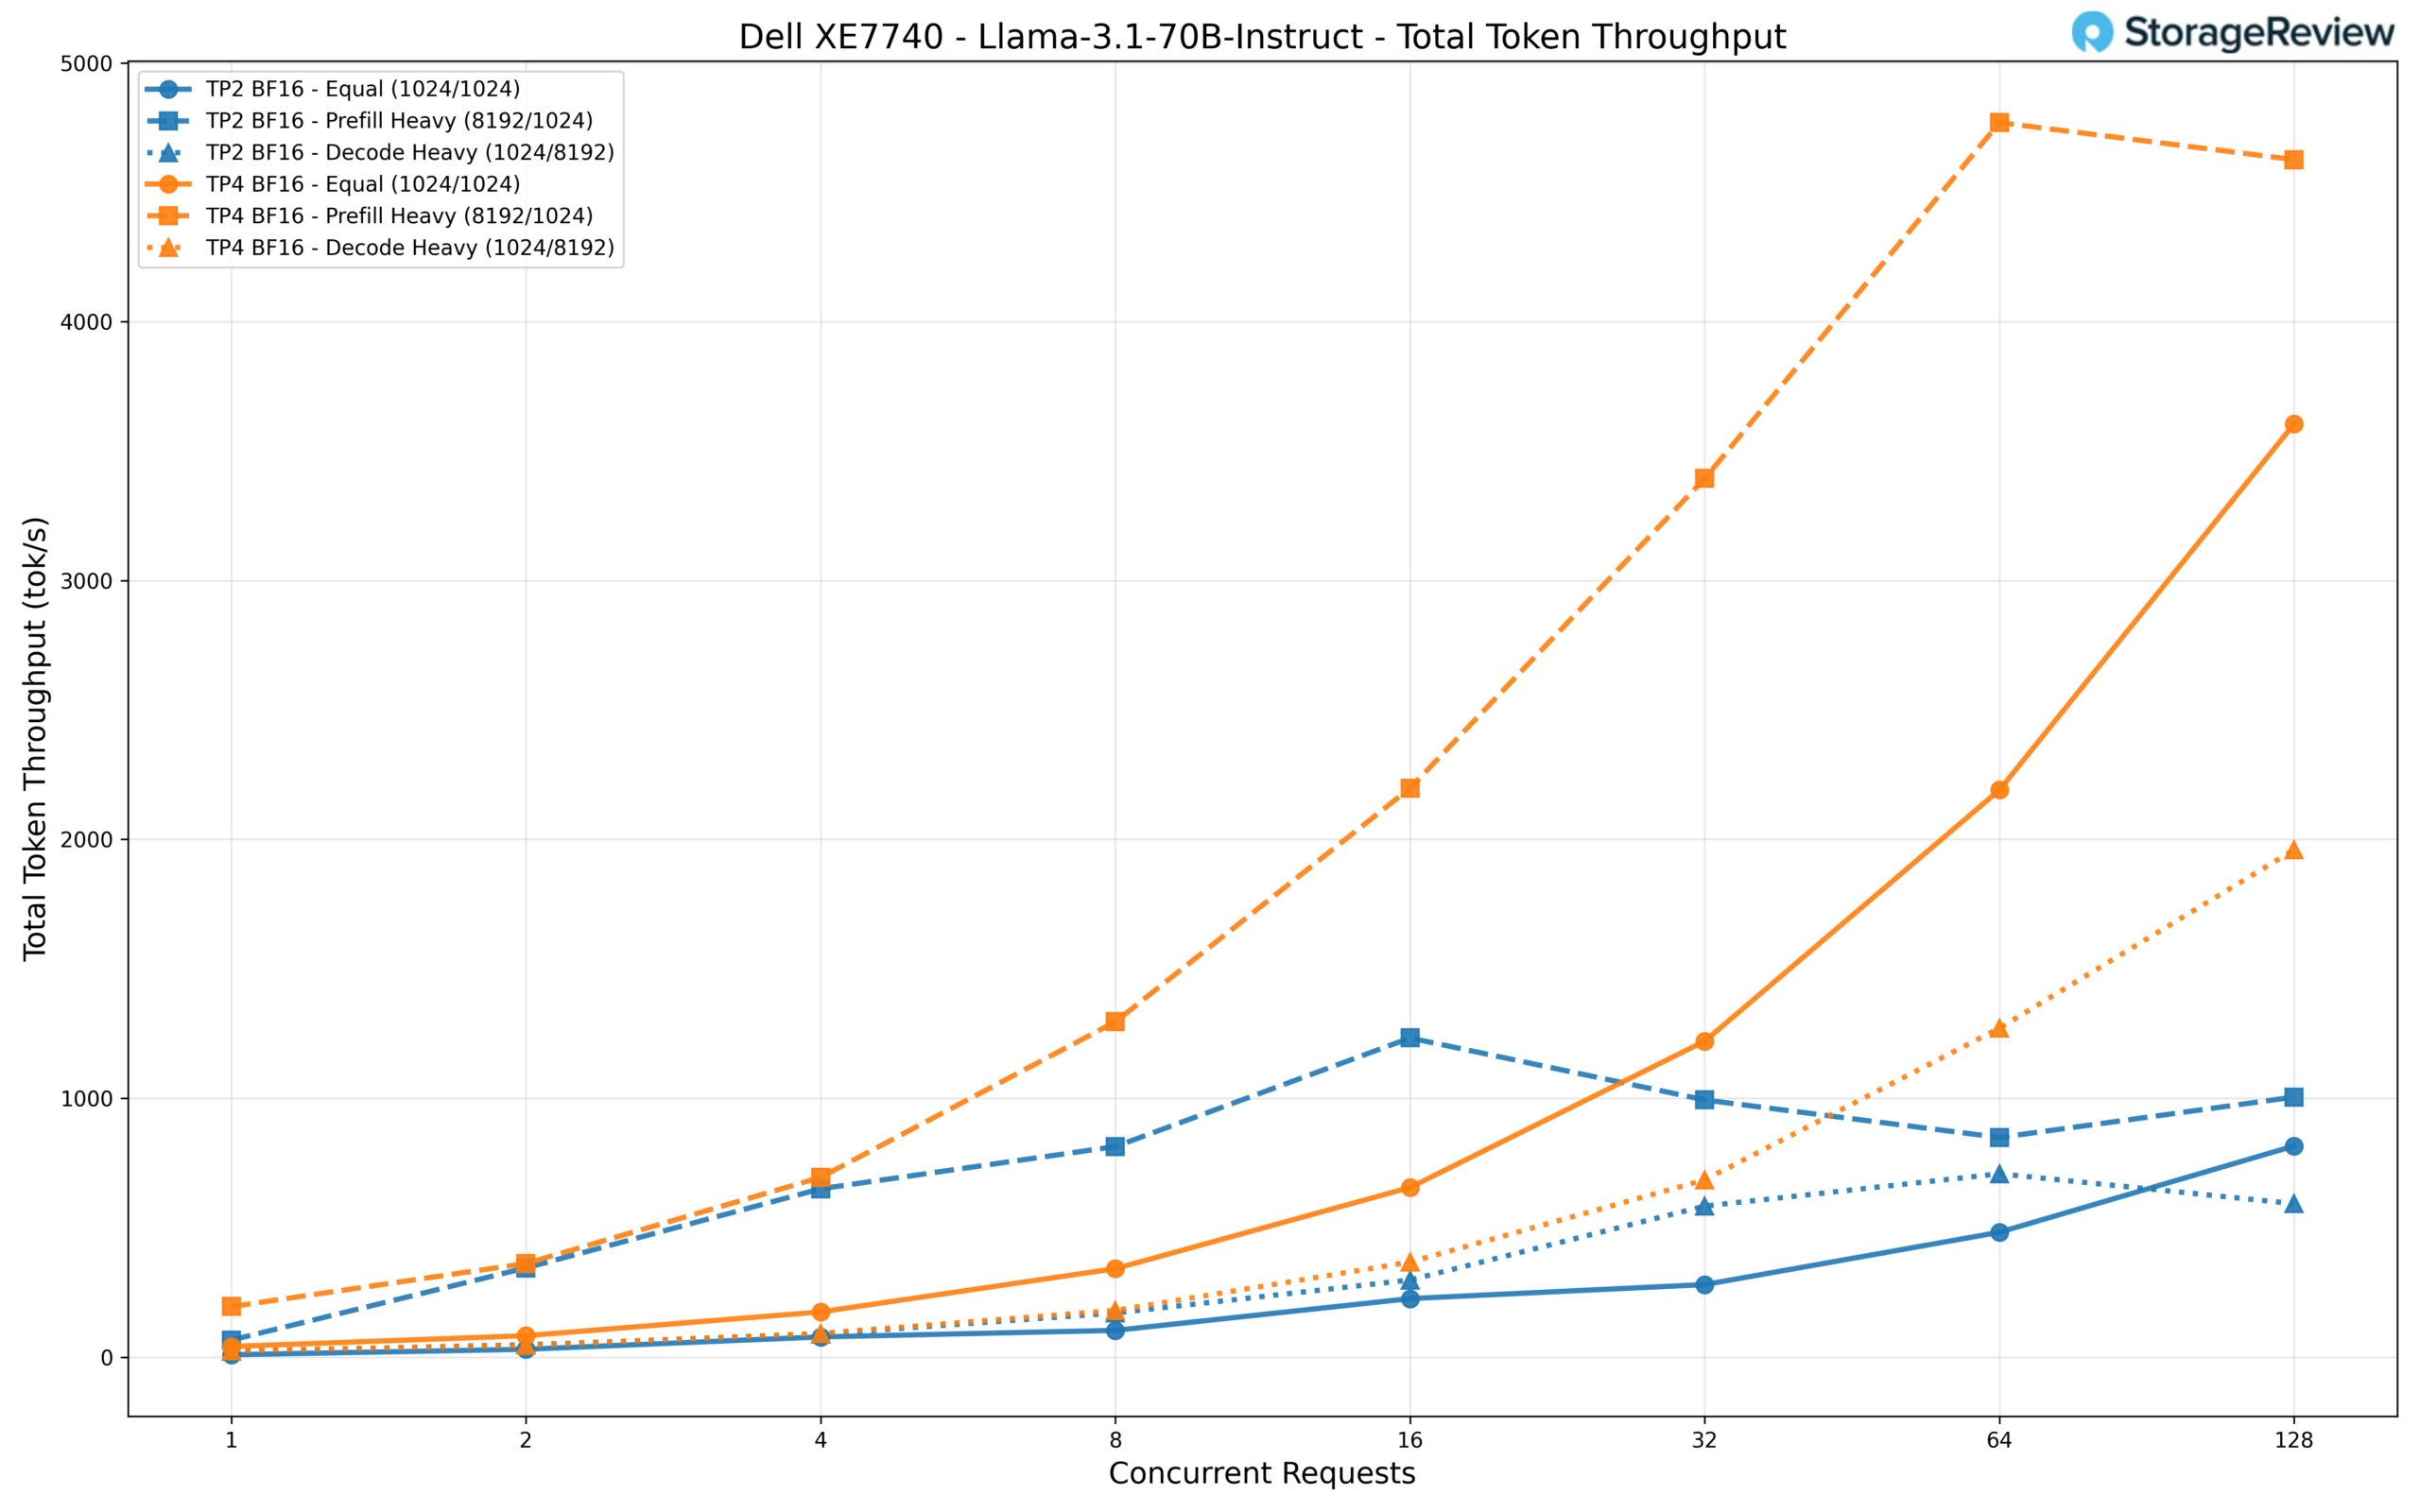
Abbiamo testato questo modello con le configurazioni TP2 e TP4. La differenza di throughput tra le due è sostanziale. Con 128 richieste simultanee, TP4 offre circa 3,600 tok/s a parità di carico di lavoro e raggiunge picchi di quasi 4,600 tok/s nello scenario con elevato pre-riempimento. Questo valore è circa 4.4 e 4.6 volte superiore al throughput di TP2, che raggiunge un massimo rispettivamente di circa 816 tok/s e 1,005 tok/s. Anche il carico di lavoro con elevato decodifica raggiunge circa 1,960 tok/s su TP4, rispetto ai 593 tok/s su TP2.
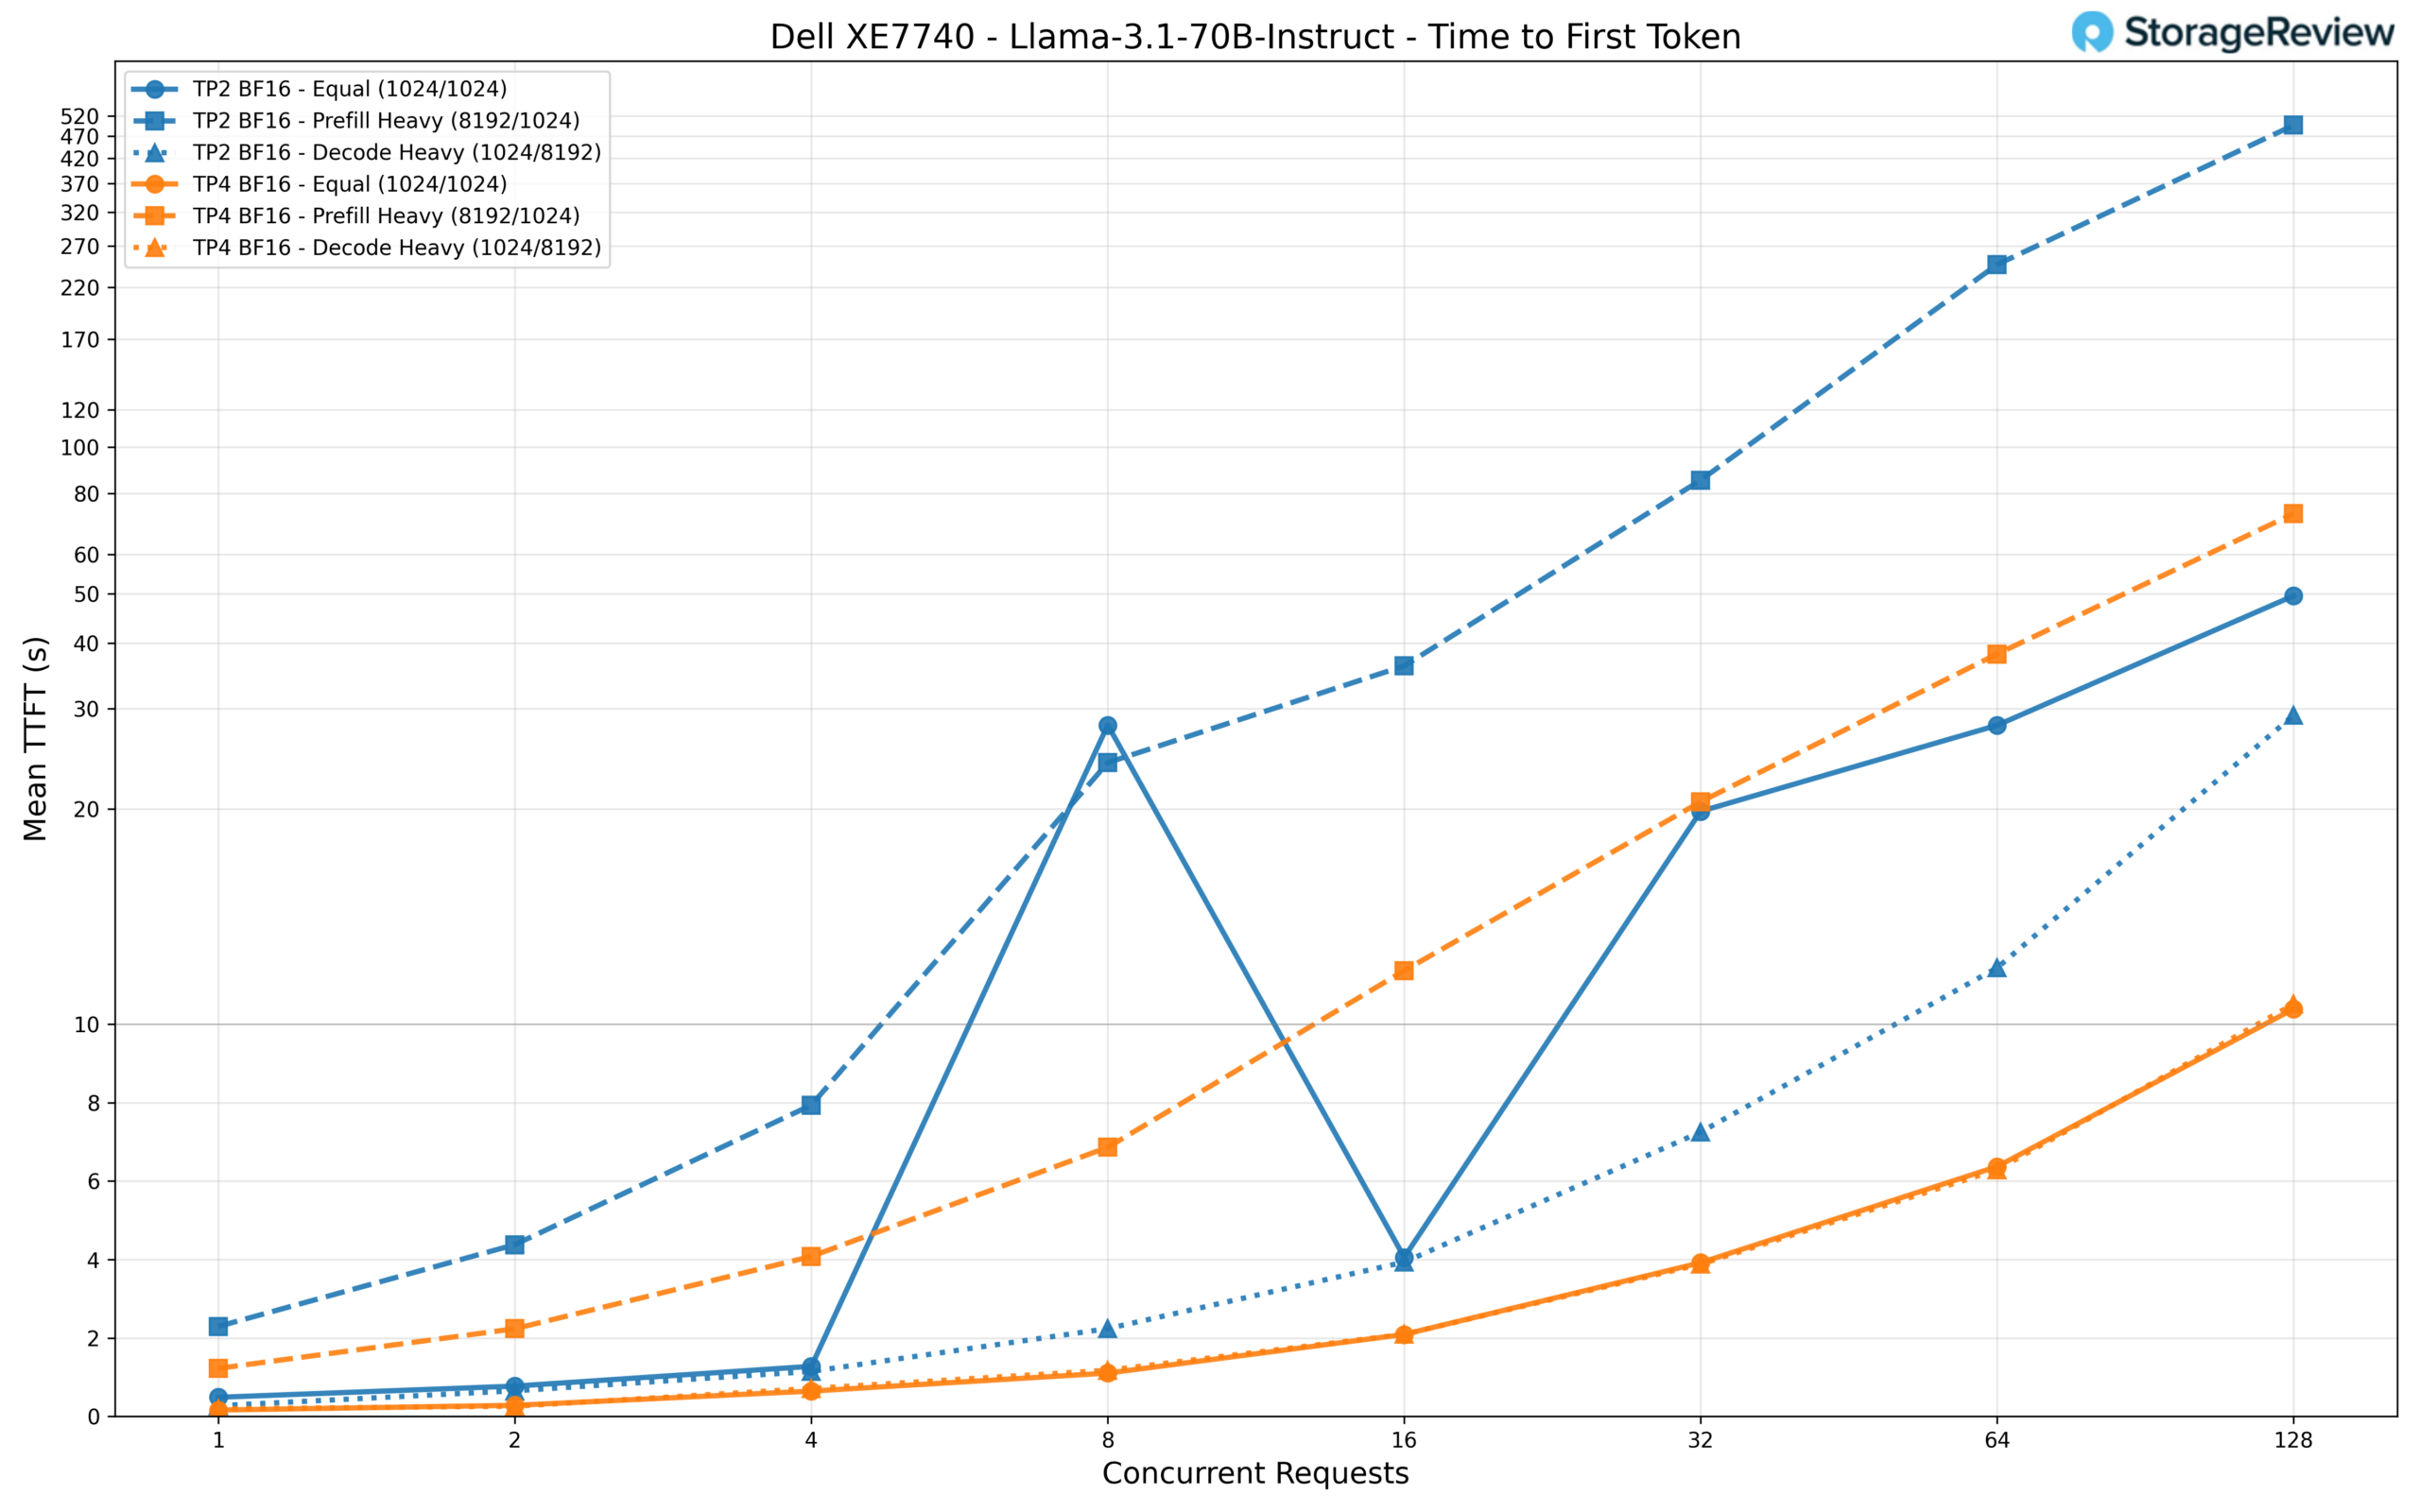
Per quanto riguarda il TTFT, TP2 fatica sotto carico con il prefill-heavy workload, raggiungendo la cifra impressionante di 496 secondi con 128 richieste simultanee, rendendolo di fatto inutilizzabile per le applicazioni interattive. TP4 riduce questo valore a circa 73 secondi. Per i carichi di lavoro equal e decode, TP4 mantiene il TTFT a circa 10 secondi con 128 richieste, mentre TP2 raggiunge rispettivamente 50 e 29 secondi. A bassa concorrenza, TP4 fornisce risposte first-token in circa 160 ms per il carico di lavoro equal, rispetto ai 486 ms di TP2.
Istruzioni per il programmatore Qwen3 30B-A3B
Qwen3 Coder 30B-A3B è uno dei modelli di codifica più diffusi per le implementazioni di inferenza locale e utilizza un'architettura Mixture-of-Experts (MoE). A differenza dei modelli densi, in cui ogni parametro partecipa a ogni passaggio in avanti, i modelli MoE instradano ogni token attraverso un piccolo sottoinsieme di reti di esperti specializzate. Qwen3 Coder mantiene una dimensione completa del modello di 30 miliardi di parametri con precisione BF16, attivando solo 3 miliardi di parametri per ogni token generato. Questo schema di attivazione sparso consente al modello di offrire la qualità di una rete molto più grande, richiedendo solo una frazione della potenza di calcolo per token, risultando estremamente efficiente su hardware che supporta l'overhead di instradamento. Per gli utenti finali, questo modello è ideale per l'assistenza quotidiana alla programmazione, come la generazione di codice boilerplate, il completamento di funzioni, la spiegazione del codice, la scrittura di unit test e la gestione di attività di sviluppo di routine che beneficiano di un modello specializzato nel codice senza richiedere un ragionamento complesso.
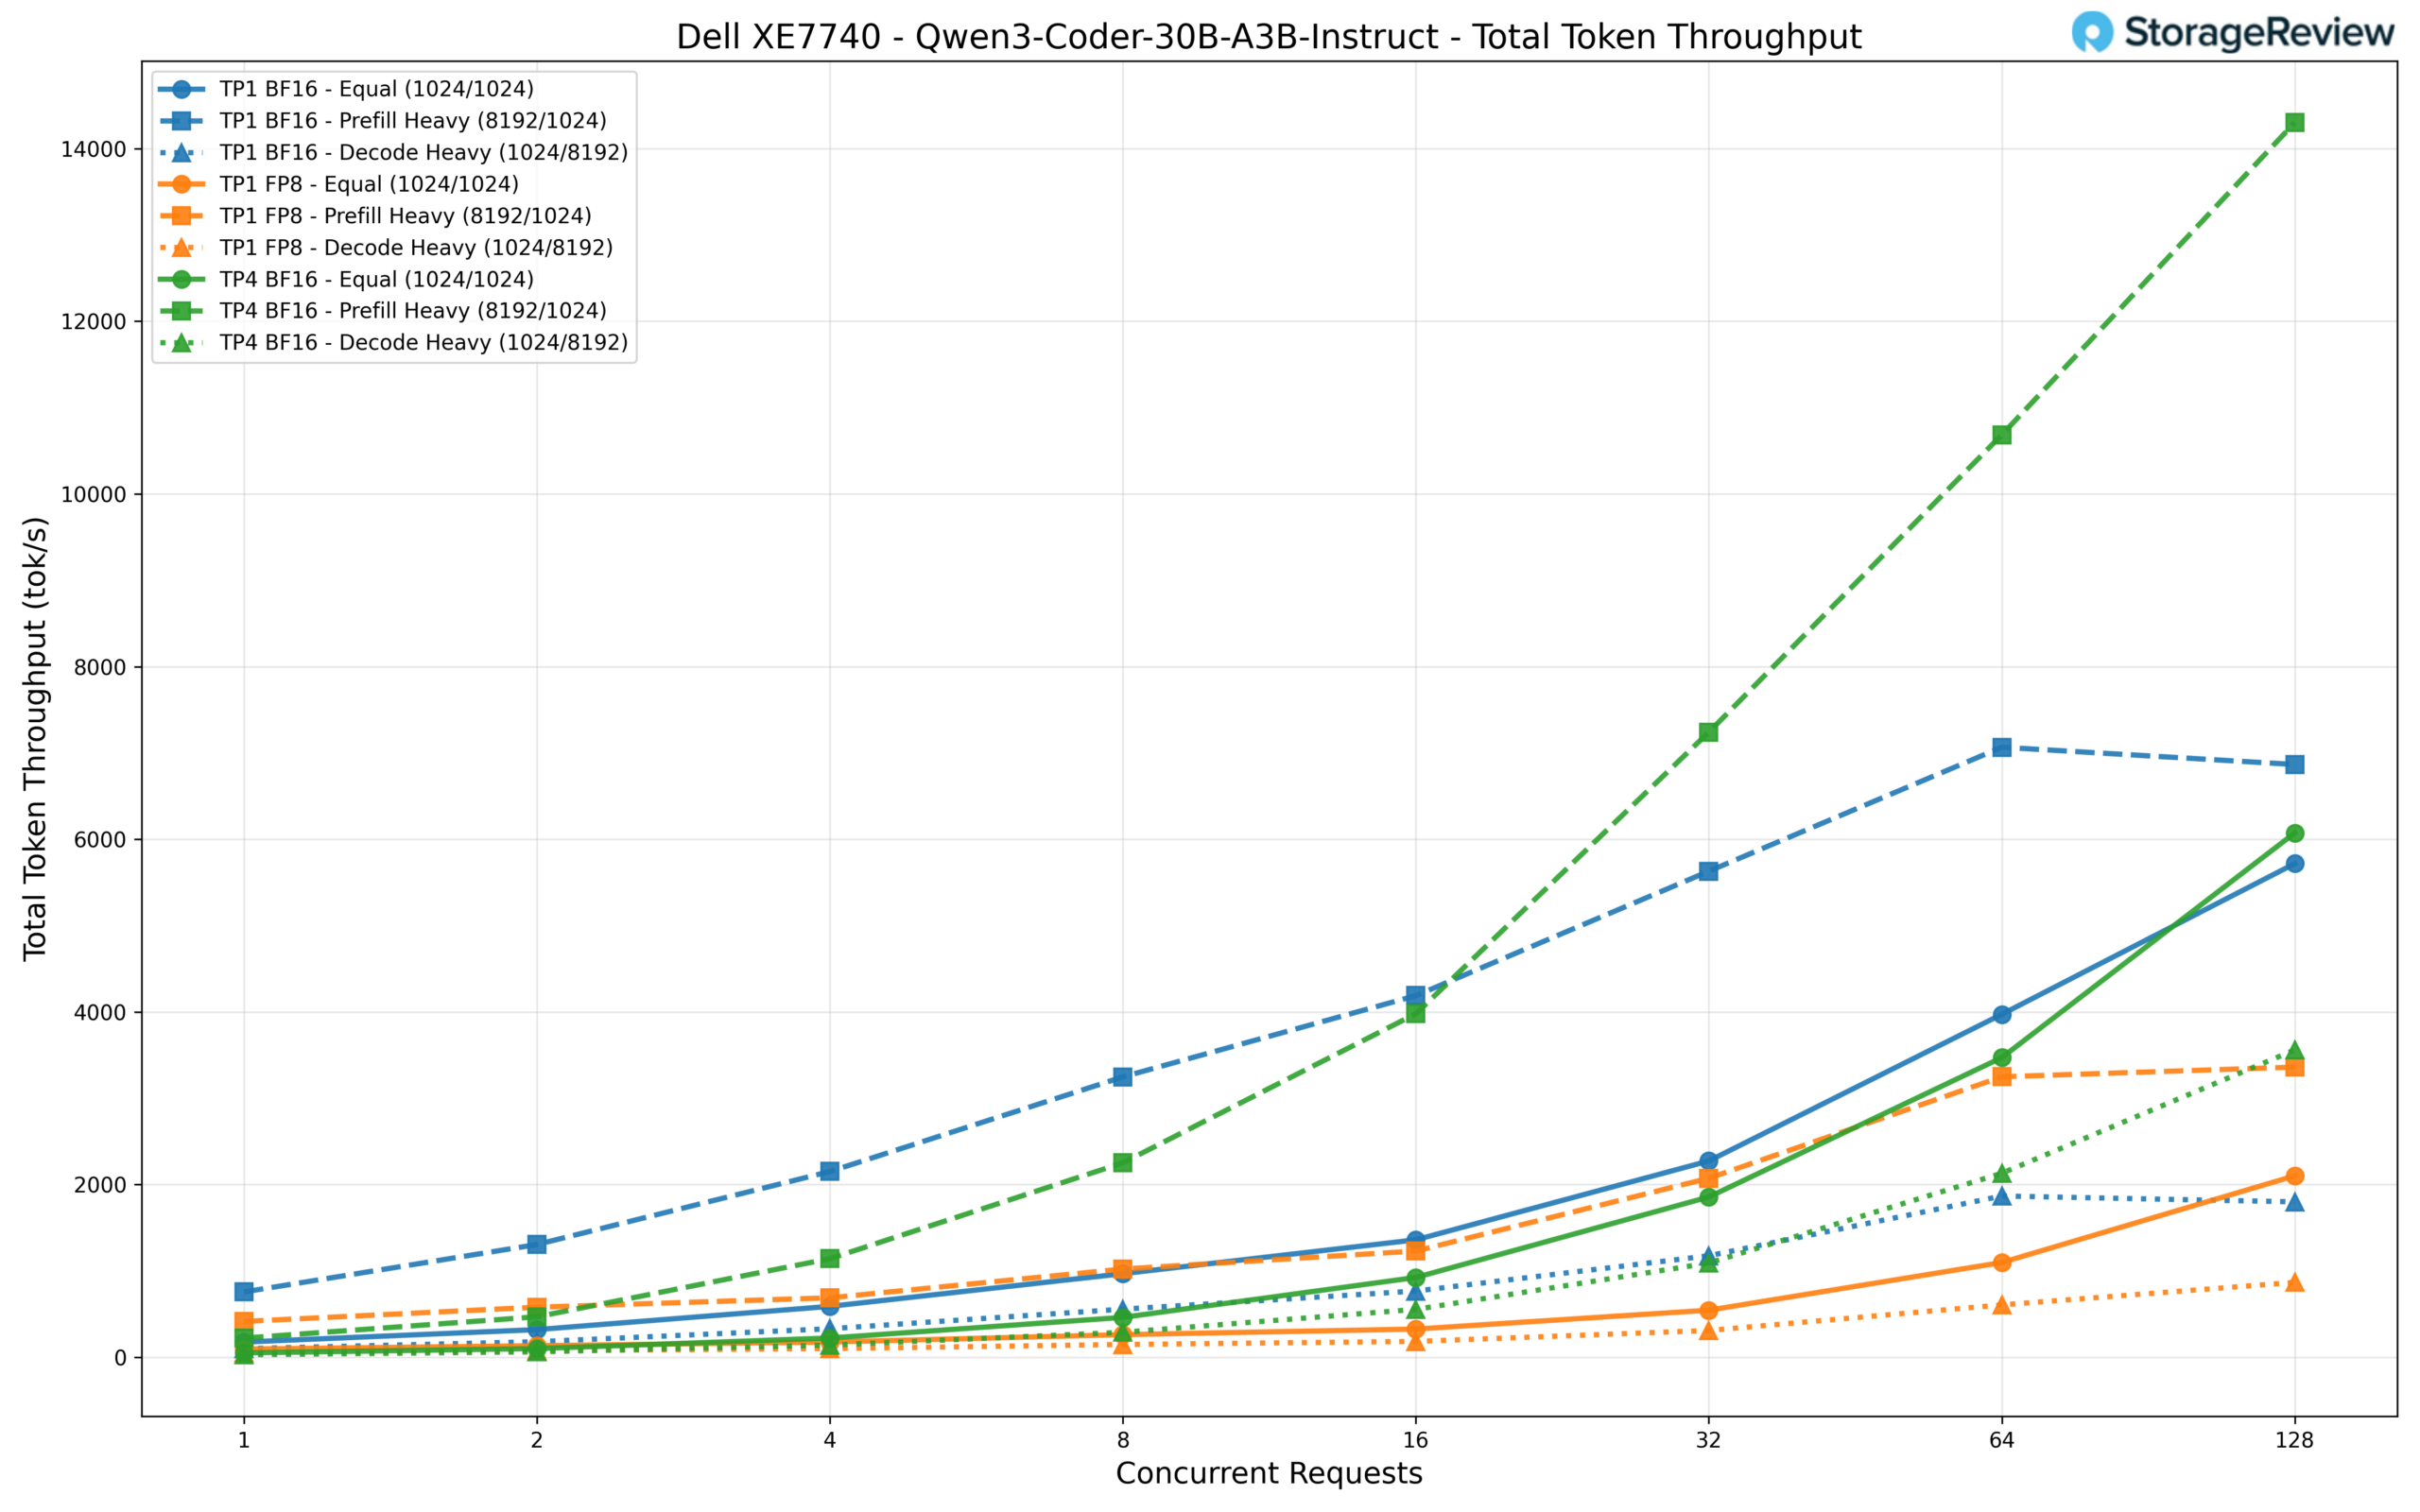
Abbiamo testato tre configurazioni: TP1 BF16, TP1 FP8 e TP4 BF16. Con 128 richieste simultanee, TP4 BF16 si posiziona al primo posto con circa 14,300 tok/s nello scenario con precaricamento intensivo, il valore di throughput più elevato registrato per qualsiasi modello nella nostra suite di test. TP1 BF16 segue con circa 6,900 tok/s nello stesso scenario, mentre TP1 FP8 si attesta intorno ai 3,360 tok/s. A parità di carico di lavoro, il divario si riduce leggermente con TP4 a 6,073 tok/s, TP1 BF16 a 5,718 tok/s e TP1 FP8 a 2,101 tok/s. Come discusso nella nota relativa a FP8, i valori inferiori di FP8 riflettono lo stato attuale del fork vLLM di Intel piuttosto che un collo di bottiglia hardware.
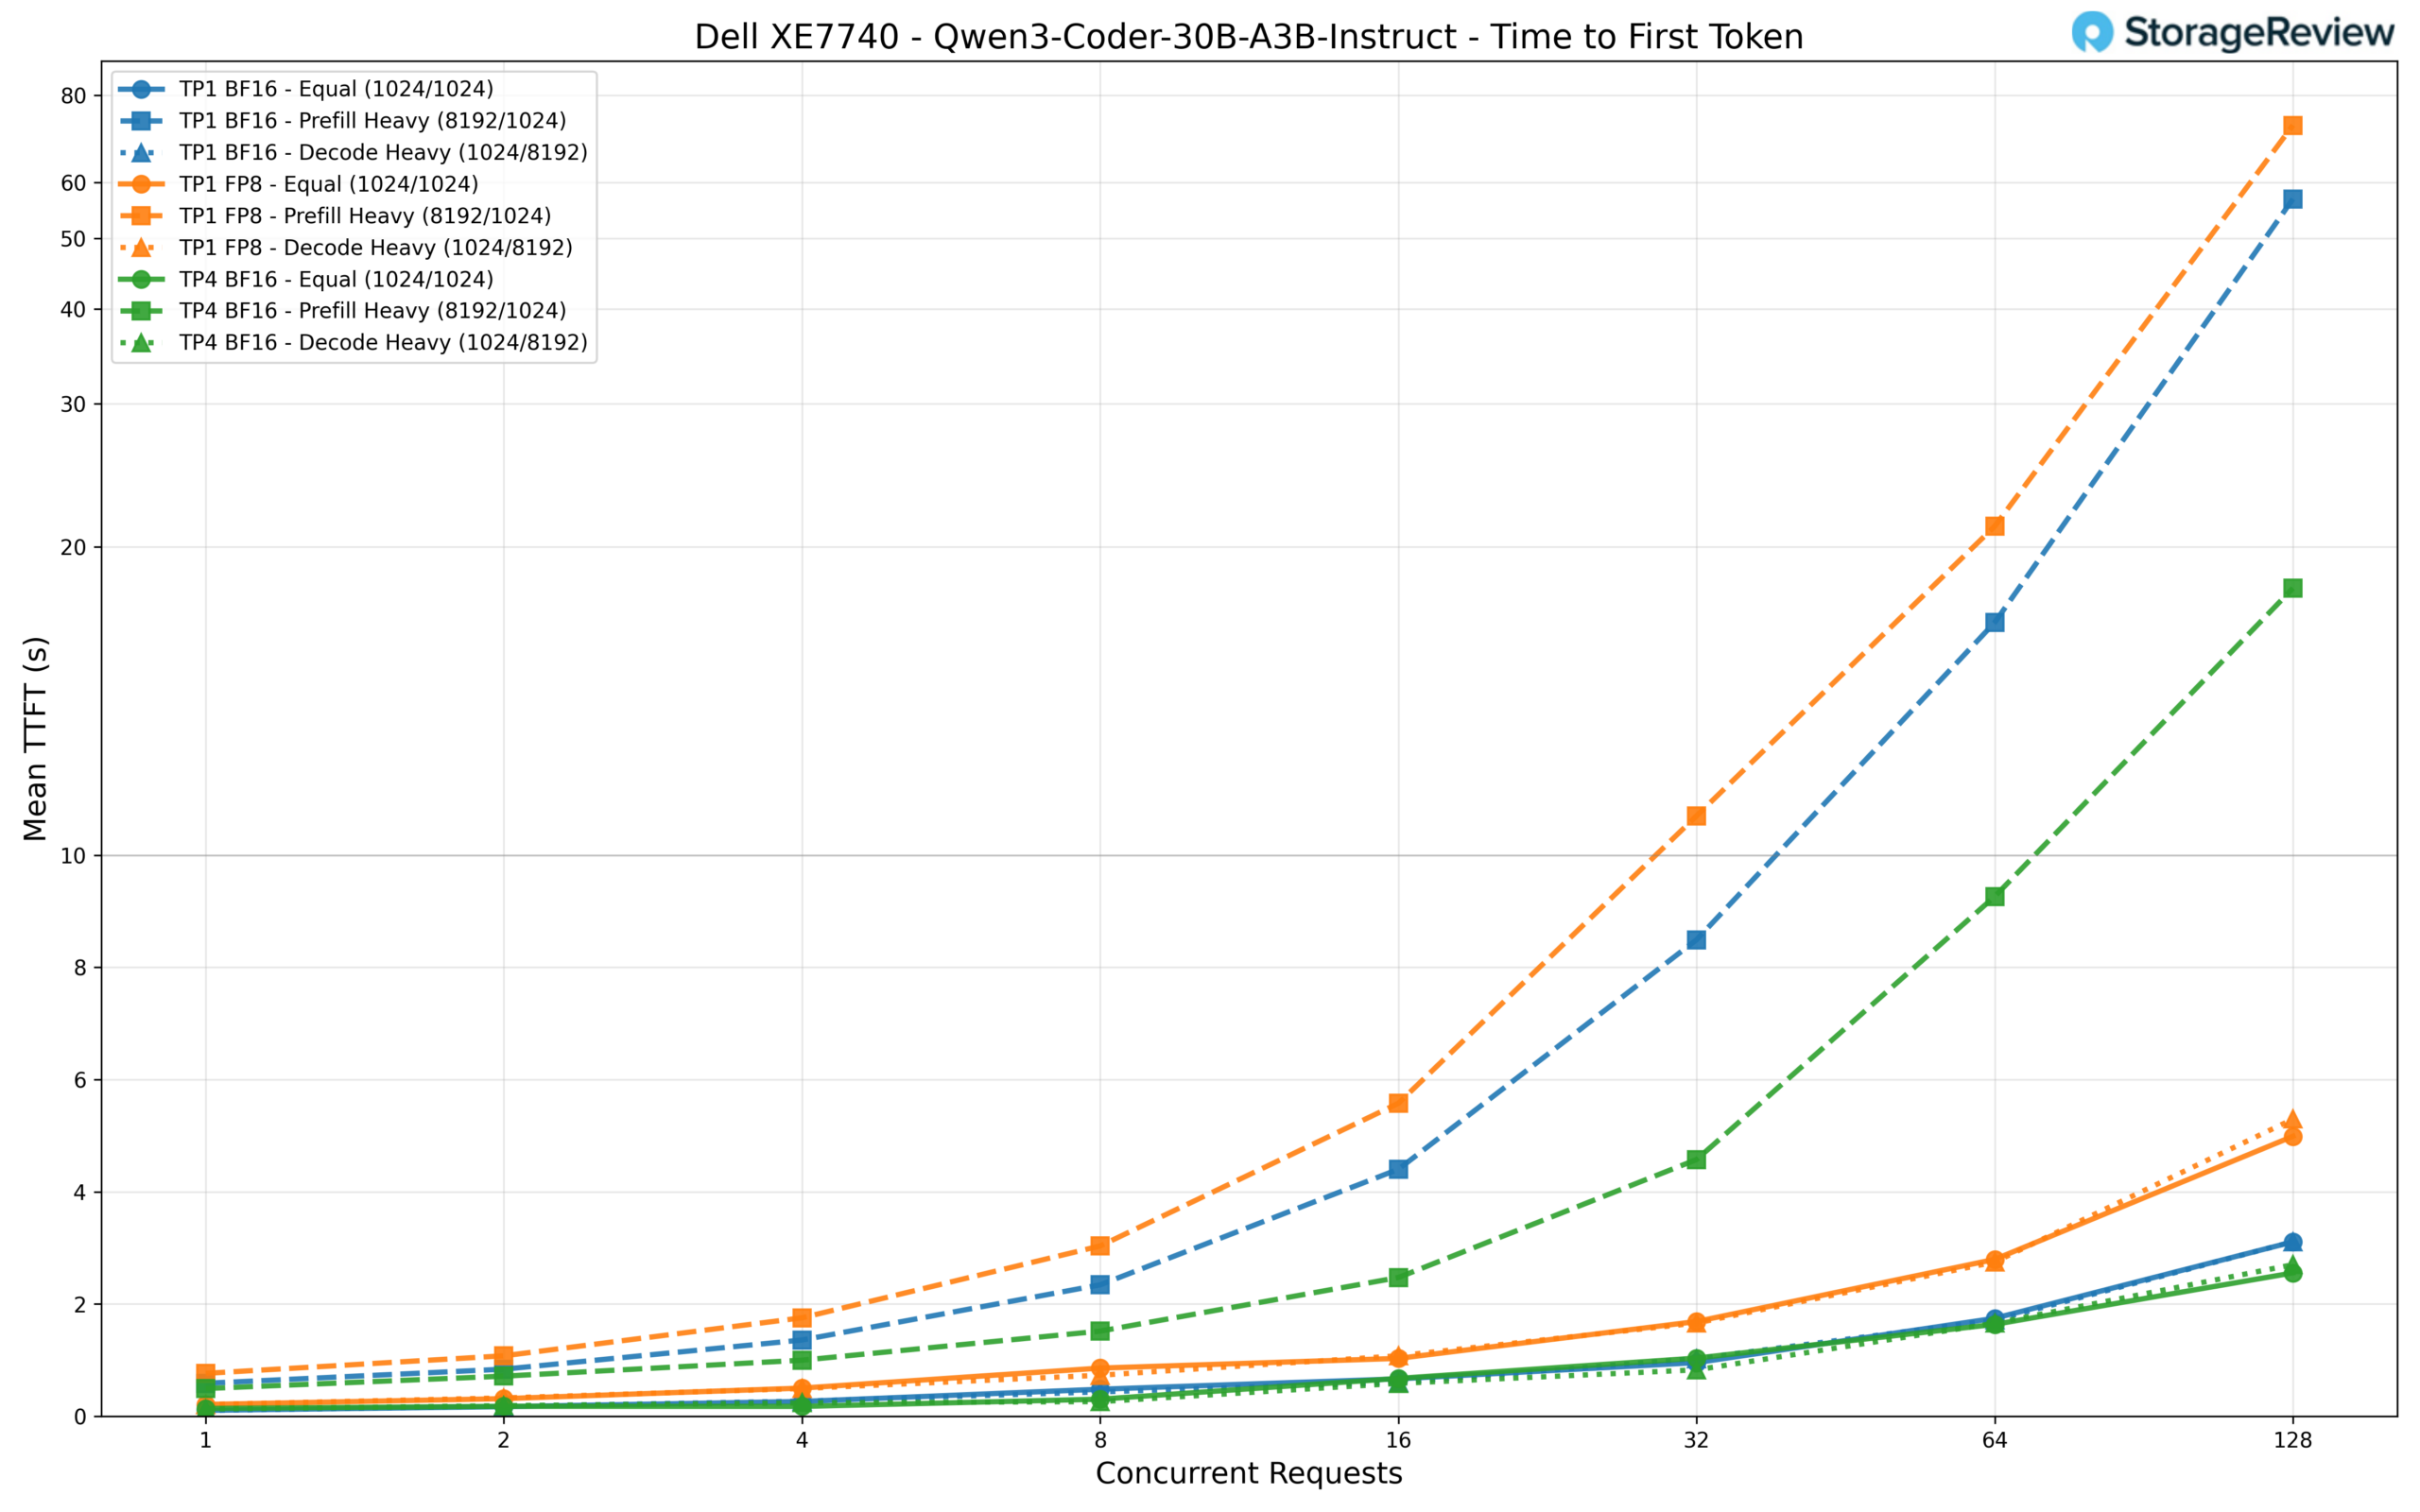
Il TTFT rimane basso grazie al modello di attivazione sparso. TP4 BF16 offre una latenza del primo token di circa 140 ms con un singolo utente e si mantiene intorno ai 2.6 secondi con 128 richieste simultanee a parità di carico. TP1 BF16 è paragonabile a bassa concorrenza (106 ms) ma sale a 3.1 secondi a pieno carico. Lo scenario con precaricamento intenso evidenzia nuovamente una netta differenza tra le configurazioni: TP4 raggiunge circa 18 secondi con 128 richieste, TP1 BF16 arriva a 57 secondi e TP1 FP8 si estende fino a 72 secondi.
Qwen3 235B-A22B Pensiero
Il modello più grande della nostra suite di benchmark, Qwen3 235B-A22B Thinking, è un modello di ragionamento MoE di dimensioni enormi con 235 miliardi di parametri totali e 22 miliardi di parametri attivi per token. Oltre alle sue dimensioni imponenti, questo modello include funzionalità di ragionamento a catena di pensiero integrate, che gli consentono di scomporre problemi complessi passo dopo passo prima di giungere a una soluzione, a costo di un maggior numero di token di decodifica. Ciò lo rende particolarmente adatto ai compiti più impegnativi: generazione e debug di codice avanzato, risoluzione di problemi matematici, ragionamento logico a più fasi e flussi di lavoro complessi e agentici in cui la precisione è più importante della velocità pura. Questo modello richiede TP4 per funzionare ed è stato testato sia con precisione BF16 che FP8.
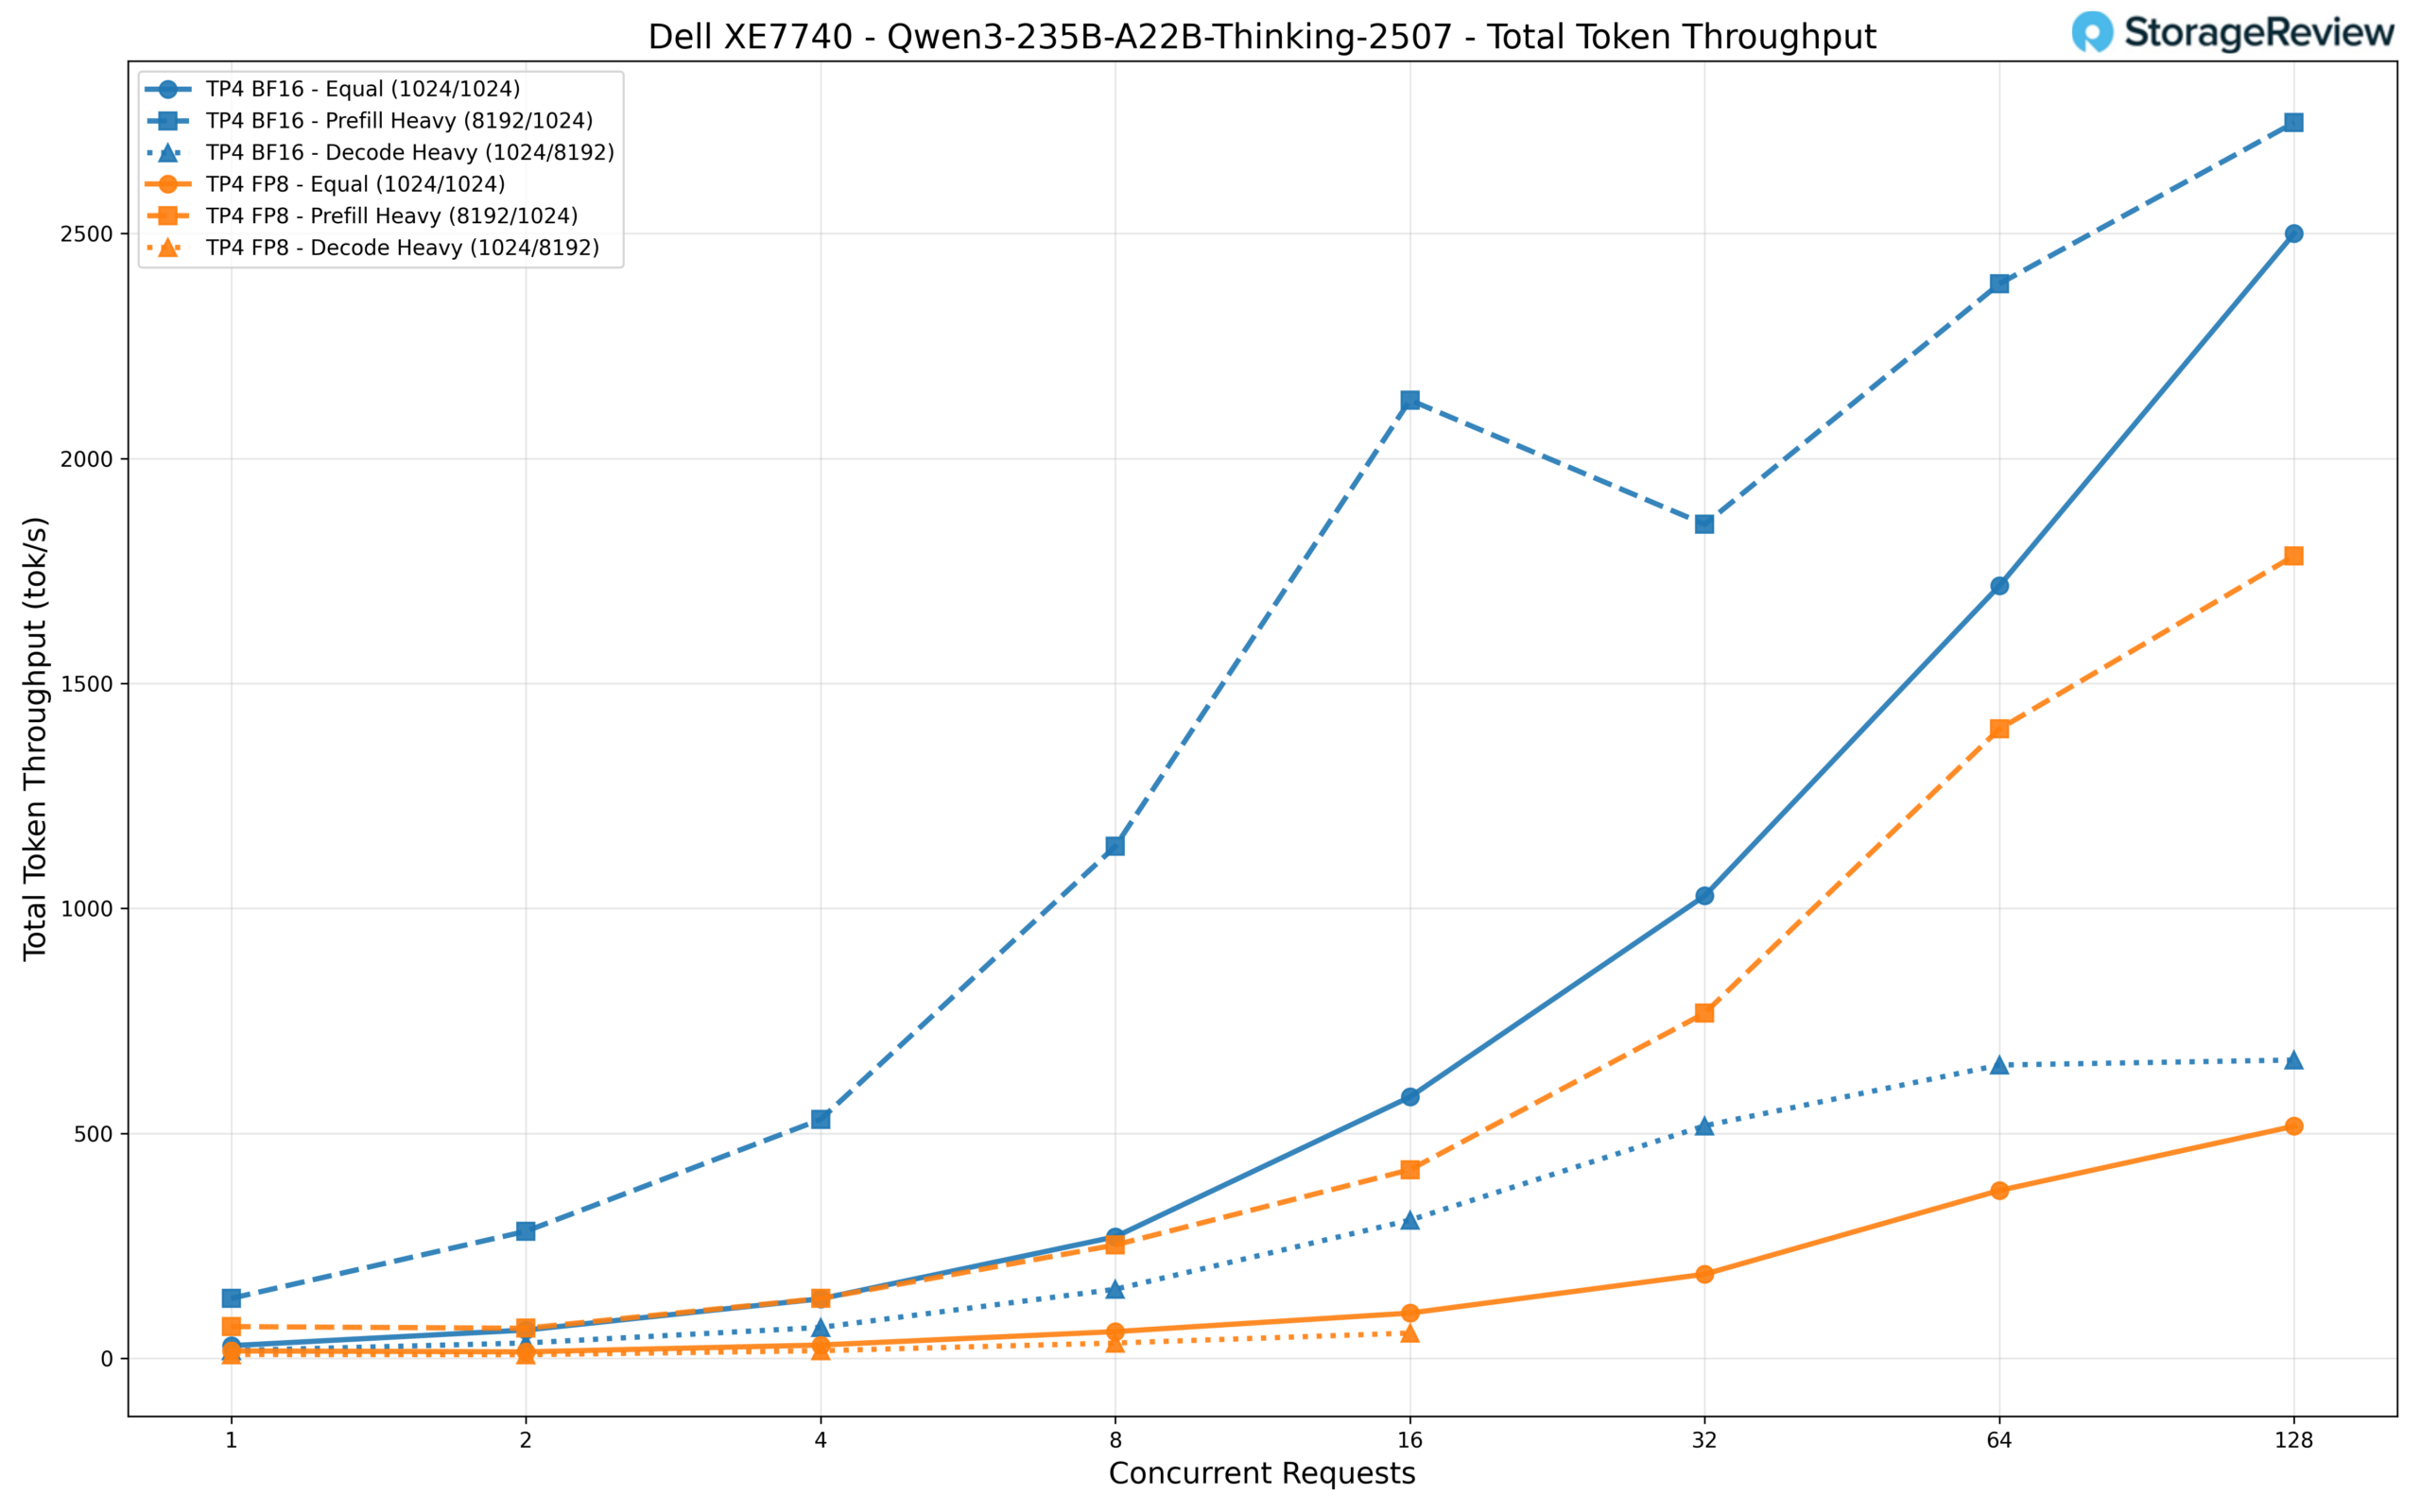
BF16 supera nettamente FP8 in tutti i parametri. Con 128 richieste simultanee, BF16 raggiunge circa 2,750 tok/s nel carico di lavoro con precaricamento intensivo e 2,500 tok/s nel carico di lavoro con uguale frequenza, mentre FP8 si ferma rispettivamente a circa 1,784 tok/s e 516 tok/s. La variante FP8 ha inoltre riscontrato timeout nello scenario con decodifica intensiva a livelli di concorrenza più elevati (oltre 32 richieste).
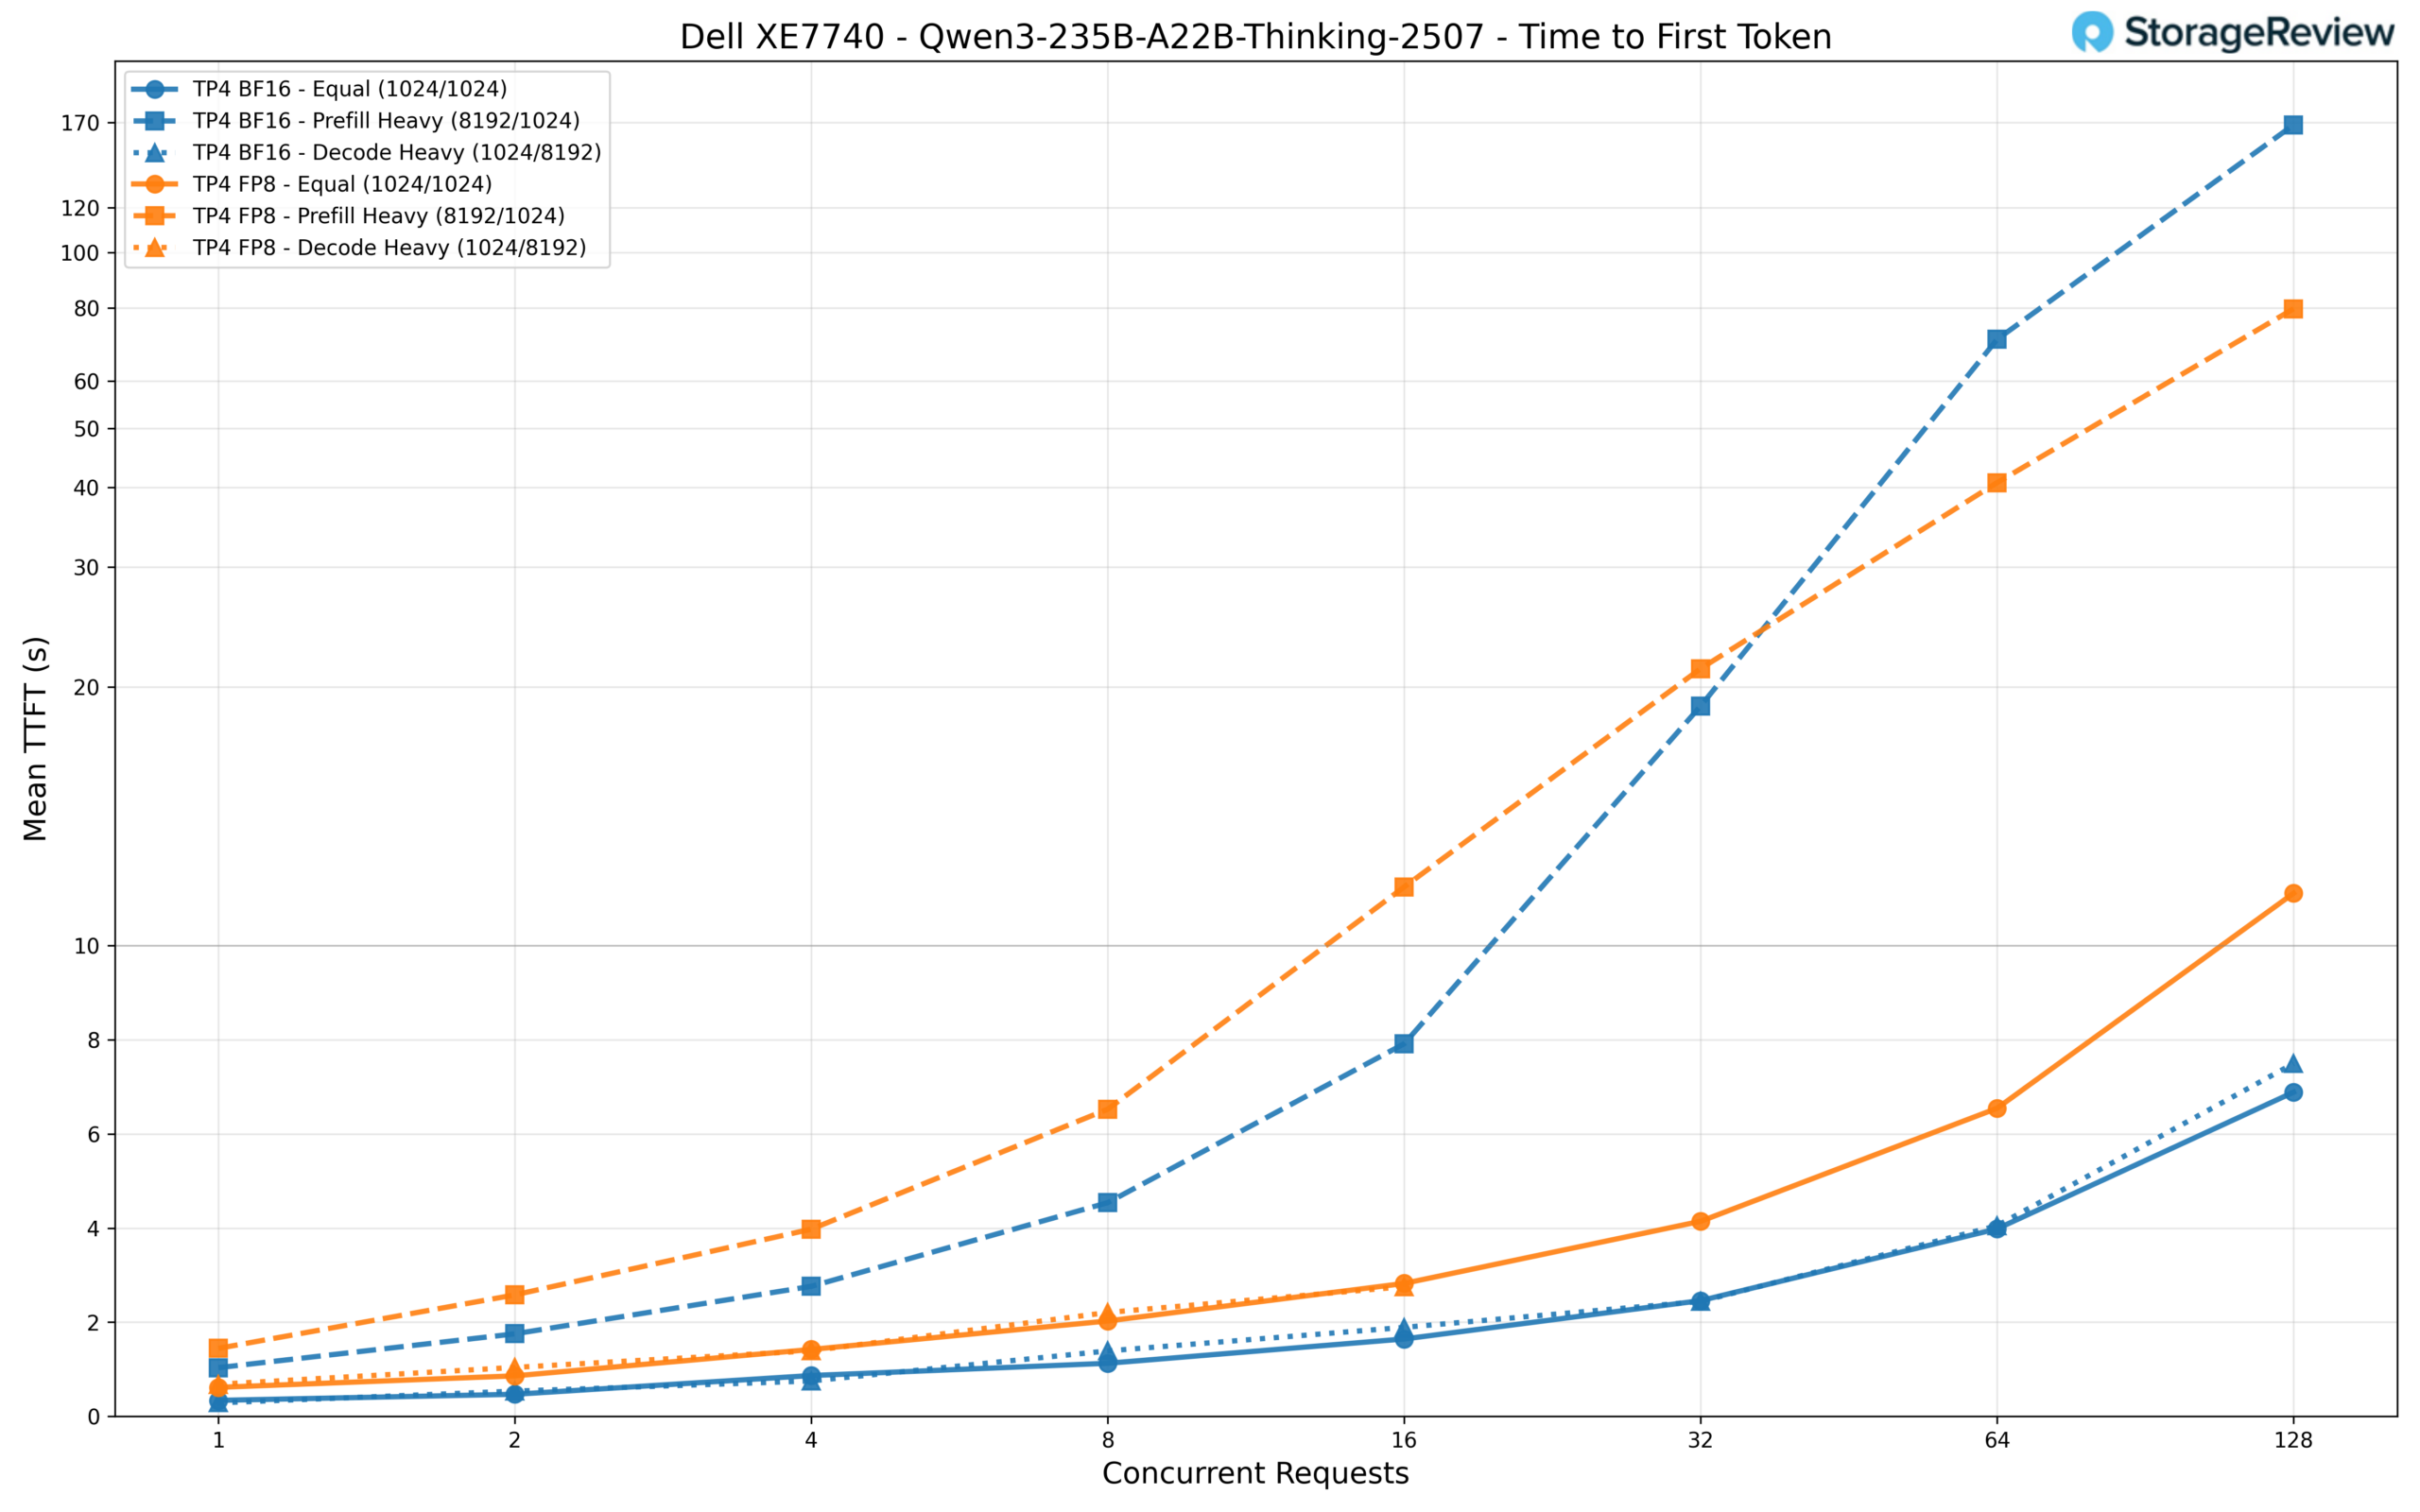
Per TTFT, BF16 parte da circa 340 ms per una singola richiesta di uguale lunghezza e arriva a circa 6.9 secondi con 128 richieste simultanee. Questo è un risultato piuttosto reattivo per un modello di queste dimensioni. FP8 è circa il doppio più lento, partendo da 615 ms e raggiungendo circa 11.2 secondi a pieno carico. Il carico di lavoro con precaricamento intensivo è lo scenario più impegnativo, con BF16 che arriva a 168 secondi e FP8 a 80 secondi con 128 richieste.
Chi è questo per?
La domanda di inferenza non accenna a diminuire. Che si tratti di implementare modelli internamente per accelerare i team di sviluppo, di integrare l'IA nei prodotti rivolti ai clienti o di creare pipeline di automazione attive 24 ore su 24, i requisiti di calcolo continuano ad aumentare. E con questa domanda si ripresenta un collo di bottiglia ben noto: l'approvvigionamento. I tempi di attesa per gli acceleratori più richiesti possono estendersi per mesi, bloccando progetti già finanziati e con personale già assegnato.
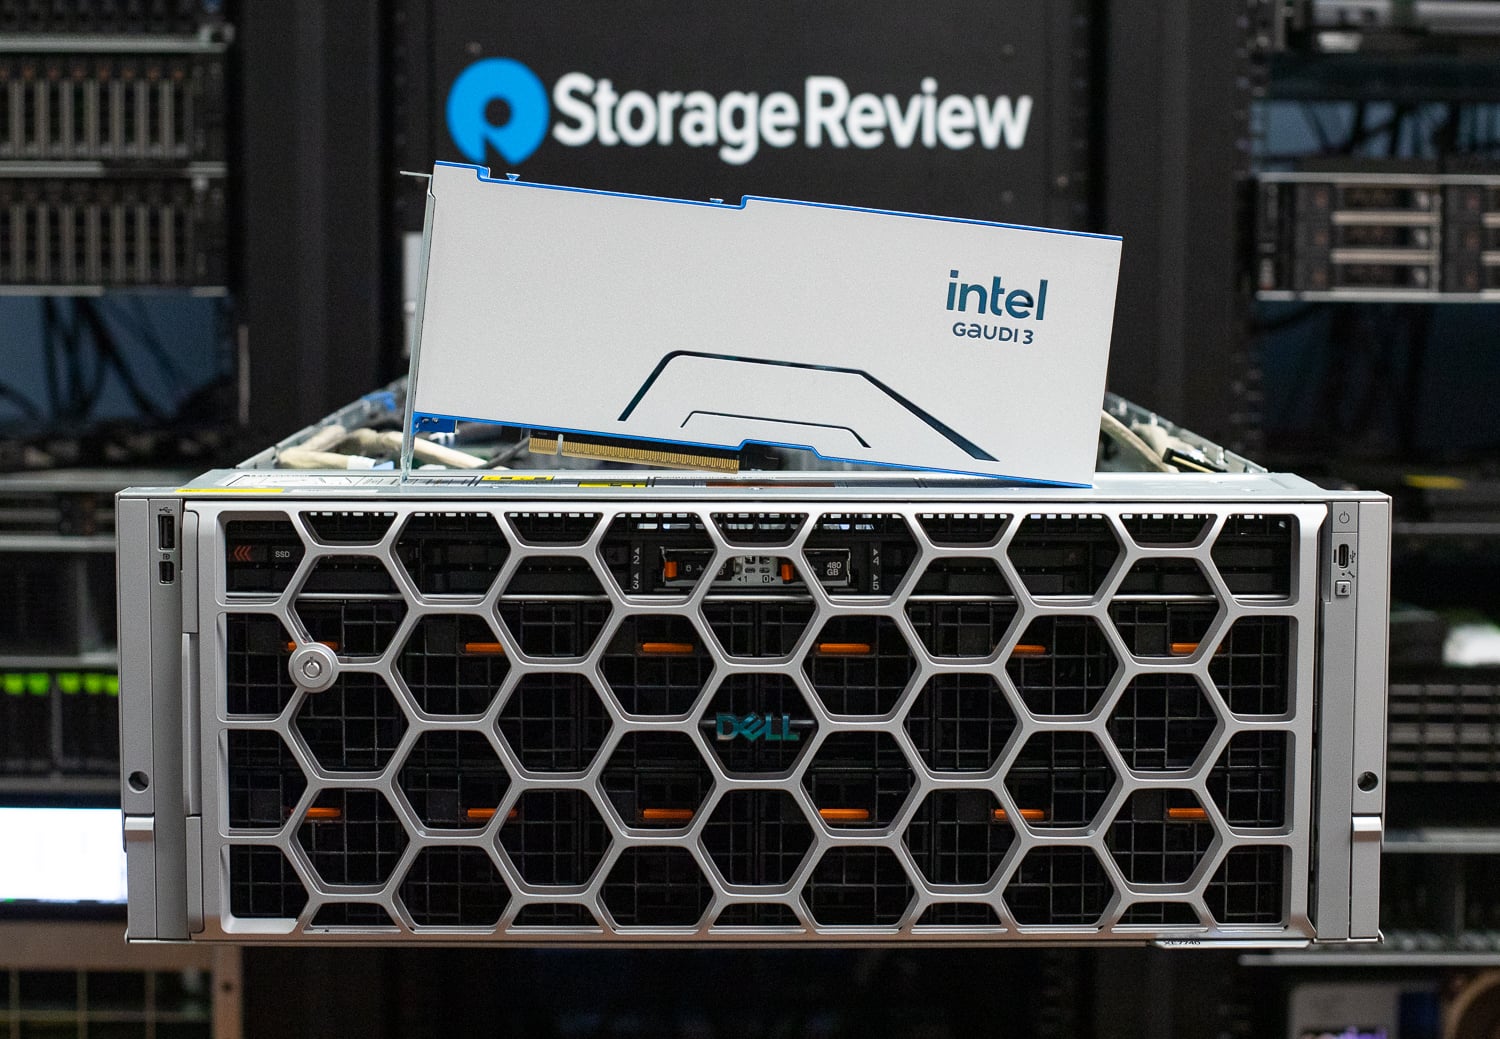
Il modello XE7740, configurato con Intel Gaudi 3, affronta direttamente questo limite. Gli acceleratori Gaudi 3 sono già disponibili e Intel fornisce modelli di implementazione validati che consentono ai team di passare dall'unboxing all'erogazione di servizi di inferenza in poche ore. Dell semplifica ulteriormente le cose con programmi di prova e acquisto che installano i sistemi XE7740 direttamente nel vostro ambiente, permettendovi di validare le prestazioni rispetto ai vostri carichi di lavoro, dati e infrastruttura reali prima di impegnarvi in un'implementazione completa. Questa combinazione di disponibilità immediata, rapido ritorno sull'investimento e valutazione a basso rischio rende la configurazione Gaudi 3 particolarmente interessante per le organizzazioni che necessitano di capacità di inferenza oggi stesso e non possono permettersi di attendere i tempi di assegnazione.
Detto questo, l'XE7740 non è una piattaforma con un solo acceleratore. Grazie all'impegno di Dell per la diversità dei chip, la stessa piattaforma può essere configurata con diverse opzioni e con tutti gli acceleratori più diffusi sul mercato, e la scelta migliore dipende interamente dal carico di lavoro. Le pipeline di elaborazione video, ad esempio, si prestano perfettamente agli acceleratori NVIDIA L4, e l'XE7740 può essere equipaggiato con 16 GPU L4 insieme a 8 slot NIC PCIe Gen5 x16 per un sistema di streaming e transcodifica senza compromessi. Le organizzazioni che gestiscono carichi di lavoro AI misti in diversi reparti possono standardizzare lo chassis XE7740 e variare semplicemente la configurazione degli acceleratori per adattarla a ciascuna implementazione, semplificando la gestione del parco macchine e personalizzando la potenza di calcolo in base all'attività.
Conclusione
Il Dell PowerEdge XE7740 è progettato per le esigenze specifiche dell'inferenza aziendale. Il suo design termico a doppia zona, la topologia PCIe strutturata, l'architettura di memoria ad alta larghezza di banda e la capacità di rete scalabile lo rendono un sistema pensato per carichi di lavoro di produzione continui. Queste non sono scelte di progettazione casuali; riflettono un modello infrastrutturale in cui l'inferenza viene eseguita in modo continuo, si adatta in modo prevedibile e si integra perfettamente nelle operazioni del data center esistente. In questa valutazione, Intel Gaudi 3 dimostra che l'XE7740 offre prestazioni di inferenza ottimali su architetture dense e MoE, con un comportamento di scalabilità prevedibile e un throughput elevato limitato dalla memoria. Le ottimizzazioni software continueranno a migliorare, ma le fondamenta architetturali della piattaforma sono già solide.
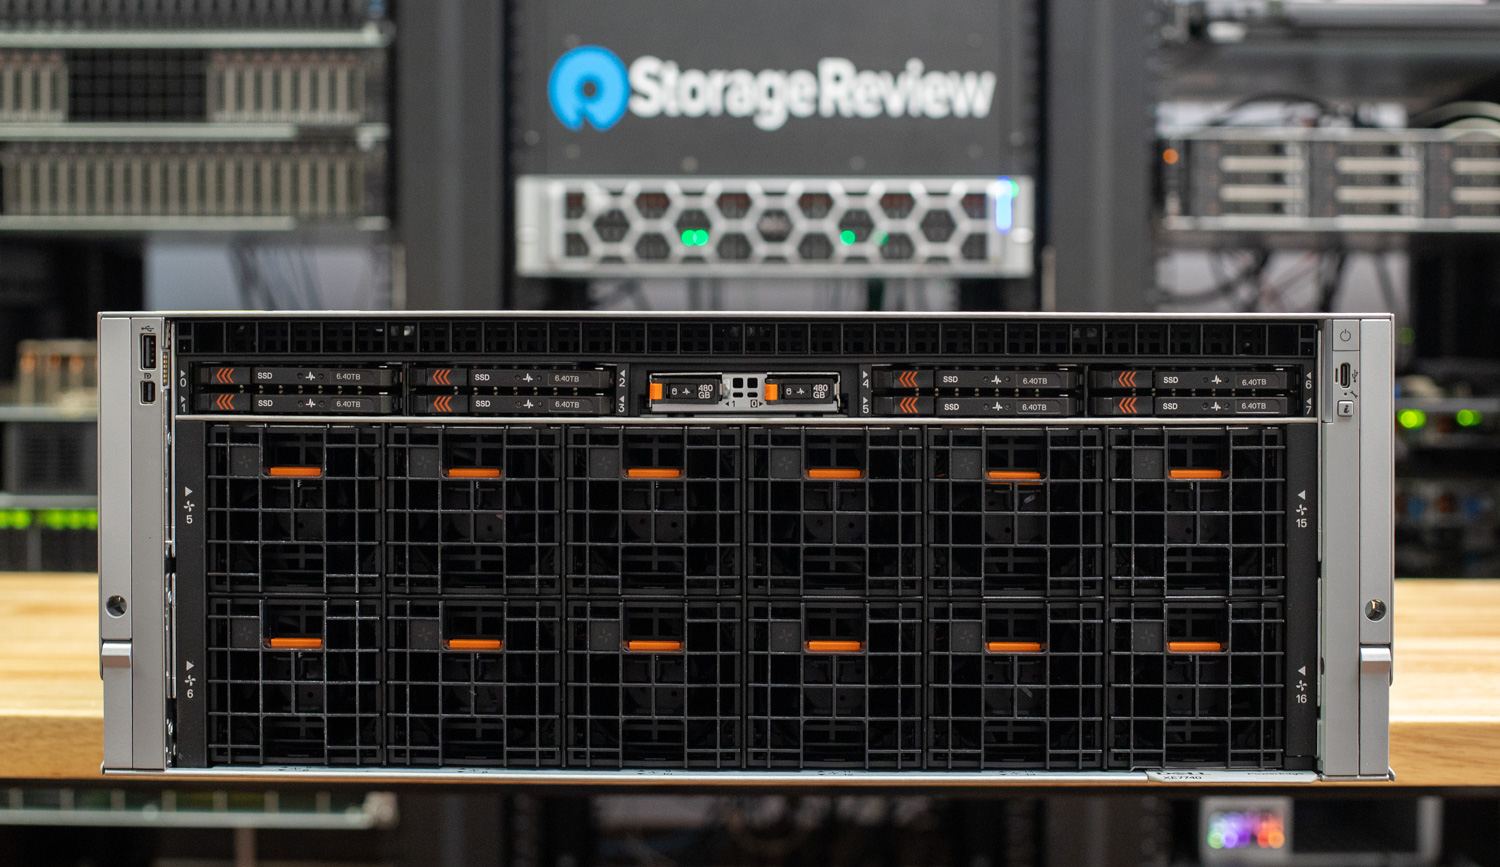
Ancora più importante, l'XE7740 definisce un modello solido e affidabile per l'infrastruttura AI aziendale. Le organizzazioni possono standardizzare chassis, stack di gestione e modello di implementazione coerenti, adattando al contempo la strategia di accelerazione nel tempo. Con la crescita dei modelli, la diversificazione dei carichi di lavoro e l'integrazione sempre più profonda dell'inferenza nelle operazioni aziendali, la necessità di un'infrastruttura stabile e adattabile non potrà che aumentare. Il PowerEdge XE7740 è progettato per rispondere a questa esigenza. Offre l'equilibrio architetturale, la maturità operativa e il margine di espansione necessari per l'IA aziendale, nel passaggio dalla fase di rapida adozione all'integrazione a lungo termine.
Questo rapporto è sponsorizzato da Dell Technologies. Tutti i pareri e le opinioni espressi in questo rapporto si basano sulla nostra visione imparziale dei prodotti in esame.


 Amazon