

La tecnologia si muove seguendo cicli e, in questo momento, nessun ciclo è più evidente dell’enfasi posta sull’intelligenza artificiale all’avanguardia. In particolare, stiamo riscontrando un massiccio passaggio all’inferenza dei bordi. NVIDIA gioca un ruolo importante in questa spinta, poiché desidera promuovere l'adozione delle proprie GPU al di fuori dei data center. Tuttavia, il fatto è che le aziende devono prendere più decisioni più rapidamente, quindi l’infrastruttura AI deve avvicinarsi ai dati.
Ricordi Hub-and-Spoke?
Ai “vecchi tempi” parlavamo di vantaggio in termini di creazione di dati e di come riportarli al data center in modo rapido ed efficiente utilizzando la tradizionale metodologia hub-and-spoke. Quella progettazione ha lasciato il posto alla progettazione gerarchica, basata su core, accesso e distribuzione con molta ridondanza e hardware e l'unico scopo di riportare i dati al data center primario. Tutti i dati raccolti all'edge solo per essere trasportati al data center principale per l'elaborazione e poi respinti ai dispositivi edge si sono rivelati inefficienti, costosi e dispendiosi in termini di tempo.
Forse, dopotutto, il design hub-and-spoke non era poi così male. Con la spinta a fornire maggiore intelligenza ai margini della rete tramite l'IA e la rivoluzione del cloud computing, sembra che il design stia influenzando significativamente la progettazione delle reti, le implementazioni edge e il luogo in cui i dati vengono elaborati. Infatti, lo slogan della conferenza HPE Discover di quest'anno sarebbe stato molto familiare in qualsiasi anno precedente alla mania del cloud, se solo si fosse sostituito "core" con "cloud": "La conferenza dall'edge al cloud".
Saltare sullo slancio del limite
HPE non è stato l’unico fornitore a comprendere l’importanza dell’edge-to-cloud computing per il settore, e Dell Technologies ha raccontato una storia simile durante l’evento Dell Technologies World. Anche IBM, Lenovo, NetApp e Supermicro si sono espressi apertamente sulla necessità di fare di più nell’edge, utilizzando al tempo stesso le risorse cloud in modo più efficace.
Cosa sta guidando l’attenzione dell’edge computing? I clienti stanno generando volumi di dati all’edge raccolti da sensori, dispositivi IoT e raccolte di dati di veicoli autonomi. La vicinanza ai dati alla fonte offrirà vantaggi aziendali, tra cui insight più rapidi con previsioni accurate e tempi di risposta più rapidi con un migliore utilizzo della larghezza di banda. L'inferenza dell'AI all'edge (intelligenza utilizzabile utilizzando tecniche di intelligenza artificiale) migliora le prestazioni, riduce i tempi (tempo di inferenza) e riduce la dipendenza dalla connettività di rete, migliorando in definitiva i profitti aziendali.
Perché non eseguire l'inferenza Edge nel cloud?
Perché l’inferenza dei bordi non può essere eseguita nel cloud? Può, e per le applicazioni che non sono urgenti e ritenute non critiche, l'inferenza dell'intelligenza artificiale nel cloud potrebbe essere la soluzione. L’inferenza in tempo reale, tuttavia, presenta molte sfide tecniche, tra cui la latenza è la principale. Inoltre, con la continua crescita dei dispositivi IoT e delle applicazioni associate che richiedono l’elaborazione all’edge, potrebbe non essere fattibile avere una connessione cloud ad alta velocità disponibile per tutti i dispositivi.
L’edge computing porta con sé sfide che includono il supporto in loco, la sicurezza fisica e delle applicazioni e uno spazio limitato che porta a uno spazio di archiviazione limitato. Gli odierni server edge offrono una potenza di calcolo adeguata per i carichi di lavoro edge tradizionali, mentre le GPU aggiungono più potenza senza aumentare la complessità.
Crescita delle opzioni Edge
È interessante notare che i fornitori di sistemi più piccoli hanno dominato principalmente il mercato delle infrastrutture edge. Supermicro, ad esempio, parla da anni di 5G e data center sui pali telefonici, e Advantech e molti altri fornitori di server specializzati hanno fatto lo stesso. Ma man mano che le GPU sono migliorate e, cosa ancora più importante, il software che le supporta, l’intera nozione di intelligenza artificiale all’edge sta diventando più reale.
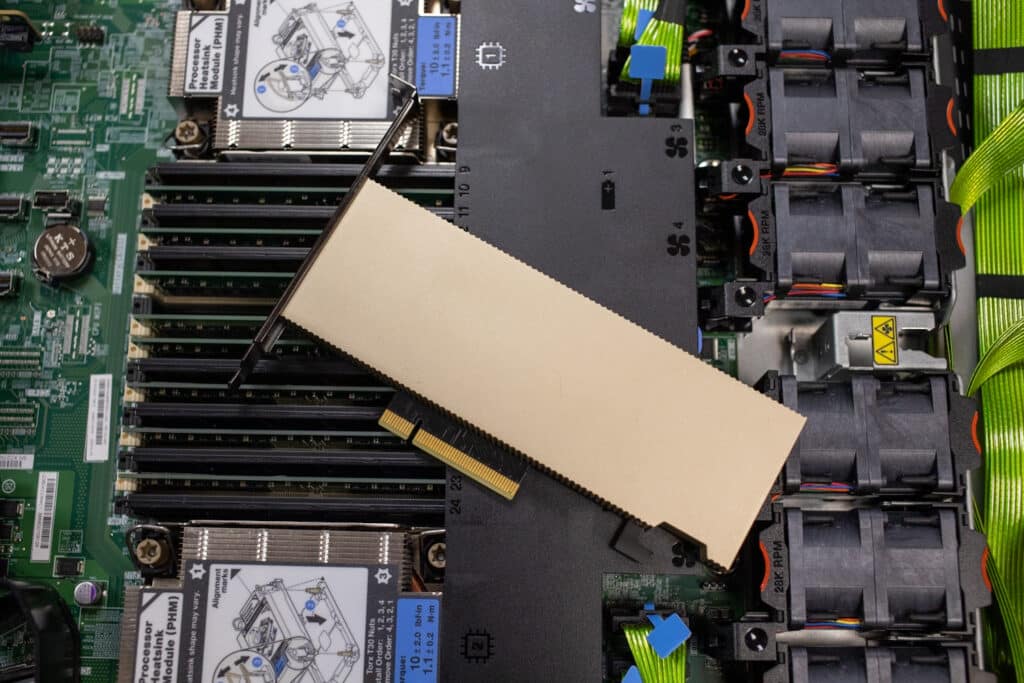
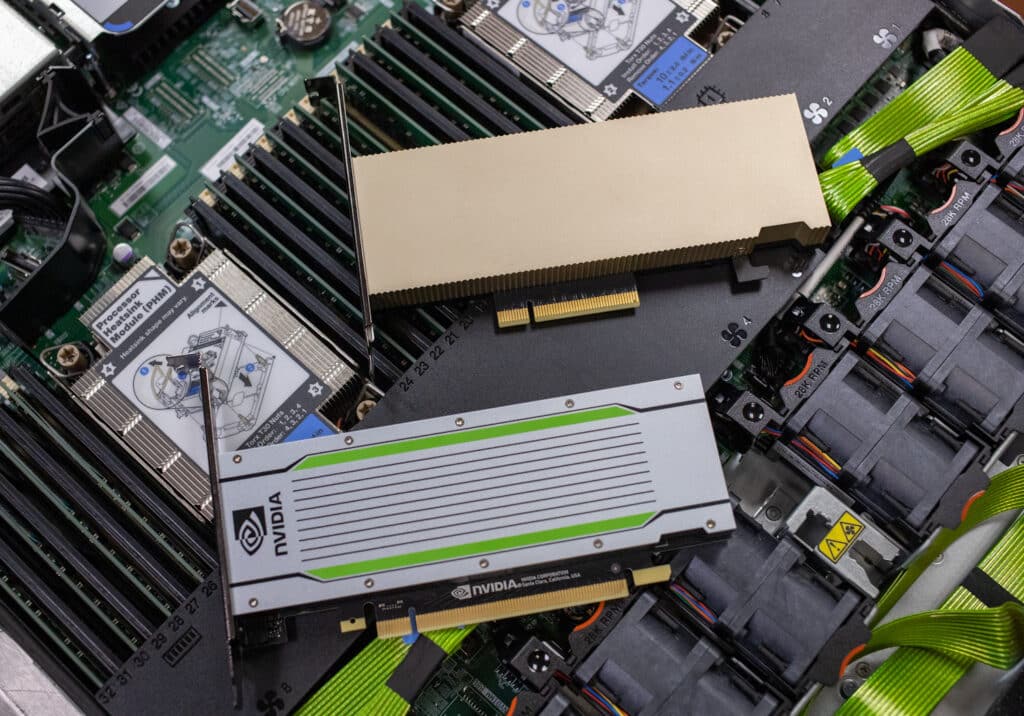
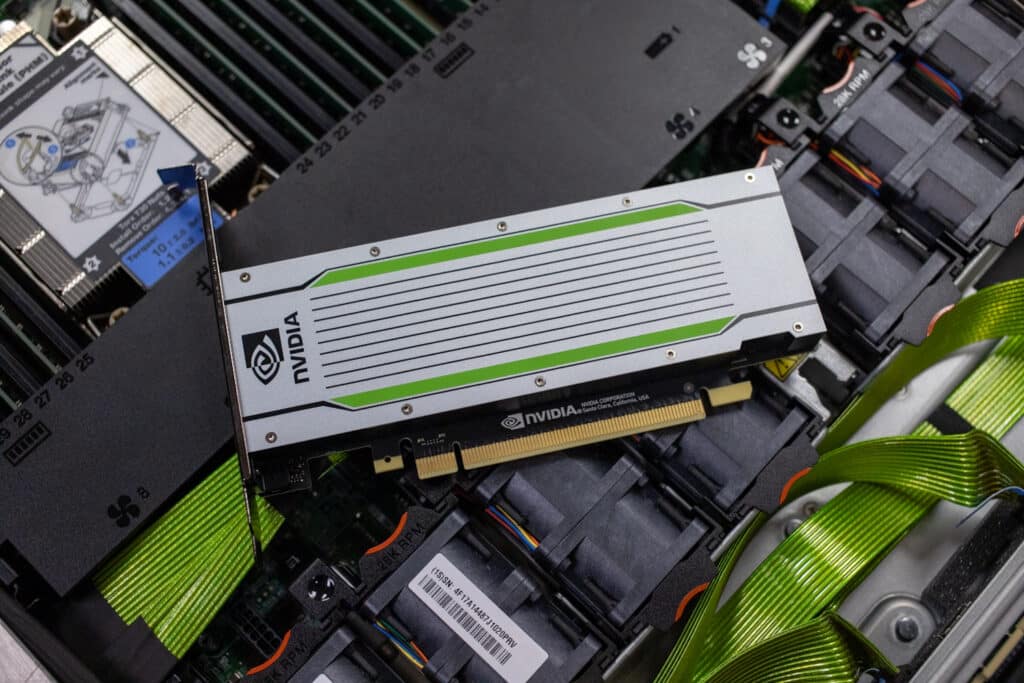
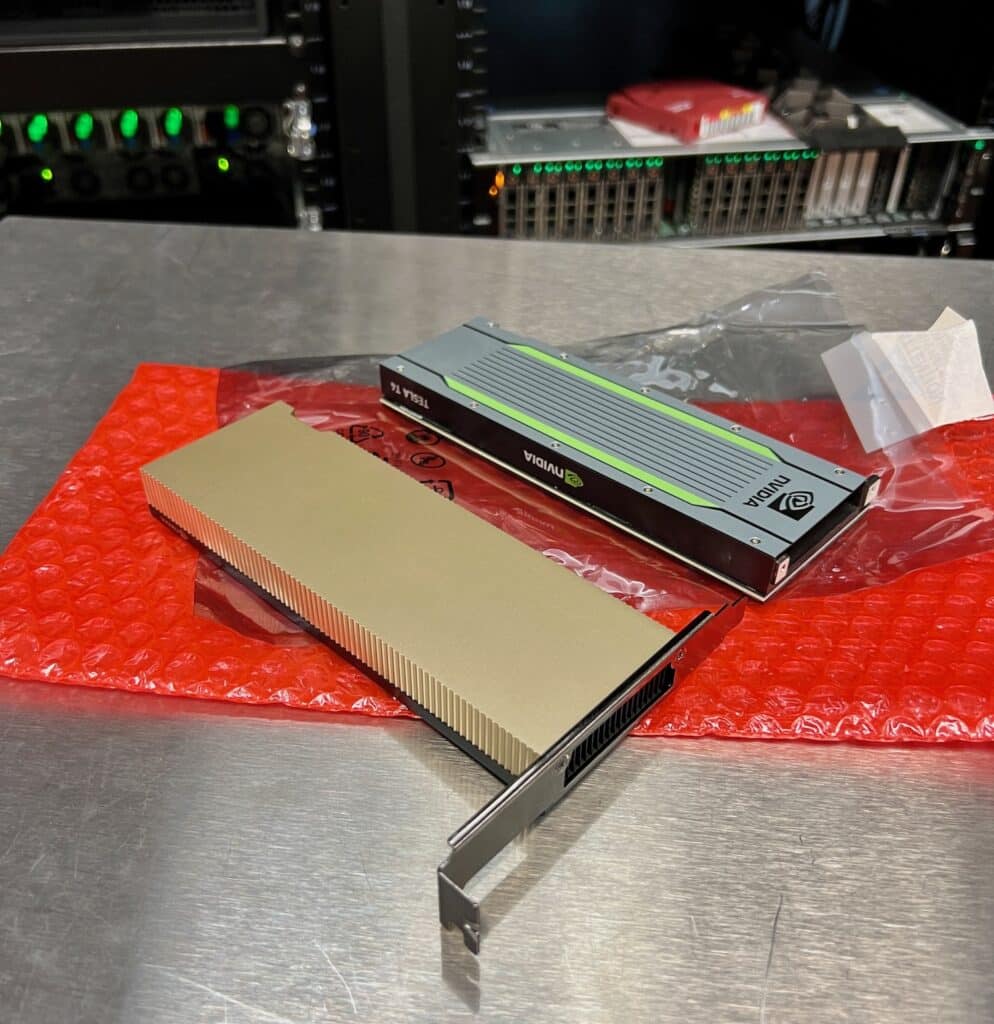
Recentemente abbiamo assistito a questa transizione nel nostro laboratorio in diversi modi. Innanzitutto, i nuovi progetti di server portano le GPU NVIDIA a slot singolo e a basso consumo come l'A2 e il sempre popolare T4. Recentemente sia Lenovo che Supermicro ci hanno inviato server da valutare che integrano queste GPU e le prestazioni sono state impressionanti.
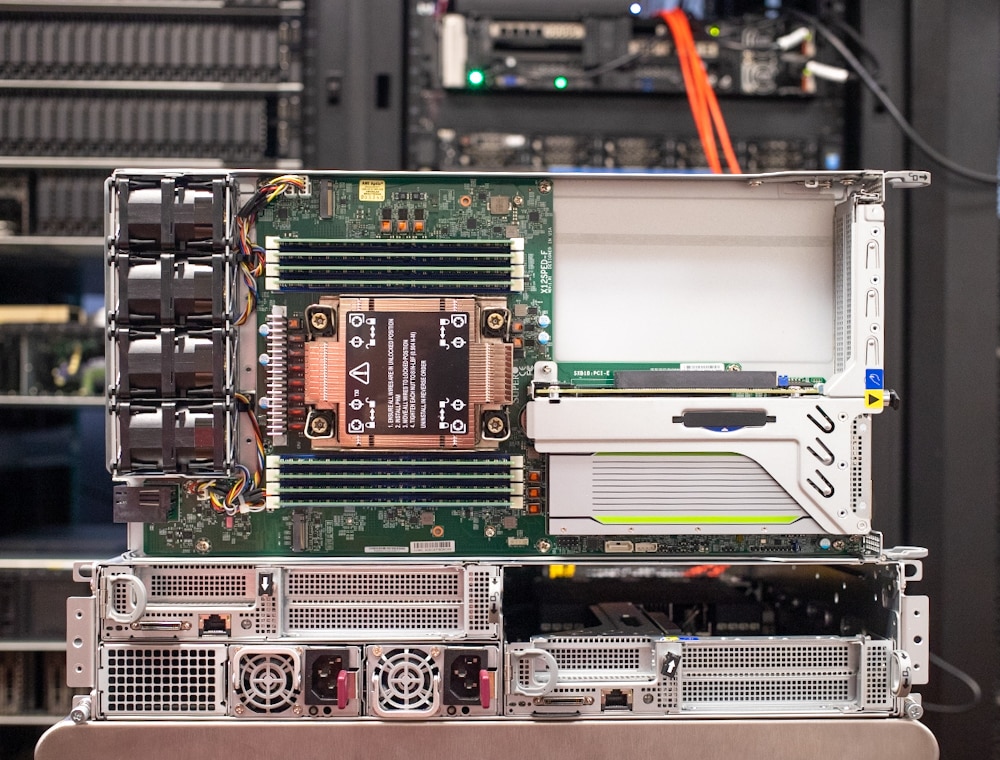 SuperMicro IoT SuperServer SYS-210SE-31A con NVIDIA T4
In secondo luogo, i fornitori di infrastrutture pongono una forte enfasi sulla fornitura di soluzioni edge con metriche direttamente collegate agli elementi fondamentali dei data center, come la bassa latenza e la sicurezza. Recentemente abbiamo esaminato alcuni di questi casi d'uso con Dell PowerVault ME5 . Sebbene sia presentato come una soluzione di storage per PMI, ME5 suscita grande interesse per i casi d'uso edge grazie al suo rapporto costo/prestazioni.
In definitiva, però, la storia dell’inferenza dei bordi è piuttosto semplice. Dipende dalla capacità della GPU di elaborare i dati, spesso al volo. Abbiamo lavorato per espandere i nostri test per avere un'idea migliore di come questi nuovi server e GPU possono funzionare per il ruolo di inferenza edge. Nello specifico, abbiamo esaminato i carichi di lavoro edge più diffusi come il riconoscimento delle immagini e i modelli di elaborazione del linguaggio naturale.
Sfondo di test
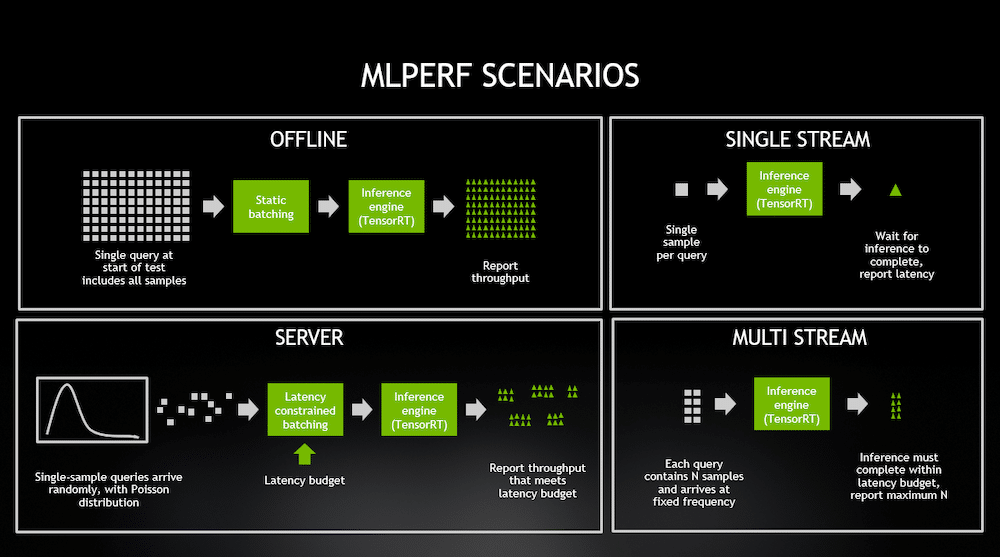
Stiamo lavorando con la suite di benchmark MLPerf Inference: Edge. Questo set di strumenti confronta le prestazioni di inferenza per i modelli DL più diffusi in vari scenari edge del mondo reale. Nei nostri test, abbiamo numeri per il modello di classificazione delle immagini ResNet50 e il modello BERT-Large NLP per le attività di risposta alle domande. Entrambi vengono eseguiti nelle configurazioni offline e SingleStream.
Lo scenario offline valuta le prestazioni di inferenza in "modalità batch", quando tutti i dati di test sono immediatamente disponibili e la latenza non è una considerazione. In questa attività, lo script di inferenza può elaborare i dati di test in qualsiasi ordine e l'obiettivo è massimizzare il numero di query al secondo (QPS=throughput). Più alto è il numero QPS, meglio è.
La configurazione Single Stream, al contrario, elabora un campione di test alla volta. Una volta eseguita l'inferenza su un singolo input (nel caso ResNet50, l'input è una singola immagine), viene misurata la latenza e il campione successivo viene reso disponibile allo strumento di inferenza. L'obiettivo è ridurre al minimo la latenza per l'elaborazione di ciascuna query; minore è la latenza, meglio è. La latenza del 90° percentile del flusso di query viene acquisita come metrica di destinazione per brevità.
L'immagine qui sotto proviene da un post del blog di NVIDIA sull'inferenza MLPerf 0.5, che visualizza molto bene gli scenari. Puoi leggere ulteriori informazioni sui vari scenari nel documento originale sull'inferenza MLPerf qui.
Inferenza Edge - Lenovo ThinkEdge SE450
Dopo aver recensito il ThinkEdge SE450 , abbiamo collaborato con Lenovo per eseguire MLPerf sulle GPU NVIDIA A2 e T4 presenti nel sistema. L'obiettivo era quello di capire cosa l'SE450 potesse fare con una sola GPU. Va notato che il sistema può supportare fino a quattro GPU NVIDIA a basso consumo, ed è logico estrapolare questi dati al numero di schede desiderate.
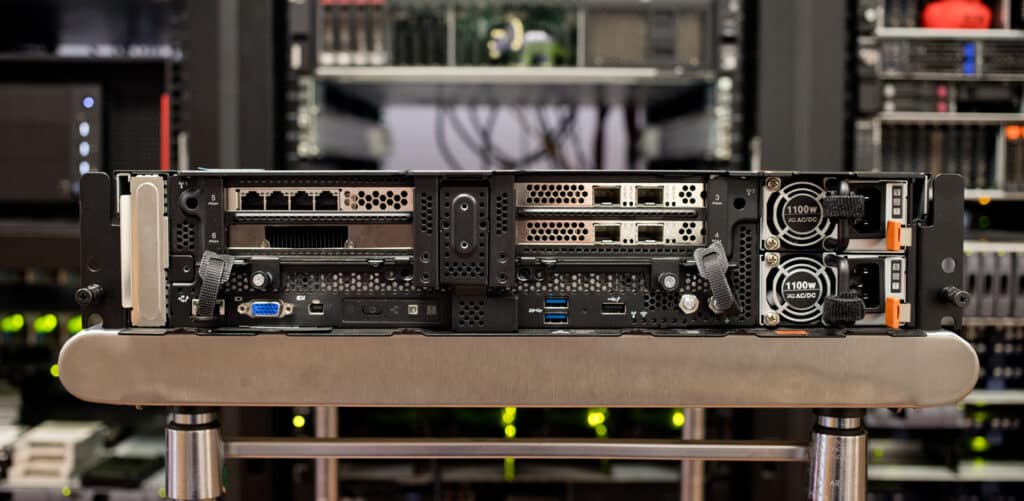
Per questo test, abbiamo lavorato direttamente con Lenovo, testando le varie configurazioni nel nostro laboratorio sia con NVIDIA A2 che con T4. Con MLPerf, i fornitori dispongono di un sistema di test specifico ottimizzato per la loro particolare piattaforma. Abbiamo utilizzato il test cablaggio di Lenovo per questo benchmarking di inferenza perimetrale per avere un'idea di dove escono queste popolari GPU.
I risultati dei test per A2 e T4 nell'SE450 nel nostro laboratorio:
| Segno di riferimento | NVIDIA A2 (TDP 40-60 W) | NVIDIA T4 (TDP 70 W) |
|---|---|---|
| ResNet50 SingleStream | Latenza di 0.714 ms | 0.867 latenza |
| ResNet50 non in linea | 3,032.18 campioni/i | 5,576.01 campioni/i |
| BERT SingleStream | Latenza di 8.986 ms | Latenza di 8.527 ms |
| BERT Non in linea | 244.213 campioni/i | 392.285 campioni/i |
È interessante notare che NVIDIA T4 ha funzionato davvero bene in ogni sua parte, il che sorprende alcuni basandosi esclusivamente sulla sua età. Il profilo prestazionale del T4 è una ragione abbastanza evidente per cui il T4 è ancora molto popolare. Detto questo, l'A2 ha un significativo vantaggio di latenza rispetto al T4 nell'inferenza delle immagini in tempo reale.
Alla fine la decisione sulla GPU è calibrata sul compito specifico da svolgere. La vecchia NVIDIA T4 consuma più energia (70 W) e utilizza uno slot PCIe Gen3 x16 mentre la più recente A2 è progettata per funzionare con meno energia (40-60 W) e utilizza uno slot PCIe Gen4 x8. Man mano che le organizzazioni comprendono meglio ciò che chiedono alla propria infrastruttura all’edge, i risultati saranno più significativi e i progetti di inferenza all’edge avranno maggiori probabilità di successo.
Considerazioni finali
I fornitori stanno correndo per sviluppare server più piccoli, più veloci e più robusti per il mercato edge. Le organizzazioni, dalla vendita al dettaglio alle fabbriche fino al settore sanitario, chiedono a gran voce di ottenere informazioni più rapide sui dati raccolti alla fonte. Migliorare il tempo di inferenza, ridurre la latenza, con opzioni per migliorare le prestazioni e utilizzare la tecnologia emergente separerà rapidamente i vincitori dai perdenti.
Il mercato edge non si ferma poiché le organizzazioni trovano nuovi modi per utilizzare le informazioni raccolte dal numero in continua espansione di dispositivi IoT. Il nostro team vede un’importante opportunità per coloro che possono muoversi rapidamente nei rispettivi settori di trarre vantaggio dall’intelligenza artificiale all’edge, che include questo caso d’uso di inferenza edge.
Prevediamo che i principali attori nel settore delle infrastrutture IT risponderanno con soluzioni innovative per questo specifico caso d'uso nel corso del prossimo anno. Inoltre, e forse ancora più importante, ci aspettiamo di assistere a numerosi progressi nel software per contribuire a democratizzare l'utilizzo delle GPU in questi casi d'uso edge. Affinché questa tecnologia sia davvero trasformativa, deve essere più facile da implementare di quanto non lo sia oggi. Visto il lavoro che stiamo vedendo non solo da parte di NVIDIA, ma anche da aziende di software come Vantiq , Viso.ai e molte altre, siamo ottimisti sul fatto che un numero maggiore di organizzazioni potrà dare vita a questa tecnologia.



 Amazon