

Con il lancio iniziale della piattaforma DGX Spark di NVIDIA, diversi produttori stanno ora integrando la piattaforma GB10 Grace Blackwell nei propri sistemi desktop compatti. Sebbene la scheda madre e il chip rimangano standardizzati, emergono differenze nel design dello chassis, nel sistema di raffreddamento, nella configurazione dello storage e nelle prestazioni complessive. In questa recensione, ci concentreremo sull'implementazione di GIGABYTE con l'AI TOP ATOM.
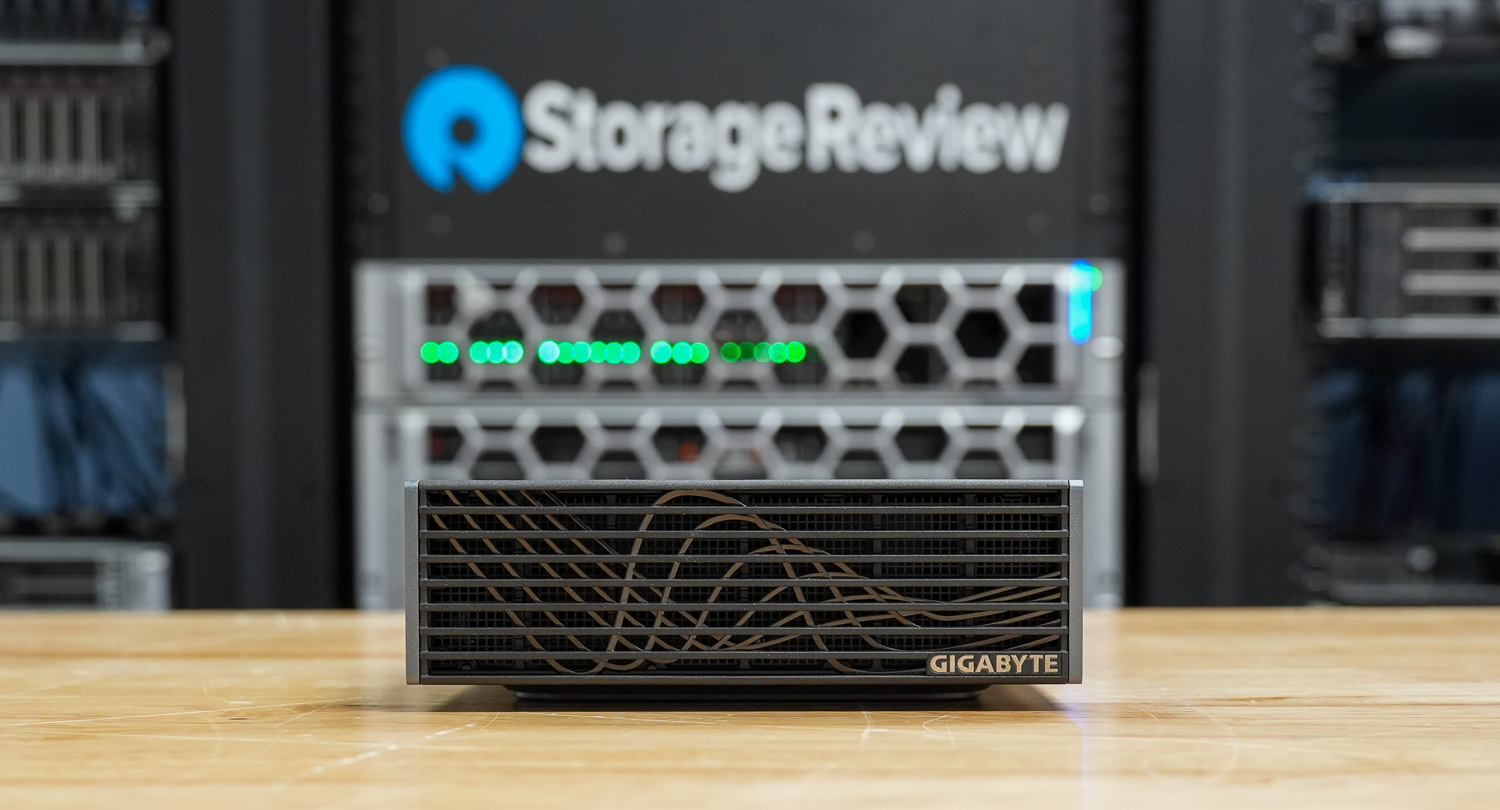
Al suo interno si trova lo stesso Superchip GB10, che combina un complesso CPU Arm a 20 core con l'accelerazione AI di Blackwell e 128 GB di memoria LPDDR5X unificata. Questa architettura supporta fino a 1 petaflop di calcolo FP4 e modella fino a 200 miliardi di parametri, posizionandosi saldamente nel territorio delle workstation per l'intelligenza artificiale.
L'AI TOP ATOM è alloggiato in un telaio compatto da 1 litro che misura 150 x 150 x 50.5 mm ed è alimentato da un adattatore esterno da 240 W. Sebbene il core di calcolo sia identico a quello degli altri sistemi Spark, esaminiamo come le scelte di progettazione di GIGABYTE influenzino la gestione termica, il comportamento sotto carico di lavoro prolungato, le prestazioni di archiviazione e l'usabilità quotidiana.
Le opzioni di archiviazione arrivano fino a 4 TB di NVMe Gen5 e il sistema viene fornito con NVIDIA DGX OS basato su Ubuntu, rendendolo pronto per i carichi di lavoro di intelligenza artificiale fin da subito. In breve, mentre l'hardware di calcolo principale rimane identico a quello degli altri sistemi di classe Spark, l'esperienza utente, la gestione termica, l'acustica e la presentazione generale dipendono da ciò che GIGABYTE offre in questo case compatto.
In questa recensione, esamineremo come la piattaforma Spark di GIGABYTE si comporta in termini di carichi di lavoro prolungati, gestione del raffreddamento e usabilità quotidiana, e se il suo formato compatto introduce compromessi significativi.
| Specificazione | GIGABYTE AI TOP ATOM (GB10) |
|---|---|
| Dimensioni e peso | |
| Altezza | 2 in |
| Larghezza | 5.9 in |
| Profondità | 5.9 in |
| Peso | 2.64 lb |
| Processore | |
| Tipo di processore | NVIDIA GB10 (Grace Blackwell Superchip) (20 core) |
| Grafica integrata | GPU NVIDIA Blackwell (integrata) |
| Memorie | |
| Tipo di memoria | LPDDR5x (Memoria di sistema unificata) |
| Configurazione della memoria | 128 GB LPDDR5x, memoria di sistema unificata |
| Banda di memoria | 273 GB/s (8533 MT/s) |
| Sistema operativo | |
| Sistemi operativi supportati | Sistema operativo NVIDIA DGX |
| Porte e slot esterni | |
| Porte di rete | Una porta RJ45 (10GbE) Scheda di rete NVIDIA ConnectX-7 (200G × 2 QSFP) |
| Porte USB | Tre porte USB 3.2 Gen 2×2 Type-C (20 Gbps) Una porta USB 3.2 Gen 2×2 Type-C con PD in |
| Porta(e) video | Una porta HDMI 2.1a |
| Porta adattatore di alimentazione | USB Type-C (ingresso PD) |
| Slot di sicurezza | Nona |
| Wireless | |
| WiFi | WiFi 7 (AW-EM637, 2×2) |
| Bluetooth | Bluetooth 5.4 |
| Archiviazione | |
| Opzioni di storage | Fino a 4 TB di NVMe Gen5 (con crittografia automatica supportata) |
| Adattatore di alimentazione | |
| Tipo | Adattatore esterno da 240 W (USB Type-C) |
Progettazione e realizzazione di GIGABYTE AI TOP ATOM
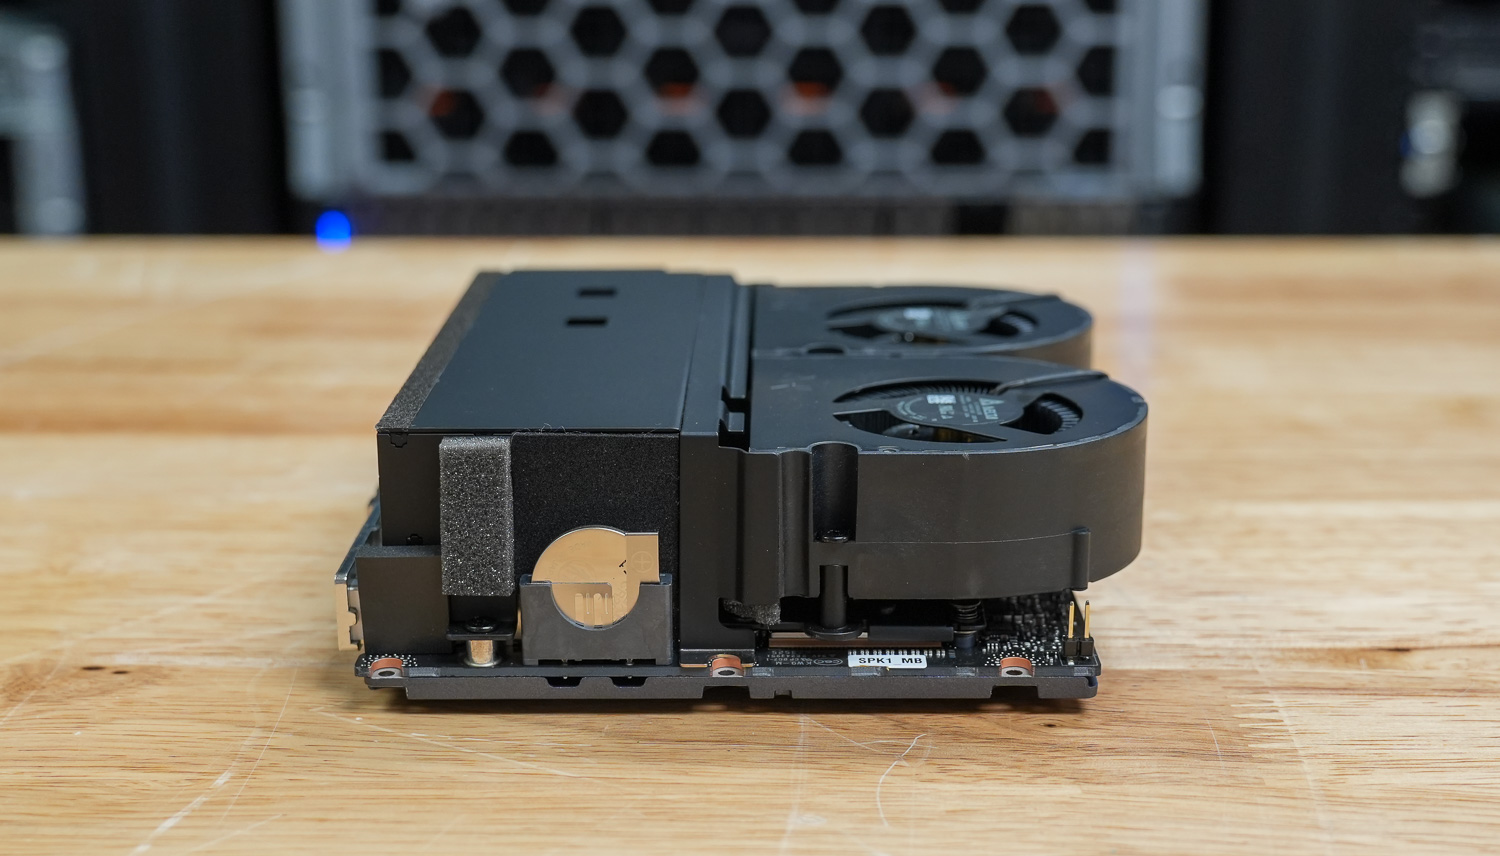
Il GIGABYTE AI TOP ATOM mantiene le dimensioni familiari di 150 x 150 mm che abbiamo visto su questi sistemi basati su Spark, con un'altezza di 50.5 mm e un peso di 1.2 kg. È sufficientemente compatto da poter essere posizionato su una scrivania, ma quando lo si prende in mano, si percepisce una sensazione di solidità e robustezza. La finitura scura e opaca gli conferisce un aspetto più da workstation.
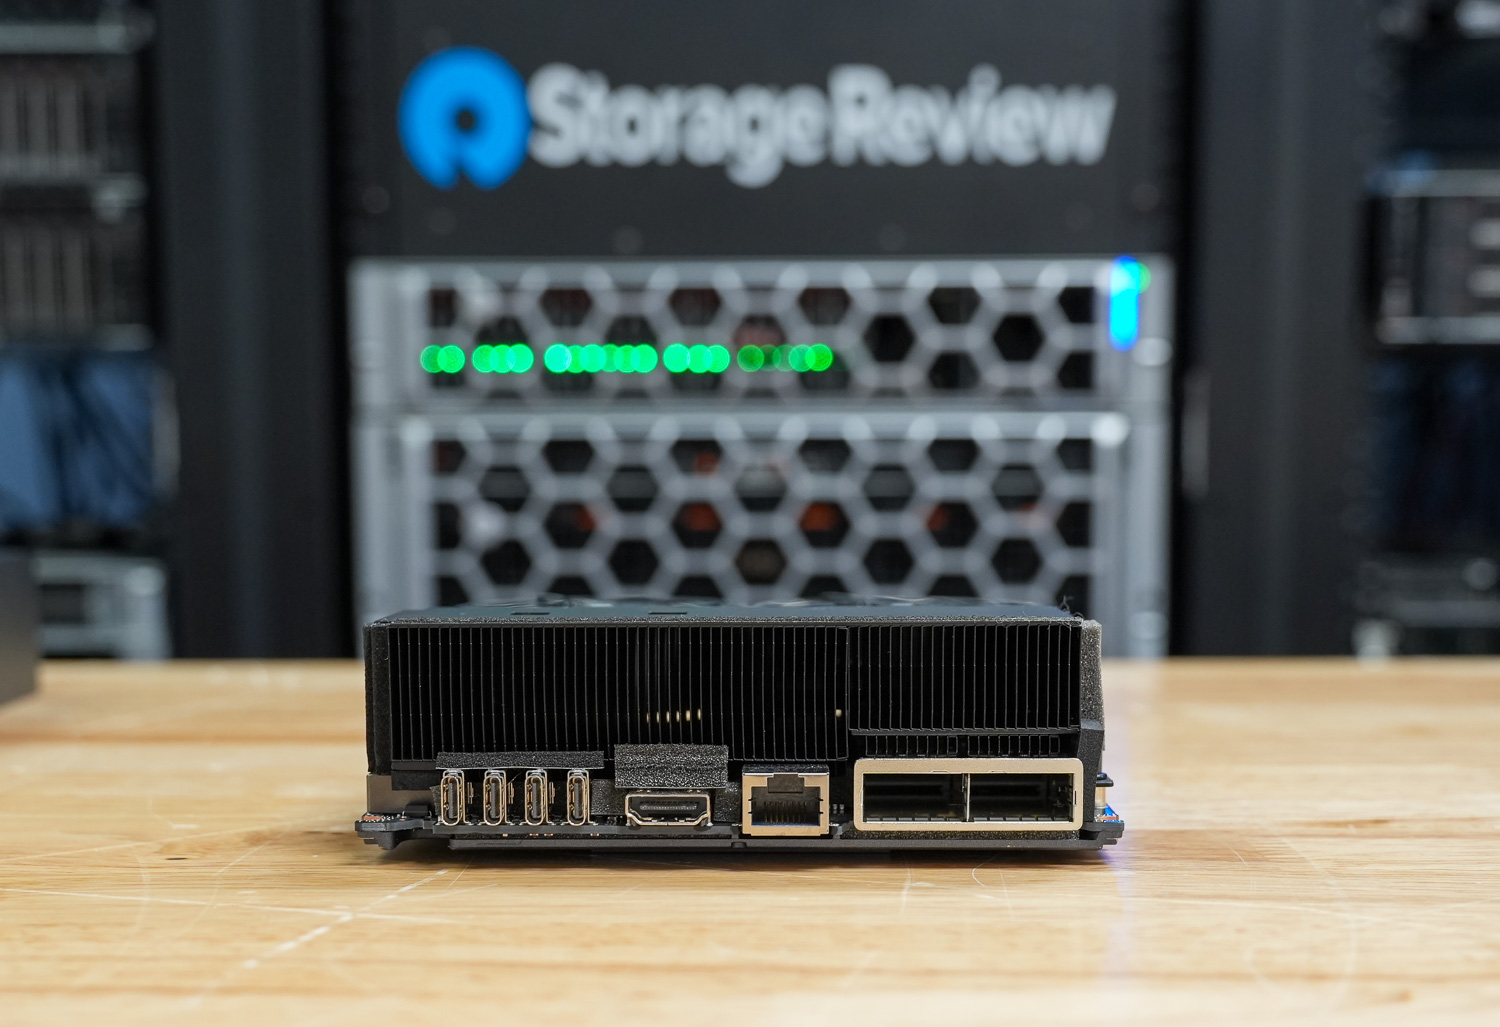
Invece di una semplice griglia piatta sul pannello frontale, l'intera superficie è composta da lamelle orizzontali con un delicato motivo ondulato dietro di esse, che conferisce profondità e texture se vista da diverse angolazioni. È un design incentrato sul raffreddamento. Il logo GIGABYTE è posizionato nell'angolo inferiore e non sono presenti porte dati frontali né un pulsante di accensione, in modo che la parte frontale rimanga pulita e ottimizzata per il flusso d'aria.
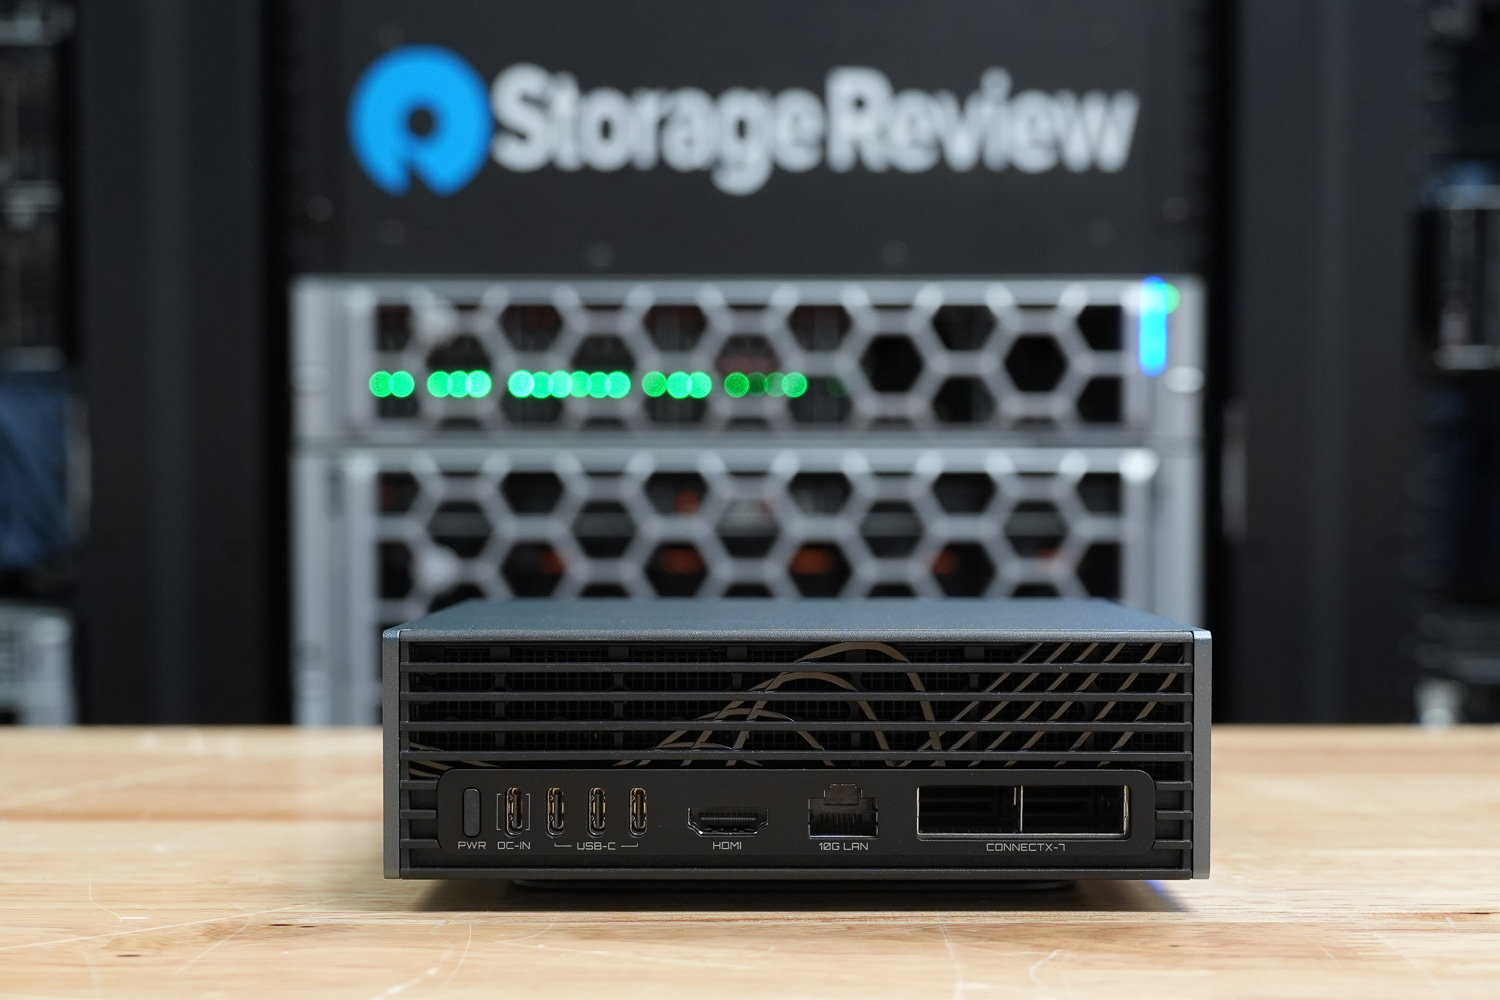
Tutte le opzioni di connettività si trovano sul pannello posteriore. Sono presenti tre porte USB 3.2 Gen 2×2 Type-C con velocità fino a 20 Gbps, oltre a una quarta porta USB Type-C dedicata all'alimentazione. Per l'uscita video, è inclusa una porta HDMI 2.1a. La connettività di rete comprende una porta RJ-45 da 10 GbE e una SmartNIC NVIDIA ConnectX-7, che supporta trasferimenti dati ad alta velocità e il collegamento di più sistemi per configurazioni più complesse. Sul pannello laterale, GIGABYTE ha integrato uno slot per lucchetto Kensington Nano.
All'interno, l'AI TOP ATOM si basa sul superchip GB10 Grace Blackwell di NVIDIA, che combina una configurazione CPU Arm a 20 core con grafica Blackwell integrata. È supportato da 128 GB di memoria unificata LPDDR5x su un'interfaccia a 256 bit, che offre una larghezza di banda fino a 273 GB/s. Come gli altri sistemi GB10, CPU e GPU condividono lo stesso pool di memoria, elemento chiave per il modo in cui queste macchine sono progettate per gestire i carichi di lavoro di intelligenza artificiale.
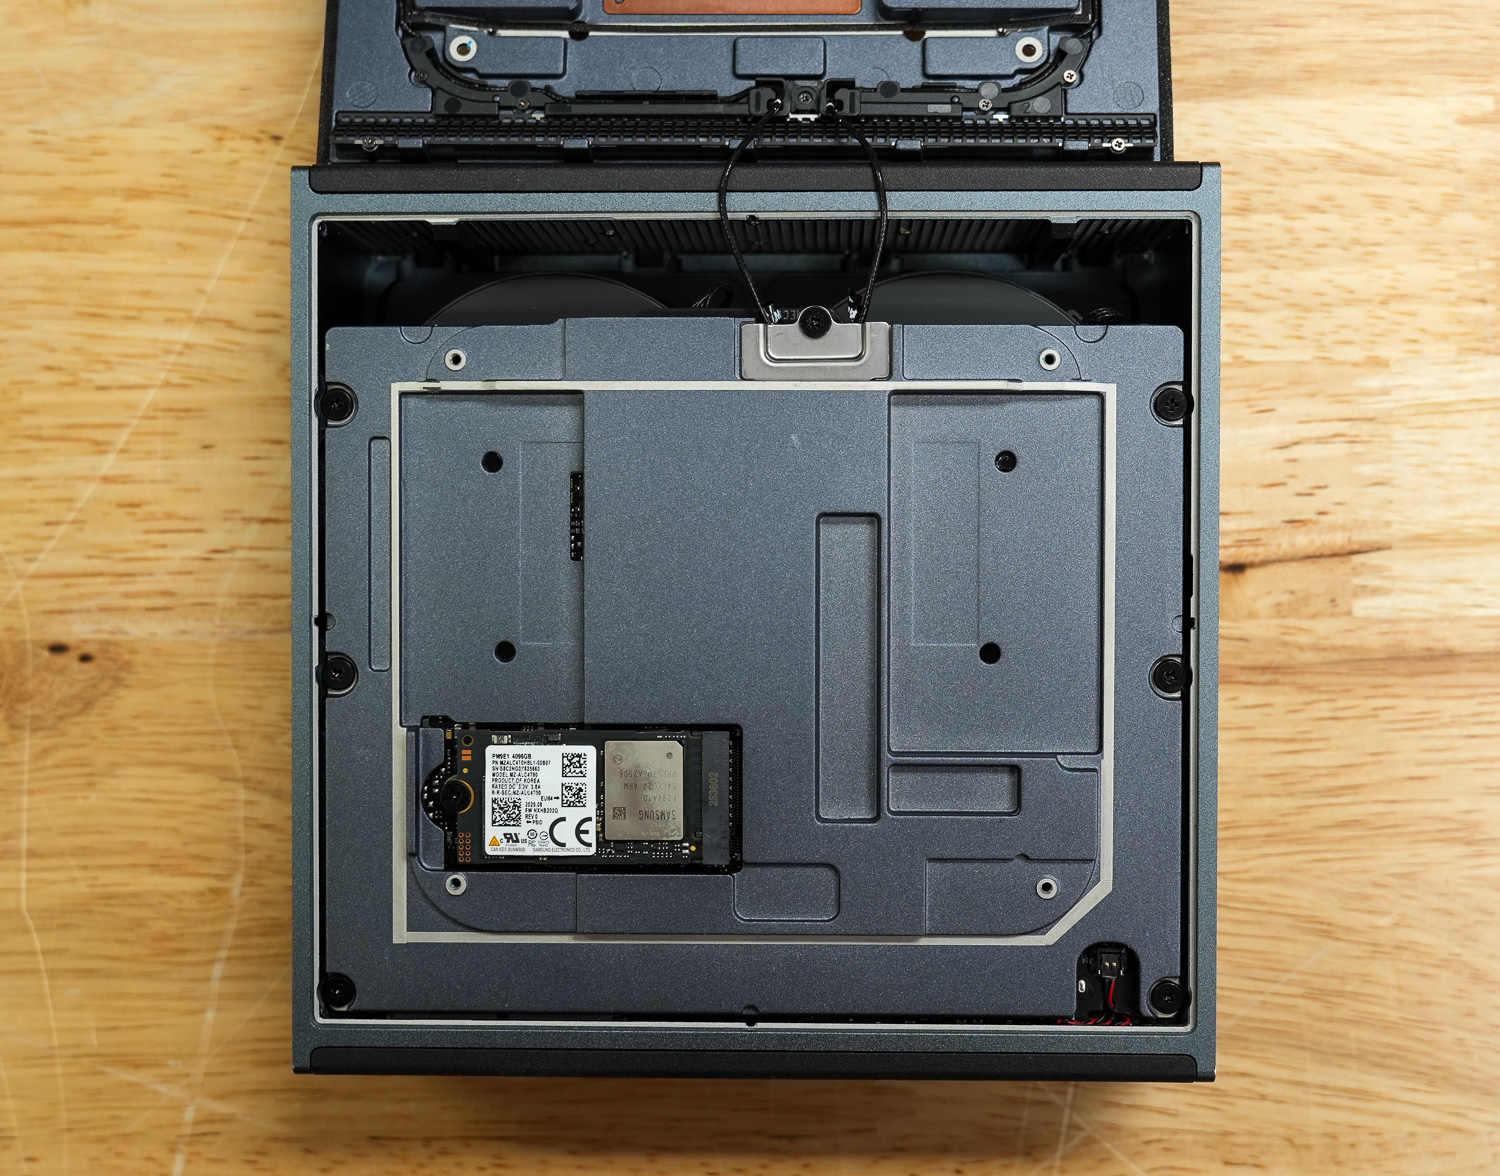
A seconda della configurazione, il supporto per lo storage arriva fino a un SSD NVMe Gen5 da 4 TB, mentre l'alimentazione è fornita tramite un adattatore esterno da 240 W. La connettività wireless include Wi-Fi 7 e Bluetooth 5.4, oltre alla rete 10 GbE integrata per prestazioni cablate elevate.
Test termici GIGABYTE AI TOP ATOM
Per testare le prestazioni termiche dei componenti del GIGABYTE AI TOP ATOM, li abbiamo confrontati con quelli della Founders Edition e di produttori OEM come Asus, Acer e Dell. Abbiamo approfondito questo aspetto nel nostro documento sui test termici di Spark.
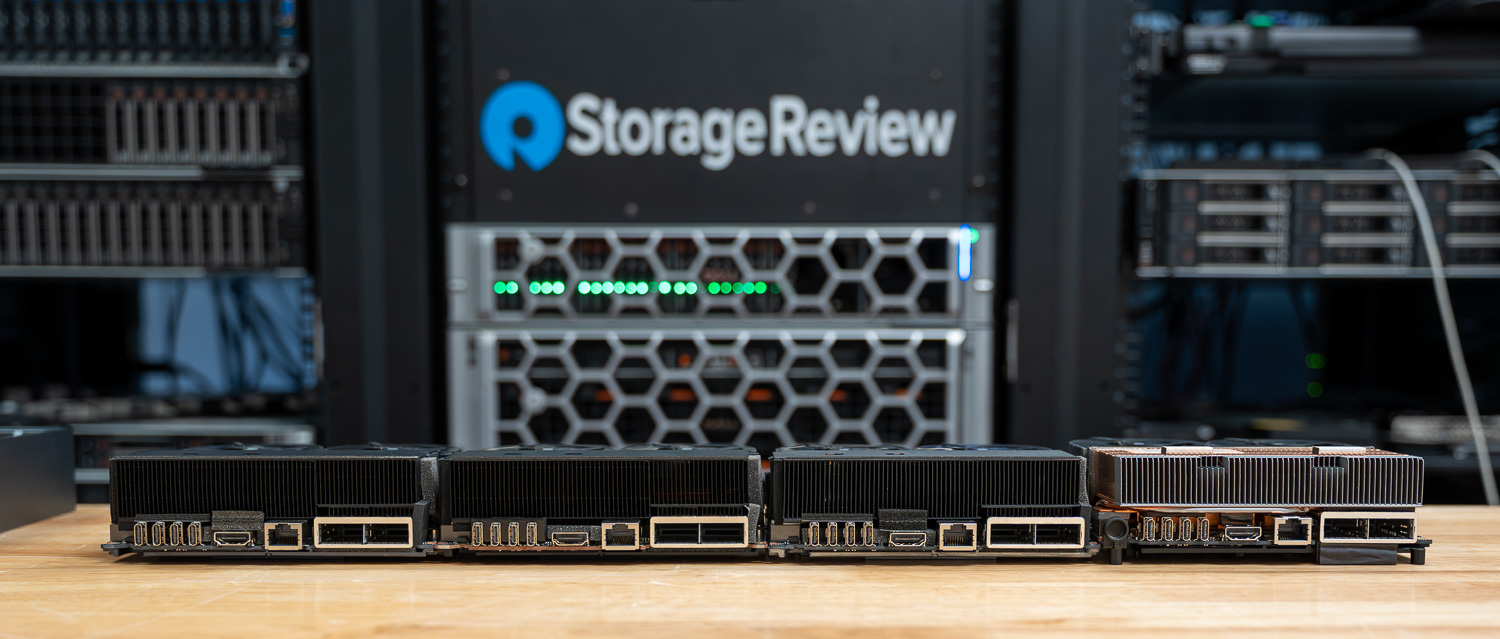
Abbiamo monitorato i componenti dell'intero stack per un determinato periodo di tempo, con 3 fasi di carico di lavoro, aumentando gradualmente l'utilizzo nell'arco di circa un'ora. Questo ci ha permesso di osservare il dispositivo in condizioni di utilizzo prolungato e in diverse fasi di carico di lavoro. Abbiamo monitorato le temperature di CPU, GPU, rete, NVMe e il consumo energetico totale.
Temperatura della CPU
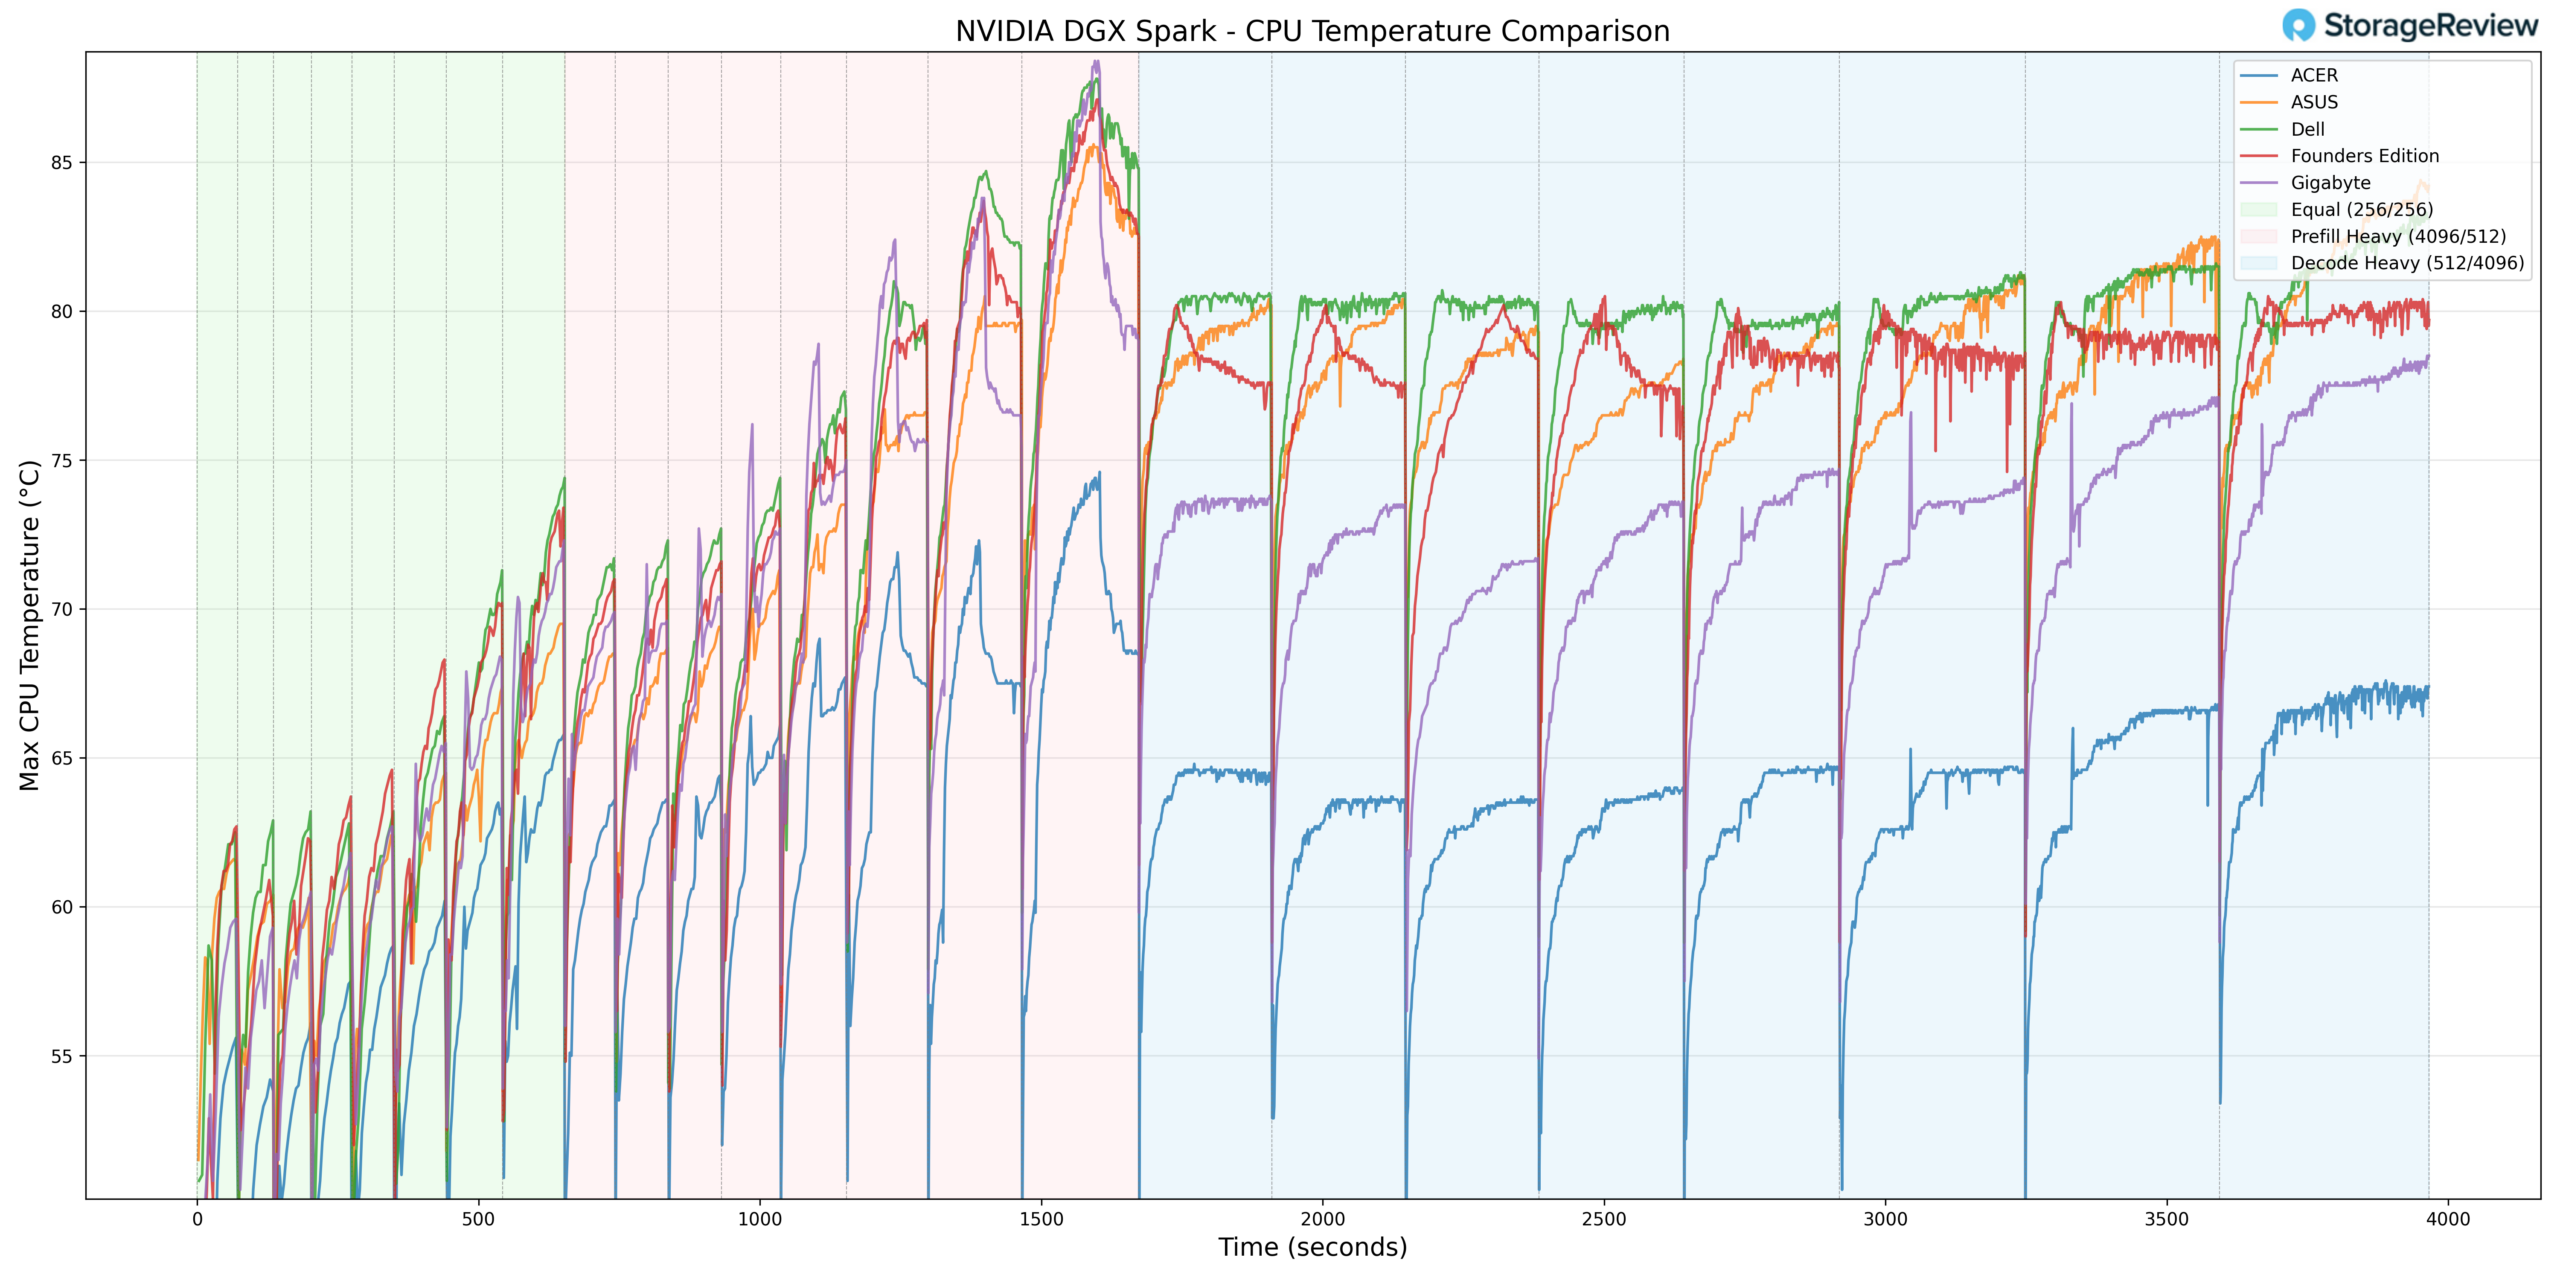
Durante i test termici della CPU, il sistema GIGABYTE ha raggiunto una temperatura massima di 90 °C durante le transizioni di pre-riempimento ad alto carico. Questo lo colloca verso il limite superiore dei picchi di temperatura della CPU osservati nel gruppo di confronto durante l'aumento del carico di lavoro aggressivo.
Una volta passati ai carichi di lavoro Equal ISL/OSL e infine a Decode Heavy, la curva di temperatura si è stabilizzata anziché continuare ad aumentare. Sotto carico prolungato, la CPU è rimasta in una fascia termica controllata, a dimostrazione che il picco più elevato era legato ad attività di rampa di breve durata piuttosto che a un'insufficiente capacità di raffreddamento a lungo termine.
Nella fascia inferiore, la CPU ha registrato una temperatura minima di 38.7 °C in condizioni di inattività o con carico leggero. Questo valore di base basso riflette un'efficiente dissipazione del calore a riposo e indica che la soluzione di raffreddamento mantiene un margine adeguato al di fuori delle fasi di picco.
Nel complesso, GIGABYTE ha mostrato temperature della CPU più elevate nei picchi di utilizzo, ma ha mantenuto un comportamento stabile e costante una volta che i carichi di lavoro si sono normalizzati.
Temperatura GPU
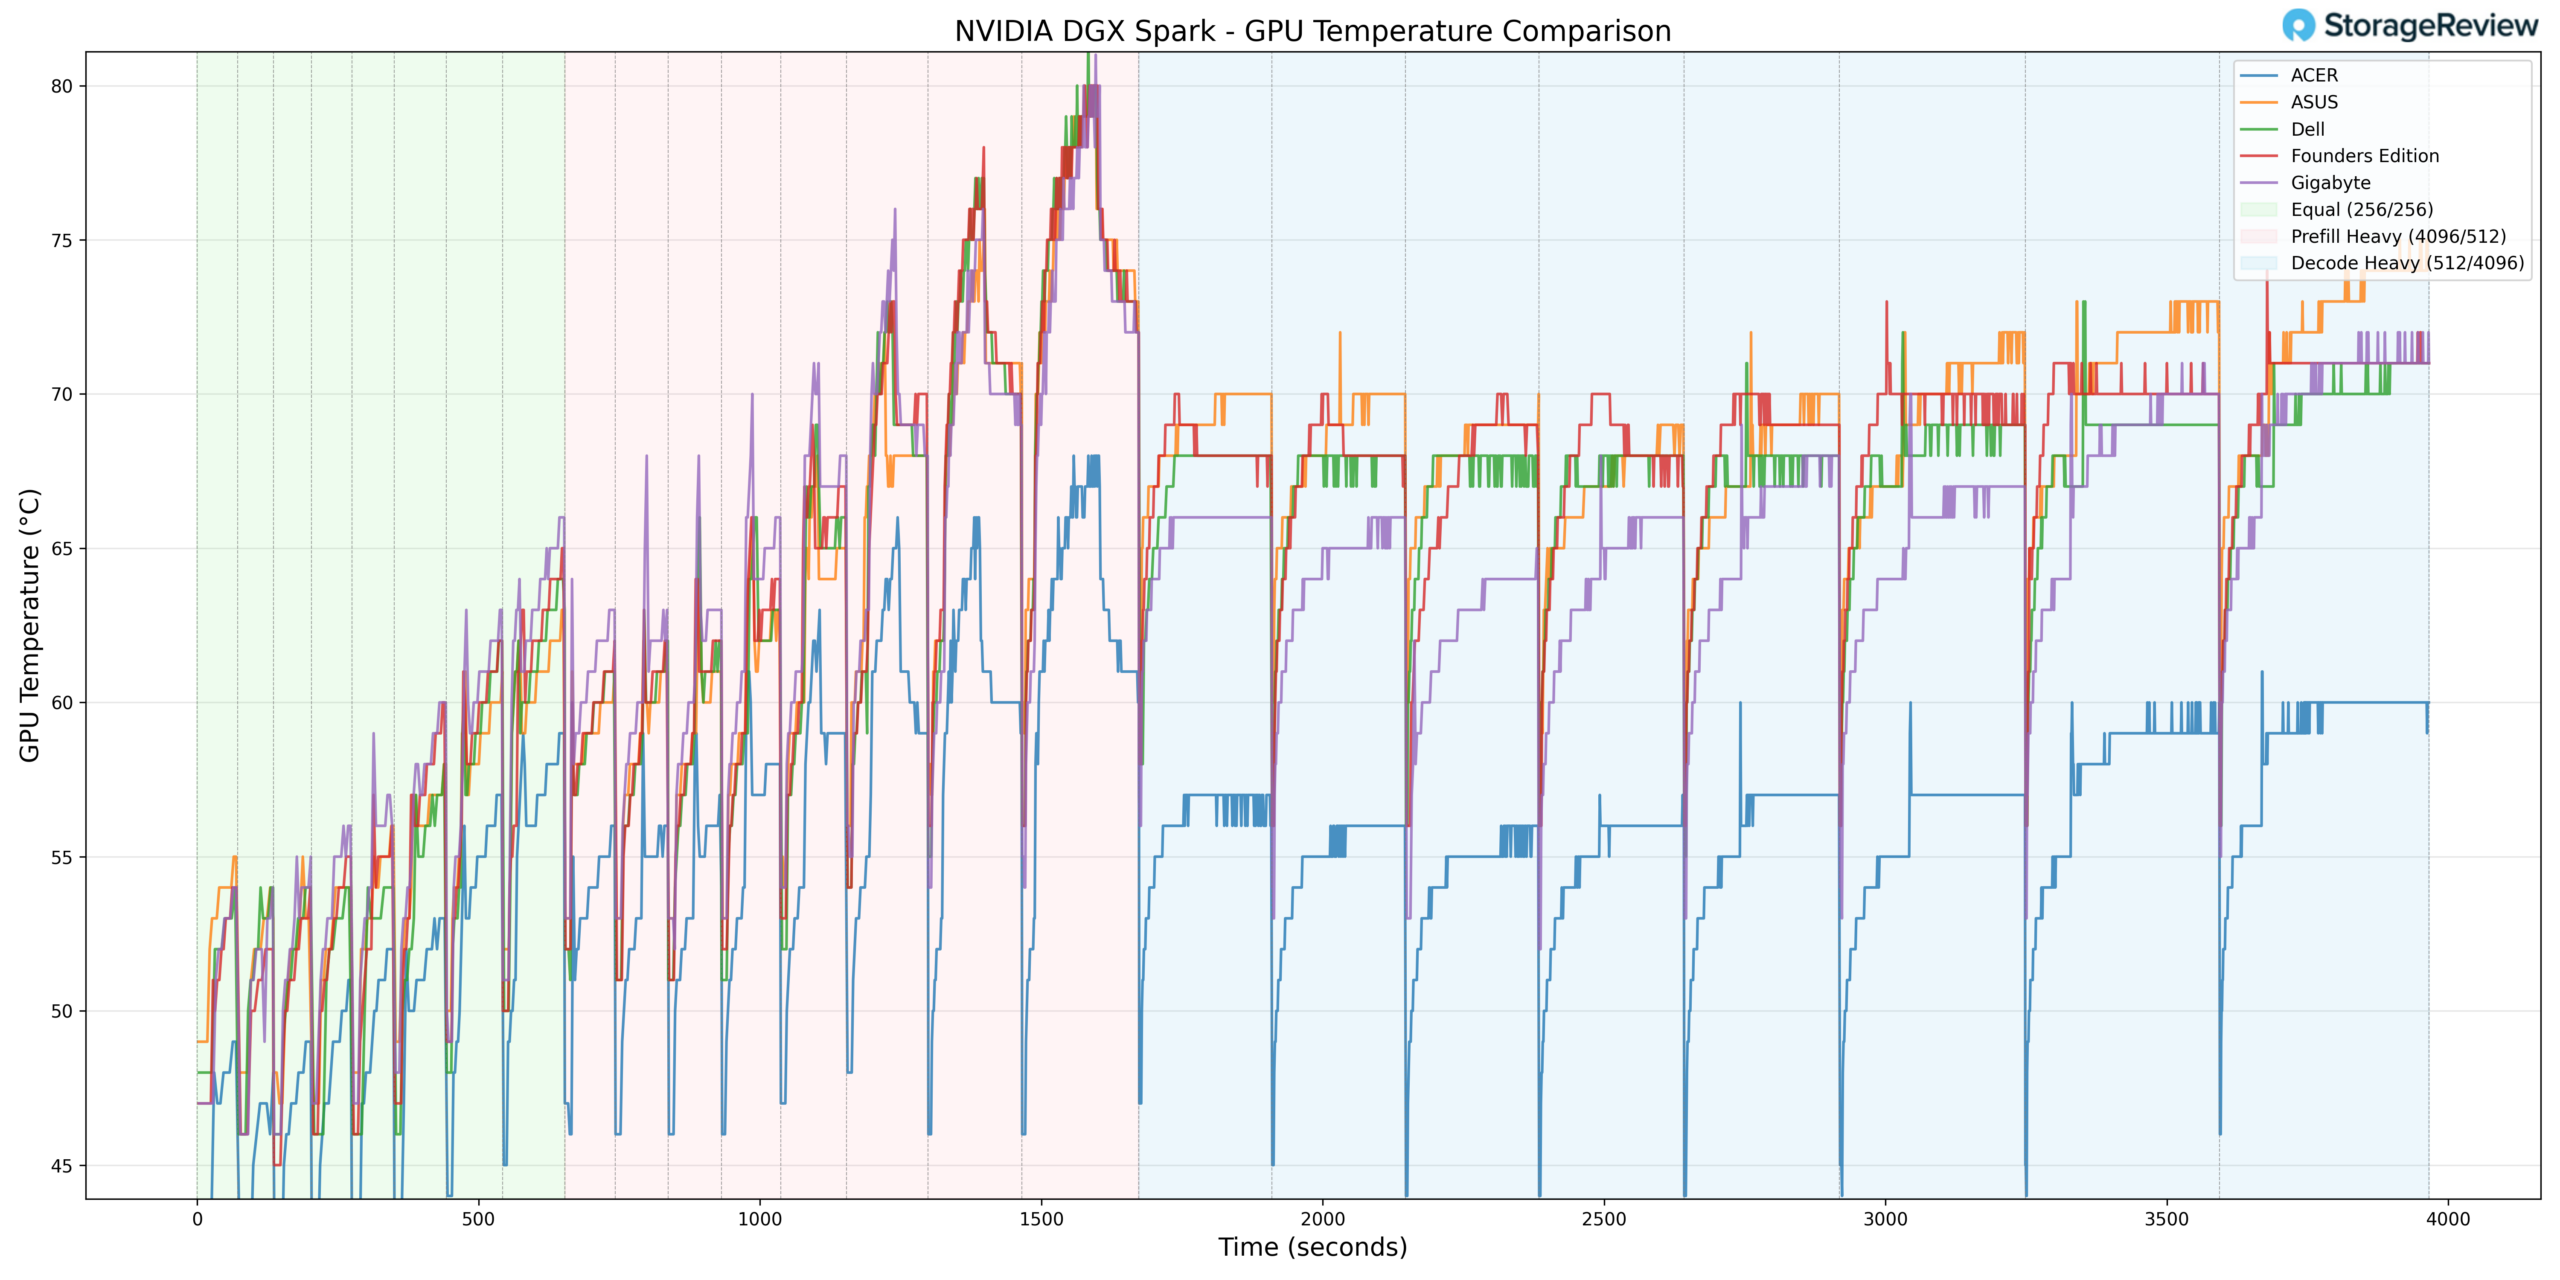
Le temperature della GPU hanno seguito un andamento simile. Durante l'attività Prefill Heavy, la GPU ha raggiunto una temperatura massima di 81 °C. Questo la colloca nella fascia più calda del gruppo durante le accelerazioni intense, ma comunque entro le specifiche operative previste per la piattaforma GB10.
Quando il carico di lavoro è passato alle fasi Equal ISL/OSL e Decode Heavy, le temperature della GPU si sono stabilizzate anziché continuare a salire.
In condizioni di inattività o con basso utilizzo, la GPU ha registrato una temperatura minima di 37 °C, indicando un solido controllo termico di base quando il sistema non è sottoposto a carico di calcolo.
Nel complesso, il comportamento delle GPU GIGABYTE riflette un utilizzo aggressivo in fase di burst abbinato a temperature stabili e costanti.
Temperatura NVMe
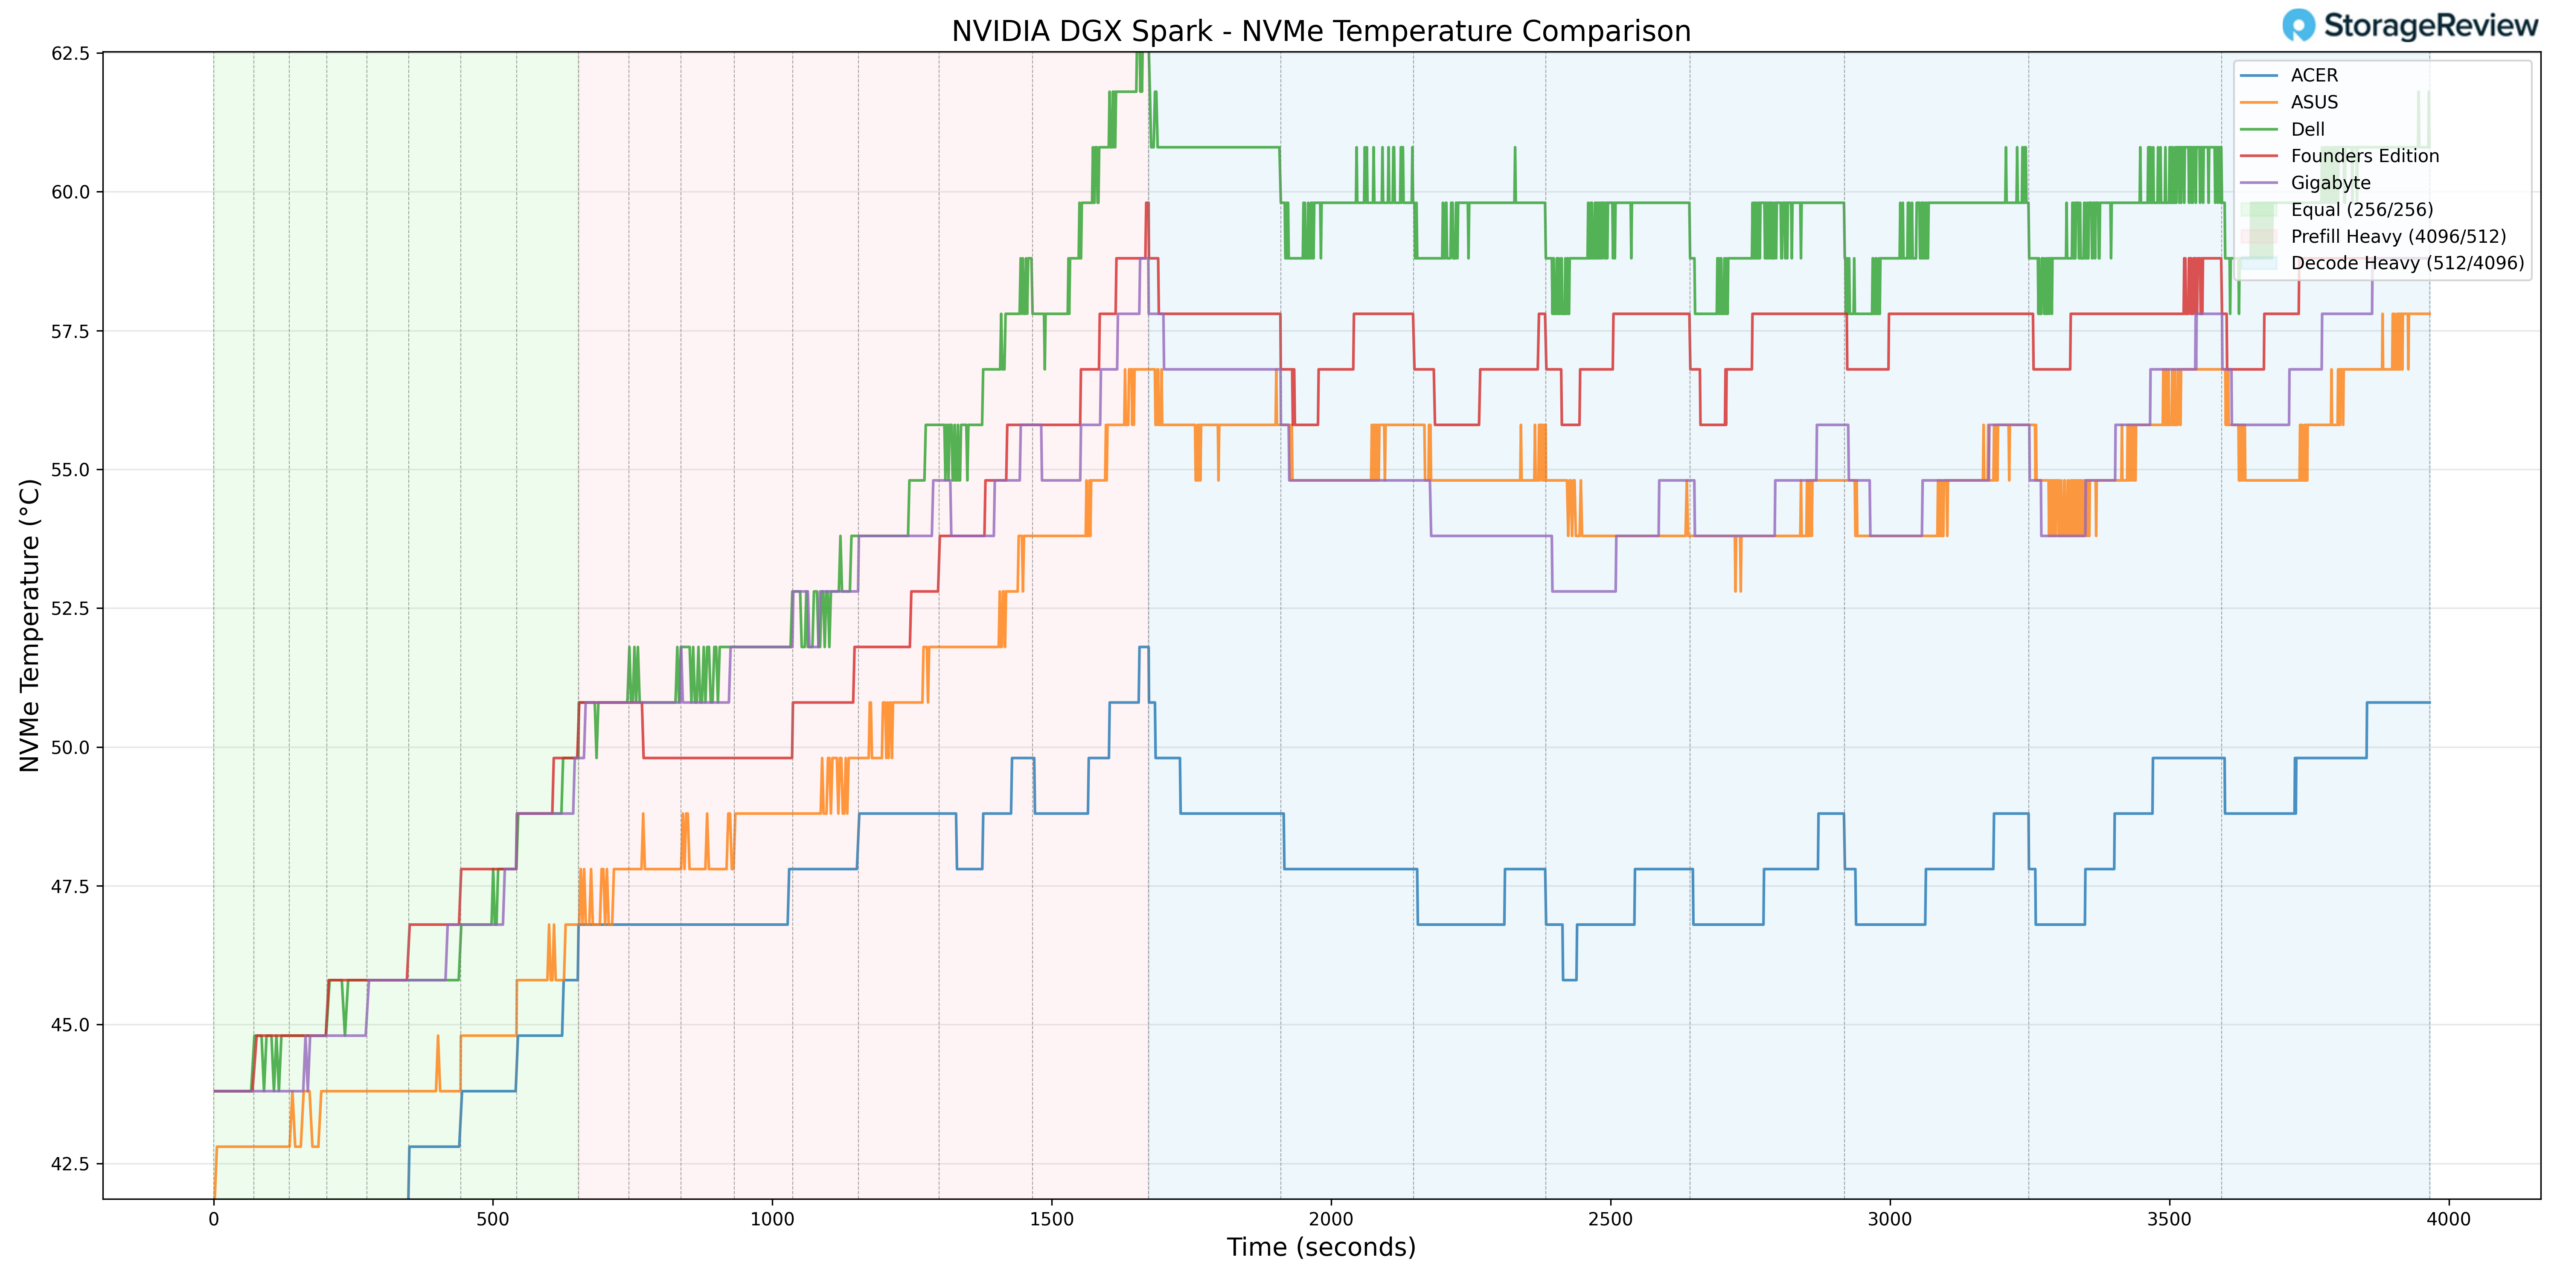
Durante i test, le temperature di archiviazione sono rimaste sotto controllo. L'unità NVMe ha registrato una temperatura massima di 59.8 °C durante le fasi di funzionamento più intense. Questo picco è rimasto ben al di sotto delle soglie di throttling più comuni, suggerendo un flusso d'aria adeguato o un posizionamento interno ottimale dell'unità all'interno dello chassis.
Durante le fasi di carico di lavoro più leggero, l'unità NVMe ha raggiunto una temperatura minima di 37.8 °C, a conferma del fatto che le prestazioni termiche dei dispositivi di archiviazione non sono limitate a riposo.
Rispetto ad alcune implementazioni compatte pensate per l'uso su desktop, il mantenimento di temperature inferiori a 60 °C sotto carico testimonia un'ottima gestione termica del sistema di archiviazione.
Temperatura NIC
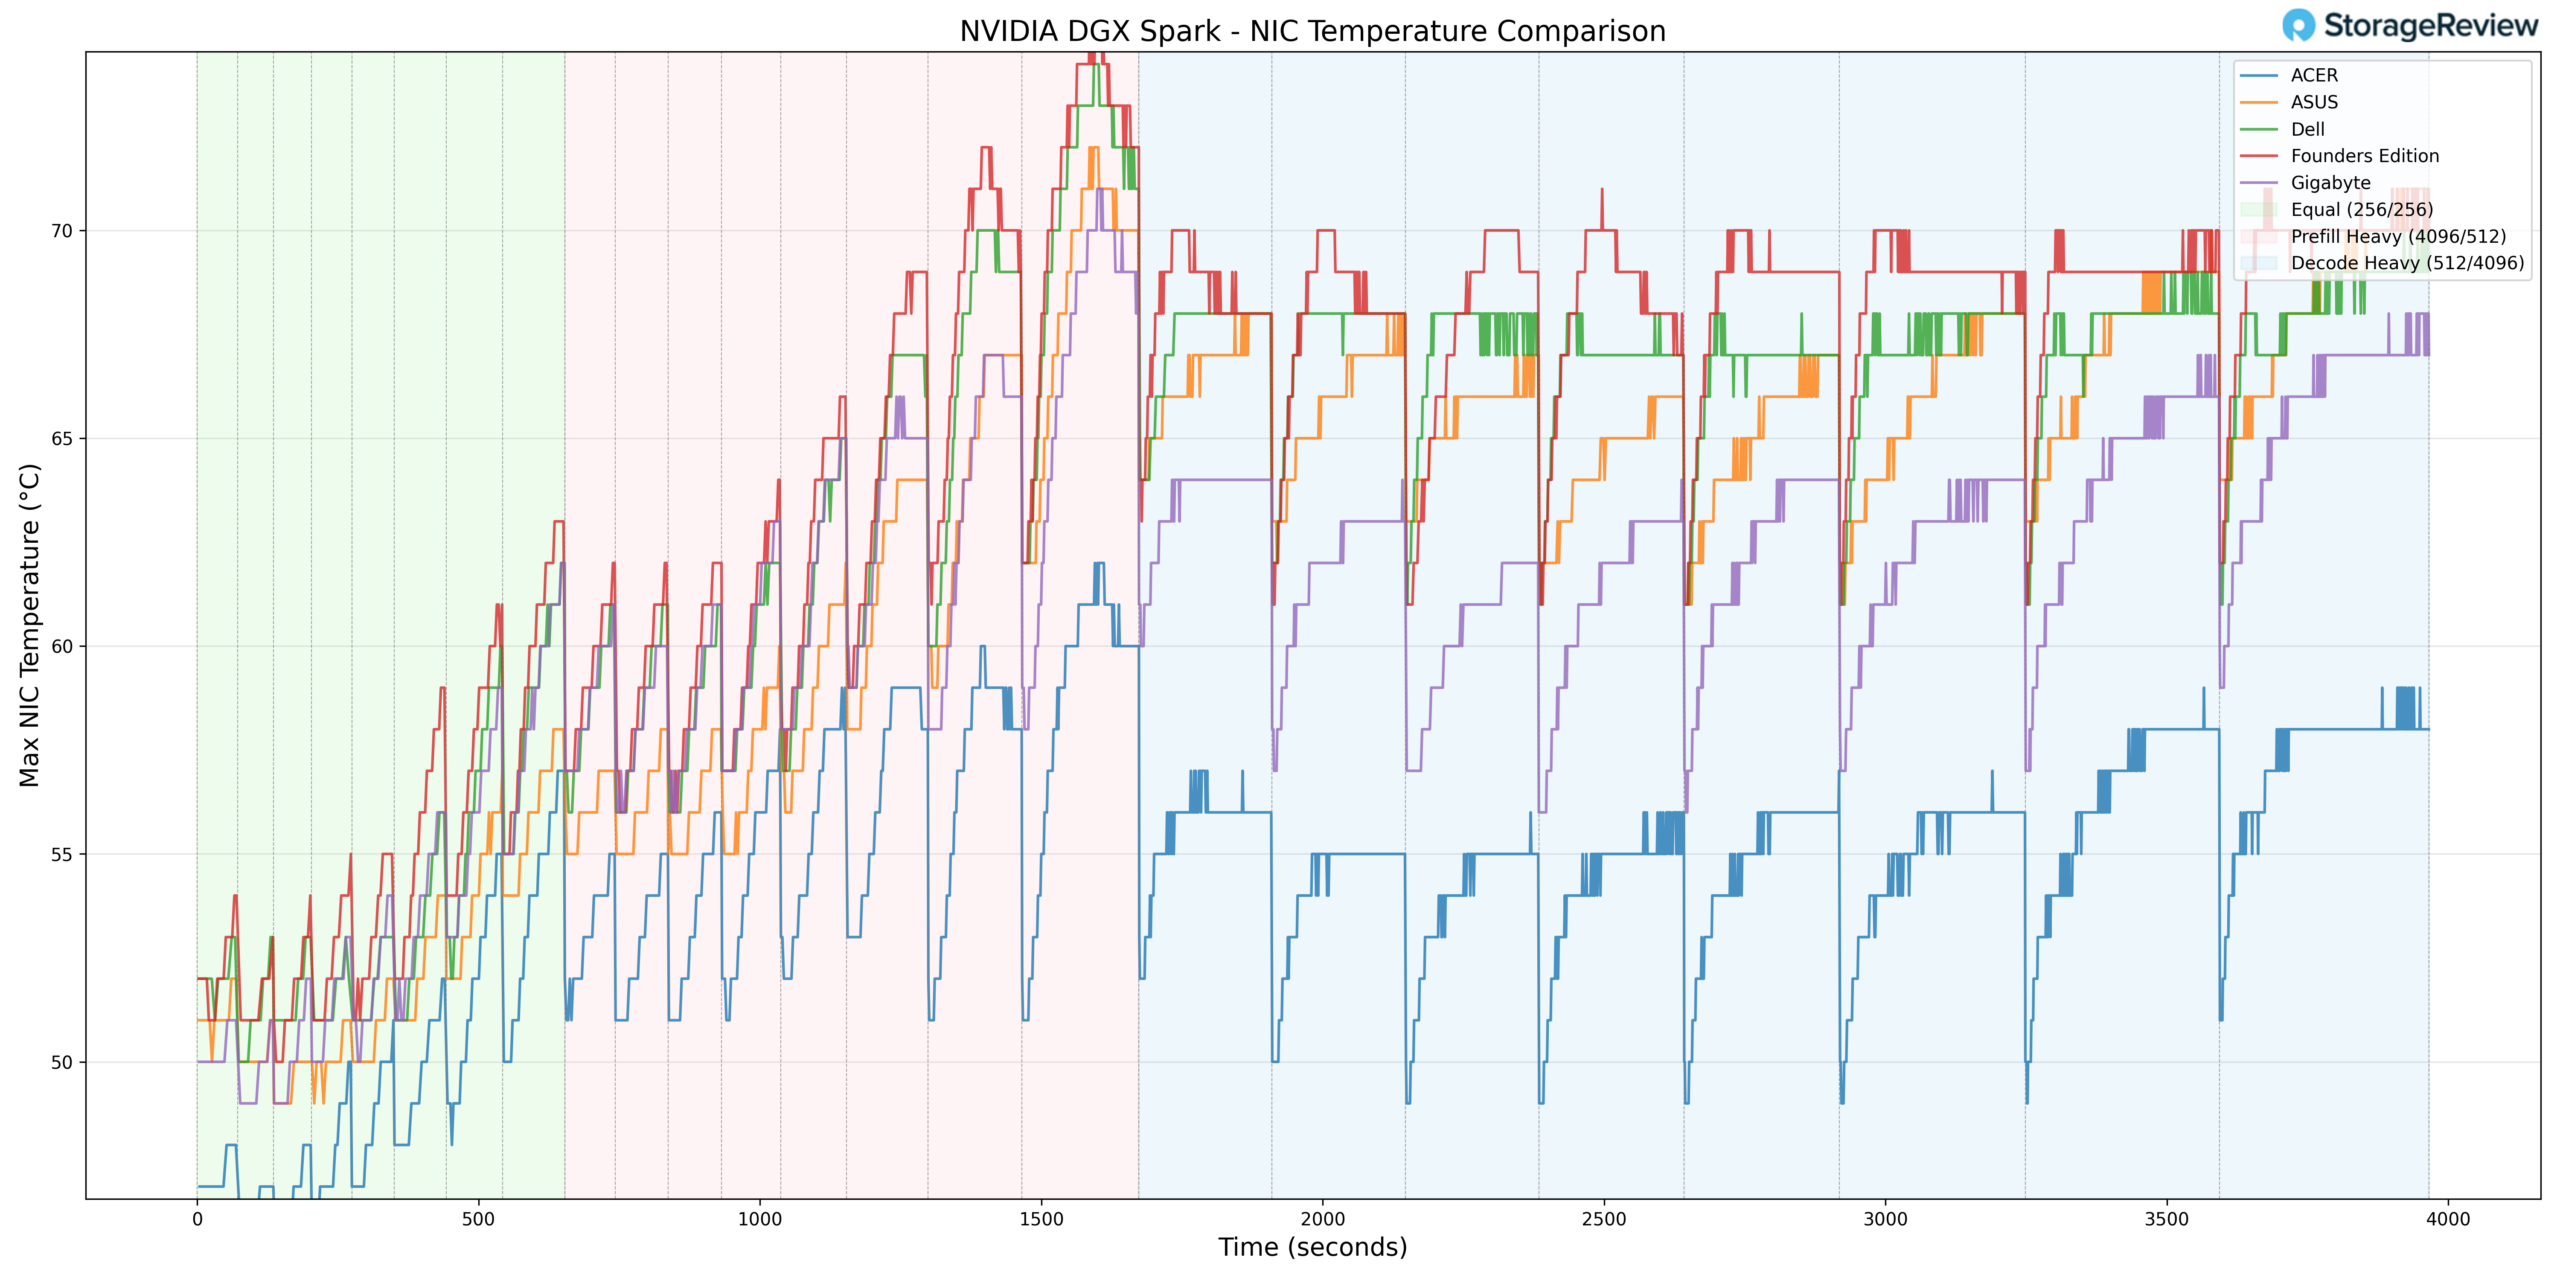
Durante le fasi di carico di lavoro più intenso, la temperatura della scheda di rete ha raggiunto un picco di 72 °C, in concomitanza con l'aumento del throughput durante le transizioni di precaricamento e decodifica. Sebbene ciò collochi il controller di rete nella metà più calda dello stack durante i picchi di attività, la temperatura è rimasta entro le tolleranze operative e non ha mostrato picchi eccessivi.
La temperatura minima registrata nel NIC è stata di 41 °C, a conferma del normale comportamento di base durante le fasi più leggere.
Nel complesso, la scheda di rete ha seguito un andamento prevedibile in base al carico complessivo del sistema e non ha mostrato variazioni anomale.
Consumo energetico della GPU
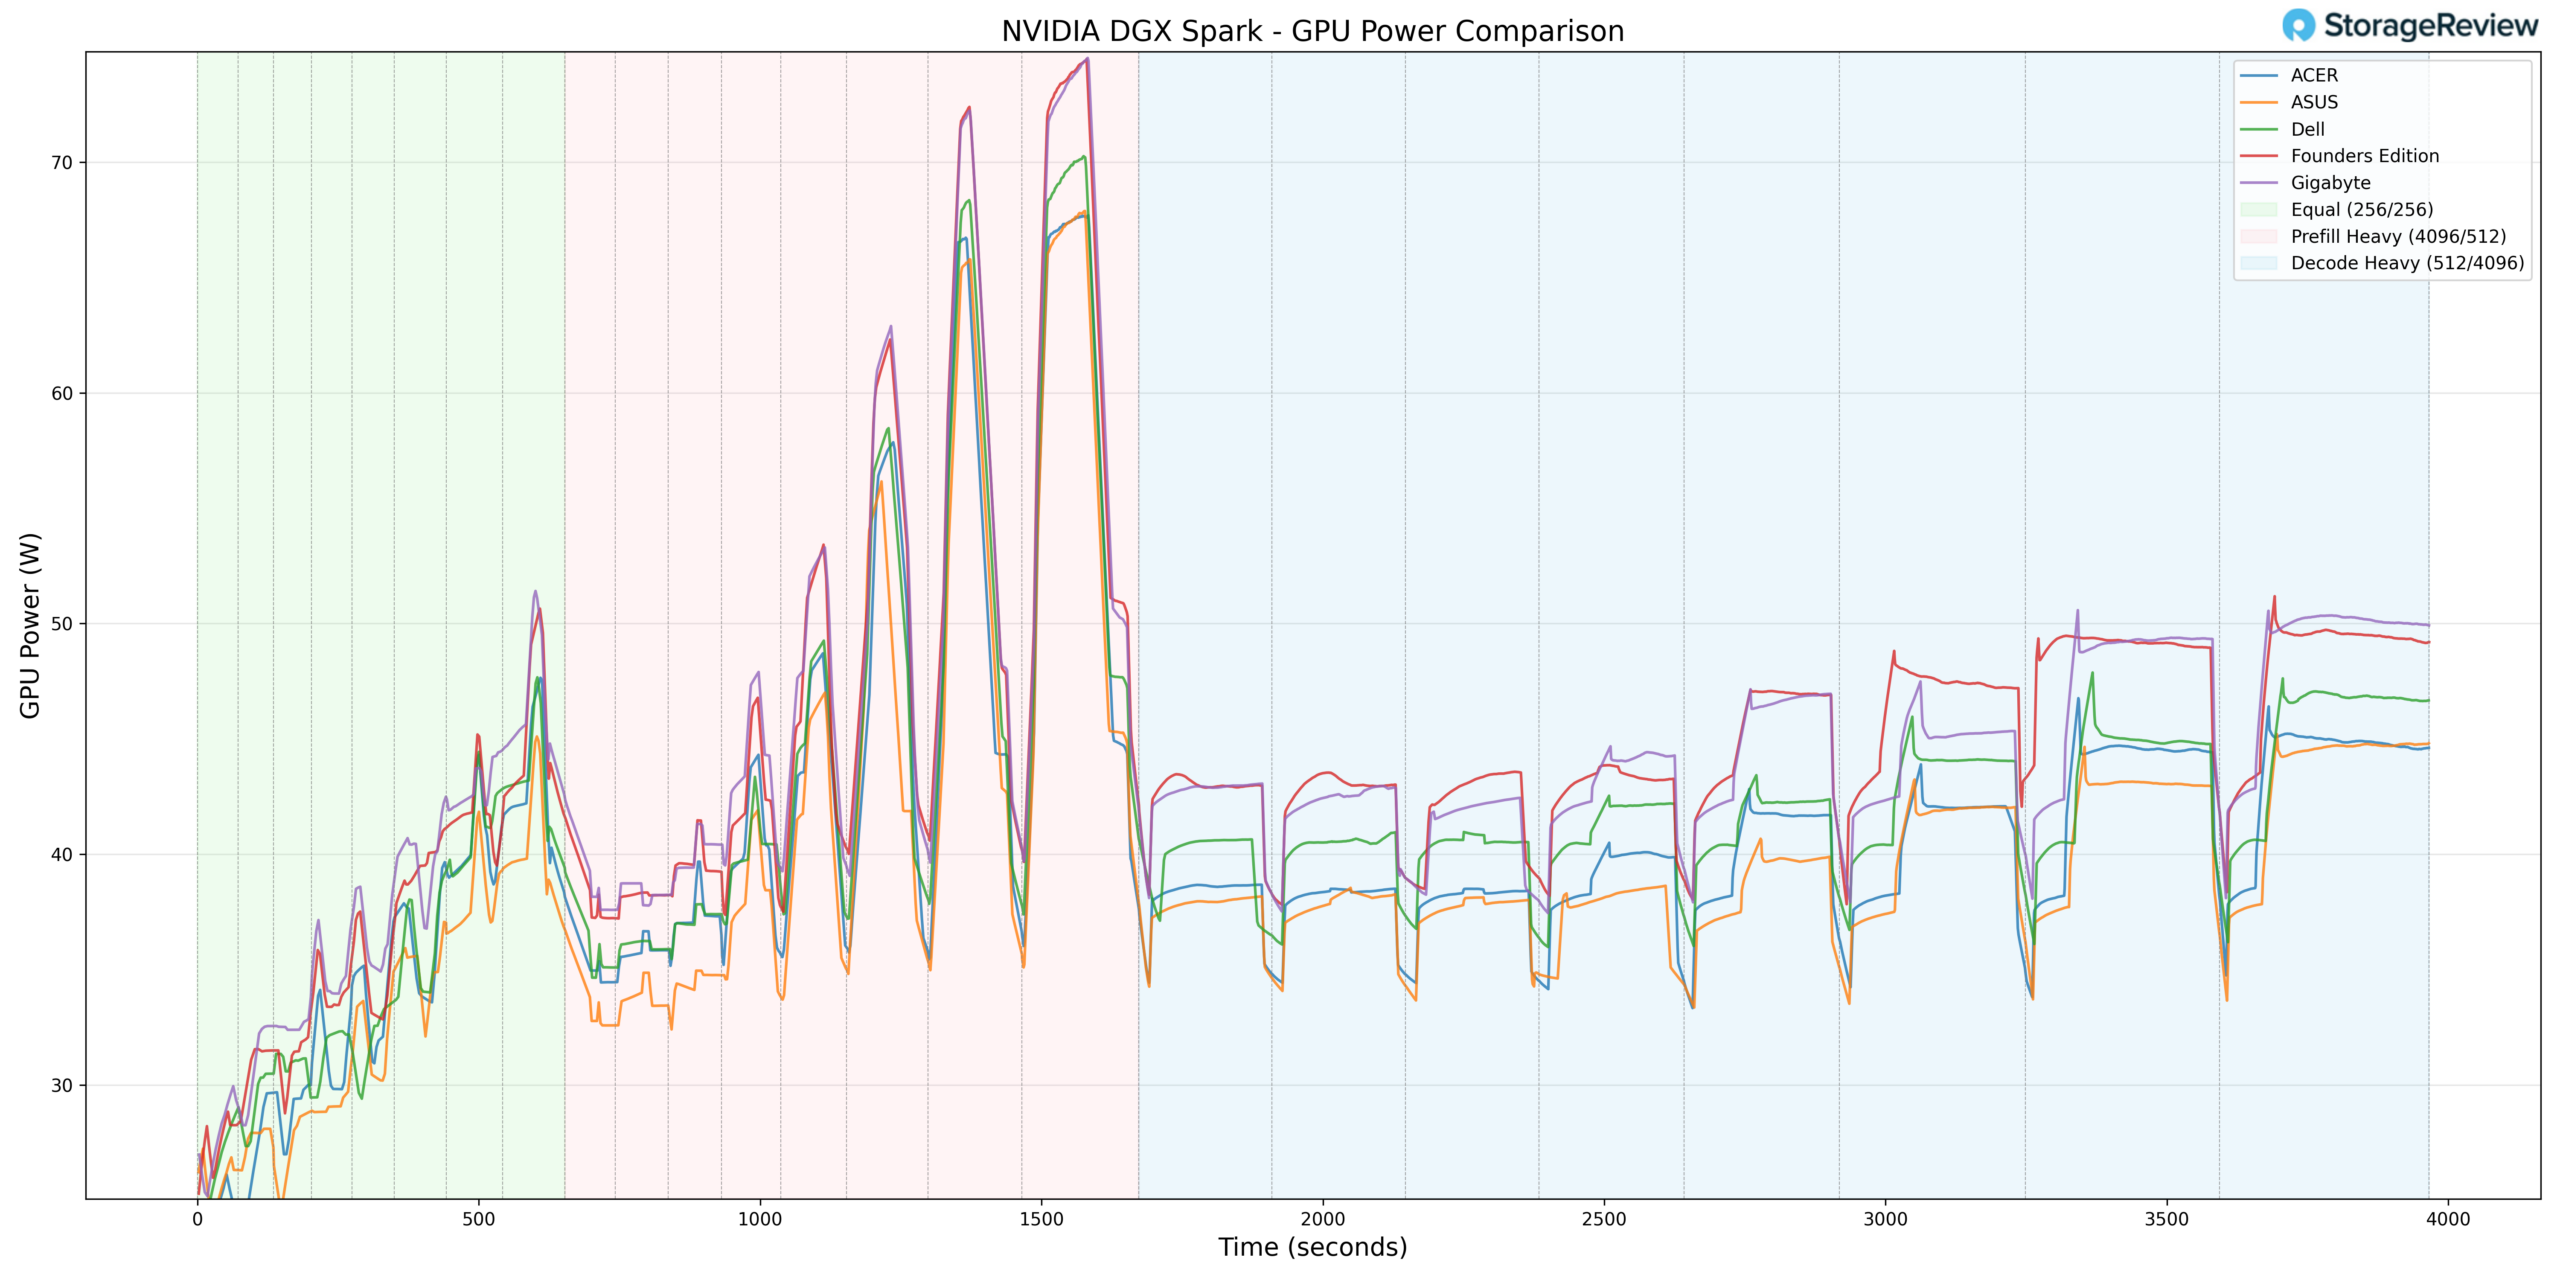
Il comportamento energetico della GPU aiuta a contestualizzare le temperature elevate riscontrate durante i picchi di consumo. GIGABYTE ha raggiunto un picco di consumo energetico della GPU di 75.54 W durante le transizioni con Prefill Heavy. Questo dato la colloca nella fascia più alta dei valori di consumo energetico osservati nelle unità GB10 testate.
Anziché limitare artificialmente la potenza della GPU, GIGABYTE sembra consentire periodi di picco prossimi al limite massimo, che sono direttamente correlati al comportamento più elevato della temperatura di picco della GPU. Quando i carichi di lavoro si sono spostati verso fasi di decodifica prolungate, il consumo energetico si è stabilizzato di conseguenza.
Dal punto di vista energetico, il sistema GIGABYTE non sembra essere eccessivamente sovraccaricato. Al contrario, i picchi termici più elevati durante le fasi di burst sono in linea con decisioni di allocazione energetica orientate alle prestazioni, piuttosto che con una progettazione termica incontrollata.
Riepilogo termico
Monitorando CPU, GPU, NVMe e NIC, il GIGABYTE GB10 ha mostrato temperature competitive in idle e picchi di consumo più elevati durante le transizioni con precaricamento intensivo. La CPU ha raggiunto i 90 °C e la GPU gli 81 °C durante le accelerazioni di picco, mentre l'NVMe è rimasto al di sotto dei 60 °C e la NIC ha raggiunto i 72 °C. Il consumo energetico della GPU ha raggiunto un massimo di 75.54 W, indicando picchi prossimi al limite massimo.
Sotto carichi di lavoro Decode prolungati, le temperature si sono stabilizzate senza ulteriori aumenti, il che suggerisce che, pur consentendo prestazioni aggressive di breve durata, GIGABYTE mantiene temperature prevedibili e controllate durante il funzionamento prolungato.
Test delle prestazioni di GIGABYTE AI TOP ATM
Per valutare GIGABYTE AI TOP ATOM, abbiamo testato le unità Spark utilizzando il benchmark vLLM Online Serving, il motore di inferenza e di gestione di grandi modelli linguistici più diffuso. Il benchmark vLLM Online Serving simula carichi di lavoro di produzione reali inviando richieste simultanee a un server vLLM in esecuzione e misurando metriche chiave, tra cui il throughput totale dei token (token al secondo), il tempo al primo token e il tempo per token di output, in diverse condizioni di carico.
I nostri test hanno coperto una vasta gamma di modelli, dalle architetture dense ai tipi di dati a scalabilità ridotta. Abbiamo valutato le prestazioni in tre scenari di carico di lavoro: ISL/OSL bilanciato, precaricamento intensivo e decodifica intensiva. Questi scenari rappresentano modelli di servizio reali distinti, da carichi di input e output bilanciati all'elaborazione intensiva dei prompt e alla generazione di token limitata dalla larghezza di banda della memoria.
Oltre al GIGABYTE AI TOP ATOM, abbiamo utilizzato come punto di riferimento la NVIDIA Founders Edition Spark, insieme a sistemi OEM di Asus, Acer e Dell. Questo ci ha permesso di collocare i risultati di GIGABYTE nel più ampio panorama competitivo e di capire dove si posiziona, se è in linea o se è in ritardo rispetto alla concorrenza, considerando diversi modelli e tipologie di carico di lavoro.
GPT-OSS-120B
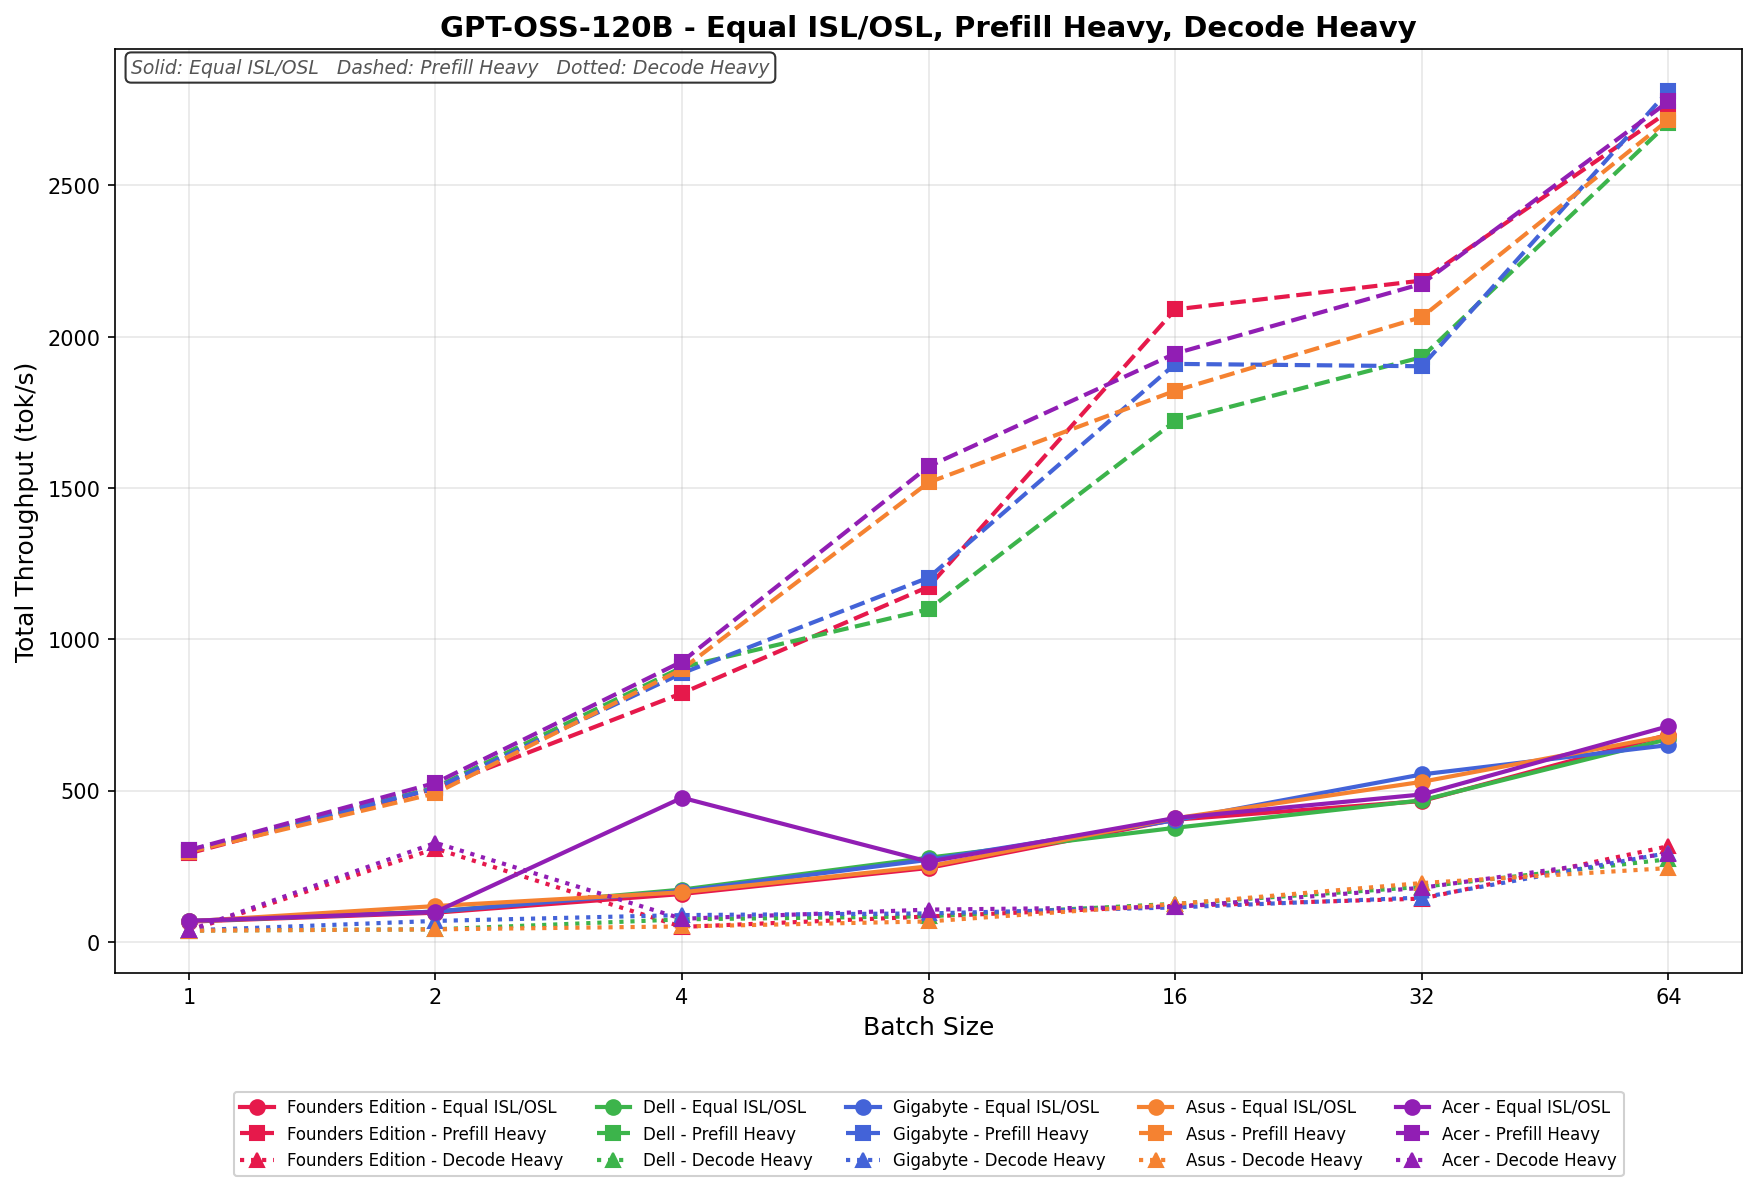
In Equal ISL/OSL, GIGABYTE scala da 60.71 a 649.62 tok/s, posizionandosi costantemente a metà classifica e allineandosi strettamente a Dell e Asus per lotti di produzione più grandi. La scalabilità è costante e lineare fino al lotto 32, con ulteriori miglioramenti al lotto 64, sebbene non superi completamente i modelli più performanti nella fascia alta.
Prefill Heavy parte da 304.63 tok/s e sale a 2,771.38 tok/s con la dimensione del lotto 64. La crescita è forte fino al lotto 16, dove GIGABYTE si posiziona brevemente al terzo posto dalla vetta, prima di convergere con il gruppo più ampio per lotti di dimensioni maggiori. Nel complesso, la scalabilità è aggressiva e competitiva, soprattutto per i lotti di dimensioni intermedie.
La velocità di decodifica di Decode Heavy varia da 47.01 a 299.41 tok/s, con una scalabilità graduale e costante durante l'intero ciclo di elaborazione.
GPT-OSS-20B
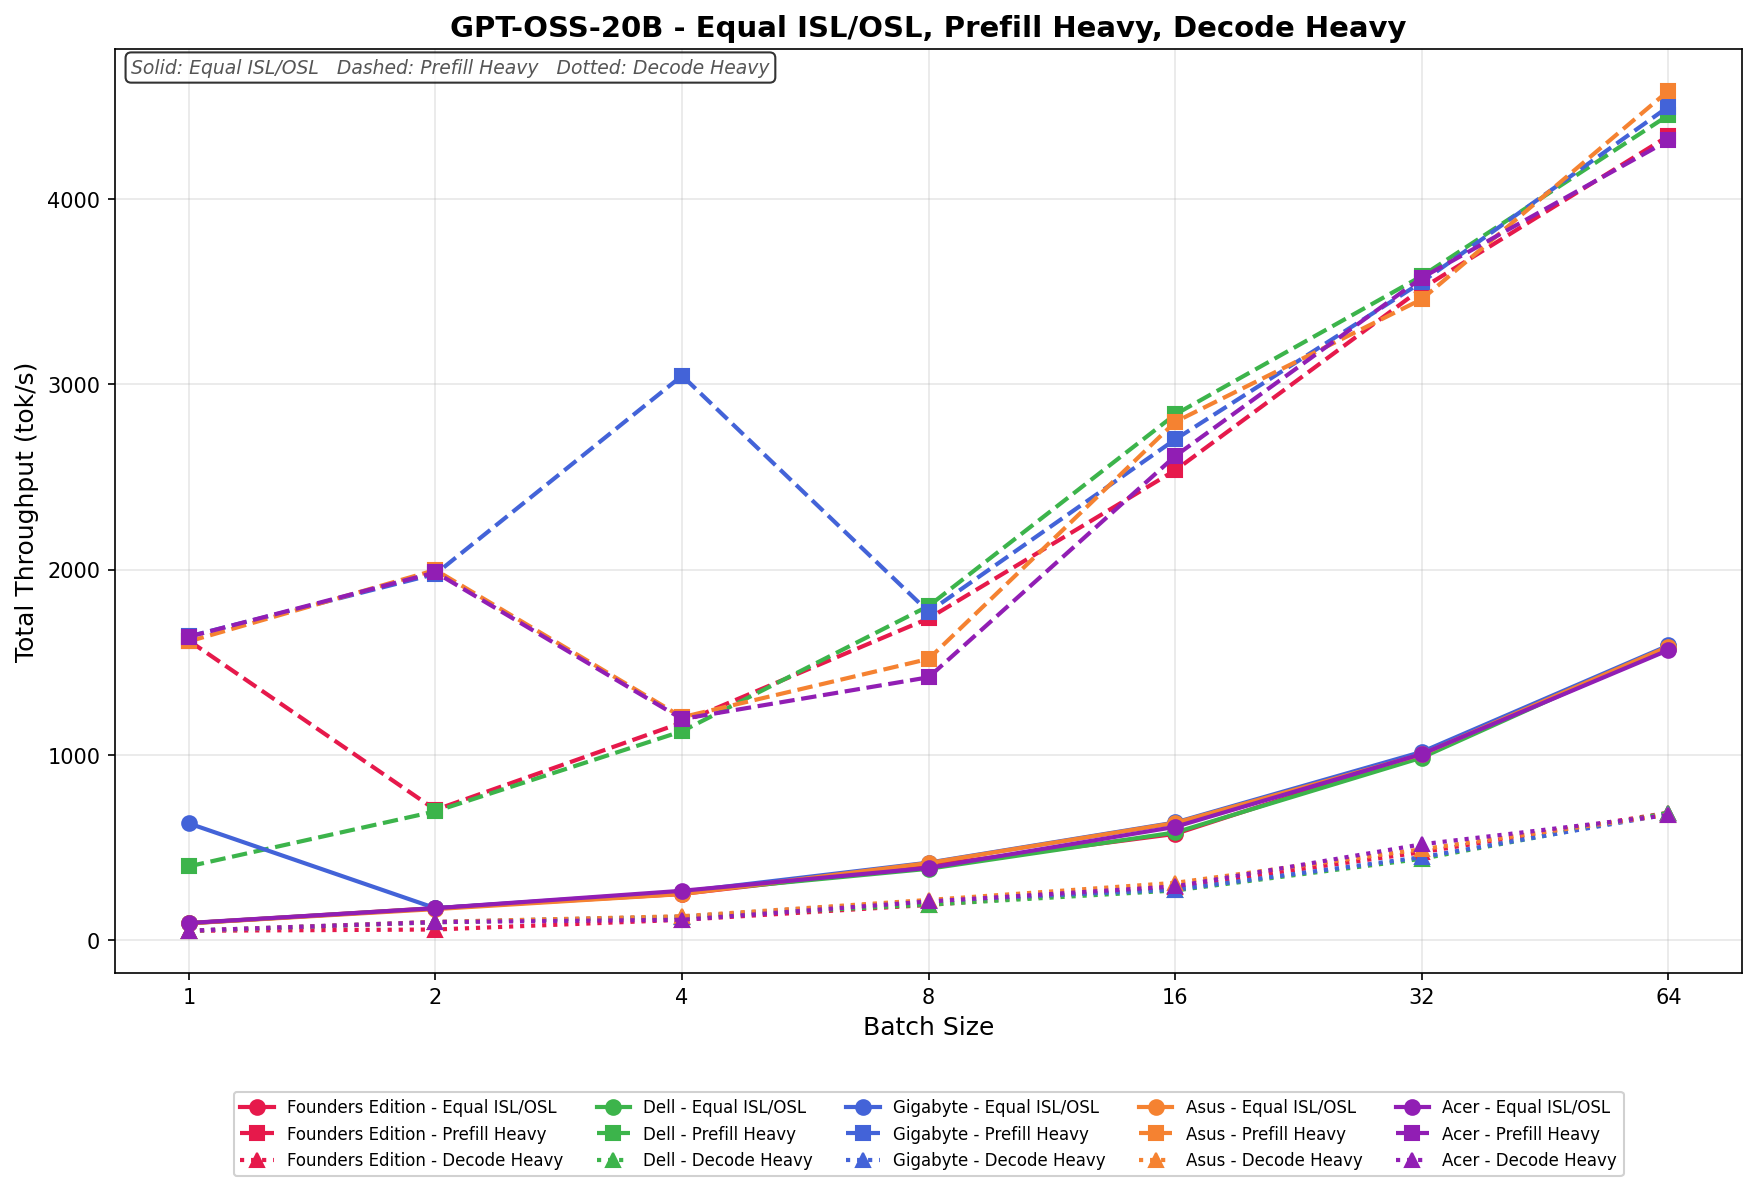
In Equal ISL/OSL, GIGABYTE scala da 641.73 a 1,587.62 tok/s, partendo forte con la dimensione del batch 1 prima di calare al batch 2 e poi progredire costantemente con batch di dimensioni maggiori. Dal batch 8 in poi, la scalabilità si normalizza e segue da vicino quella del resto del settore, terminando vicino alla vetta al batch 64.
La velocità di precaricamento pesante parte da 1,650.32 tok/s e raggiunge un picco di 4,401.27 tok/s con la dimensione del lotto 64. Dal lotto 16 in poi, la scalabilità è costante e competitiva, tenendo il passo con Dell e Asus anche per le dimensioni di lotto più elevate.
Decode Heavy raggiunge valori compresi tra 63.18 e 688.44 tok/s, con una scalabilità lineare e precisa lungo tutto l'intervallo di misurazione. I miglioramenti sono incrementali ma costanti, si allineano strettamente con le altre piattaforme e riflettono il comportamento di scalabilità più limitato tipico dei carichi di lavoro con un'elevata intensità di decodifica.
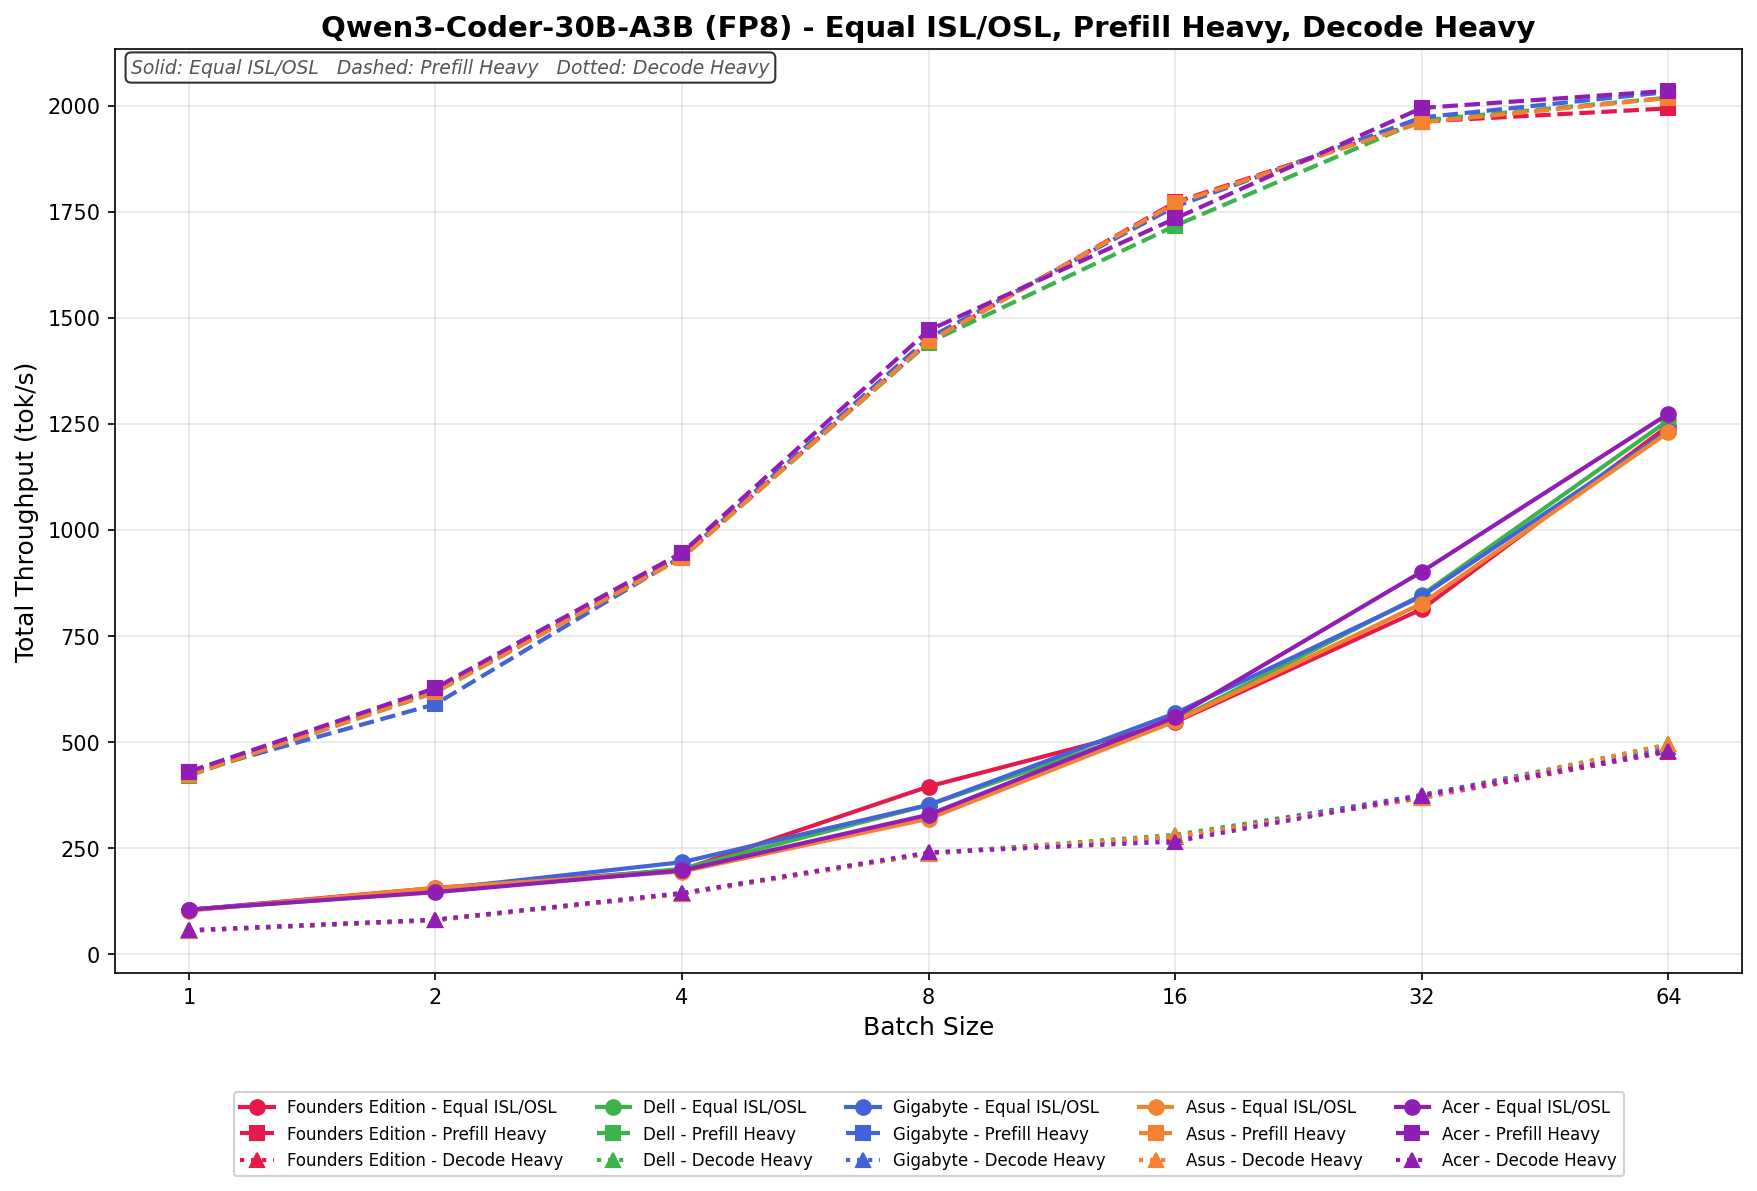
Codificatore Qwen3 30B A3B FB8
In Equal ISL/OSL, GIGABYTE scala da 101.27 a 1,251.84 tok/s, mostrando una progressione lineare costante lungo l'intero ciclo di test. Le prestazioni si allineano strettamente a quelle di Dell e Asus fino al batch 16, per poi continuare a crescere in modo pulito fino al batch 64, terminando vicino alla fascia più alta senza anomalie di scalabilità evidenti.
Prefill Heavy parte da 428.66 tok/s e arriva a 2,026.94 tok/s all'aumentare della dimensione del batch fino a 64. La crescita è graduale e costante per tutte le dimensioni del batch, con GIGABYTE che rimane strettamente allineata al resto del settore.
Decode Heavy offre una velocità di elaborazione che varia da 61.18 a 482.73 tok/s, con miglioramenti prevedibili e incrementali all'aumentare delle dimensioni del batch.
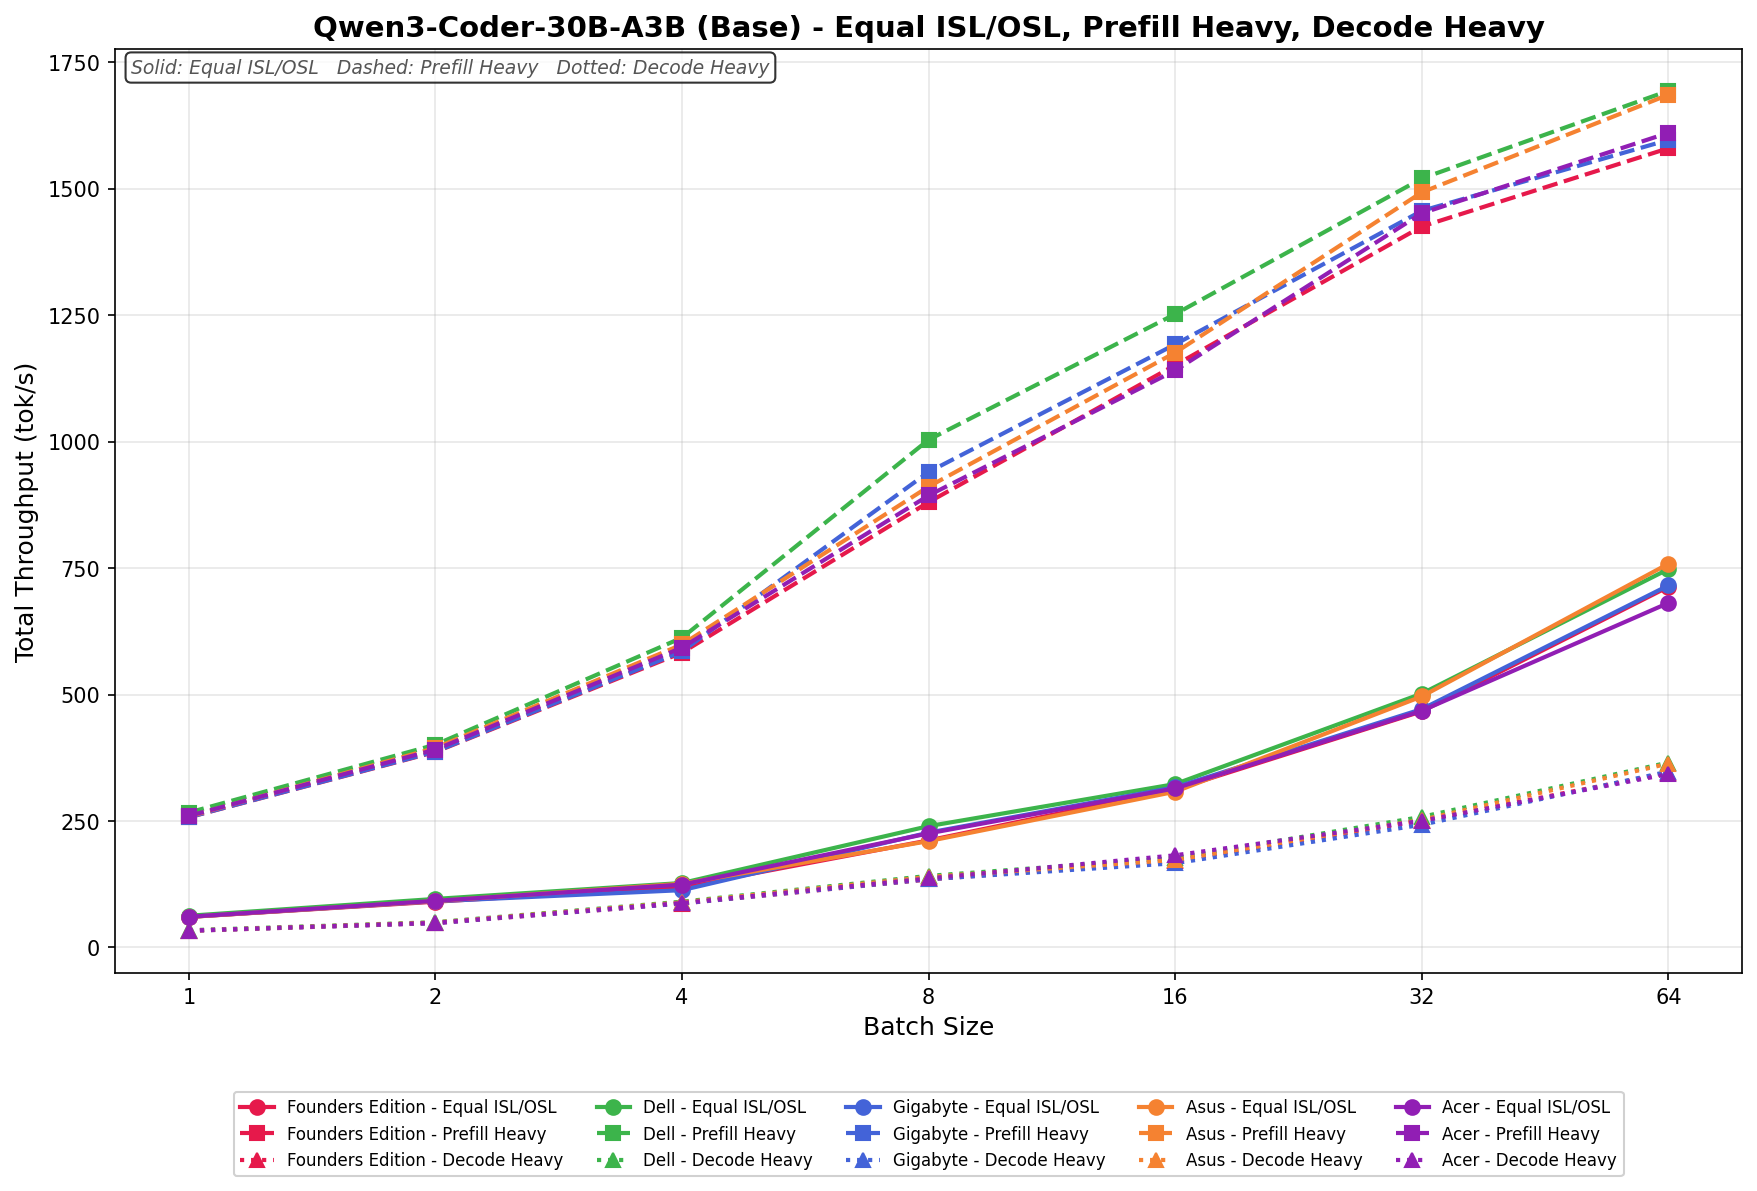
Codificatore Qwen3 30B A3B Base
In Equal ISL/OSL, GIGABYTE scala da 63.42 a 721.08 tok/s, progredendo costantemente lungo l'intervallo di batch. Le prestazioni qui seguono da vicino quelle del mercato più ampio fino al batch 16 e continuano a scalare in modo pulito fino al batch 64, terminando in modo competitivo senza alcuna deviazione significativa dal comportamento lineare.
Il pre-riempimento pesante inizia a 258.11 tok/s e sale a 1,603.74 tok/s con la dimensione del lotto 64.
La velocità di decodifica di Decode Heavy varia da 33.57 a 349.82 tok/s, con una scalatura lineare e incrementale lungo l'intero intervallo.
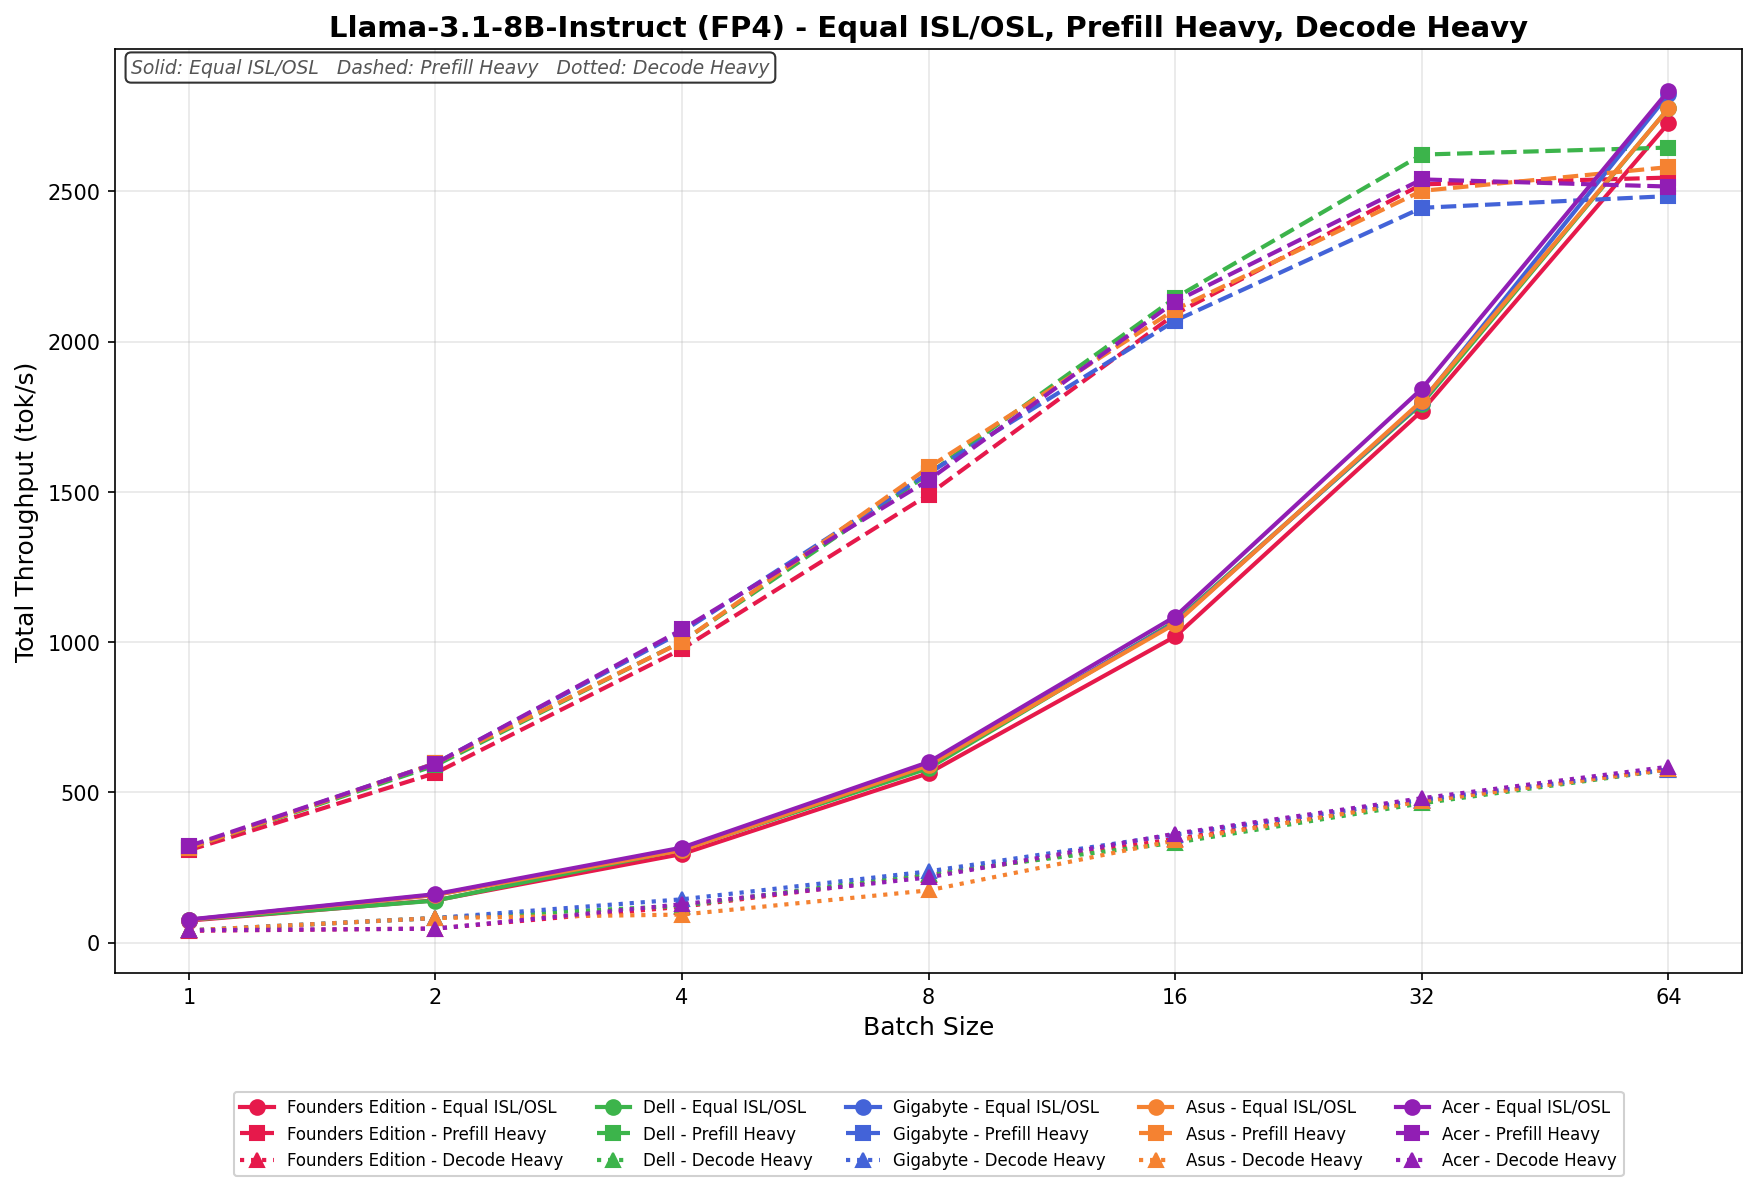
Llama 3.1 8B Istruzione FP4
In Equal ISL/OSL, GIGABYTE aumenta da 69.84 a 2,756.91 tok/s nell'arco dell'intero ciclo di elaborazione. La scalabilità è progressiva e ben bilanciata fino al batch 32, dove il throughput si avvicina al livello superiore, prima di registrare un forte incremento al batch 64, posizionandosi tra i sistemi leader a livelli di concorrenza più elevati.
Prefill Heavy parte da 321.67 tok/s e raggiunge 2,493.52 tok/s con la dimensione del lotto 64. La crescita è costante fino al lotto 16, poi inizia a diminuire leggermente con dimensioni del lotto maggiori rispetto al prodotto con le prestazioni migliori, indicando un'efficienza di scalabilità per lotti di grandi dimensioni solida ma non dominante.
Decode Heavy offre una velocità che varia da 48.92 a 575.84 tok/s, con incrementi costanti all'aumentare della dimensione del batch.
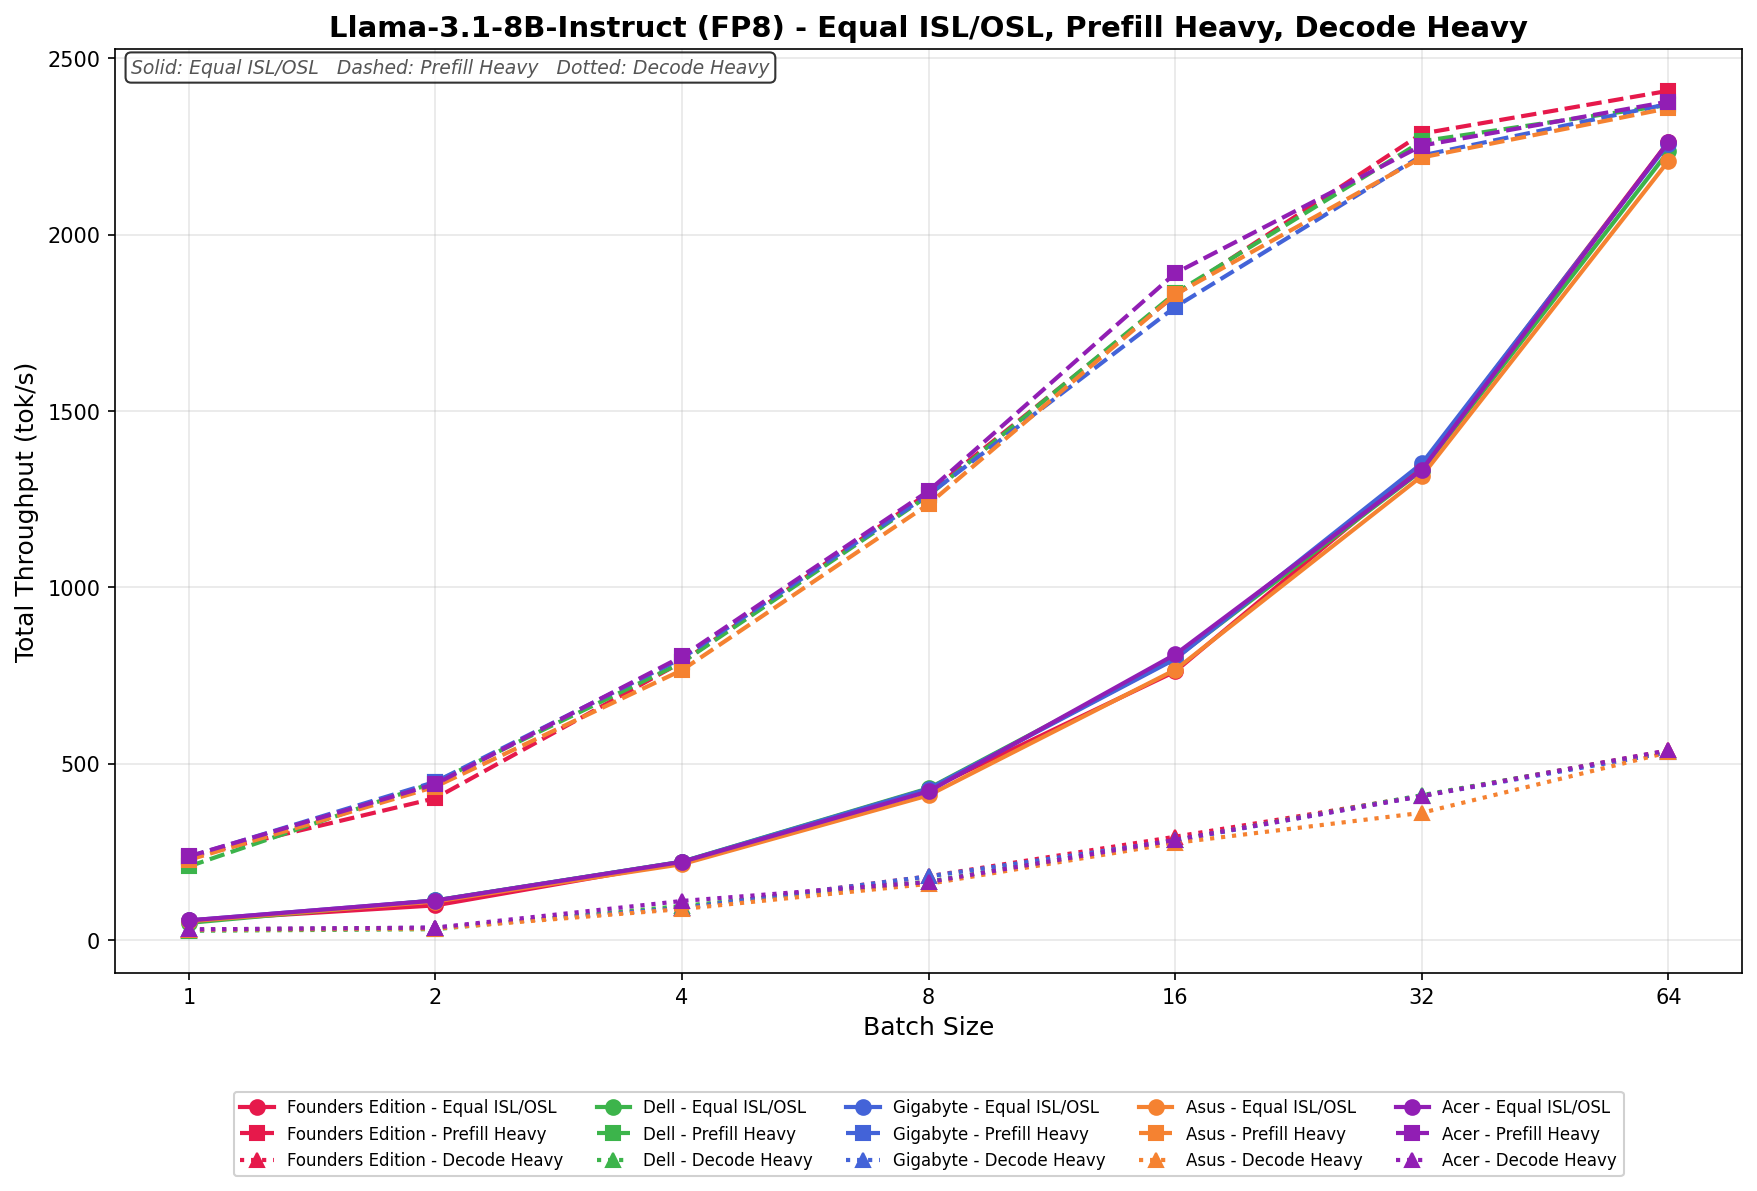
Llama 3.1 8B Istruzione FP8
In Equal ISL/OSL, GIGABYTE scala da 54.12 a 2,314.87 tok/s, mostrando una crescita lineare e uniforme fino al batch 32 e una forte spinta al batch 64 che la mantiene competitiva a livelli di concorrenza più elevati.
Il pre-riempimento pesante inizia a 226.43 tok/s e raggiunge 2,332.19 tok/s con una dimensione del lotto pari a 64. La scalabilità è coerente lungo tutta la scansione, seguendo da vicino il campo più ampio e mantenendo una solida efficienza anche con lotti di dimensioni maggiori.
La velocità di Decode Heavy varia da 32.88 a 522.41 tok/s, con incrementi costanti all'aumentare della dimensione del batch. Come previsto, la scalabilità rimane più limitata rispetto ai carichi di lavoro Equal e Prefill.
Archiviazione diretta GPU
Uno dei test che abbiamo condotto sullo Spark è stato il test MagnumIO GPU Direct Storage (GDS). GDS è una funzionalità sviluppata da NVIDIA che consente alle GPU di bypassare la CPU quando accedono ai dati archiviati su unità NVMe o altri dispositivi di archiviazione ad alta velocità. Invece di instradare i dati attraverso la CPU e la memoria di sistema, GDS consente la comunicazione diretta tra la GPU e il dispositivo di archiviazione, riducendo significativamente la latenza e migliorando la velocità di trasmissione dei dati.
Gigabyte utilizza l'SSD Samsung PM9E1 Gen5 da 4 TB all'interno dell'AI TOP ATOM, che ad oggi è l'unità M.2 2242 più veloce che abbiamo visto sul mercato. Si tratta dello stesso SSD che abbiamo visto utilizzato nel FE Spark e nell'Acer Veriton GN100.
Come funziona l'archiviazione diretta GPU
Tradizionalmente, quando una GPU elabora i dati memorizzati su un'unità NVMe, questi devono prima passare attraverso la CPU e la memoria di sistema prima di raggiungere la GPU. Questo processo introduce dei colli di bottiglia perché la CPU funge da intermediario, aggiungendo latenza e consumando preziose risorse di sistema. La tecnologia GPU Direct Storage elimina questa inefficienza consentendo alla GPU di accedere ai dati direttamente dal dispositivo di archiviazione tramite il bus PCIe. Questo percorso diretto riduce l'overhead di trasferimento dati, consentendo trasferimenti più rapidi ed efficienti.
I carichi di lavoro AI, in particolare quelli che coinvolgono il deep learning, sono altamente intensivi in termini di dati. L'addestramento di grandi reti neurali richiede l'elaborazione di terabyte di dati e qualsiasi ritardo nel trasferimento dei dati può portare a GPU sottoutilizzate e tempi di addestramento più lunghi. GPU Direct Storage affronta questa sfida assicurando che i dati vengano consegnati alla GPU il più rapidamente possibile, riducendo al minimo i tempi di inattività e massimizzando l'efficienza computazionale.
Inoltre, GDS è particolarmente utile per carichi di lavoro che comportano lo streaming di grandi set di dati, come l'elaborazione video, l'elaborazione del linguaggio naturale o l'inferenza in tempo reale. Riducendo la dipendenza dalla CPU, GDS accelera lo spostamento dei dati e libera risorse della CPU per altre attività, migliorando ulteriormente le prestazioni complessive del sistema.
Velocità di lettura GDSIO 16k
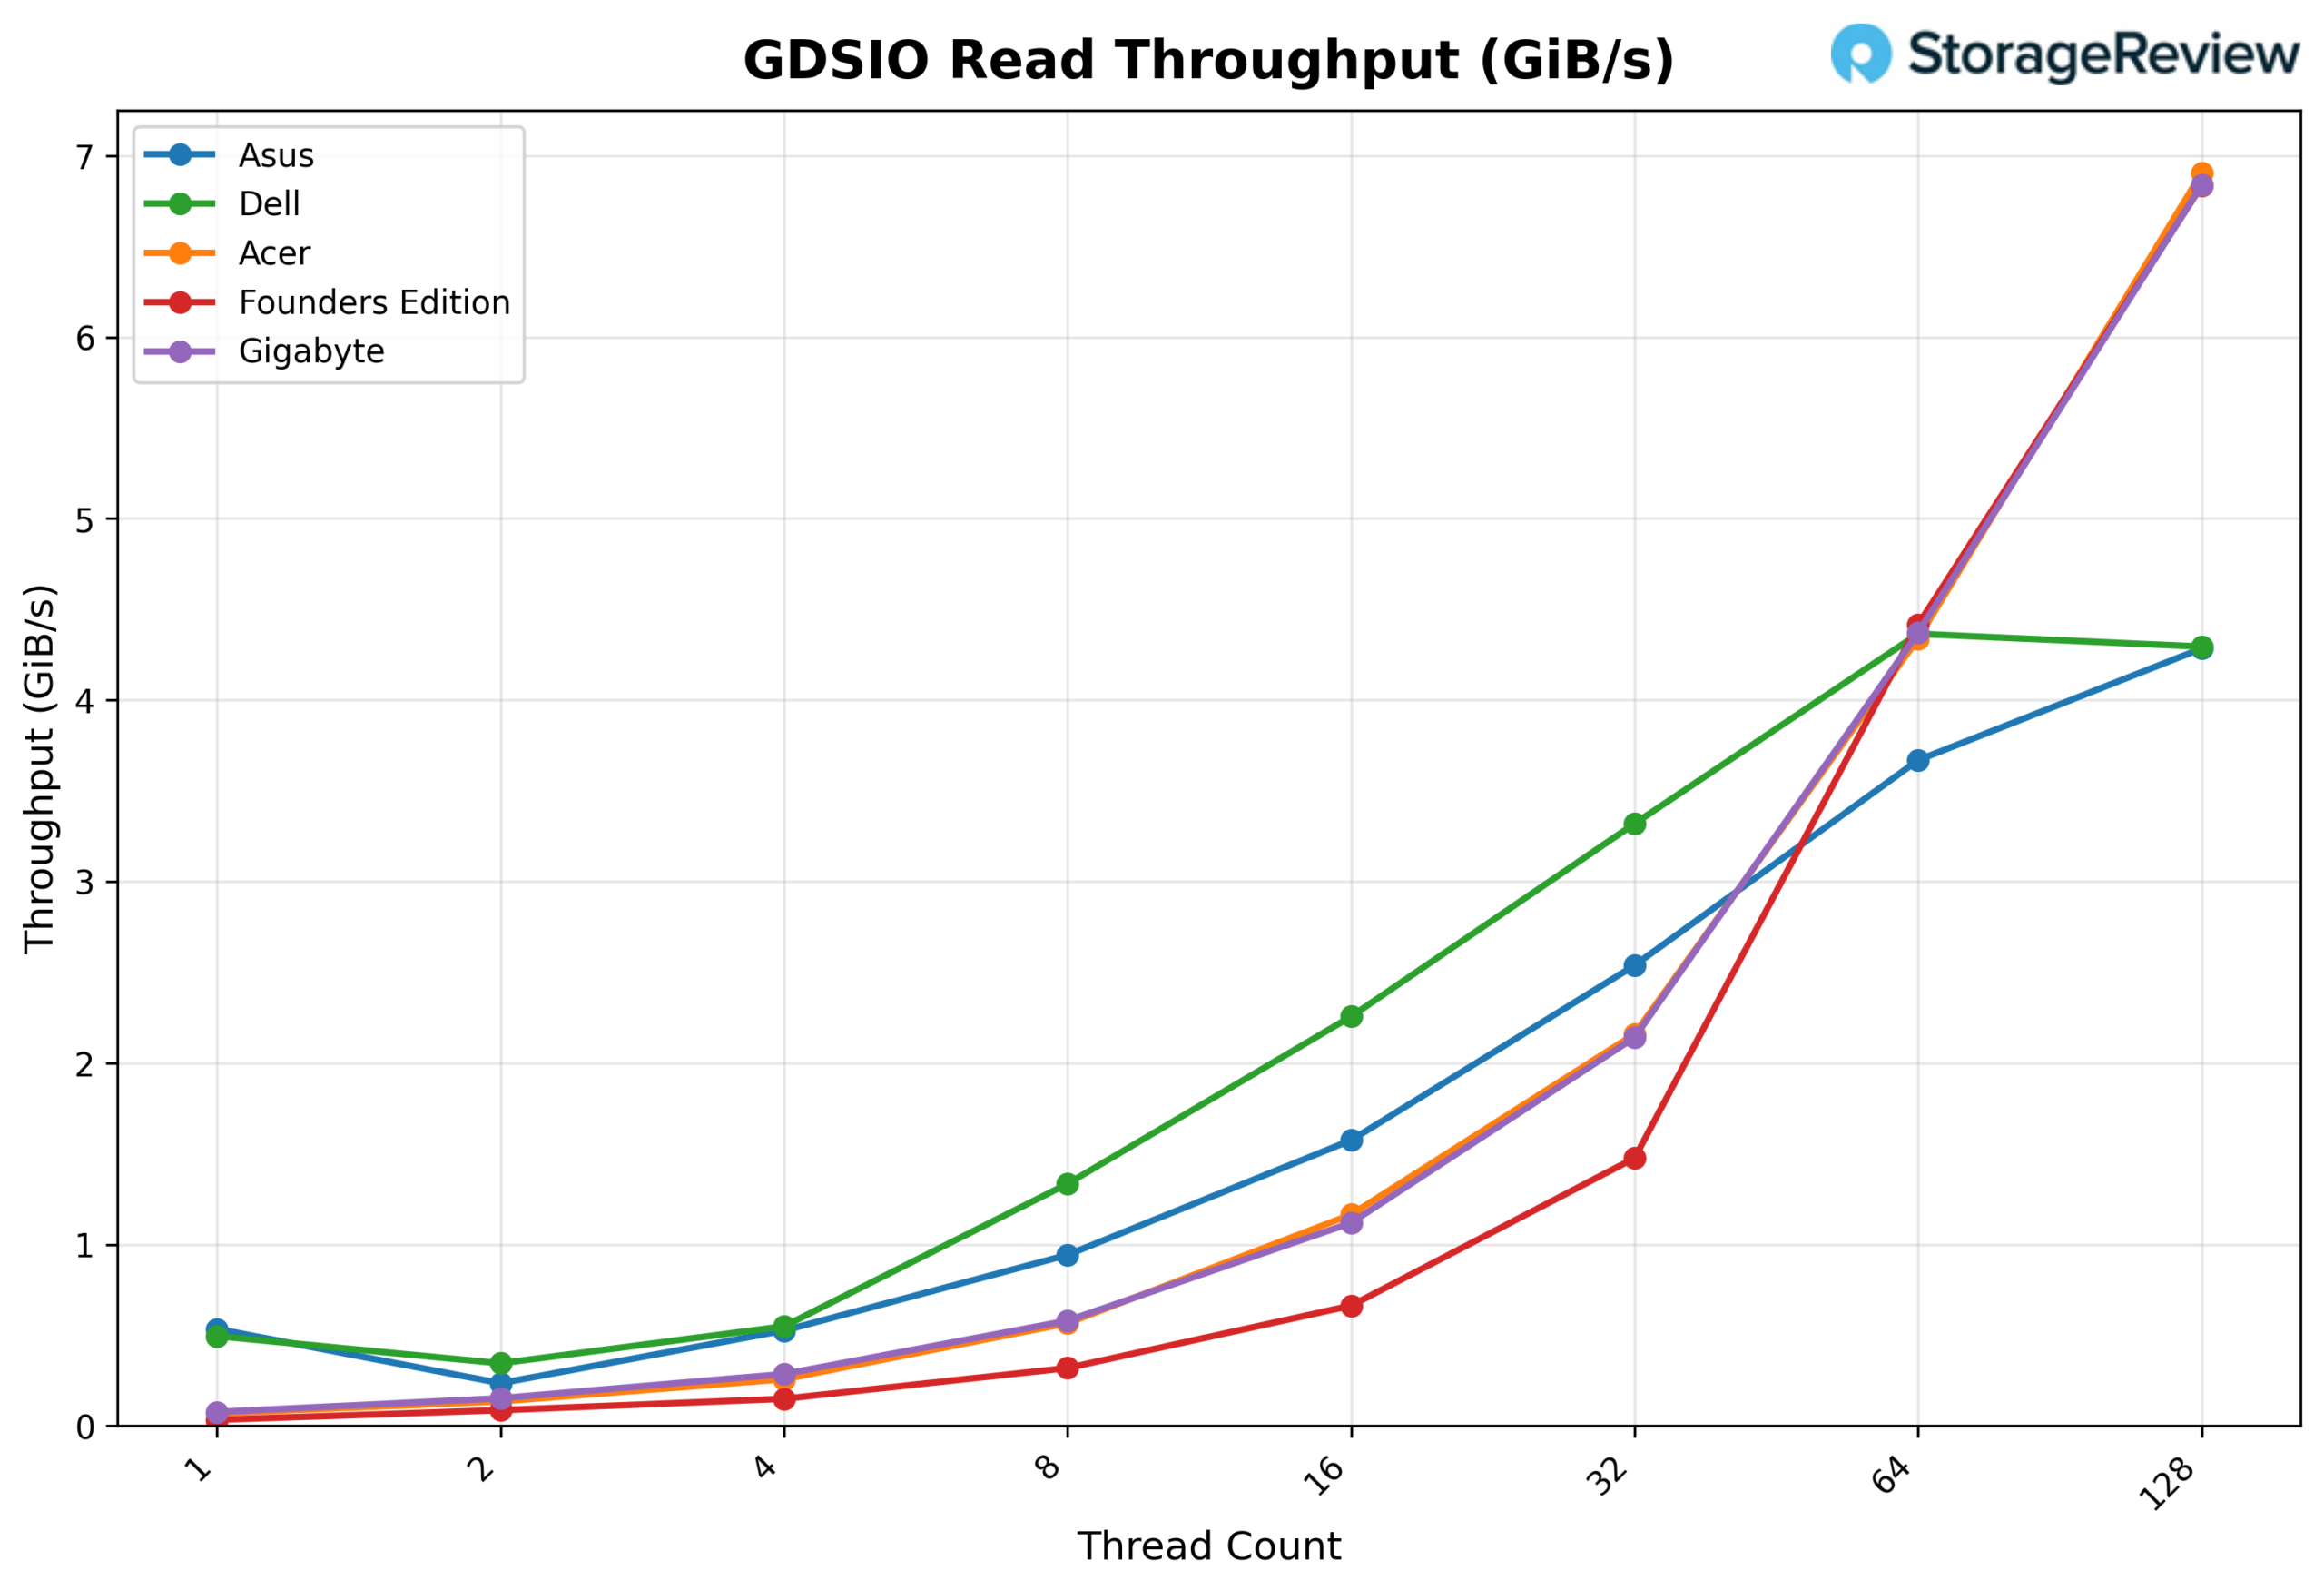
Analizzando il throughput di lettura GDSIO a 16 KB, la scheda GIGABYTE parte da circa 0.08 GiB/s con 1 thread e sale a 0.58 GiB/s con 8 thread. Da lì, continua a scalare in modo pulito a 16 thread (1.12 GiB/s) e 32 thread (2.14 GiB/s), prima di aumentare bruscamente a 64 thread fino a 4.37 GiB/s. A 128 thread, GIGABYTE continua a scalare fino a 6.84 GiB/s, senza mostrare alcun segno di stabilizzazione nella parte alta della gamma di thread.
Latenza media di lettura GDSIO 16K
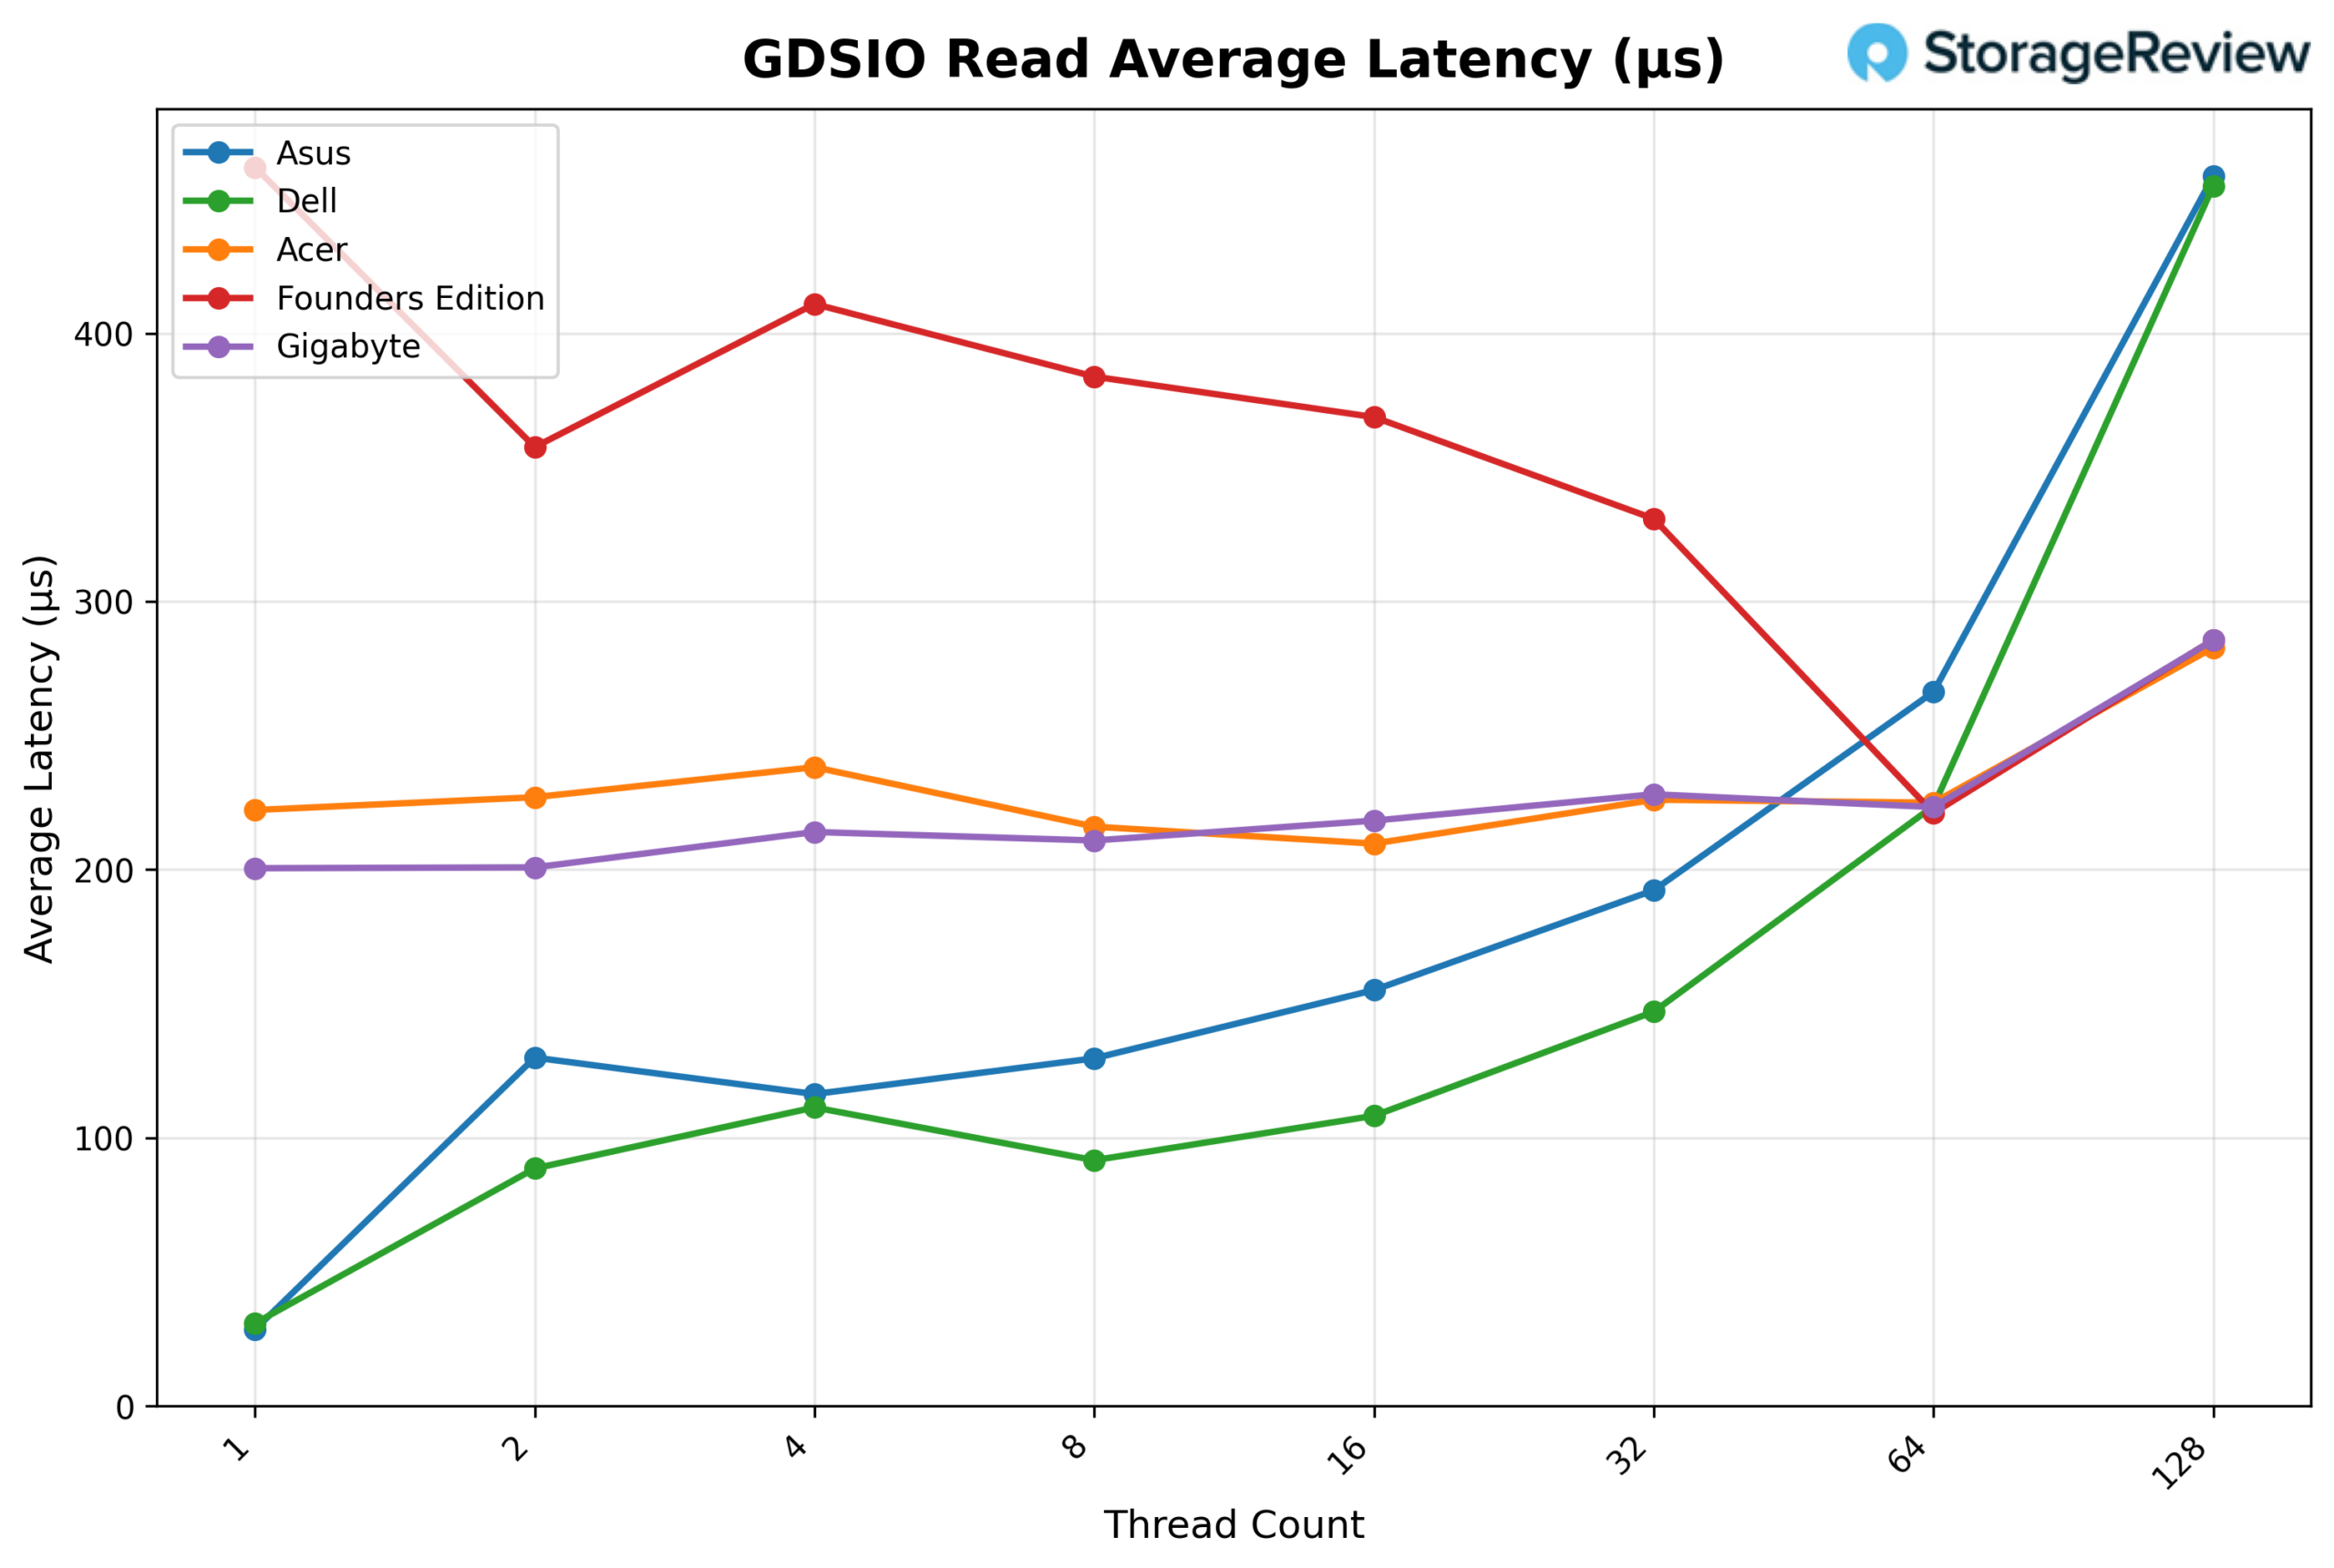
Analizzando la latenza media di lettura GDSIO (16K), GIGABYTE mantiene una latenza molto costante lungo la maggior parte della curva. Si parte da circa 0.201 ms con 1 thread e si mantiene in un intervallo ristretto tra ~0.21 e 0.23 ms da 2 a 64 thread (ad esempio, 0.211 ms con 8 thread, 0.218 ms con 16 thread, 0.228 ms con 32 thread e 0.223 ms con 64 thread). Solo a 128 thread la latenza aumenta in modo più evidente, raggiungendo circa 0.286 ms, mentre il throughput continua a crescere.
Velocità di scrittura GSDIO 16K
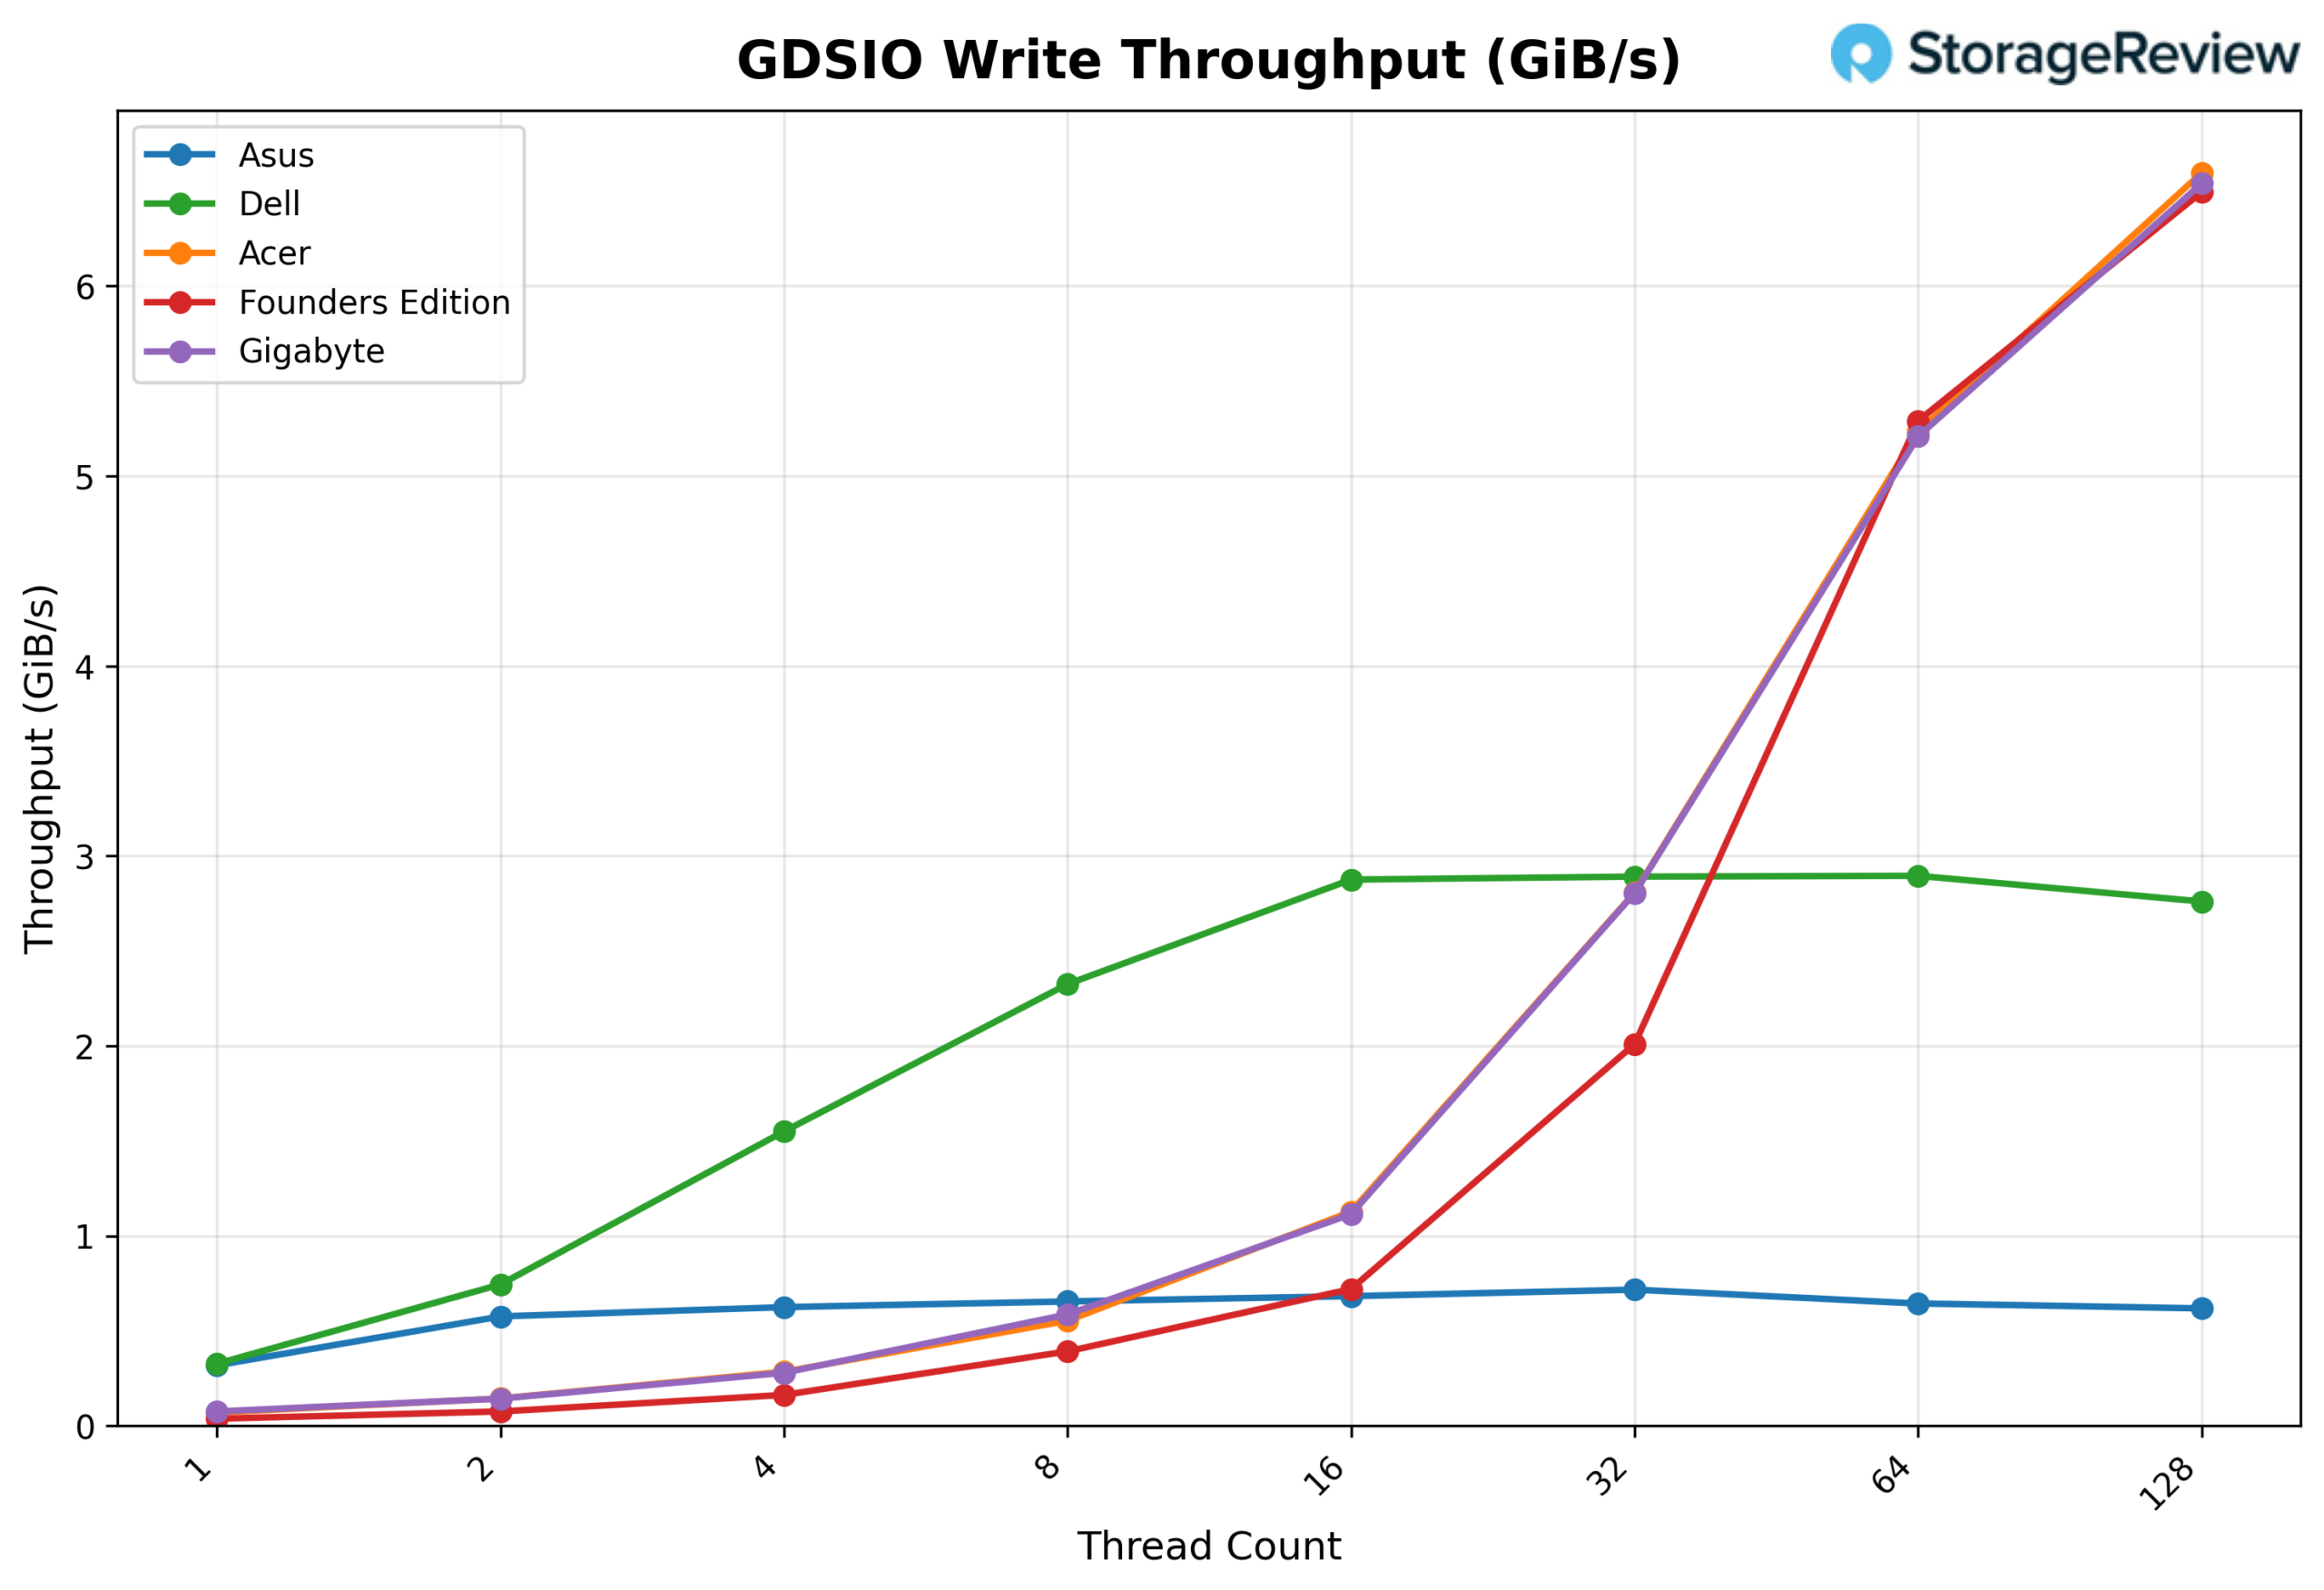
Analizzando il throughput di scrittura GDSIO a 16 KB, la GIGABYTE parte da circa 0.08 GiB/s con 1 thread, scala costantemente fino a 0.14 GiB/s con 2 thread e 0.28 GiB/s con 4 thread. Le prestazioni continuano a crescere in modo netto a 8 thread (0.59 GiB/s) e 16 thread (1.11 GiB/s) prima di aumentare in modo più aggressivo a 32 thread (2.80 GiB/s). La scalabilità rimane elevata a 64 thread (5.21 GiB/s) e raggiunge il picco di 6.54 GiB/s a 128 thread, mostrando una continua crescita senza un plateau iniziale.
Latenza media di scrittura GDSIO 16K
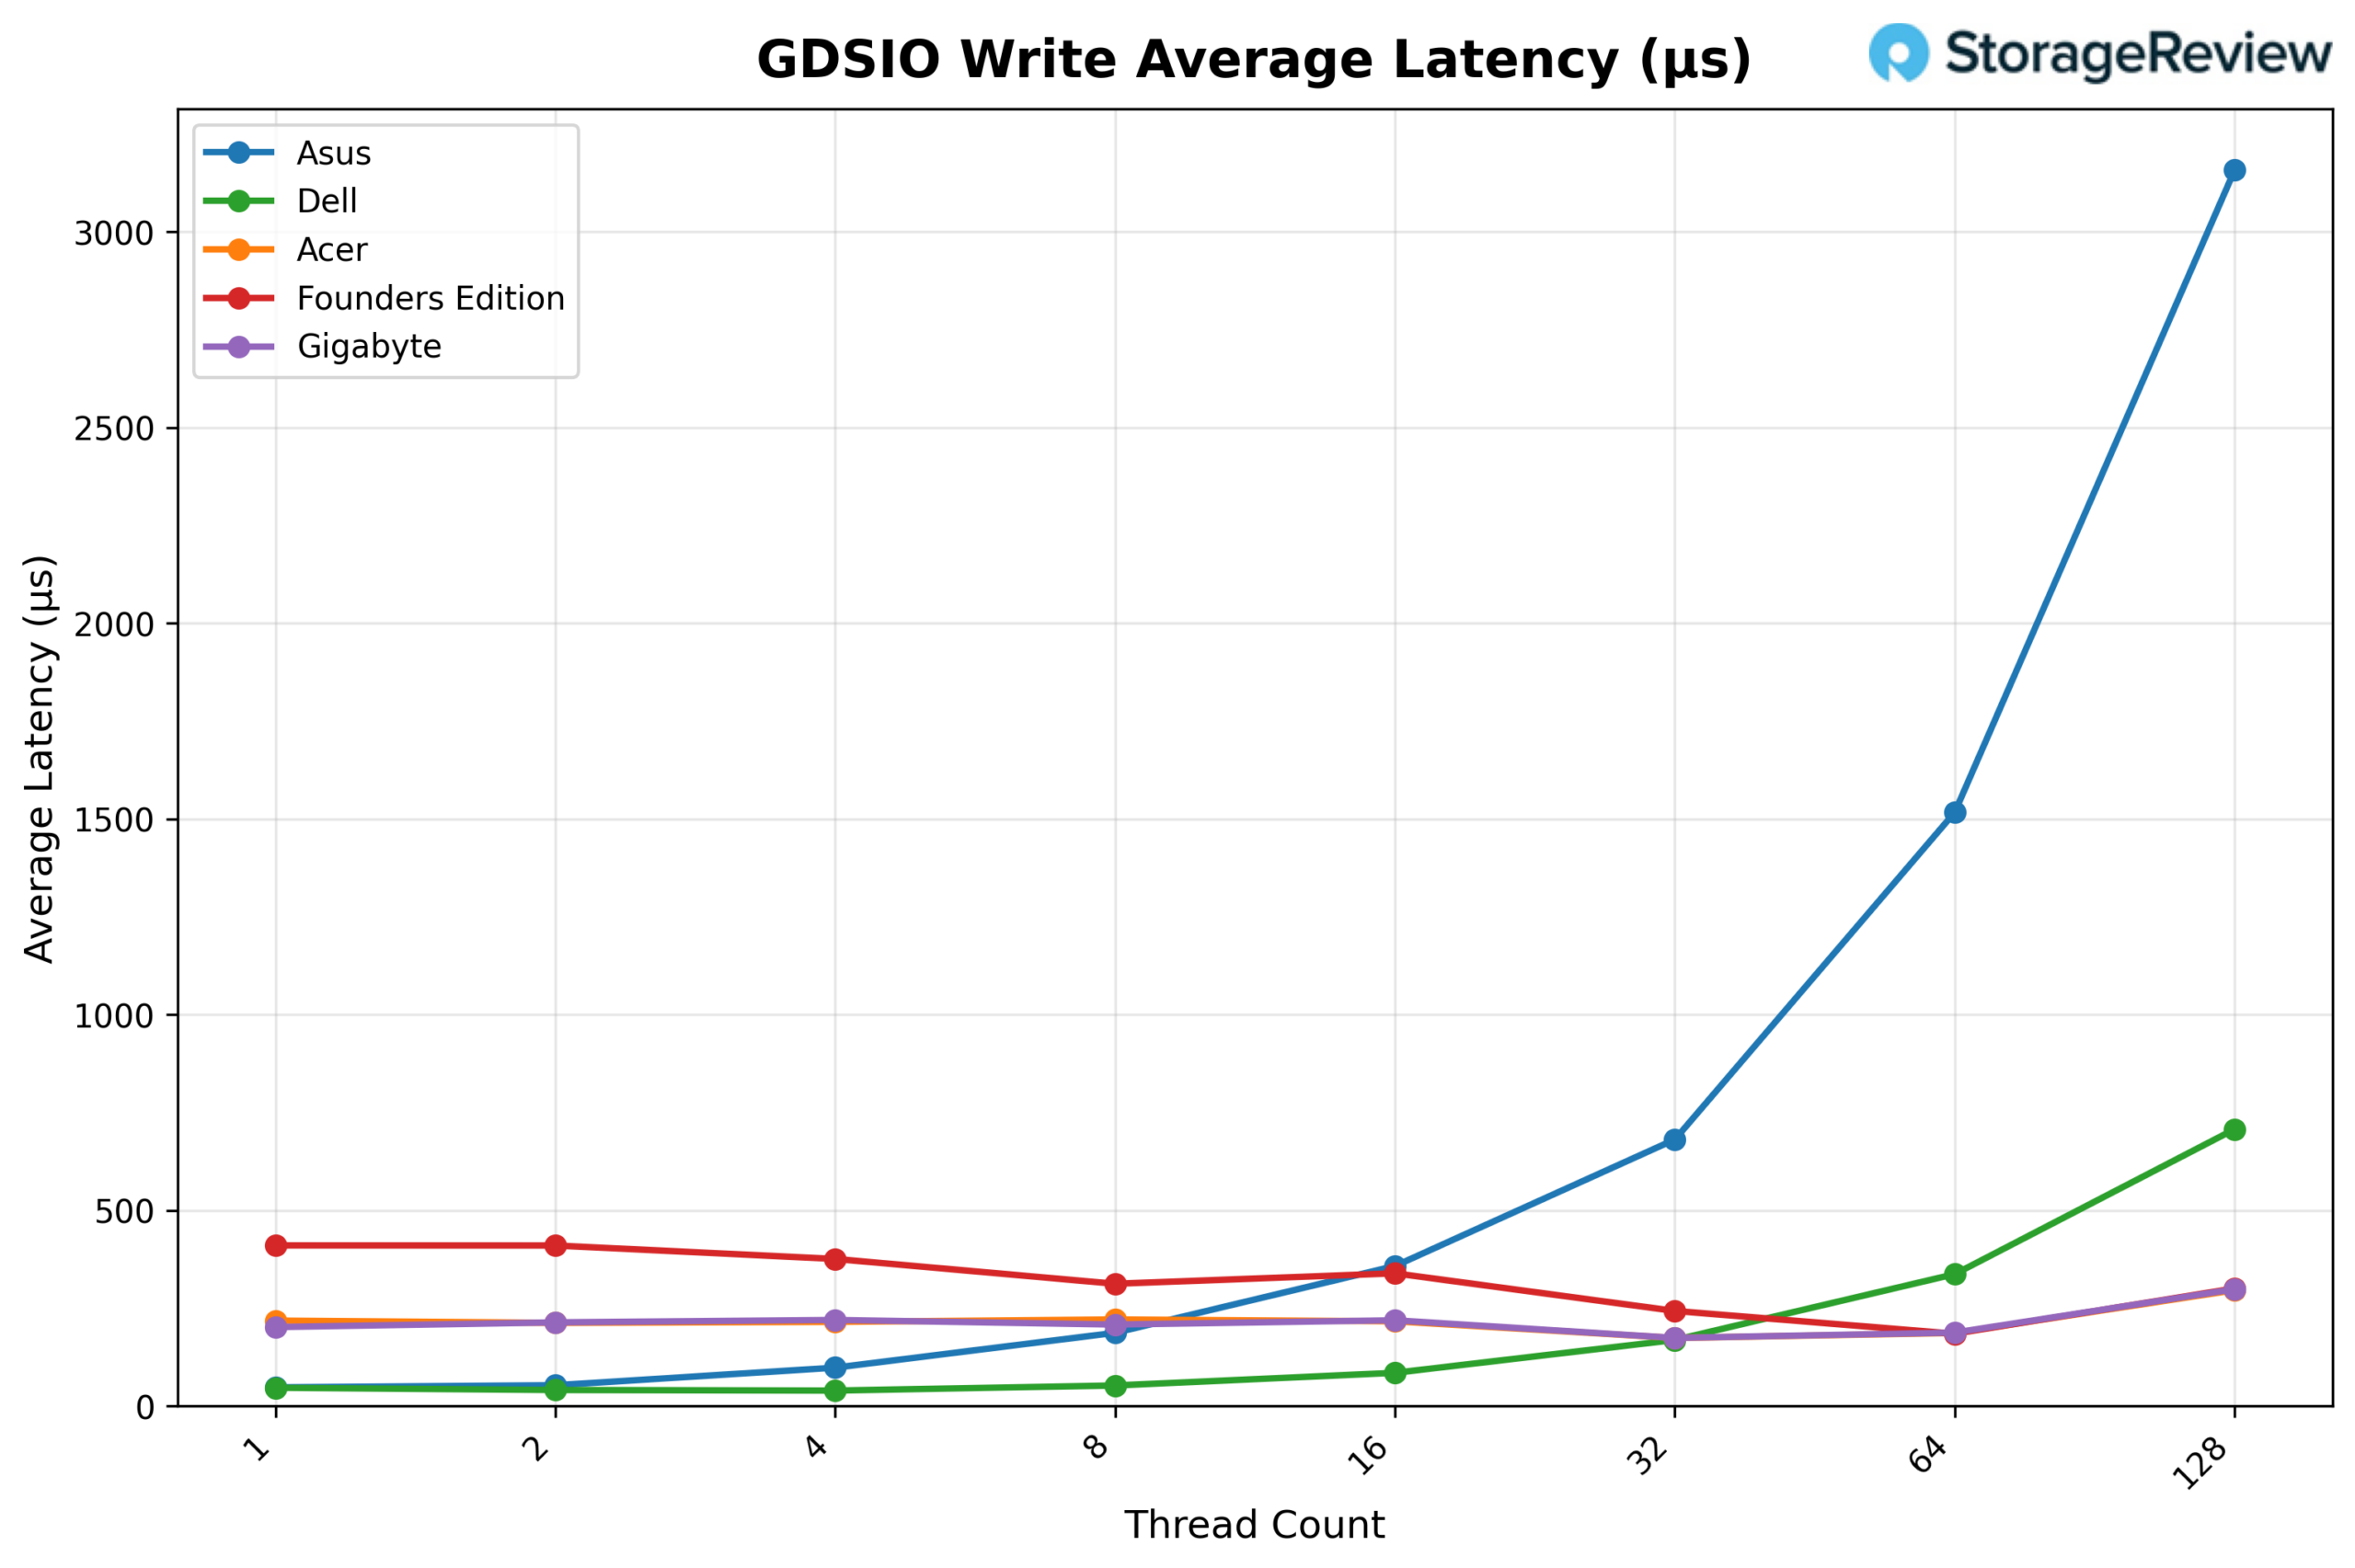
Analizzando la latenza media di scrittura GDSIO (16K), GIGABYTE mantiene una latenza relativamente stabile per gran parte della curva. Si parte da circa 0.20 ms con 1 thread e si mantiene nell'intervallo ~0.21-0.22 ms fino a 16 thread. Con 32 thread, la latenza migliora leggermente fino a circa 0.17 ms, per poi aumentare modestamente a 64 thread (0.19 ms). Solo con 128 thread la latenza aumenta in modo significativo, raggiungendo circa 0.30 ms, corrispondente al livello di throughput più elevato.
Velocità di lettura GDSIO 1M
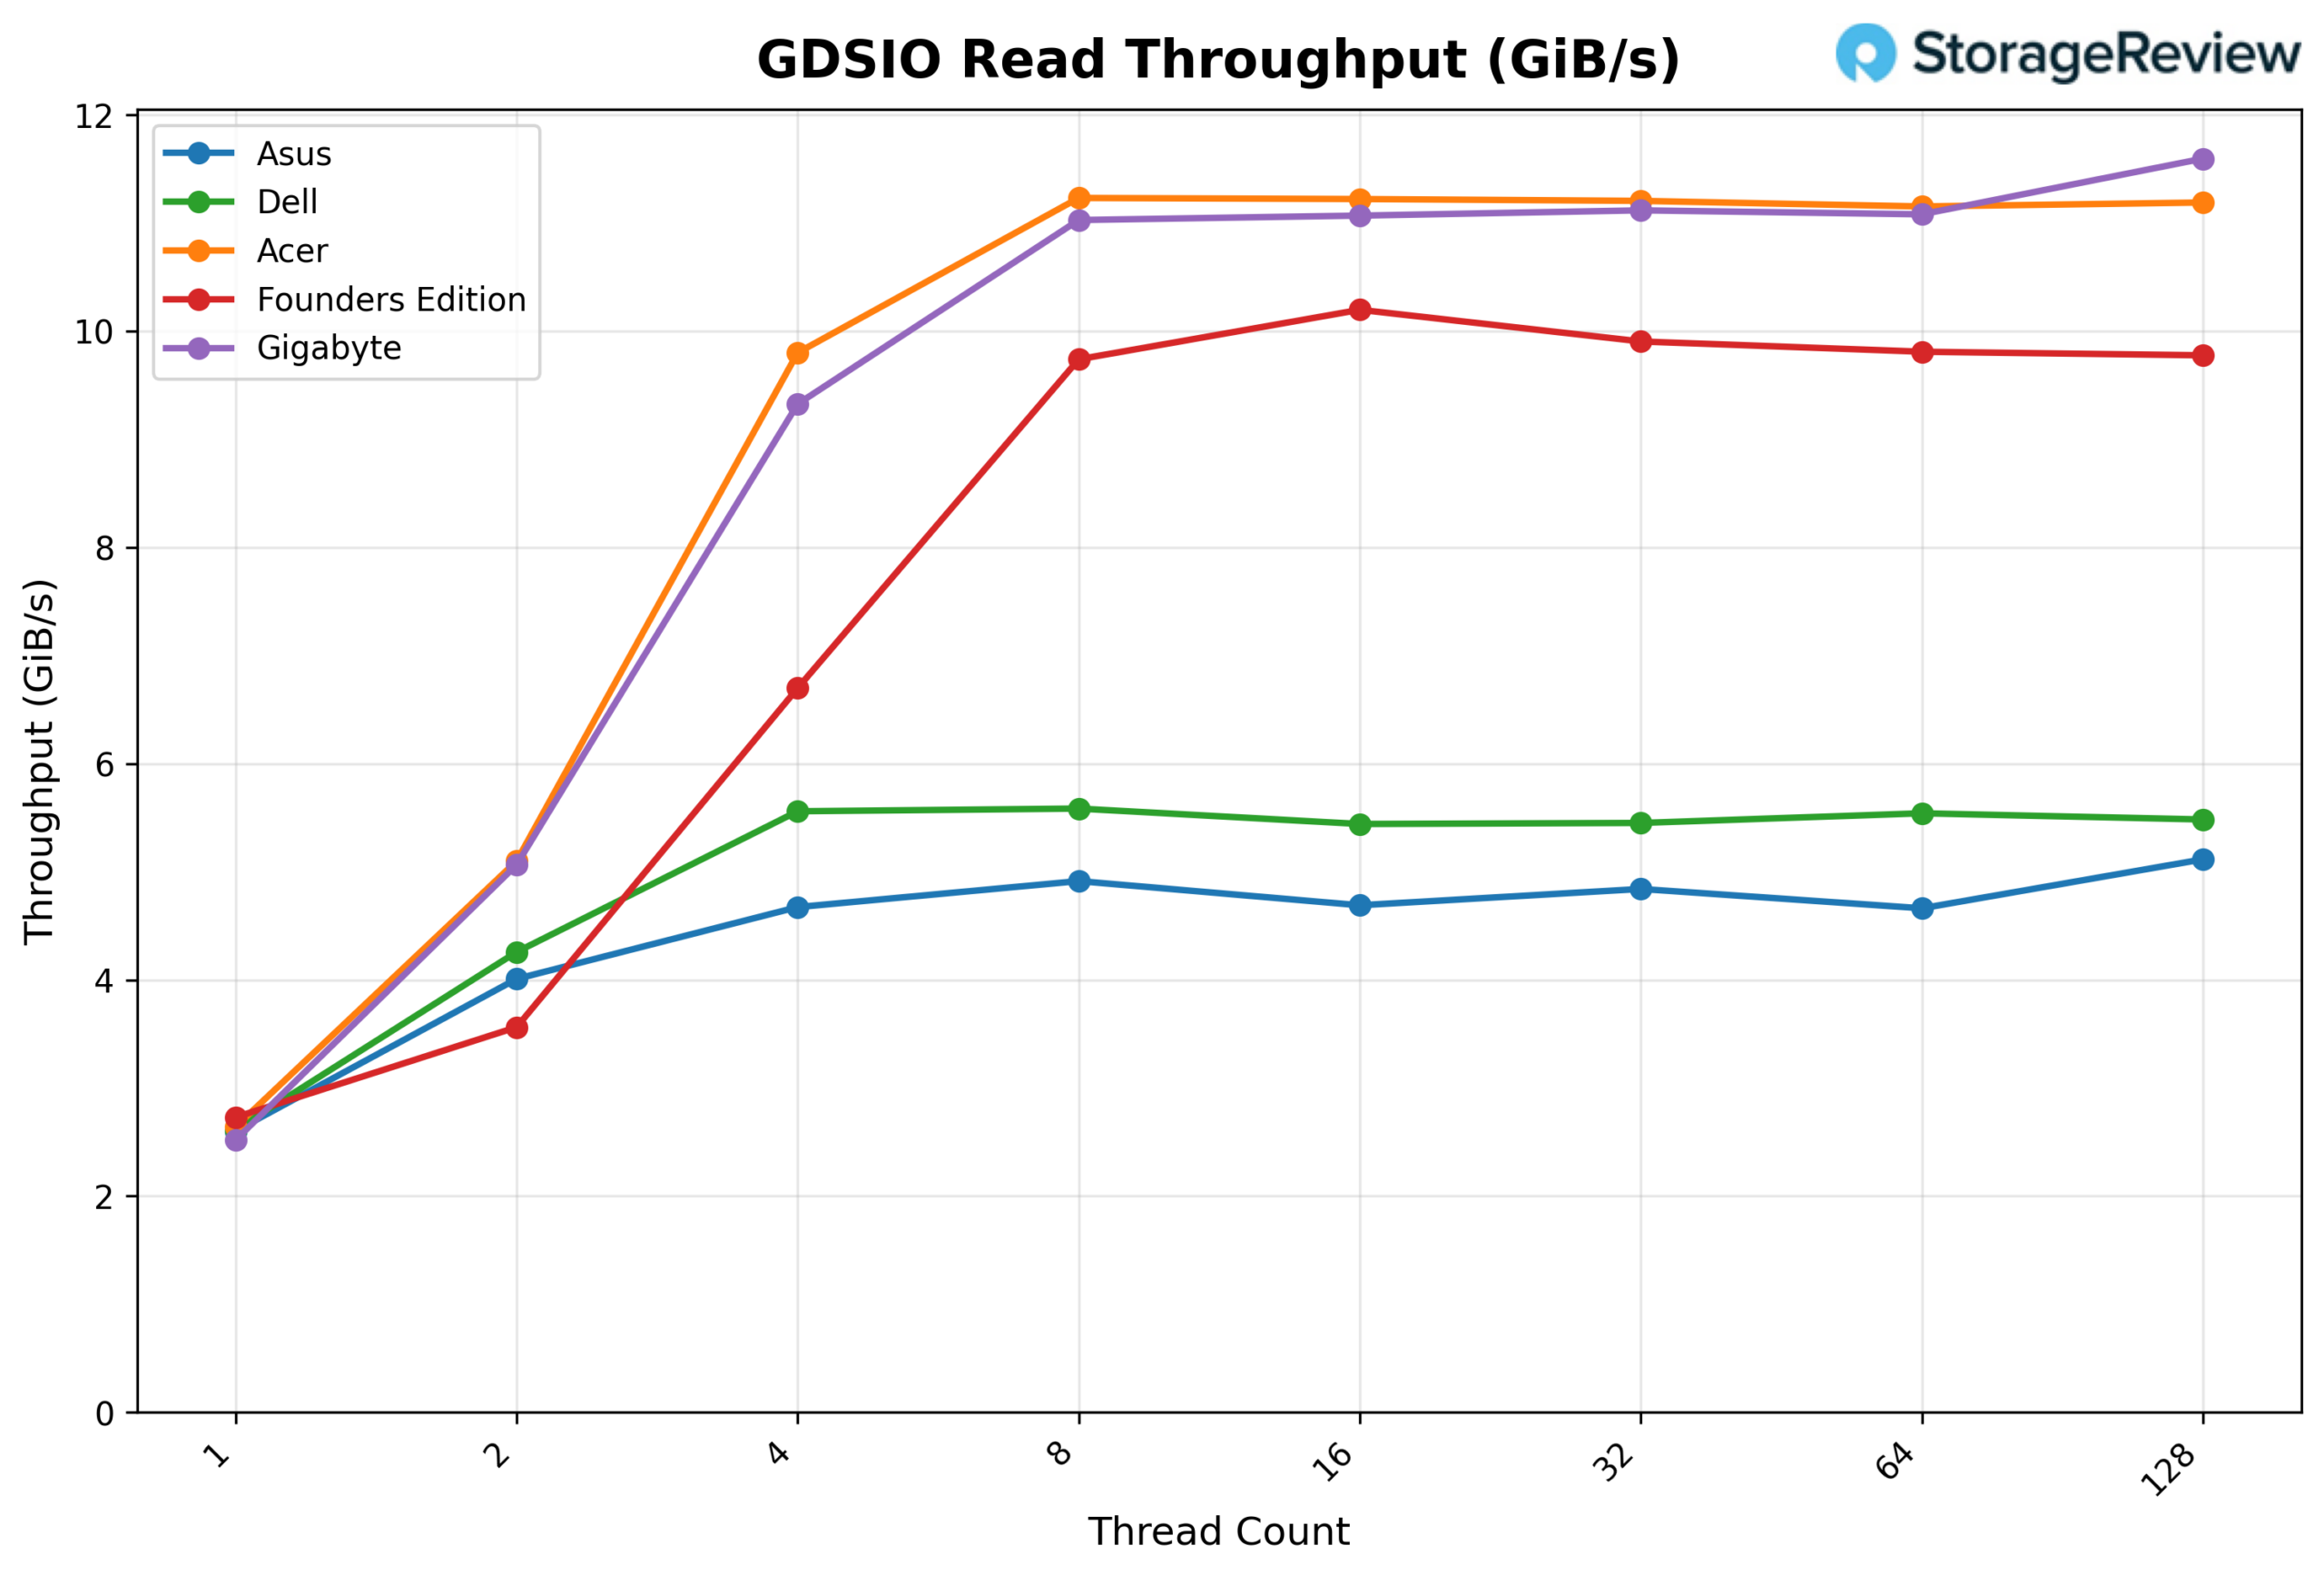
Analizzando il throughput di lettura GDSIO a 1 MB, la GIGABYTE parte da 2.52 GiB/s con 1 thread e sale a 5.07 GiB/s con 2 thread e 9.33 GiB/s con 4 thread. Con 8 thread, il throughput raggiunge 11.03 GiB/s, dopodiché la piattaforma si satura. Le prestazioni rimangono costanti a 16 thread (11.07 GiB/s), 32 thread (11.12 GiB/s) e 64 thread (11.08 GiB/s), mostrando un plateau stabile. Con 128 thread, il throughput aumenta leggermente a 11.60 GiB/s, segnando il risultato più alto osservato durante il test.
Latenza media di lettura GDSIO 1M
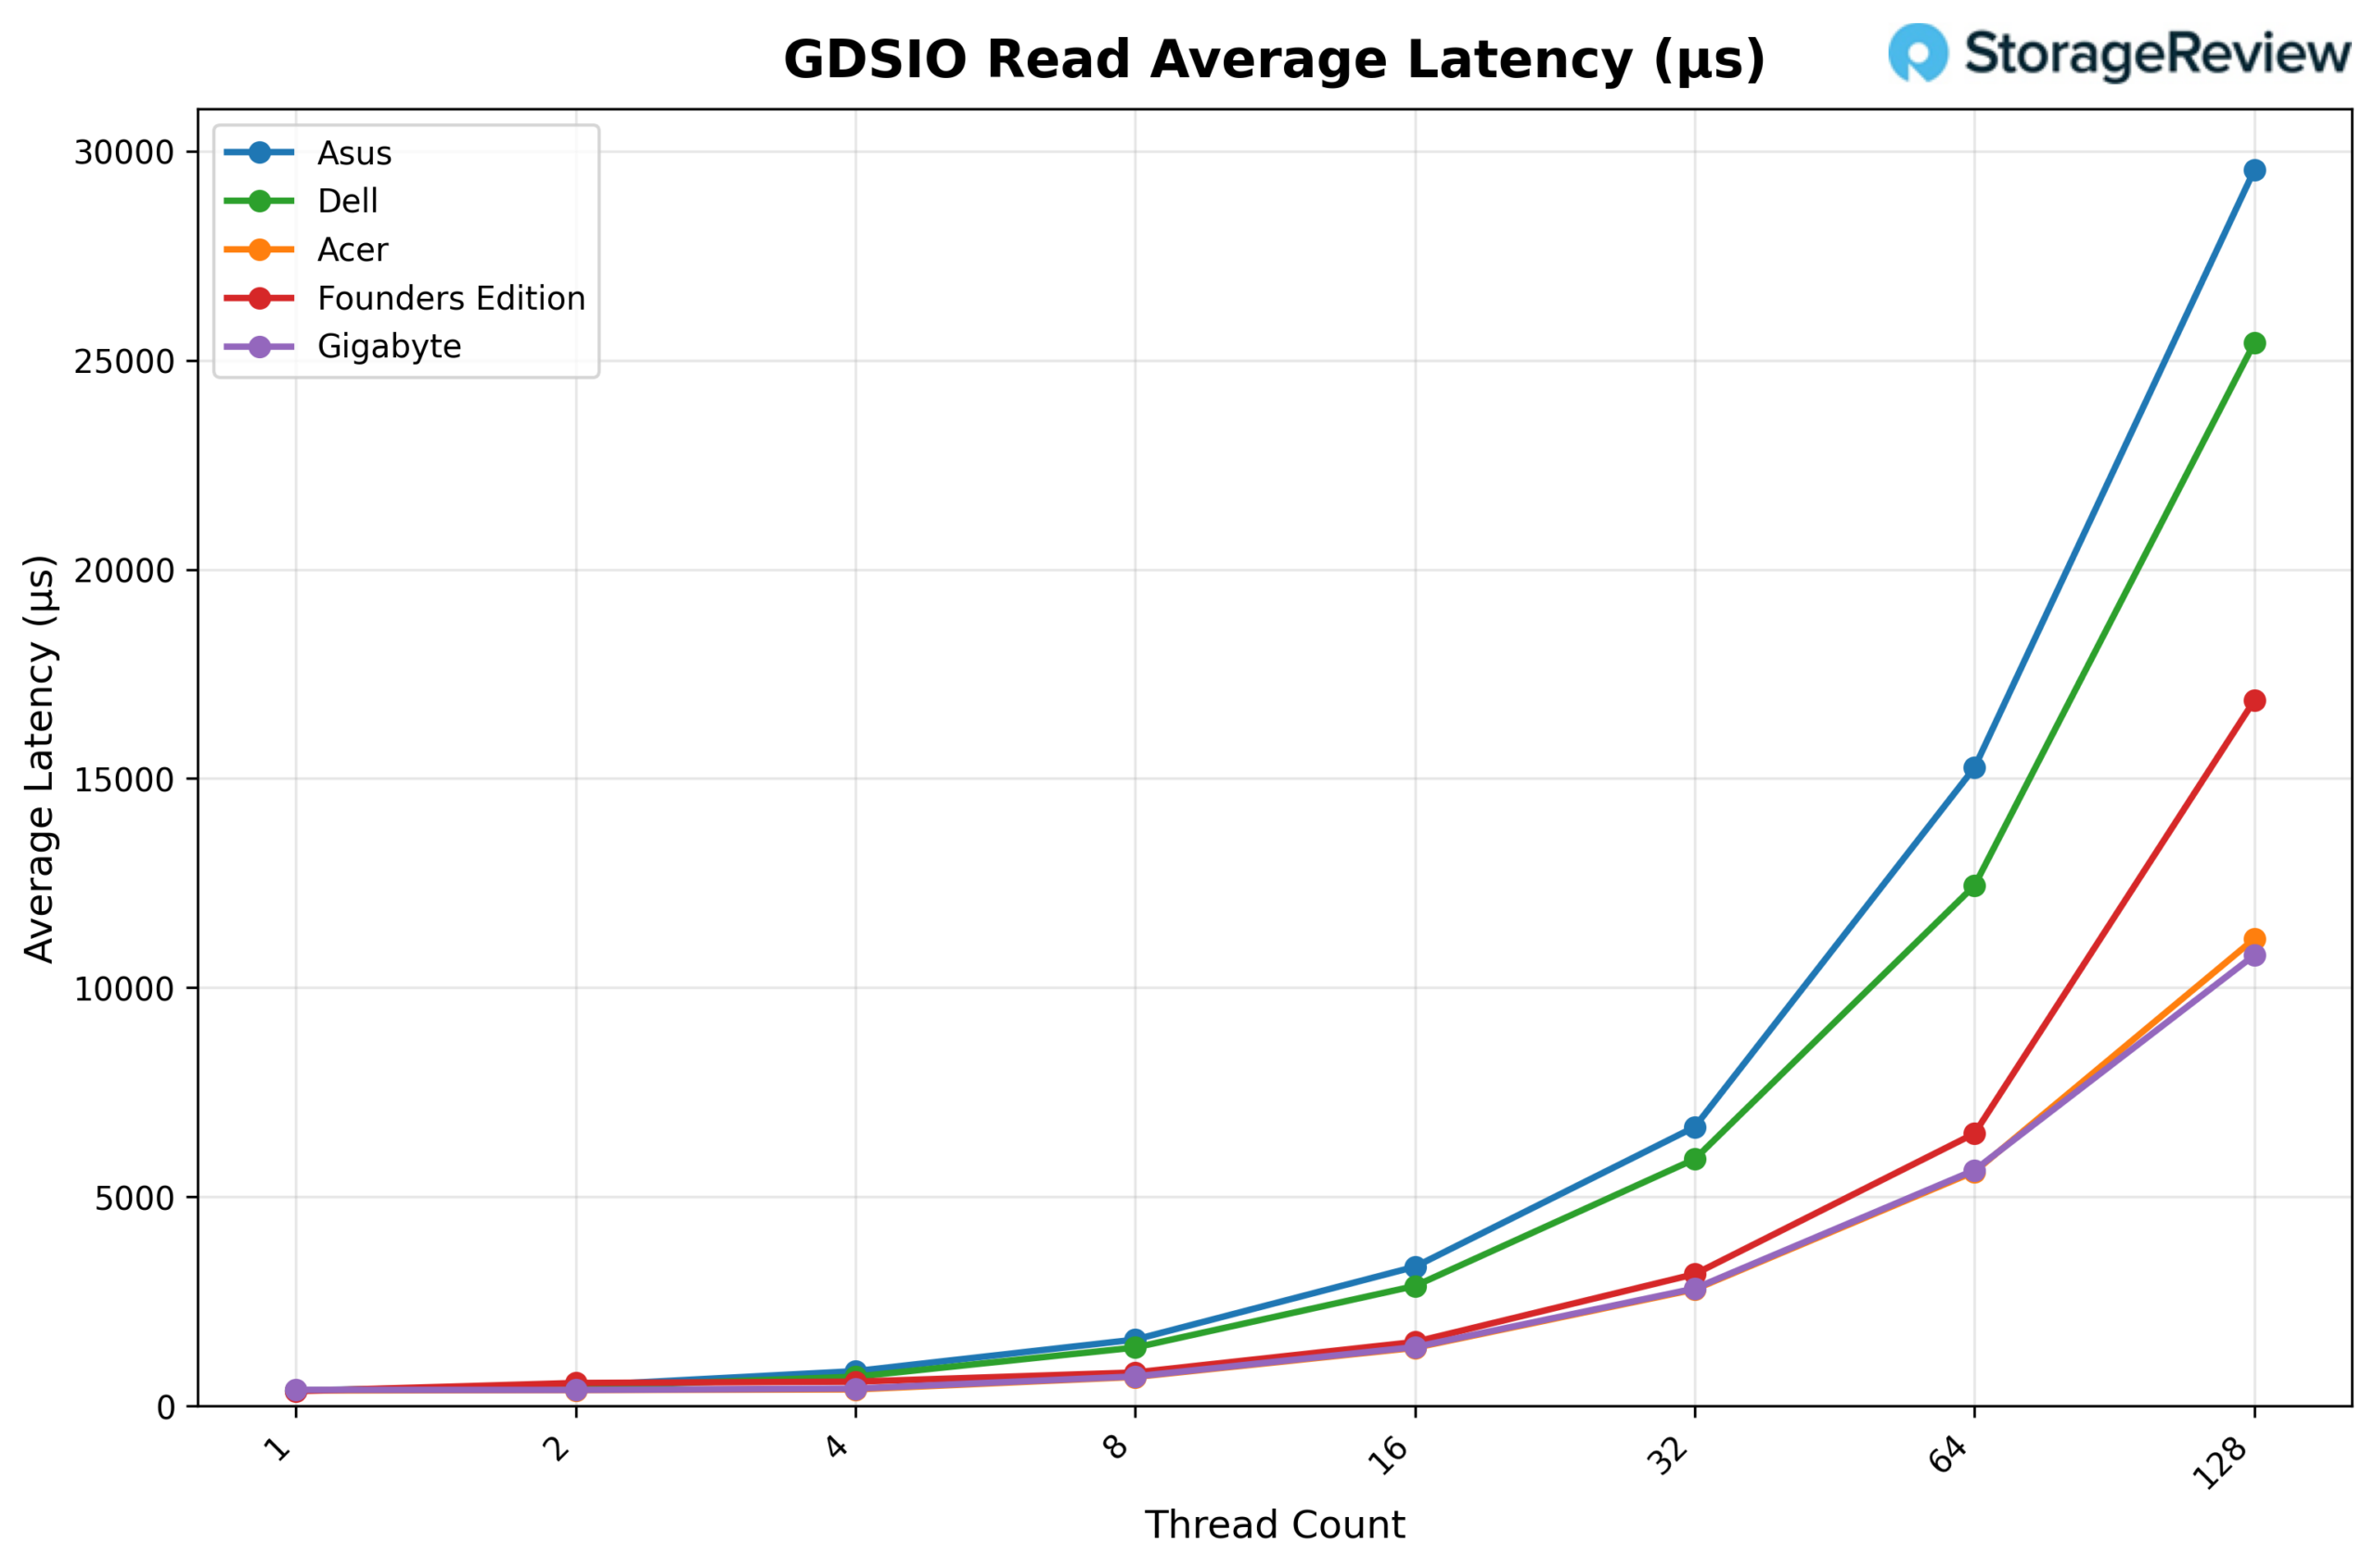
Analizzando la latenza media di lettura GDSIO (1M), GIGABYTE parte da circa 0.39 ms con 1 thread e rimane simile con 2 thread (0.39 ms) e 4 thread (0.42 ms). La latenza aumenta con l'aumentare della concorrenza, raggiungendo 0.71 ms con 8 thread, 1.41 ms con 16 thread e 2.81 ms con 32 thread. La tendenza al rialzo continua con 64 thread (5.64 ms) e raggiunge i 10.78 ms con 128 thread, corrispondenti ai livelli di concorrenza massimi, mentre il throughput rimane sostanzialmente costante.
Velocità di scrittura GDSIO 1M
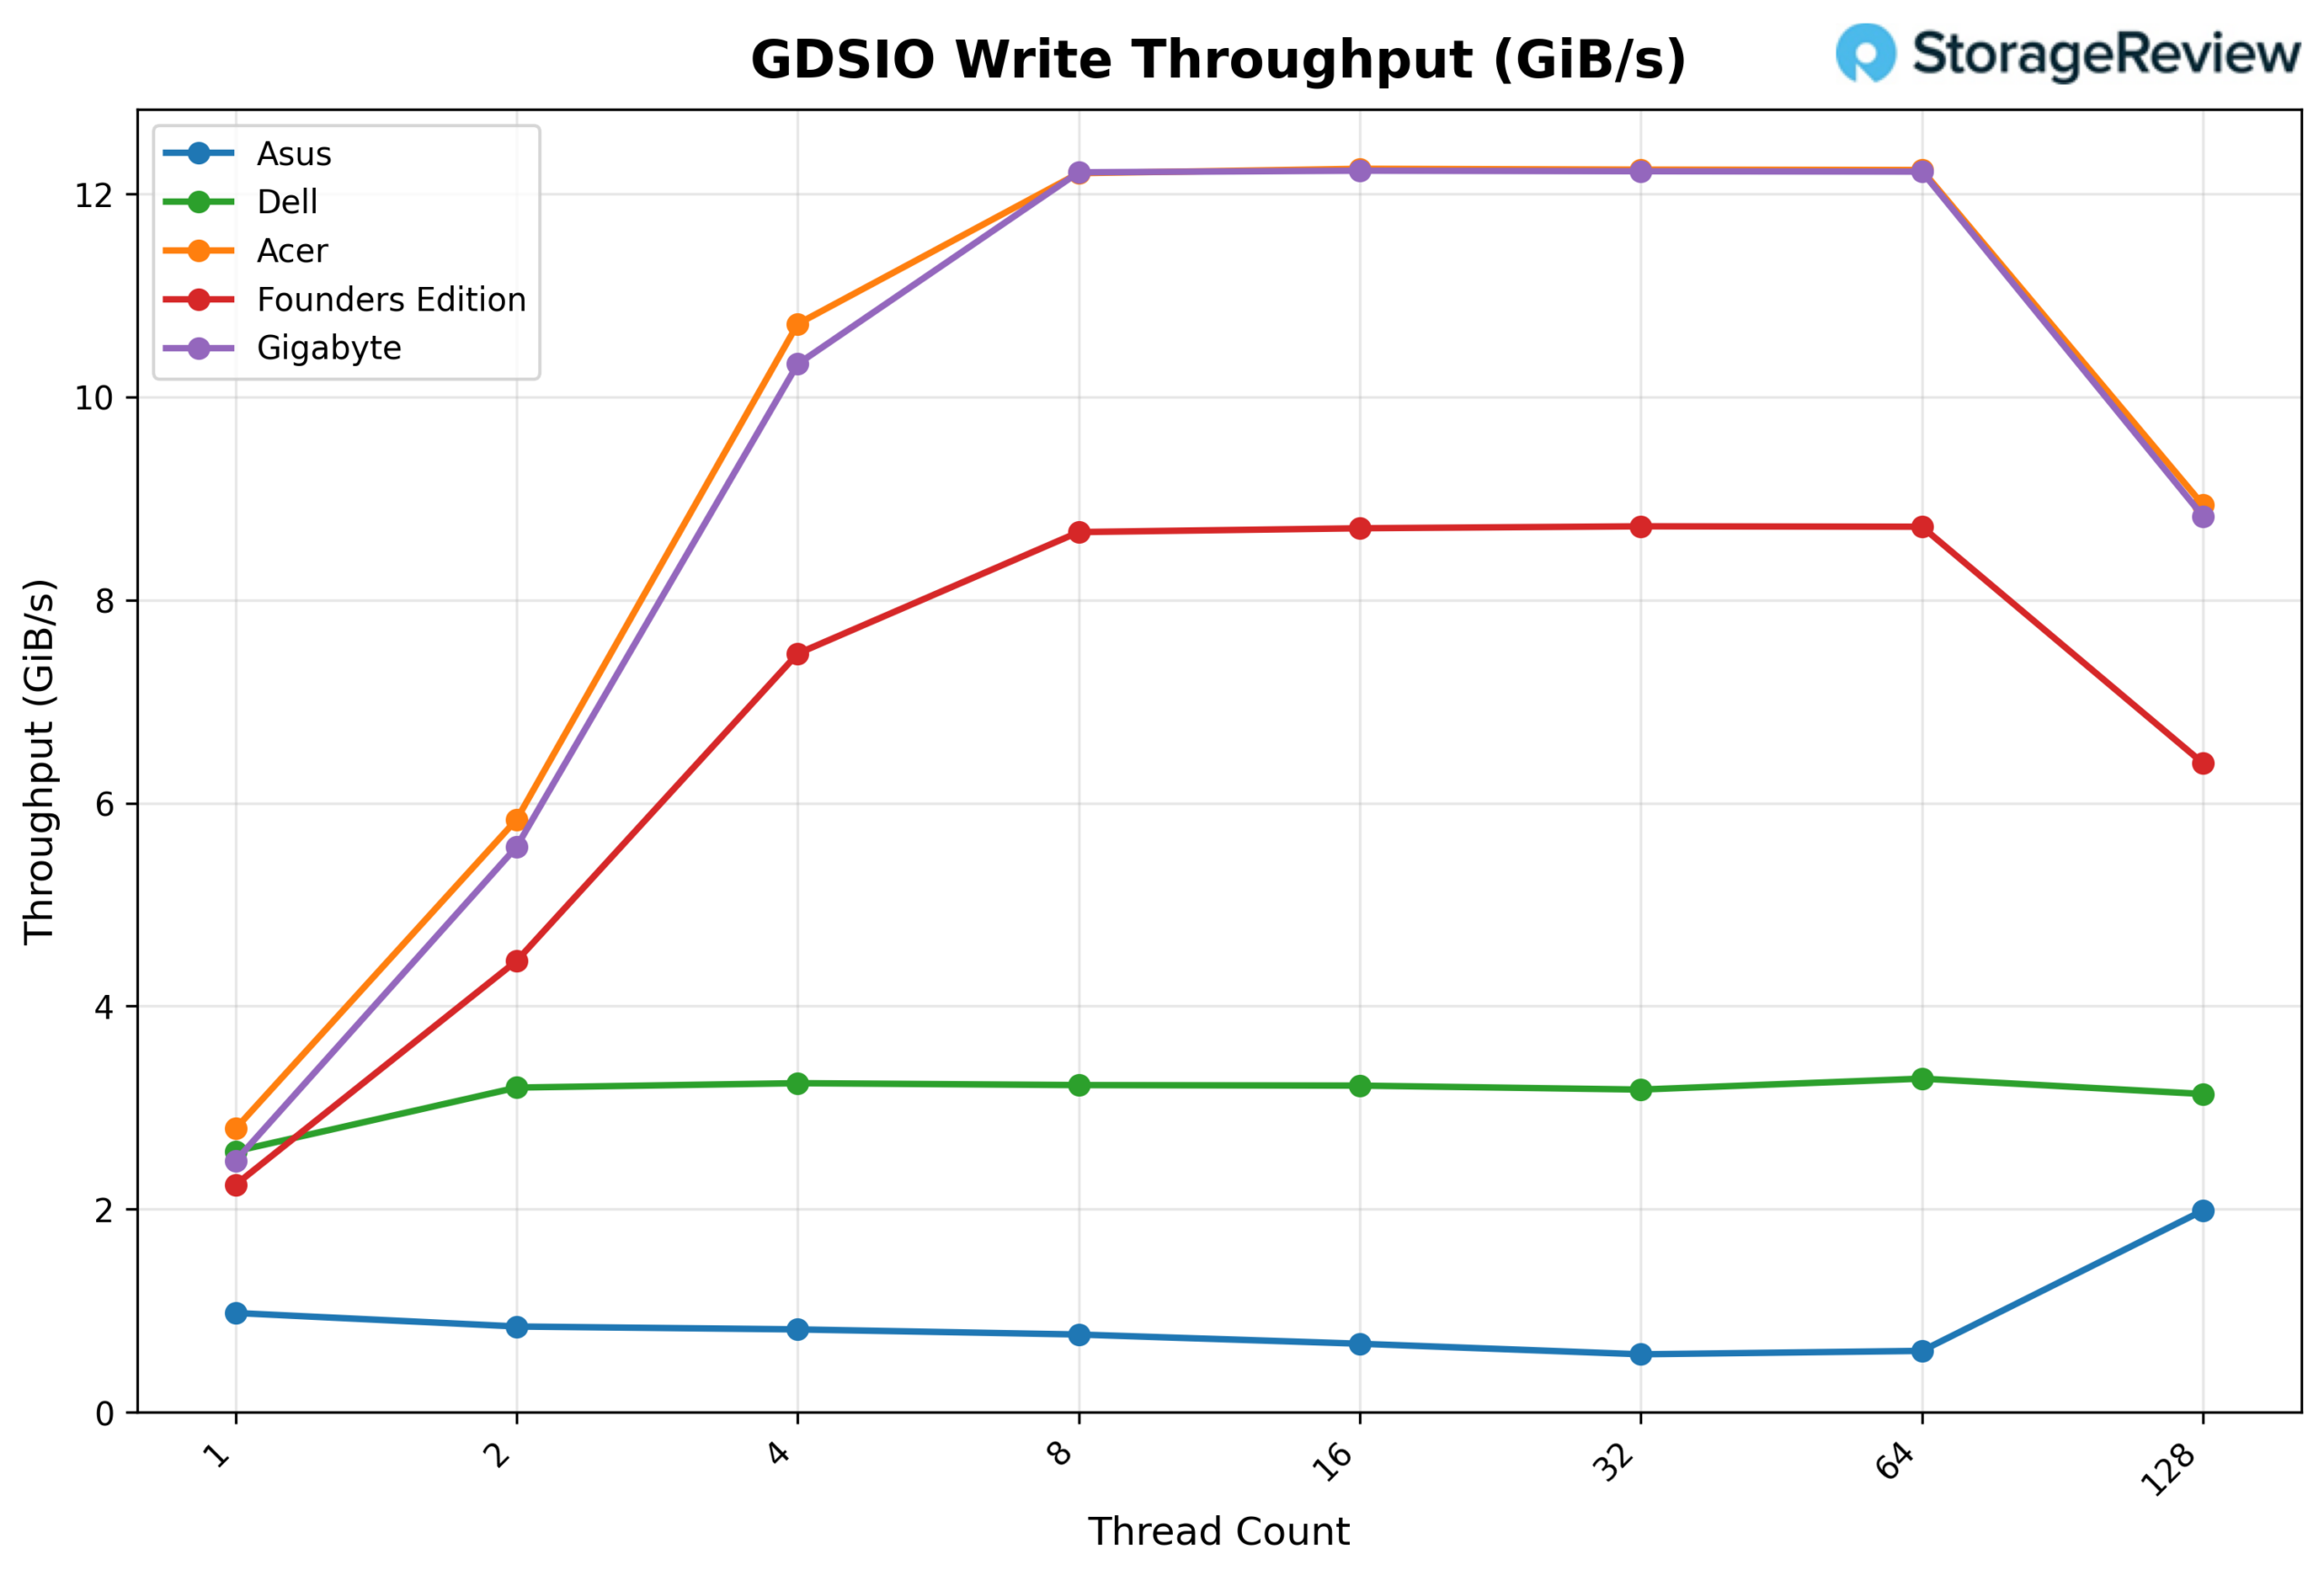
Analizzando il throughput di scrittura GDSIO a 1 MB, la GIGABYTE parte da 2.48 GiB/s con 1 thread e scala rapidamente a 5.57 GiB/s con 2 thread e 10.32 GiB/s con 4 thread. Con 8 thread, il throughput raggiunge i 12.21 GiB/s, saturando di fatto la piattaforma. Le prestazioni rimangono stabili a 16 thread (12.23 GiB/s), 32 thread (12.22 GiB/s) e 64 thread (12.22 GiB/s), indicando un plateau iniziale. A 128 thread, il throughput scende a 8.82 GiB/s, suggerendo che il sistema ha superato il suo intervallo di concorrenza ottimale.
Latenza media di scrittura GDSIO 1M
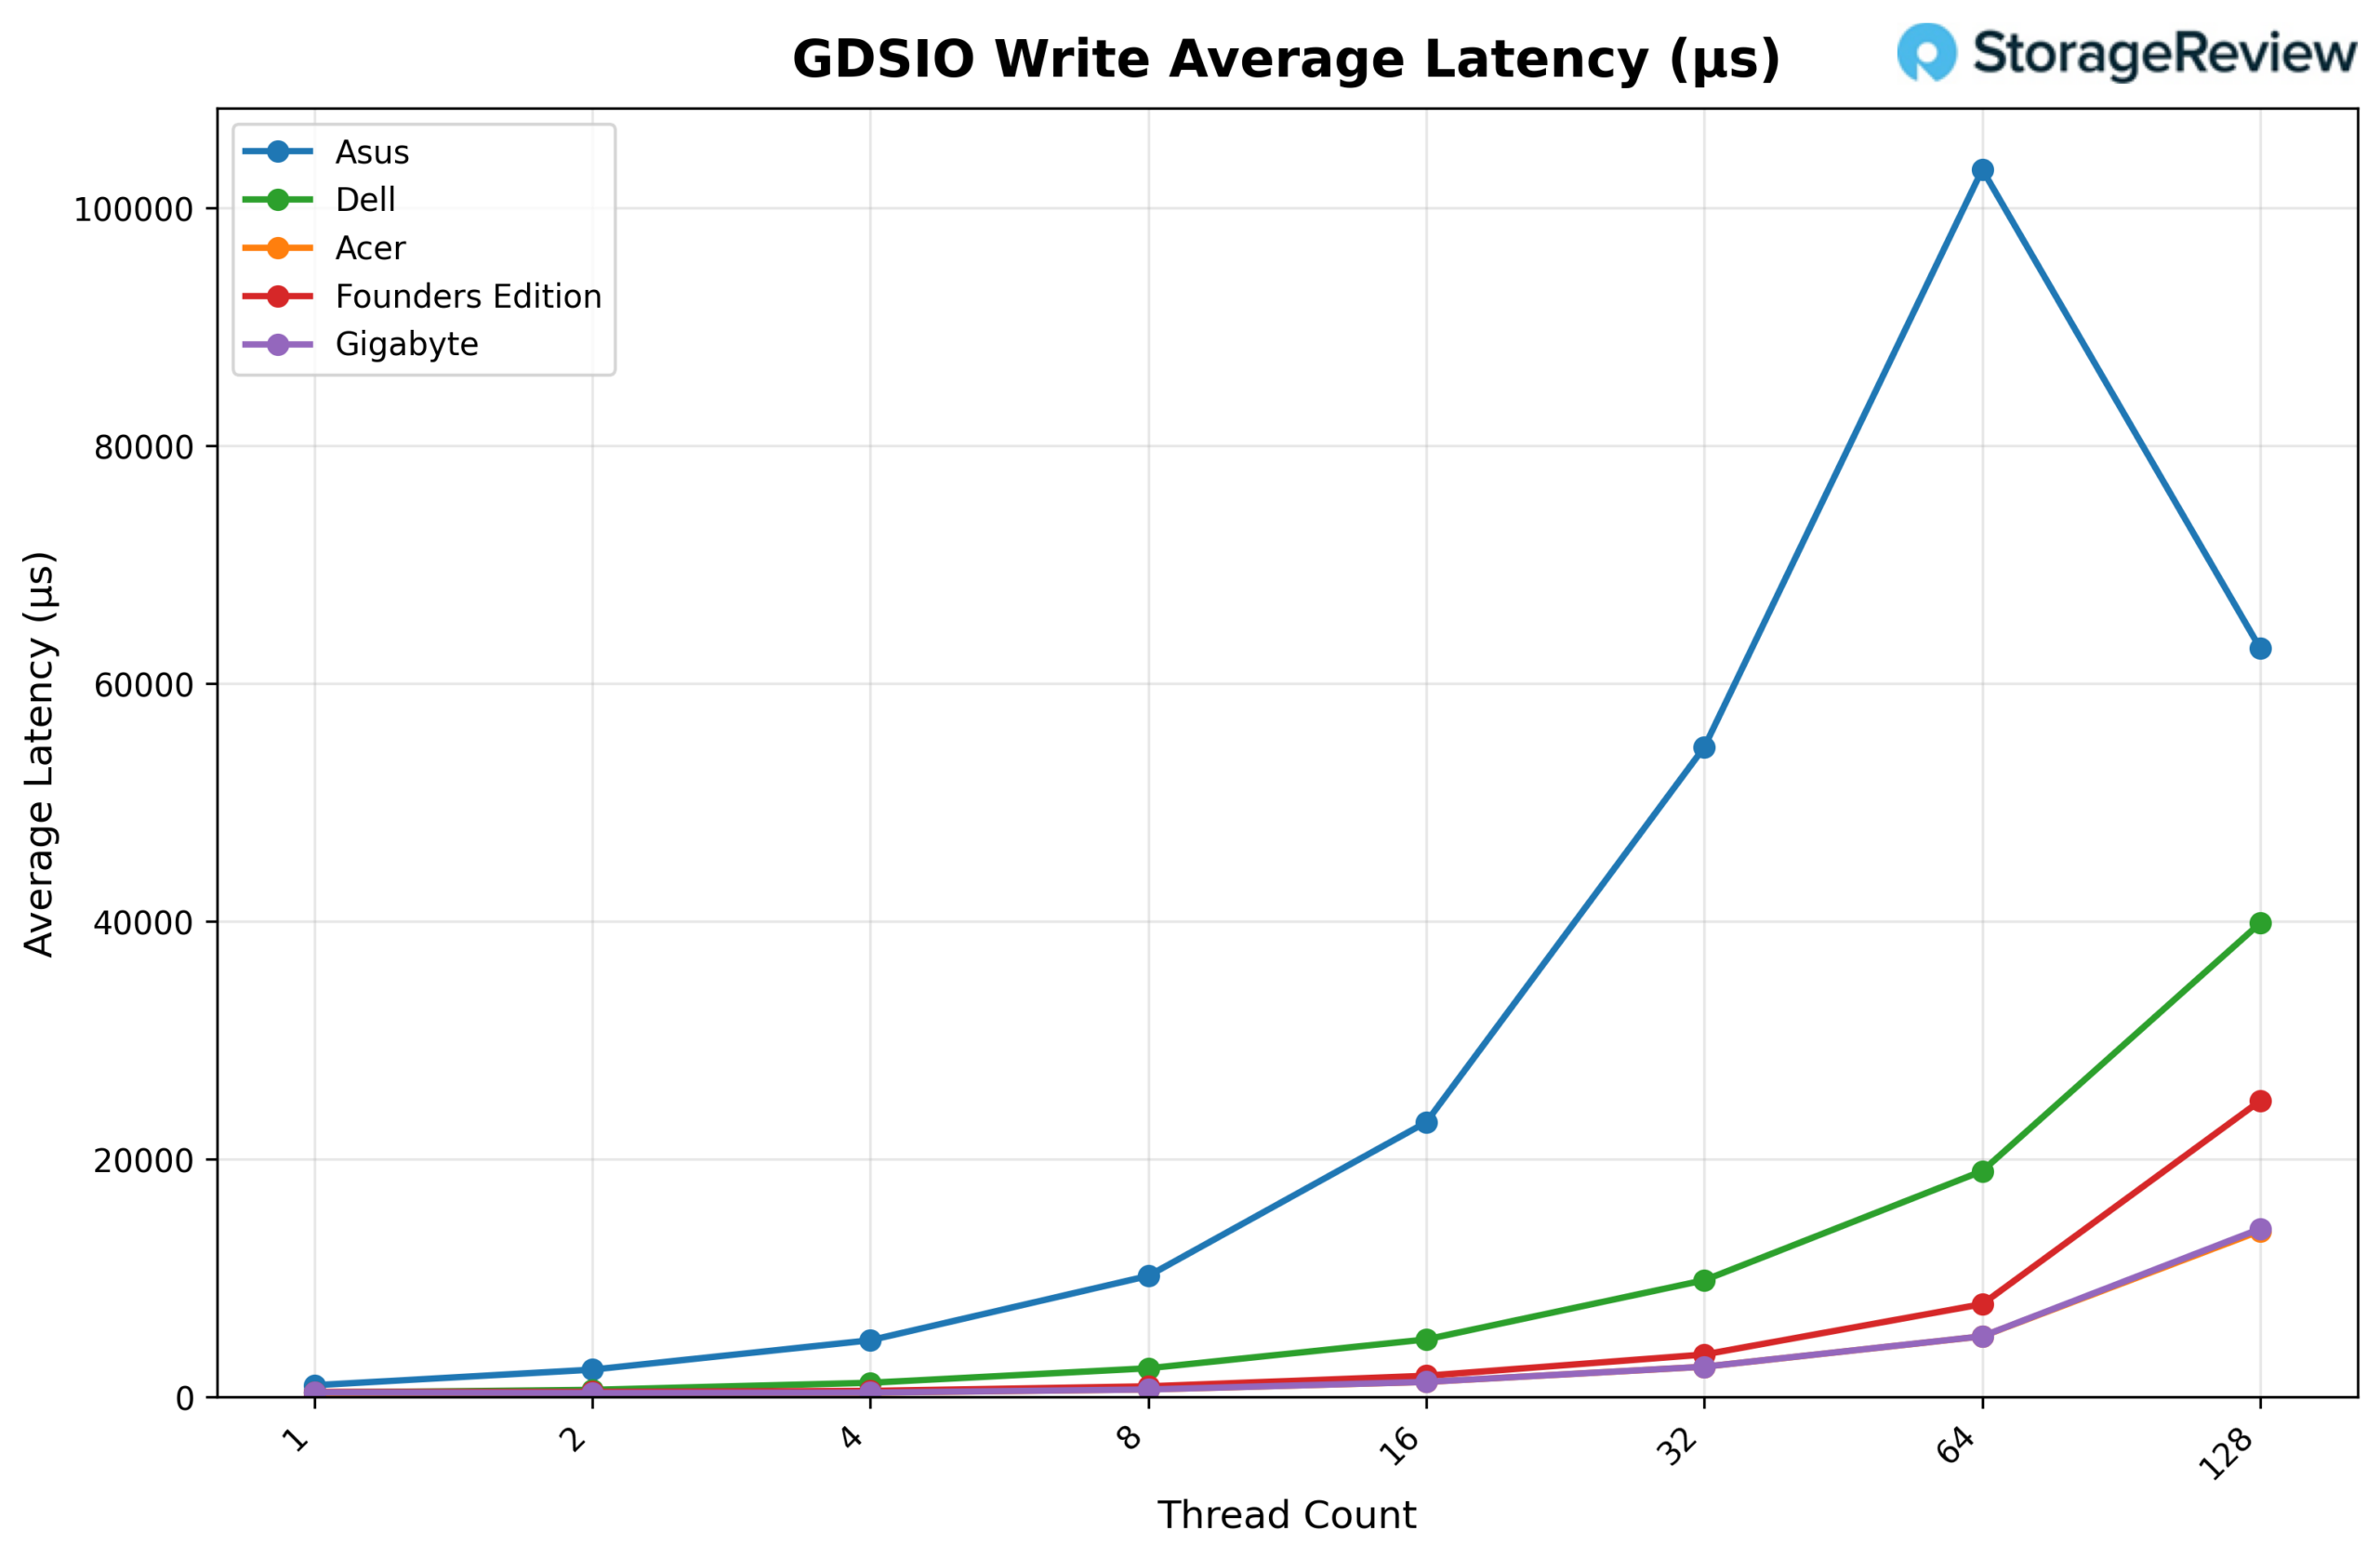
Analizzando la latenza media di scrittura GDSIO (1M), GIGABYTE parte da circa 0.39 ms con 1 thread e rimane relativamente stabile con 2 thread (0.35 ms) e 4 thread (0.38 ms). La latenza aumenta in modo più evidente con un numero maggiore di thread, raggiungendo 0.64 ms con 8 thread, 1.28 ms con 16 thread e 2.56 ms con 32 thread. La tendenza continua a crescere con 64 thread (5.11 ms) prima di impennarsi significativamente con 128 thread a 14.16 ms, in linea con il calo di throughput osservato al livello di concorrenza più elevato.
Conclusione
La GIGABYTE AI TOP ATOM è un'altra implementazione della piattaforma Spark basata su GB10 di NVIDIA, costruita sulla stessa scheda e sullo stesso silicio che abbiamo testato su tutta la gamma. Come previsto, le prestazioni di calcolo principali in vLLM rispecchiano fedelmente quelle del resto del mercato. Nei modelli GPT-OSS, Qwen3-Coder e Llama 3.1, il comportamento di scalabilità è rimasto prevedibile, con un throughput di pre-riempimento elevato e prestazioni di equalizzazione e decodifica stabili all'aumentare della concorrenza.
Dal punto di vista termico, GIGABYTE ha consentito un comportamento di burst leggermente più aggressivo. La CPU ha raggiunto picchi di 90 °C e la GPU di 81 °C durante le transizioni con pre-riempimento intensivo, con una potenza della GPU che ha raggiunto i 75.54 W. Una volta normalizzati i carichi di lavoro, le temperature si sono stabilizzate senza segni di throttling prolungato. In pratica, i picchi più elevati riflettono decisioni di allocazione di potenza di breve durata piuttosto che instabilità.
Il punto di forza di questa unità risiede nello storage. Utilizzando il Samsung PM9E1 Gen5 da 4 TB, GIGABYTE ha ottenuto alcuni dei migliori risultati GDSIO nel gruppo Spark. La velocità di lettura e scrittura si è adattata perfettamente sia ai carichi di lavoro da 16 che da 1 milione di dati, con una saturazione precoce ai livelli di concorrenza previsti e un aumento della latenza principalmente ai livelli di thread più elevati.
Poiché tutti i sistemi Spark condividono la stessa architettura GB10, le differenze di benchmark nell'inferenza AI rimangono minime. La scelta nel mondo reale si basa sul design dello chassis, sul comportamento termico durante i picchi di carico, sulla configurazione dello storage e sull'allineamento con il fornitore, piuttosto che su differenze fondamentali di calcolo.
Pagina del prodotto – GIGABYTE AI TOP ATOM
Classifica: Il GIGABYTE AI TOP ATOM fa parte dei dispositivi testati presenti nella nostra classifica dei migliori desktop per l'intelligenza artificiale locale.


 Amazon