

Non passa settimana senza che un fornitore IT ci parli dell’impatto che le sue soluzioni hanno sulle organizzazioni coinvolte nell’intelligenza artificiale, nel deep learning, nell’apprendimento automatico o nell’edge intelligence. Il problema, tuttavia, è che mancano informazioni concrete su come queste soluzioni influiscono sulle prestazioni di ciascuna di queste attività. Recentemente abbiamo deciso di vedere se potevamo fare qualcosa al riguardo collaborando con byteLAKE, un costruttore di soluzioni AI e HPC con sede in Polonia. L'obiettivo principale è valutare l'impatto dello storage e della GPU sui carichi di lavoro AI.
Impatto dello storage sull'intelligenza artificiale
Inizialmente, volevamo esplorare un'idea diffusa secondo cui lo storage locale influisce sulle prestazioni dei modelli di intelligenza artificiale. Abbiamo preso uno dei server Dell EMC PowerEdge R740xd presenti nel nostro laboratorio, configurandolo con due CPU Intel Xeon Gold 6130 e 256 GB di DRAM. Abbiamo eseguito il test di intelligenza artificiale byteLAKE utilizzando tre diverse alternative di storage locale. Per il test abbiamo utilizzato un SSD KIOXIA PX04S di vecchia generazione , insieme ai più veloci Samsung 983 ZET e Intel Optane 900P.
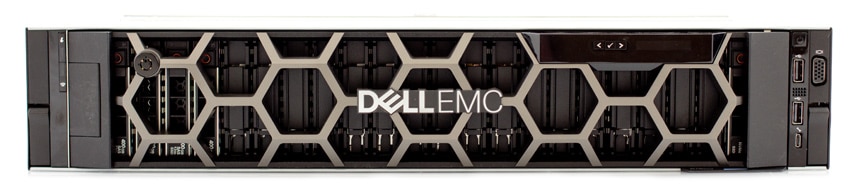
Durante il benchmark, abbiamo analizzato le prestazioni del processo di apprendimento dell'IA. Nei test, abbiamo eseguito il processo di apprendimento per uno scenario reale. In questo caso, i test facevano parte della procedura di addestramento di uno dei prodotti byteLAKE: EWA Guard . Si basa sull'ultimo modello YOLO (You Only Look Once), un modello di rilevamento in tempo reale all'avanguardia. Il modello è composto da un singolo strato di input, 22 strati convoluzionali, 5 strati di pooling, 2 strati di routing, un singolo strato di riorganizzazione e un singolo strato di rilevamento.
Come metrica di base della prestazione, abbiamo utilizzato il tempo di esecuzione dell'allenamento per 5000 epoche. I benchmark sono stati ripetuti tre volte per ciascuna configurazione di archiviazione e i valori medi sono presentati di seguito.
risultati:
- KIOXIA 98h 24m
- Samsung 98 ore 44
- Intel 98h 42
Come risulta chiaro dai dati, l'archiviazione locale non ha avuto alcun impatto sulle prestazioni. I test hanno spaziato da un SSD SATA all'ultimo e migliore Optane, senza alcun impatto. Detto questo, lo storage potrebbe svolgere un ruolo più importante quando si tratta di ingresso e uscita dei dati, ma dal punto di vista computazionale per l’intelligenza artificiale in questo caso non c’è stato alcun impatto.
Impatto di GPU e storage sull'intelligenza artificiale
Con i dati di archiviazione in mano, abbiamo aggiunto un singolo NVIDIA T4 a PowerEdge per valutare l'impatto di una GPU sull'intelligenza artificiale. Per questo test abbiamo eseguito anche le stesse tre configurazioni di archiviazione.
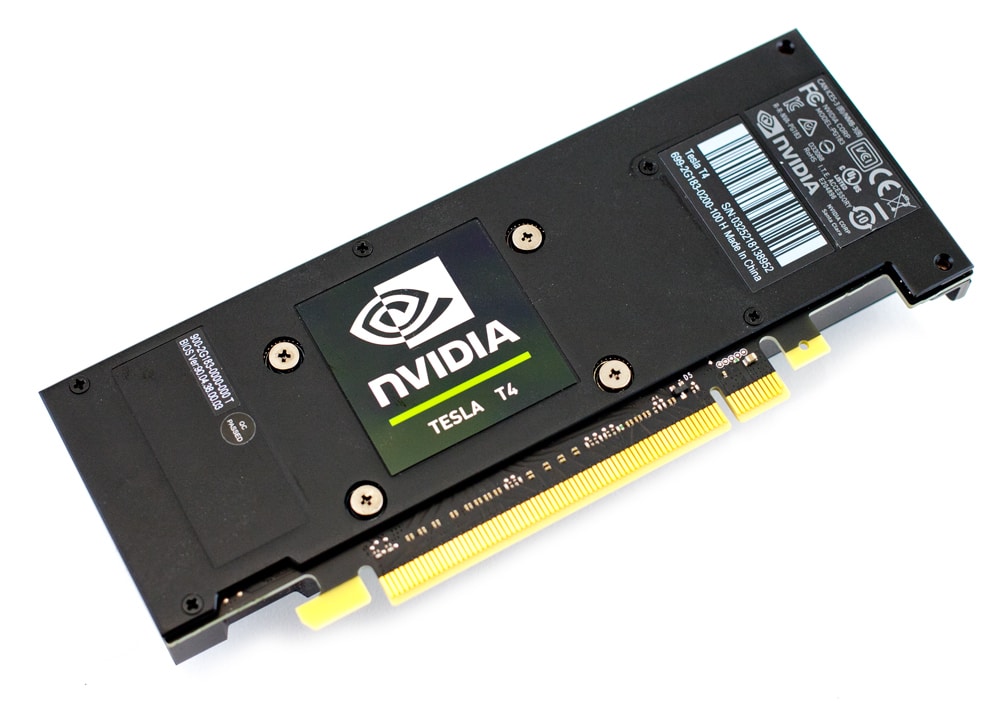
risultati:
- KIOXIA 4h 30
- Samsung 4 ore 28 minuti
- Intel 4 ore 27 minuti
Come previsto, la GPU ha avuto un impatto, anzi esponenziale, determinando un miglioramento di 22 volte. Dato che la GPU accelera le prestazioni complessive dell'intelligenza artificiale, si pensava che uno spazio di archiviazione più veloce potesse avere un impatto. Tuttavia non è stato così in quanto l'unità SATA era perfettamente in linea con l'NVMe ad alta velocità.
Conclusioni
In questo test, abbiamo riscontrato che l'uso di dispositivi di archiviazione più veloci non migliora le prestazioni di apprendimento. Il motivo principale qui è una struttura complessa del modello AI. Il tempo di apprendimento è più lungo del tempo di lettura dei dati. Detto in altro modo, il tempo di apprendimento utilizzando il batch di immagini corrente è più lungo del tempo necessario per leggere quello successivo. Di conseguenza, le operazioni di archiviazione sono nascoste dietro i calcoli dell’intelligenza artificiale.
Quando si è aggiunto NVIDIA T4, si pensava che un'elaborazione più rapida da parte dell'intelligenza artificiale avrebbe indotto lo storage ad avere un impatto sulle prestazioni. Questo non è stato il caso in questo test, poiché anche con il T4, il modello AI aveva ancora una componente di apprendimento più pesante e non richiedeva che l'archiviazione fosse particolarmente veloce.
Sebbene sia necessario lavorare ancora per testare ulteriormente l’impatto di componenti e sistemi specifici sull’intelligenza artificiale, riteniamo che questi dati iniziali siano utili e un buon punto di partenza per la conversazione. Abbiamo bisogno dei dati applicativi per poter comprendere meglio quali sono le leve giuste dal punto di vista IT e dove la spesa di bilancio può produrre i risultati di maggiore impatto. Ciò ovviamente dipende in gran parte anche da dove si svolge questa attività, nel data center o nell'edge. Per ora accogliamo con favore l'impegno di byteLAKE e altri all'avanguardia nell'intelligenza artificiale per contribuire a fornire dati utili per rispondere a queste domande urgenti.
Questo è il nostro primo test di IA, ma non l'ultimo. Mariusz Kolanko, co-fondatore di byteLAKE, ha indicato che stanno lavorando a un prodotto chiamato CFD Suite (IA per la fluidodinamica computazionale "CFD" per accelerare i solutori) in cui il processo di deep learning richiede una grande quantità di dati per ogni epoca di addestramento. Questo modello potrebbe infatti imporre un carico maggiore sullo storage per addestrare i modelli nell'ambito dei Big Data e potrebbe avere un impatto sulle prestazioni degli stessi processi di deep learning. In definitiva, come per qualsiasi applicazione, è fondamentale comprenderne le esigenze per assegnare le risorse del data center appropriate. L'IA non è chiaramente un'applicazione adatta a tutti.



 Amazon