

NVIDIAとCiscoは本日、AIファブリックにおけるレーンあたり400Gb/sイーサネット向けに設計された光モジュールフォーマットである超高密度小型フォームファクタプラグイン(USFP)の計画を発表しました。計画されている最初のトランシーバーは、OSFPモジュールと同程度のフットプリントに16の全二重レーンを搭載し、モジュールあたり6.4Tb/sの帯域幅を実現します。コネクタは32レーン、12.8Tb/sまで拡張できるように設計されています。NVIDIAとCiscoは、USFPはレーンあたり200Gb/sのプラグインモジュールと比較して、帯域幅と前面パネル密度が4倍、電力効率は約1.3倍になると述べています。
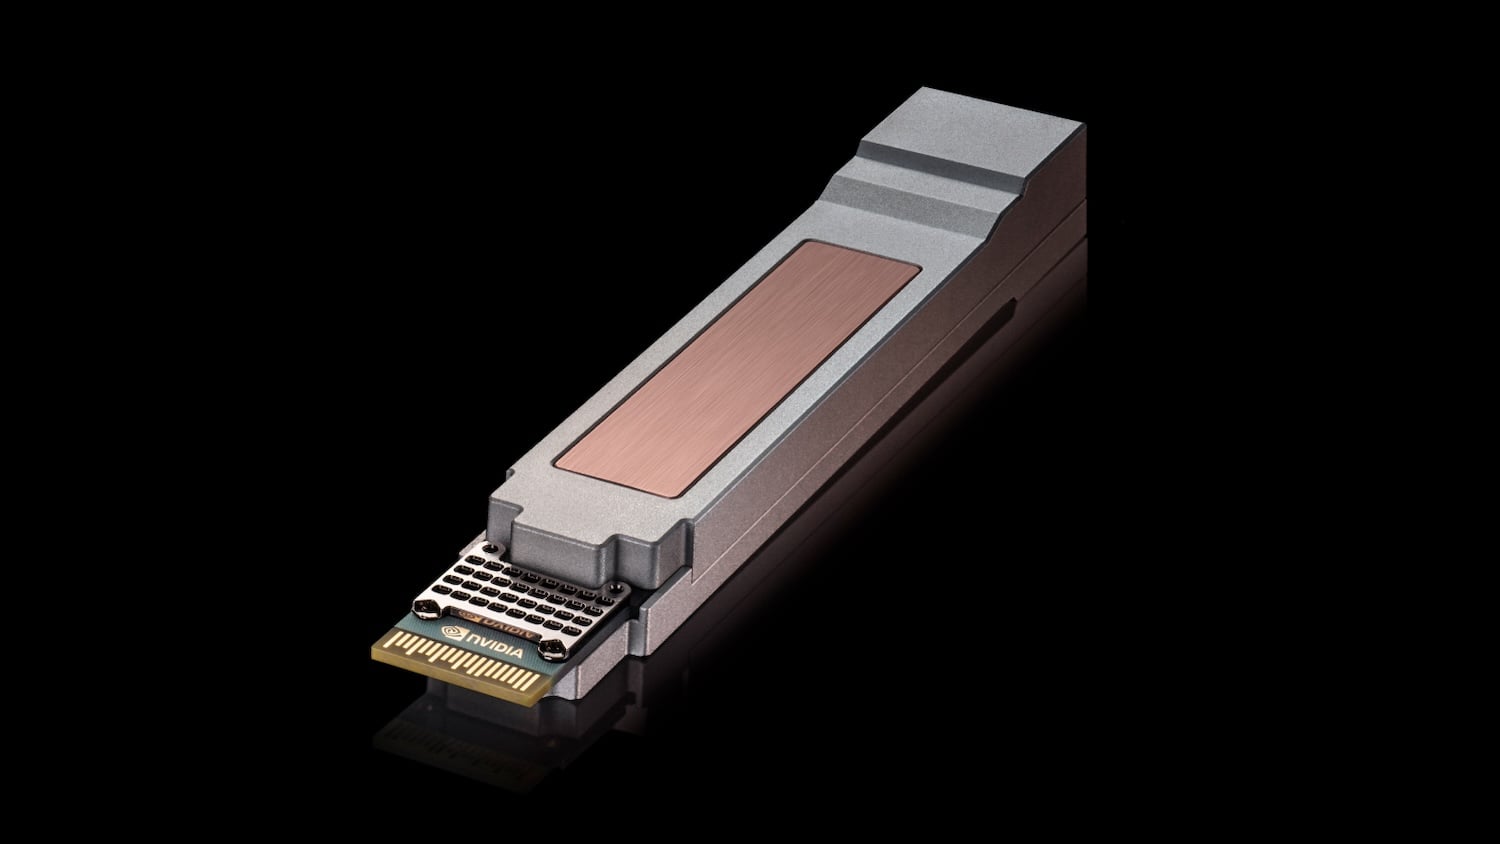
USFPは、サンプル提供予定日や発売時期が未定の計画であり、NVIDIAとCiscoは、コミュニティ主導の複数ソース契約を通じて、この設計をオープンな業界仕様にすることを目指しています。これは、OCPグローバルサミットにおけるNVIDIAの貢献の一部であり、Vera Rubinのラック設計、DSX AIファクトリーソフトウェア、施設およびグリッド仕様、800VDC電源、MetaおよびGoogleとのイーサネット関連の取り組みなども含まれています。
USFPはレーン数とフロントパネルの帯域幅密度を増加させる
USFPは、現在のモジュールのレーン数とレーンあたりのレートの両方を2倍にし、NVIDIAとCiscoによれば、ネットワーク層を追加することなく、スイッチがより多くの1.6Tb/sエンドポイントを接続できるようになる。このモジュールは、スイッチとSuperNICの両方に対応することを想定している。両社は、フロントパネルの密度をAIファブリックの成長における制限要因と捉えている。スイッチのポートが不足すると、次のステップはより多くの光モジュールを備えた別のスイッチ層となり、レイテンシ、電力、コストが増加する。USFPはプラグインモデルを維持しているため、モジュールは現場で交換および保守が可能である。
「世界最大のAI工場を構築するには、まず最小の接続部分を見直すことから始める必要がある」と、NVIDIAの上級副社長であるギラッド・シャイナー氏は述べた。シスコの光システムおよび光学部門の上級副社長兼ゼネラルマネージャーであるビル・ガートナー氏は、プラグイン可能な光モジュールをレーンあたり400Gb/sまで拡張するには、既存のモジュール設計を段階的に拡張するだけでは不十分だと述べた。
400Gb/s信号伝送をサポートする新しいコネクタ
このコネクタは、2段階の挿入シーケンスを備えた2次元コンタクトアレイで、モジュールが所定の位置に装着された後にのみ高速コンタクトが係合します。NVIDIAとCiscoは、これによりコンタクトの摩耗が低減され、信号の完全性が向上し、挿入力がより予測しやすくなると述べています。このコネクタは1レーンあたり400Gb/sに対応するように設計されており、両社によれば、1レーンあたり200Gb/sでも性能が向上するとのことです。
USFPモジュールは、トランシーバー内部に専用の冷却回路がなくても最大100Wの電力を放散できるため、スイッチの設計が簡素化され、信頼性が向上すると両社は述べています。すべてのUSFP構成は、信号処理を簡素化して遅延と消費電力を削減する光設計をサポートしており、このフォーマットはさまざまな光技術と伝送距離クラスに対応しています。NVIDIAとCiscoは、TE ConnectivityおよびAmphenolと協力してケージ、コネクタ、モジュールを開発しており、NVIDIA Spectrum-XとCisco Silicon Oneベースのイーサネットネットワーク間の既存の相互運用性に関する取り組みを基盤として、今後さらに多くのパートナーが加わる予定です。
MGX 1.2はVera Rubinラックインフラストラクチャを拡張します
NVIDIAは、オープンなMGXアーキテクチャを通じてVera Rubinラックおよびコンピューティングトレイの設計をOCPに提供しました。これは、OCPのOpen DC Initiativeにおける第3世代MGXリファレンス設計の一部として、MQDおよびMQDBオープン液冷設計とともに提供されています。MGX 1.2仕様では、ラック規模のブラインドメイト液冷、相互運用可能なラック規模の相互接続インフラストラクチャ、液冷式5,000Aバスバーが追加され、19インチ機器および最大250kWのラック展開をネイティブにサポートしています。
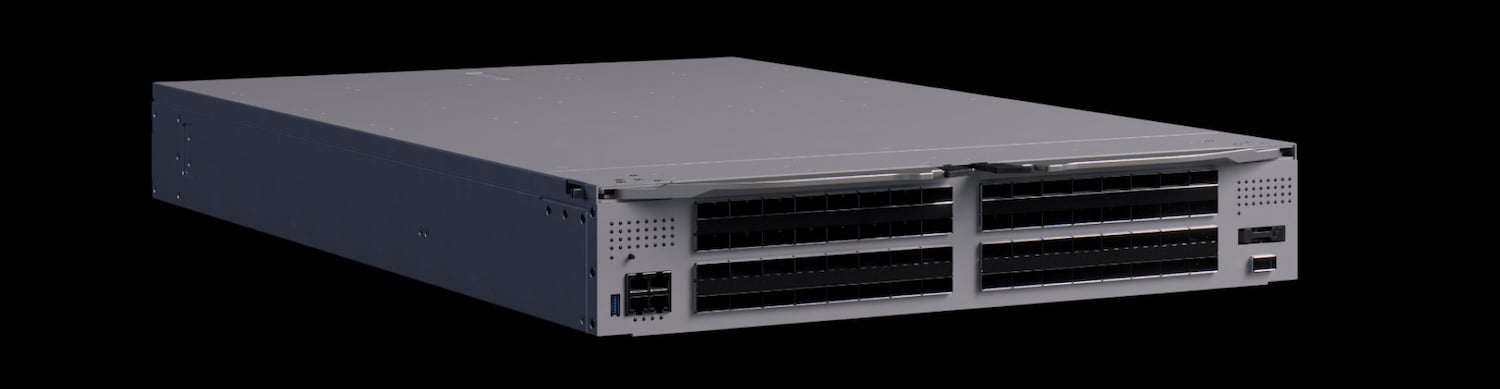
構成可能なI/Oベイ、ファンレス液冷式コンピューティングトレイ、標準化された電源および冷却インターフェースが仕様を構成し、NVIDIAは共通インターフェースによりパートナーの組み立て、テスト、およびサービス時間を短縮できると述べています。別途Vera CPUラック設計仕様により、MGXはアクセラレーテッドコンピューティングの枠を超えて拡張されます。NVIDIAは、Vera Rubin NVL72を大規模なトレーニングおよび推論のためのプラットフォームとして位置付け、Vera CPUラックをエージェントワークロードによって追加されるツール呼び出し、オーケストレーション、およびサンドボックス実行のためのプラットフォームとして位置付けています。
DSX OSにネットワーク、ラック、クラスタ管理コンポーネントが追加されました
NVIDIAは、 DSX AIファクトリープラットフォームのオープンオペレーティングレイヤーであるDSX OSを、4つのオープンソースコンポーネントで拡張しました。NVIDIA Config Managerは、AIファブリック全体にわたるスイッチ構成、検証、およびメンテナンスを自動化します。NVIDIA Cluster Readiness Engineは、トレーニング開始前にワークロードシミュレーションを使用してGPUクラスタのストレステストを実行します。NVIDIAによると、これにより、そうでなければジョブの失敗につながるハードウェアの問題を検出できるとのことです。

NVIDIA Rack Management Serviceは、ラックを運用単位として扱い、ハードウェアの抽象化とファームウェア管理をそのレベルで行います。NVIDIA Infrastructure Controller用のCluster API Providerは、ベアメタル環境の展開とテナントのオンボーディングを処理し、NVIDIAは、生のハードウェアを数時間で本番環境対応のクラスターに変換できると主張しています。これらのコンポーネントは、NVIDIAがDGX Cloudを運用してきた経験に基づいており、クラウドプロバイダーやソフトウェアパートナーがAIファクトリーの運用をマルチテナントプラットフォームに統合できるようにすることを目的としています。
オープン仕様書は、施設設計と電力網復旧を対象としています。
NVIDIA、AMD、Google、Metaは、機器メーカー、コロケーションプロバイダー、オペレーターが設計に活用できる、電力アーキテクチャ、冷却、物理レイアウトを網羅した共有施設設計図であるOpen Data Center Specification v0.7を公開した。また、Google、Meta、Microsoft、NVIDIAは、大規模AI施設が電力供給の障害にどのように対応すべきかを定義するOCP Grid Resilience Specificationも公開した。この仕様では、接続を維持し、自動的に対応し、2秒以内にほぼフル稼働状態に戻ることが求められる。NVIDIAは、これらの仕様はいずれも同社のDSXリファレンスデザインに準拠していると述べている。
Visionbayは、NVIDIAの800VDCリファレンスアーキテクチャとVertivの電源・熱管理機器を組み合わせたAIファクトリープラットフォーム「K-1」の計画を発表した。これは、将来のVera Rubin導入に向けたものだ。K-1は、AC-DC変換をクラスタレベルの電源センターに移し、800VDCをコンピューティングユニットにより近い場所に供給する。800VDCの段階的な導入、液冷、モジュール式拡張が特徴だが、Visionbayは導入時期を明らかにしていない。
Meta社がSpectrum-6とマルチプレーンネットワークを採用
Metaは、Vera Rubin AIファクトリー向けにNVIDIA Spectrum-6 102.4Tb/sイーサネットを採用する予定です。NVIDIAによると、Spectrum-6はSpectrum-4の2倍のスイッチング容量とレーンあたりの帯域幅を実現し、レーンあたり200Gで動作し、ジョブ間のパフォーマンス分離も実現しています。MetaのSpectrum-6ベースのN-IceCubeスイッチは、同社のIcePack 100T液冷ラックに搭載され、MetaのオープンスイッチソフトウェアであるFBOSSを実行します。FBOSSは、OCPスイッチ抽象化インターフェースを使用して、ベンダーに依存しないハードウェア制御を実現します。
Spectrum-X Multiplaneは、Spectrum-6スイッチとConnectX-9 SuperNICを組み合わせ、ハードウェア上で最大8つの独立したネットワークプレーンにGPUトラフィックを分散させます。NVIDIAによると、この設計は10万個以上のGPUに対応でき、スイッチの階層数も少なくて済み、コンポーネントに障害が発生した場合でもトラフィックは残りのプレーンに切り替わるため、帯域幅は低下するもののジョブは継続されるとのことです。MetaとNVIDIAは、オンプレミス環境とクラウド環境の両方で耐障害性の向上を検証済みであると述べていますが、具体的な数値は公表していません。
GoogleのFalcon Transportは将来のNVIDIAネットワークハードウェアをターゲットにしている
NVIDIAとGoogleは、将来のNVIDIA ConnectX-10 SuperNICおよびBlueField DPU向けにFalcon Transportのサポートを発表しました。Falconは、マルチパス負荷分散、プログラマブル輻輳制御、ハードウェアベースの損失回復、および接続ごとのセキュリティを通じて、イーサネット上で信頼性の高いデータ伝送を実現します。NVIDIAはこれをハードウェアアクセラレーションとDOCAソフトウェアで実装するため、NVIDIAとGoogleのNICは共通のトランスポートプロトコルを使用しながら、アプリケーションは標準のRDMAインターフェースを維持できます。両社は、これによりイーサネットファブリックの拡張に伴うAIおよびストレージトラフィックの帯域幅利用率とパフォーマンス予測性が向上すると述べています。
CiscoがSilicon One G300システムを出荷開始、51.2Tのトップオブラック部品を追加
Cisco は、同じ OCP 発表を利用して自社のシリコン製品ラインナップを更新しました。102.4Tb/s Silicon One G300 は現在サンプル出荷中で、最初の G300 ベースのシステムが顧客に出荷されています。また Cisco は、1.6T 光モジュールとチップ直結液冷を備えたトップオブラックシステム向けに構築された 200G SerDes 搭載の 51.2Tb/s スイッチ ASIC である G302 を追加し、2026 年末までに出荷予定です。Cisco はまた、51.2Tb/s P200 ディープバッファルーティングシリコンがハイパースケーラーで生産されていると述べています。Microsoft は P200 システムを生産に移行し、Alibaba Cloud は自社の Quantum Cat ルーターを eCORE バックボーン全体に P200 上で展開し、SONiC を実行しています。
Cisco の残りのリストは運用中です。Cisco 8001 は Silicon One A100 の 10G および 1G バージョン上の管理スイッチで、SONiC を帯域外ネットワークにもたらすため、オペレーターはファブリックからラックまで 1 組の API と自動化を実行できます。Cisco が検証した SONiC は Nexus One アーキテクチャに同梱されており、公開された脆弱性を恒久的な修正に先立って実行時にパッチする Live Protect オプションは 2027 年半ばに予定されています。Cisco は ESUN のメンバーであり、スケールアップ ネットワークの 1.0 仕様に取り組んでいると述べています。


 Amazon