

これまでGB300 DGX Stationをいくつか検証してきましたが、最近、ASUS ExpertCenter Pro ET900N G3とHP ZGX Fury AI Stationの2台を同時にラボに持ち込むことができました。2台のタワーを隣り合わせに設置し、接続して、2台目のGB300が1台のマシンのパフォーマンスにどのような付加価値をもたらし、より連携のとれたデスクトップAIワークロードを実現できるのかを検証しました。
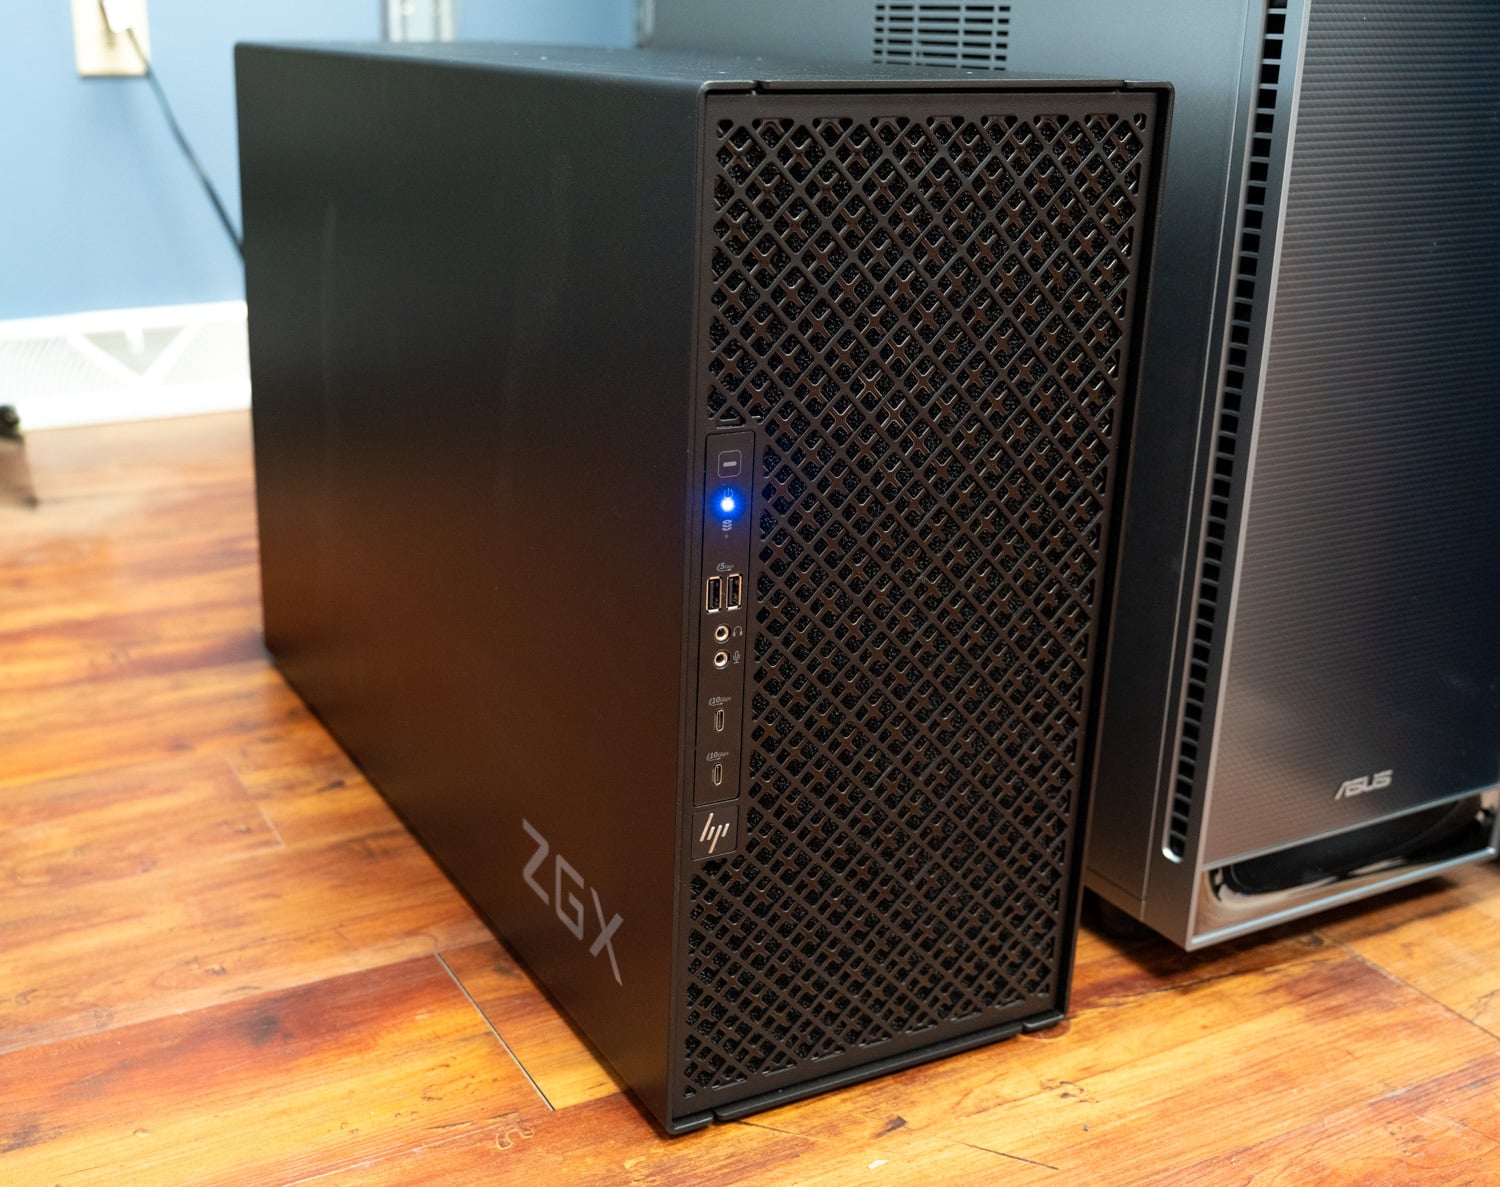
デスクトップ環境を1台ずつ拡張していくというアイデアは新しいものではありません。NVIDIAはGB10プラットフォームでこの点を明確に打ち出しました。DGX Sparkの特長の1つは、1台のシステムから始めて、ワークロードの増加に合わせて接続数を増やしていける点です。GB300は初期性能がかなり高いものの、より大規模なモデルを実行したり、より多くのユーザーに対応したりすると、これまでテストした中で最も高速なデスクトップマシンでも負荷がかかる可能性があります。これが、以前のMSIレビューで指摘した点です。ワークロードがこれらのステーション1台分の導入を正当化するレベルであれば、最終的には複数台導入する理由も容易に想像できます。
多くの購入者にとって、コストが拡張の実現可能性を左右するでしょう。2つのステーションがどれだけうまく連携するかを今理解しておくことで、1つのステーションから始めるユーザーは、後々拡張することで得られるメリットをより明確に把握できます。
主要なポイント(要点)
- ケーブル2本、回線速度の98%: ASUS ET900N G3とHP ZGX FuryのConnectX-8ポート間に2つの400G DACを接続したところ、NCCLはブロードキャスト、リデュース、送受信で98GB/sの速度を達成し、これは2つのDACが対応できる最大100GB/sの速度に匹敵するものでした。GPUDirect RDMAは各レールで392Gb/sに達し、8バイトのRDMA書き込みは平均1.46µsでした。このセットアップはNVIDIAのマニュアルに従って行われました。
- GLM-5.2は、同等の同時実行数において11倍の性能向上を実現しました。 433GBのNVFP4チェックポイントは、1つのステーション上のGraceメモリに約215GBの専門家の重みを流出させ、32ストリームで毎秒139個の出力トークンを処理。テンソル並列で2つのB300に分割すると、32ストリームで1,525個、256ストリームで3,141個に達した。
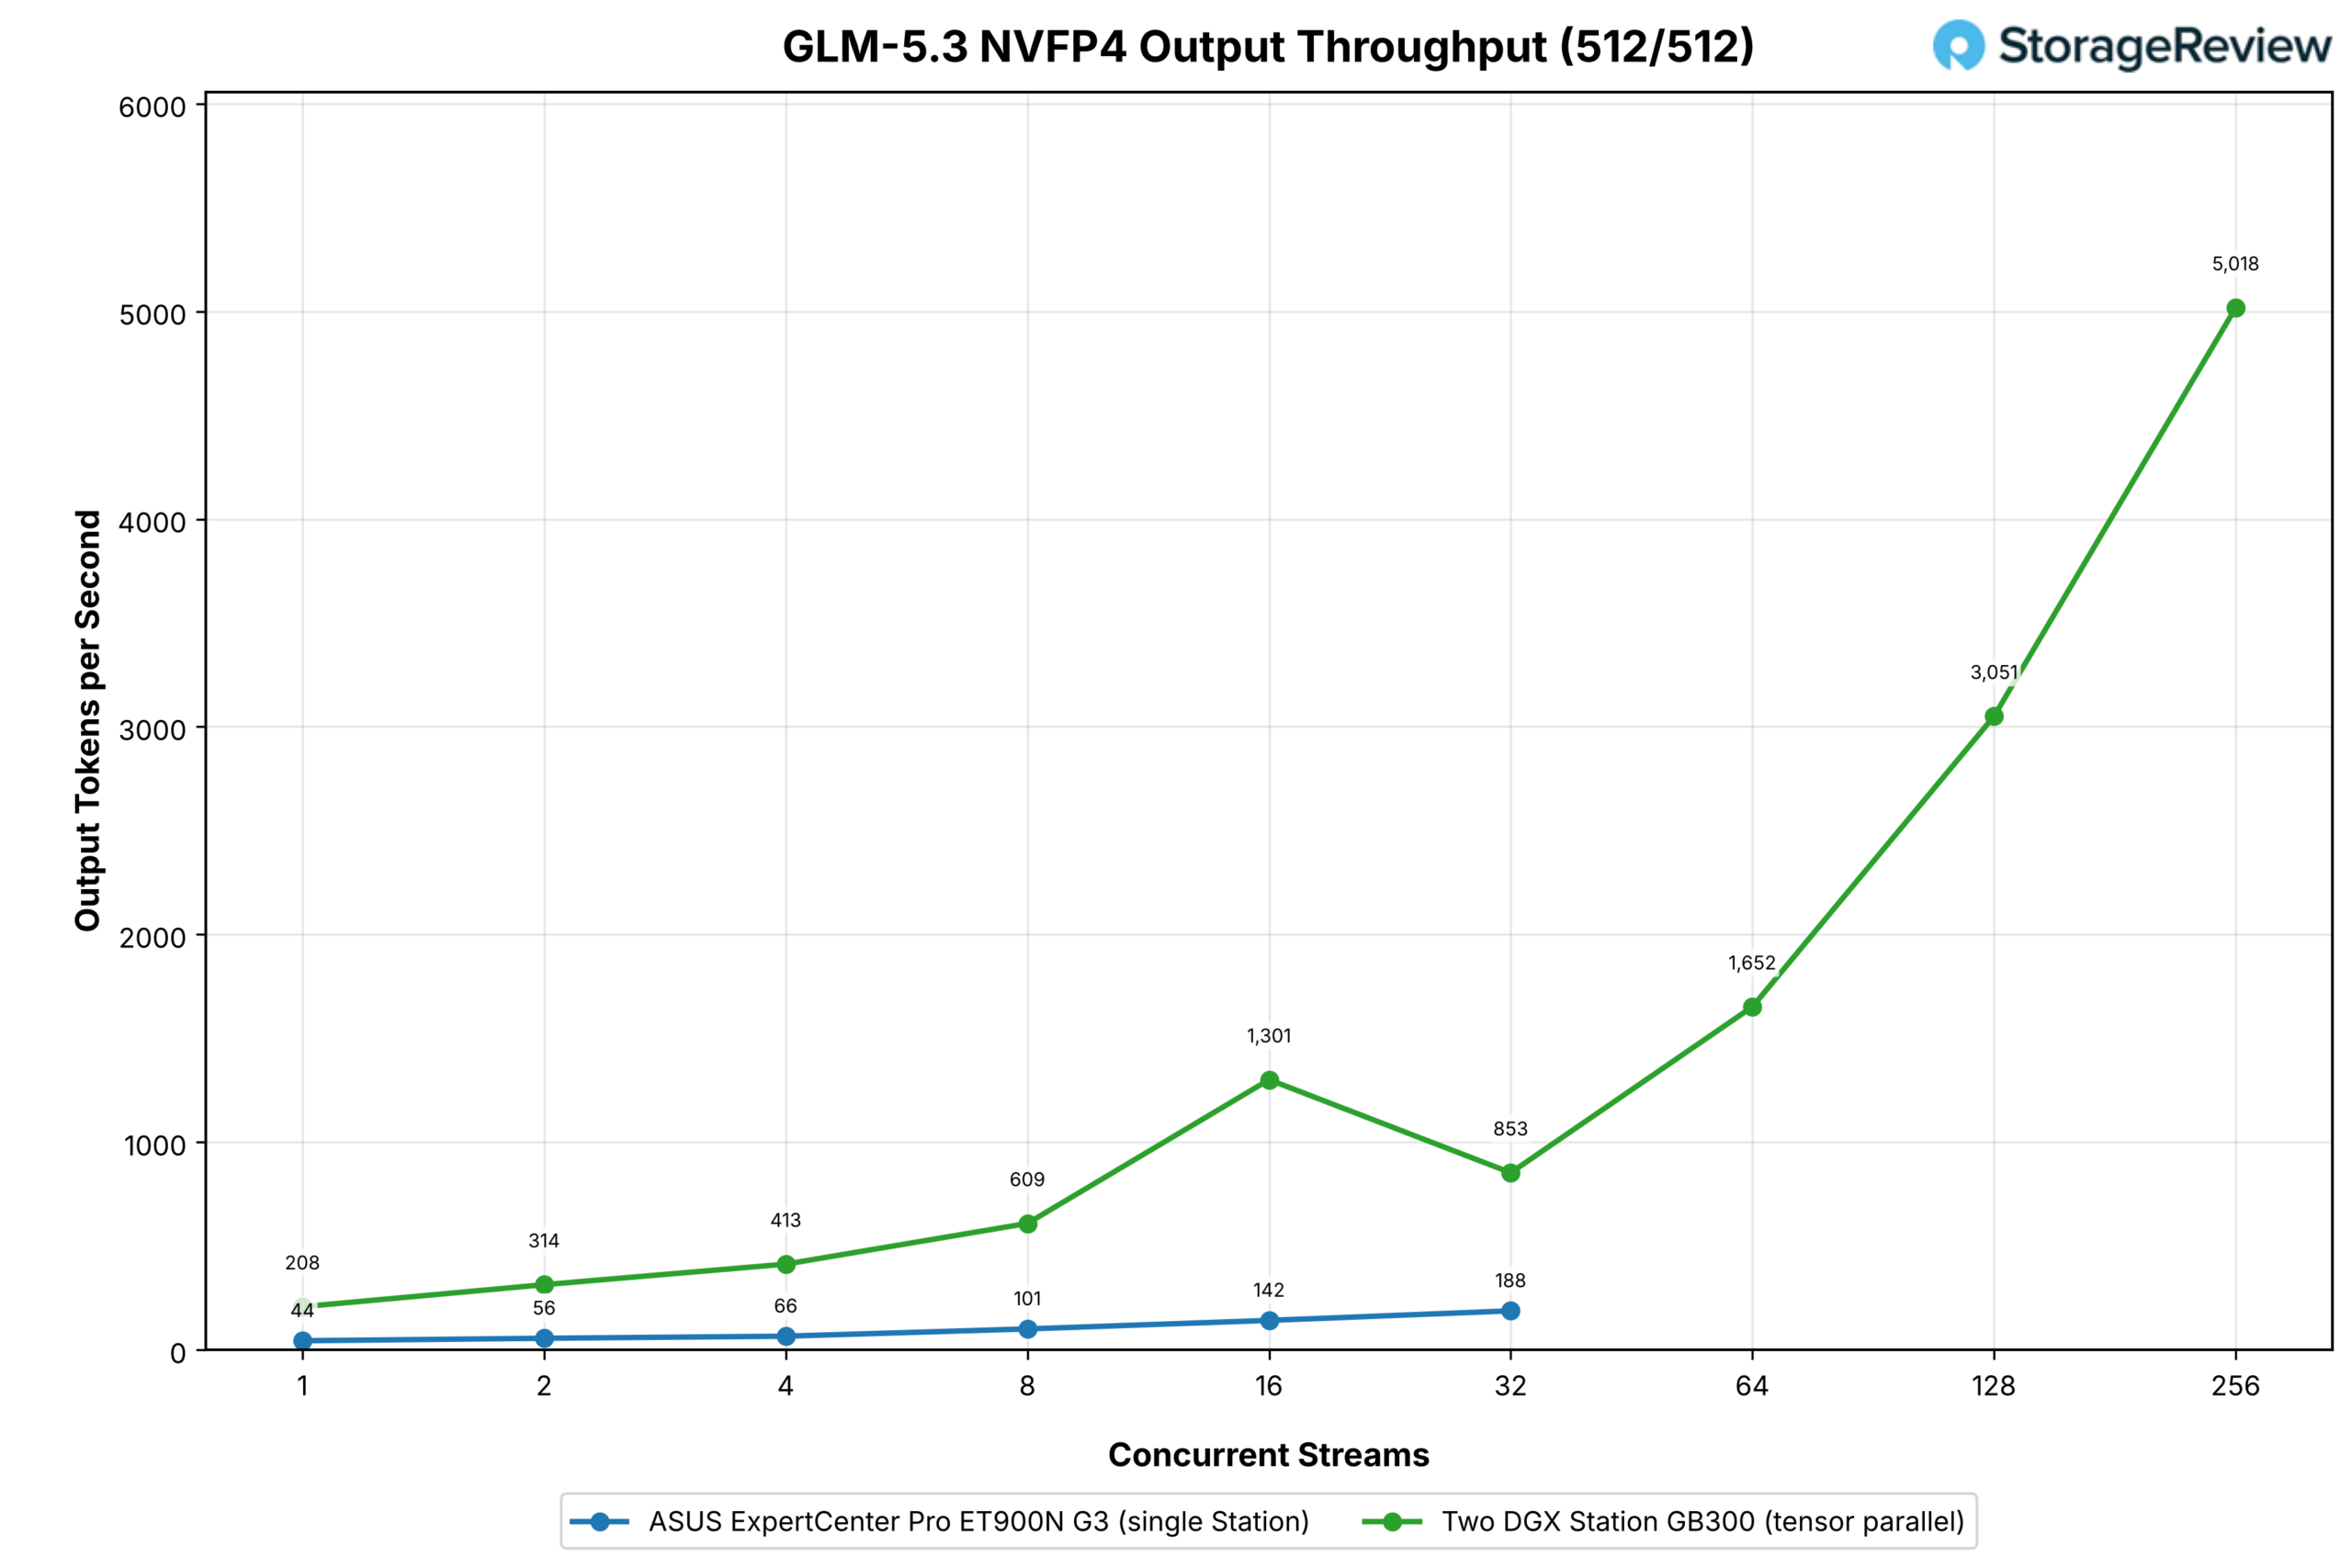
- GLM-5.3では、トークン処理速度が毎秒188トークンから5,018トークンに向上しました。 このセットの中で最大のゲイン(27倍)は、252GBのHBM3eをオーバーフローさせたもう一方のモデルによるもので、このペアは同等のワークロードで256ストリームまで上昇し続け、8,192トークンのプロンプトで毎秒約600の出力トークンを保持しており、これは単一タワーの約5倍に相当します。
- MiniMax-M3の長いプロンプトは、1つのステーションで8つのストリームで停止します。 単一のタワーは、KVキャッシュが枯渇したため、8ストリームで毎秒103トークンの出力に低下した。一方、2つのタワーは同じ時点で736トークン(7.1倍)を供給し、256ストリームで1,801トークンまで供給を続けた。
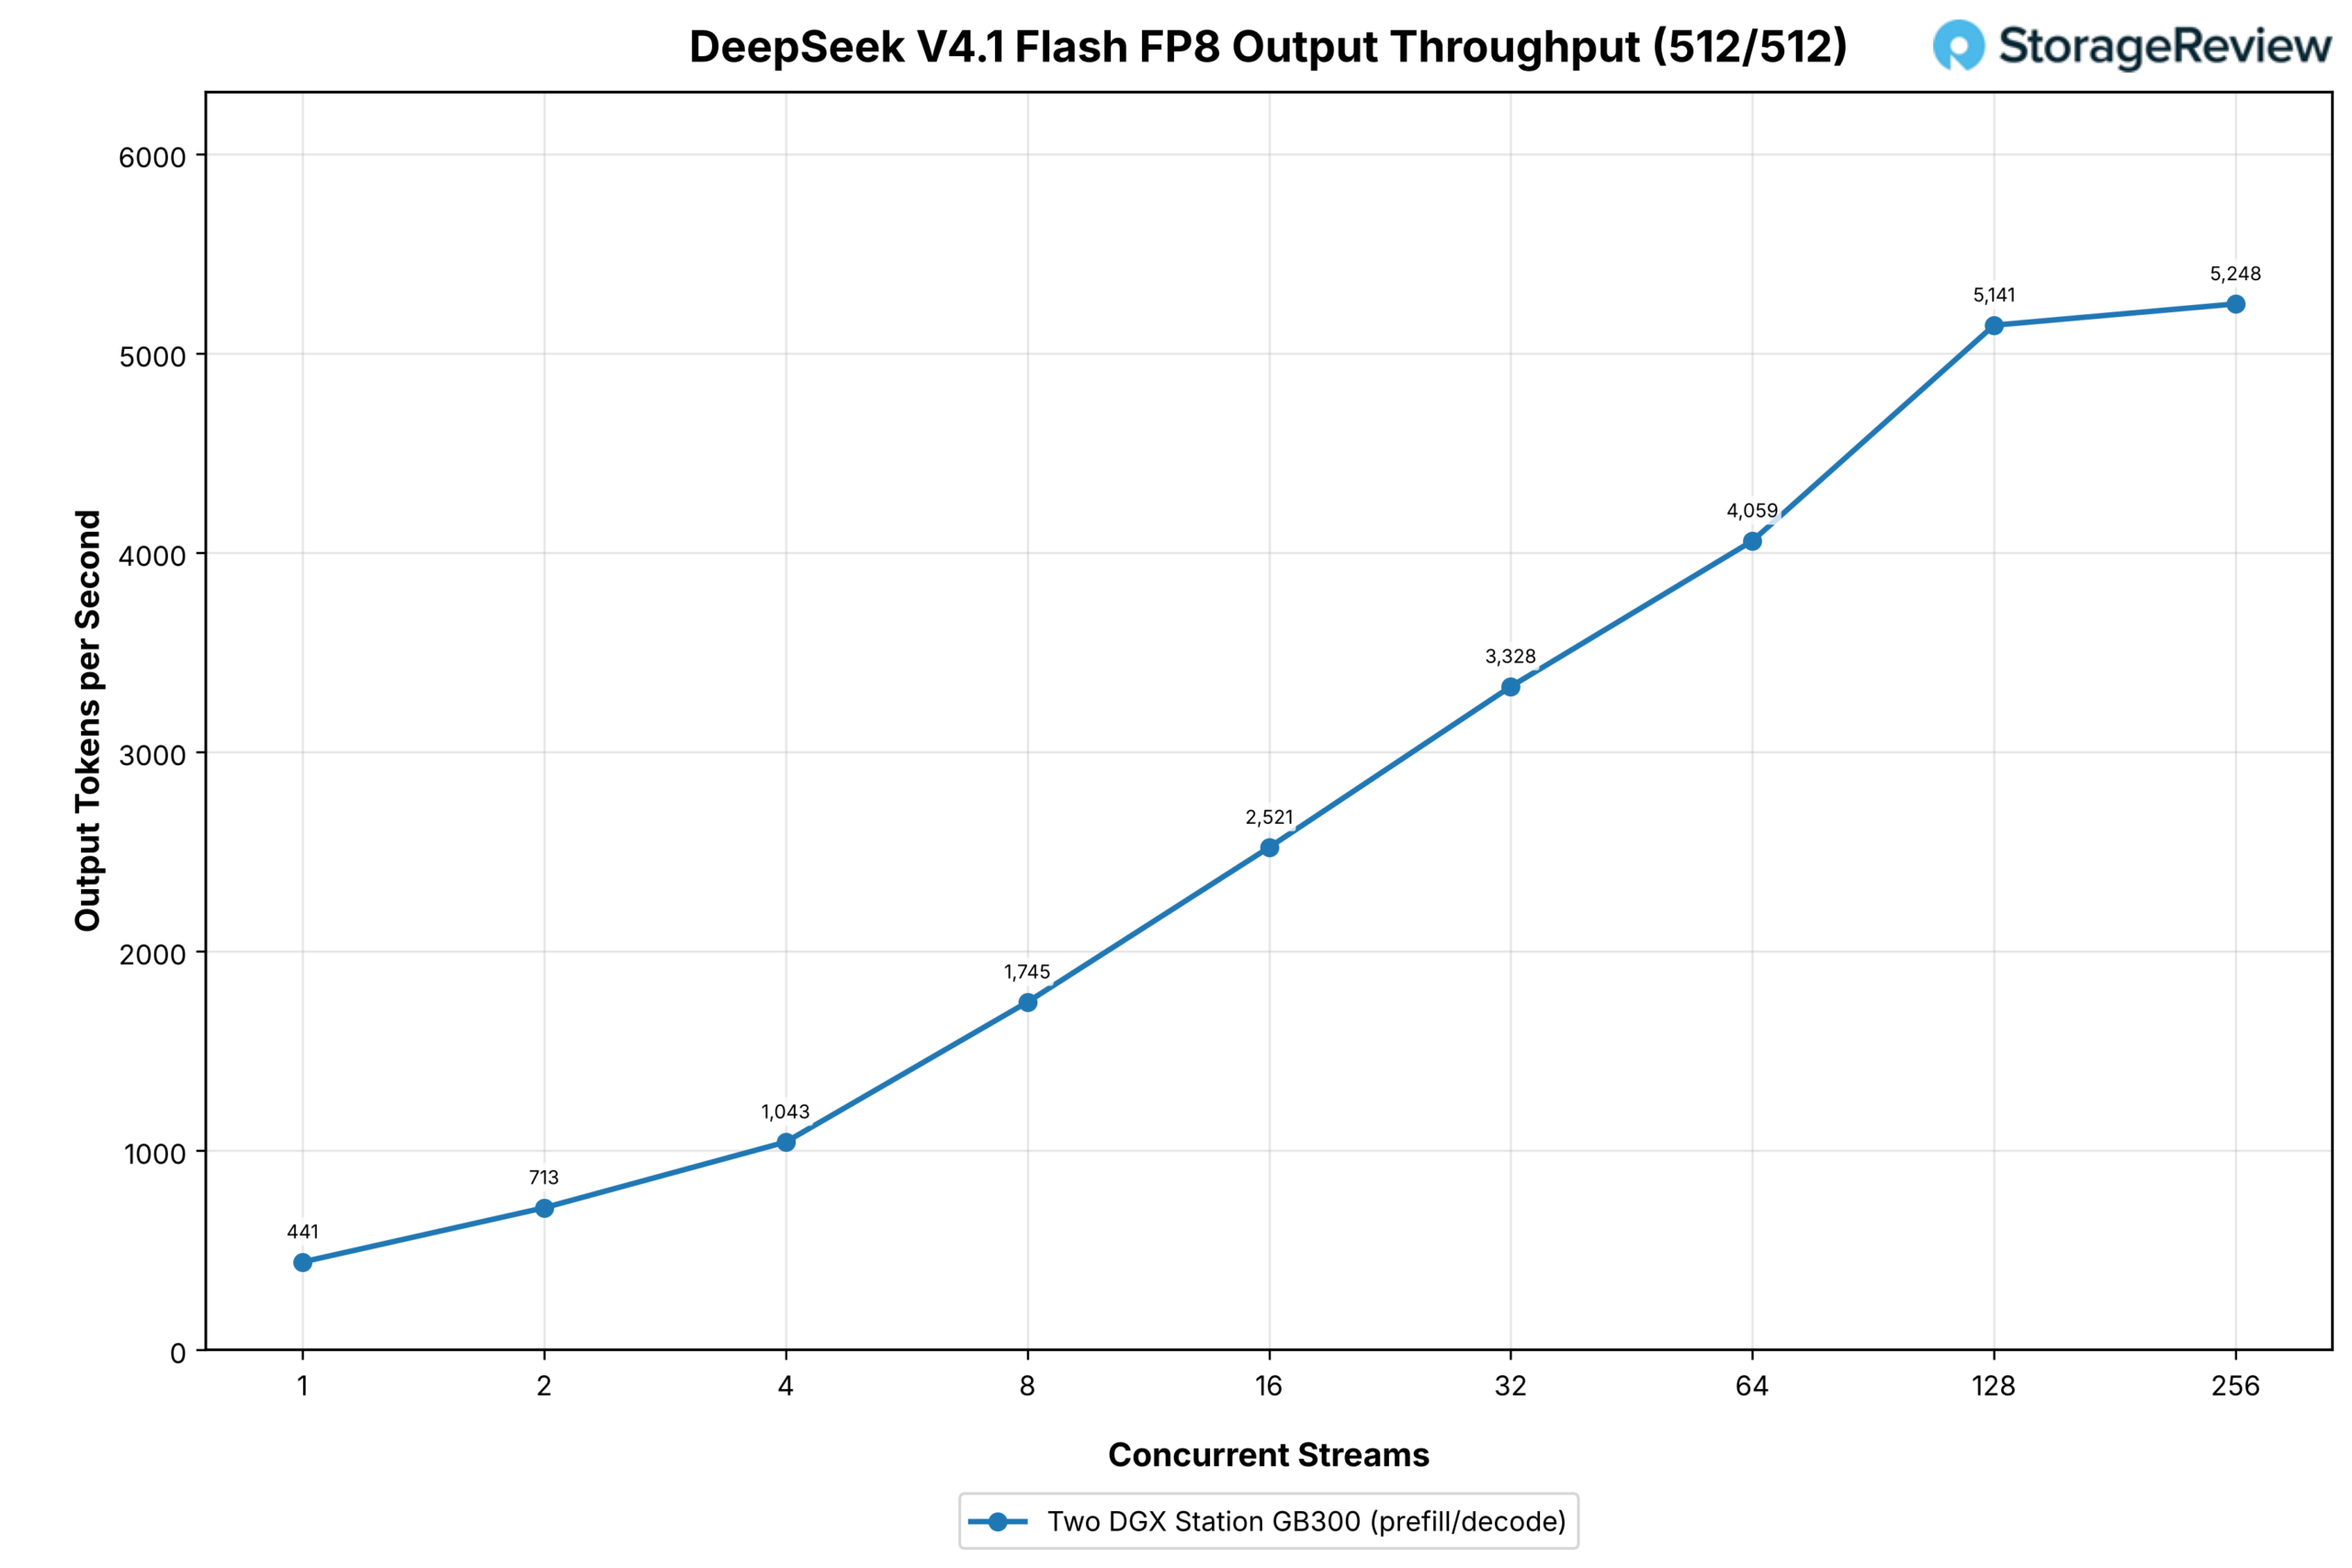
- 適合するモデルは、2つ目のコピーと事前入力/デコード分割を受け取ります。 一方のステーションをプリフィル、もう一方をデコードに設定した場合、GLM-5.3 Flashは32ストリームでショートプロンプトのスループットを3倍(828から2,721)に、ロングプロンプトのスループットを2倍(1,219から2,448)に向上させ、DeepSeek V4.1 Flashはテストしたどのモデルよりも高い出力スループット(256ストリームで毎秒5,248トークン)を記録しました。
DGXステーションでのネットワーク構築
クラスターについて詳しく説明する前に、MSIのレビューで取り上げたネットワーク機能についておさらいしておきましょう。ConnectX-8 SuperNICは、ネットワーク接続を提供するだけでなく、それ以上の機能を提供します。内蔵のPCIeスイッチは、Graceや2つのPCIe Gen 6 x4ストレージスロットへの接続など、Stationの内部I/Oの一部も処理します。
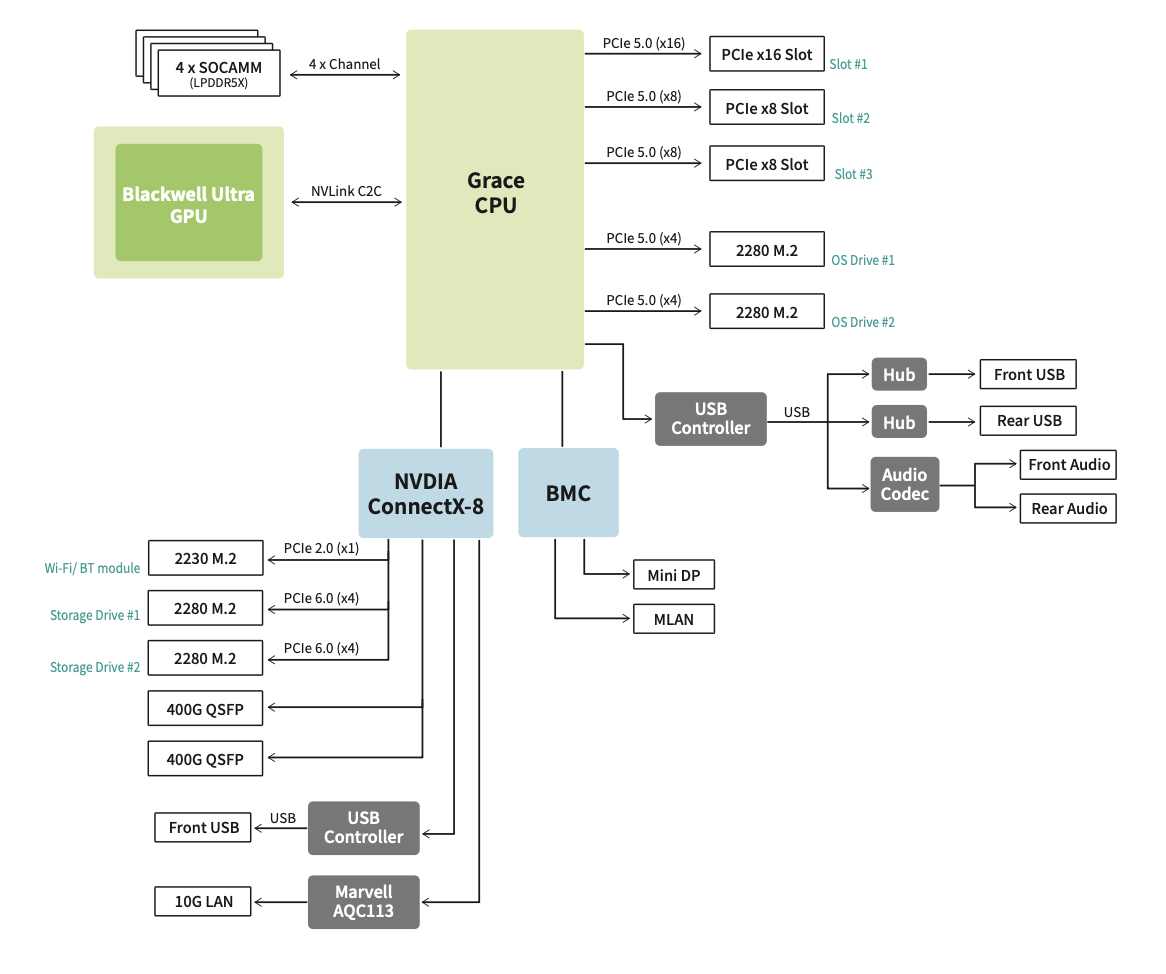
実際のネットワーク接続のために、システムはそれぞれ400Gb/sの定格を持つ2つのQSFP112ポートを提供し、合計800Gb/sの帯域幅を提供することで、ステーション同士を接続したり、より大規模なネットワークに接続したりすることが可能になります。
以前のDGX Sparkレビューで取り上げたDGX Sparkの実装と比較すると、Sparkの400Gb/sクラスのConnectX-7は、GB10のPCIe接続で十分に活用できる以上の性能を備えていました。コントローラは2つの独立したPCIe 5.0 x4リンクの背後に配置されていたため、有効なネットワークスループットは合計で約200Gb/sに制限されていました。また、2つの物理ポートはLinux上で4つの論理イーサネットインターフェイスとして認識されていました。フル帯域幅を実現するには、これらのインターフェイスを接続されたケージにマッピングし、その背後にある両方の論理インターフェイスを構成し、RDMAトラフィックが両方のPCIeパスを使用できることを確認する必要がありました。
このステーションは、それぞれが独立したネットワークレールとして機能する2つの400Gb/sポートを備えており、よりシンプルな構成を実現しています。
Sparkの使用可能な帯域幅の4倍を2つのQSFPケージを通して処理すると冷却負荷も増加しますが、テスト中、すべてのユニットがこれを処理できました。ConnectX-8自体は液冷式で、MSIのようにQSFPケージにも冷却機能を拡張しているベンダーもあれば、ASUSのレビューで見たように、ケージの上にヒートシンクと専用ファンを使用しているシステムもあります。この冷却は、パッシブDACよりも発熱量の多い光モジュールにとって特に有効です。どちらの方法もテストではうまく機能し、ネットワークの冷却に関する問題は発生しませんでした。
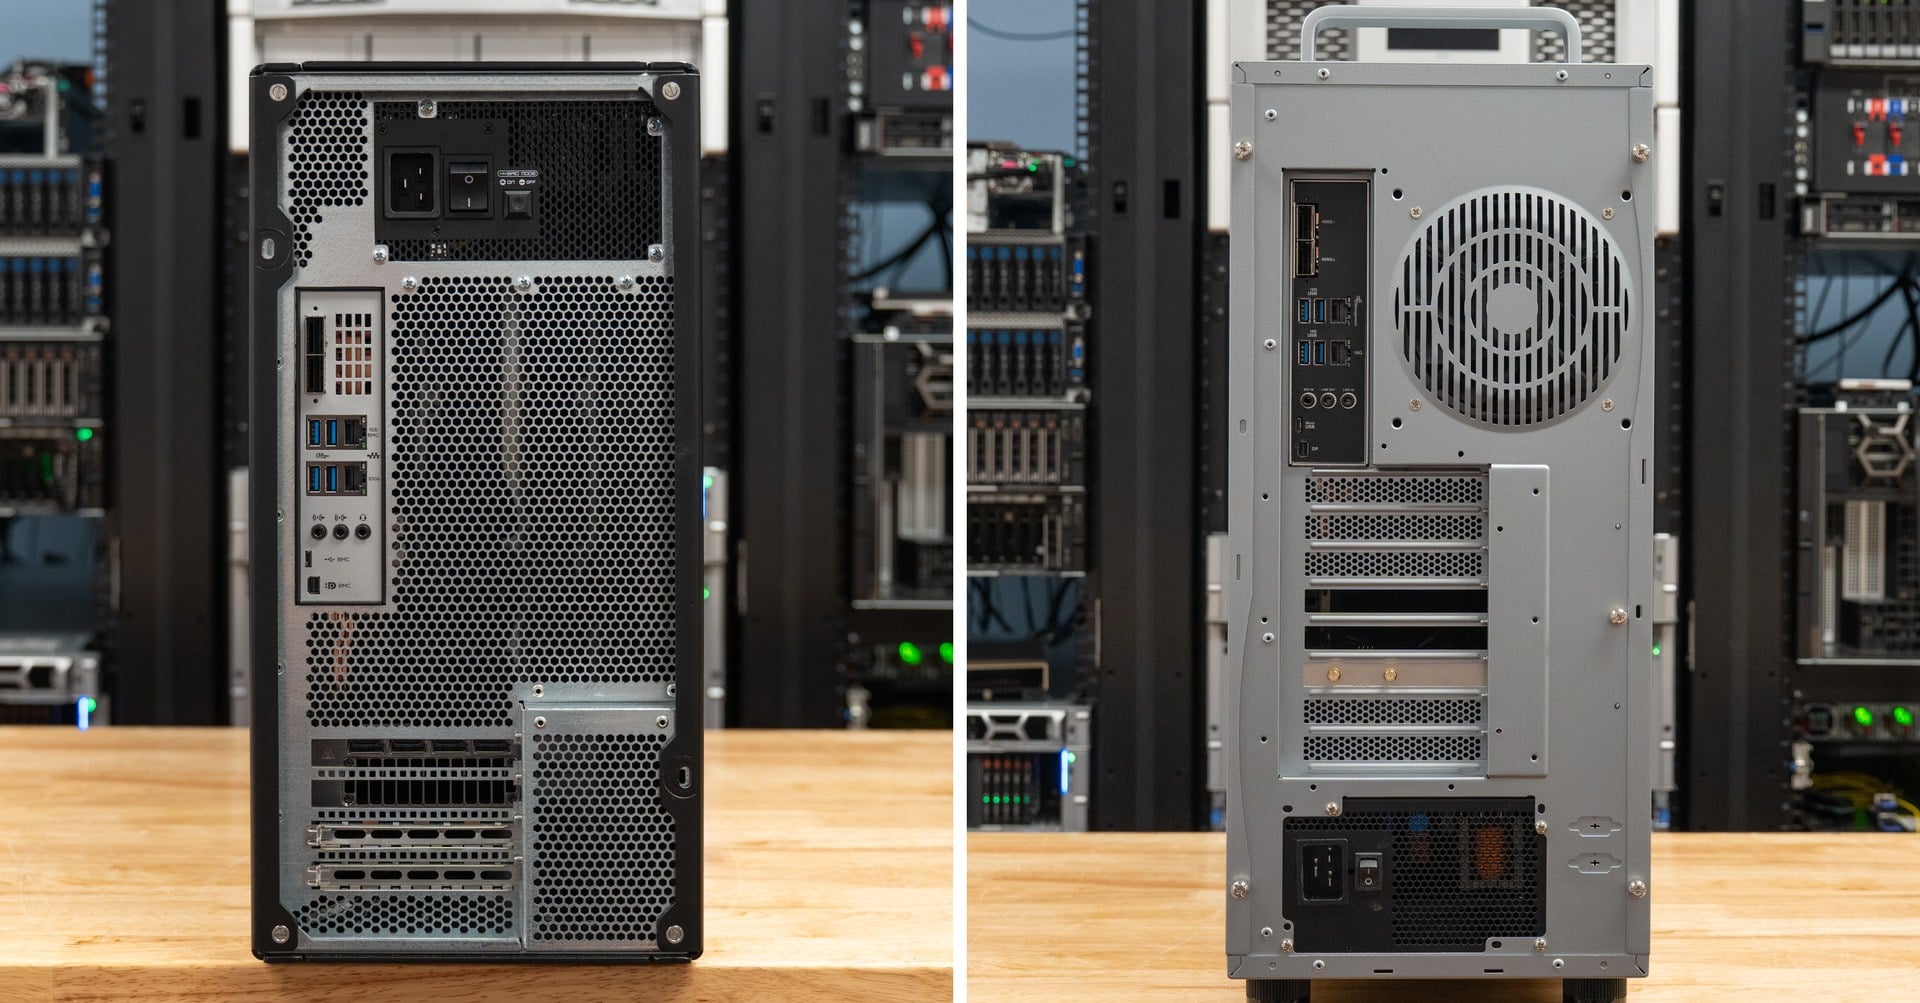
2つの駅を結ぶ
2台のDGXステーションをクラスタリングするのは簡単でした。ASUSとHPのステーションを、それぞれ対応するQSFP112ポート間に2本の400Gダイレクトアタッチ銅線(DAC)ケーブルで直接接続し、2つの独立した400Gb/s接続を実現しました。
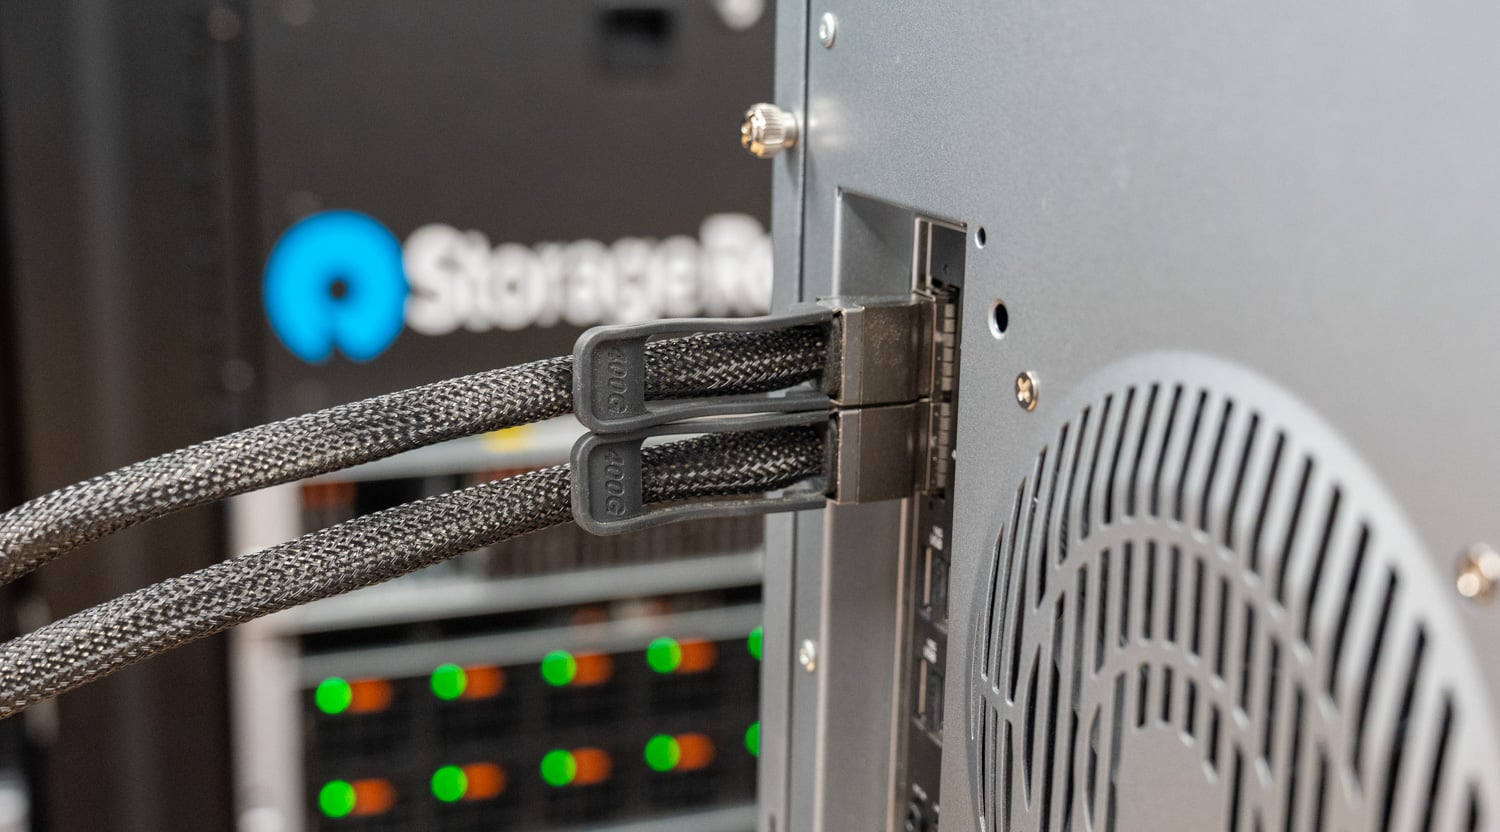
ソフトウェア面では、NVIDIAがシステムクラスタリングの手順を段階的に説明したガイドを提供しており、その説明は非常に分かりやすかったため、Claude Codeにリンクを渡すだけでセットアップは完了しました。Claude Codeは2つのステーション間のネットワークを構成し、NCCL帯域幅テストを実行して、結果レポートを出力してくれました。
このガイドは、SSH経由で両方のステーションに接続する3台目のマシンから実行される番号付きのプレイブックです。ポートは、QSFP0とQSFP0、QSFP1とQSFP1というように、対応するレールとしてケーブル接続され、各レールは独自のポイントツーポイントRoCEv2リンクになります。スクリプトは、2つのConnectX-8インターフェースを9,000バイトのMTUで起動し、各レールに独自のプライベート/24を割り当て、RoCEおよびGPUDirectランタイム設定を適用します。
次に、検証パスによって、両方のリンクが 400G でトレーニングされていること、ジャンボ ピングが各レールを通過すること、2 つの RDMA デバイス mlx5_0 と mlx5_1 がアクティブであることを報告していること、および各レールで ib_write_bw が実行され、ファブリックが ping だけでなく RDMA トラフィックも転送することが証明されることが確認されます。その後、NCCL は NCCL_IB_HCA=mlx5_0,mlx5_1 で両方のレールを指すように設定され、ジョブは他の 2 ノード実行と同様に起動されます。以下の結果は、この一連の処理から得られたものです。
最初の表は nccl-tests からのもので、分散推論またはトレーニングジョブの集合処理は、両方のレールが使用されている状態で 2 台の B300 上で実行されます。ステーションごとに 1 つの GPU があるため、すべての集合処理は 2 つの GPU が 2 つの 400G リンクを介してデータを交換することになります。そのため、バス帯域幅の列は、2 つのケーブルが提供する 100GB/s (800Gb/s) に直接対応しています。ピークはメッセージサイズ全体で最良の結果を示し、16 GiB の列はテストされた最大のメッセージであり、帯域幅が安定しています。
| 操作 | ピークサイズ | ピークバス帯域幅 | バス帯域幅16GiB |
|---|---|---|---|
| すべて削減 | 1 GiB | 92.242 GB / sの | 91.346 GB / sの |
| 全員集合 | 16 GiB | 87.893 GB / sの | 87.893 GB / sの |
| 散乱を減らす | 2 GiB | 93.930 GB / sの | 92.905 GB / sの |
| 放送 | 16 GiB | 97.975 GB / sの | 97.975 GB / sの |
| 減らす | 16 GiB | 97.978 GB / sの | 97.978 GB / sの |
| 全員対全員 | 8 GiB | 80.522 GB / sの | 80.512 GB / sの |
| 送受信、一方向 | 16 GiB | 97.953 GB / sの | 97.953 GB / sの |
| 送受信、双方向 | 16 GiB | 83.748 GB/s(方向あたり) | 合計167.496 GB/s |
ブロードキャスト、リデュース、および一方向の送受信はすべて 98GB/s に達し、2 本のケーブルで伝送できる速度の 98% となりました。データが双方向に同時に移動するパターンでは、速度は低下し、オールリデュースでは 92GB/s、オールツーオールでは 80GB/s となりました。双方向の送受信の結果は、これらの基準点となります。両方の GPU が同時に送信する場合、各方向の速度は 84GB/s に落ち着き、リンク全体で合計 167GB/s となりました。
2 番目のテーブルは、一度に 1 つのレールを使用して ib_write_bw を使用して NCCL より下の生の RDMA パスにドロップします。GPUDirect 行は、NIC が GPU メモリを直接読み書きして、一方の B300 の HBM からもう一方の HBM に 1 MiB の転送を書き込みます。両方のレールで 392Gb/s に達し、ライン レートの 98% になります。ホスト メモリ行は、ガイドの基本的なスモーク テストで、Grace メモリからソースする単一のキュー ペアです。NVIDIA のプレイブックでは、400G レールで 220 ~ 230Gb/s と評価されていますが、228Gb/s を確認しました。レイテンシ行は 8 バイトの書き込みで、平均 1.46 µs です。
| ホイール試乗 | 帯域幅 | リンク利用率 |
|---|---|---|
| GPUDirect RDMA、GPUメモリ、ib_write_bw、1 MiB転送 | ||
| レール0 | 392.15 Gb / s | 98.04% |
| レール1 | 392.15 Gb / s | 98.04% |
| ホストメモリRDMA、両方のレール | ||
| RDMA書き込み、一方向 | 228.15 Gb / s | |
| RDMA読み出し、一方向 | 228.23 Gb / s | |
| RDMA送信、一方向 | 228.16 Gb / s | |
| RDMA書き込み、双方向 | 合計447.10Gb/s | |
| RDMA書き込みレイテンシ、8バイト | 平均1.46 µs、レールごとの99パーセンタイル値は1.63 µsと1.66 µs | |
クラスターのテスト方法
ペアで作業できる時間が限られていたため、現在最も普及しているAIワークロードである推論に重点を置きました。今後は、より大規模なクラスタにこの研究を拡張していく予定です。この記事では、より大規模なモデルに焦点を当て、テンソル並列処理(TP)とプリフィル/デコード(PD)による分解を用いた単一のステーションと2つのステーションを比較しました。
テンソル並列処理では、モデル内の重みテンソルと計算処理を複数のGPUに分割します。2ステーション構成(TP2)では、各B300がモデルの一部を保持し、両方のGPUが各リクエストを処理します。これにより、重みを配置するための高帯域幅メモリ(HBM)が増え、計算処理能力も向上します。ただし、推論処理全体を通してGPU間で中間結果の交換とNCCLを介した同期が必要となるため、通信オーバーヘッドがモデル実行コストの一部となります。
分離推論では、リクエストのプリフィル段階とデコード段階を別々のワーカーに割り当てます。プリフィルは入力プロンプトを処理し、キー/バリュー(KV)キャッシュ(モデルが生成時に再利用するアテンション状態)を構築します。デコードはその状態を使用して、出力トークンを1つずつ生成します。この2つの段階は処理要件が異なります。プリフィルは計算負荷が高く、デコードはメモリ帯域幅を多く消費します。大規模なシステムでは、このように推論を分離することで、KVキャッシュのオフロードに関する論文で示したように、オペレーターは需要に応じてワーカーを個別にスケーリングできます。
シングルノード構成では、両方のフェーズがワーカーを共有するため、vLLM は受信プロンプトの事前入力処理と既に進行中のリクエストのデコード処理を交互に実行できます。このプロンプト処理により、出力トークン間の時間が長くなる可能性があります。PD 構成では、一方のステーションが事前入力処理を行い、リクエストの KV キャッシュをもう一方のステーションに転送し、もう一方のステーションがデコード処理を行います。各ワーカーは、グレース メモリに格納されたデータを含め、モデルの独自のコピーにアクセスできます。デコード ワーカーは、トークン生成と並行して新しいプロンプト処理をスケジュールする必要がなくなり、推論スループットが向上します。
今回のテストでは、モデルのメモリ要件によって使用するアプローチが決定されました。単一のステーションが相当量のモデル重みをGraceメモリにオフロードする必要があった大規模なチェックポイントでは、TPが最高のパフォーマンスを発揮しました。重みを2つのGPUに分散することで、より多くのモデルをHBMに保持でき、オフロードによるペナルティを軽減できました。HBMに完全に収まるか、Graceへのオフロードが限定的なモデルなど、1つのステーションに比較的うまく収まるモデルについては、PD分解を使用しました。これには、エングラムルックアップテーブルがGrace DRAMに配置されたDeepSeek V4.1 Flashも含まれます。
以前の調査結果との比較可能性を維持するため、入力シーケンス長(ISL)と出力シーケンス長(OSL)を固定した従来の手法を採用しました。ワークロードが均等な場合は入力トークン512個と出力トークン512個を使用し、事前入力が多い場合は入力トークン8,192個と出力トークン1,024個を使用します。シーケンス長は固定したまま、同時リクエスト数を変化させています。
各グラフにおけるシングルステーションのベースラインは、レビューで使用したASUS ET900N G3で、32ストリームまでスイープしています。2ステーションでの実行では、256ストリームまでスイープします。各ポイントは1回のパスを表すため、同時接続レベルの低下は収集済みとして報告されます。
推論構成
| モデル | クラスターモード | ソフトウェア | 推測的デコード | グレース・メモリー |
|---|---|---|---|---|
| DeepSeek V4.1 フラッシュ (FP8) | 事前入力/デコード分解、ステーションごとの完全コピー | vllm/vllm-openai:deepseekv41-flash-0909 | モデル作成者自身による設計、トークン5個固定 | 各ステーションには、Graceメモリに固定された2つのFP8エングラムテーブル(188.84GiB)と、オフロードされた131.97GBのエキスパートウェイトが配置されている。 |
| GLM-5.3 NVFP4 | テンソル並列処理(TP2) | NVIDIA vLLM 26.08 NGCコンテナ(vLLM 0.27.1) | MTP、5トークンドラフト固定 | クラスター上には何もなし。215GBの専門家重みが単一のステーションにオフロードされる。 |
| GLM-5.3 フラッシュ NVFP4 | プリフィル/デコード分解、ASUSプリフィル、HPデコード | vLLM 0.28.1 RC1 | MTP、5トークンドラフト固定 | なし |
| GLM-5.2 NVFP4 | テンソル並列処理(TP2) | NVIDIA vLLM 26.08 NGCコンテナ(vLLM 0.27.1) | MTP、3トークンドラフト固定 | クラスター上には何もなし。約215GBの専門家重みが単一のステーションにオフロードされる。 |
| MiniMax-M3 NVFP4 | テンソル並列処理(TP2) | NVIDIA vLLM 26.08 NGCコンテナ(vLLM 0.27.1) | EAGLE3、3トークンドラフトの修正 | クラスター上には何も存在しない。専門家の一部が単一のステーションにオフロードされている。 |
推論パフォーマンス
DeepSeek V4.1 フラッシュ
DeepSeek V4.1 Flashは、1つのステーションがプリフィル処理、もう1つのステーションがデコード処理を行うという、分離構成で実行されました。各ステーションには、モデルの完全なコピー(合計188.84GiBの2つのFP8エングラムテーブルがGraceメモリに固定され、さらに131.97GBの専門家ウェイトがGraceにオフロードされる)が保持されました。これにより、両方のマシンでGraceメモリが使用される構成は、このセットの中でこの構成のみとなりました。また、ASUSのレビューでは以前のV4 Flashチェックポイントが実行されたため、両者を直接比較することはできないため、このモデルはシングルステーション構成がない唯一のモデルでもあります。
2台のステーションで構成されるクラスタでは、ネイティブFP8モデルの出力トークン数は、1ストリームで毎秒441個から、32ストリームで毎秒3,328個、128ストリームで毎秒5,141個、256ストリームで毎秒5,248個まで増加し、このセットのどのモデルよりも高い出力スループットを示しました。出力曲線は、スイープの頂点付近でのみ平坦化しました。参考までに、レビューでは、単一のASUSステーションが32ストリームで毎秒1,766個のV4 Flashトークンを出力しました。
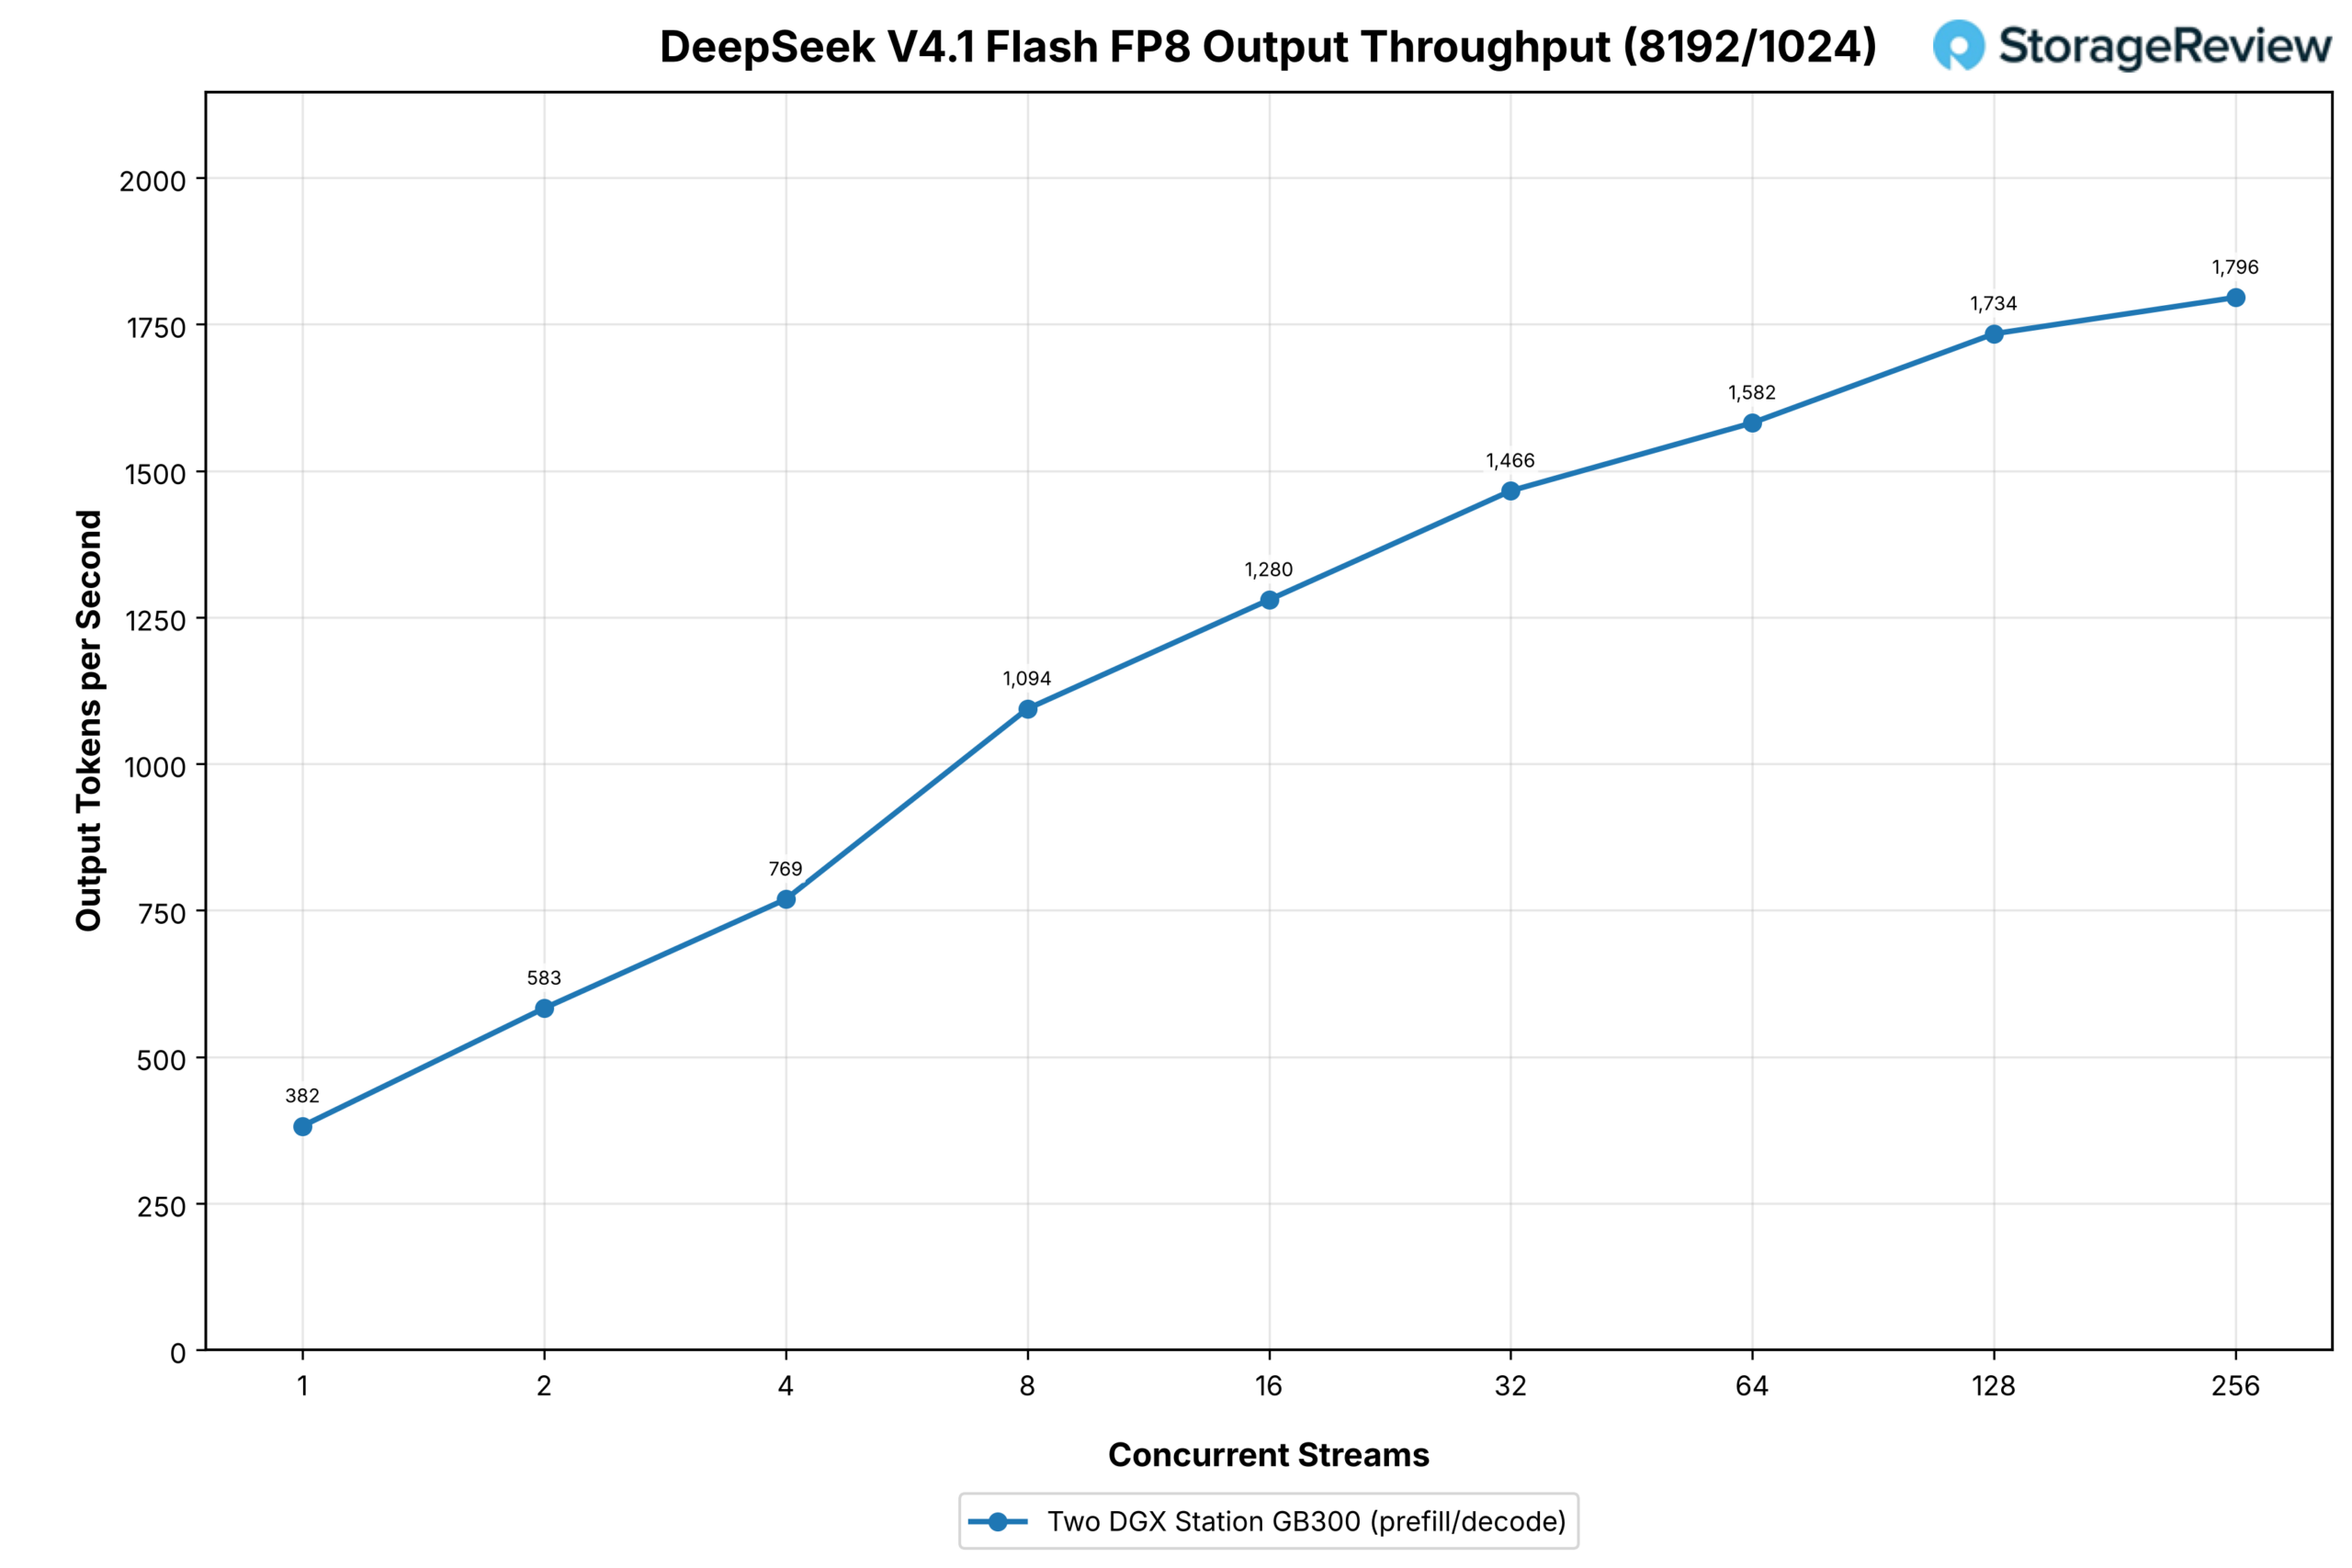
事前入力が多いプロファイルでは、クラスタは1ストリームで毎秒382出力トークンから、32で毎秒1,466、256で毎秒1,796まで動作し、各リクエストには8,192の入力トークンが含まれるため、スイープのピーク時には合計スループットが毎秒16,163トークンに達しました。エングラムテーブルと131.97GBのエキスパートウェイトが各ステーションのGraceメモリに格納されているため、スイープ全体を通して曲線は滑らかに保たれます。
GLM-5.3
GLM-5.3はTP2上でGraceのオフロードなしで実行されました。単一のステーションでは、215GBのエキスパートウェイトがGraceメモリにオフロードされ、クラスタの結果は、不均一になる前のほとんどのスイープでGLM-5.2とほぼ同じでした。1つのステーションでは、同じワークロードで、1ストリームで毎秒44個の出力トークンから、32ストリームで毎秒188個の出力トークンまで実行されました。
2 つのステーションのクラスタは、1 つのストリームで 208 から 16 で 1,301 まで増加し、これは単一のタワーの 4.7 倍から 9.2 倍に相当します。その後、32 で 853 まで減少し、64 で 1,652、128 で 3,051、256 で 5,018 まで再び増加しました。32 ストリームのポイントは収集されたデータにあります。バッチ処理の決定とカーネルの選択は、同時実行性が高まるにつれて変化し、テンソル並列展開では、次のステップに進む前に完了する必要のある集合処理が各レイヤーに追加されるため、曲線は直線ではありませんが、256 ストリームでの上限は、1 つのステーションが 32 で到達した値の 27 倍です。
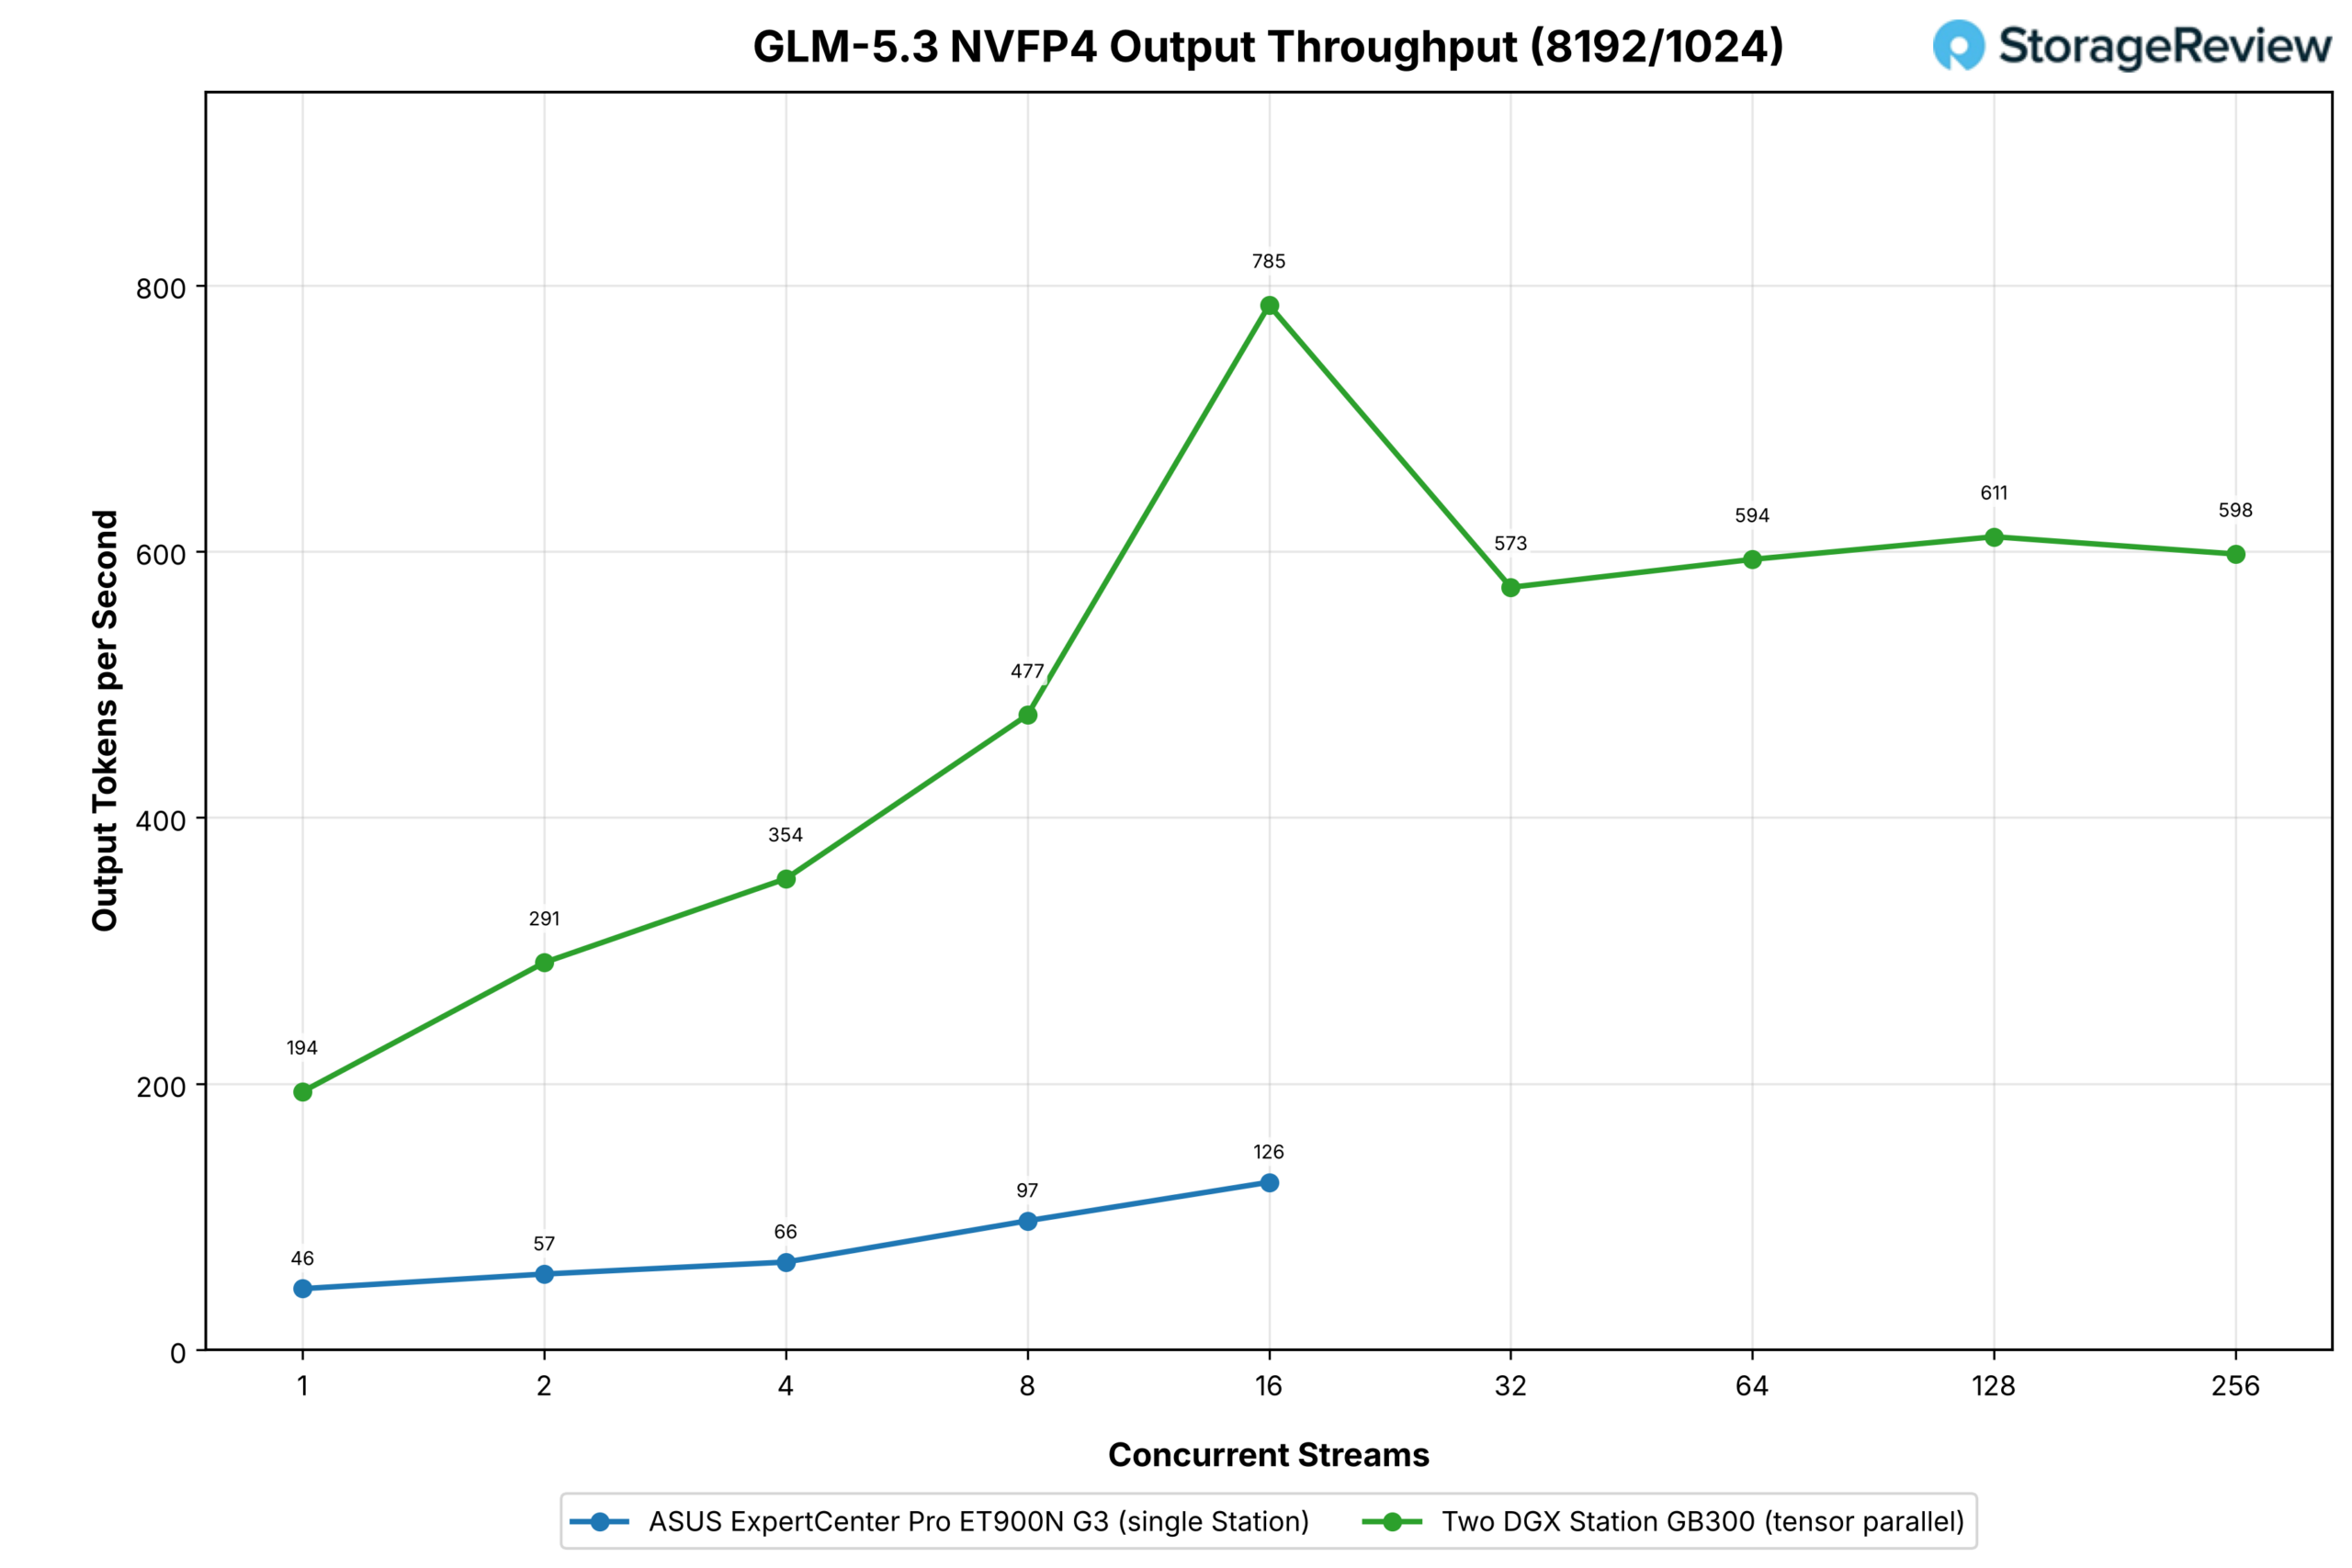
プリフィルが多いプロファイルでは、シングルステーションは設計どおり16ストリームで停止しました。オフロードモデルはすぐに平坦化し、並行処理をさらに進めても得るものはほとんどありません。出力トークン数は、1ストリームで毎秒46個から、16ストリームで毎秒126個に増加しました。クラスタは同じ範囲で194から785に増加し、最高で6.2倍になり、その後、32ストリームから256ストリームまで573から611の間で落ち着きました。これは、毎秒600出力トークンに近い長いプロンプトの上限であり、シングルステーションの最高値の約5倍です。
GLM-5.3 フラッシュ
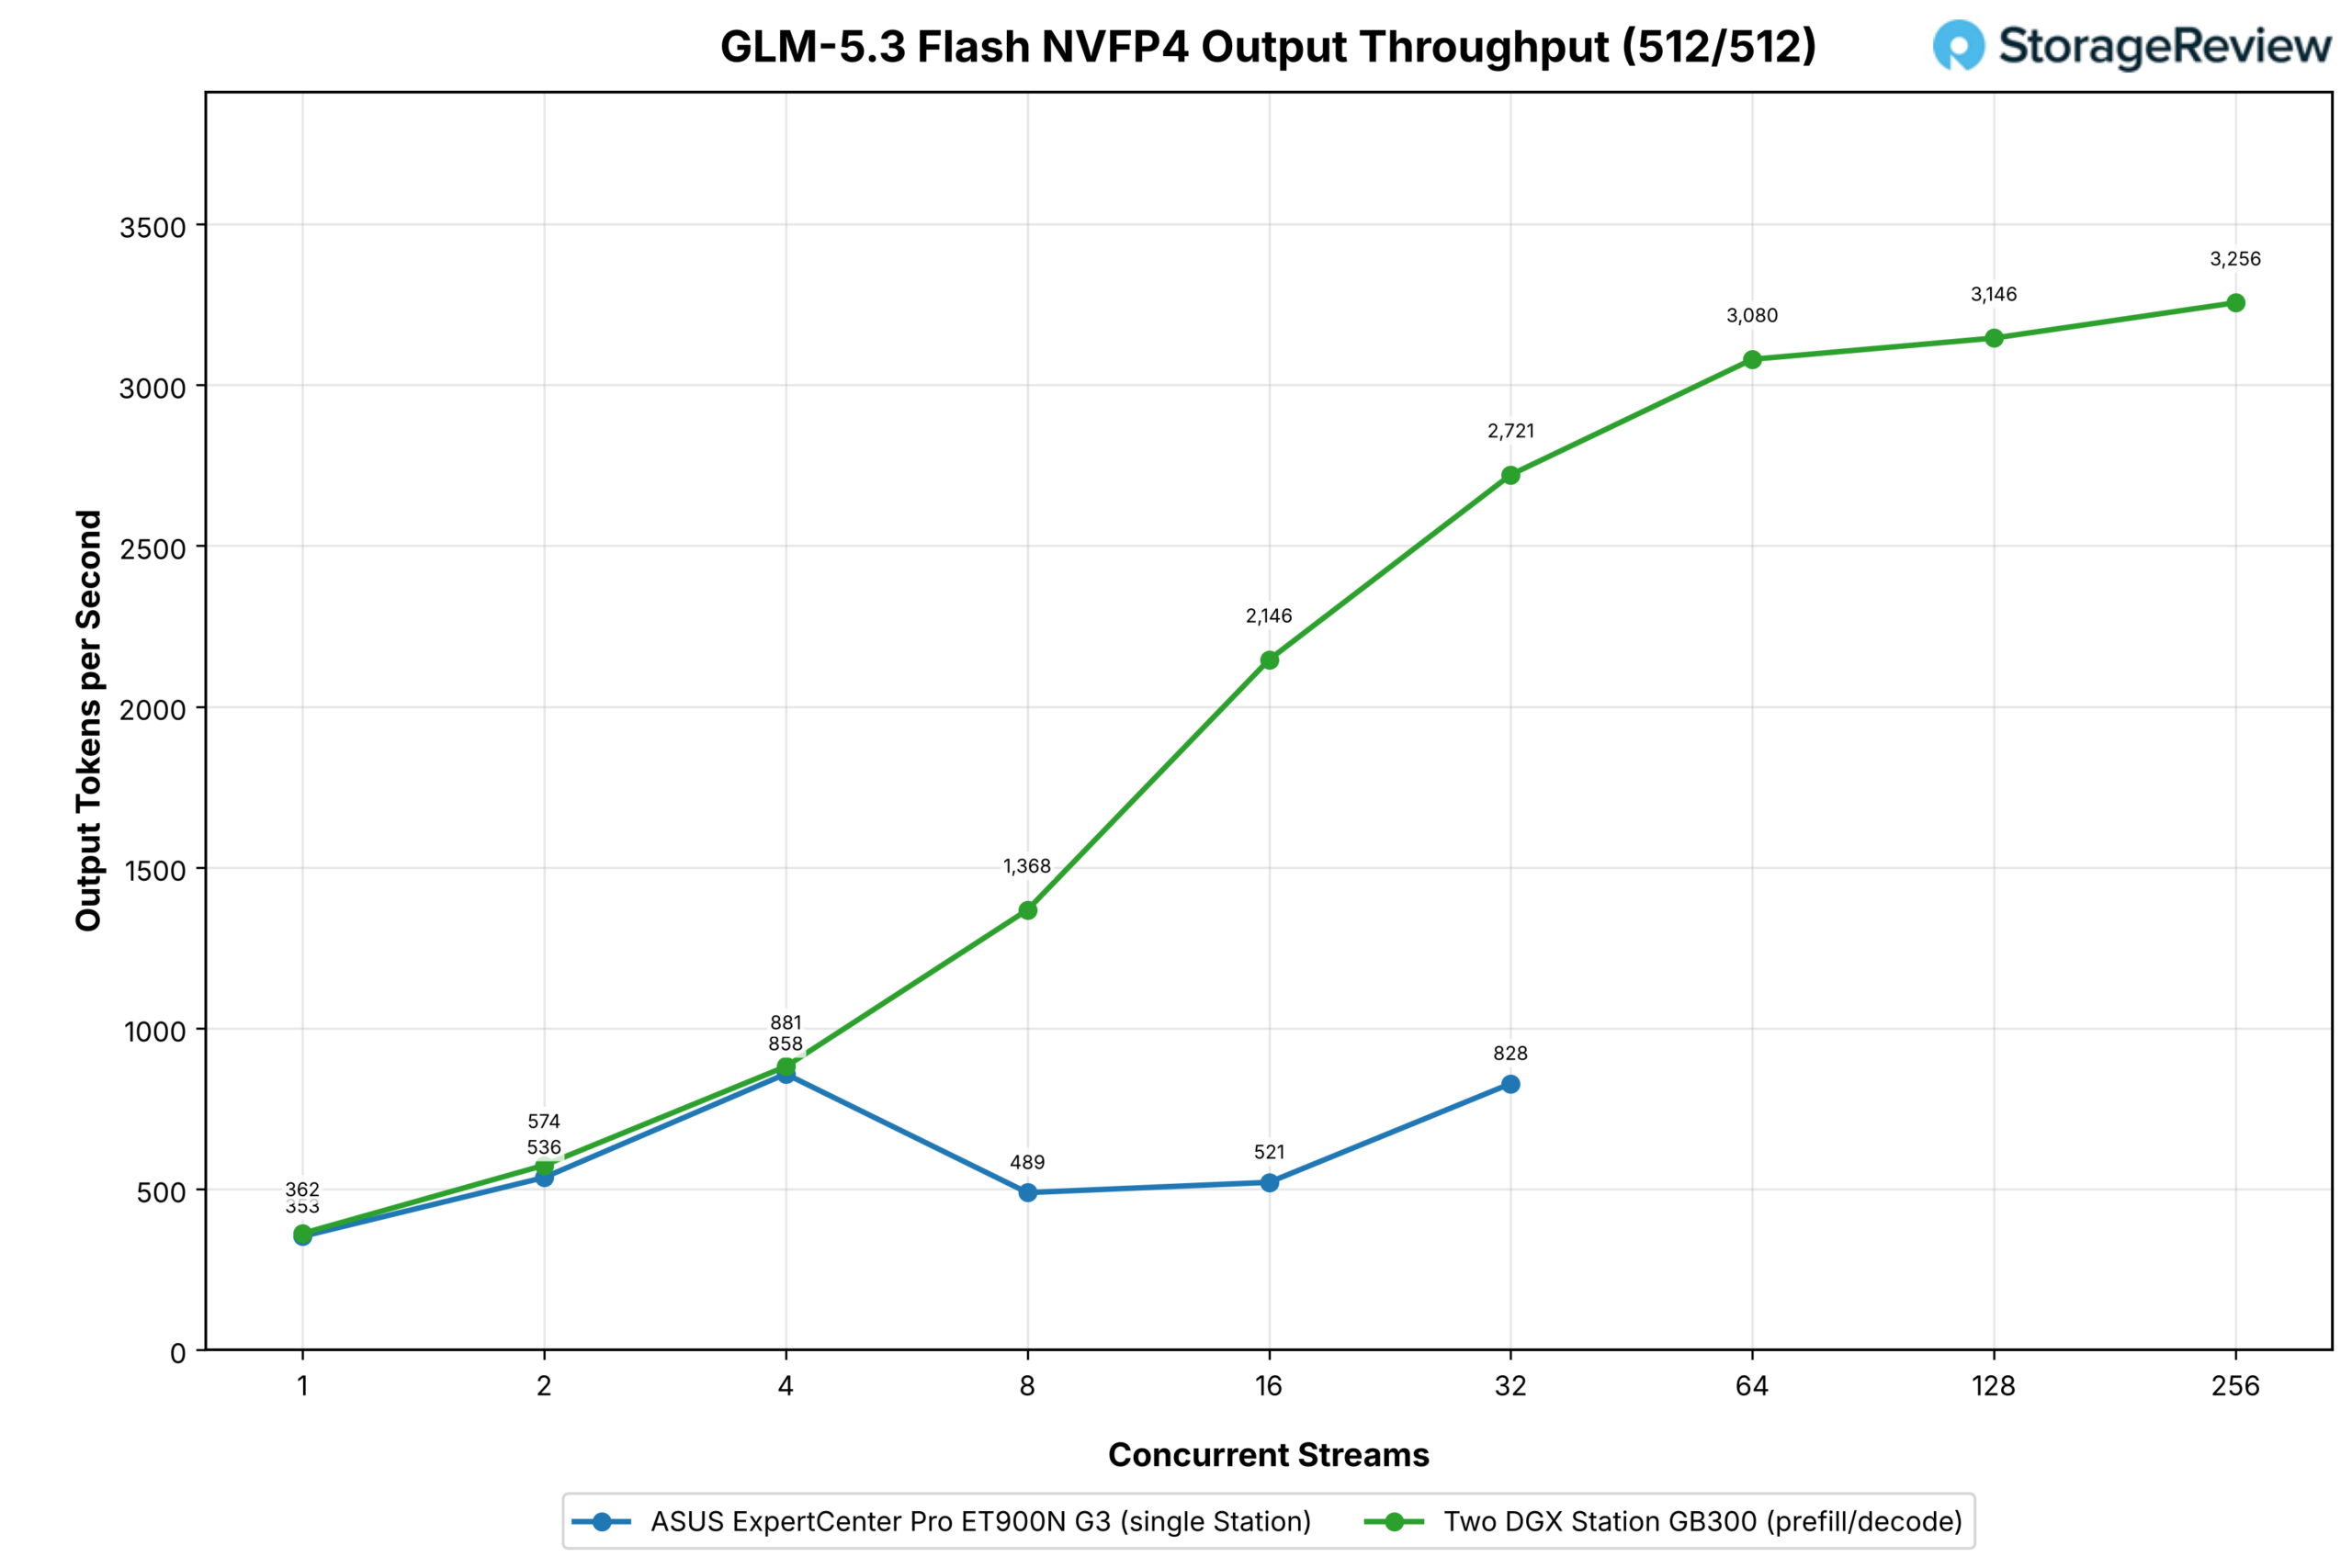
GLM-5.3 Flash は、各ステーションが完全なコピーを保持できるほど小さいため、ASUS がプリフィルを、HP がデコードを処理するというように、分離して実行されました。Flash はアクティブなパラメータ数が少ないため、単一のステーションですでに高速に動作します。同じワークロードで、1 つのストリームで毎秒 353 個の出力トークン、32 ストリームで毎秒 828 個の出力トークンを生成し、収集されたものとして報告される中間値 (4 つのストリームで 858、8 つのストリームで 489) は不均一です。
分離されたペアでは、同等のワークロードは、1つのストリームで毎秒362個の出力トークンから、32のストリームで毎秒2,721個(単一タワーの3.3倍)、そして256のストリームで毎秒3,256個まで増加しました。
1つまたは2つのストリームの場合、このペアは単一のステーションとほぼ完全に一致します。これは、デコードステーションが単独で同じ作業を行っている場合に予想される結果です。利点は、プリフィルステーションが常に稼働状態を維持できるほど十分なリクエストが処理され、デコードステーションがプリフィルのために一時停止する必要がないというメリットを享受できるようになったときに現れます。
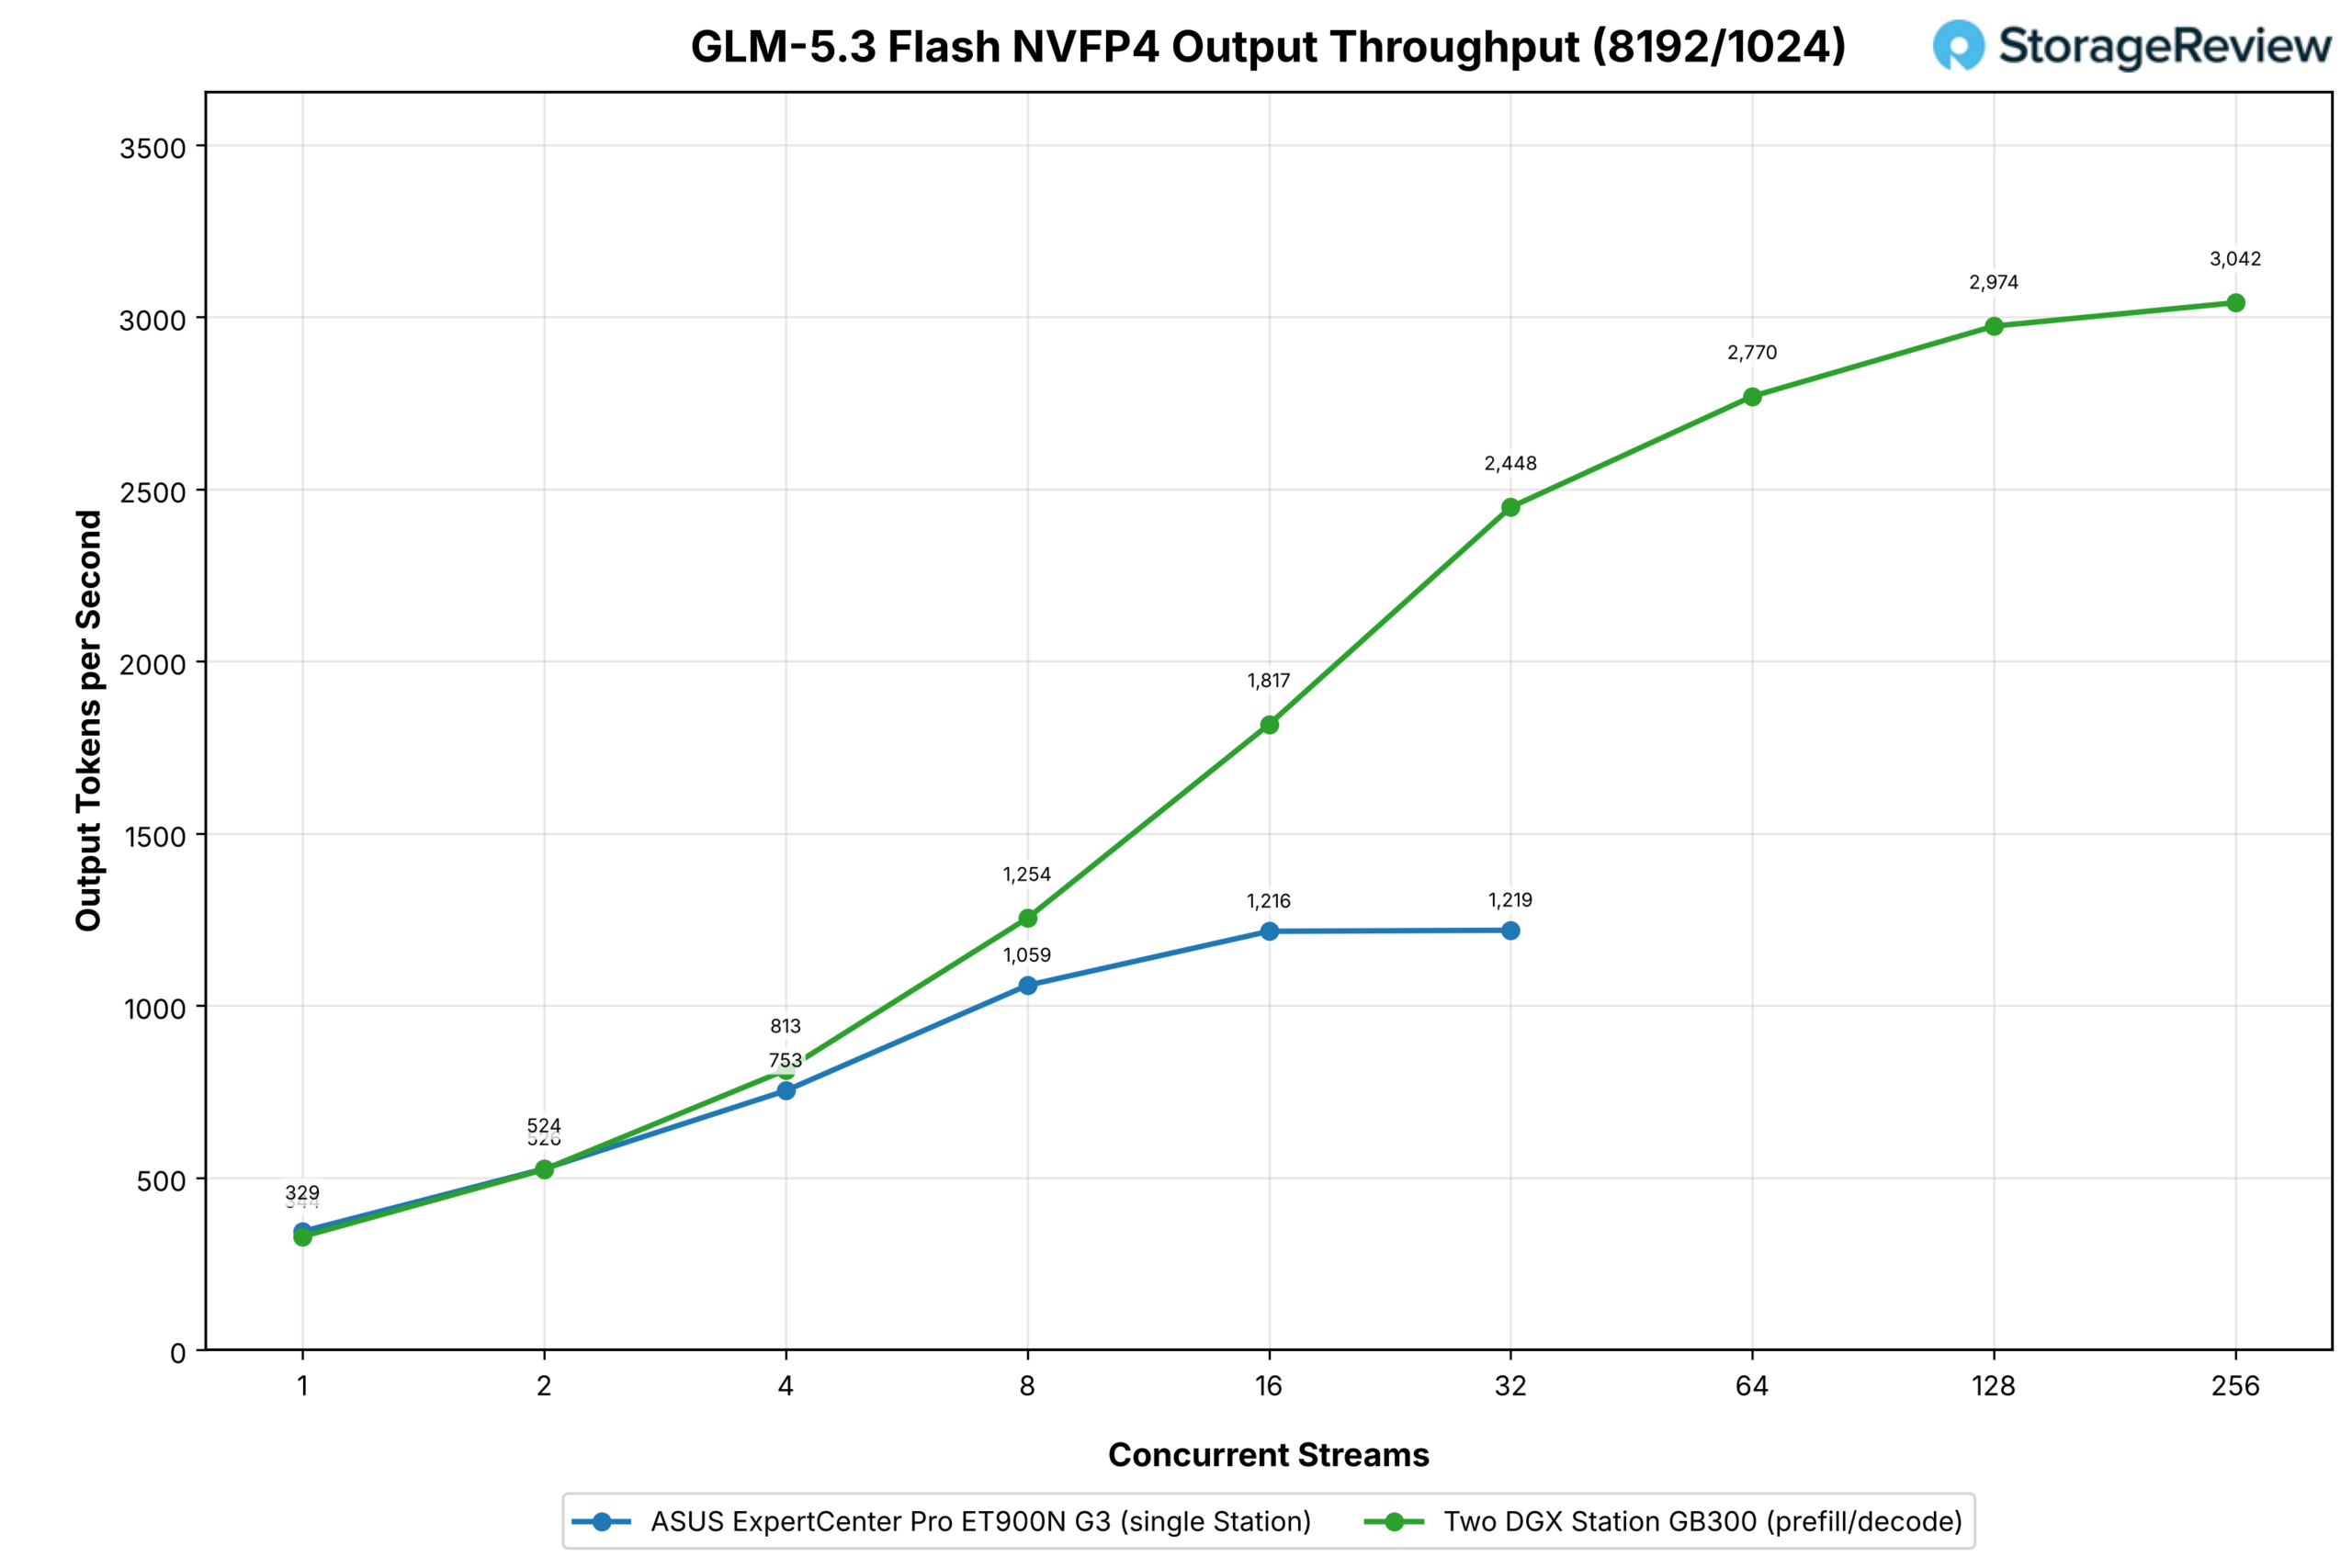
プリフィルが多いプロファイルでは、シングルステーションの出力トークン数は、1ストリームで毎秒344個から16ストリームで毎秒1,216個に増加し、32ストリームでは1,219個で横ばいとなり、16ストリーム以降は横ばいでした。プリフィル/デコードペアは、1ストリームで毎秒329個から32ストリームで毎秒2,448個に増加し続け、横ばいとなったシングルステーションの2倍になり、256ストリームで毎秒3,042個になりました。長いプロンプトは、この分割が想定しているケースです。プリフィルステーションが8,192トークンのプロンプトを吸収し、デコードステーションのKVキャッシュと計算は生成時に残るためです。
GLM-5.2
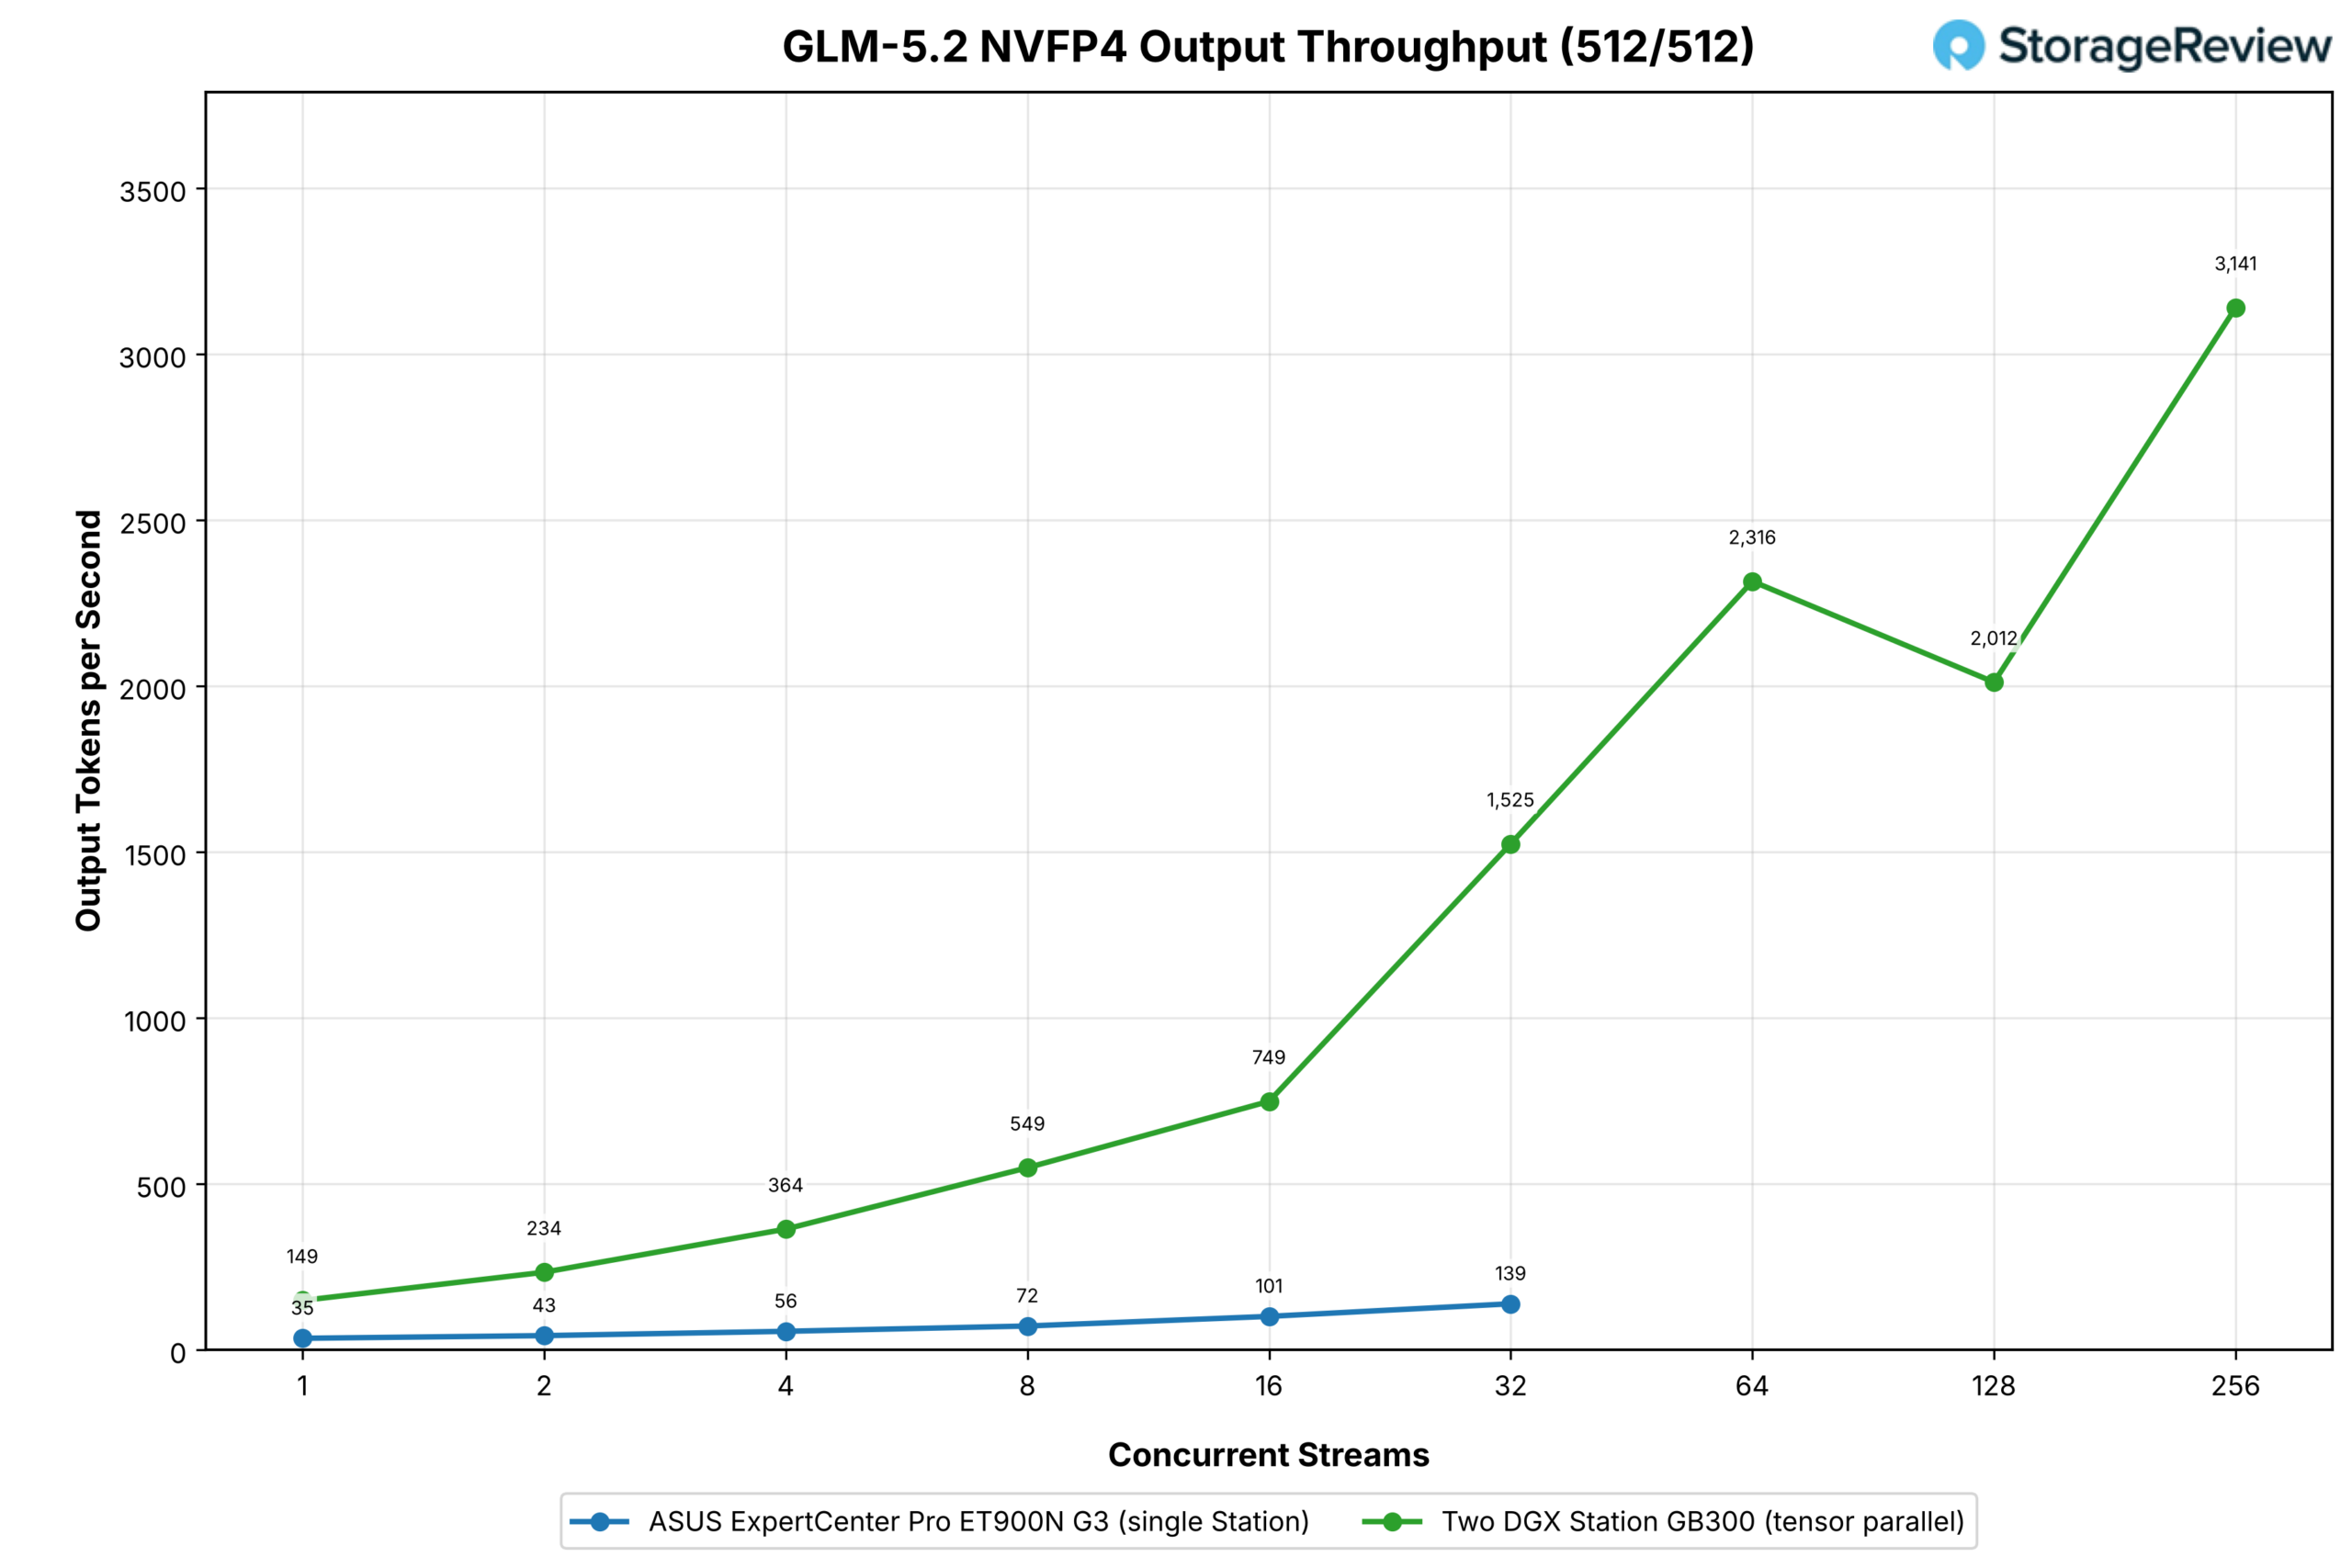
GLM-5.2 は、クラスター上で Grace オフロードを使用せずに TP2 で実行され、2 つ目の Station の必要性を最も強く示すモデルです。NVFP4 チェックポイントは約 433GB なので、1 つの GB300 では約 215GB のエキスパート重みが Grace メモリに格納され、それらにアクセスするすべてのデコード ステップは NVLink-C2C を介して LPDDR5X に 396GB/s で転送されます。2 つの Station に分割すると、各 B300 にはモデルの約半分が HBM3e に格納されます。
同じワークロードでは、単一の ET900N G3 は 1 つのストリームで毎秒 35 個の出力トークンを、32 ストリームで毎秒 139 個の出力トークンを生成しました。2 つの Station クラスタは、1 つのストリームで毎秒 149 個のトークンから始まり、単一のタワーの 4.3 倍となり、32 ストリームで 11 倍の 1,525 個に達し、64 ストリームで毎秒 2,316 個、256 ストリームで毎秒 3,141 個まで上昇し続け、128 ストリームで毎秒 2,012 個まで低下しました。少数のユーザーに対して会話速度で 1 つの Station がサービスを提供するモデルは、部門に対して 2 つの Station がサービスを提供できるモデルになります。
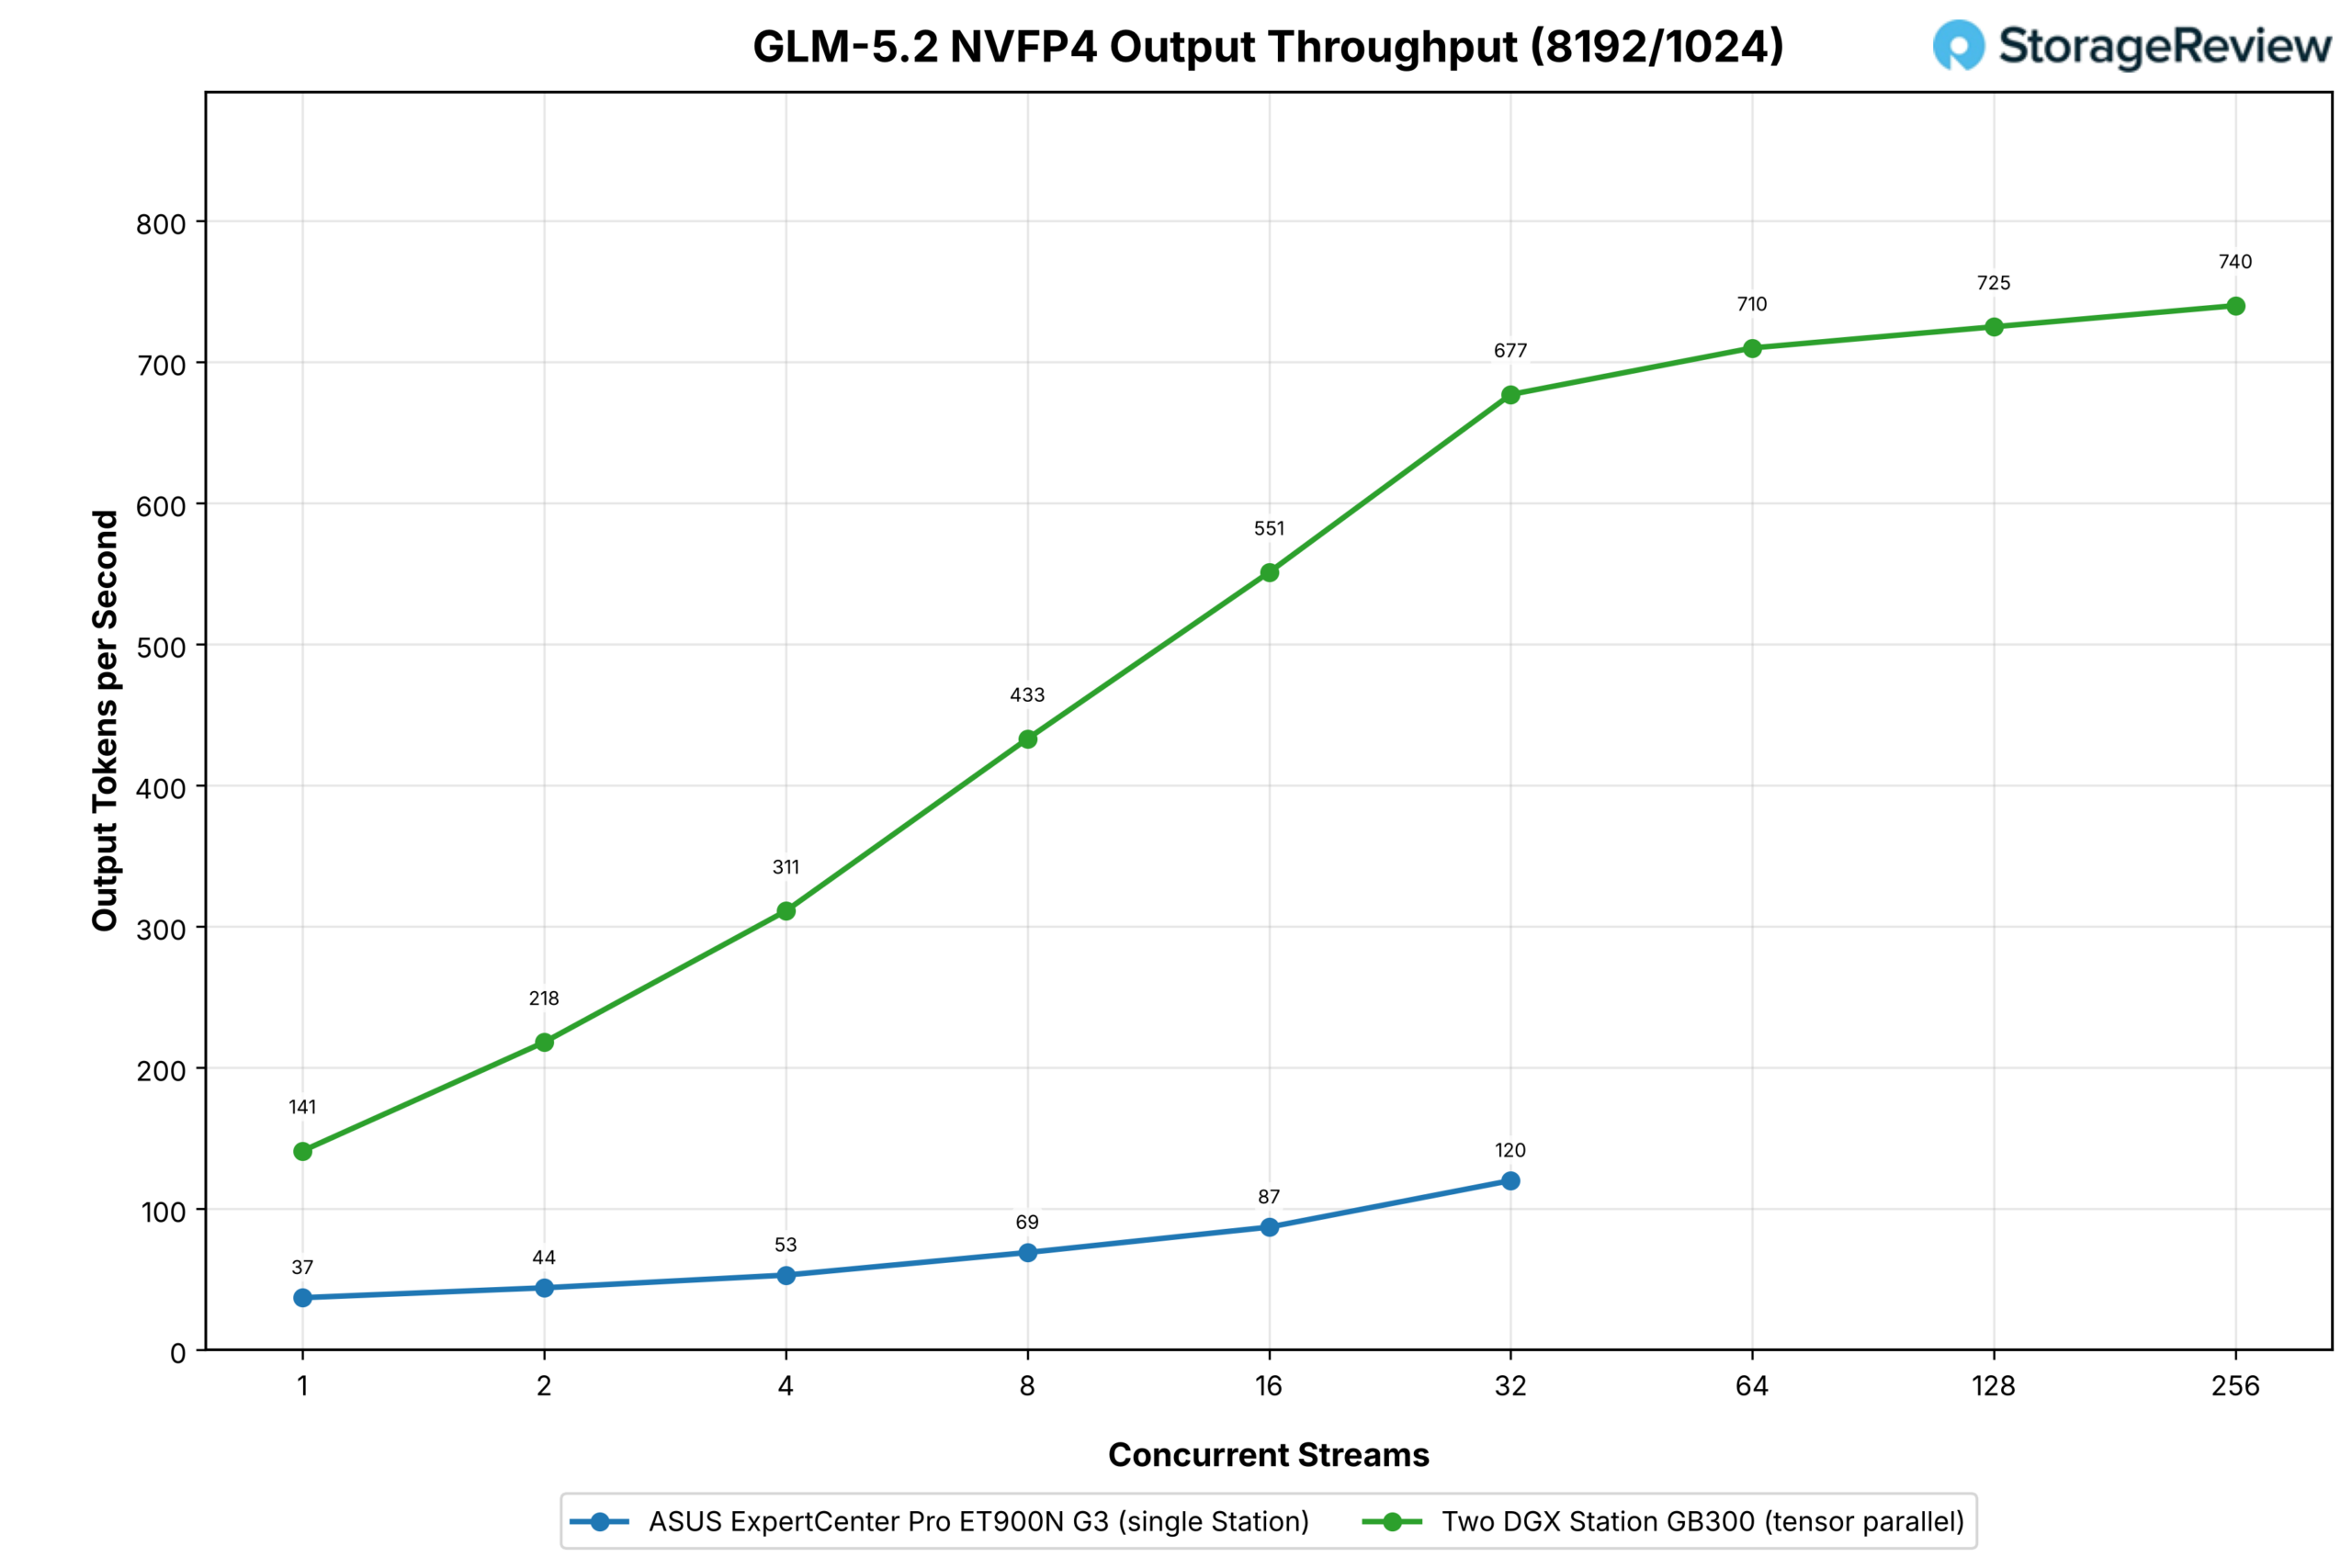
プリフィルが多いプロファイルは、より低い高さで同じことを示している。1 つのステーションは、1 つのストリームで毎秒 37 個の出力トークンから 32 ストリームで毎秒 120 個に増加し、クラスターは同じ範囲で 141 個から 677 個に増加し、スイープの下部で 3.8 倍、上部で 5.6 倍となり、その後 256 ストリームで 710、725、740 で横ばいになる。
長いプロンプトでは、処理の大部分がプリフィルに集中し、どちらの構成も演算処理がボトルネックとなるため、2 番目のステーションによって解消されるオフロードのペナルティは、短いプロンプトの場合よりも全体のペナルティに占める割合が小さくなります。2 番目のステーションは 433GB モデルを LPDDR5X から取り出し、そのすべてを HBM に配置するため、両方のプロファイルで 2 倍以上のゲインが得られます。これは、2 番目の B300 の演算処理よりも重要です。
ミニマックス-M3
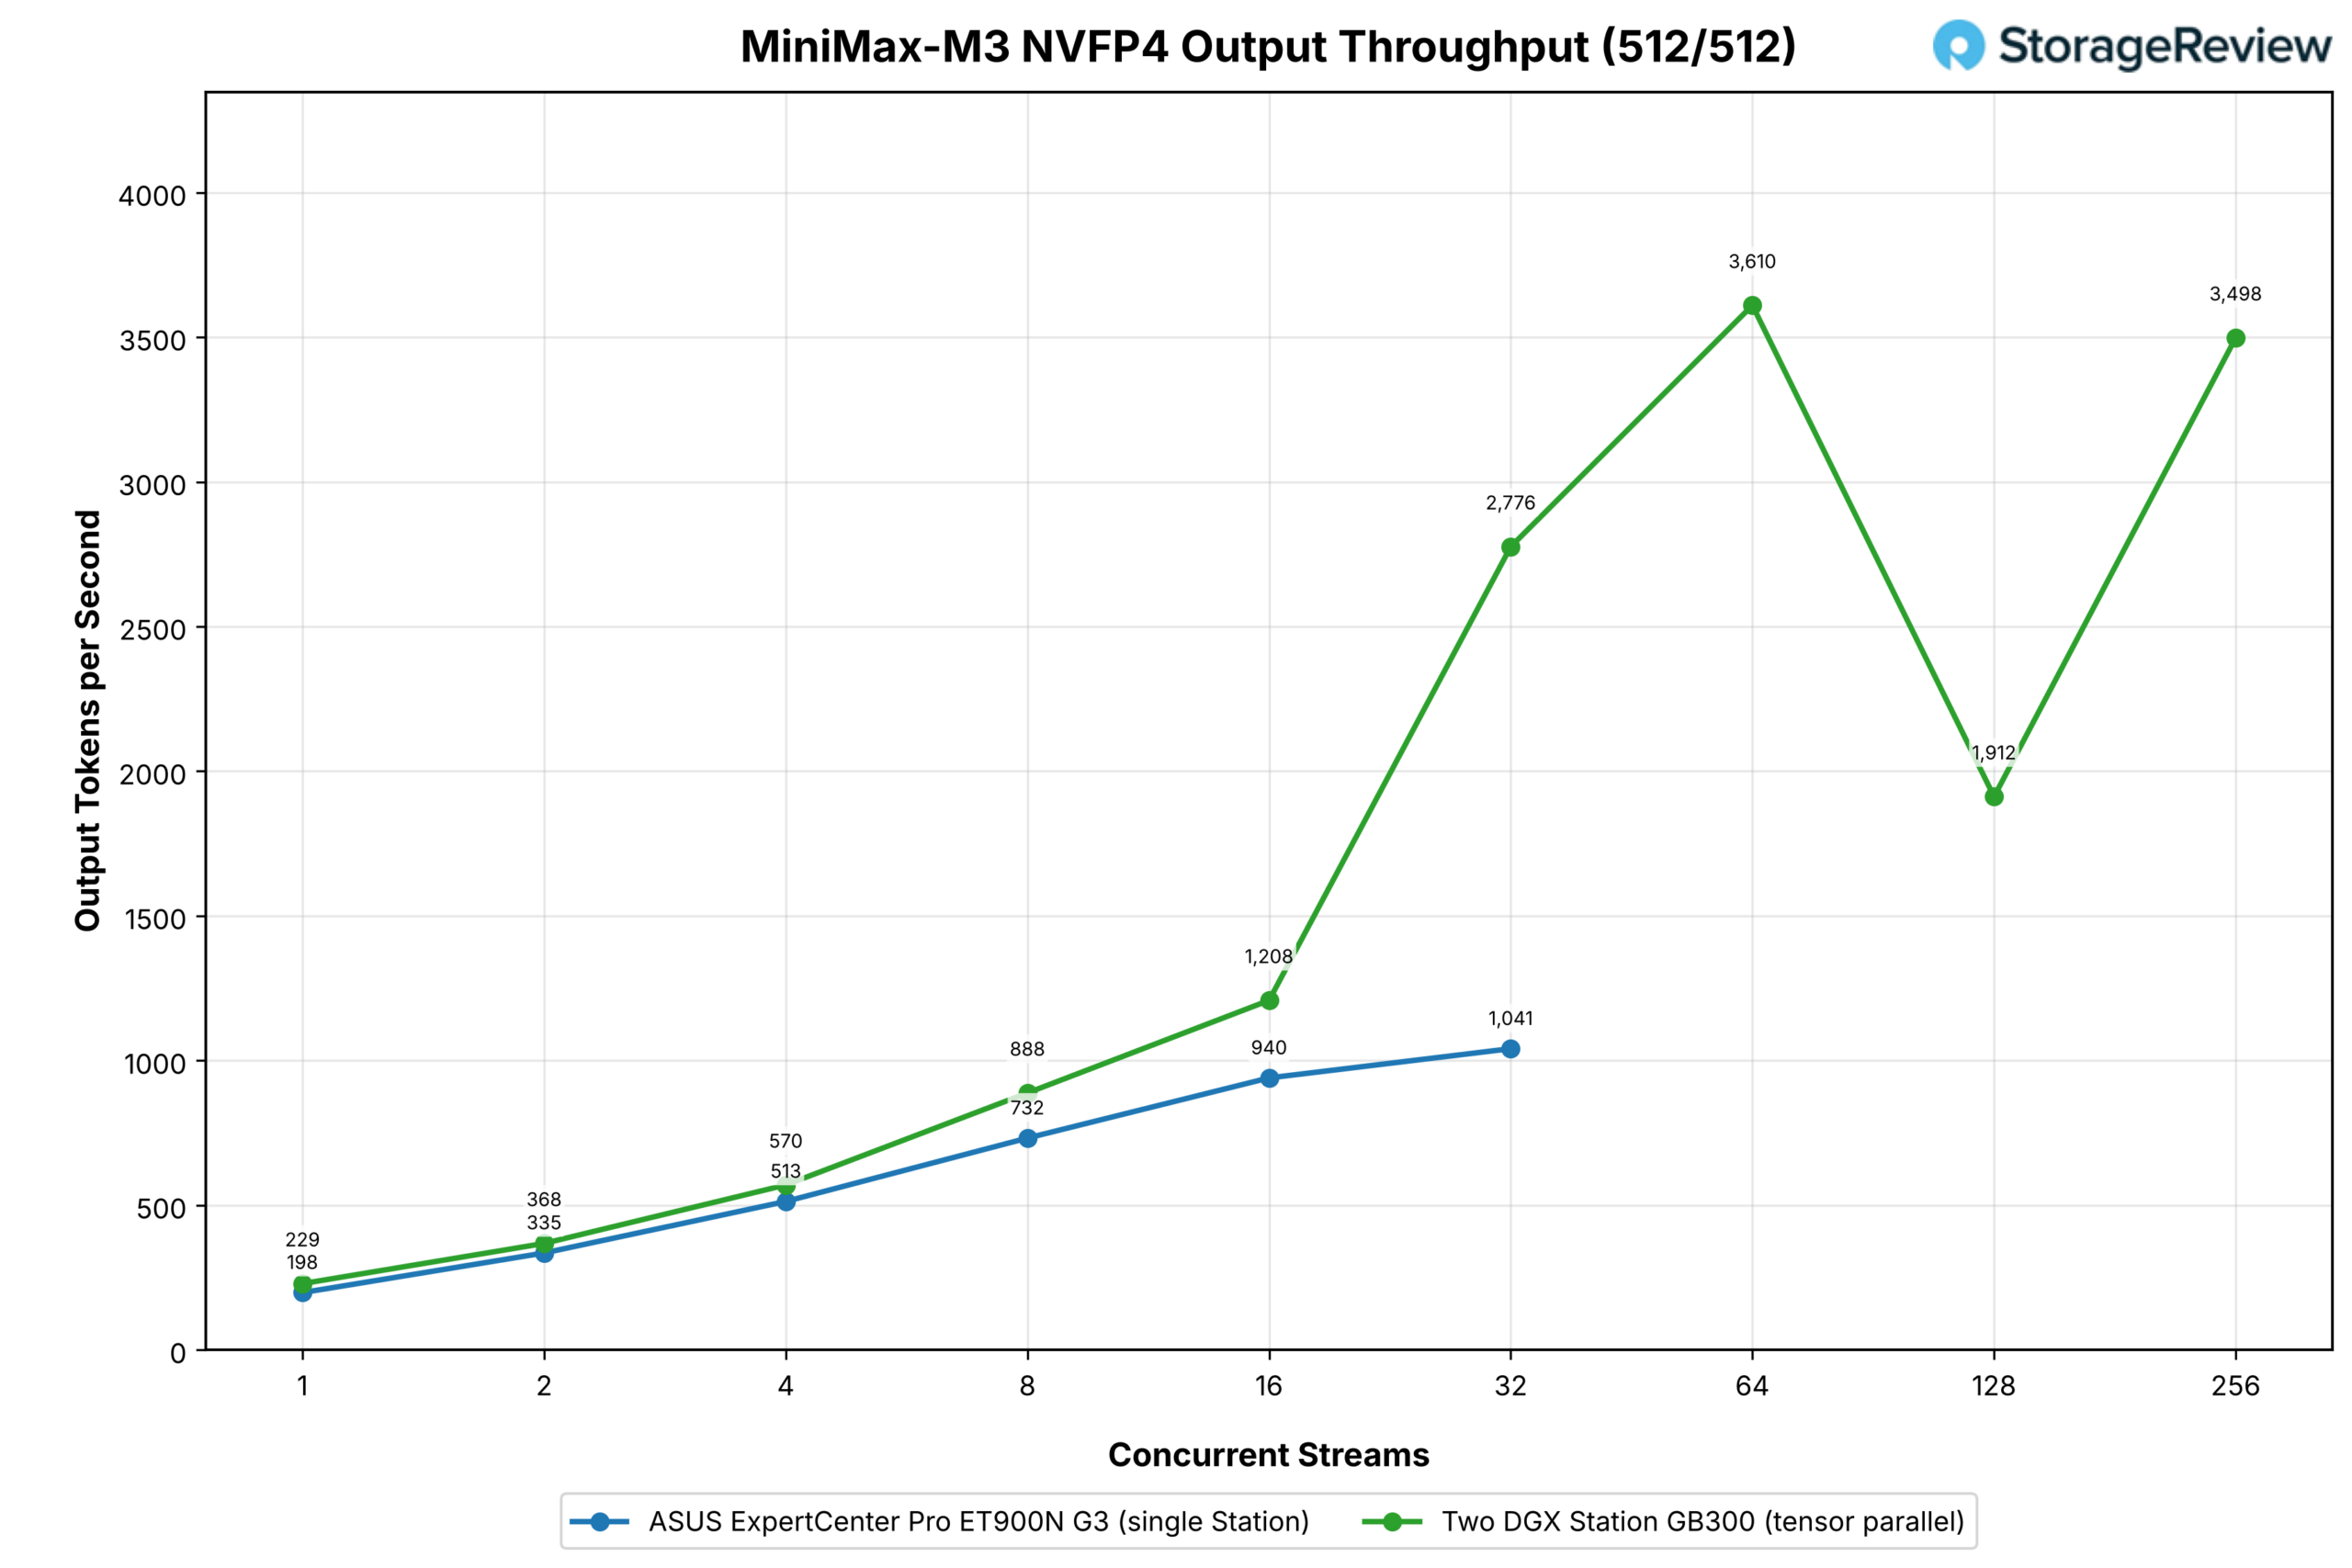
MiniMax-M3はTP2で動作し、Graceオフロードは使用していません。あるステーションでは、エキスパートの一部がGraceメモリに配置され、HBM境界ぎりぎりの位置にあります。ASUSのレビューでは、EAGLE3と同等のワークロードで、32ストリームで毎秒1,041個の出力トークンを達成しました。
クラスターは、16 ストリーム (940 に対して 1,208) で単一のステーションに非常に近い値を示し、その後、32 で 2,776 (単一のタワーの 2.7 倍)、64 で 3,610、128 で 1,912 に低下、256 で 3,498 と、引き離します。ここでは、1 つのステーションが既にこのモデルの大部分を HBM に保持しているため、2 つのステーションの追加は GLM-5.2 の場合よりも少なく、2 番目の GPU の貢献は、KV キャッシュの余裕が加わった単純な計算スケーリングに近くなります。
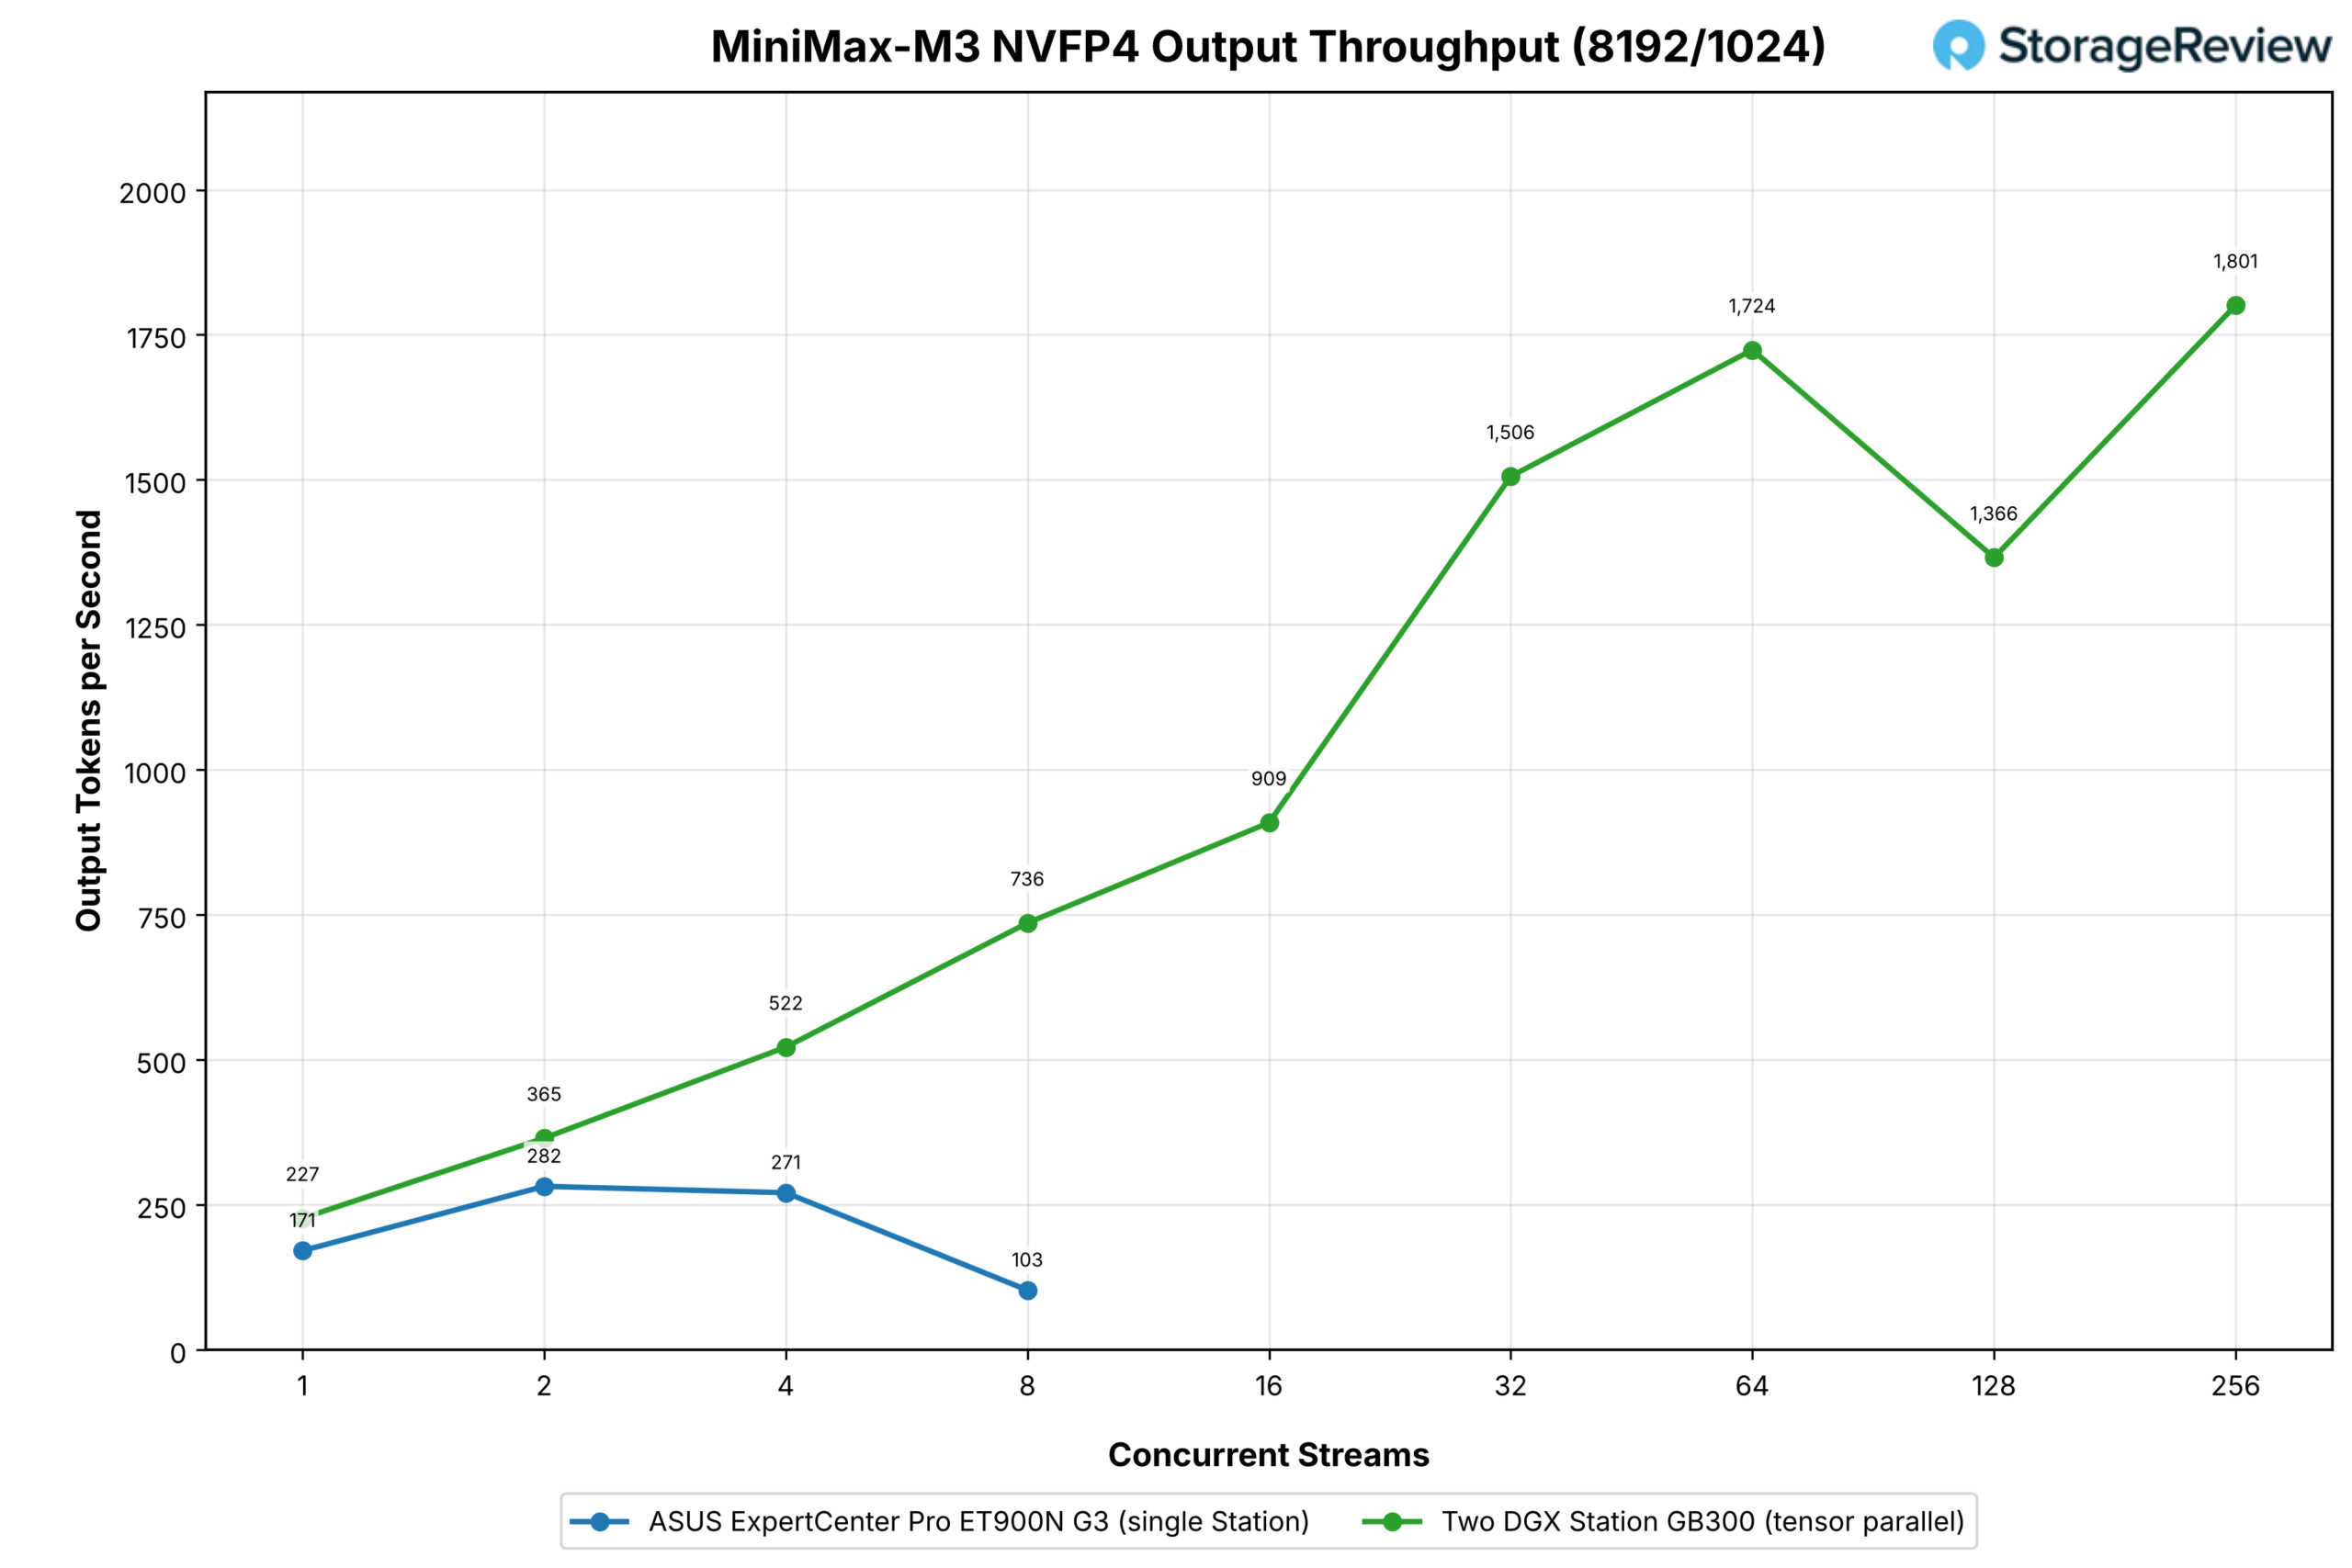
プリフィル処理が多いプロファイルでは、MiniMax-M3 は 1 つのステーションで容量不足に陥りました。8,192 トークンのプロンプトが残りの KV キャッシュを急速に消費するため、単一のタワーは 2 つのストリームで毎秒 282 個の出力トークンでピークに達し、4 つのストリームでは 271 個、8 つのストリームでは 103 個に低下し、測定するものがなくなったためスキャンは終了しました。
モデルを 2 つのステーションに分割すると、同じポイントは 365、522、736 となり、両方の構成でキャッシュに余裕がある 2 つのストリームでは 30% の増加、1 つの構成でキャッシュが不足している 8 つのストリームでは 7.1 倍の増加となります。その後、クラスターは 16 で 909、32 で 1,506、64 で 1,724、128 で 1,366、256 で 1,801 まで続き、このプロファイルでは単一のステーションでは全く到達できない範囲となります。
結論
ConnectX-8ポートを介してケーブル接続された2台のGB300 DGX Stationは、NVIDIAのドキュメントに記載されているとおりに動作します。セットアップは簡単で、これはデュアルシステム構成における最初のスループットデータです。
2 番目のステーションは、252 GB の HBM3e を超えるモデルでその価値を発揮します。GLM-5.2 は、1 つのステーションで 32 ストリームで毎秒 139 個の出力トークンから、2 つのステーションで 1,525 個、さらに 256 ストリームで 3,141 個に増加します。これは、分割によって 433 GB モデルが LPDDR5X から取り出されるためです。GLM-5.3 は、単一ステーションの上限 188 個から 256 ストリームで 5,018 個に達します。長いプロンプトの MiniMax-M3 は、8 ストリームで速度が低下するタワーから、256 ストリームでもまだ上昇し続けるペアに変わります。
1 つのステーションに収まる 2 つのモデル、GLM-5.3 Flash と DeepSeek V4.1 Flash では、2 つ目のボックスを使用するより良い方法は、各ステーションに完全なコピーを与え、プリフィルとデコードを分離し、デコード ワーカーが一時停止せずに生成できるようにすることです。GLM-5.3 Flash では、これにより 32 ストリームでのロング プロンプト スループットが 2 倍になり、ショート プロンプト スループットが 3 倍になりました。また、DeepSeek V4.1 Flash は、1 秒あたり 5,248 トークンという、このセットの中で最高の出力スループットを記録しました。
MSI XpertStation WS300のレビュー以来、この製品に対する私たちの見解は変わっていません。これは特定の市場向けの興味深いマシンであり、もしあなたがこのマシンを必要としているなら、もう1台必要になるかもしれません。
これらを運用する最良の方法は、代替可能なインフラストラクチャとして活用することです。つまり、チームが作業をスケジュールし、プロジェクトの変更に応じて再編成できるプールとして運用することです。そして、NVIDIAはそれを実現するための要素を所有しています。NVIDIAは、スケジューリングのためにRun:ai、開発者環境のためにBrev、コンピューティングマーケットプレイスのためにLeptonを買収しました。これら3つのいずれかをStationのラックと組み合わせることで、アクセス権があれば、製品の魅力はさらに高まります。
2台のボックス構成は優れたスケーリング性能を示しました。測定された中で最も大きなゲインはGLM-5.3で、1台のステーションでは毎秒188個の出力トークンだったものが、2台のステーションでは毎秒5,018個に増加しました(27倍のゲイン)。また、同時実行数を合わせたGLM-5.2では、32ストリームで11倍のゲインを達成しました。どちらのモデルも、1台のステーションでは重みをGraceメモリにスピルアウトすることによってのみ処理できるものです。これは2台の400GBに対して300GBの成果であり、NVIDIAが次世代のHBMとNVLink-C2Cを搭載したVera Rubin Stationを発売した際に、どのような性能を発揮するのか非常に興味深いところです。
この製品の立ち位置は変わっていません。ラックやデータセンターを必要とせず、デスク上に2台のステーションを設置するだけで、かつてGPUサーバーとその関連設備を導入する理由となっていたモデルに対応できます。そのため、データセンターのスロットを確保できない、あるいはスロット待ちをしたくないチームでも、すぐそばで最先端の推論処理を実現できる道が開かれます。NVIDIAはこのカテゴリーにおいて、価格面を抜きにしても、高い基準を打ち立てました。GB300クラスは、ローカルAI向けベストデスクトップランキングで上位にランクインしており、今回のクラスタデータもその評価を裏付けています。



 Amazon