

Intel Arc Pro B70は、Intelが出荷したデスクトップ向けAIカードの中で最も高性能で将来有望な製品ですが、同時に最も使いづらい製品でもあります。Intelは今年3月の発売時に、32GBのGDDR6搭載モデルを949ドルで販売しました。しかし、市場全体を圧迫しているメモリ不足により、このレビュー執筆時点では実売価格は1,100ドルを超えています。それでも、B70はNVIDIAのRTX Pro 4000よりも低価格です。RTX Pro 4000は、B70よりも3分の1少ない24GBのVRAMを搭載しているにもかかわらず、定価は高く、2,000ドルを超えています。1台のワークステーションまたはサーバーに4台のB70を搭載すれば、合計128GBのプールVRAMとなり、かつてははるかに高額な費用が必要だった同時実行数で1,200億パラメータの混合エキスパートモデルをホストするのに十分な容量となります。ハードウェアは印象的ですが、価格はさらに印象的です。昨年12月にプレビューしたB60と同じ問題が、このチップの足を引っ張っている。つまり、ソフトウェアがまだ完成していないのだ。そして、インテルは果たしていつかそこにたどり着けるのだろうか、と疑問に思わざるを得ない。
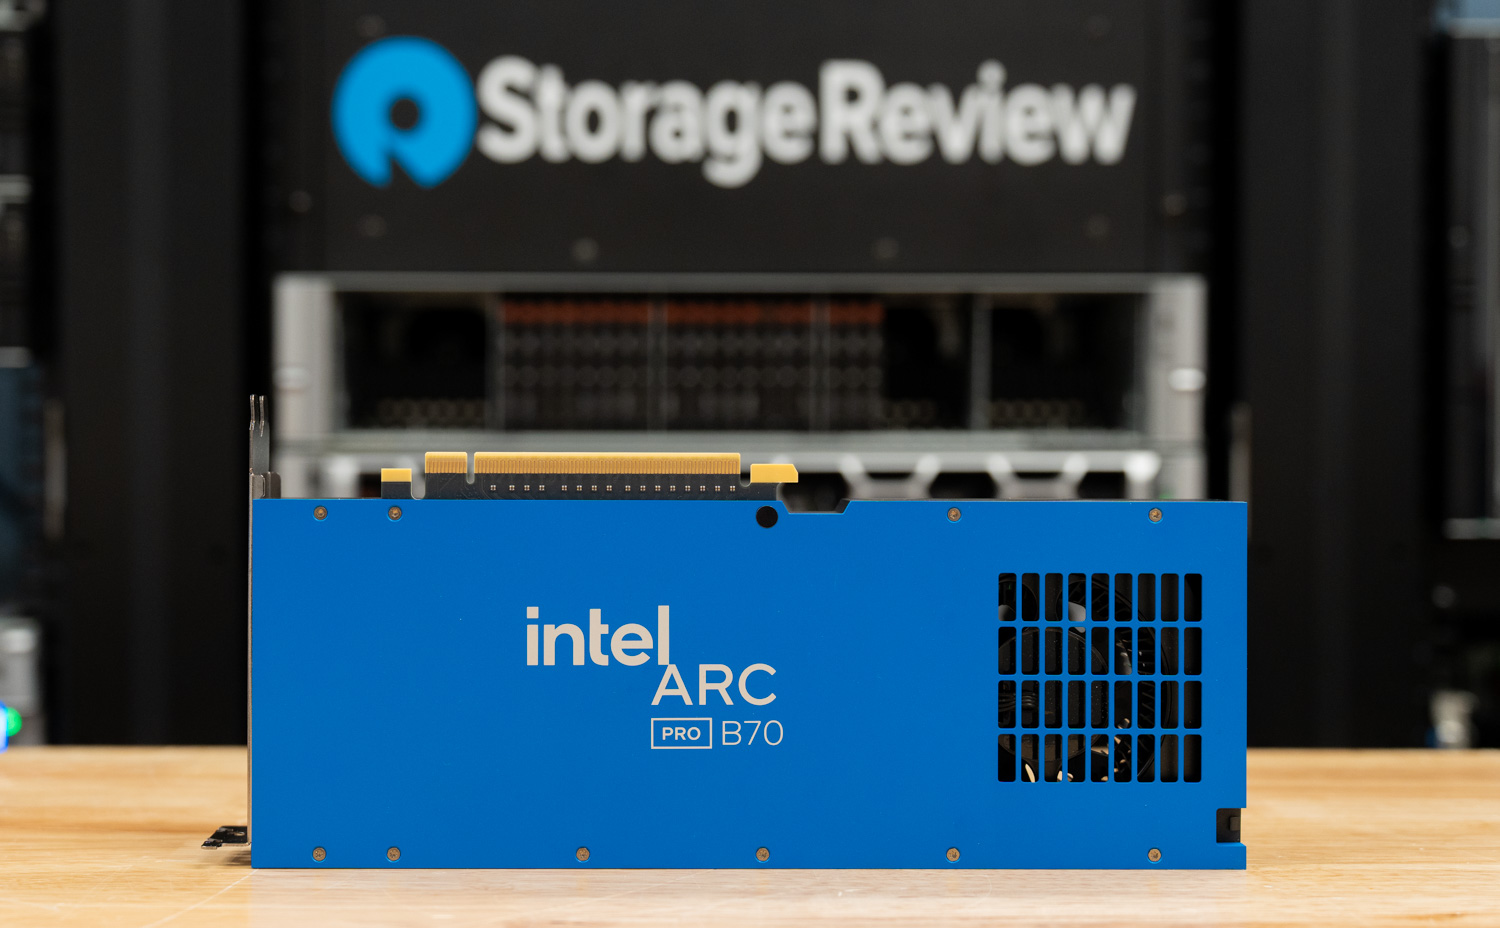
Intel では、これまでにも何度か同じようなことがありました。Arc Pro B60 Battlematrixを調べたときは、リリース前のスタックで待っている素晴らしいシリコンの話でしたが、B70 はその両方の要素を受け継いでいます。このカードは、32 個の Xe2 コア、256 個の XMX エンジン、367 個の INT8 TOPS を備えた、より大きな BMG-G31 ダイをベースにしています。608 GB/s の 256 ビットバスで供給され、160W から 290W まで構成可能です。B60 と比較すると、Intel はワークステーションのワークロード全体で平均 44%、プロフェッショナル アプリケーションでは最大 69% の世代的向上を実現しています。導入時に知っておくべき注意点が 1 つあります。B60 はスロットを x8/x8 に分割するデュアル GPU カードとして出荷されましたが、B70 はカードごとに 1 つの GPU で、フル PCIe 5.0 x16 レーンが必要となるため、4 枚のカード シャーシへの取り付け方法が変わります。
Intelのマーケティングは完全にローカル推論に重点を置いており、比較対象として選んだのはNVIDIAのRTX Pro 4000 24GBです。Intel独自のLinux数値によると、B70の32GBはメモリ不足になる前に約93KのKVキャッシュトークンを保持し、RTX Pro 4000の42Kに対して、同時ユーザー数の増加に伴ってトークンスループットが最大85%向上し、負荷がかかった状態での最初のトークンまでの時間で最大6.2倍速く応答し、1ドルあたりのトークン数が最大2倍になります。これらはIntelの数値で、BF16の小型Llama 3.1 8Bでシングルカードの場合です。B70についてはもう少し負荷をかけます。1ドルあたりのトークン数は発売時の定価を主張していますが、現在の価格では、Intel有利の差は維持されるか、さらに広がります。
ベンチマークに入る前に、このトレードオフが重要である理由を説明しましょう。なぜなら、このトレードオフによって、今日このカードを購入すべき人が決まるからです。IntelのLLM Scalerは、vLLMのBattlemage対応開発ブランチですが、私たちの見解では、せいぜいベータ版リリースです。モデルのカバー範囲は限られており、動作するはずの量子化パスのいくつかはまだ動作しておらず、スタックがハードウェアの機能を制限しています。Dell PowerEdge XE7740のIntel Gaudi 3でも同じ問題が見られました。ソフトFP8の結果は、シリコンではなく、IntelのvLLMフォークの未成熟なコードパスに起因していました。B70も同じ状況です。ここでIntelは決断を下し、これまで以上に積極的にその決断を貫く必要があります。
NVIDIAの強みはCUDAだけではありません。モデルをデプロイする際に本当に重要なのは、ドキュメント、サンプル、動作するコンテナ、フォーラムでの回答、そしてほとんどの問題が解決されている豊富なコミュニティ履歴といった、地味ながらも重要な部分です。AMDもROCmを同じ方向に推し進めてきました。IntelもArc Proに関して同じレベルの取り組みをしなければ、B70は愛好家には魅力的に映るものの、チームが採用に苦労するカードになってしまうリスクがあります。
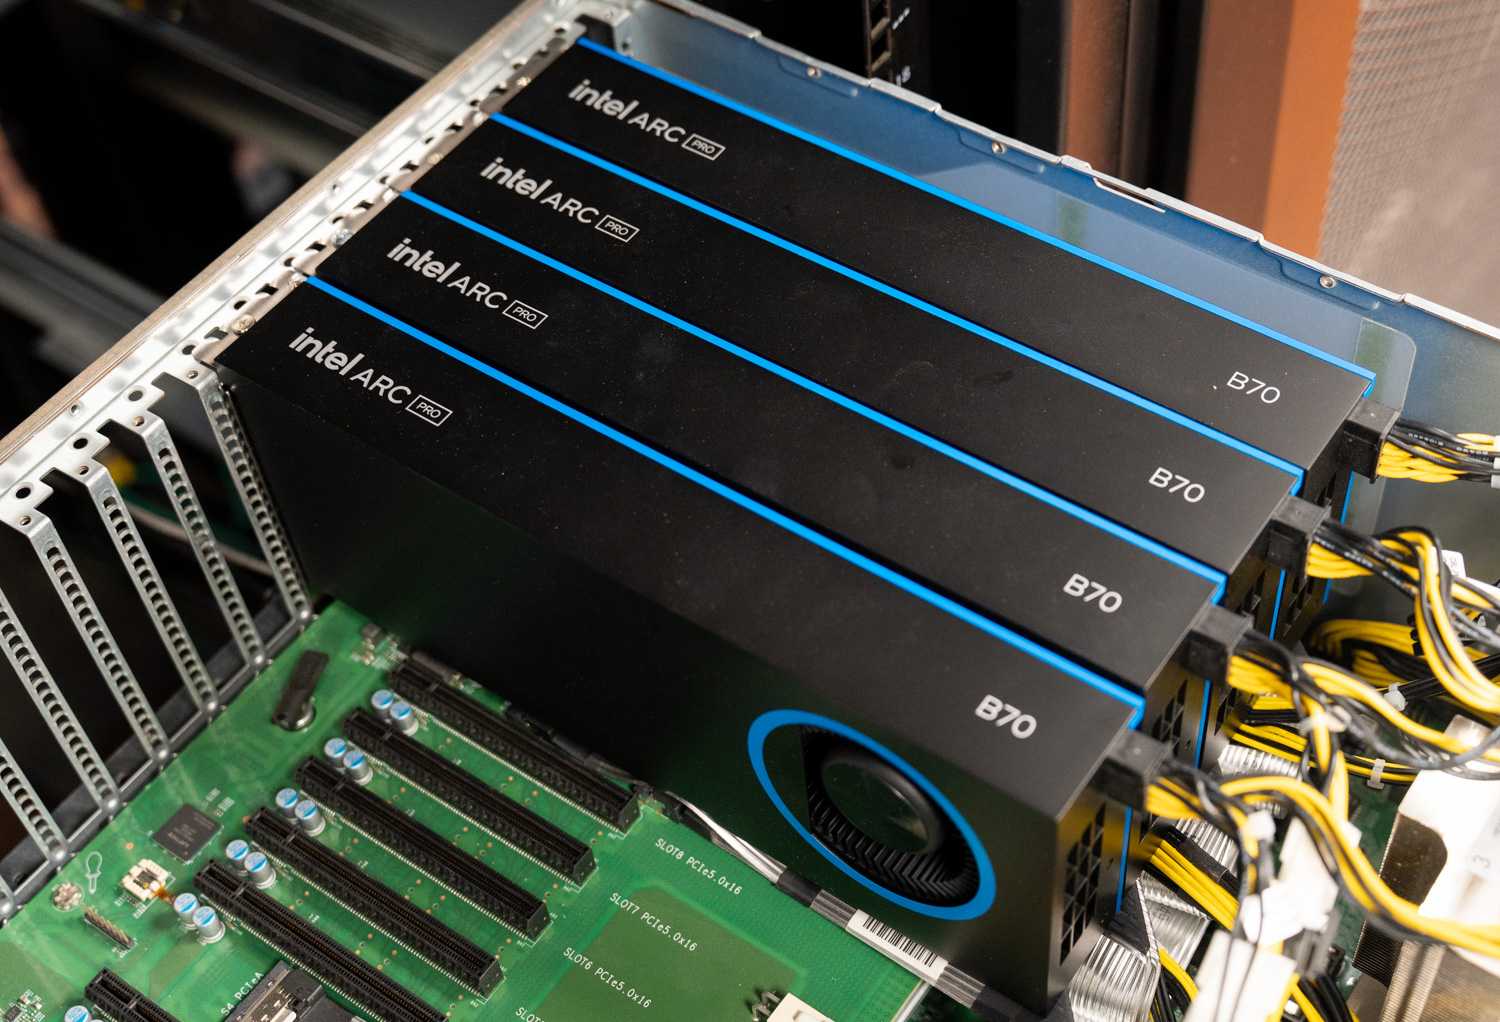
今回のレビューでは、比較を公平にするため、プラットフォームをB60の時と全く同じにしました。Supermicro AS-4125GS-TNRTにAMD EPYC 9374Fプロセッサと512GBのDDR5メモリを搭載し、vLLM環境下で4枚のB70(128GB)と4枚のB60(96GB)を比較しました。B60と同様、これはIntelのオールIntel Battlematrixリファレンスではありません。Battlematrixリファレンスでは、これらのカードはXeon 6ホストと組み合わせて使用されます。Intel製シリコンを使用した製品版システムでは、動作が異なる場合があります。以下に示す内容は、同一ベンチマーク上での世代間および価値の比較であり、ソフトウェアの成熟度が結果に影響します。
Intel Arc Pro B70 の仕様
| 製品仕様 | インテル アーク プロ B70 |
|---|---|
| 全般 | |
| 製品ファミリ | インテル Arc Pro Bシリーズ グラフィックス |
| モデル | インテル アーク プロ B70 |
| コード名 | バトルメイジ |
| マイクロアーキテクチャ | Xe2 |
| プロセス技術 | TSMC N5 |
| 打ち上げ日 | 1 Q2026 |
| 保証 | 3年間 |
| GPUの仕様 | |
| Xeコア | 32 |
| スライスをレンダリングする | 8 |
| レイ トレーシング ユニット | 32 |
| インテルXMXエンジン | 256 |
| Xeベクターエンジン | 256 |
| グラフィッククロック | 2280 MHz |
| 最大ダイナミッククロック | 2800 MHz |
| FP32のパフォーマンス | 22.94 TFLOPS |
| INT8 AIパフォーマンス | 367トップス |
| 総ボード電力 (TBP) | 230W(設定可能:160~290W) |
| PCIExpressインターフェイス | PCIe 5.0 x16 |
| メモリ | |
| メモリ容量 | 32GB GDDR6 |
| メモリーバス | 256ビット |
| メモリ帯域幅 | 608 GB / sの |
| ECCメモリ | サポート |
| ディスプレイとI/O | |
| 出力を表示する | DisplayPort 2.1 |
| 最大ディスプレイ数 | 4 |
| 最高分解能 | 7680 × 4320 @ 120Hz (HDMI / DisplayPort) |
| 可変リフレッシュレート | HDMI VRR、VESA Adaptive Sync |
| 機能とソフトウェア | |
| ビデオエンコード/デコード | H.264、H.265(HEVC)、AV1 |
| レイトレーシング | サポート |
| AI フレームワーク | oneAPI、OpenVINO、Intel Extension for PyTorch (IPEX) |
| グラフィックス API | DirectX 12 Ultimate、Vulkan 1.3、OpenGL 4.6、OpenCL 3.0 |
| インテル XeSS | サポート |
| HDRサポート | HDR10、HDR10+ゲーミング、ドルビービジョン |
| マルチフォーマットコーデックエンジン | 2 |
| 物理的仕様 | |
| 寸法 | 10.5×3.9インチ |
| スロット幅 | デュアルスロット |
| 重量 | 1020g |
| 電源コネクタ | 1 × 8ピン(ATX 2×4) |
Intel Arc Pro B70 の構築と設計
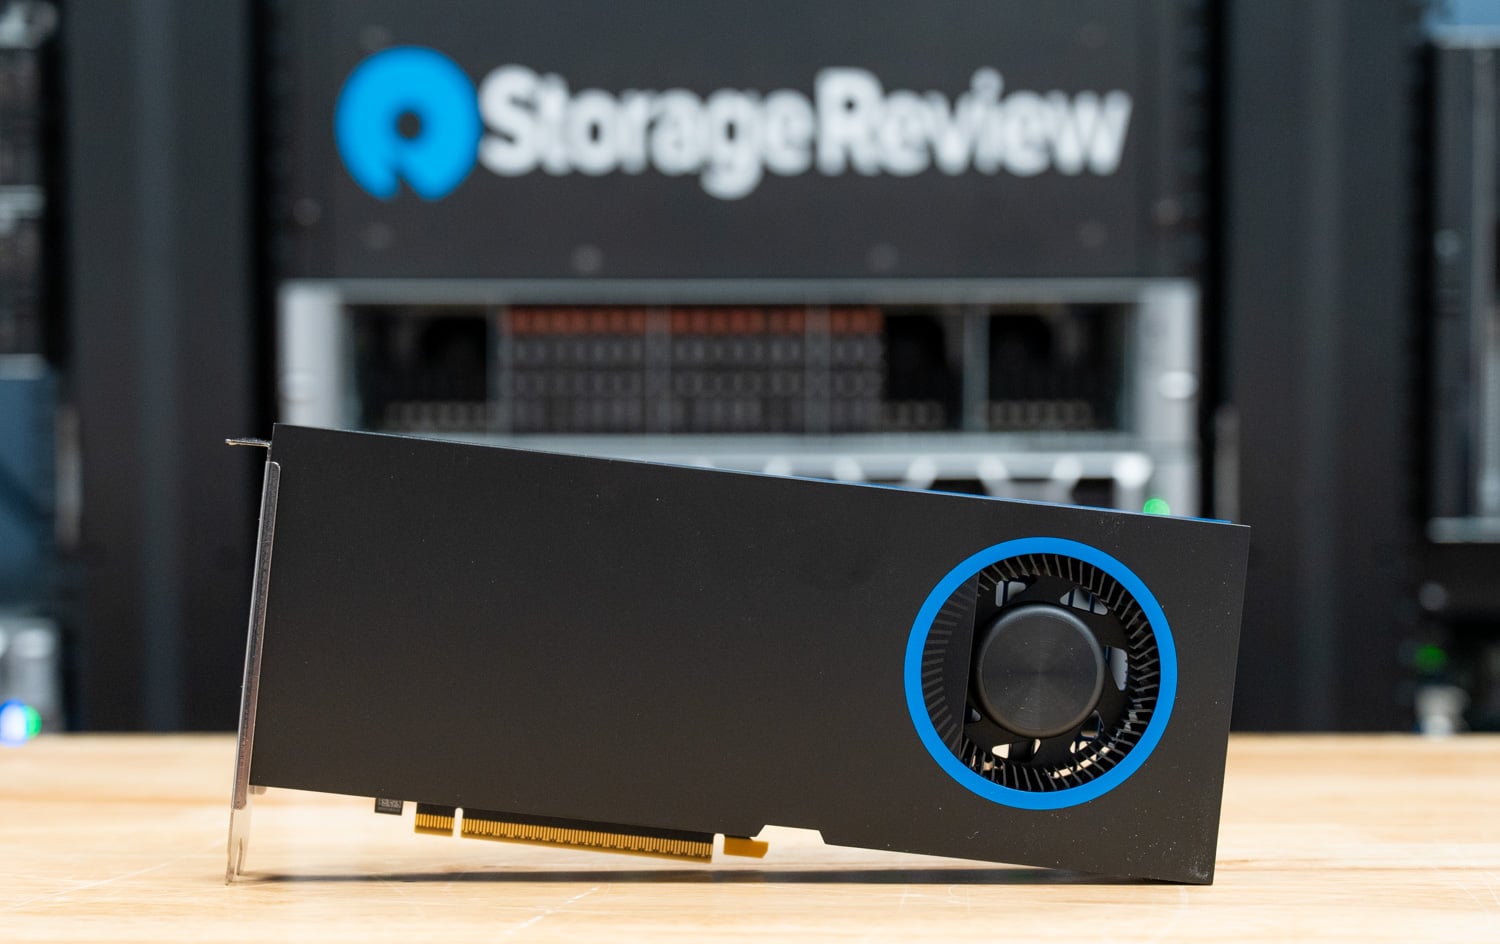
インテル Arc Pro B70は、サイズが10.5 × 3.9インチ(267 × 99 mm)、重量が2.25ポンドで、すっきりとした控えめな外観のコンパクトなデュアルスロット設計を採用しています。カードはマットブラック仕上げで、インテルの象徴であるブルーのアクセントが施されています。また、剛性を高め、インテルのブランドイメージにマッチする、全長にわたる陽極酸化アルミニウム製バックプレートが付属しています。
このカードは、ヒートシンクを通して空気を吸い込み、背面I/Oブラケットから直接排気するブロワー式ファンを1基搭載しています。この密閉型冷却設計により、カードの設置面積をコンパクトに保ち、システム全体の空気の流れをスムーズに保ちます。
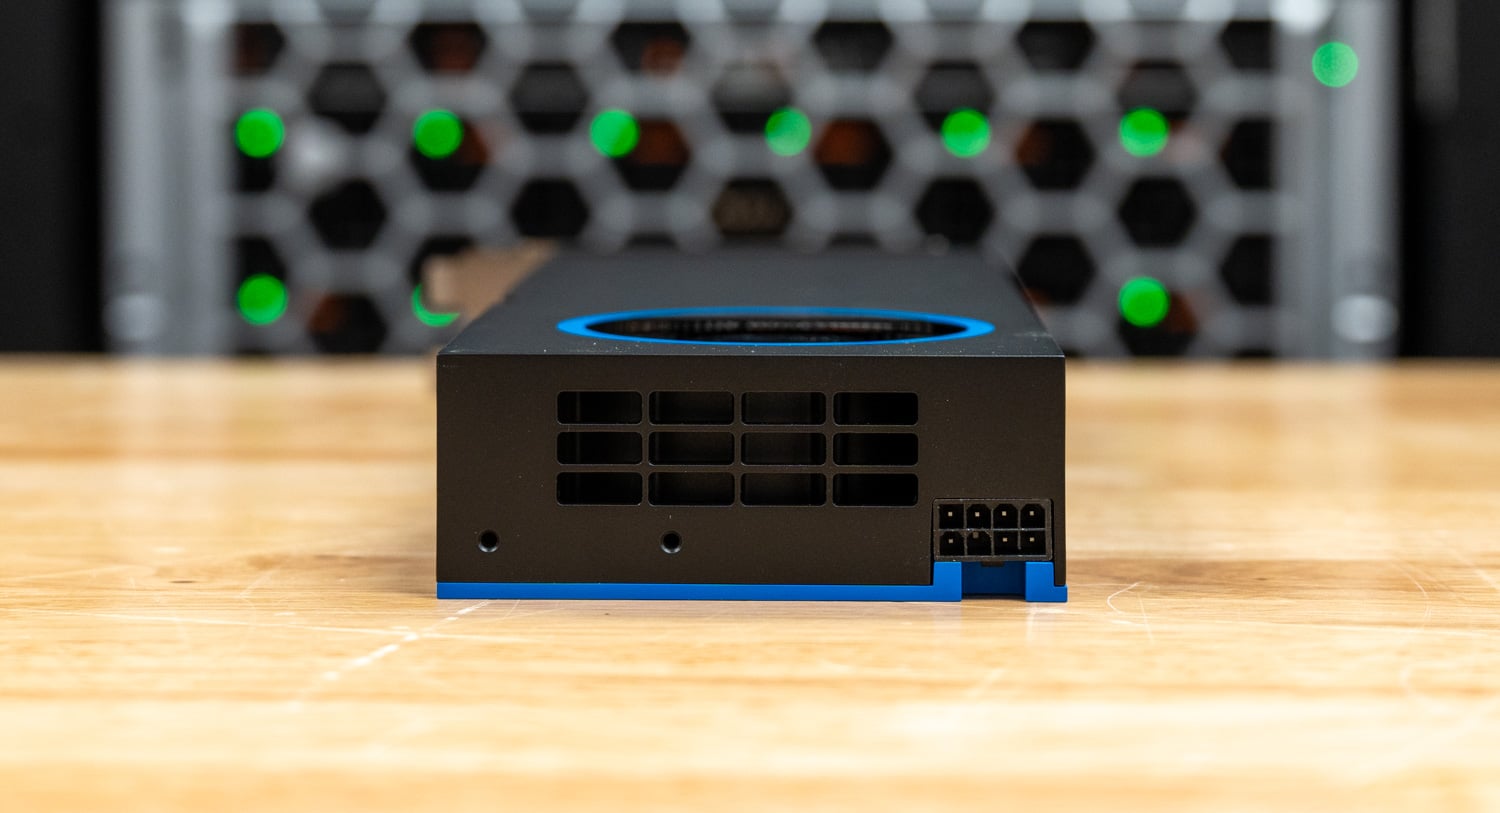
カード背面、PCIeブラケットの反対側には、外部電源供給用の8ピン(2×4)PCIe電源コネクタが1つ搭載されています。このシュラウドの端には、ブロワーファンに新鮮な空気を送り込むための吸気口が複数設けられており、ワークステーションへの設置時の安定性を向上させるためのオプションのGPUサポートブラケットを取り付けるためのネジ穴も備えています。
Arc Pro B70は、底面エッジに沿ってホスト接続用の標準的なPCIe 5.0 x16インターフェースを採用しています。この角度から見ると、カードがデュアルスロット形状であることが分かります。これにより、内蔵ブロワー冷却ソリューションのための十分なスペースが確保されつつ、高密度なワークステーションやサーバーへの設置にも適したコンパクトさを実現しています。
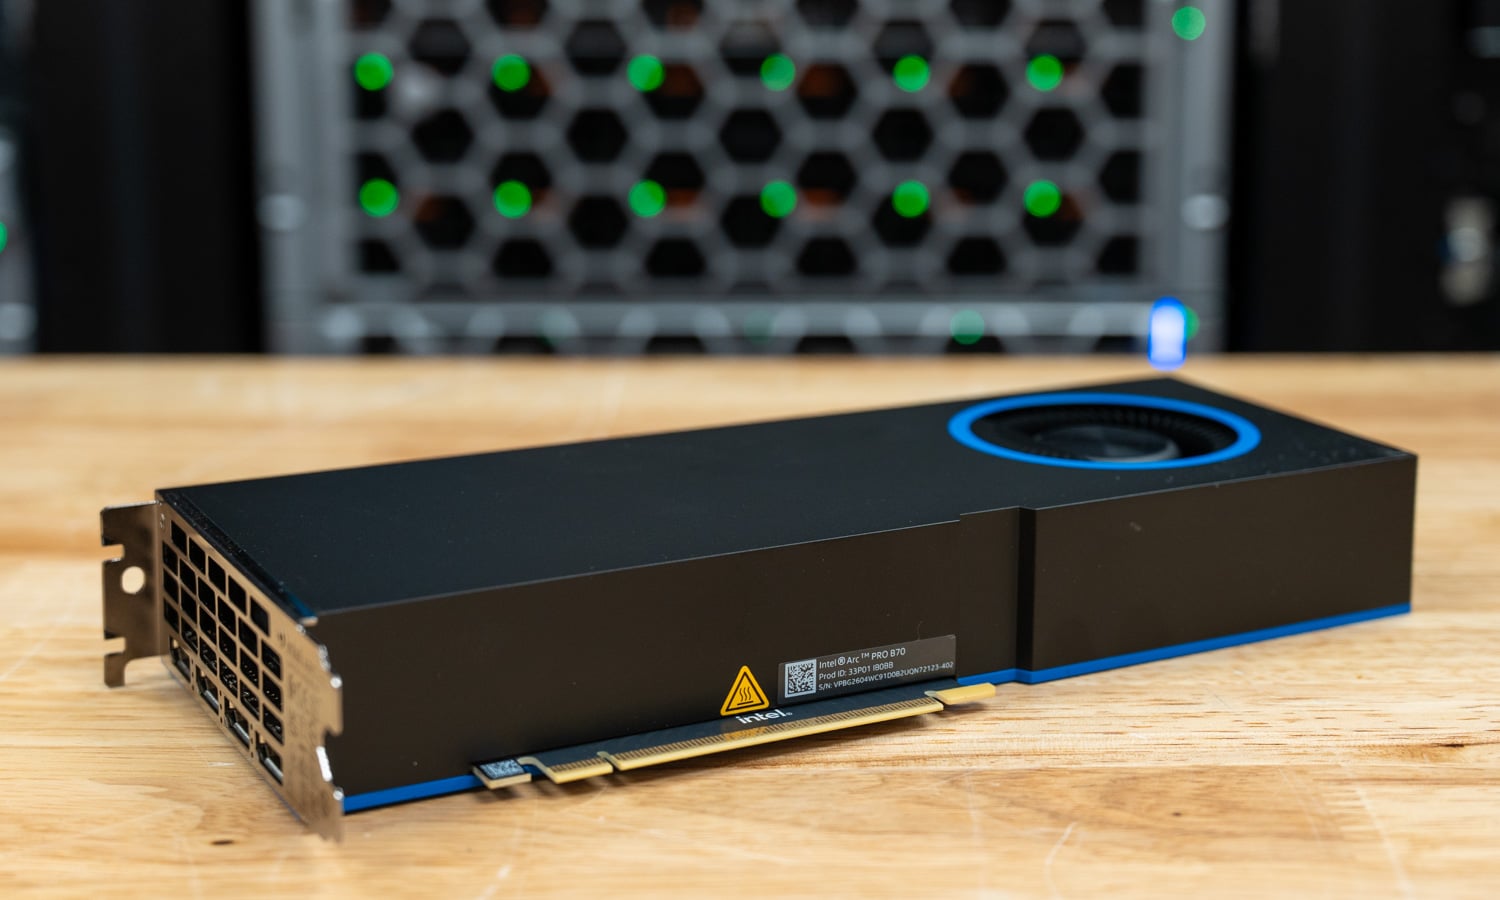
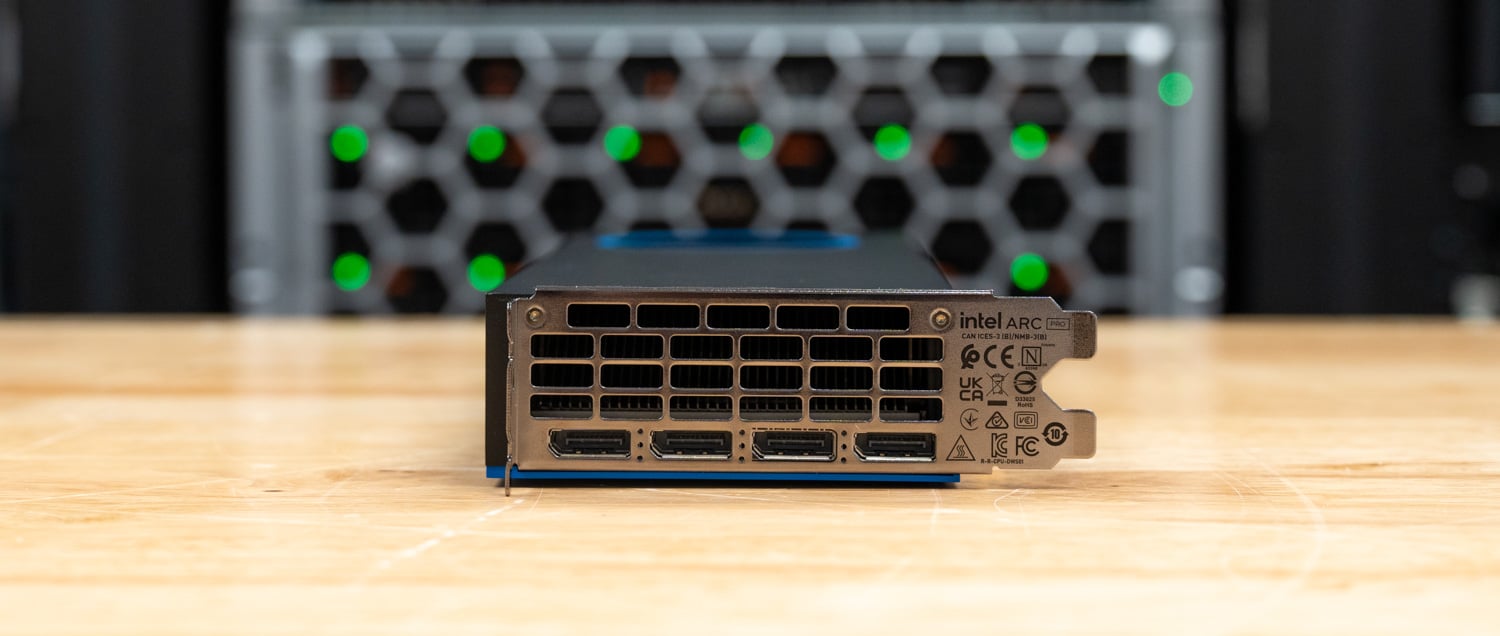
I/Oブラケットには、ブロワーファンがシャーシから直接熱気を排出できる大型の通気口が設けられています。排気口の下には4つのDisplayPort 2.1出力端子があり、それぞれ最大7680×4320(8K)解像度、120Hzのリフレッシュレートに対応したディスプレイを駆動できるため、高解像度マルチモニターワークステーション環境に十分な帯域幅を提供します。
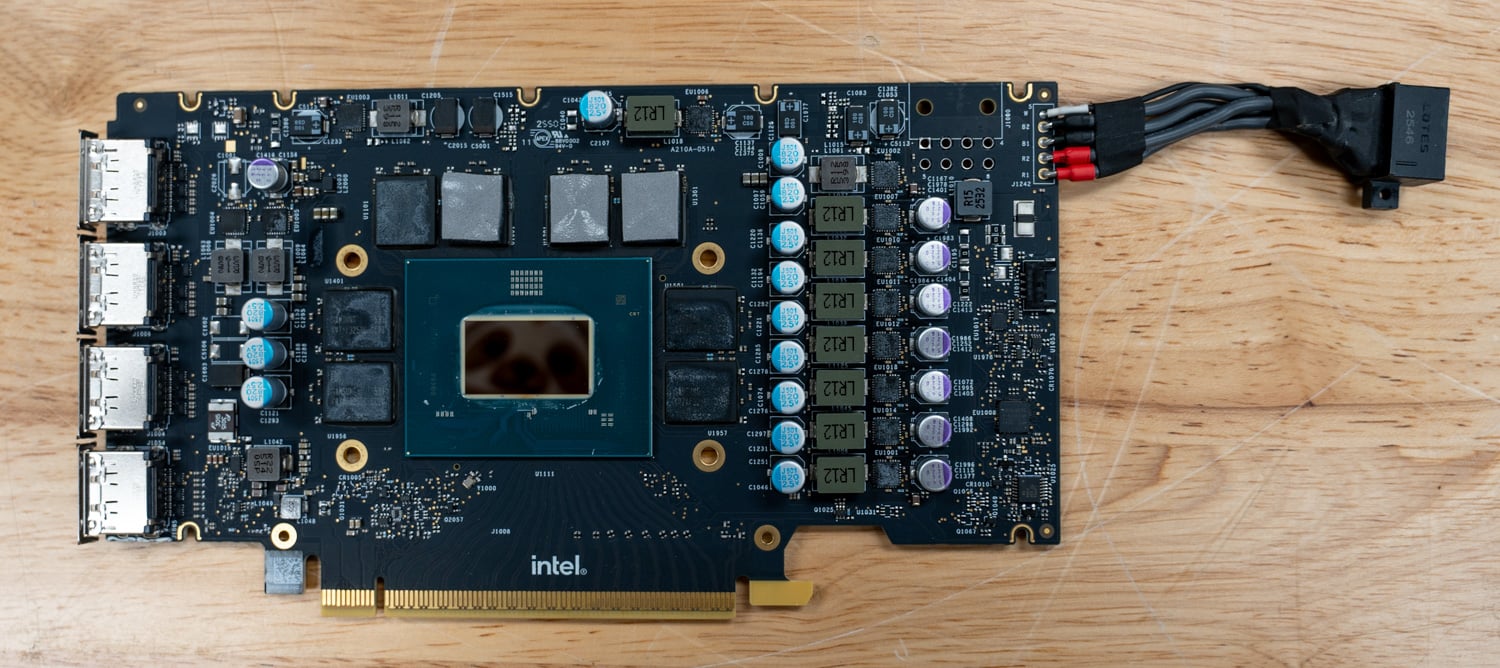
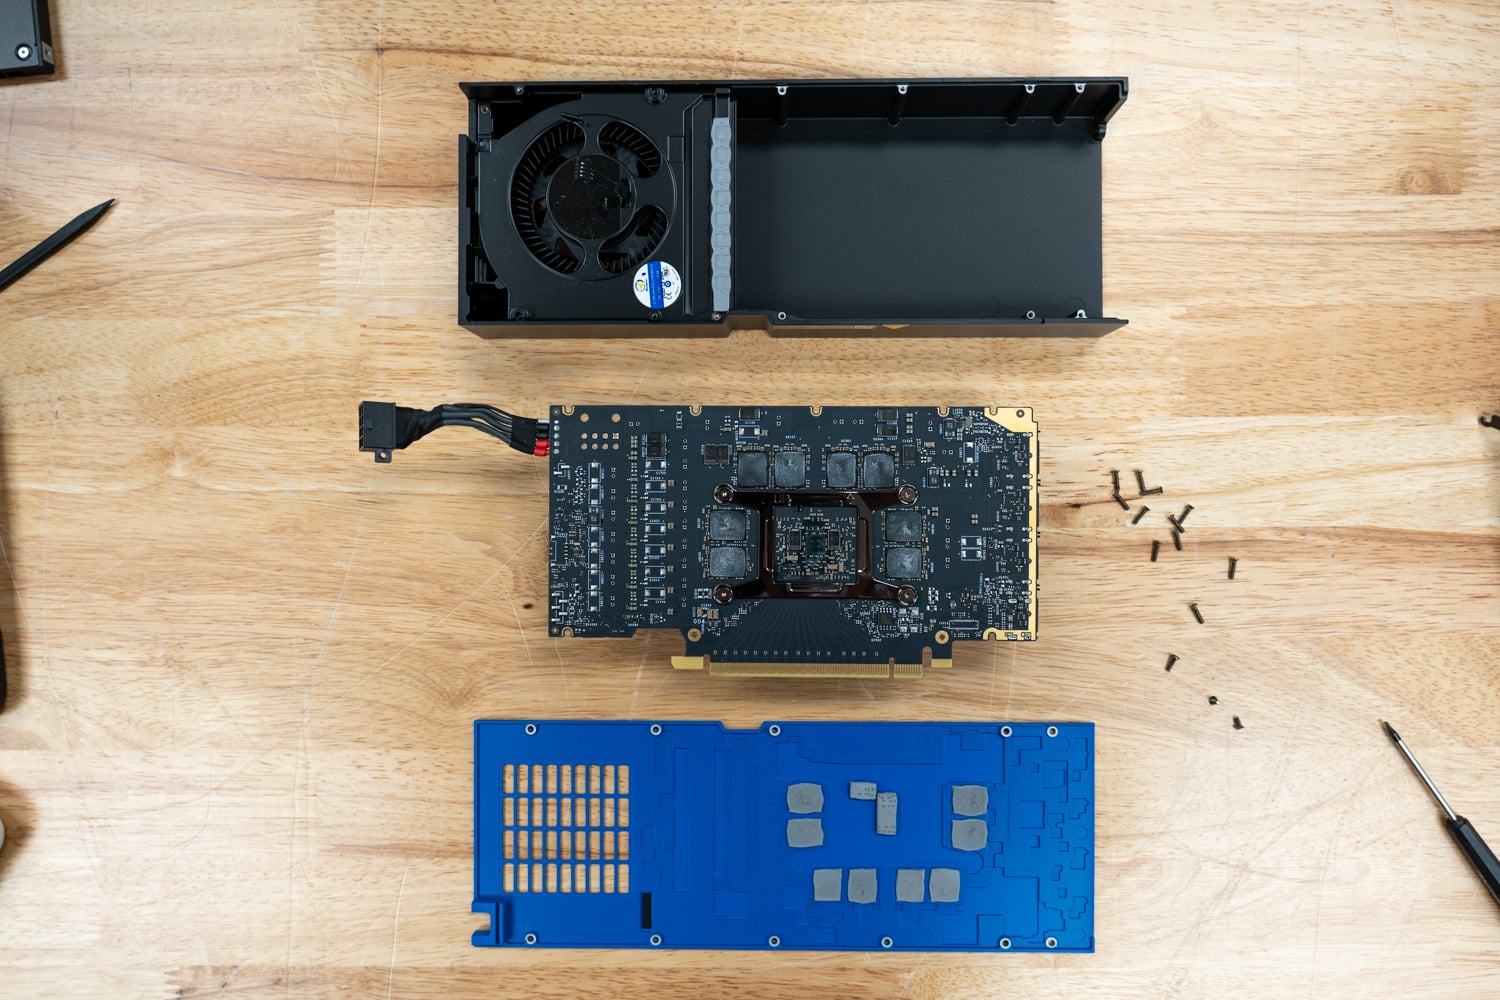
クーラーを取り外すと、Arc Pro B70のPCBには、カードの主要コンポーネントが露出します。中央には、Intelの32コアXe2-HPG GPUが配置され、その周囲には、最大608GB/sのメモリ帯域幅を提供する256ビットのメモリインターフェイスを介して接続された32GBの専用GDDR6メモリが搭載されています。このGPUには、最大367INT8 TOPSのAI演算性能を提供する256個のXMX AIエンジンと、ハードウェアアクセラレーションによるレイトレーシングワークロード用の32個の専用レイトレーシングユニットも統合されています。GPUの周囲には、カードの設計を支える電源供給ステージ、メモリ回路、およびディスプレイ出力コンポーネントが配置されています。
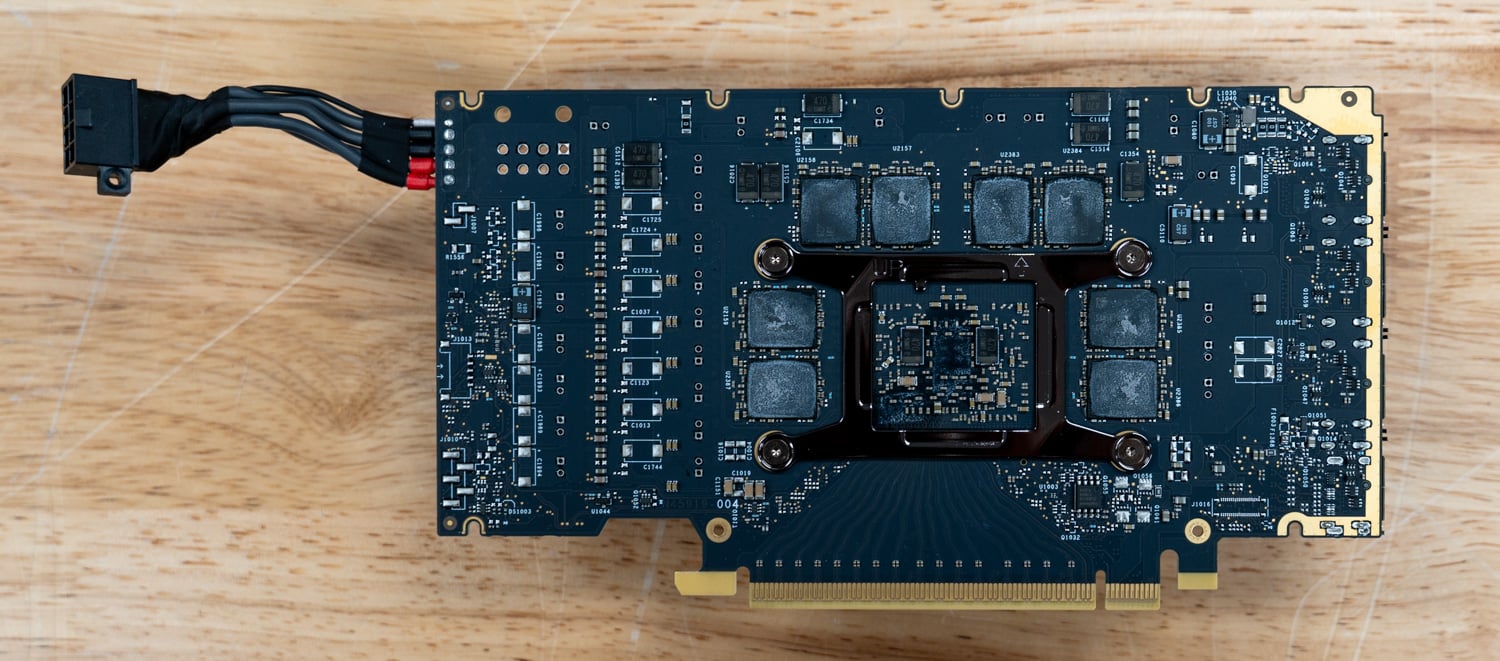
PCBの背面には、GDDR6メモリパッケージとカードの電源供給回路の一部が露出しています。GPUパッケージを囲む大きな保持ブラケットは、ヒートシンクからの取り付け圧力を均等に分散するのに役立ちます。8ピンPCIe電源コネクタは、カードに外部電源を供給します。PCIeスロット経由で電源が供給されるため、Arc Pro B70は最大230Wのボード電力に対応しています。
Intel Arc Pro B70 パフォーマンス テスト
Windowsテスト – StorageReview AMD Threadripperテストプラットフォーム
今回、Intel Arc Pro B70単体のテストに使用するテストプラットフォームは以下のとおりです。
- マザーボード: ASUS Pro WS TRX50-SAGE WIFI
- CPU: AMD Ryzen Threadripper 7980X 64コア
- RAM: 128GB DDR5 4800MT/秒
- ストレージ: 2TB サムスン 980 プロ
- OSの: ワークステーション用のWindows11 Pro
同等のGPUをテスト済み
- インテル アーク プロ B50
- インテル アーク プロ B70
- AMD Radeon RX 9060 XT
- AMDのRadeon RX 9070
- AMD Radeon RX 9070 XT
- NVIDIA GeForce RTX 5060 Ti
- NVIDIA GeForce RTX 5070FE
UL Procyon: AIテキスト生成
Procyon AIテキスト生成ベンチマークは、簡潔かつ一貫性のある評価方法により、AI LLMのパフォーマンステストを効率化します。複数のLLMモデルにわたる繰り返しテストを可能にしながら、大規模モデルの複雑さや変動要因の影響を最小限に抑えます。AIハードウェアのリーディングカンパニーと共同開発されたこのベンチマークは、ローカルAIアクセラレータの利用を最適化し、より信頼性が高く効率的なパフォーマンス評価を実現します。以下の結果は、NVIDIAモデルではTensorRT、AMDモデルではONNXを使用して測定されました。
Arc Pro B70は、比較対象の中で最も大きな世代間改善を実現しており、Phi、Mistral、Llama 3モデル全体でB50と比較して総合スコアを60%向上させ、最初のトークンまでの時間を40~45%短縮しています。AMDとの比較では、B70はPhiでRadeon RX 9060 XTより224%高いスコア(4,152対1,281)、Mistralで220%高いスコア(4,082対1,274)、Llama 3で250%高いスコア(4,029対1,150)を記録しています。Radeon RX 9070 XTと比較すると、Intelはそれぞれ100%、83%、95%の優位性を維持しています。 NVIDIAは差を縮め、RTX 5060 TiはPhiとMistralでそれぞれB70に45%差で劣る一方、RTX 5070は同じモデルで15~20%差で劣る。際立った結果はLlama 2で、B70は比較全体で最高のスコア5,769を記録し、RTX 5070を85%、RX 9070 XTを151%上回った。
| UL Procyon: AIテキスト生成 | インテル アーク プロ B50 | インテル アーク プロ B70 | AMD Radeon RX 9060 XT | AMDのRadeon RX 9070 | AMD Radeon RX 9070 XT | NVIDIA GeForce RTX 5060 Ti | NVIDIA GeForce RTX 5070FE |
|---|---|---|---|---|---|---|---|
| ファイ総合スコア | 2,593 | 4,152 | 1,281 | 1,933 | 2,080 | 2,870 | 3,453 |
| 最初のトークンまでの Phi 出力時間 | 0.275秒 | 0.155秒 | 1.473秒 | 0.954秒 | 0.855秒 | 0.375秒 | 0.323秒 |
| Phi 出力トークン数/秒 | 72.128 トークン/秒 | 104.121 トークン/秒 | 94.453 トークン/秒 | 139.187 トークン/秒 | 144.471 トークン/秒 | 120.773 トークン/秒 | 150.435 トークン/秒 |
| Phi 全体期間 | 39.179秒 | 37.924秒 | 39.365秒 | 26.989秒 | 25.587秒 | 25.216秒 | 20.302秒 |
| ミストラル総合スコア | 2,483 | 4,082 | 1,274 | 2,040 | 2,231 | 2,807 | 3,562 |
| ミストラルの最初のトークン出力時間 | 0.346秒 | 0.180秒 | 1.827秒 | 1.109秒 | 0.946秒 | 0.526秒 | 0.433秒 |
| ミストラル出力トークン数/秒 | 46.799 トークン/秒 | 65.834 トークン/秒 | 65.115 トークン/秒 | 101.300 トークン/秒 | 103.348 トークン/秒 | 91.057 トークン/秒 | 120.507 トークン/秒 |
| ミストラル全体の所要時間 | 59.907秒 | 58.976秒 | 54.516秒 | 34.960秒 | 33.350秒 | 33.377秒 | 25.496秒 |
| ラマ3 総合スコア | 2,427 | 4,029 | 1,150 | 1,904 | 2,070 | 2,599 | 3,125 |
| Llama3 最初のトークンまでの時間の出力 | 0.311秒 | 0.166秒 | 1.632秒 | 0.981秒 | 0.845秒 | 0.449秒 | 0.379秒 |
| Llama3 出力トークン数/秒 | 45.031 トークン/秒 | 66.340 トークン/秒 | 53.167 トークン/秒 | 87.594 トークン/秒 | 89.102 トークン/秒 | 74.709 トークン/秒 | 100.388 トークン/秒 |
| Llama3 全体の所要時間 | 61.926秒 | 53.687秒 | 62.563秒 | 38.273秒 | 36.742秒 | 39.489秒 | 29.720秒 |
| ラマ2 総合スコア | – | 5,769 | 1,252 | 2,047 | 2,298 | 2,576 | 3,125 |
| Llama2 最初のトークンまでの時間の出力 | – | 0.259秒 | 2.992秒 | 1.926秒 | 1.565秒 | 0.844秒 | 0.785秒 |
| Llama2 出力トークン数/秒 | – | 63.666 トークン/秒 | 34.654 トークン/秒 | 59.673 トークン/秒 | 61.127 トークン/秒 | 41.386 トークン/秒 | 56.647 トークン/秒 |
| Llama2 全体の所要時間 | – | 44.131秒 | 99.027秒 | 59.100秒 | 55.520秒 | 71.302秒 | 53.234秒 |
ULプロキオン: AI画像生成
Procyon AI Image Generation Benchmarkは、低消費電力NPUからハイエンドGPUまで、幅広いハードウェアにおけるAI推論性能を、一貫性をもって正確に測定します。このベンチマークには、ハイエンドGPU向けのStable Diffusion XL(FP16)、中程度の性能のGPU向けのStable Diffusion 1.5(FP16)、低消費電力デバイス向けのStable Diffusion 1.5(INT8)の3つのテストが含まれています。ベンチマークは各システムに最適な推論エンジンを使用するため、公平で比較可能な結果が得られます。
画像生成も Arc Pro B70 が小型版に比べて劇的に改善している分野の一つで、Stable Diffusion 1.5 FP16 スコアは 179% 向上 (2,101 対 754) し、生成時間は 132.6 秒から 47.6 秒に短縮され、64% 短縮されています。B70 は RTX 5060 Ti とほぼ同等 (2,101 対 2,110、1% 未満の差) ですが、RX 9070 XT には 19%、RTX 5070 には 29% 劣っています。Stable Diffusion XL FP16 では、Intel は再び B50 のパフォーマンスをほぼ 3 倍 (181% 向上) にし、RTX 5060 Ti をわずか 8% 上回る結果となりましたが、RTX 5070 FE には約 18% 劣っています。 INT8ワークロードはNVIDIAのTensorRT実装に有利だが、B70はB50に比べて265%性能が向上し、画像生成時間を72%以上短縮している。
| UL Procyon: AI画像生成 (総合評価:点数が高いほど良い) |
インテル アーク プロ B50 | インテル アーク プロ B70 | AMD Radeon RX 9060 XT | NVIDIA GeForce RTX 5060 Ti | AMDのRadeon RX 9070 | AMD Radeon RX 9070 XT | NVIDIA GeForce RTX 5070FE |
|---|---|---|---|---|---|---|---|
| 安定拡散 1.5 (FP16) — 総合スコア | 754 | 2,101 | 1,436 | 2,110 | 2,280 | 2,598 | 2,937 |
| 安定拡散 1.5 (FP16) — 全体時間 | 132.585秒 | 47.585秒 | 69.633秒 | 47.590秒 | 43.858秒 | 38.481秒 | 34.038秒 |
| 安定拡散1.5(FP16) — 画像生成速度 | 8.287 秒/画像 | 2.974 秒/画像 | 4.352 秒/画像 | 2.974 秒/画像 | 2.741 秒/画像 | 2.405 秒/画像 | 2.127 秒/画像 |
| 安定拡散 1.5 (INT8) — 総合スコア | 5,020 | 18,344 | 無し | 27,705 | 無し | 無し | 36,320 |
| 安定拡散 1.5 (INT8) — 全体時間 | 49.795秒 | 13.628秒 | 無し | 9.024秒 | 無し | 無し | 6.883秒 |
| 安定拡散 1.5 (INT8) — 画像生成速度 | 6.224 秒/画像 | 1.703 秒/画像 | 無し | 1.128 秒/画像 | 無し | 無し | 0.860 秒/画像 |
| 安定拡散XL(FP16) — 総合スコア | 748 | 2,102 | 1,124 | 1,940 | 1,805 | 2,010 | 2,473 |
| 安定拡散XL(FP16) — 全体時間 | 790.774秒 | 285.344秒 | 533.736秒 | 326.550秒 | 332.400秒 | 298.499秒 | 242.606秒 |
| 安定拡散XL(FP16) — 画像生成速度 | 49.423 秒/画像 | 17.834 秒/画像 | 33.359 秒/画像 | 20.409 秒/画像 | 20.775 秒/画像 | 18.656 秒/画像 | 15.163 秒/画像 |
ラックスマーク
Luxmarkは、オープンソースのレイトレーシングレンダラーであるLuxRenderを使用し、非常に詳細な3Dシーンにおけるシステムのパフォーマンスを評価するGPUベンチマークです。このベンチマークは、サーバーやワークステーションのグラフィカルレンダリング機能の評価に特に適しており、特に正確な光シミュレーションが不可欠な視覚効果や建築ビジュアライゼーションアプリケーションに適しています。
LuxMarkはBattlemageにおいて優れたスケーリング性能を示しています。Arc Pro B70は、FoodシーンでB50を128%、Hallシーンで137%上回ります。また、Radeon RX 9060 XTをFoodシーンで33%、Hallシーンで53%上回ります。ゲーミングに特化したRX 9070 XTはFoodシーンで約54%、Hallシーンで約37%の優位性を維持しており、NVIDIAのRTX 5070 FEはそれぞれ62%と81%の差でリードしています。総合的に見て、B70はワークステーションワークロード向けの強力なOpenCLレンダリングアクセラレータとしての地位を確固たるものにしています。
| ラックスマーク (高いほど良い) |
インテル アーク プロ B50 | インテル アーク プロ B70 | AMD Radeon RX 9060 XT | NVIDIA GeForce RTX 5060 Ti | AMDのRadeon RX 9070 | AMD Radeon RX 9070 XT | NVIDIA GeForce RTX 5070FE |
|---|---|---|---|---|---|---|---|
| フードスコア | 2,456 | 5,609 | 4,220 | 6,590 | 8,233 | 8,610 | 9,061 |
| ホールスコア | 5,158 | 12,220 | 8,007 | 15,348 | 16,566 | 16,758 | 22,062 |
Geekbench 6
Geekbench 6は、システム全体のパフォーマンスを測定するクロスプラットフォームのベンチマークツールです。Geekbench Browserを使用すると、あらゆるシステムをGeekbench 6と比較できます。
Arc Pro B70は140,165というスコアを記録し、Arc Pro B50からちょうど100%向上しました。Radeon RX 9070を約1%上回り、RX 9060 XTを36%上回り、RTX 5060 Tiにはわずか7%劣る結果となりました。NVIDIAのRTX 5070 FEはリードを約24%に広げ、AMDのRX 9070 XTは約35%上回っており、B70は上位メインストリームコンピューティングスタックのちょうど真ん中に位置づけられています。
| ギークベンチ6 OpenCL (高いほど良い) |
インテル アーク プロ B50 | インテル アーク プロ B70 | AMD Radeon RX 9060 XT | AMDのRadeon RX 9070 | NVIDIA GeForce RTX 5060 Ti | NVIDIA GeForce RTX 5070FE | AMD Radeon RX 9070 XT |
|---|---|---|---|---|---|---|---|
| GPU OpenCLスコア | 70,038 | 140,165 | 102,750 | 138,463 | 150,743 | 173,255 | 188,892 |
3DMark
3DMark Port Royal、Speed Way、Steel Nomadは、様々なシナリオにおけるパフォーマンスをテストするGPUベンチマークです。Port Royalはレイトレーシングに焦点を当て、Speed Wayはレーシングシミュレーションにおけるパフォーマンスを評価し、Steel Nomadは高輝度でリアルなグラフィックスでGPUの性能を競います。レンダリング、ライティング、そしてダイナミックシーンにおけるGPUの性能を評価します。
合成グラフィックス性能は、新しいアーキテクチャで良好にスケーリングします。Arc Pro B70 は、Port Royal で B50 より 154%、Speed Way で 136%、Steel Nomad で 149% 高いスコアを記録しました。RX 9060 XT と比較すると、B70 は Port Royal で 9%、Speed Way で 7%、Steel Nomad で 9% リードしています。RTX 5060 Ti と比較すると、B70 は Port Royal で 2% 以内の性能、Speed Way で 23% 劣る性能、Steel Nomad で 13% リードしています。上位機種の RTX 5070 FE と RX 9070 XT は、ワークロードに応じて 31~83% の優位性を維持しており、高性能ゲーミング GPU としての位置づけを反映しています。
| 3DMark (高いほど良い) |
インテル アーク プロ B50 | インテル アーク プロ B70 | AMD Radeon RX 9060 XT | NVIDIA GeForce RTX 5060 Ti | NVIDIA GeForce RTX 5070FE | AMDのRadeon RX 9070 | AMD Radeon RX 9070 XT |
|---|---|---|---|---|---|---|---|
| ポートロイヤル | 4,197 | 10,668 | 9,751 | 10,432 | 14,026 | 15,760 | 17,989 |
| スピードウェイ | 1,355 | 3,202 | 3,004 | 4,184 | 5,869 | 5,791 | 6,237 |
| Steel Nomad (DX12) | 1,644 | 4,089 | 3,767 | 3,611 | 5,019 | 5,992 | 6,977 |
トパーズ ビデオ AI
Topaz Video AIは、高度なAIモデルを使用してビデオを強化・修復するプロフェッショナル向けアプリケーションです。4Kまたは8Kへのアップスケーリング、ぼやけたコンテンツのシャープ化、ノイズ低減、顔のディテール強調、白黒映像のカラー化、滑らかな動きを実現するためのフレーム補間など、さまざまなタスクをサポートします。このスイートには、さまざまなビデオ強化アルゴリズムにおけるシステムパフォーマンスを測定するオンボードベンチマークが含まれており、ハードウェアプラットフォームが要求の厳しいAIビデオ処理ワークロードをどの程度処理できるかを明確に把握できます。
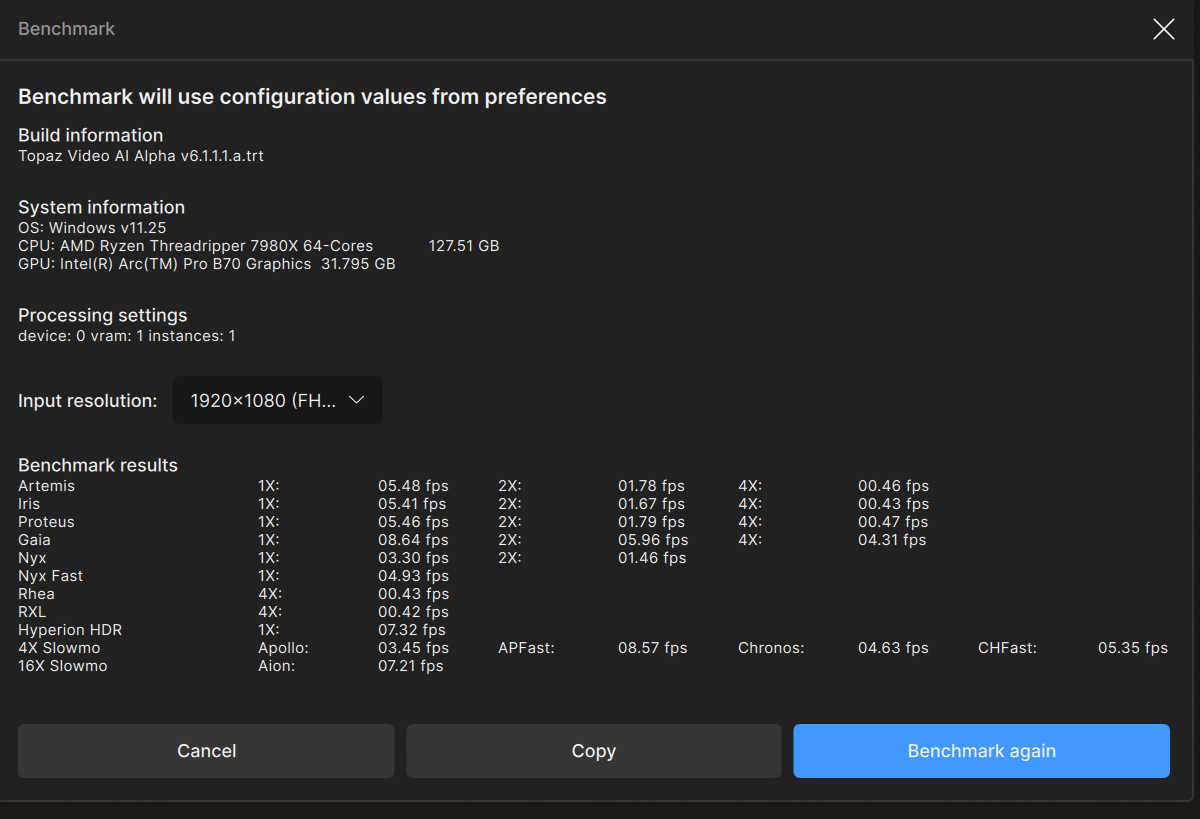
Arc Pro B70は、Intelの以前の世代のプロフェッショナル向け製品に比べて大幅な改善を実現しており、特にAIアップスケーリングワークロードで大きな向上が見られます。このカードは、Artemisで5.48 FPS、Irisで5.41 FPS、Proteusで5.46 FPS(1倍のエンハンスメント)を達成し、Gaiaでは8.64 FPSに達し、標準エンハンスメントモデルの中で最速の結果となっています。計算負荷の高い復元モデルは当然ながら動作が遅くなり、Nyxでは3.30 FPS、Nyx Fastでは4.93 FPS、Hyperion HDRでは7.32 FPSで映像を処理します。スローモーション生成も良好で、Apolloでは3.45 FPS、APFastでは8.57 FPS、Chronosでは4.63 FPS、CHFastでは5.35 FPS、Aionでは7.21 FPSを実現しています。これらの結果を総合すると、Arc Pro B70は、ビデオの画質向上やノイズ除去からHDR変換やフレーム補間まで、Topaz AIのあらゆるワークフローに対応できることが示されており、IntelのXMX AIアクセラレーションを活用したいクリエイターにとって確かな選択肢となる。
ブレンダー4.5
Blenderはオープンソースの3Dモデリングアプリケーションです。このベンチマークは、Blender Benchmarkユーティリティを使用してGPU上で実行されました。スコアは1分あたりのサンプル数で測定され、値が高いほどパフォーマンスが優れていることを示します。
Arc Pro B70は、Monsterで1分あたり1,524.6サンプル、Junkshopで1分あたり846.9サンプル、Classroomで1分あたり912.2サンプルのレンダリング性能を発揮します。これらの数値は、RX 9070 XTやRTX 5070といったハイエンドのGPUには及びませんが、Battlemageがプロフェッショナルなビジュアライゼーションやコンテンツ制作のワークロードに十分なレンダリング性能を備えていることを示しています。32GBのフレームバッファと認定ワークステーションドライバを組み合わせることで、B70はレンダリング能力、AIアクセラレーション、そしてプロフェッショナルな信頼性の間で実用的なバランスを実現しています。
| Blender 4.5.0(1分あたりのサンプル数、数値が高いほど良い) | インテル アーク プロ B70 |
|---|---|
| モンスター | 1,524.60 |
| ジャンクショップ | 846.87 |
| 教室 | 912.24 |
消費電力: Intel B70
消費電力は、あらゆるコンピューティングプラットフォームにおいて重要な要素です。GPUの新世代が出るたびに、負荷時の消費電力は増加し、より大型の電源装置と十分な冷却用エアフローが必要となります。しかし、高速なGPUはピーク値が高くなる一方で、各ワークロードの実行時間は短くなります。テストラボでQuarch Mains Analyzerを使用し、 Procyon AI Image Generator Stable Diffusion XL FP16テスト中のシステム全体の消費電力を測定しました。このワークロードは各GPUを電力限界まで駆動し、生成された各画像の開始点と終了点が明確に示されました。
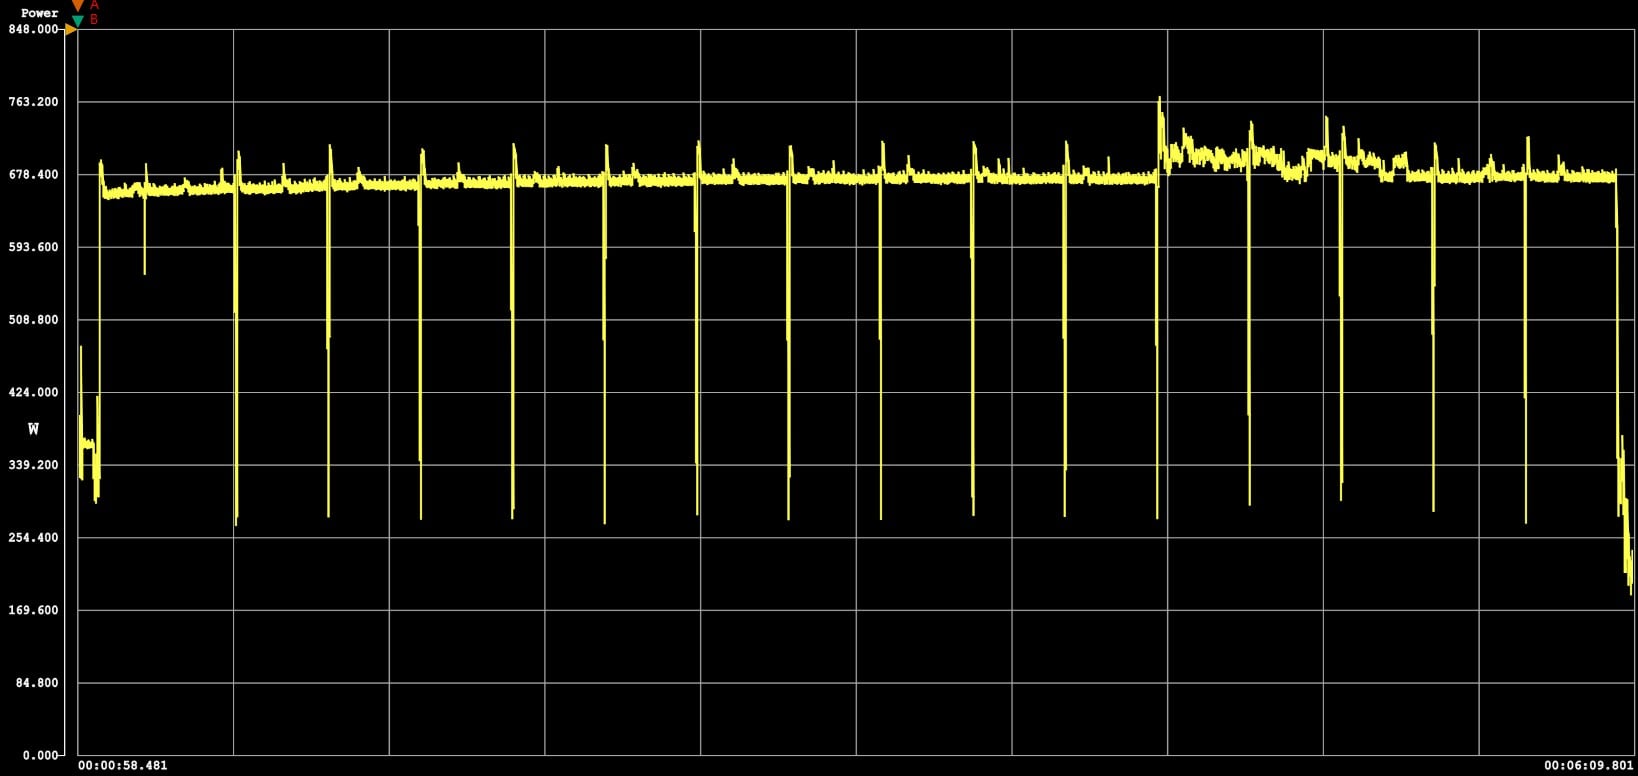
Intel Arc Pro B70のテスト中に、システムアイドル時の消費電力は207W、ワークロード時のピーク消費電力は705.6W、ワークロード時の平均消費電力は638.6Wと測定されました。
| 安定した拡散 XL FP16 電力効率 (低いほど良い) |
インテル アーク プロ B50 | インテル アーク プロ B70 | AMDのRadeon RX 9070 | AMD Radeon RX 9070 XT | PNY NVIDIA GeForce RTX 5060 Ti | NVIDIA GeForce RTX 5070FE |
|---|---|---|---|---|---|---|
| 消費電力 | 5.32 WH | 3.45 WH | 4.00 WH | 3.41 WH | 2.13 WH | 2.46 WH |
| テスト期間 | 49.9秒 | 18.46秒 | 33.0秒 | 17.4秒 | 20.2秒 | 19.2秒 |
vLLMオンラインサービングベンチマークパフォーマンス
vLLMは、LLM(論理レベル管理)向けの最も人気のある高スループット推論およびサービスエンジンです。vLLMオンラインサービスベンチマークは、同時リクエスト下での実際のサービスパフォーマンスを測定するパフォーマンス評価ツールです。リクエストレート、入出力長、同時クライアント数などの設定可能なパラメータを使用して、実行中のvLLMサーバーにリクエストを送信することで、本番環境のワークロードをシミュレートします。このベンチマークでは、スループット(1秒あたりのトークン数)、最初のトークン取得までの時間(TTFT)、出力トークンあたりの時間(TPOT)などの主要な指標を測定し、さまざまな負荷条件下でのvLLMのパフォーマンスをユーザーが理解するのに役立ちます。
テストプラットフォーム:
- サーバー: スーパーマイクロ AS-4125GS-TNRT
- プロセッサ: AMD EPYC 9374F
- メモリ: 512GB Samsung 4800 MT/s DDR5
- ISL 2k/ OSL 256
同等のGPUテスト
- インテル アーク プロ B60
- インテル アーク プロ B70
- NVIDIA RTX Pro 6000
- NVIDIA DGX スパーク
Supermicroホスト上で、4枚のB70(128GB)と4枚のB60(96GB)を、1枚のRTX Pro 6000と1枚のDGX Sparkと比較してテストしました。GPUの枚数が不均等なのは意図的なものです。定価949ドルのB70 4枚セットは、1枚のSparkとほぼ同じ価格帯で、1枚のRTX Pro 6000よりははるかに安いため、この比較ではカードの枚数ではなく、おおよその投資額でプラットフォームを揃えています。
ミストラル・スモール24B
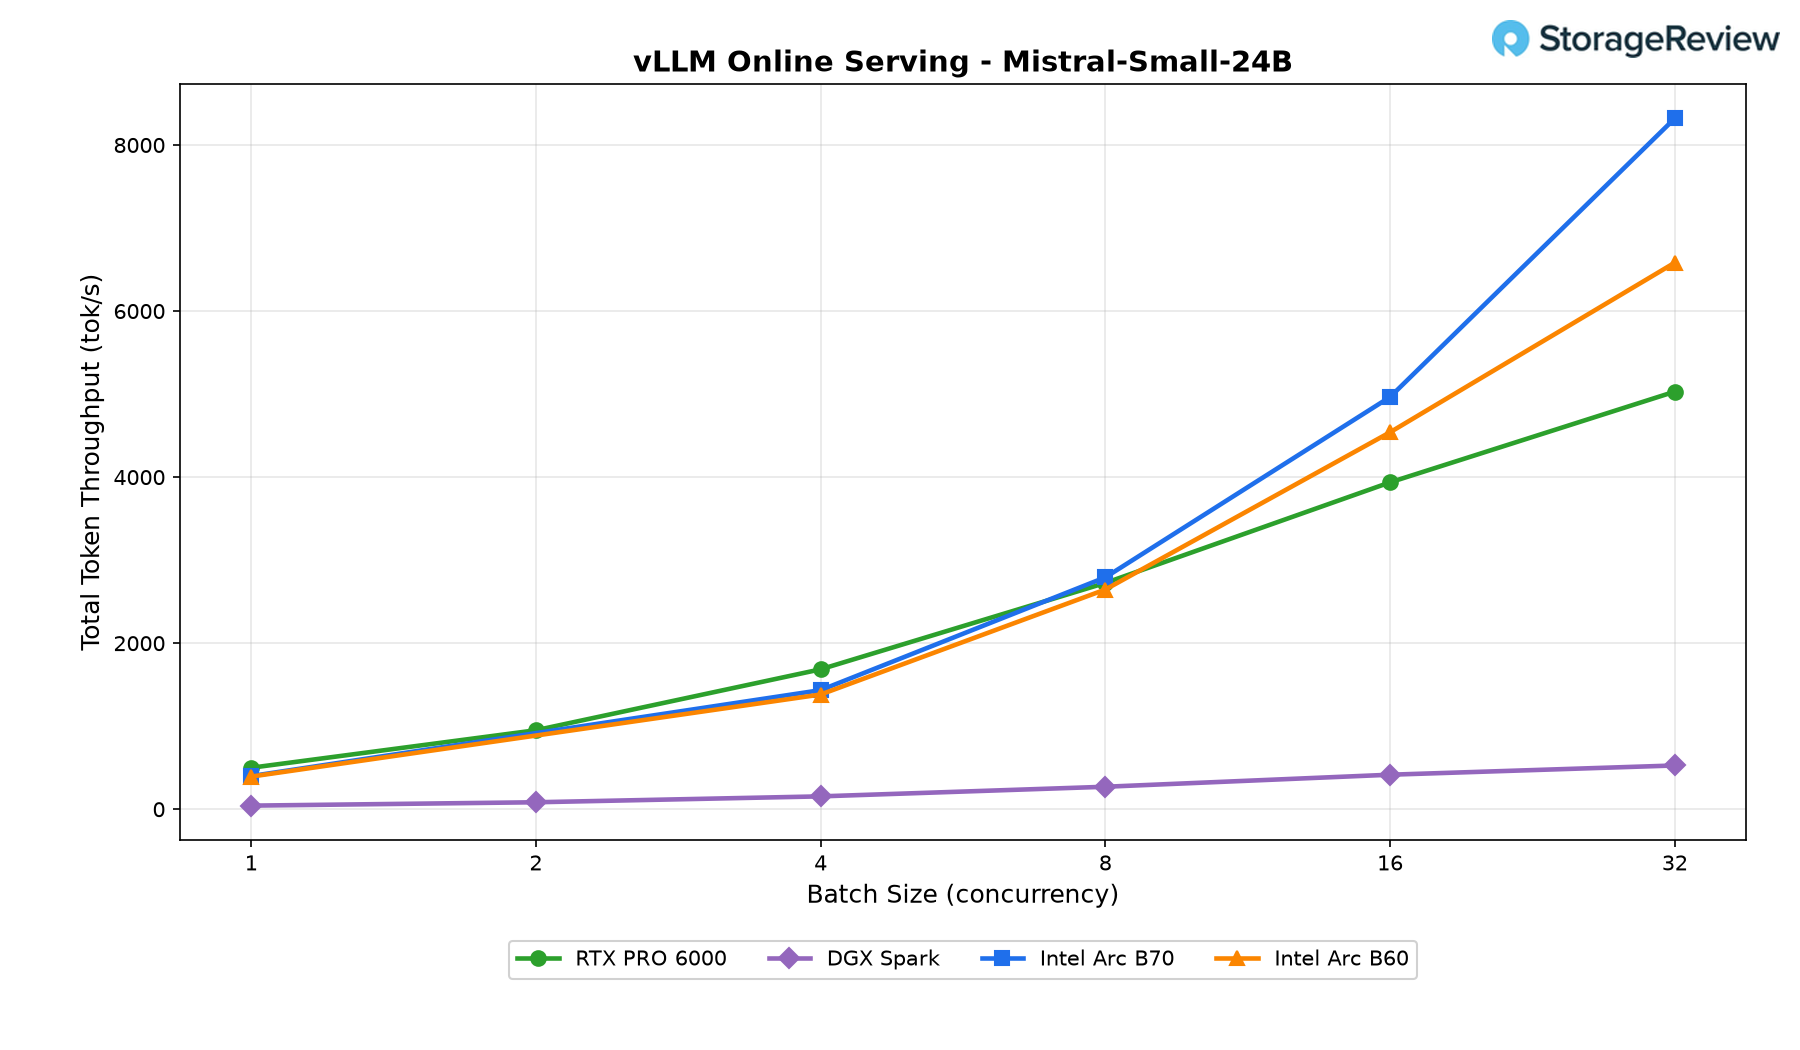
Intel Arc Pro B70 は、Mistral-Small-24B ワークロードで最も優れたパフォーマンスを発揮し、バッチ サイズ 1 での 450 tok/s からバッチ サイズ 32 での 8,321 tok/s までスケーリングしました。RTX PRO 6000 はバッチ サイズ 4 まではわずかに優位に立っていましたが、B70 はバッチ サイズ 8 でそれを追い抜き、着実に差を広げ、最高同時実行数では約 65% リードしました。小型版の Arc Pro B60 と比較すると、B70 は初期段階でわずかなリードを維持し、バッチ サイズ 32 までにその優位性を約 26% に拡大しました。DGX Spark はテスト全体を通して大きく遅れを取り、最大でもわずか 527 tok/s にとどまり、最大負荷時でも B70 は 16 倍近く高速でした。
Qwen3 コーダ 30B
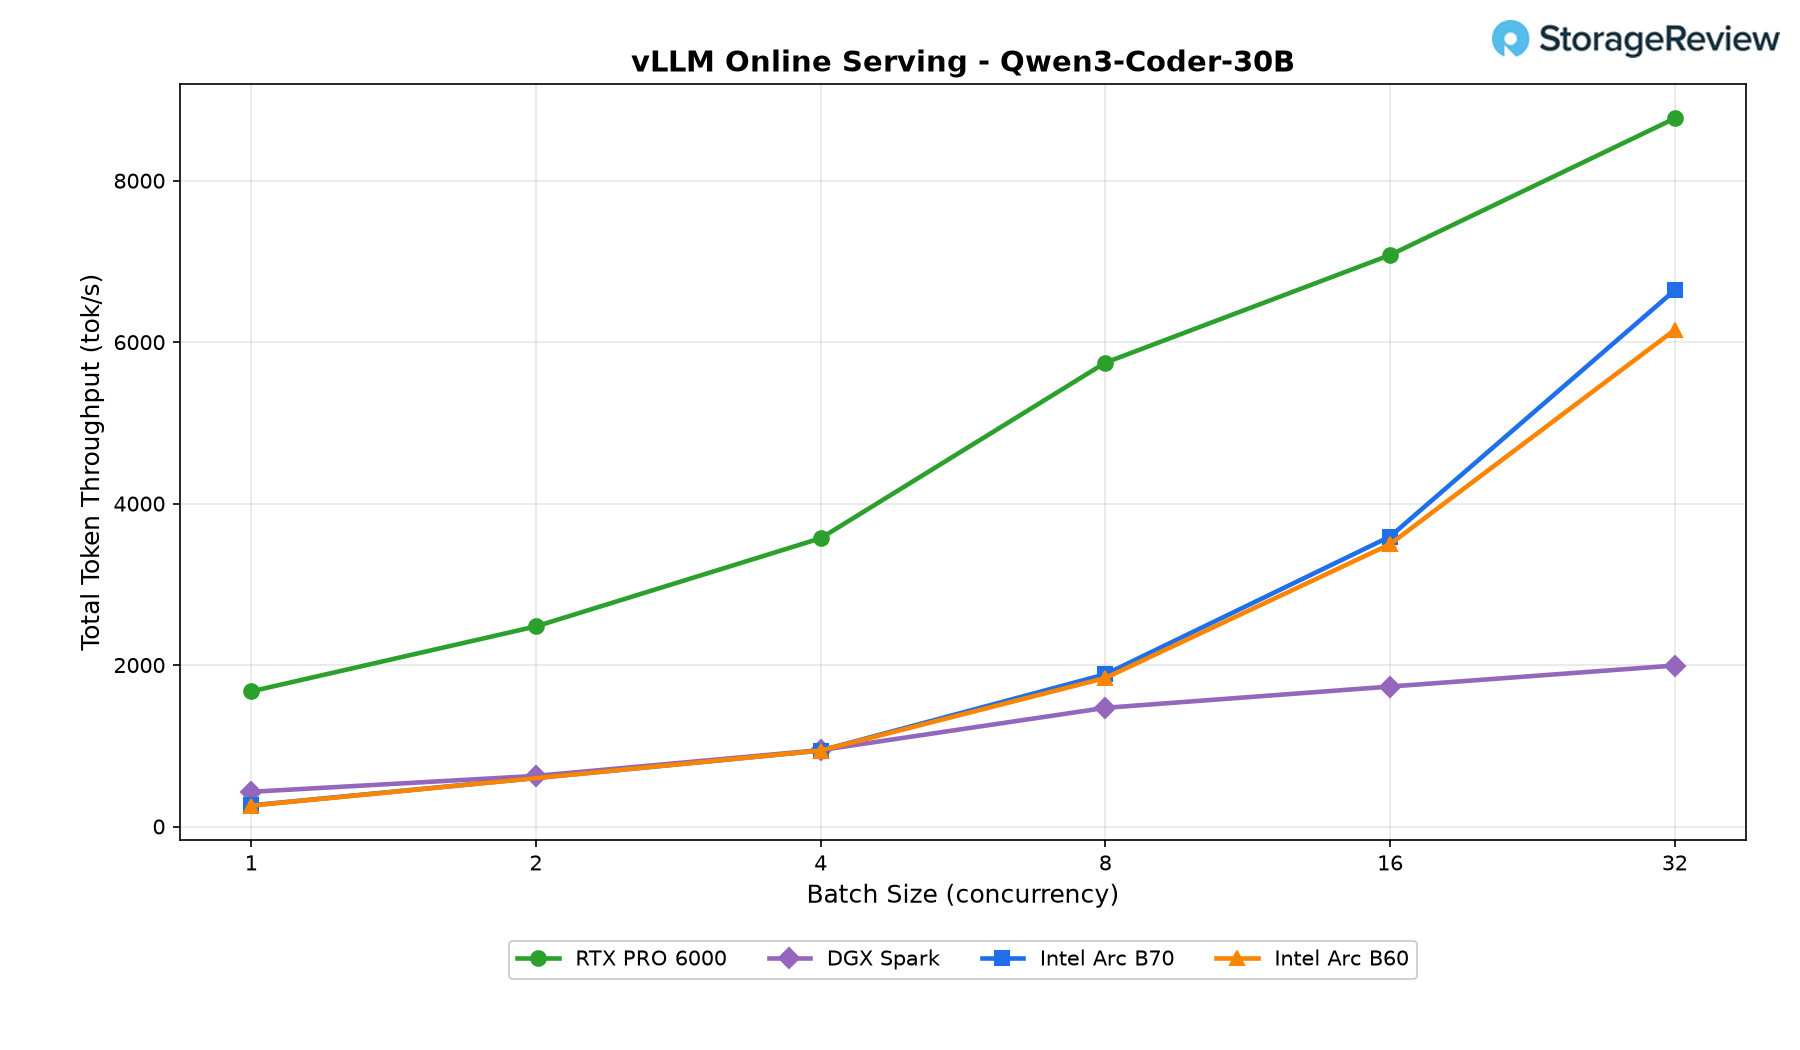
Qwen3-Coder-30B では RTX PRO 6000 が優位に立ち、すべての同時実行レベルで最高のスループットを維持し、8,772 tok/s を達成しました。Intel Arc Pro B70 もスケーリングに優れ、バッチサイズ 32 で 6,643 tok/s を達成し、Arc Pro B60 に対してわずかながら一貫した優位性を維持し、約 8% 高速に完了しました。この開発者向けワークロードでは RTX PRO 6000 には及ばなかったものの、B70 は最大同時実行時で DGX Spark の 3 倍以上のスループットを実現し、より多くの同時推論要求を効率的に処理できる能力を示しました。
ラマ3.1 8B
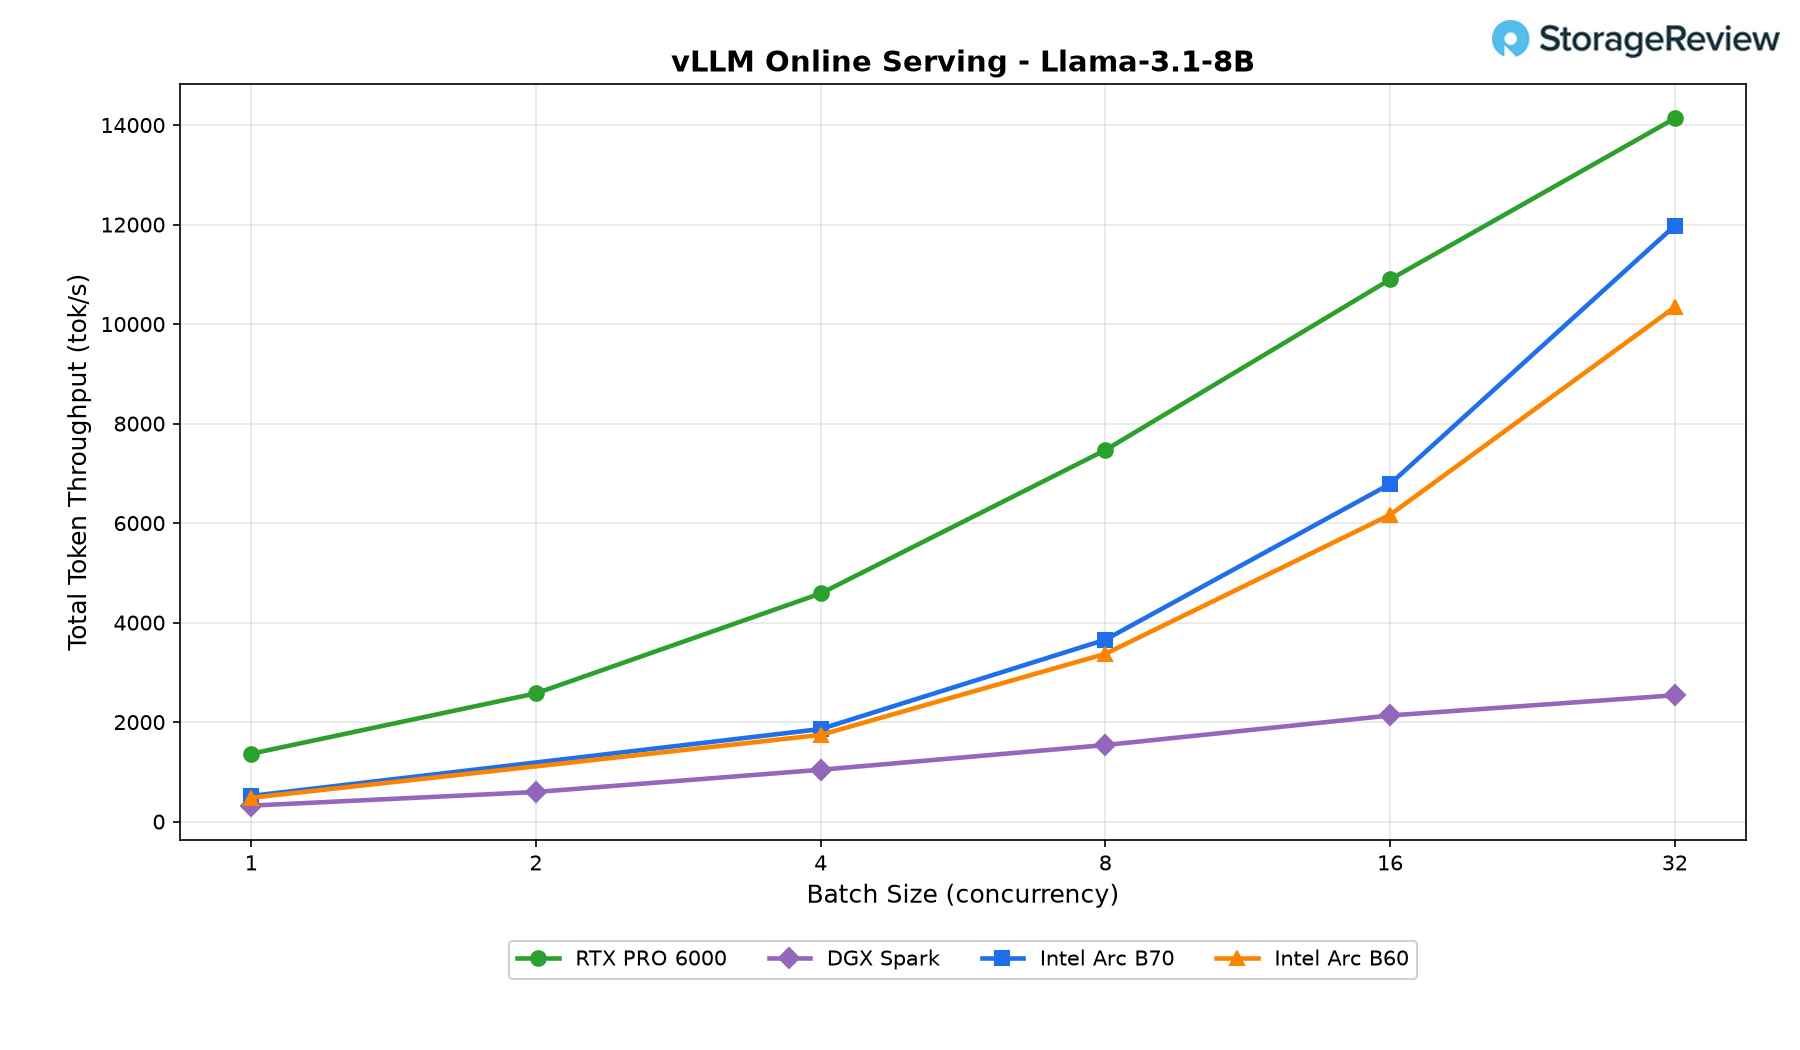
小型の Llama-3.1-8B モデルでは、並列処理が増加するにつれてすべてのディスクリート GPU が積極的にスケーリングしましたが、RTX PRO 6000 が依然として圧倒的なパフォーマンス リーダーでした。Intel Arc Pro B70 はバッチ サイズ 32 で 12,000 トーク/秒近くまで上昇し、Arc Pro B60 を約 16% 上回り、RTX PRO 6000 のスループットの約 85% に達しました。並列処理が増加するにつれて DGX Spark との差は拡大し続け、B70 は最大のバッチ サイズで約 4.7 倍のスループットを生成しました。この結果は、B70 がより大きなリクエスト キューから大きな恩恵を受け、利用可能な GPU リソースを最大限に活用できることも示しています。
GPT OSS 20B
GPT-OSS-20B ベンチマークでは、RTX PRO 6000 が再びチャートのトップに立ち、約 16,900 tok/s を記録しました。Intel Arc Pro B70 は 10,000 tok/s をわずかに上回り、スケーリング カーブ全体で Arc Pro B60 に対してわずかながら測定可能なリードを維持し、バッチ サイズ 32 で約 7% 高速になりました。NVIDIA のフラッグシップ ワークステーション GPU には約 40% 劣るものの、DGX Spark の約 3 倍のスループットを実現しました。バッチ サイズ 8 を超えるとほぼ線形にスケーリングされることから、同時リクエストが増加しても B70 は十分に活用されていることがわかります。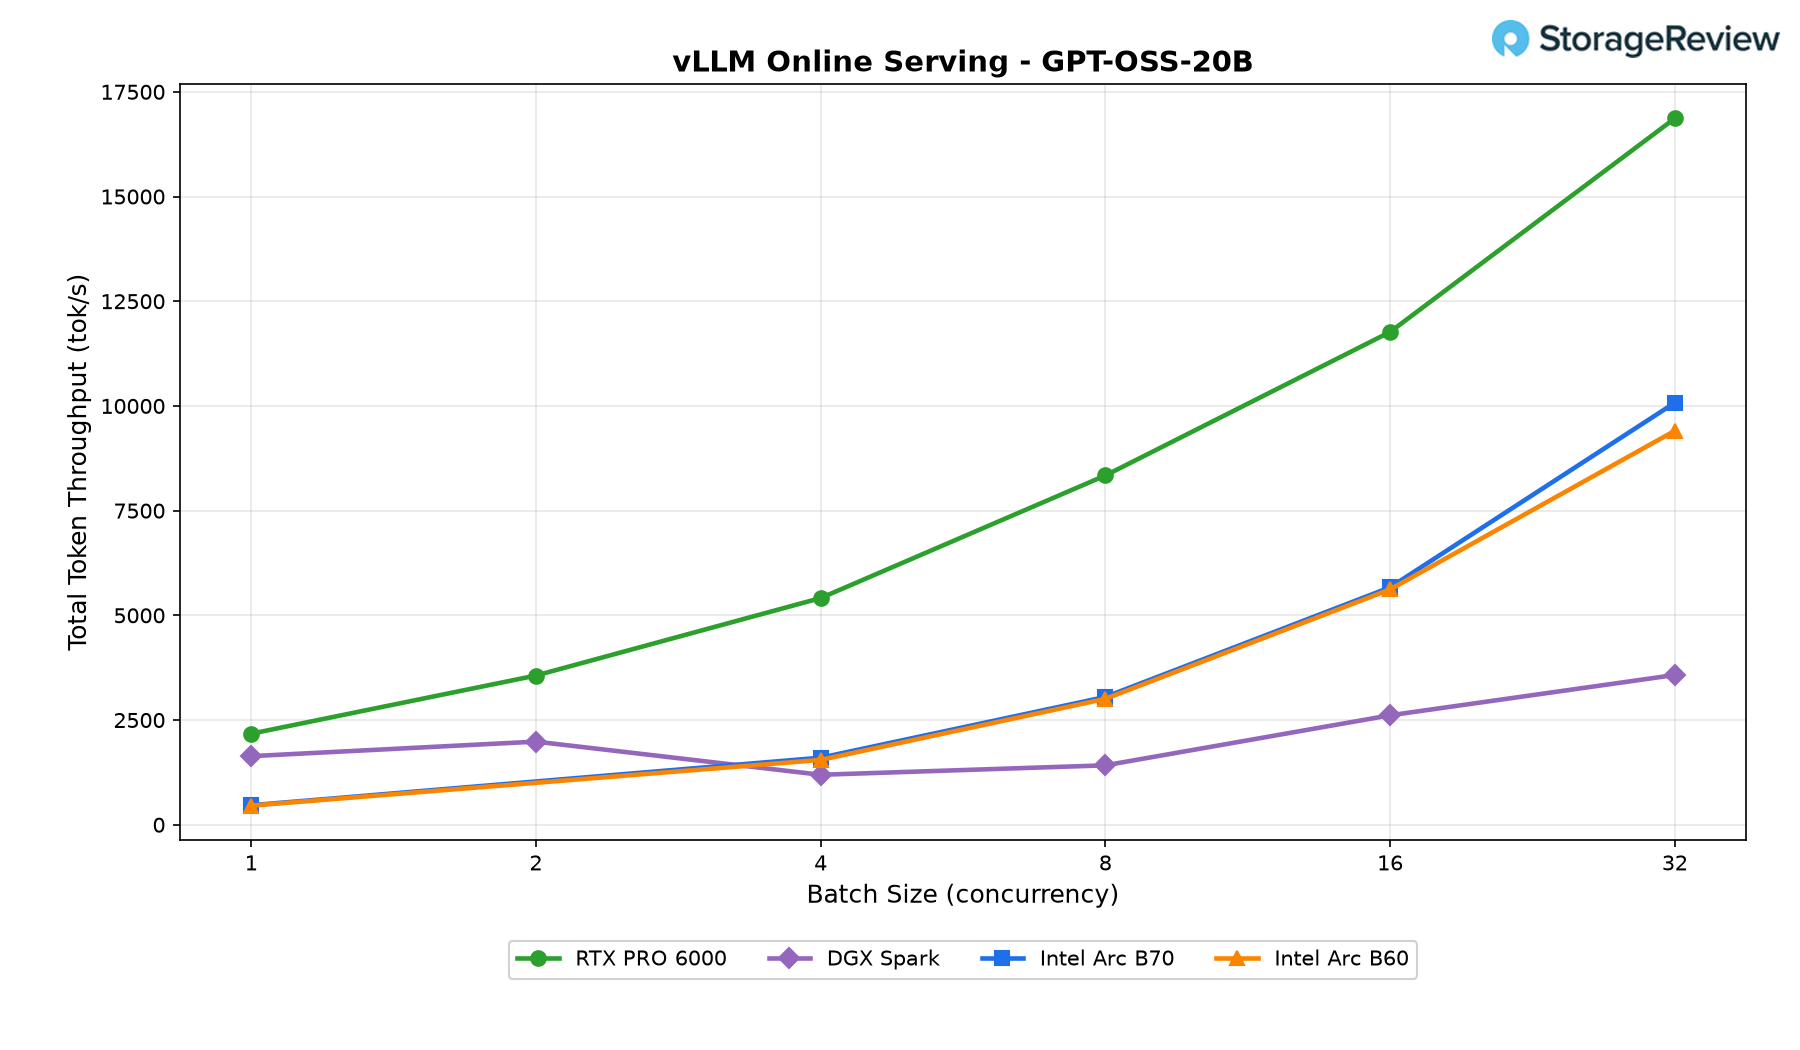
GPT OSS 120B
グループ内で最大のモデルは、すべてのプラットフォームでより高い要求を課すことが判明しましたが、Intel Arc Pro B70 は引き続き効率的にスケーリングしました。6,870 tok/s で終了し、Arc Pro B60 を約 7% 上回り、RTX PRO 6000 のスループットの約 4分の 3 を達成しました。DGX Spark は同じ同時実行レベルで 2,175 tok/s に達し、B70 は約 3.2 倍の優位性を示しました。RTX PRO 6000 は全体的なリードを維持しましたが、B70 は、特に高い同時実行によってハードウェアがフル稼働している場合、より大規模な言語モデルを処理する上で非常に競争力があることを示しました。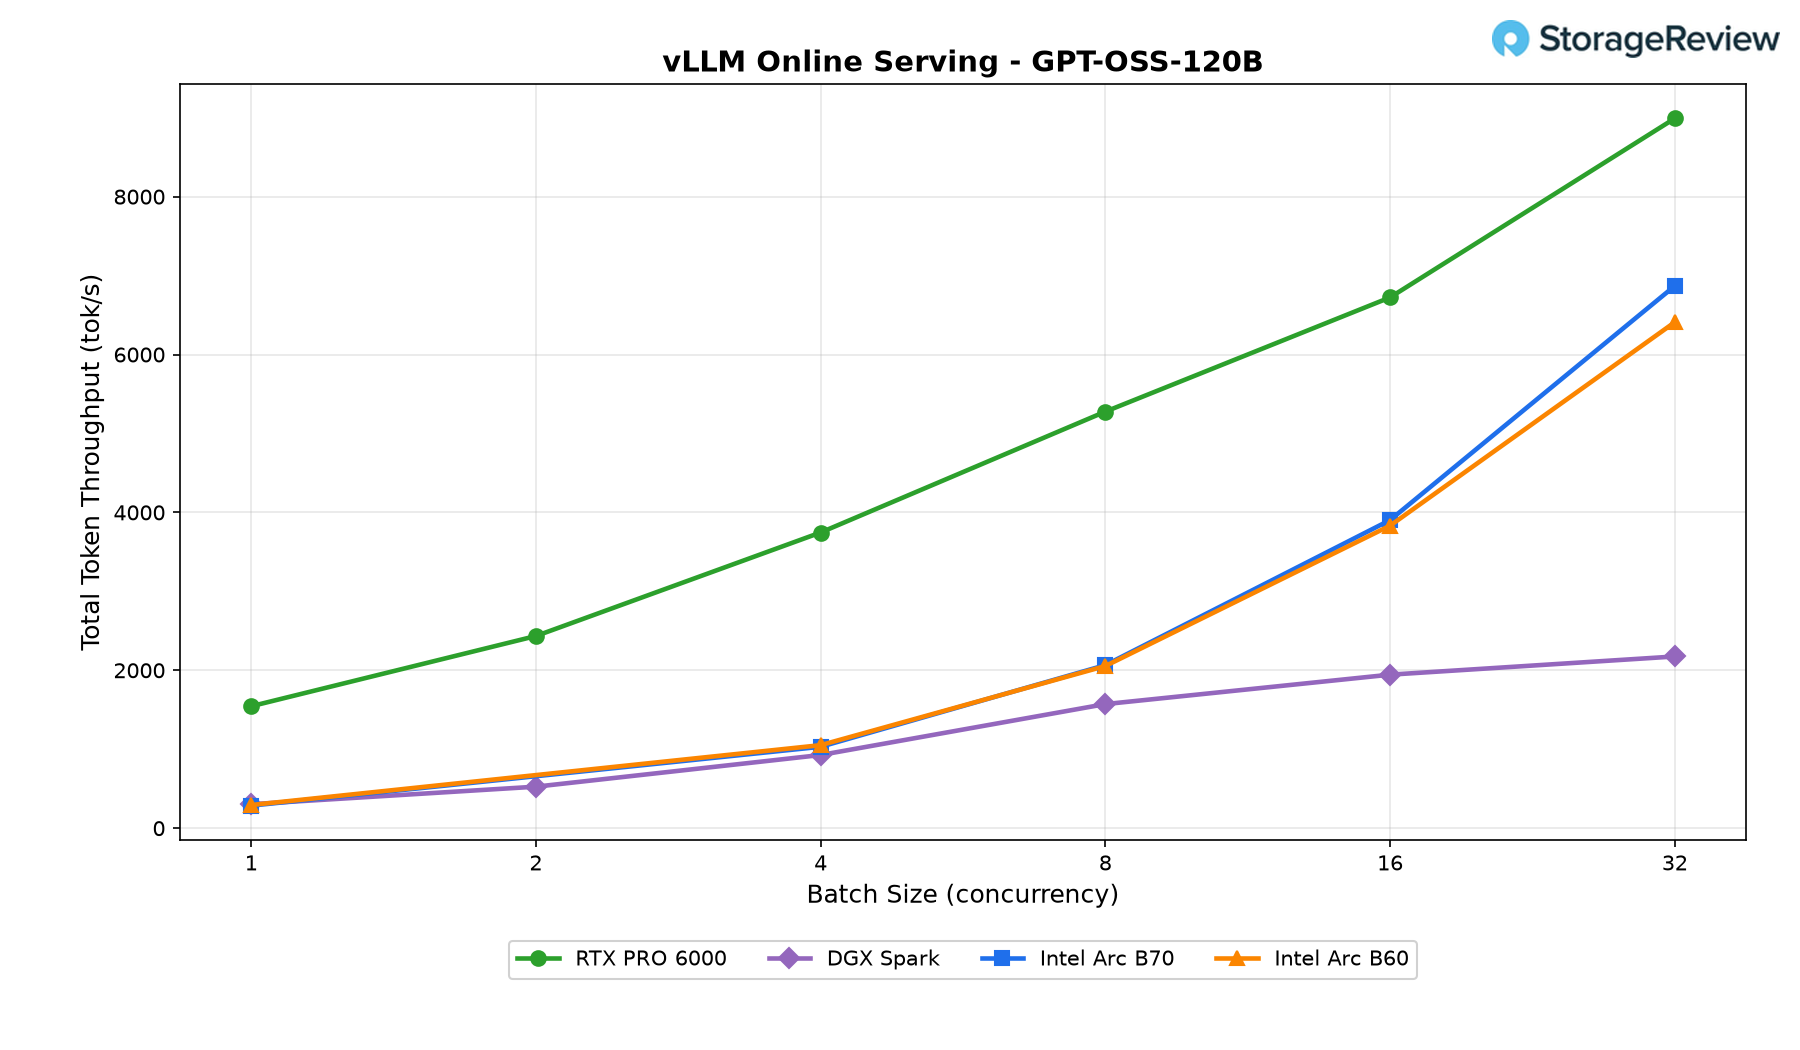
結論
Intel Arc Pro B70は、Intelがこれまでにリリースしたワークステーション向けAI GPUの中でも特に魅力的な製品の一つです。発売当初の希望小売価格949ドルで、32GBのECC GDDR6メモリを搭載し、多くのAIおよびプロフェッショナル向けワークロードにおいて、同価格帯のコンシューマー向けGPUを凌駕するパフォーマンスを発揮しながら、ワークステーション向けNVIDIA製品を大幅に下回る価格を実現することで、独自の地位を確立しました。現在の市場価格が1,100ドルを超えているにもかかわらず、特に大規模なローカルモデルやマルチGPU構成を必要とするユーザーにとって、メモリ容量が処理能力よりもボトルネックとなる場合、RTX Pro 4000などの製品と比較して、依然として魅力的な価格設定となっています。
ハードウェアの観点から見ると、Intel Arc Pro B70 は期待に応えてくれました。Stable Diffusion 1.5 の画像生成では RTX 5060 Ti とほぼ同等の性能を発揮し、レンダリング結果も良好で、最新の言語モデルをローカル AI インフラストラクチャの有力な選択肢となるほどの速度で処理しました。Llama 3.1 8B では 12,000 トーク/秒近くに達し、4 枚のカードを使用した場合、Mistral Small 24B ではフル同時実行で当社の RTX Pro 6000 リファレンス 1 枚を 65% 上回りました。1 つのワークステーションに 4 枚の B70 を搭載すると、定価で約 3,800 ドルで 128GB の VRAM が利用可能になり、ハイエンドのワークステーション GPU 1 枚よりもはるかに安価です。
Arc Pro B70が直面する最大の課題は、シリコンそのものではなく、それを取り巻くソフトウェアエコシステムにある。ドライバの品質とフレームワークのサポートは、NVIDIAのCUDAエコシステムと、ますます成熟しつつあるAMDのROCmスタックの両方に依然として劣っている。IntelはoneAPI、OpenVINO、そしてBattlemage対応のvLLM開発において大きな進歩を遂げているものの、ユーザーは依然として時折発生する互換性の問題、限られたモデルサポート、そして競合プラットフォームよりも多くのトラブルシューティングへの対応を覚悟しておく必要があるだろう。ほぼすべてのAIフレームワークとアプリケーションで「すぐに使える」ターンキーGPUを求めるユーザーにとって、NVIDIAとAMDは依然としてより安全な選択肢となるだろう。
最終的に、Arc Pro B70は、VRAM容量、ワークステーション機能、そして価格対性能比のAIパフォーマンスを重視する購入者にとって、自信を持っておすすめできる製品です。ただし、購入前にその製品の特徴を十分に理解しておくことが前提となります。優れたハードウェアであり、価格設定も魅力的ですが、長期的な成功は、Intelがソフトウェア開発を継続し、エコシステムサポートを拡大していくかどうかにほぼ全面的に左右されます。Intelがこの投資を継続できれば、B70はコンシューマー向けおよびプロフェッショナル向けAIアクセラレーションにおいて、最もコストパフォーマンスの高い製品の一つとなる可能性を秘めています。そうでなければ、NVIDIAやAMDの競合製品のような使いやすさを実現できないまま、大きな可能性を秘めたカードとして終わってしまうリスクがあります。


 Amazon