

엔비디아는 대규모 데이터센터와 소형 워크스테이션을 위한 새로운 하드웨어로 전문가용 GPU 라인업을 확장하고 있습니다. SIGGRAPH 2025에서 엔비디아는 엔터프라이즈 서버용 RTX PRO 6000 블랙웰 서버 에디션과 함께 RTX PRO 4000 소형 폼 팩터(SFF) 에디션, RTX PRO 2000 블랙웰 등 두 가지 새로운 데스크톱 GPU를 공개했습니다. 이번 발표는 AI 모델 학습, 산업 시뮬레이션부터 엔지니어링 설계, 미디어 제작에 이르기까지 광범위한 전문가용 워크로드 전반에 걸쳐 블랙웰 아키텍처 성능을 제공하려는 노력을 강조합니다. 엔비디아와 파트너사들은 하드웨어 외에도 생성 AI부터 로봇 공학, 물리 AI 애플리케이션에 이르기까지 모든 것을 가속화할 수 있는 통합 AI 소프트웨어 플랫폼을 강조하고 있습니다.
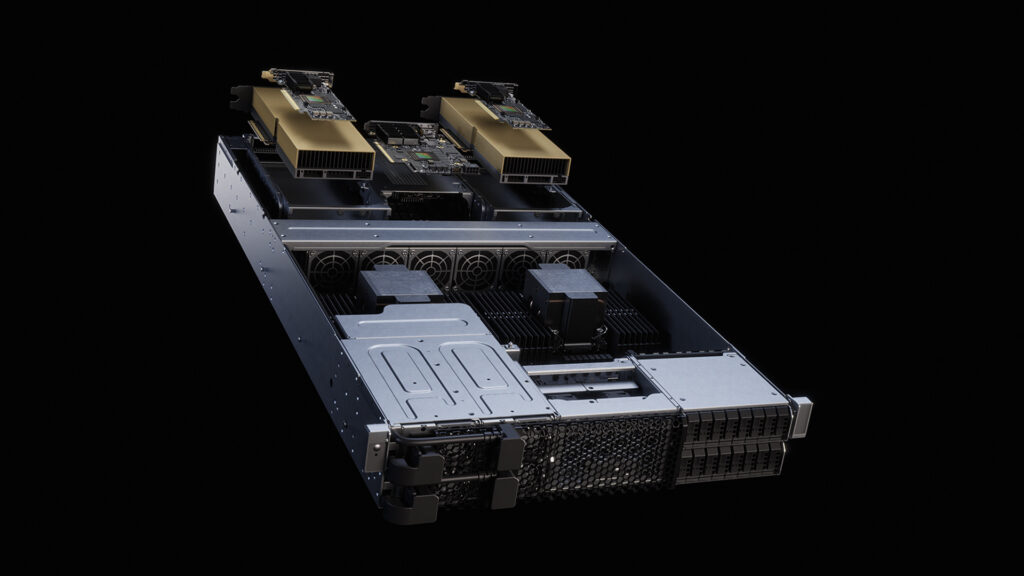
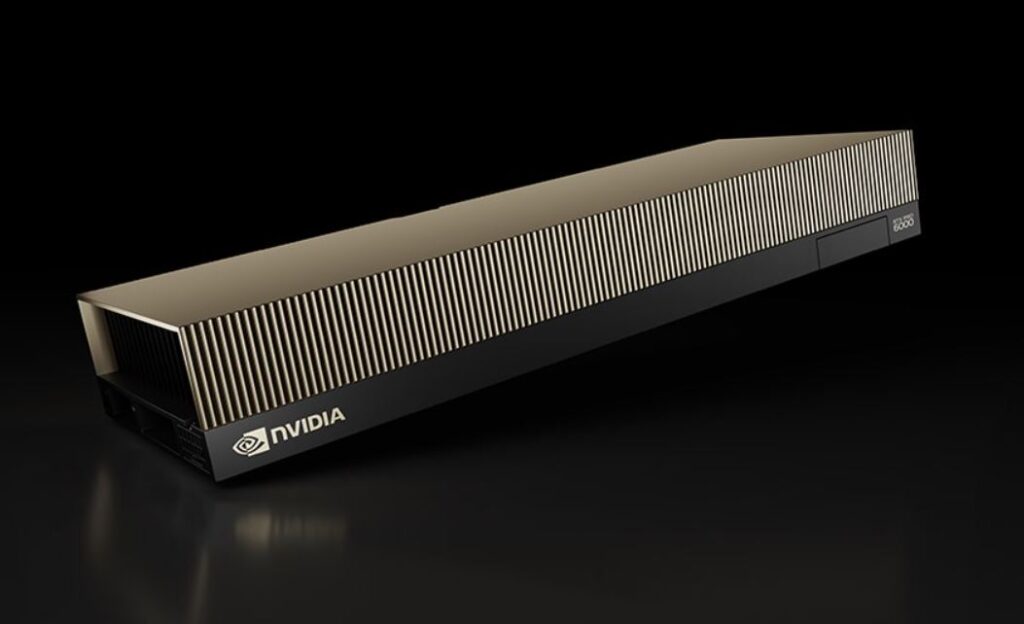
NVIDIA RTX PRO 6000 Blackwell Server Edition: 데이터 센터를 위한 새로운 힘
엔비디아는 RTX PRO 6000 블랙웰 서버 에디션 GPU가 곧 다양한 주류 엔터프라이즈 서버에 출시될 예정이라고 밝혔습니다. 이를 통해 최신 GPU 아키텍처를 2U 랙 시스템(가장 널리 사용되는 서버 폼팩터 중 하나)에 적용할 수 있게 되었습니다. 이러한 새로운 구성은 기업들이 기존 CPU 전용 데이터센터 환경에서 GPU 가속 플랫폼으로 전환할 수 있도록 지원합니다.
RTX PRO 6000은 NVIDIA의 Blackwell 아키텍처를 기반으로 24,064개의 CUDA 병렬 처리 코어를 탑재하여 다양하고 까다로운 워크로드를 처리할 수 있습니다. AI 학습 및 추론 속도를 높이는 752개의 5세대 NVIDIA Tensor 코어와 실시간 레이 트레이싱을 위한 188개의 117세대 RT 코어가 포함되어 있습니다. 사양 측면에서는 32테라플롭의 단정밀도(FP3.7) 성능, 4페타플롭의 FP354.5 AI 성능, 그리고 XNUMX테라플롭의 RT 코어 성능을 제공합니다. 이러한 조합을 통해 이 카드는 고집적 연산과 고사양 렌더링이 모두 필요한 작업을 처리할 수 있습니다.
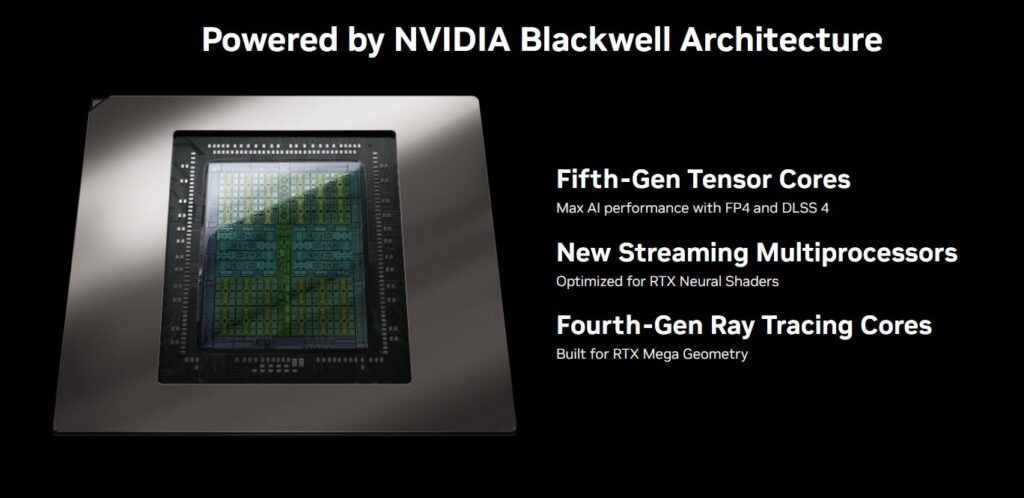
메모리 용량은 96GB GDDR7이며, ECC를 통해 처리 중 데이터 무결성을 향상시킵니다. 512비트 메모리 인터페이스와 1,597GB/s의 대역폭을 갖춘 이 GPU는 시뮬레이션, AI 모델 학습, 고해상도 시각화에 매우 중요한 대용량 데이터 세트를 처리할 수 있습니다. 이 설계는 vGPU와 최대 24개의 MIG(Multi-Instance GPU) 파티션을 지원하며, 각 파티션에는 XNUMXGB의 전용 메모리가 있어 동일한 물리적 카드에서 여러 워크로드를 동시에 실행할 수 있습니다. 비디오 및 이미지 처리 작업은 XNUMX개의 NVENC 인코더, XNUMX개의 NVDEC 디코더, XNUMX개의 JPEG 엔진을 통해 가속화됩니다.
보안 및 안정성 기능에는 기밀 컴퓨팅 지원, 신뢰 루트를 통한 보안 부팅, 고속 연결을 위한 PCI Express 5.0 x16 인터페이스가 포함됩니다. 이 카드는 2.1개의 DisplayPort 4.4 커넥터를 통해 출력하며, 높이 10.5인치, 길이 5인치이고 듀얼 슬롯 구성에 적합합니다. 냉각은 패시브 방식으로 이루어지며, 전력은 단일 PCIe CEM16 600핀 커넥터를 통해 공급되며, 최대 XNUMXW까지 전력 소비량을 조절할 수 있습니다.
Cisco, Dell Technologies, HPE, Lenovo, Supermicro의 시스템은 새로운 2U RTX PRO 서버를 탑재한 최초의 제품 중 하나로, 각 서버는 RTX PRO 6000 Blackwell GPU의 다양한 구성을 지원합니다. 이 아키텍처는 AI 모델 학습 및 추론, 데이터 분석, 과학 시뮬레이션, 사실적 렌더링, 산업 로봇 공학 및 기타 형태의 "물리적 AI" 개발을 포함한 광범위한 워크로드를 가속화하도록 설계되었습니다.
| NVIDIA RTX PRO 6000 블랙웰 서버 에디션 | |
| GPU 아키텍처 | NVIDIA Blackwell 아키텍처 |
| CUDA 병렬 처리 코어 | 24,064 |
| NVIDIA 텐서 코어 | 752(5세대) |
| NVIDIA RT 코어 | 188(4세대) |
| 단정밀도 성능(FP32) | 117 TFLOPS |
| 최대 FP4 AI PFLOPS | 3.7PFLOPS |
| RT 코어 성능 | 354.5 TFLOPS |
| GPU 메모리 | 96GB GDDR7(ECC 포함) |
| 메모리 인터페이스 | 512-bit |
| 메모리 대역폭 | 1597 GB / 초 |
| 전력 소비 | 최대 600W(구성 가능) |
| 멀티 인스턴스 GPU | 최대 4개 MIG @ 24GB |
| NVENC | NVDEC | JPEG | 4배 | 4배 | 4배 |
| 기밀 컴퓨팅 | 지원 |
| 신뢰 루트를 통한 보안 부팅 | 가능 |
| 그래픽 버스 | PCI 익스프레스 5.0 x16 |
| 디스플레이 커넥터 | 4x 디스플레이 포트 2.1 |
| 폼 팩터 | 4.4인치(H) x 10.5인치(L), 듀얼 슬롯 |
| 열 솔루션 | 수동 |
| 전원 커넥터 | PCIe CEM1 5핀 16개 |
이전 세대 NVIDIA L40S GPU 대비 성능 향상은 상당히 클 것으로 예상됩니다. FP5 정밀도를 지원하는 새로운 2세대 텐서 코어와 4세대 트랜스포머 엔진은 최대 XNUMX배 빠른 추론 속도를 제공합니다. XNUMX세대 RTX 그래픽 기술은 렌더링 및 시각화 처리량을 최대 XNUMX배까지 향상시킵니다.
성능 향상 외에도, 이 새로운 RTX PRO 6000 시스템은 효율성을 염두에 두고 설계되었습니다. NVIDIA는 CPU 전용 18U 서버 대비 최대 2배 높은 에너지 효율을 자랑하며, 이는 특히 공간 및 전력이 제한된 시설에 매우 유용합니다. 이러한 속도와 효율성의 균형은 대규모 시뮬레이션, 합성 데이터 생성, 로봇 훈련과 같이 결과 도출 시간이 중요한 워크로드에 매우 중요합니다.
HPE는 ProLiant Compute 라인업에 GPU를 통합할 예정입니다. 여기에는 새로운 385U RTX PRO 폼팩터에 RTX PRO 11 GPU 6000개를 지원하는 DL2 Gen380과 12U 디자인에 최대 4개의 GPU를 지원하는 DLXNUMXa GenXNUMX가 포함됩니다. 이 시스템들은 HPE의 프라이빗 클라우드 AI 플랫폼과 호환되며, 에이전트 AI를 위한 Nemotron, 로봇 공학을 위한 Cosmos Reason, 그리고 업데이트된 비디오 검색 및 요약 도구를 포함한 NVIDIA의 최신 AI 모델을 지원합니다.
이러한 서버 모델의 출하는 2025년 9월 2일 부터 시작됩니다.
NVIDIA RTX PRO 4000 SFF 및 RTX PRO 2000 Blackwell GPU: 컴팩트 워크스테이션 가속
서버 중심 출시와 함께 NVIDIA는 전문가용 워크스테이션을 겨냥한 두 가지 새로운 Blackwell 기반 모델인 RTX PRO 4000 SFF Edition과 RTX PRO 2000으로 데스크톱 GPU 라인업을 확장합니다. 두 모델 모두 엔지니어링, 미디어 제작, 건축 등 다양한 산업 분야에서 차세대 AI와 그래픽 가속의 이점을 작고 에너지 효율적인 워크스테이션에 제공하도록 설계되었습니다.
RTX PRO 4000 SFF Edition은 4세대 RT 코어와 2.5세대 텐서 코어를 유지하면서도 일반 GPU의 절반 크기에 불과합니다. 이전 모델 대비 최대 1.7배 향상된 AI 성능, 1.5배 향상된 레이 트레이싱, 그리고 70배 향상된 메모리 대역폭을 제공하며, 이 모든 것이 XNUMXW의 전력 소모량으로 구현됩니다.
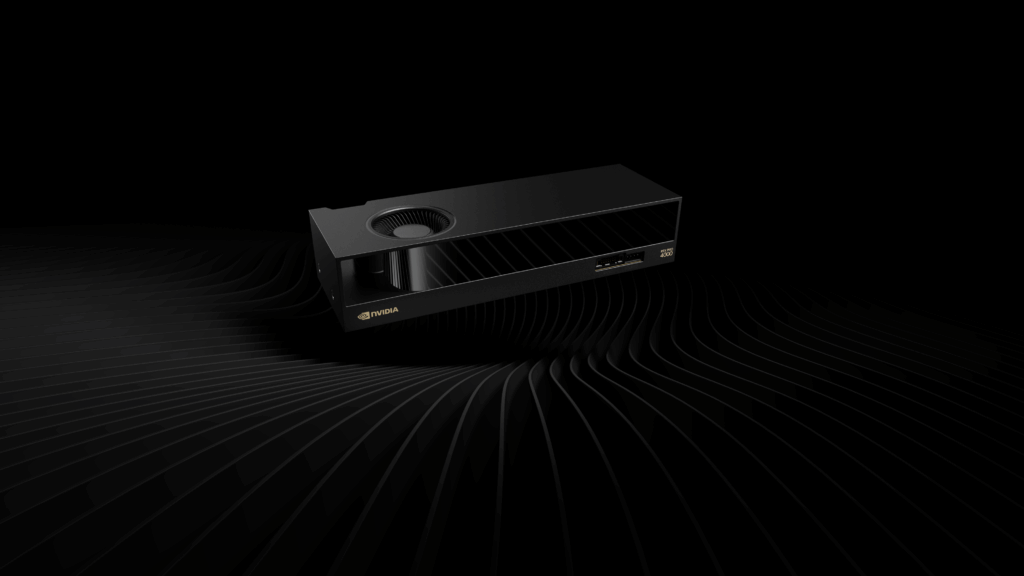
RTX PRO 2000은 주류 디자인 및 AI 작업을 목표로 하며, NVIDIA는 이전 세대보다 최대 1.6배 빠른 3D 모델링, 1.4배 빠른 CAD 성능, 그리고 1.6배 빠른 렌더링 속도를 제공한다고 밝혔습니다. 또한 생성적 AI 워크로드에서도 눈에 띄는 발전을 이루어, 이미지 생성 속도가 1.4배, 텍스트 생성 속도가 2.3배 향상되어 더욱 신속한 프로토타입 제작과 반복 작업이 가능합니다.
엔비디아는 마일 하이 홍수 방지 지구, 칸타브리아 주 정부 지리공간국, 그리고 스튜디오 팀 푸(Studio Tim Fu)와 같은 디자인 스튜디오에서 실시한 실제 테스트 결과를 통해 RTX PRO 2000이 대규모 데이터 세트, 지리공간 워크로드, 그리고 AI 기반 설계 워크플로우를 처리하는 데 얼마나 유용한지 입증했습니다. 엔지니어링 회사 손튼 토마세티(Thornton Tomasetti)의 벤치마크 결과에 따르면 RTX PRO 27은 이전 세대보다 구조 분석 속도가 거의 XNUMX배, CPU 기반 방식보다 XNUMX배 이상 빠른 것으로 나타났습니다.
두 모델 모두 올해 하반기에 주요 OEM 및 유통 파트너를 통해 출시될 예정입니다.
SIGGRAPH 포커스: 물리적 AI 시대의 워크스테이션
SIGGRAPH에서 NVIDIA는 전문가용 AI 및 시뮬레이션 워크플로우를 지원하는 RTX PRO 워크스테이션 라인업(새로운 RTX PRO 4000 SFF 및 RTX PRO 2000 포함)의 역할을 강조했습니다. NVIDIA는 하드웨어 외에도 소프트웨어 생태계를 도입의 핵심 동력으로 삼고 있습니다.
NVIDIA AI Enterprise 제품군은 인프라 전반에 걸쳐 AI를 개발하고 확장할 수 있는 도구를 제공하며, Cosmos 플랫폼은 로봇 공학, 자동화 및 엣지 AI에 최적화된 기반 모델을 제공합니다. Omniverse 플랫폼은 3D 시뮬레이션, 협업 설계 및 디지털 트윈 워크플로의 핵심 역할을 하며, 하드웨어의 AI 기능과 직접 통합됩니다.
작고 효율적인 GPU와 잘 개발된 AI 소프트웨어 스택의 조합은 업계가 얼마나 빠르게 변화하고 있는지를 보여줍니다. AI 가속 컴퓨팅은 더 이상 대규모 데이터 센터에서만 가능한 일이 아닙니다. 이제 더 작은 워크스테이션도 생성형 AI 콘텐츠 제작부터 로봇 시뮬레이션까지, 이전에는 훨씬 더 크고 전력 소모가 큰 시스템을 필요로 했던 동일한 종류의 작업을 처리할 수 있습니다.
Dell, NVIDIA 및 Elastic과 협력해 AI 데이터 플랫폼 확장
NVIDIA와 Elastic과 협력하여 데이터 수집부터 추론까지 전체 AI 워크플로우를 처리하도록 설계된 Dell AI 데이터 플랫폼에 대한 업데이트도 발표되었습니다. Elastic의 벡터 검색을 기반으로 하는 새로운 비정형 데이터 엔진은 시맨틱 검색과 하이브리드 키워드 검색 기능을 추가하여 대규모 비정형 데이터 세트에 더욱 빠르고 정확하게 접근할 수 있도록 지원합니다. GPU 가속을 사용하며, 페더레이션 SQL 엔진, 대규모 데이터 처리, 고속 AI 지원 스토리지와 같은 기존 도구와 함께 작동합니다.
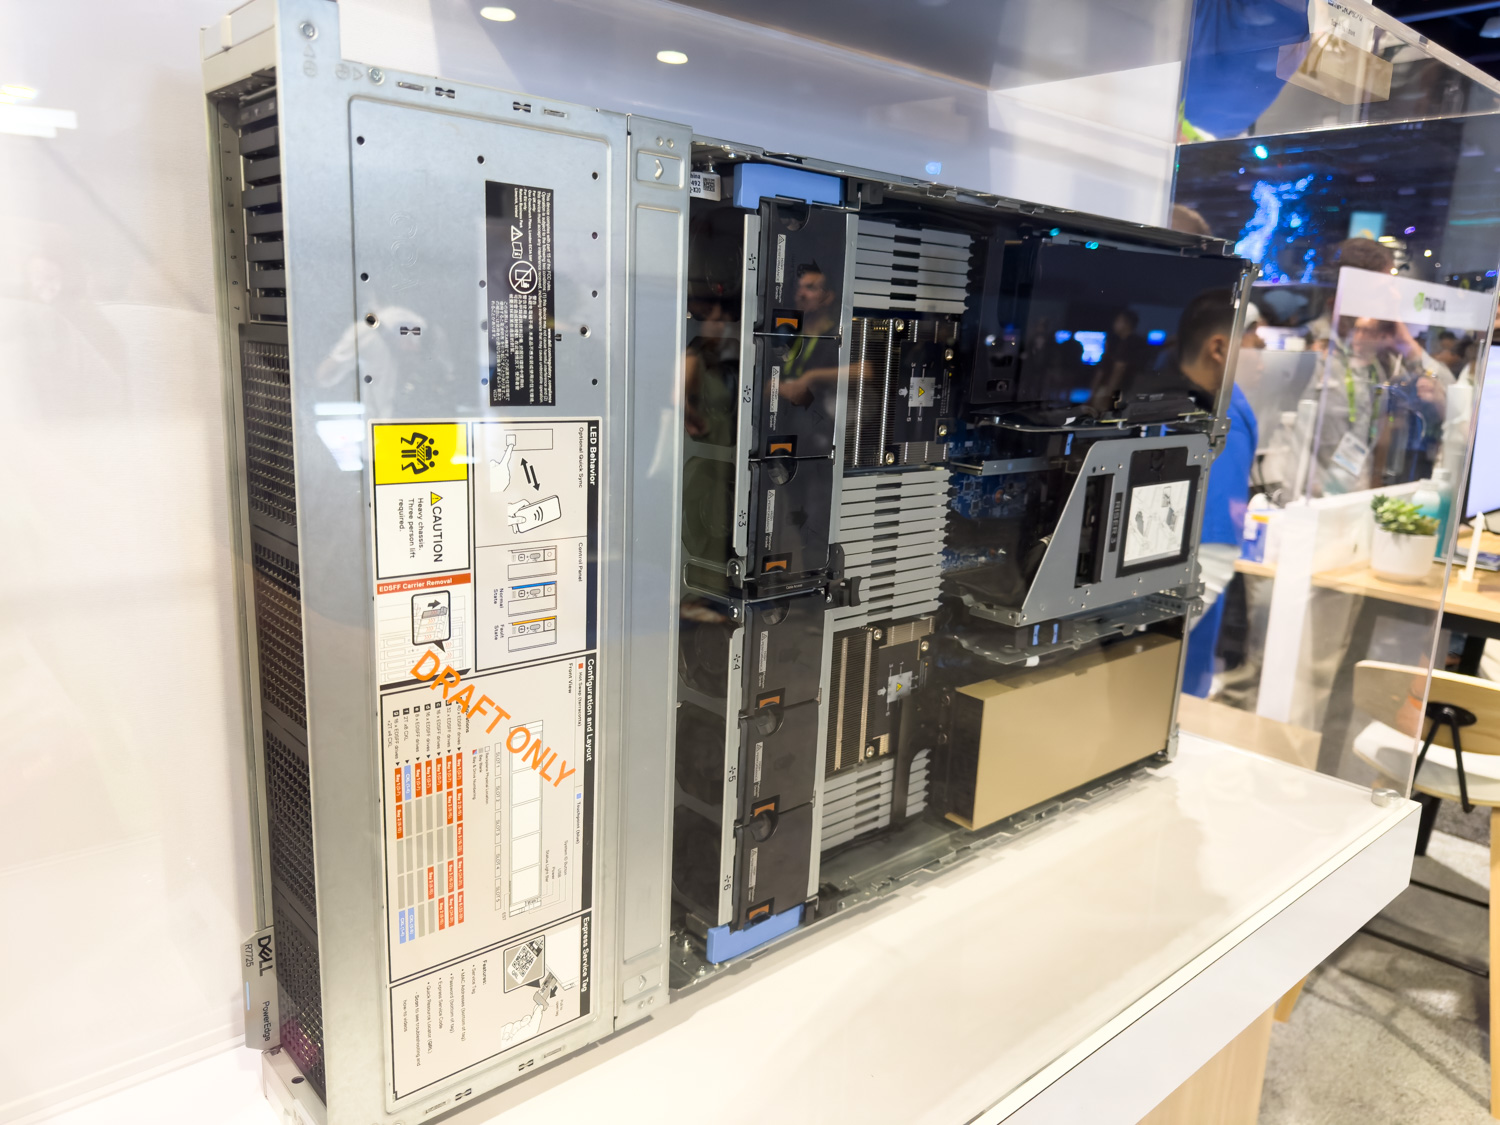
이제 이 플랫폼은 NVIDIA AI 데이터 플랫폼 레퍼런스 디자인과 통합되어 스토리지, 컴퓨팅, 네트워킹 및 AI 소프트웨어를 결합한 검증된 아키텍처를 제공합니다. 이 구성을 최초로 탑재한 하드웨어는 앞서 언급한 NVIDIA RTX PRO 6000 Blackwell Server Edition GPU가 장착된 2U 서버인 Dell PowerEdge R7725입니다 . 이러한 시스템은 대규모 언어 모델 추론, 엔지니어링 시뮬레이션, NVIDIA NeMo 및 Cosmos와 같은 모델을 사용한 AI 추론 등의 워크로드를 대상으로 합니다.
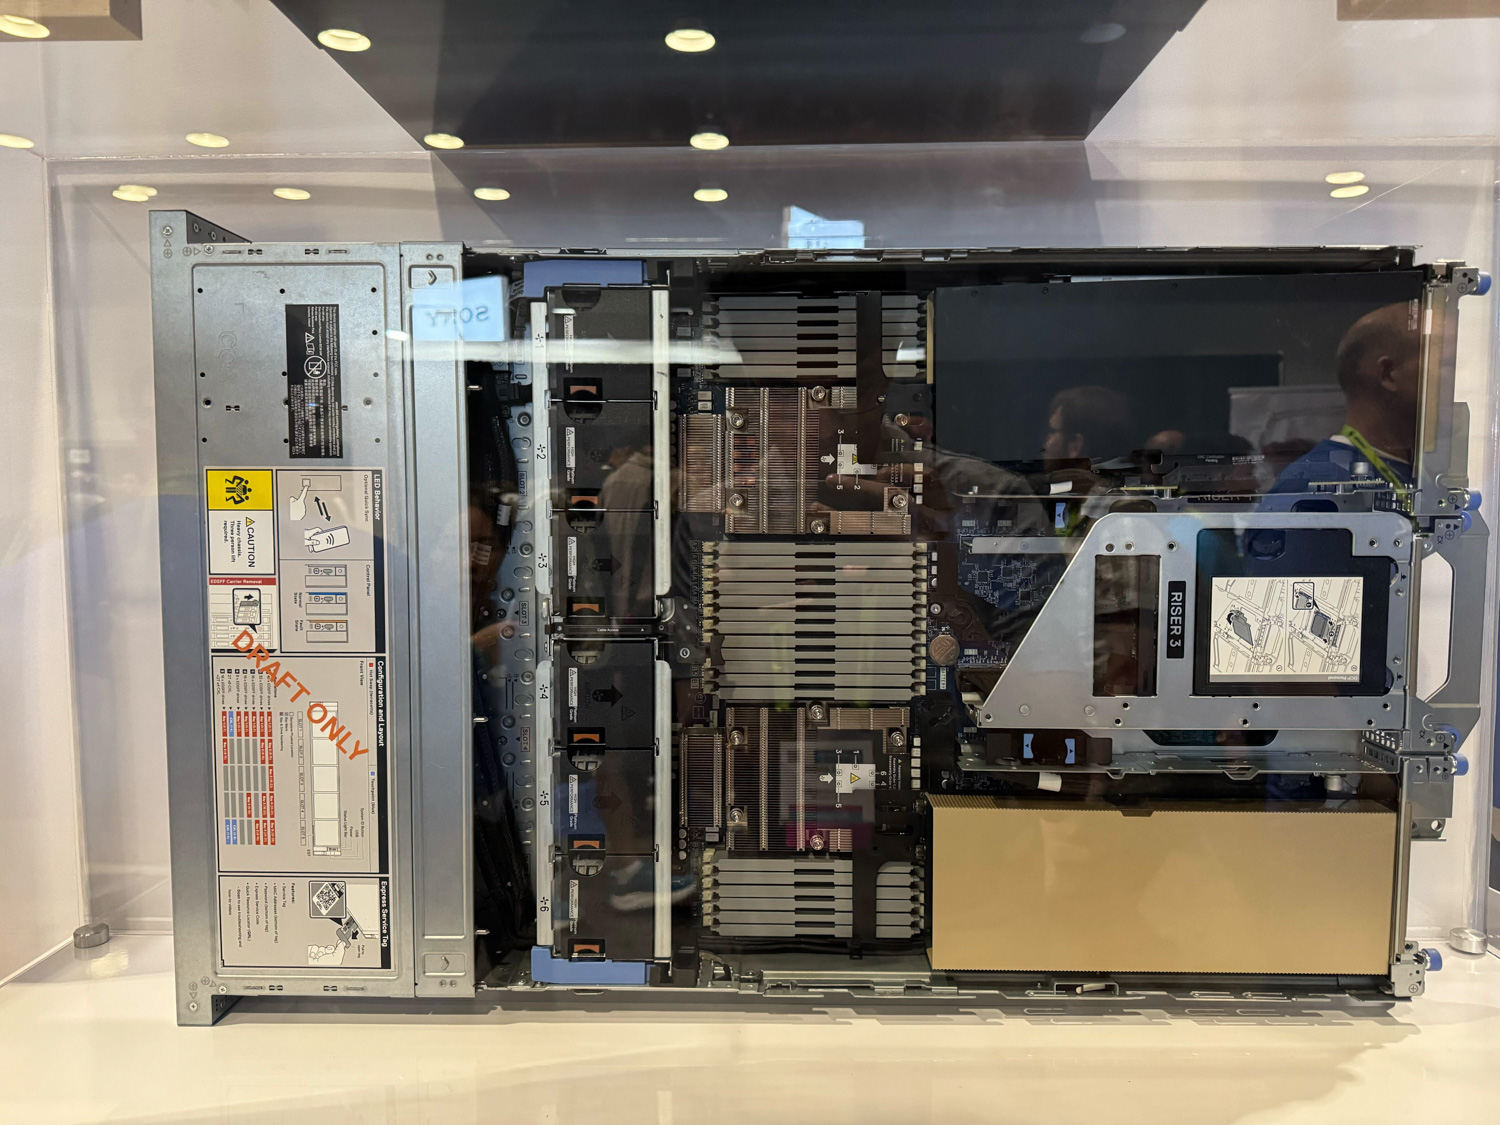
Dell은 RTX PRO 6000이 이전 세대보다 최대 7725배 높은 LLM 토큰 처리량, XNUMX배 향상된 엔지니어링 시뮬레이션 성능, 그리고 XNUMX배 더 많은 동시 MIG 사용자를 지원할 수 있다고 밝혔습니다. RXNUMX를 업데이트된 플랫폼과 결합하면 더 빠른 추론, 반응형 시맨틱 검색, 그리고 맞춤형 시스템 설계 없이도 대규모 AI 워크로드를 처리할 수 있는 턴키 옵션을 제공합니다.
Dell은 SIGGRAPH 2025에서 Dell Pro Max PC 라인업과 함께 이러한 기능을 시연하고 있으며, 곧 GB10 AI 개발자 워크스테이션이 탑재된 컴팩트한 Pro Max도 추가될 예정입니다.
HPE, ProLiant 서버에 RTX PRO 6000 Blackwell 탑재
마지막으로 HPE의 NVIDIA AI 컴퓨팅 포트폴리오에 새로운 제품이 추가되었으며, 2U 폼팩터의 ProLiant Compute 서버에 RTX PRO 6000 Blackwell Server Edition GPU가 탑재됩니다 . 두 가지 구성이 제공될 예정입니다. ProLiant DL385 Gen11은 새로운 2U RTX PRO 서버 폼팩터에 최대 2개의 RTX PRO 6000 GPU를 장착할 수 있으며, ProLiant DL380a Gen12는 4U 설계에 최대 8개의 GPU를 지원합니다. 두 제품 모두 2025년 9월 2일부터 출하될 예정입니다.
이 서버는 생성 및 에이전트 AI부터 로봇 공학, 산업 애플리케이션, 시뮬레이션, 비주얼 컴퓨팅에 이르기까지 광범위한 워크로드를 위해 설계되었습니다. Gen12 ProLiant 모델은 실리콘 기반 Root of Trust를 지원하는 HPE iLO(Integrated Lights Out) 7, 안전한 엔클레이브, 양자 방어 펌웨어 서명 등 계층화된 보안 기능을 포함합니다. HPE Compute Ops Management는 배포 및 유지 관리를 위한 중앙 집중식 자동화를 제공하여 서버 관리 시간과 다운타임을 줄여줍니다.
HPE는 NVIDIA와 공동 개발한 차세대 프라이빗 클라우드 AI 플랫폼도 선보였습니다. 이 업데이트는 RTX PRO 6000 GPU를 지원하고, GPU 세대 간 원활한 확장성을 제공하며, 에어갭 관리 및 엔터프라이즈 멀티테넌시와 같은 기능을 포함합니다. 이 플랫폼은 에이전트 AI를 위한 NVIDIA의 최신 Nemotron 추론 모델, 로봇 및 물리 AI를 위한 Cosmos Reason 비전 언어 모델, 그리고 업데이트된 비디오 검색 및 요약을 위한 블루프린트(VSS 2.4)와의 호환성을 추가합니다. 이러한 추가 기능은 기업이 대량의 비디오 및 시각 데이터를 처리하고 분석할 수 있는 AI 에이전트를 신속하게 구축할 수 있도록 지원합니다.


 아마존