

AMD는 산호세에서 열린 Advancing AI 행사에서 차세대 GPU인 Instinct MI350 시리즈와 미래 AI 가속 플랫폼에 대한 공격적인 로드맵을 공개했습니다. 첨단 CDNA4 아키텍처를 기반으로 구축된 MI350 시리즈는 까다로운 AI 워크로드에서 상당한 성능 향상을 약속합니다. 이번 발표에는 향후 Instinct 라인업에 대한 미리보기도 포함되어, AI 하드웨어 분야의 지속적인 혁신에 대한 AMD의 의지를 강조했습니다.
AMD 본능 MI350 시리즈
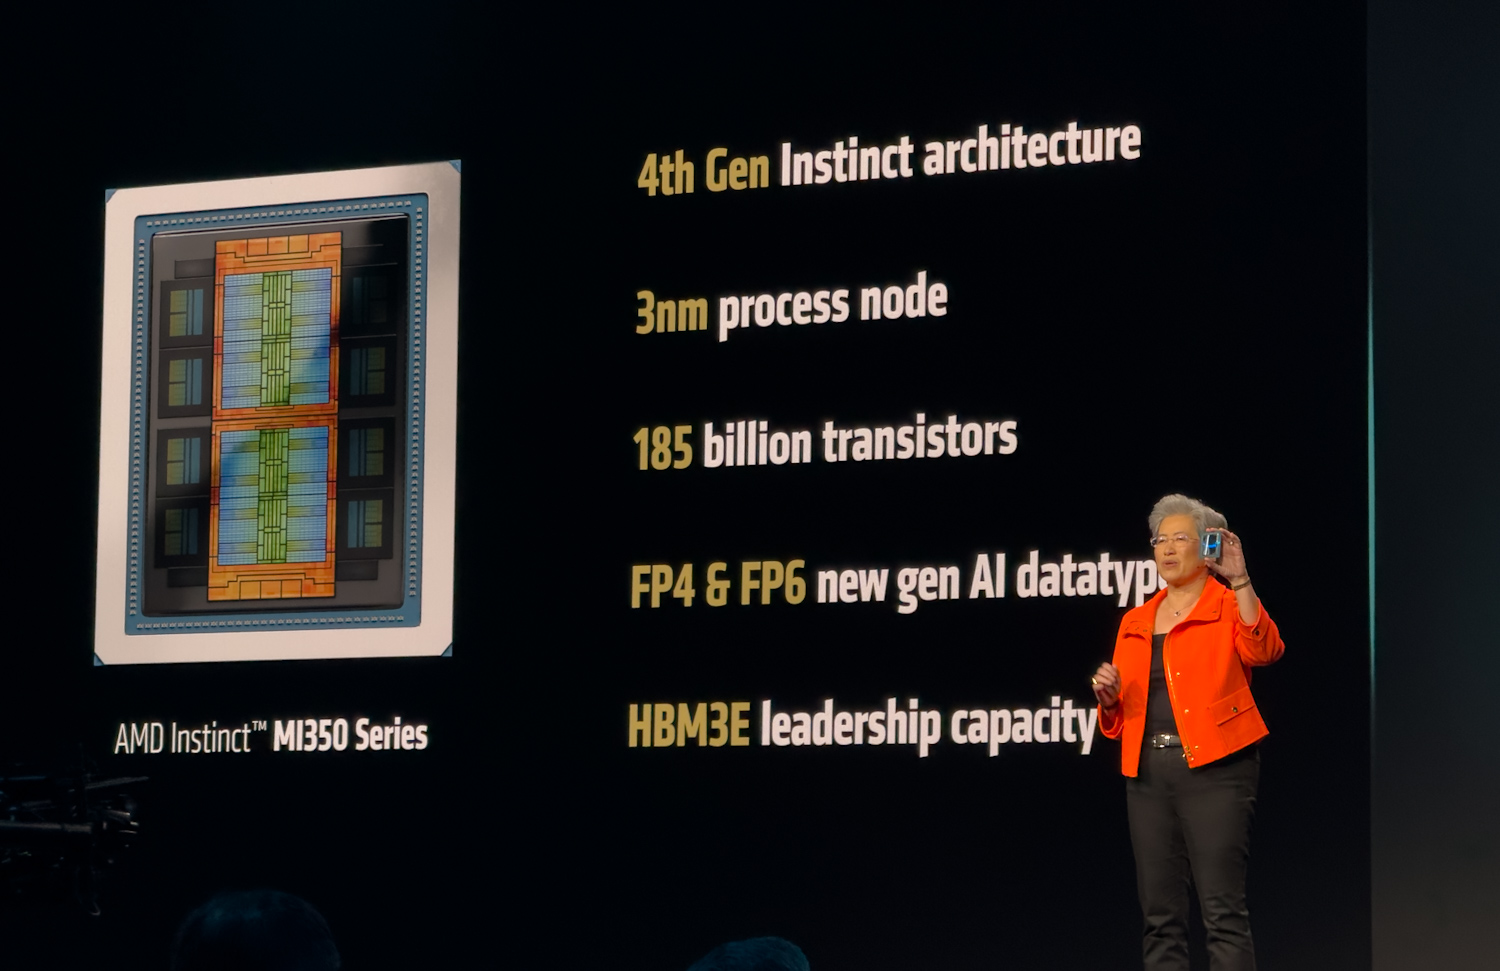
AMD Instinct MI350 시리즈는 새로운 CDNA4 아키텍처를 기반으로 AI 컴퓨팅 성능에 있어 획기적인 도약을 이루었습니다. AI 워크로드에 특화된 CDNA4 아키텍처는 향상된 행렬 엔진, 새로운 데이터 형식 지원, 그리고 에너지 효율성의 획기적인 개선을 제공합니다.
고급 패키징 및 칩렛 아키텍처: MI350의 기반
MI350 시리즈는 AMD의 첨단 3D 칩렛 패키징 기술을 기반으로 제작되었으며, 주요 기능이 향상된 MI300 시리즈에서 발전되었습니다.
칩렛 설계 및 제작
GPU 패키지의 핵심은 주요 연산 엔진인 3개의 가속기 연산 칩렛(XCD)입니다. 이 XCD는 MI3 시리즈에 사용된 5nm 기술에서 업그레이드된 첨단 300nm 노드 4+ 공정으로 제조되어 에너지 효율을 크게 향상시킵니다. 각 XCD에는 32개의 셰이더 엔진이 내장되어 있으며, 각 엔진에는 256개의 활성 CDNAXNUMX 연산 유닛이 포함되어 XCD당 XNUMX개의 CU를 처리하고, 가속기에는 총 XNUMX개의 CU가 사용됩니다.

XCD를 보완하는 두 개의 IO 다이(IOD)는 MI300 시리즈의 네 개 IOD보다 훨씬 작습니다. 6nm 공정으로 제조된 이 IOD는 메모리 액세스, I/O 작업, 그리고 칩렛 간 통신을 처리합니다. 더욱 넓어진 내부 상호 연결과 결합된 이 간소화된 두 개의 IOD 설계는 대역폭 목표를 유지하면서도 전력 소비를 줄입니다.
물리적 통합과 논리적 통일성
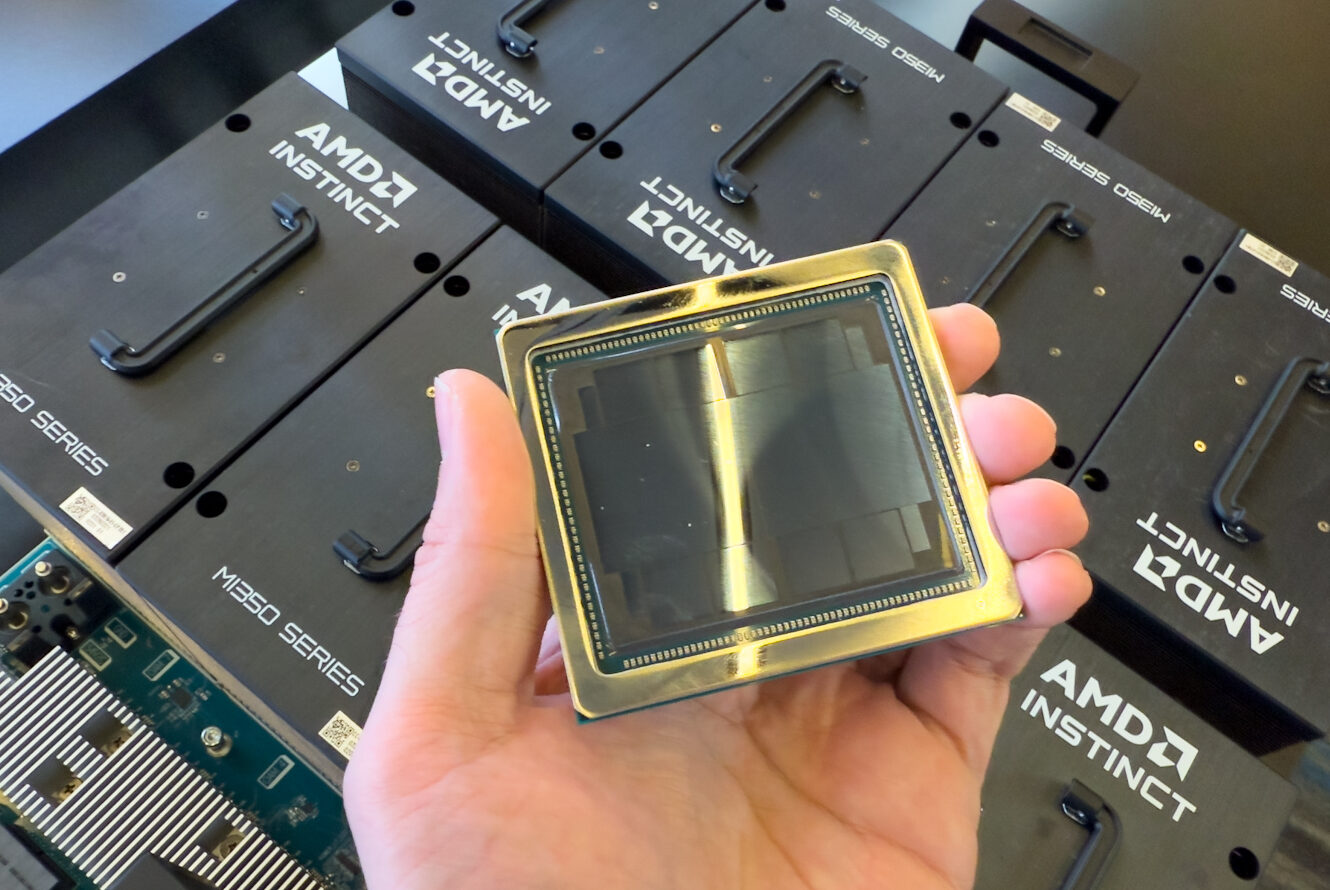
물리적 조립에는 XCD와 HBM3E 메모리 스택을 COOS(Chip-on-Wafer-on-Substrate) 인터포저에 장착하는 과정이 포함됩니다. 이 설계의 핵심은 XCD와 그 아래에 위치한 IOD를 하이브리드 본딩하는 것입니다. 이 3D 하이브리드 본딩 기술은 컴퓨팅 칩렛과 I/O 칩렛 사이에 매우 고밀도의 고대역폭 상호 연결을 생성하여 기존 2.5D 구조를 크게 뛰어넘습니다. 이는 전력 소모가 큰 XCD에 데이터를 효율적으로 공급하는 데 필수적입니다. 또한, 이러한 첨단 3D 통합은 전체 GPU 설치 공간을 줄여 제조 수율과 운영 안정성을 향상시킬 수 있습니다.
복잡한 칩렛 구조에도 불구하고 MI350은 논리적으로 단일 통합 GPU로 작동합니다. 각 XCD는 명령 프로세서와 4MB L2 캐시를 포함한 글로벌 리소스를 갖춘 Accelerator Compute Complex를 구성합니다.
향상된 메모리 서브시스템
강력한 CDNA4 코어를 충분히 공급하기 위해 MI350 시리즈는 대폭 업그레이드된 메모리 서브시스템을 탑재했습니다. 3개의 HBM288E 메모리 스택을 탑재하여 GPU당 총 36GB의 용량을 제공합니다. 12개의 24Gbit 디바이스로 구성된 각 3GB 스택은 핀당 8Gbps의 최대 HBMXNUMXE 핀 속도로 작동합니다.
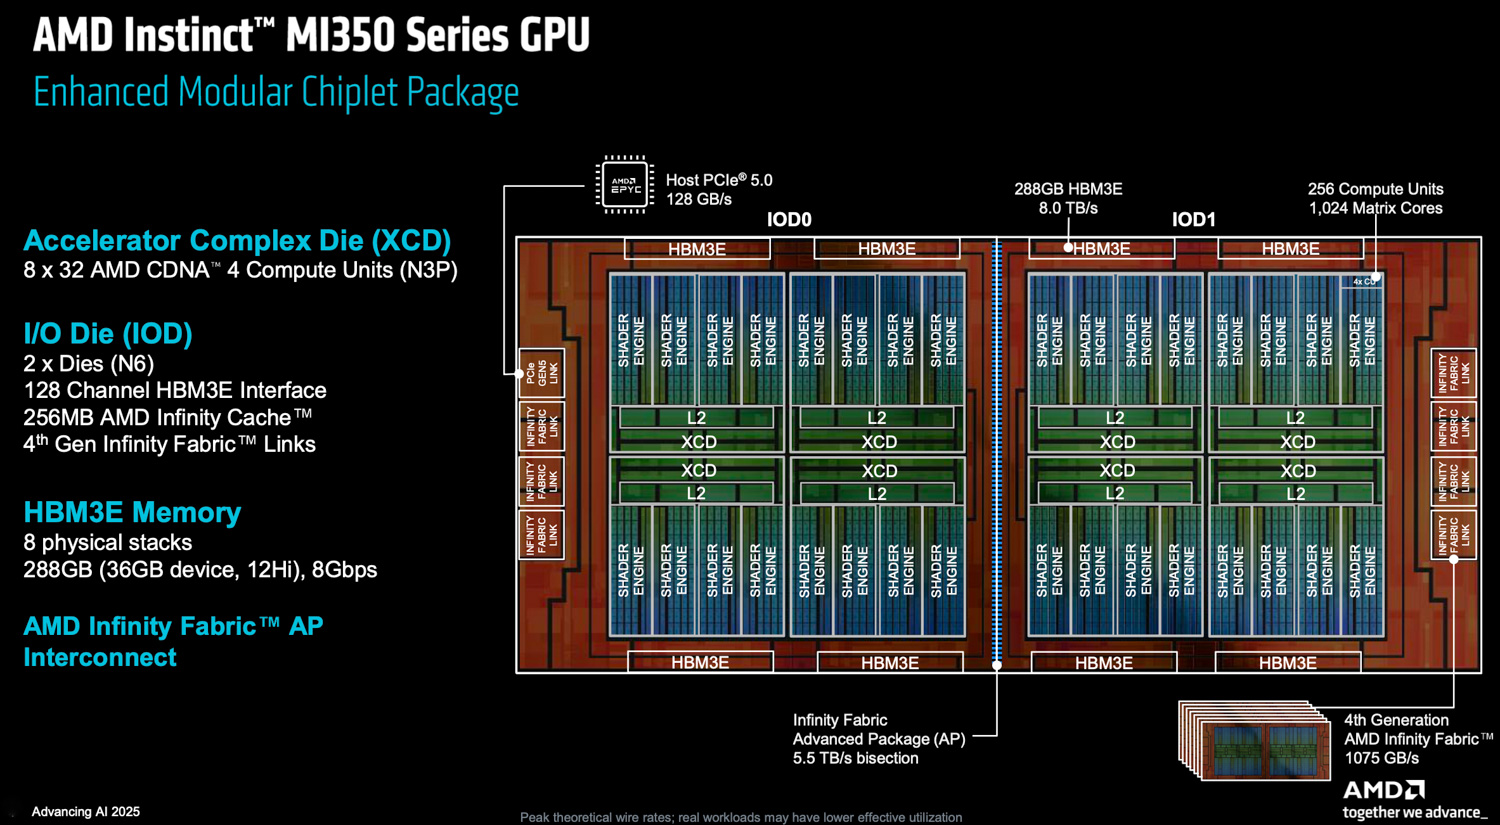
이 아키텍처는 HBM과 인피니티 패브릭/L2 캐시 사이에 위치한 핵심 메모리 측 캐시인 AMD 인피니티 캐시를 그대로 유지합니다. 이 캐시는 128개의 채널로 구성되며, 각 채널은 2MB의 캐시로 백업되어 GPU에 총 256MB의 용량을 제공합니다. 저전력에서 대역폭 전달 효율을 높이기 위해 AMD는 IOD 내의 온다이 네트워크 버스를 확장하고 저전압으로 작동시켰습니다. 이러한 최적화를 통해 비트당 에너지 소비량이 감소하여 MI350 시리즈는 이전 모델인 MI1.3 시리즈에 비해 와트당 약 300배 더 높은 메모리 대역폭을 달성할 수 있습니다.
또한, 288GB의 방대한 물리 메모리를 효과적으로 관리하기 위해 CPU TLB(Translation Lookaside Buffer)와 유사한 UTC(Universal Translation Caches) 기능이 크게 향상되었습니다. MI350 시리즈는 UTC L1 및 L2 모두에서 더욱 세밀한 페이지 크기 제어 기능과 향상된 용량을 제공합니다. 이러한 개선을 통해 TLB 도달 범위가 확대되고 가상 메모리 관리 효율성이 향상됩니다.
인피니티 패브릭 개선
AMD의 인피니티 패브릭 기술은 MI350의 확장성과 GPU 간 통신 성능의 핵심 요소입니다. 두 개의 IOD를 연결하는 인피니티 패브릭 AP 링크의 양방향 대역폭이 5.5TB/s로 크게 향상되어 GPU의 두 부분 간 효율적인 데이터 이동이 가능해졌습니다.
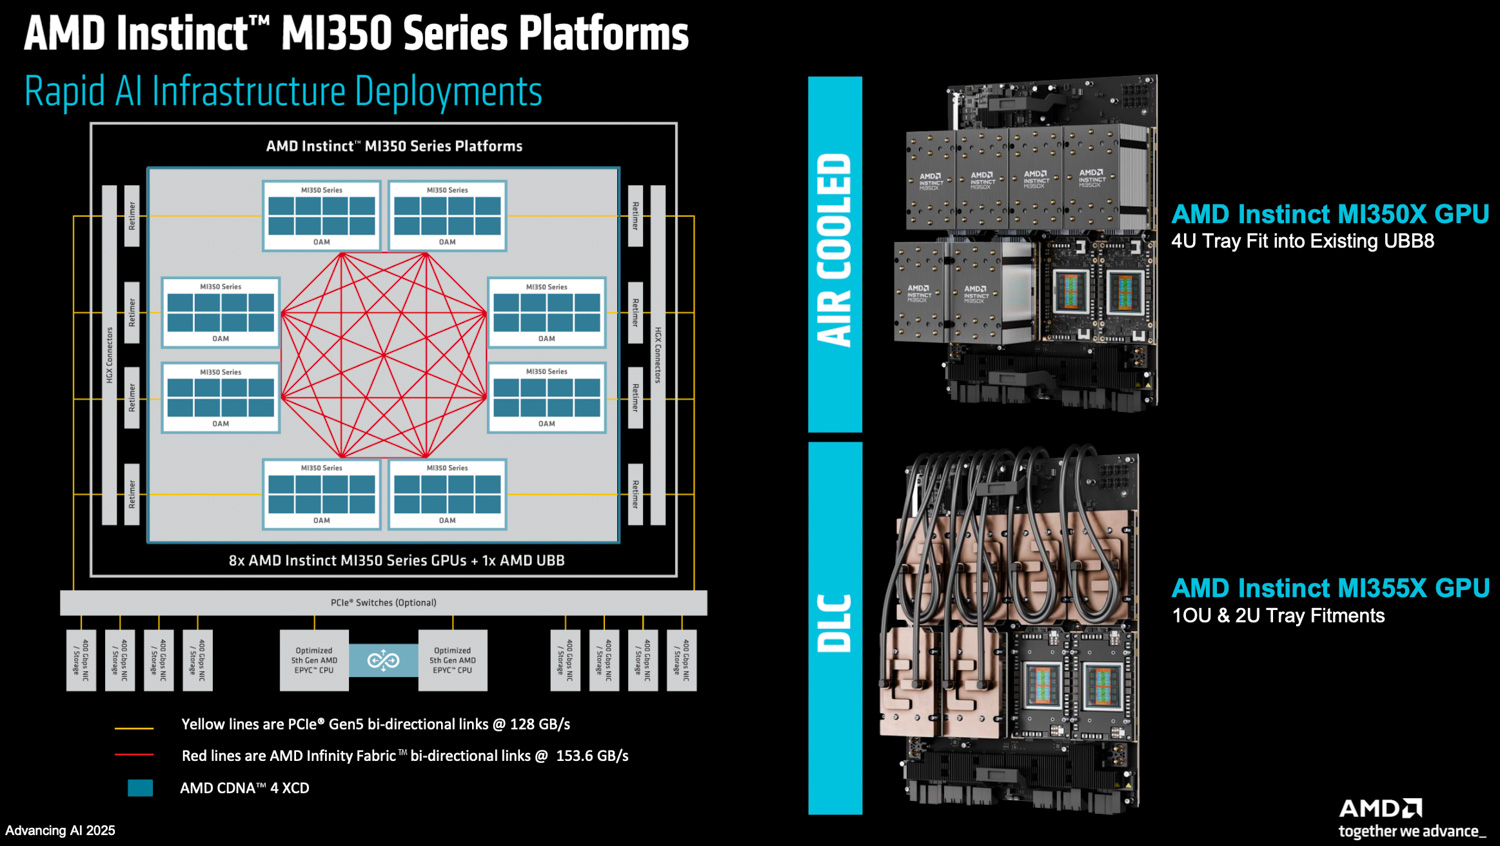
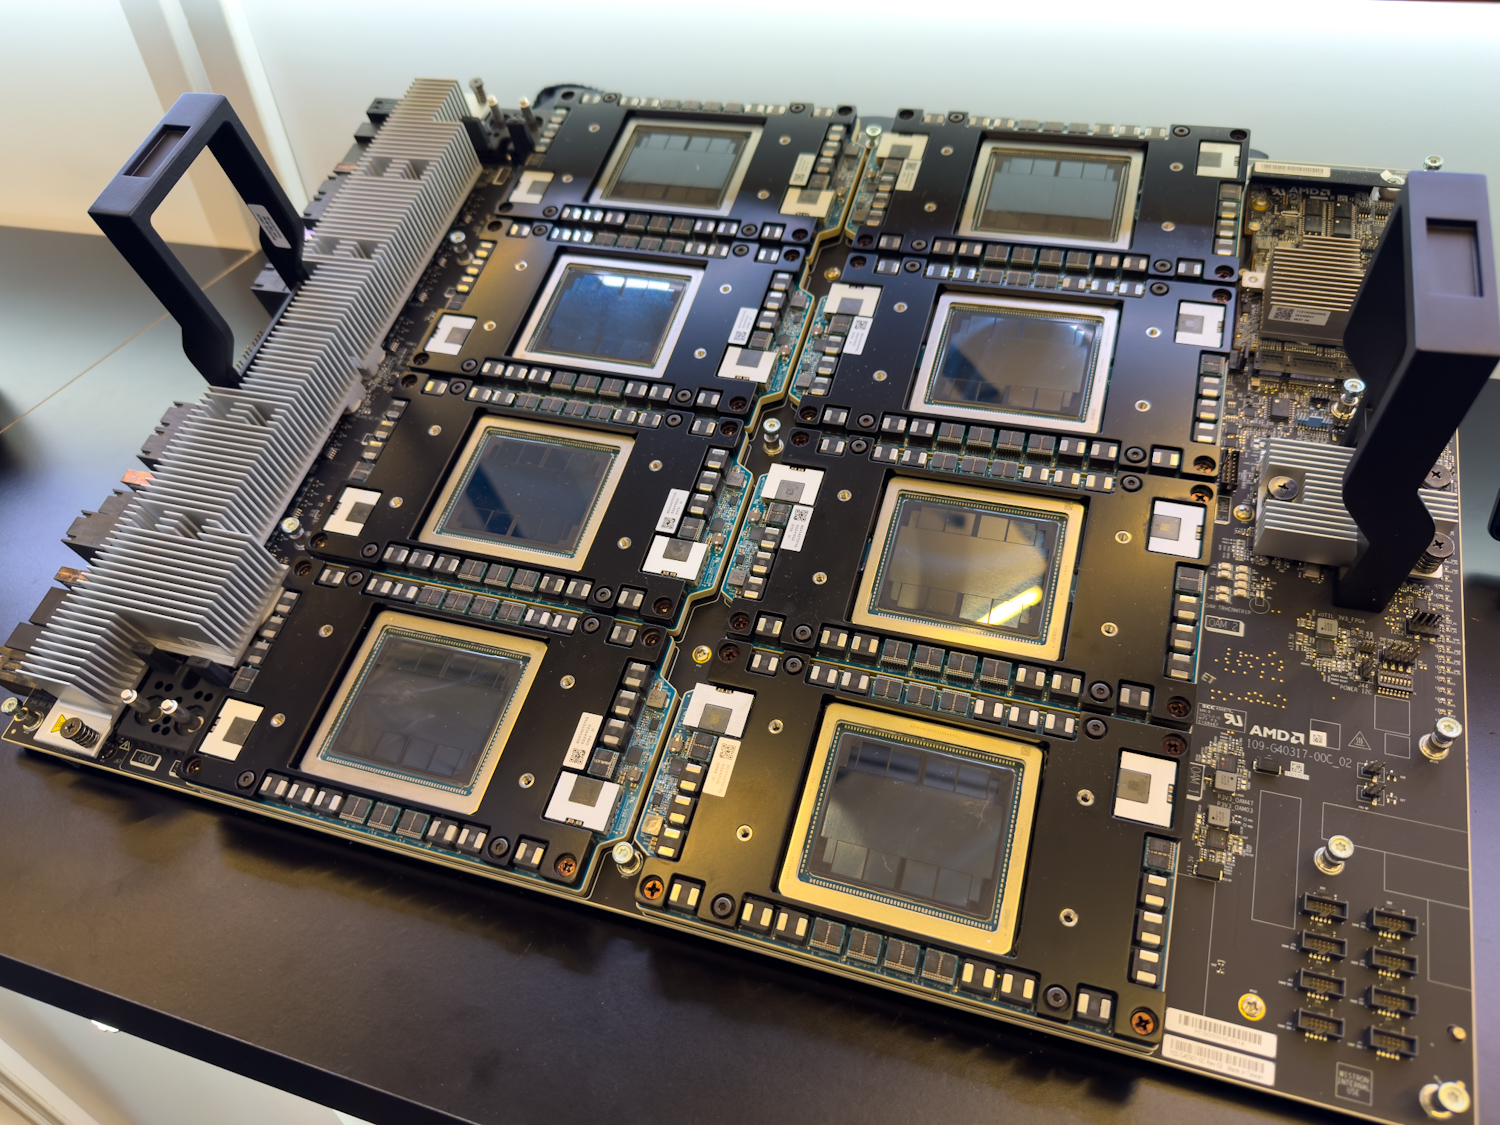
외부 통신을 위해 각 MI350 GPU는 8개의 Infinity Fabric 링크를 갖추고 있어 2.0-GPU UBB 38.4 플랫폼과 같은 구성에서 GPU 간 직접 연결을 지원합니다. 이 링크는 핀당 8Gbps의 속도로 작동합니다. 153.6-GPU OAM 설정에서 이 구성은 링크당 각 방향으로 약 3GB/s의 바이섹션 대역폭을 제공합니다. AMD는 또한 이러한 외부 링크에서 데이터 패킹 및 압축 기술을 개선하여 효과적인 대역폭 전달을 향상시켰습니다. 내부적으로 Infinity Fabric은 모든 XCD가 두 IOD를 통해 전체 HBMXNUMXE 메모리 공간에 완전하고 세분화된 인터리브 방식으로 액세스할 수 있도록 보장하여 메모리를 컴퓨팅 유닛에 단일 플랫 통합 리소스로 제공합니다.
CDNA4 컴퓨팅 코어 아키텍처
MI350의 핵심 처리 능력인 CDNA4 컴퓨팅 장치 는 AI에 맞춰 대대적인 재설계를 거쳤습니다.
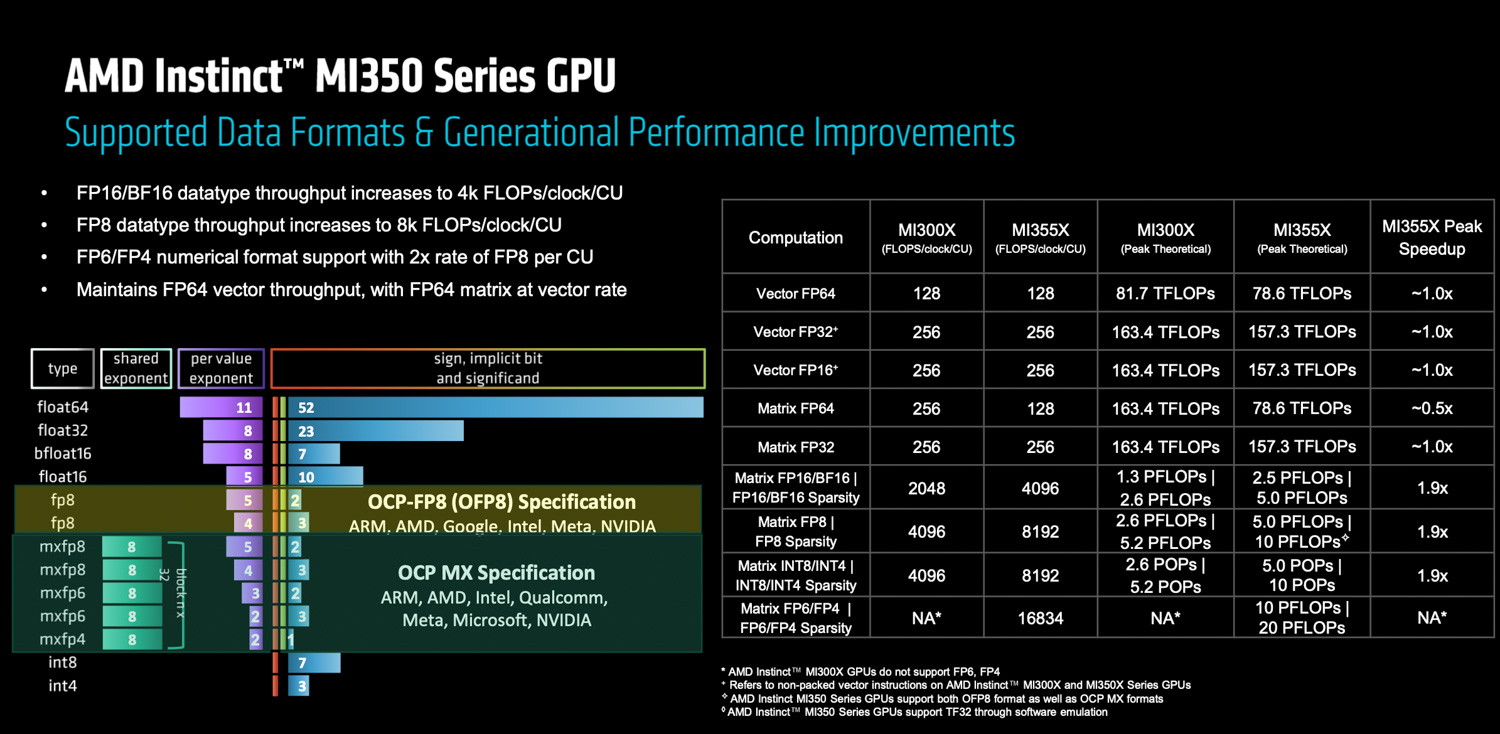
행렬 연산 기능이 크게 향상되었습니다. MI350 CU는 MI2 대비 16비트(BF16, FP16) 및 8비트(FP8, INT8) 연산에서 CU당 처리량이 300배 향상되었습니다. MI350 시리즈는 또한 OCP MX 지정 마이크로스케일 포맷, 특히 FP6에 비례하여 확장되는 FP4 및 FP8에 대한 하드웨어 지원을 도입했습니다. 특히 AMD의 구현 방식은 FP6가 FP4와 동일한 연산 속도로 작동할 수 있도록 지원합니다. 이러한 전략적 결정은 AMD가 AI 학습에 잠재력을 가진 새로운 포맷인 FP6 분야에서 선두 자리를 차지할 수 있도록 합니다. 또한, 2비트 연산을 지원하고 BF16 결과를 FP32에 누적할 수 있는 새로운 벡터 ALU가 추가되어 특정 저정밀 벡터 연산의 처리량이 향상되었습니다.
이러한 향상된 텐서 처리량을 지원하기 위해 CU당 로컬 데이터 공유(LDS) 크기가 증가했으며, 새로운 기능을 통해 글로벌 메모리에서 LDS로 데이터를 로드하는 대역폭이 향상되었습니다. 소프트맥스 및 어텐션 메커니즘과 같은 연산에서 발생할 수 있는 병목 현상을 고려하여, 텐서 코어 개선과 함께 초월 함수 처리량도 증가했습니다.
성능과 유연성을 높이기 위해 다음과 같은 몇 가지 다른 아키텍처 개선 사항이 적용되었습니다.
- 하드웨어 지원 확률적 반올림: 엔트로피를 주입하여 FP32에서 낮은 정밀도 형식으로 다운캐스팅할 때 편향을 완화합니다.
- 논리 연산자 3(LUT3) 명령어: 프로그래머에게 사용자 정의 XNUMX입력 논리 연산을 구현하기 위한 더 큰 유연성을 제공합니다.
- 새로운 최소-최대 연산자: 프로그래머가 비교 중에 NaN 전파를 제어할 수 있도록 하여 NaN 값을 전파하거나 NaN이 아닌 부동 소수점 숫자를 선택할 수 있게 함으로써 견고한 AI 데이터 관리에 도움이 됩니다.
MI350 시리즈는 AI에 중점을 두고 있지만, 벡터 및 행렬 유닛 모두에서 64비트 부동 소수점(FP64) 연산을 지원합니다. 그러나 MI300과의 주요 차이점은 MI350에서 행렬 FP64 연산이 벡터 FP64 유닛과 동일한 속도로 실행된다는 것입니다. 즉, MI64의 FP300 행렬 연산 속도의 절반에 불과합니다.
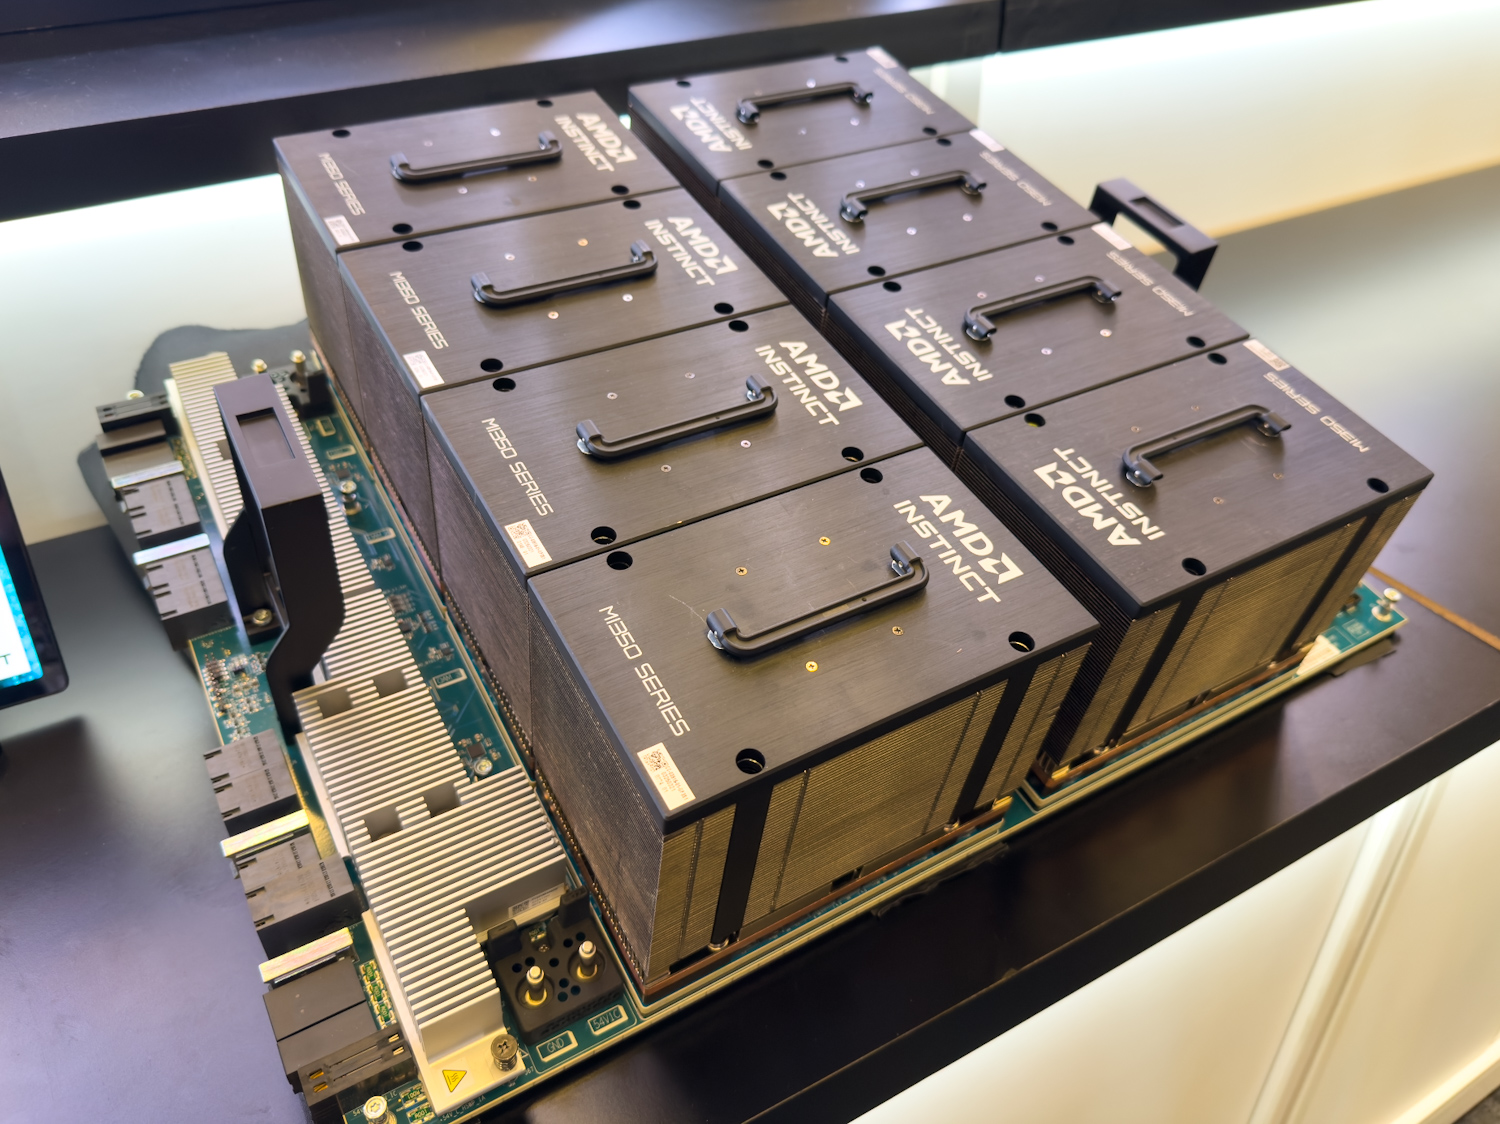
마지막으로, 더 높은 HBM3E 대역폭과 약간 줄어든 CU 수(MI256X/350X는 355개, MI304X는 300개)의 조합은 MI350 시리즈의 각 CU가 클록당 글로벌 메모리 대역폭 증가의 이점을 누릴 수 있음을 의미합니다. 이는 GEMM(일반 행렬 곱셈) 연산과 대역폭 제한 벡터 연산을 가속화하는 데 매우 중요합니다.
유연성을 위한 파티셔닝: NPS 및 컴퓨팅 파티셔닝
AMD MI350 시리즈는 향상된 파티셔닝 기능을 갖추고 있어 다양한 작업 부하에서 활용도와 효율성을 극대화하기 위해 상당한 리소스를 매우 유연하게 할당할 수 있습니다.
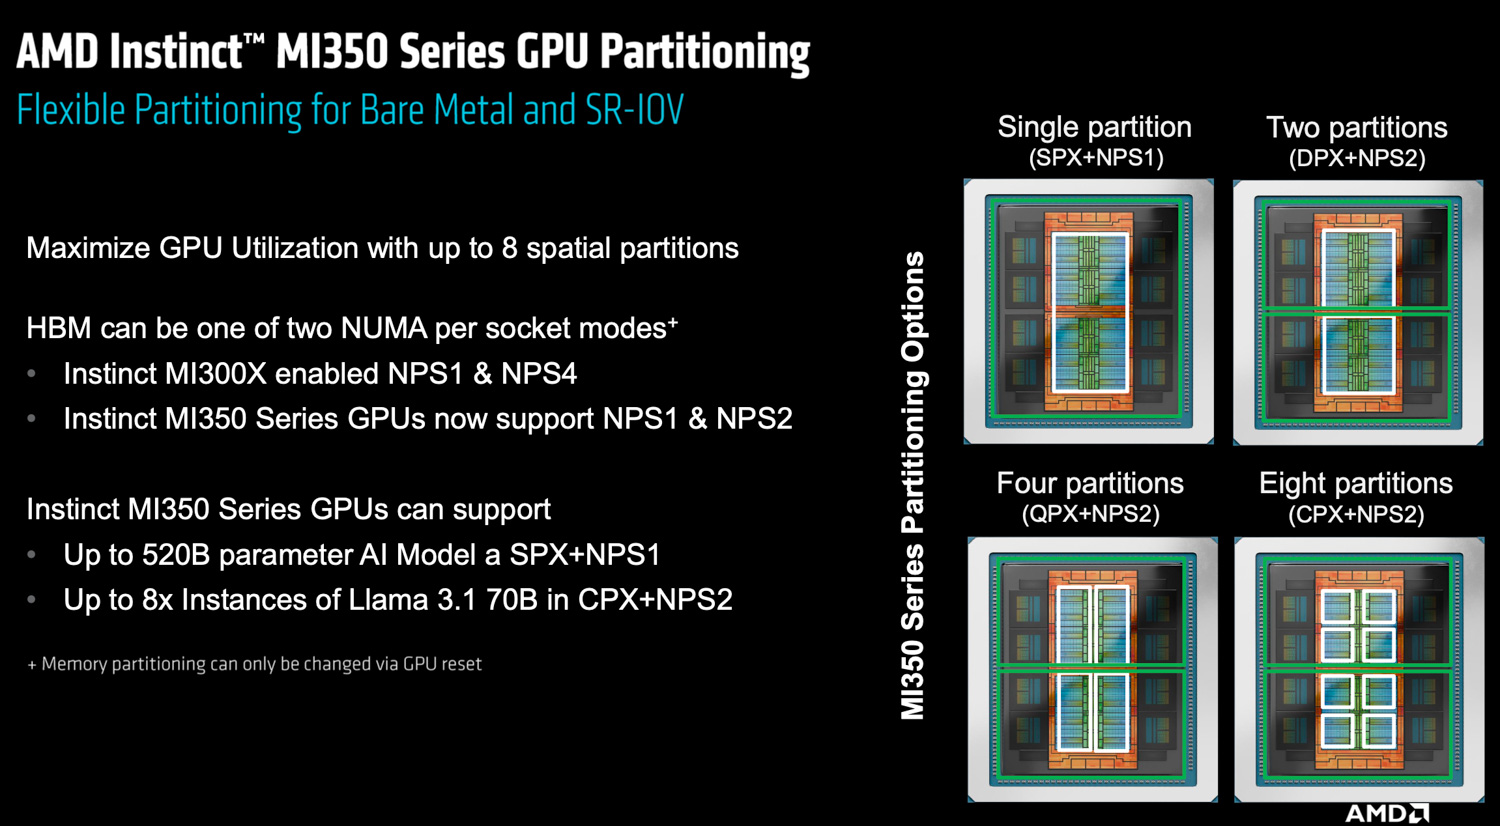
메모리 관리를 위해 MI350은 두 가지 기본 NUMA(비균일 메모리 액세스) 모드를 제공합니다.
- NPS1: 288개의 HBM 스택 전체에 걸쳐 데이터 액세스를 인터리빙하여 전체 3GB HBMXNUMXE 메모리를 단일의 통합된 NUMA 도메인으로 처리합니다.
- NPS2: 메모리를 두 개의 개별 NUMA 도메인으로 나눕니다. 각 도메인은 두 개의 IOD 중 하나와 그에 연결된 네 개의 HBM 스택에 대응합니다. NPS2 모드에서 각 IOD 내의 메모리 액세스는 미세하게 인터리빙되지만, IOD 전체에서는 거칠게 처리됩니다. 이 모드는 특히 컴퓨트 파티셔닝과 결합될 때 공간 지역성 최적화를 가능하게 합니다.
특히 AMD는 MI4(MI350에서는 지원되던)에서 NPS300 모드를 지원하지 않기로 결정했습니다. 이러한 결정은 새로운 아키텍처의 두 IOD 내에서 메모리 결합이 더욱 강화되어 추가적인 메모리 세분화를 통해 얻을 수 있는 잠재적인 성능 이점이 감소했기 때문입니다.
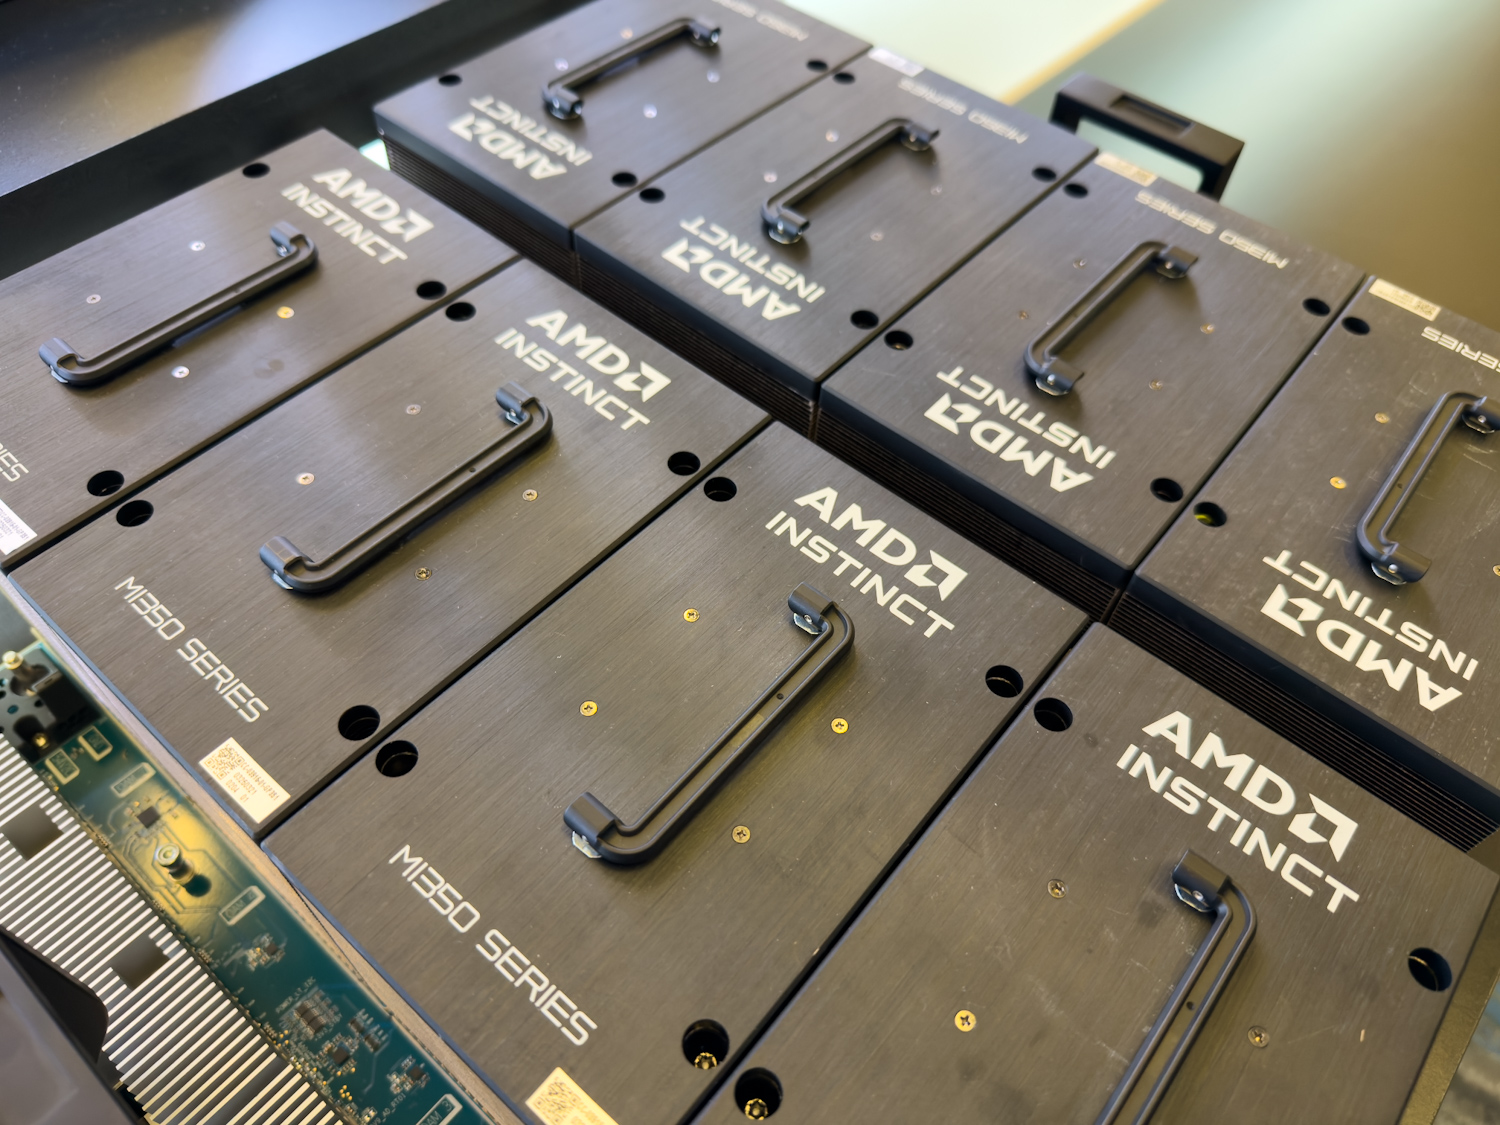
컴퓨팅 측면에서 GPU는 여러 모드에서 작동하도록 구성할 수 있습니다.
- SPX(단일 파티션 실행): GPU는 단일의 강력한 엔진으로 작동하며, 일반적으로 NPS1 메모리 모드와 함께 사용됩니다.
- DPX, QPX, OPX(듀얼, 쿼드, 옥탈 파티션 실행): GPU는 각각 2개, 4개 또는 8개의 독립적인 컴퓨팅 파티션으로 나눌 수 있습니다.
이러한 컴퓨팅 파티션은 NPS1 또는 NPS2 메모리 구성과 쌍을 이룰 수 있지만, 컴퓨팅 파티션의 세분성은 최소한 메모리 파티션만큼 미세하거나 더 미세해야 한다는 제약이 있습니다(예: SPX 모드는 NPS2 메모리 파티셔닝과 호환되지 않습니다).
이러한 다재다능한 파티셔닝 옵션은 베어 메탈 배포와 SR-IOV(단일 루트 I/O 가상화) 모두에서 지원되므로 가상화된 멀티 테넌트 환경에 이상적입니다. 예를 들어, 클라우드 또는 데이터 센터 환경에서는 단일 MI350 GPU를 논리적으로 분할하여 여러 사용자 또는 애플리케이션을 동시에 지원할 수 있습니다. 각 테넌트는 전용 메모리 및 컴퓨팅 리소스를 할당받아 서비스 품질과 보안을 보장합니다. 이는 서로 다른 가상 머신이 GPU 하드웨어에 개별적으로 액세스해야 하는 경우에 특히 유용합니다.
MI350X 대 MI355X: 다양한 배포에 맞춤화
MI350 시리즈는 다양한 배포 요구 사항과 열 범위를 충족하는 두 가지 주요 변형으로 출시되었습니다.
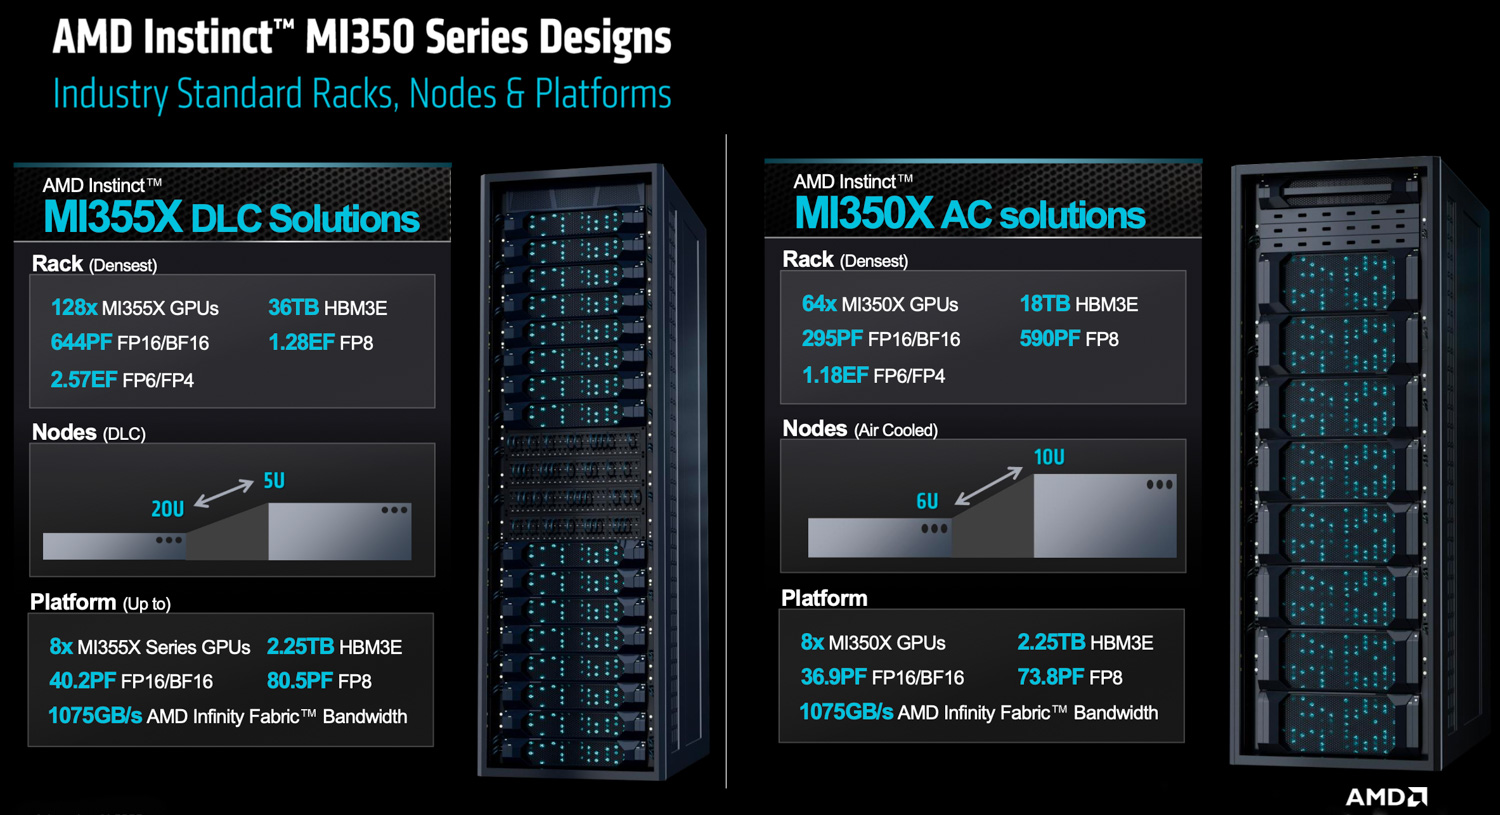
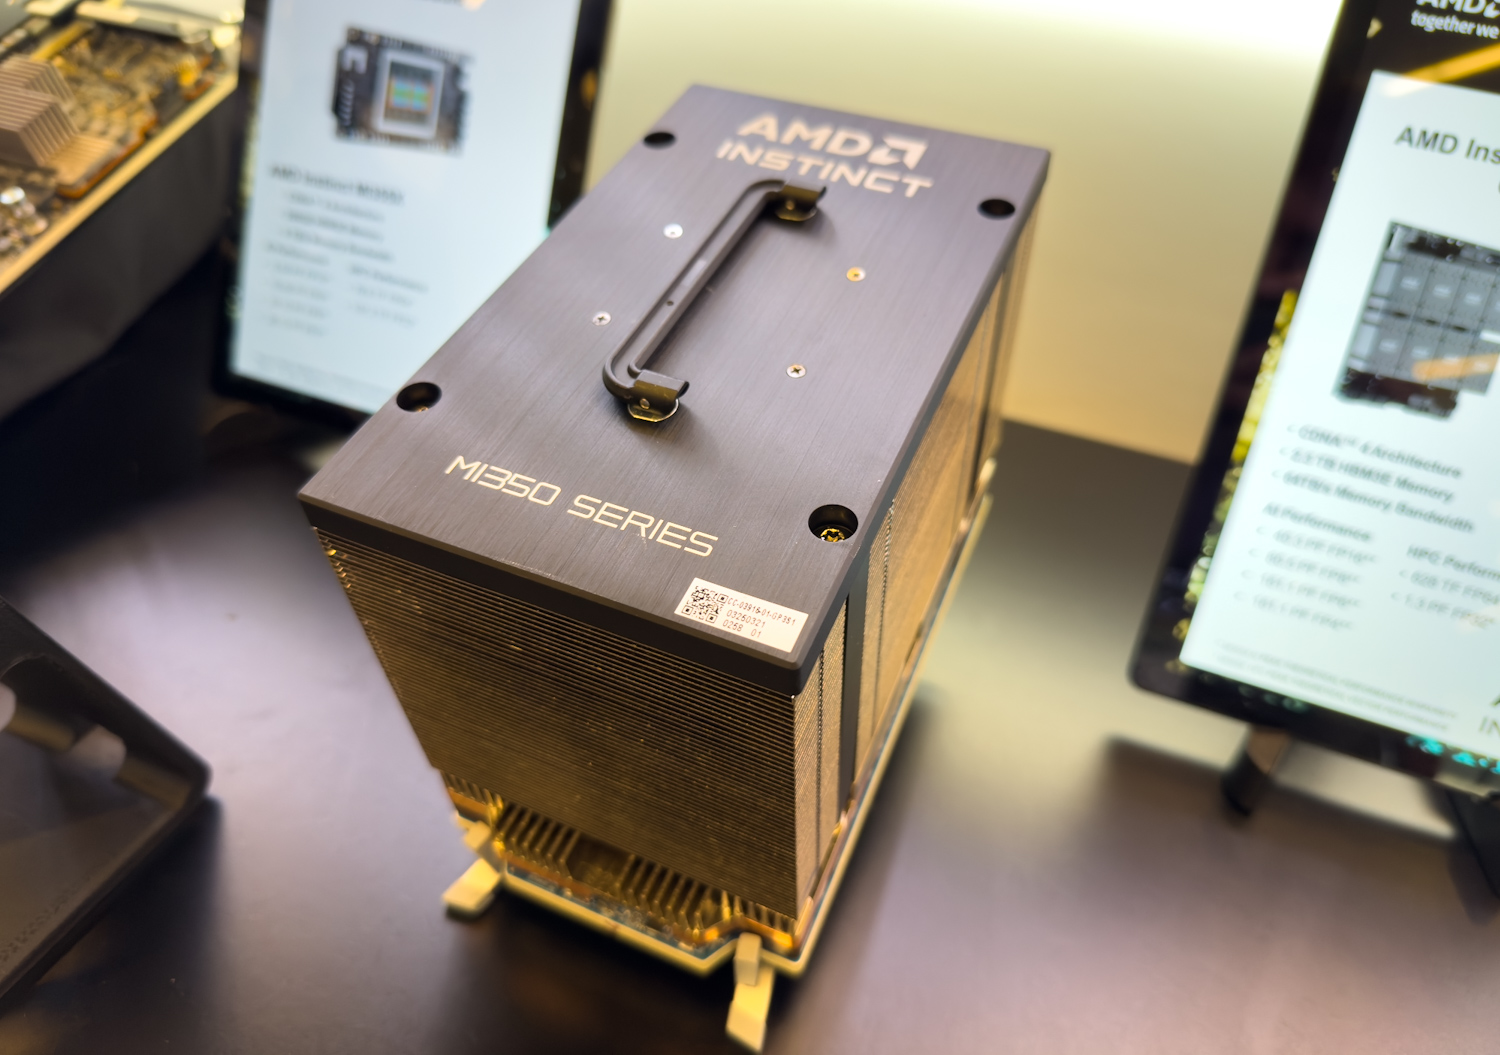
- MI350X: 이 모델은 최대 XNUMXkW의 열 설계 전력(TDP)으로 저전력 소비를 위해 설계되었습니다. 공랭식 구축을 지원하여 기존 데이터 센터 인프라 내에서 더욱 폭넓은 호환성을 제공합니다.
- MI355X: 최대 1.4킬로와트 TDP의 더 높은 시스템 전력으로 작동하는 MI355X는 주로 액체 냉각 배포를 목표로 하여 최대 성능을 제공할 수 있습니다.
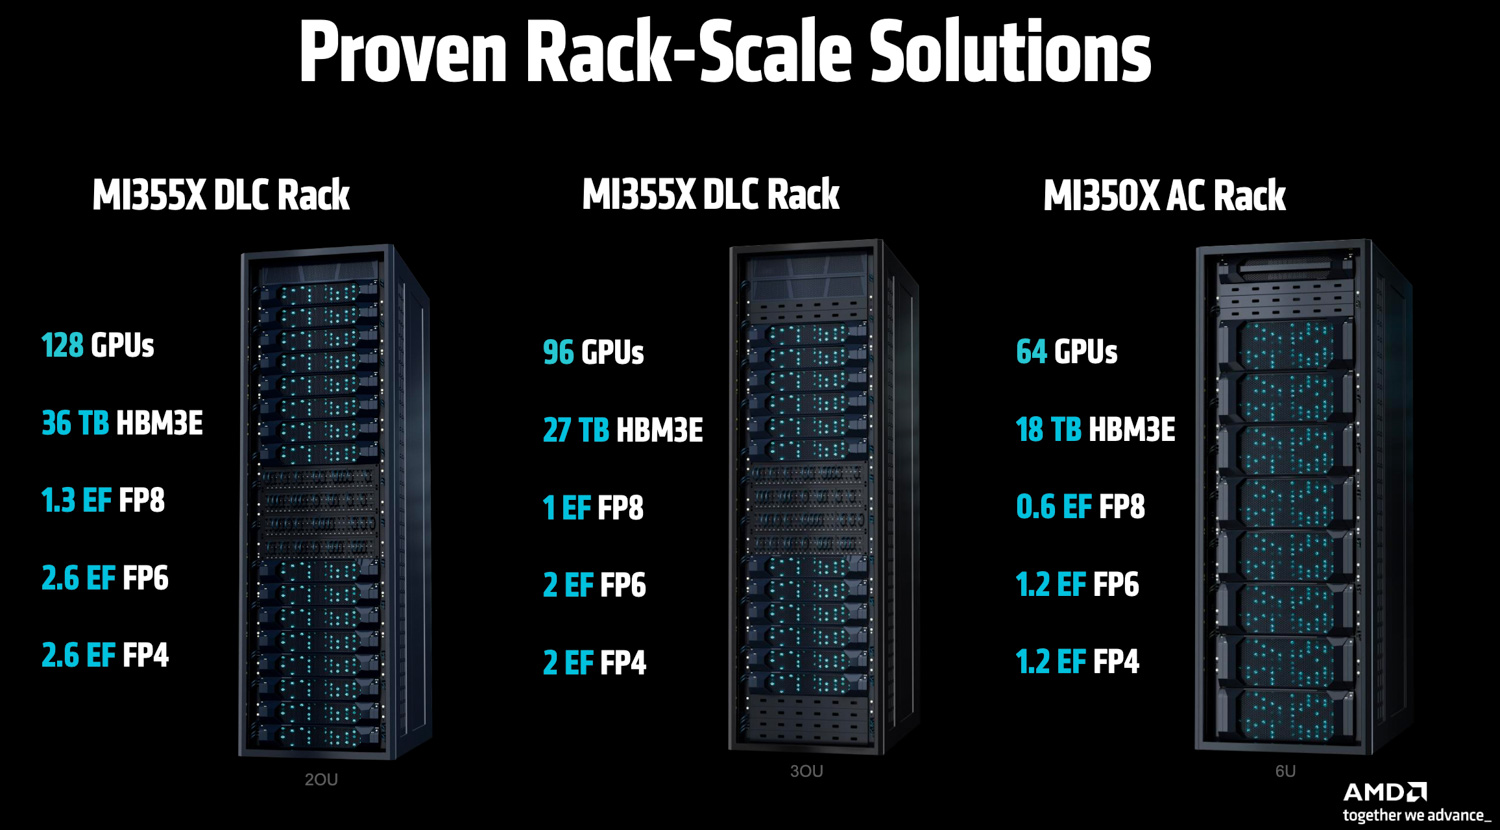
두 모델 모두 동일한 기본 하드웨어를 기반으로 구축되었지만, MI355X의 높은 작동 전력 범위는 더 높은 지속 클럭 주파수를 가능하게 합니다. 이는 MI20X와 비교했을 때 실제 엔드투엔드 워크로드에서 약 350%의 성능 향상을 의미합니다. 이 제품들은 세 가지 검증된 랙 구성으로 제공됩니다.
AMD Pensando Pollara 네트워킹
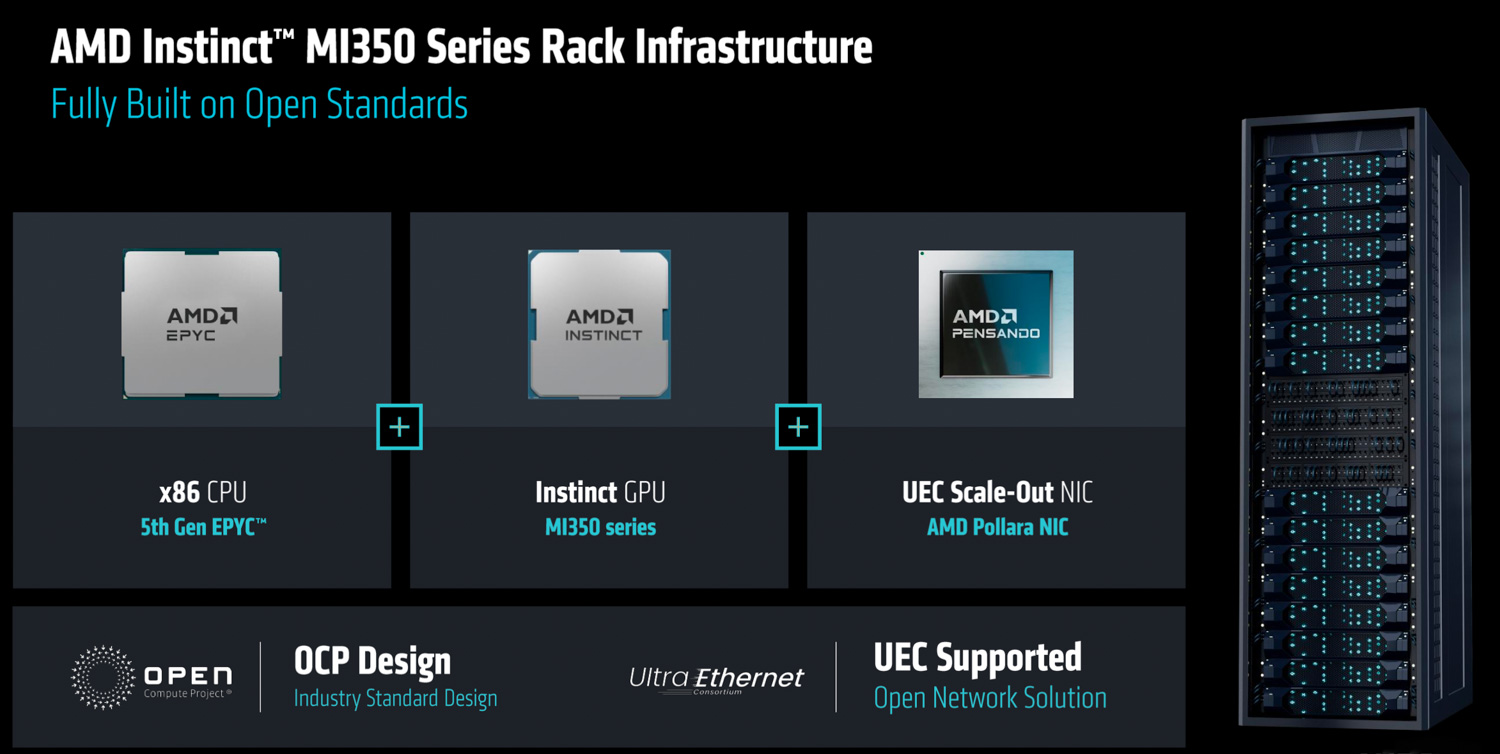
새로운 GPU 외에도 AMD는 폴라라 네트워킹 솔루션을 심층적으로 살펴보고, 대규모 인공지능 시스템의 증가하는 수요를 충족하도록 설계된 중요한 아키텍처 발전을 선보였습니다. AMD가 펜산도(Pensando)를 인수하면서 확보한 기술을 기반으로 구축된 폴라라 400 AI NIC는 AI 네트워크 패브릭에 새로운 차원의 프로그래밍 가능성과 지능을 제공합니다.

Pollara 혁신의 핵심은 프로그래밍 가능한 아키텍처에 있습니다. 고정 기능 하드웨어와 달리 Pollara NIC는 P4 프로그래밍 가능 MPU 코어를 탑재하고 있습니다. AI 네트워킹 요구 사항은 끊임없이 변화하고 새로운 프로토콜, 전송 메커니즘, 그리고 원격 측정 요구 사항이 빠르게 등장하기 때문에 이러한 설계는 매우 중요합니다. 프로그래밍 기능을 통해 Pollara NIC는 소프트웨어 업데이트를 통해 적응할 수 있으며, 하드웨어 교체 없이도 맞춤형 트래픽 관리 체계, 새로운 부하 분산 알고리즘, 그리고 맞춤형 혼잡 제어 메커니즘을 구축할 수 있습니다. 이러한 유연성은 AI 데이터 센터의 미래를 보장하고 변화하는 워크로드 특성에 신속하게 대응하는 데 필수적입니다.
폴라라는 일반적인 네트워크 병목 현상을 해결하기 위해 멀티캐스트를 도입했습니다. GPU 간 통신을 위해 단일 연결의 데이터를 여러 개의 물리적 네트워크 링크에 동시에 분산할 수 있습니다. 이러한 접근 방식은 단일 경로의 혼잡을 방지하여 전반적인 네트워크 활용도와 처리량을 향상시킵니다. NIC 자체가 목적지에 도착하는 패킷의 순서를 바꾸는 등 이러한 분산 과정의 복잡성을 관리합니다.
Pollara는 재전송에 대한 선택적 확인 응답을 통해 네트워크 효율성을 향상시킵니다. 기존 네트워크에서는 단일 패킷 손실로 인해 방대한 양의 데이터가 재전송될 수 있습니다. Pollara는 손실된 패킷만 재전송하는 더욱 정밀한 방식을 구현합니다. 이를 통해 네트워크상의 중복 데이터를 크게 줄여 대역폭 효율을 개선합니다. 또한 Pollara 네트워킹 솔루션은 손실이 발생하는 연결을 포함한 다양한 네트워크 환경에서 안정적으로 작동하도록 설계되었습니다. 정교하고 프로그래밍 가능한 경로 인식 혼잡 제어 기능을 통합하여, 현대 AI 클러스터에 필요한 대규모 환경에서 구현 및 유지 관리가 복잡하고 비용이 많이 드는 무손실 네트워크 구조에 대한 의존도를 낮춥니다.

AMD는 울트라 이더넷 컨소시엄(UEC)에도 적극적으로 참여하여 표준 제정에 기여하고 이를 구현하고 있습니다. UEC는 효율적인 부하 분산, 향상된 안정성, 그리고 AI 전용 혼잡 제어에 중점을 두고 AI에 최적화된 차세대 이더넷을 정의하는 것을 목표로 합니다. 이러한 개방형 표준을 준수함으로써 상호 운용성을 높이고 더 넓은 생태계를 조성할 수 있습니다.
마지막으로, 폴라라 기술은 AMD의 광범위한 플랫폼 내에서 시너지 효과를 발휘하도록 설계되어 CPU, GPU 및 NIC 구성 요소 전반에 걸친 공동 혁신을 가능하게 합니다. 여기에는 NIC가 특정 네트워크 집약적 통신 작업(GPU 연산이 필요하지 않은 작업)을 처리하는 공동 작업 오프로드와 같은 기능이 포함됩니다. 이를 통해 GPU 리소스를 주요 처리 작업에 사용할 수 있습니다.
ROCm 7: 고급 AI를 위한 개방형 소프트웨어 생태계
이러한 하드웨어 혁신의 근간에는 성능과 접근성을 극대화하도록 설계된 AMD의 개방형 소프트웨어 플랫폼의 최신 버전인 ROCm 7이 발표되었습니다. 7월 정식 출시에 앞서 오늘 공개 미리보기로 공개될 예정인 ROCm 3은 기존 하드웨어에서 이전 버전 대비 추론 및 학습 성능이 3.5배에서 XNUMX배까지 놀랍도록 향상되었다고 AMD는 밝혔습니다.
기업 고객을 위해 AMD는 대규모 배포를 위한 클러스터 관리, MLOps, 애플리케이션 구축 도구를 제공하는 포괄적인 제품군인 ROCm AI Enterprise를 출시합니다. 동시에 AMD는 개별 개발자들이 실험을 장려하기 위해 무료 GPU 크레딧을 제공하는 새로운 개발자 클라우드를 통해 접근성을 확대합니다. ROCm 7은 Windows 기반 노트북 및 워크스테이션을 포함한 클라이언트 기기에 대한 지원을 공식 확대하여 개발자들이 AMD 생태계 전반에서 AI 애플리케이션을 원활하게 구축하고 테스트할 수 있도록 지원함으로써 접근성 향상을 위한 노력을 더욱 확대합니다.
앞서가는 길
AMD는 MI350 시리즈를 넘어서는 제품 로드맵을 통해 매년 빠른 혁신을 이루는 데 전념하고 있습니다.

AMD는 2026년 출시를 목표로 완전 통합 랙 스케일 솔루션인 Helios의 핵심이 될 MI400 시리즈를 개발하고 있습니다. 이 플랫폼은 최첨단 AI 모델을 학습하고 대규모 분산 추론 작업을 관리하도록 특별히 설계되었습니다. Helios 시스템은 AMD의 통합 플랫폼으로, 향후 EPYC CPU(코드명 Venice), Instinct MI400 GPU, 그리고 차세대 Pensando 네트워킹(특히 Vulcano 800G AI NIC)을 통합합니다. 자동화된 배포 및 관리를 위한 전용 패브릭 매니저를 포함한 포괄적인 ROCm 소프트웨어 스택도 이 솔루션에 포함됩니다. 개방형 표준을 강조하는 Helios 랙은 OCP 사양을 준수합니다. 랙 간 네트워킹 확장을 위해 Ultra Ethernet(UEC)을 활용하고, 단일 랙 내 통신 확장을 위해 Ultra Accelerator Link(UAL 1.0)를 도입합니다.

Instinct MI400 GPU 자체는 초대규모 AI 애플리케이션을 위해 특별히 설계되었습니다. 예비 사양에 따르면 40페타플롭스의 FP4 성능과 20페타플롭스의 FP8 성능을 포함한 뛰어난 성능이 특징입니다. 각 GPU는 432기가바이트의 HBM 메모리를 탑재하여 약 20TB/s의 HBM 메모리 대역폭을 제공하고, 초당 300기가비트의 스케일아웃 대역폭을 제공할 것으로 예상됩니다. GPU를 보완하는 Vulcano 800G AI NIC는 UEC를 지원하며 PCIe Gen6와 함께 UAL을 지원합니다. UAL은 PCIe Gen6의 두 배에 달하는 대역폭을 제공합니다. 이 NIC는 이전 Polara 세대보다 GPU당 최대 355배 더 큰 스케일아웃 대역폭을 제공할 것으로 예상됩니다. AMD는 Helios 랙 솔루션에 대해 야심 찬 성능 목표를 가지고 있으며, 최첨단 프론티어 모델에서 MI2026와 비교했을 때 최대 50배 더 높은 AI 성능을 제공할 것으로 예상합니다. Helios는 50년 Vera Rubin과 경쟁하기 위해 경쟁력 있는 원시 FLOPS, 50% 더 많은 HBM 용량, XNUMX% 더 많은 HBM 메모리 대역폭, 최대 XNUMX% 더 많은 확장형 대역폭을 제공하는 것을 목표로 합니다.
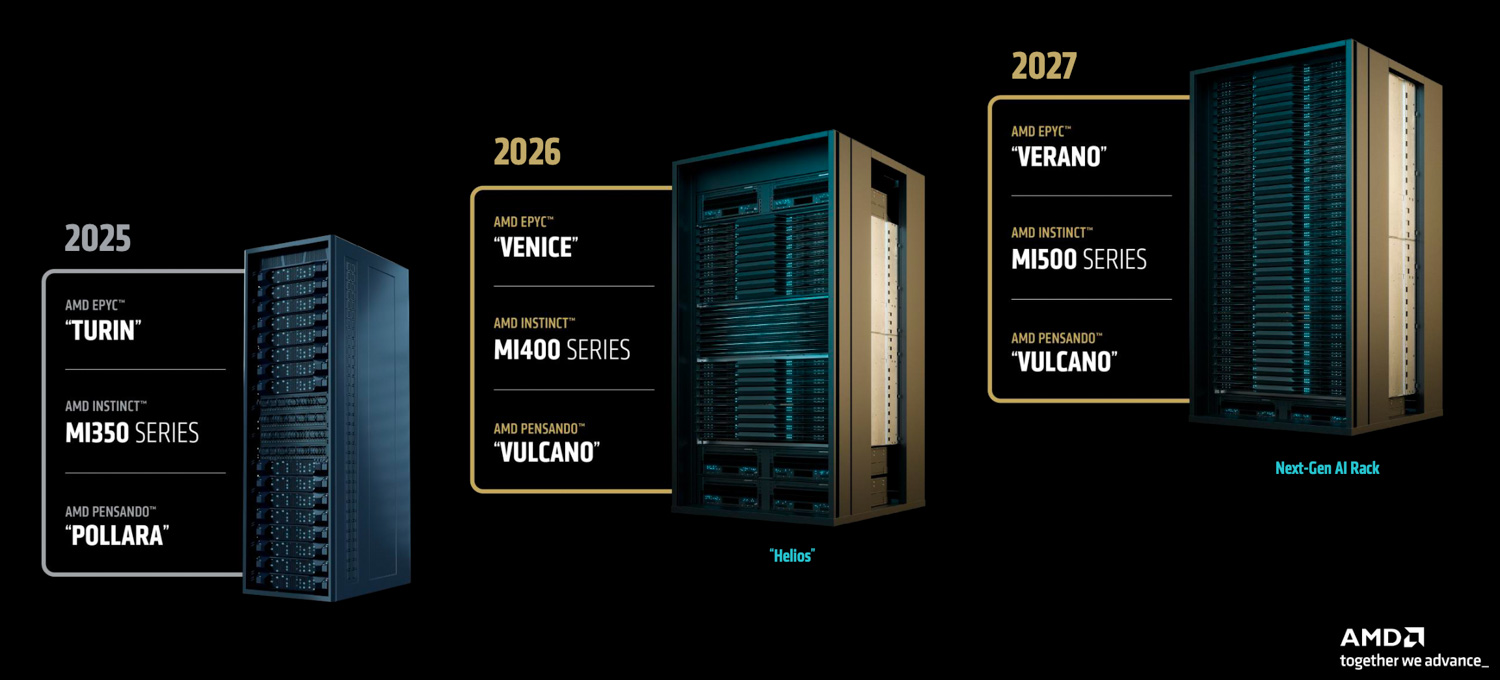
AMD의 로드맵은 더욱 확장되어 MI500 시리즈와 2027년 이후 출시될 랙 스케일 아키텍처 개발이 이미 순조롭게 진행되고 있습니다. 이러한 미래 플랫폼은 MI500 시리즈와 차세대 EPYC CPU(코드명 Verano)를 통합하고, 펜산도(Pensando) 네트워킹 기술을 더욱 발전시킬 것입니다. 그러나 이번 행사에서는 추가 정보가 공개되지 않았습니다.


 아마존