

오늘 Google Cloud Platform은 두 가지 새로운 데이터 분석 제품인 Google Cloud Dataflow와 Google Cloud Pub/Sub의 정식 출시를 발표했습니다. 이러한 제품은 데이터 분석을 위한 통합 프로그래밍 모델을 제공하여 애플리케이션과 서비스를 통합하고 실시간으로 데이터 스트림을 분석하는 동시에 배치 및 스트림 데이터 소스의 필요성을 제거합니다. Google은 또한 Cloudera Director 1.5의 출시를 발표했습니다.
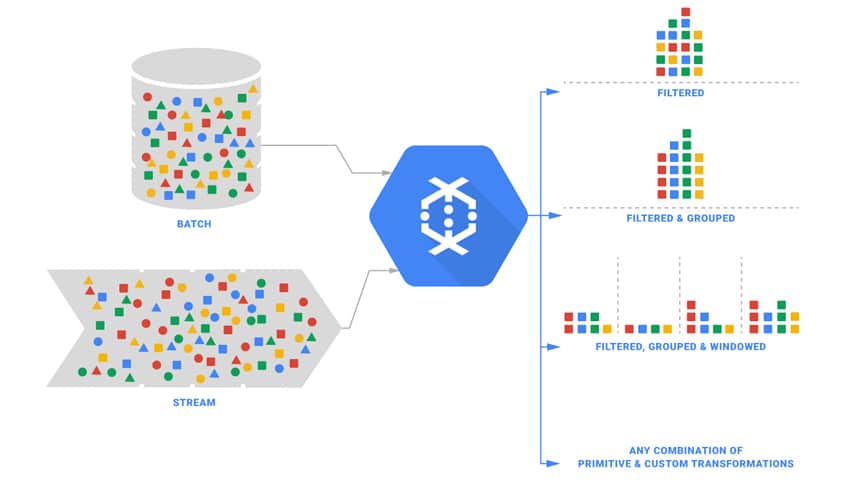
구글은 빅쿼리를 시작으로 빅데이터 도구 제품군 전체를 구글 클라우드 데이터플로우(Google Cloud Dataflow)와 구글 클라우드 퍼블릭/서브(Google Cloud Pub/Sub)를 정식 출시하며 라인업을 완성했습니다 . 구글은 베타 라벨을 해제하고 이 새로운 제품들을 통해 수천 테라바이트의 데이터가 즉시 분석될 것으로 기대하고 있습니다. 구글 클라우드 데이터플로우와 구글 클라우드 퍼블릭/서브는 기존 빅데이터 시스템에서 흔히 발생하는 운영 부담 없이 데이터 처리를 가능하게 합니다. 또한, 고객은 필요에 따라 확장 가능한 플랫폼에서 애플리케이션을 구축하고, 낮은 지연 시간과 높은 안정성을 확보할 수 있습니다.
Google Cloud Dataflow는 통합 프로그래밍 모델을 제공하여 배치 및 스트리밍 데이터 소스를 위한 별도의 시스템을 개발하는 복잡성을 제거합니다. Cloud Dataflow는 대규모 클러스터 관리 및 최적화와 관련된 오버헤드를 제거합니다.
장점은 다음과 같습니다 :
- 배치 및 스트림 처리를 위한 완전 관리형, 내결함성, 고가용성, SLA 지원 서비스입니다.
- 정렬되지 않은 대규모 데이터를 처리할 때 정확성, 대기 시간 및 비용의 균형을 맞추기 위한 포괄적인 모델입니다. 이러한 개념은 Cloud Dataflow 프로그래밍 모델의 핵심 요소를 강화합니다.
- Cloud Dataflow는 PageRank 및 WordCount와 같은 기존 MapReduce 기반 파이프라인을 평가할 때 Hadoop보다 2~3배 빠르고 저렴합니다. 그리고 동적 작업 재조정을 통해 Cloud Dataflow는 수동 개입 없이 추가적인 성능 향상을 제공하는 리소스 활용을 효과적으로 최적화합니다.
- 확장 가능한 SDK. Google은 Tamr, Salesforce, Clearstory, springML, Cloudera, data Artisans를 포함하여 기술 파트너, 타사 커넥터 및 서비스 공급자 통합 노력을 확장했습니다. 또한 Google은 Apache Spark 및 Apache Flink에 대한 대체 실행기 지원을 계속 지원합니다.
- Cloud Storage, Cloud Datastore, BigQuery 및 Cloud Pub/Sub를 위한 기본 Google Cloud Platform 통합.
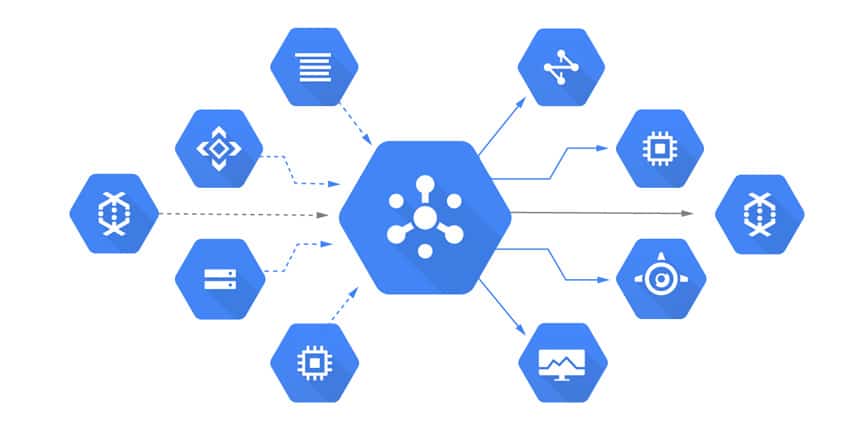
Google Cloud Pub/Sub는 1년에 걸친 혁신의 결과입니다. 애플리케이션과 서비스를 안정적으로 통합할 수 있을 뿐만 아니라 빅 데이터 스트림을 실시간으로 분석할 수 있습니다. Cloud Pub/Sub는 알파 및 베타 실행 중에 XNUMX조 개 이상의 메시지를 전달하여 성능을 미세 조정하는 데 도움을 주었습니다. 또한 단일 API에서 광범위한 시나리오를 처리할 수 있습니다.
이용 가능 여부 (Availability)
현재 Google Cloud Dataflow와 Google Cloud Pub/Sub를 모두 사용할 수 있습니다.


 아마존