

메타는 자사의 메타 트레이닝 및 추론 가속기(MTIA) 프로그램의 빠른 개발 과정을 설명했습니다. 약 2년 동안 개발된 4세대 칩에 대해 소개했으며, 이 칩들은 전 세계 AI 산업에 필수적인 핵심 인프라 문제, 즉 긴 실리콘 개발 주기에 의존하지 않고 저렴한 비용으로 진화하는 모델 아키텍처에 신속하게 적응할 수 있도록 하는 문제를 해결합니다. MTIA는 더 광범위한 실리콘 전략의 일환이며, 메타는 이러한 칩 개발을 위해 브로드컴과 협력하고 있음을 재확인했습니다.
Meta에 따르면, 이미 수십만 대의 MTIA 디바이스를 실제 운영 환경에 배포했으며 여러 자체 개발 모델을 통합했습니다. 검증 작업에는 Llama와 같은 대규모 언어 모델 테스트가 포함됩니다. Meta는 이전에 ISCA 연구 논문을 통해 MTIA 100과 MTIA 200의 첫 두 세대에 대한 기술 세부 정보를 발표했습니다. 현재 MTIA 300, 400, 450, 500을 통해 플랫폼을 확장하고 있습니다. 이러한 새로운 구성 요소는 순위 및 추천(R&R) 추론에서 R&R 학습으로, 그리고 점차 일반적인 GenAI 워크로드, 특히 추론으로 적용 범위를 확장하며, 2026년과 2027년에 배포가 진행 중이거나 계획되어 있습니다.
반복은 디자인 원칙이다
핵심은 개발 속도입니다. Meta는 모델 진화 속도가 설계부터 생산까지 2년이 걸리는 기존 칩 개발 방식보다 빠르다고 주장합니다. Meta는 오픈 소스 RISC-V 아키텍처를 기반으로 MTIA 칩을 개발하고, 대만 TSMC(Taiwan Semiconductor Manufacturing Corporation)에서 제조를 담당합니다. 이를 통해 반복적이고 모듈식 설계 방식을 구현합니다. 각 세대는 재사용 가능한 칩렛을 기반으로 구축되며, 운영자와 서비스에 대한 최신 정보를 활용하여 미세 조정됩니다. Meta는 칩 자체뿐 아니라 재사용의 중요성도 강조합니다. MTIA 400, 450, 500은 동일한 섀시, 랙, 네트워크 인프라를 공유합니다. 따라서 신속한 업그레이드가 가능하여 실리콘 개발부터 데이터 센터 배포까지 걸리는 시간을 단축할 수 있습니다.
MTIA 300: 실리콘에 내장된 네트워킹 및 협업
MTIA 300은 새로운 로드맵의 기반이 됩니다. 초기에는 GenAI가 등장하기 전 Meta의 주요 워크로드였던 R&R(Reference and Reference) 학습에 최적화되었습니다. 이 아키텍처에는 내장 네트워킹 칩렛, 효율적인 집단 통신을 위한 전용 메시지 엔진, 그리고 집단 연산 부하를 줄이기 위한 니어 메모리 컴퓨팅이 포함되어 있습니다. R&R에 초점을 맞추었지만, 이러한 통신 구성 요소는 향후 버전에서 GenAI 학습 및 추론 효율성 향상에도 기여할 것입니다.
블록 수준에서 Meta는 MTIA 300을 하나의 컴퓨팅 칩렛, 두 개의 네트워크 칩렛, 그리고 여러 개의 HBM 스택을 특징으로 하는 멀티 칩렛 설계라고 설명했습니다. 컴퓨팅 블록은 처리 요소(PE)의 그리드 형태로 배열되어 있으며, 수율 향상을 위해 추가 PE가 포함되어 있습니다. 각 PE는 두 개의 RISC-V 벡터 코어, 행렬 연산을 위한 내적 엔진, 활성화 및 요소별 연산을 위한 특수 기능 장치, 누적 및 PE 간 통신을 위한 감소 엔진, 그리고 로컬 데이터 전송을 위한 DMA 엔진을 포함합니다.
MTIA 400: 경쟁력 있는 처리량을 내세우며 GenAI로의 전환
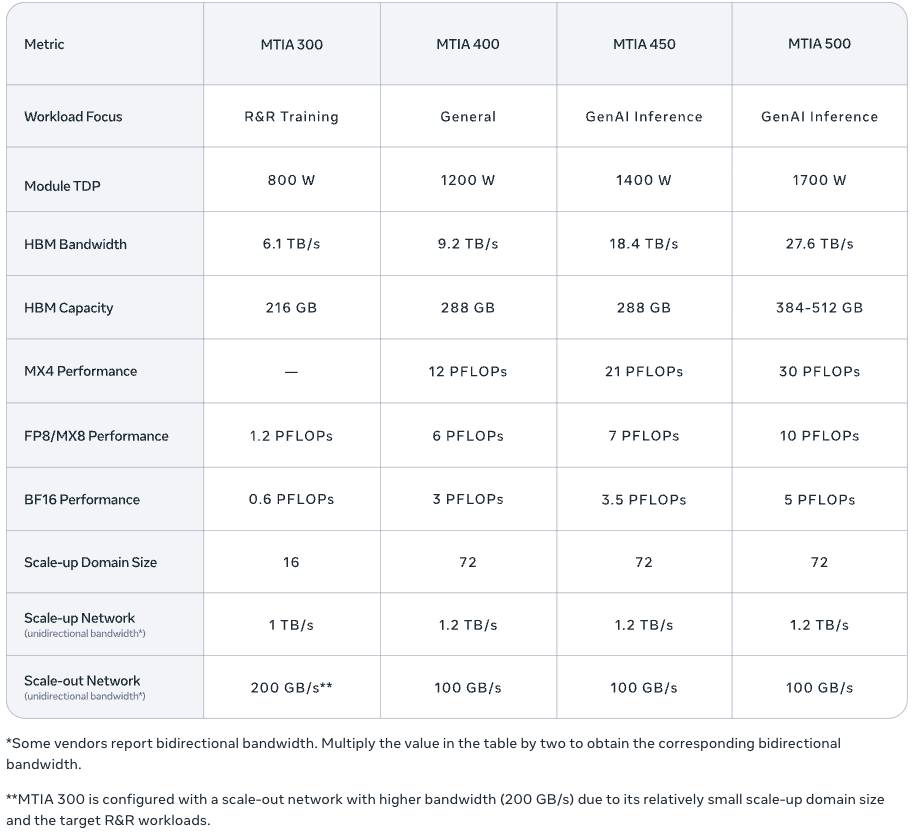
MTIA 400은 MTIA 300을 업그레이드하여 GenAI를 더욱 효과적으로 지원하면서 R&R(Reference and Reference) 기능을 유지합니다. Meta는 MTIA 400을 주요 업그레이드 제품으로 설명하며, MTIA 300 대비 FP8 FLOPS가 400% 향상되고 HBM 대역폭이 51% 증가했다고 밝혔습니다. 아키텍처적으로 MTIA 400은 두 개의 컴퓨팅 칩렛을 결합하여 컴퓨팅 밀도를 높였으며, Meta가 효율적인 GenAI 추론에 필수적이라고 판단하는 MX8 및 MX4 저정밀 포맷에 대한 지원을 개선했습니다.

시스템 설계는 여전히 핵심적인 초점입니다. Meta는 72개의 MTIA 400 장치가 스위치 백플레인을 통해 연결되어 단일 확장 가능한 도메인을 형성하는 랙 규모 배포 사례를 설명했습니다. 유연한 배포를 위해 Meta는 기존 데이터 센터에서 설치 속도를 높이는 공랭식 액체 냉각(AALC) 랙을 언급했습니다. 또한 플랫폼이 액체 냉각 솔루션을 지원할 수 있다고 밝혔습니다.
MTIA 450: GenAI 추론 최적화는 메모리 대역폭에서 시작됩니다
MTIA 450은 MTIA 400의 개선된 버전으로, 추론에 초점을 맞추고 GenAI 추론에 대한 수요 증가에 대응하여 개발되었습니다. Meta는 HBM 대역폭이 추론 성능을 제한하는 주요 요인임을 파악하고 MTIA 400에서 MTIA 450으로 대역폭을 두 배로 늘렸습니다. 또한, MX4 FLOPS를 75% 향상시켜 전문가 혼합 연산(mixture-of-experts) 성능을 개선했으며, 하드웨어 가속을 통해 어텐션 및 피드포워드 연산, 특히 Softmax 및 FlashAttention의 동작에서 발생하는 일반적인 병목 현상을 줄였습니다.
Meta는 데이터 타입 관련 기술을 중요한 요소로 강조했습니다. MTIA 450은 FP8 및 MX8을 뛰어넘어 FP16/BF16보다 6배 빠른 속도로 MX4 수준의 처리량을 달성합니다. 이 칩은 소프트웨어 변환 없이 혼합 저정밀도 연산을 지원합니다. 또한, 모델 품질을 유지하면서 FLOPS를 향상시키고 면적에 미치는 영향을 최소화하도록 설계된 맞춤형 혁신 기술을 특징으로 합니다. MTIA 450은 2027년 초 대량 생산될 예정입니다.
MTIA 500: 더 넓은 대역폭, 더 큰 용량, 더욱 정교한 칩렛 분해
MTIA 500은 메모리와 컴퓨팅 성능을 더욱 향상시켜 추론에 중점을 두고 있습니다. Meta는 MTIA 500이 MTIA 450 대비 HBM 대역폭을 50% 증가시키고, HBM 용량을 최대 80%까지 늘리며, MX4 FLOPS를 43% 향상시켰다고 밝혔습니다. 칩렛 설계는 여러 개의 HBM 스택과 두 개의 네트워크 칩렛으로 둘러싸인 2x2 구성의 소형 컴퓨팅 칩렛을 채택하여 발전했습니다. 또한 호스트 CPU 및 스케일아웃 NIC와의 PCIe 연결을 위한 시스템 온 칩(SoC) 칩렛도 포함되어 있습니다. Meta는 추론 병목 현상을 해결하기 위해 하드웨어 가속을 추가하고 데이터 유형을 변경했다고 언급했습니다.
MTIA 500은 2027년에 대량 배치될 예정입니다.
쉬운 입양
Meta는 MTIA를 손쉬운 도입을 목표로 개발하고 있으며, 특수 프레임워크보다는 업계 표준 도구를 강조하고 있습니다. Meta는 MTIA가 PyTorch 네이티브 방식으로 작동하며, PyTorch 2.x 컴파일 프로세스와 원활하게 연동되고 즉시 실행과 그래프 실행을 모두 지원한다고 설명했습니다. 그래프 모드에서 개발자는 torch.compile과 torch.export를 사용하여 MTIA 전용 모델을 다시 작성할 필요 없이 그래프를 최적화할 수 있으므로 GPU와 MTIA 전반에 걸쳐 병렬 배포가 가능합니다.
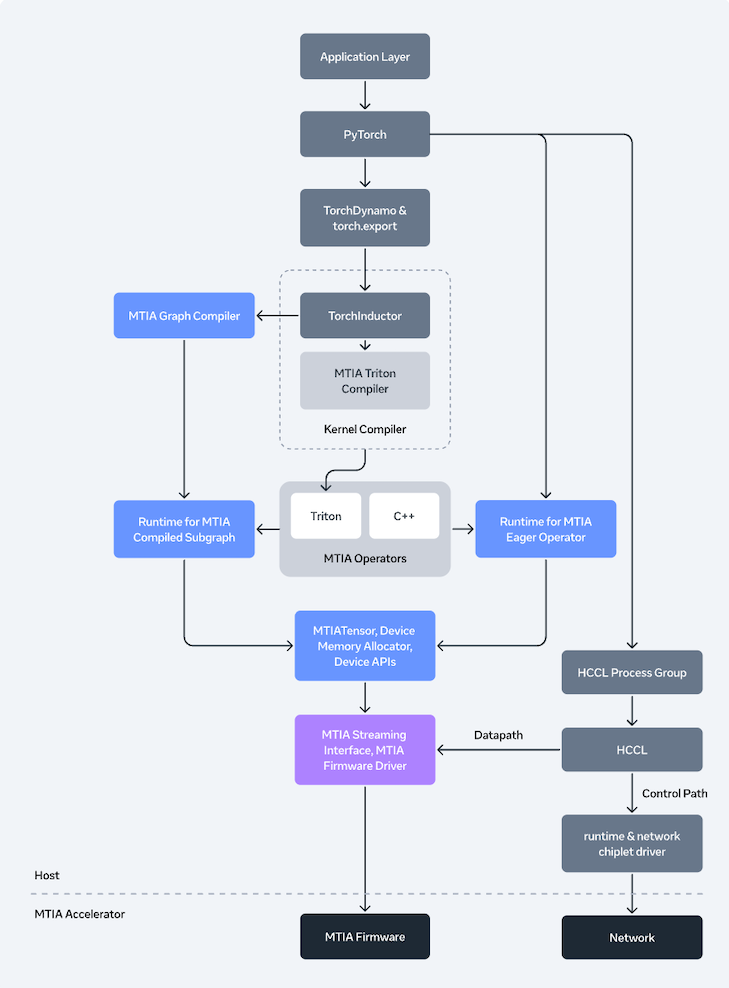
내부적으로 Meta는 Torch FX IR과 TorchInductor를 기반으로 구축된 MTIA 컴파일러 스택에 대해 자세히 설명했습니다. 하위 계층은 Triton, MLIR 및 LLVM을 사용하며, 커널 융합 개선 및 성능에 중요한 부분에 대한 확장 기능을 포함한 MTIA 관련 최적화가 적용되었습니다. 자동 튜닝은 다양한 컴파일 전략 중에서 선택할 수 있는 핵심 기능입니다.
분산 실행을 위해 Meta는 Hoot Collective Communications Library(HCCL)를 도입했습니다. 이 라이브러리는 GPU 콜렉티브 스택과 유사하지만 MTIA의 내장 네트워킹 칩렛 및 메시지 엔진에 최적화되어 있습니다. HCCL은 메모리 근접 컴퓨팅을 활용하여 리덕션 연산을 가속화합니다. 또한 Meta는 지연 시간을 줄이기 위해 컴퓨팅 콜렉티브 퓨전을 지원하며, 데이터 경로를 관리하고 호스트 오버헤드를 줄이도록 설계된 전송 스택을 갖추고 있습니다.
Meta는 런타임 시 즉시 실행 모드와 그래프 모드 전반에 걸쳐 메모리, 스케줄링 및 조정을 관리하는 장치 런타임을 시연했습니다. 또한 기존의 커널 내 Linux 드라이버에서 벗어나 Rust 기반 사용자 공간 드라이버를 도입했습니다. 펌웨어는 베어메탈 Rust로 작성되어 낮은 지연 시간과 안전성을 강조합니다.
GenAI 서비스와 관련하여 Meta는 플러그인 시스템을 사용한 vLLM 통합에 대해 설명했습니다. 이 시스템은 FlashAttention 및 fused LayerNorm과 같은 주요 연산자를 MTIA 전용 커널로 대체합니다. 또한 사용자 지정 torch.compile 백엔드를 통해 그래프 모드를 활성화합니다. 뿐만 아니라 Meta는 호스트 및 장치 전반에 걸친 모니터링, 프로파일링, 디버깅 및 관찰 기능을 포함하여 대규모 MTIA 배포를 관리하는 도구에 대해서도 언급했습니다.
무엇 향후 계획
Meta의 업데이트된 MTIA 로드맵은 GenAI 추론의 경제성을 강조하며, HBM 대역폭과 저정밀 포맷을 핵심 요소로 부각합니다. Meta가 배포 일정을 준수한다면, MTIA 450 및 500은 빠른 칩렛 반복 개발과 표준화된 소프트웨어를 기반으로 하는 추론 우선 가속기 전략이 GenAI 서비스 제공에 있어 주류 GPU 플랫폼 대비 우위를 유지할 수 있는지 여부를 판단하는 최초의 대규모 테스트가 될 것입니다.


 아마존