

MLCommons는 MLPerf Inference v6.1을 발표했으며, 이번 라운드에는 30개 기관이 참여하여 486개의 데이터센터 및 엣지 컴퓨팅 결과를 기록하며 역대 최대 규모를 달성했습니다. 이번 버전에는 데이터센터용 엔드투엔드 RAG 파이프라인과 단일 사용자 장치용 엣지 에이전트 추론 벤치마크 등 두 가지 새로운 테스트가 추가되었으며, NVIDIA의 Vera Rubin NVL72, AMD의 Instinct MI350P, Intel의 Arc Pro B70, AMD의 Ryzen AI Max+ 395에 대한 최초의 동료 평가를 거친 결과가 포함되었습니다. MLCommons는 성능 향상 속도에 대해 서버 시나리오에서 가속기별 최고 DeepSeek-R1 결과가 1년 전 v5.1 대비 5.7배 향상되었으며, 최고 VLM 결과는 v6.0 이후 6개월 동안 2.99배 향상되었다고 밝혔습니다.
두 가지 새로운 테스트: 엔드투엔드 RAG 및 엣지 에이전트 추론
End-to-End RAG 벤치마크는 여러 모델과 벡터 데이터베이스가 함께 작동하는 완전한 질의응답 파이프라인의 성능을 측정합니다. 참조 구현에서는 네 가지 모델이 동시에 실행됩니다. gpt-oss-120B는 질의 분해, 충분성 검사 및 답변 생성을 담당하고, gpt-oss-20B는 검색된 문서를 평가하며, e5-base-v2는 임베딩을 생성하고, ColBERTv2는 지문을 재순위화합니다. 코퍼스는 2,515개의 HTML 파일에서 추출한 107,484개의 지문으로 구성됩니다. 질문은 Google의 FRAMES 데이터셋에서 가져온 824개의 멀티홉 태스크이며, 각 태스크는 파이프라인이 충분한 증거를 확보했다고 판단하기 전까지 최대 5번의 검색 라운드를 거칠 수 있습니다. 두 가지 지표가 산출됩니다. 하나는 FAISS HNSW 벡터 데이터베이스 구축에 소요되는 초당 문서 처리량이고, 다른 하나는 해당 데이터베이스에 대한 질문 답변 처리에 소요되는 초당 태스크 처리량입니다. Llama 3.1-8B 채점기가 최종 답변을 97% 정확도 목표에 따라 채점하며, 채점 시간은 제한되지 않습니다.
Edge Agentic Inference 벤치마크는 워크스테이션 및 데스크톱 AI 박스로 이동한 코딩 어시스턴트 패턴을 대상으로 합니다. 사용된 모델은 Qwen3.6-27B이며, 사고 과정이 비활성화된 상태로 참조 환경의 llama.cpp에서 Q4_K_M GGUF로 실행되고, 턴당 32KB의 컨텍스트 윈도우가 처리됩니다. 성능 워크로드는 SWE-bench Verified에서 가져온 20개의 에이전트 코딩 궤적을 기록한 재생 방식으로, 총 1,007턴으로 구성됩니다. 이는 개발자가 노트북에서 에이전트를 실행하는 방식과 유사하게 단일 스트림에서 하나의 요청만 처리합니다. 보고되는 메트릭은 턴당 평균 지연 시간이며, 첫 번째 토큰 생성 시간 및 출력 토큰당 생성 시간 분포가 함께 제공됩니다. 정확도는 BFCL v4를 사용하여 참조 점수의 97%로 별도로 평가됩니다. MLCommons는 곧 출시될 MLPerf Agentic 데이터센터 벤치마크의 프레임워크를 이 벤치마크에 적용했습니다.
MLPerf 추론 워킹 그룹 공동 의장인 미로 호닥은 “질문 응답 방식이 단순히 코퍼스로 학습된 LLM을 넘어 진화했음이 분명하기 때문에 엔드투엔드 RAG 테스트를 추가했습니다. 이해관계자들은 오늘날 구축되고 있는 다단계, 다중 구성 요소 파이프라인의 실제 성능을 이해해야 합니다.”라고 말했습니다. “마찬가지로, 에이전트 속성을 가진 복잡한 추론 시스템이 엣지 컴퓨팅 장치에서 점점 더 많이 호스팅되면서 고객이 직면하는 새로운 성능 문제가 발생하고 있기 때문에 엣지 에이전트 추론 테스트를 추가했습니다.”
이번 라운드에서는 기존에 DeepSeek-R1에만 제한되었던 추측 디코딩 지원 기능이 대화형 시나리오의 GPT-OSS 벤치마크로 확장되었으며, 응답 시간이 약 1.5초를 목표로 하는 VLM 테스트를 위한 새로운 대화형 시나리오가 정의되었습니다.
데스크톱에서 랙까지, 새로운 실리콘 기술
NVIDIA의 Vera Rubin NVL72가 NVIDIA와 Nebius가 VR200 NVL72를 기반으로 제출한 프리뷰 부문에서 MLPerf에 처음으로 등장했습니다. NVIDIA는 TensorRT-LLM을 사용한 DeepSeek-R1 테스트에서 오프라인, 서버 및 인터랙티브 시나리오 전반에 걸쳐 GB300 NVL72보다 최대 2.5배 높은 토큰 처리량을, NVIDIA Dynamo를 사용한 vLLM 기반의 Qwen3 비전 언어 모델에서는 최대 3.7배 높은 처리량을 달성했다고 보고했습니다. 이는 NVIDIA가 자사 이전 세대 제품과 비교한 결과이며, 프리뷰로 지정된 것은 해당 플랫폼이 다음 라운드에서 상용화될 것으로 예상됨을 의미합니다.
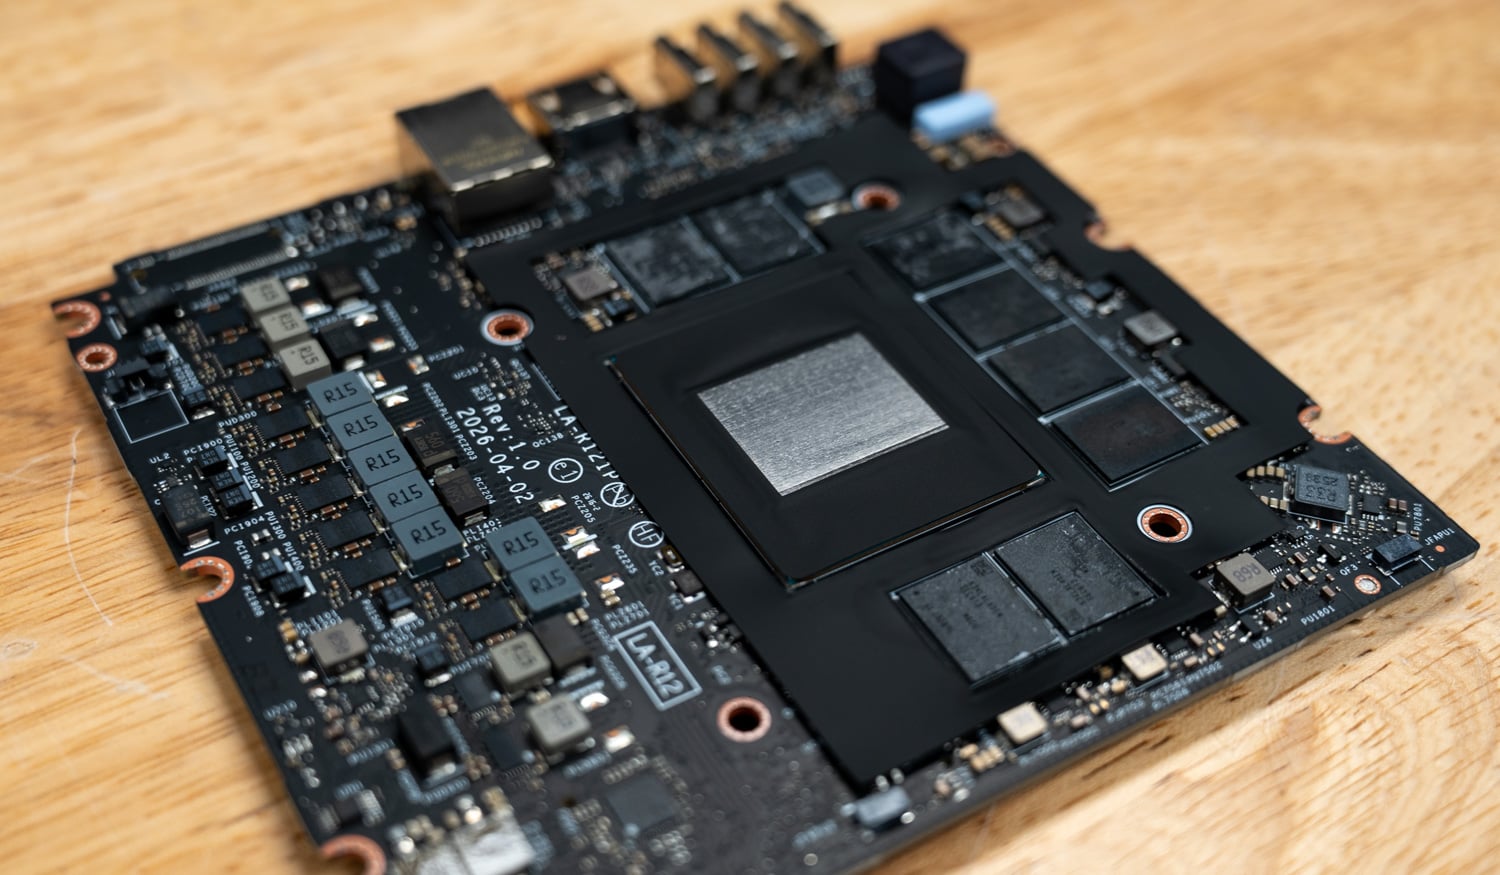
AMD는 Instinct MI355X, MI350X 및 새로운 MI350P PCIe 카드를 사용하여 언어, 추론, 텍스트-비디오 변환 및 추천 작업에 걸쳐 6개 모델 제품군으로 MLPerf Inference 6.1 제출을 확장했습니다. MI355X를 기반으로 구축된 512개 GPU로 구성된 Crusoe 클러스터에 대한 자세한 내용과 AMD의 이번 라운드 분석은 아래에서 확인할 수 있습니다.
인텔의 Arc Pro B70은 128GB의 VRAM을 탑재한 6.0개의 GPU 노드로 구성되어 있으며, 인텔은 이를 기반으로 Llama 3.1-8B, Llama 2-70B, gpt-oss-120B, Whisper 및 새로운 E2E-RAG 테스트를 진행했습니다. 인텔에 따르면 gpt-oss-120B 테스트 결과, 동일한 하드웨어에서 서버 환경은 36%, 오프라인 환경은 27% 향상된 성능을 보였습니다. CPU 측면에서는 Xeon 6980P의 Llama 3.1-8B 서버 처리량이 동일한 실리콘에서 v6.0 대비 2.4배 증가했으며, 이는 소프트웨어적인 개선만으로 달성된 결과입니다.
Ryzen AI Max+ 395는 Atlas Inference를 통해 성능을 입증했습니다. Atlas Inference는 이번에 처음으로 새로운 Edge Agentic 워크로드를 NVIDIA DGX Spark와 AMD Strix Halo 데스크톱에서 동일한 엔진과 양자화 레시피로 실행했습니다. Atlas는 DGX Spark에서 초당 20.1개의 토큰을 처리하며 1,007번의 턴을 64분 이내에 완료했고, Strix Halo에서는 초당 19.63개의 토큰을 처리했다고 보고했습니다. 이는 Ryzen AI Halo 및 DGX Spark 리뷰 에서 기본 런타임을 사용하여 측정했던 두 플랫폼 간의 격차보다 좁은 수치 이며, 새로운 벤치마크가 의도한 결과입니다.
더 크고, 더 다양하며, 더 분산된
이번 라운드에서는 멀티 노드 제출 건수가 v4.0의 0건에서 역대 최고치를 기록했으며, 그중 세 건이 특히 눈에 띕니다. 이번에 처음으로 제출한 Crusoe는 AMD를 사용하여 MLPerf 추론 역사상 최대 규모의 시스템을 운영했습니다. 표준 RoCE 이더넷 패브릭의 64개 노드에 걸쳐 512개의 Instinct MI355X GPU를 사용한 이 시스템은 gpt-oss-120b와 DeepSeek-R1에 대해 제출되었습니다. AMD는 해당 클러스터에서 gpt-oss-120b의 오프라인 시나리오에서 초당 5.75만 토큰, 서버 시나리오에서 5.39만 토큰을 처리했으며, DeepSeek-R1의 경우 오프라인에서 2.90만 토큰, 서버 시나리오에서 2.41만 토큰을 처리했다고 보고했습니다. AMD는 이를 MLPerf 역사상 가장 높은 총 토큰 처리량이라고 밝혔으며, 처리량은 1개 노드에서 64개 노드까지 거의 선형적으로 확장된다고 설명했습니다. gpt-oss-120b 실행에서는 512개의 독립적인 단일 GPU 복제본이 네이티브 MXFP4 형식으로 모델을 처리했습니다. DeepSeek-R1은 노드당 8개의 GPU 복제본 하나를 사용하는 SGLang을 사용했습니다. AMD는 별도로 72개의 GPU를 사용한 GPT-OSS-120B 제출에서 95%의 확장 효율성과 초당 100만 개의 토큰 처리 능력을 달성했다고 밝혔는데, 이는 v6.0의 MI355X 에서 달성했던 것과 동일한 결과입니다.
시스코는 벤치마크에 최초로 여러 공급업체의 이기종 시스템을 제출했습니다. 이 시스템은 시스코 실리콘 원 G200 패브릭을 통해 8개의 NVIDIA H200과 8개의 AMD Instinct MI350X GPU를 단일 추론 풀로 구성했으며, 이는 시스코가 자사의 Secure AI Factory를 통해 판매하는 것과 동일한 혼합 가속기 접근 방식 입니다. 지리적으로 분산된 시스템은 MangoBoost와 Dell이 공동으로 구축했으며, 태평양을 가로지르는 두 대륙의 네 개 사이트에서 MangoBoost, Dell, TensorWave, Microsoft Azure의 호스팅을 통해 단일 엔드포인트처럼 작동하여 MangoBoost가 보고한 97%의 확장 효율성을 달성했습니다. 또한 MangoBoost는 AMD Instinct GPU에서 사전 채우기/디코딩 분리 결과를 최초로 제시했다고 주장합니다.
다른 결과들을 살펴보면, CoreWeave는 GB300 NVL72에서 초당 평균 1.16만 토큰을 처리했으며, GPU별 오프라인 처리량은 v6.0 이후 17% 증가했다고 보고했습니다. HPE는 Blackwell Ultra를 탑재한 두 대의 Compute XD690 서버에서 DeepSeek-R1 테스트를 통해 GPU당 초당 8,500 토큰을 처리했다고 밝혔습니다. Google은 업계의 대규모 혼합 전문가 모델로의 전환 추세를 고려하여 DeepSeek-R1에 집중적으로 제출했습니다. gpt-oss-120b는 112건의 제출을 기록하며 MLPerf 워크로드 중 가장 많은 제출 수를 보였습니다.
AMD의 CDNA 4 폼팩터 두 가지: OAM 및 듀얼 슬롯 PCIe
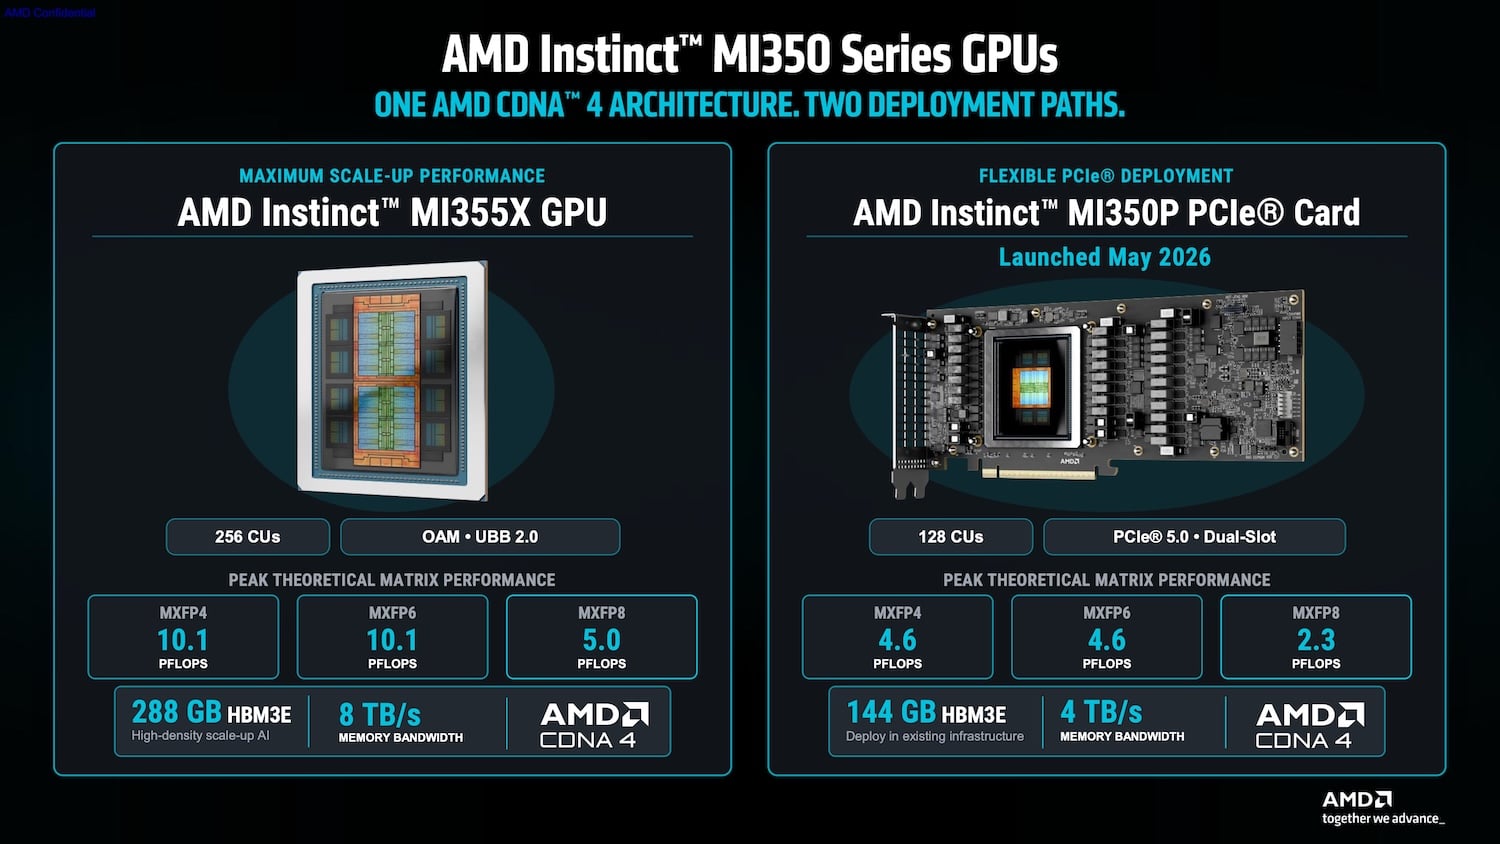
AMD의 CDNA 4 아키텍처는 데이터 센터의 전력 및 냉각 제약 조건에 맞춰 두 가지 물리적 폼 팩터로 제공됩니다. 플래그십 제품인 Instinct MI355X는 OCP Universal Baseboard(UBB 2.0) 플랫폼 기반의 OAM 폼 팩터를 사용하여 고밀도 컴퓨팅 노드를 목표로 하며, 256개의 컴퓨팅 유닛, 288GB의 HBM3E 메모리, 그리고 8TB/s의 총 메모리 대역폭을 제공합니다. 이 제품은 MXFP4 및 MXFP6 매트릭스 컴퓨팅에서 최대 10.1PFLOPS의 이론적 최고 성능을 제공합니다. 새롭게 출시된 Instinct MI350P는 동일한 CDNA 4 실리콘을 표준 엔터프라이즈 섀시용 듀얼 슬롯 PCIe 5.0 애드인 카드에 적용하여 128개의 컴퓨팅 유닛, 144GB의 HBM3E 메모리, 4TB/s의 대역폭을 제공하며, MXFP4 및 MXFP6 매트릭스 컴퓨팅에서 최대 4.6PFLOPS의 이론적 최고 성능을 제공합니다.
동일한 실리콘 기반에서 소프트웨어로 구현되는 세대적 성능 향상
AMD ROCm v7의 소프트웨어 최적화를 통해 동일한 MI355X 하드웨어에서 단일 MLPerf 사이클 동안 측정 가능한 처리량 향상을 달성했습니다. 8개의 GPU로 구성된 MI355X 노드에서 수행된 테스트 결과, GPT-OSS-120B 처리량은 오프라인 시나리오에서 28%, 서버 시나리오에서 38% 증가했으며, WAN-2.2 SingleStream 성능은 70% 향상되었습니다. 클러스터 규모에서는 MLPerf 6.1에서 72개의 MI355X 가속기가 6.0 라운드에서 보고된 94개 GPU 구성보다 더 높은 GPT-OSS-120B 총 처리량을 기록했습니다. AMD가 발표한 경쟁 비교 결과에서 8개의 GPU로 구성된 MI355X는 GPT-OSS-120B에서 NVIDIA B200 및 B300을 상대로 최고 성능을 보였으며, 72개의 GPU로 구성된 클러스터는 NVIDIA의 GB200 제출 결과에서 최고 성능을 기록했습니다.
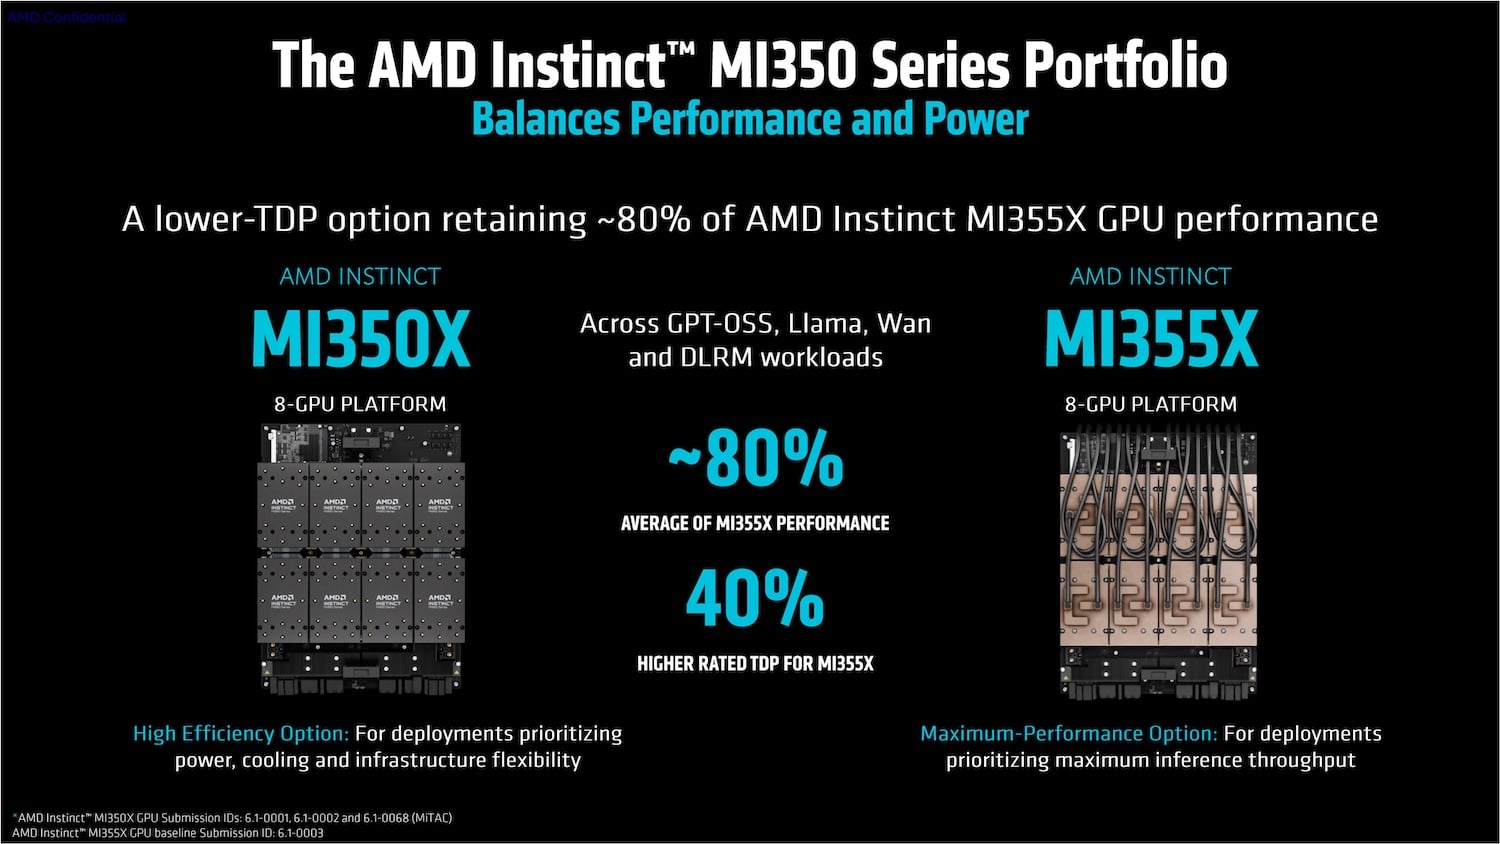
첫 번째 MLPerf 테스트에서 듀얼 슬롯 MI350P는 5개의 폐쇄형 워크로드에서 NVIDIA RTX PRO 6000 Server Edition 및 H200 NVL의 일부 제출물에 비해 우수한 결과를 기록했습니다. 전력 및 냉각 예산에 민감한 배포 환경에서 8개의 GPU를 탑재한 MI350X 시스템은 GPT-OSS, Llama, WAN 및 DLRM 워크로드에서 MI355X 플랫폼 벤치마크 성능의 약 80%를 유지했으며, MI355X는 정격 TDP가 40% 더 높습니다. Signal65에서 의뢰한 연구에 따르면 이러한 처리량 수치는 고정된 지연 시간 범위 내에서 문서당 운영 비용 절감 및 달러당 토큰 생산량 증가로 이어집니다.
AMD 파트너 실적 및 한국-미국 클러스터
AMD는 델 테크놀로지스, 오라클, 휴렛팩커드 엔터프라이즈, 슈퍼마이크로, 망고부스트, 크루소, 미탁 등 7개 파트너사가 제출한 MI355X 테스트 결과가 자사 레퍼런스 시스템 결과와 평균 4% 이내의 차이를 보였으며, 일부 테스트에서는 레퍼런스 시스템과 동일하거나 약간 더 나은 결과를 보였다고 밝혔습니다.
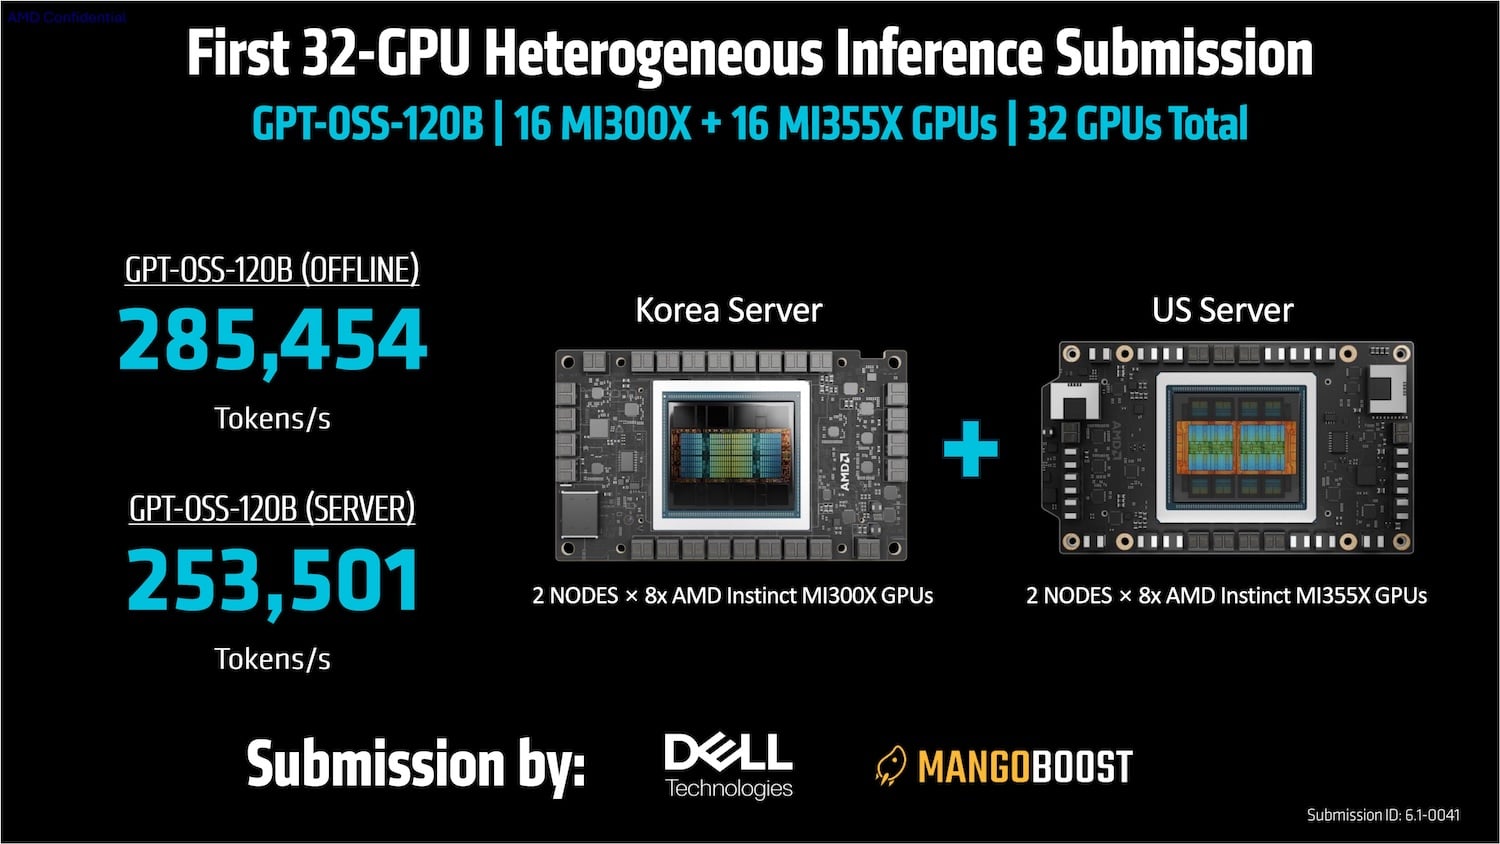
위에 언급된 MangoBoost와 Dell의 참가 사례는 벤치마크 최초의 이기종 32-GPU 서버 구성으로, 한국에 있는 이전 세대 Instinct MI300X GPU 16개와 미국에 있는 Instinct MI355X GPU 16개를 통합된 GPT-OSS-120B 엔드포인트로 연결했습니다. 이 분할 클러스터 구성은 초당 285,454개의 오프라인 토큰과 253,501개의 서버 토큰을 처리했습니다. 해당 테스트는 ROCm 7에서 실행되었으며, AMD는 HBM4 기반 MI400 시리즈 와 그 후속 세대인 MI500 시리즈 를 위해 vLLM, SGLang 및 ROCm.AI 프로파일링 도구가 포함된 ROCm 10 버전을 개발 방향으로 제시하고 있습니다.
데이터센터에서 MLPerf 추론을 대체하는 솔루션
이번 라운드에서는 30개 제출자 중 16명이 MLPerf의 API 중심 하네스를 사용했는데, 이는 v6.0의 오픈 부문 제출자 1개에서 크게 증가한 수치입니다. 이 하네스는 표준 API를 통해 호스팅된 엔드포인트에 대해 진정한 클라이언트/서버 설정을 실행하며, 이는 데이터센터 추론이 배포되는 방식과 동일합니다. 또한, 새로운 Edge Agentic 테스트, VLM-Interactive, gpt-oss, DeepSeek-R1, Llama 3.1-8B, text-to-video 테스트를 이미 포함하고 있습니다. 이는 MLPerf Endpoints의 기반이 되며, MLPerf Endpoints는 2026년 1.0월부터 상시 제출을 시작하여 2027년에는 MLPerf Inference를 대체하는 데이터센터 벤치마크가 될 예정입니다. Endpoints v1.0에서는 정규화된 결과와 확장된 에이전트 워크로드가 제공될 계획입니다.
MLPerf의 책임자인 데이비드 칸터는 "앞으로 MLPerf Endpoints는 데이터센터용 벤치마크 제품군에서 Inference를 대체할 것이며, API 중심의 하네스가 빠르게 도입됨에 따라 이러한 전환이 원활하게 이루어질 것입니다."라고 말했습니다. 이번에 처음으로 제출한 6개 업체는 Atlas Inference, Crusoe, Orrick Industries, ScitiX, VibeHPC, 그리고 개인 참가자인 하버드 켐프너 연구소의 나임 코슈네비스(Naeem Khoshnevis)로, 그는 H200 Llama 3.1-8B 단일 결과를 제출했습니다.
이번 추론 라운드는 2주 전에 발표된 MLPerf Storage v3.0 결과 에 이은 것으로 , 전체 데이터센터 및 엣지 테이블과 제출자 추가 자료는 MLCommons 결과 페이지에서 확인할 수 있습니다.


 아마존