

오늘 SC20에서 엔비디아는 인기 있는 A100 GPU가 엔비디아 A100 80GB GPU를 공개하면서 고대역폭 메모리를 두 배로 늘릴 것이라고 발표했습니다. 이 새로운 GPU는 새로운 NVIDIA HGX AI 슈퍼컴퓨팅 플랫폼을 지원하는 혁신이 될 것입니다. 두 배의 메모리를 갖춘 새로운 GPU는 연구원과 엔지니어가 전례 없는 속도와 성능을 달성하여 차세대 AI 및 과학적 혁신을 실현하는 데 도움이 되기를 희망합니다.
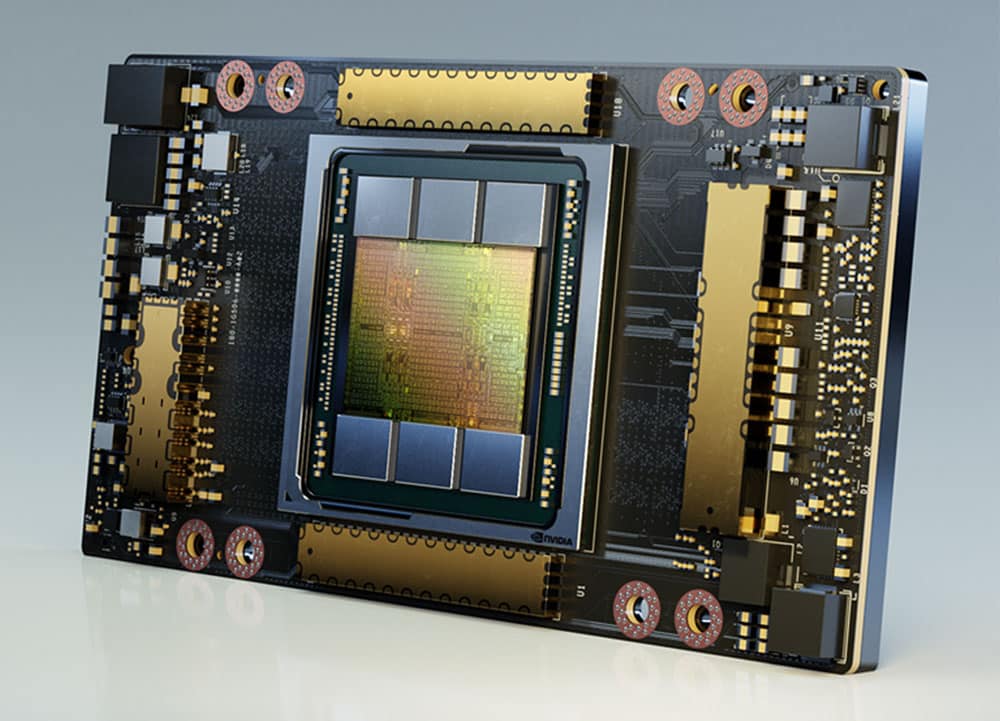
올해 초 GTC에서 NVIDIA는 7nm GPU인 NVIDIA A100을 발표했습니다 . 당시 보도했듯이, A100은 NVIDIA의 암페어(Ampere) 아키텍처를 기반으로 하며 540억 개의 트랜지스터를 포함하고 있습니다. 이전 NVIDIA 데이터 센터 GPU와 마찬가지로 A100에는 텐서 코어(Tensor Core)가 탑재되어 있습니다. 텐서 코어는 추론에 일반적으로 사용되는 행렬 곱셈 및 덧셈 연산을 빠르게 수행하도록 특별히 설계된 GPU의 핵심 부품입니다. 더욱 강력해진 새로운 GPU에는 더욱 강력해진 텐서 코어가 함께 제공됩니다. 이전 NVIDIA의 텐서 코어는 최대 32비트 부동 소수점까지만 지원했지만, A100은 64비트 부동 소수점 연산을 지원하여 훨씬 더 높은 정밀도를 제공합니다.
고대역폭 메모리(HBM2e)를 80GB로 올리면 초당 2테라바이트의 메모리 대역폭을 제공할 수 있다고 한다. 이 새로운 부스트는 AI 교육, 자연어 처리 및 빅 데이터 분석과 같이 막대한 데이터 메모리 요구 사항이 있는 HPC의 새로운 애플리케이션에 도움이 됩니다.
A100 80GB의 주요 기능
A100 80GB에는 NVIDIA Ampere 아키텍처의 많은 획기적인 기능이 포함되어 있습니다.
- 20세대 Tensor 코어: 새로운 형식의 TF32, HPC용 2.5x FP64, AI 추론용 20x INT8 및 BF16 데이터 형식 지원으로 이전 Volta 세대의 최대 XNUMX배 AI 처리량을 제공합니다.
- 더 크고 더 빠른 HBM2e GPU 메모리: 메모리 용량을 두 배로 늘리고 업계 최초로 초당 2TB 이상의 메모리 대역폭을 제공합니다.
- MIG 기술: 격리된 인스턴스당 메모리를 두 배로 늘려 각각 10GB인 최대 XNUMX개의 MIG를 제공합니다.
- 구조적 희소성: 희소 모델을 추론하는 속도가 최대 2배 빨라집니다.
- 600세대 NVLink 및 NVSwitch: 이전 세대 상호 연결 기술의 GPU 간 대역폭의 두 배를 제공하여 데이터 집약적인 워크로드를 위해 GPU로의 데이터 전송을 초당 XNUMXGB로 가속화합니다.
이용 가능 여부 (Availability)
기존 시스템 제공업체인 Atos, Dell Technologies, Fujitsu, GIGABYTE, Hewlett Packard Enterprise, Inspur, Lenovo, Quanta 및 Supermicro는 내년 상반기에 A100 100GB GPU를 특징으로 하는 HGX A80 통합 베이스보드를 사용하여 구축된 시스템을 제공하기 시작할 것으로 예상됩니다.


 아마존