

VAST Data는 클라우드 제공업체와 기업이 학습, 추론, 검색 증강 생성 및 에이전트 기반 AI 서비스를 배포할 수 있도록 AI 인프라 분야에서 AMD와의 협력을 확대했습니다. 이번 협력을 통해 VAST AI 운영 체제와 6세대 AMD EPYC 프로세서 , AMD Instinct GPU, AMD 네트워킹 하드웨어 및 ROCm 소프트웨어가 결합되었습니다.
이번 협력은 학습 중심의 AI 클러스터에서 지속적인 컨텍스트, 높은 동시성 추론, 다중 턴 에이전트 워크플로우를 지원해야 하는 환경으로의 광범위한 인프라 전환을 반영합니다. 이러한 배포에서는 데이터 이동, 키-값 캐시 관리, GPU 활용, 그리고 대규모 모델 및 컨텍스트 데이터 세트에 대한 저지연 액세스 제공 능력이 더욱 중요해집니다.
VAST는 분산형 공유 모든 것(DASE ) 아키텍처를 이러한 환경을 위한 공유 데이터 계층으로 제시합니다. 이 플랫폼은 파일 및 객체 스토리지, 데이터베이스, 이벤트 스트리밍, 데이터 서비스를 통합된 글로벌 네임스페이스 아래에 결합합니다. 또한 동시 고객 및 애플리케이션 워크로드를 처리하는 AI 클라우드를 위해 멀티테넌시 및 워크로드 격리 기능을 제공합니다.
VAST CBox 및 EBox 시스템용 EPYC 9006 플랫폼
VAST는 차세대 CBox 및 EBox 플랫폼에 6세대 AMD EPYC 프로세서(이전 코드명 베니스)를 채택했습니다. 회사는 이 프로세서를 VAST AI 운영 체제의 기반이 되는 6세대 CBox 및 3세대 EBox 시스템에 사용할 계획입니다.
AMD EPYC 9006 지원을 통해 VAST 하드웨어 플랫폼에 PCIe Gen6 연결이 도입되었습니다. VAST는 이 새로운 인터페이스가 세대별 I/O 대역폭을 두 배로 늘려 파일 및 객체 스토리지 처리량을 향상시키고, VAST DataBase 및 DataEngine을 통해 제공되는 데이터베이스, 데이터 웨어하우스, 이벤트 스트리밍 워크로드와 같은 데이터 서비스의 지연 시간을 줄인다고 밝혔습니다.
AI 인프라의 경우, 더 높은 I/O 대역폭은 컴퓨팅, 네트워크 및 NVMe 스토리지 리소스 간의 병목 현상을 줄이는 데 도움이 될 수 있습니다. 이는 특히 모델 로딩, 검색 파이프라인, 체크포인트 액세스 및 외부화된 KV 캐시 워크플로와 같이 GPU 메모리 용량만으로는 활성 컨텍스트를 유지하기에 불충분한 경우에 중요합니다.
참조 아키텍처는 Helios, VAST 및 DriveNets를 결합합니다.
VAST, AMD 및 DriveNets는 AMD Helios 랙 규모 AI 인프라, VAST AI 운영 체제 및 DriveNets AI Fabric 네트워킹을 기반으로 구축된 AI 인프라 참조 아키텍처를 개발하고 있습니다.

참조 아키텍처는 모델 학습, 추론, 강화 학습 및 KV 캐시 워크로드에 대한 배포 지침을 제공하기 위해 설계되었습니다. 여기에는 공유 데이터 인프라와 고성능 네트워킹, 그리고 GPU 컴퓨팅이 필요한 AI 팩토리를 구축하는 조직을 위한 규모 산정 및 가용성 고려 사항이 포함됩니다.
VAST는 추론 소프트웨어 제공업체인 TensorMesh 및 EmbeddedLLM과의 협력 확대도 언급했습니다. 이러한 생태계 구축 노력은 에이전트형 AI 애플리케이션을 위한 프로덕션 추론 아키텍처에 초점을 맞추고 있지만, 구체적인 제품 통합 및 출시 정보는 공개되지 않았습니다.
KV 캐시 오프로드는 고동시성 추론을 목표로 합니다.
이번 발표의 핵심 요소는 AMD Instinct GPU , AMD Infinity Context, ROCm 소프트웨어 및 VAST AI 운영 체제를 활용한 확장된 KV 캐시 지원 입니다.
KV 캐시 데이터는 추론 과정에서 생성되는 중간 상태 정보를 저장합니다. 이 데이터를 유지하면 다중 턴 상호작용 및 장기 컨텍스트 워크로드의 성능이 향상되지만, 캐시 크기가 커지면 GPU 메모리를 많이 소모할 수 있습니다. KV 캐시를 고성능 스토리지 플랫폼으로 외부화하거나 계층화하면 활성 워크로드에 필요한 GPU 메모리를 확보하면서 후속 추론 요청을 위한 컨텍스트를 유지할 수 있습니다.
VAST는 AMD Instinct MI355X GPU를 사용한 초기 테스트 결과, 고동시성 에이전트형 AI 워크로드에서 KV 캐시 오프로드를 위해 VAST를 사용할 경우 첫 토큰 생성 시간이 9배 단축되고 토큰 처리량이 9.7배 증가하는 것을 확인했다고 발표했습니다. 다만, 이러한 결과는 하드웨어 성능, 워크로드 특성 및 스토리지 구성에 따라 달라질 수 있다고 회사 측은 덧붙였습니다.
이 통합 기능은 VAST 수명 주기 정책을 KV 캐시 데이터에 적용합니다. 이 기능은 캐시된 정보를 자동으로 만료시키고 삭제하기 위한 것으로, 추론 컨텍스트에 민감한 데이터, 개인 정보 또는 규제 대상 데이터가 포함된 경우에 유용합니다.
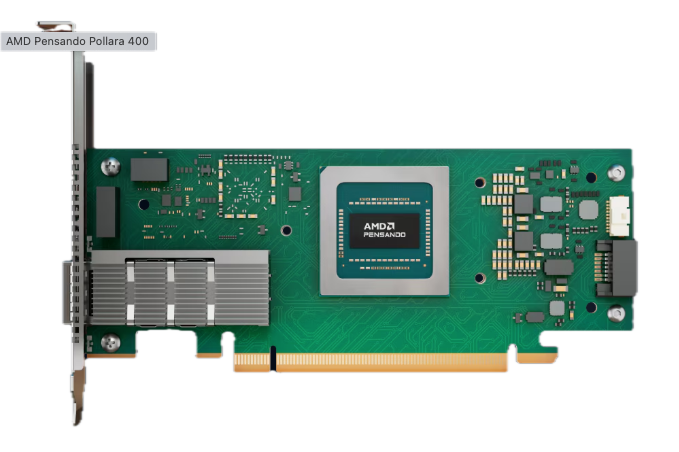
Pensando Pollara 400은 GPU를 공유 스토리지에 연결합니다.
이 아키텍처는 AMD Pensando Pollara 400 AI NIC를 사용하여 AMD Instinct GPU와 VAST 스토리지 클러스터를 연결합니다. VAST에 따르면, 이 NIC는 TCP 및 RDMA를 통한 NFS를 통해 GPU와 스토리지 간의 데이터 이동을 지원하며, 이를 통해 KV 캐시 및 더 광범위한 추론 데이터 요구 사항을 충족하기 위해 NVMe SSD 기반 VAST 클러스터에 액세스할 수 있습니다.
결과적으로 설계된 이 플랫폼은 GPU 메모리와 관계없이 컨텍스트 관리를 확장해야 하는 AI 환경을 지원하도록 설계되었습니다. VAST는 스토리지를 별도의 영구 저장 계층으로 취급하는 대신, 분산 인프라 전반에 걸쳐 모델, 데이터베이스, 스트리밍 데이터, 파일 데이터 및 AI 컨텍스트를 관리할 수 있는 데이터 및 실행 계층으로 플랫폼을 포지셔닝합니다.
AI 클라우드 제공업체의 경우, 이러한 접근 방식은 GPU 임대 및 배치 학습을 넘어 지속적인 추론 및 에이전트 기반 AI 서비스로 배포가 진행됨에 따라 GPU 활용률을 높이고 운영 효율성을 개선하는 것을 목표로 합니다.


 아마존