

Corsair FlexPrime V20C는 로컬 AI 작업에 최적화된 마이크로 ATX 타워 워크스테이션으로, 24코어 Intel Core Ultra 7 270K Plus CPU와 Intel Arc Pro B70 메인보드, 그리고 32GB의 전용 그래픽 메모리를 탑재했습니다. Ubuntu 24.04 LTS 운영체제, 360mm 수랭식 CPU 쿨러, 850W 파워 서플라이가 기본 제공되며, Corsair가 2026년 5월에 출시한 AI 워크스테이션 및 서버 제품군인 CORSAIR PRO 시리즈에 속합니다. 저희는 Linux 환경에서 이 제품을 소형 RTX PRO 4000 워크스테이션 및 128GB 통합 메모리를 탑재한 두 대의 데스크톱과 비교 테스트했습니다.

주요 요점
- Arc Pro B70은 당사의 LLM 서빙 테스트에서 모든 호환 모델 중 선두 또는 동위를 차지했습니다. SYCL의 llama.cpp를 통해 V20C는 Ministral 3 8B를 한 명의 사용자에게 초당 63.7 토큰으로 제공했으며, 이는 Dell Pro Max Micro에 탑재된 RTX PRO 4000 SFF의 52.0 토큰 및 GB10이 탑재된 Dell Pro Max의 37.0 토큰보다 높은 수치입니다.
- 32GB 그래픽 메모리는 24GB 카드로는 로드할 수 없었던 27B 모델을 실행할 수 있었습니다. Qwen3.8 27B는 단일 요청에서 초당 19.8개의 토큰을 생성했고, 8개 요청에 걸쳐서는 35.4개를 생성했습니다. GB10은 단일 요청에서 초당 11.2개의 토큰을 처리했으며, 8개 요청에서는 V20C와 동일한 성능을 보였습니다.
- 24코어 Core Ultra 7 270K Plus는 우리가 진행한 모든 빌드 및 렌더링 테스트에서 최고의 성능을 보여주었습니다. 이 시스템은 Blender Monster를 분당 330.4개의 샘플로 렌더링했는데, 이는 AMD Ryzen AI Halo의 285.3개 샘플보다 높은 수치입니다. 또한 LLVM 빌드는 136초 만에 완료되었는데, 이는 AMD의 149초, 173초, 175초보다 빠른 기록입니다. 그리고 Linux 커널 컴파일은 639초 만에 완료되었는데, 이는 AMD의 918초, AMD의 892초보다 빠른 속도입니다.
- 이 GPU에서 최종 결과는 소프트웨어 백엔드에 의해 결정됩니다. Ollama와 stable-diffusion.cpp는 Vulkan을 통해 실행되었으며, V20C는 코딩 에이전트에서 초당 32.2개의 토큰을 생성했는데 이는 GB10의 53.9개에 비해 낮은 수치입니다. 또한 분당 4.26개의 FLUX.2 이미지를 생성했는데, 이는 GB10의 9.96개에 비해 낮은 수치입니다.
- 이 제품의 가격은 3,999.99달러로, AMD 라이젠 AI 헤일로와 비슷한 수준이며, 128GB RAM을 탑재한 델 프로맥스(GB10 탑재)보다 약 3,500달러 저렴합니다. 이러한 시스템은 더 큰 모델을 지원하며, 여기의 68GB/s에 비해 114GB/s에서 121GB/s에 이르는 메모리 대역폭을 제공합니다. OpenFOAM 테스트에서 이러한 시스템은 1,636초, 여기의 시스템은 1,222초, 여기의 시스템은 1,148초를 기록했습니다.
- 팬 제어와 SSD에 점검이 필요합니다. 테스트 도중 팬 속도가 불규칙적으로 올라갔다 내려갔다 했는데, 그 원인을 파악하기에는 시간이 부족했습니다. 1TB SSD는 4K 랜덤 쓰기에서 최고 184K IOPS를 기록했고 온도는 81°C에 도달했습니다.
FlexPrime V20C의 위치
CORSAIR PRO는 Corsair가 올해 초 출시한 AI 시스템 포트폴리오로, FlexPrime은 워크스테이션 제품군이고 FlexGrid는 랙 서버 제품군입니다. Corsair는 FlexPrime을 AI를 로컬에서 개발, 미세 조정 및 배포하려는 팀을 위한 AI 워크스테이션으로 설명하며, V20C는 해당 제품군의 V20 섀시에 고정 구성으로 제공되는 제품으로 SKU CSW-9040004-NA입니다. 동일한 섀시는 Corsair의 구성 도구를 통해 NVIDIA RTX PRO Blackwell 카드와 AMD Radeon AI PRO R9700을 비롯하여 다른 프로세서와 최대 128GB 메모리 구성으로도 주문할 수 있습니다.
V20C는 Corsair 스토어에서 3,999.99달러에 판매되고 있으며, 이 글을 작성하는 시점에는 재고가 있었습니다. 3년 보증과 평생 기술 지원이 제공됩니다. 이 가격에는 Core Ultra 7 270K Plus, Arc Pro B70 메인보드, 16GB DIMM 두 개로 구성된 32GB DDR5 메모리, 1TB M.2 NVMe SSD, 그리고 Ubuntu 24.04 LTS가 포함되어 있습니다. Corsair는 리뷰용 제품에 16GB DIMM 네 개를 장착하여 총 64GB 시스템 메모리를 제공했으므로, 아래 결과는 명시된 메모리 용량의 두 배를 기준으로 합니다. Corsair는 미국에서 B70 시스템을 자사 구성 도구 외에서는 미리 정의되고 검증된 구성으로만 판매하므로, 저희가 테스트한 64GB 구성은 별도의 가격이 책정되어 있지 않습니다.
인텔은 32GB GDDR6 메모리, 32개의 Xe2 코어, 256개의 XMX 엔진, 그리고 608GB/s의 메모리 대역폭을 갖춘 Arc Pro B70을 949달러에 출시했습니다. 이 가격대의 워크스테이션에서 32GB 그래픽 메모리를 구현할 수 있었던 것은 바로 이러한 사양 덕분입니다. 인텔 Arc Pro B70 리뷰 에서 우리는 하드웨어가 소프트웨어보다 앞서 있다는 것을 발견했는데, 드라이버와 프레임워크 지원이 CUDA와 ROCm에 비해 뒤처져 있었습니다. V20C는 이 그래픽 카드를 리눅스 워크스테이션에 탑재한 제품으로, 이번 리뷰에서는 그 이후로 소프트웨어 스택이 얼마나 발전했는지도 살펴봅니다.
Corsair는 제품 페이지에서 B70의 토큰 처리 속도를 공개하고 있는데, Qwen3.8-27B에서는 초당 약 55개, Gemma-4-E4B에서는 약 85개, Qwen3.5-27B에서는 약 20개의 토큰을 처리한다고 나와 있습니다. 하지만 해당 페이지에는 양자화 방식, 추론 엔진, 컨텍스트 길이 등의 정보가 명시되어 있지 않으므로, 이 수치들은 방향성을 고려한 값임에 유의해야 합니다.
빌드 및 디자인
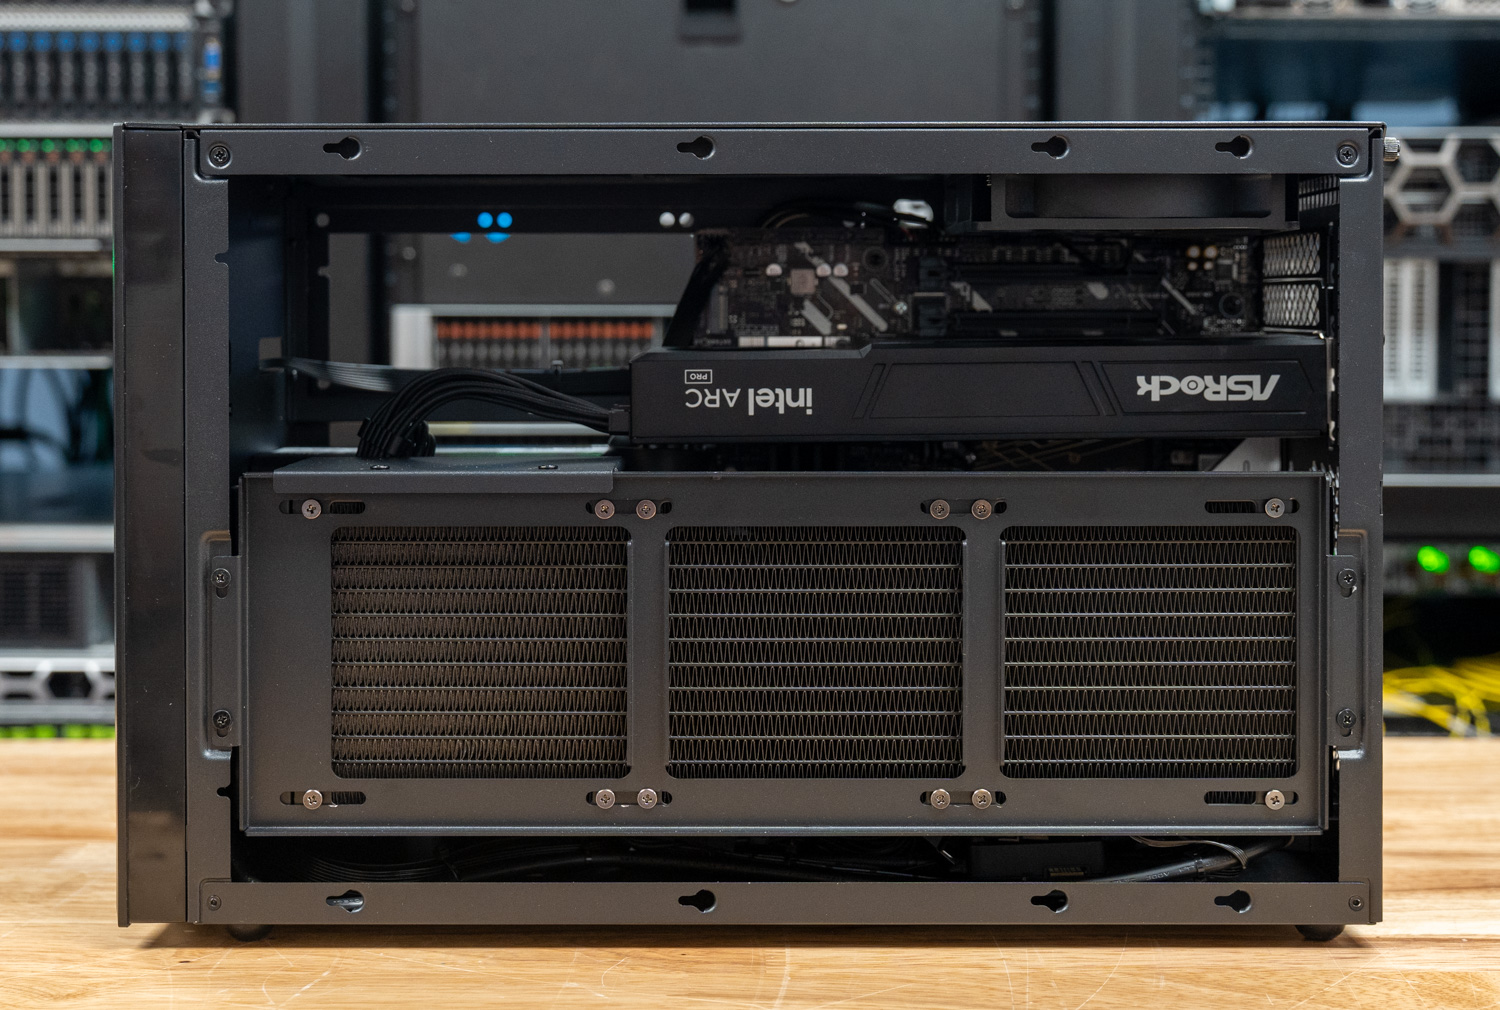
V20C는 가로 202mm, 세로 451mm, 높이 286mm(7.95인치 x 17.76인치 x 11.26인치) 크기에 무게는 14kg(30.9파운드)으로, 풀사이즈 그래픽 카드와 360mm 라디에이터를 장착할 수 있는 소형 타워 케이스입니다. Corsair는 내부 용적을 26.1리터로 추산하며, 마더보드를 180도 회전시켜 그래픽 카드가 상단에서 공기를 흡입하고 측면으로 배출하도록 설계했습니다. 최대 400mm 길이의 그래픽 카드를 장착할 수 있으며, 후면에는 120mm 배기 팬이 있습니다. 마이크로 ATX 규격의 이 케이스는 검은색이며, 측면 패널에는 Corsair 로고가 새겨져 있습니다. 다만, Corsair의 다른 제품들과 동일한 디자인을 찾을 수는 없었습니다.
Corsair는 패널을 도구 없이 분리할 수 있다고 명시하고 있으며, 저희가 테스트한 제품의 측면 패널도 예상대로 쉽게 분리되었습니다. 회사 측은 이 제품의 레이아웃을 각 부품에 최적화된 냉각 설계와 개별적인 공기 흐름 경로를 갖춘 구조라고 설명합니다. 구성 도구에서는 360mm 라디에이터 두 개를 지원한다고 나와 있습니다. Corsair는 케이스 측면에 부착하는 디스플레이 패널 액세서리도 판매하는데, 저희는 테스트하지 않았으며 워크스테이션에서 이러한 액세서리가 얼마나 유용할지는 의문입니다.
CPU 냉각은 360mm 수랭 쿨러를 통해 이루어지며, Corsair는 시스템에 120mm 팬 5개를 기본 제공합니다. 저희 테스트 시스템에 장착된 쿨러는 Corsair의 iCUE LINK TITAN 360 RX RGB 변형 모델로, RGB 기능이 없는 팬이 장착되어 있습니다. 라디에이터와 3개의 팬은 케이스 측면의 브래킷에 장착되며, 튜브가 부착된 상태로 브래킷을 분리하면 마더보드가 드러납니다. 그래픽 카드는 공랭식 ASRock Arc Pro B70이며, 전원은 80 PLUS Gold 등급의 850W Corsair RM850e 파워 서플라이에서 공급됩니다.

우분투 환경에서 테스트하는 동안 부하가 시작되고 종료될 때 팬 속도가 불규칙적으로 증가했다가 감소하는 현상이 발생했습니다. 이 문제를 진단하고 해결 가능한지 여부를 확인하는 데 많은 시간을 할애하지는 않았지만, 만약 해결되지 않는다면 다소 거슬리는 현상입니다.
저희 시스템에 탑재된 마더보드는 BIOS 3012 버전에서 ASUS PRIME Z890M-PLUS WIFI로 확인되었으며, Wi-Fi 7을 지원하는 micro-ATX Z890 보드입니다. 메모리는 Crucial Pro DDR5-6400 16GB DIMM 모듈 4개가 모두 장착되어 있으며, 저장 장치는 PCIe Gen5 x4 링크에 연결된 1TB XPG MARS 970 PLUS입니다. 이러한 부품들은 일반적인 데스크톱 구성이므로 메모리, 저장 장치, 그래픽 카드 및 파워 서플라이는 나중에 교체할 수 있습니다.
Corsair의 구성 도구에 따르면 M.2 2280 슬롯은 PCIe 5.0 x4 슬롯 1개와 PCIe 4.0 x4 슬롯 2개를 포함하여 총 3개입니다. 저장 장치 확장을 위한 슬롯으로는 SATA 포트 6개, 2.5인치 베이 2개, 그리고 3.5인치 또는 2.5인치 드라이브를 장착할 수 있는 베이 1개가 있습니다. 메인보드에는 확장 슬롯이 4개 있는데, B70용 PCIe 5.0 x16 슬롯 1개, PCIe 4.0 x4 슬롯 1개, 그리고 PCIe 4.0 x1 슬롯 2개입니다. Gen5 슬롯에 부팅 드라이브를 장착하면 나머지 2개의 Gen4 M.2 슬롯을 추가 저장 장치용으로 사용할 수 있습니다.
전면 I/O 스트립은 상단 패널에 있으며 5Gbps USB Type-C 포트 1개, 5Gbps USB Type-A 포트 2개, 전원 버튼 옆에 콤보 오디오 잭이 있습니다.

메인보드 뒷면에는 20Gbps USB Type-C 포트 1개, 10Gbps USB Type-A 포트 1개, 5Gbps USB Type-A 포트 4개, USB 2.0 포트 2개, 2.5GbE, Wi-Fi 7 안테나 커넥터, 오디오 잭 3개가 있습니다. B70 보드는 DisplayPort 2.1 출력 포트 4개를 갖추고 있으며, 프로세서 내장 그래픽을 위한 DisplayPort와 HDMI 포트도 제공합니다.
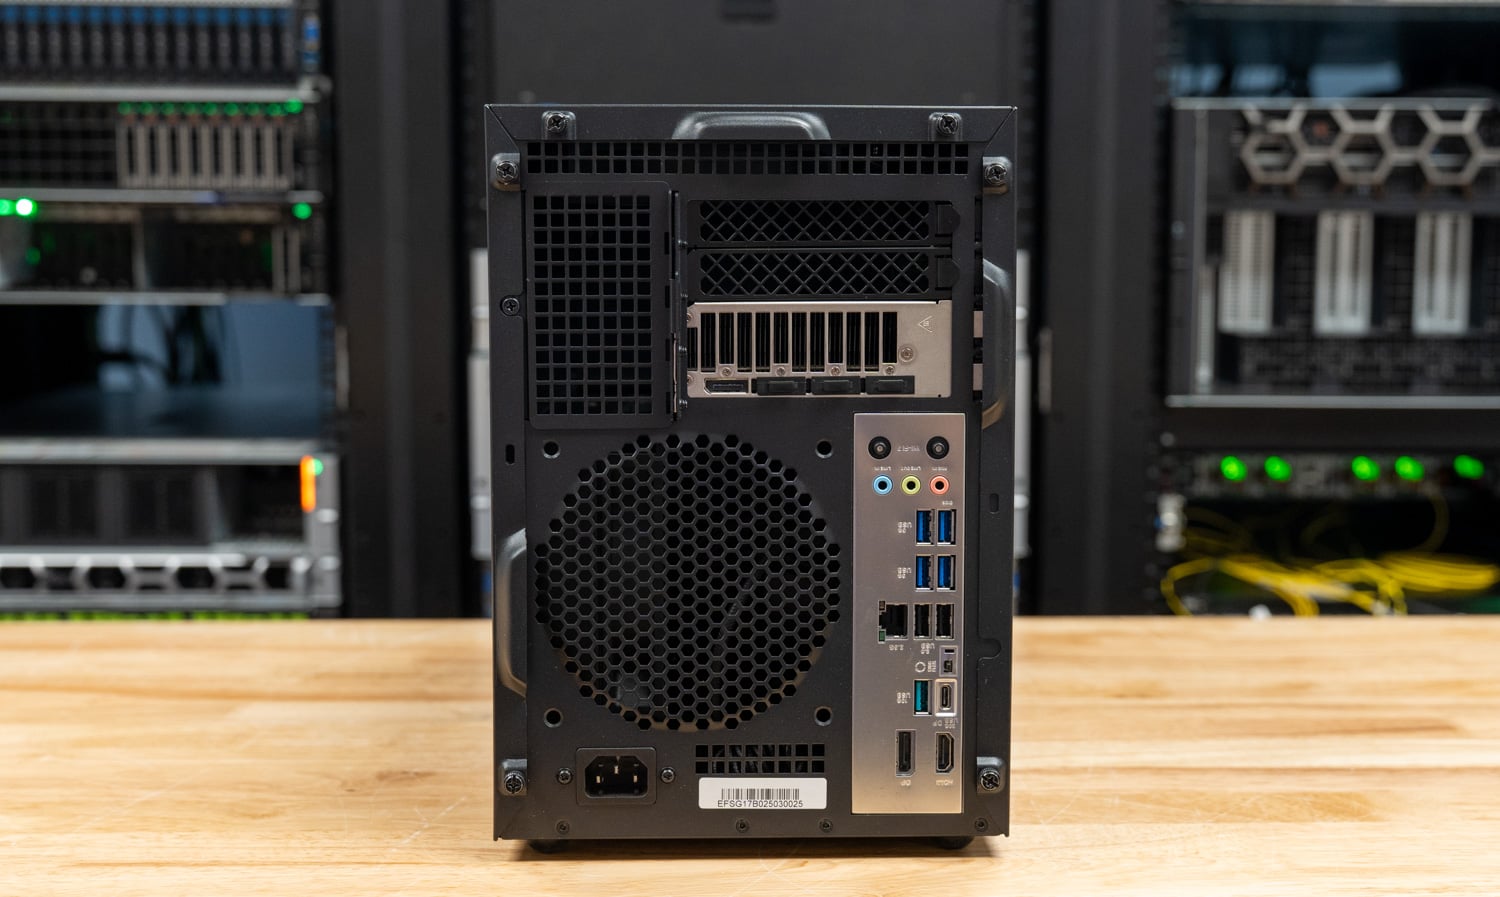
Corsair는 V20C를 Ubuntu 24.04 LTS와 함께 제공하며, 구성 도구에서 Windows 11 Pro를 대안으로 제시합니다. 이 회사는 통합 프레임워크, GPU 가속, 컨테이너, 모니터링 및 개발자 도구를 갖춘 완벽한 에이전트 기반 AI 소프트웨어 스택을 광고합니다. Corsair는 해당 이미지에서 로컬 모델을 다운로드 및 전환하고, PI Agent와 Hermes Agent 하네스 중 하나를 선택하고, 앱을 관리할 수 있는 CORSAIR PRO 대시보드를 제공한다고 설명합니다. 이 SKU에 대한 설정 가이드는 Docker 환경에서 llama.cpp를 사용하여 Qwen3.8-27B를 65,536 토큰 컨텍스트로 실행하고 Hermes Desktop을 해당 로컬 엔드포인트에 연결하는 과정을 안내합니다.
Corsair의 구성 도구는 Ubuntu 설치에 GPU 드라이버와 그래픽 카드에 맞는 컴퓨팅 런타임이 포함되어 있으며, 선택적으로 GPU 런타임이 포함된 Docker, 모니터링 도구 및 Python을 추가하는 Corsair AI Stack을 제공한다고 설명합니다. 연구실에서는 테스트 전에 공장 이미지를 교체했습니다.
Corsair FlexPrime V20C 사양
| 스펙 | Corsair FlexPrime V20C |
|---|---|
| 플랫폼 | |
| SKU | CSW-9040004-NA |
| 프로세서 | 인텔 코어 울트라 7 270K 플러스, 24코어(P코어 8개, E코어 16개), 24스레드, 최대 5.5GHz |
| 그래픽 업로드 | 인텔 아크 프로 B70, 32GB GDDR6 32개의 Xe2 코어, 256개의 XMX 엔진 608GB/s 메모리 대역폭 테스트된 ASRock 카드 |
| 메모리 | 명시된 대로 32GB(16GB x 2) DDR5 테스트 결과 64GB (16GB x 4) Crucial Pro DDR5-6400 |
| 스토리지 | 1TB M.2 NVMe SSD XPG MARS 970 PLUS는 PCIe Gen5 x4 링크에서 테스트되었습니다. |
| 마더 보드 | 인텔 Z890, 마이크로 ATX ASUS PRIME Z890M-PLUS WIFI 테스트 결과 |
| 운영체제 | Ubuntu 24.04 LTS (출시 당시 버전) 테스트 환경: Ubuntu 26.04.1 LTS |
| 냉각 및 전력 | |
| CPU 냉각 | 360mm 액체 쿨러 Corsair iCUE LINK TITAN 360 RX (비RGB 팬 장착 모델 테스트 결과) |
| 시스템 팬 | 5x 120mm |
| GPU 냉각 | 비행기 |
| 전원 공급 장치 | 850W Corsair RM850e 테스트 결과 |
| 입/출력 라인 | |
| 전면 포트 | USB Type-C (5Gbps) 1개 2x USB Type-A(5Gbps) 1x 콤보 오디오 |
| 후면 포트 | USB Type-C (20Gbps) 1개 1x USB Type-A(10Gbps) 4x USB Type-A(5Gbps) 2x USB 2.0 디스플레이 포트, HDMI 3배속 오디오 |
| GPU 출력 | 4x 디스플레이 포트 2.1 |
| 네트워킹 | 2.5GbE Wi-Fi 7, Bluetooth 5.4 |
| 확장 | M.2 2280: PCIe 5.0 x4 1개, PCIe 4.0 x4 2개 PCIe: 5.0 x16 1개, 4.0 x4 1개, 4.0 x1 2개 베이: 2.5인치 2개, 3.5인치 1개 또는 2.5인치 |
| 물리적 및 지원 | |
| 크기 (폭 x D x 높이) | 202 x 451 x 286mm (7.95 x 17.76 x 11.26in) |
| 중량(평량) | 14kg (30.9lb) |
| 색상 | 검정 |
| 품질 보증 | 3년, 평생 기술 지원 |
| 가격 | 3,999.99달러 (코세어, 32GB 메모리 포함) |
테스트 설정 및 방법론
Corsair의 공장 출고 이미지는 Ubuntu 24.04 LTS이며, 저희는 최신 커널이 설치된 Linux 환경에서 고성능 워크스테이션을 테스트하기 때문에 연구실에서는 7.0 커널이 탑재된 Ubuntu 26.04.1 LTS를 설치했습니다. 이는 본 리뷰에 사용된 Dell Pro Max Micro에서 실행된 것과 동일한 버전입니다. V20C는 BIOS 3012, Mesa 26.0.8, 그리고 Intel의 xe 커널 드라이버를 사용하여 성능 전원 프로파일로 테스트되었으며, Arc Pro B70에서 GPU 사용 가능 메모리는 31.9GB로 측정되었습니다.
결과는 자체 개발한 세 가지 테스트 스위트에서 얻은 것입니다. 첫 번째는 클라이언트 스위트의 Linux 빌드인 sr-client_linux 0.1로, 로컬 AI, 콘텐츠 제작, 그래픽 및 스토리지 기능을 포함합니다. Cinebench, Geekbench, 3DMark, PCMark, Procyon은 Linux 빌드가 없으므로 해당 테스트와 30분 지속 루프 테스트는 포함되지 않았습니다. 벤치마크 도구는 Phoronix Test Suite 워크로드와 y-cruncher를 사용하며, 서버 스위트는 ClickBench, OpenFOAM, STREAM, Valkey를 실행합니다.
클라이언트 결과는 스위트 테스트를 세 번 실행한 결과를 종합한 것이며, 동일한 테스트가 두 번 이상 실행된 경우 가장 최근에 유효한 결과를 보고합니다. 각 수치는 반복 실행 결과의 중앙값입니다. 스위트의 PyTorch 빌드가 CUDA와 ROCm을 모두 지원하기 때문에 V20C에서는 미세 조정 테스트를 실행하지 않았습니다. 따라서 Corsair 설명에 나와 있는 미세 조정 부분에 대한 측정 결과는 없으며, 38GB 이상의 GPU 메모리가 필요한 이미지 및 LLM 워크로드도 실행에 적합하지 않았습니다.
The comparison set covers three ways to buy local AI hardware. The 델 프로 맥스 마이크로 is a compact workstation with the 24-core Core Ultra 9 285, a 24GB RTX PRO 4000 Blackwell SFF, and 96GB of DDR5-6400. The GB10이 탑재된 Dell Pro Max NVIDIA의 20코어 GB10 프로세서와 128GB 통합 메모리를 NVIDIA의 Ubuntu 24.04 이미지에서 실행합니다. AMD 라이젠 AI 헤일로 AMD의 리눅스 개발자 이미지에서 128GB의 통합 LPDDR5X 메모리를 탑재한 16코어 Ryzen AI Max+ 395 프로세서를 실행합니다.
Halo는 AMD 개발자 이미지에서 sr-client_linux 0.1, harness v3.6 및 server suite r5.28을 실행했습니다. GB10은 동일한 애플리케이션 버전으로 이전 버전의 harness 및 server suite를 실행했으며, 세 운영 체제는 서로 다른 컴파일러를 사용하기 때문에 커널 컴파일과 같은 소스 빌드 테스트에 영향을 미칩니다.
소프트웨어 경로는 GPU 제조사에 따라 다르며, 이는 이후 모든 AI 결과에 영향을 미칩니다. V20C에서는 MLPerf Client가 OpenVINO를 통해 실행되었고, llama.cpp는 SYCL 백엔드를 사용하여 fp16으로 실행되었습니다. Ollama와 stable-diffusion.cpp는 Vulkan을 통해 실행되었는데, 이는 Ollama의 네이티브 경로가 Arc 카드에 모델을 배치하지 않았기 때문입니다. 두 NVIDIA 시스템은 전체적으로 CUDA를 사용했고, Halo는 AMD의 ROCm을 사용했습니다. V20C에서 Ollama를 한 번 실행했을 때는 Vulkan 장치 연결 끊김 오류가 발생했지만, 재실행 후에는 성공했습니다.
| 구성 | CPU | 메모리 | GPU | 부팅 드라이브 | 운영체제 |
|---|---|---|---|---|---|
| Corsair FlexPrime V20C | Core Ultra 7 270K Plus, 24코어 | 64GB DDR5-6400(4GB 16개) | 인텔 아크 프로 B70, 사용 가능 용량 31.9GB | 1TB XPG MARS 970 PLUS, PCIe Gen5 | 우분투 26.04.1 LTS, 커널 7.0 |
| 델 프로맥스 마이크로(FCM2250) | 코어 울트라 9 285, 24코어 | 96GB DDR5-6400(2GB 48개) | NVIDIA RTX PRO 4000 블랙웰 SFF, 23.9GB 사용 가능 메모리 | 1TB Sandisk SN8050S, PCIe Gen5 | 우분투 26.04.1 LTS, 커널 7.0 |
| Dell Pro Max GB10 (FCM1253) | NVIDIA GB10, 20코어 | 128GB LPDDR5X-8533, 통합형 | NVIDIA GB10, 사용 가능 용량 121.6GB | 4TB PCIe Gen4 | 우분투 24.04.5 LTS, NVIDIA 커널 7.0 |
| AMD 라이젠 AI 헤일로 | 라이젠 AI 맥스+ 395, 16코어 | 128GB LPDDR5X-8000, 통합형 | 라데온 8060S(내장형), 95.5GB 사용 가능 용량 | 2TB 마이크론 4600, PCIe Gen4 링크 | AMD 리눅스 개발자 이미지, 커널 7.2 |
로컬 AI 성능
Arc Pro B70은 V20C에 32GB의 전용 그래픽 메모리를 제공하는데, 이는 Dell Pro Max Micro에 탑재된 RTX PRO 4000 SFF보다 8GB 더 많고, GB10이 통합 풀에서 처리할 수 있는 용량의 약 4분의 1에 해당합니다. 테스트 스위트는 V20C의 31.9GB 메모리를 24GB Dell 제품과 동일한 메모리 계층으로 분류하여 20B 에이전트 모델과 27B 서빙 모델을 실행했습니다. 128GB 시스템에서 사용할 수 있는 더 큰 계층은 실행되지 않았습니다.
LLM 제공
| llama.cpp 서버 (별도로 명시되지 않은 경우, 값이 높을수록 좋습니다) | Corsair FlexPrime V20C (Ultra 7 270K Plus, Arc Pro B70 32GB) | 델 프로 맥스 마이크로 (울트라 9 285, RTX PRO 4000 SFF 24GB) | Dell Pro Max GB10(128GB 통합) | AMD 라이젠 AI 헤일로(라이젠 AI 맥스+ 395, 128GB 통합) |
|---|---|---|---|---|
| Ministral 3 3B, 요청 1개(토큰/초) | 84.9 | 80.7 | 53.2 | 43.0 |
| Ministral 3 3B, 요청 4개(토큰/초) | 213.3 | 201.5 | 139.8 | 105.1 |
| Ministral 3 3B, 요청 1건, 첫 번째 토큰 생성 시간(밀리초, 낮을수록 좋음) | 590 | 666 | 572 | 1,659 |
| Ministral 3 8B, 요청 1개(토큰/초) | 63.7 | 52.0 | 37.0 | 30.6 |
| Ministral 3 8B, 요청 4개(토큰/초) | 141.8 | 108.9 | 97.2 | 66.6 |
| Ministral 3 8B, 요청 1건, 첫 번째 토큰 생성 시간(밀리초, 낮을수록 좋음) | 1,362 | 1,477 | 1,398 | 4,602 |
| Qwen3.8 27B, 요청 1건(토큰/초) | 19.8 | 맞지 않았다 | 11.2 | 9.1 |
| Qwen3.8 27B, 4개 요청(토큰/초) | 33.5 | 맞지 않았다 | 27.1 | 18.4 |
| Qwen3.8 27B, 8개 요청(토큰/초) | 35.4 | 맞지 않았다 | 35.6 | 20.1 |
| Qwen3.8 27B, 요청 1건, 첫 번째 토큰 획득 시간(밀리초, 낮을수록 좋음) | 9,005 | 맞지 않았다 | 9,207 | 24,024 |
LLM 서버는 Ministral 3 모델에서 4,096개 토큰 프롬프트와 1,024개 토큰 출력을 사용하는 llama.cpp 서버를 실행합니다. V20C는 해당 모델에서 NVIDIA 시스템 중 가장 뛰어난 성능을 보였습니다. 3B 모델에서는 한 명의 사용자에게 초당 84.9개 토큰을 처리하여 RTX PRO 4000 SFF보다 5%, GB10보다 60% 앞섰고, 8B 모델에서는 초당 63.7개 토큰을 처리하여 동일한 두 시스템보다 각각 22%와 72% 앞섰습니다. 동시 요청이 4개일 때는 초당 213.3개와 141.8개 토큰을 처리하여 Dell Pro Max Micro보다 각각 6%와 30% 앞섰습니다.
Halo에 내장된 Radeon 8060S는 ROCm에서 llama.cpp를 실행했을 때 세 제품 모두에서 성능이 뒤처졌습니다. 3B 모델의 경우 한 번의 요청에 대해 초당 43.0개의 토큰을 처리했고, 8B 모델의 경우 초당 30.6개의 토큰을 처리했는데, 이는 V20C의 절반 수준입니다. 또한 Qwen3.8 27B 모델에서는 초당 9.1개의 토큰을 생성했으며, 첫 번째 토큰을 처리하는 데 걸린 시간의 중앙값은 24.0초로 V20C의 9.0초보다 길었습니다.

Qwen3.8 27B(Q4_K_M)는 가중치 계산과 한 요청의 키-값 캐시를 위해 30GB의 GPU 사용 가능 메모리가 필요하므로 24GB RTX PRO 4000 SFF로는 실행할 수 없었습니다. 하지만 V20C의 31.9GB 메모리는 모든 동시 실행 수준에서 요구 조건을 충족했습니다. 단일 요청 시 V20C는 초당 19.8개의 토큰을 생성하여 GB10의 11.2개보다 77% 빠른 속도를 보였습니다. 동시 요청이 4개일 때는 격차가 24%로 좁혀졌습니다. 8개일 때는 두 시스템의 성능이 거의 동일하여 각각 초당 35.4개와 35.6개의 토큰을 처리했습니다.
27B 모델의 8,192개 토큰 프롬프트에서 첫 번째 토큰을 받는 데 걸린 시간은 V20C에서 9.0초, GB10에서 9.2초였습니다. 따라서 프롬프트 처리 속도는 두 제품 간에 동일하며, B70의 장점은 생성 속도에 있습니다. Corsair는 이 모델의 초당 약 55개의 토큰을 처리한다고 명시했지만 설정값은 밝히지 않았습니다. 저희 테스트 환경에서 V20C 사용자 한 명은 초당 약 20개의 토큰을 받았고, 요청이 추가됨에 따라 시스템 전체 출력은 최대 약 35개까지 올라갔습니다.

MLPerf 클라이언트 v2.0
| MLPerf 클라이언트 v2.0 (OpenVINO, GPU) | Corsair FlexPrime V20C |
|---|---|
| 라마 3.1 8B, 첫 토큰 획득 시간(초, 낮을수록 좋음) | 0.08 |
| 라마 3.1 8B, 토큰 비율(토큰/초) | 105.4 |
| Phi-4-mini, 첫 번째 토큰 생성 시간(초, 낮을수록 좋음) | 0.07 |
| Phi-4-mini, 토큰 비율(토큰/초) | 130.0 |
MLPerf Client v2.0은 Arc Pro B70에서 OpenVINO를 통해 실행되었으며, 모든 테스트에서 V20C가 기록한 가장 높은 단일 스트림 토큰 생성률을 보여주었습니다. Llama 3.1 8B는 초당 105.4개의 토큰을 생성했고, 첫 번째 토큰 생성에는 0.08초가 걸렸습니다. Phi-4-mini는 초당 130.0개의 토큰을 생성했습니다. 벤치마크의 Linux 버전에는 Intel OpenVINO 구성만 포함되어 있고 arm64 빌드가 없기 때문에 다른 세 시스템에서는 실행할 수 없었습니다. 따라서 이 표에서 V20C만 유일하게 남게 되었습니다.
모델 로딩 및 코딩 에이전트
| gpt-oss:20b (Ollama 0.40.3) | Corsair FlexPrime V20C (Ultra 7 270K Plus, Arc Pro B70 32GB) | 델 프로 맥스 마이크로 (울트라 9 285, RTX PRO 4000 SFF 24GB) | Dell Pro Max GB10(128GB 통합) | AMD 라이젠 AI 헤일로(라이젠 AI 맥스+ 395, 128GB 통합) |
|---|---|---|---|---|
| gpt-oss:20b 첫 번째 토큰에 콜드 로드(s, 낮을수록 좋음) | 6.29 | 5.11 | 6.86 | 4.20 |
| gpt-oss: 첫 번째 토큰에 20b 웜 로드(s, 낮을수록 좋음) | 3.18 | 3.12 | 6.36 | 4.03 |
| 코딩 에이전트, 성공 실행 횟수 (3회 중) | 3 | 1 | 3 | 2 |
| 코딩 에이전트, 평균 대기 시간(초, 낮을수록 좋음) | 368 | 80 * | 221 | 282 * |
| 코딩 에이전트, 생성 속도(토큰/초) | 32.2 | 76.2 | 53.9 | 41.2 |
| 에이전트 옆의 속도계 감속(x, 낮을수록 좋음) | 1.03 | 실행되지 않음 | 1.54 | 1.16 |
*델 프로맥스 마이크로는 에이전트 실행 3회 중 1회를 완료했고, AMD 라이젠 AI 헤일로는 3회 중 2회를 완료했습니다. 표시된 시간은 완료된 실행 시간입니다.
모델 부하 테스트는 12.8GB 모델인 gpt-oss:20b에서 Ollama를 실행하여 첫 번째 토큰을 생성하는 데 걸리는 시간을 SSD에서 바로 로드했을 때와 페이지 캐시에서 로드했을 때를 비교하여 측정했습니다. V20C는 바로 로드했을 때 6.29초, 캐시에서 로드했을 때 3.18초가 걸렸으며, Dell Pro Max Micro는 5.11초와 3.12초, GB10은 6.86초와 6.36초, Halo는 4.20초와 4.03초가 걸렸습니다. 바로 로드했을 때 V20C의 읽기 속도는 4,040MB/s였으며, fio에서 측정한 최대 속도는 7,311MB/s였습니다. 따라서 SSD 자체의 성능보다는 런타임이 속도를 좌우하는 요인임을 알 수 있습니다.
코딩 에이전트 테스트는 고정된 프로그래밍 작업을 통해 64K 컨텍스트에서 gpt-oss:20b에 대해 Crush를 실행하며, 각 라운드당 최대 3회씩 총 3번 실행됩니다. V20C는 11개 테스트 중 11개를 모두 통과했고, GB10도 마찬가지였습니다. Halo는 3개 중 2개, Dell Pro Max Micro는 3개 중 1개를 통과했습니다. V20C의 실행 시간은 각각 102초, 368초, 530초였으며, Vulkan 기반 Ollama에서 초당 32.2개의 토큰을 처리하는 속도는 Halo(41.2개), GB10(53.9개), RTX PRO 4000 SFF(76.2개)에 이어졌습니다.
128GB GB10은 qwen3.6:35b-a3b 환경에서 64K 및 128K 컨텍스트로 에이전트를 실행하여 각각 평균 90초와 70초 만에 작업을 완료했는데, 이는 gpt-oss:20b 환경에서 221초가 걸린 것보다 훨씬 빠른 속도입니다. V20C에서는 이러한 환경이 실행되지 않았습니다. 에이전트와 함께 Speedometer를 실행했을 때, V20C의 브라우저 점수는 51.8에서 50.4로 1.03배 감소했고, Halo는 1.16배, GB10은 1.54배 감소했습니다.

RAG의 두 가지 스케일
| RAG, 20,963개 구절 (Ollama 0.40.3) | Corsair FlexPrime V20C (Ultra 7 270K Plus, Arc Pro B70 32GB) | 델 프로 맥스 마이크로 (울트라 9 285, RTX PRO 4000 SFF 24GB) | Dell Pro Max GB10(128GB 통합) | AMD 라이젠 AI 헤일로(라이젠 AI 맥스+ 395, 128GB 통합) |
|---|---|---|---|---|
| 섭취량, 초당 통과 횟수 | 87.5 | 268.2 | 211.4 | 95.5 |
| 수집, 임베딩 속도(토큰/초) | 14,162 | 43,430 | 34,227 | 15,468 |
| 답변: 생성률(토큰/초) | 76.5 | 137.0 | 93.2 | 80.0 |
| 답변, 첫 번째 토큰 p50까지의 시간 (초, 낮을수록 좋음) | 0.30 | 0.16 | 0.15 | 0.42 |
| 50페이지에 있는 질문에 답해주세요 (s, 낮을수록 좋습니다) | 0.39 | 0.22 | 0.22 | 0.50 |
RAG 테스트는 20,963개의 SQuAD 지문을 임베드하고, 각 질문에 대한 상위 5개 지문을 추출하여 Ollama를 통해 Phi-4-mini로 답변을 생성합니다. Vulkan 환경에서 V20C는 초당 87.5개의 지문을 처리했습니다. 이는 Dell Pro Max Micro의 268.2개에 비해 약 3분의 1 수준이며, GB10의 211.4개에 비하면 절반에도 못 미칩니다. 답변 생성 속도는 초당 76.5개의 토큰으로, 각각 137.0개와 93.2개에 해당합니다. 질문에서 답변까지의 중간 시간은 두 NVIDIA 시스템 모두 0.39초 대 0.22초였습니다. Halo는 초당 95.5개의 지문 처리, 초당 80.0개의 토큰 처리, 그리고 질문에서 답변까지의 중간 시간 0.50초로 V20C에 가장 근접한 성능을 보였습니다.
| RAG 대규모 분석, 1,002,067개 통로 | Corsair FlexPrime V20C (Ultra 7 270K Plus, Arc Pro B70 32GB) | 델 프로 맥스 마이크로 (울트라 9 285, RTX PRO 4000 SFF 24GB) | AMD 라이젠 AI 헤일로(라이젠 AI 맥스+ 395, 128GB 통합) |
|---|---|---|---|
| 섭취, 1만 회분(회분/초) | 321.4 | 313.9 | 65.8 |
| 입력 시간(초, 낮을수록 좋음) | 3,118 | 3,192 | 15,230 |
| HNSW 지수 빌드(s, 낮을수록 좋음) | 73.4 | 78.9 | 68.9 |
| HNSW 검색, ef 64 (쿼리/초) | 29,643 | 27,359 | 34,012 |
| HNSW 검색, ef 256 (쿼리/초) | 8,285 | 7,664 | 9,649 |
| 50페이지에 있는 질문에 답해주세요 (s, 낮을수록 좋습니다) | 0.36 | 0.20 | 0.46 |
더 큰 규모의 RAG 테스트는 llama.cpp를 통해 백만 개의 위키피디아 구절을 임베딩하고, CPU에 HNSW 인덱스를 구축한 후 검색합니다. SYCL 환경에서 임베딩을 수행했을 때, V20C는 초당 321.4개의 구절을 처리하며 52분 만에 완료했는데, 이는 Dell Pro Max Micro의 313.9분보다 약간 빠른 속도입니다. 동일한 임베딩 모델을 사용한 소규모 테스트에서는 Vulkan 환경의 Ollama를 통해 초당 14,162개의 토큰을 처리했고, 이번 테스트에서는 SYCL 환경의 llama.cpp를 통해 초당 45,498개의 토큰을 처리했습니다. 두 테스트에서 Dell의 CUDA 처리 속도는 3% 이내의 차이를 보였습니다.
CPU 성능 측면에서는 V20C가 약간 우위를 보였습니다. 24개의 코어를 탑재한 V20C는 인덱스 구축에 73.4초(Dell은 78.9초)가 소요되었고, ef 설정 64에서 초당 29,643개의 쿼리를 처리하여 Dell의 27,359개 쿼리보다 빠른 속도를 보였습니다. 정확한 검색에 대한 재현율은 두 시스템 모두 91% 이상이었습니다. 이번 테스트에서 답변 생성은 Ollama를 사용했으며, 질문부터 답변까지의 평균 소요 시간은 V20C에서 0.36초, Dell에서 0.20초였습니다.
Halo는 백만 건의 문단 처리 테스트도 완료했는데, 임베딩 단계는 초당 65.8개의 문단 처리, 데이터 수집에 4.2시간이 걸리는 등 훨씬 느렸습니다. 16코어 프로세서는 인덱스 구축에 68.9초, 검색에는 초당 34,012개의 쿼리를 처리하여 두 부문 모두 V20C보다 앞섰으며, 질문과 답변 사이의 평균 시간은 0.46초였습니다.
이미지 생성
| stable-diffusion.cpp, 1024×1024 (이미지/분, 높을수록 좋음) | Corsair FlexPrime V20C (Ultra 7 270K Plus, Arc Pro B70 32GB) | 델 프로 맥스 마이크로 (울트라 9 285, RTX PRO 4000 SFF 24GB) | Dell Pro Max GB10(128GB 통합) | AMD 라이젠 AI 헤일로(라이젠 AI 맥스+ 395, 128GB 통합) |
|---|---|---|---|---|
| FLUX.2 클라인 4B Q4_0 (이미지/분) | 4.26 | 11.46 | 9.96 | 3.86 |
| FLUX.2 클라인 4B BF16(이미지/분) | 2.40 | 10.93 | 10.28 | 4.17 |
| Z-Image Turbo 6B Q4_0 (이미지/분) | 2.11 | 4.39 | 3.68 | 1.85 |
| Z-Image Turbo 6B BF16 (이미지/분) | 0.96 | 3.95 | 3.94 | 0.47 |
| Qwen-Image 20B Q4_0 (이미지/분) | 0.35 | 맞지 않았다 | 0.50 | 0.23 |
| Qwen-Image 20B Q8_0 (이미지/분) | 맞지 않았다 | 맞지 않았다 | 0.48 | 0.23 |
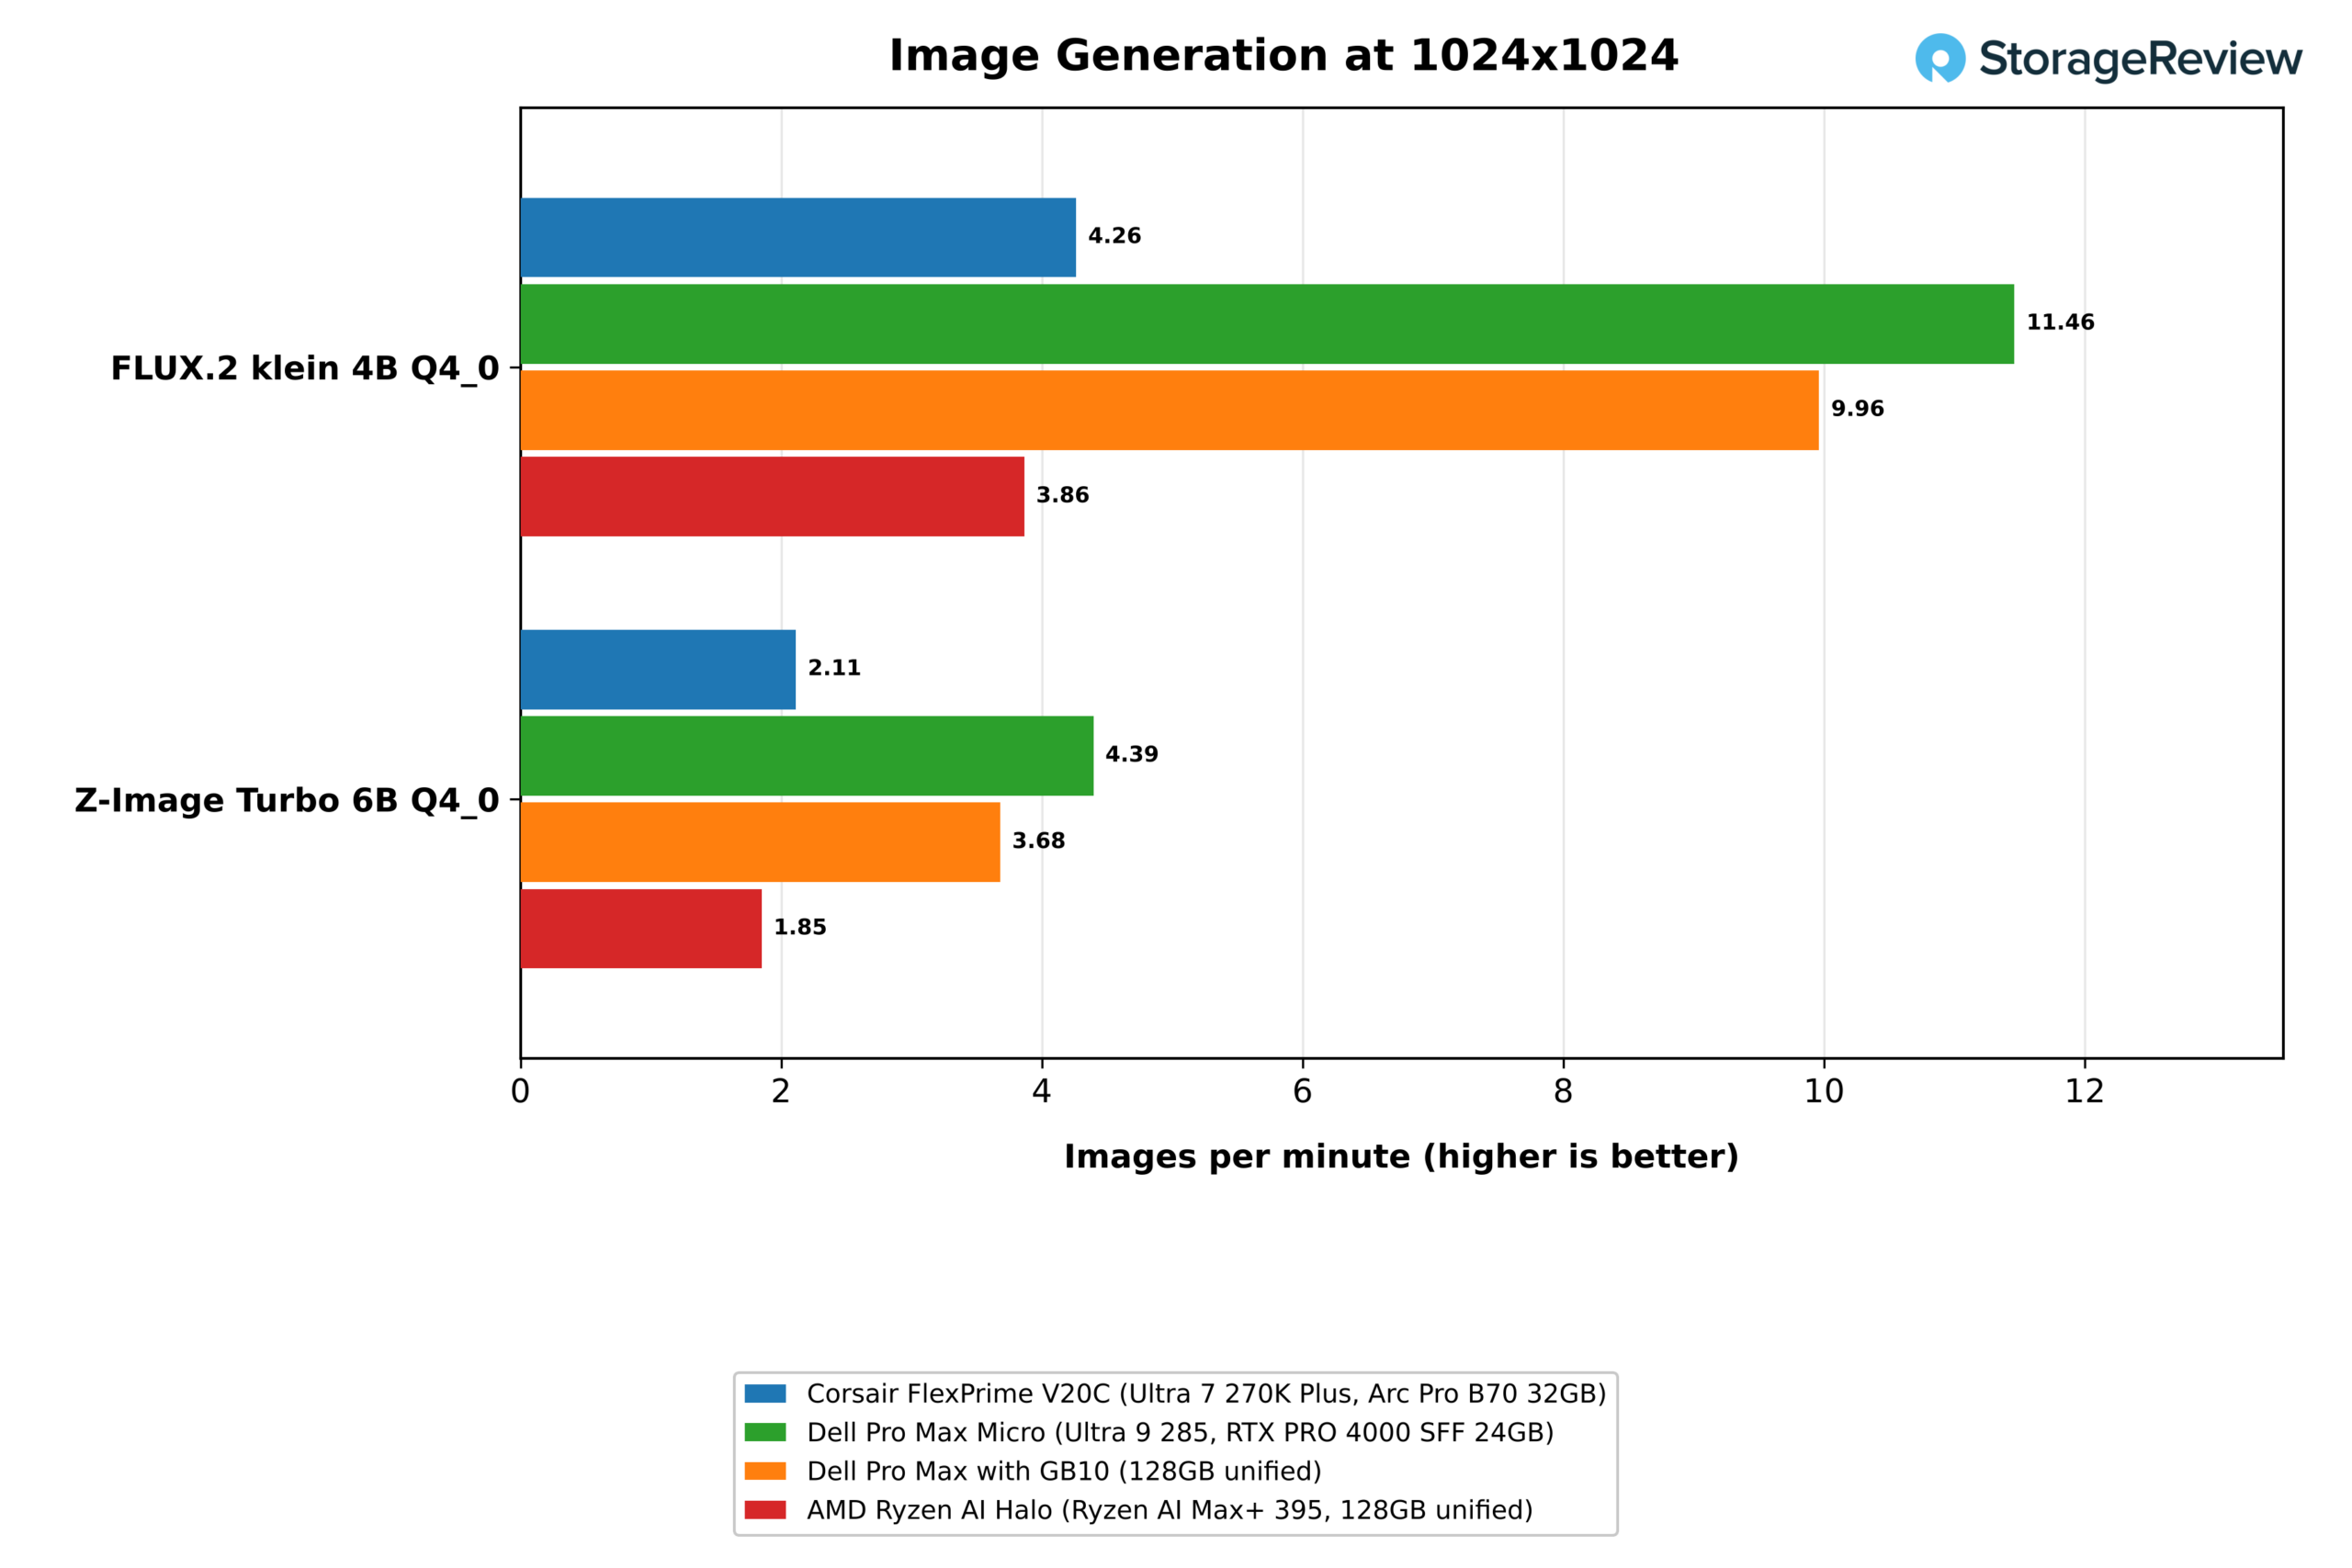
이미지 생성 성능은 V20C의 가장 약한 부분입니다. Vulkan을 사용한 stable-diffusion.cpp 테스트에서 FLUX.2 klein 4B 데이터셋을 Q4_0 기준으로 분당 4.26개의 이미지를 생성했는데, 이는 RTX PRO 4000 SFF의 11.46개, CUDA를 사용하는 GB10의 9.96개에 비해 낮은 수치입니다. GB10 역시 Vulkan 환경에서 동일한 테스트를 실행하여 분당 8.29개의 이미지를 생성했으므로, 성능 차이의 일부는 백엔드 성능 때문이며, 동일한 API를 사용했을 때도 B70은 GB10의 절반 수준에 그쳤습니다. Halo는 ROCm 데이터셋에서 분당 3.86개의 이미지를 생성했는데, 이는 V20C가 Q4_0 기준으로 유일하게 앞선 시스템이었습니다.
정밀도가 높아질수록 성능 차이는 더욱 커집니다. BF16에서 V20C는 FLUX.2 Klein에서 분당 2.40이미지, Z-Image Turbo에서 분당 0.96이미지로 성능이 저하된 반면, NVIDIA 시스템은 Q4_0 버전과 거의 비슷한 성능을 보였습니다. 메모리 용량은 Q4_0 버전에서 28GB 메모리가 필요한 Qwen-Image 20B에서 V20C에 유리하게 작용했습니다. V20C는 분당 0.35이미지를 처리한 반면, GB10은 0.50이미지, Halo는 0.23이미지를 처리했으며, 24GB 메모리 카드는 아예 로드하지 못했습니다. Q8_0 버전은 38GB 메모리가 필요하며, 통합 메모리 시스템을 사용하는 두 시스템에서만 정상적으로 작동했습니다.
CPU 성능
7-Zip, Blender, HandBrake 및 LLVM
| Test | Corsair FlexPrime V20C (Ultra 7 270K Plus, Arc Pro B70 32GB) | 델 프로 맥스 마이크로 (울트라 9 285, RTX PRO 4000 SFF 24GB) | Dell Pro Max GB10(128GB 통합) | AMD 라이젠 AI 헤일로(라이젠 AI 맥스+ 395, 128GB 통합) |
|---|---|---|---|---|
| 7-Zip, 모든 스레드, 총합(GIPS) | 199.6 | 164.0 | 149.5 | 215.8 |
| 7-Zip, 단일 스레드, 총합(GIPS) | 11.26 | 10.90 | 9.68 | 9.66 |
| 블렌더 4.5 몬스터(샘플/분) | 330.4 | 243.1 | arm64 빌드 없음 | 285.3 |
| Blender 4.5 정크샵(샘플/분) | 212.5 | 161.6 | arm64 빌드 없음 | 173.9 |
| Blender 4.5 강의실용 (샘플/분) | 152.8 | 114.5 | arm64 빌드 없음 | 144.0 |
| 핸드브레이크 x265 (fps) | 49.6 | 39.7 | arm64 빌드 없음 | 44.5 |
| 핸드브레이크 SVT-AV1 (fps) | 177.4 | 147.9 | arm64 빌드 없음 | 194.1 |
| LLVM 빌드(s, 낮을수록 좋음) | 136 | 173 | 175 | 149 |
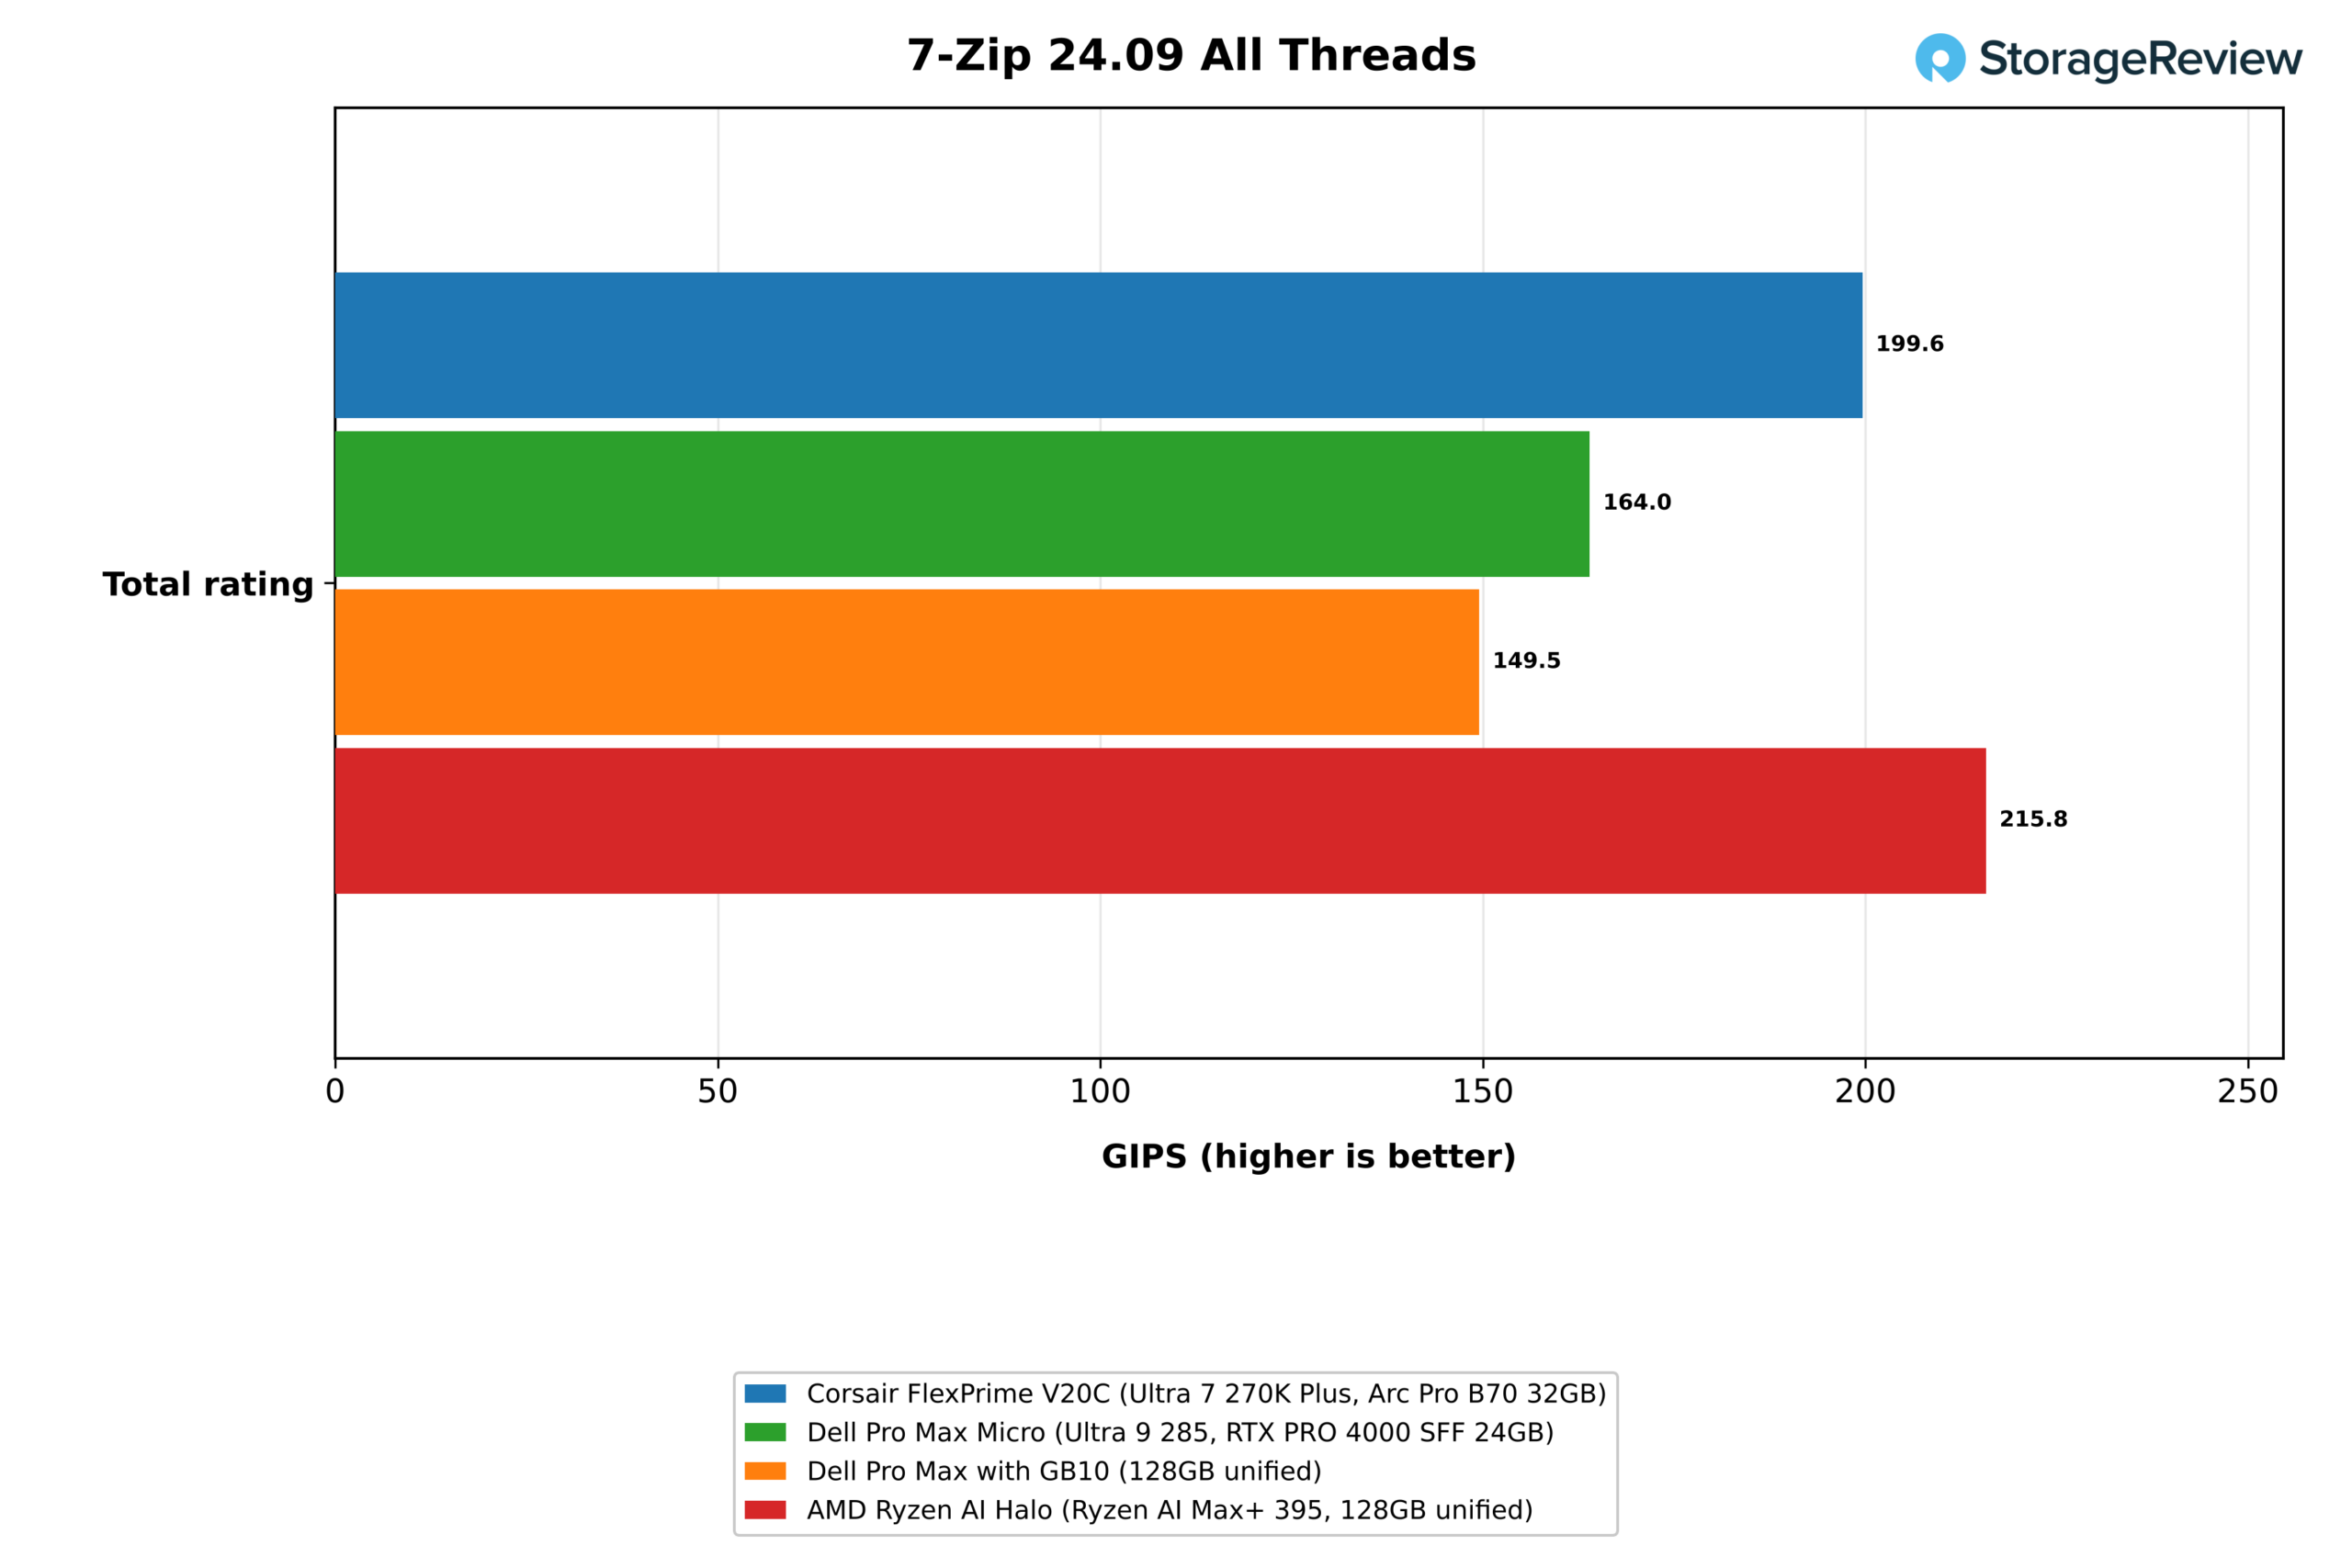
Core Ultra 7 270K Plus는 360mm 수랭 쿨러가 장착된 24코어 데스크톱 프로세서로, 이 표의 모든 항목에서 Dell 시스템 중 가장 뛰어난 성능을 보여주었습니다. V20C는 7-Zip 테스트에서 199.6 GIPS를 기록하며 Dell Pro Max Micro에 탑재된 Core Ultra 9 285보다 22%, GB10보다 34% 앞섰습니다. Blender 테스트에서는 세 가지 장면 모두에서 Dell 시스템보다 31~36% 빠른 속도를 보였으며, x265 및 SVT-AV1 인코딩 속도는 각각 25%와 20% 더 빨랐습니다. Blender와 HandBrake는 저희 테스트 환경에 arm64 Linux 빌드가 없기 때문에 GB10의 결과는 포함되지 않았습니다.
Halo에 탑재된 16코어 Ryzen AI Max+ 395는 V20C와 이러한 테스트에서 비슷한 성능을 보였습니다. 모든 스레드를 사용하는 7-Zip 테스트에서 215.8 GIPS를 기록하며 8% 앞섰고, SVT-AV1 인코딩에서는 194.1fps로 V20C의 177.4fps보다 높은 성능을 보였습니다. 반면 Blender 테스트에서는 V20C가 6~22%, x265 테스트에서는 11.5%, LLVM 빌드 테스트에서는 136초로 V20C의 149초보다 빠른 속도를 기록했습니다.
LLVM 빌드는 V20C에서 136초 만에 완료되었는데, 이는 Dell Pro Max Micro의 173초, GB10의 175초와 비교됩니다. 개발자 워크스테이션에 가장 중요한 결과입니다. 싱글 스레드 7-Zip 테스트에서는 차이가 크지 않았는데, V20C가 Core Ultra 9 285보다 3%, GB10보다 16% 앞섰습니다. Dell 프로세서의 코어 수는 동일하므로, 멀티 스레드 성능 차이는 타워형 PC의 전력 효율과 냉각 성능 차이에서 비롯된 것으로 보입니다.

Stockfish, primesieve, Python 및 브라우저
| Test | Corsair FlexPrime V20C (Ultra 7 270K Plus, Arc Pro B70 32GB) | 델 프로 맥스 마이크로 (울트라 9 285, RTX PRO 4000 SFF 24GB) | Dell Pro Max GB10(128GB 통합) | AMD 라이젠 AI 헤일로(라이젠 AI 맥스+ 395, 128GB 통합) |
|---|---|---|---|---|
| 말린 대구, 한 가닥 (Mnps) | 2.08 | 2.02 | 1.66 | 2.15 |
| 스톡피쉬, 모든 스레드(Mnps) | 40.55 | 31.58 | 23.86 | 38.74 |
| 10^12까지의 소수체, 모든 스레드 (s, 값이 낮을수록 좋음) | 6.48 | 8.72 | 9.16 | 6.29 |
| 10^11까지의 소수체, 스레드 1개 (s, 값이 낮을수록 좋음) | 9.03 | 9.07 | 12.32 | 6.76 |
| PyPerformance go (ms, 낮을수록 좋음) | 56.0 | 57.8 | 85.5 | 69.1 |
| PyPerformance nbody (ms, 낮을수록 좋음) | 36.3 | 38.9 | 55.0 | 43.1 |
| 속도계 3.1 (점수) | 51.8 | 실행되지 않음 | 37.2 | 38.7 |
V20C는 올스레드 Stockfish 테스트에서 40.55 Mnps를 기록하며 Dell Pro Max Micro보다 28%, GB10보다 70% 앞섰습니다. 10^12까지의 primesieve 테스트는 V20C가 6.48초 만에 완료했는데, 이는 Dell Pro Max Micro의 8.72초, GB10의 9.16초보다 빠른 기록입니다. 두 Intel 시스템의 단일 스레드 테스트 결과는 Stockfish에서 3% 이내의 차이를 보였고, primesieve에서는 거의 동일했습니다. V20C는 Speedometer 3.1에서 51.8점을 기록하며 GB10의 37.2점보다 높았고, PyPerformance 응답 시간은 V20C가 56.0ms로 Arm 시스템의 85.5ms보다 빨랐습니다. Halo는 올스레드 Stockfish 테스트에서 38.74 Mnps로 V20C에 근접한 성능을 보였고, primesieve 테스트는 6.29초 만에 완료했으며, Speedometer에서는 38.7점을 기록했습니다.
GROMACS 및 OpenBLAS
| Test | Corsair FlexPrime V20C (Ultra 7 270K Plus, Arc Pro B70 32GB) | 델 프로 맥스 마이크로 (울트라 9 285, RTX PRO 4000 SFF 24GB) | Dell Pro Max GB10(128GB 통합) | AMD 라이젠 AI 헤일로(라이젠 AI 맥스+ 395, 128GB 통합) |
|---|---|---|---|---|
| GROMACS benchMEM, 16개 코어 (ns/일) | 67.23 | 52.68 | 27.81 | 72.39 |
| GROMACS benchMEM, 모든 코어(ns/일) | 77.77 | 55.52 | 34.61 | 70.95 |
| OpenBLAS DGEMM, 모든 코어(GFLOPS) | 1,100.0 | 791.6 | 418.0 | 1,610.3 |
| OpenBLAS LU는 N=20000, 모든 코어(GFLOPS)를 해결합니다. | 938.6 | 717.0 | 393.0 | 1391.3 |
| 메모리 지연 시간, 4KiB 페이지(ns, 낮을수록 좋음) | 105.2 | 129.0 | 123.8 | 162.2 |
GROMACS benchMEM은 16코어에서 67.23ns/일, 24코어 모두에서 77.77ns/일을 기록했는데, 이는 Dell Pro Max Micro보다 각각 28%와 40% 빠른 수치이며, GB10의 27.81ns/일과 34.61ns/일보다 두 배 이상 빠른 속도입니다. OpenBLAS DGEMM은 모든 코어에서 1,100.0GFLOPS를 달성했는데, 이는 기존의 791.6GFLOPS와 418.0GFLOPS에서 크게 향상된 수치입니다. LU 연산(N=20000)은 938.6GFLOPS를 기록했습니다. 4KiB 페이지에서의 메모리 지연 시간은 V20C의 DDR5-6400에서 105.2ns로 측정되어 그룹 내에서 가장 낮았습니다.
Halo는 16코어 GROMACS 테스트에서 72.39ns/일, OpenBLAS DGEMM 테스트에서 1,610.3GFLOPS를 기록하며 V20C보다 각각 8%와 46% 앞섰고, LU 해석에서는 1,391.3GFLOPS를 달성했습니다. 모든 스레드를 사용한 GROMACS 테스트에서는 V20C가 77.77ns/일로 70.95ns/일의 Halo보다 여전히 앞섰습니다.

서버 및 HPC 워크로드
이 결과는 Linux에서만 실행되는 당사의 벤치마크 도구 및 서버 제품군에서 얻은 것입니다. 이 도구들은 V20C를 일반적인 컴퓨팅 노드로 측정하며, 컴파일, 압축, 웹 및 캐시 요청 처리, 분석 쿼리 실행, CFD 사례 해결 등의 작업을 수행합니다. 각 시스템은 서로 다른 Linux 배포판과 컴파일러를 사용하기 때문에 Ubuntu 26.04.1을 공유하는 V20C와 Dell Pro Max Micro가 가장 긴밀한 비교 대상이 됩니다.
| Phoronix Test Suite 및 y-cruncher (별도로 명시되지 않은 경우, 수치가 높을수록 좋습니다) | Corsair FlexPrime V20C (Ultra 7 270K Plus, Arc Pro B70 32GB) | 델 프로 맥스 마이크로 (울트라 9 285, RTX PRO 4000 SFF 24GB) | Dell Pro Max GB10(128GB 통합) | AMD 라이젠 AI 헤일로(라이젠 AI 맥스+ 395, 128GB 통합) |
|---|---|---|---|---|
| 리눅스 커널 컴파일 시간, allmodconfig (초, 낮을수록 좋음) | 639 | 918 | 892 | 727 |
| 7-Zip 압축 등급, 모든 스레드(MIPS) | 186,668 | 150,543 | 154,634 | 178,530 |
| 7-Zip 감압 등급, 모든 나사산(MIPS) | 128,723 | 88,641 | 106,148 | 143,464 |
| 7-Zip 압축 등급, 단일 스레드(MIPS) | 10,260 | 9,351 | 7,474 | 8,019 |
| OpenSSL AES-256-GCM, 모든 스레드 (GB/s) | 171.4 | 110.0 | 97.1 | 298.6 |
| nginx, 1,000 연결(요청/초) | 225,708 | 155,203 | 114,909 | 223,433 |
| nginx, 4,000 연결(요청/초) | 155,146 | 109,352 | 101,613 | 190,454 |
| y-cruncher Pi, 1억 자리 (초, 숫자가 낮을수록 좋음) | 17.54 | 30.10 | 실행되지 않음 | 10.46 |
| y-cruncher Pi, 5억 자리 (초, 숫자가 낮을수록 좋음) | 111.17 | 158.24 | 실행되지 않음 | 63.45 |
| y-cruncher Pi, 10억 자리 (초, 숫자가 낮을수록 좋음) | 244.44 | 342.87 | 실행되지 않음 | 135.18 |
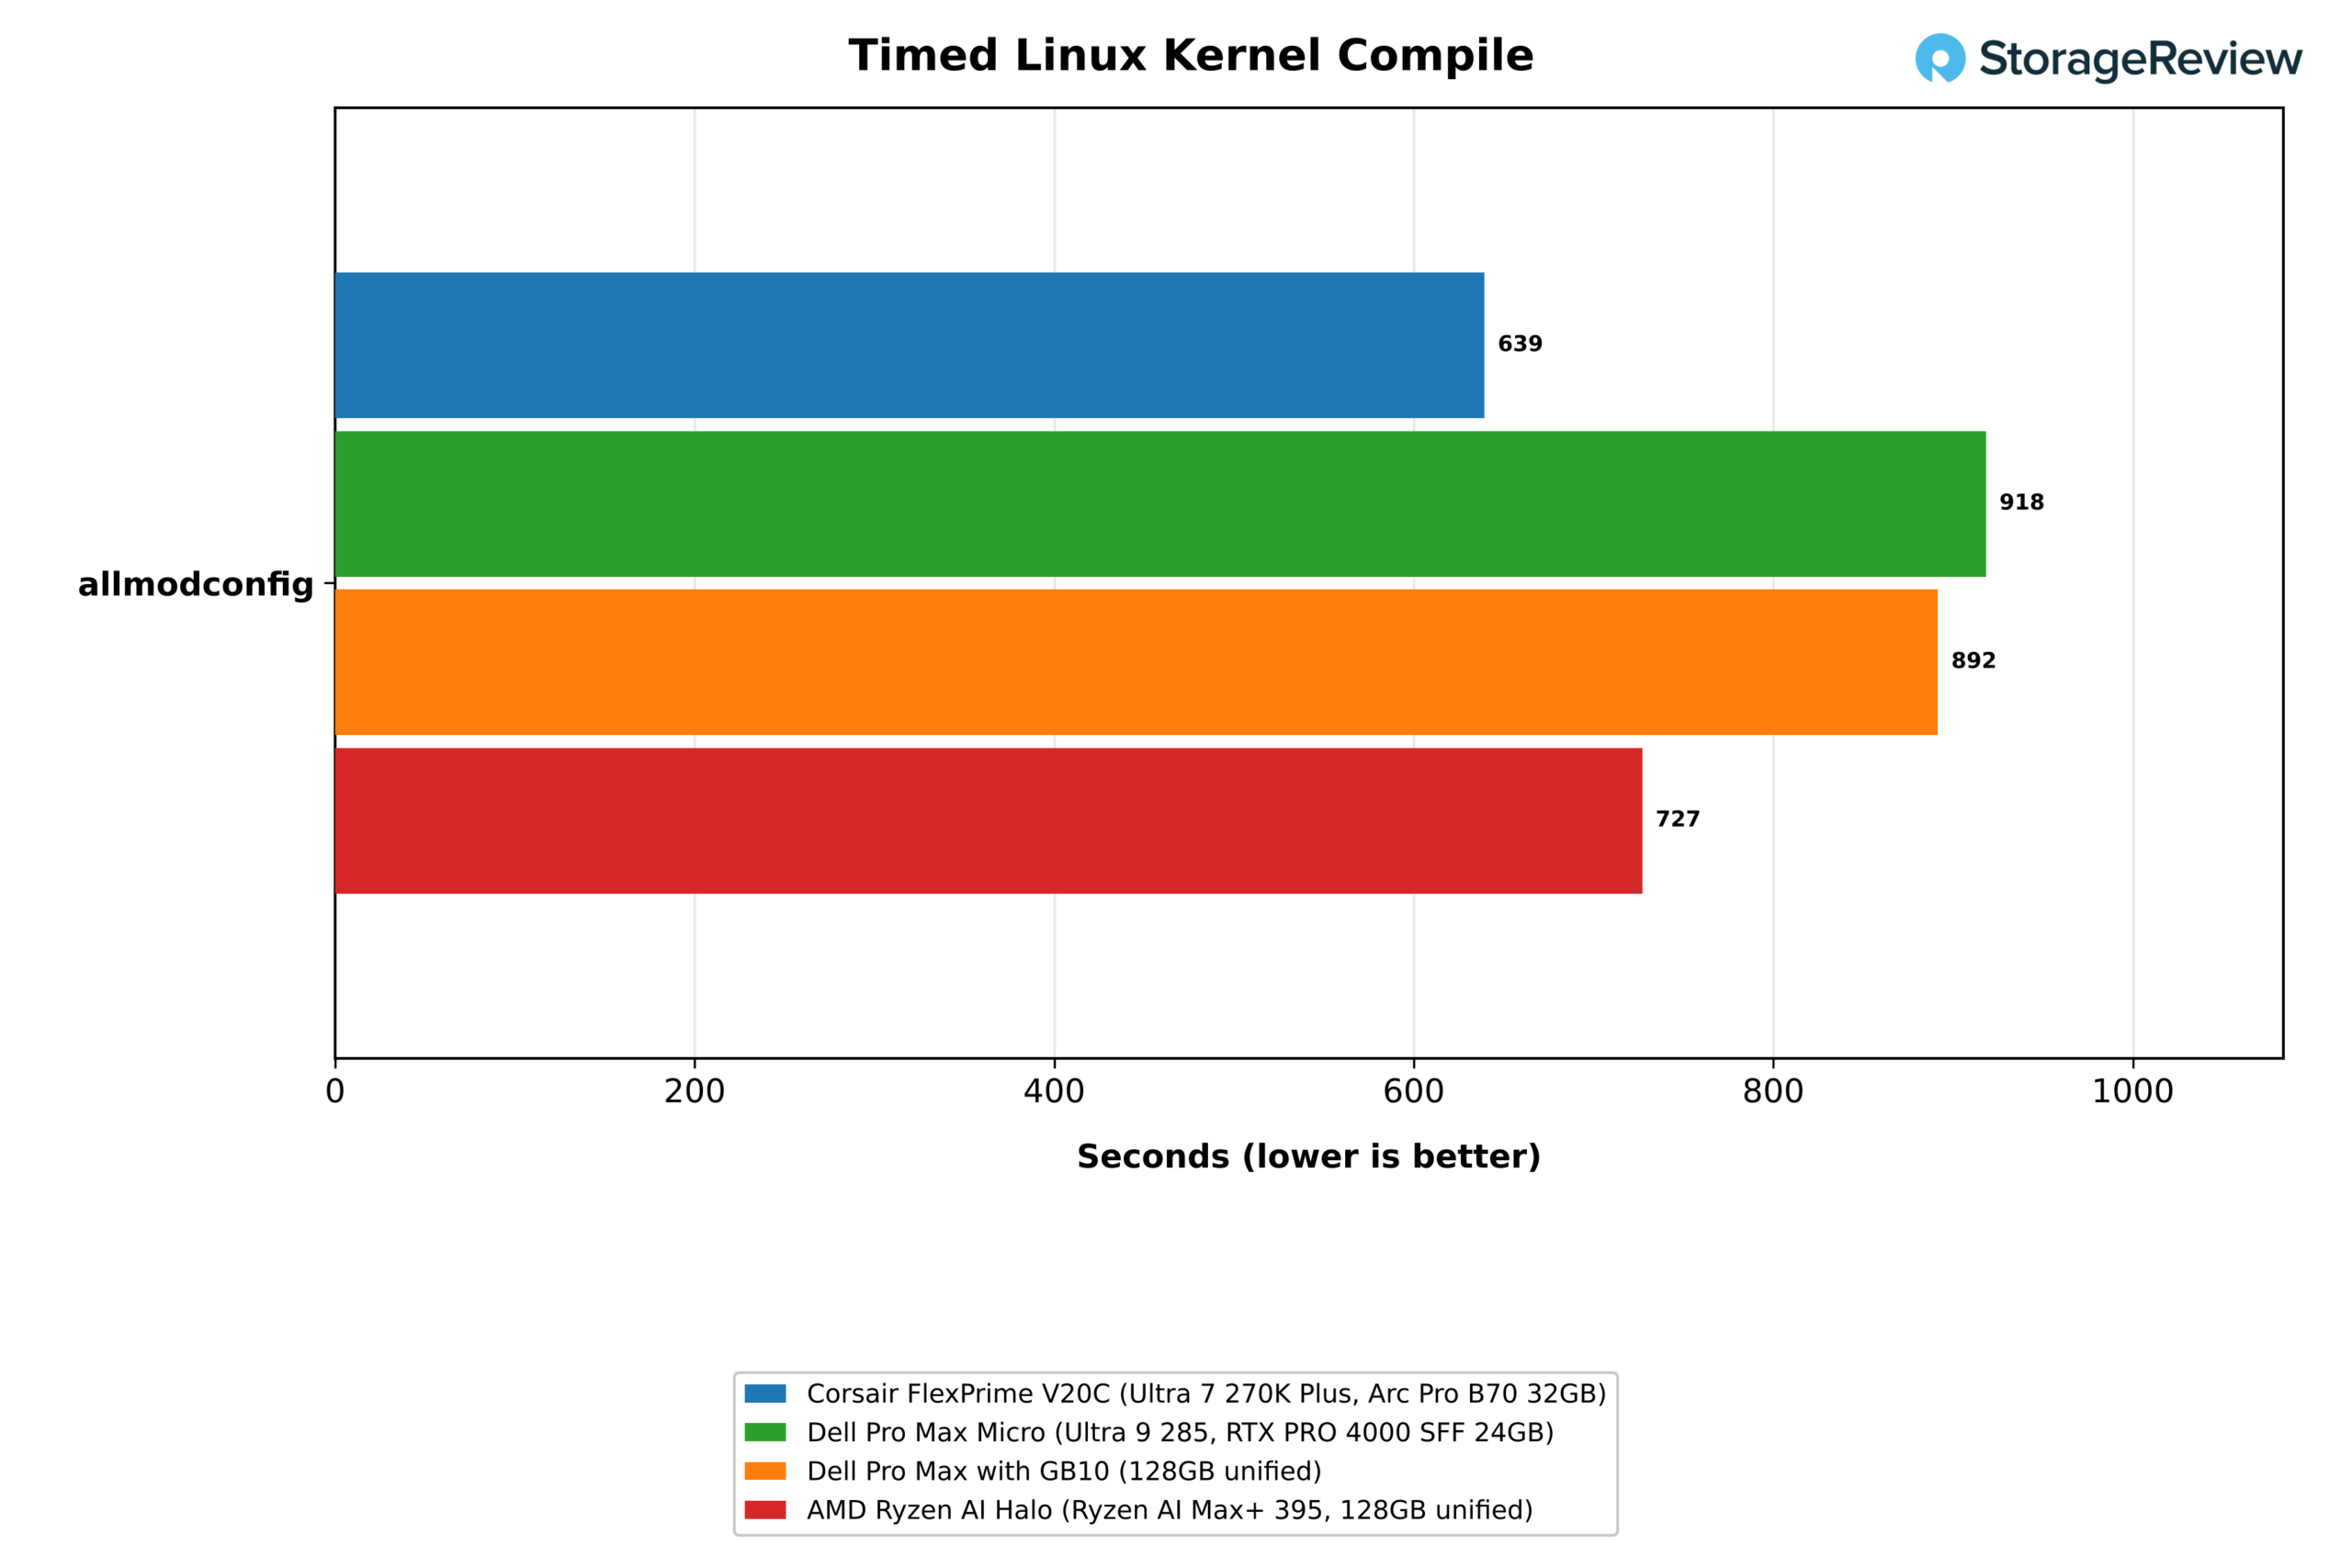
V20C는 리눅스 커널 컴파일에 639초가 걸렸는데, 이는 Dell Pro Max Micro의 918초, GB10의 892초보다 빠른 기록입니다. 또한 7-Zip, OpenSSL, nginx 실행에서는 두 제품 모두보다 우수한 성능을 보였습니다. Halo는 16개의 코어를 탑재했음에도 불구하고 예상보다 훨씬 더 근접한 성능을 보여주었습니다. 커널 컴파일에는 727초가 걸렸고, nginx 실행에서는 1,000개 연결에서는 V20C와 동일한 성능을 보였으며, 4,000개 연결에서는 23% 더 빠른 속도를 기록했습니다. OpenSSL AES-256-GCM 실행 속도는 298.6GB/s로 V20C의 171.4GB/s보다 빨랐습니다. 모든 스레드를 사용한 7-Zip 실행에서는 압축 속도에서 V20C보다 4% 뒤처졌지만, 압축 해제 속도에서는 11% 앞섰습니다. 반면 단일 스레드 압축에서는 V20C가 28% 더 빠른 속도를 보였습니다.
y-cruncher 테스트에서 Halo는 파이(π)의 50억 자리 숫자를 계산하는 데 63.45초가 걸렸는데, 이는 V20C의 111.17초, Dell Pro Max Micro의 158.24초와 비교됩니다. 100억 자리 숫자에서는 Halo가 135.18초, Dell Pro Max Micro가 244.44초가 걸려 성능 차이가 더욱 벌어졌습니다. 이 테스트는 메모리 대역폭과 벡터 폭에 민감한데, Halo는 AVX-512 코덱과 더 넓은 메모리 버스를 제공하는 반면, V20C는 DDR5 메모리 두 채널을 사용합니다. GB10은 y-cruncher 테스트를 실행하지 않았기 때문에 해당 행의 결과는 없습니다.

| 서버 제품군 (별도 표기가 없는 한, 등급이 높을수록 좋습니다) | Corsair FlexPrime V20C (Ultra 7 270K Plus, Arc Pro B70 32GB) | 델 프로 맥스 마이크로 (울트라 9 285, RTX PRO 4000 SFF 24GB) | Dell Pro Max GB10(128GB 통합) | AMD 라이젠 AI 헤일로(라이젠 AI 맥스+ 395, 128GB 통합) |
|---|---|---|---|---|
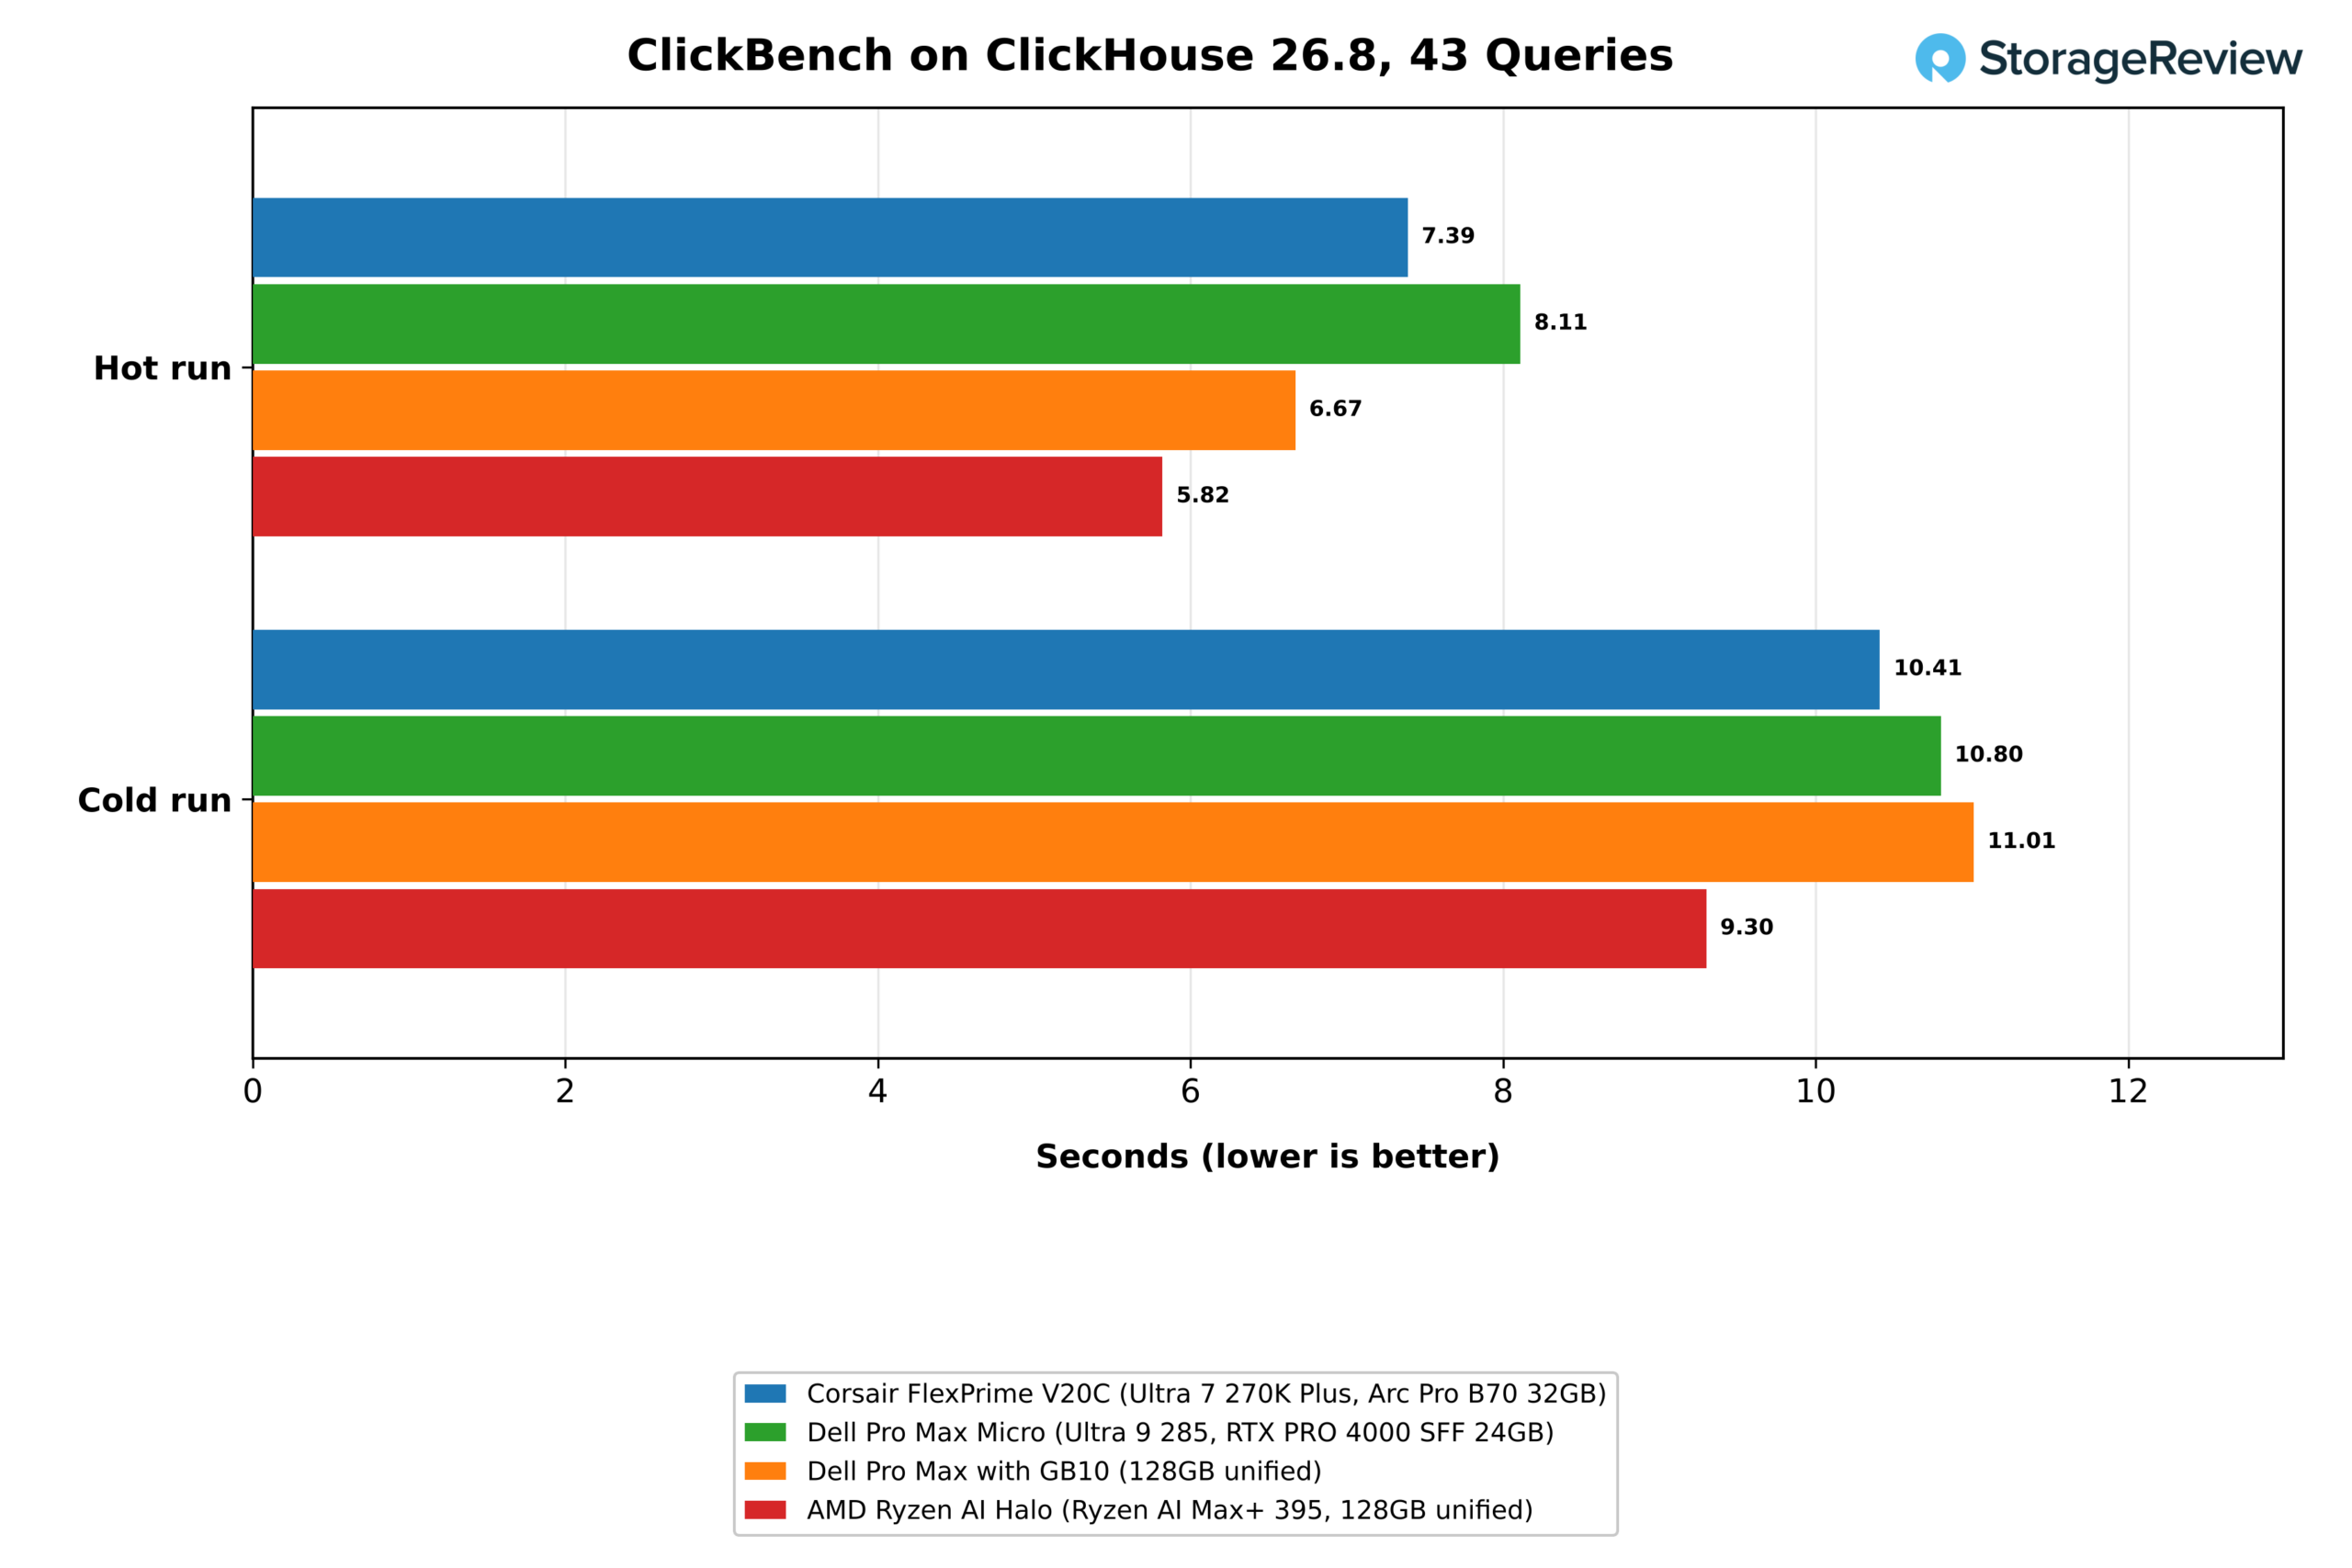
| ClickBench 핫런, 43개 쿼리 (초, 낮을수록 좋음) | 7.39 | 8.11 | 6.67 | 5.82 |
| ClickBench 콜드런, 43개 쿼리 (초, 수치가 낮을수록 좋음) | 10.41 | 10.80 | 11.01 | 9.30 |
| OpenFOAM 드라이버, 3M 셀, 해결 시간(초, 낮을수록 좋음) | 1,636 | 2,320 | 1,222 | 1,148 |
| 스트림 트라이어드(MB/s) | 68,252 | 65,802 | 121,313 | 114,007 |
| Valkey 캐시, SET(요청/초) | 1,852,556 | 1,389,084 | 810,246 | 1,211,538 |
| Valkey 캐시, GET (초당 요청 수) | 1,866,031 | 1,398,409 | 884,644 | 1,271,481 |
메모리 대역폭이 서버 성능 평가 결과의 대부분을 설명합니다. STREAM Triad 테스트에서 V20C는 두 개의 DDR5 채널에서 68GB/s를 기록한 반면, GB10은 121GB/s, Halo는 114GB/s를 기록했습니다. 300만 개의 셀을 사용하는 OpenFOAM drivAer 케이스 테스트는 V20C에서 1,636초, GB10에서 1,222초, Halo에서 1,148초가 걸렸습니다. ClickBench 핫런 테스트는 V20C가 7.39초, GB10이 6.67초, Halo가 5.82초가 소요되었습니다. Dell Pro Max Micro는 OpenFOAM 테스트에서 V20C보다 42%, ClickBench 테스트에서 10% 더 오래 걸렸습니다.
V20C의 더 빠른 코어는 Valkey 캐시 프로파일에서 우위를 점하게 하여 초당 1.85만 건의 SET 요청과 1.87만 건의 GET 요청을 처리했습니다. 이는 Dell Pro Max Micro보다 33% 높은 수치이며, GB10의 초당 81만 건의 SET 요청과 88만 5천 건의 GET 요청보다 두 배 이상 빠른 속도입니다. Halo는 초당 1.21만 건의 SET 요청과 1.27만 건의 GET 요청을 처리했는데, 이는 V20C 속도의 약 3분의 2 수준입니다. 모델 서버 외에 벡터 스토리지, 캐시 또는 소규모 데이터베이스를 함께 사용하는 워크스테이션은 코어당 속도가 매우 중요한데, 270K Plus는 대부분의 코어별 테스트에서 이러한 제품군 중 가장 우수한 성능을 보여주었습니다.

그래픽 및 GPU 인코딩
| SuperTuxKart 1.5 및 FFmpeg (버전이 높을수록 좋습니다) | Corsair FlexPrime V20C (Ultra 7 270K Plus, Arc Pro B70 32GB) | 델 프로 맥스 마이크로 (울트라 9 285, RTX PRO 4000 SFF 24GB) | Dell Pro Max GB10(128GB 통합) | AMD 라이젠 AI 헤일로(라이젠 AI 맥스+ 395, 128GB 통합) |
|---|---|---|---|---|
| SuperTuxKart 1080p, 평균 FPS | 345.7 | 실행되지 않음 | 277.1 | 274.7 |
| SuperTuxKart 1080p, 안정적인 FPS | 249 | 실행되지 않음 | 195 | 166 |
| SuperTuxKart 4K, 평균 FPS | 174.0 | 실행되지 않음 | 실행되지 않음 | 90.8 |
| SuperTuxKart 4K, 안정적인 FPS | 137 | 실행되지 않음 | 실행되지 않음 | 66 |
| FFmpeg 8.1 하드웨어 HEVC 인코딩(fps) | 154 (빠른 동기화) | 123 (NVENC) | 134 (NVENC) | 204 (VAAPI) |
SuperTuxKart 최고 설정으로 테스트한 결과, V20C는 Mesa의 OpenGL 드라이버를 사용하여 1080p 해상도에서 평균 345.7fps, 4K 해상도에서 평균 174.0fps를 기록했습니다. GB10은 1080p 해상도에서 평균 277.1fps를 기록하여 Arc Pro B70이 25% 앞섰습니다. Dell Pro Max Micro에서는 테스트가 실행되지 않았습니다. GB10은 디스플레이 해상도가 1080p로 제한되어 있어 4K 테스트 결과는 얻을 수 없었습니다. Halo 테스트에서는 1080p 해상도에서 평균 274.7fps, 4K 해상도에서 평균 90.8fps를 기록했는데, 이는 V20C의 4K 프레임률의 약 절반 수준입니다.
GPU 인코딩의 경우, FFmpeg 8.1(HEVC Quick Sync 사용)은 테스트 스위트의 4K Big Buck Bunny 클립에서 154fps로 실행되었고, VAAPI 경로는 152fps로 실행되었습니다. NVIDIA 시스템은 다른 인코더 설정을 사용하는 NVENC를 사용하므로 123fps와 134fps는 참고용으로 표시된 것이며 세 가지 인코더의 순위를 나타내는 것은 아닙니다. Halo의 Radeon은 FFmpeg의 VAAPI 경로를 204fps로 실행했습니다. 두 Intel 인코딩 경로는 첫 번째 실행에서는 초기화에 실패했지만 두 번째 실행에서는 성공했습니다.
부하 시 열 관리
| Corsair FlexPrime V20C | CPU 최대치(섭씨) | CPU 평균(C) | GPU 최대치(C) | GPU 평균(C) |
|---|---|---|---|---|
| 7 - 우편 번호 | 91 | 67.8 | 50 | 47.5 |
| 믹서기 | 88 | 77.7 | 50 | 49.2 |
| LLVM 빌드 | 88 | 77.8 | 48 | 48.0 |
| GROMACS | 97 | 77.5 | 48 | 48.0 |
| MLPerf 클라이언트 | 69 | 41.6 | 72 | 62.7 |
| 코딩 에이전트 | 66 | 43.1 | 74 | 71.5 |
| LLM 과정 제공 | 68 | 46.1 | 84 | 80.1 |
| 대규모 RAG | 81 | 49.4 | 80 | 78.5 |
| 이미지 생성 | 89 | 43.8 | 82 | 76.5 |
| 슈퍼턱스카트 | 61 | 44.1 | 76 | 70.6 |
수랭 쿨러 덕분에 270K Plus는 대부분의 모든 코어 테스트에서 최고 온도를 88°C에서 91°C 사이로 유지했으며, Blender, LLVM 빌드 및 GROMACS 테스트 시 평균 온도는 70°C 후반대를 기록했습니다. GROMACS 테스트에서만 97°C로 가장 높은 온도를 보였습니다. CPU는 테스트 사이 유휴 상태에서 37°C에서 38°C를 유지했으며, MLPerf Client, LLM Serving 및 백만 건의 패스를 처리하는 RAG 실행과 같은 GPU 작업 중에는 평균 42°C에서 49°C를 기록했습니다.
Arc Pro B70은 유휴 상태에서 약 48°C를 유지했으며, LLM 서비스 실행 중 최고 84°C까지 올라가 26분간의 테스트 동안 평균 80.1°C를 기록했습니다. 이미지 생성 및 대용량 RAG 데이터 수집 시에는 각각 82°C와 80°C를 유지했습니다. 이러한 지속적인 GPU 부하 시에는 안정적인 공기 흐름이 가장 중요하므로 앞서 언급한 불규칙적인 팬 속도 조절 문제를 해결해야 합니다.
스토리지 성능
| fio, 25GiB 용량 (용량이 클수록 좋음) | Corsair FlexPrime V20C (Ultra 7 270K Plus, Arc Pro B70 32GB) | 델 프로 맥스 마이크로 (울트라 9 285, RTX PRO 4000 SFF 24GB) | Dell Pro Max GB10(128GB 통합) | AMD 라이젠 AI 헤일로(라이젠 AI 맥스+ 395, 128GB 통합) |
|---|---|---|---|---|
| 순차 읽기 속도 128K(MB/s) | 7,311 | 9,433 | 6,947 | 7,232 |
| 순차 쓰기 속도 128K(MB/s) | 6,082 | 6,766 | 6,310 | 1,554 * |
| 랜덤 읽기 4K, 최대 (IOPS) | 1,184,970 | 2,084,437 | 932,210 | 1,197,992 |
| 랜덤 쓰기 4K, 최대 (IOPS) | 184,231 | 1,028,079 * | 997,758 | 121,285 * |
| 랜덤 읽기 4K, QD32 x 4 작업(IOPS) | 1,184,970 | 1,386,889 | 754,896 | 1,001,941 |
| 랜덤 쓰기 4K, QD32 x 4 작업(IOPS) | 178,312 | 1,028,079 * | 946,264 | 121,285 * |
*재실행 후 실행 간 편차가 발생하여 해당 검사 도구에서 플래그가 지정되었습니다.
본 테스트 장치에 탑재된 1TB XPG MARS 970 PLUS는 PCIe Gen5 x4로 연결되며, 순차 작업에서는 빠른 Gen4 드라이브와 유사한 성능을 보여줍니다. 25GiB 용량에서 읽기 속도는 7,311MB/s, 쓰기 속도는 6,082MB/s를 기록했는데, 이는 GB10에 탑재된 Gen4 드라이브의 6,947MB/s 및 6,310MB/s와 비슷한 수준입니다. Dell Pro Max Micro에 탑재된 Gen5 Sandisk 드라이브는 읽기 속도가 9,433MB/s였습니다. V20C의 최대 4K 랜덤 읽기 IOPS는 1.18만 IOPS에 달하여 GB10보다 우수하고 Dell의 2.08만 IOPS의 절반을 약간 웃도는 수준입니다. Halo에 탑재된 Micron 4600은 읽기 속도 7,232MB/s, 랜덤 읽기 IOPS 1.20만 IOPS를 기록했는데, 이는 V20C와 동일한 수준입니다.
랜덤 쓰기 성능은 이 드라이브의 약점으로, 25GiB 용량에서는 최대 184 IOPS, 5GiB 용량에서는 최대 350 IOPS를 기록했으며, 두 테스트 모두 3% 이내의 오차 범위를 보였습니다. 반면 두 대의 Dell 시스템은 약 1.0만 IOPS의 쓰기 성능을 보였고, Halo 드라이브는 최대 121 IOPS를 기록하며 편차 플래그가 표시되었습니다. 또한, 이 드라이브는 99분간의 스토리지 테스트 동안 최고 80.8°C, 평균 75.3°C의 발열 문제를 나타냈습니다.
Corsair의 구성 도구에는 V20 섀시용 2TB 및 4TB 옵션이 나와 있으며, 부팅 드라이브에 데이터 세트나 벡터 인덱스를 저장할 계획이라면 4TB 옵션을 예산에 포함시키는 것이 좋습니다. 드라이브는 그래픽 카드와 CPU 블록 사이의 M.2 슬롯에 장착되며, XPG의 방열판이 사용되지만 마더보드 방열판은 없습니다.


맺음말
Corsair FlexPrime V20C 테스트 결과, Arc Pro B70 메인보드는 적절한 백엔드 소프트웨어를 사용할 경우 강력한 로컬 AI 워크스테이션을 구축할 수 있음을 보여줍니다. SYCL의 llama.cpp 테스트에서 Arc Pro B70은 Ministral 모델에서 RTX PRO 4000 SFF보다 5~30% 더 높은 성능을 보였고, 24GB 카드로는 로드할 수 없었던 27B 모델도 단일 사용자 기준으로 GB10보다 77% 높은 성능을 기록했습니다. 반면, 24코어 270K Plus는 컴파일, 렌더링, 캐시 처리 등 모든 테스트에서 가장 우수한 성능을 보였습니다.
32GB 시스템 메모리를 탑재한 V20C는 3,999.99달러로, 마이크로센터에서 AMD 라이젠 AI 헤일로와 동일한 가격대에 판매되고 있으며, 델 공식 웹사이트(Dell.com)에서 판매하는 128GB RAM, GB10 칩셋, 1TB SSD를 탑재한 Pro Max(7,521달러)보다 약 3,500달러 저렴합니다. 두 데스크톱 모두 128GB 통합 메모리를 탑재하여 V20C에서는 실행할 수 없는 에이전트 및 이미지 모델을 GB10으로 실행할 수 있으며, OpenFOAM 케이스 테스트도 더 빨리 완료했습니다. V20C는 32GB RAM을 사용하는 모델에서 더 빠른 llama.cpp 서버 실행 속도를 제공하는데, 이는 미니스트랄 모델에서 헤일로의 약 두 배에 달하는 속도이며, 부품 교체 및 유지보수가 용이한 타워형 디자인을 자랑합니다.
소프트웨어와 튜닝 부분에서 아쉬운 점이 눈에 띕니다. Ollama와 stable-diffusion.cpp는 Vulkan으로 다운그레이드되어 모든 세대 및 인제스트 테스트에서 NVIDIA 시스템보다 성능이 떨어졌습니다. 미세 조정 테스트에는 Intel 경로가 없었고, 테스트 도중 팬 속도가 불규칙적으로 증가했습니다. 1TB SSD는 랜덤 쓰기 속도가 느리고 최고 온도가 81°C에 달했습니다. Ollama.cpp 또는 OpenVINO를 통해 모델을 배포하고 강력한 x86 시스템을 원하는 개발자에게 이 구성이 적합합니다. Ollama, 이미지 생성 또는 32GB 이상의 모델을 사용하는 팀은 통합 메모리 데스크톱이나 Corsair의 NVIDIA 구성 제품을 고려해야 합니다.


 아마존