

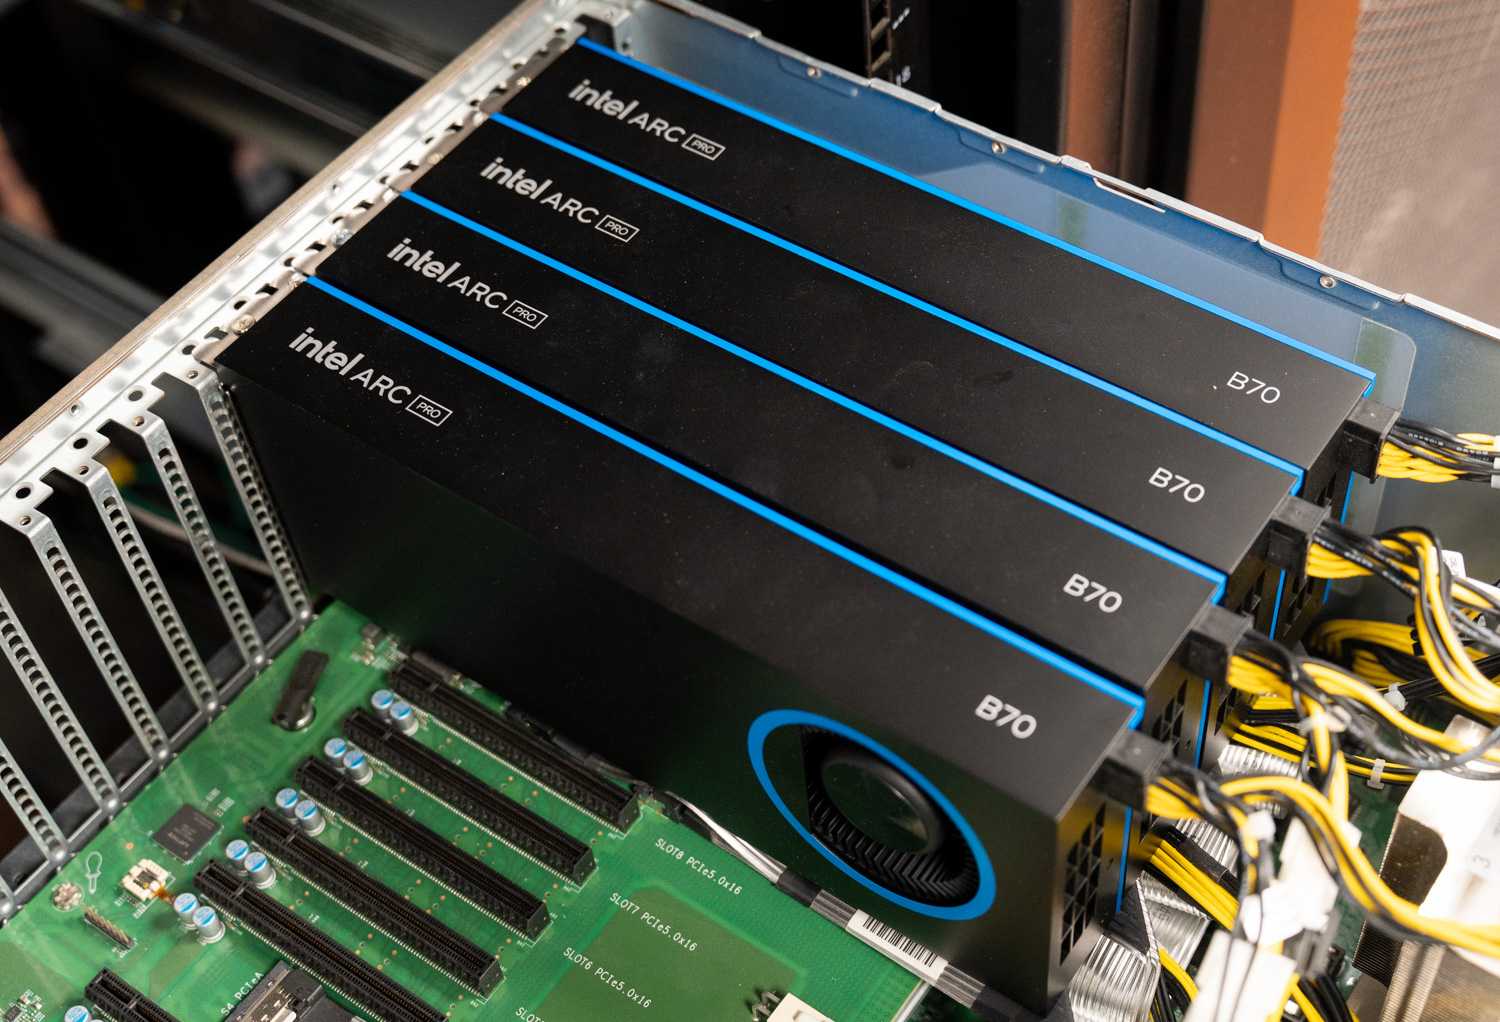
인텔 Arc Pro B70은 인텔이 출시한 데스크톱 AI 카드 중 가장 강력하고 유망한 제품이지만, 때로는 가장 실망스러운 제품이기도 합니다. 인텔은 올해 3월 출시 당시 32GB GDDR6 모델의 권장 소비자 가격을 949달러로 책정했습니다. 그러나 시장 전반을 휩쓴 메모리 부족 현상으로 인해 이 리뷰를 작성하는 시점에는 실제 판매 가격이 1,100달러를 넘어섰습니다. 그럼에도 불구하고 B70은 NVIDIA의 RTX Pro 4000보다 저렴합니다. RTX Pro 4000은 24GB의 VRAM을 제공하지만 B70보다 3분의 1 적은 용량을 제공하며, 가격은 2,000달러를 넘어섰습니다. 워크스테이션이나 서버 하나에 B70 4개를 장착하면 총 128GB의 VRAM을 구성할 수 있어, 기존에는 훨씬 더 많은 비용을 투자해야만 가능했던 1200억 개의 파라미터를 가진 다양한 전문가 혼합 모델을 동시에 실행할 수 있습니다. 하드웨어 성능도 인상적이지만, 가격은 더욱 놀랍습니다. 이 제품의 발목을 잡는 것은 작년 12월에 미리 살펴봤던 B60의 문제점과 동일합니다. 바로 소프트웨어가 아직 완벽하지 않다는 점입니다. 과연 인텔이 이 문제를 해결할 수 있을지 의문입니다.
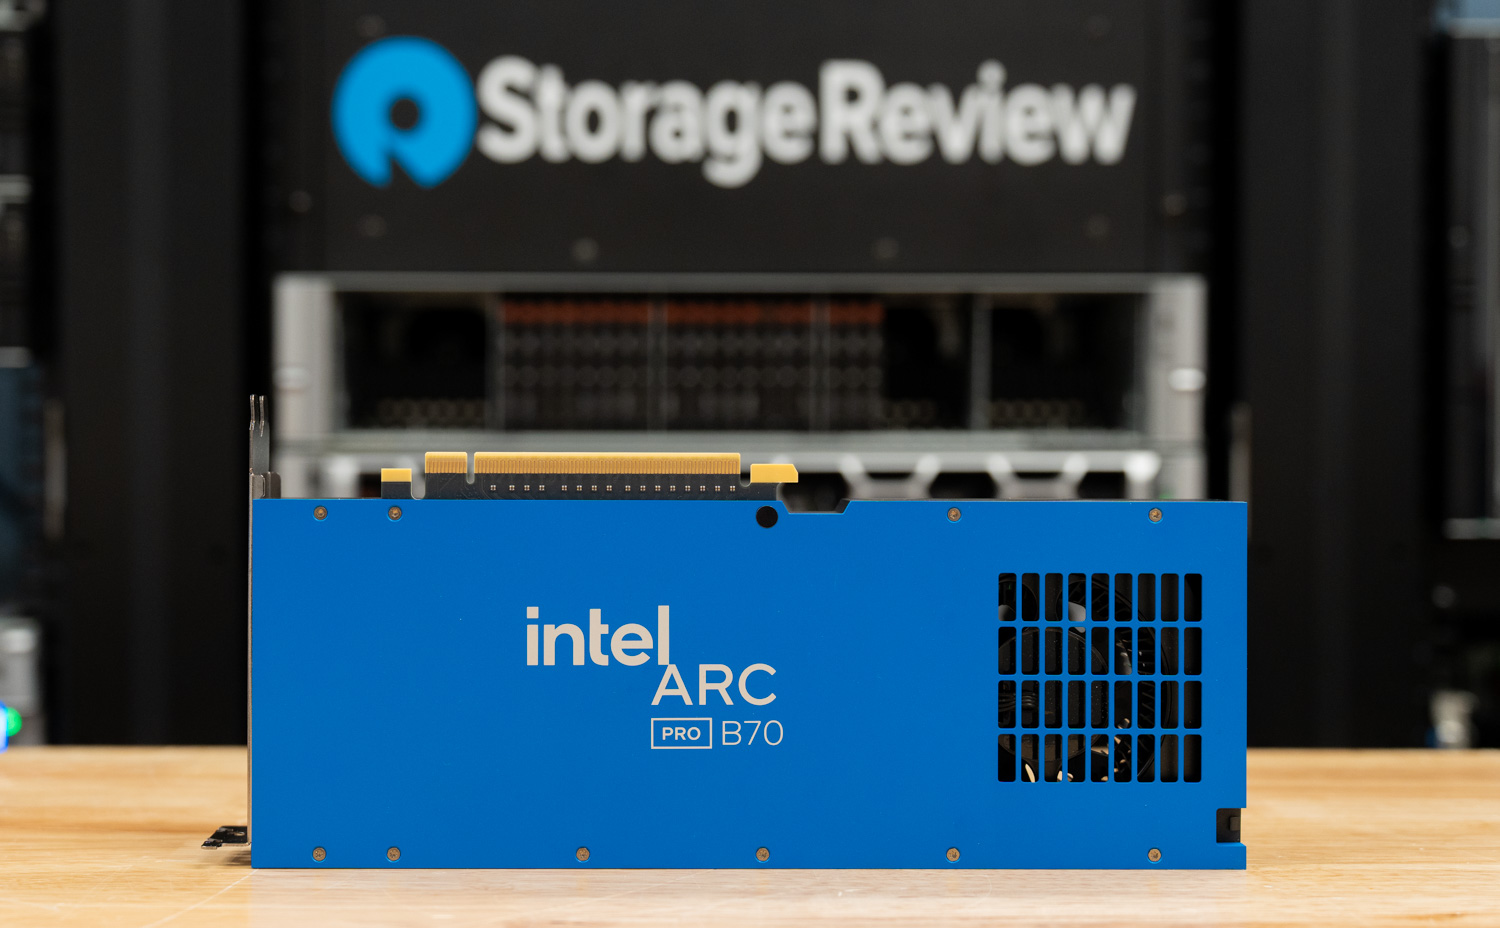
인텔과 함께라면 이런 경험을 여러 번 해봤습니다. Arc Pro B60 Battlematrix 를 살펴봤을 때 , 출시 전 준비 단계에서 뛰어난 실리콘 칩이 탑재되었다는 점이 주목되었는데, B70은 그 두 가지 특징을 모두 계승합니다. 이 카드는 32개의 Xe2 코어, 256개의 XMX 엔진, 그리고 367개의 INT8 TOPS를 갖춘 더 큰 BMG-G31 다이를 기반으로 제작되었습니다. 256비트 버스를 통해 608GB/s의 대역폭을 제공하며, 160W에서 290W까지 전력 소비를 조절할 수 있습니다. 인텔은 B60 대비 워크스테이션 작업 부하에서 평균 44%, 전문가용 애플리케이션에서는 최대 69%의 성능 향상을 B70에서 제공한다고 밝혔습니다. 설치 시 알아두어야 할 중요한 점은 B60이 슬롯 하나를 x8/x8로 분할하여 사용하는 듀얼 GPU 카드였던 반면, B70은 카드당 하나의 GPU만 사용하며 PCIe 5.0 x16 레인을 완전히 활용해야 한다는 것입니다. 따라서 4개 카드를 장착하는 섀시 구성 방식이 달라집니다.
인텔의 마케팅은 전적으로 로컬 추론에 초점을 맞추고 있으며, 비교 대상으로 NVIDIA의 RTX Pro 4000 24GB를 선택했습니다. 인텔 자체 Linux 테스트 결과에 따르면, B70의 32GB KV 캐시 토큰은 RTX Pro 4000의 42K보다 적은 약 93K의 KV 캐시 토큰을 메모리 부족 상태까지 저장할 수 있으며, 동시 접속 사용자 수가 증가함에 따라 토큰 처리량은 최대 85% 더 높고, 부하 시 첫 토큰 응답 시간은 최대 6.2배 빠르며, 가격 대비 토큰 수는 최대 2배 더 높습니다. 이 수치는 인텔이 BF16에서 소형 Llama 3.1 8B 시스템에서 단일 카드 기준으로 측정한 값이며, 실제 테스트에서는 B70의 성능을 더욱 극한으로 끌어올릴 예정입니다. 가격 대비 토큰 수에 대한 인텔의 주장은 출시 당시 가격을 기준으로 한 것이며, 현재 가격으로는 인텔이 더 유리하거나 그 격차가 더 벌어질 것으로 예상됩니다.
벤치마크 결과를 살펴보기 전에, 이 카드가 현재 어떤 사용자에게 적합한지 결정하는 중요한 요소인 장단점을 먼저 고려해야 합니다. 인텔의 LLM 스케일러(Battlemage를 지원하는 vLLM 개발 브랜치)는 저희 생각에는 아직 베타 버전에 가깝습니다. 지원 모델이 제한적이고, 작동해야 할 여러 양자화 경로가 아직 제대로 작동하지 않으며, 스택 자체가 하드웨어 성능을 제한합니다. 저희는 Dell PowerEdge XE7740에 탑재된 인텔 Gaudi 3 에서도 동일한 문제를 발견했습니다 . 당시 소프트 FP8 결과에서 문제가 발생한 것은 실리콘 자체의 문제가 아니라 인텔 vLLM 포크의 미성숙한 코드 경로 때문이었습니다. B70 역시 같은 상황에 놓여 있습니다. 인텔은 이 부분에 대해 더욱 적극적인 결정을 내리고 지금까지보다 더 확고한 입장을 취해야 합니다.
NVIDIA의 경쟁력은 단순히 CUDA에만 있는 것이 아닙니다. 모델 배포 시 중요한 요소들, 즉 문서, 예제, 제대로 작동하는 컨테이너, 포럼 답변, 그리고 대부분의 문제가 해결된 충분한 커뮤니티 이력 등이 핵심입니다. AMD 역시 ROCm을 같은 방향으로 추진해 왔습니다. 인텔도 Arc Pro에 대해 이와 같은 수준의 노력을 기울여야 합니다. 그렇지 않으면 B70은 마니아들이 좋아하지만 실제 팀에서는 도입하기 어려운 카드가 될 위험이 있습니다.
이번 리뷰에서는 B60 테스트와 동일한 플랫폼을 사용하여 공정한 비교를 진행했습니다. Supermicro AS-4125GS-TNRT 메인보드에 AMD EPYC 9374F 프로세서와 512GB DDR5 메모리를 장착하고, vLLM 환경에서 B70(128GB) 4개와 B60(96GB) 4개를 비교 테스트했습니다. B60 테스트와 마찬가지로, 이번 비교는 인텔의 인텔 전용 Battlematrix 레퍼런스 시스템(Xeon 6 호스트와 카드들을 조합한 환경)을 사용한 것이 아닙니다. 인텔 칩셋을 사용하는 실제 생산 시스템에서는 동작 방식이 다를 수 있습니다. 따라서 아래 내용은 동일한 벤치마크 환경에서 세대별 성능과 가치를 비교한 것이며, 소프트웨어 완성도에 따라 결과가 달라질 수 있음을 감안해 주시기 바랍니다.
인텔 Arc Pro B70 사양
| 스펙 | 인텔 아크 프로 B70 |
|---|---|
| 일반 | |
| 제품군 | 인텔 아크 프로 B 시리즈 그래픽 |
| 모델 | 인텔 아크 프로 B70 |
| 코드 네임 | 전투 마법사 |
| 마이크로 아키텍처 | Xe2 |
| 공정 기술 | TSMC N5 |
| 출시일 | Q1 2026 |
| 품질 보증 | 3 년 |
| GPU 사양 | |
| Xe-코어 | 32 |
| 렌더 슬라이스 | 8 |
| 광선 추적 장치 | 32 |
| 인텔 XMX 엔진 | 256 |
| Xe 벡터 엔진 | 256 |
| 그래픽 시계 | 2280 MHz |
| 최대 동적 클록 | 2800 MHz |
| FP32 성능 | 22.94 TFLOPS |
| INT8 AI 성능 | 367 상단 |
| 총 보드 전력(TBP) | 230W (설정 가능: 160~290W) |
| PCI 익스프레스 인터페이스 | PCIe 5.0 x16 |
| 메모리 | |
| 메모리 용량 | 32GB GDDR6 |
| 메모리 버스 | 256-bit |
| 메모리 대역폭 | 608 GB / 초 |
| ECC 메모리 | 지원 |
| 디스플레이 및 입출력 | |
| 디스플레이 출력 | DisplayPort 2.1 |
| 최대 디스플레이 | 4 |
| 최대 해상도 | 7680 × 4320 @ 120Hz (HDMI / DisplayPort) |
| 가변 재생률 | HDMI VRR, VESA 어댑티브 싱크 |
| 기능 및 소프트웨어 | |
| 비디오 인코딩/디코딩 | H.264, H.265 (HEVC), AV1 |
| 광선 추적 | 지원 |
| AI 프레임워크 | oneAPI, OpenVINO, Intel PyTorch 확장 프로그램(IPEX) |
| 그래픽 API | DirectX 12 Ultimate, Vulkan 1.3, OpenGL 4.6, OpenCL 3.0 |
| 인텔 XeSS | 지원 |
| HDR 지원 | HDR10, HDR10+ 게임, 돌비 비전 |
| 다중 형식 코덱 엔진 | 2 |
| 물리적 사양 | |
| 크기 | 10.5 × 3.9 인치 |
| 슬롯 너비 | 듀얼 슬롯 |
| 중량(평량) | 1020g |
| 전원 커넥터 | 1 × 8핀 (ATX 2×4) |
Intel Arc Pro B70 조립 및 설계
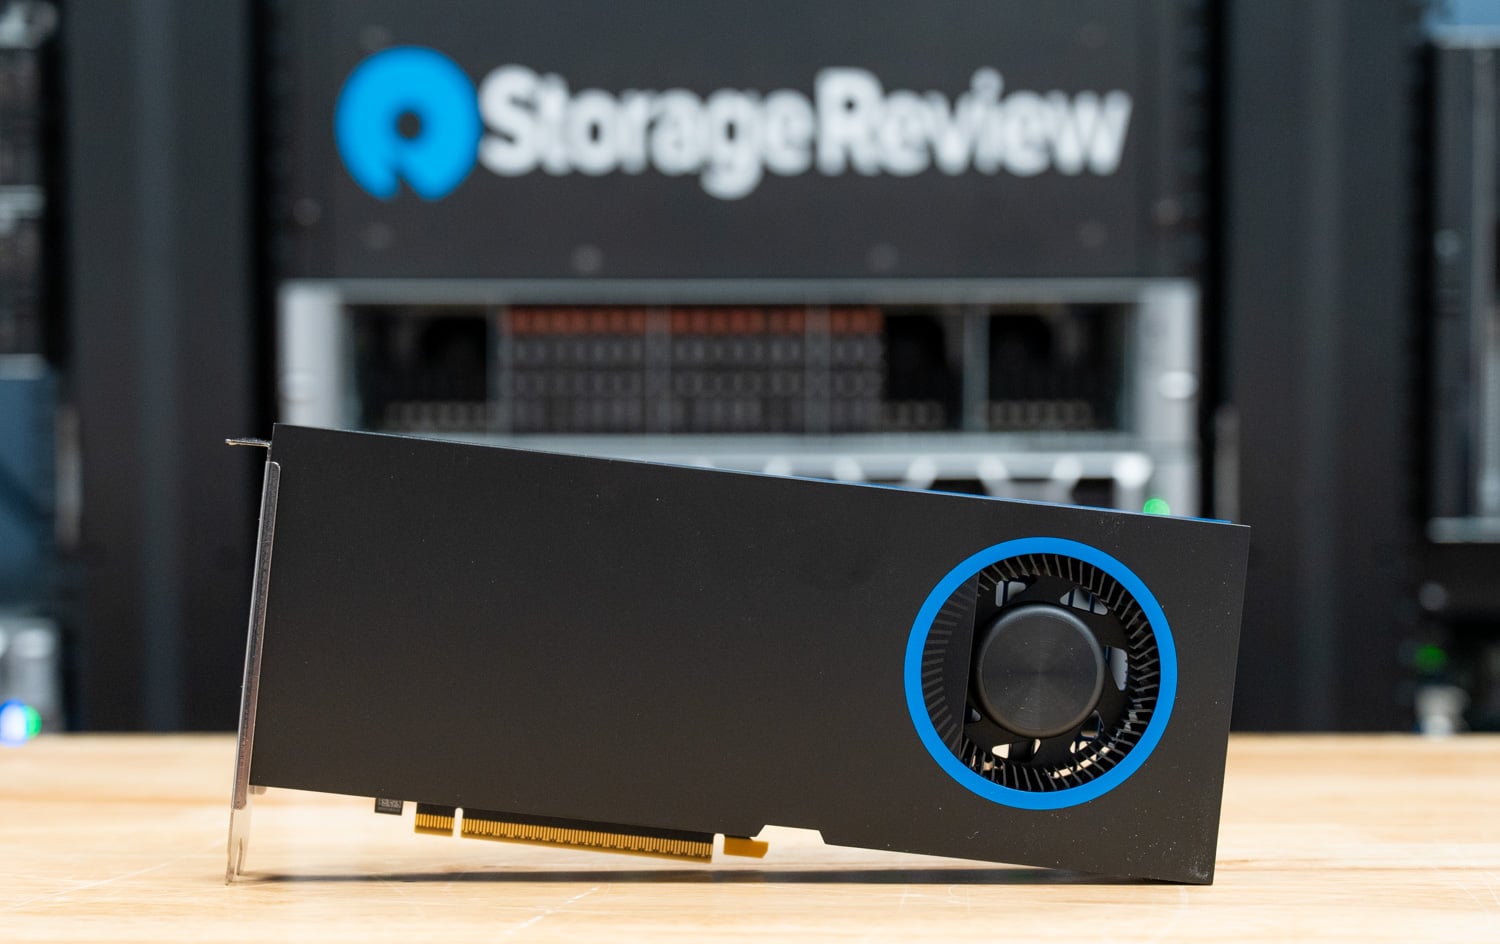
크기는 267mm x 99mm(10.5 x 3.9인치)이고 무게는 1kg(2.25파운드)인 Intel Arc Pro B70은 깔끔하고 절제된 디자인의 컴팩트한 듀얼 슬롯 보드입니다. 무광 블랙 색상에 인텔 특유의 파란색 포인트가 더해져 세련된 외관을 자랑합니다. 또한, 전체 길이에 걸쳐 양극 산화 처리된 알루미늄 백플레이트가 적용되어 견고함을 더하고 인텔 브랜드 이미지를 강조합니다.
이 제품은 방열판을 통해 공기를 흡입하고 후면 I/O 브래킷으로 직접 배출하는 단일 블로어형 팬을 특징으로 합니다. 이러한 밀폐형 냉각 설계는 카드의 크기를 컴팩트하게 유지하고 시스템 전체에 깨끗한 공기 흐름 경로를 유지합니다.
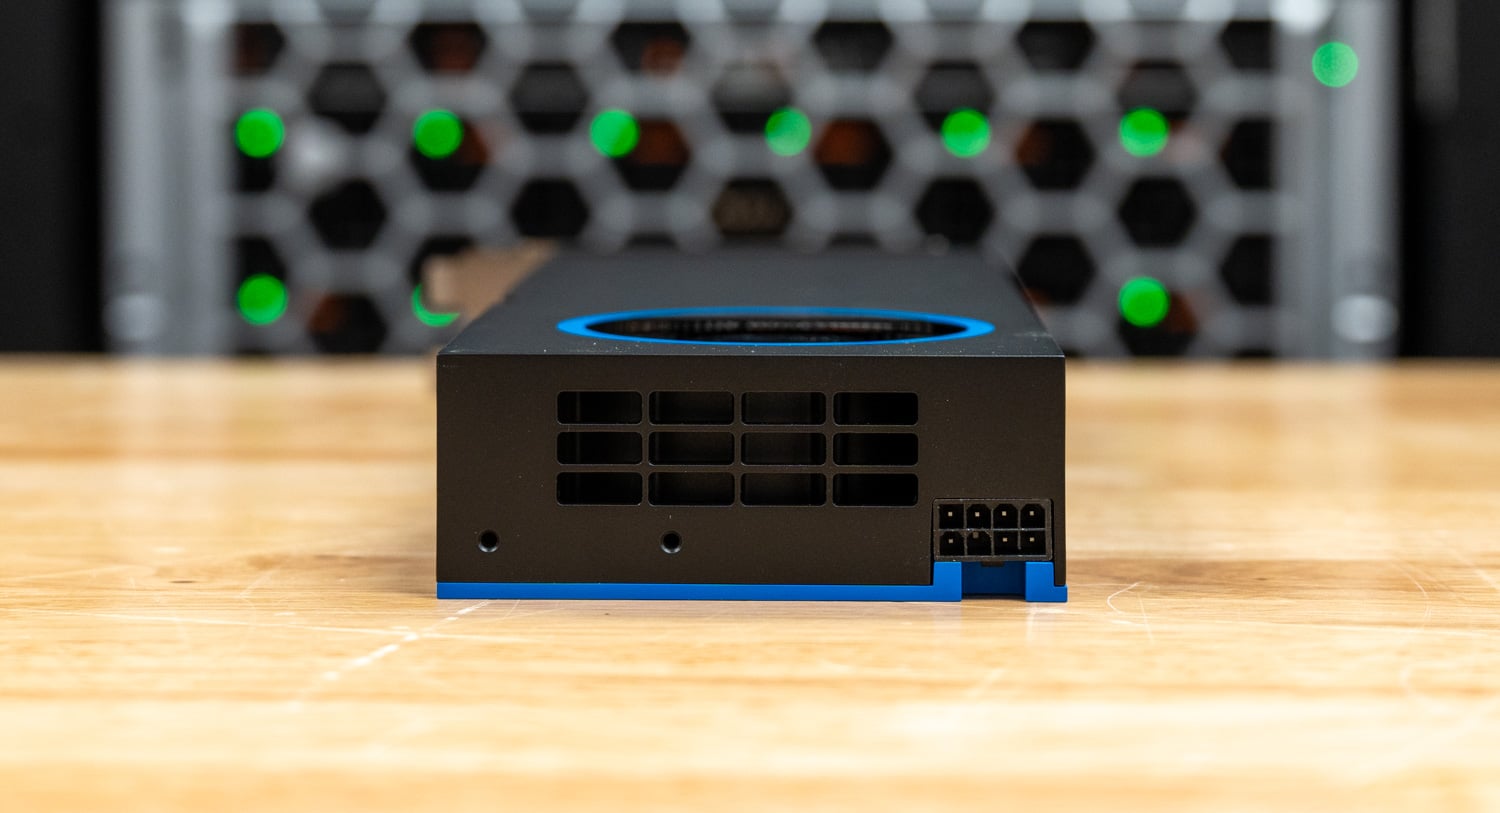
그래픽 카드 후면, PCIe 브래킷 반대편에는 외부 전원 공급을 위한 8핀(2×4) PCIe 전원 커넥터 하나가 있습니다. 또한, 이쪽 끝에는 송풍 팬에 신선한 공기를 공급하는 추가 흡기구와 워크스테이션 환경에서 안정성을 향상시키기 위해 옵션 GPU 지지 브래킷을 부착할 수 있는 나사식 장착 지점이 있습니다.
Arc Pro B70은 하단 가장자리를 따라 표준 PCIe 5.0 x16 인터페이스를 사용하여 호스트와 연결합니다. 이 각도에서 보면 카드의 듀얼 슬롯 폼 팩터가 잘 드러납니다. 이 폼 팩터는 밀폐형 블로어 냉각 솔루션을 위한 충분한 공간을 제공하면서도 워크스테이션 및 서버와 같이 시스템이 밀집된 환경에 적합할 만큼 컴팩트합니다.
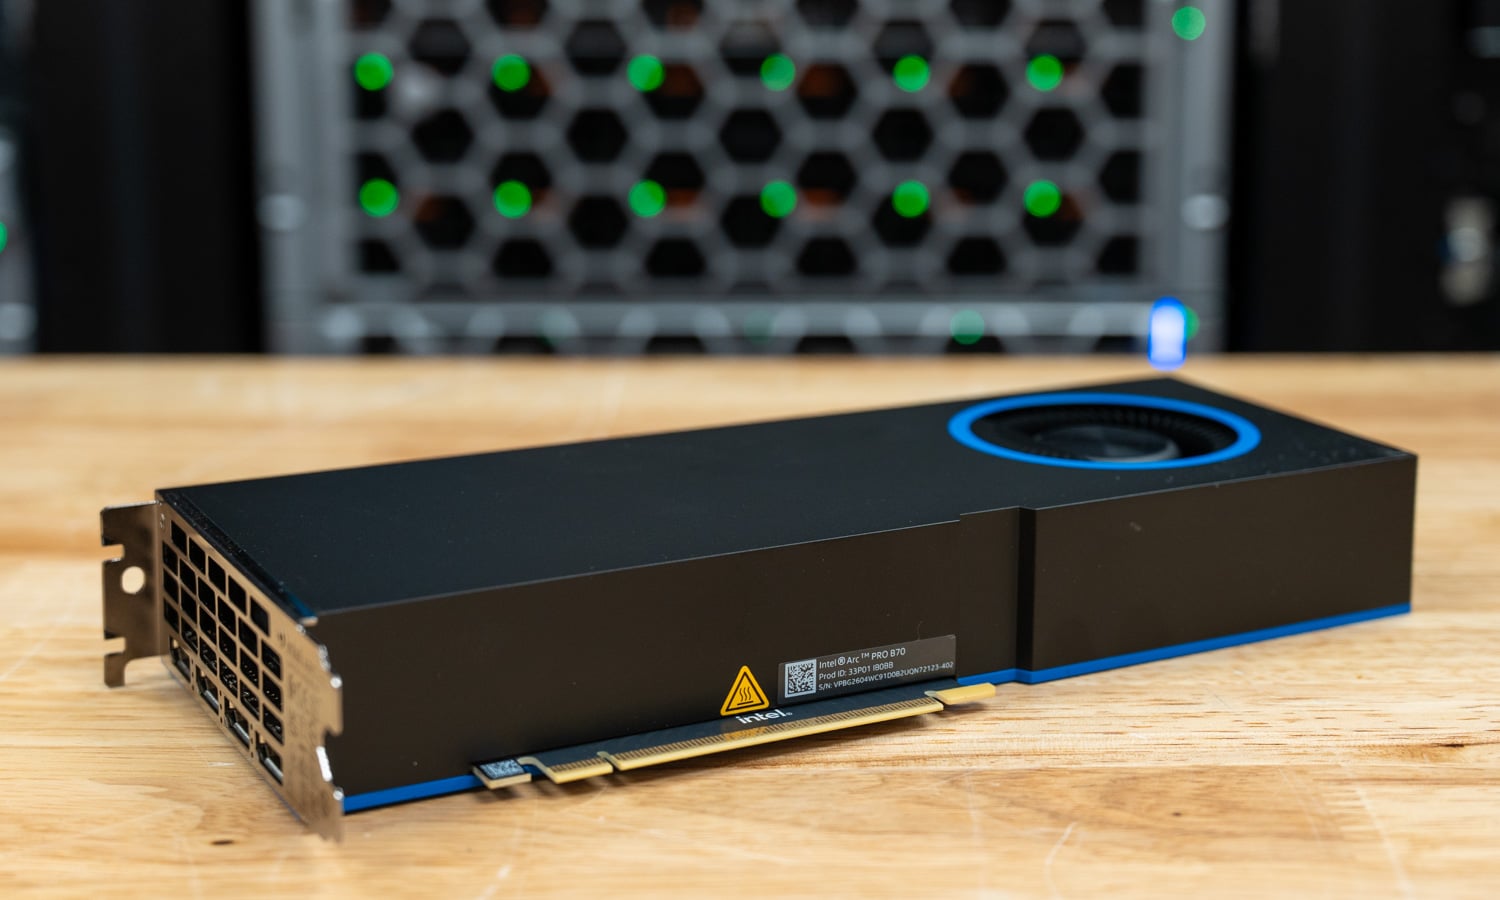
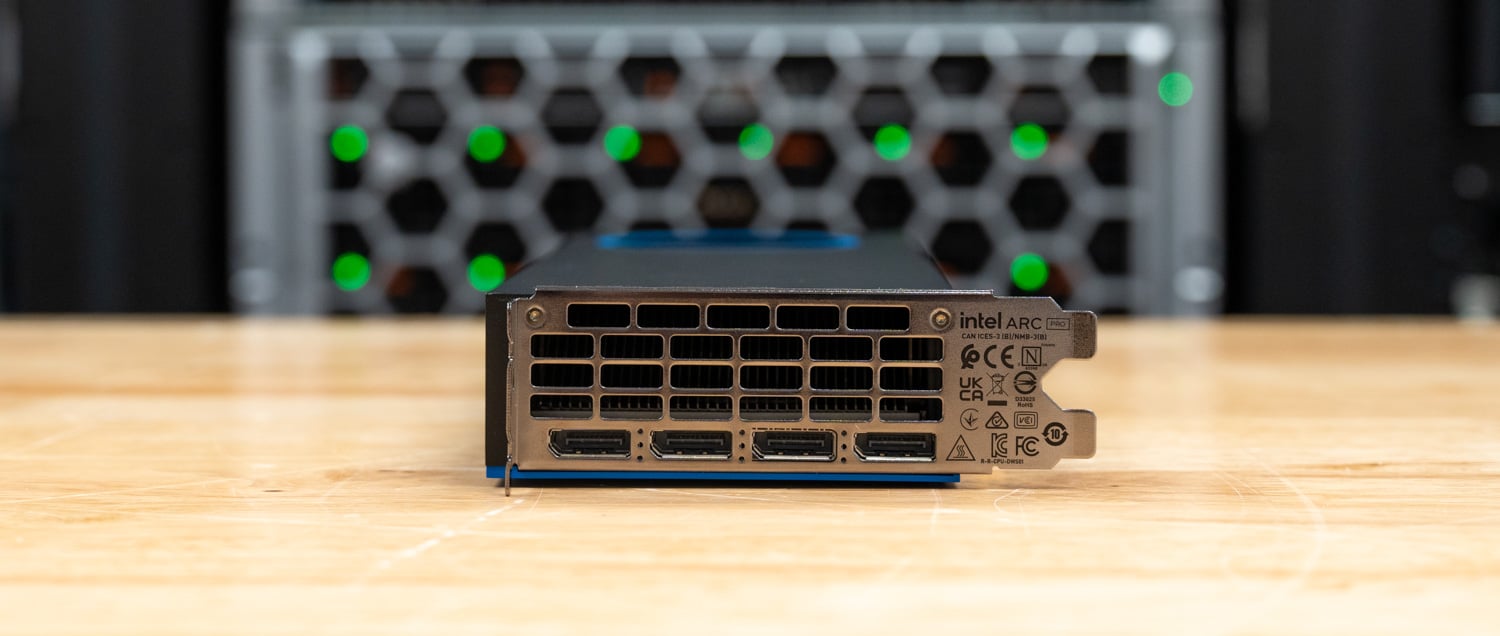
I/O 브래킷에는 대형 통풍구가 있어 송풍 팬이 섀시 내부의 뜨거운 공기를 직접 배출할 수 있습니다. 통풍구 아래에는 DisplayPort 2.1 출력 포트 4개가 있으며, 각 포트는 최대 7680 × 4320(8K) 해상도에서 120Hz 주사율로 디스플레이를 구동할 수 있어 고해상도 멀티 모니터 워크스테이션 환경에 충분한 대역폭을 제공합니다.
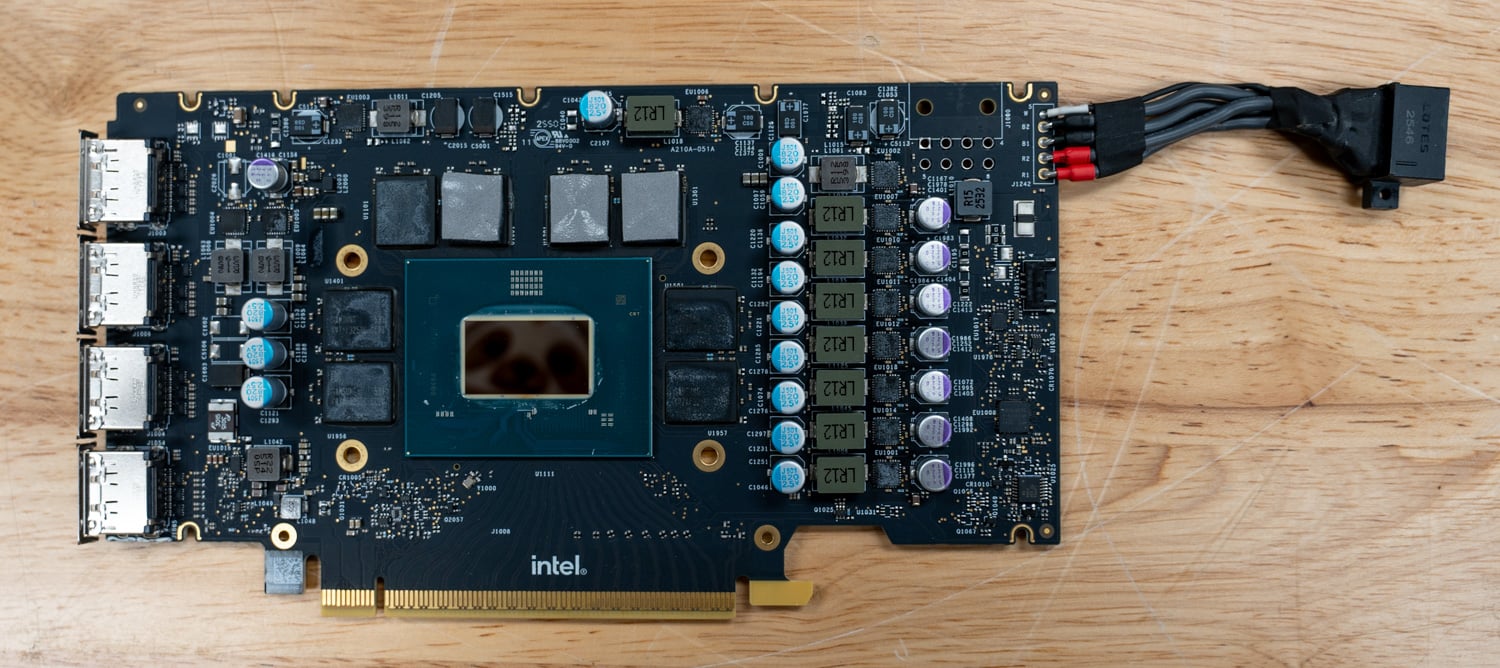
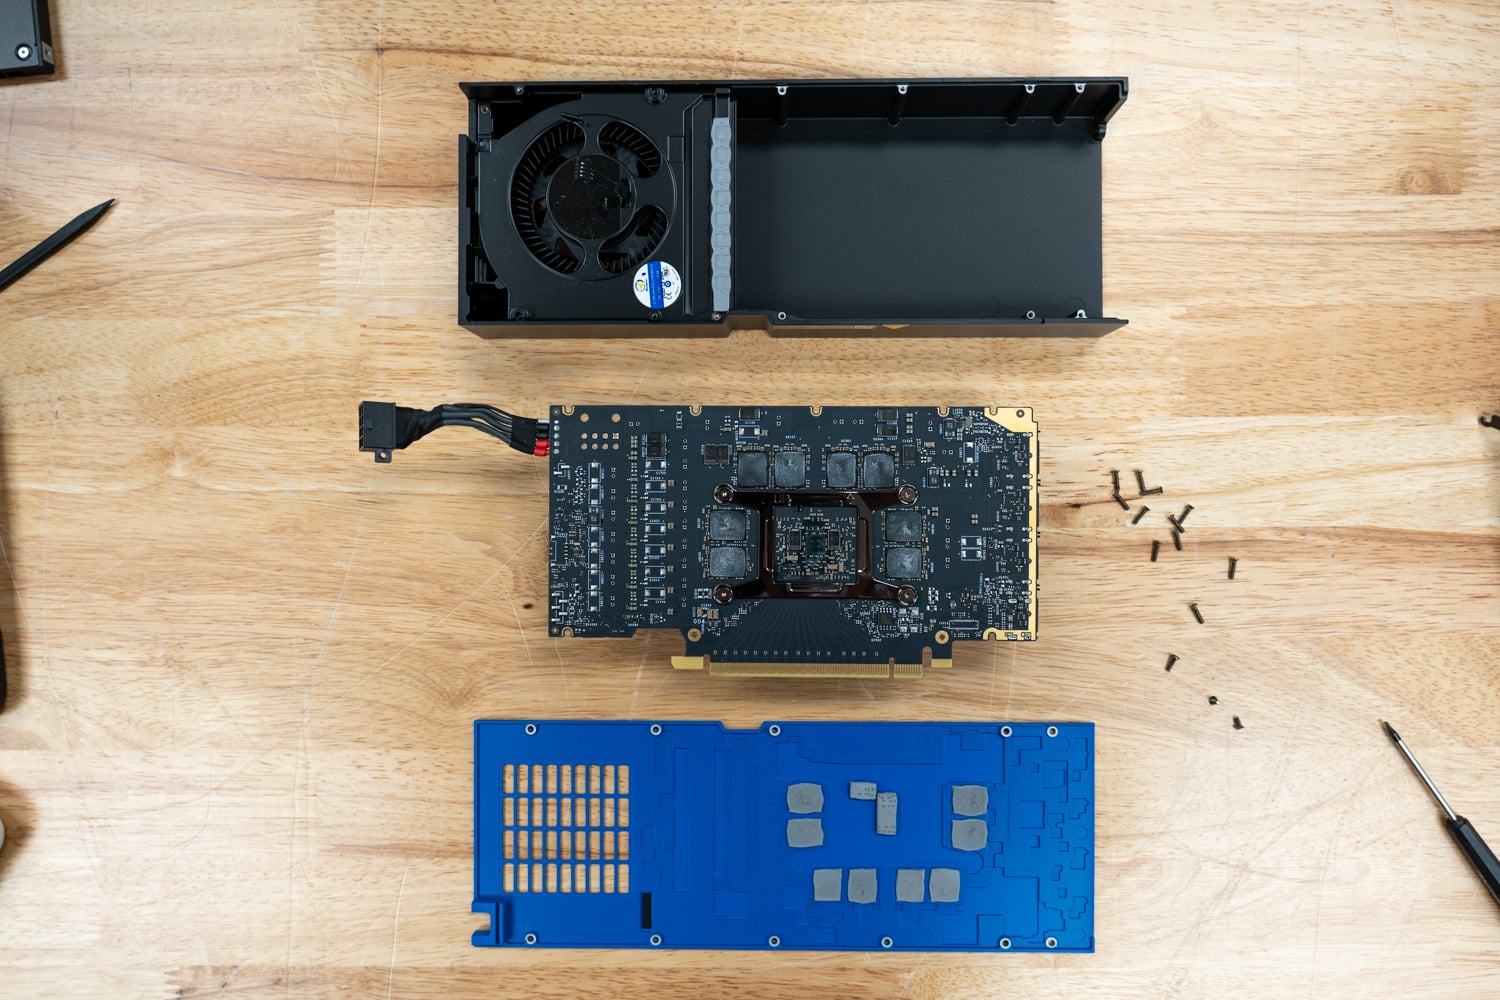
쿨러를 제거하면 Arc Pro B70의 PCB에서 그래픽 카드 구동에 필요한 주요 부품들을 확인할 수 있습니다. 중앙에는 인텔의 32코어 Xe2-HPG GPU가 자리 잡고 있으며, 256비트 메모리 인터페이스를 통해 연결된 32GB의 전용 GDDR6 메모리가 이를 둘러싸고 있어 최대 608GB/s의 메모리 대역폭을 제공합니다. 또한, 이 GPU는 최대 367 INT8 TOPS의 AI 컴퓨팅 성능을 제공하는 256개의 XMX AI 엔진과 하드웨어 가속 레이 트레이싱 워크로드를 위한 32개의 전용 레이 트레이싱 유닛을 통합하고 있습니다. GPU 주변에는 그래픽 카드 설계를 지원하는 전원 공급 장치, 메모리 회로 및 디스플레이 출력 부품들이 배치되어 있습니다.
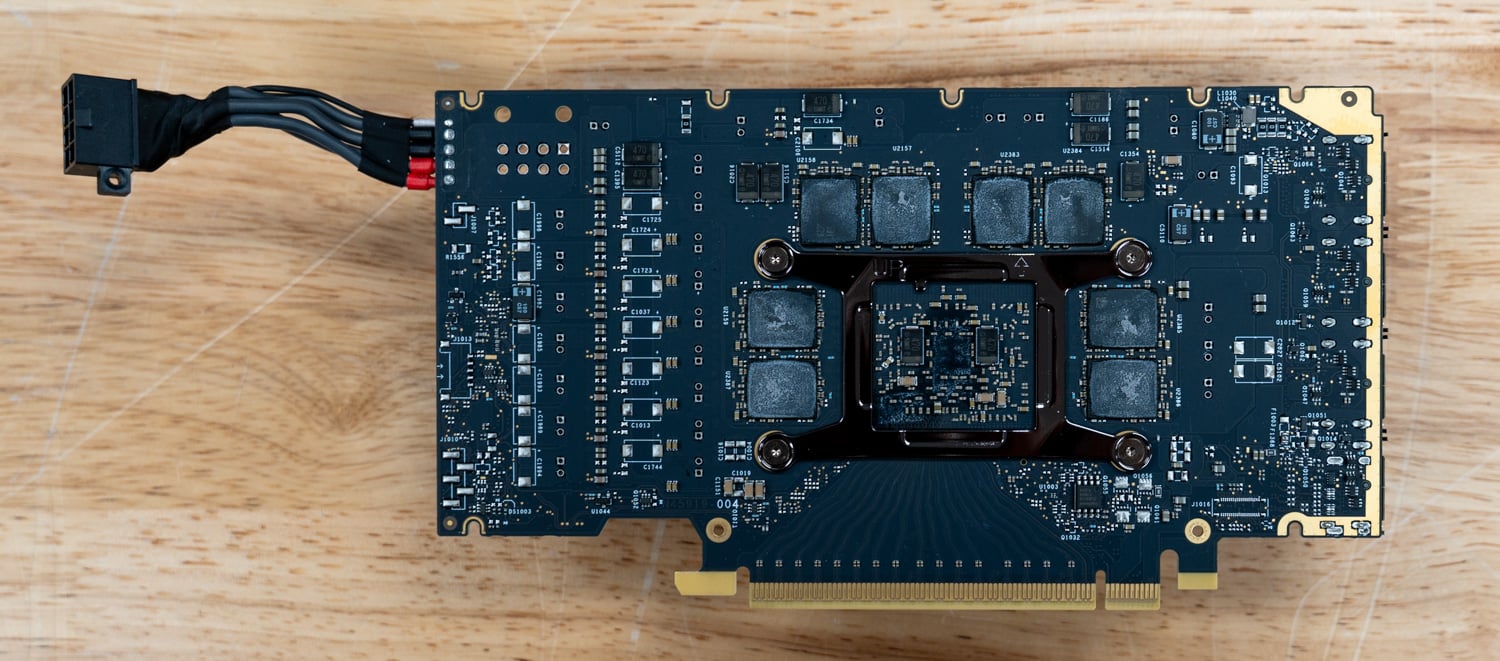
PCB 뒷면에는 GDDR6 메모리 패키지와 그래픽 카드 전원 공급 회로의 일부가 노출되어 있습니다. GPU 패키지를 둘러싼 대형 고정 브래킷은 방열판에서 발생하는 장착 압력을 고르게 분산하는 데 도움을 줍니다. 8핀 PCIe 전원 커넥터는 그래픽 카드에 외부 전원을 공급합니다. PCIe 슬롯을 통해 전원을 공급받을 경우, Arc Pro B70은 최대 230W의 총 보드 전력을 처리할 수 있습니다.
Intel Arc Pro B70 성능 테스트
Windows 테스트 - StorageReview AMD 스레드리퍼 테스트 플랫폼
다음은 인텔 Arc Pro B70 단일 제품 테스트에 사용할 테스트 플랫폼입니다.
- 마더 보드 : ASUS 프로 WS TRX50-SAGE WIFI
- CPU : AMD Ryzen Threadripper 7980X 64코어
- 램: 128GB DDR5 4800MT/초
- 스토리지 : 2TB 삼성 980 프로
- OS : 워크스테이션용 Windows 11 Pro
유사한 GPU 테스트 결과
- 인텔 아크 프로 B50
- 인텔 아크 프로 B70
- AMD Radeon RX 9060 XT
- AMD 라데온 RX 9070
- AMD Radeon RX 9070 XT
- NVIDIA GeForce RTX 5060 Ti
- 엔비디아 지포스 RTX 5070FE
UL Procyon: AI 텍스트 생성
Procyon AI 텍스트 생성 벤치마크는 간결하고 일관된 평가 방법을 통해 AI LLM 성능 테스트를 간소화합니다. 이 벤치마크는 대규모 모델의 복잡성과 변수 요인의 영향을 최소화하면서 여러 LLM 모델에 걸쳐 반복적인 테스트를 가능하게 합니다. AI 하드웨어 선도 기업들과 협력하여 개발된 이 벤치마크는 로컬 AI 가속기 사용을 최적화하여 더욱 안정적이고 효율적인 성능 평가를 제공합니다. 다음 결과는 NVIDIA 모델에서는 TensorRT를, AMD 모델에서는 ONNX를 사용하여 측정되었습니다.
Arc Pro B70은 비교 대상 중 가장 큰 세대 간 성능 향상을 보여주며, Phi, Mistral, Llama 3 테스트에서 B50 대비 전체 점수를 60% 향상시키고 첫 번째 토큰 획득 시간(time-to-first-token)을 40~45% 단축했습니다. AMD 그래픽 카드와 비교했을 때, B70은 Phi 테스트에서 Radeon RX 9060 XT보다 224% 높은 점수(4,152점 vs. 1,281점), Mistral 테스트에서 220% 높은 점수(4,082점 vs. 1,274점), Llama 3 테스트에서 250% 높은 점수(4,029점 vs. 1,150점)를 기록했습니다. Radeon RX 9070 XT와 비교했을 때는 Intel이 여전히 각각 100%, 83%, 95%의 우위를 유지하고 있습니다. NVIDIA는 격차를 좁혀 RTX 5060 Ti가 Phi와 Mistral에서 B70보다 각각 45% 뒤처지는 반면, RTX 5070은 동일 지표에서 15~20% 뒤처지는 결과를 보였습니다. 특히 주목할 만한 결과는 Llama 2 벤치마크에서 B70이 5,769점으로 전체 비교 대상 중 최고 점수를 기록하며 RTX 5070보다 85%, RX 9070 XT보다 151% 높은 성능을 보여준 것입니다.
| UL Procyon: AI 텍스트 생성 | 인텔 아크 프로 B50 | 인텔 아크 프로 B70 | AMD Radeon RX 9060 XT | AMD 라데온 RX 9070 | AMD Radeon RX 9070 XT | NVIDIA GeForce RTX 5060 Ti | 엔비디아 지포스 RTX 5070FE |
|---|---|---|---|---|---|---|---|
| 파이 전체 점수 | 2,593 | 4,152 | 1,281 | 1,933 | 2,080 | 2,870 | 3,453 |
| 첫 번째 토큰까지의 Phi 출력 시간 | 0.275들 | 0.155들 | 1.473들 | 0.954들 | 0.855들 | 0.375들 | 0.323들 |
| 초당 Phi 출력 토큰 | 72.128 토큰/초 | 104.121 토큰/초 | 94.453 토큰/초 | 139.187 토큰/초 | 144.471 토큰/초 | 120.773 토큰/초 | 150.435 토큰/초 |
| 파이 전체 기간 | 39.179들 | 37.924들 | 39.365들 | 26.989들 | 25.587들 | 25.216들 | 20.302들 |
| 미스트랄 종합 점수 | 2,483 | 4,082 | 1,274 | 2,040 | 2,231 | 2,807 | 3,562 |
| 미스트랄 출력 시간 첫 번째 토큰까지 | 0.346들 | 0.180들 | 1.827들 | 1.109들 | 0.946들 | 0.526들 | 0.433들 |
| 초당 미스트랄 출력 토큰 | 46.799 토큰/초 | 65.834 토큰/초 | 65.115 토큰/초 | 101.300 토큰/초 | 103.348 토큰/초 | 91.057 토큰/초 | 120.507 토큰/초 |
| 미스트랄 전체 기간 | 59.907들 | 58.976들 | 54.516들 | 34.960들 | 33.350들 | 33.377들 | 25.496들 |
| Llama3 전체 점수 | 2,427 | 4,029 | 1,150 | 1,904 | 2,070 | 2,599 | 3,125 |
| Llama3 첫 번째 토큰까지의 출력 시간 | 0.311들 | 0.166들 | 1.632들 | 0.981들 | 0.845들 | 0.449들 | 0.379들 |
| Llama3 초당 출력 토큰 | 45.031 토큰/초 | 66.340 토큰/초 | 53.167 토큰/초 | 87.594 토큰/초 | 89.102 토큰/초 | 74.709 토큰/초 | 100.388 토큰/초 |
| 라마3 전체 지속 시간 | 61.926들 | 53.687들 | 62.563들 | 38.273들 | 36.742들 | 39.489들 | 29.720들 |
| Llama2 전체 점수 | - | 5,769 | 1,252 | 2,047 | 2,298 | 2,576 | 3,125 |
| Llama2 첫 번째 토큰까지의 출력 시간 | - | 0.259들 | 2.992들 | 1.926들 | 1.565들 | 0.844들 | 0.785들 |
| Llama2 초당 출력 토큰 | - | 63.666 토큰/초 | 34.654 토큰/초 | 59.673 토큰/초 | 61.127 토큰/초 | 41.386 토큰/초 | 56.647 토큰/초 |
| 라마2 전체 지속 시간 | - | 44.131들 | 99.027들 | 59.100들 | 55.520들 | 71.302들 | 53.234들 |
UL 프로키온: AI 이미지 생성
Procyon AI 이미지 생성 벤치마크는 저전력 NPU부터 고성능 GPU에 이르기까지 다양한 하드웨어 환경에서 AI 추론 성능을 일관되고 정확하게 측정합니다. 이 벤치마크는 고성능 GPU용 Stable Diffusion XL(FP16), 중성능 GPU용 Stable Diffusion 1.5(FP16), 저전력 장치용 Stable Diffusion 1.5(INT8)의 세 가지 테스트로 구성됩니다. 각 시스템에 최적화된 추론 엔진을 사용하여 공정하고 비교 가능한 결과를 제공합니다.
이미지 생성 성능 또한 Arc Pro B70이 하위 모델 대비 크게 향상된 부분입니다. Stable Diffusion 1.5 FP16 점수는 179% 더 높은 2,101점(B50은 754점)을 기록했으며, 생성 시간은 132.6초에서 47.6초로 64% 단축되었습니다. B70은 RTX 5060 Ti와 거의 동일한 성능(2,101점 대 2,110점, 1% 미만 차이)을 보였지만, RX 9070 XT보다는 19%, RTX 5070보다는 29% 뒤처졌습니다. Stable Diffusion XL FP16에서도 인텔은 B50 대비 거의 세 배에 가까운 181%의 성능을 보여주었으며, RTX 5060 Ti보다 8% 앞섰지만 RTX 5070 FE보다는 약 18% 뒤처졌습니다. INT8 워크로드에서는 NVIDIA의 TensorRT 구현이 더 유리하지만, B70은 B50보다 265% 향상되었고 이미지 생성 시간도 72% 이상 단축되었습니다.
| UL Procyon: AI 이미지 생성 (총점: 높을수록 좋음) |
인텔 아크 프로 B50 | 인텔 아크 프로 B70 | AMD Radeon RX 9060 XT | NVIDIA GeForce RTX 5060 Ti | AMD 라데온 RX 9070 | AMD Radeon RX 9070 XT | 엔비디아 지포스 RTX 5070FE |
|---|---|---|---|---|---|---|---|
| 안정적 확산 1.5(FP16) - 전체 점수 | 754 | 2,101 | 1,436 | 2,110 | 2,280 | 2,598 | 2,937 |
| 안정적 확산 1.5(FP16) - 전체 시간 | 132.585들 | 47.585들 | 69.633들 | 47.590들 | 43.858들 | 38.481들 | 34.038들 |
| 안정적 확산 1.5(FP16) - 이미지 생성 속도 | 8.287초/이미지 | 2.974초/이미지 | 4.352초/이미지 | 2.974초/이미지 | 2.741초/이미지 | 2.405초/이미지 | 2.127초/이미지 |
| 안정적 확산 1.5(INT8) - 전체 점수 | 5,020 | 18,344 | N/A | 27,705 | N/A | N/A | 36,320 |
| 안정 확산 1.5(INT8) - 전체 시간 | 49.795들 | 13.628들 | N/A | 9.024들 | N/A | N/A | 6.883들 |
| 안정적 확산 1.5(INT8) - 이미지 생성 속도 | 6.224초/이미지 | 1.703초/이미지 | N/A | 1.128초/이미지 | N/A | N/A | 0.860초/이미지 |
| Stable Diffusion XL(FP16) - 전체 점수 | 748 | 2,102 | 1,124 | 1,940 | 1,805 | 2,010 | 2,473 |
| 안정적 확산 XL(FP16) - 전체 시간 | 790.774들 | 285.344들 | 533.736들 | 326.550들 | 332.400들 | 298.499들 | 242.606들 |
| 안정된 확산 XL(FP16) - 이미지 생성 속도 | 49.423초/이미지 | 17.834초/이미지 | 33.359초/이미지 | 20.409초/이미지 | 20.775초/이미지 | 18.656초/이미지 | 15.163초/이미지 |
럭스마크
Luxmark는 오픈소스 레이 트레이싱 렌더러인 LuxRender를 사용하여 고도로 세부적인 3D 장면에서 시스템의 성능을 평가하는 GPU 벤치마크입니다. 이 벤치마크는 특히 서버와 워크스테이션의 그래픽 렌더링 성능 평가에 적합하며, 정확한 조명 시뮬레이션이 필수적인 시각 효과 및 건축 시각화 애플리케이션에서 특히 유용합니다.
LuxMark는 Battlemage에서 뛰어난 확장성을 보여줍니다. Arc Pro B70은 B50 대비 음식(Food) 장면에서 128%, 홀(Hall) 장면에서 137% 향상된 성능을 보였습니다. 또한 Radeon RX 9060 XT보다 음식 장면에서 33%, 홀 장면에서 53% 높은 성능을 나타냈습니다. 게임에 특화된 RX 9070 XT는 음식 장면에서 약 54%, 홀 장면에서 37%의 우위를 유지했으며, NVIDIA RTX 5070 FE는 각각 62%와 81%의 우위를 보였습니다. 전반적으로 B70은 워크스테이션 워크로드에 적합한 강력한 OpenCL 렌더링 가속기임을 확실히 입증했습니다.
| 럭스마크 (높을수록 좋다) |
인텔 아크 프로 B50 | 인텔 아크 프로 B70 | AMD Radeon RX 9060 XT | NVIDIA GeForce RTX 5060 Ti | AMD 라데온 RX 9070 | AMD Radeon RX 9070 XT | 엔비디아 지포스 RTX 5070FE |
|---|---|---|---|---|---|---|---|
| 음식 점수 | 2,456 | 5,609 | 4,220 | 6,590 | 8,233 | 8,610 | 9,061 |
| 홀 스코어 | 5,158 | 12,220 | 8,007 | 15,348 | 16,566 | 16,758 | 22,062 |
Geekbench 6
Geekbench 6 는 시스템의 전반적인 성능을 측정하는 크로스 플랫폼 벤치마크 프로그램입니다. Geekbench 브라우저를 사용하면 어떤 시스템이든 Geekbench 6와 비교할 수 있습니다.
Arc Pro B70은 140,165점을 기록하며 Arc Pro B50 대비 정확히 100% 향상된 성능을 보여주었습니다. Radeon RX 9070보다 약 1% 높은 점수를, RX 9060 XT보다 36% 높은 점수를, RTX 5060 Ti보다는 단 7% 낮은 점수를 기록했습니다. NVIDIA의 RTX 5070 FE는 약 24% 더 높은 점수를, AMD의 RX 9070 XT는 약 35% 더 높은 점수를 기록하며, B70은 상위 메인스트림 컴퓨팅 제품군에서 중간 정도의 위치를 차지했습니다.
| Geekbench 6 OpenCL (높을수록 좋다) |
인텔 아크 프로 B50 | 인텔 아크 프로 B70 | AMD Radeon RX 9060 XT | AMD 라데온 RX 9070 | NVIDIA GeForce RTX 5060 Ti | 엔비디아 지포스 RTX 5070FE | AMD Radeon RX 9070 XT |
|---|---|---|---|---|---|---|---|
| GPU OpenCL 점수 | 70,038 | 140,165 | 102,750 | 138,463 | 150,743 | 173,255 | 188,892 |
3DMark
3DMark Port Royal, Speed Way, Steel Nomad는 다양한 시나리오에서 성능을 테스트하는 GPU 벤치마크입니다. Port Royal은 레이 트레이싱에 중점을 두고, Speed Way는 레이싱 시뮬레이션의 성능을 평가하며, Steel Nomad는 고강도의 사실적인 그래픽으로 GPU 성능을 시험합니다. 렌더링, 조명 및 동적 장면에서 GPU 성능을 평가합니다.
새로운 아키텍처 덕분에 그래픽 성능 테스트에서 우수한 확장성을 보여줍니다. Arc Pro B70은 Port Royal에서 B50보다 154%, Speed Way에서 136%, Steel Nomad에서 149% 더 높은 점수를 기록했습니다. RX 9060 XT와 비교했을 때는 Port Royal에서 9%, Speed Way에서 7%, Steel Nomad에서 9% 더 높은 성능을 보였습니다. RTX 5060 Ti와 비교했을 때는 Port Royal에서 2% 이내의 성능 차이를 보였고, Speed Way에서는 23% 뒤처졌지만 Steel Nomad에서는 13% 앞섰습니다. 최상위급 게이밍 GPU인 RTX 5070 FE와 RX 9070 XT는 작업 부하에 따라 31~83%의 성능 우위를 유지하며 고성능 게이밍 GPU로서의 입지를 확고히 했습니다.
| 3DMark (높을수록 좋다) |
인텔 아크 프로 B50 | 인텔 아크 프로 B70 | AMD Radeon RX 9060 XT | NVIDIA GeForce RTX 5060 Ti | 엔비디아 지포스 RTX 5070FE | AMD 라데온 RX 9070 | AMD Radeon RX 9070 XT |
|---|---|---|---|---|---|---|---|
| 포트 로얄 | 4,197 | 10,668 | 9,751 | 10,432 | 14,026 | 15,760 | 17,989 |
| 스피드웨이 | 1,355 | 3,202 | 3,004 | 4,184 | 5,869 | 5,791 | 6,237 |
| 스틸 노마드(DX12) | 1,644 | 4,089 | 3,767 | 3,611 | 5,019 | 5,992 | 6,977 |
토파즈 비디오 AI
Topaz Video AI는 고급 AI 모델을 사용하여 비디오를 향상시키고 복원하는 전문가용 애플리케이션입니다. 4K 또는 8K로 영상 업스케일링, 흐릿한 부분 선명화, 노이즈 감소, 얼굴 디테일 향상, 흑백 영상 컬러화, 부드러운 움직임을 위한 프레임 보간 등 다양한 작업을 지원합니다. 이 제품군에는 다양한 비디오 향상 알고리즘의 시스템 성능을 측정하는 내장 벤치마크가 포함되어 있어 하드웨어 플랫폼이 까다로운 AI 비디오 처리 작업 부하를 얼마나 잘 처리하는지 명확하게 보여줍니다.
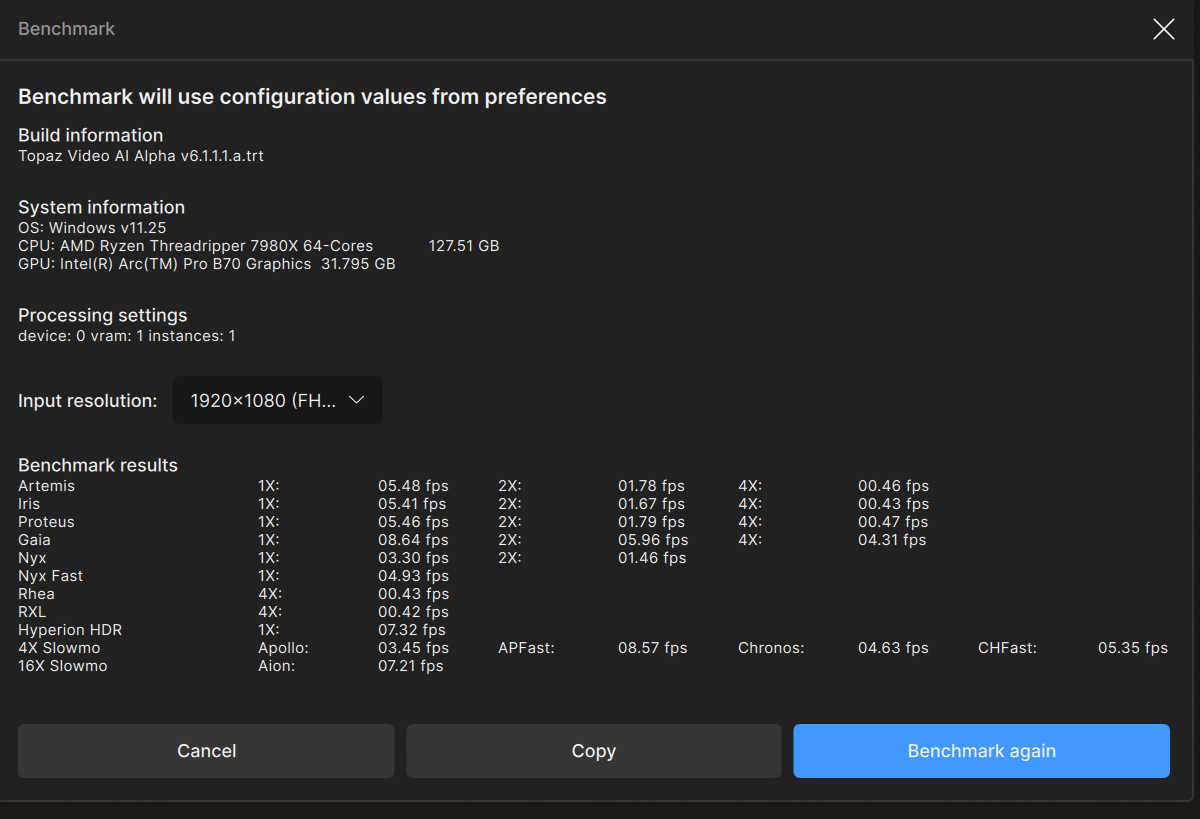
Arc Pro B70은 인텔의 이전 세대 전문가용 제품 대비 상당한 성능 향상을 제공하며, 특히 AI 업스케일링 작업에서 가장 큰 성능 향상을 보여줍니다. 이 카드는 Artemis에서 5.48 FPS, Iris에서 5.41 FPS, Proteus에서 1배 향상 시 5.46 FPS를 달성했으며, Gaia에서는 표준 향상 모델 중 가장 빠른 8.64 FPS를 기록했습니다. 연산 집약적인 복원 모델은 자연스럽게 속도가 느려져 Nyx는 3.30 FPS, Nyx Fast는 4.93 FPS를, Hyperion HDR은 7.32 FPS를 처리했습니다. 슬로우 모션 생성 또한 우수한 성능을 보여주며, Apollo에서 3.45 FPS, APFast에서 8.57 FPS, Chronos에서 4.63 FPS, CHFast에서 5.35 FPS, Aion에서 7.21 FPS를 기록했습니다. 종합적으로 이러한 결과는 Arc Pro B70이 비디오 향상 및 노이즈 제거부터 HDR 변환 및 프레임 보간에 이르기까지 Topaz AI 워크플로우의 모든 범위를 처리할 수 있음을 보여주며, 인텔의 XMX AI 가속을 활용하려는 크리에이터에게 훌륭한 선택이 될 수 있음을 시사합니다.
블렌더 4.5
Blender는 오픈 소스 3D 모델링 애플리케이션입니다. 이 벤치마크는 Blender Benchmark 유틸리티를 사용하여 GPU에서 실행되었습니다. 점수는 분당 샘플 수로 측정되며, 값이 높을수록 성능이 우수함을 나타냅니다.
Arc Pro B70은 Monster 벤치마크에서 분당 1,524.6 샘플, Junkshop 벤치마크에서 분당 846.9 샘플, Classroom 벤치마크에서 분당 912.2 샘플을 생성합니다. 이러한 수치는 RX 9070 XT나 RTX 5070과 같은 고급형 그래픽 카드와는 비교할 수 없지만, Battlemage가 전문적인 시각화 및 콘텐츠 제작 작업에 필요한 렌더링 성능을 충분히 제공한다는 것을 보여줍니다. 32GB 프레임 버퍼와 인증된 워크스테이션 드라이버를 갖춘 B70은 렌더링 기능, AI 가속 및 전문적인 안정성 사이에서 실용적인 균형을 제공합니다.
| 블렌더 4.5.0 (분당 샘플 수, 높을수록 좋음) | 인텔 아크 프로 B70 |
|---|---|
| 몬스터 | 1,524.60 |
| 정크샵 | 846.87 |
| 교실 | 912.24 |
전력 소비량: Intel B70
전력 소비는 모든 컴퓨팅 플랫폼에서 중요한 요소입니다. 새로운 GPU 세대가 나올 때마다 부하 시 전력 소비량이 증가하므로 더 큰 전원 공급 장치와 충분한 냉각 공기 흐름이 필요합니다. 하지만 더 빠른 GPU는 더 높은 최대 전력 소비량을 기록할 수 있지만, 각 작업 부하의 지속 시간은 줄어듭니다. 저희 테스트 연구실에서 Quarch Mains Analyzer를 사용하여 Procyon AI Image Generator Stable Diffusion XL FP16 테스트 동안 시스템 전체의 전력 소비량을 측정했습니다 . 이 작업 부하는 각 GPU의 전력 한계까지 몰아붙였으며, 생성된 각 이미지의 시작점과 종료점이 명확하게 나타났습니다.
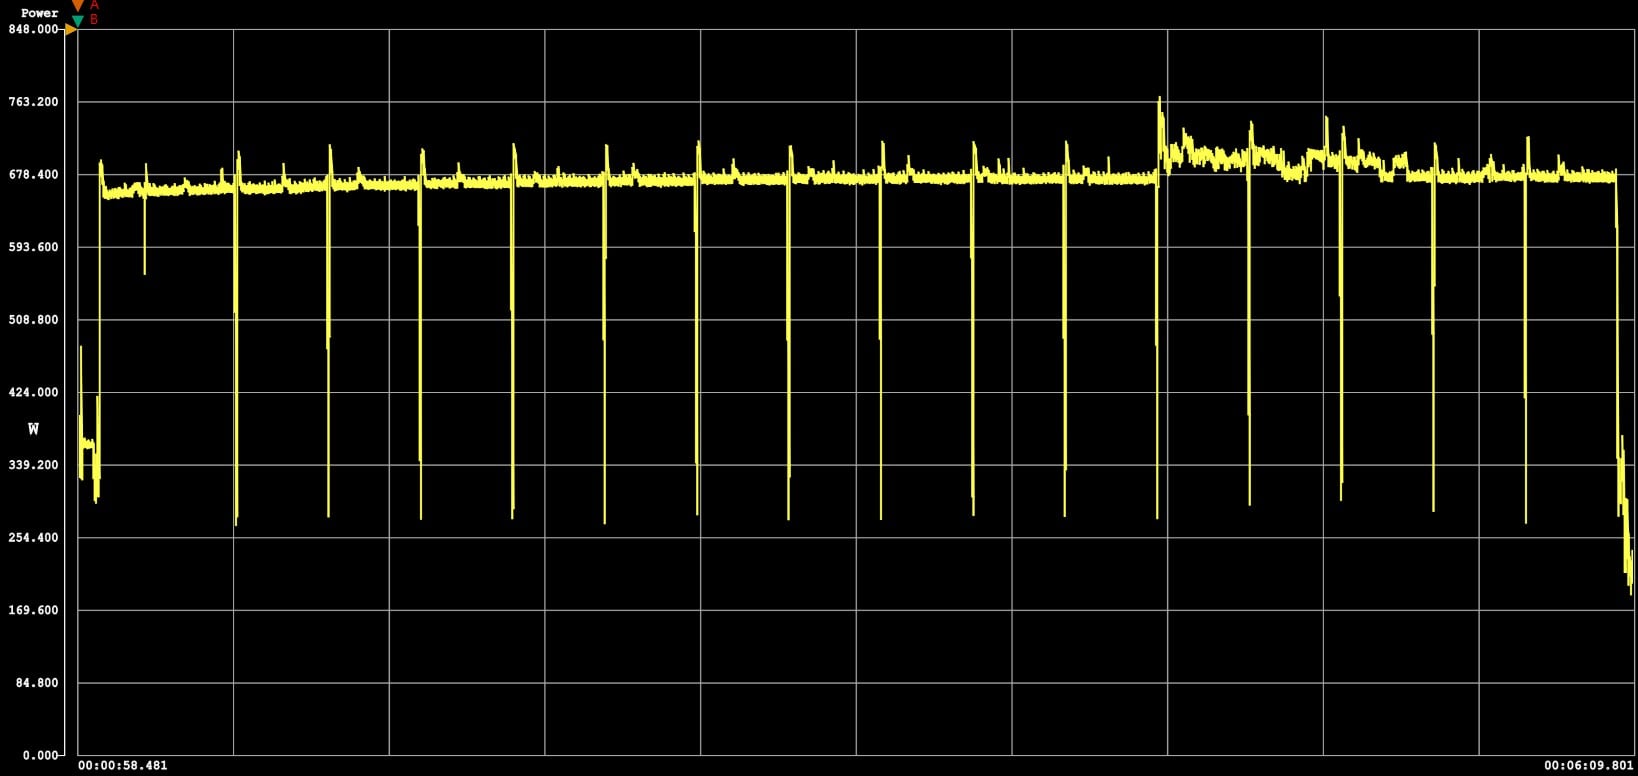
Intel Arc Pro B70 테스트 결과, 시스템 유휴 전력 소모량은 207W, 작업 부하 시 최대 소모량은 705.6W, 작업 부하 평균 소모량은 638.6W로 측정되었습니다.
| 안정적인 확산 XL FP16 전력 효율 (낮을수록 좋습니다) |
인텔 아크 프로 B50 | 인텔 아크 프로 B70 | AMD 라데온 RX 9070 | AMD Radeon RX 9070 XT | PNY 엔비디아 지포스 RTX 5060 Ti | 엔비디아 지포스 RTX 5070FE |
|---|---|---|---|---|---|---|
| 소비 전력 | 5.32 어 | 3.45 어 | 4.00 어 | 3.41 어 | 2.13 어 | 2.46 어 |
| 시험 기간 | 49.9들 | 18.46들 | 33.0들 | 17.4들 | 20.2들 | 19.2들 |
vLLM 온라인 서비스 벤치마크 성능
vLLM은 LLM(로지스틱 회귀 모델)을 위한 가장 인기 있는 고처리량 추론 및 서비스 엔진입니다. vLLM 온라인 서비스 벤치마크는 실제 환경에서 동시 요청 처리 성능을 측정하는 성능 평가 도구입니다. 이 벤치마크는 요청 속도, 입력/출력 길이, 동시 클라이언트 수 등 구성 가능한 매개변수를 사용하여 실행 중인 vLLM 서버에 요청을 전송함으로써 실제 운영 환경을 시뮬레이션합니다. 벤치마크는 처리량(초당 토큰 수), 첫 번째 토큰 획득 시간(TTFT), 출력 토큰당 시간(TPOT) 등의 주요 지표를 측정하여 사용자가 다양한 부하 조건에서 vLLM의 성능을 파악할 수 있도록 지원합니다.
테스트 플랫폼:
- 서버 : 슈퍼마이크로 AS-4125GS-TNRT
- 프로세서 : AMD EPYC 9374F
- 메모리: 512GB 삼성 4800 MT/s DDR5
- ISL 2k/ OSL 256
유사한 GPU 테스트
- 인텔 아크 프로 B60
- 인텔 아크 프로 B70
- 엔비디아 RTX 프로 6000
- 엔비디아 DGX 스파크
저희는 Supermicro 호스트에서 B70(128GB) 4개와 B60(96GB) 4개를 사용하여 RTX Pro 6000 1개와 DGX Spark 1개를 비교 테스트했습니다. GPU 개수를 다르게 설정한 것은 의도적인 것입니다. 정가 949달러인 B70 4개 세트는 Spark 1개 가격과 비슷하고 RTX Pro 6000 1개보다는 훨씬 저렴하기 때문에, 이번 비교에서는 카드 개수보다는 대략적인 가격 기준으로 플랫폼을 비교했습니다.
미스트랄 스몰 24B
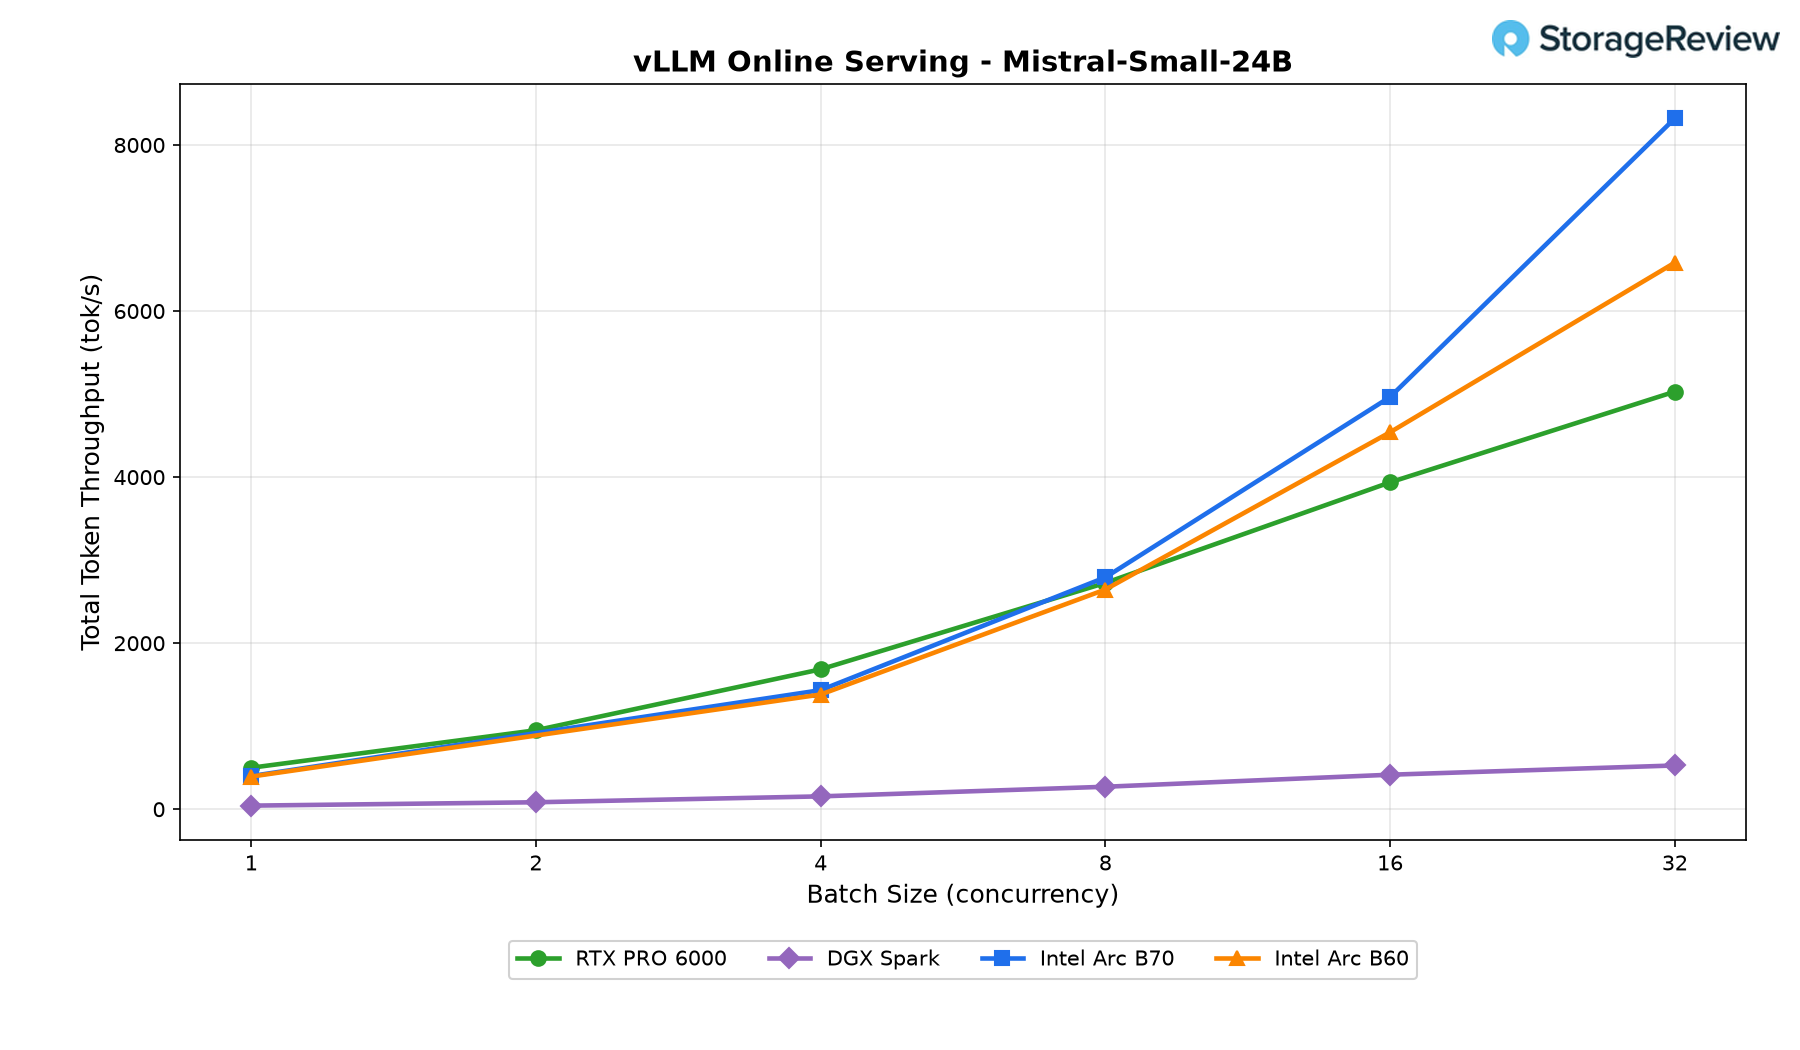
Intel Arc Pro B70은 Mistral-Small-24B 워크로드에서 가장 뛰어난 성능을 보여주었으며, 배치 크기 1에서 450 tok/s, 배치 크기 32에서 8,321 tok/s까지 확장되었습니다. RTX PRO 6000이 배치 크기 4까지는 약간 우위를 점했지만, B70은 배치 크기 8부터 이를 추월하여 격차를 꾸준히 벌려 최고 동시 처리량에서 약 65% 앞섰습니다. 하위 모델인 Arc Pro B60과 비교했을 때, B70은 초반에 소폭 우위를 유지하다가 배치 크기 32에서는 약 26%의 우위를 보였습니다. DGX Spark는 테스트 내내 크게 뒤처졌으며, 최고 처리량은 527 tok/s에 불과하여 B70이 최대 부하에서 거의 16배 빠른 속도를 기록했습니다.
큐웬3 코더 30B
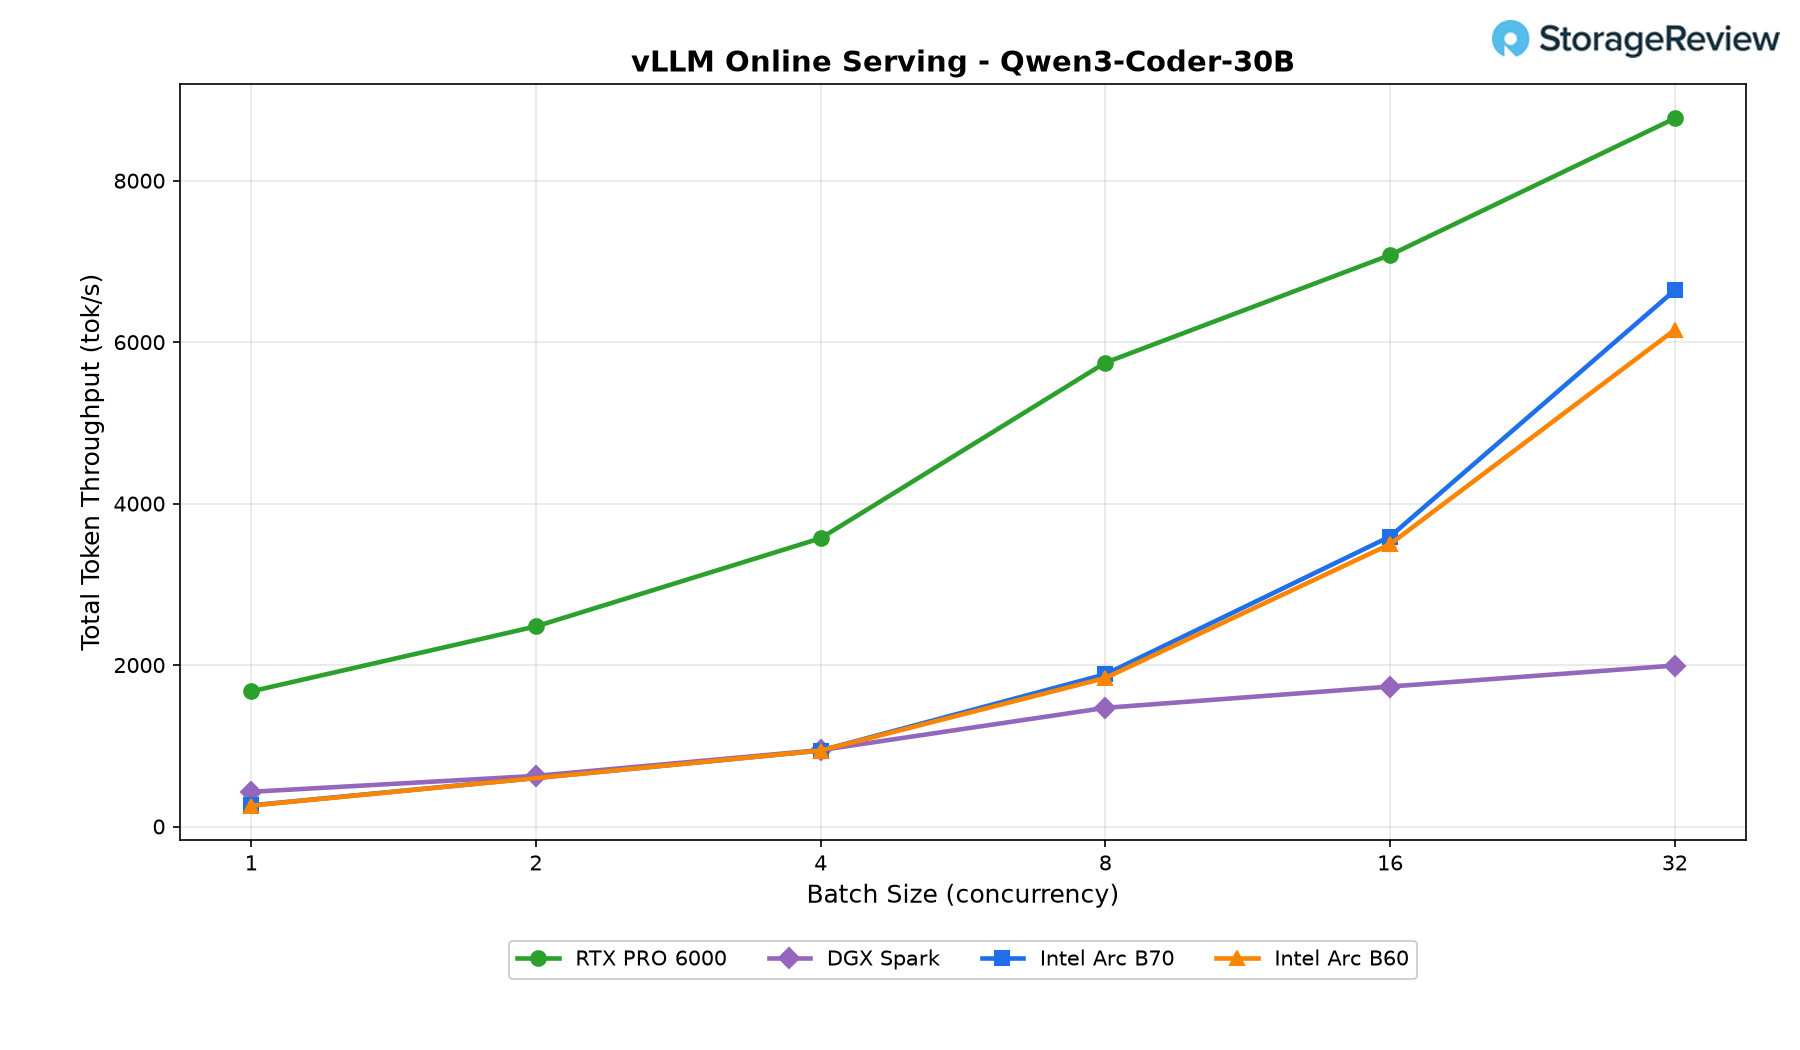
Qwen3-Coder-30B 테스트에서는 RTX PRO 6000이 가장 우수한 성능을 보였으며, 모든 동시 실행 수준에서 8,772 tok/s의 최고 처리량을 기록했습니다. 하지만 Intel Arc Pro B70 역시 우수한 확장성을 보여주며 배치 크기 32에서 6,643 tok/s를 달성했고, Arc Pro B60보다 약 8% 빠른 속도를 유지하며 꾸준히 우위를 점했습니다. 개발자 중심의 이 워크로드에서는 RTX PRO 6000에 미치지 못했지만, B70은 최대 동시 실행 수준에서 DGX Spark보다 3배 이상 높은 처리량을 제공하여 더 많은 동시 추론 요청을 효율적으로 처리할 수 있는 능력을 입증했습니다.
라마 3.1 8B
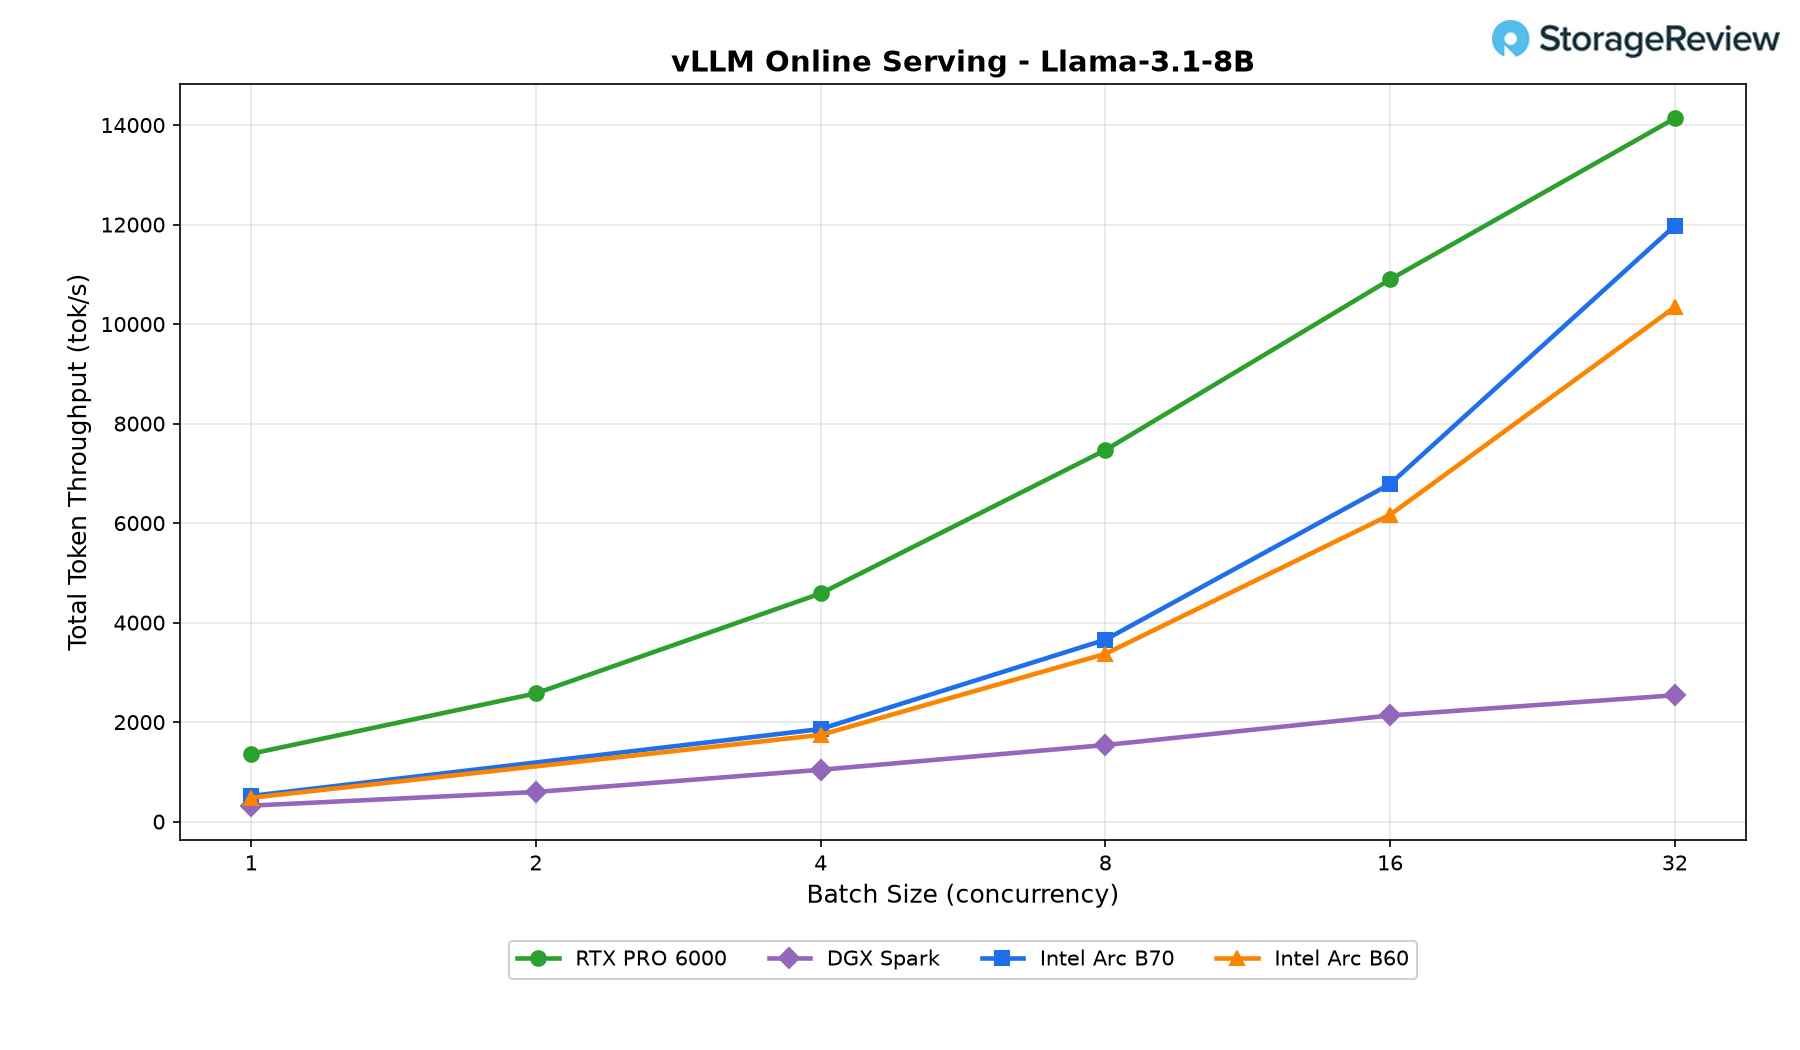
더 작은 Llama-3.1-8B 모델에서는 모든 외장 GPU가 동시 처리량이 증가함에 따라 공격적으로 확장되었지만, RTX PRO 6000은 여전히 성능 면에서 압도적인 선두를 유지했습니다. Intel Arc Pro B70은 배치 크기 32에서 거의 12,000 tok/s에 도달하여 Arc Pro B60보다 약 16% 앞서면서 RTX PRO 6000 처리량의 약 85%에 근접했습니다. 동시 처리량이 증가함에 따라 DGX Spark와의 격차는 계속 벌어졌으며, 가장 큰 배치 크기에서 B70은 약 4.7배의 처리량을 기록했습니다. 또한 이 결과는 B70이 더 큰 요청 큐에서 상당한 이점을 얻어 사용 가능한 GPU 리소스를 최대한 활용할 수 있음을 보여줍니다.
GPT OSS 20B
GPT-OSS-20B 벤치마크에서 RTX PRO 6000은 다시 한번 최고 성능을 자랑하며 약 16,900 tok/s의 처리량을 기록했습니다. 인텔 Arc Pro B70은 10,000 tok/s를 약간 웃도는 성능을 보이며, 배치 크기 32에서 약 7% 더 빠른 처리량을 기록하는 등 확장 곡선 전반에 걸쳐 Arc Pro B60보다 작지만 확실한 우위를 유지했습니다. NVIDIA의 플래그십 워크스테이션 GPU에는 약 40% 정도 뒤처졌지만, DGX Spark보다는 거의 3배에 달하는 처리량을 제공했습니다. 배치 크기 8 이상에서 거의 선형적으로 확장되는 것은 동시 요청이 증가함에 따라 B70이 여전히 효율적으로 활용됨을 시사합니다.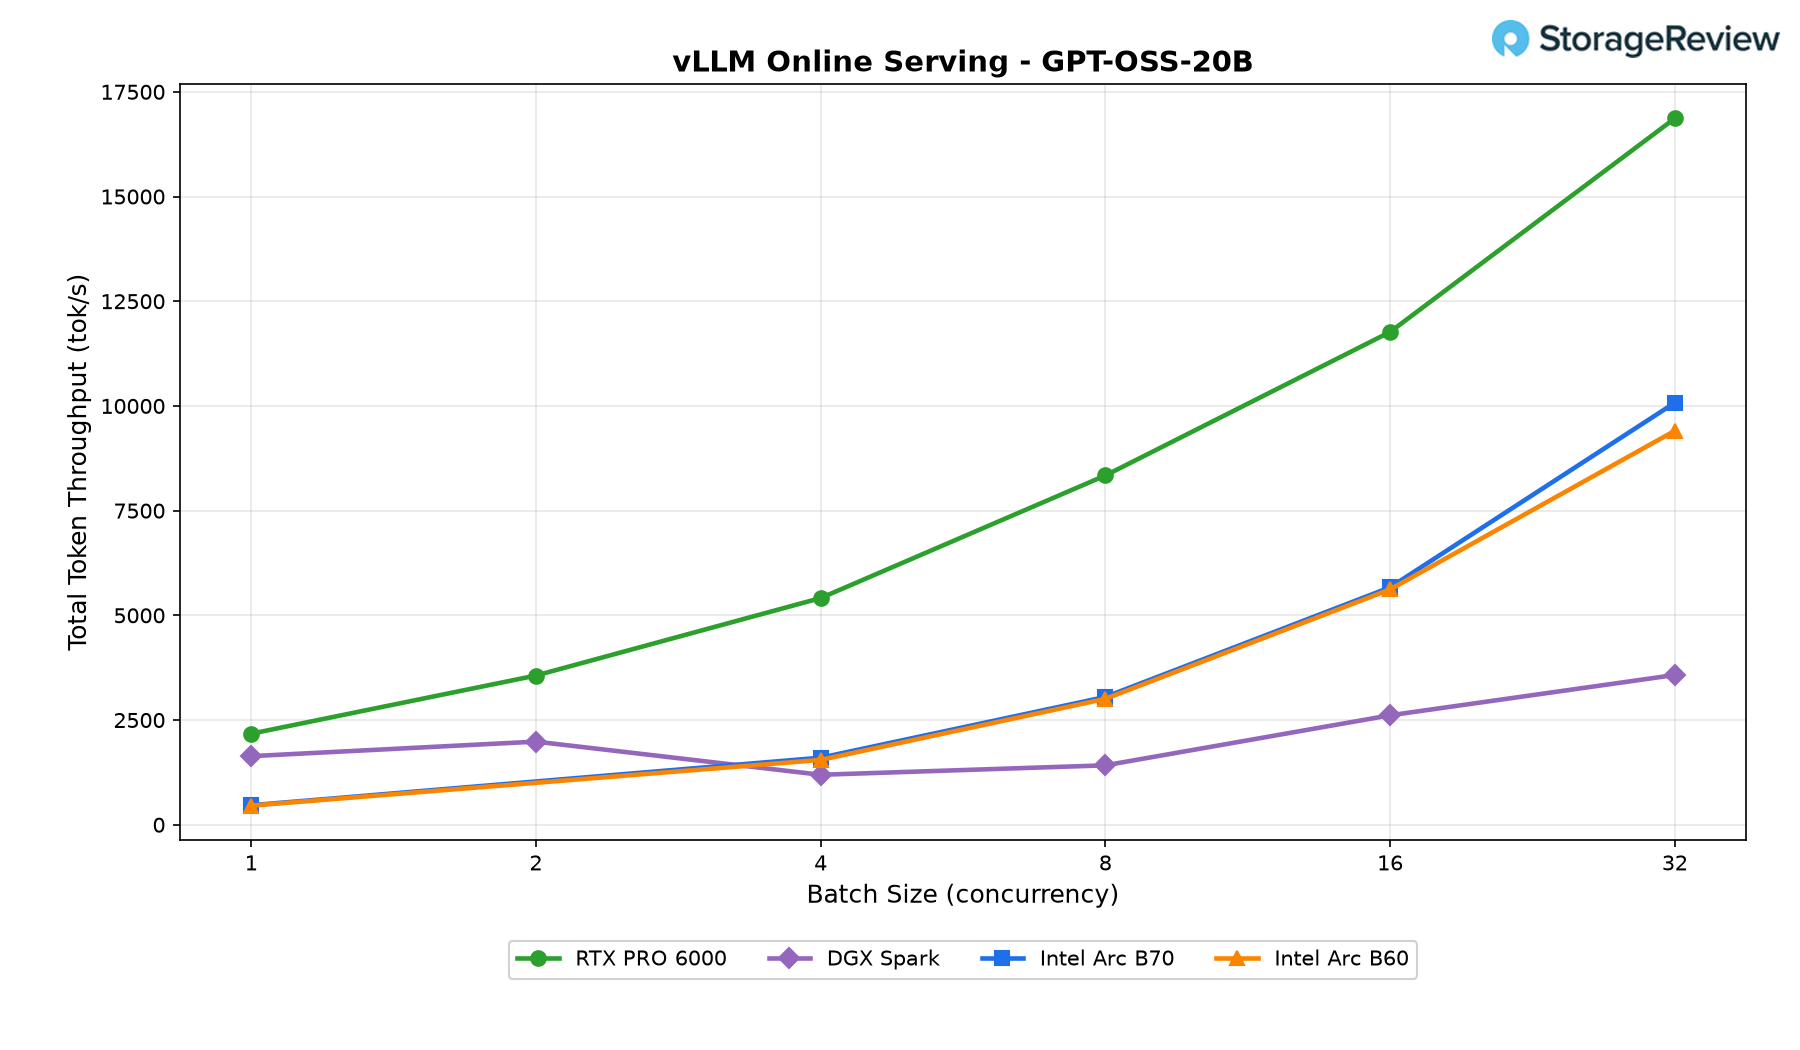
GPT OSS 120B
그룹 내 가장 큰 모델은 모든 플랫폼에서 더 높은 성능을 요구했지만, Intel Arc Pro B70은 효율적인 확장성을 보여주었습니다. 최종 처리량은 6,870 tok/s로 Arc Pro B60보다 약 7% 높았으며, RTX PRO 6000 처리량의 약 4분의 3 수준을 달성했습니다. DGX Spark는 동일한 동시 처리량 수준에서 2,175 tok/s를 기록하여 B70이 약 3.2배의 우위를 보였습니다. RTX PRO 6000이 전반적인 우위를 유지했지만, B70은 특히 높은 동시 처리량으로 하드웨어 활용률이 극대화될 때 대규모 언어 모델을 처리하는 데 있어 여전히 매우 경쟁력 있는 성능을 보여주었습니다.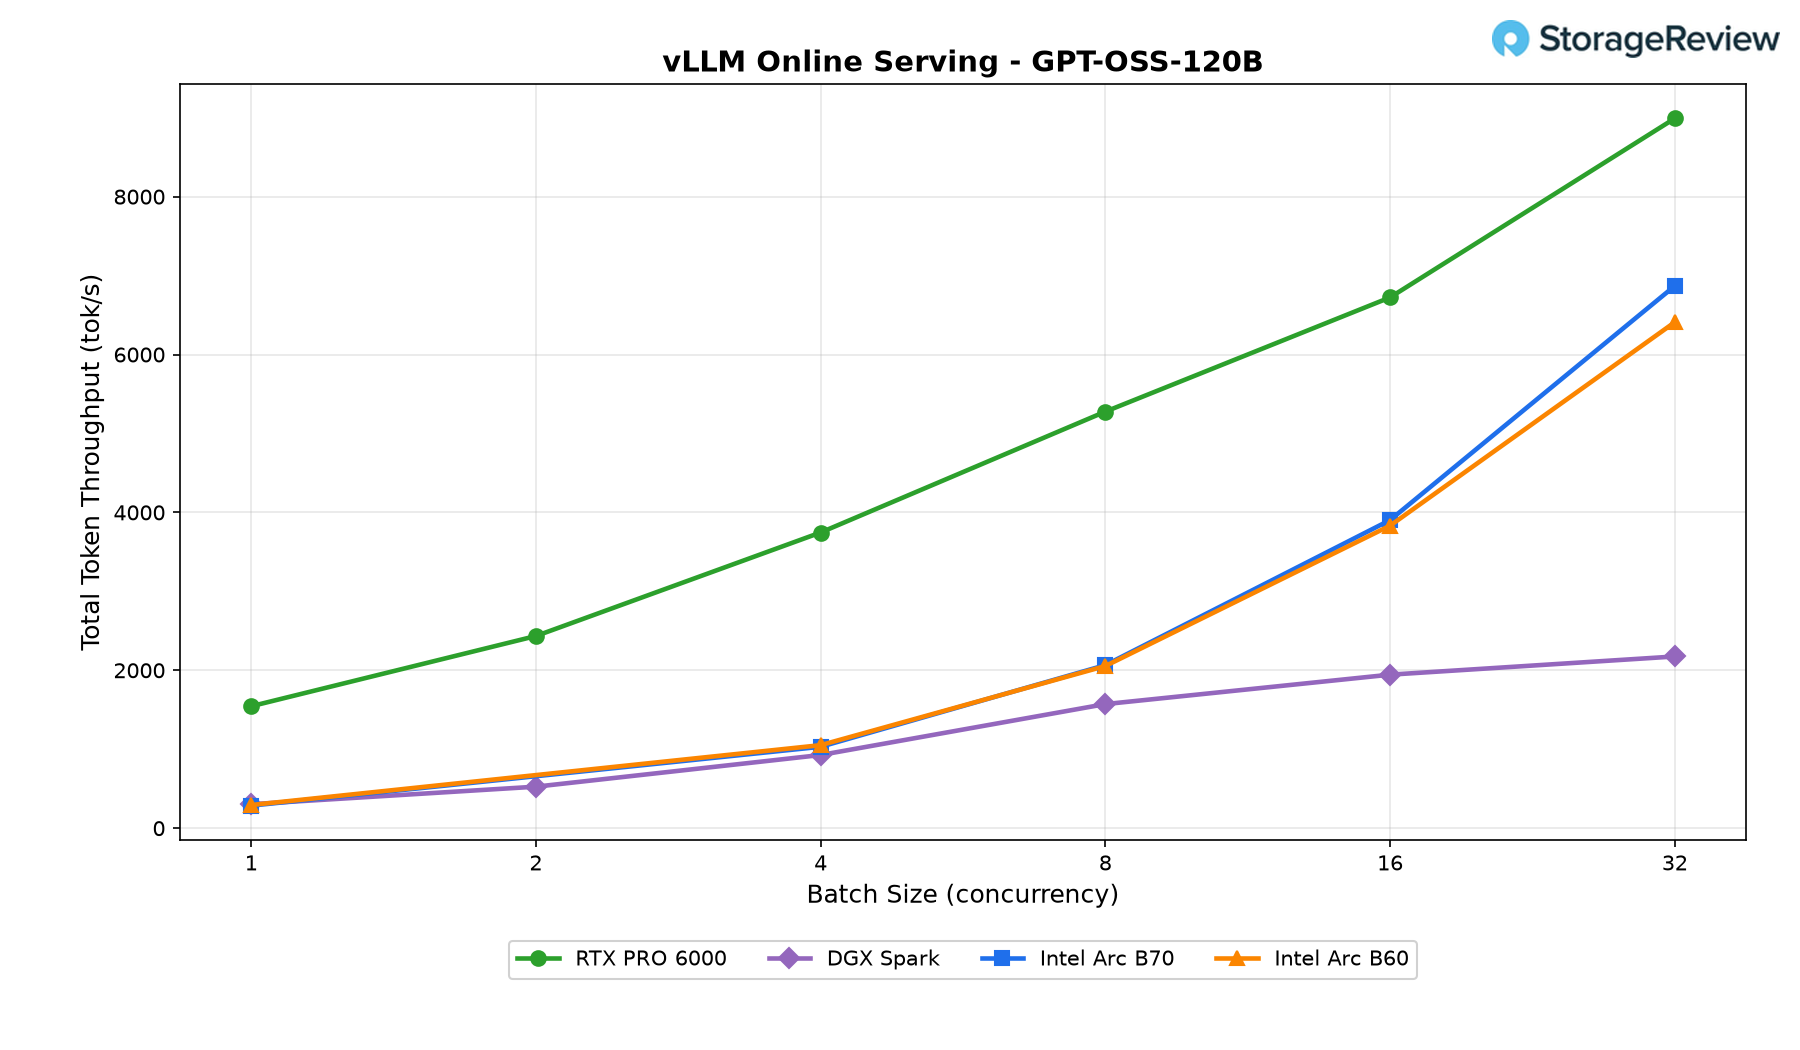
맺음말
인텔 Arc Pro B70은 인텔이 출시한 워크스테이션 AI GPU 중 가장 매력적인 제품 중 하나입니다. 출시 당시 949달러라는 합리적인 가격으로 32GB의 ECC GDDR6 메모리와 다양한 AI 및 전문 워크로드에서 비슷한 가격대의 소비자용 GPU를 능가하는 성능을 제공하며, 동시에 워크스테이션급 NVIDIA 제품보다 훨씬 저렴한 가격으로 독보적인 위치를 차지했습니다. 현재 시장 가격이 1,100달러를 넘어섰지만, 특히 대규모 로컬 모델이나 멀티 GPU 환경처럼 연산 능력보다는 메모리 용량이 제약 요소인 사용자에게는 RTX Pro 4000과 같은 제품과 비교했을 때 여전히 매력적인 가성비를 자랑합니다.
하드웨어 측면에서 인텔 Arc Pro B70은 뛰어난 성능을 보여주었습니다. Stable Diffusion 1.5 이미지 생성에서 RTX 5060 Ti와 거의 동등한 성능을 보였고, 렌더링 결과도 만족스러웠으며, 최신 언어 모델을 처리하는 속도 또한 로컬 AI 인프라에 적합한 수준이었습니다. Llama 3.1 8B 테스트에서는 거의 12,000 tok/s의 처리량을 기록했고, 4개의 B70 카드를 사용했을 때는 Mistral Small 24B 테스트에서 최대 동시 처리 환경에서 단일 RTX Pro 6000 레퍼런스보다 65% 높은 성능을 보여주었습니다. 워크스테이션 한 대에 4개의 B70을 장착하면 128GB의 VRAM을 제공하며, 가격은 정가 기준으로 약 3,800달러로 고성능 워크스테이션용 GPU 한 대 가격보다 훨씬 저렴합니다.
Arc Pro B70이 직면한 가장 큰 과제는 실리콘 자체가 아니라, 이를 둘러싼 소프트웨어 생태계입니다. 드라이버 품질과 프레임워크 지원은 NVIDIA의 CUDA 생태계와 AMD의 점점 더 성숙해지는 ROCm 스택에 비해 여전히 뒤처지고 있습니다. 인텔은 oneAPI, OpenVINO, 그리고 Battlemage 기반의 vLLM 개발을 통해 상당한 진전을 이루었지만, 사용자들은 여전히 간헐적인 호환성 문제, 제한적인 모델 지원, 그리고 경쟁 플랫폼에 비해 더 많은 문제 해결 노력을 예상해야 합니다. 거의 모든 AI 프레임워크와 애플리케이션에서 "그냥 작동하는" 완벽한 GPU를 찾는 사용자에게는 NVIDIA와 AMD가 여전히 더 안전한 선택이 될 것입니다.
결론적으로, Arc Pro B70은 VRAM 용량, 워크스테이션 기능, 그리고 가격 대비 AI 성능을 중시하는 구매자에게 추천할 만한 제품입니다. 단, 구매 시 어떤 점을 고려해야 하는지 정확히 이해해야 합니다. 공격적인 가격 책정으로 뒷받침되는 뛰어난 하드웨어이지만, 장기적인 성공은 인텔의 지속적인 소프트웨어 개발과 생태계 지원 확장에 달려 있습니다. 인텔이 이러한 투자를 지속할 수 있다면, B70은 소비자 및 전문가용 AI 가속 분야에서 가장 강력한 가성비를 자랑하는 하드웨어 기반이 될 수 있습니다. 그렇지 못할 경우, 엄청난 잠재력을 가졌지만 NVIDIA와 AMD 경쟁 제품처럼 손쉬운 사용성을 제공하지 못하는 제품으로 남을 위험이 있습니다.


 아마존