

QSAN은 2004년부터 엔터프라이즈 스토리지 솔루션을 구축해 왔으며, 이러한 경험은 XN4 제품군에서 여실히 드러납니다. 저희 연구실의 XN4226D는 듀얼 액티브 컨트롤러를 탑재한 2U, 26베이, 올-NVMe 어레이로, 통합 블록 및 파일 스토리지로서 높은 가용성을 제공합니다. QSM 4 소프트웨어는 스냅샷, 복제 옵션, 데이터 감소, 간편한 관리 환경 등 필요한 데이터 서비스를 제공합니다. XN4는 멀티프로토콜 유연성을 유지하면서도 NVMe 속도를 원하는 팀을 위해 설계되었으며, 이 모든 것을 매우 합리적인 가격으로 제공합니다.
주요 요점
- 실제 HA를 갖춘 통합 블록 및 파일. 듀얼 액티브 컨트롤러와 QSM 4는 블록과 파일을 위한 단일 플랫폼으로 높은 가용성을 제공합니다.
- NVMe-oF를 올바르게 구현했습니다. iSCSI, 파이버 채널, NFS, SMB, FTP, WebDAV와 함께 TCP 및 RDMA를 통한 NVMe-oF를 통한 전체 프로토콜 확산.
- 검증된 처리량. TCP를 사용한 대용량 순차 읽기에서는 최대 21.21GB/s, RDMA를 사용한 대용량 순차 쓰기에서는 11.14GB/s의 속도를 측정했습니다.
- 현대식 파이프라인에 맞게 제작되었습니다. 2U에 26개의 NVMe 베이가 있어 관리가 간편하고, 미디어, 감시 분석, VDI, 데이터베이스, AI 추론을 위해 100~200GbE까지 확장 가능한 I/O 옵션이 제공됩니다.
이 플랫폼은 iSCSI, 파이버 채널, NFS, SMB, FTP, WebDAV 외에도 TCP 및 RDMA를 통한 NVMe-oF를 지원합니다. 또한 TCP와 RDMA의 동작 및 확장성을 비교하는 NVMe-oF 집중 연구도 완료했습니다. 테스트에서 대용량 순차 읽기를 통해 장치의 한계를 시험하여 21.21GB/s라는 놀라운 처리량을 달성했습니다. 이 시스템의 적합성은 단순한 수치만큼이나 중요합니다. XN4226D는 VM, VDI, 데이터베이스 계층을 위한 VMware 또는 Proxmox를 혼합한 혼합 환경은 물론, 예측 가능한 NVMe 경로가 필요한 크리에이티브 파일 서비스, AI 추론 노드, 미디어 백업, 감시 및 센서 워크로드를 위한 고대역폭 수집에도 적합합니다. QSAN XN4226D는 거의 모든 워크로드에 적합합니다.
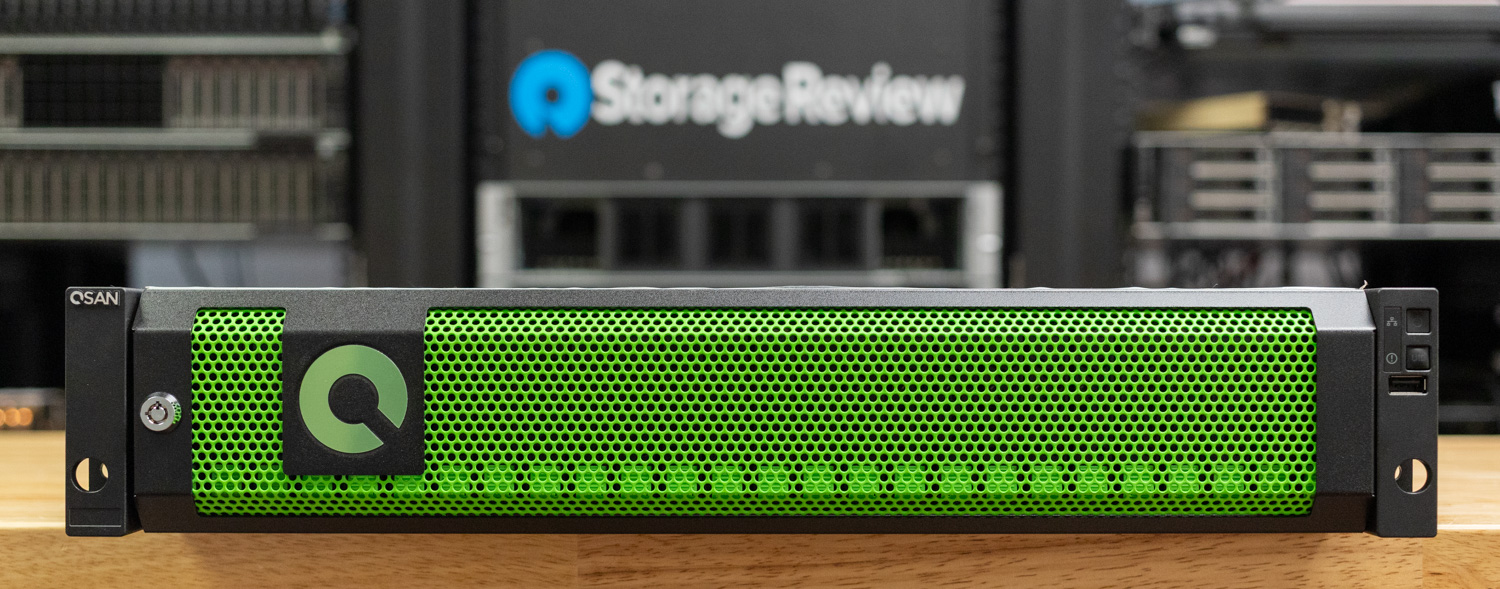
QSAN은 생방송, 재생 옵션, AI 비디오 향상, OTT/엣지 캐싱을 포함한 미디어 제작과 스마트 시티 CCTV, 이상 감지, 실시간 재생과 같은 감시 비디오 분석 분야에서 상당한 성장을 기록했습니다. 이러한 워크로드는 100~200GbE 처리량으로 이상적으로 지원됩니다.
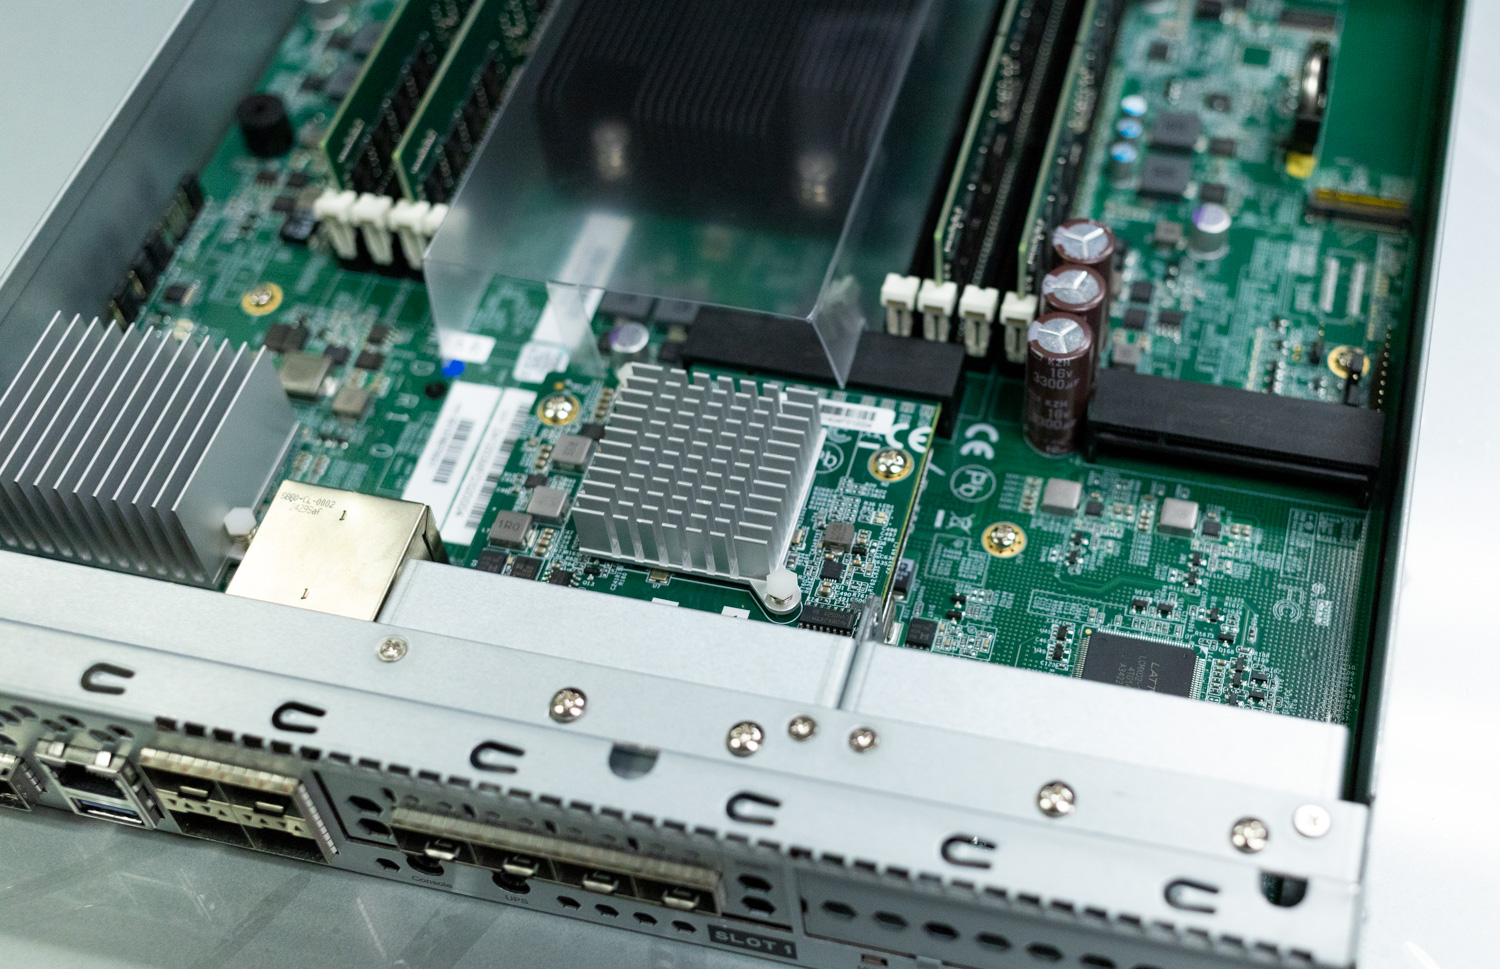
궁극적으로 가치는 명확합니다. 통합된 고가용성, 섀시 전체에 걸친 NVMe, 그리고 요구 사항에 따라 최대 100GbE 또는 32Gb 파이버 채널의 I/O 옵션을 제공합니다. 성능은 많은 Tier-1 어레이의 성능을 따라가며, 라이선스는 더욱 쉽게 이용할 수 있으며, NVMe-oF, iSCSI, 파이버 채널, SMB 및 NFS 전반에 걸쳐 광범위한 프로토콜 지원이 제공됩니다. InfiniBand를 고려하지만 예산이 부족한 기업을 위해 QSAN의 이더넷 방식은 100~200GbE 규모의 표준 장비에서 IB에 가까운 응답성을 제공합니다.
실제 애플리케이션 결과를 우선시하는 팀의 경우, QSAN의 긴 수명, 직관적인 소프트웨어, 깔끔한 하드웨어 설계 덕분에 XN4226D는 믿을 수 있는 올플래시 워크호스로 활용할 수 있습니다.
QSAN XN4 하드웨어
QSAN XN4 시리즈 스토리지 어레이는 26베이, 2U, 19인치 랙 호환 서버 섀시로 제공되며, 4코어 또는 8코어 Intel Xeon CPU를 탑재한 단일 또는 듀얼 컨트롤러 옵션을 통해 소규모 및 대규모 운영의 중복성 및 성능 요구 사항을 충족합니다. 26개 베이를 모두 채울 경우, 단일 XN4 시리즈 섀시는 2.5인치 U.2/U.3 NVMe SSD에 최대 798TB의 데이터를 저장할 수 있습니다. 최대 20개의 SAS 연결 확장 유닛을 추가하여 어레이의 총 용량을 최대 16.773PB까지 늘릴 수 있습니다.
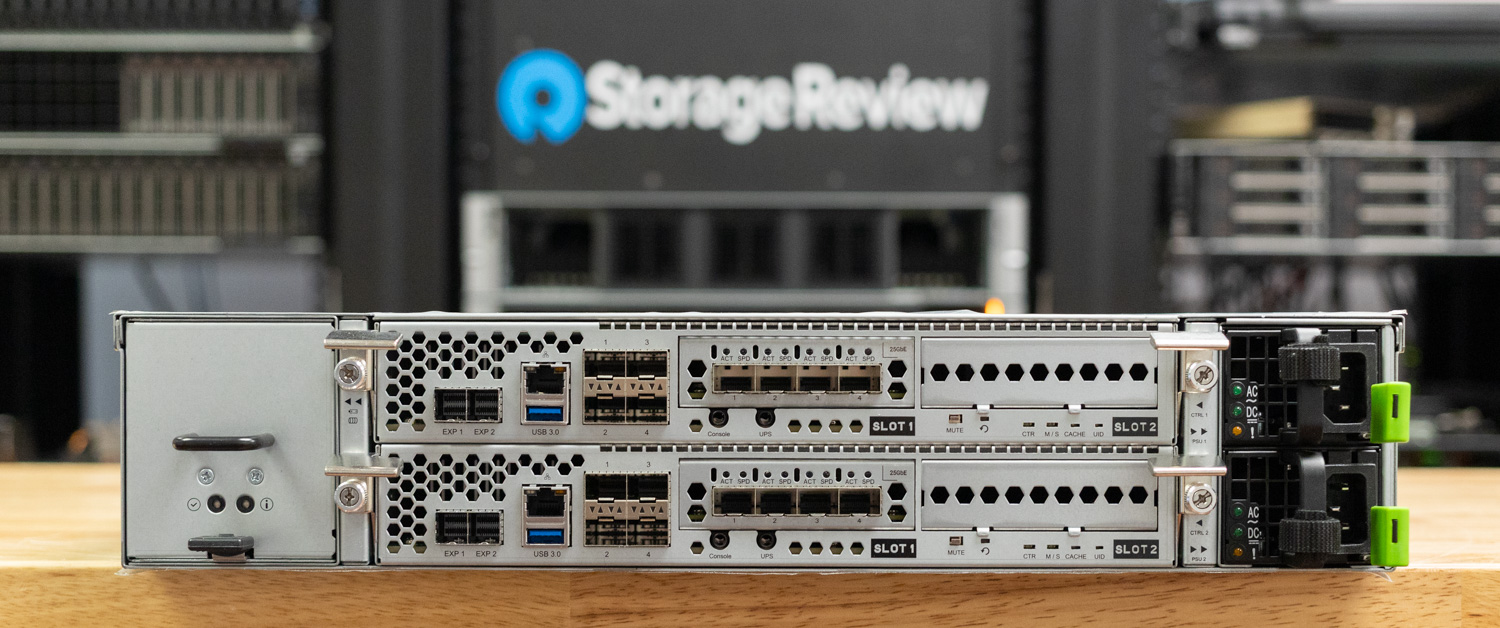
각 컨트롤러는 2.5Gbps RJ45 이더넷 포트 1개, 10Gbps SFP+ 포트 4개, 12Gbps SAS 와이드 포트 2개를 갖추고 있습니다. 10Gbps RJ45, 25Gbps SFP28, 100Gbps QSFP 포트로의 업그레이드 옵션도 제공됩니다. 16Gbps SFP+ 및 32Gbps SFP28 어댑터를 통해 파이버 채널 지원도 추가할 수 있습니다.
아래 표는 XN4226D-4C와 XN4226S-4C 스토리지 시스템의 사양을 비교한 것입니다. 이 시스템은 4C 모델로, 모델에 따라 듀얼 액티브 또는 단일 업그레이드 가능 컨트롤러를 탑재하도록 설계되었습니다. 더 높은 처리 능력이 필요한 구축 환경에서는 8C 버전도 제공됩니다.
| 스펙 | XN4226D-4C | XN4226S-4C |
|---|---|---|
| 모델 이름 | XN4226D-4C | XN4226S-4C |
| 아키텍처 | 듀얼 액티브 컨트롤러 | 단일 업그레이드 가능 컨트롤러 |
| CPU | 인텔® 제온® 4코어 × 2 | 인텔® 제온® 4코어 |
| 메모리 | ||
| 메모리 모듈 사전 설치 | 32GB DDR4 RDIMM | 16GB DDR4 RDIMM |
| 총 메모리 슬롯 | 16 | 8 |
| 메모리 확장 가능 | 2,048GB | 1,024GB |
| 스토리지 | ||
| 드라이브 베이 | 2.5인치 슬롯 × 26 | 2.5인치 슬롯 × 26 |
| 확장 장치가 있는 최대 드라이브 베이 | 546 | 546 |
| 호환 가능한 드라이브 유형 | 2.5인치 듀얼 포트 U.2 / U.3 NVMe SSD 2.5인치 SAS SSD(확장 장치용) 3.5인치 SAS HDD(확장 장치용) |
2.5인치 싱글 포트 U.2/U.3 NVMe SSD 2.5인치 SAS SSD(확장 장치용) 3.5인치 SAS HDD(확장 장치용) |
| 드라이브 인터페이스 | U.2 NVMe(PCIe Gen 4) SAS 12Gb/s(확장 장치용) |
U.2 NVMe(PCIe Gen 4) SAS 12Gb/s(확장 장치용) |
| 최대 내부 원시 용량 | 798TB | 798TB |
| 확장을 통한 최대 원시 용량 | 16,773TB | 16,773TB |
| 핫 스왑 가능 드라이브 | 가능 | 가능 |
| 연결 포트 | ||
| PCIe 확장 | (Gen 4×8 슬롯) × 4 | (Gen 4×8 슬롯) × 2 |
| 2.5GbE RJ45 LAN 포트 | 2 (선상) | 1 (선상) |
| 10GbE SFP+ LAN 포트 | 8(탑재) / 16(옵션) | 4(탑재) / 8(옵션) |
| 10GbE RJ45 LAN 포트 | 16 (옵션) | 8 (옵션) |
| 25GbE SFP28 LAN 포트 | 16 (옵션) | 8 (옵션) |
| 100GbE QSFP LAN 포트 | 8 (옵션) | 4 (옵션) |
| 16Gb SFP+ 파이버 채널 | 16 (옵션) | 8 (옵션) |
| 32Gb SFP28 파이버 채널 | 16 (옵션) | 8 (옵션) |
| 확장 및 외부 포트 | ||
| 12Gb/s SAS 와이드 포트 | 4 (선상) | 2 (선상) |
| USB 포트 | 1(전면) / 2(후면) | 1(전면) / 1(후면) |
| 기타 | 콘솔 포트 × 2, 서비스 포트 × 2 | 콘솔 포트 × 1, 서비스 포트 × 1 |
| 소프트웨어 사양 | ||
| 스토리지 OS | QSM 4 | QSM 4 |
| RAID 유형 | 0 / 1 / 5 / 6 / 10 / 50 / 60 / 5EE / 6EE / 50EE / 60EE | |
| 스토리지 효율성 | 씬 프로비저닝/압축 및 중복 제거(옵션) | |
| 소프트웨어 가속 | SSD 캐시 / 자동 계층화 / RDMA | |
| 데이터 보호 | 스냅샷 / 비동기 / 동기(옵션) | |
| 백업 서비스 | Rsync / S3 백업 / 클라우드 백업 / XMirror* / Microsoft 365 이메일 백업 | |
| 보안 | SSL / SSH / iSCSI CHAP / ISE 및 SED / WORM / RBAC / Windows ACL / 바이러스 백신 | |
| 지원 프로토콜 | CIFS / NFS / FTP / WebDAV / iSCSI / FCP / NVMe-oF | |
| 웹 UI / Windows AD / LDAP / RESTful API / SES / LCM | ||
| 외관 | ||
| 치수(높이 × 너비 × 깊이) | 88 × 438 × 573mm | 88 × 438 × 573mm |
| 순 무게 | 19.6kg | 16.5kg |
| 총 중량 | 28.6kg | 25.5kg |
| 기타 | ||
| 메모리 보호 | 캐시-플래시 모듈(내장) | |
| 시스템 팬 | 8의 개 | 4의 개 |
| 전원 공급 장치 | 850W × 2(80 플러스 플래티넘) | |
| 전원 입력 | 100~240VAC, 50/60Hz | |
| 전력 소비 | 812W / 2,770BTU | |
| 인증 | CE / FCC / BSMI | |
| 표준 보증 | 시스템: 5년 | 캐시-투-플래시 모듈: 1년 | |
QSAN XN4 기능
XN4 어레이는 고성능 컴퓨팅 및 데이터 집약적인 AI 모델을 지원하는 데 필요한 최신 연결 프로토콜을 기본으로 제공하며, 여기에는 TCP 및 RDMA를 통해 제공되는 NVMe-oF(NVMe over Fabrics)가 포함됩니다. iSCSI, NFS, FCP, CIFS/SMB, FTP 및 WebDAV를 통한 연결도 가능하므로, 기존 시스템과 최신 시스템이 혼합된 데이터 센터의 블록 및 파일 스토리지 요구 사항을 충족할 수 있습니다.
NVMe-oF의 장점
iSCSI, NFS, FCP와 같은 프로토콜이 엔터프라이즈 스토리지 애플리케이션에서 여전히 널리 사용되고 있지만, NVMe-oF는 지연 시간을 크게 개선합니다. NVMe 표준은 시스템의 PCIe 버스에 직접 연결된 SSD(Solid State Drive)를 위해 처음부터 설계되었습니다. 반면, iSCSI 및 NFS와 같은 기존 프로토콜은 기존 하드 디스크 드라이브의 한계와 느린 액세스 시간을 고려하여 개발되었습니다. NVMe-oF 기술은 거의 모든 경우에서 기존 연결 프로토콜보다 더 높은 대역폭과 빠른 액세스 시간을 제공하여 성능을 향상시킵니다. 또한 NVMe-oF는 RDMA(Remote Direct Memory Access) 기능을 갖춘 네트워크 인터페이스를 활용하여 CPU 처리 없이 대상 컴퓨터의 메모리로 직접 데이터를 전송할 수 있습니다.
데이터 감소 및 최적화 기능
XN4 스토리지 어레이의 고성능 하드웨어 스택은 스토리지 관리자들에게 널리 알려져 있고 높이 평가받는 다양한 소프트웨어 기능으로 더욱 강화됩니다. 씬 프로비저닝, 압축 및 중복 제거 기능을 통해 기업은 SAN 용량을 극대화할 수 있으며, SSD 캐싱 및 자동 스토리지 계층화 기능은 자주 사용되는 파일 및 객체의 액세스 시간을 단축합니다. 또한, 이 어플라이언스의 QSM 4 운영 체제는 내장된 스냅샷 도구를 사용하여 변경 사항을 쉽게 테스트하고 롤백할 수 있도록 지원합니다.
보안 및 관리 기능
QSAN은 XN4 제품군을 통해 고객의 변화하는 보안 및 관리 요구 사항을 반영했습니다. XN4는 ISE(Instant Secure Erase) 및 SED(Self-Encrypting Drives)와 호환되며, SSL/TLS, 역할 기반 액세스 제어(RBAC)를 통한 인증, Active Directory/LDAP 서버 지원 등의 보안 프로토콜과도 호환됩니다. 이 어레이는 HTTPS 웹 UI 또는 RESTful API를 사용하여 관리할 수 있으며, Ansible이나 Terraform과 같은 다양한 도구를 통해 자동화를 구현할 수 있습니다.
QSM 4 관리
QSAN XN4 시리즈의 운영 체제인 QSM 4는 모든 경험 수준의 스토리지 관리자에게 스토리지 어레이의 설정 및 관리를 간편하게 해줍니다. 즉시 배포가 간편합니다. 빠른 풀 생성, 직관적인 호스트 할당, 웹 UI 및 REST API를 통한 간편한 관리 기능을 제공하며, 이 모든 기능은 스토리지 전문 지식이 부족한 소규모 IT 팀을 위해 설계되었습니다.
대시보드 화면에는 시스템 상태 정보와 서버에서 기록한 최근 이벤트가 표시됩니다.
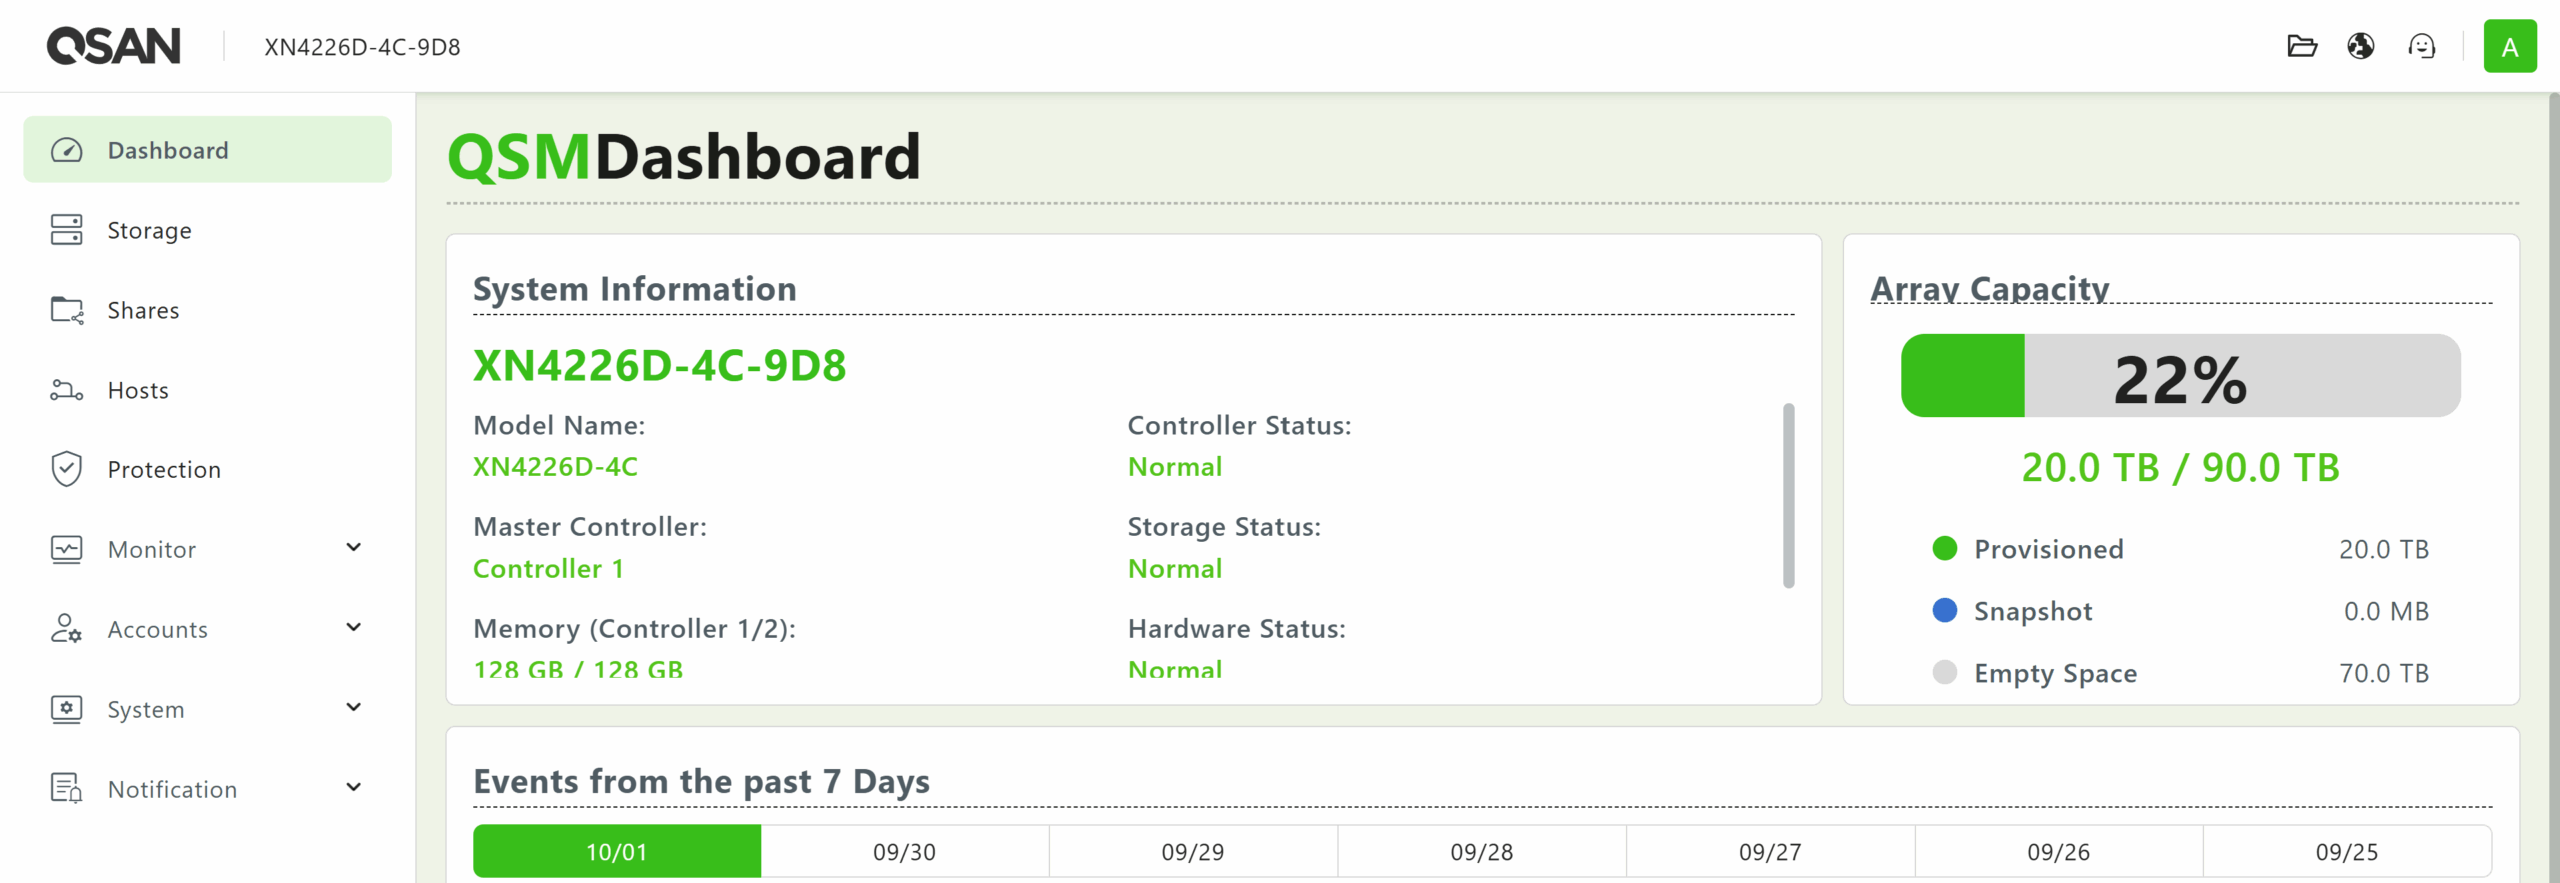
로그인 후 사용자는 SAN 상태를 간략하게 확인할 수 있는 대시보드 화면을 볼 수 있습니다. 여기에서 왼쪽 패널 목록의 하위 메뉴로 바로 이동할 수 있습니다.
저장소 메뉴에서 관리자는 드라이브 풀과 관련 볼륨을 만들고 관리할 수 있습니다.
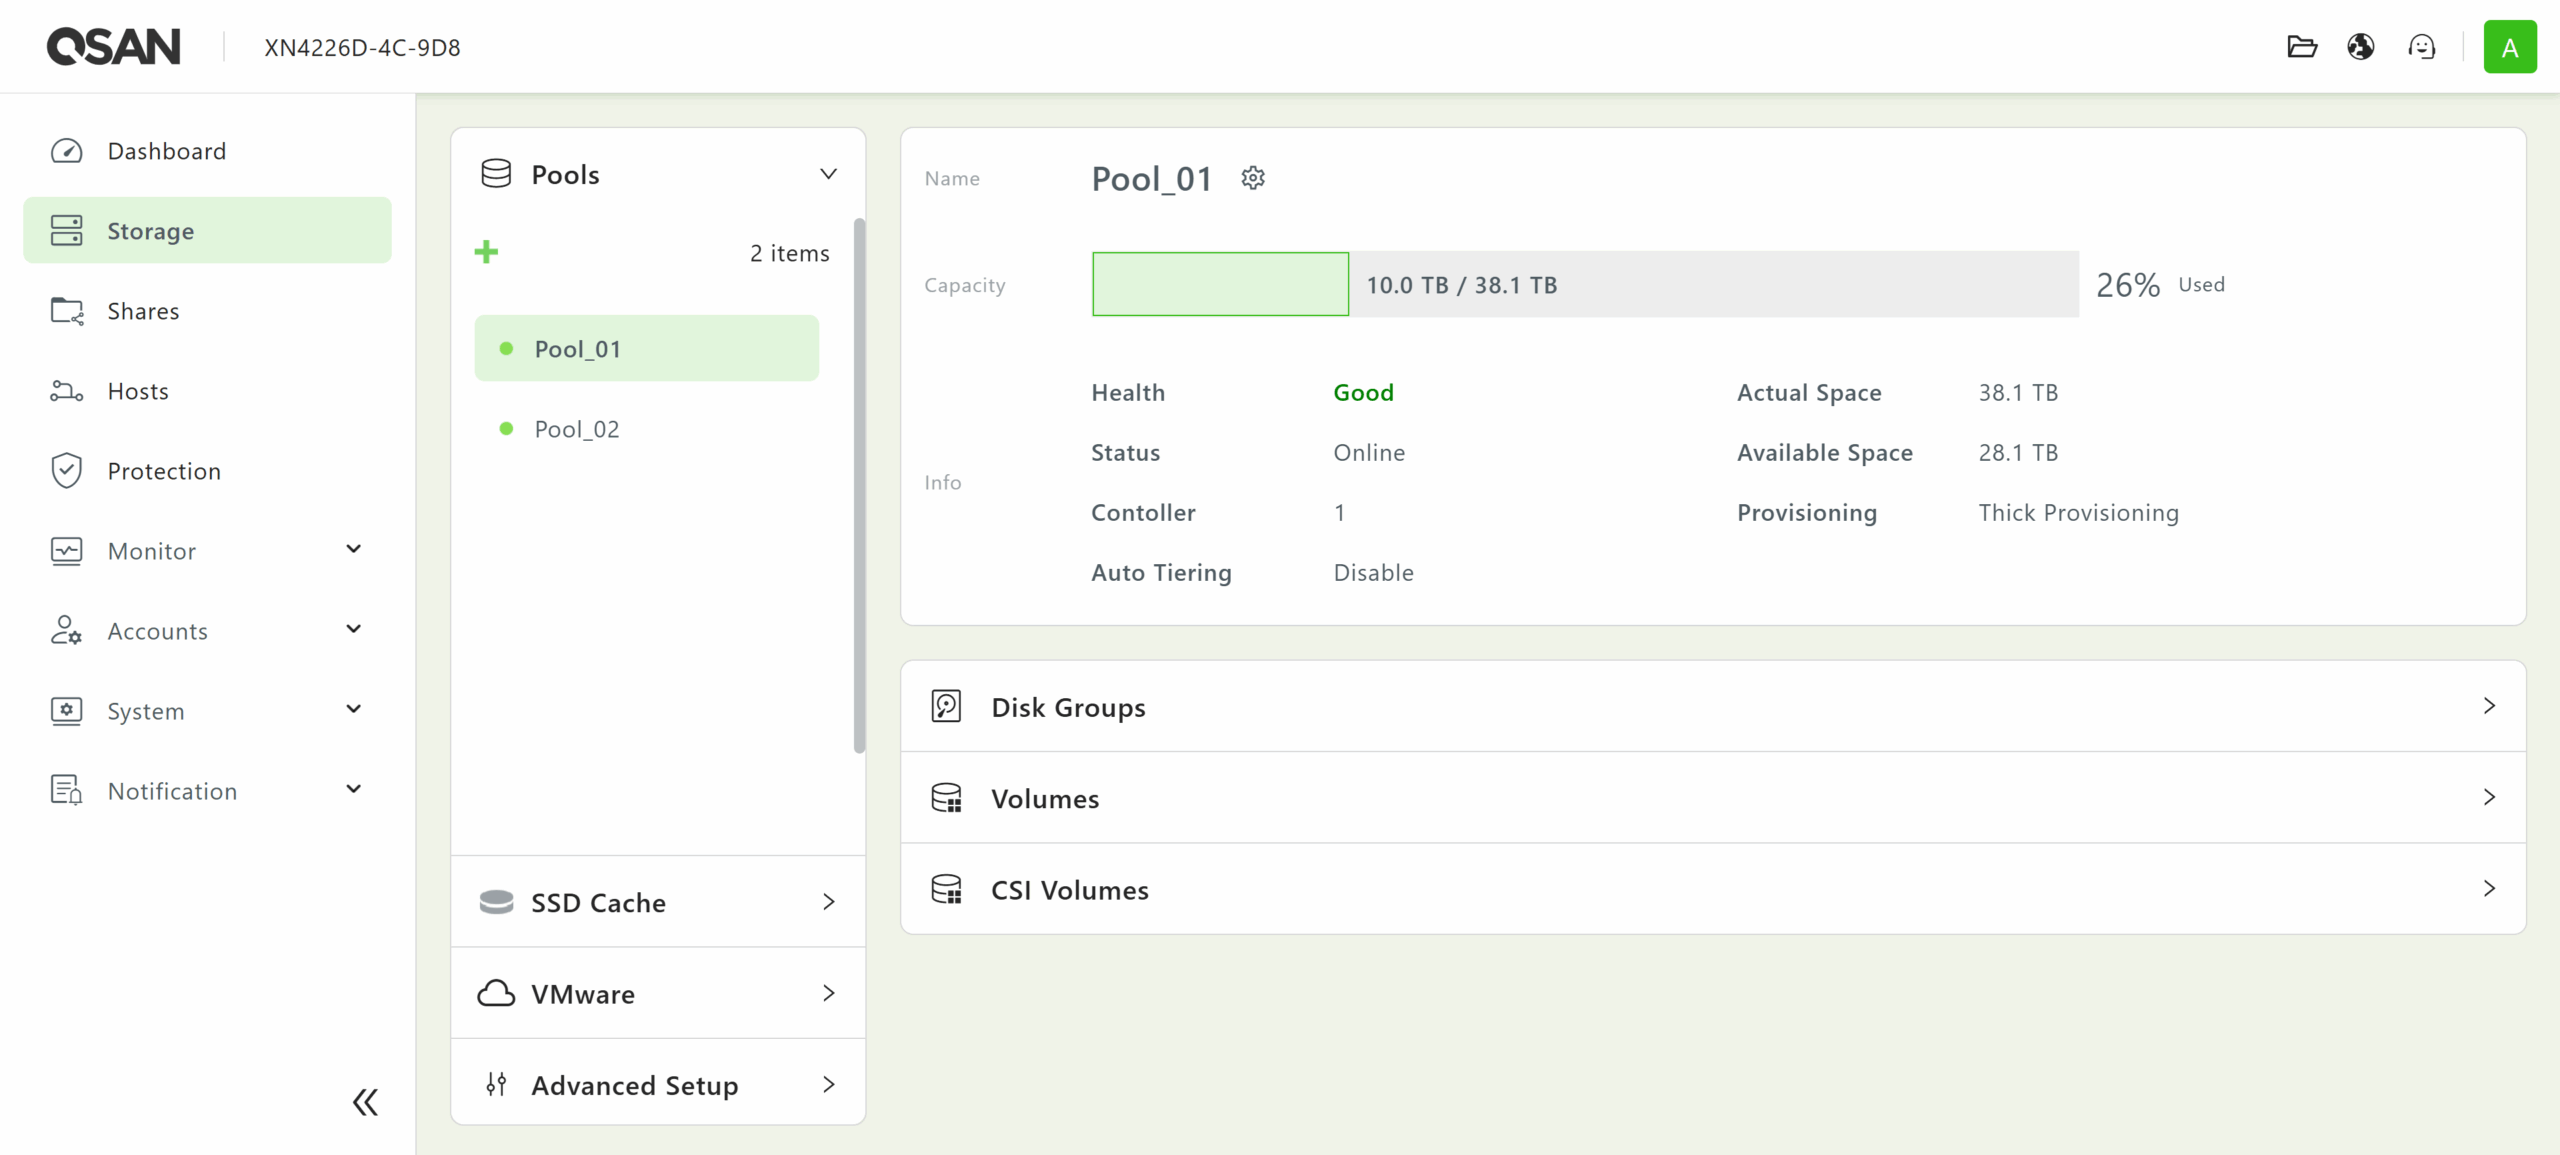
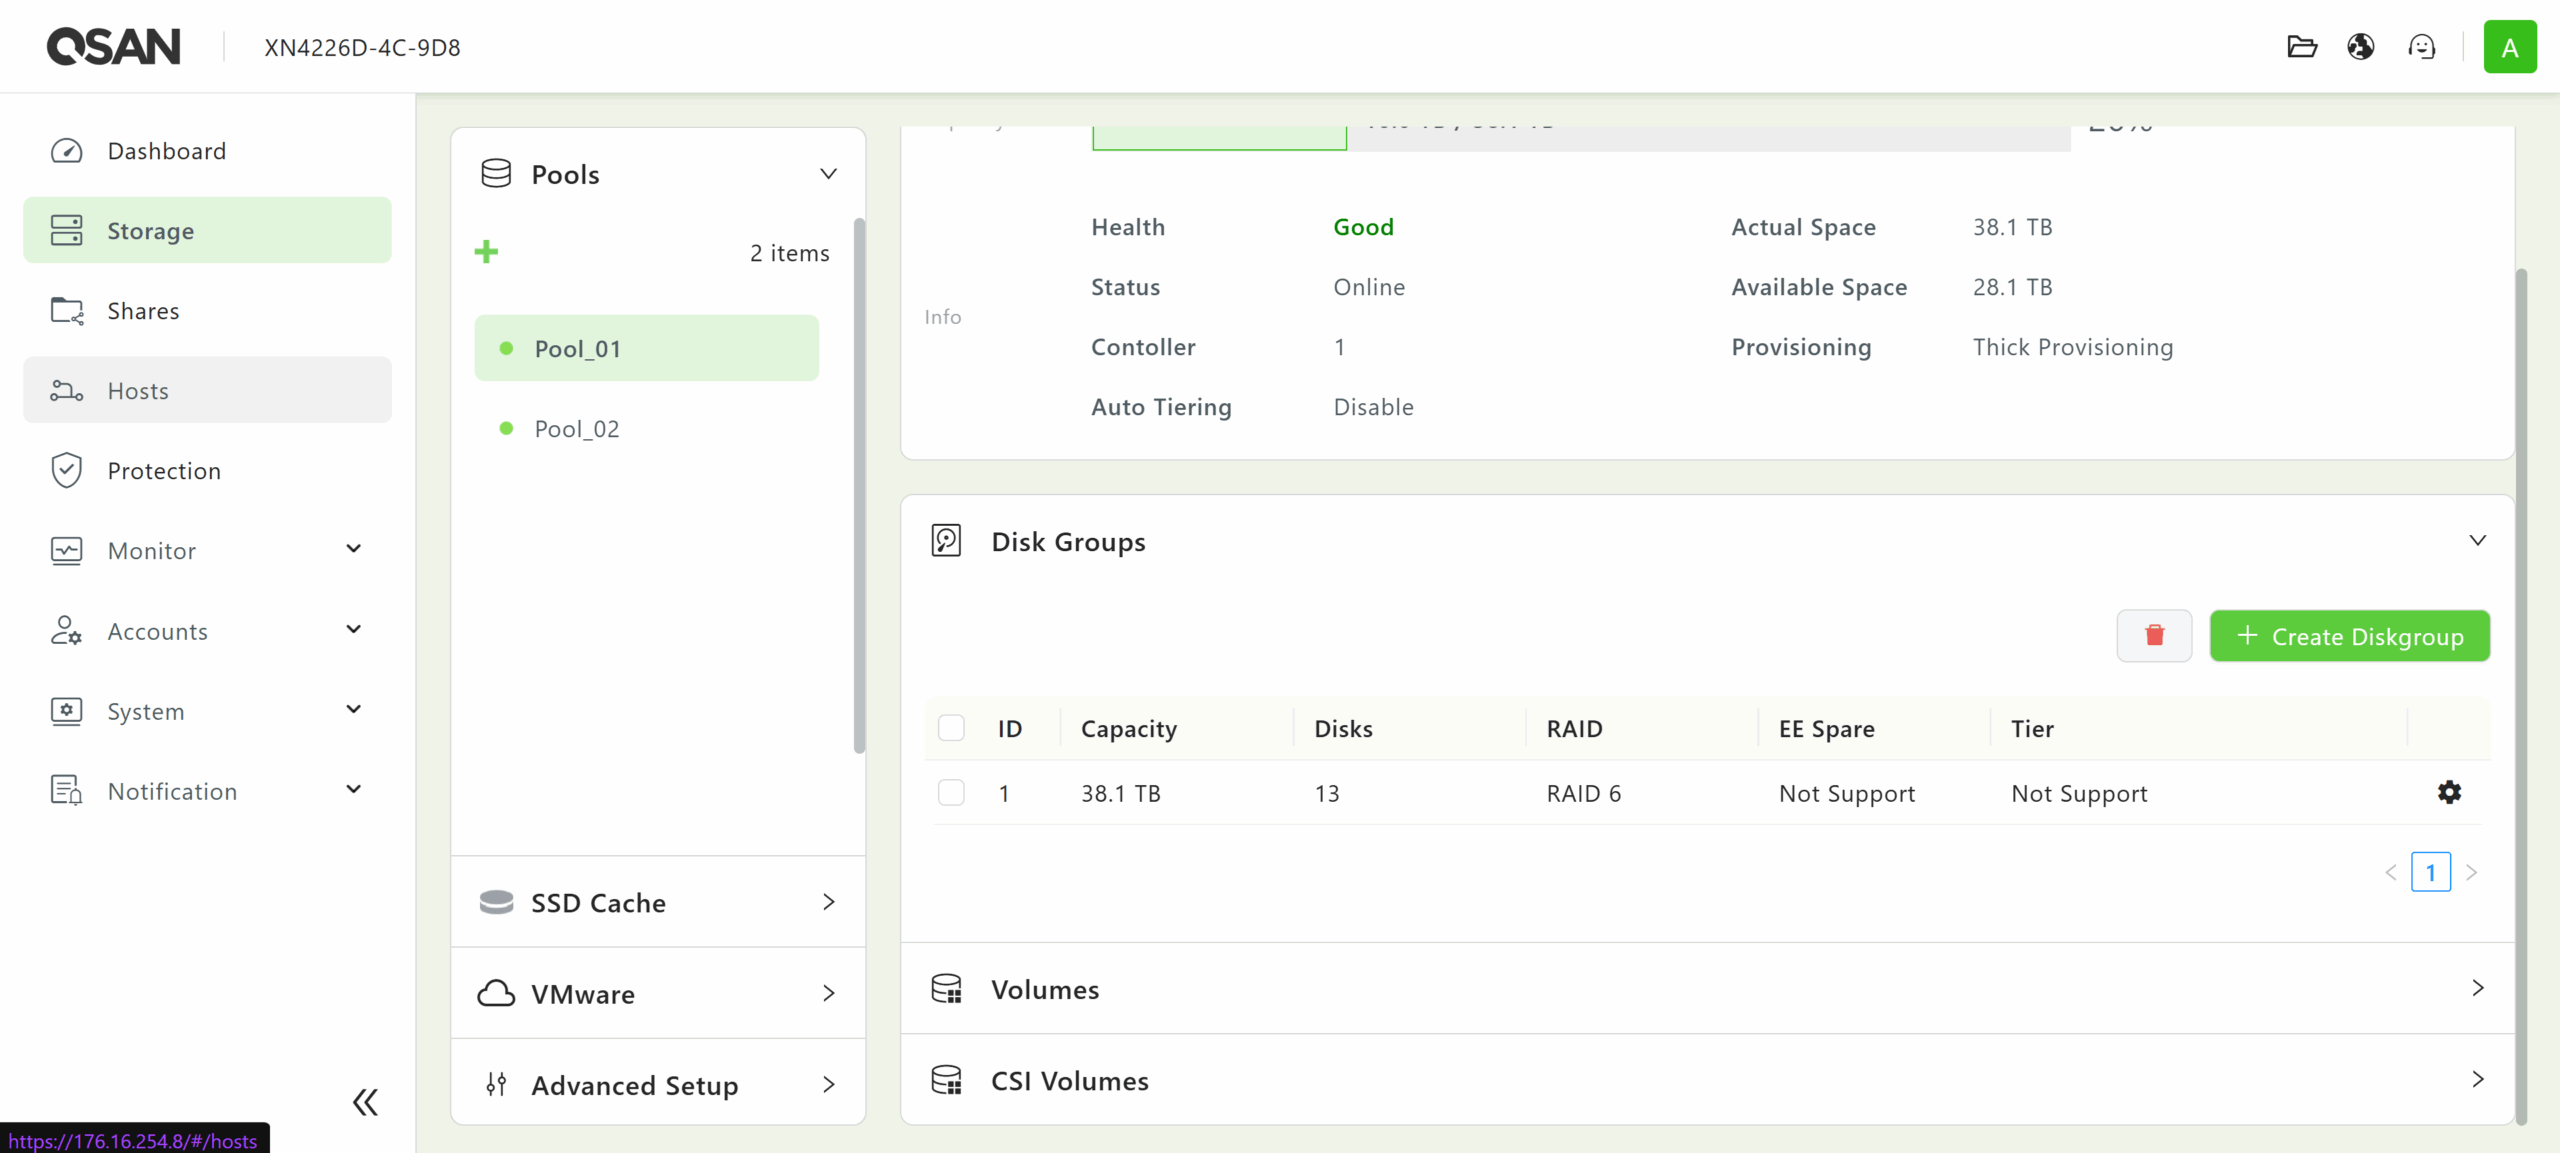
각 풀을 구성하는 디스크 그룹은 '디스크 그룹' 탭에서 관리할 수 있습니다. 이 기능은 이미 할당된 드라이브 수에 따라 0, 1, 5, 6, 10, 50, 60, 5EE, 6EE, 50EE, 60EE 등 다양한 RAID 레벨을 지원합니다.
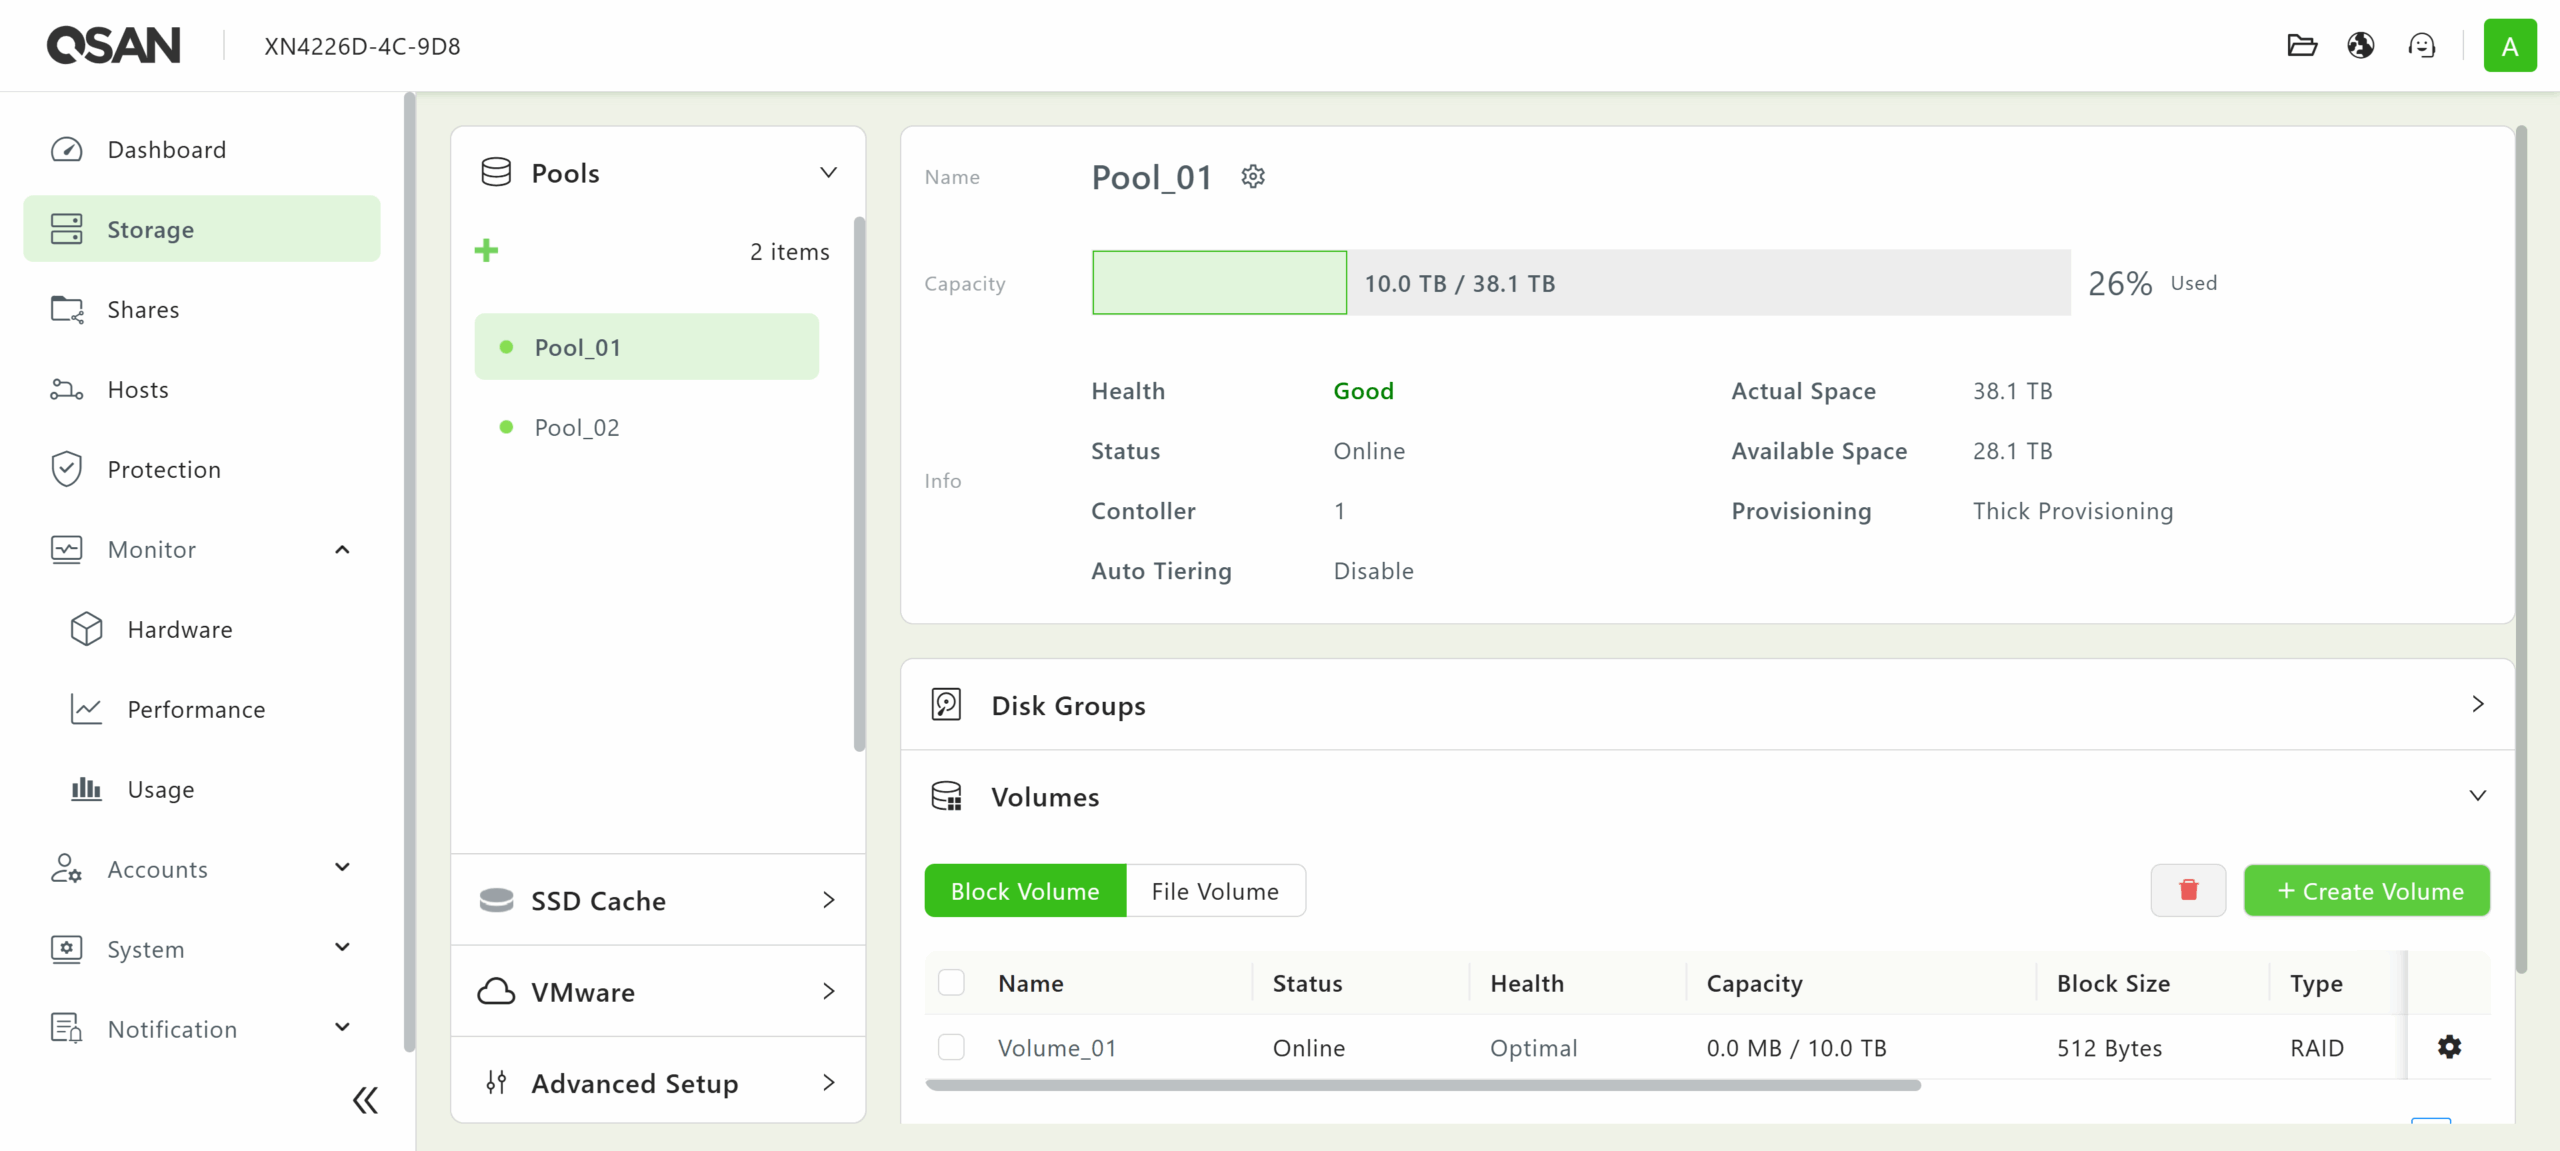
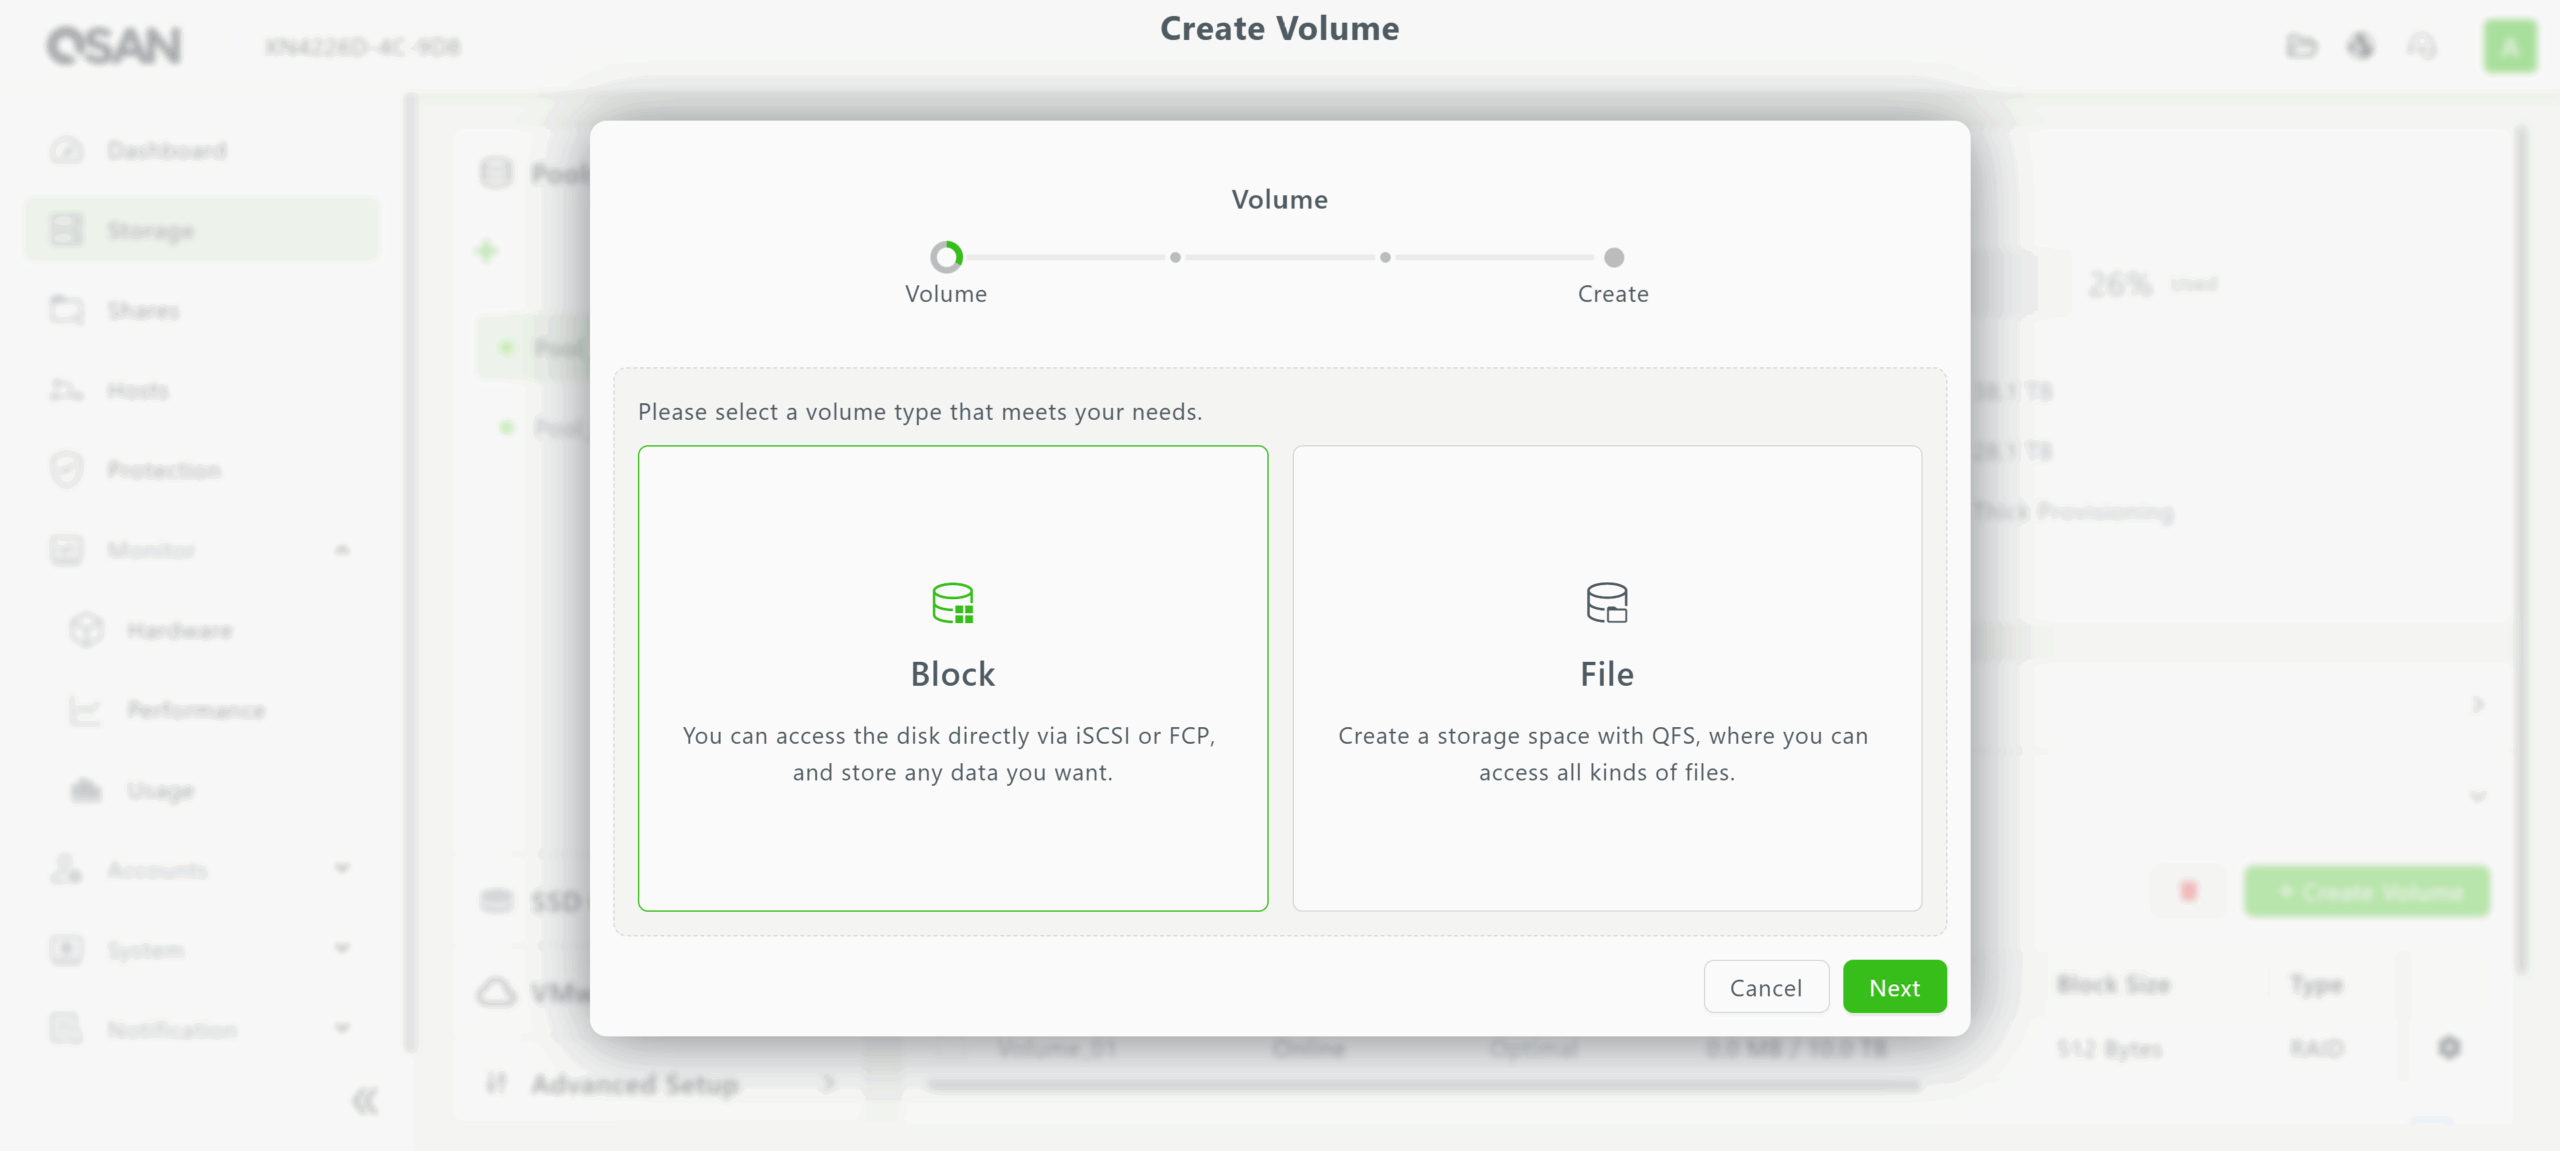
블록 및 파일 저장 요구 사항에 맞는 볼륨을 풀 위에 구축할 수 있습니다. 마법사를 사용하여 연결된 클라이언트의 요구 사항에 맞게 각 볼륨의 용량과 블록 크기를 설정할 수 있습니다.
목록을 아래로 내려가면 '공유' 메뉴를 사용하여 파일 볼륨 위에 공유 객체를 생성할 수 있습니다. 지원되는 공유 프로토콜로는 CIFS(SMB), FTP, NFS, WebDAV가 있습니다.
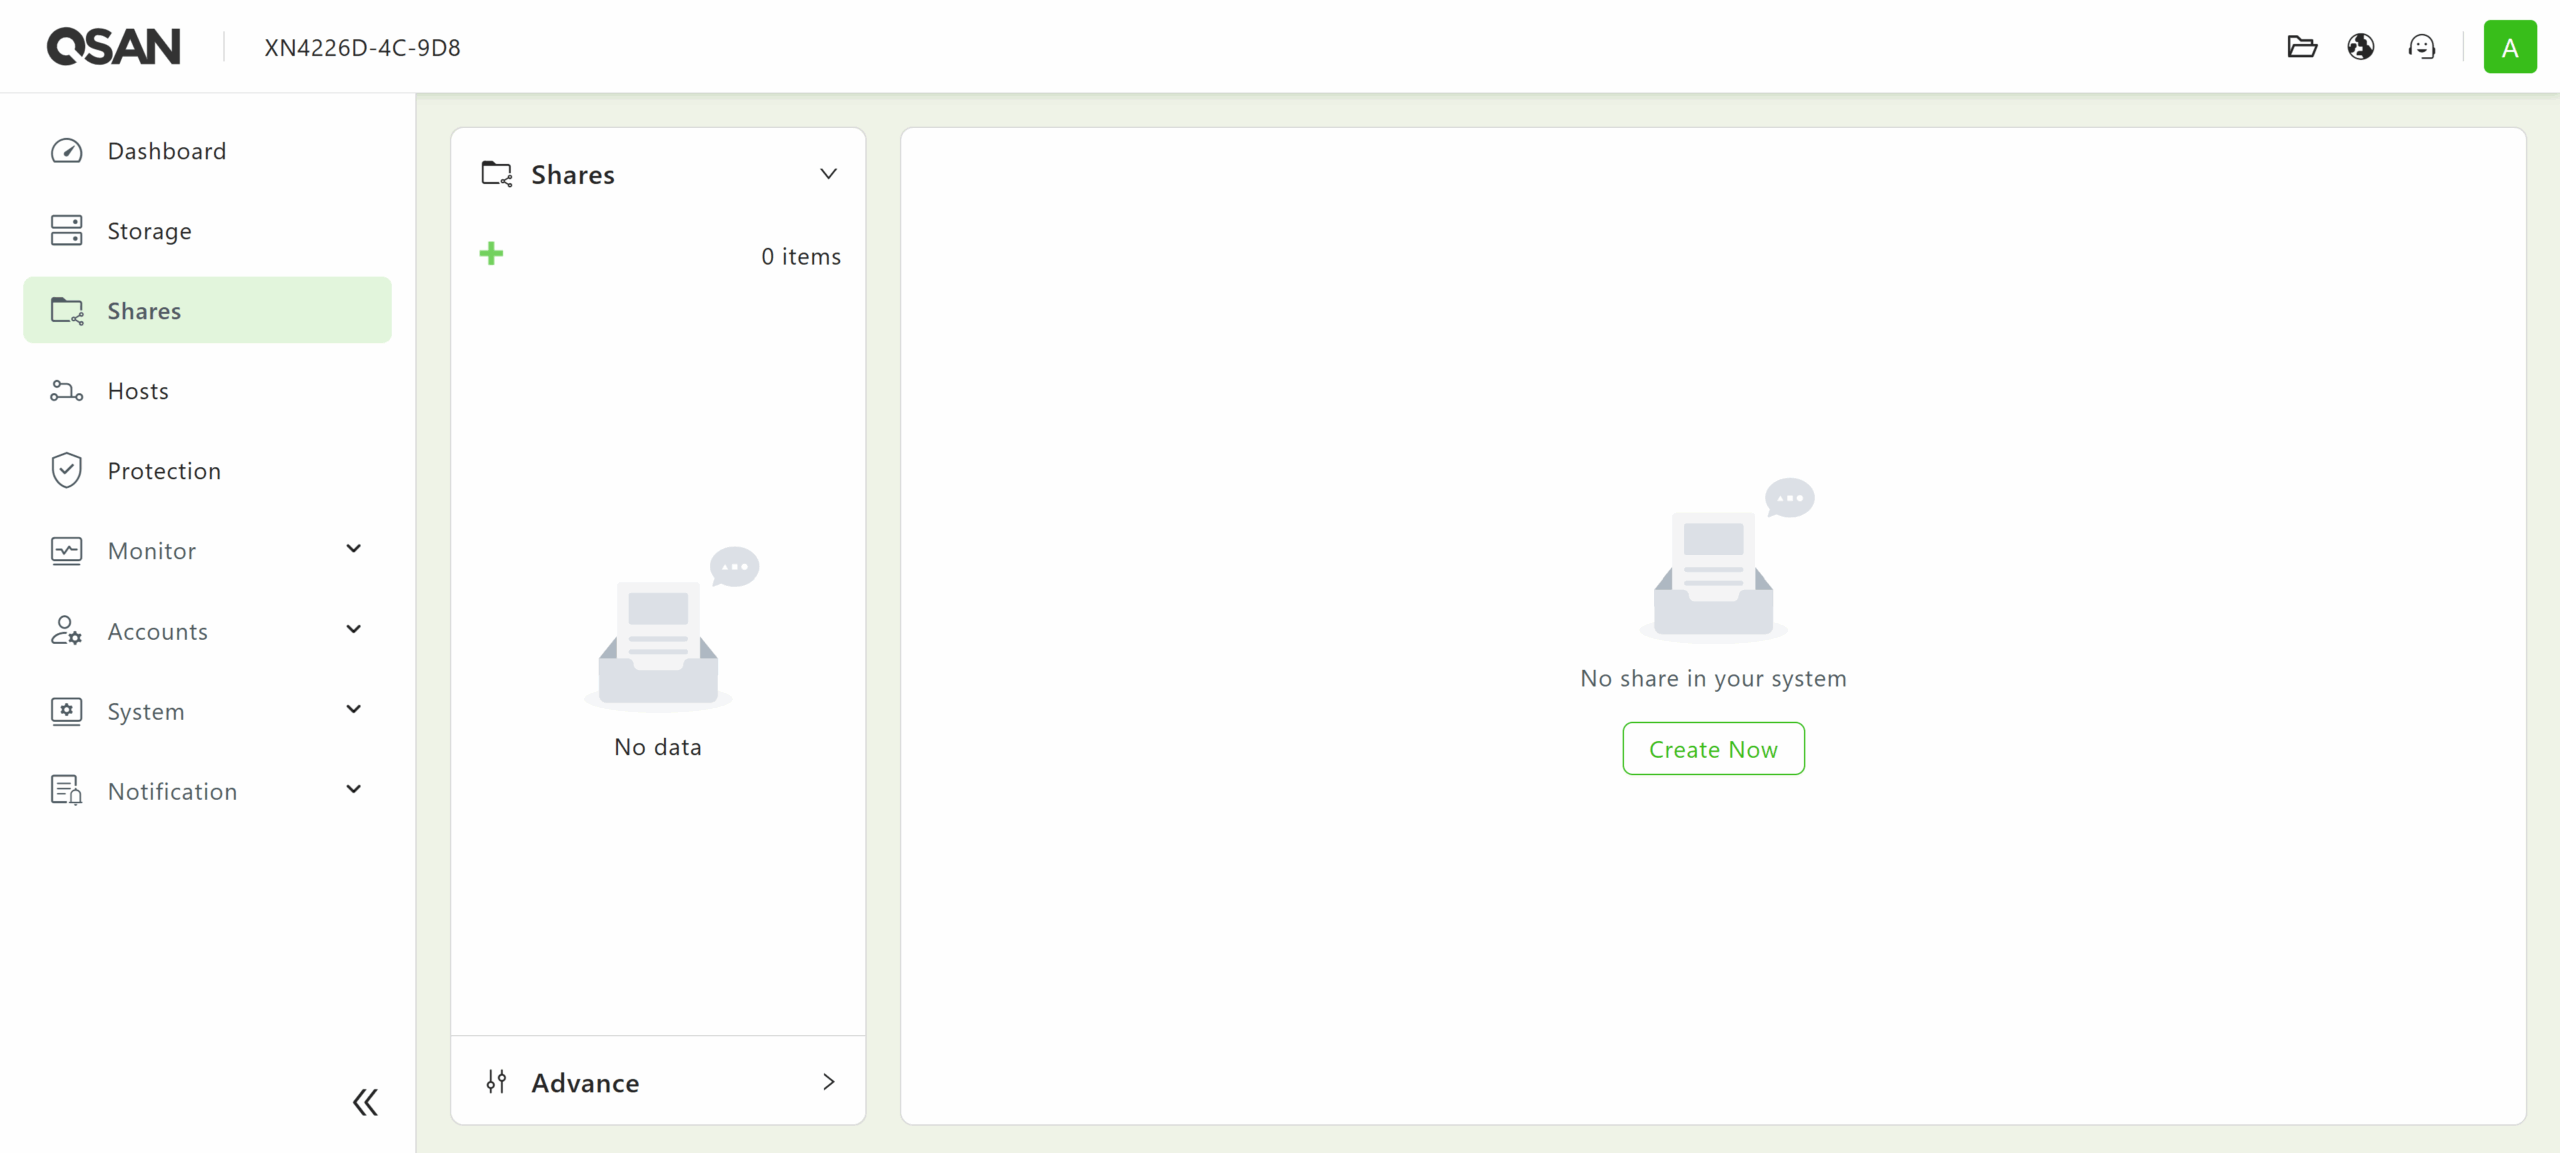 QSM 4는 새로운 공유를 생성할 때 두 가지 옵션을 제공합니다. 여러 사용자가 액세스할 수 있는 파일을 호스팅하기 위한 표준 네트워크 공유와 개별적으로만 액세스할 수 있는 사용자의 홈 폴더를 보관하도록 설계된 사용자 홈 공유입니다.
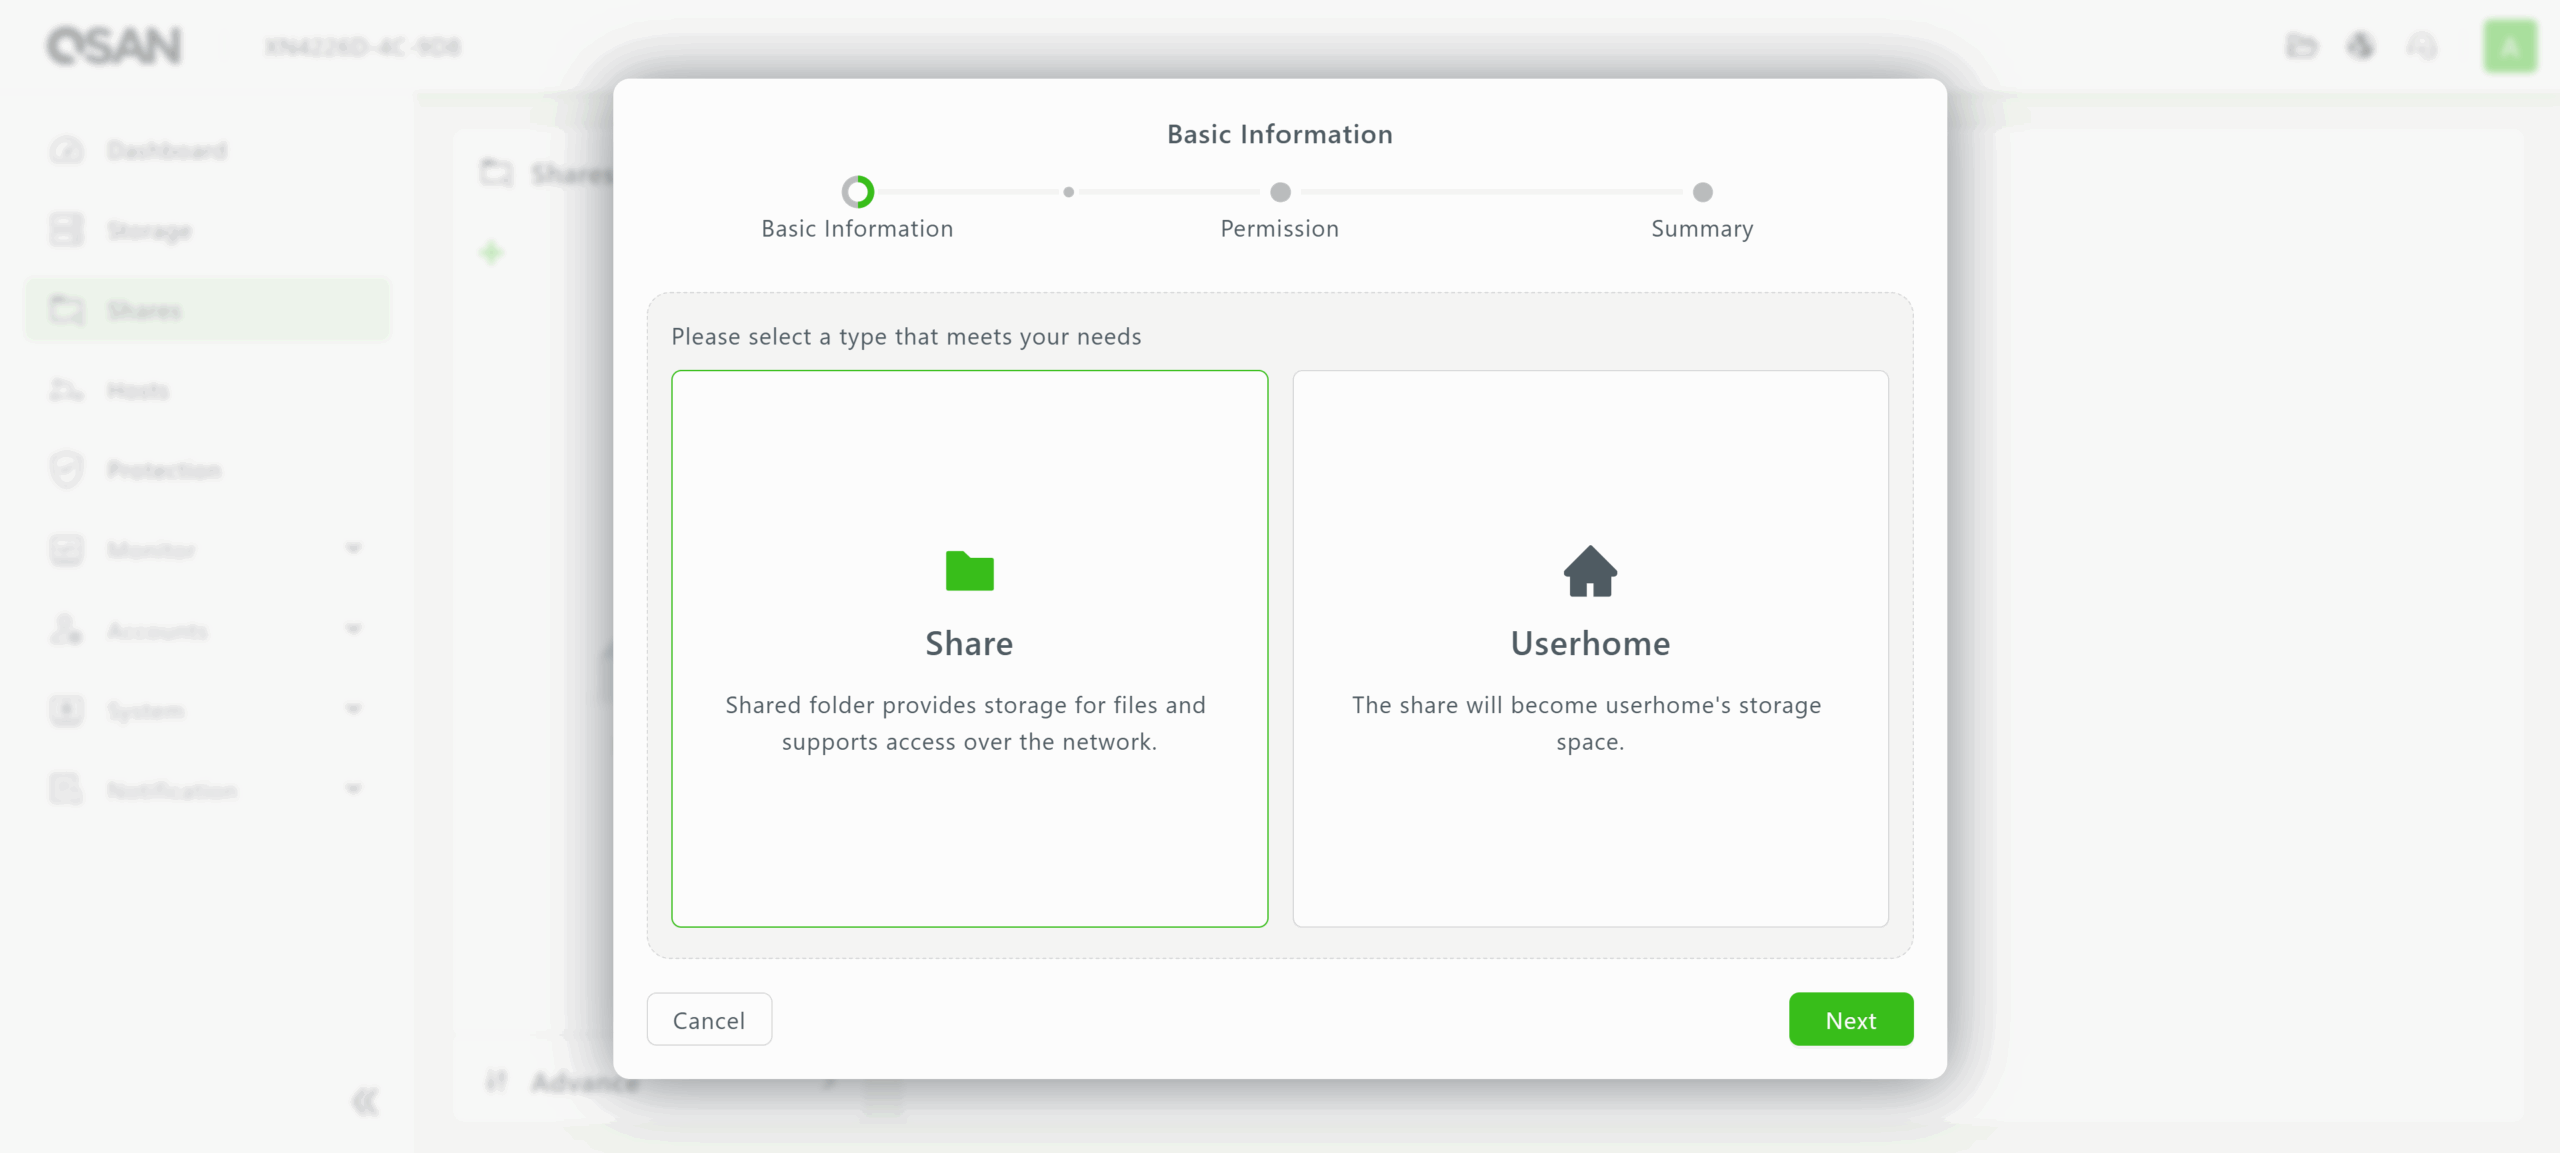
블록 볼륨 또는 파일 볼륨과 공유가 생성되면 호스트 메뉴에서 IP 주소 또는 호스트 이름을 지정해야 합니다. 호스트는 아래 스크린샷과 같이 블록 또는 파일(공유) 스토리지에 해당하는지 여부에 따라 구성됩니다.
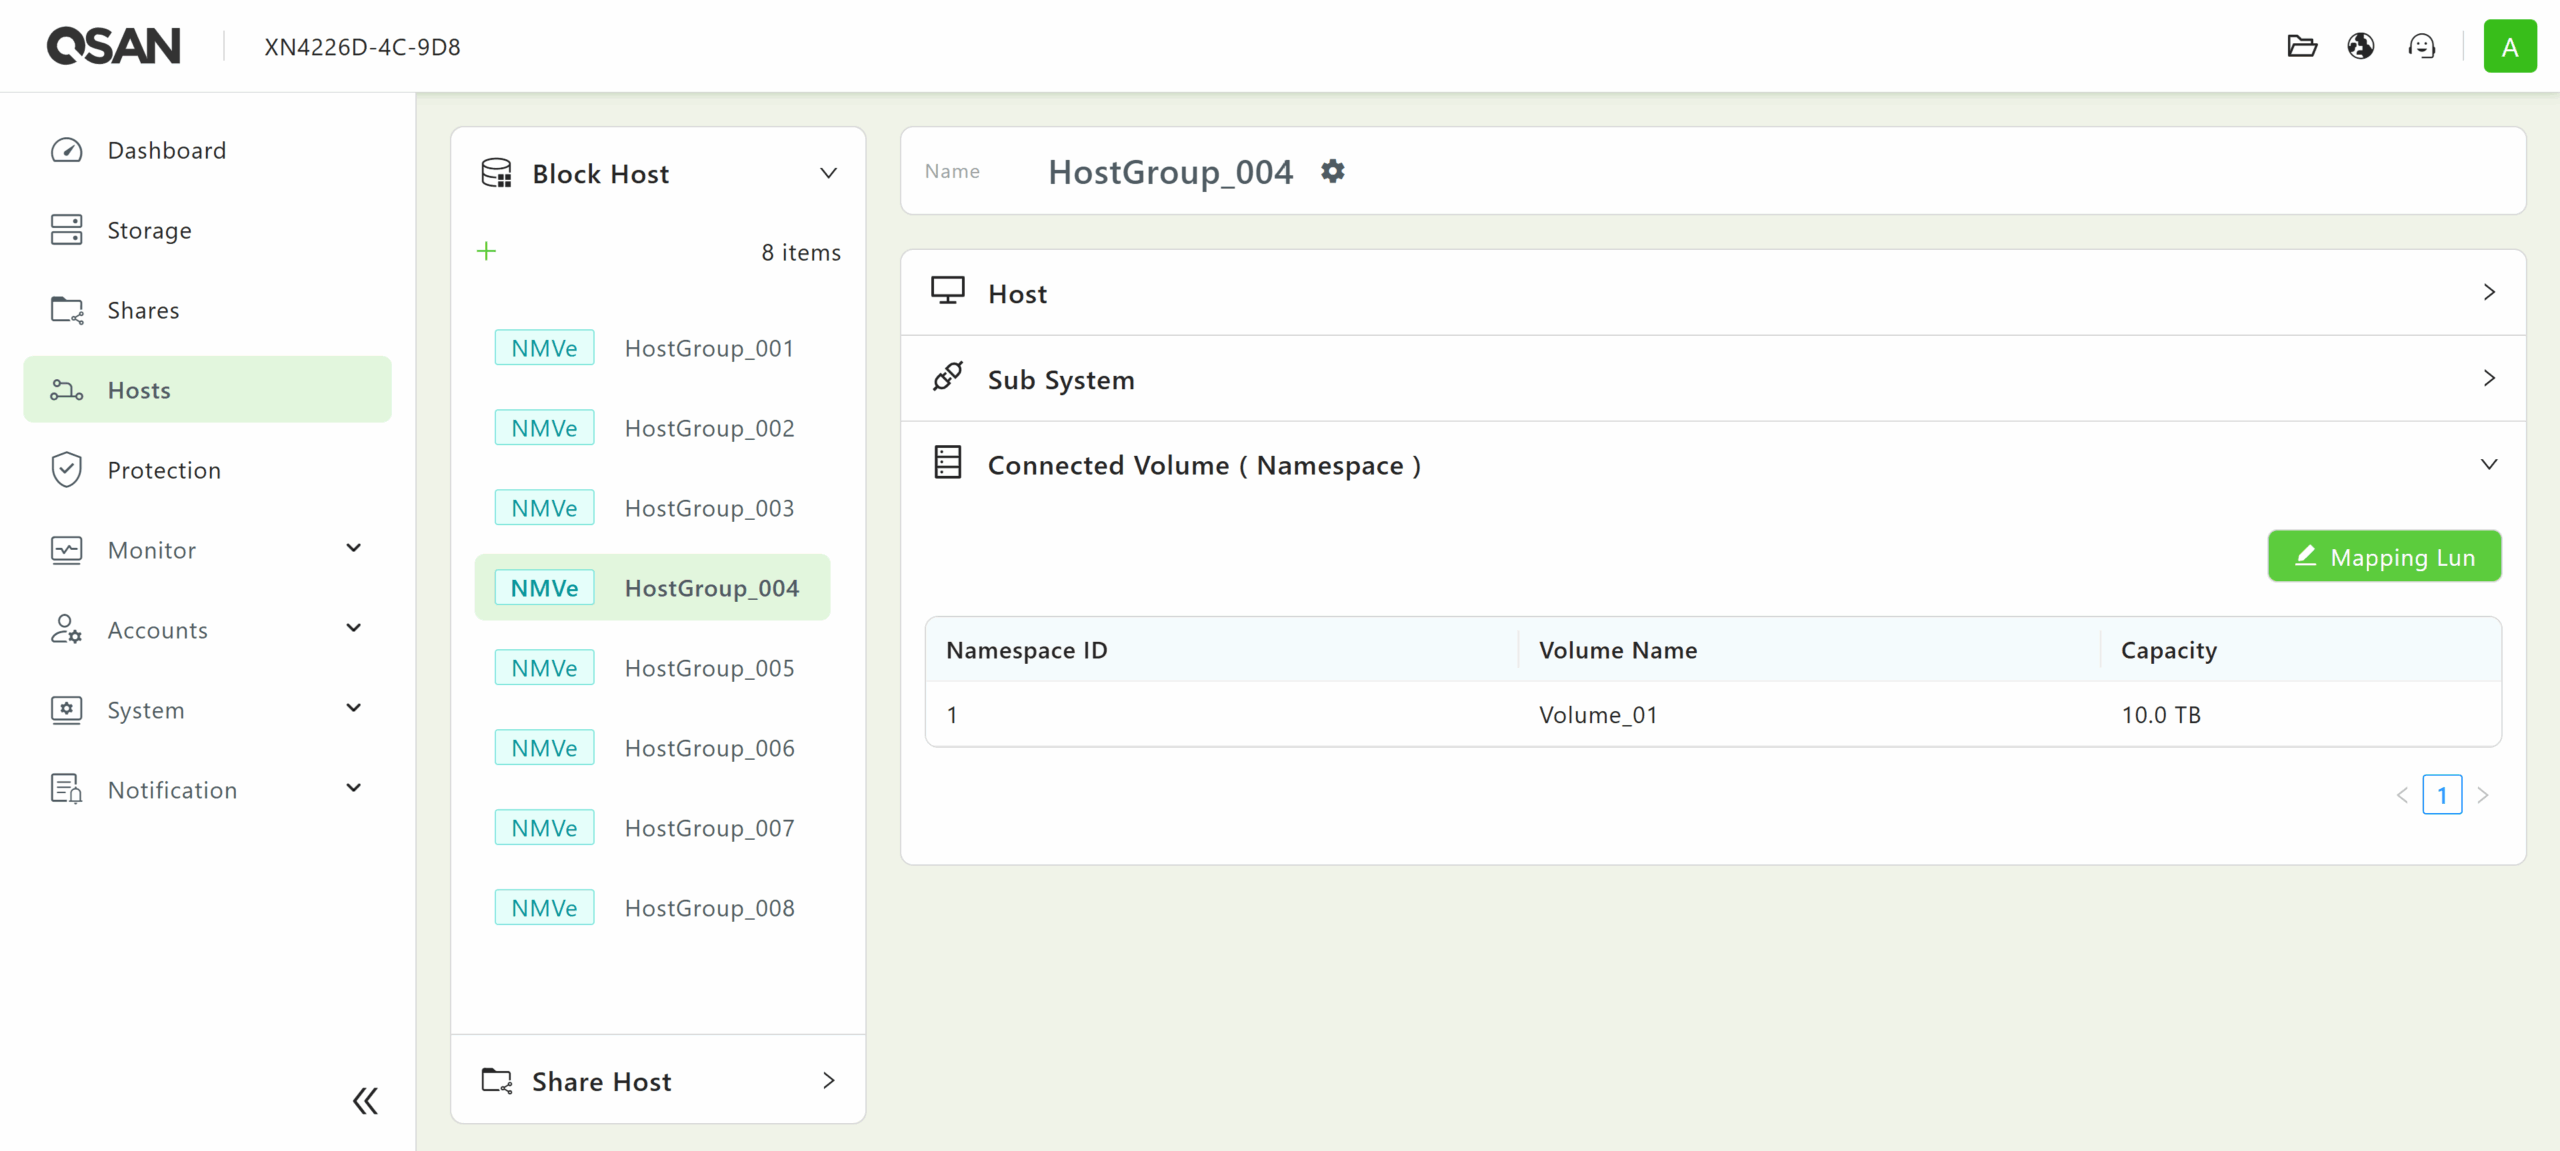
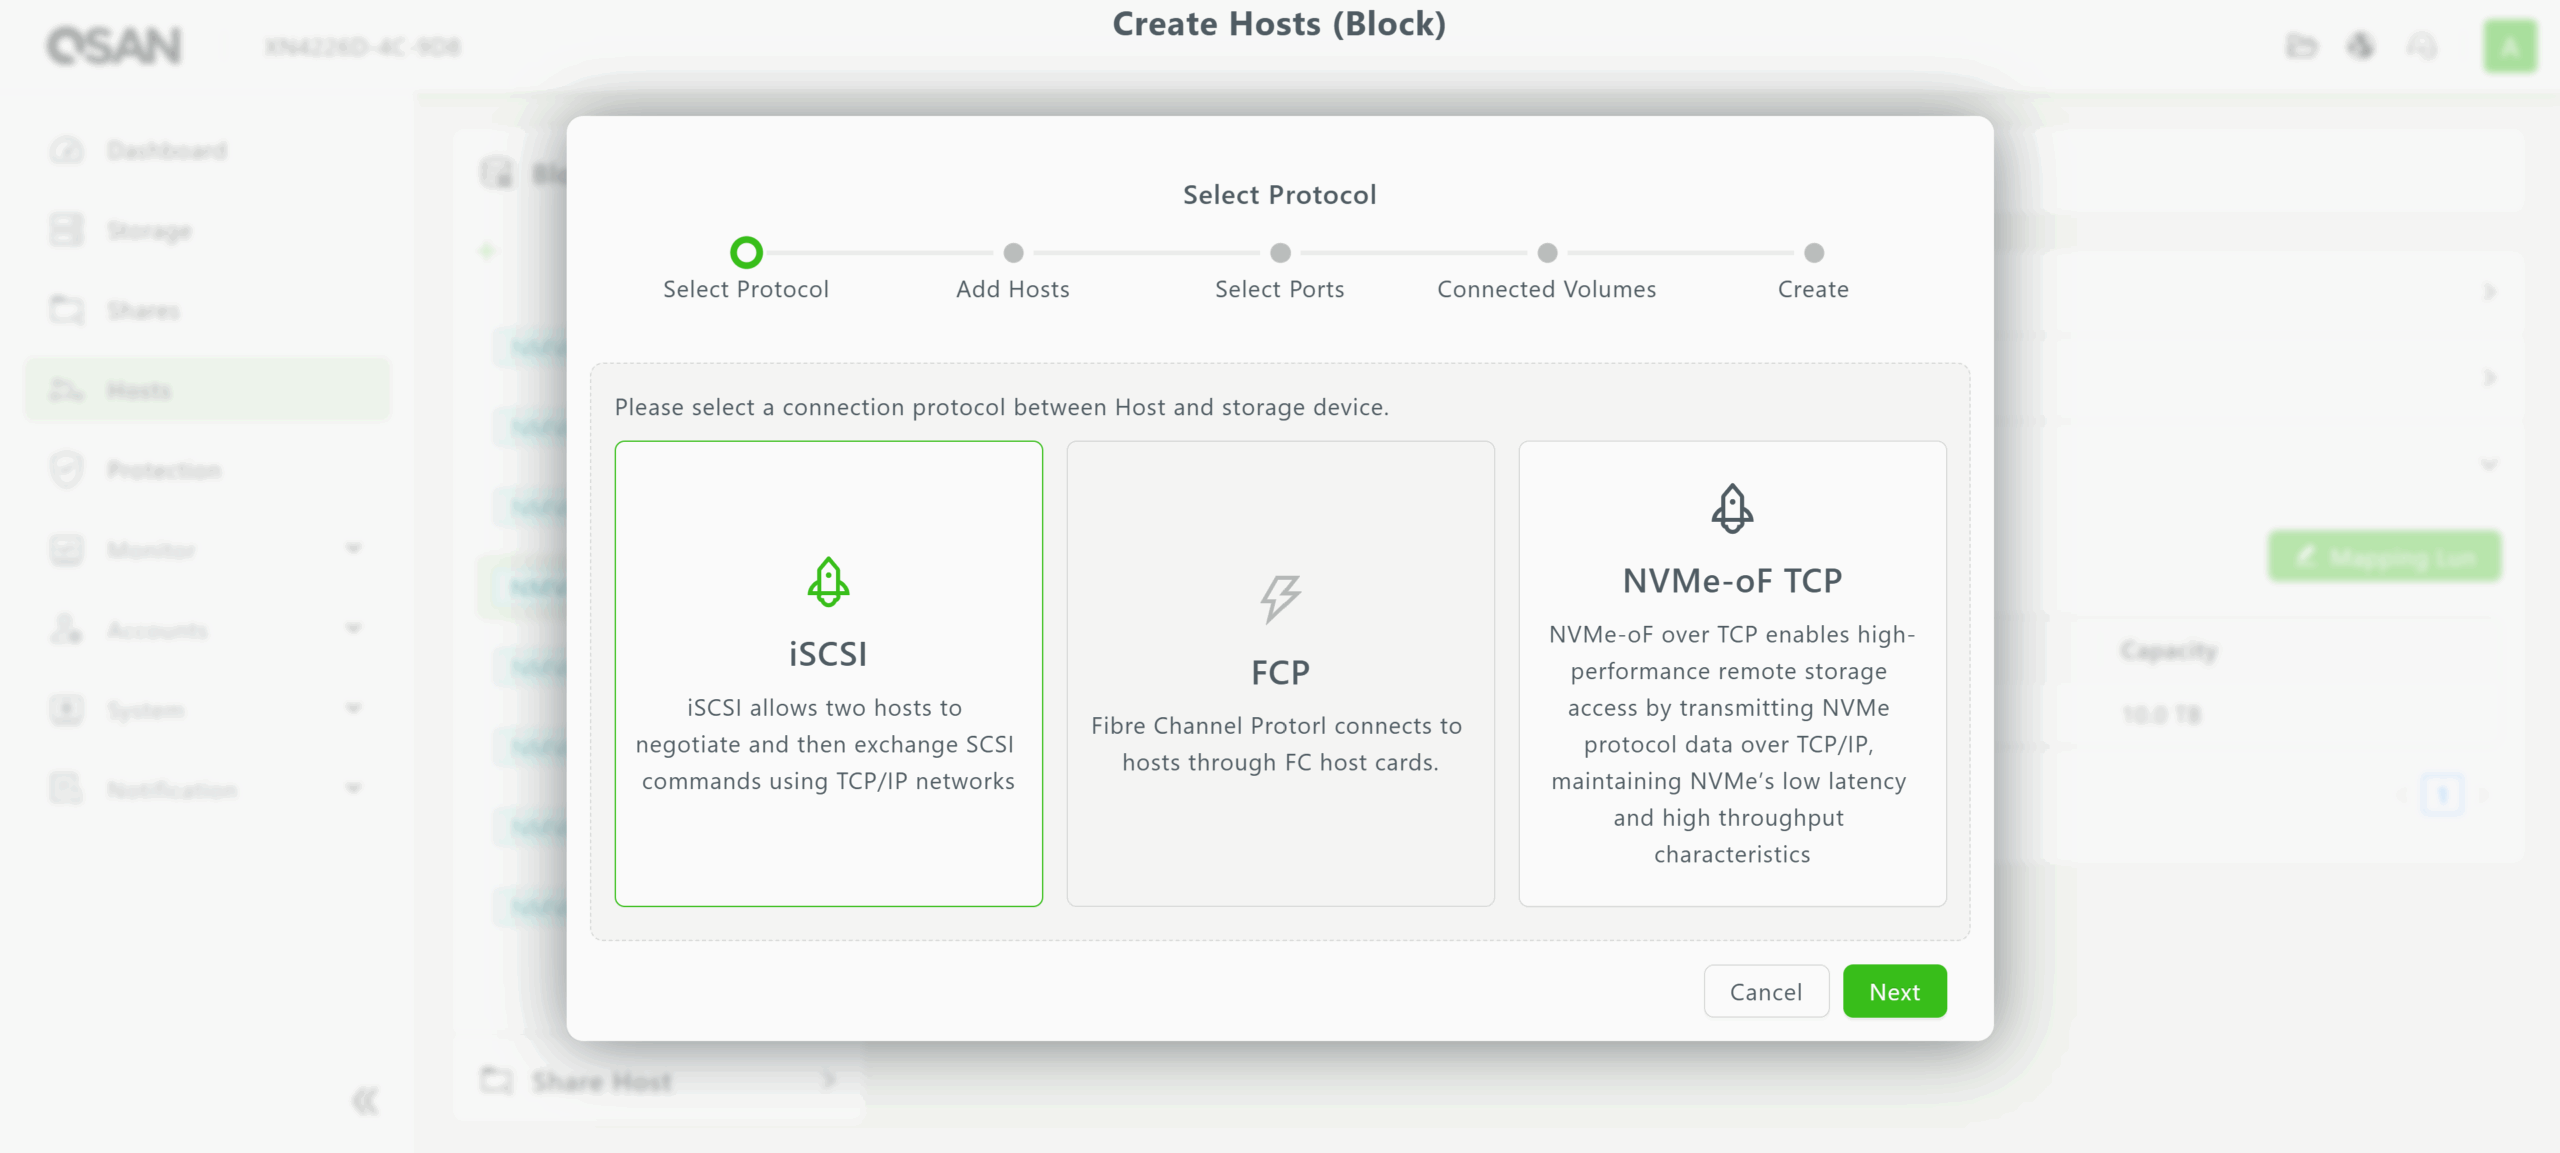
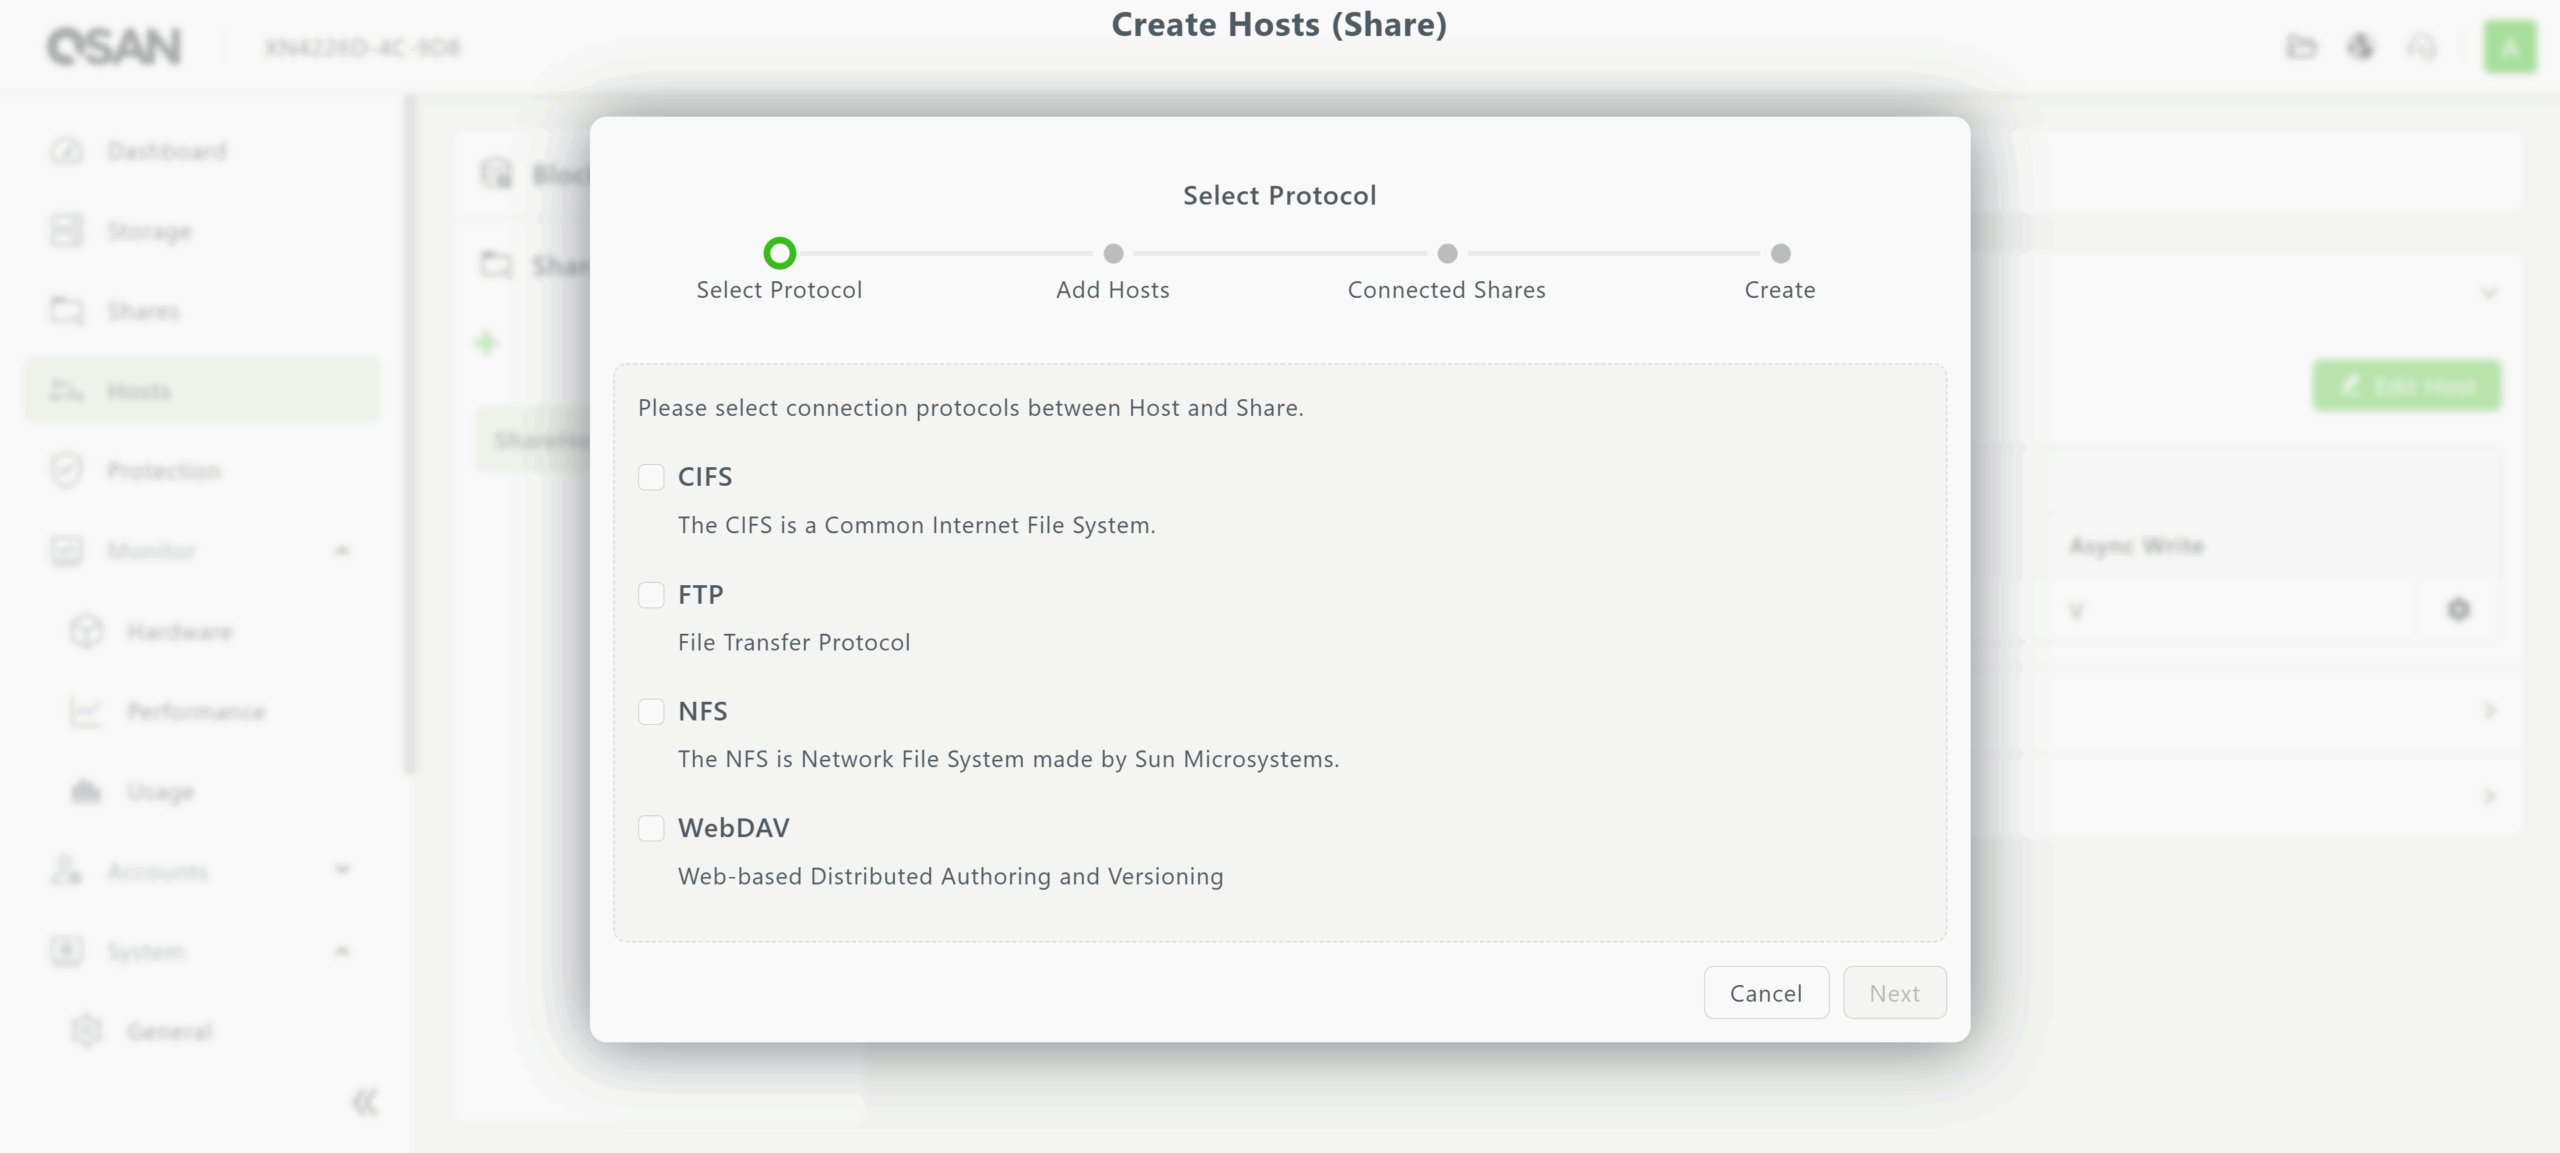
블록 스토리지용 호스트는 볼륨에 대해 iSCSI, FCP 또는 NVMe-oF over TCP를 활용할 수 있습니다. 반면, 파일(공유) 스토리지용 호스트는 여러 프로토콜을 동시에 지원할 수 있어 다양한 파일 공유 요구 사항을 가진 데이터 센터에 필수적인 유연성을 제공합니다.
QSM 4는 모니터 메뉴에서 기본적인 모니터링 기능을 제공하여 어레이 내의 다양한 하드웨어 모듈과 드라이브의 상태는 물론, 드라이브, 스토리지 풀, CPU, 메모리 사용에 대한 통계도 표시합니다.
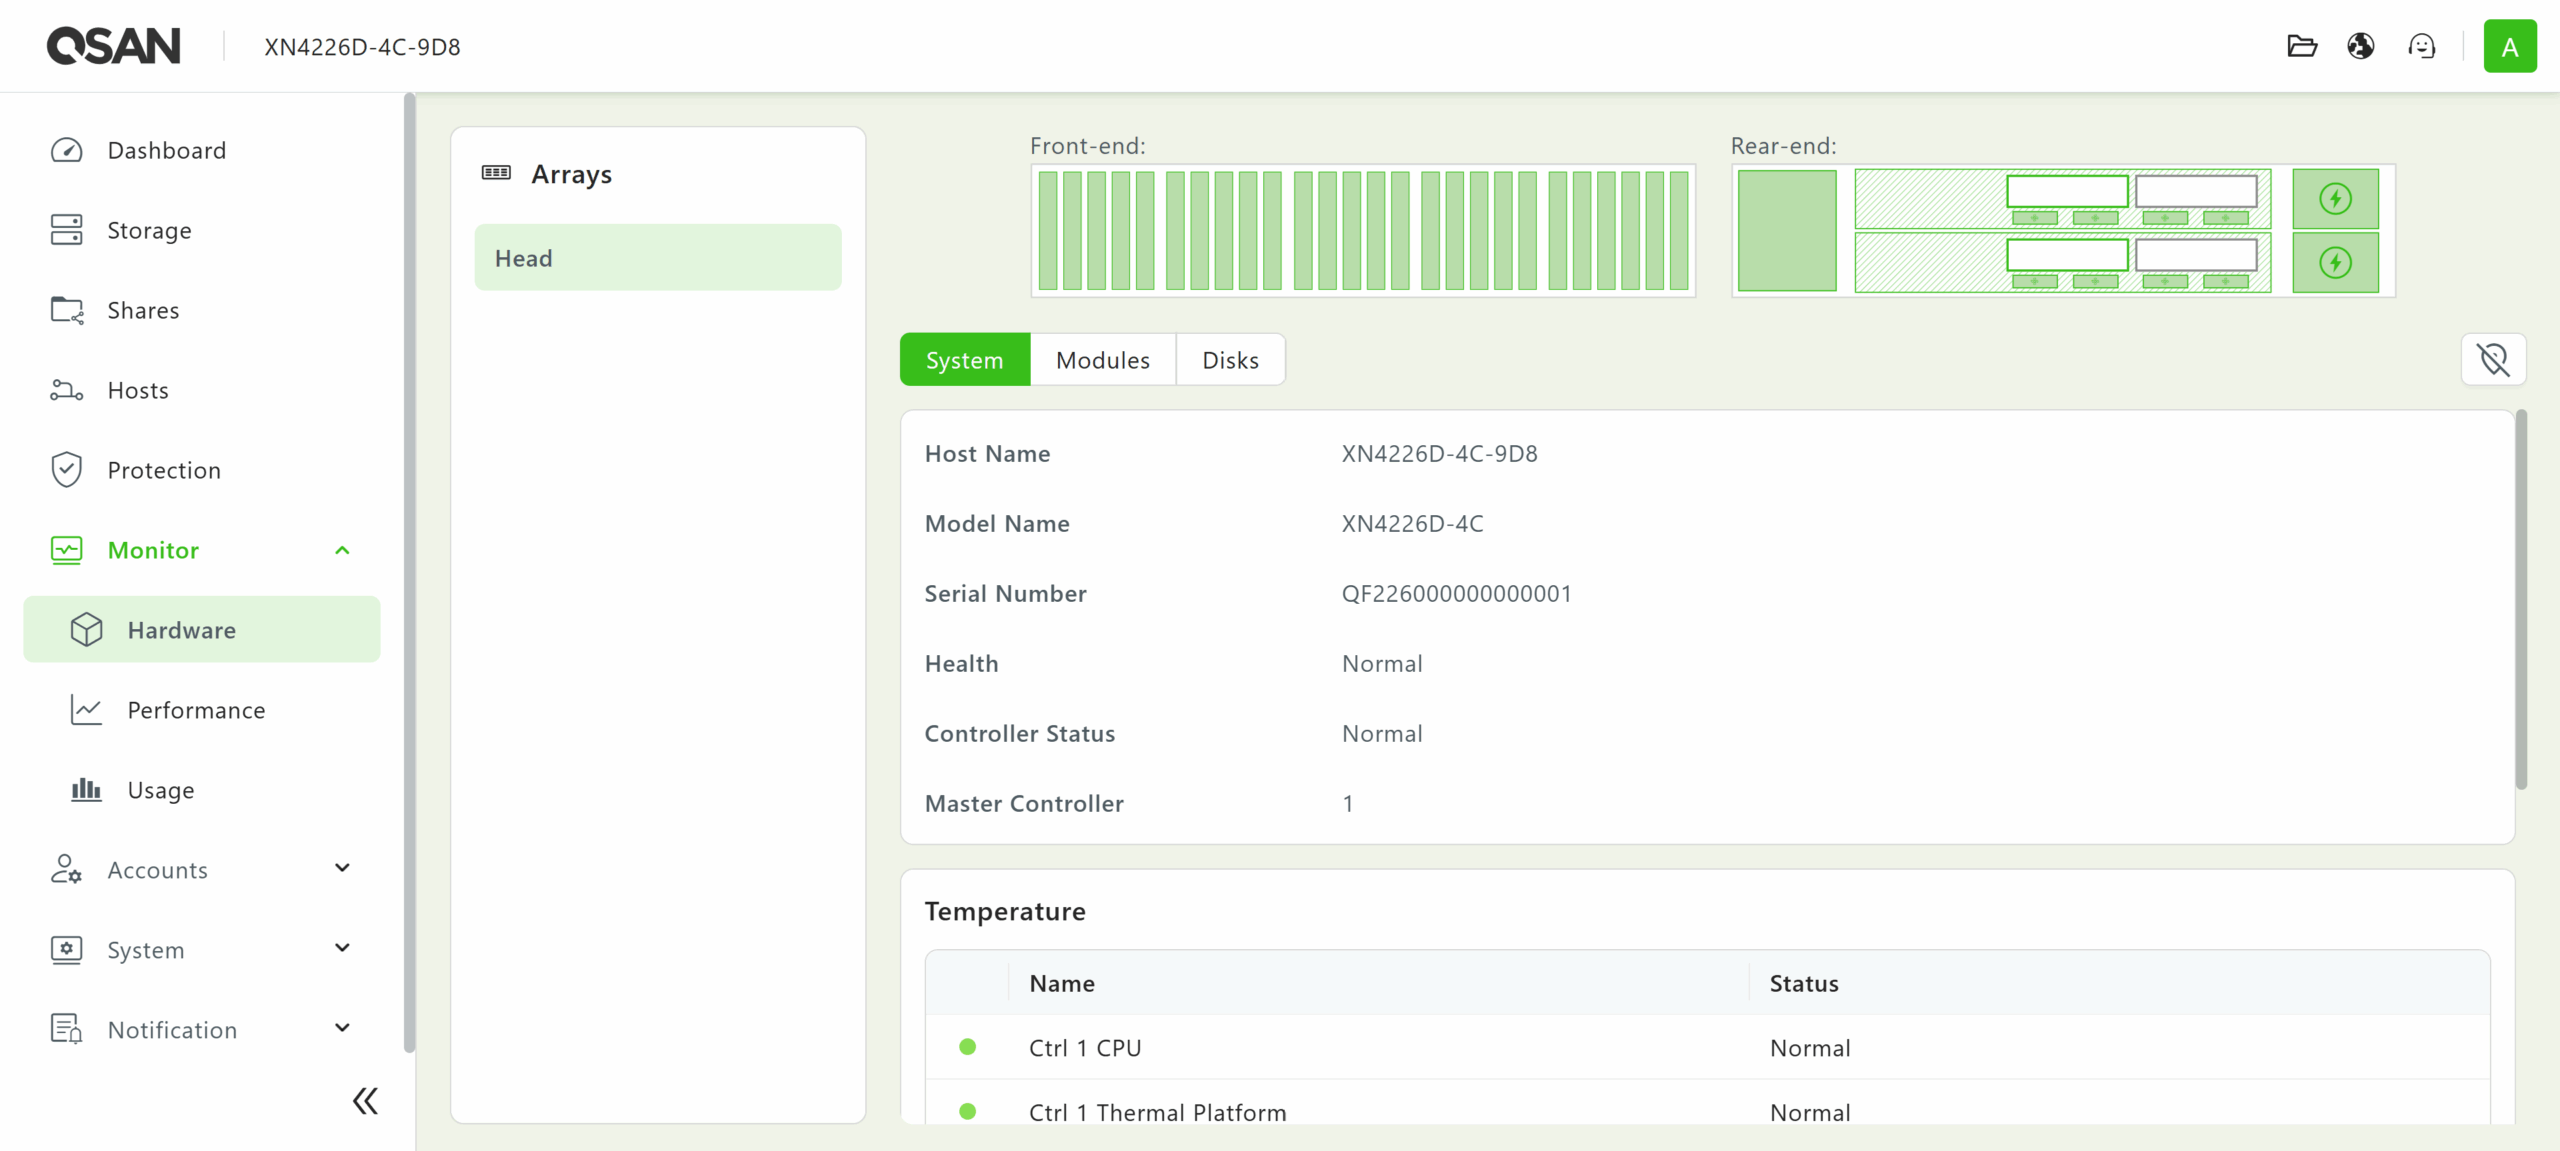
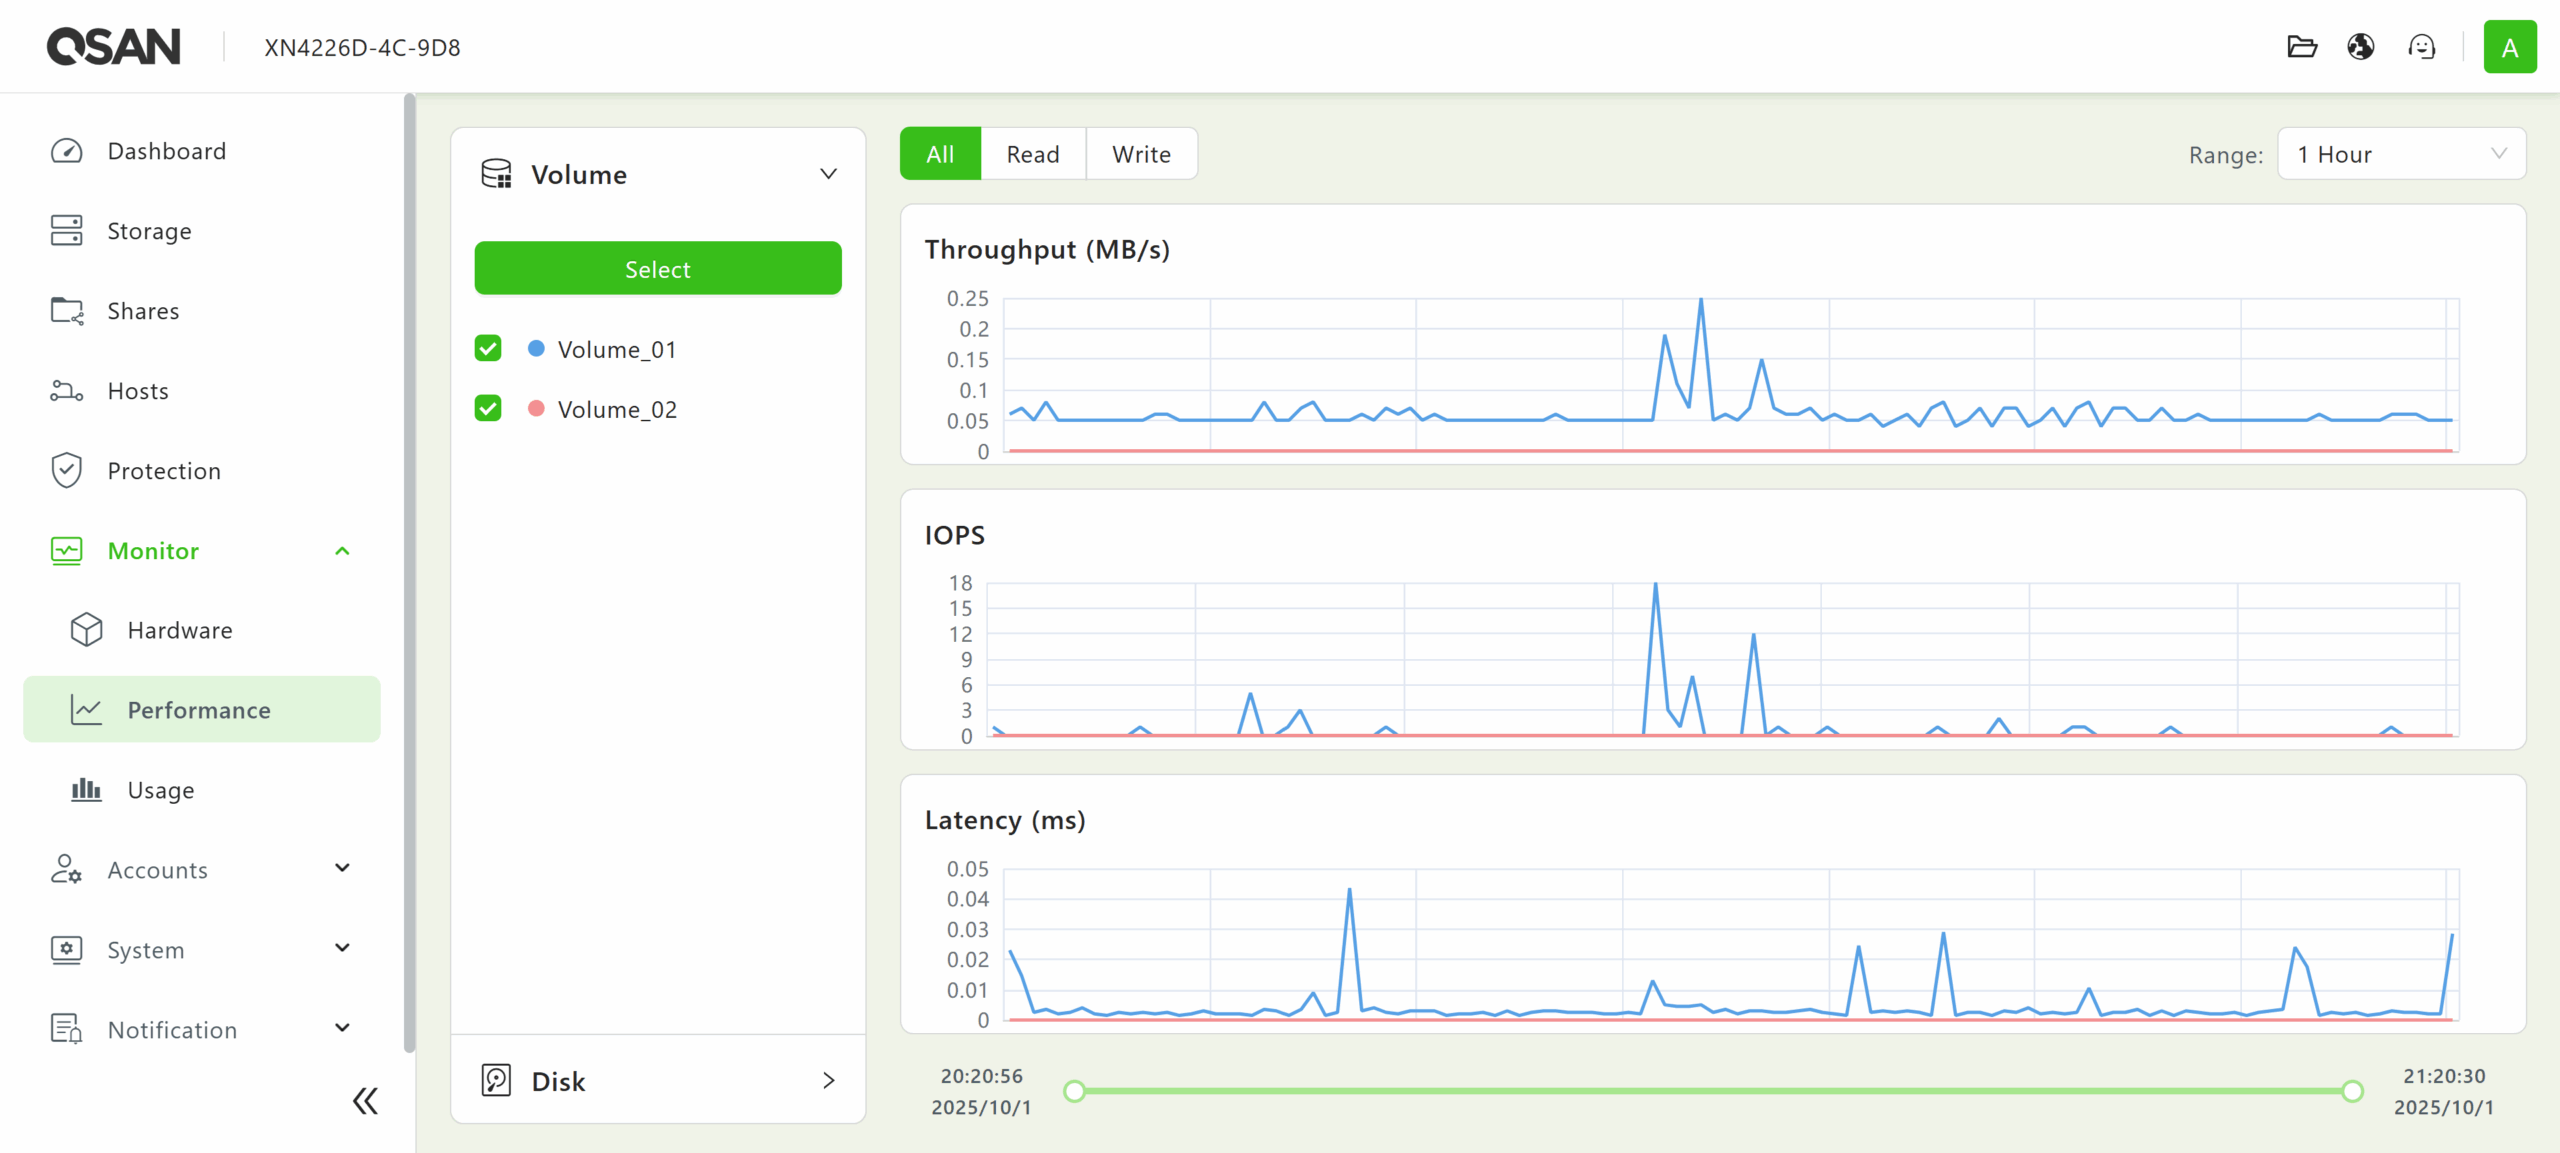
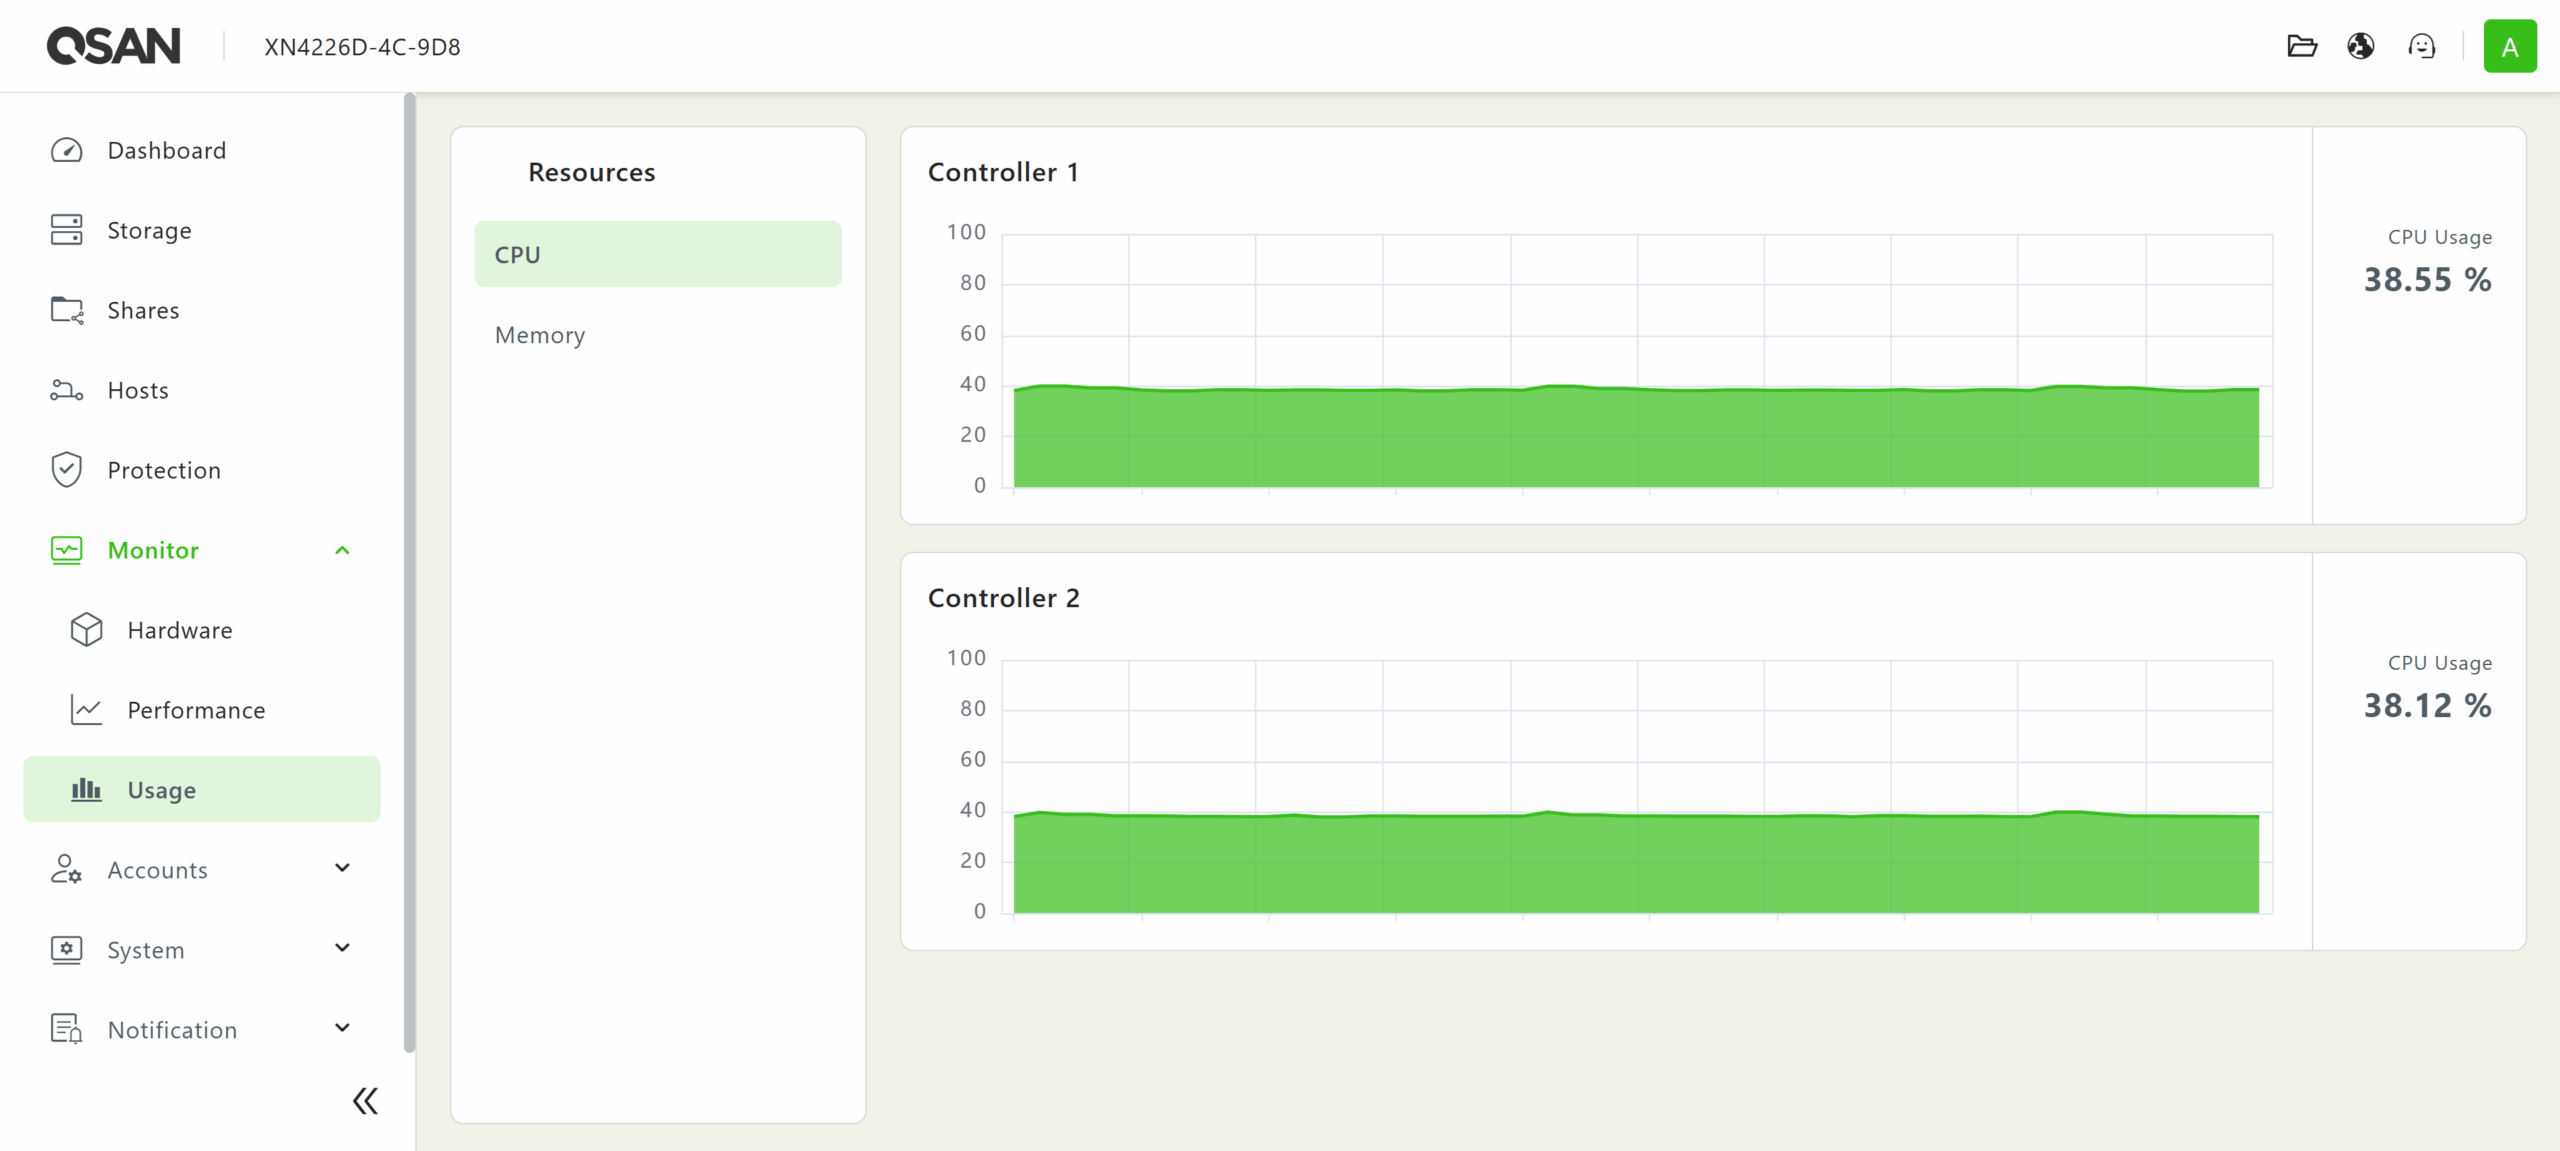
QSM 4 웹 UI는 계정 메뉴에서 사용자, 그룹 및 도메인 관리 기능을 제공합니다. 시스템 메뉴에서는 다양한 SAN 전체 구성 옵션을 사용할 수 있습니다. 로깅 및 알림 기능은 알림 메뉴에서 이용할 수 있습니다. 마지막으로, QSAN 파일 관리자, 언어 지원, 로그아웃/전원 관리 아이콘은 메뉴 막대 오른쪽 상단에 있습니다.
간단한 Proxmox 통합
Proxmox는 기본적으로 NVMe over Fabrics(NVMe-oF)를 지원하여 고성능 스토리지 어레이를 클러스터에 손쉽게 통합할 수 있습니다. 이 프로세스는 스토리지 시스템에 NVMe-oF 대상을 프로비저닝하는 것으로 시작됩니다. 그런 다음 Proxmox 호스트를 사용하여 해당 대상을 검색하고 연결합니다. 연결되면 재부팅 후에도 연결이 유지되도록 시스템을 구성해야 합니다.
우리의 예에서, 검색은 어레이의 IP 주소와 서비스 포트를 지정하는 셸 명령을 사용하여 수행됩니다.
nvme discover -t tcp -a 172.16.16.100 -s 4420
nvme discover -t tcp -a 172.13.13.100 -s 4420
다음으로, NQN을 참조하여 프로비저닝된 네임스페이스에 연결합니다.
nvme connect -t tcp -n nqn.2024-11.com.qsan:dev4 -a 172.16.16.100 -s 4420
nvme connect -t tcp -n nqn.2024-11.com.qsan:dev6 -a 172.13.13.100 -s 4420
재부팅 후에도 구성이 지속되도록 하려면 검색 주소를 NVMe 검색 구성 파일에 추가할 수 있습니다.
echo "discover -t tcp -a 172.16.16.100 -s 4420" | tee -a /etc/nvme/discovery.conf
echo "discover -t tcp -a 172.13.13.100 -s 4420" | tee -a /etc/nvme/discovery.conf
마지막으로, Proxmox가 시작 시 NVMe 세션을 자동으로 다시 설정하도록 자동 연결 서비스를 활성화합니다.
systemctl enable nvmf-autoconnect.serviceProxmox는 QSAN 스토리지와 완벽하게 통합되어 네트워크 패브릭의 유연성과 함께 NVMe의 저지연성, 고대역폭 성능을 제공합니다.
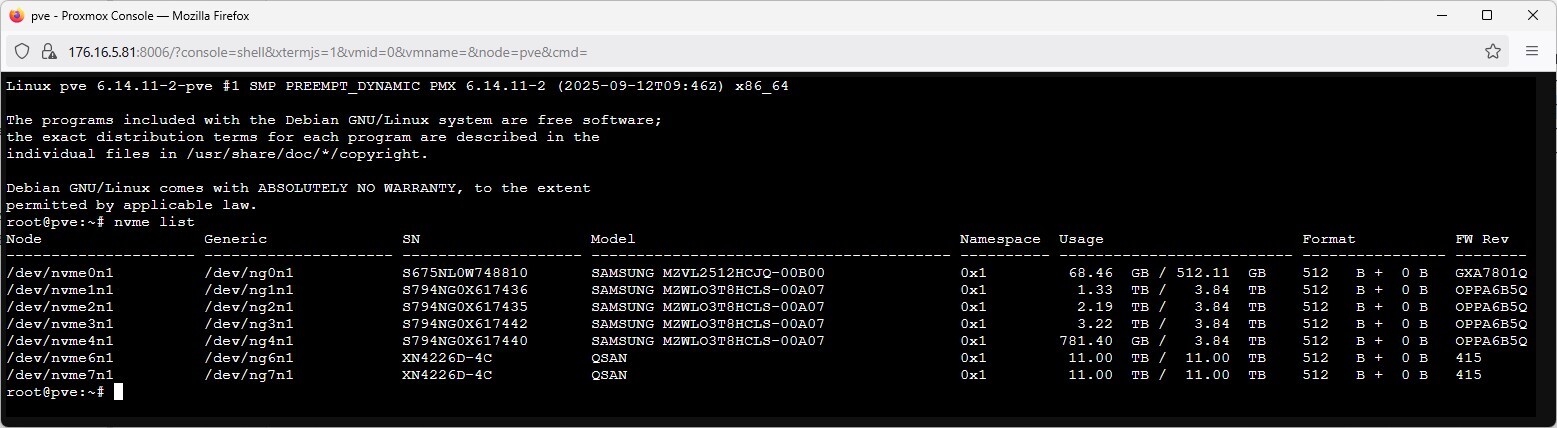
QSAN을 연결한 후 Proxmox 셸에서 "nvme list" 명령을 실행하여 모든 NVMe 장치를 표시할 수 있습니다. 새로 추가된 QSAN 볼륨은 각각 11TB의 저장 용량을 가진 /dev/nvme6n1 및 /dev/nvme7n1로 나타납니다.
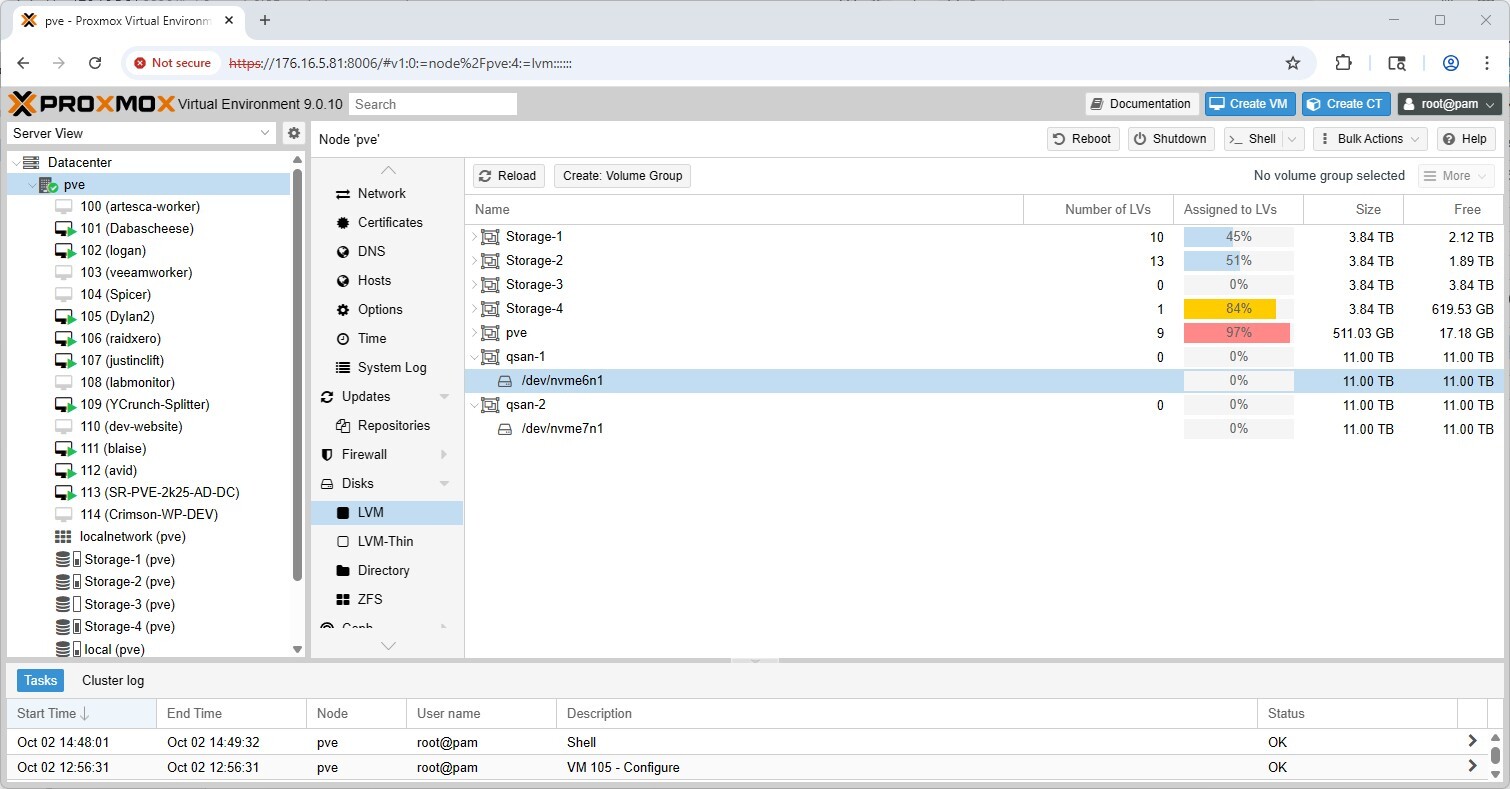
Proxmox GUI에서 QSAN 스토리지가 표시되면 새 LVM 볼륨 그룹을 만들 수 있습니다. pve > 디스크 > LVM, 두 개의 11TB 장치(/dev/nvme6n1 및 /dev/nvme7n1)가 나타나고 VM 및 컨테이너와 함께 사용할 수 있도록 별도의 볼륨 그룹(예: qsan-1 및 qsan-2)으로 초기화할 수 있습니다.
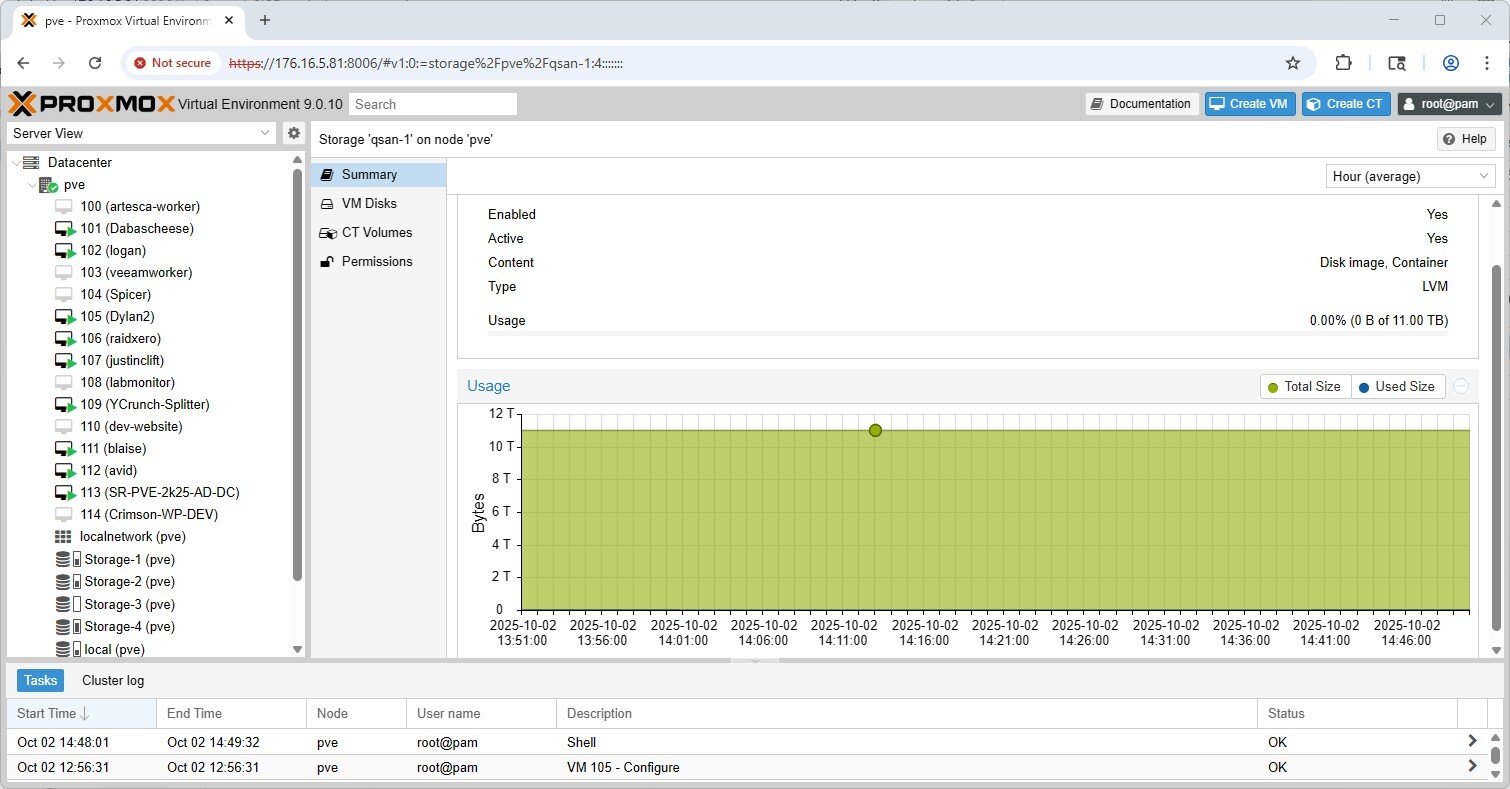
저장소 창에서 새로운 LVM 풀(qsan-1) 중 하나를 클릭하면 해당 풀이 온라인 상태이고 활성화되어 있으며 전체 11TB 용량으로 사용 가능하고 VM 및 컨테이너 프로비저닝에 적합하다는 것을 알 수 있습니다.
성능 시험
QSAN XN4226D를 두 가지 환경에서 서로 다른 테스트 플랫폼을 활용하여 테스트했습니다. 첫 번째 환경은 4개의 NVIDIA ConnectX-5 듀얼 포트 25G NIC가 장착된 Dell PowerEdge R750을 기반으로 구축되었습니다. 8개의 DAC 케이블을 사용하여 QSAN XN4226D를 이 서버에 직접 연결했습니다. 이 설정은 QSAN의 모든 사용 가능한 네트워크 포트를 활용하여 최고 성능을 보여줄 수 있었습니다.
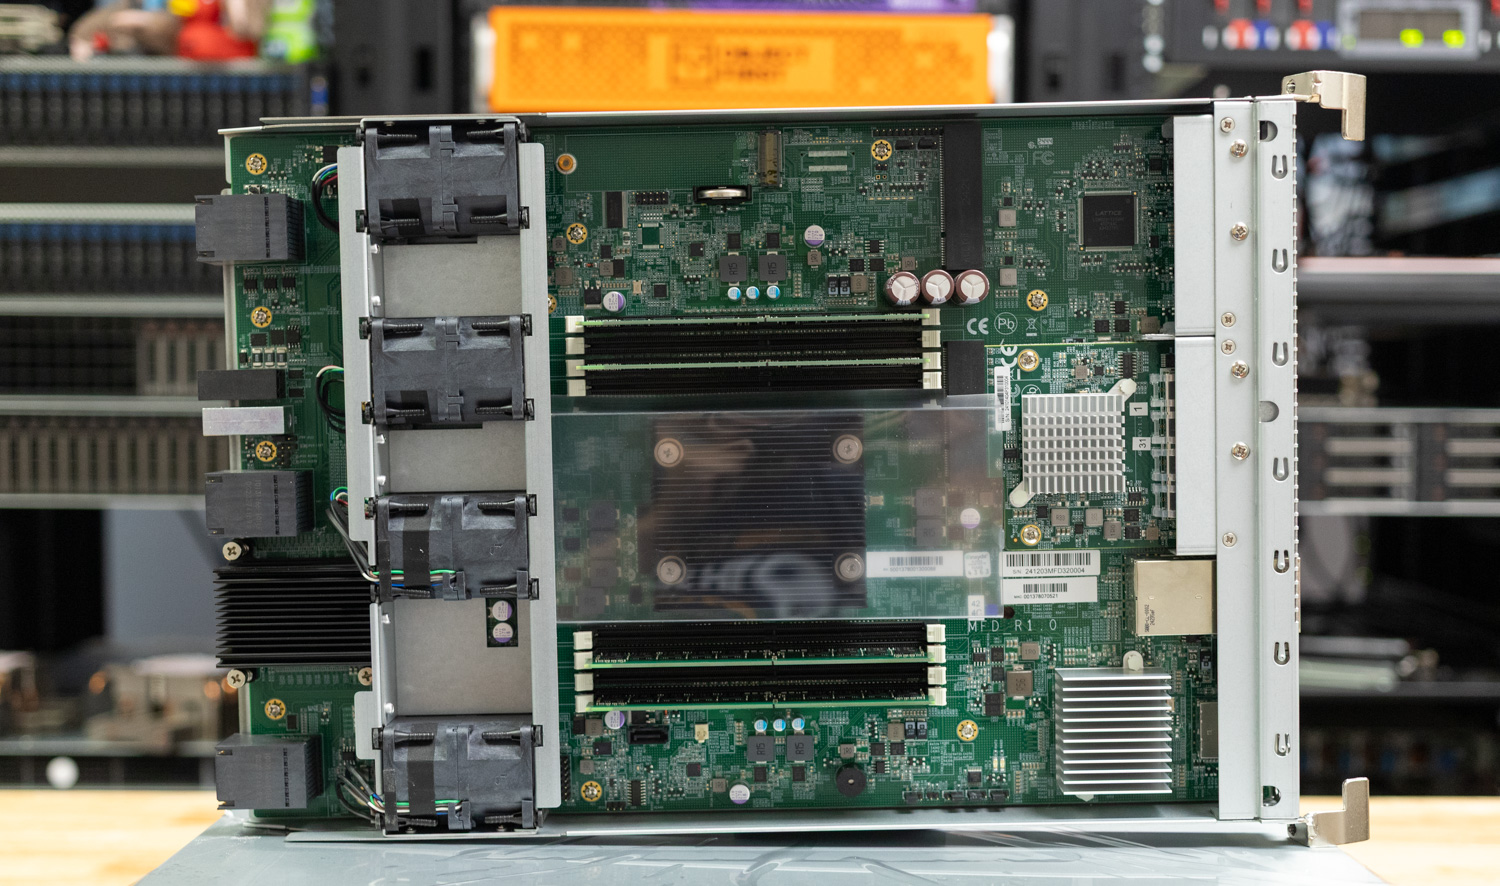
FIO 테스트를 위해 두 개의 RAID6 스토리지 풀을 사용하여 두 컨트롤러에 균등하게 분산된 8개의 블록 볼륨을 생성했습니다. 각 볼륨은 고유한 대상에 할당되어 각 볼륨에 단일 IP 주소를 할당했습니다. 이 플랫폼에서 NVMe-oF RDMA와 TCP를 모두 측정했습니다.
GDSIO의 두 번째 환경은 NVIDIA H100 GPU 2개와 쿼드포트 Broadcom 25G NIC가 장착된 Dell PowerEdge R7715를 활용했습니다. 이 환경에서는 동일한 QSAN 볼륨 레이아웃을 유지했지만, 볼륨 수는 8개에서 4개로 줄였습니다. 쿼드포트 NIC를 사용하여 4개의 25G 연결을 통해 서버를 스토리지 어레이에 직접 연결했습니다.
FIO 성능 벤치마크
QSAN XN4226D의 스토리지 성능을 측정하기 위해 업계 표준 지표를 적용하고 FIO 도구를 활용했습니다. 각 스토리지 장치는 동일한 테스트 프로세스를 거칩니다. 이 테스트에는 순차적 쓰기 워크로드를 포함하는 두 번의 전체 드라이브 채우기를 포함하는 사전 조정 단계와 그 후 정상 상태 성능 측정이 포함됩니다. 측정되는 각 워크로드 유형이 변경됨에 따라, 새로운 전송 크기에 대한 사전 조정 채우기를 다시 실행합니다.
이 섹션에서는 다음 FIO 벤치마크에 초점을 맞춥니다.
- 1M 순차
- 64K 랜덤
- 16K 랜덤
- 4K 랜덤
1M 순차 쓰기 대역폭
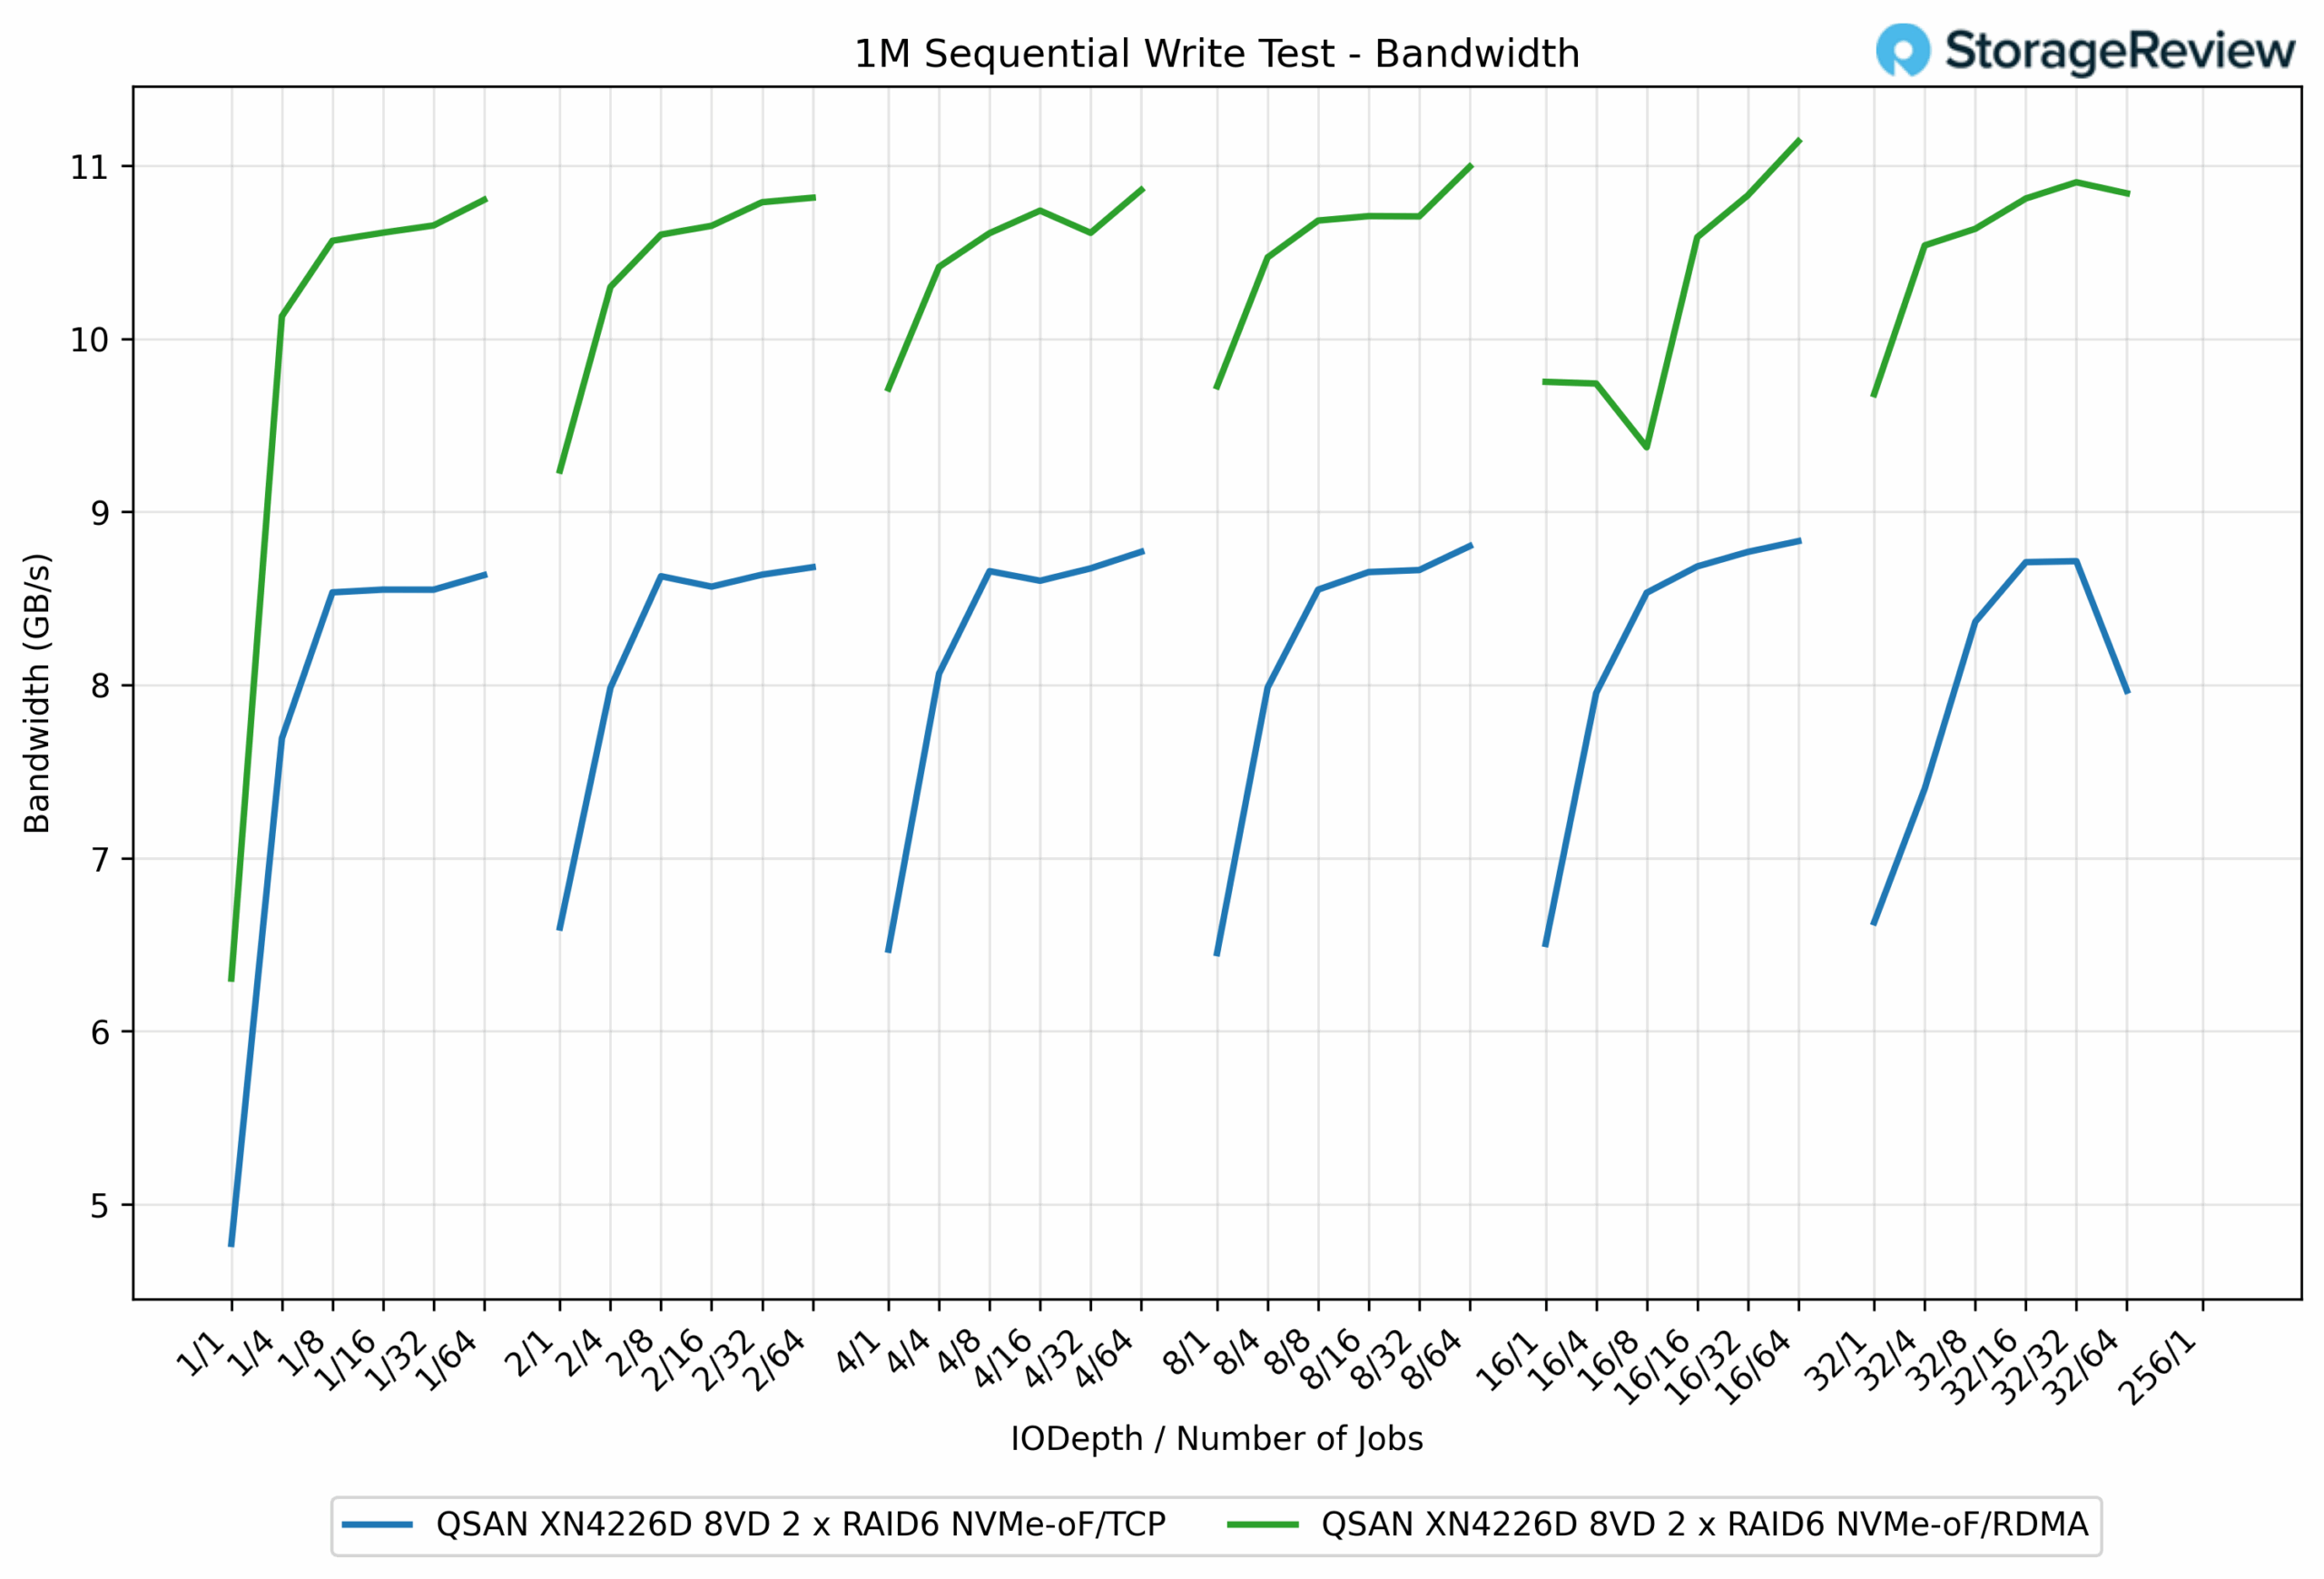
1M 순차 쓰기 테스트에서 NVMe over RDMA는 거의 모든 대기열 깊이와 작업 수에서 NVMe over TCP보다 일관되게 더 높은 대역폭을 제공했습니다. 최대 속도에서 RDMA는 11.14GB/s를 기록한 반면, TCP는 8.83GB/s로 RDMA에 비해 약 26% 더 높은 대역폭을 제공했습니다. 대기열 깊이가 더 낮은 경우에도 RDMA는 우위를 유지했습니다. 예를 들어, QD1/1 작업에서는 RDMA가 6.30GB/s를 기록하여 TCP의 4.77GB/s를 약 32% 앞섰습니다.
두 프로토콜 간의 성능 격차는 워크로드가 확장됨에 따라 다소 줄어들었지만, RDMA는 전반적으로 확실한 우위를 보였습니다. TCP는 여러 테스트 지점에서 8.5~8.8GB/s 범위를 꾸준히 유지한 반면, RDMA는 10.5GB/s를 자주 넘어 최대 11GB/s를 약간 상회했습니다.
1M 순차 쓰기 대기 시간
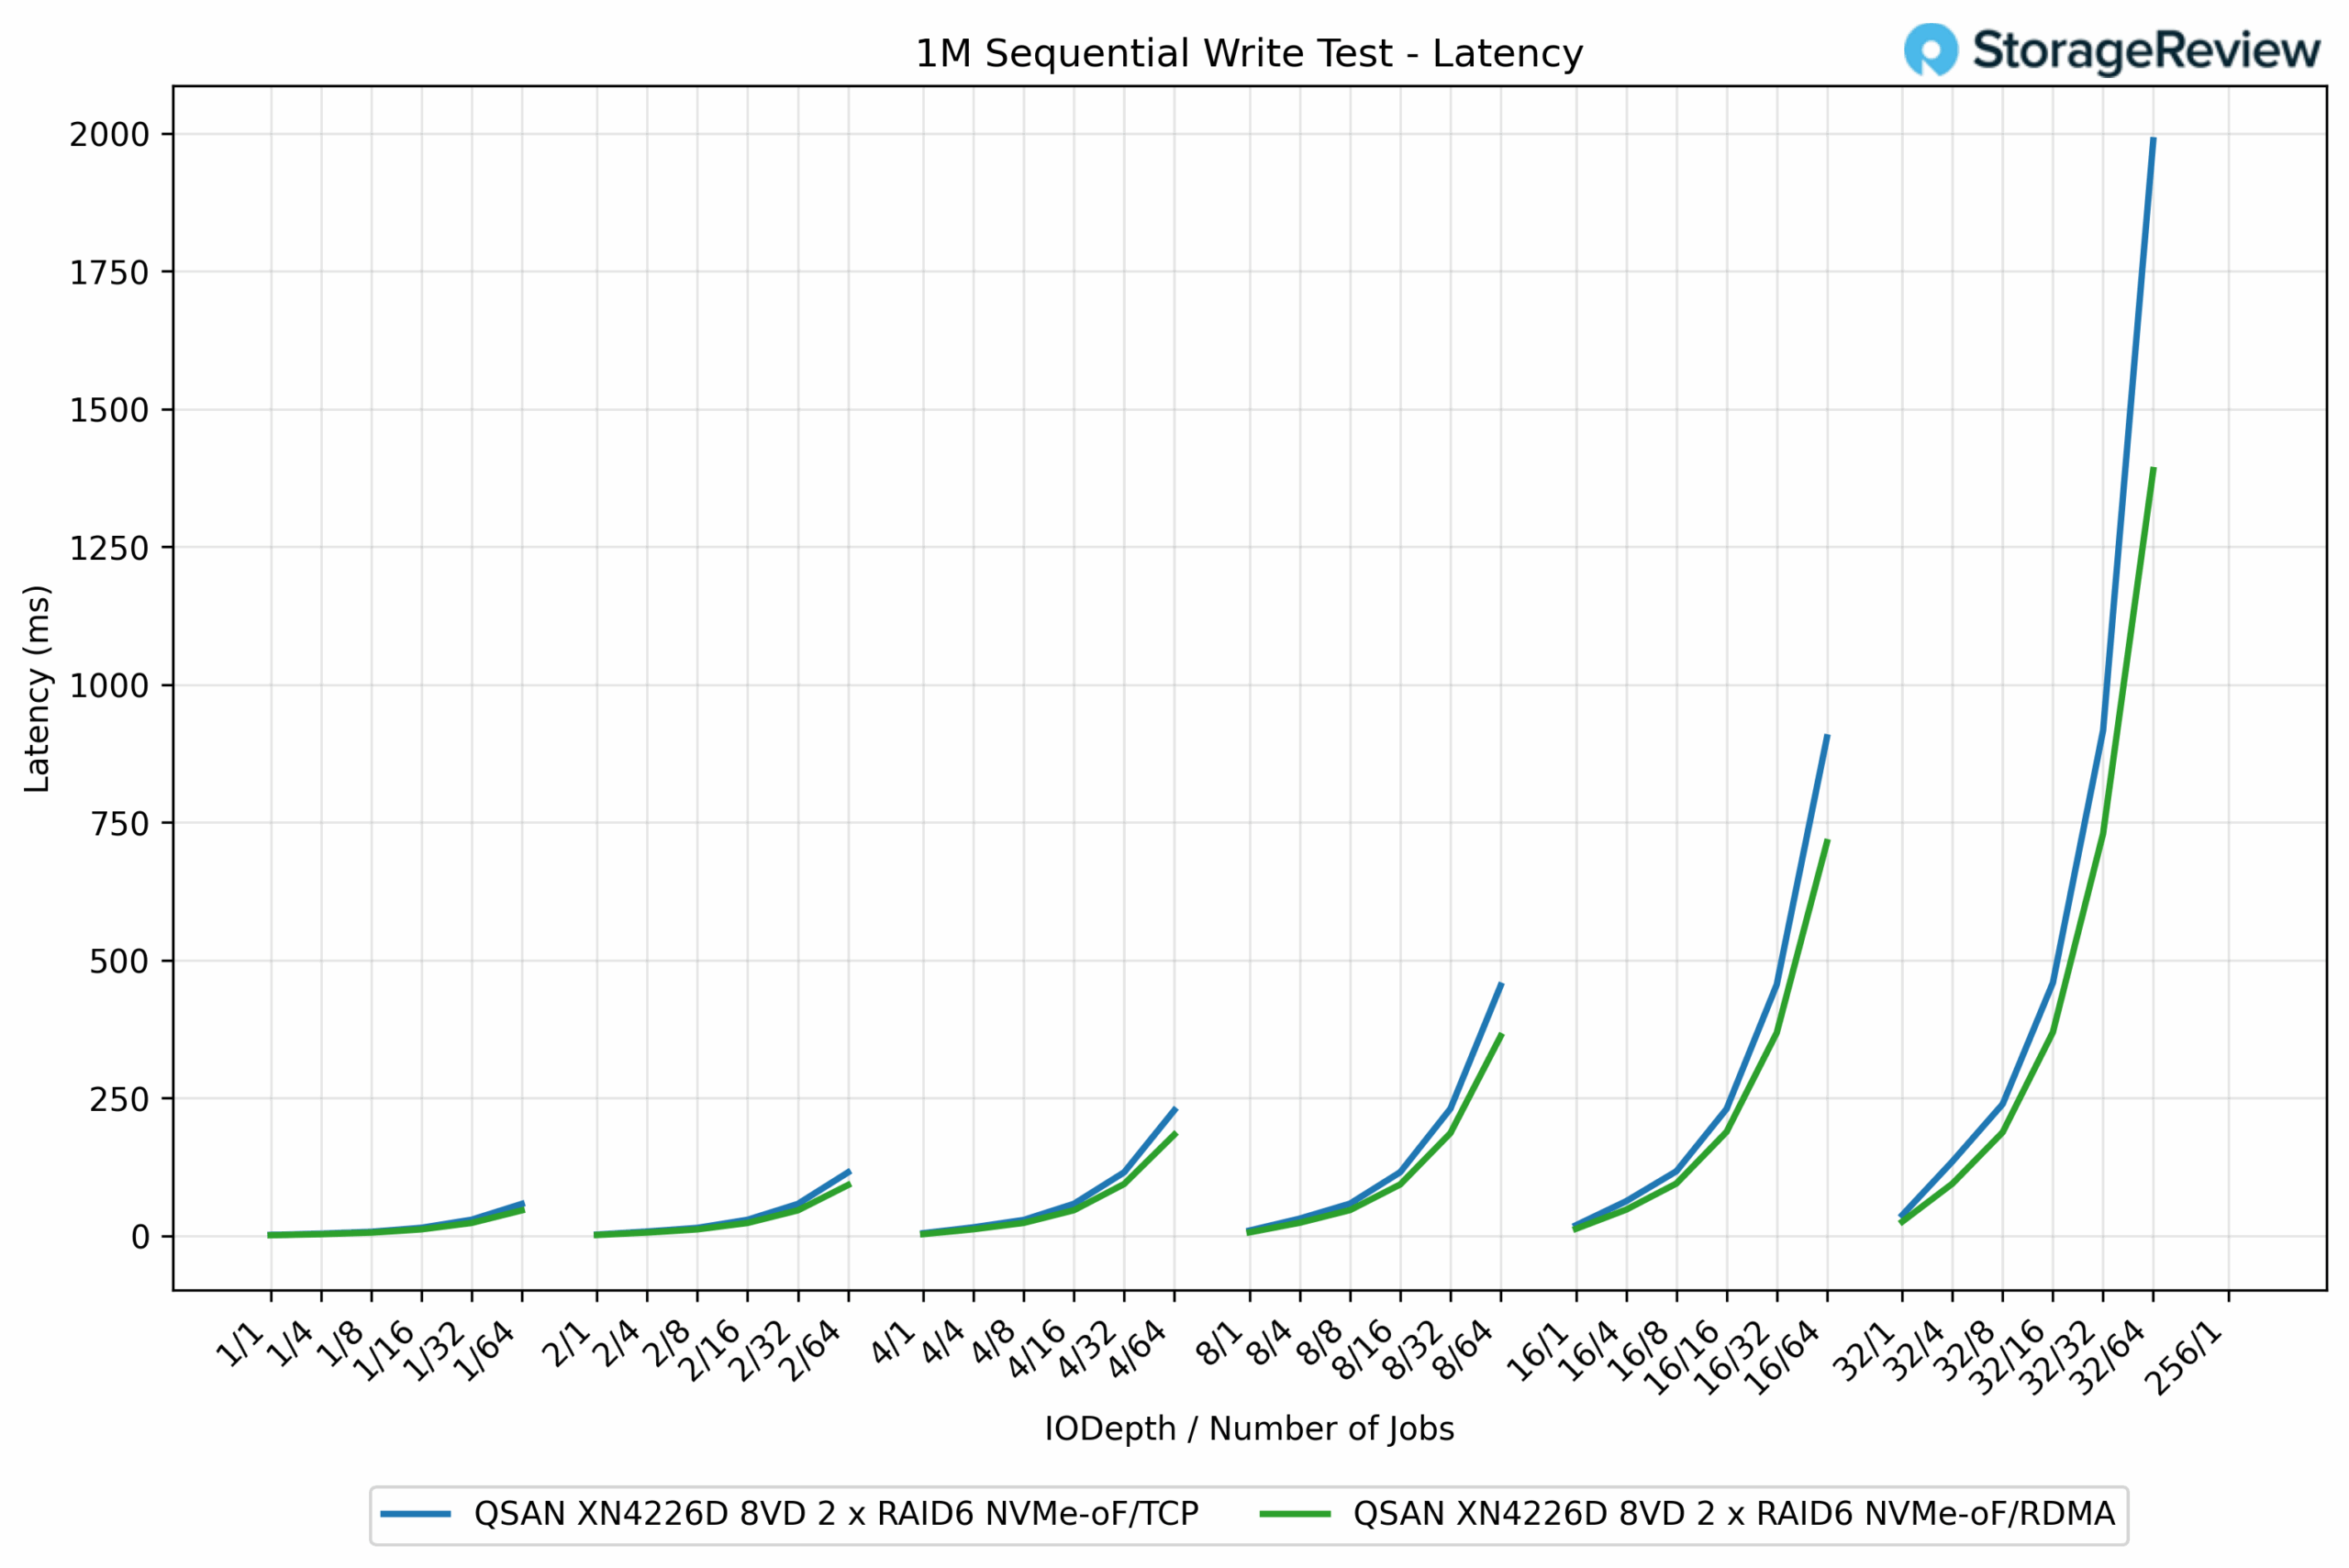
1M 순차 쓰기 지연 시간 테스트에서 RDMA는 대부분의 대기열 깊이와 작업 수에서 TCP보다 확실한 효율성 우위를 유지했습니다. 가벼운 작업 부하에서는 두 프로토콜이 서로 비슷한 추이를 보였으며, 모두 5ms 미만의 지연 시간을 보였습니다. 그러나 동시성이 증가함에 따라 그 차이는 더욱 뚜렷해졌습니다. 예를 들어, QD16/16 작업에서 RDMA는 368.48ms를 기록한 반면 TCP는 455.95ms를 기록하여 RDMA가 19% 향상되었습니다.
이러한 차이는 극단적인 규모에서 더욱 커졌습니다. QD256/1 작업에서 RDMA는 1,389.16ms로 완료되었고, TCP는 1,987.39ms로 증가하여 RDMA가 43% 지연 시간을 단축했습니다. 이러한 추세는 특히 부하가 높은 상황에서 RDMA가 지연 시간을 억제하면서 더 높은 처리량을 유지할 수 있음을 보여줍니다.
1M 순차 읽기 대역폭
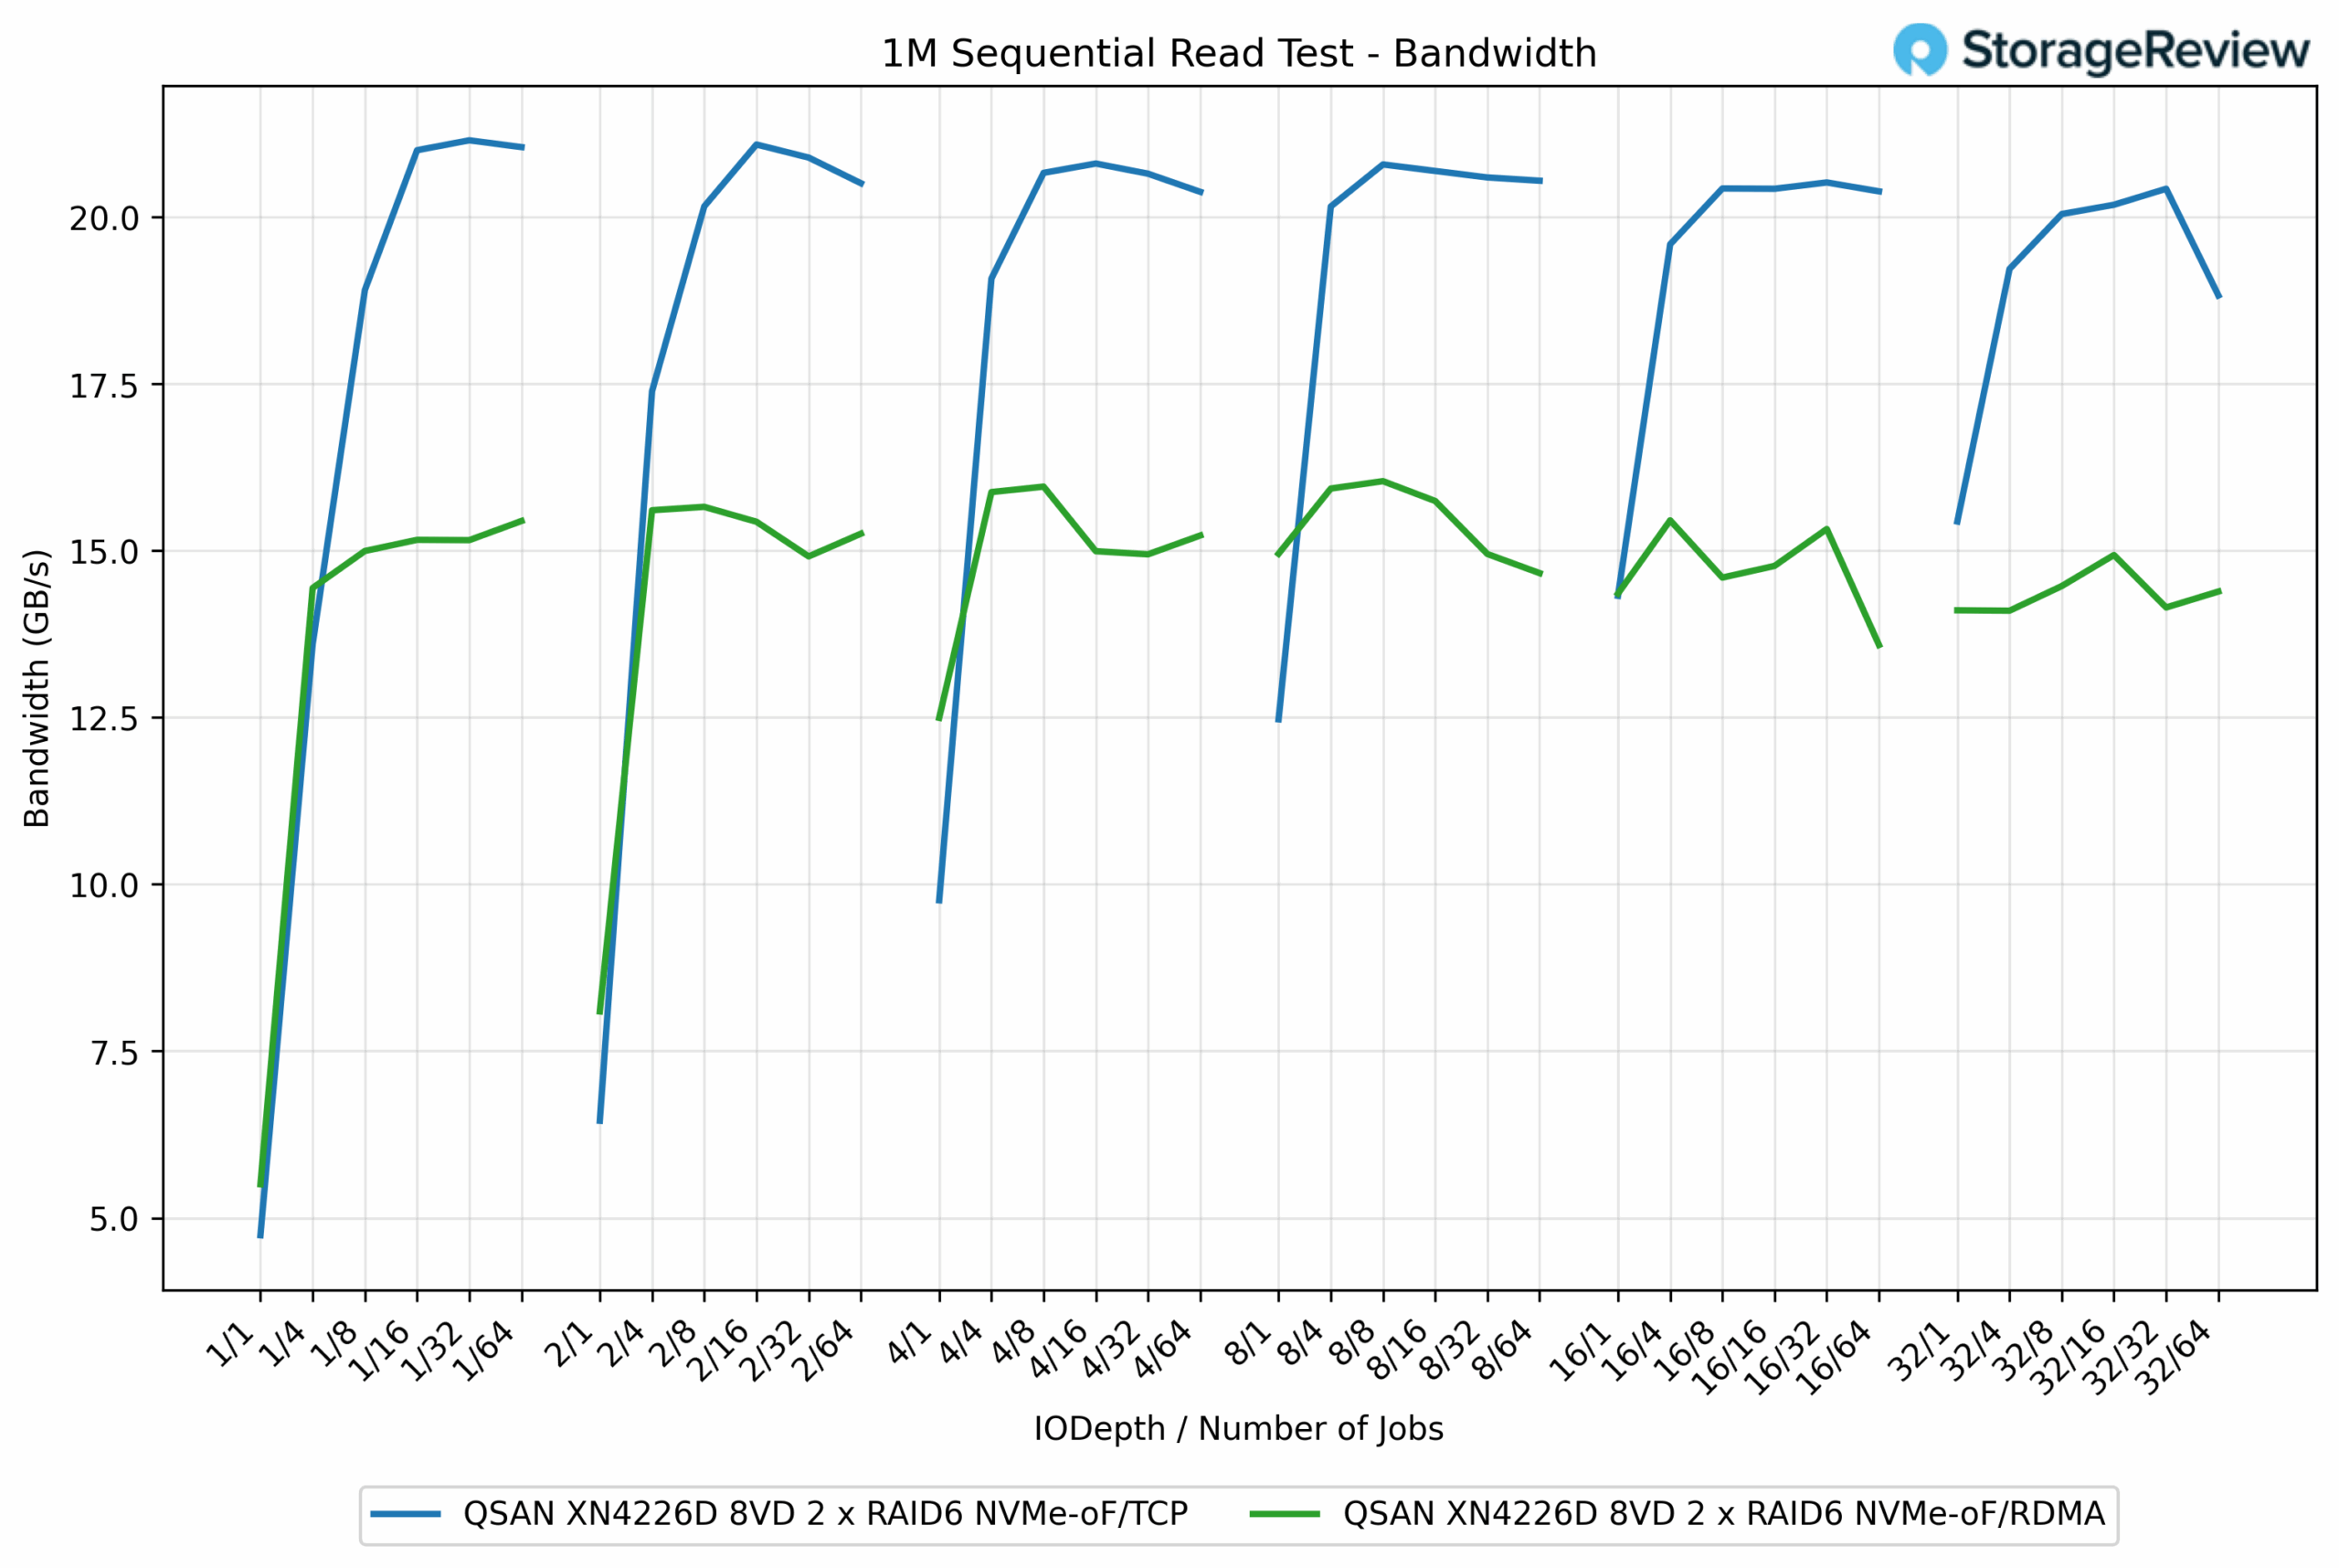
1M 순차 읽기 테스트에서는 성능 변동이 나타났으며, TCP가 전반적으로 RDMA를 크게 앞지르고 있었습니다. TCP는 최대 21.21GB/s에 도달한 반면, RDMA는 15.96GB/s로 최고치를 기록하여 TCP에 비해 약 33%의 차이를 보였습니다. 대기열 깊이가 낮은 경우에도 TCP가 빠르게 앞서 나갔습니다. 예를 들어, QD1/4 작업에서 TCP는 18.91GB/s를 기록한 반면 RDMA는 15.05GB/s를 기록하여 25% 이상의 격차를 보였습니다.
TCP의 장점은 거의 모든 워크로드 규모에서 일관되게 나타났습니다. 포화 상태에 도달한 후, TCP는 20~21GB/s 범위의 결과를 유지한 반면, RDMA는 15GB/s에 가깝게 평탄화되었습니다. 이는 RDMA가 쓰기 작업이 많고 지연 시간에 민감한 작업에서는 탁월한 반면, TCP는 테스트된 RAID6 NVMe 구성에서 순차 읽기 대역폭 효율성이 더 높음을 나타냅니다.
1M 순차 읽기 대기 시간
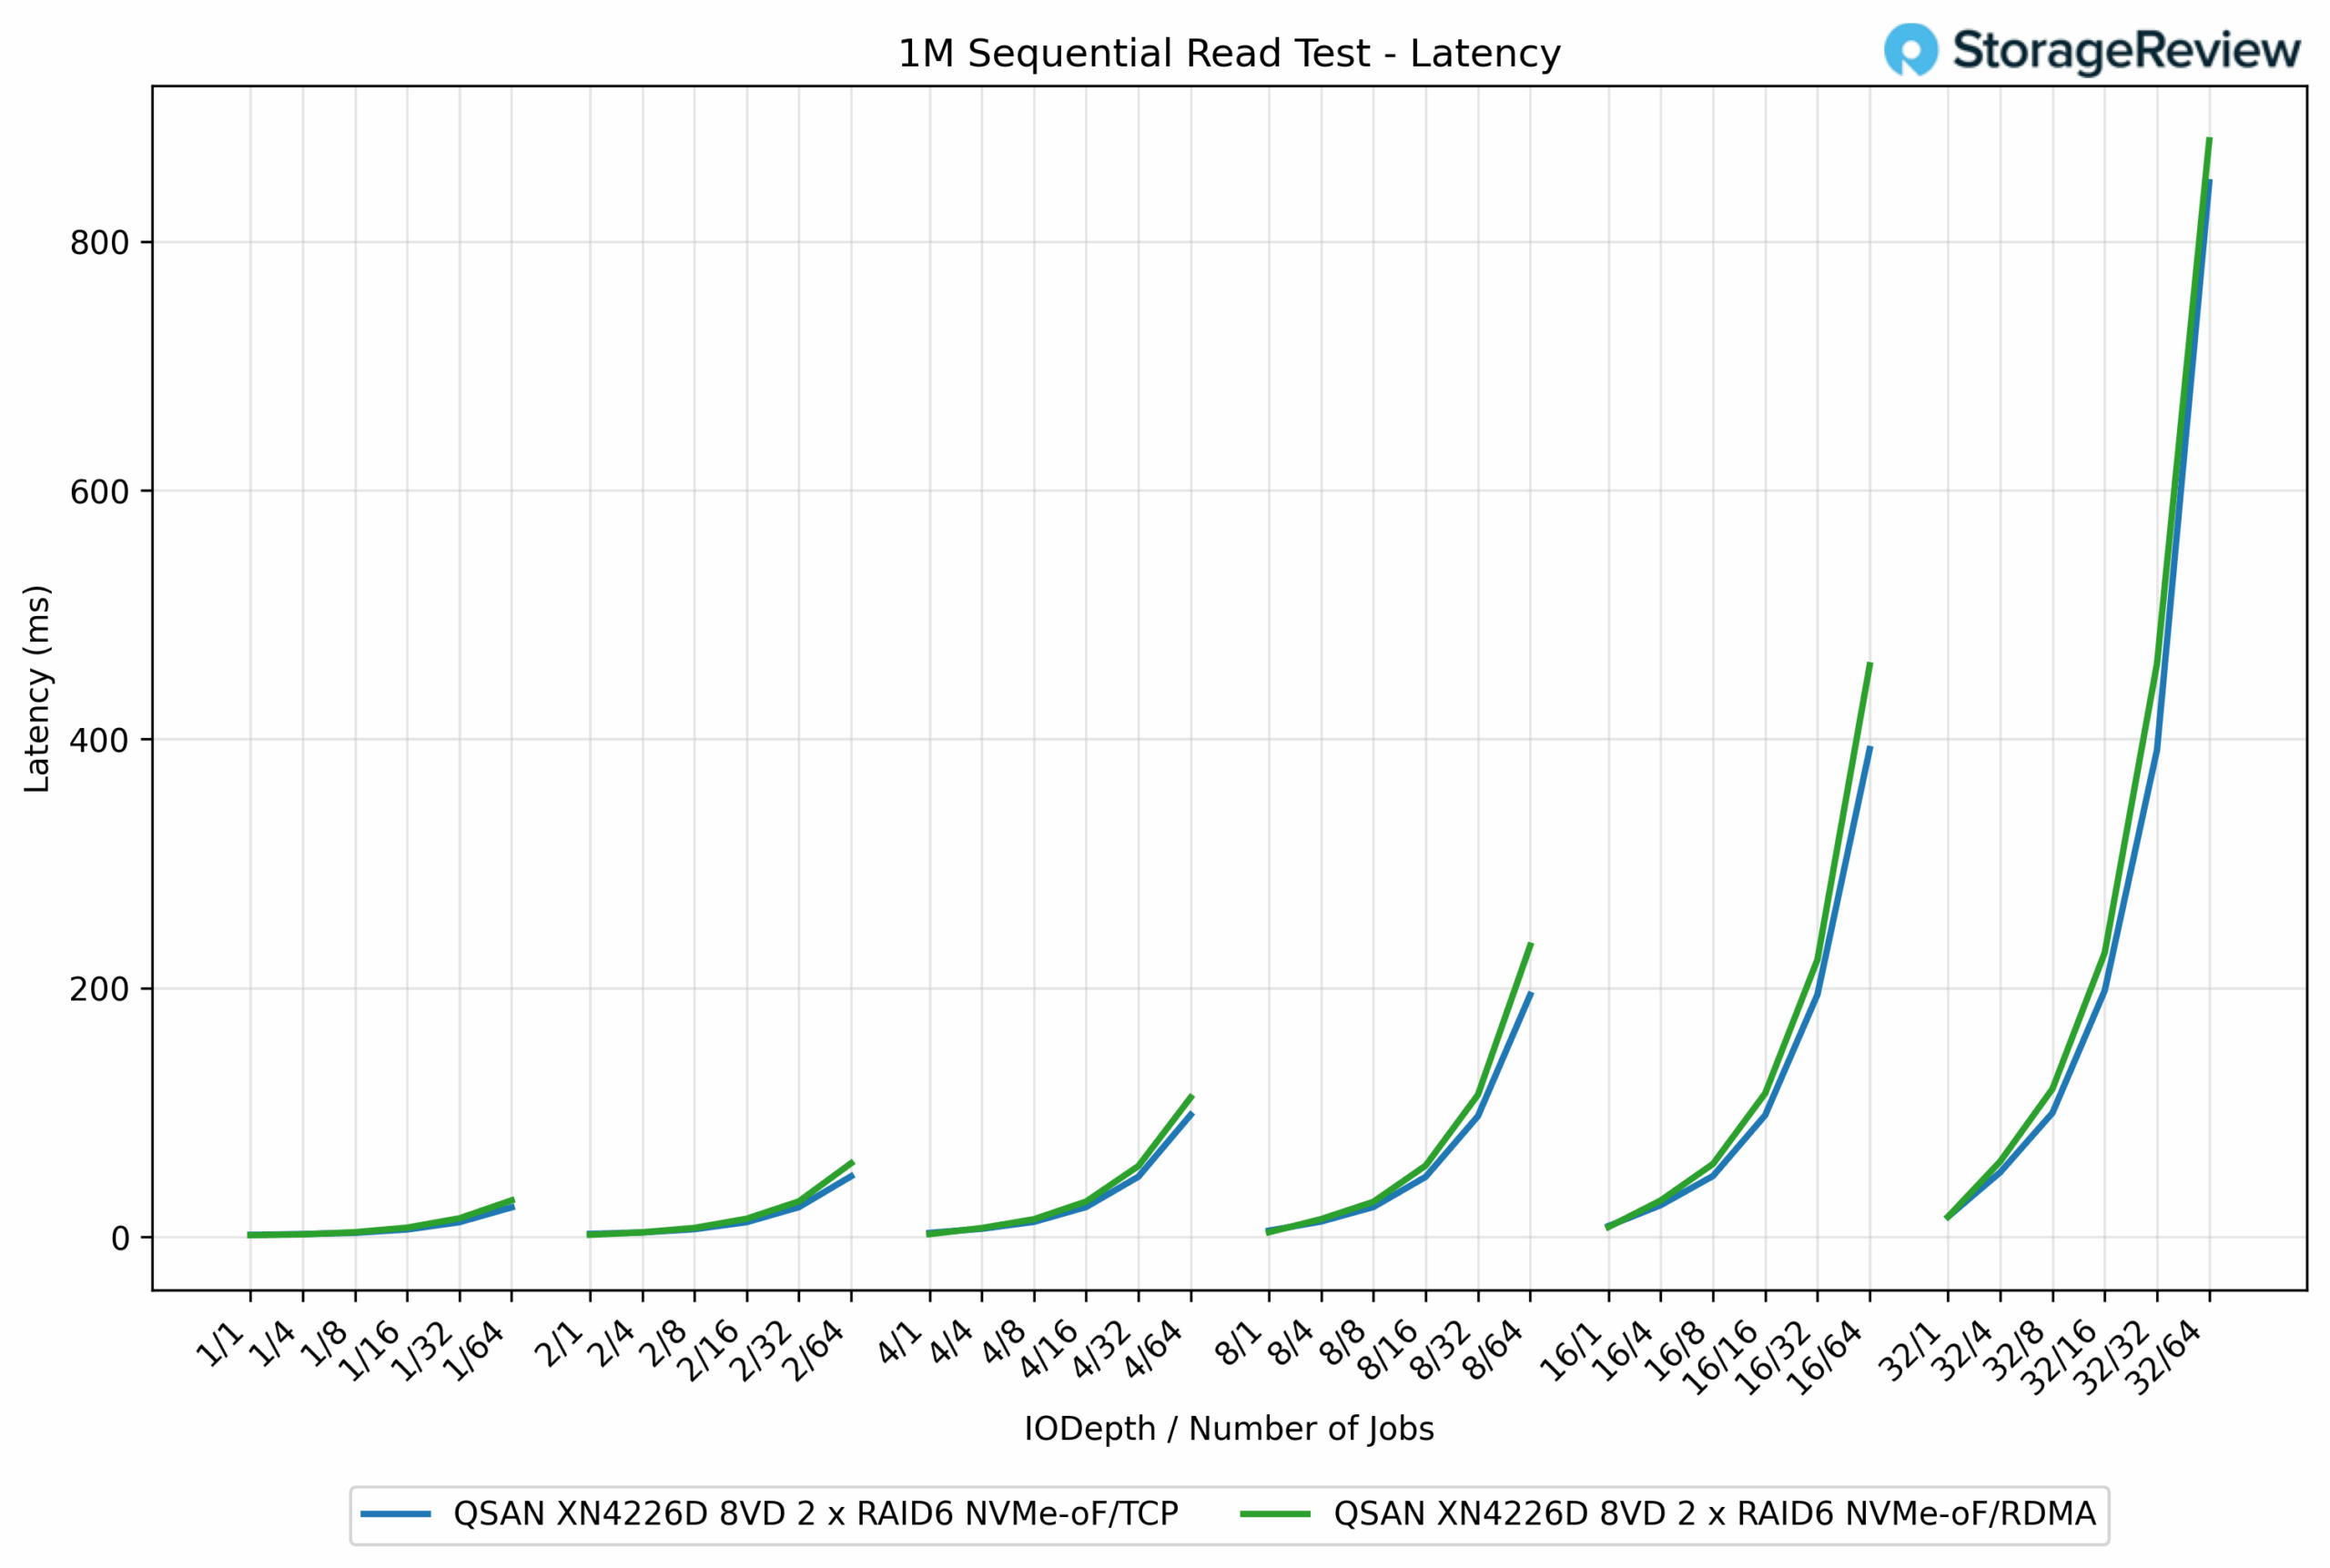
1M 순차 읽기 지연 시간 테스트에서는 두 프로토콜 간 결과가 비슷했지만, RDMA는 일반적으로 대기열 깊이가 높을수록 약간 더 우위를 보였습니다. 가벼운 작업 부하에서는 지연 시간이 거의 동일했으며, 동시성이 증가하기 시작할 때까지 두 프로토콜 모두 5ms 미만으로 유지되었습니다. 예를 들어, QD8/64 작업에서 TCP는 234.09ms를 기록한 반면, RDMA는 194.54ms로 17% 감소했습니다.
이러한 추세는 부하가 더 높을 때도 지속되었습니다. QD32/64 작업에서 RDMA는 847.59ms를 기록한 반면, TCP는 881.31ms를 기록했습니다. 이는 3.8% 소폭 개선된 수치이지만, RDMA의 낮은 스택 오버헤드와도 일맥상통합니다. 하지만 두 프로토콜 모두 유사한 패턴으로 확장되었으며, 작업 부하가 증가함에 따라 지연 시간이 예측 가능하게 증가했습니다.
64k 랜덤 쓰기 IOPS
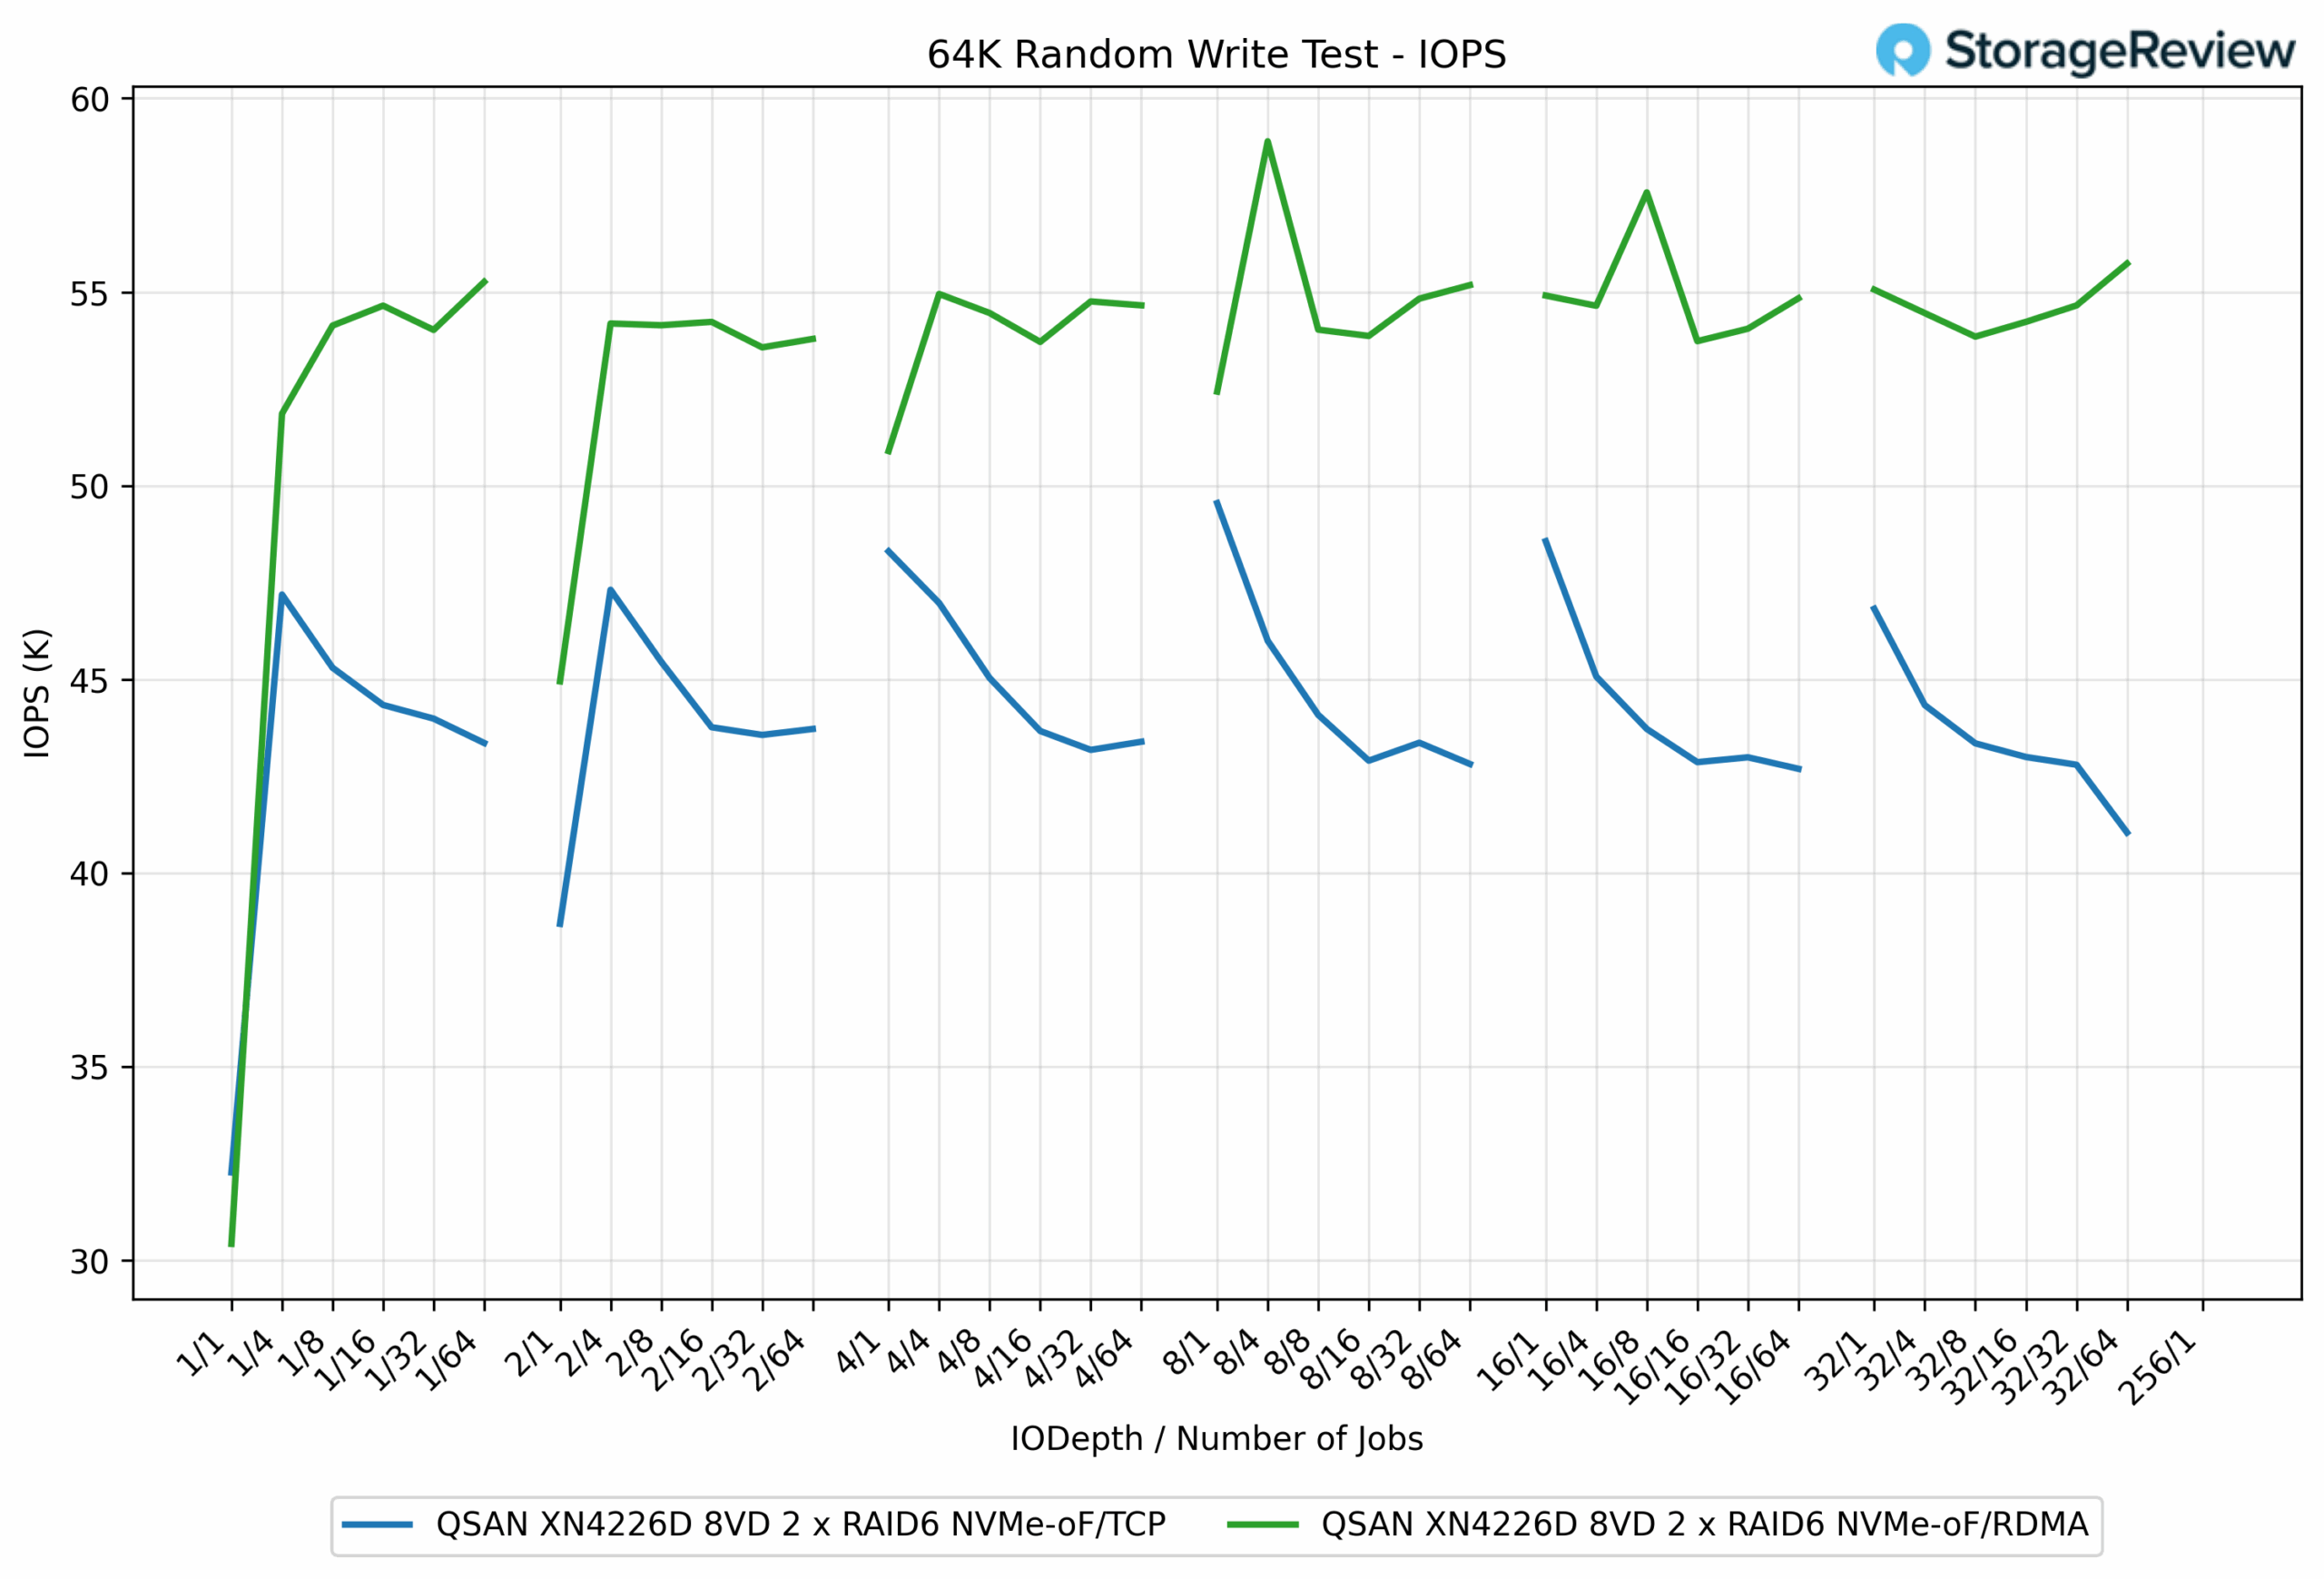
64K 랜덤 쓰기 테스트에서 RDMA는 TCP보다 지속적으로 높은 IOPS를 제공하여 병렬화된 랜덤 작업 처리 효율성을 입증했습니다. 최대 성능에서 RDMA는 58.89K IOPS에 도달한 반면, TCP는 48.57K IOPS로 21%의 성능 우위를 보였습니다.
두 프로토콜 간의 차이는 테스트 내내 나타났습니다. 예를 들어, QD1/16 작업에서 RDMA는 54.13K IOPS를 기록한 반면, TCP는 45.30K IOPS를 기록하여 거의 16%의 차이를 보였습니다. 작업 부하가 더 커짐에 따라 RDMA는 53K~55K IOPS 범위를 유지한 반면, TCP는 42K~46K IOPS 범위를 유지했습니다.
64K 임의 쓰기 지연 시간
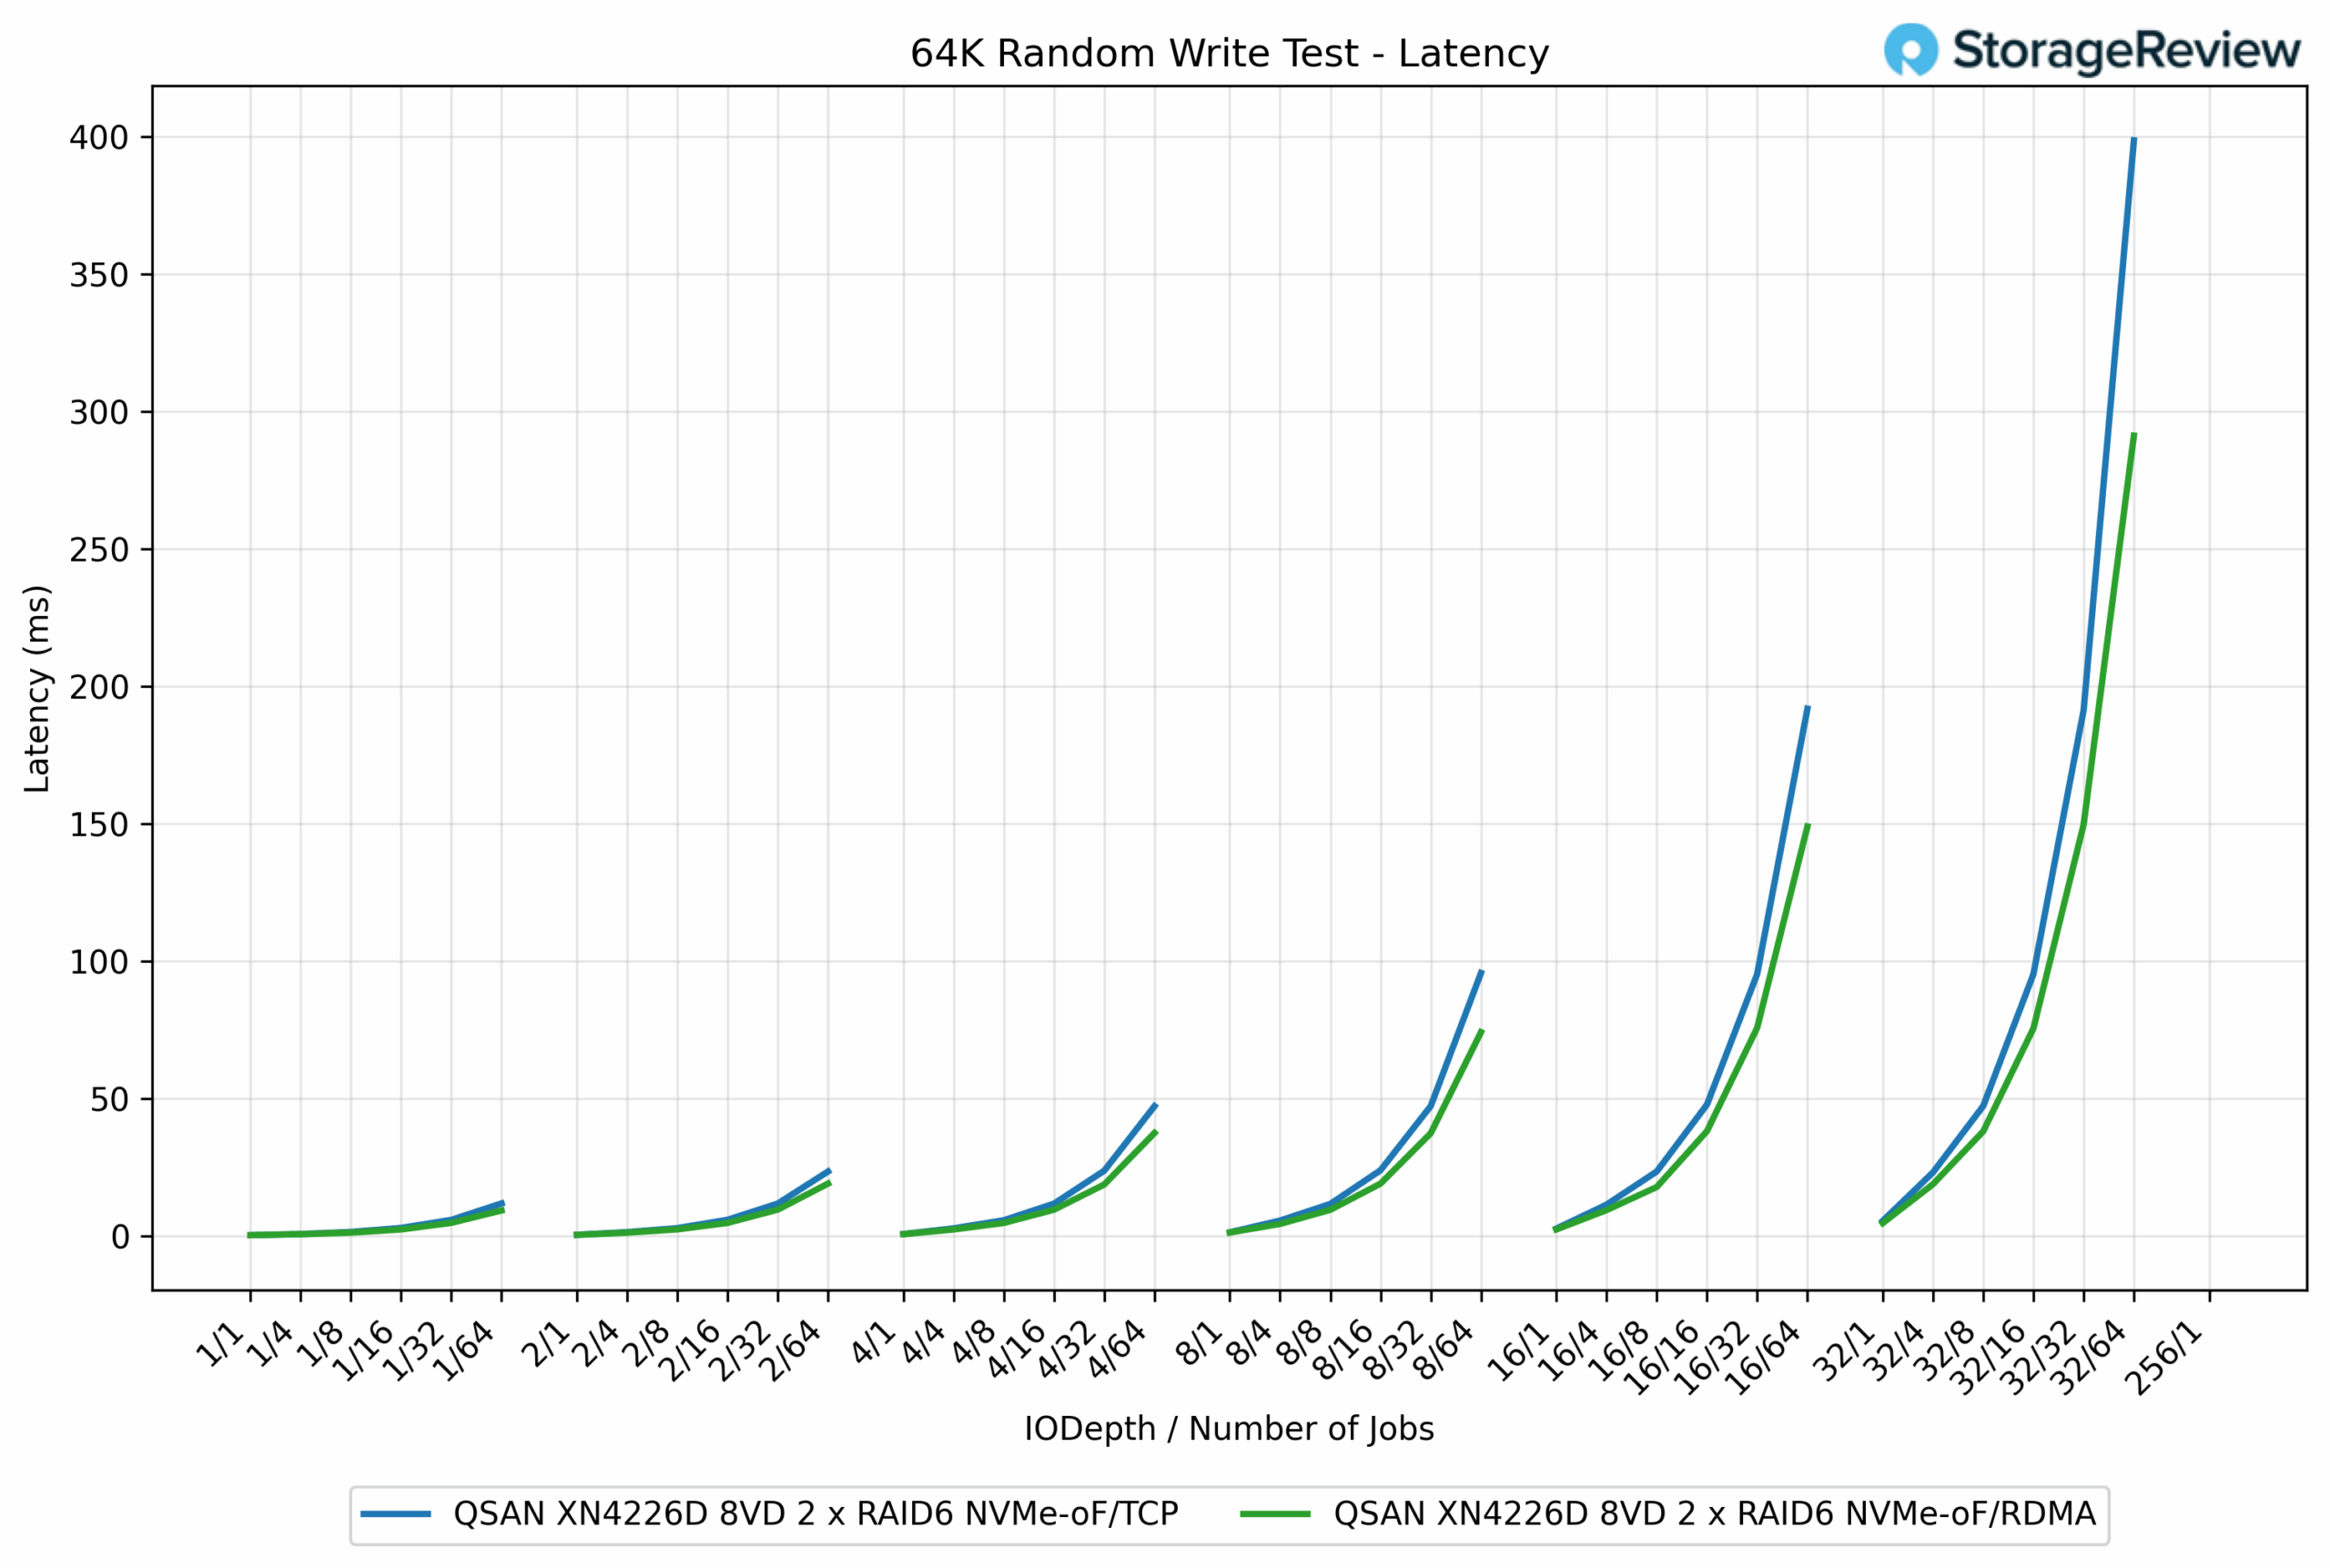
64K 랜덤 쓰기 지연 시간 테스트에서 RDMA는 TCP보다 응답 시간이 더 짧았는데, 특히 대기열 깊이와 작업 수가 증가함에 따라 더욱 두드러졌습니다. 부하가 낮을 때는 두 프로토콜 모두 거의 동일한 성능을 보였으며, 1ms 미만을 유지했습니다. 예를 들어, QD1/1 작업에서 TCP는 0.26ms를 기록한 반면, RDMA는 0.25ms로 거의 동일했습니다.
그러나 작업 부하가 증가함에 따라 RDMA는 효율성 우위를 유지했습니다. QD16/64 작업에서 RDMA는 74.09ms를 기록한 반면 TCP는 95.64ms를 기록하여 약 23%의 차이를 보였습니다. 최대 부하가 걸리는 QD256/1 작업에서는 RDMA가 291.13ms를 기록한 반면 TCP는 398.56ms로 거의 37% 더 높은 속도를 기록했습니다.
64K 무작위 읽기 IOPS
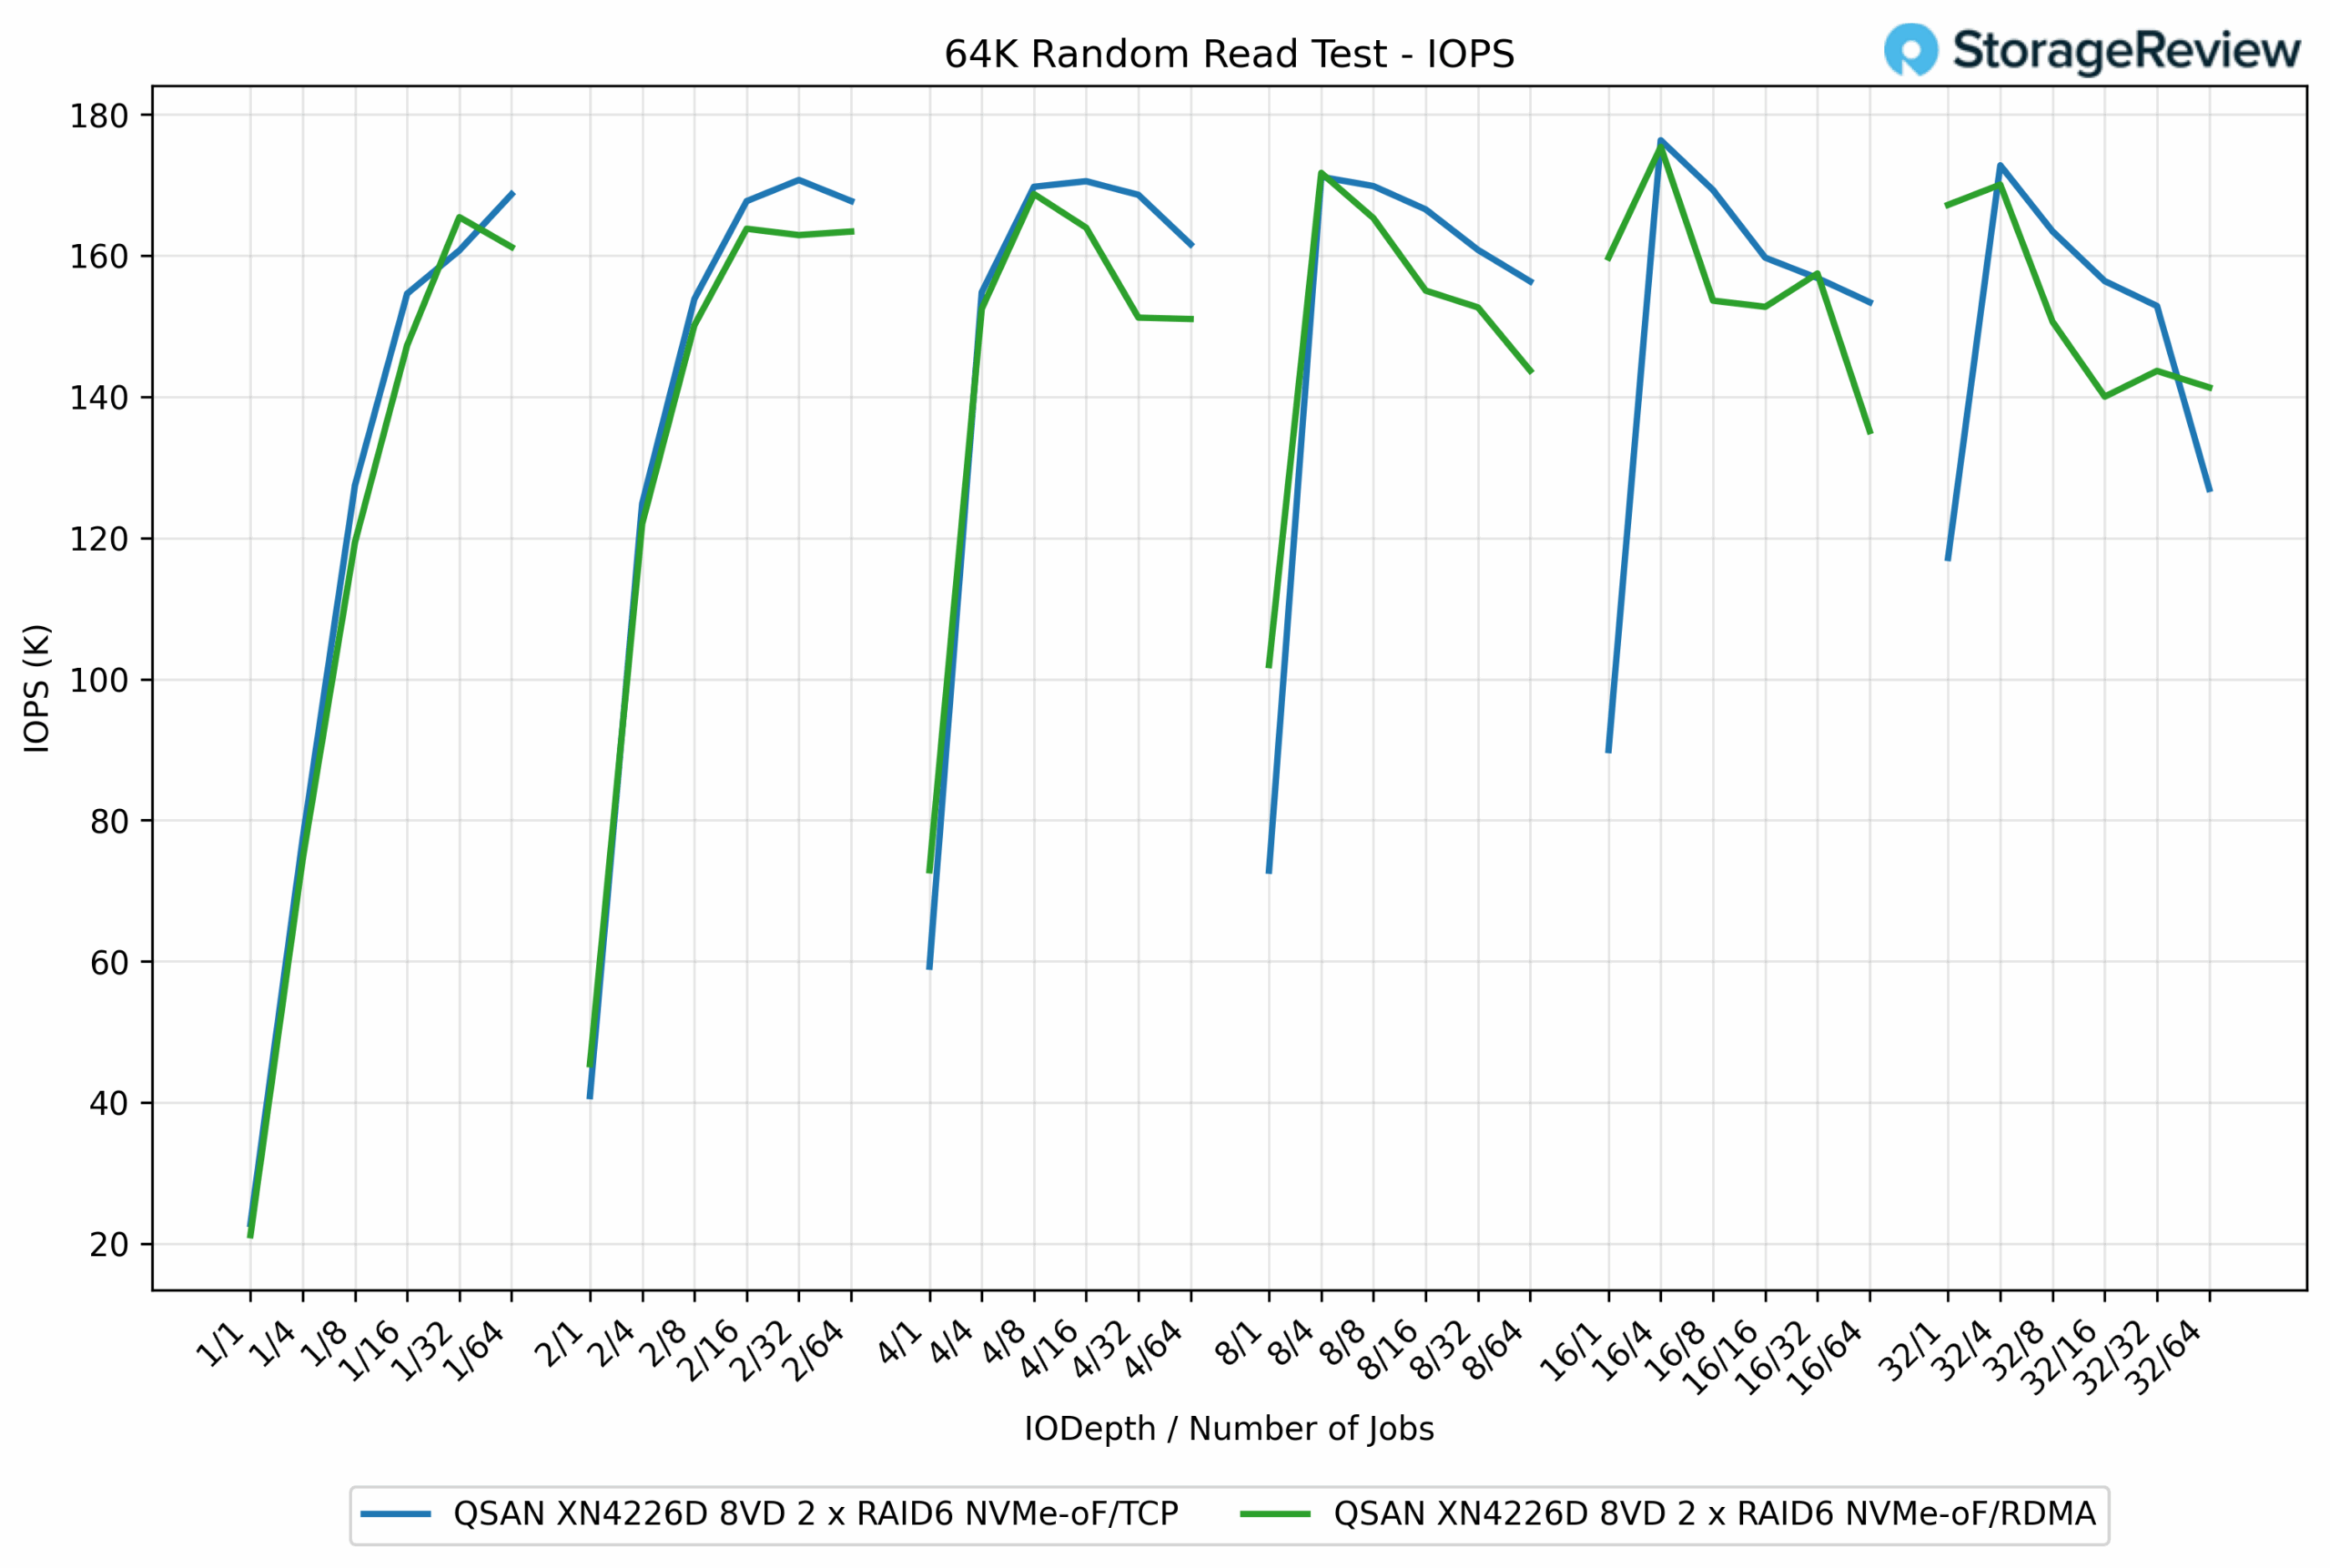
64K 랜덤 읽기 테스트에서 TCP와 RDMA는 전반적으로 매우 유사한 성능을 보였으며, 워크로드에 따라 두 프로토콜 간의 성능 차이가 약간씩 나타났습니다. TCP는 최대 176.33K IOPS를 달성한 반면, RDMA는 175.40K IOPS로 그 뒤를 이었고, 0.5%의 차이만 보였습니다.
중간 심도에서는 결과가 밀접하게 그룹화되었습니다. 예를 들어, 4분기/16일 작업에서 TCP는 168.60K IOPS를 기록한 반면, RDMA는 163.94K IOPS로 그 뒤를 이었고, 이는 2.8% 미만의 차이였습니다. 다른 지점에서는 RDMA가 약간 더 높은 수치를 보였는데, 예를 들어 8분기/1일 작업에서는 RDMA가 171.71K IOPS를 기록했고, TCP는 171.15K IOPS를 기록하여 사실상 동률을 이루었습니다.
64K 랜덤 읽기 대기 시간
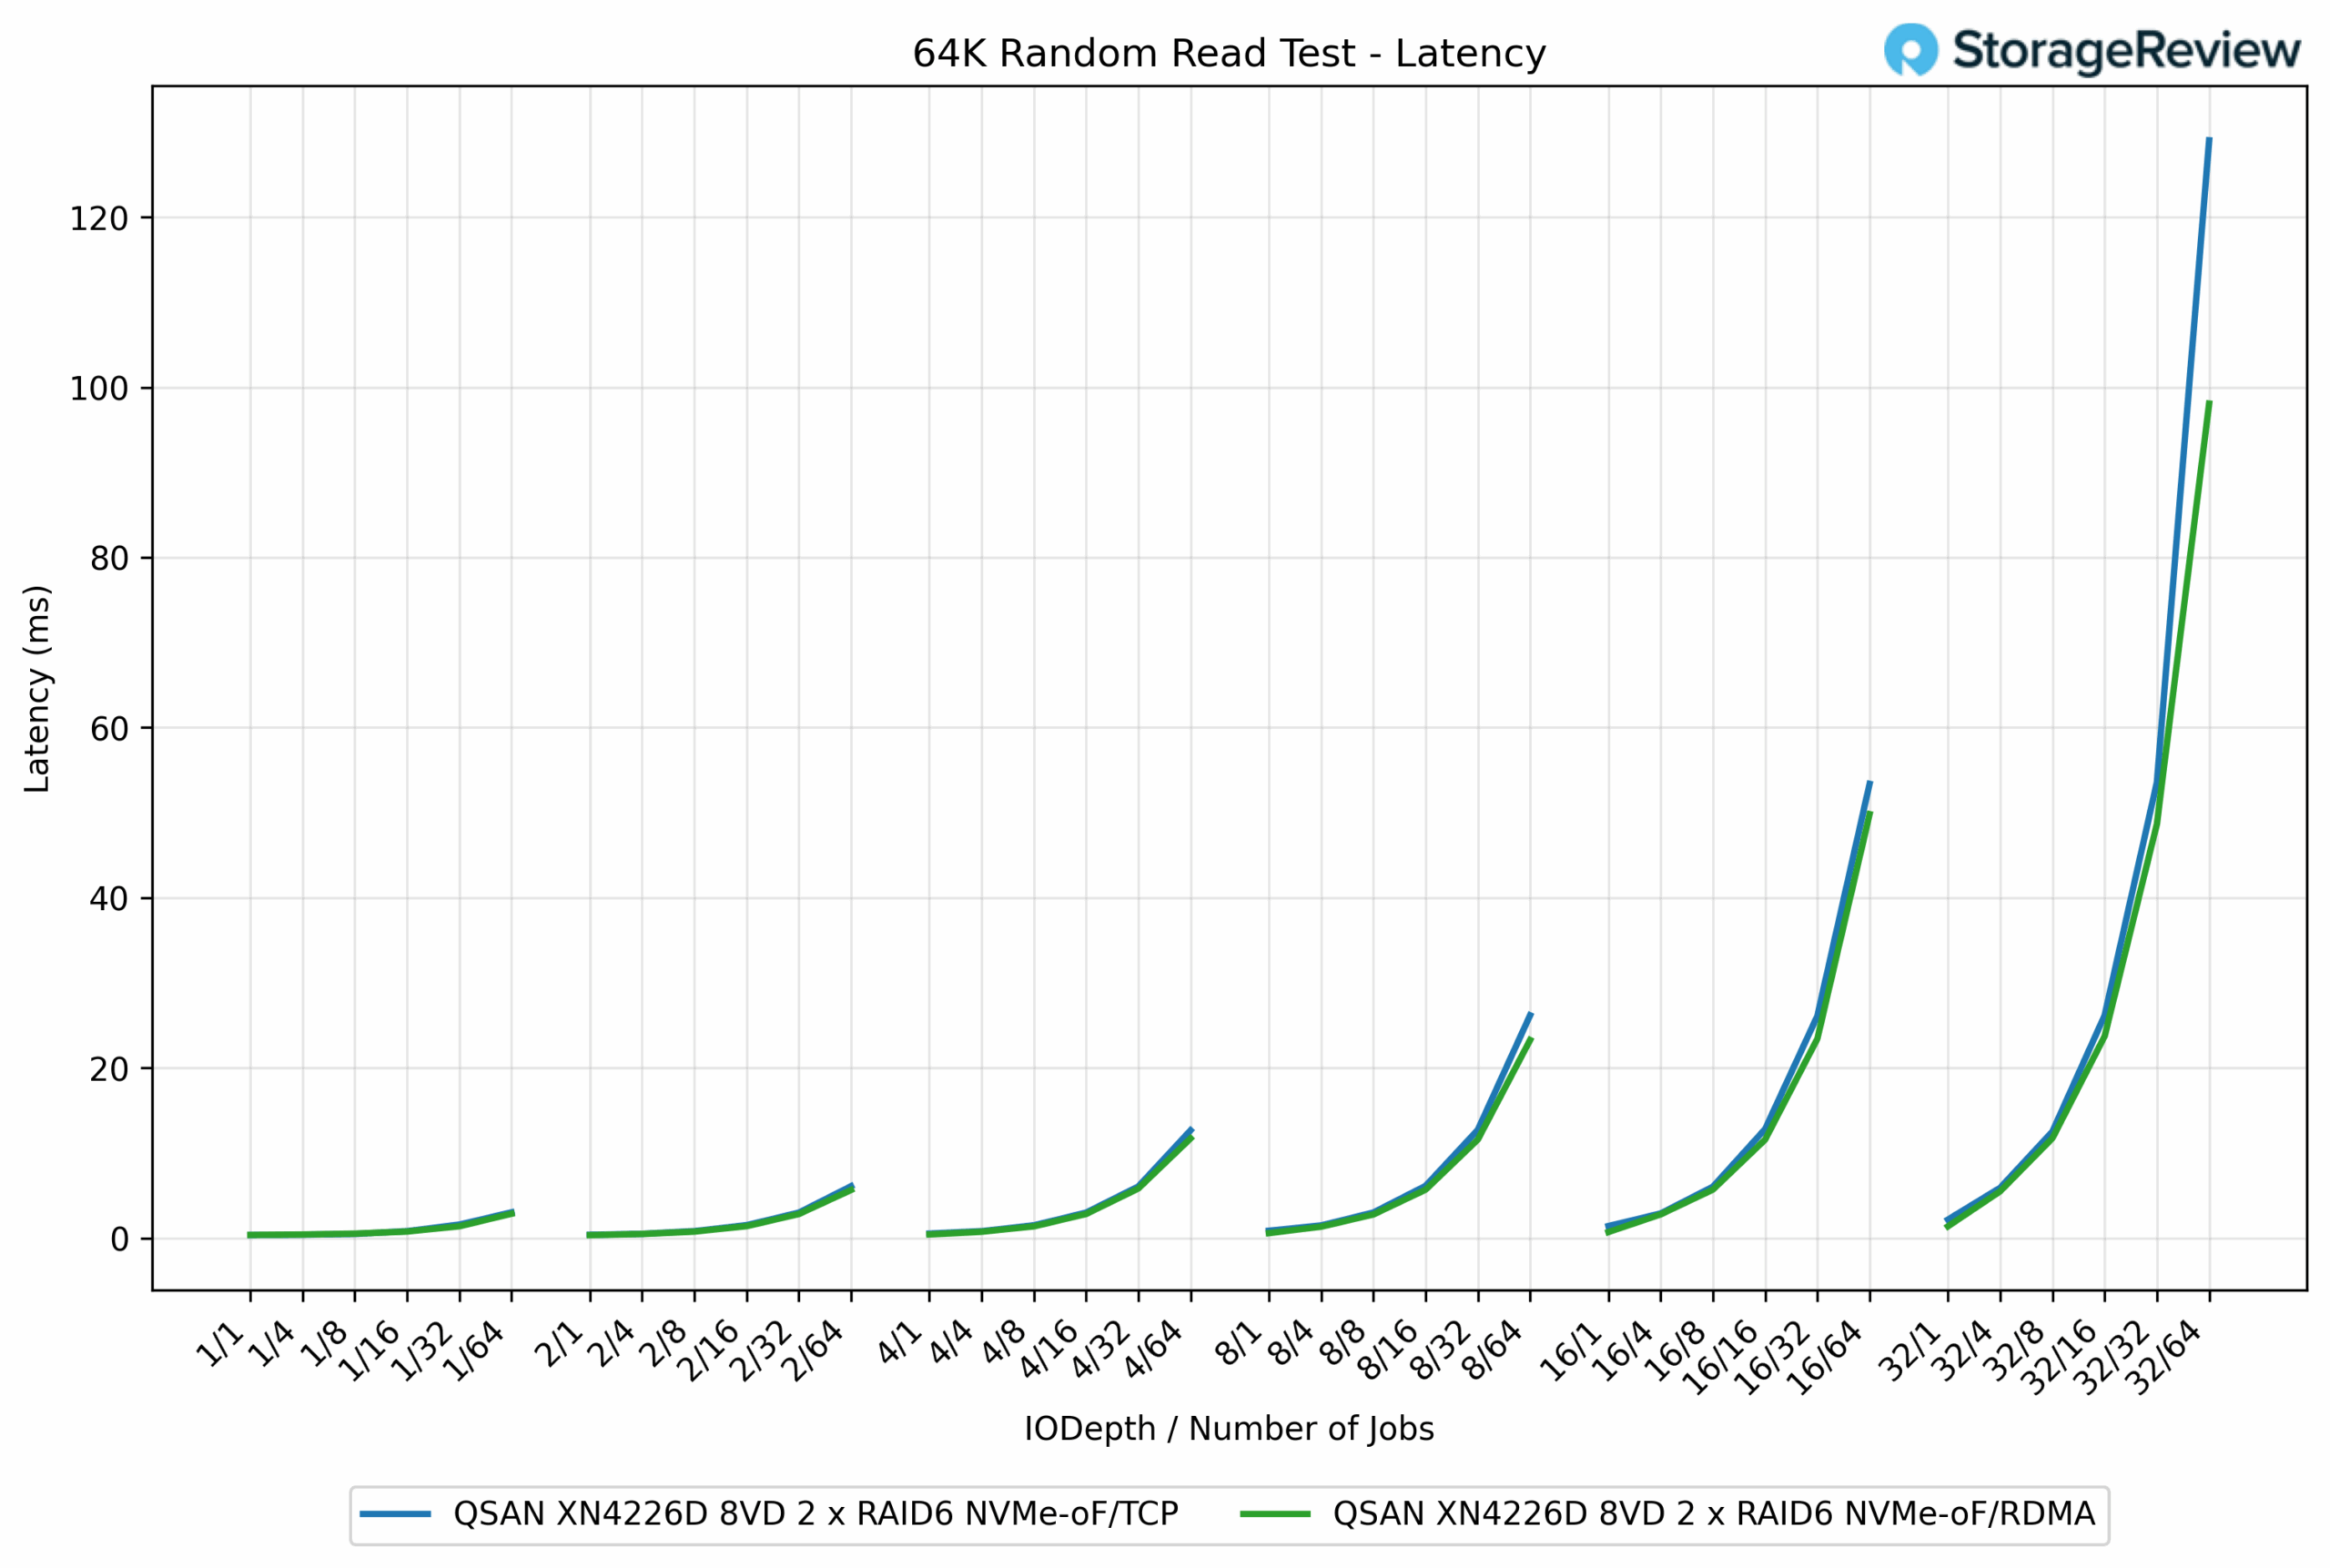
64K 랜덤 읽기 지연 시간 테스트에서 두 프로토콜은 매우 유사한 결과를 보였지만, RDMA는 높은 부하에서 약간의 우위를 보였습니다. 가벼운 작업 부하에서는 TCP와 RDMA 모두 1ms 미만의 지연 시간을 기록하여 사실상 구분이 불가능했습니다. 예를 들어, QD1/1 작업에서 TCP는 0.43ms를 기록한 반면 RDMA는 0.38ms를 기록했습니다.
동시성이 증가함에 따라 그 차이는 더욱 두드러졌습니다. QD16/64 작업에서 RDMA는 23.28ms, TCP는 26.19ms로 12% 향상되었습니다. 최대 부하 상황에서는 RDMA가 98.08ms, TCP가 129.02ms로 24% 감소하여 차이가 더 커졌습니다.
16K 무작위 쓰기 IOPS
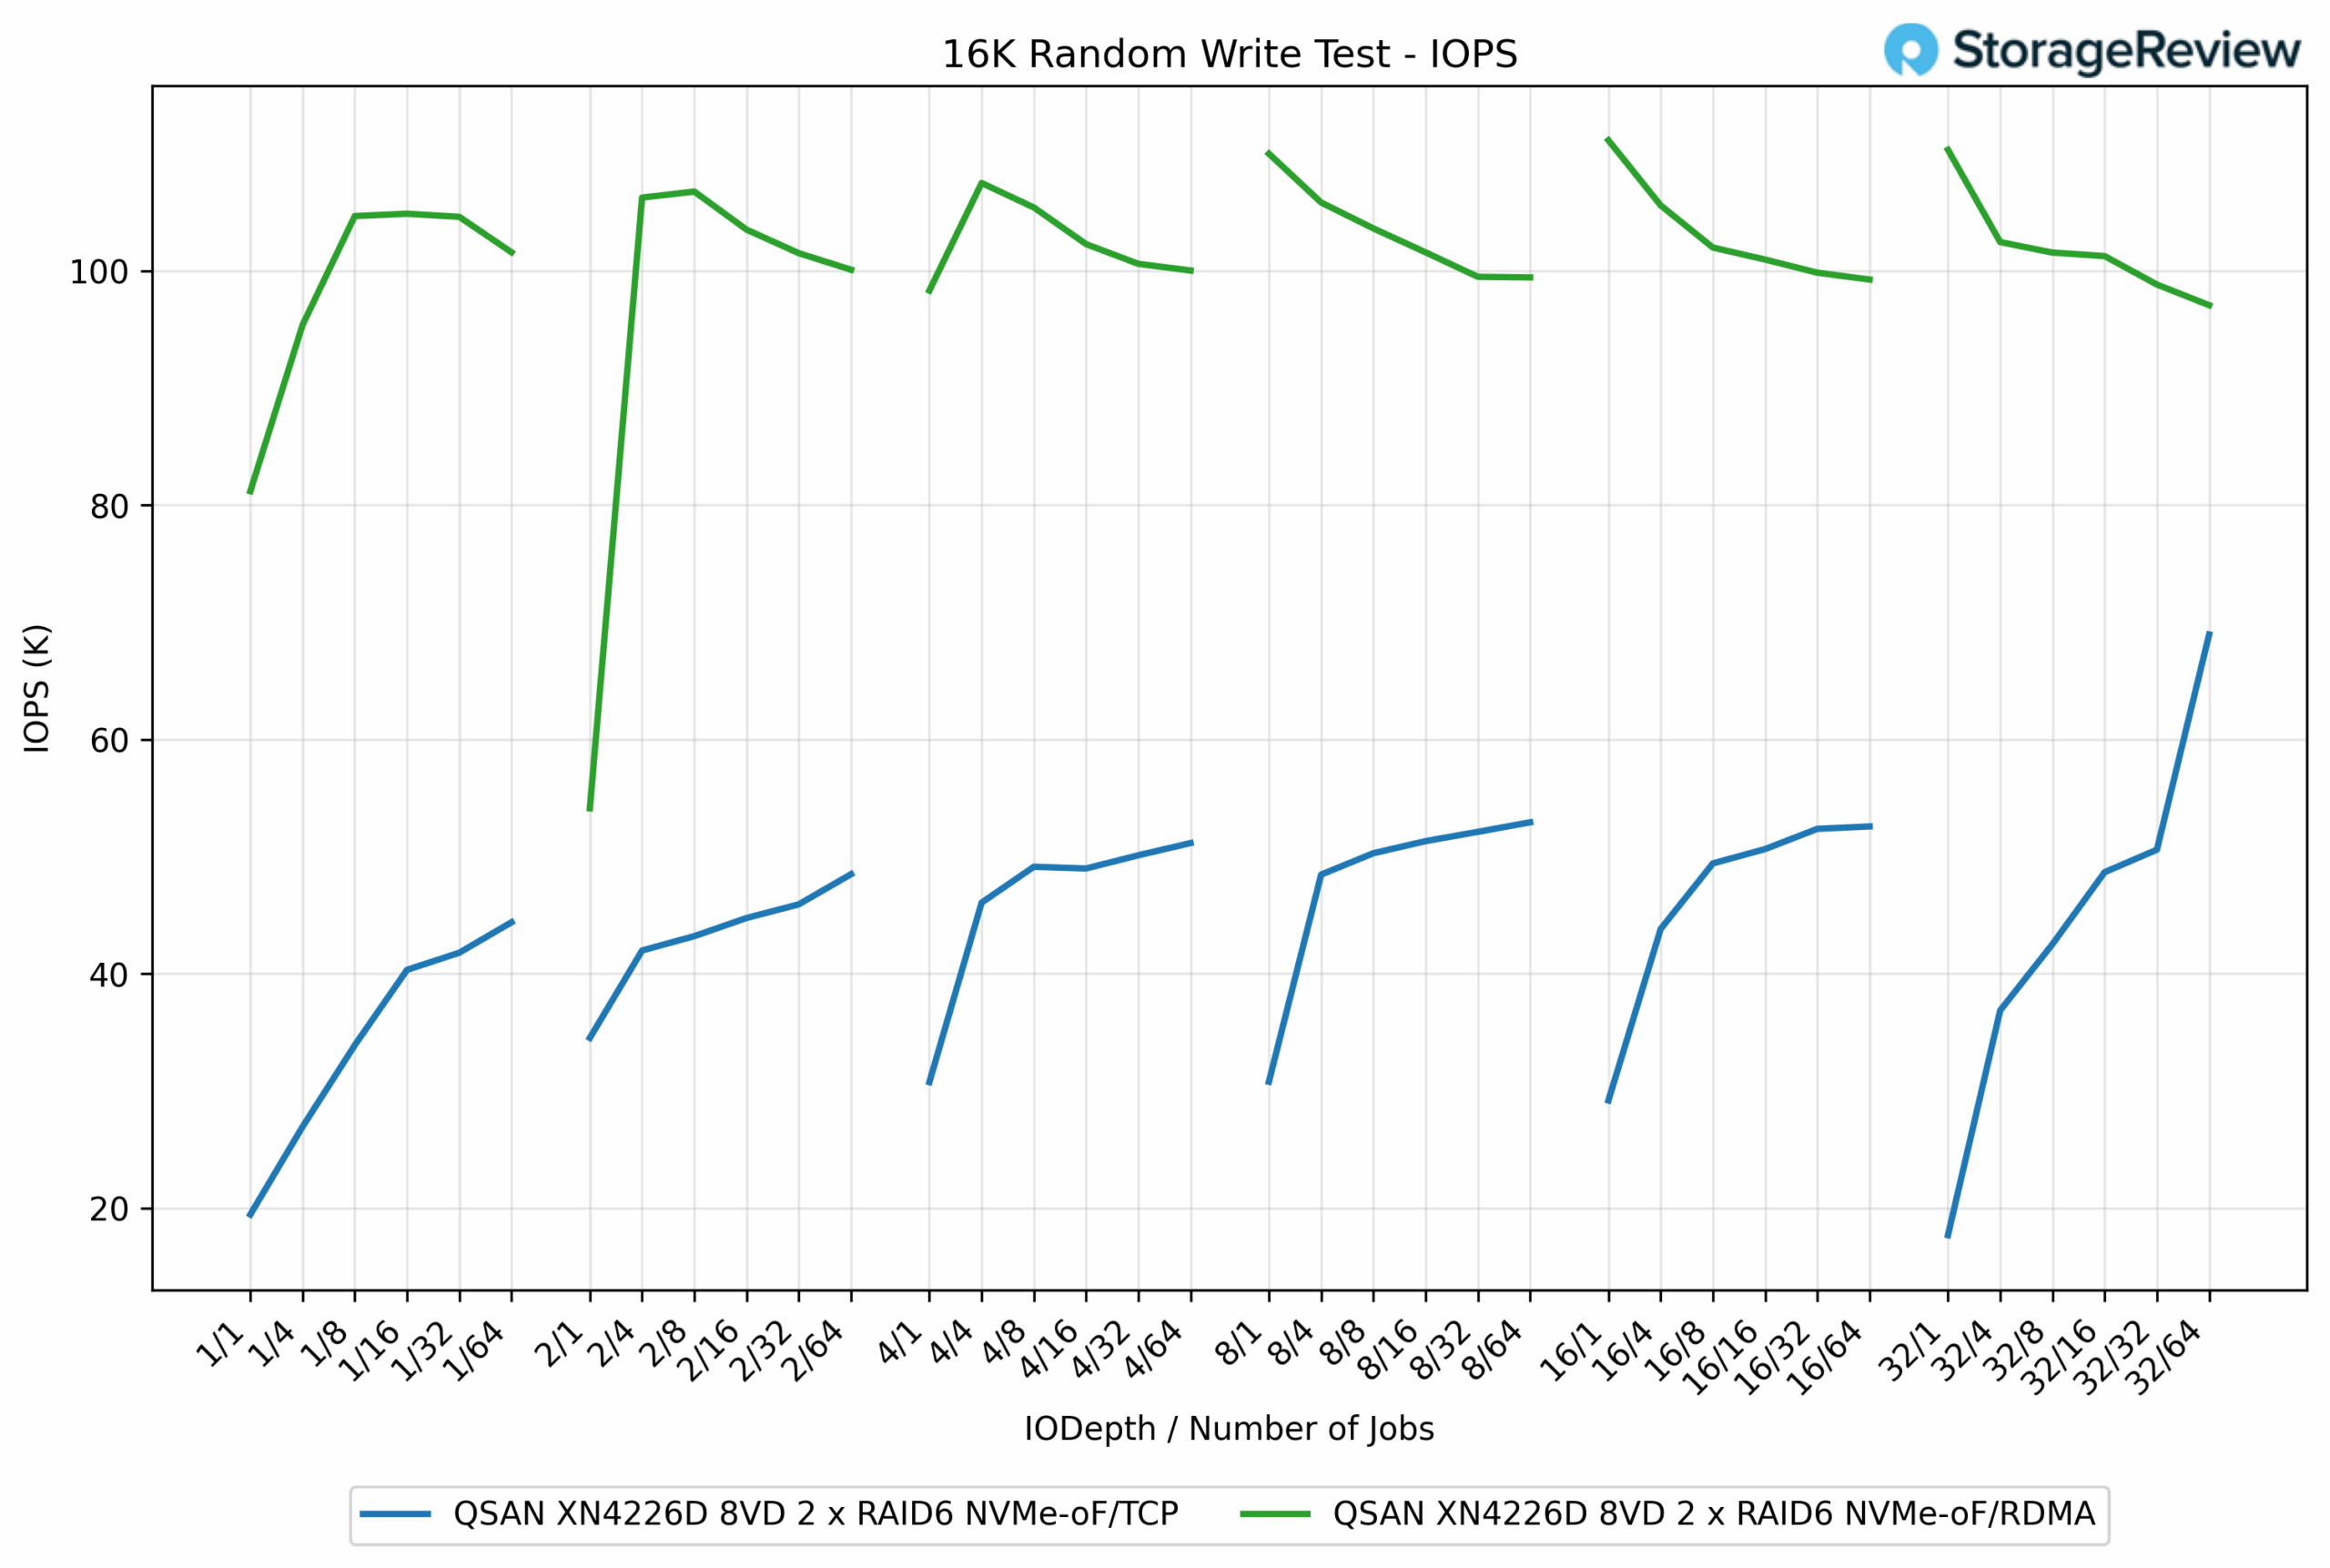
16K 랜덤 쓰기 테스트에서 두 프로토콜 간의 성능 차이는 상당했으며, 대부분의 경우 RDMA가 TCP보다 두 배 이상의 IOPS를 제공했습니다. RDMA는 111.13K IOPS로 최고치를 기록한 반면, TCP는 68.95K IOPS로 최고치를 기록하여 RDMA가 61% 더 우수한 것으로 나타났습니다.
대기열 깊이가 낮을수록 차이는 확연했습니다. 예를 들어, QD1/16 작업에서 RDMA는 104.86K IOPS를 기록한 반면, TCP는 41.78K IOPS를 기록하여 RDMA가 151% 더 높은 성능을 보였습니다. 전체 워크로드 범위에서 RDMA는 100K~111K IOPS 범위에서 지속적으로 결과를 유지한 반면, TCP는 최대 깊이에서 후반부 급증을 제외하고 전반적으로 40K~50K IOPS 범위를 유지했습니다.
16K 임의 쓰기 지연 시간
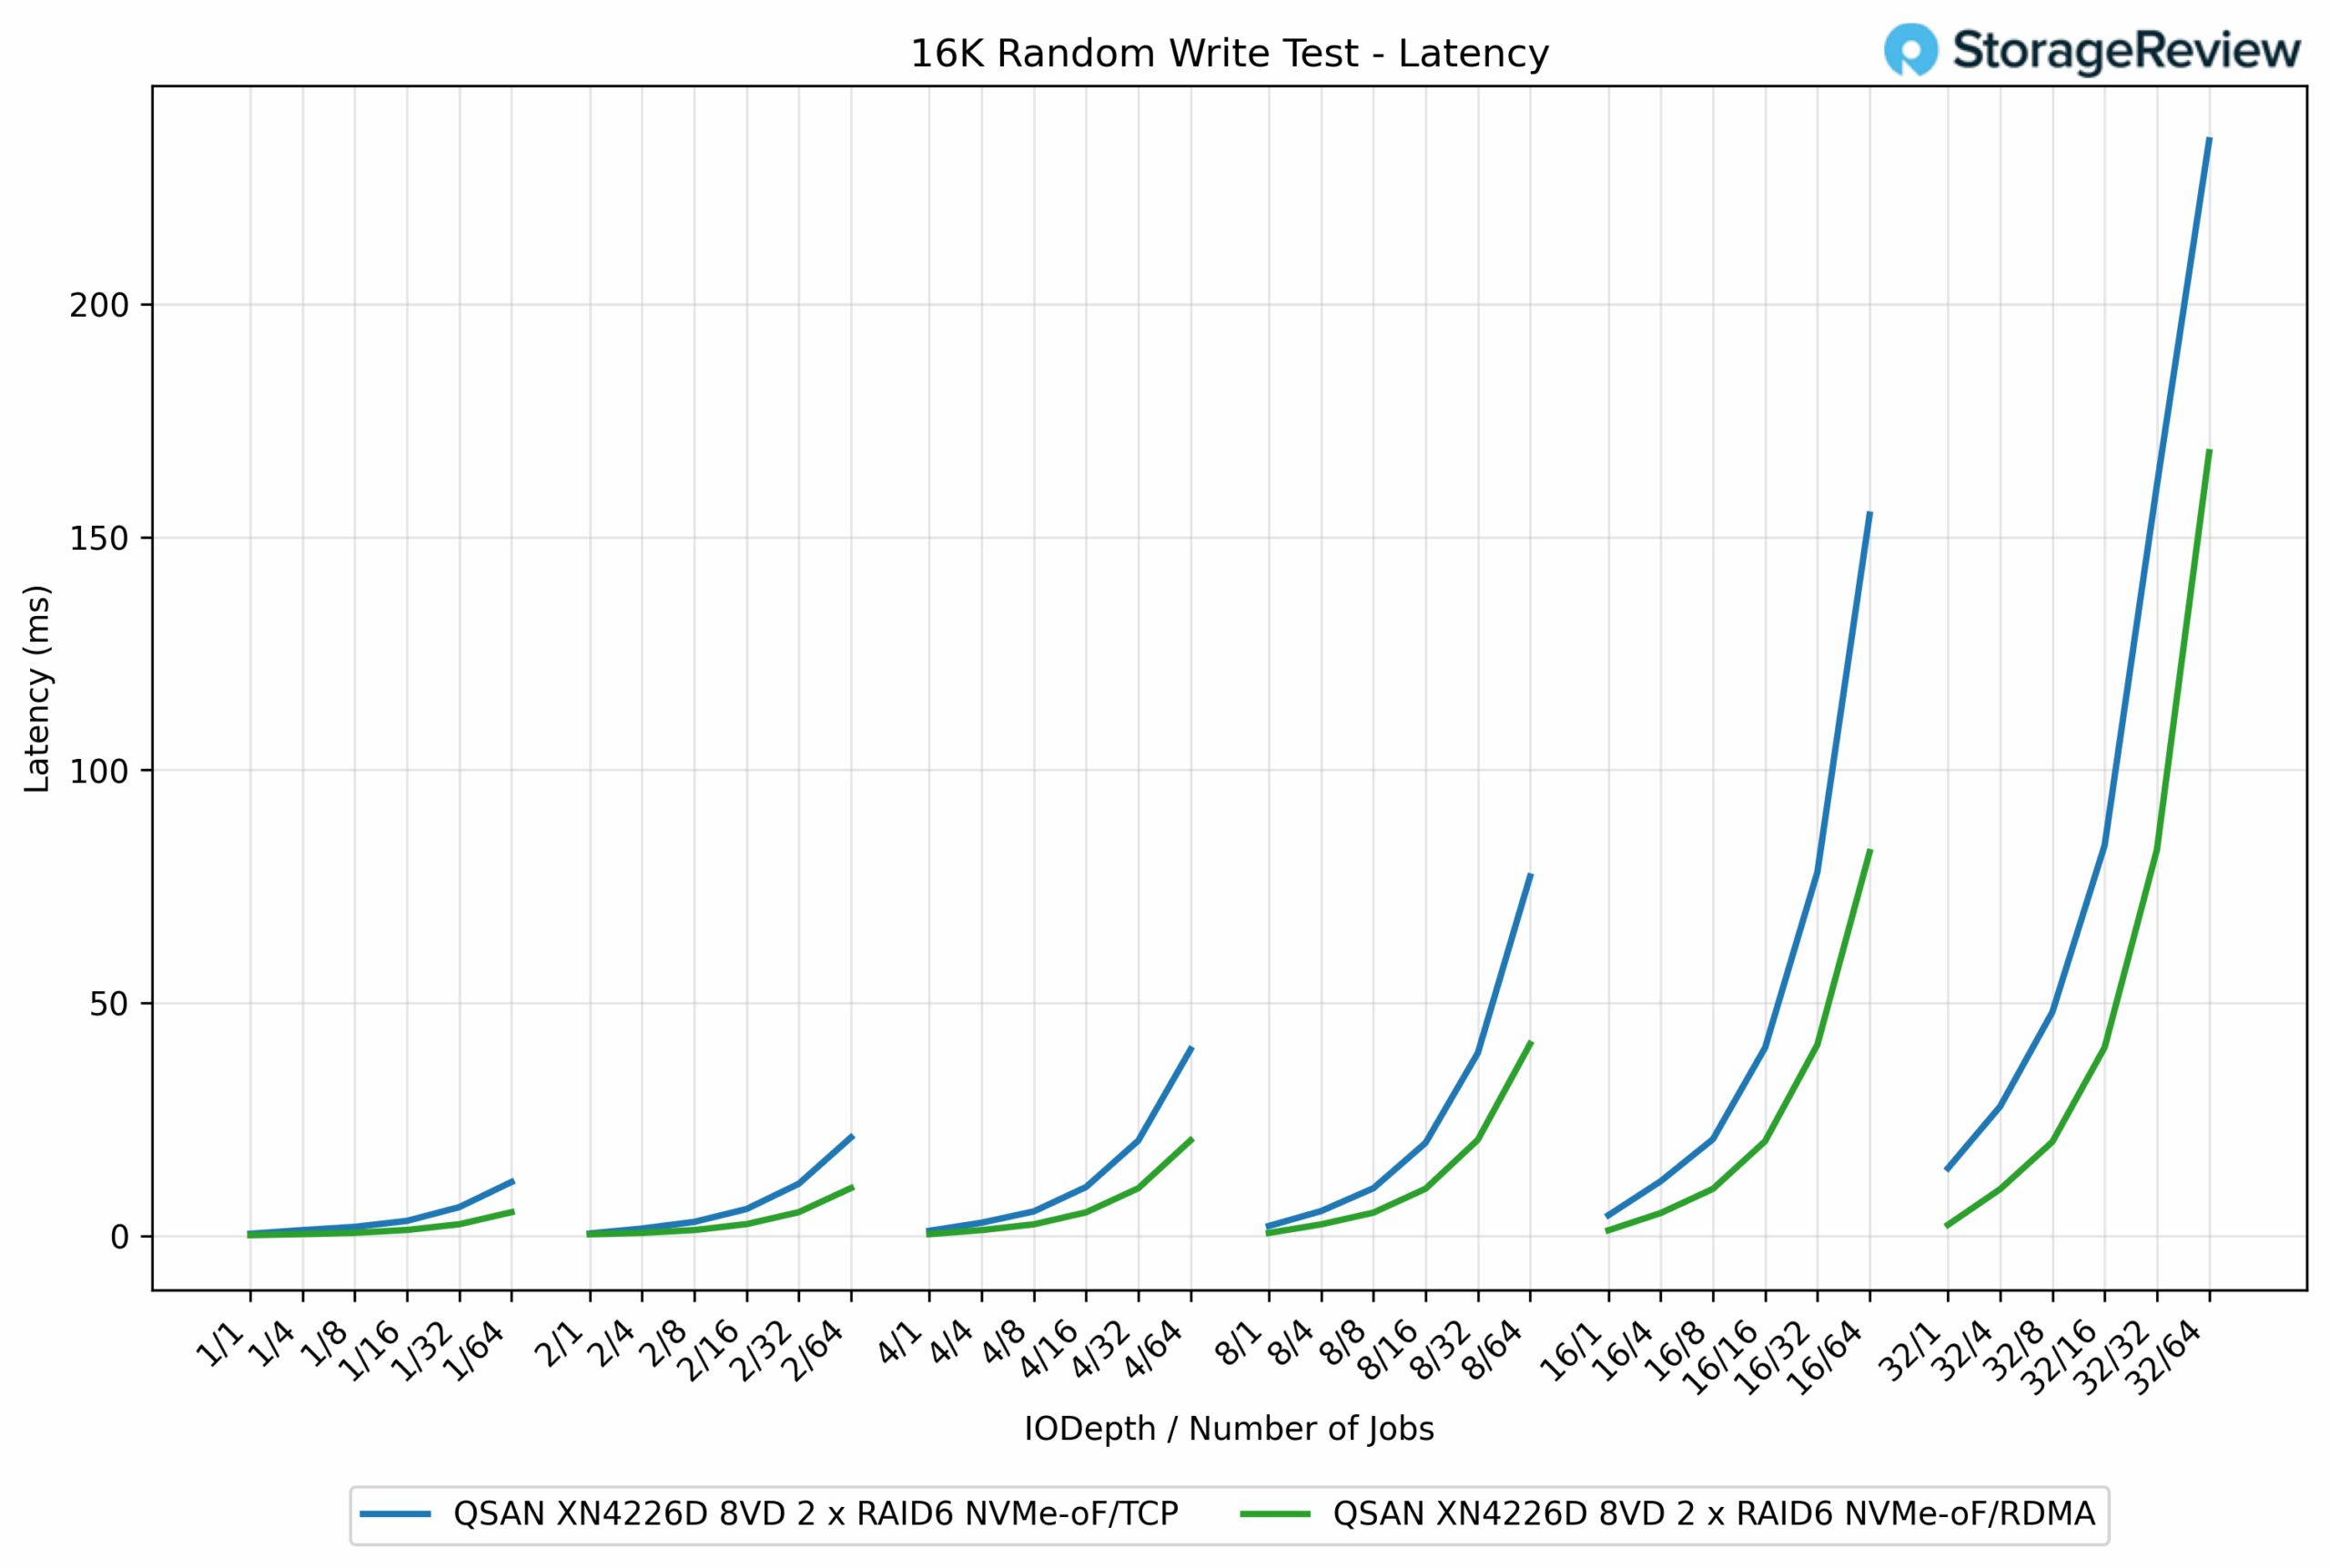
16K 랜덤 쓰기 지연 시간 테스트에서 RDMA는 워크로드가 확장됨에 따라 TCP보다 확연한 우위를 유지했습니다. 부하가 낮은 상황에서는 두 프로토콜 모두 거의 동일했으며, 응답 시간은 2ms 미만으로 유지되었습니다. 예를 들어, QD1/1 작업에서 TCP는 0.40ms, RDMA는 0.41ms를 기록했습니다.
동시성이 증가함에 따라 RDMA가 분리되기 시작했습니다. QD16/64 작업에서 RDMA는 21.15ms를 기록한 반면, TCP는 77.12ms로 72%의 극적인 감소를 보였습니다. 이러한 이점은 최고 깊이에서도 지속되었습니다. QD32/64 작업에서 RDMA는 161.13ms로 완료되었고, TCP는 235.17ms로 31% 향상되었습니다.
16K 무작위 읽기 IOPS
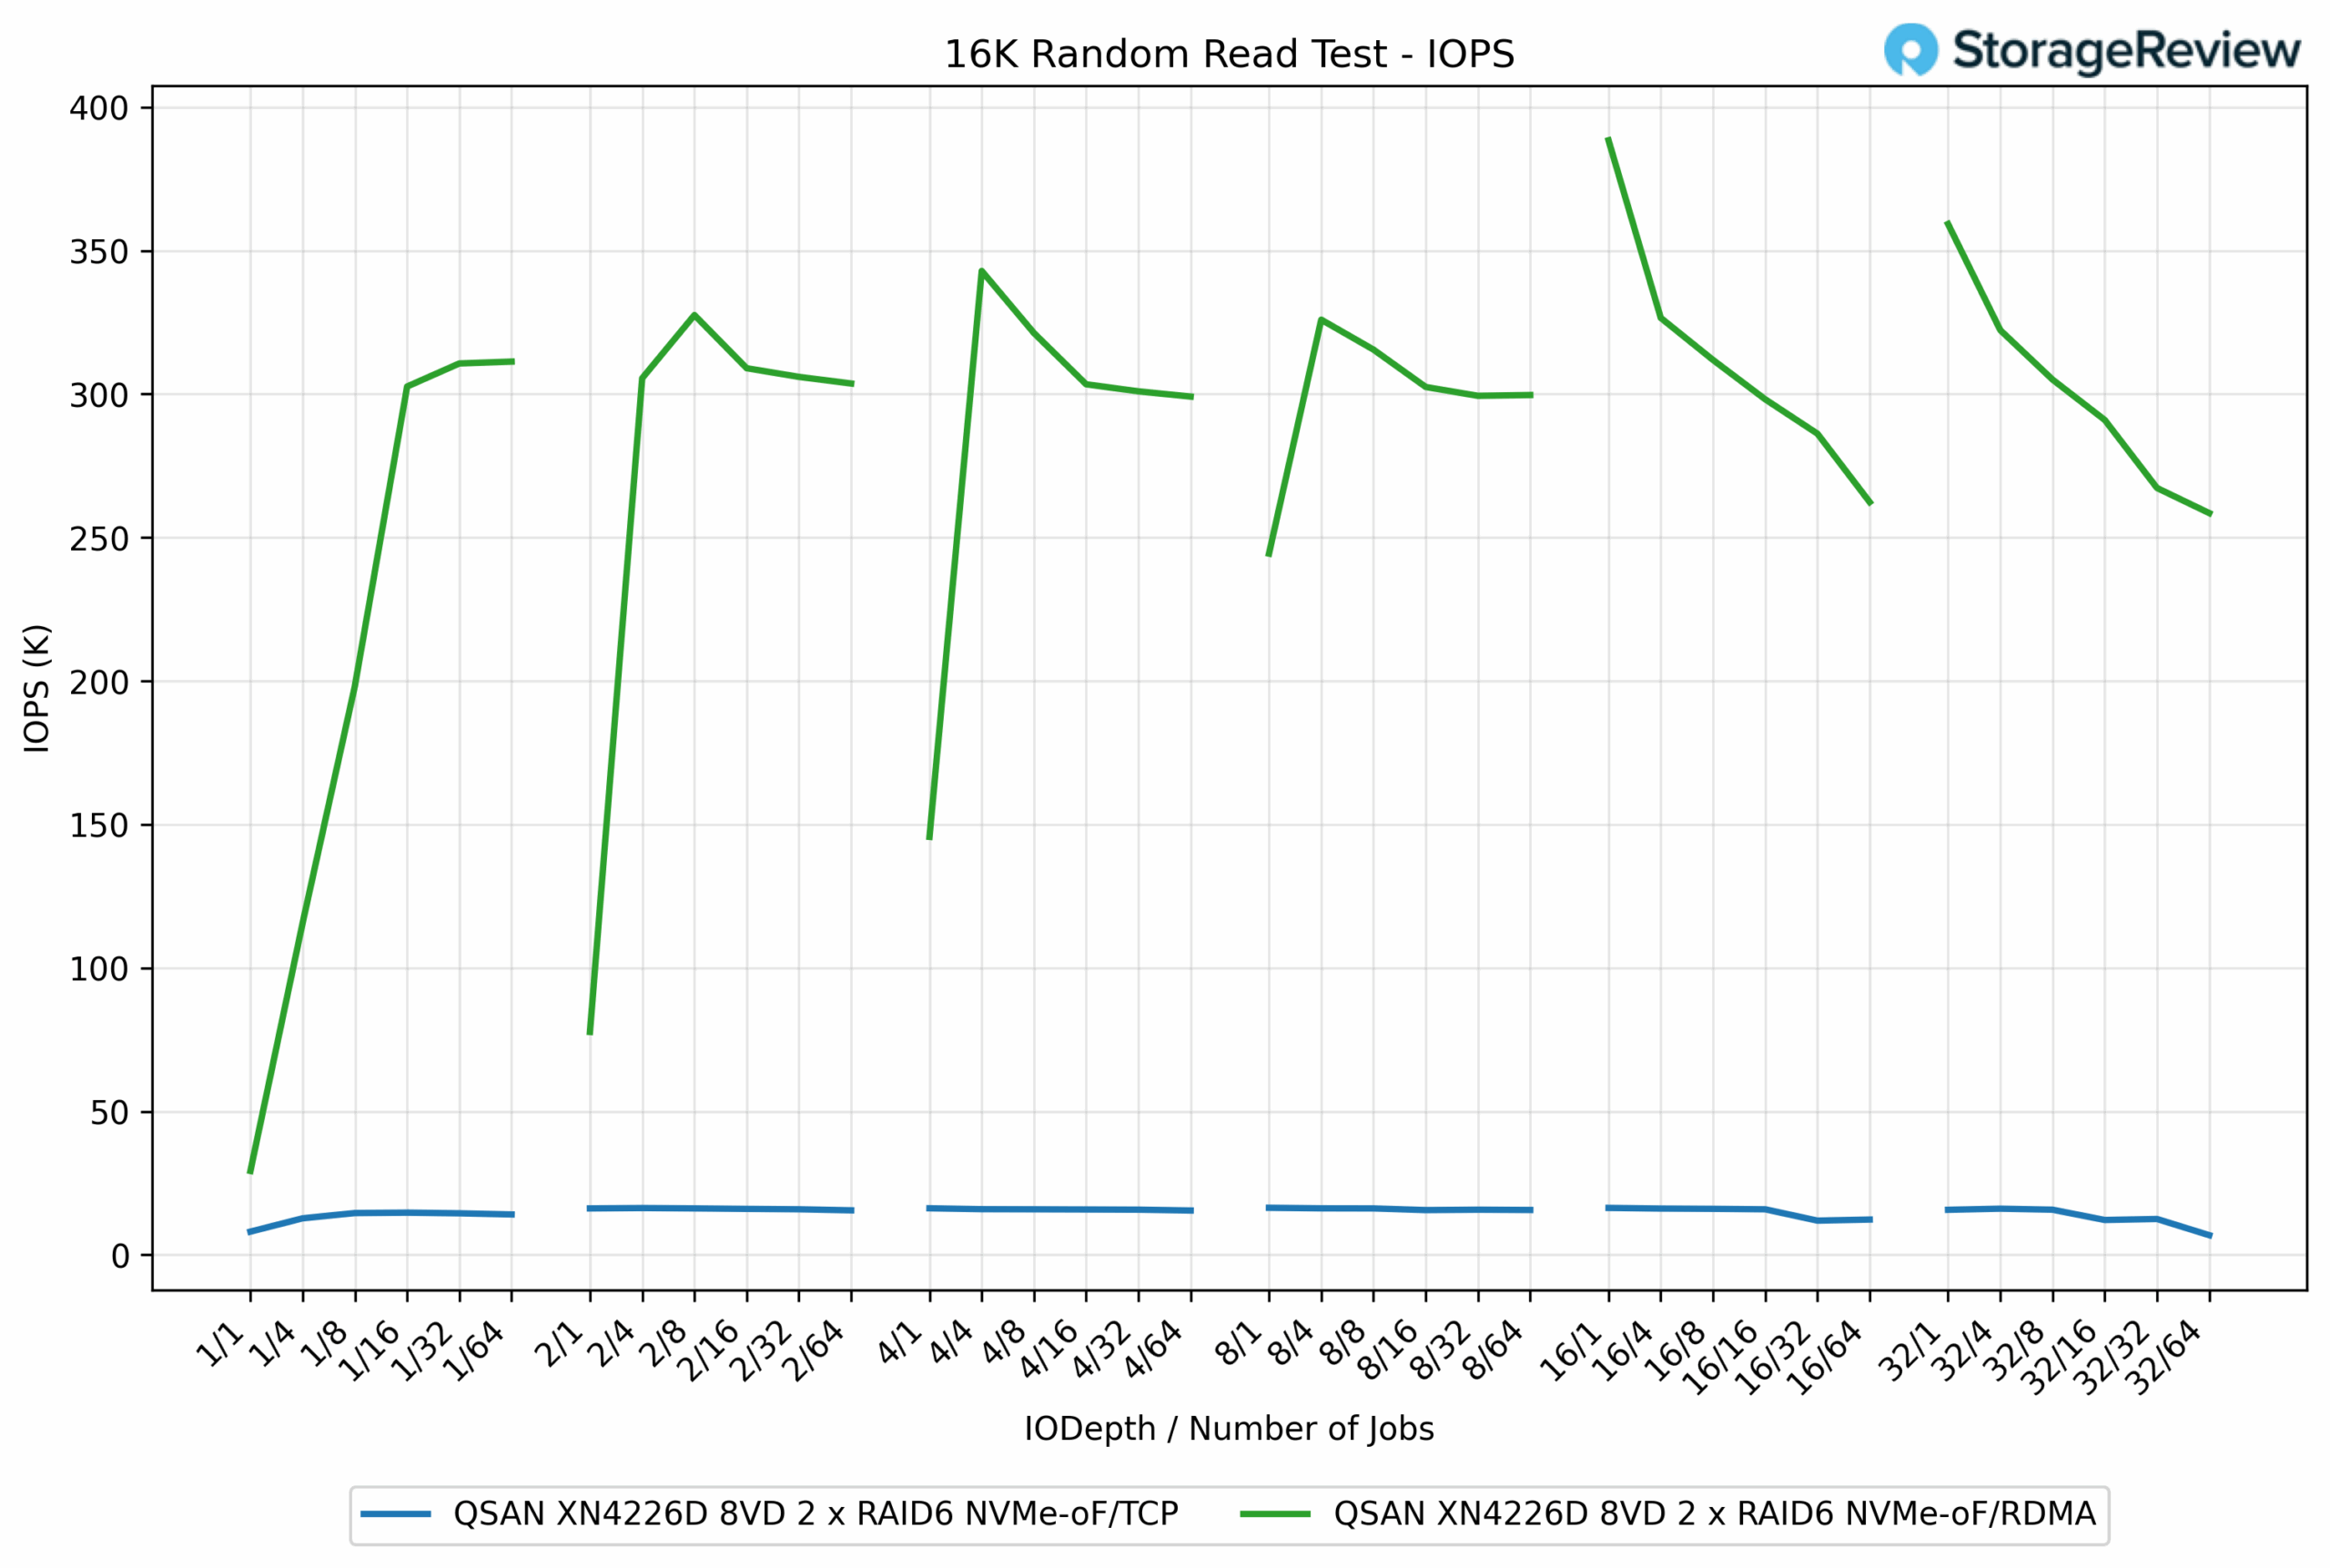
16K 랜덤 읽기 테스트에서 RDMA는 전체 워크로드 범위에서 TCP를 완전히 앞지르며, RDMA는 최대 388.44K IOPS를 달성한 반면, TCP는 16.42K IOPS로 최고치를 기록하여 RDMA가 23배 이상 우위를 보였습니다.
이러한 차이는 처음부터 드러났습니다. QD1/1 작업에서 RDMA는 29.27K IOPS를 제공한 반면, TCP는 8.10K IOPS에 그쳤습니다. 동시성이 증가함에 따라 RDMA는 300만에서 380만 IOPS 범위로 빠르게 확장된 반면, TCP는 대기열 크기가 더 커져도 15에서 16 IOPS 정도에서 정체되었습니다.
16K 랜덤 읽기 지연 시간
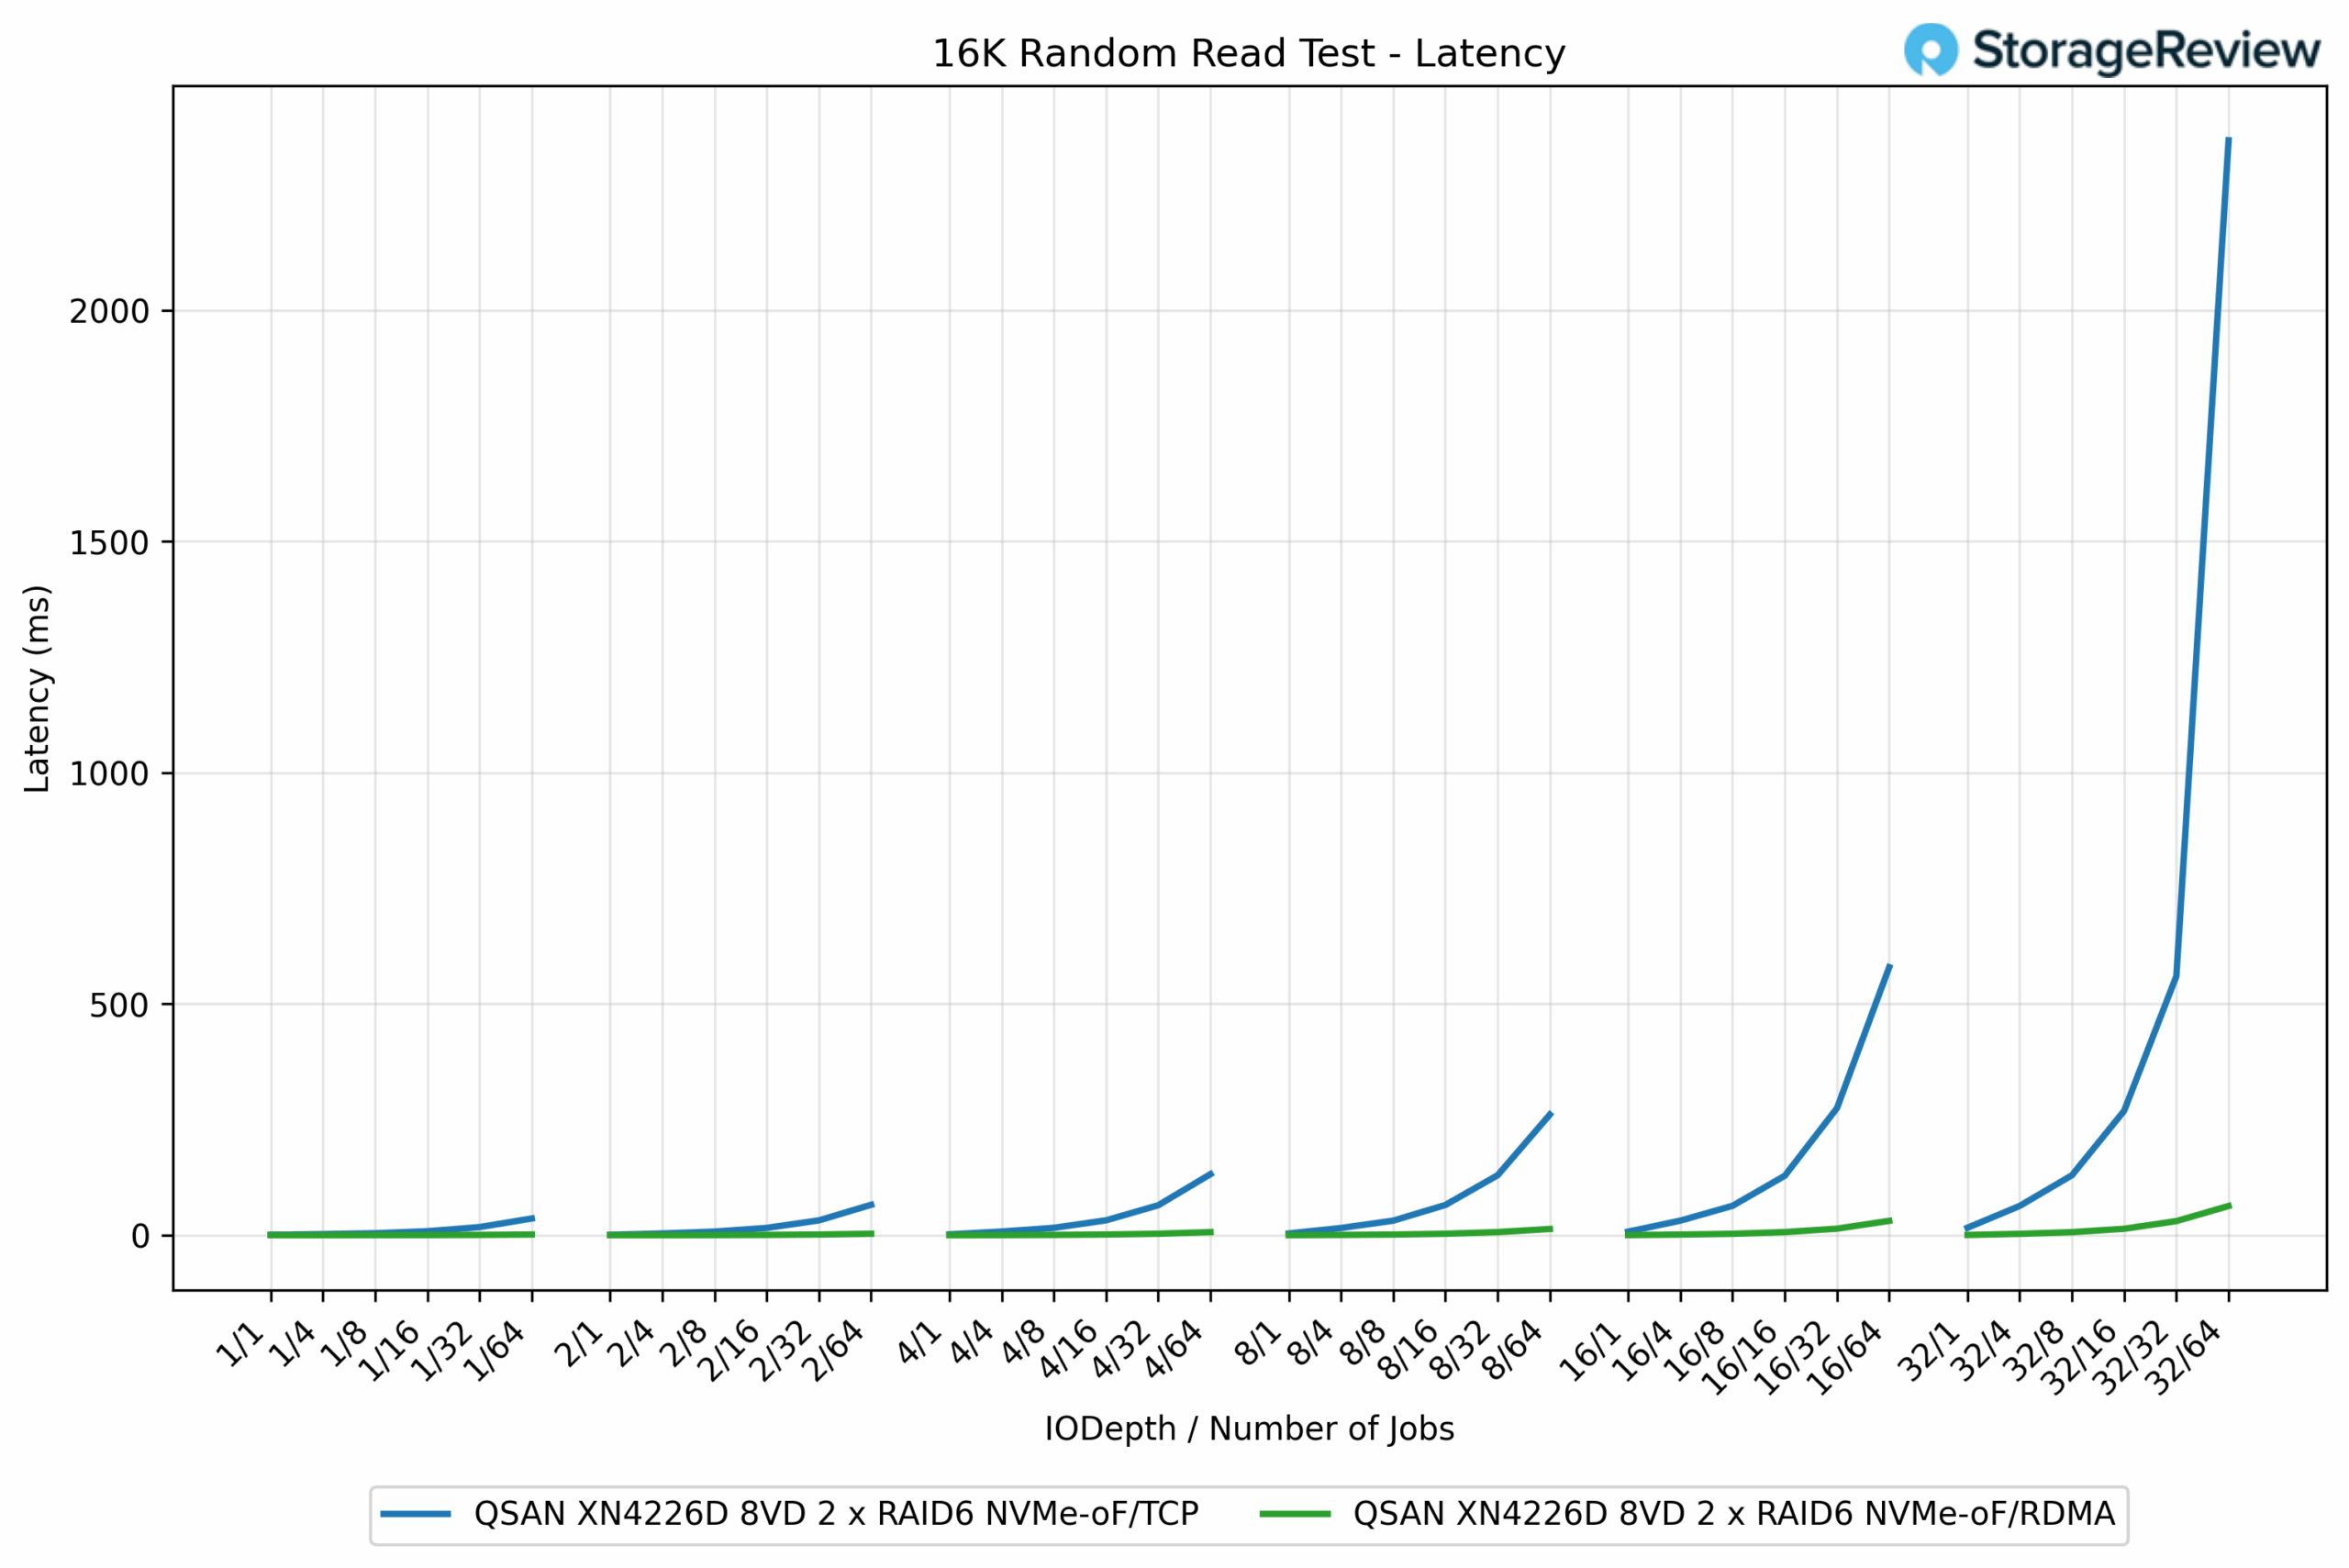
16K 랜덤 읽기 지연 시간 테스트에서 RDMA와 TCP 간의 차이는 극명했으며, IOPS 결과와 유사했습니다. 가벼운 작업 부하에서는 두 프로토콜이 거의 동일했으며, 지연 시간은 1ms에서 10ms까지 다양했습니다.
워크로드가 확장됨에 따라 RDMA는 지연 시간을 잘 조절했지만, TCP는 크게 저하되었습니다. 8분기/64 작업에서 RDMA는 13.65ms로 측정된 반면, TCP는 260.90ms로 거의 19배 향상되었습니다. 궁극적으로 32분기/64 작업의 RDMA 완료 시간은 63.28ms인 반면, TCP는 2,366.99ms로 거의 37배 더 길었습니다.
4K 무작위 쓰기 IOPS
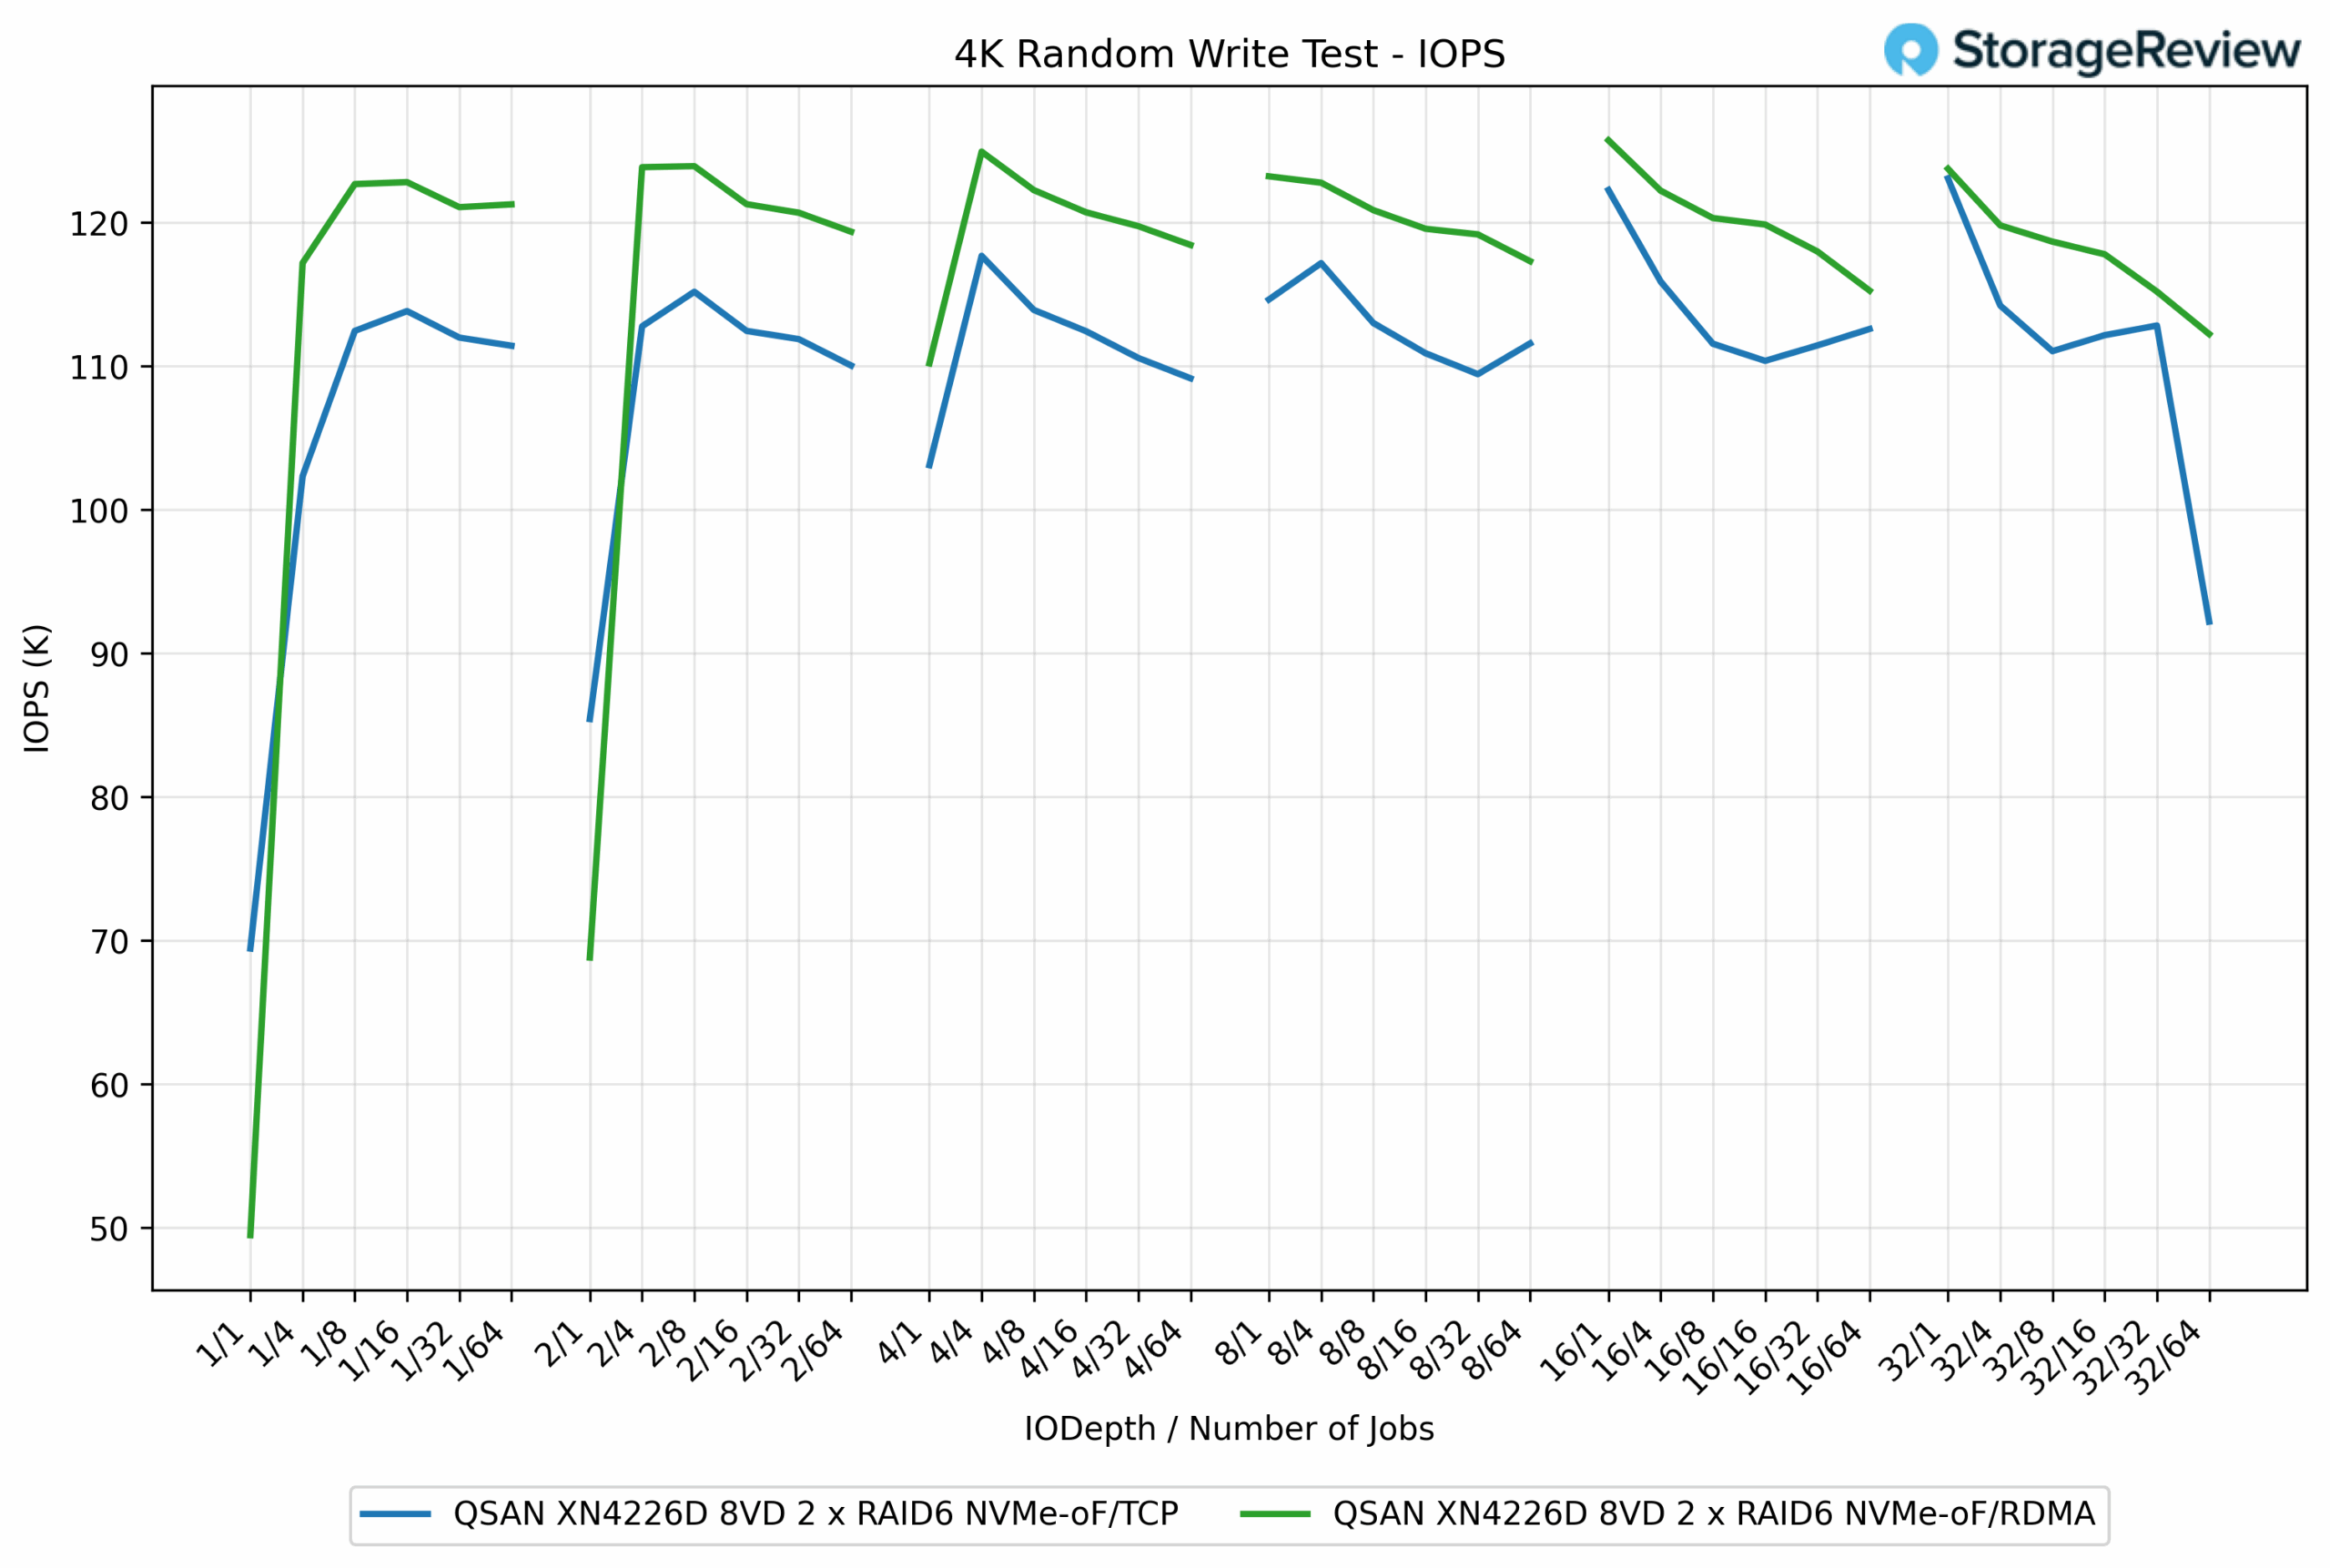
4K 랜덤 쓰기 테스트에서 RDMA는 TCP보다 지속적으로 우수한 성능을 보였지만, 블록 크기가 큰 워크로드에 비해 그 차이는 작았습니다. RDMA는 최대 125.73K IOPS를 달성한 반면, TCP는 115.89K IOPS를 기록하여 RDMA가 약 8.5% 우위를 보였습니다.
대기열 깊이가 낮을 때 TCP는 RDMA에 약간 뒤처졌지만 여전히 경쟁력 있는 성능을 제공했습니다. 예를 들어, QD1/16 작업에서 RDMA는 122.82K IOPS를 달성한 반면, TCP는 111.91K IOPS를 달성하여 거의 10% 향상되었습니다. 대부분의 테스트 지점에서 RDMA는 120K에서 125K IOPS 범위를 유지한 반면, TCP는 110K에서 116K IOPS 사이의 결과를 유지했습니다. QD32/64 작업에서는 92.21K IOPS로 후반부 하락했습니다.
4K 임의 쓰기 지연 시간
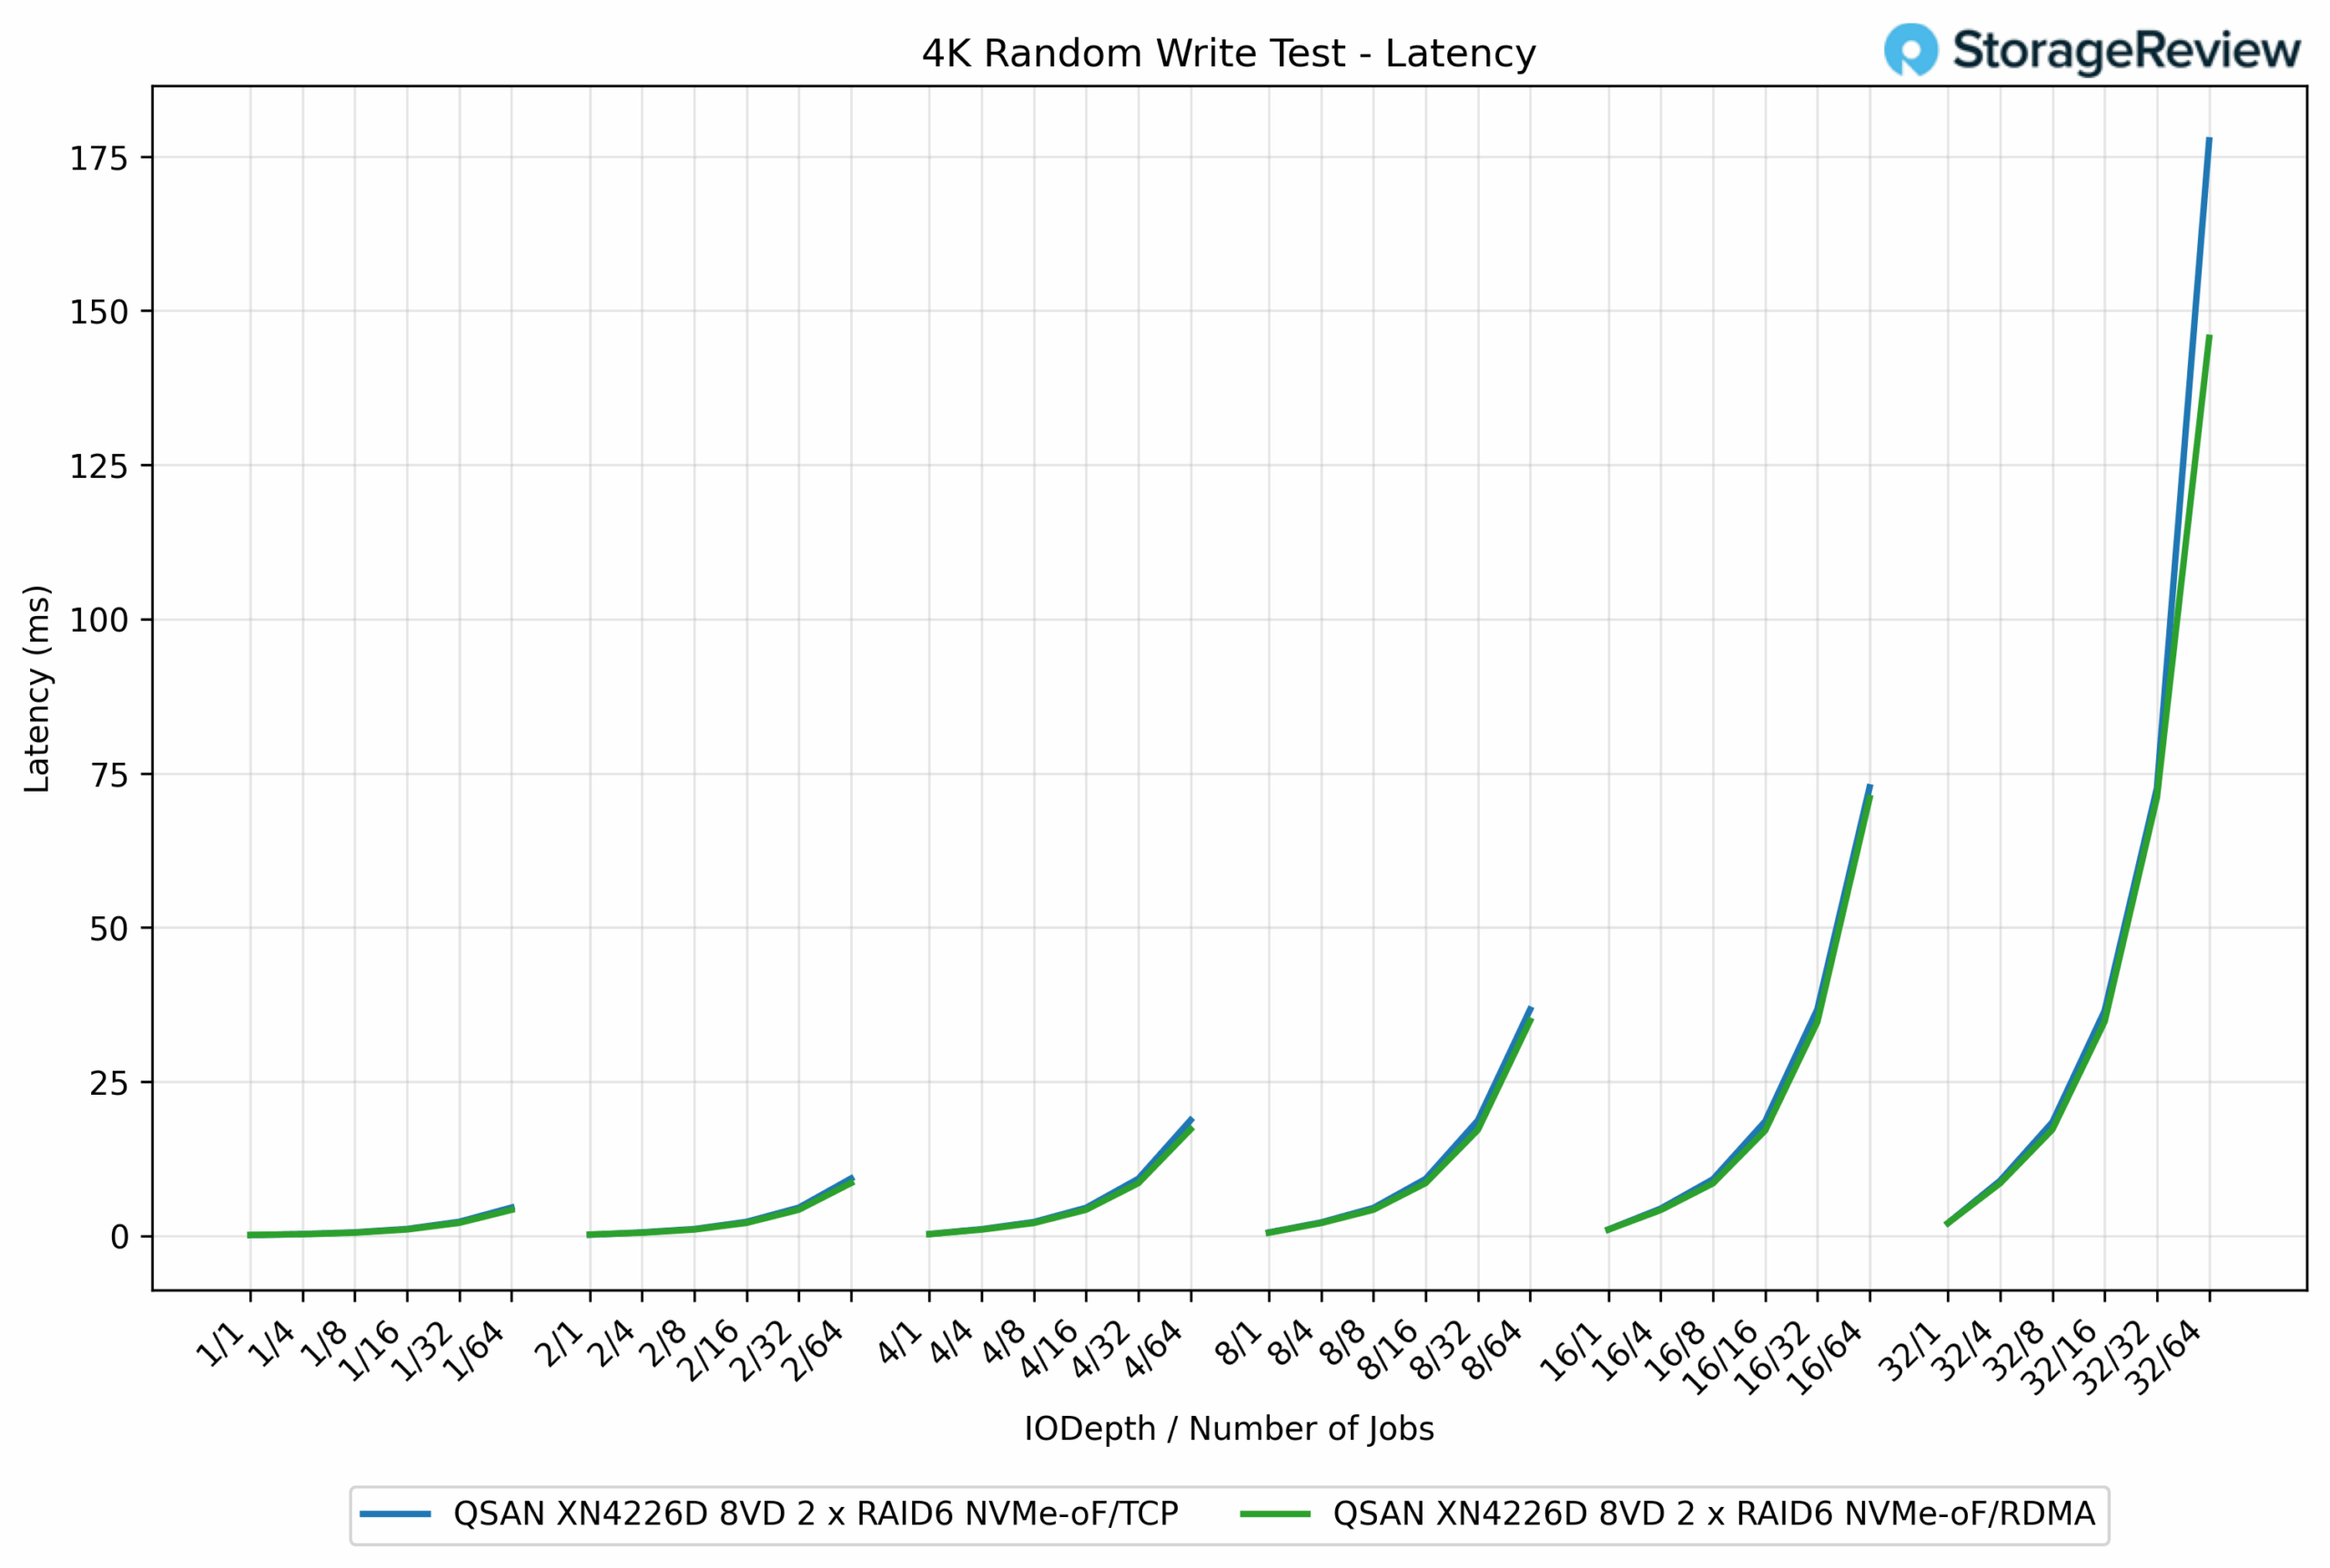
4K 랜덤 쓰기 지연 시간 테스트에서 RDMA는 TCP보다 지속적으로 낮은 응답 시간을 보였지만, 더 큰 블록 워크로드에 비해 그 차이가 더 작았습니다. 가벼운 부하에서는 두 프로토콜 모두 거의 동일했으며, 각각 1ms 미만을 유지했습니다. 예를 들어, QD1/1에서 TCP는 0.16ms, RDMA는 0.21ms를 기록했습니다.
동시성이 증가함에 따라 차이는 더욱 뚜렷해졌습니다. QD16/64 작업에서 RDMA는 19.36ms를 기록한 반면 TCP는 36.20ms를 기록하여 RDMA의 지연 시간이 46% 감소했습니다. 최대 깊이에서 RDMA는 145.61ms로 완료되었고, TCP는 177.62ms로 증가하여 RDMA가 22% 향상되었습니다.
4K 무작위 읽기 IOPS
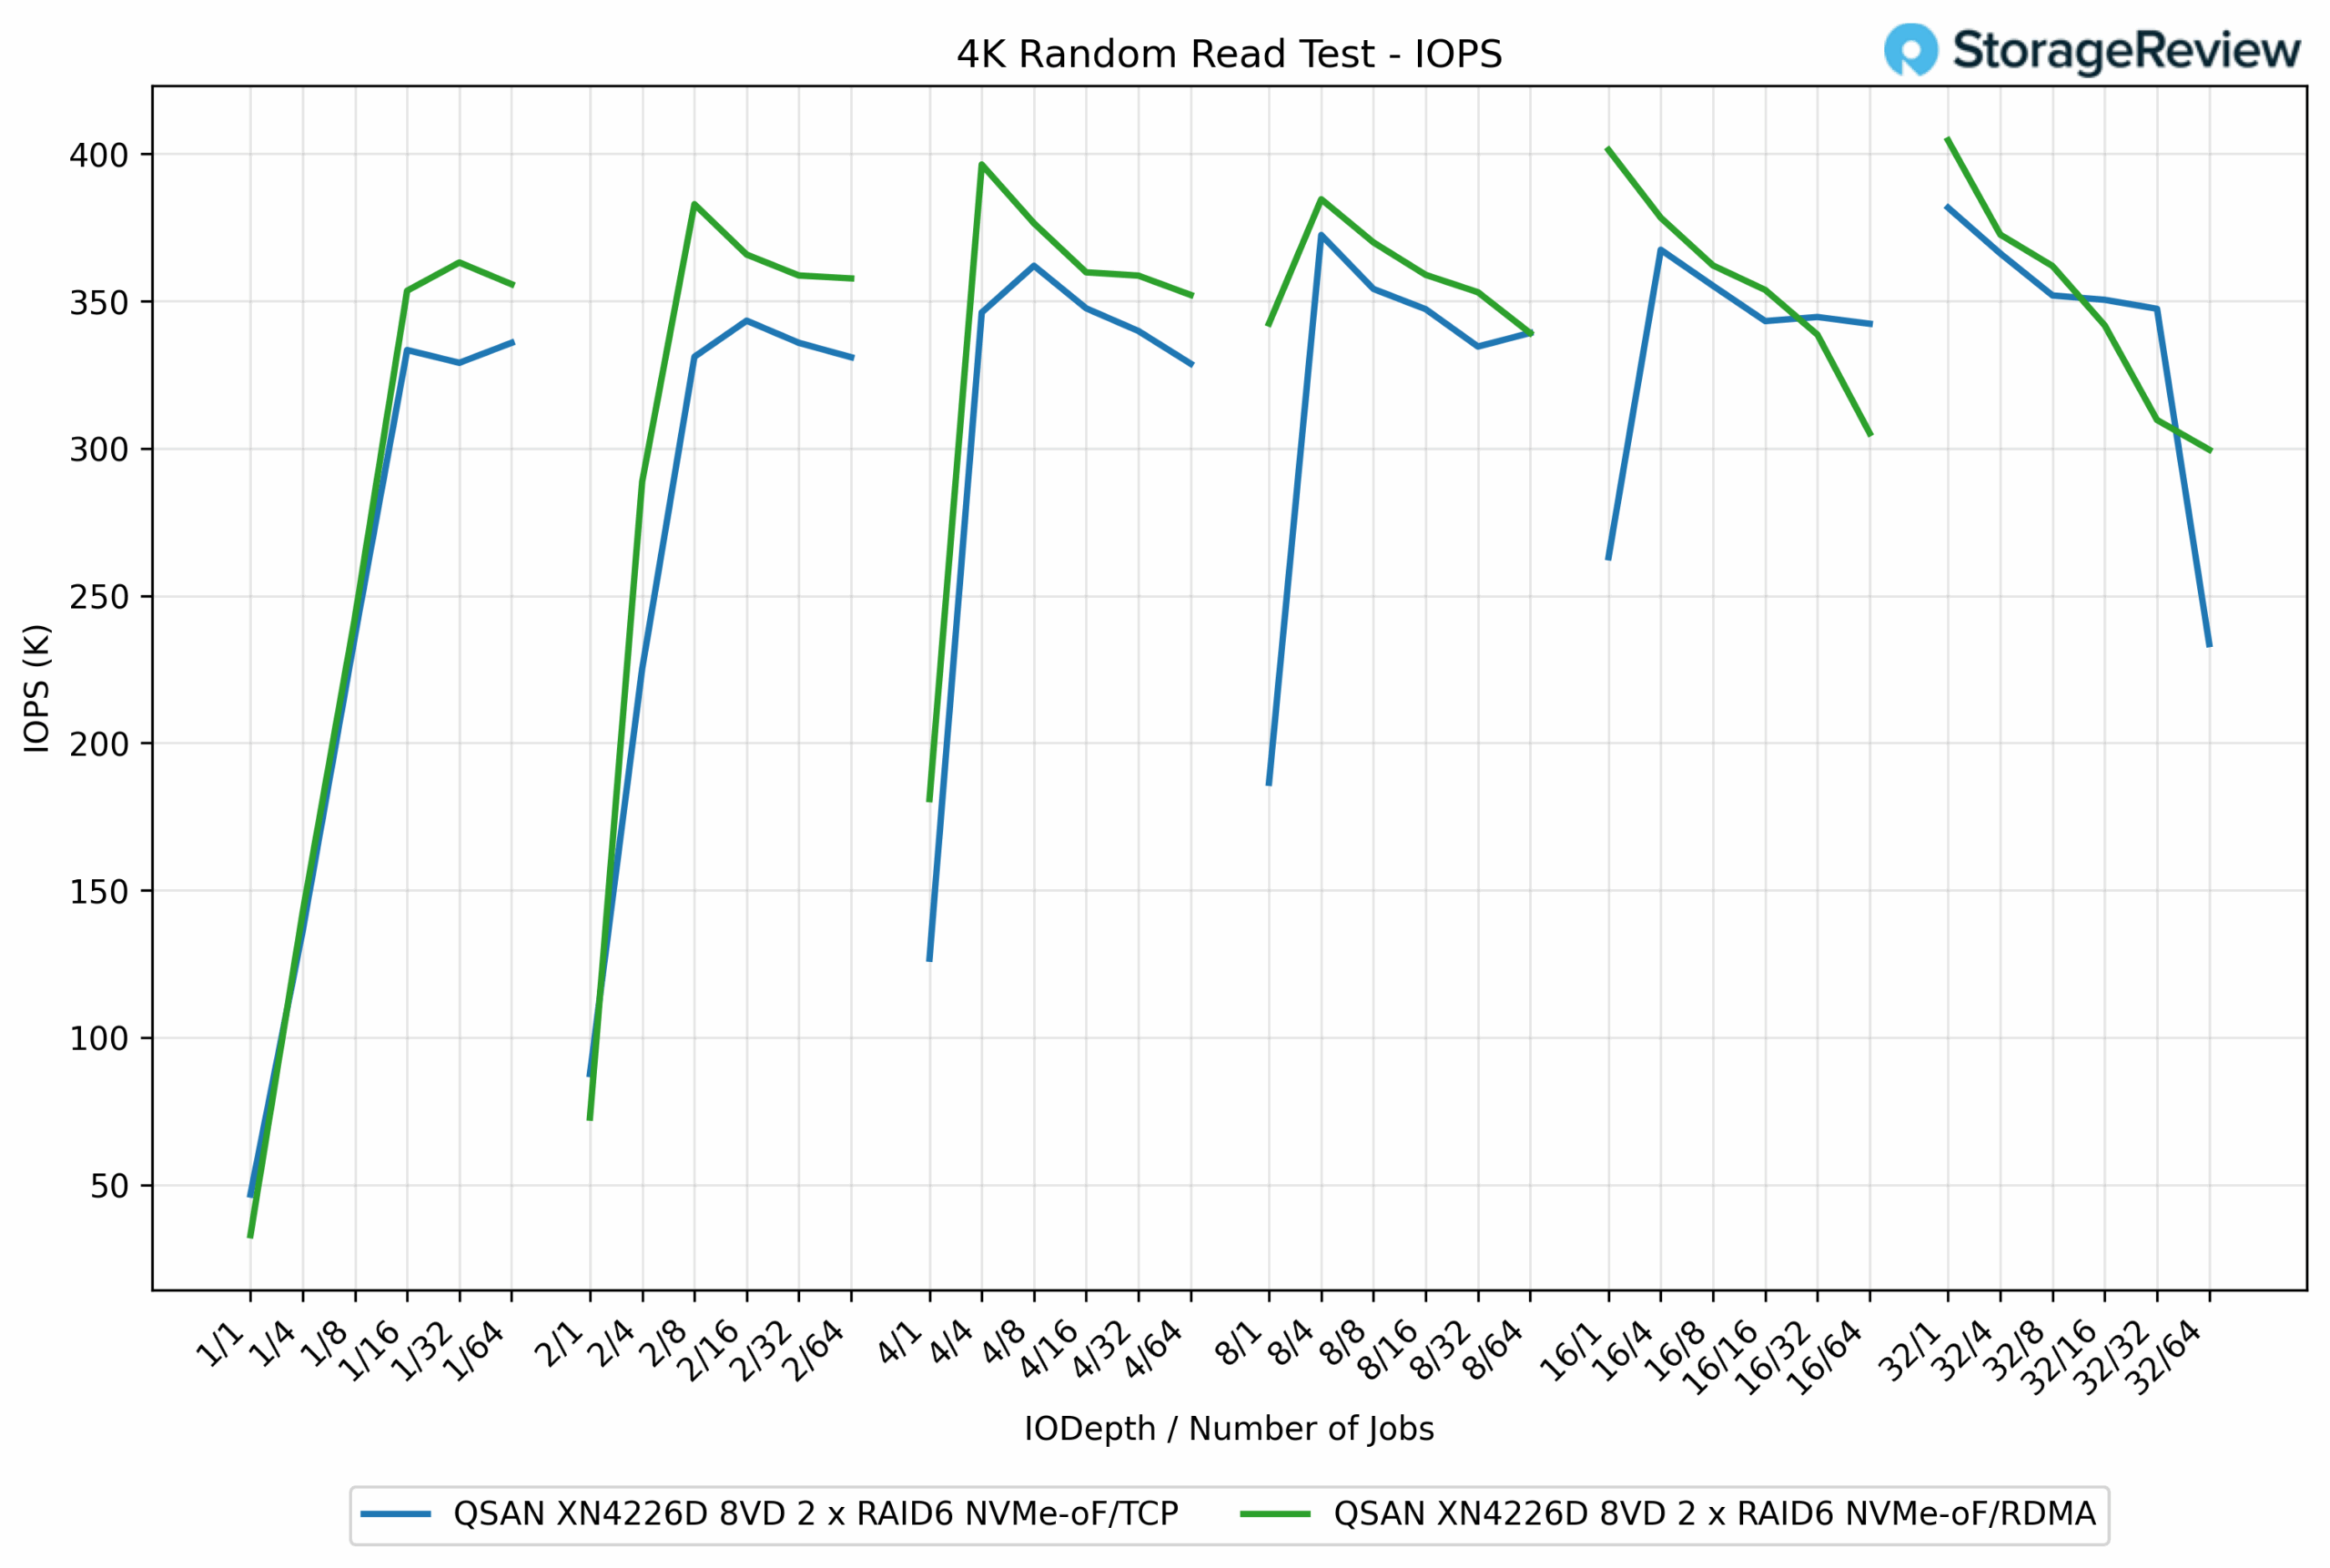
4K 랜덤 읽기 테스트에서 두 프로토콜 모두 강력한 성능을 보였지만, RDMA가 TCP보다 지속적으로 약간 우위를 보였습니다. RDMA는 최대 404.64K IOPS에 도달한 반면, TCP는 382.96K IOPS로 정점을 찍으며 RDMA가 5.7% 우위를 보였습니다.
더 낮은 깊이에서는 결과가 이미 RDMA에 유리했습니다. 예를 들어, QD1/16 작업에서 RDMA는 353.57K IOPS를 달성한 반면, TCP는 329.10K IOPS를 달성하여 약 7.5%의 차이를 보였습니다. 워크로드가 확장됨에 따라 RDMA는 일반적으로 360K~400K IOPS 범위에서 우위를 유지한 반면, TCP는 330K~380K IOPS에 근접했습니다.
4K 랜덤 읽기 대기 시간
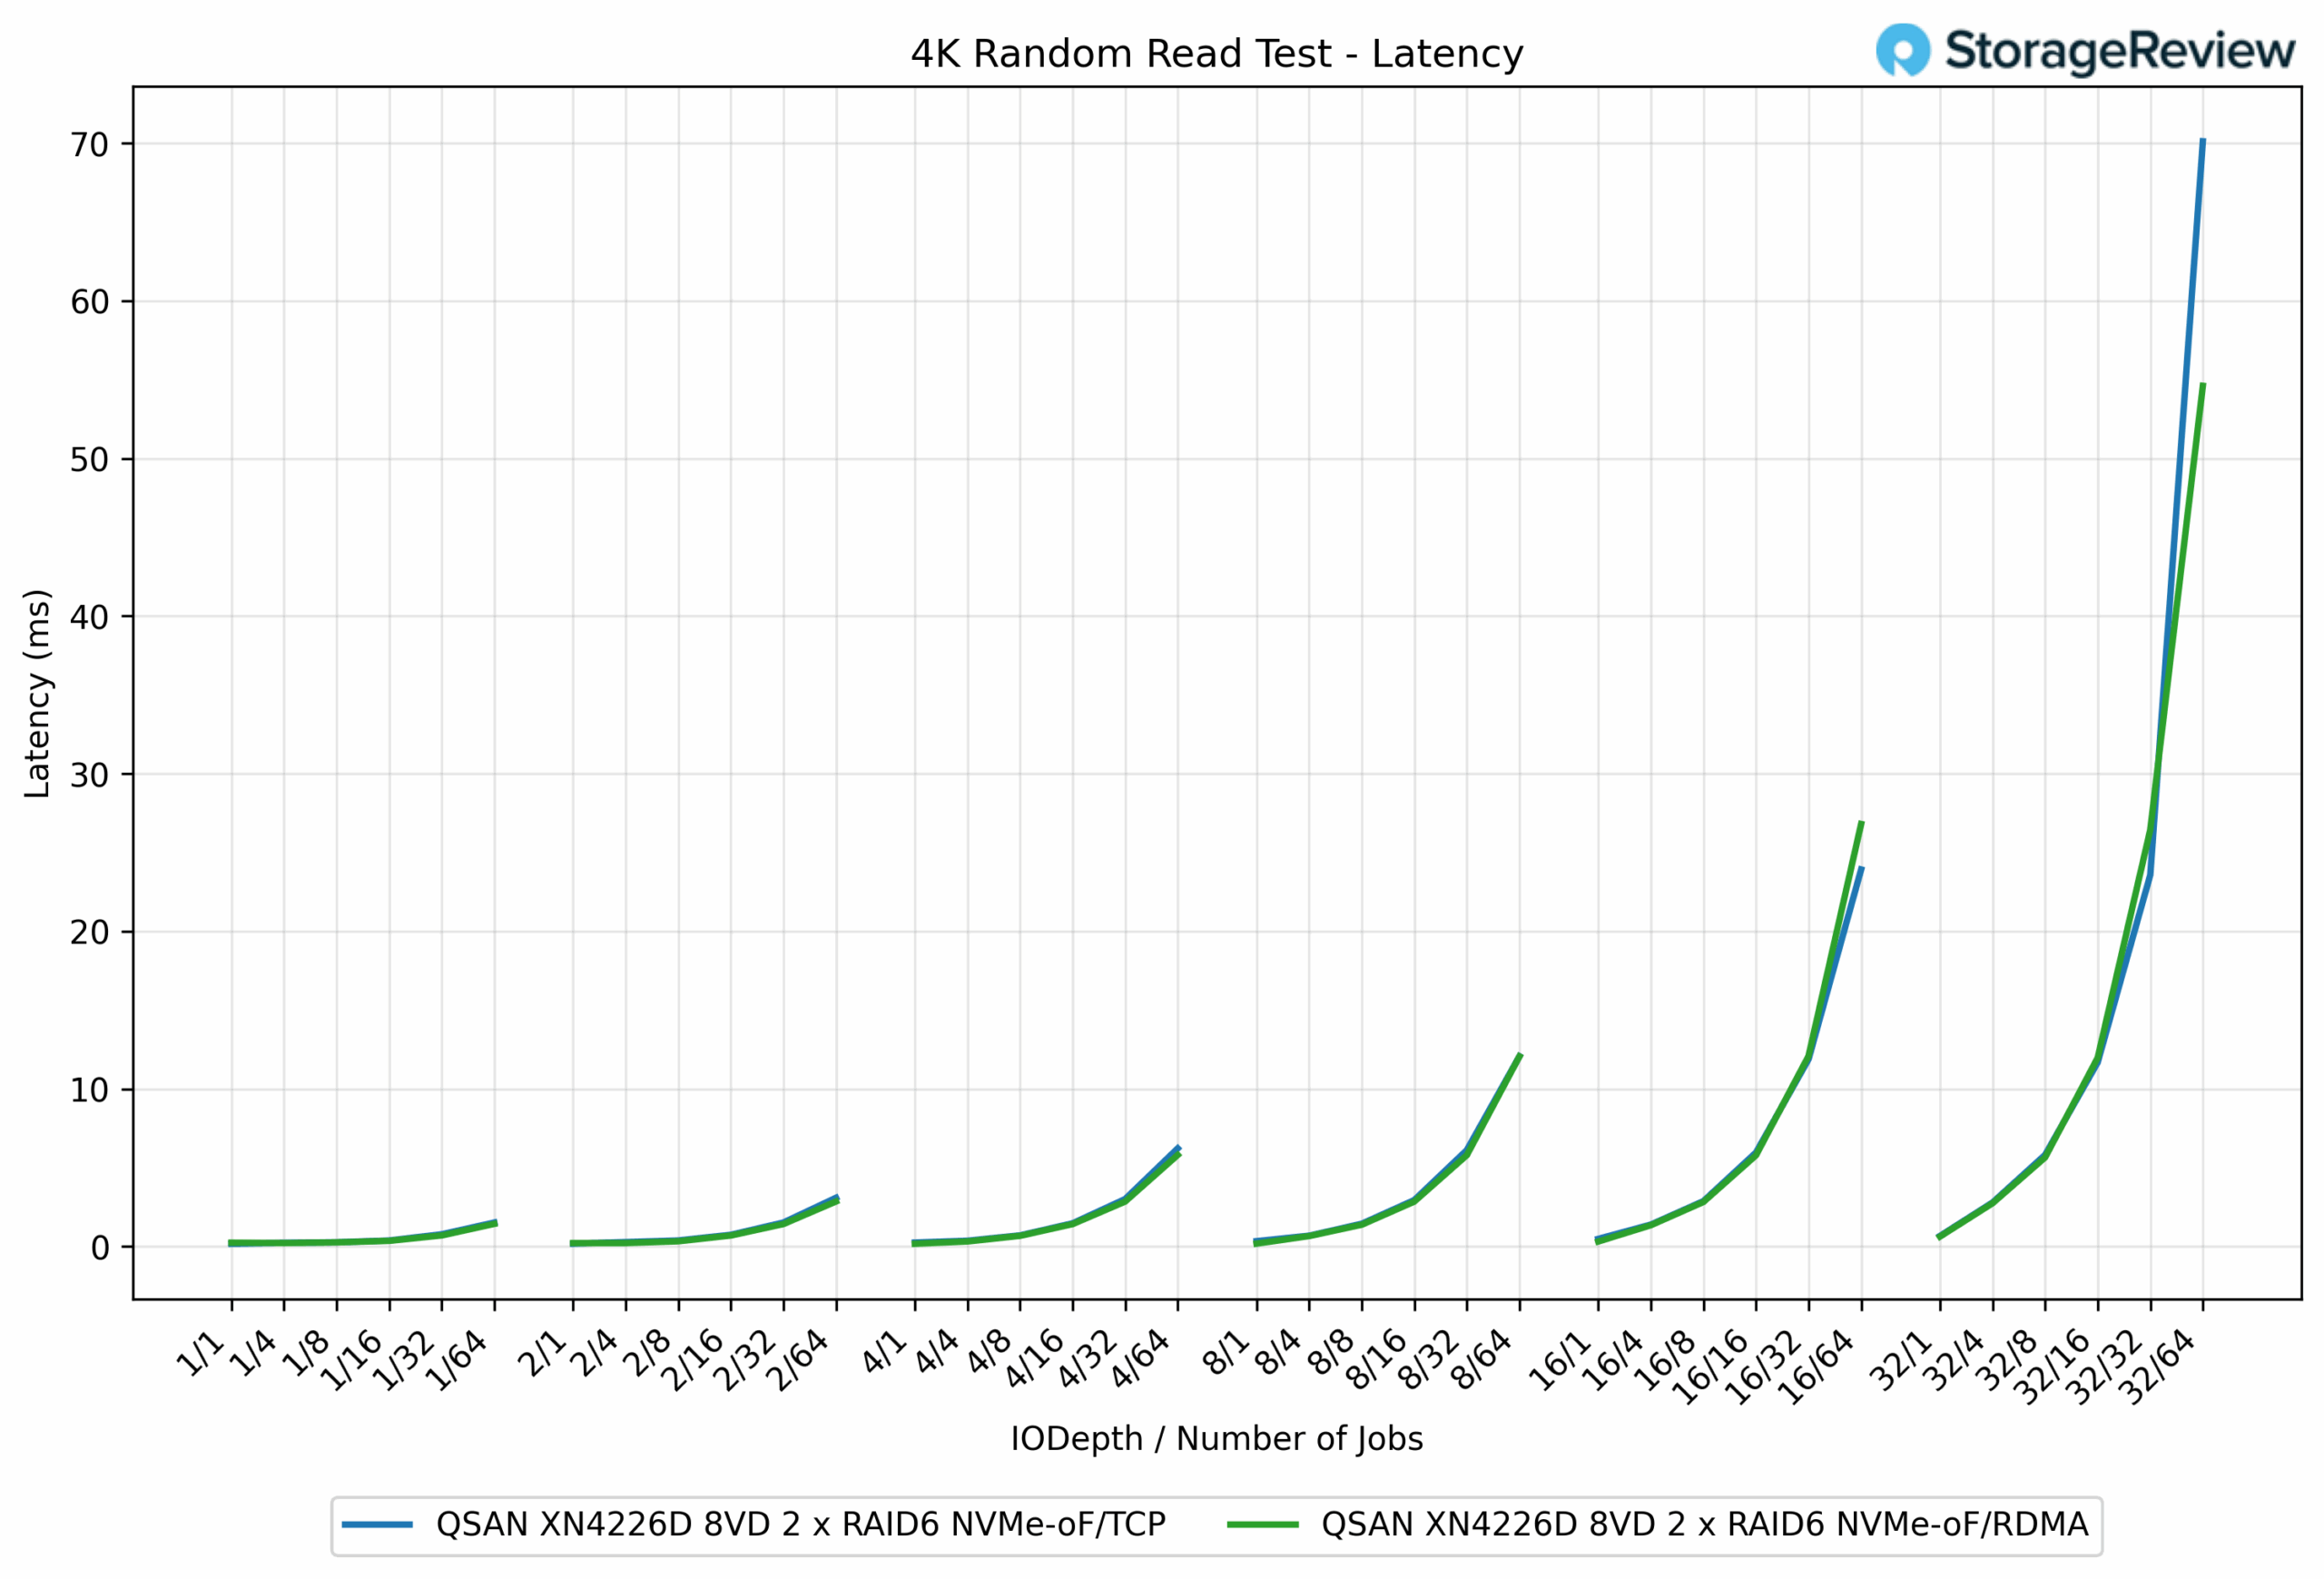
4K 랜덤 읽기 지연 시간 테스트에서 RDMA는 TCP보다 확실히 효율적인 것으로 나타났으며, 특히 워크로드 규모가 증가함에 따라 더욱 두드러졌습니다. 대기열 깊이가 낮은 상황에서는 두 프로토콜이 거의 동일했습니다. 예를 들어, QD1/1 작업에서 TCP는 0.24ms를 기록한 반면, RDMA는 0.27ms로 TCP보다 약간 뒤처졌습니다.
동시성이 증가함에 따라 RDMA가 앞서 나갔습니다. QD16/64 작업에서 RDMA는 23.92ms, TCP는 26.81ms로 10.8% 향상되었습니다. QD32/64 작업의 최대 부하에서는 RDMA가 54.61ms로 완료되었고, TCP는 70.12ms로 급증하여 RDMA의 지연 시간이 22% 감소했습니다.
GPUDirect 스토리지 성능
이 테스트벤치에서 수행한 테스트 중 하나는 Magnum IO GPUDirect Storage(GDS) 테스트였습니다. GDS는 NVIDIA에서 개발한 기능으로, GPU가 NVMe 드라이브나 기타 고속 저장 장치에 저장된 데이터에 액세스할 때 CPU를 거치지 않고 바로 접근할 수 있도록 합니다. GDS는 CPU와 시스템 메모리를 통해 데이터를 라우팅하는 대신, GPU와 저장 장치 간의 직접 통신을 가능하게 하여 지연 시간을 크게 줄이고 데이터 처리량을 향상시킵니다.
GPUDirect 스토리지 작동 방식
전통적으로 GPU가 NVMe 드라이브에 저장된 데이터를 처리할 때, 데이터는 GPU에 도달하기 전에 먼저 CPU와 시스템 메모리를 거쳐야 합니다. 이 과정에서 CPU가 중개 역할을 하게 되어 병목 현상이 발생하고, 지연 시간이 늘어나고 귀중한 시스템 리소스가 소모됩니다. GPUDirect Storage는 GPU가 PCIe 버스를 통해 저장 장치의 데이터에 직접 액세스할 수 있도록 하여 이러한 비효율성을 제거합니다. 이러한 직접 경로는 데이터 이동과 관련된 오버헤드를 줄여 더 빠르고 효율적인 데이터 전송을 가능하게 합니다.
AI 워크로드, 특히 딥러닝 관련 워크로드는 매우 데이터 집약적입니다. 대규모 신경망을 학습하려면 테라바이트급의 데이터를 처리해야 하며, 데이터 전송 지연은 GPU 활용도 저하 및 학습 시간 증가로 이어질 수 있습니다. GPUDirect Storage는 데이터가 GPU에 최대한 빠르게 전달되도록 보장하여 유휴 시간을 최소화하고 연산 효율성을 극대화함으로써 이러한 문제를 해결합니다.
또한 GDS는 비디오 처리, 자연어 처리 또는 실시간 추론과 같이 대용량 데이터 세트를 스트리밍하는 작업 부하에 특히 유용합니다. GDS는 CPU에 대한 의존도를 줄임으로써 데이터 이동을 가속화하고 다른 작업을 위한 CPU 리소스를 확보하여 전반적인 시스템 성능을 더욱 향상시킵니다.
GPUDirect는 원시 대역폭 외에도 NVMe-oF(TCP/RDMA)를 지원하여 초저지연 I/O를 제공합니다. 이를 통해 GPU가 데이터 부족 현상을 겪지 않도록 보장하여 실시간 AI 추론, 분석 파이프라인, 비디오 재생에 이상적인 시스템입니다.
많은 실제 배포에서 이는 100~200GbE의 사용 가능 처리량으로 변환되며, AI 추론(2~4개 GPU), 미디어 제작(브로드캐스트 재생, OTT 에지 캐싱), 감시 비디오 분석, HPC 체크포인팅과 같은 워크로드에 완벽하게 부합합니다.
읽기 처리량
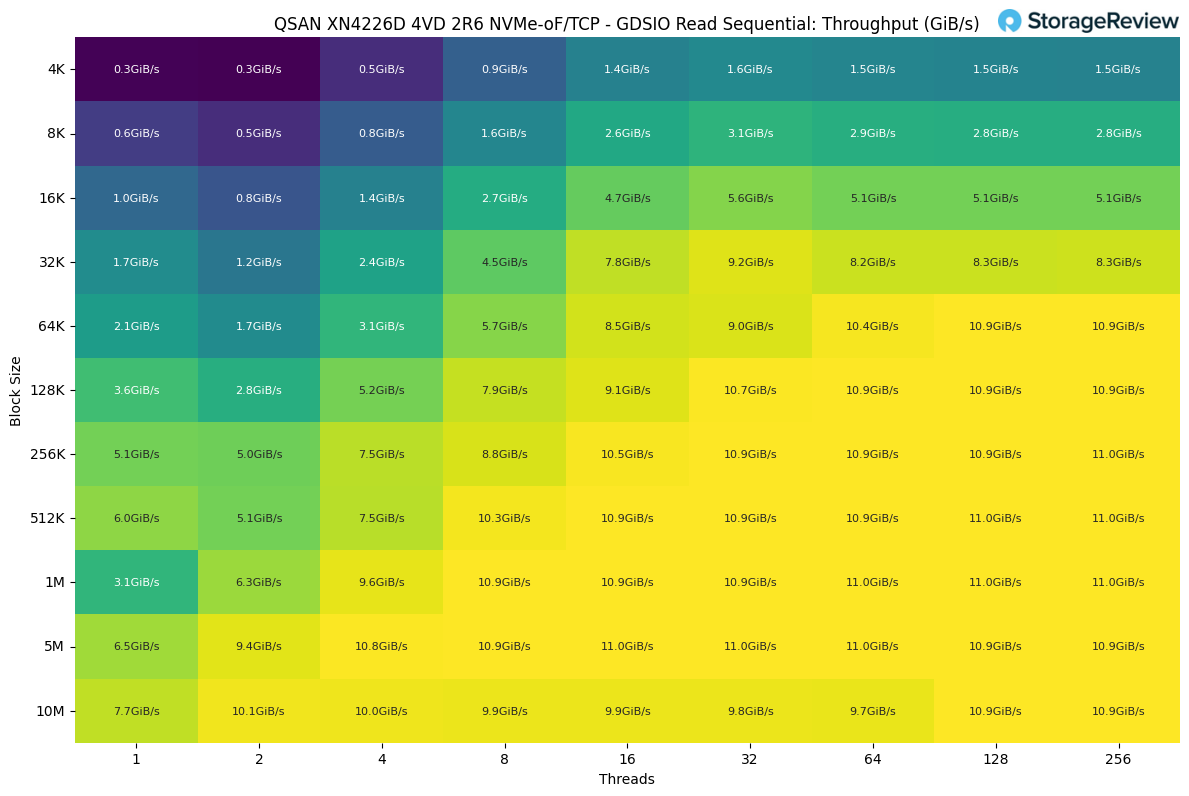
GDSIO 순차 읽기 워크로드에서 처리량은 블록 크기와 스레드 수 모두에 따라 꾸준히 증가하여 여러 테스트 지점에서 최대 11.0GiB/s에 도달했습니다. 블록 크기가 512K 이상에 도달했을 때 가장 높은 결과가 유지되었으며, 스레드 수에 관계없이 처리량은 10.9~11.0GiB/s 사이에서 안정적으로 유지되었습니다.
블록 크기가 작을수록 성능은 훨씬 낮게 시작되었습니다. 예를 들어, 4K 블록의 경우 단일 스레드에서 처리량은 0.3GiB/s에서 시작하여 256개 스레드에서도 1.5GiB/s로 평준화되었습니다. 반면, 블록 크기를 64K로 늘리자 시스템은 최대 10.9GiB/s까지 확장할 수 있었고, 스레드 수가 많아질수록 처리량이 거의 포화 상태에 도달했습니다.
최적의 처리량은 128K에서 256K 블록 사이로 나타났으며, 32개 이상의 스레드에서 처리량이 10GiB/s를 초과하고 테스트된 가장 큰 블록 크기에서도 일관된 수준을 유지했습니다. 이는 블록 크기가 충분히 커지면 플랫폼이 최대 대역폭 포화에 도달하며, 256K를 넘어서면 점진적인 이득만 얻는다는 것을 보여줍니다.
읽기 대기 시간
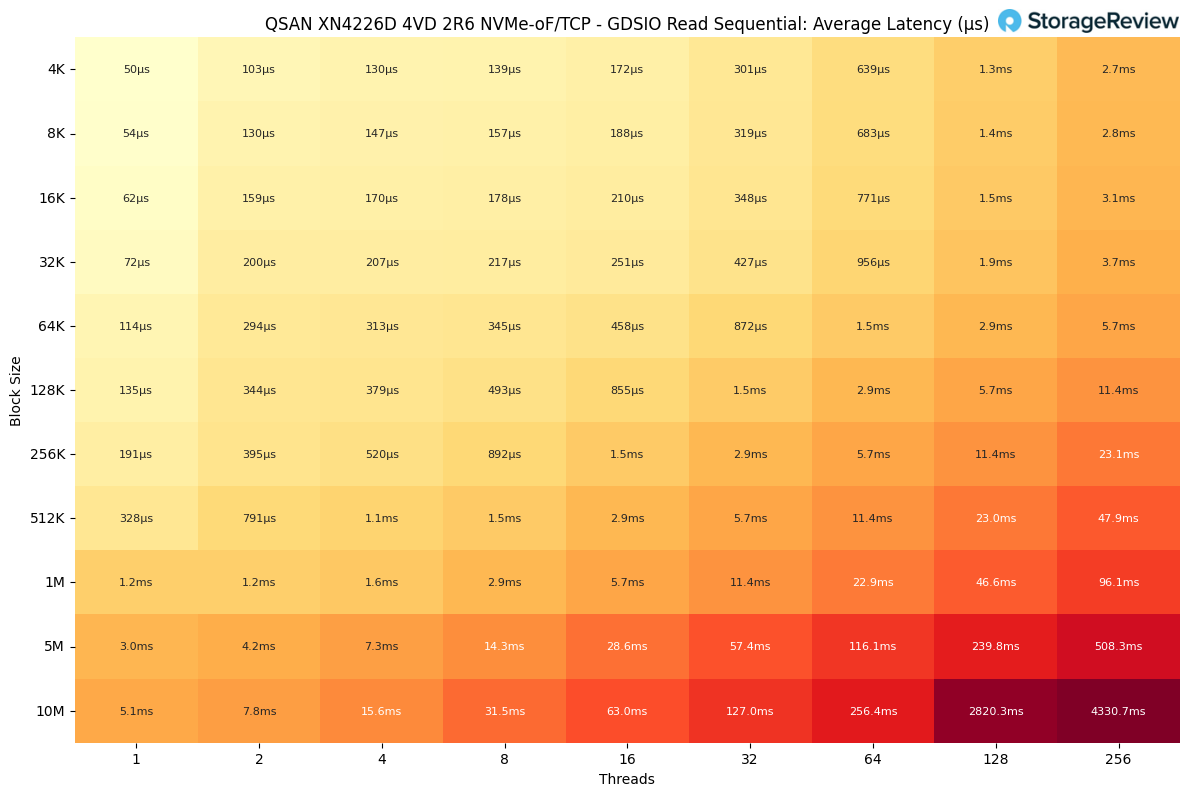
GDSIO 순차 읽기 지연 시간 결과에서 응답 시간은 블록 크기와 스레드 수 모두에 따라 예측 가능하게 증가했습니다. 가장 작은 워크로드에서는 지연 시간이 매우 낮게 유지되었습니다. 예를 들어, 단일 스레드에서 4K 블록을 처리할 경우 지연 시간은 50µs에 불과했으며, 최소 동시성으로 최대 32K 블록 크기까지 지연 시간은 200µs 미만으로 유지되었습니다.
스레드 수가 증가함에 따라 지연 시간이 눈에 띄게 증가하기 시작했습니다. 64K 블록과 64개 스레드에서 지연 시간은 1.5ms에 달했고, 128개 스레드에서는 2.9ms로 두 배 증가했으며, 256개 스레드에서는 5.7ms로 증가했습니다. 반면, 4K 및 8K와 같은 더 작은 블록 크기는 최대 256개 스레드에서도 2.7~2.8ms 범위에 머물렀으며, 이는 더 세밀한 제어가 가능함을 보여줍니다.
블록 크기가 커질수록 더 큰 폭의 증가가 나타났습니다. 1M 블록과 256개 스레드에서 지연 시간은 96.1ms에 달했고, 10M 블록과 256개 스레드에서는 4.3초로 급증했습니다. 이는 극한 상황에서 시스템의 확장성 한계를 여실히 보여주었습니다.
쓰기 처리량
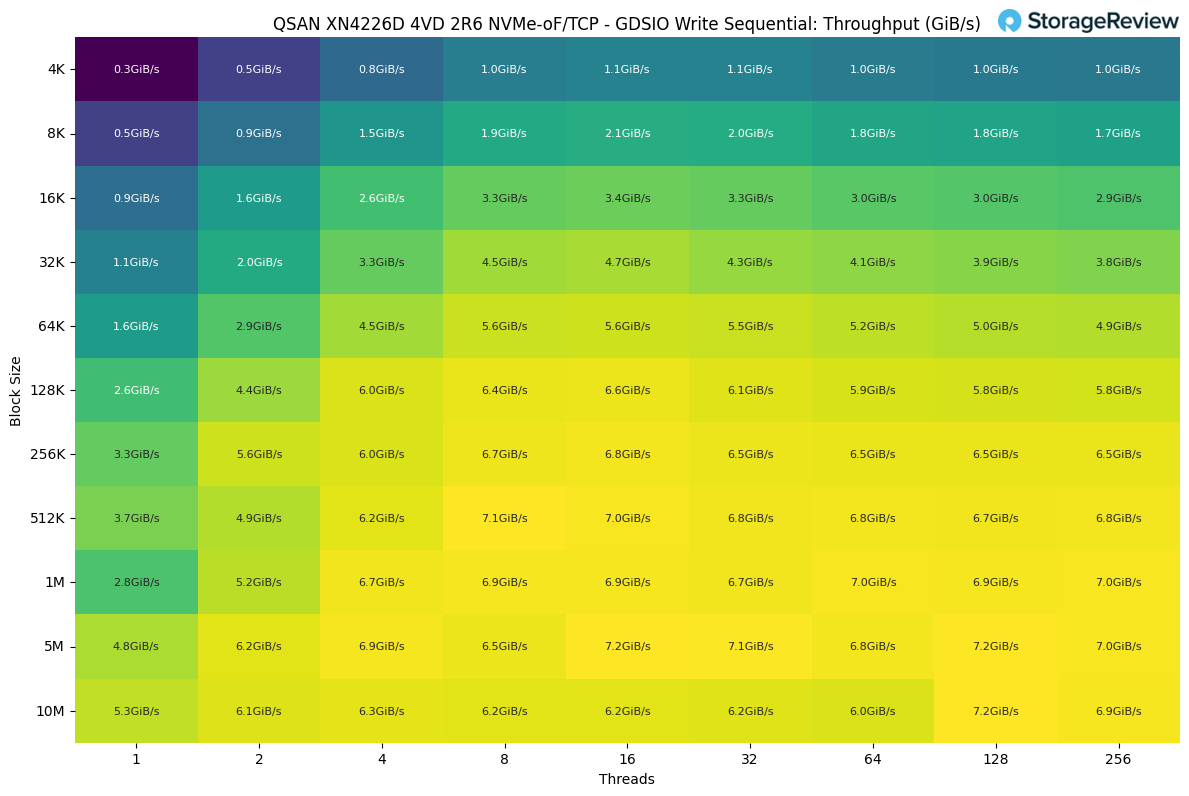
GDSIO 순차 쓰기 워크로드에서 처리량은 블록 크기와 스레드 수에 따라 증가했지만, 읽기 성능 한계점보다 훨씬 낮은 수준에서 정체되었습니다. 시스템은 128개 스레드에서 5M 및 10M과 같은 더 큰 블록 크기를 활용하여 최대 7.2GiB/s의 성능을 달성했습니다.
가장 작은 블록 크기에서는 처리량이 미미했습니다. 4K 블록에서는 단일 스레드에서 0.3GiB/s로 시작하여 32개 스레드에서는 1.0GiB/s로 확장된 후 안정화되었습니다. 블록 크기를 64K로 늘리자 대역폭이 증가하여 8개 스레드에서 5.6GiB/s에 도달했고, 이후 동시성이 높아지면서 처리량이 약간 감소했습니다.
최적의 균형은 512K에서 1M 블록 사이에서 나타났으며, 처리량은 스레드 수에 따라 6.7~7.1GiB/s로 시스템이 포화 상태에 도달했음을 나타냅니다. 이 범위를 넘어서면 스레드 추가는 유의미한 성능 향상을 가져오지 못했으며, 경우에 따라 오버헤드 증가로 인해 성능이 오히려 약간 저하되었습니다.
쓰기 대기 시간
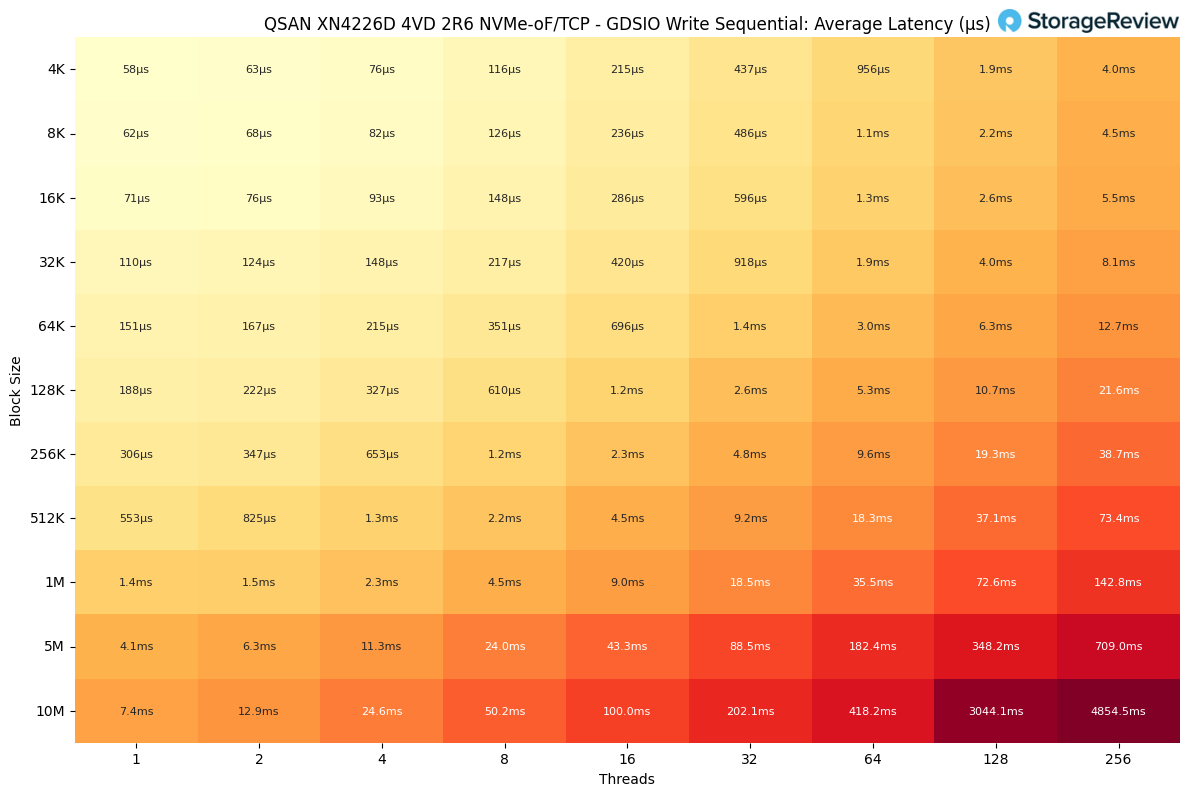
GDSIO 순차 쓰기 지연 결과에서 응답 시간은 블록 크기가 작을수록 원활하게 증가했지만 블록 크기와 스레드 수가 모두 증가하면 급격히 증가했습니다.
가장 작은 워크로드에서는 지연 시간이 최소화되었습니다. 4K 블록과 단일 스레드를 사용할 경우 평균 지연 시간은 58µs에 불과했으며, 최대 4개 스레드에서 16K 블록까지 200µs 미만을 유지했습니다. 32K 블록과 적당한 동시성에서도 지연 시간은 1ms 미만으로 유지되었습니다.
시스템이 더 큰 블록 크기로 전환됨에 따라 지연이 더욱 두드러졌습니다. 128K 블록과 64개 스레드에서 지연 시간은 5.3ms에 달했고, 128개 스레드에서는 다시 두 배인 10.7ms로 증가했습니다. 512K 블록에서는 결과가 더욱 길어져 256개 스레드에서는 73.4ms까지 증가했습니다.
가장 무거운 케이스인 256개 스레드의 5M 및 10M 블록은 지연 시간이 각각 709ms 및 4.8초로 급격히 증가하여 순차적 쓰기 확장의 상한선을 드러냈습니다.
최종 생각
QSAN의 XN4226D는 많은 IT 팀이 필요로 하는 바로 그 자리에 있습니다. 아키텍처 변경 없이 최신 프로토콜과 레거시 프로토콜을 모두 지원하는 통합 듀얼 컨트롤러 NVMe 플랫폼입니다. 테스트 결과, TCP는 21.21GB/s의 대용량 순차 읽기 성능을 기록했으며, RDMA는 11.14GB/s의 대용량 순차 쓰기 성능을 기록하며 동시성 확장 시 지연 시간을 단축했습니다. 더 작은 블록 크기에서 RDMA는 임의 쓰기 효율성을 지속적으로 향상시키고 테일 동작을 억제했습니다. 결론은 간단합니다. 광범위한 호환성과 높은 읽기 대역폭을 위해서는 NVMe-oF TCP를 사용하고, 쓰기 지연 시간과 일관성이 가장 중요한 경우에는 RDMA를 사용하는 것이 좋습니다.
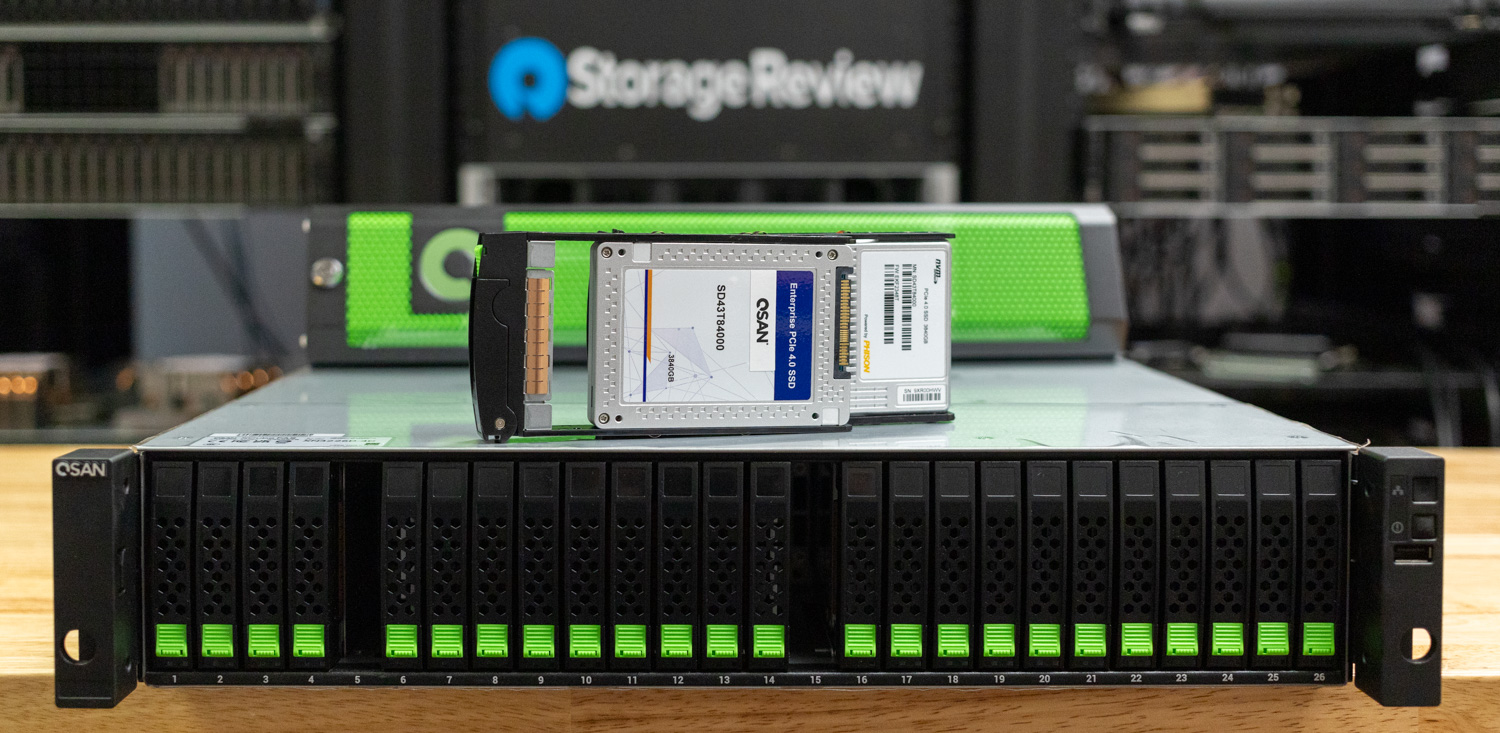
하드웨어 설치 공간은 실용적입니다. 2U 섀시에 U.2 또는 U.3 NVMe 드라이브용 전면 베이 26개를 제공하며, 활성 고가용성을 제공하고 용량이 NVMe 속도보다 우선시될 경우 SAS 셸프로 간편하게 확장할 수 있습니다. QSM 4는 기대되는 데이터 서비스와 깔끔한 UI, 그리고 기존 자동화 시스템과의 원활한 통합을 지원하는 REST API를 제공합니다. 소규모 IT 팀은 QSM 4를 쉽게 구성하고 관리할 수 있습니다. 이를 검증하기 위해 Proxmox 클러스터를 손쉽게 통합하여 해당 VM에 고속 스토리지 액세스를 제공했습니다. 더욱 향상된 워크로드를 위해 QSAN은 중소기업 AI 요구 사항을 충족할 수 있도록 설계되었습니다.
예측 가능한 성능, 깔끔한 관리, 그리고 다중 프로토콜 지원 범위를 중시하는 기업이라면 XN4226D를 강력히 추천합니다. 진정한 NVMe 처리량, RDMA를 통한 뛰어난 쓰기 지연 시간, 그리고 속도 저하 없는 소프트웨어 경험을 제공합니다. 합리적인 가격까지 더해지면, 이 QSAN 플랫폼은 혼합 환경을 문제없이 지원할 수 있습니다.


 아마존