

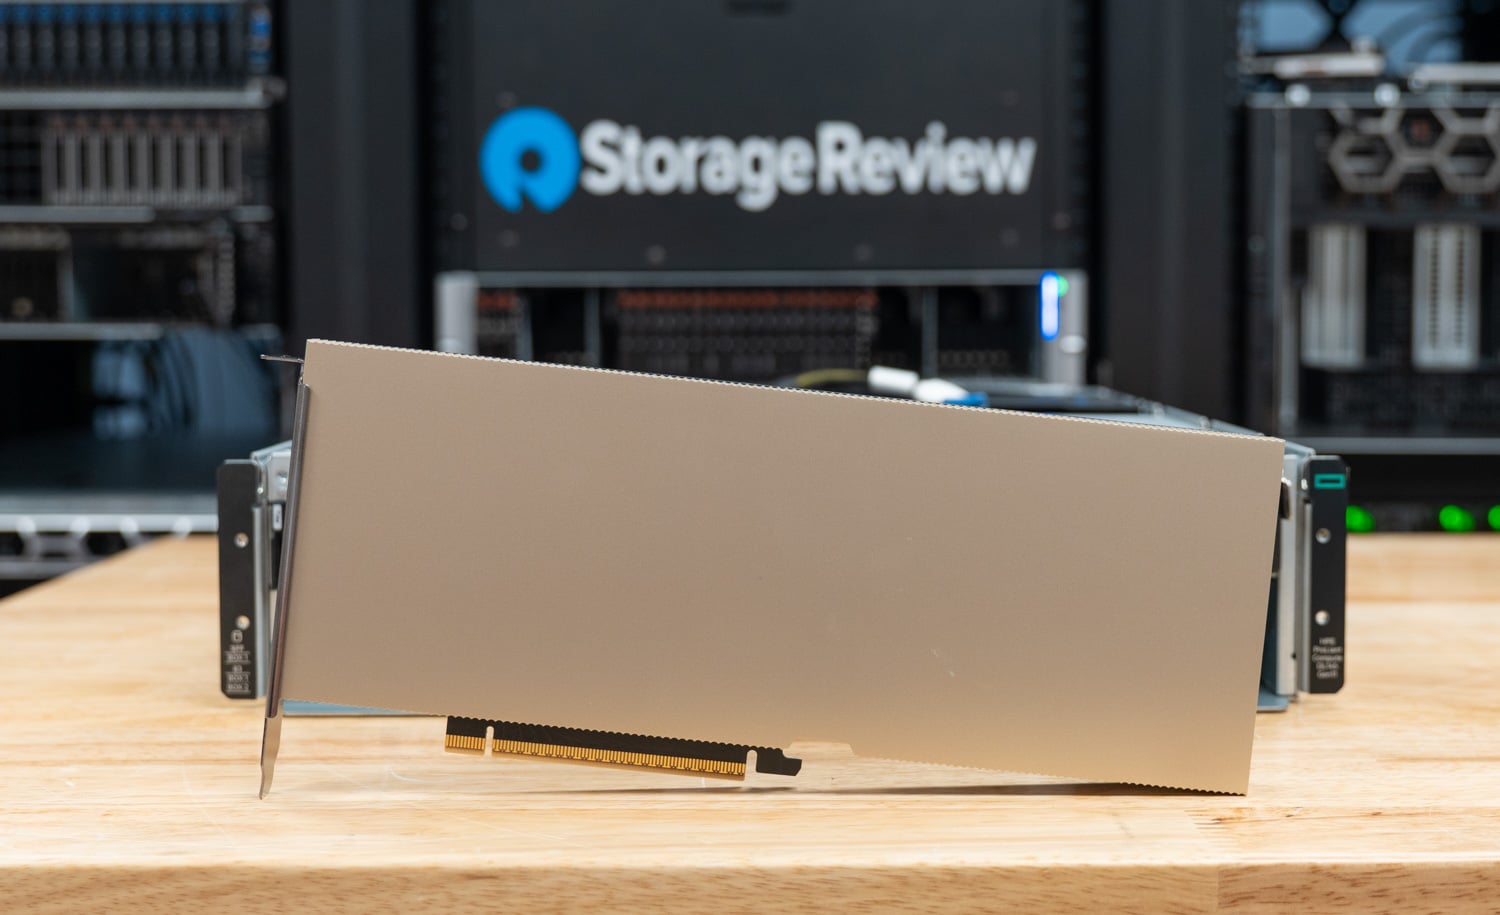
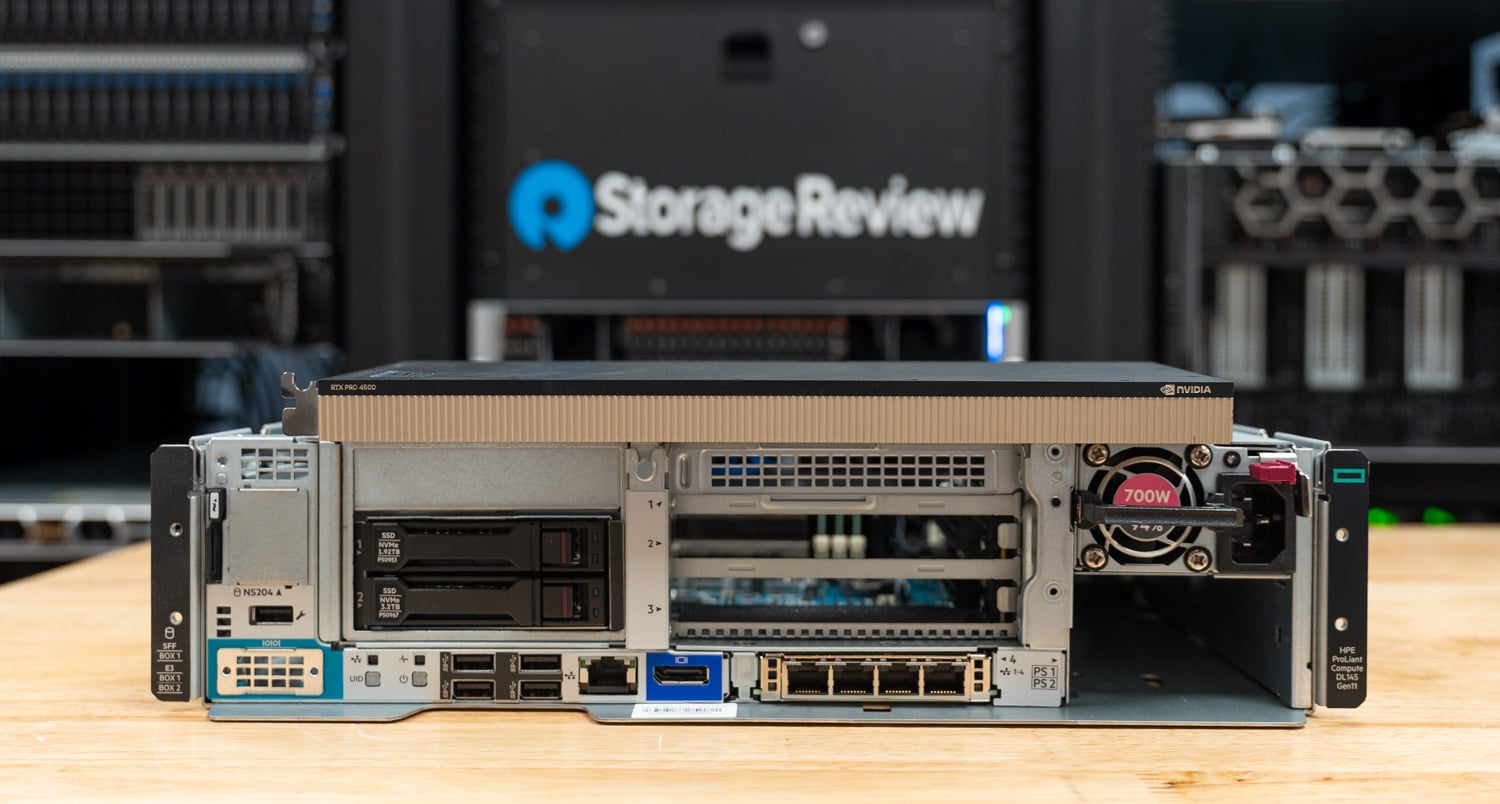
NVIDIA RTX PRO 4500 Blackwell Server Edition은 데이터 센터 외부에 있는 서버의 L4 스토리지를 대체하기 위해 NVIDIA가 개발한 그래픽 카드입니다. 싱글 슬롯, PCIe Gen5, 팬리스 쿨링 방식, 165W 소비 전력, 32GB GDDR7 메모리, 그리고 FP4 텐서 코어와 멀티 인스턴스 GPU를 포함한 Blackwell의 모든 기능을 갖추고 있습니다. HPE는 자사의 Nemotron 엣지 솔루션에 이 GPU와 함께 사용되는 소형 엣지 서버인 ProLiant DL145 Gen11을 제공했고, 동일한 섀시에서 RTX PRO 4500과 L4 스토리지를 사용하여 동일한 vLLM 서빙 테스트를 진행했습니다. 이 RTX PRO 4500 엣지 에디션 리뷰는 바로 이 비교에 초점을 맞추고 있습니다. 엣지 서버에서 이미 L4 스토리지를 사용하고 있는 사이트가 RTX PRO 4500으로 교체했을 때 토큰 사용량, 지연 시간, 그리고 전력 소비 측면에서 어떤 이점을 얻을 수 있는지 살펴봅니다.
두 개의 소규모 BF16 모델을 실제 동시 접속 환경에서 테스트한 결과, RTX PRO 4500은 L4 스토리지보다 2.7배 빠른 처리량을 제공하며, L4 스토리지가 이미 대기열에 들어간 부하에서도 첫 토큰 처리 지연 시간을 1초 미만으로 유지합니다. 이를 위해 DL145의 전체 서버 소비 전력을 약 196W에서 약 301W로 높였습니다. GPU 와트당 성능 향상은 1.3~1.4배입니다. 카드 한 장당 성능 향상은 동시 채팅 세션 32~64개 처리와 256개 처리의 차이에 해당합니다. DL145는 서버 한 대당 최대 3개의 L4 스토리지를 사용하며, 각각 32개의 세션을 처리하는 3개의 L4 스토리지는 처리량 면에서 RTX PRO 4500 한 대와 거의 비슷한 수준입니다. 따라서 RTX PRO 4500의 서버 성능 차이는 사용자별 속도, 지연 시간, 32GB 단일 메모리 풀, 그리고 FP4 연산 능력에 달려 있습니다.
이 글은 Metrum AI® Bench Platform에서 24GB 및 32GB 모델을 사용하여 RTX PRO 4500 Server Edition의 성능을 이전 모델과 비교한 엣지 서버 환경 분석입니다. RTX PRO 4500 Server Edition은 NVIDIA의 다른 추론 그래픽 카드 제품군과의 광범위한 비교 대상이기도 하며, 해당 테스트는 별도의 기사에서 다룰 예정입니다. 이 글에서는 L4 캐시 성능 비교가 가장 중요하며, 더 큰 용량의 카드와 비교했을 때 26GB 모델의 NVFP4 성능이 어떻게 달라지는지 보여주기 위해 RTX PRO 6000 Blackwell 데이터셋 하나를 추가했습니다. RTX PRO 6000은 HPE 엣지 서버에서 지원되지 않습니다.
주요 요점
- 동일 서버 내 L4 성능이 2.7배 향상되었습니다. Qwen3.5-4B 및 Gemma 4 E4B의 18가지 입력 및 출력 조합에 걸쳐 RTX PRO 4500은 동시 요청 8~32개에서 L4보다 초당 평균 2.7배, 256개에서는 3.0배~3.2배 빠른 출력 토큰을 제공했으며, 두 카드 모두 동일한 HPE ProLiant DL145 Gen11에 장착되었습니다.
- 지연 시간이 더 큰 격차입니다. 4500은 토큰당 12~15ms의 응답 시간을 보이는 반면, L4는 35~40ms가 소요됩니다. 또한, 256개의 동시 요청 시 첫 번째 토큰 생성까지의 중간 시간은 256개 토큰 요청에서 264ms~650ms로 유지되었지만, L4는 9초에서 39초까지 증가했습니다.
- 벽면 콘센트에서 105W 더 많은 전력을 소비하면 토큰은 2.7배 증가합니다. DL145는 L4에서 서비스할 때 약 196W, 4500에서 32명의 동시 접속 시 약 301W의 전력을 소모했습니다. 시스템 와트당 출력 토큰 수는 Qwen3.5-4B에서 2.7에서 5.1로, Gemma 4 E4B에서 2.9에서 5.6으로 증가했습니다.
- 채팅 형태의 프롬프트에서 사용자별 속도는 256개 세션으로 제한됩니다. 동시 접속자 수로 출력을 나누어 보면, 4500은 256개 토큰 이상의 짧은 및 중간 길이의 질문에 대한 답변을 입력할 때, 동시 접속자 256명에서 여전히 모든 사용자에게 초당 11~22개의 토큰을 제공하는 반면, L4는 3.7~8.7개로 떨어집니다. L4는 대부분의 질문 형태에서 32~256개 세션 사이에서 초당 10개 토큰 미만의 최저치를 기록하고, 사전 입력이 많은 1,024/32 형태에서는 8~16개 세션 사이에서 최저치를 기록합니다. 반면 4500은 짧은 답변형과 1,024개 토큰 질문 형태를 제외하고는 동시 접속자 256명에서 최저치를 유지합니다.
- 32GB와 FP4는 L4가 기본적으로 실행할 수 없는 모델 클래스를 엽니다. Gemma 4 26B-A4B NVFP4 메모리와 FP8 KV 캐시를 사용한 테스트에서, RTX 4500은 32개의 동시 접속 환경에서 초당 1,613개의 출력 토큰을 165W의 전력 소모로 생성했습니다. 이는 워크스테이션에서 8~32개의 동시 접속 환경에서 266~471W를 소모하는 RTX PRO 6000 Blackwell의 절반 수준입니다. 동시 접속이 256개로 증가하면 그 차이는 약 2.5배로 벌어집니다.
RTX PRO 4500 서버 에디션은 어떤 용도로 설계되었습니까?
NVIDIA는 GTC 2026에서 RTX PRO 서버 제품군의 엔트리 티어이자 L4의 후속 제품인 RTX PRO 4500 Blackwell 서버 에디션을 발표했습니다. 이 제품은 RTX PRO 4500 Blackwell 워크스테이션 카드와 이름은 같지만, 동일한 실리콘과 10,496개의 CUDA 코어를 공유합니다. 서버 에디션은 디스플레이 출력과 팬을 제거하고 보드 전력을 165W로 제한하며, 데이터 센터 기능을 추가했습니다. 여기에는 최대 16GB 인스턴스를 두 개까지 지원하는 MIG, 기밀 컴퓨팅, 세 번째 NVENC 및 NVDEC, 그리고 vGPU 지원이 포함됩니다. NVIDIA는 메모리 속도를 800GB/s, FP4 텐서 연산 성능을 스파시티 처리 시 최대 1.6 PFLOPS로 발표했으며, 이 카드를 "주류 데이터 센터 및 엣지 서버를 위한 전력 효율적인 엔터프라이즈 AI용 Blackwell GPU"라고 설명했습니다. 이 내용은 HPE GTC 2026 보도 자료 에서 다뤘습니다.
NVIDIA는 폼팩터도 변경했습니다. 2024년에 리뷰했던 L4 는 72W 전력을 소비하는 하프 하이트, 하프 랭스 카드로 24GB의 GDDR6 메모리(300GB/s)를 탑재했지만, RTX PRO 4500 서버 에디션은 165W 전력을 소비하는 풀 하이트, 풀 랭스 싱글 슬롯 보드입니다. 따라서 슬롯 하나는 차지하지만 풀 랭스 라이저와 16핀 전원 케이블이 필요합니다. DL145 Gen11의 표준 슬롯은 풀 하이트, 하프 랭스이며, HPE는 테스트 장치에 풀 랭스 라이저와 전원 케이블을 장착했습니다. 스펙상으로 4500은 L4보다 2.7배 높은 메모리 대역폭, 33% 더 많은 메모리 용량, 2.3배 더 높은 전력 소비량으로 FP8 텐서 피크 성능이 1.7배 향상되었으며, L4에는 하드웨어적으로 지원되지 않는 FP4 경로도 제공합니다.
| 스펙 | RTX PRO 4500 블랙웰 서버 에디션 | 엔비디아 L4 |
|---|---|---|
| 플랫폼 개요 | ||
| 아키텍처 | 블랙웰 | 에이다 러브 레이스 |
| CUDA 코어 | 10,496 | 7,424 |
| 메모리 | 32GB GDDR7(ECC 포함) | 24GB GDDR6 |
| 메모리 대역폭 | 800GB / s | 300GB / s |
| 성능 (NVIDIA 최고 수치, 희소성 포함) | ||
| FP32 | 51 TFLOPS | 30.3 TFLOPS |
| FP8 텐서 | 811 TFLOPS | 485 TFLOPS |
| FP4 텐서 | 1.6PFLOPS | 지원되지 않음 |
| 전력 및 폼 팩터 | ||
| 보드 전원 | 165W | 72W |
| 폼 팩터 | 싱글 슬롯, 전체 높이, 전체 길이, 패시브 | 단일 슬롯, 반높이, 반길이, 패시브 |
| 전원 커넥터 | PCIe CEM1 5핀 16개 | 슬롯 전원 공급 |
| 인터페이스 | PCIe 5.0 x16 | PCIe 4.0 x16 |
| 기능 | ||
| MIG | 최대 2개의 인스턴스, 16GB 용량 | 아니 |
| NVENC / NVDEC | 3 / 3 | 2 / 4 |
| 기밀 컴퓨팅 | 유능한 | 아니 |
엣지 서버: HPE ProLiant DL145 Gen11
HPE는 DL145 Gen11을 서버실이 없는 사업장을 위한 서버로 포지셔닝합니다. HPE의 DL145 및 NVIDIA Nemotron 솔루션 개요에 따르면, 이 제품은 벽걸이형으로 설치가 가능하고 소음이 거의 없는 박스 형태로, -5°C에서 55°C까지의 작동 온도를 지원하며, 공기 흐름이 원활하지 않거나 먼지가 많은 장소, 또는 극한의 온도 변화에도 대응합니다. 또한 iLO 및 컴퓨팅 운영 관리 기능을 통해 전원과 이더넷만으로 수백 개의 사업장을 효율적으로 운영할 수 있도록 지원합니다. HPE는 소매, 의료, 금융, 제조, 에너지 산업을 주요 고객으로 제시하며, 본 리뷰에서 측정한 워크로드(소규모 언어 모델, RAG, 벡터 검색)도 HPE에서 제안한 것과 동일합니다. 이를 통해 지연 시간에 민감하고 규제 대상인 데이터가 사업장 외부로 유출되지 않도록 로컬에서 효율적으로 처리할 수 있습니다. DL145 Gen11은 출시 당시 이미 리뷰했으므로, 여기서는 자세한 내용은 생략하겠습니다.
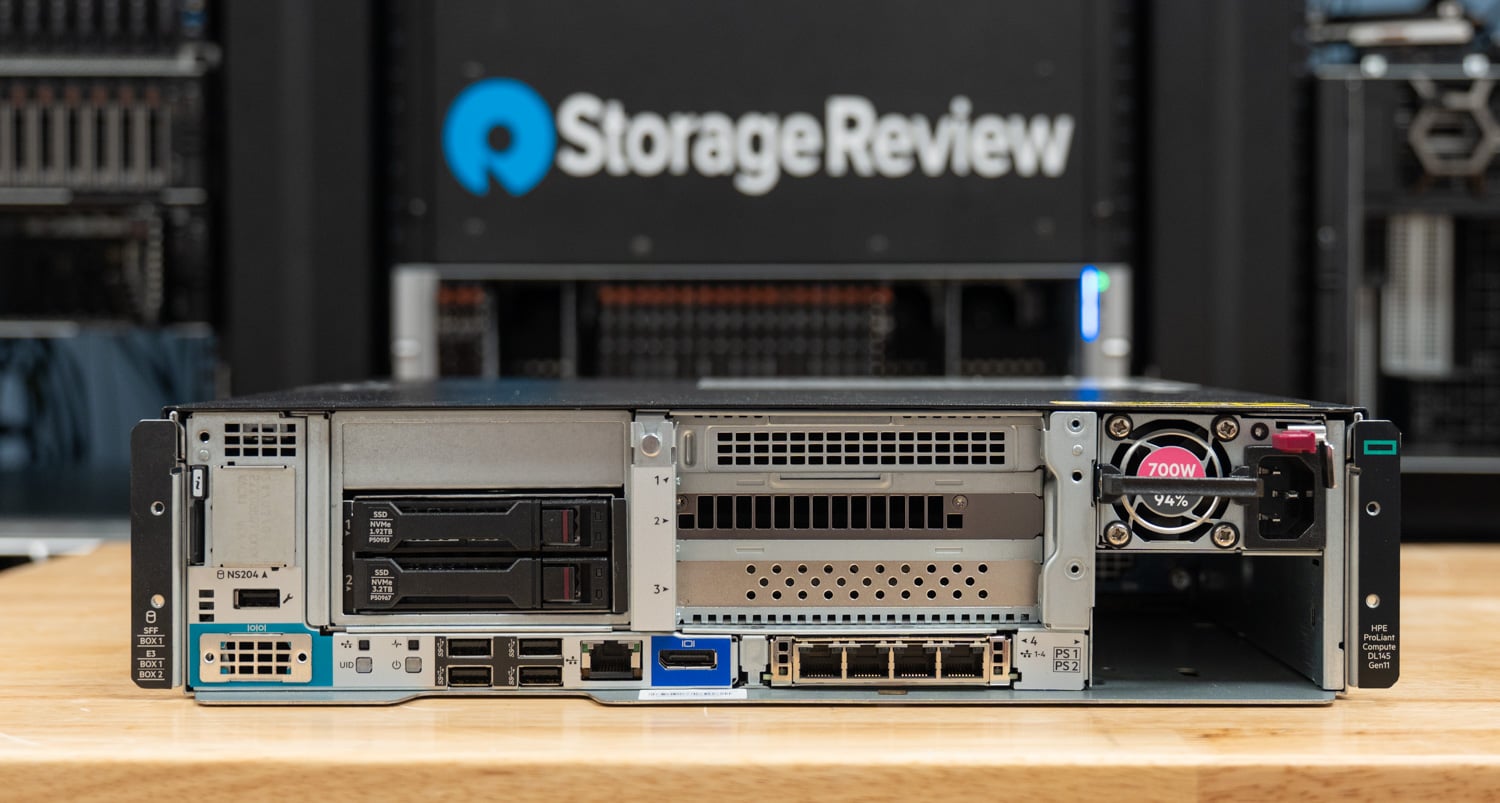
HPE에서 테스트용으로 제공한 장치는 AMD EPYC 8534P(64코어 128스레드 시에나 프로세서), 16GB DIMM 6개로 구성된 96GB DDR5-4800 메모리, 그리고 풀사이즈 라이저에 장착된 RTX PRO 4500 Blackwell Server Edition으로 구성되어 있습니다. 섀시는 2베이 U.3 백플레인을 갖추고 있으며, 저희 장치는 SATA 케이블만 제공되는 상태로 배송되었기 때문에 PCIe 슬롯에 장착된 6.4TB Solidigm D7-P5620 NVMe SSD에서 부팅했습니다. 이는 GPU 성능 결과에는 영향을 미치지 않습니다. L4 비교에도 동일한 서버 구성을 사용했습니다. RTX PRO 4500은 HPE가 Nemotron 엣지 솔루션용으로 이 플랫폼에 탑재하는 그래픽 카드이며, L4는 지난 2년간 DL145 사용자가 해당 슬롯에 장착했을 가능성이 가장 높은 그래픽 카드입니다.
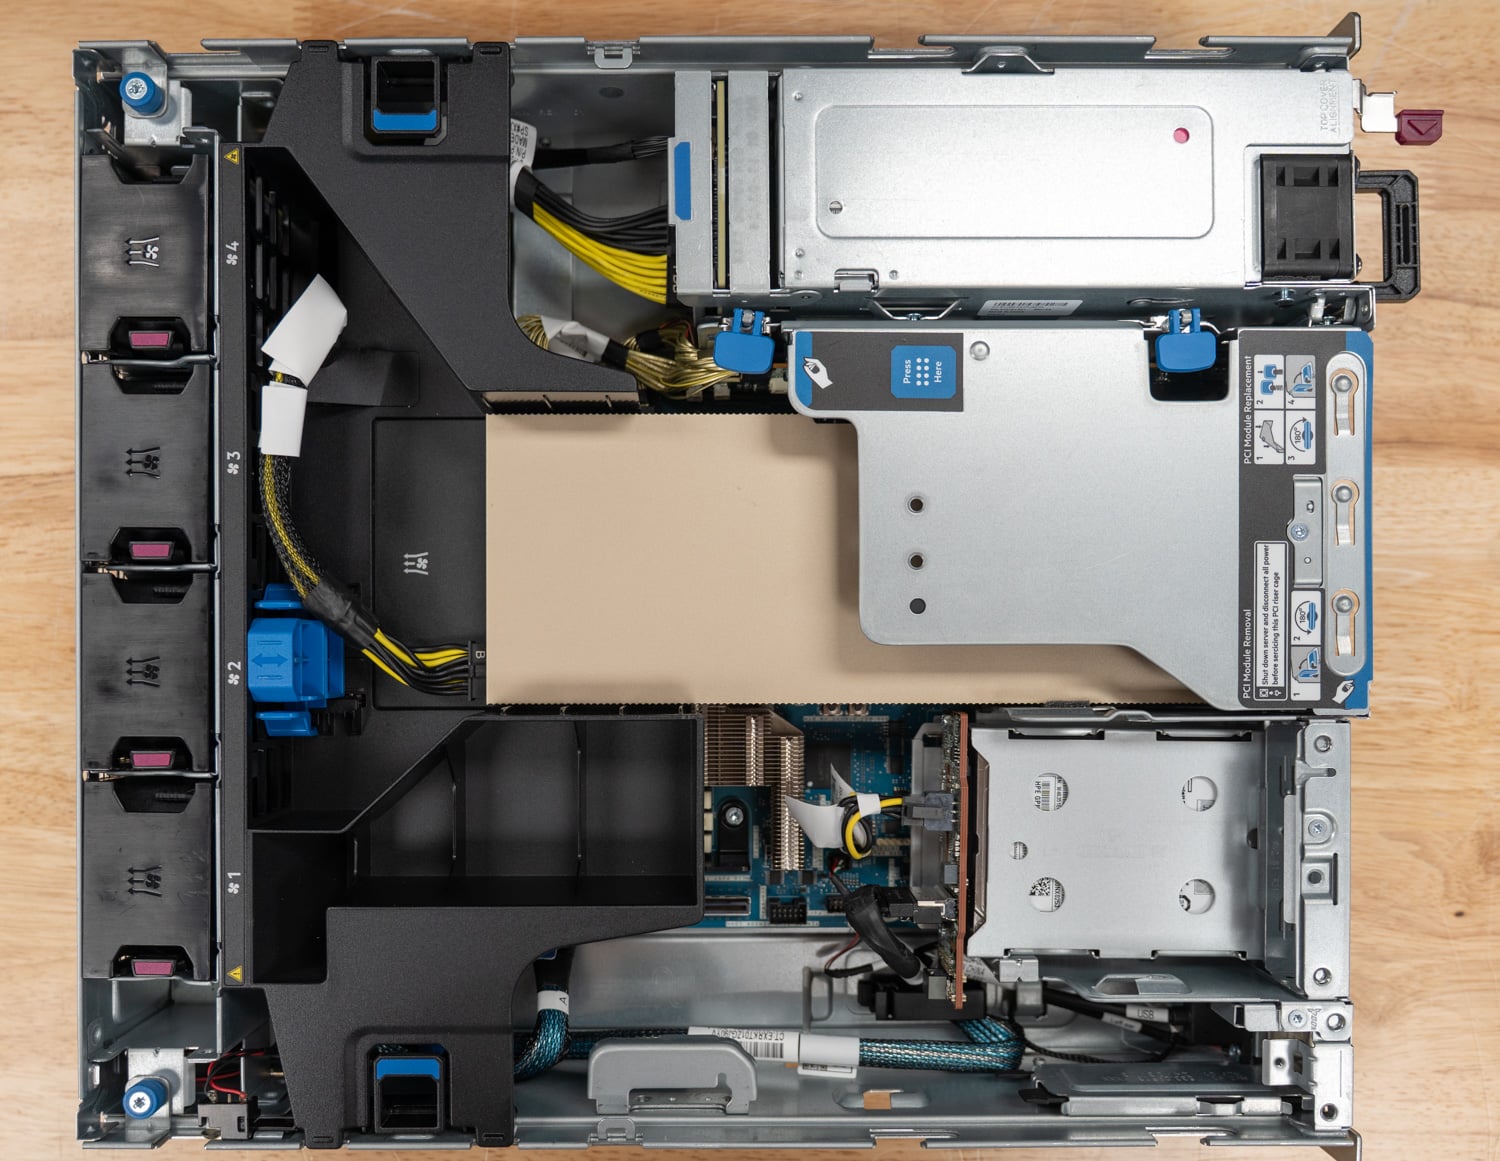
아래 분석에는 두 가지 플랫폼 수치가 더 활용되었습니다. DL145는 iLO를 통해 서버 전체 전력을 보고하고, Bench Platform은 모든 실행에서 GPU 자체의 보드 전력과 함께 전력을 기록하므로 벽면 콘센트에서의 소비 전력(와트)과 그래픽 카드에서의 소비 전력(와트)을 모두 확인할 수 있습니다. 또한 서버의 공기 흐름 덕분에 두 패시브 카드 모두 허용 범위 내에서 온도를 유지할 수 있었습니다. 4500은 가장 긴 실행 시간 동안 평균 GPU 온도가 84°C를 기록했고, L4는 86°C를 기록했습니다. 이는 2U 크기의 짧은 깊이 섀시에서 최대 전력으로 추론 작업을 지속적으로 수행한 결과입니다.
테스트 방법
본 리뷰에 사용된 모든 추론 데이터는 Metrum AI Bench Platform (버전 3.9.2, 실행 파일에는 이전 이름인 Metrum Insights로 기록됨)을 사용하여 수집되었으며, 서비스 엔진으로는 vLLM 0.24.0이 사용되었습니다. Bench Platform은 각 시스템에 대해 고정된 시나리오 그리드를 실행하고, 각 시나리오에 대한 처리량, 지연 시간 백분위수, GPU 원격 측정 데이터 및 호스트 전력을 기록하며, 결과를 작업별 단일 데이터 세트로 내보냅니다. 저희는 이전에 Metrum AI와 오리건 주립대학교의 협력 사례에 대해 소개한 적이 있으며 , Dell 또한 R770AP 기술 브리핑에 동일한 플랫폼을 사용했습니다. 이번에는 저희가 이 플랫폼을 사용하여 GPU 비교를 처음부터 끝까지 진행한 첫 번째 사례입니다. Metrum AI 엔지니어와 저희 연구실이 함께 작업을 실행했으며, Bench Platform은 데이터 수집을 담당하고 저희 팀은 하드웨어, 모델 및 질문을 설정했습니다.
Metrum AI는 독자들이 자신의 시스템에서 동일한 유형의 테스트를 실행할 수 있도록 오픈 소스 버전인 Metrum AI Bench CLI 도 제공합니다 . Metrum AI는 등록 상표이며, Metrum AI Bench CLI 및 Metrum AI Bench Platform은 Metrum AI, Inc.의 상표입니다. Metrum AI Bench의 사용이 Metrum AI의 승인을 의미하는 것은 아닙니다.
그리드는 9가지 프롬프트 형태로 구성됩니다. 입력 토큰의 32, 256, 1,024개 조합과 최대 출력 토큰의 32, 256, 1,024개 조합을 각각 1, 8, 16, 32, 256개의 동시 요청으로 실행하여 모델 및 GPU당 45개의 시나리오를 생성했습니다. L4의 Gemma 4 실행에는 64개와 128개의 동시 요청도 포함되었는데, 이는 최대 성능을 찾는 데 유용했습니다. 각 시나리오는 1~32개의 동시 요청에서는 스트림당 15개의 요청을, 256개의 동시 요청에서는 1,280개의 요청을 전송합니다. 4500의 Gemma 4 E4B 작업은 세 번 실행되었으며, 시나리오 간 반복 실행의 편차는 2% 미만이었습니다. 따라서 중앙값을 보고합니다. L4 및 4500 BF16 작업과 각 카드에 하나씩 있는 두 개의 Gemma 4 26B 작업을 포함하여 총 378개의 시나리오 실행이 수행되었으며, 이 중 4500 시나리오 중 한 번의 반복 실행에서 요청 실패가 한 건 발생했습니다. 이는 정보 공개를 위해 언급하는 것입니다.
테스트에는 세 가지 모델이 사용되었습니다. Qwen3.5-4B와 Gemma 4 E4B는 모두 BF16 KV 캐시를 사용하는 BF16 방식으로 실행되었으며, L4와 4500 모두에서 실행되었습니다. 이 두 모델은 현재 24GB 그래픽 카드를 사용하는 엣지 환경에서 실제로 사용되는 모델 크기입니다. Gemma 4 26B-A4B는 약 4B개의 활성 파라미터를 가진 26B 혼합형 전문가 모델로, 4500에서만 FP8 KV 캐시를 사용하는 NVFP4 방식으로 실행되었습니다. 기준점 으로는 Dell Pro Max Tower T2 에 장착된 RTX PRO 6000 Blackwell Workstation Edition(600W)이 사용되었습니다. L4는 네이티브 FP4 연산 기능을 지원하지 않고 BF16 환경에서 해당 모델을 실행할 공간이 없으므로 테스트에서 제외되었습니다.
차트 해석 시 세 가지 유의사항: 처리량 그래프는 동시 요청 8개부터 시작합니다. 단일 요청 시나리오는 매우 짧기 때문에(요청 15개, 각 요청당 몇 초 소요) 4500에서 각 단일 사용자 Qwen 시나리오의 첫 번째 요청(첫 토큰 수신까지 37~39초 지연 발생)이 전체 처리량 수치를 왜곡할 수 있습니다. 따라서 단일 사용자 시나리오의 경우, 영향을 받지 않는 토큰당 지연 시간과 응답 시간을 보고합니다. GPU 전력은 샘플링된 평균값이므로, 평균값이 안정될 만큼 충분히 긴 실행 시간(실제로는 동시 요청 16개 이상)에 대해서만 와트당 토큰 수를 계산합니다. 또한, 프롬프트 시간이 긴 256개의 동시 요청에서는 두 카드 모두 KV 캐시가 부족해지고 vLLM 큐에 요청이 쌓입니다. 이러한 지점도 실제 처리량 수치이긴 하지만, 해당 부하에서의 첫 토큰 수신 시간은 큐 상태를 나타내므로, 지연 시간에 민감한 사용 환경에서는 동시 요청 32개를 적정 작동 범위로 간주합니다.
Qwen3.5-4B
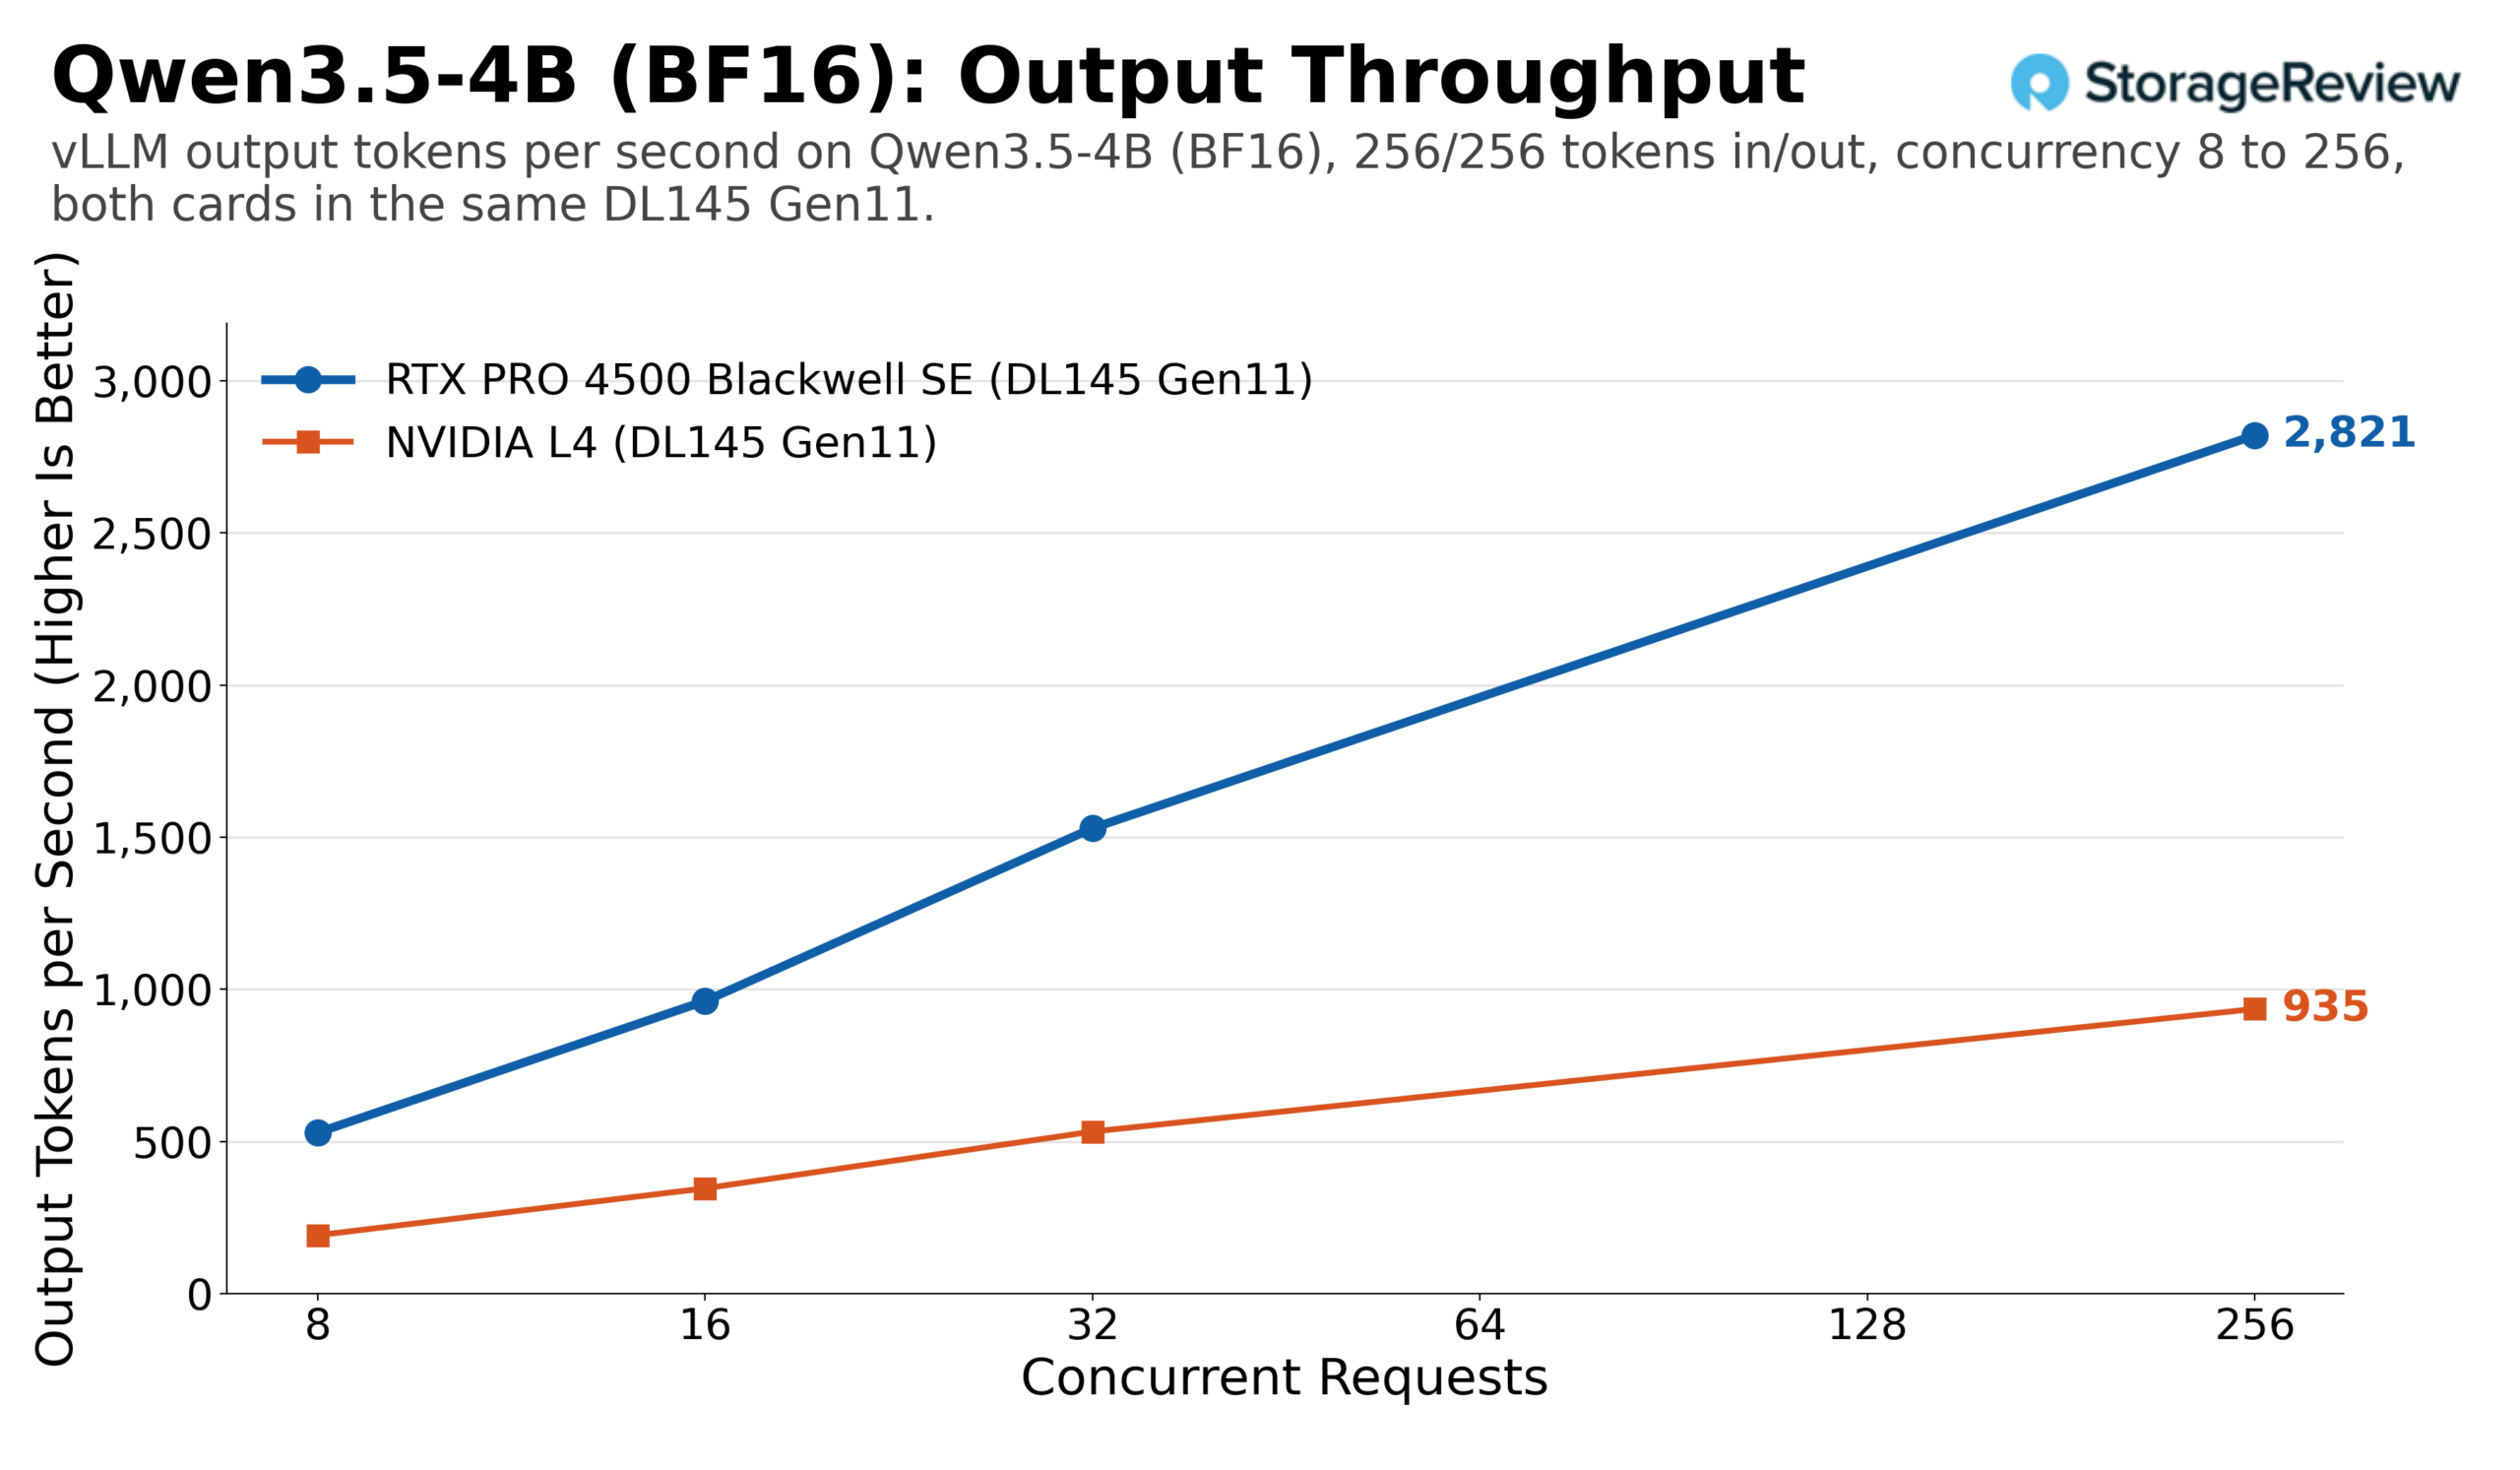
아래 표는 Qwen3.5와 4B의 전체적인 비교를 한눈에 보여줍니다. 8개에서 256개까지의 동시 요청 수에 따라 두 카드 모두에서 초당 출력되는 토큰 수를 나타냅니다. 동일한 곡선 형태가 9개의 패널 전체에 걸쳐 반복되며, 4500은 동시 요청 수 8개에서 L4의 약 2.5~2.8배로 시작하여 32개까지는 약간 더 빠르게 증가하다가 256개에서는 2.4~3.2배에 도달합니다.
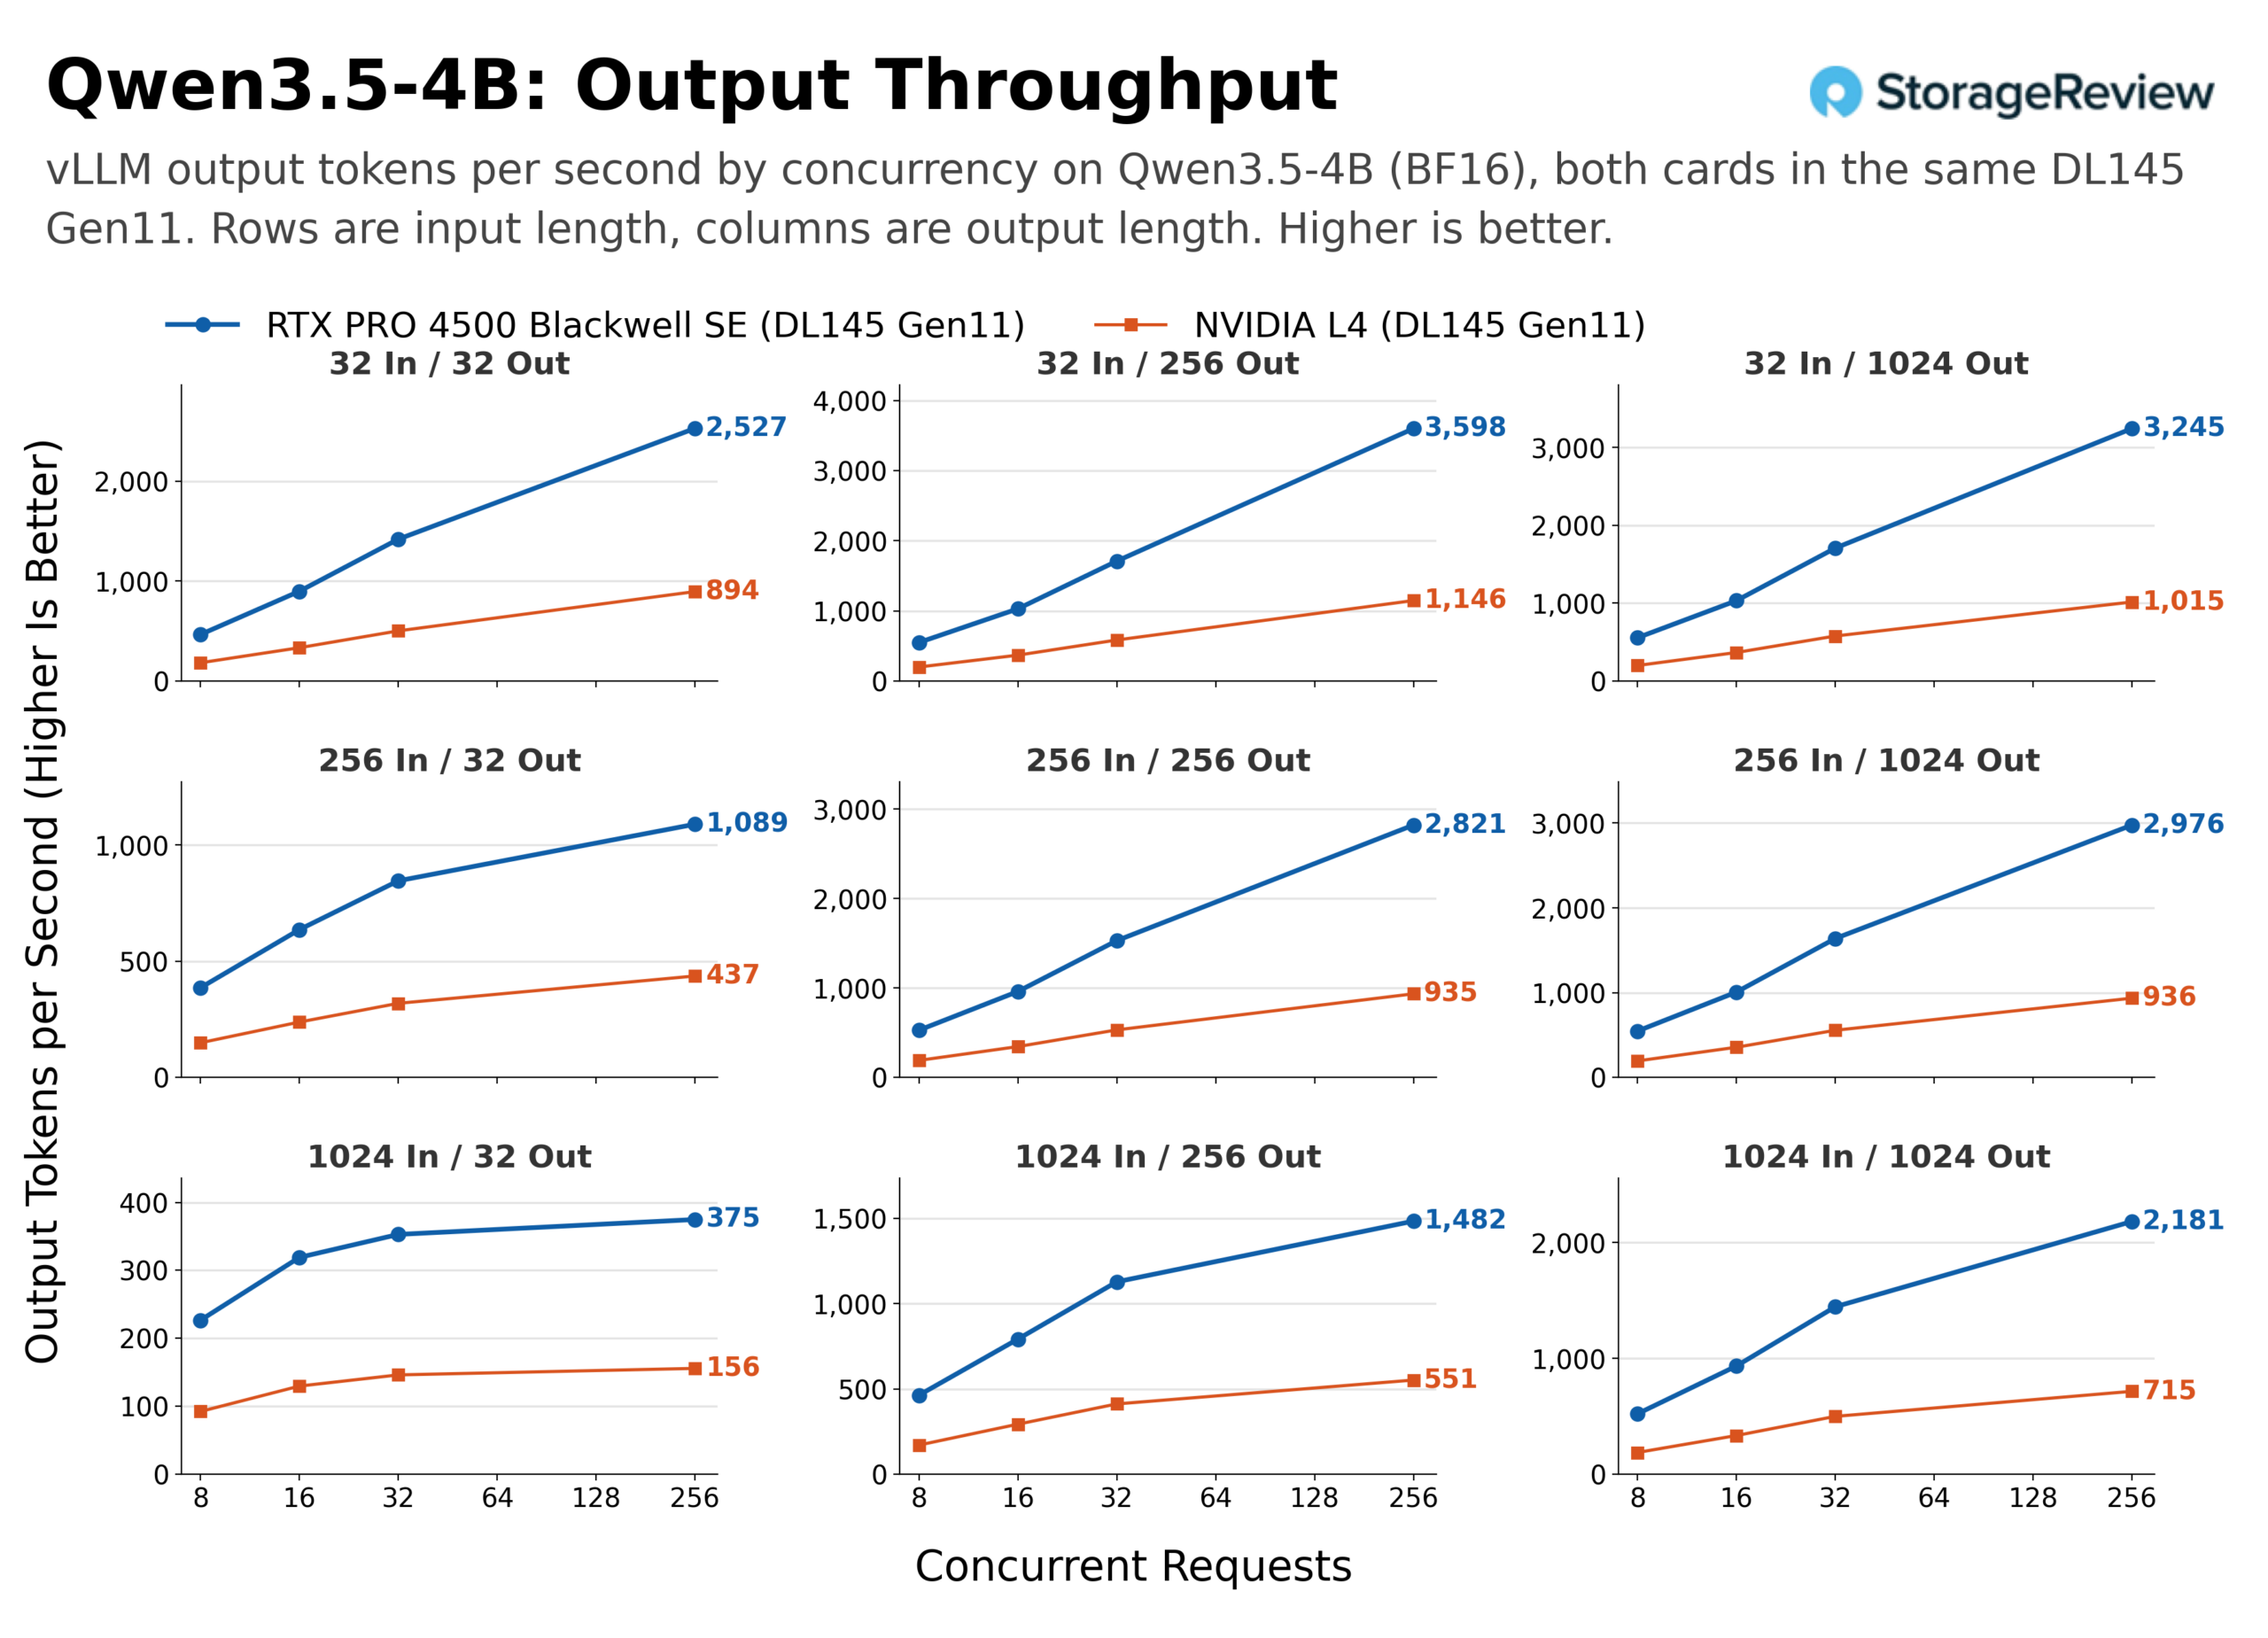
256개의 입력과 256개의 출력 토큰을 채팅 규모 기준으로 삼았을 때, 동시 접속자 8명에서는 L4가 초당 192개의 출력 토큰을, 4500은 529개의 출력 토큰을 생성하여 2.76배의 성능을 보였습니다. 동시 접속자 32명에서는 L4가 532개, 4500이 1,529개로 2.87배의 성능을, 동시 접속자 256명에서는 935개, 4500이 2,821개로 3.02배의 성능을 나타냈습니다. 가장 긴 형태인 양방향 1,024개 토큰의 경우에도 거의 동일한 결과를 보였습니다. 동시 접속자 32명에서는 499개, 4500이 1,445개, 동시 접속자 256명에서는 715개, 4500이 2,181개의 출력 토큰을 생성했습니다. 전체 범위에서 가장 차이가 적은 경우는 사전 채우기 작업이 많은 1,024개 입력, 32개 출력의 경우로, 이 워크로드는 거의 전적으로 즉시 처리 작업이며 두 카드 모두 처음부터 연산 능력 한계에 도달하기 때문에 동시 접속자 8명부터 4500이 꾸준히 2.4배의 성능을 보였습니다. Qwen3.5-4B는 두 카드 모두에서 해당 형태를 따라 꾸준히 상승합니다. BF16 그리드에서 동시 발생 16에서의 유일한 하락은 1,024/32에 있는 4500 실행 Gemma 4 E4B 때문이며, 이는 세 번의 반복 모두에서 나타났습니다. 아직 원인을 파악하지 못했습니다.
단일 사용자의 경우, 처리량 비율만으로는 차이를 제대로 파악할 수 없습니다. 사용자가 체감하는 것은 단어가 나타나는 속도이기 때문입니다. 256/256 형태의 경우, 4500은 토큰당 평균 12.4ms, L4는 35.0ms의 처리 속도를 보였습니다. 따라서 256개의 토큰으로 구성된 답변을 처리하는 데 4500에서는 약 3.2초, L4에서는 약 9.0초가 걸렸습니다. 1,024개의 토큰으로 구성된 경우에는 각각 13.1초와 36.6초가 소요되었습니다. 해당 사용자의 첫 번째 토큰 지연 시간은 짧은 프롬프트의 경우 4500에서 43ms, L4에서 81ms였고, 긴 프롬프트의 경우 4500에서 99ms, L4에서 219ms였습니다.
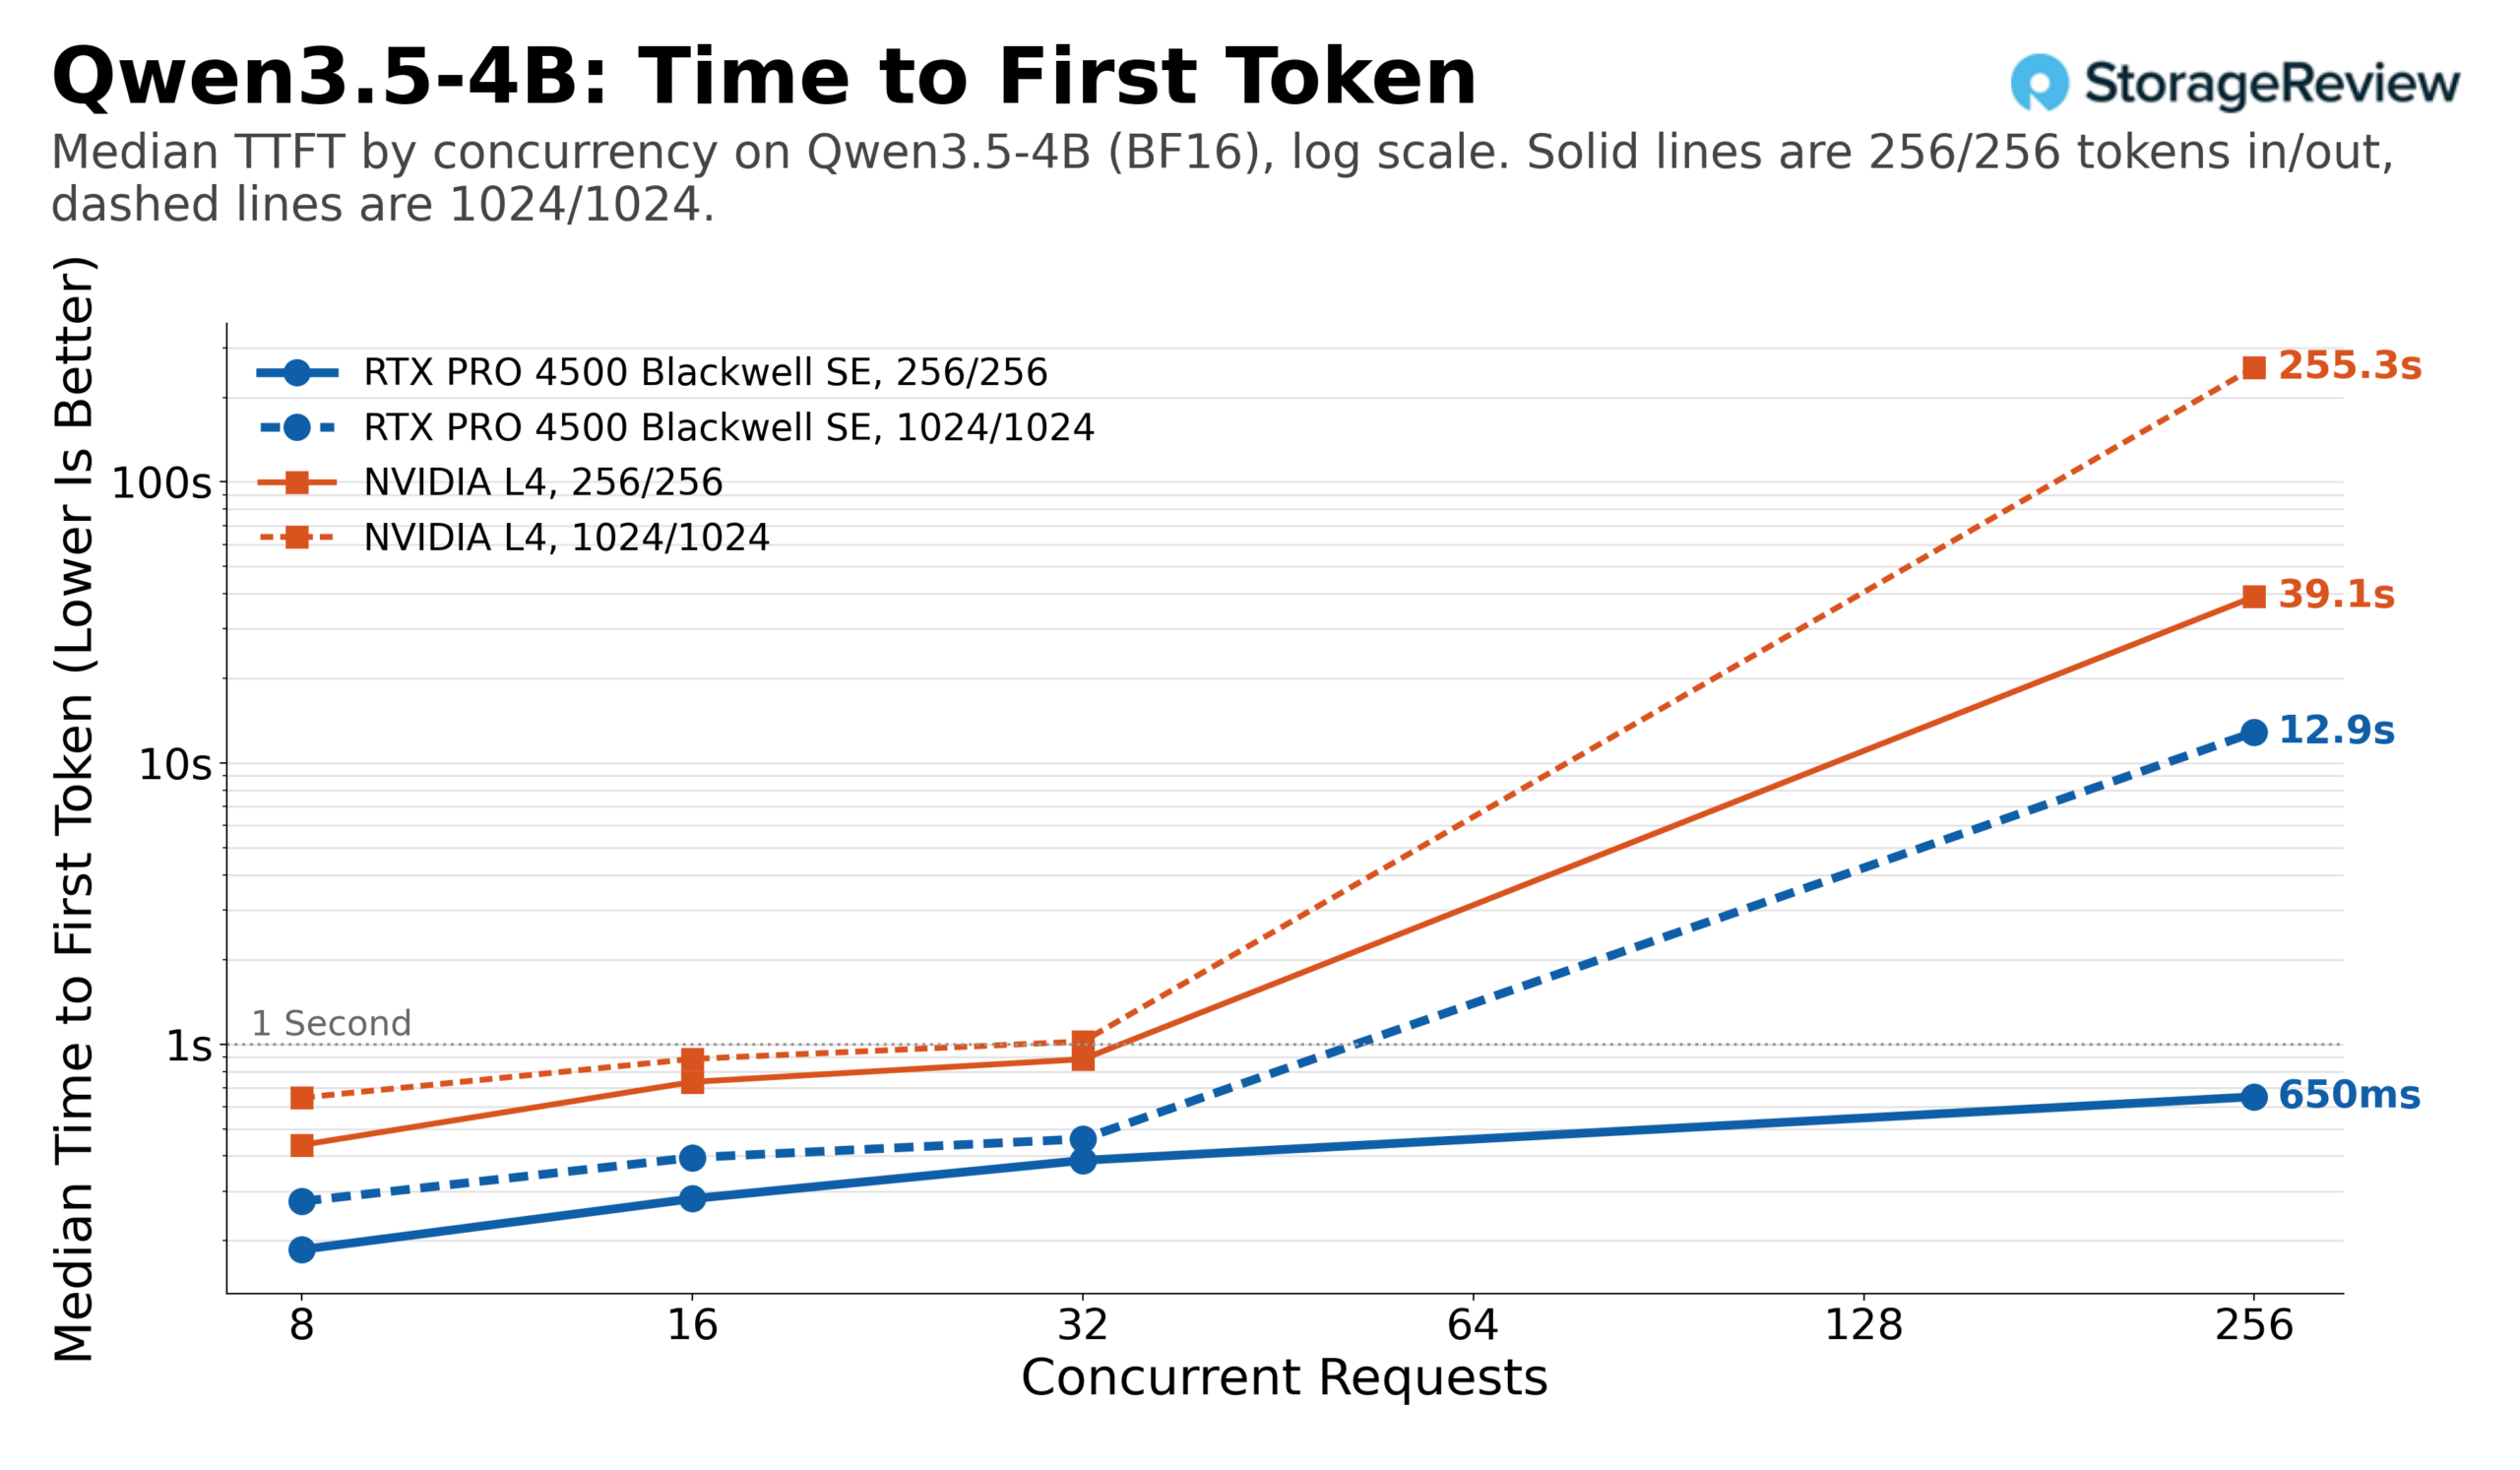
부하가 걸리면 지연 시간 차이가 벌어집니다. 256/256 셰이프에서 동시 접속자 32명일 때 L4의 첫 번째 토큰 수신까지의 중앙값 시간은 884ms였고, 4500은 386ms였습니다. 동시 접속자 256명에서는 L4의 지연 시간이 39초로 증가한 반면, 4500은 650ms를 유지했습니다. 1,024/1,024 셰이프에서는 동시 접속자 32명일 때 이미 1초를 초과했고(1,022ms), 256명에서는 255초에 달했습니다. 이는 요청이 vLLM 큐에서 KV 캐시가 비워지기를 4분 동안 기다리는 것과 같습니다. 4500은 해당 셰이프에서 동시 접속자 256명일 때만 1초를 넘었고, 이때 지연 시간은 12.9초였습니다. 아래 차트에서 L4의 그래프는 32명과 256명 사이에서 1초를 벗어나는 반면, 4500은 더 짧은 셰이프에서 1초 미만을 유지합니다.
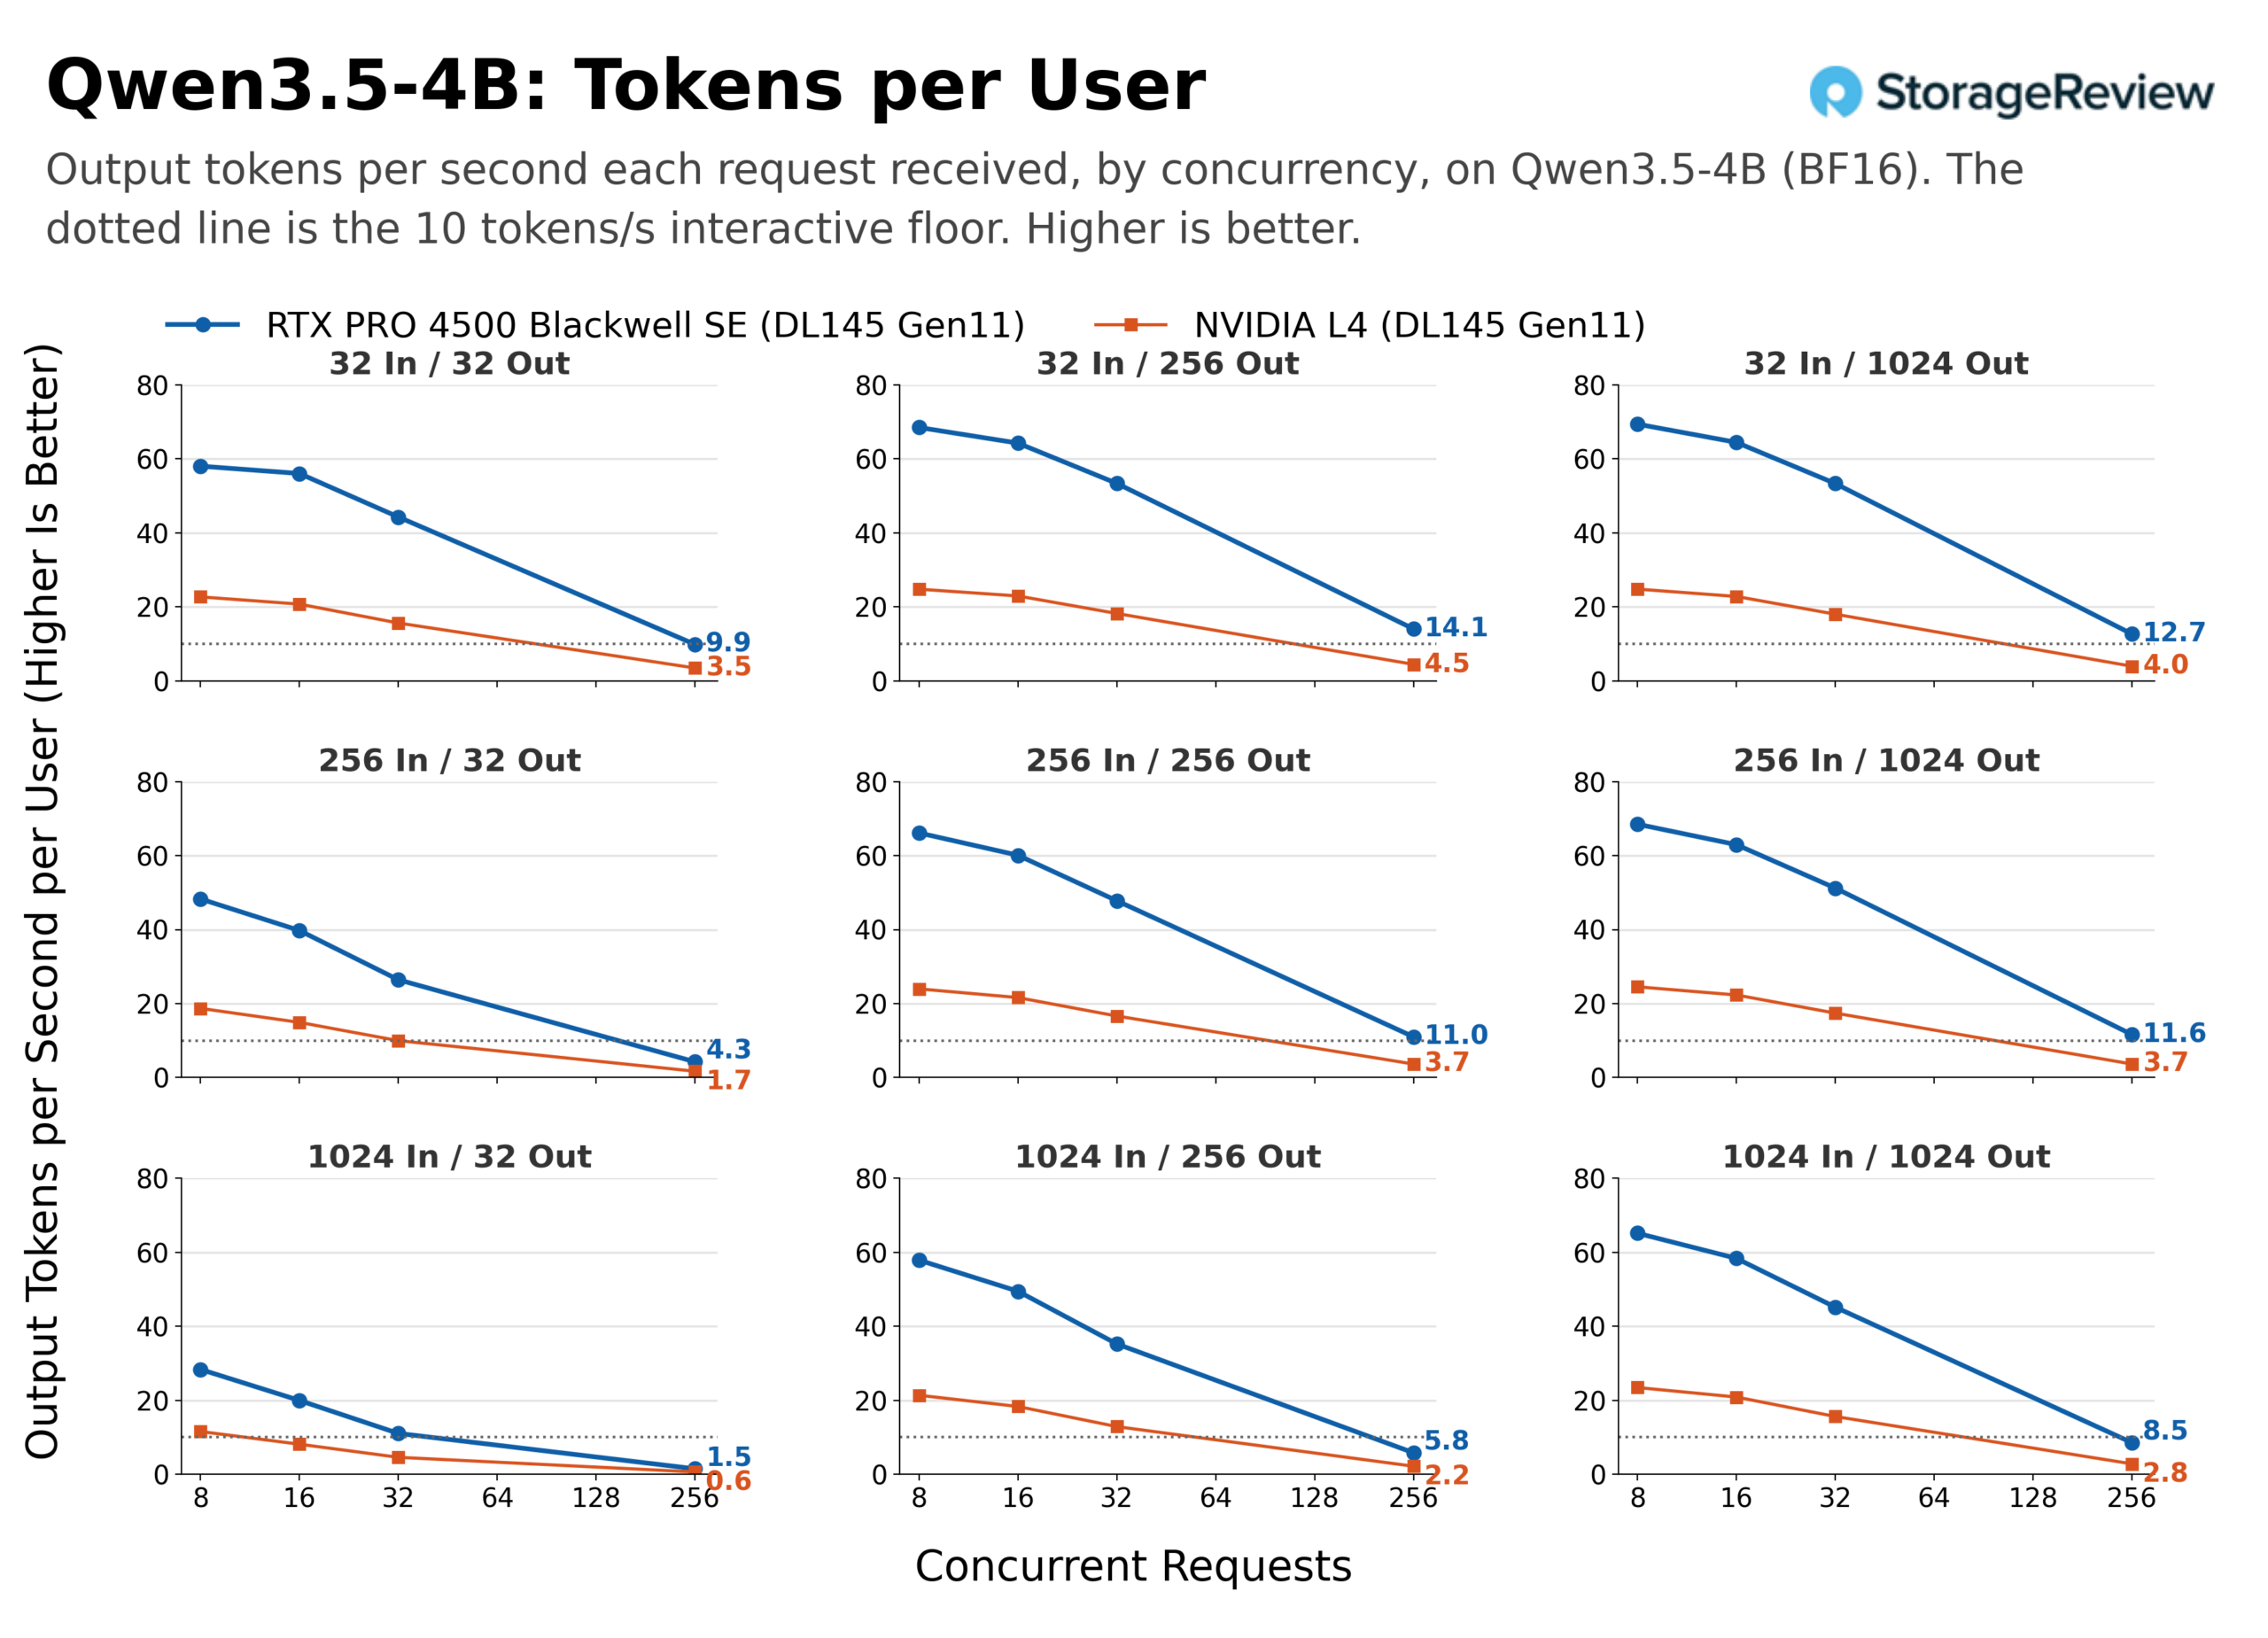
같은 데이터를 읽는 또 다른 방법은 사용자별로 살펴보는 것입니다. 초당 출력 토큰 수를 동시 요청 수로 나눈 값이 바로 큐에 있는 각 사용자가 실제로 경험하는 처리 속도입니다. 아래 표는 모든 도형에 대해 초당 10개의 토큰이라는 공통적인 대화형 사용 임계값을 기준으로 이 값을 보여줍니다. 동시 접속자가 32명일 때, 4500은 1,024개 입력, 32개 출력 도형을 제외한 모든 도형에서 사용자당 초당 44~53개의 토큰을 처리합니다. 1,024개 입력, 32개 출력 도형에서는 초당 11개의 토큰을 처리합니다. 반면 L4는 초당 10~18개의 토큰을 처리하다가 동일한 도형에서 이미 초당 4.6개까지 떨어졌습니다. 동시 접속자 수 256명에서 4500은 네 가지 채팅 형태 조합(32/256에서 14.1, 32/1,024에서 12.7, 256/256에서 11.0, 256/1,024에서 11.6)에서 최저치 이상을 유지하고, 32/32에서는 9.9로 최저치에 도달하며, 1,024 토큰 프롬프트와 단답형 프롬프트에서는 최저치 아래로 떨어져, 거의 모든 작업이 사전 입력으로 이루어지는 1,024/32에서는 1.5까지 내려갑니다. L4는 동시 접속자 수 256명에서 모든 형태에서 최저치 미만인 0.6에서 4.5 사이에 있습니다. 32명과 256명 사이에서는 테스트가 이루어지지 않았으므로 각 선이 점선으로 표시된 최저치를 넘는 지점은 이 두 동시 접속자 수 사이 어딘가에 있습니다. 차트에서 볼 수 있듯이 L4의 교차점은 모든 차트 형태에서 256보다 훨씬 이전에 나타나고, 4500의 교차점은 차트 형태에서 256 부근에서 나타납니다.
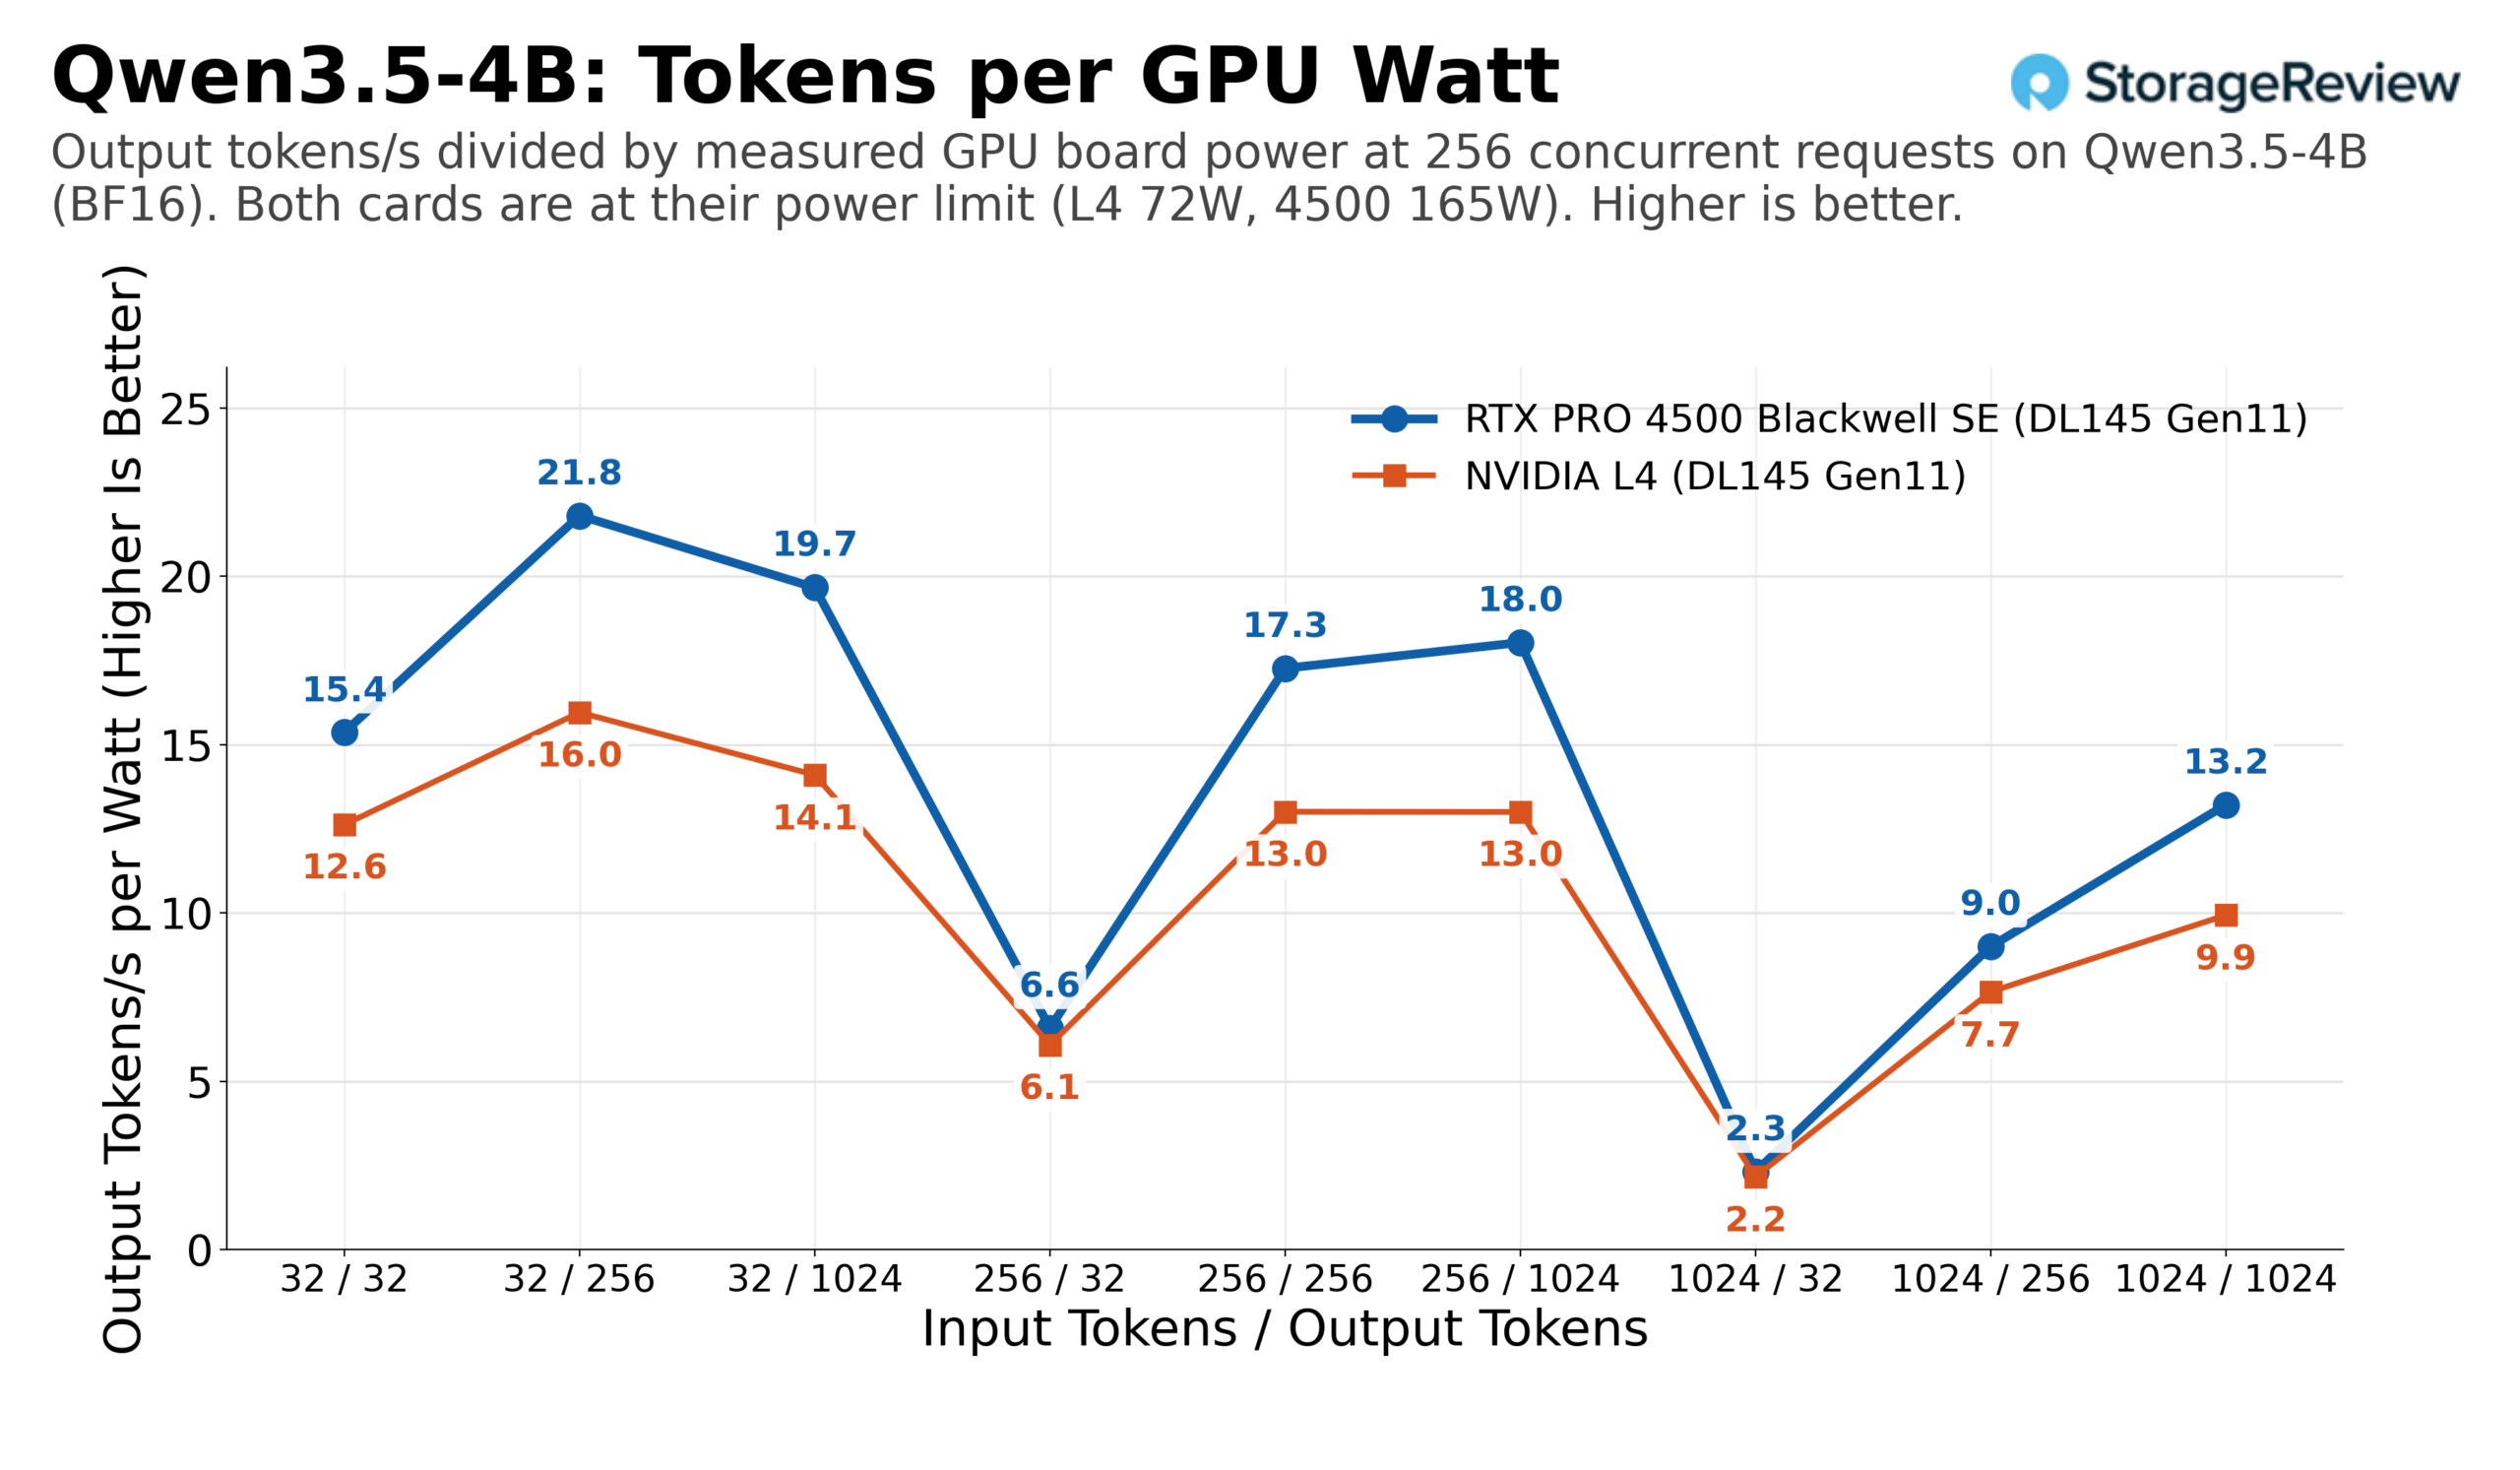
두 카드 모두 대부분의 동시 실행 16개 이상에서 보드 전력 한계치(L4는 72W, 4500은 165W)에 근접하거나 그 수준에서 작동했습니다. 출력량이 적은 프로세스에서는 전력 소모가 더 낮았는데, 예를 들어 4500은 동시 실행 32개에서 Qwen3.5-4B 32/32를 실행할 때 125W를 기록했습니다. 따라서 GPU 와트당 토큰 처리량은 처리량과 밀접한 관련이 있습니다. 동시 실행 256개에서 4500은 9가지 프로세스 전체에서 L4보다 와트당 평균 1.33배 높은 토큰 처리량을 보였습니다. 이는 사전 입력 제한이 있는 1,024/32 프로세스에서 1.07배, 256/1,024 프로세스에서 1.39배에 해당합니다. 여기에 2.3배의 전력 소모 차이를 곱하면 처리량이 3배 앞서는 것을 알 수 있는데, 1.33배는 Blackwell이 와트당 더 많은 작업을 처리하기 때문이고, 2.3배는 4500이 더 많은 전력을 소비하기 때문입니다.
젬마 4 E4B
Gemma 4 E4B는 Google의 Gemma 4 제품군 중 가장 작은 모델로, E는 4B 파라미터를 의미하며, Qwen3.5-4B와 유사하게 작동하지만 그리드 상단에서 약간 더 나은 확장성을 보여줍니다. 동시 접속자 수가 8~32명일 때 중간 처리량 비율은 2.67배(범위 2.31배~3.07배)이고, 256명일 때는 3.20배입니다. 특히 1,024/1,024 구성에서는 L4 캐시가 KV 한계에 거의 도달하여 처리량 비율이 3.82배까지 올라갑니다.
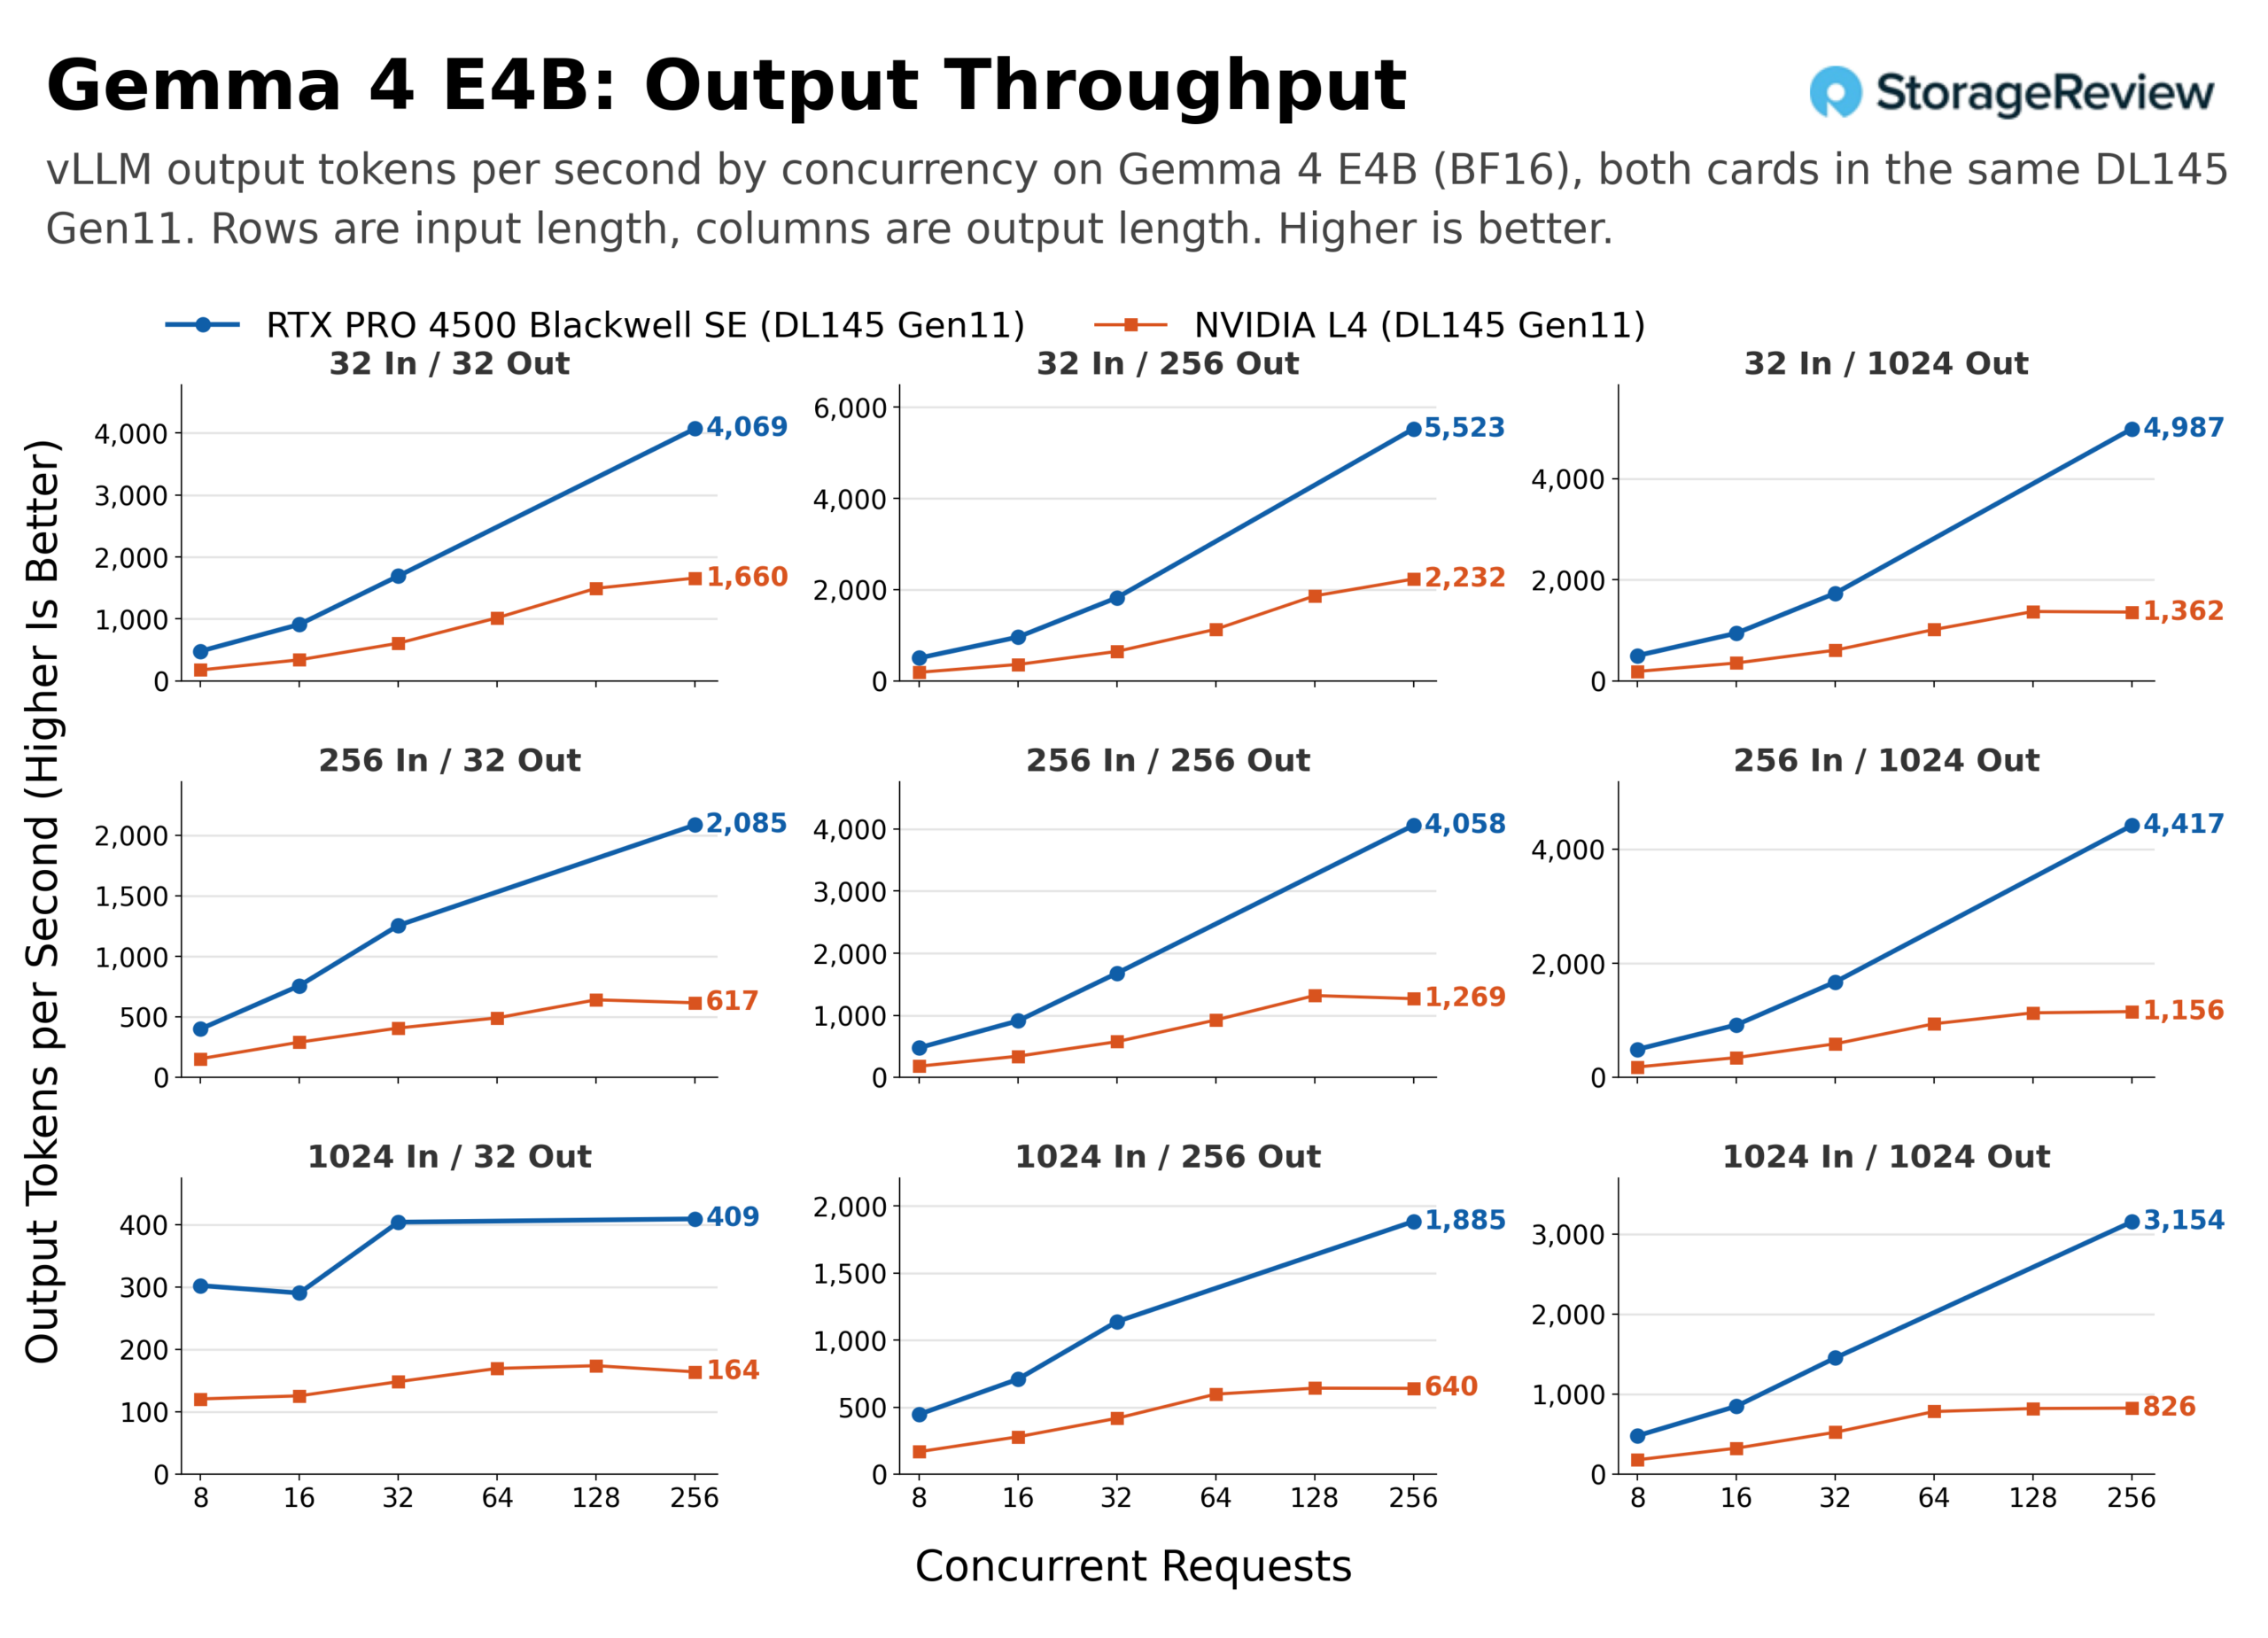
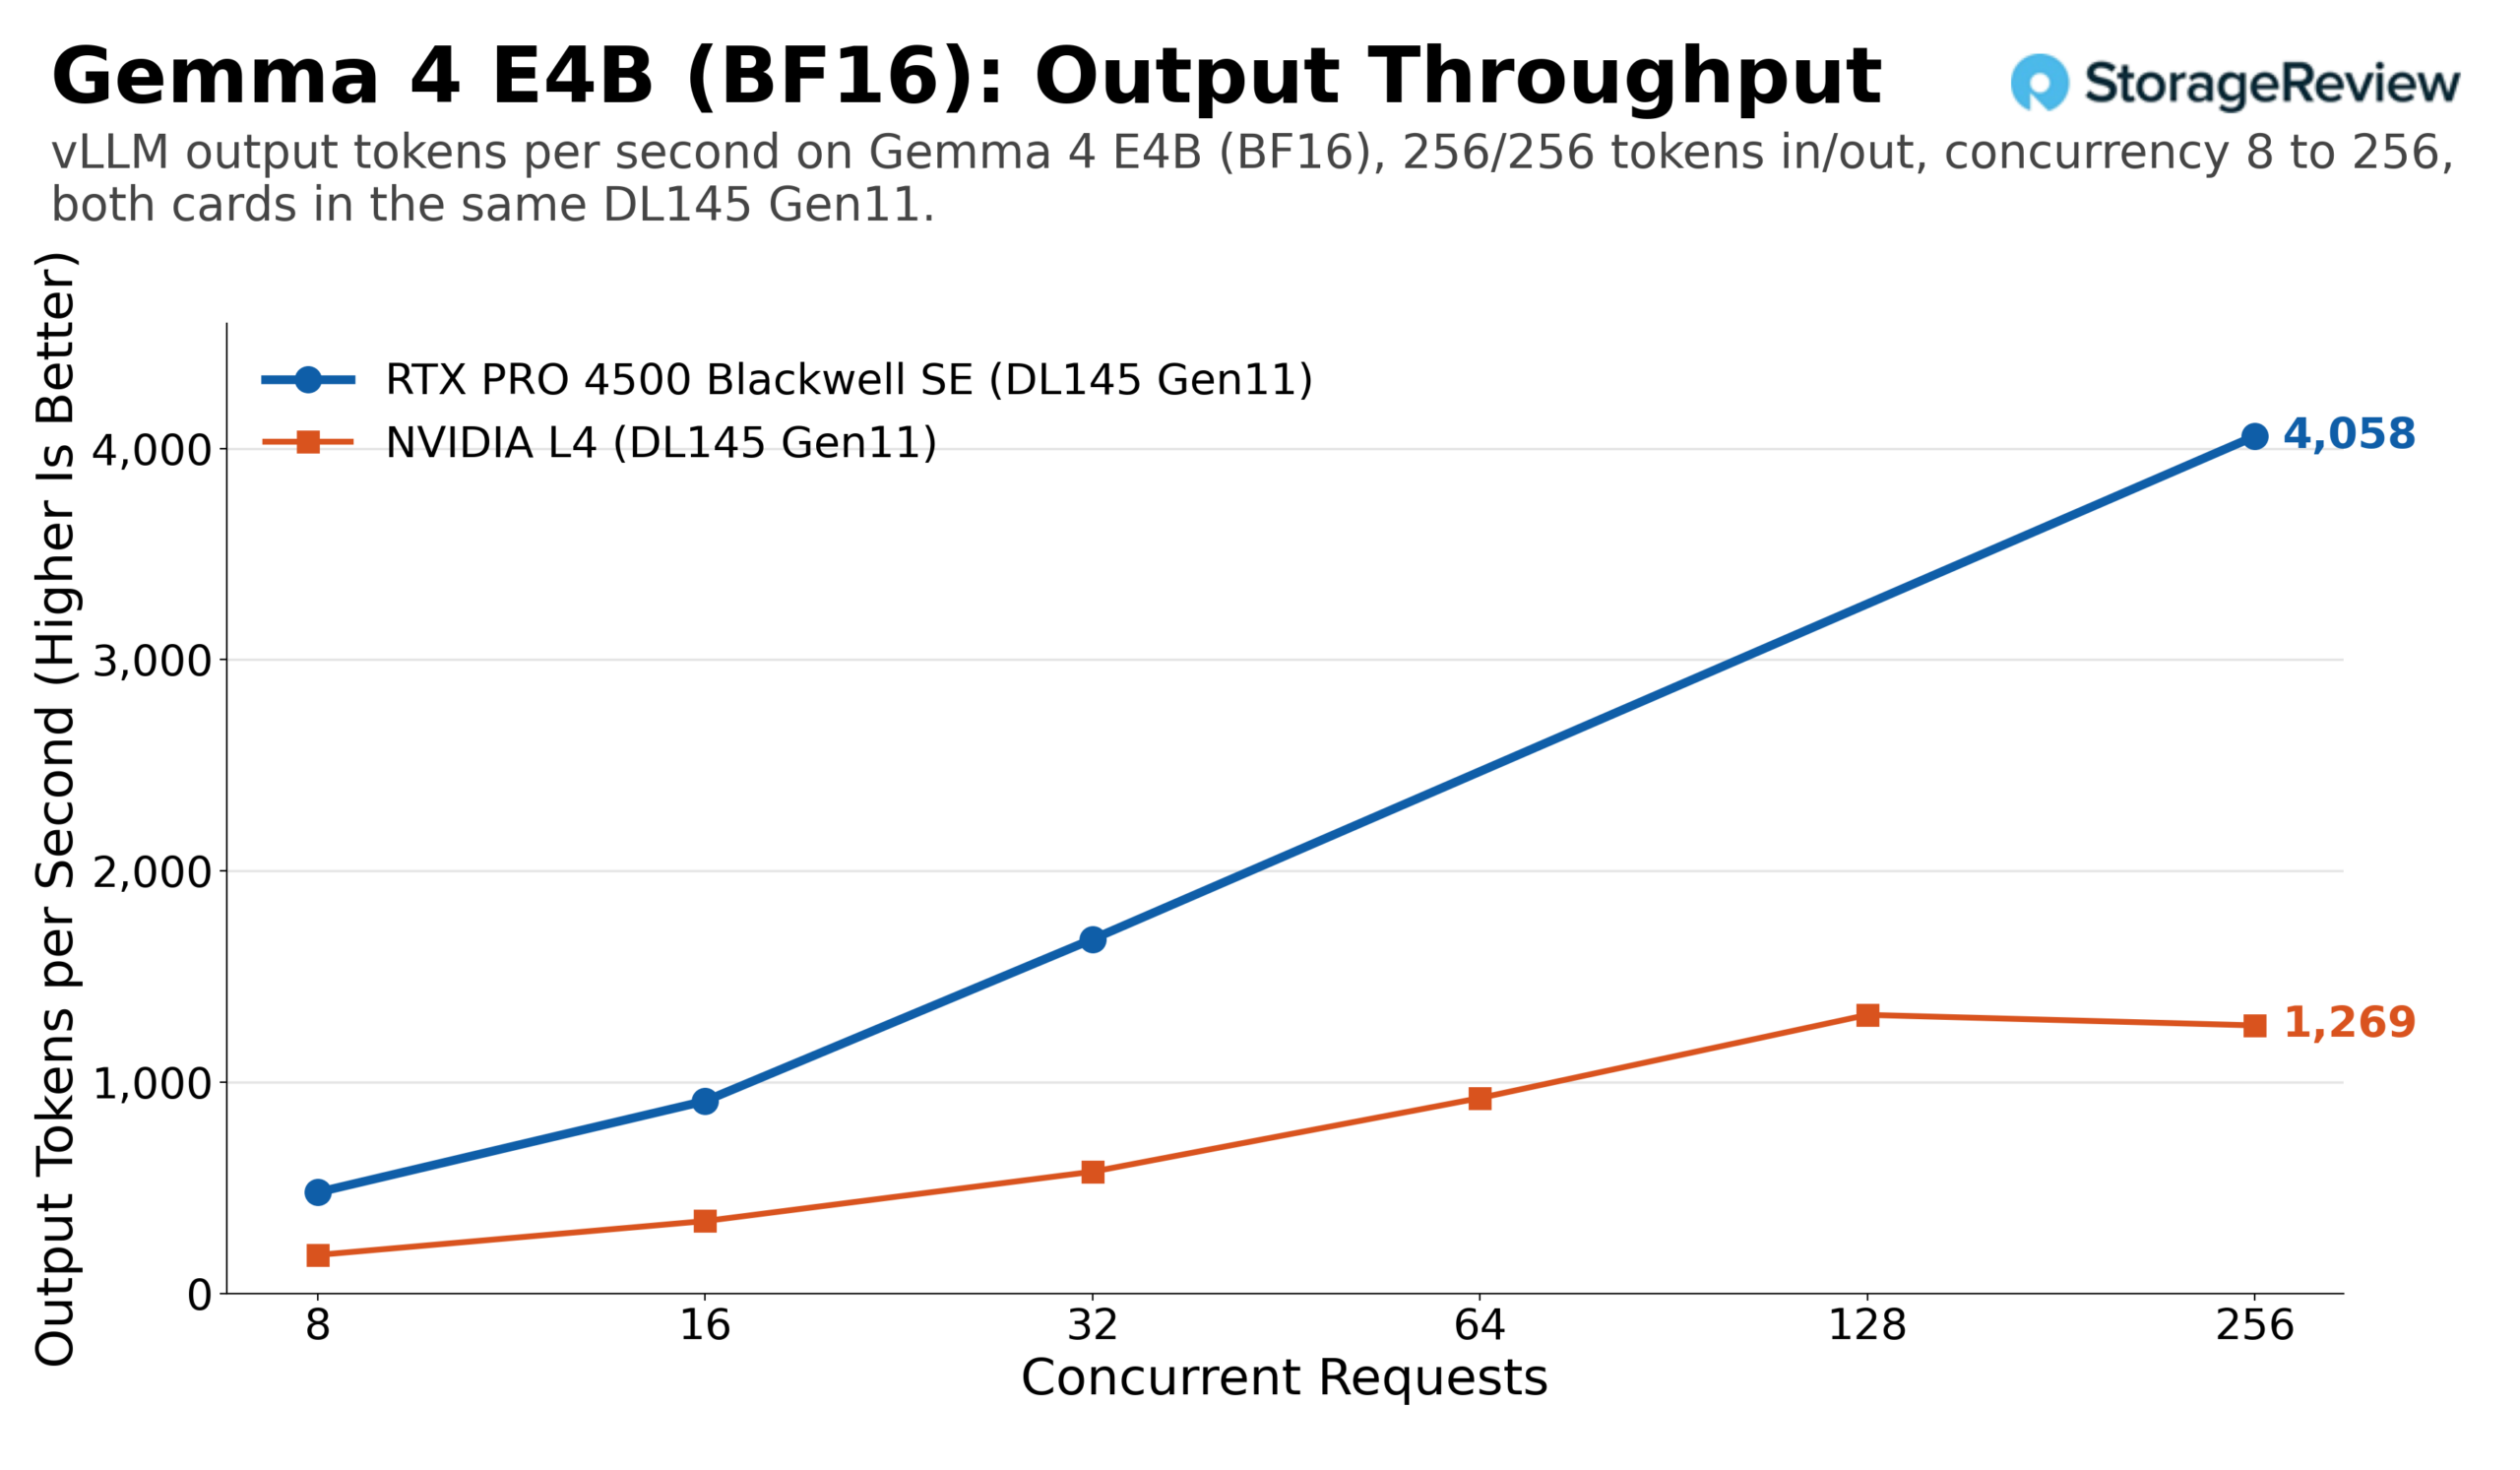
256/256 그래프에서 L4는 동시 접속자 8명일 때 초당 183개의 출력 토큰을, 32명일 때 577개를, 256명일 때 1,269개를 생성했습니다. 4500은 각각 479개, 1,678개, 4,058개를 생성했습니다. 1,024/1,024 그래프에서는 L4가 180개, 524개, 826개를, 4500은 480개, 1,454개, 3,154개를 생성했습니다. 긴 그래프에서 4500의 256 동시 접속자 수치는 L4의 3.8배이며, 그 이유는 L4의 그래프에서 확인할 수 있습니다. L4는 동시 접속자 수를 32명에서 256명으로 늘릴 때 초당 302개의 토큰만 추가했는데, 이는 세션을 추가할 메모리가 부족했기 때문입니다.
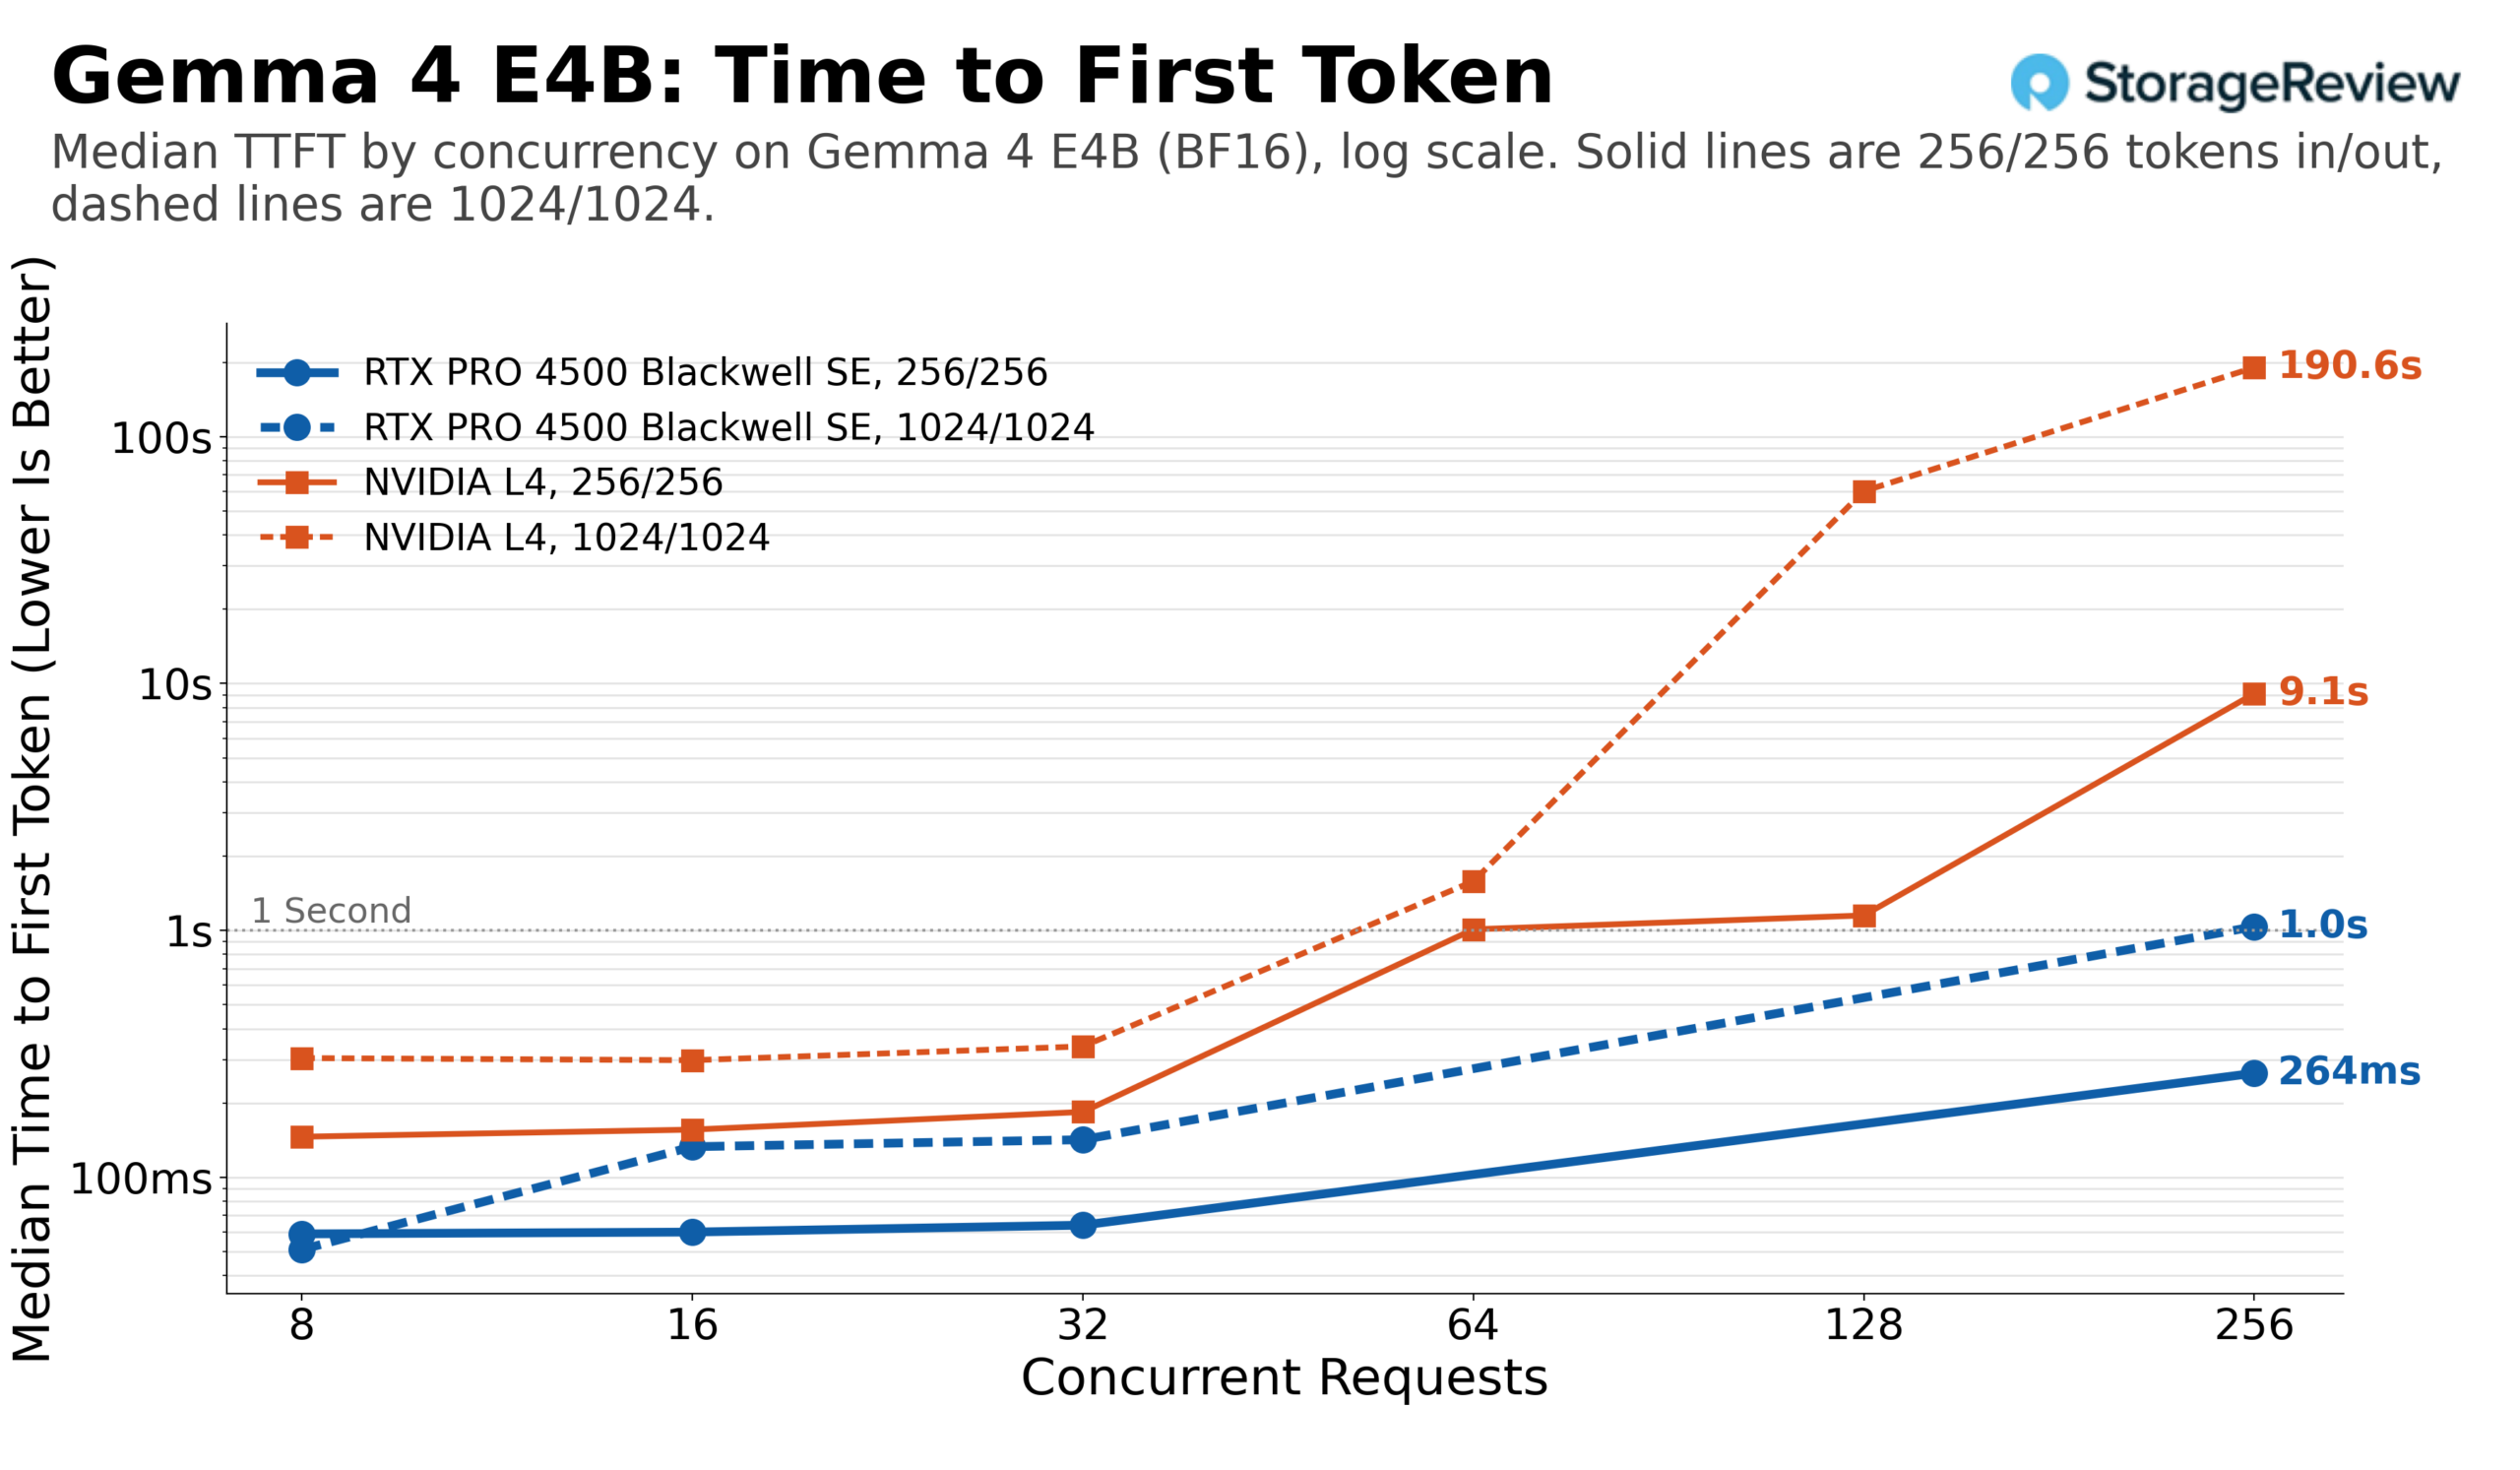
L4의 Gemma 4 작업에는 64개와 128개의 동시 접속자가 포함되었기 때문에, 이 모델은 L4가 한계에 도달하는 지점을 정확히 보여줍니다. 256/256 형태에서 첫 번째 토큰까지의 중간 시간은 동시 접속자 32명일 때 184ms, 64명일 때 1초 남짓, 256명일 때 9.1초였습니다. 1,024/1,024 형태에서는 동시 접속자 32명일 때 339ms, 64명일 때 1초 남짓, 128명일 때 60초, 256명일 때 191초였습니다. 4500은 짧은 형태에서는 동시 접속자 32명일 때 64ms, 256명일 때 264ms를 유지했고, 긴 형태에서는 동시 접속자 32명일 때 142ms, 256명일 때만 1초를 넘는 1,036ms를 기록했습니다. 따라서 채팅 길이 프롬프트에서 Gemma 4 E4B의 경우, 이 서버의 L4는 32~64세션 카드이고, 4500은 256세션 카드로 지연 시간 여유가 있습니다.
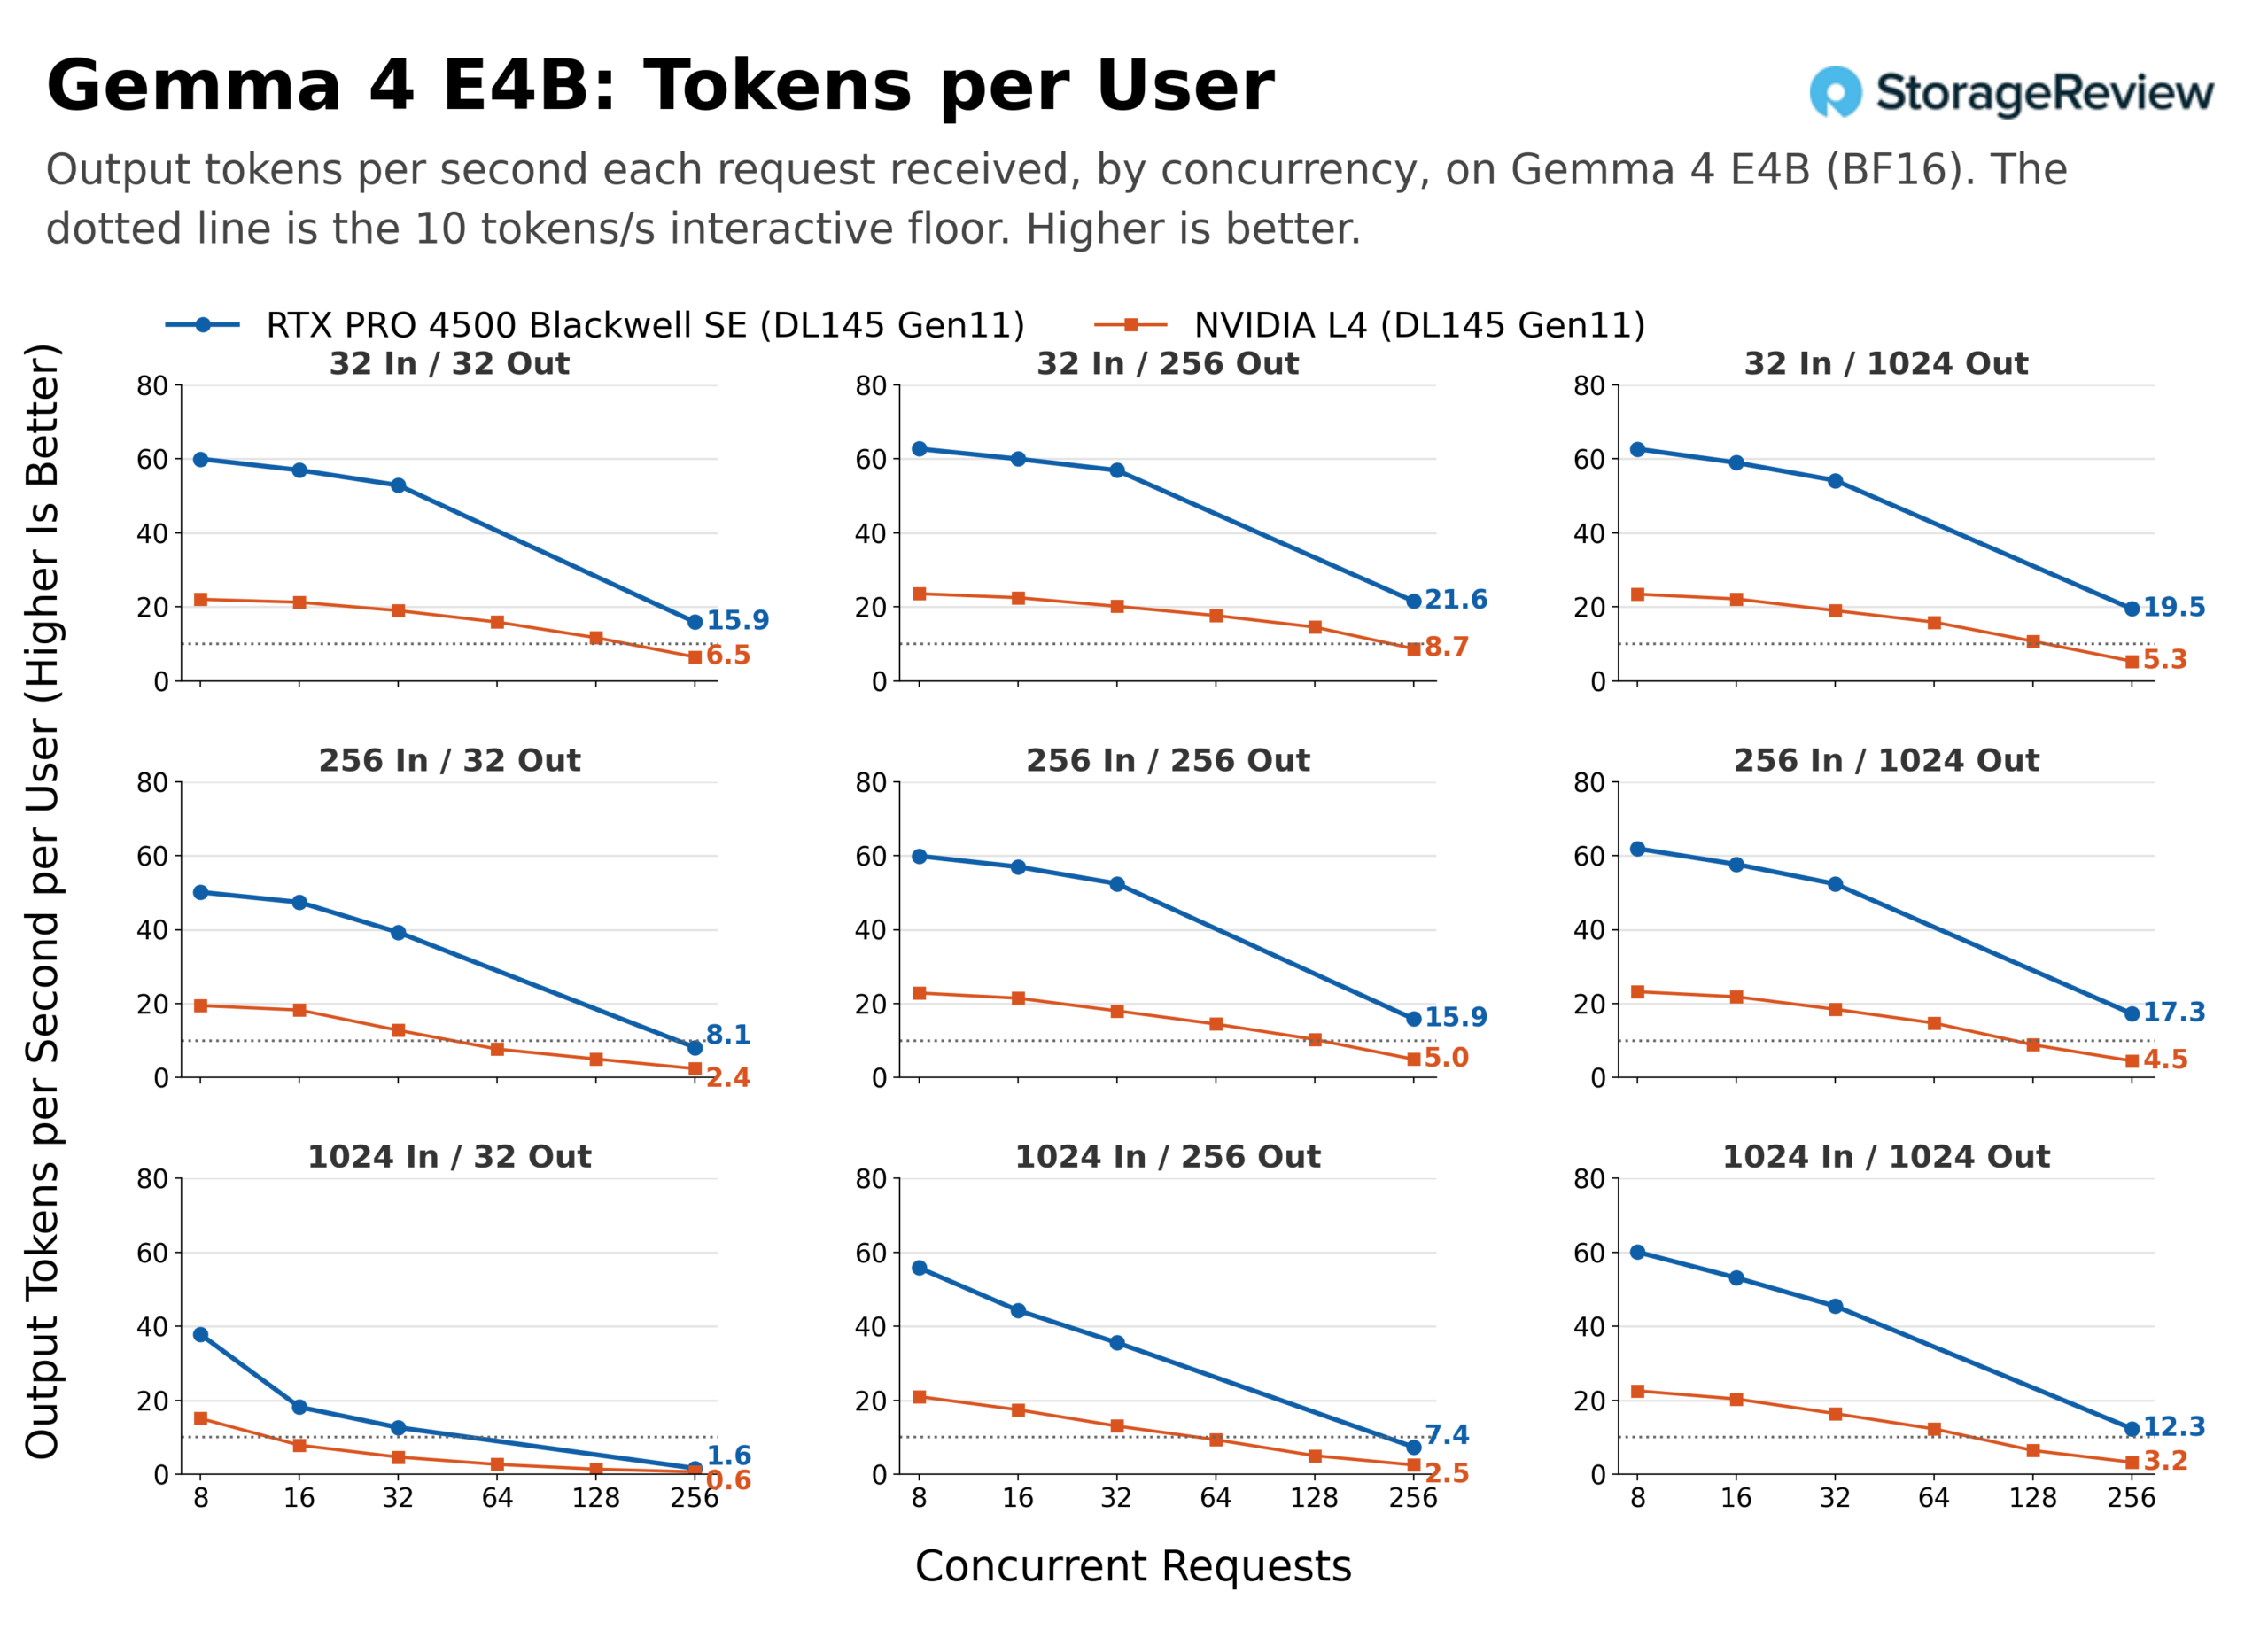
L4의 64개 및 128개 입력 지점을 채운 사용자별 보기에서는 한계점을 넘어서는 지점을 확인할 수 있습니다. 256/256 그래프에서 L4는 동시 접속자 32명일 때 사용자당 초당 18.0 토큰, 64명일 때 14.5 토큰, 128명일 때 10.3 토큰, 256명일 때 5.0 토큰을 처리하므로, 해당 그래프에서는 128명과 256명 사이에서 초당 10 토큰이라는 한계점을 넘어섭니다. 256/1,024 그래프에서는 128명일 때 초당 8.9 토큰을 처리하고, 단답형 및 1,024개 입력 그래프에서는 64명일 때 한계점 아래에 위치합니다(256/32 그래프에서는 초당 7.7 토큰, 1,024/256 그래프에서는 초당 9.3 토큰). 4500은 동시 접속자 32명 기준 채팅 형식에서 사용자당 52~57개의 입력값을 보이며, 9개 형식 중 6개 형식(256/32를 제외한 32개 및 256개 입력 형식에서 15.9~21.6, 1,024/1,024 형식에서 12.3)에서 최저치인 256을 상회합니다. 단답형 및 장문형 프롬프트 형식 3개에서만 최저치 아래로 떨어집니다(256/32 형식에서 8.1, 1,024/256 형식에서 7.4, 1,024/32 형식에서 1.6).
Gemma 4 E4B는 GPU 와트당 4500에 256 동시 접속 시 L4 캐시 대비 평균 1.39배의 성능을 제공하며, 256/1,024 동시 접속 시에는 1.68배, L4 캐시 용량이 부족한 다른 장시간 응답 패턴에서는 1.6배 이상의 차이를 보입니다. 반면, 32/32 동시 접속 시에는 워크로드가 너무 짧아 두 카드 모두 성능을 최대한 발휘하지 못하므로 차이가 1.07배로 가장 작습니다. 256/256 동시 접속 시에는 와트당 출력 토큰 처리량이 4500이 24.6개, L4가 17.7개로 향상되었습니다.
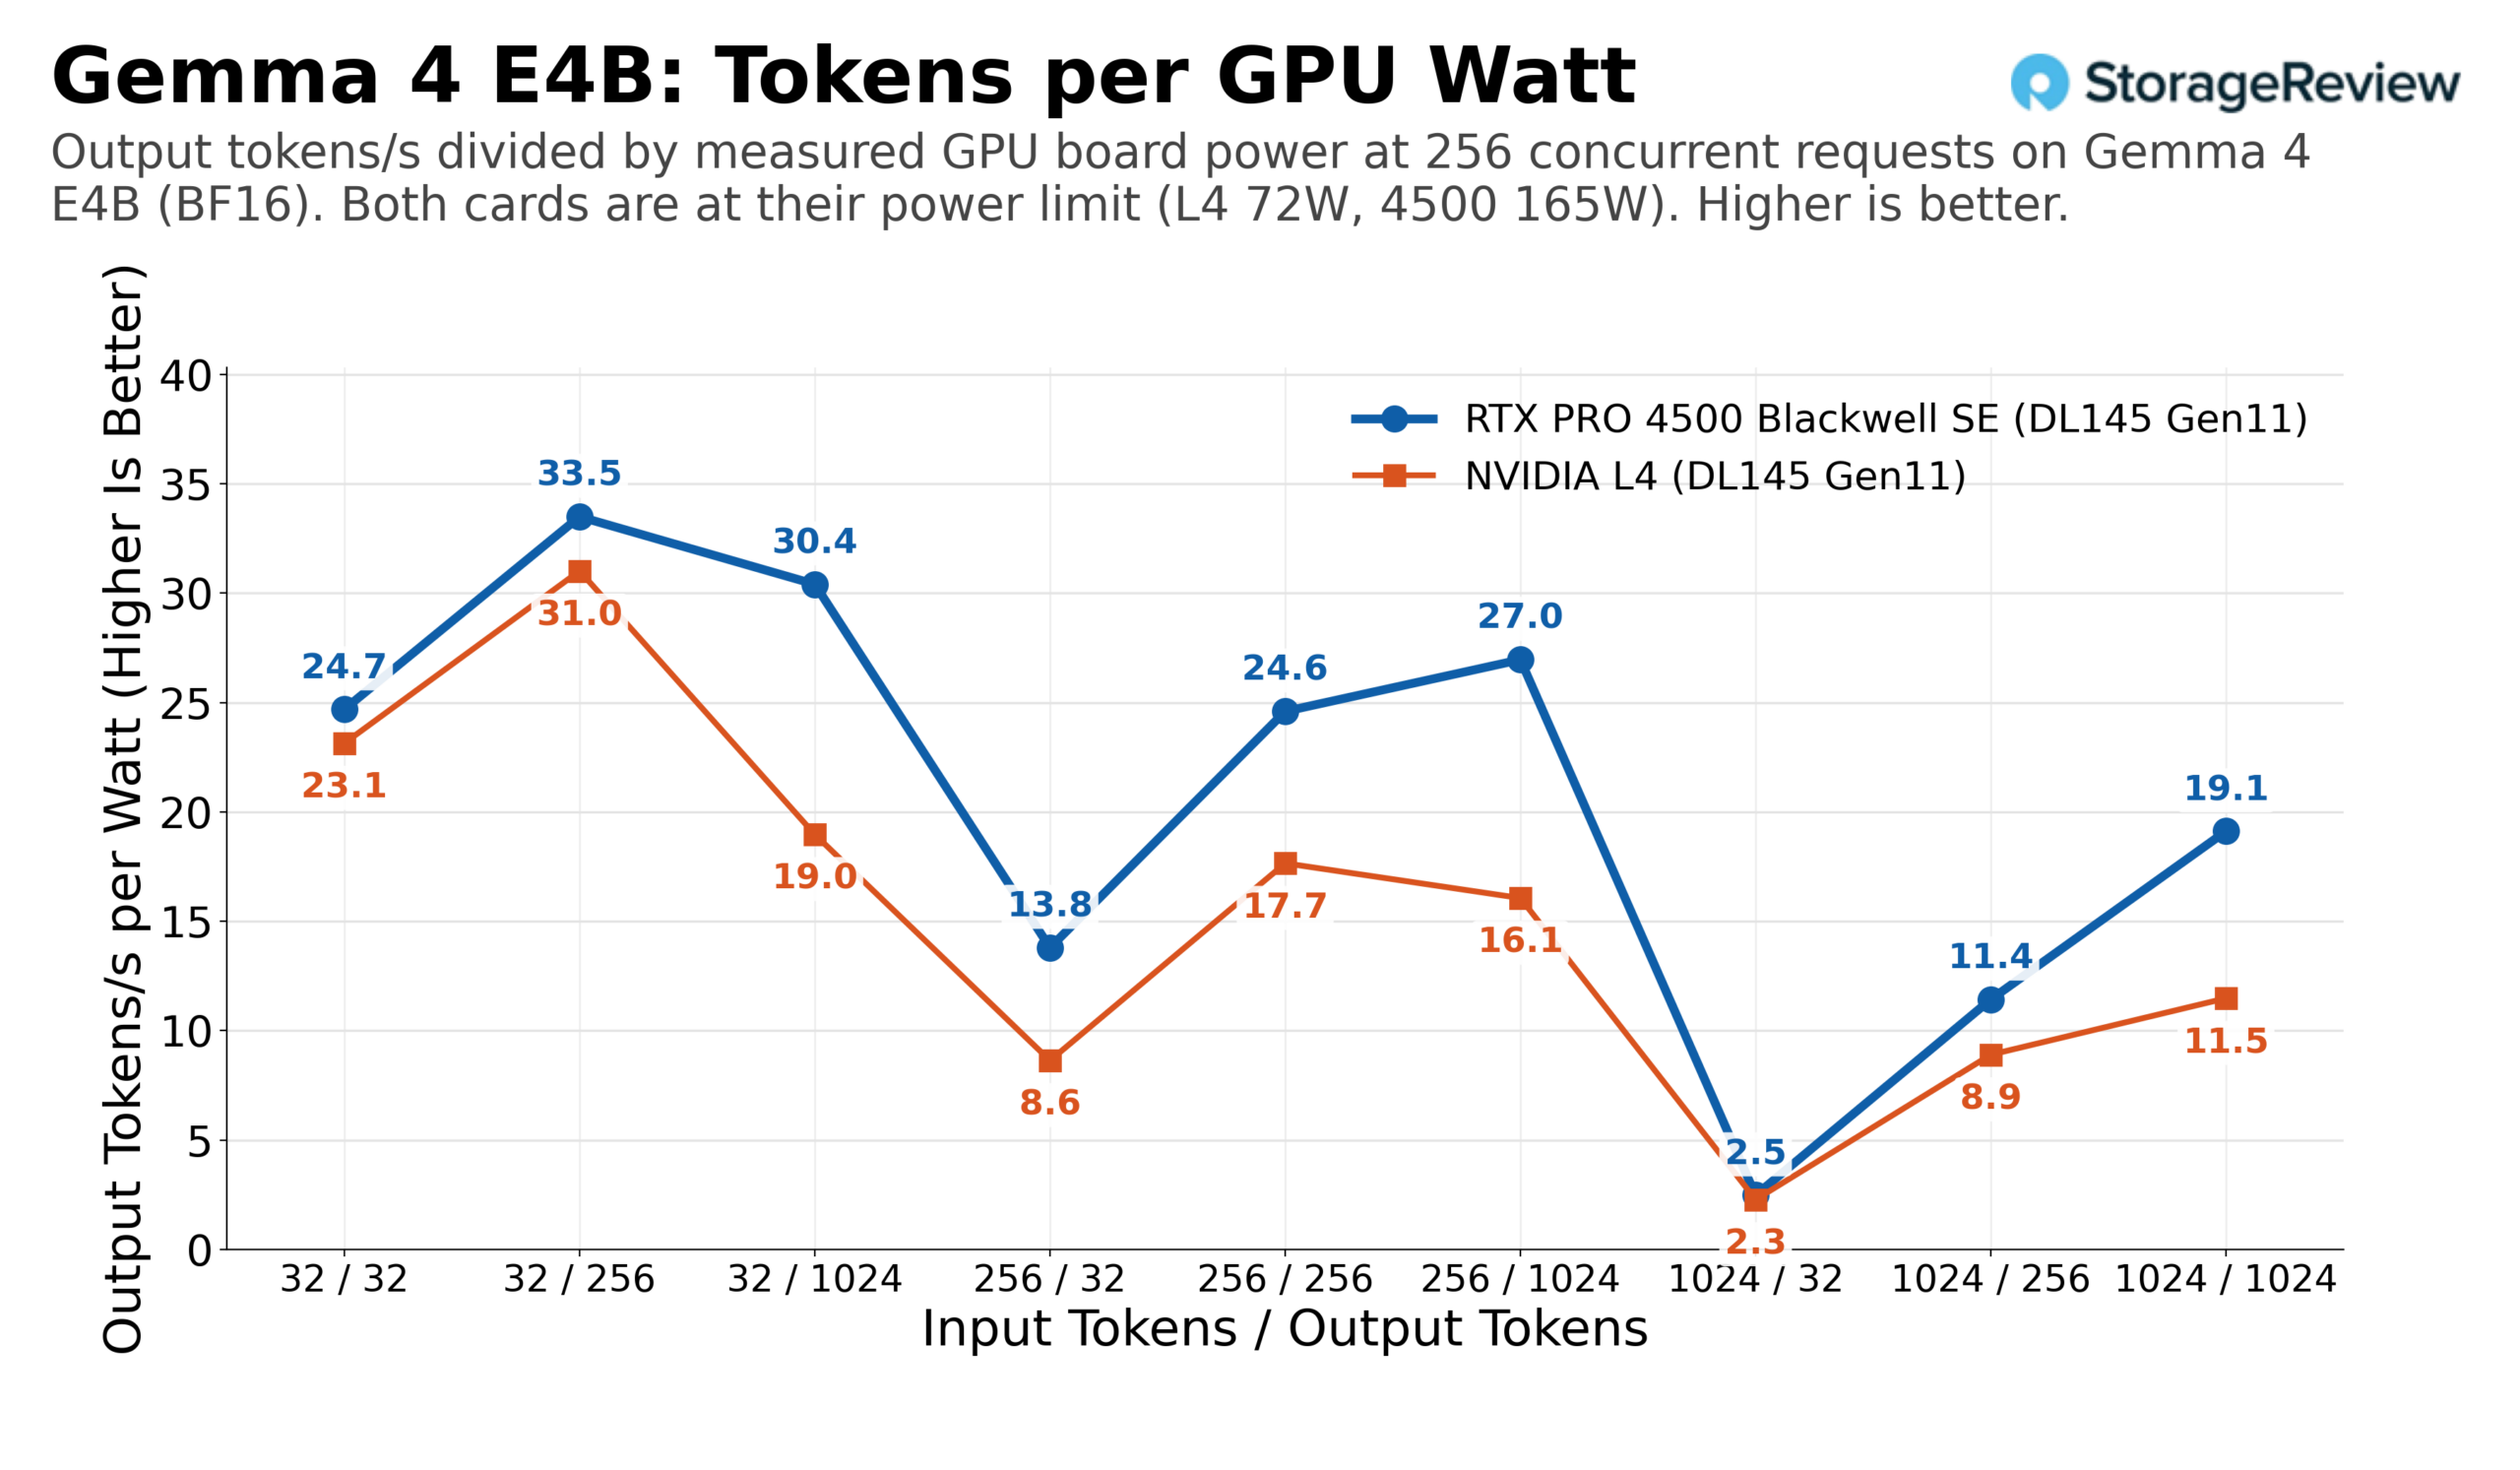
단일 사용자에 대한 토큰당 지연 시간은 Qwen과 일치합니다. 256/256의 경우 4500에서 토큰당 14.1ms, L4에서 39.1ms이고, 1,024/1,024의 경우 14.6ms, 39.8ms입니다. 따라서 1,024개 토큰에 대한 응답은 4500에서 약 15초, L4에서 약 41초가 걸립니다.
벽에서의 전력
엣지 사이트는 전력 여유가 부족한 경우가 많으므로, 모든 실행 시 DL145의 iLO를 통해 서버 전체의 전력 소모량을 추적했습니다. GPU가 43~65W를 소모하는 단일 사용자 실행과 같은 저부하 환경에서 서버는 두 그래픽 카드 모두 약 160W를 소모했습니다. 256/256 구성에서 32명의 동시 접속자를 처리했을 때, L4 카드 장착 시 평균 196W, RTX PRO 4500 장착 시 평균 301W를 소모했으며, 이러한 평균값은 두 BF16 모델 모두에서 동일하게 나타났습니다. 기록된 최대 전력 소모량은 L4 카드 장착 시 209W, RTX PRO 4500 장착 시 308W였습니다. 따라서 부하 시 업그레이드 비용은 벽면 콘센트에서 약 105W 정도 증가하는데, 이는 두 카드의 보드 전력 등급 차이인 93W에 약간의 변환 손실과 추가 팬 작동으로 인한 전력 소모를 더한 값과 거의 같습니다.
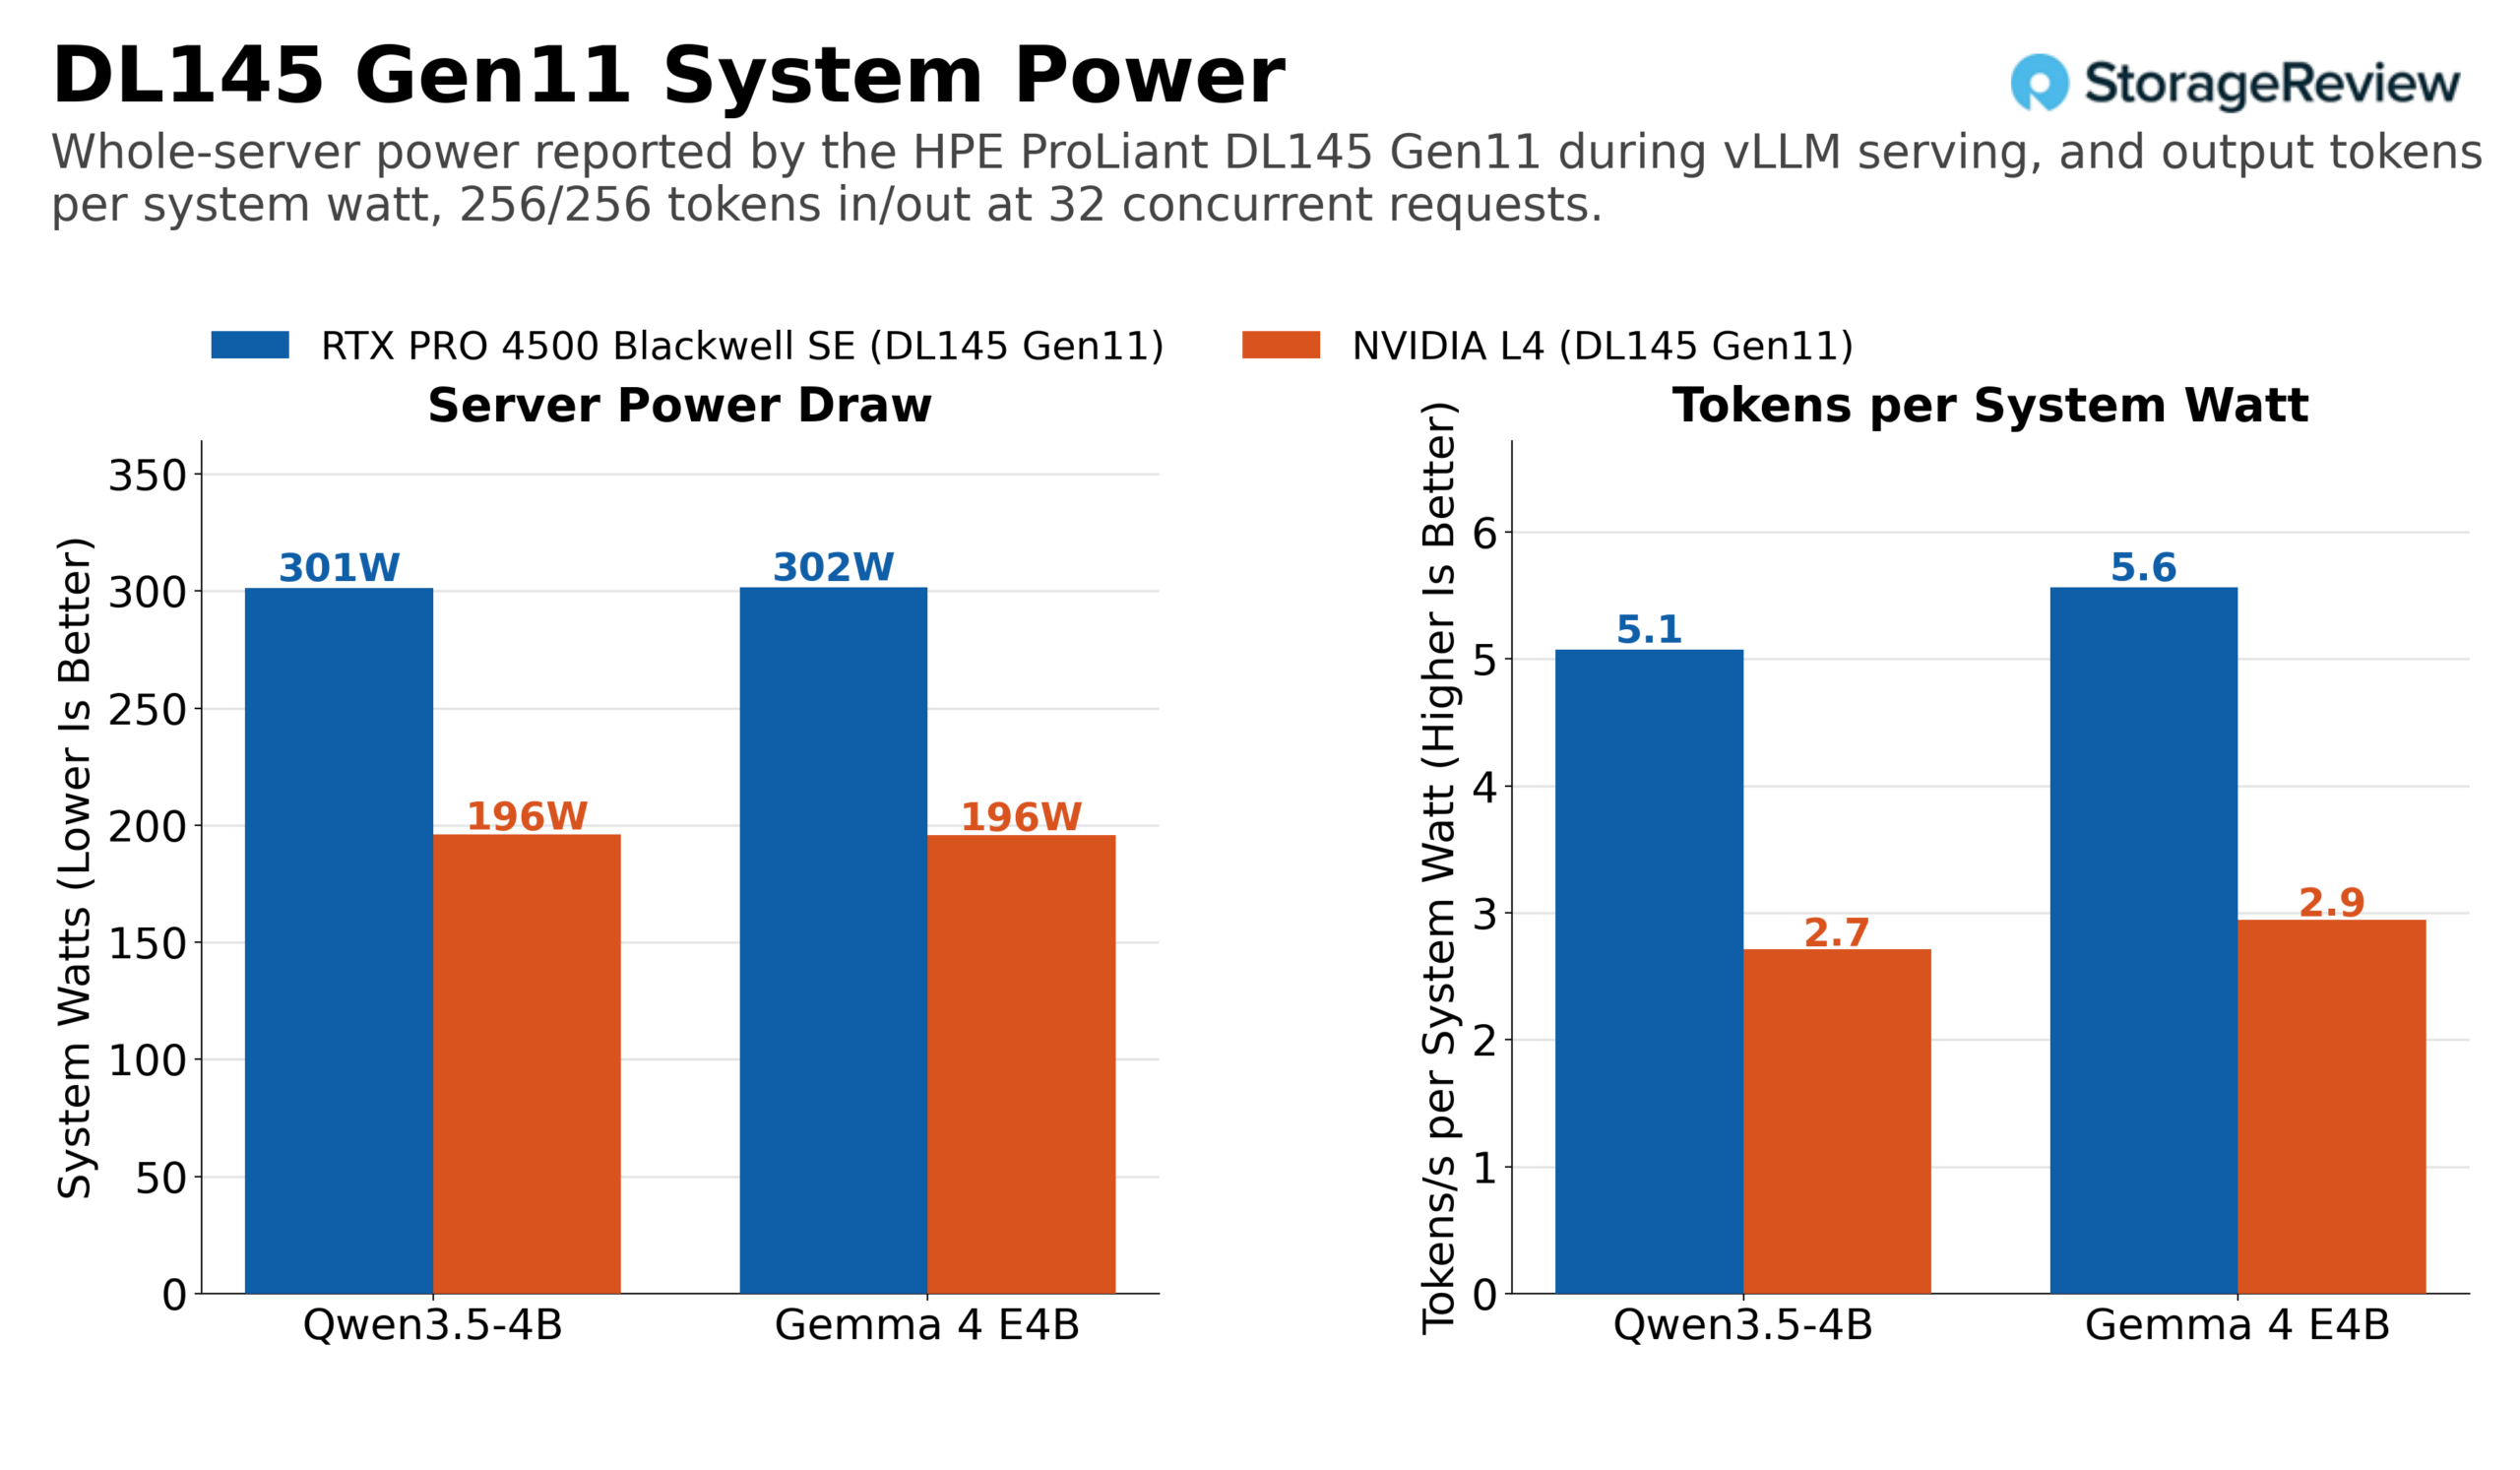
256/256 환경에서 32명의 동시 접속자를 기준으로 DL145 서버는 Qwen3.5-4B(L4 GPU 사용 시)에서 시스템 와트당 초당 2.7개의 출력 토큰을, 4500 GPU 사용 시 5.1개의 출력 토큰을 생성했습니다. Gemma 4 E4B 환경에서는 각각 2.9개와 5.6개의 출력 토큰을 생성했습니다. 시스템 수준의 효율성 향상이 카드 수준의 향상보다 더 큰 이유는 DL145의 전력 소모 대부분이 고정 비용이기 때문입니다. CPU, 메모리, 팬, 스토리지의 전력 소모는 GPU가 초당 532개의 토큰을 생성하든 1,529개의 토큰을 생성하든 거의 동일합니다. 서버 비용을 지불하는 사이트는 전력 교환을 통해 벽면 콘센트에서 와트당 1.9배 더 많은 토큰을 얻을 수 있으며, 이는 카드 수준에서의 1.3배보다 높은 수치입니다. 사이트별 전력 예산으로 운영되는 서버 규모에서는 이 수치를 기준으로 계획을 세워야 합니다.
32GB와 NVFP4의 장점은 무엇일까요?
위의 모든 작업은 L4에서도 수행할 수 있지만 속도가 느립니다. 4500의 또 다른 장점은 L4에서 기본적으로 처리할 수 없는 모델 클래스가 있다는 것입니다. 바로 NVFP4 형식의 Gemma 4 26B-A4B 모델입니다. 이 모델은 토큰당 약 4억 개의 파라미터가 활성화되는 26비트 혼합 전문가 모델로, FP8 KV 캐시를 사용합니다. BF16 기준으로 이 모델의 가중치만 해도 24GB를 초과합니다. NVFP4 형식에서는 4500의 32GB 메모리에 KV 캐시를 위한 여유 공간까지 확보할 수 있으며, Blackwell FP4 Tensor Core는 이 형식을 기본적으로 지원합니다. vLLM은 가중치 전용 커널을 통해 L4의 Ada 아키텍처에 NVFP4 가중치를 로드할 수 있으며, 약 14GB 크기의 4비트 가중치는 24GB 메모리에 들어갑니다. 하지만 L4에는 FP4 연산 기능이 없기 때문에 해당 환경에서 실행하지는 않았습니다. 비교를 위해, 동일한 작업을 Dell Pro Max Tower T2에 장착된 RTX PRO 6000 Blackwell Workstation Edition(96GB, 600W)에서 실행했습니다. 이는 호스트 환경과 그래픽 카드 등급이 다르기 때문에, 4500 시리즈의 성능 수치를 비교 기준으로 삼기 위해 포함시켰습니다.
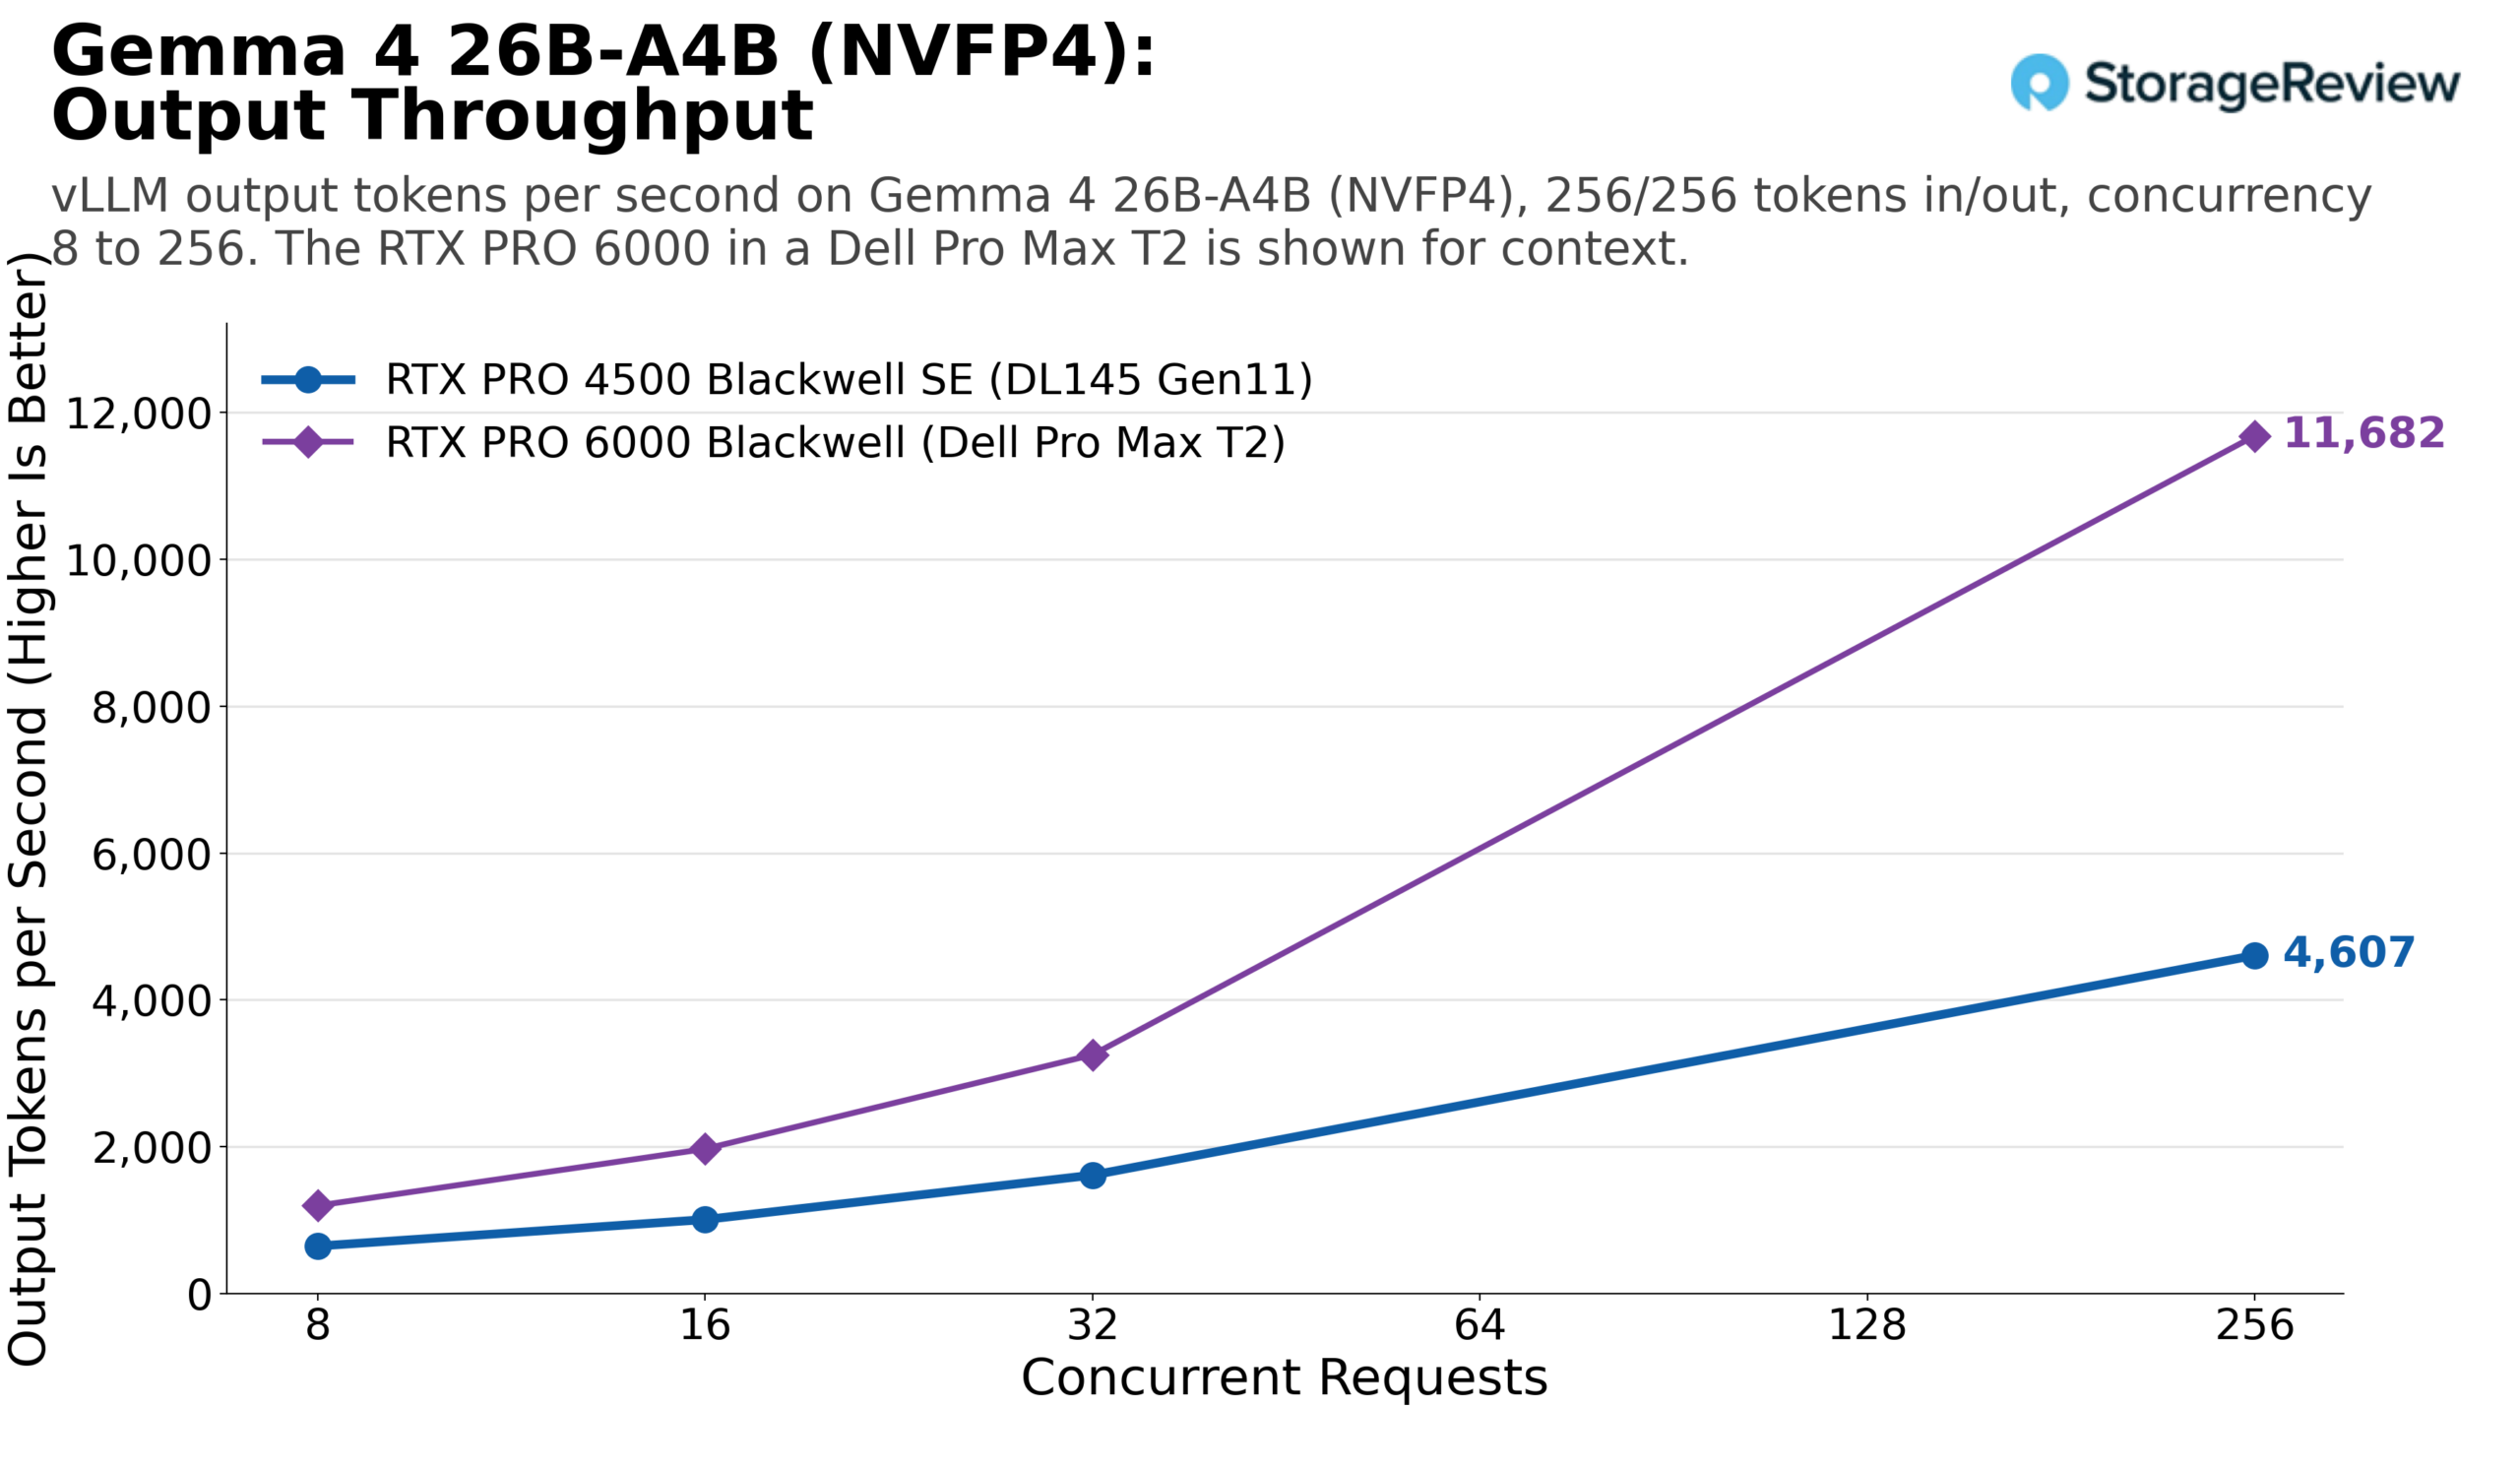
256/256 테스트에서 RTX 4500은 동시 접속자 8명일 때 초당 647개의 출력 토큰을, 32명일 때 1,613개를, 256명일 때 4,607개를 생성했습니다. RTX PRO 6000은 각각 1,198개, 3,252개, 11,682개를 생성했습니다. 동시 접속자 수가 8명에서 32명으로 증가함에 따라, RTX 4500은 1,024/32의 경우처럼 메모리 용량이 최대치에 도달하는 경우를 제외하고 모든 테스트에서 RTX 6000 대비 48%~55%의 성능을 보였습니다. 1,024/32의 경우 동시 접속자 32명일 때 RTX 4500의 성능은 29%까지 떨어졌습니다. RTX 4500의 소비 전력은 165W인 반면, RTX 6000은 측정된 모든 테스트에서 266W~471W였습니다. 동시 접속자 256명일 때는 32GB 메모리가 모두 차면서 성능은 23%~42%로 떨어집니다.
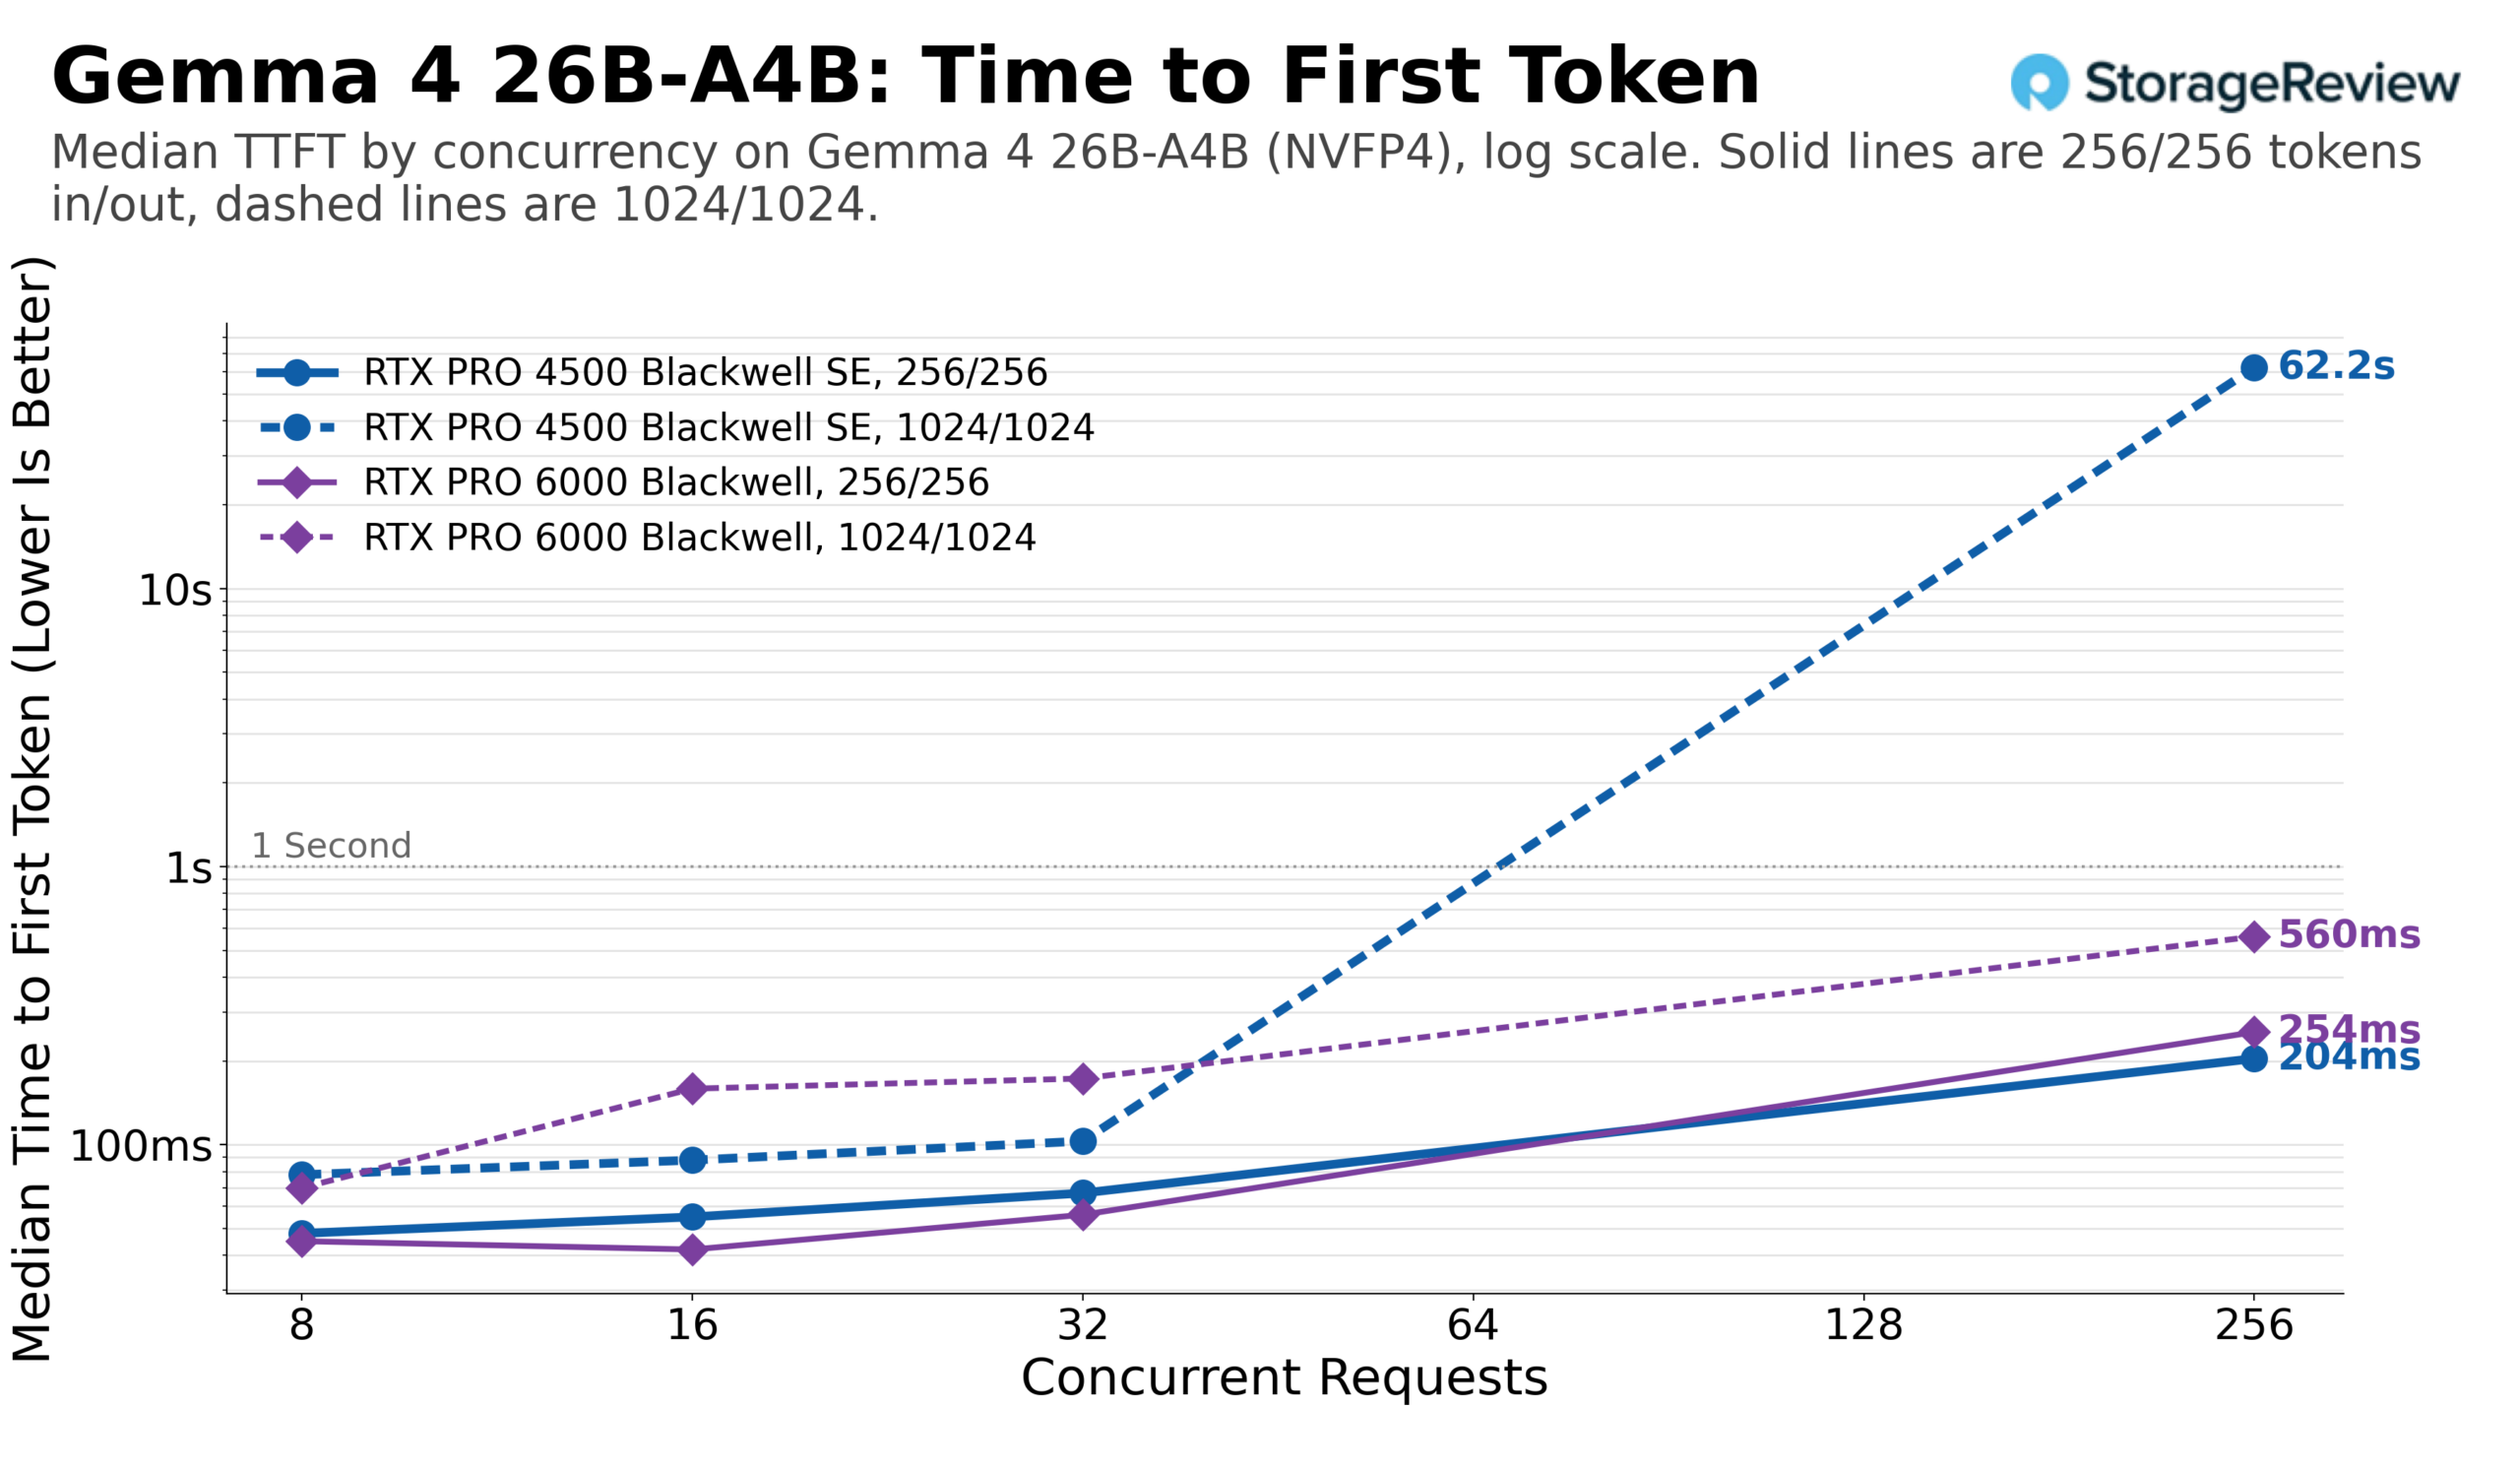
첫 번째 토큰 지연 시간은 BF16 모델과 동일한 결과를 보여줍니다. 동시 접속 32개에서 4500의 중앙값은 256/256 컨텍스트에서 67ms, 1,024/1,024 컨텍스트에서 103ms로, 6000과 몇십 밀리초 차이밖에 나지 않았습니다. 또한, 짧은 컨텍스트에서 동시 접속 256개일 때는 204ms를 유지했습니다. 동시 접속 256개에서 1,024/1,024 컨텍스트를 사용했을 때 4500은 62초의 대기 시간을 보인 반면, 메모리 용량이 세 배인 6000은 560ms를 유지했습니다. 26B MoE의 경우, 4500은 긴 컨텍스트에서는 32세션, 채팅 길이에서는 256세션을 지원하는 카드이며, L4 서버에는 없는 FP4 하드웨어에서 해당 모델을 실행합니다.
DL145는 4500에서 26B 모델에 전원을 공급할 때 최대 306W의 전력을 소모했고, 4B 모델에서는 최대 308W를 소모했습니다. 이는 카드의 기본 전력 소모량이 165W이기 때문입니다. 벽면 콘센트에서 300W를 소비하는 엣지 박스에 장착된 26B급 모델이 여기서 성능 향상을 가져오며, 이는 소형 모델과 비교했을 때 전력 소모량이 더 많지 않습니다.
맺음말
NVIDIA는 RTX PRO 4500 Blackwell Server Edition의 성능이 L4보다 5배 이상 우수하다고 평가하는데, 이 수치는 FP4 및 NIM 연산을 기반으로 합니다. 동일한 DL145 Gen11 환경에서 BF16을 동일하게 비교한 결과, 4500은 두 개의 소규모 모델에서 L4보다 평균 2.7배 높은 출력 처리량을 보였으며, 최대 부하 시에는 3.0배에서 3.2배 높은 성능을 나타냈습니다. 또한, 단일 사용자 기준 토큰 생성 속도는 2.8배 빨랐고, L4가 수십 초 동안 대기해야 했던 부하에서도 첫 토큰 처리 지연 시간을 1초 미만으로 유지했습니다. L4는 대부분의 프롬프트에서 32~256개의 세션까지 모든 사용자에게 초당 10개 이상의 출력 토큰을 제공하지만, 사전 입력이 많은 1,024/32 프롬프트에서는 8개로 제한되는 반면, 4500은 채팅 길이의 프롬프트에서도 256개의 세션까지 이를 유지했습니다. 4500 기종은 L4 기종이 기본적으로 구동할 수 없는 NVFP4 기종의 Gemma 4 26B-A4B에도 사용되었습니다.
벽면 콘센트에서 소비되는 전력은 105W이며, 서버 전체 부하 시에는 약 196W에서 301W까지 소모됩니다. 그래픽 카드 자체에서 소비되는 전력은 보드 전력의 2.3배입니다. GPU에서 측정했을 때, 4500은 출력 토큰당 L4 스토리지보다 1.3~1.4배 효율적입니다. 시스템의 나머지 전력 소모가 발생하는 벽면 콘센트에서 측정했을 때는 약 1.9배 효율적입니다. 서버당 전력 예산이 제한적인 사이트에서는 4500이 이미 사용하고 있는 전력을 더 효율적으로 활용할 수 있는 선택이 될 것이며, 슬롯 수를 기준으로 규모를 정한 사이트에서는 4500 하나로 32개 세션을 처리하는 3개의 L4 스토리지와 동일한 처리량을 제공하면서 사용자당 데이터 생성 속도는 2.8배 빠르고, 32GB 단일 스토리지 풀을 사용할 수 있습니다.
리뷰 서두에서 언급한 범위 제한 사항은 여전히 유효합니다. 이 리뷰는 세 가지 소형 모델의 엣지 서버에서 하나의 카드와 이전 모델을 비교한 것에 불과하며, RTX PRO 4500 Server Edition이 L40S, RTX PRO 6000 Server Edition 및 기타 현재 추론 라인업 내에서 어떤 위치를 차지하는지는 더 광범위한 분석에서 다룰 별도의 문제입니다. L4 서버를 사용하는 DL145 사용자가 궁금해할 만한 질문에 대한 답은, 섀시에 전체 길이 라이저와 16핀 전원 공급 장치가 있다면 4500은 해당 플랫폼이 수용하도록 설계된 업그레이드이며, HPE가 엣지 Nemotron 환경에서 이 카드와 해당 서버를 조합한 것은 하드웨어의 성능에 매우 적합하다는 것입니다.
DL145 Gen11 자체는 우리 제품의 가장자리 부분에 나타납니다. 최고의 서버 이 결과는 이제 리더보드에서 엣지 추론의 핵심 지표로 자리 잡았습니다.
리더 보드 : RTX PRO 4500 Blackwell Server Edition은 저희 평가에서 최고의 싱글 슬롯 GPU로 선정되었습니다. 최고의 기업용 GPU leaderboard, and the L4 holds Best Slot-Powered Card for 1U and Edge.


 아마존