

AMD heeft de resultaten van MLPerf Inference v6.0 gepubliceerd, waarmee de Instinct MI355X GPU zich positioneert als een schaalbaar inferentieplatform voor single-node, multi-node en heterogene implementaties. De inzending gaat verder dan incrementele verbeteringen door nieuwe workloads toe te voegen, een cluster-schaal doorvoer van meer dan 1 miljoen tokens per seconde aan te tonen en de reproduceerbaarheid binnen een groeiend partner-ecosysteem te valideren.
De CDNA 4-architectuur is gericht op inferentie met hoge capaciteit.
De Instinct MI355X GPU is gebaseerd op AMD's CDNA 4- architectuur, gebouwd op een TSMC 3nm | 6nm FinFET-proces (het maakt gebruik van een dual-process chiplet-ontwerp: de compute dies (XCD's) gebruiken TSMC's 3nm-node, terwijl de I/O-dies 6nm gebruiken), met 185 miljard transistors en ondersteuning voor FP4- en FP6-dataformaten. Het is belangrijk om te vermelden dat dit geldt voor het gehele multi-chiplet-pakket, niet voor een monolithische chip. Elke GPU bevat tot 288 GB HBM3E-geheugen, waardoor modellen met maximaal 520 miljard parameters op één apparaat kunnen worden ondersteund. AMD positioneert deze combinatie van rekendichtheid en geheugencapaciteit als cruciaal voor inferentie met grote modellen zonder overmatige modelpartitionering.
Het platform is beschikbaar in UBB8-configuraties met zowel luchtgekoelde als direct vloeistofgekoelde opties, afgestemd op de implementatievereisten van datacenters.
Multinode-doorvoer overtreft 1 miljoen tokens per seconde
Een belangrijk resultaat van deze ronde is dat AMD de grens van 1 miljoen tokens per seconde op clusterniveau heeft overschreden. Met behulp van Instinct MI355X GPU's behaalde AMD deze drempel op Llama 2 70B in zowel server- als offline-scenario's, en op GPT-OSS-120B in offline-modus.
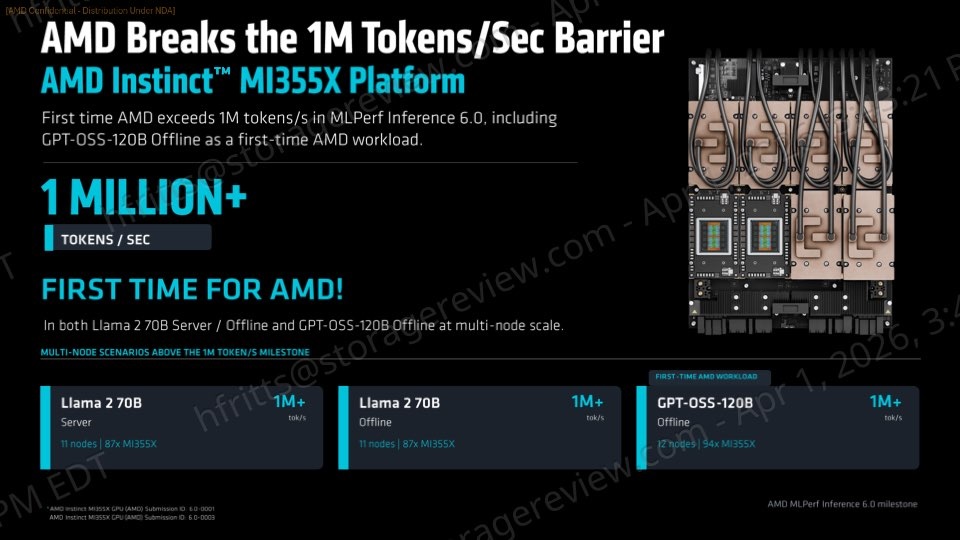
Deze resultaten weerspiegelen een verschuiving naar het evalueren van inferentieprestaties op clusterniveau in plaats van per accelerator. De totale doorvoer en de tijd die nodig is om een applicatie te leveren, worden steeds vaker gebruikt om de gereedheid voor grootschalige AI-implementaties in productie te bepalen.
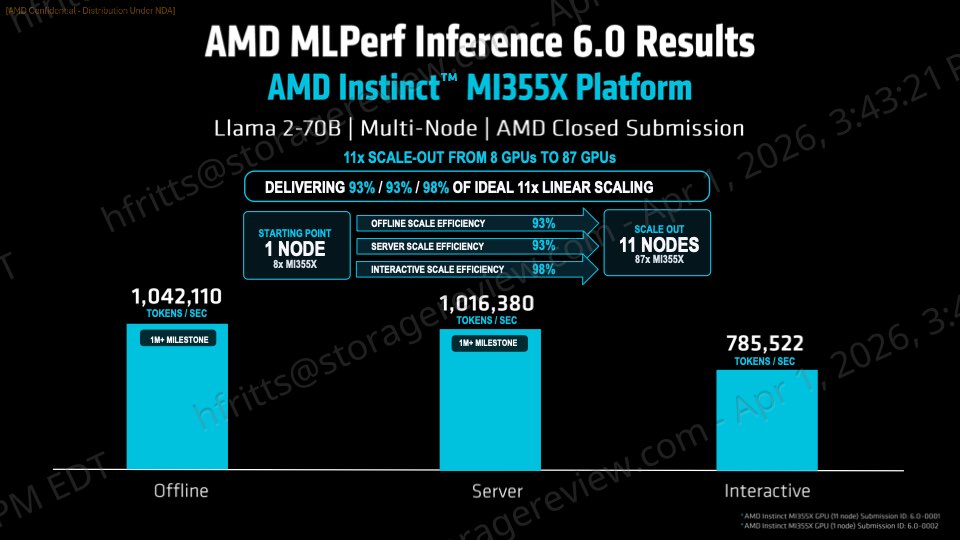
AMD demonstreerde ook efficiënte schaalbaarheid. Op de Llama 2 70B bereikte een configuratie van 11 nodes en 87 GPU's meer dan 1 miljoen tokens per seconde in offline-, server- en interactieve scenario's, met een schaalbaarheidsefficiëntie van 93% tot 98%. Op de GPT-OSS-120B behaalde een cluster van 12 nodes en 94 GPU's een vergelijkbare doorvoer met een schaalbaarheidsefficiëntie van meer dan 90%. Deze resultaten geven aan dat de prestatiewinsten effectief behouden blijven naarmate implementaties zich uitbreiden tot meer dan één systeem.
Generatiewinst en concurrerende prestaties van één enkele node
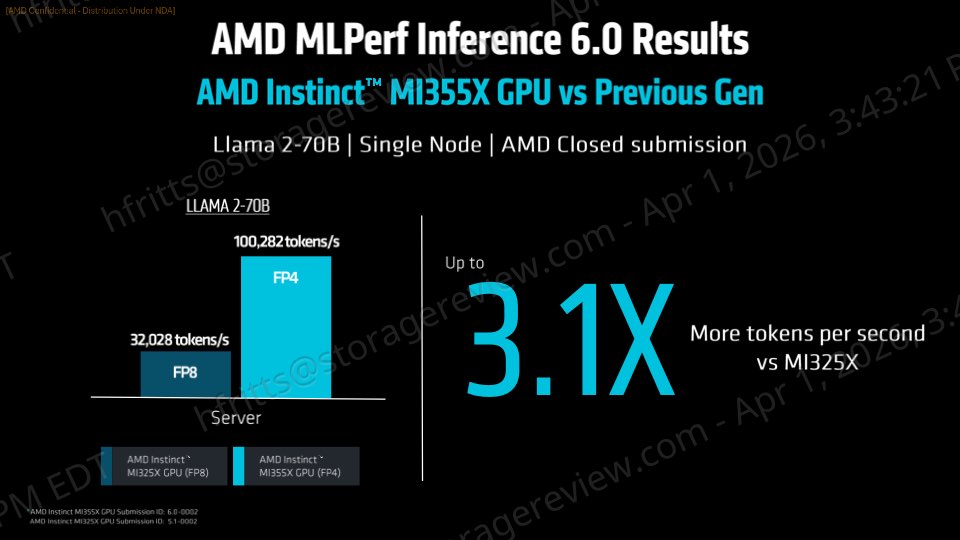
AMD rapporteerde een prestatieverbetering van 3.1x voor de Llama 2 70B Server in vergelijking met de vorige generatie Instinct MI325X, met een prestatie van 100,282 tokens per seconde. Deze verbetering is te danken aan zowel architectonische veranderingen als optimalisaties in de ROCm-software. De offline prestaties verbeterden met een factor 4.4 en de serverprestaties met een factor 4.8 ten opzichte van eerdere testrondes. Deze winst is voornamelijk toe te schrijven aan FP4-kwantisatie.
Bij vergelijkingen met één processor liet de MI355X een concurrerende positie zien ten opzichte van NVIDIA-platformen. Op de Llama 2 70B evenaarde AMD de NVIDIA B200 qua offline doorvoer, bereikte bijna gelijke prestaties in servermodus en overtrof de interactieve prestaties. Ten opzichte van Nvidia's B300 levert de GPU van AMD 92% in offline modus, 93% in servermodus en overtreft deze met 104% in interactieve modus.
De eerste keer dat een model wordt ingezet, wordt de dekking uitgebreid.
MLPerf Inference v6.0 bevat diverse nieuwe workloads en AMD heeft deze ronde gebruikt om de snelle implementatie van modellen te demonstreren. GPT-OSS-120B, een model met een mix van experts, werd voor het eerst geïntroduceerd en behaalde concurrerende resultaten ten opzichte van NVIDIA-systemen in zowel offline als serverscenario's.
AMD diende ook resultaten in voor Wan-2.2 tekst-naar-video-generatie, waarmee het bedrijf zijn intrede deed in de wereld van multimodale en generatieve video-inferentie. Hoewel de officiële inzending zich richtte op de latentie van een enkele stream, waren de resultaten concurrerend met die van bestaande platforms. Na de inzending werd de prestatie verder geoptimaliseerd, wat aangeeft dat er nog ruimte is voor verbetering naarmate de software zich verder ontwikkelt.
Deze toevoegingen benadrukken AMD's focus op het uitbreiden van hun aanbod buiten de traditionele LLM-benchmarks om opkomende AI-workloads te ondersteunen.
ROCm-software maakt schaling en heterogene inferentie mogelijk.
AMD schrijft een groot deel van de prestaties en schaalbaarheid toe aan de ROCm-softwarestack. Verbeteringen omvatten geoptimaliseerde FP4-uitvoering, verbeterde GPU-naar-GPU-communicatie voor gedistribueerde inferentie en ondersteuning voor dynamische taakverdeling over heterogene omgevingen.
De eerste heterogene inzending voor MLPerf werd ontwikkeld met behulp van drie AMD Instinct GPU-modellen: MI300X, MI325X en MI355X. De configuratie, ingediend door Dell en MangoBoost, behaalde 141,521 tokens per seconde op Llama 2 70B Server en 151,843 tokens per seconde op Llama 2 70B Offline.
Het is belangrijk om te vermelden dat het AMD Instinct MI355X-platform zich in het laboratorium van Dell in de Verenigde Staten bevond, terwijl de Instinct MI300X- en MI325X-platforms in Korea stonden. Dit toont aan dat systemen op verschillende geografische locaties gecoördineerd kunnen worden.
Groei en reproduceerbaarheid van ecosystemen
Het partner-ecosysteem van AMD is in deze MLPerf-ronde uitgebreid, met negen bedrijven die resultaten hebben ingediend voor meerdere Instinct GPU-generaties. De deelnemende leveranciers waren onder andere Cisco, Dell, Giga Computing, HPE, MangoBoost, MiTAC, Oracle, Supermicro en Red Hat.
De resultaten van de partners kwamen grotendeels overeen met de interne resultaten van AMD, doorgaans binnen 4% en in sommige gevallen zelfs binnen 1%. Deze consistentie wijst erop dat de prestaties reproduceerbaar zijn op OEM- en cloudplatformen, waardoor het implementatierisico wordt verlaagd en het vertrouwen in de resultaten in de praktijk wordt vergroot.


 Amazon