

Tijdens het Advancing AI-evenement in San Jose onthulde AMD de Instinct MI350-serie, de nieuwste generatie GPU's, en een ambitieuze roadmap voor toekomstige AI-acceleratorplatforms. De MI4-serie, gebouwd op de geavanceerde CDNA350-architectuur, belooft aanzienlijke prestatieverbeteringen voor veeleisende AI-workloads. Deze aankondiging omvatte ook een preview van de toekomstige Instinct-reeks, waarmee AMD's toewijding aan continue innovatie in AI-hardware werd onderstreept.
AMD Instinct MI350-serie
De AMD Instinct MI350-serie , aangedreven door de nieuwe CDNA4-architectuur, vertegenwoordigt een aanzienlijke sprong voorwaarts in AI-berekeningen. De CDNA4-architectuur is specifiek ontworpen voor AI-workloads en introduceert verbeterde matrixengines, ondersteuning voor nieuwe dataformaten en cruciale verbeteringen in energie-efficiëntie.
Geavanceerde verpakking en chipletarchitectuur: de basis van MI350
De MI350-serie is gebaseerd op de geavanceerde 3D-chipletverpakkingstechnologie van AMD en is een voortzetting van de MI300-serie met belangrijke verbeteringen.
Chipletontwerp en -fabricage
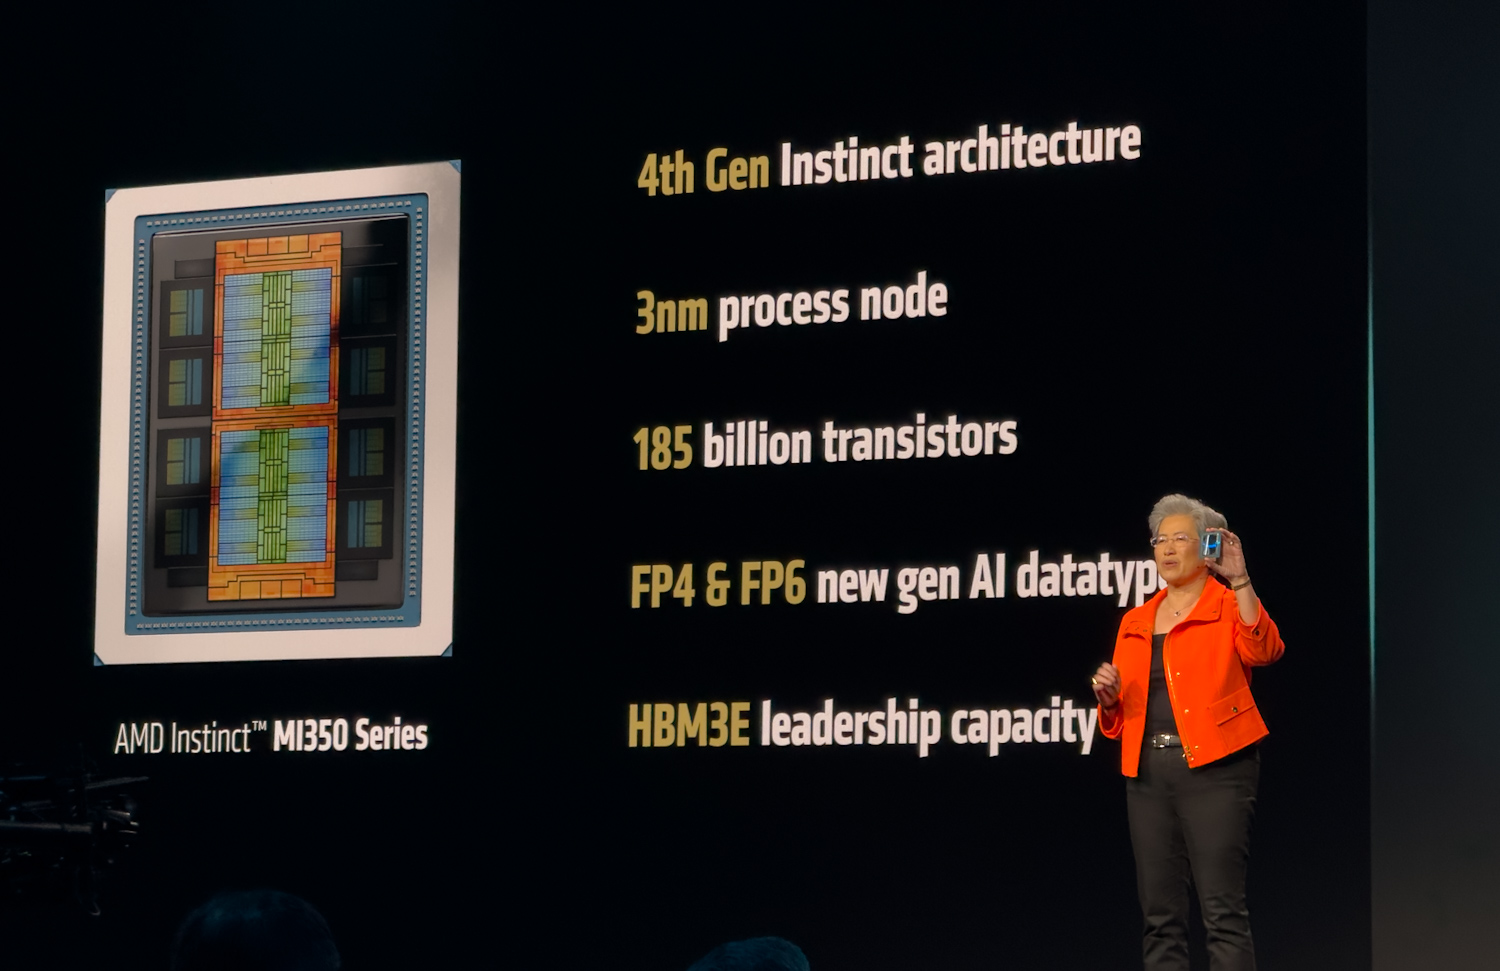
De kern van het GPU-pakket bestaat uit acht Accelerator Compute Chiplets (XCD's), de belangrijkste rekenengines. Deze XCD's worden gefabriceerd met behulp van een geavanceerd 3nm Node 3+ nodeproces, een upgrade van de 5nm-technologie die in de MI300-serie wordt gebruikt, en dragen aanzienlijk bij aan een verbeterde energie-efficiëntie. Elke XCD bevat vier shaderengines, elk met acht actieve CDNA4-rekenunits, wat resulteert in 32 CU's per XCD en een totaal van 256 CU's voor de accelerator.

De XCD's worden aangevuld met twee I/O-dies (IOD's), een vermindering ten opzichte van de vier IOD's in de MI300-serie. Deze IOD's, geproduceerd met een 6nm-klasse proces, verzorgen geheugentoegang, I/O-bewerkingen en communicatie tussen chipsets. Dit gestroomlijnde ontwerp met twee I/O's, gecombineerd met bredere interne verbindingen, handhaaft de bandbreedtedoelstellingen en verlaagt het stroomverbruik.
Fysieke integratie en logische eenheid
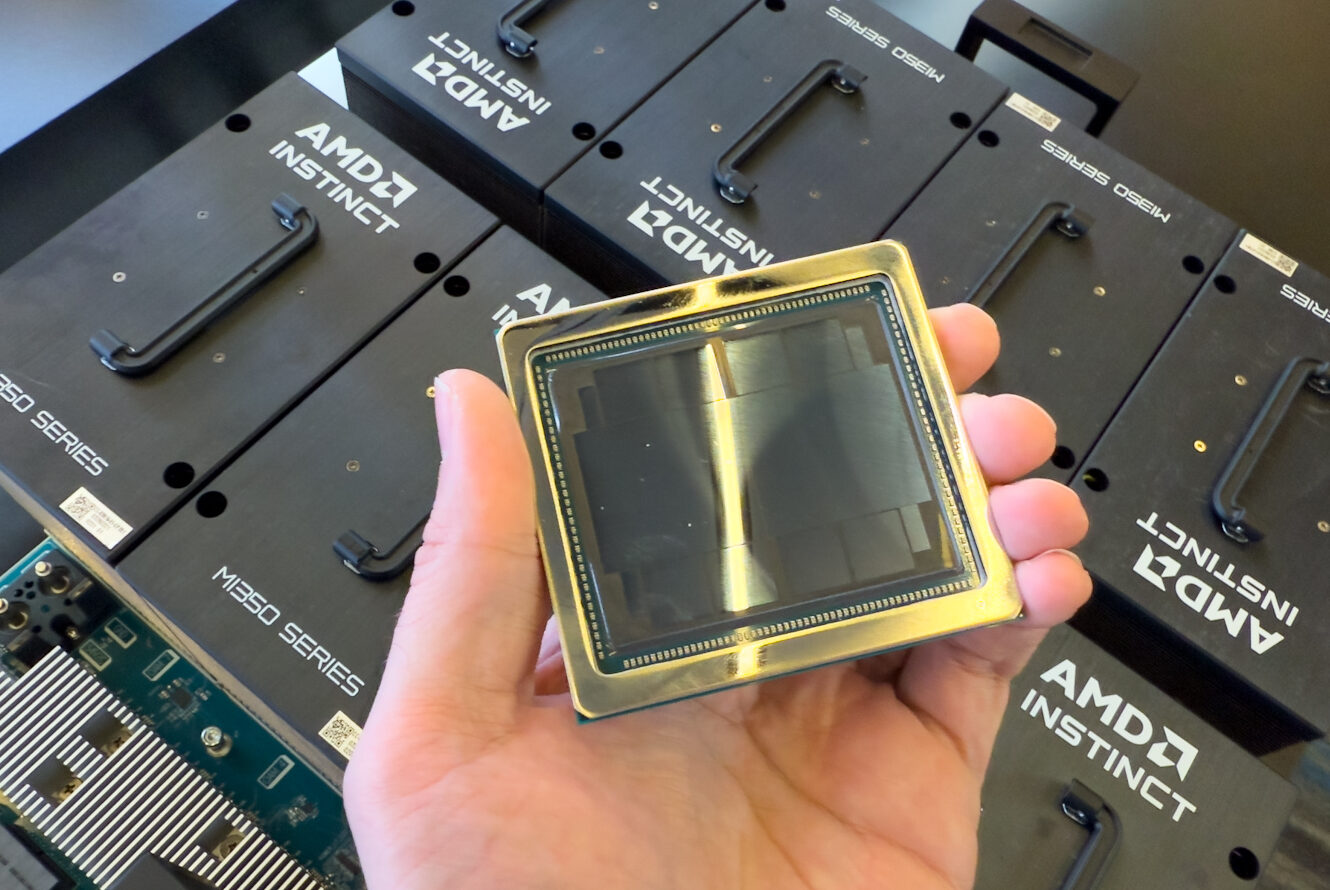
De fysieke assemblage omvat het monteren van de XCD's en HBM3E-geheugenstacks op een Chip-on-Wafer-on-Substrate (COOS) interposer. Een cruciaal aspect van dit ontwerp is de hybride binding van XCD's met de IOD's eronder. Deze 3D-hybride bindingstechniek creëert uitzonderlijk dichte verbindingen met hoge bandbreedte tussen de reken- en I/O-chiplets, wat traditionele 2.5D-constructies ver overtreft, wat essentieel is voor een efficiënte datalevering aan de energieverslindende XCD's. Bovendien draagt deze geavanceerde 3D-integratie bij aan een kleinere totale GPU-voetafdruk, wat de productiecapaciteit en operationele betrouwbaarheid kan verbeteren.
Ondanks de complexe chipletconstructie functioneert de MI350 logischerwijs als één uniforme GPU. Elke XCD vormt een Accelerator Compute Complex, uitgerust met wereldwijde resources, waaronder een command processor en een L4-cache van 2 MB.
Verbeterd geheugensubsysteem
Om de krachtige CDNA4-cores adequaat te kunnen ondersteunen, beschikt de MI350-serie over een aanzienlijk verbeterd geheugensubsysteem. De serie is uitgerust met acht stacks HBM3E-geheugen, goed voor een totale capaciteit van 288 GB per GPU. Elke stack van 36 GB, bestaande uit 12 24-Gbps-apparaten, werkt op de volledige HBM3E-pinsnelheid van 8 Gbps per pin.
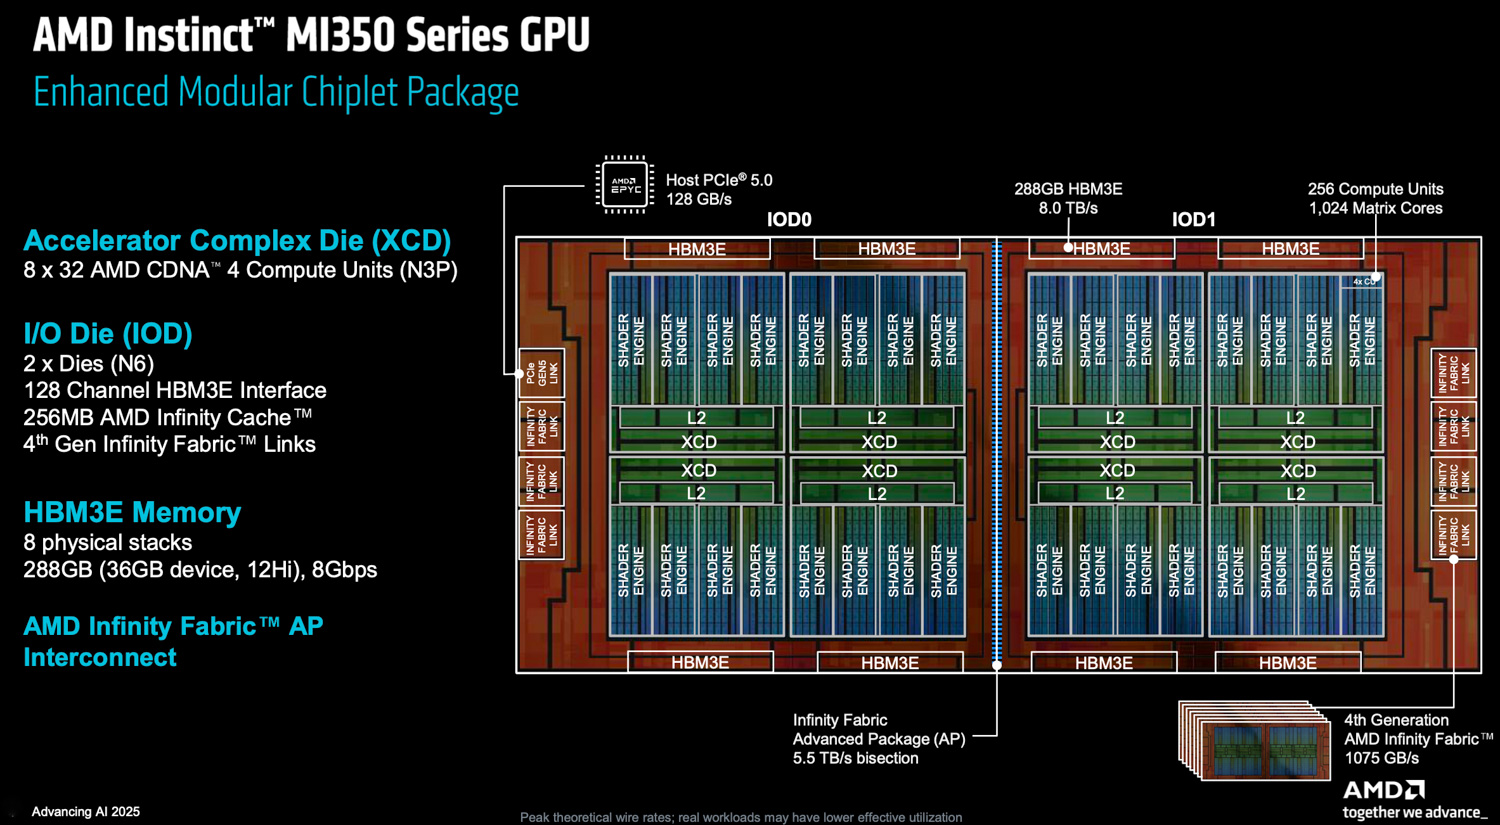
De architectuur behoudt ook AMD's Infinity Cache, een cruciale cache aan de geheugenzijde, gepositioneerd tussen de HBM en de Infinity Fabric/L2-caches. Deze cache bestaat uit 128 kanalen, elk ondersteund door 2 MB cache, voor een totaal van 256 MB voor de GPU. Om de efficiëntie van de bandbreedtelevering bij een lager stroomverbruik te verbeteren, heeft AMD de on-die netwerkbussen in de IOD's verbreed en deze op een lagere spanning laten werken. Deze optimalisatie verlaagt de energie per bit, waardoor de MI350-serie een ongeveer 1.3 keer hogere geheugenbandbreedte per watt bereikt in vergelijking met zijn voorganger, de MI300-serie.
Om het uitgebreide fysieke geheugen van 288 GB effectief te beheren, zijn de Universal Translation Caches (UTC's), analoog aan CPU Translation Lookaside Buffers (TLB's), aanzienlijk verbeterd. De MI350-serie introduceert gedetailleerdere instellingen voor paginagrootte in zowel UTC L1 als L2, naast een grotere capaciteit. Deze verbeteringen zorgen voor een groter TLB-bereik en efficiënter beheer van virtueel geheugen.
Verbeteringen aan Infinity Fabric
De Infinity Fabric-technologie van AMD blijft essentieel voor de schaalbaarheid en de communicatieprestaties tussen de GPU's van de MI350. De bandbreedte van de Infinity Fabric AP-link die de twee IOD's verbindt, is aanzienlijk verhoogd tot 5.5 TB/s, waardoor efficiënte gegevensoverdracht tussen de twee helften van de GPU mogelijk is.
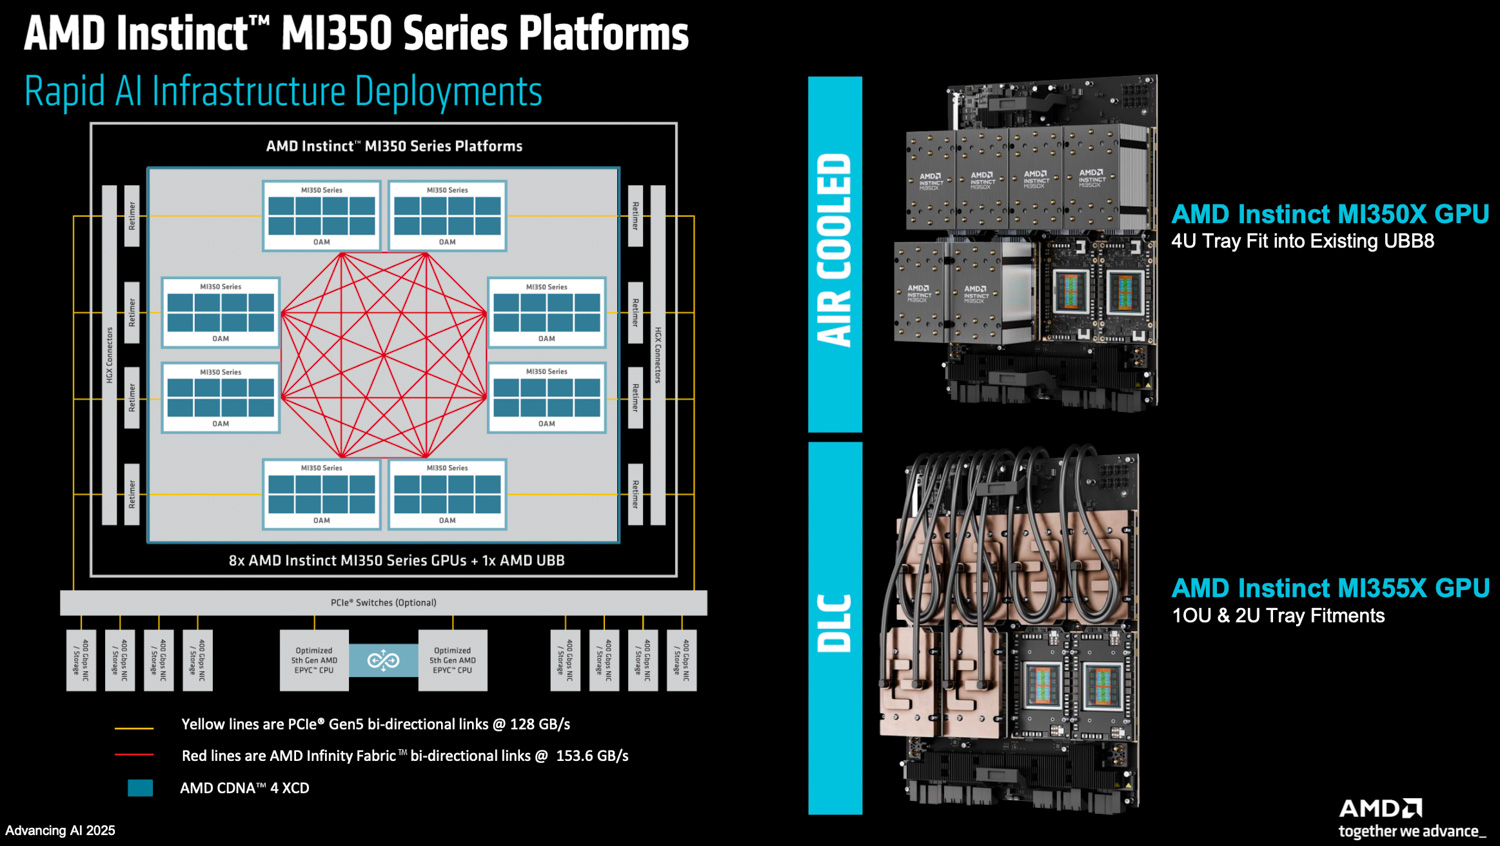
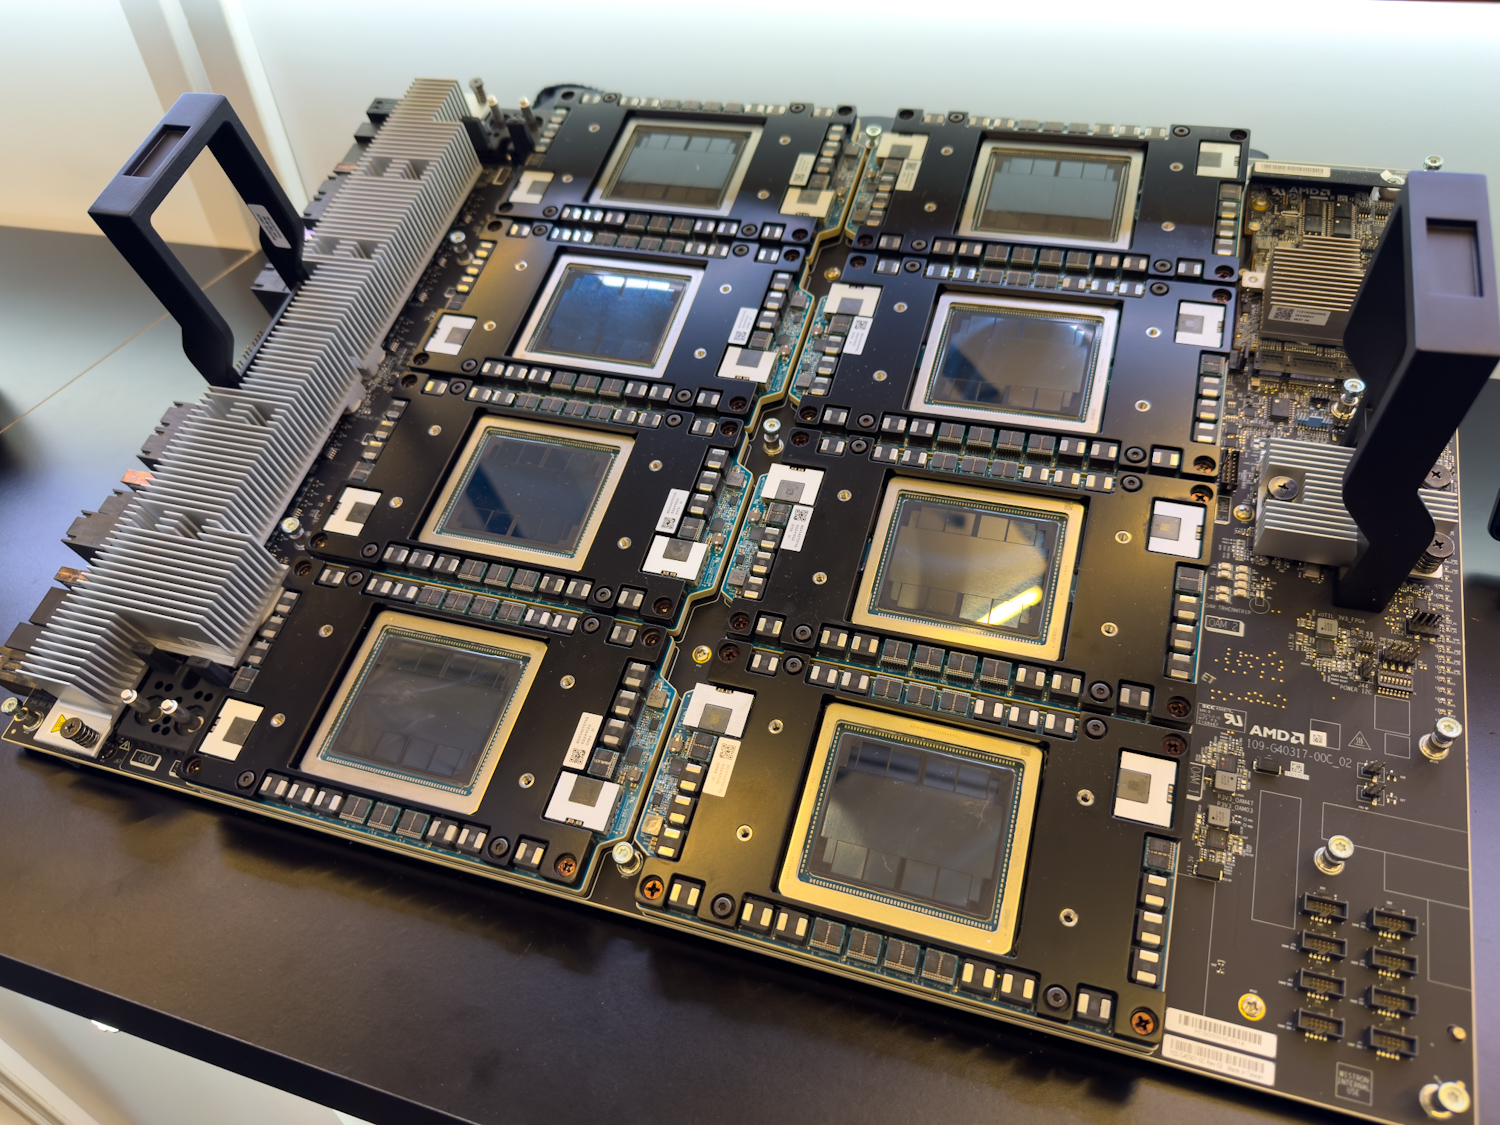
Voor externe communicatie beschikt elke MI350 GPU over zeven Infinity Fabric-verbindingen, waardoor directe GPU-naar-GPU-connectiviteit mogelijk is in configuraties zoals een 8-GPU UBB 2.0-platform. Deze verbindingen werken met 38.4 Gbps per pin. In een 8-GPU OAM-configuratie levert deze configuratie een bisectionele bandbreedte van ongeveer 153.6 GB/s in elke richting per verbinding. AMD heeft ook de datapackaging- en compressietechnieken voor deze externe verbindingen verfijnd om de effectief geleverde bandbreedte te verhogen. Intern zorgt de Infinity Fabric ervoor dat alle XCD's volledige, fijnmazige interleaved toegang hebben tot de volledige HBM3E-geheugenruimte over beide IOD's, waardoor het geheugen als één platte, uniforme resource aan de rekeneenheden wordt gepresenteerd.
CDNA4 Compute Core-architectuur
De CDNA4-rekeneenheid , die de kern vormt van de rekenkracht van de MI350 , heeft een ingrijpende herstructurering ondergaan, specifiek gericht op AI.
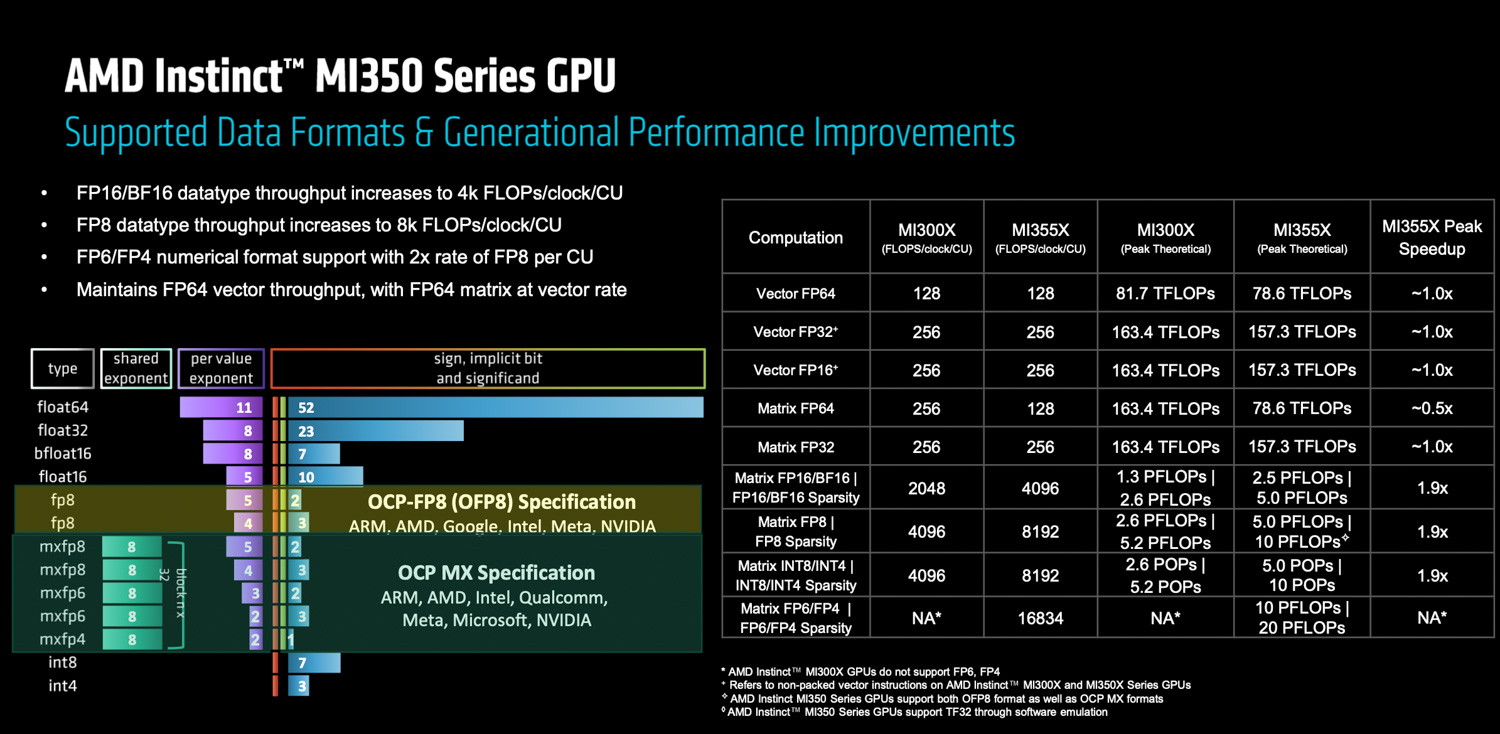
De matrixwiskundemogelijkheden zijn aanzienlijk verbeterd: MI350-processoren leveren een 2x hogere doorvoersnelheid per processor voor 16-bits (BF16, FP16) en 8-bits (FP8, INT8) bewerkingen vergeleken met hun MI300-tegenhangers. De MI350-serie introduceert ook hardwareondersteuning voor OCP MX-gespecificeerde microschaalformaten, met name FP6 en FP4, die proportioneel schalen ten opzichte van FP8. AMD's implementatie zorgt er met name voor dat FP6 met dezelfde rekensnelheid werkt als FP4. Deze strategische beslissing positioneert AMD als koploper in FP6, een opkomend formaat met potentieel voor AI-training. Bovendien is er een nieuwe vector-ALU toegevoegd die 2-bits bewerkingen ondersteunt en BF16-resultaten in FP32 kan accumuleren, waardoor de doorvoersnelheid voor bepaalde vectorbewerkingen met lage precisie wordt verbeterd.
Ter ondersteuning van deze verbeterde tensordoorvoer is de Local Data Share (LDS)-grootte per CU vergroot en zijn nieuwe mogelijkheden beschikbaar om de bandbreedte voor het laden van gegevens vanuit het globale geheugen in de LDS te vergroten. Gezien de potentiële knelpunten in bewerkingen zoals softmax en aandachtsmechanismen, is ook de doorvoer voor transcendentale functies verhoogd, parallel aan de verbeteringen aan de tensorkern.
Verschillende andere architectuurverbeteringen dragen bij aan de prestaties en flexibiliteit:
- Hardware-ondersteunde stochastische afronding: vermindert vertekening bij het omzetten van FP32 naar formaten met lagere precisie door entropie in te spuiten.
- Logical Operator 3 (LUT3)-instructie: biedt programmeurs meer flexibiliteit voor het implementeren van aangepaste logische bewerkingen met drie ingangen.
- Nieuwe Min-Max-operatoren: Hiermee kunnen programmeurs de NaN-voortplanting regelen tijdens vergelijkingen. Ze kunnen dan NaN-waarden voortplanten of een niet-NaN-drijvendkommagetal selecteren, wat bijdraagt aan robuust AI-gegevensbeheer.
Hoewel AI de primaire focus is, behoudt de MI350-serie ondersteuning voor 64-bits floating-point (FP64) bewerkingen in zowel vector- als matrixeenheden. Een belangrijk verschil met de MI300 is echter dat matrix-FP350 bewerkingen op de MI64 met dezelfde snelheid worden uitgevoerd als de vector-FP64 eenheden, effectief de helft van de FP64 matrixsnelheid van de MI300.
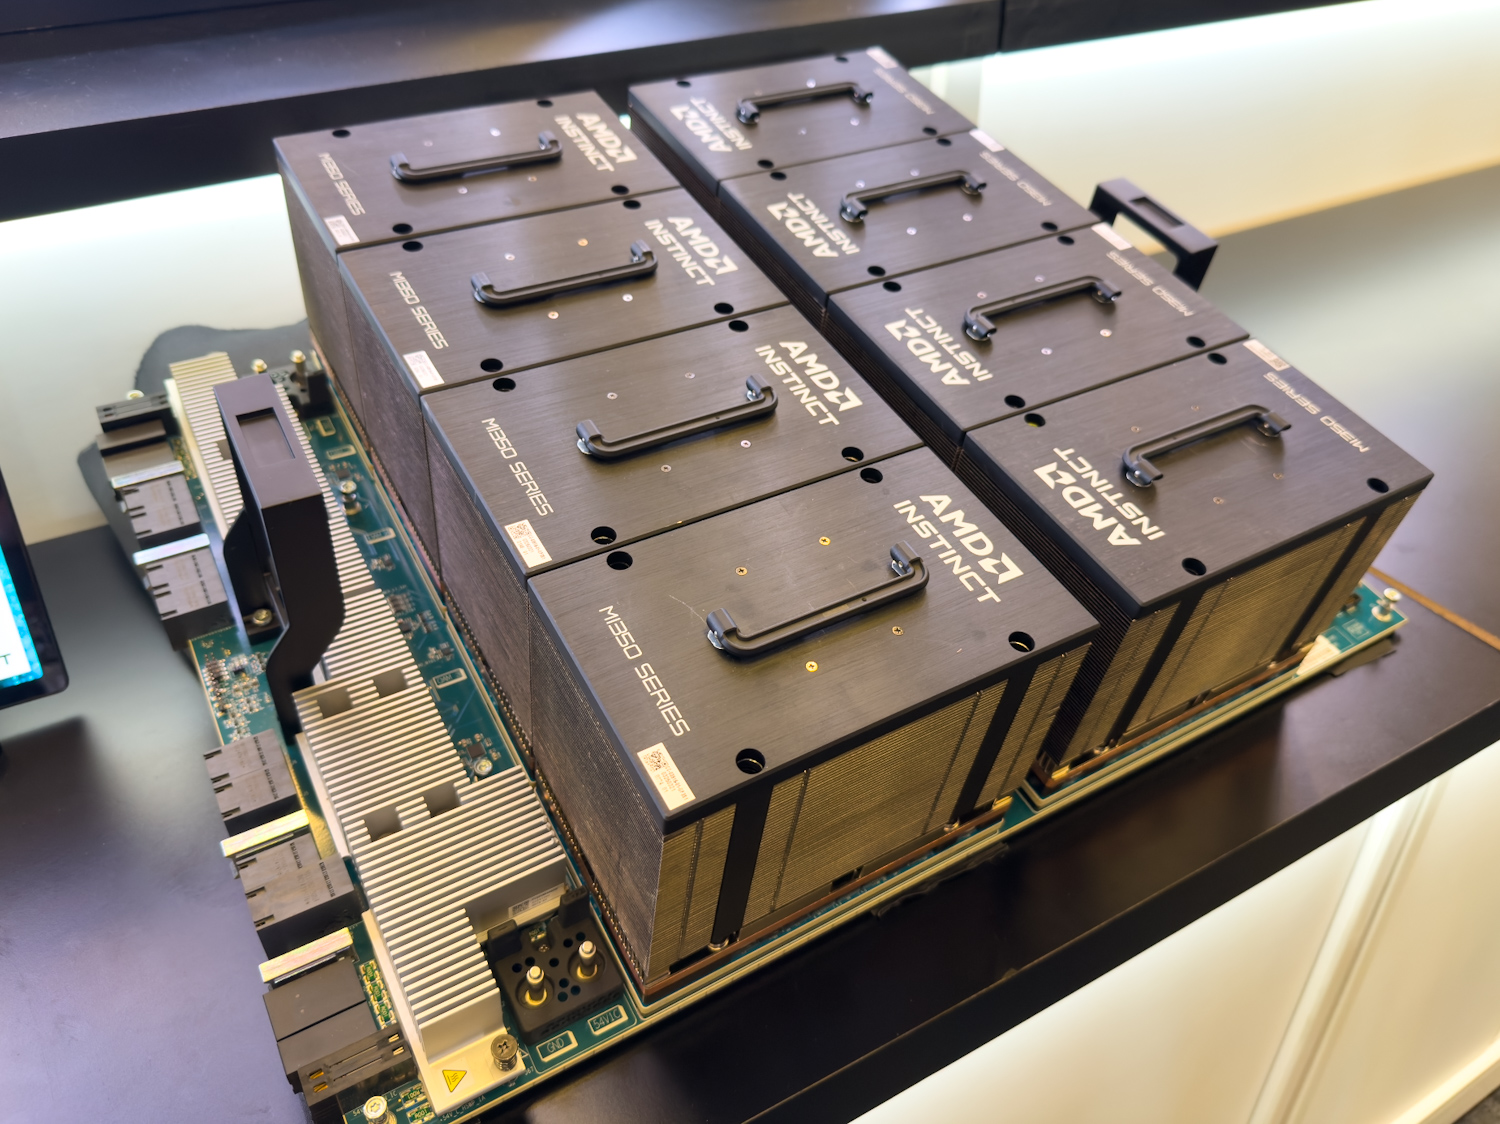
Ten slotte zorgt de combinatie van een hogere HBM3E-bandbreedte en een iets lager aantal geheugenmodules (256 op de MI350X/355X versus 304 op de MI300X) ervoor dat elke geheugenmodule in de MI350-serie profiteert van een hogere globale geheugenbandbreedte per klok. Dit is cruciaal voor het versnellen van zowel GEMM-intensieve (General Matrix Multiply) bewerkingen als bandbreedtegebonden vectorberekeningen.
Partitionering voor flexibiliteit: NPS en compute-partitionering
De AMD MI350-serie beschikt over verbeterde partitioneringsmogelijkheden en biedt daardoor een uiterst flexibele toewijzing van de substantiële bronnen, om zo het gebruik en de efficiëntie van uiteenlopende workloads te maximaliseren.
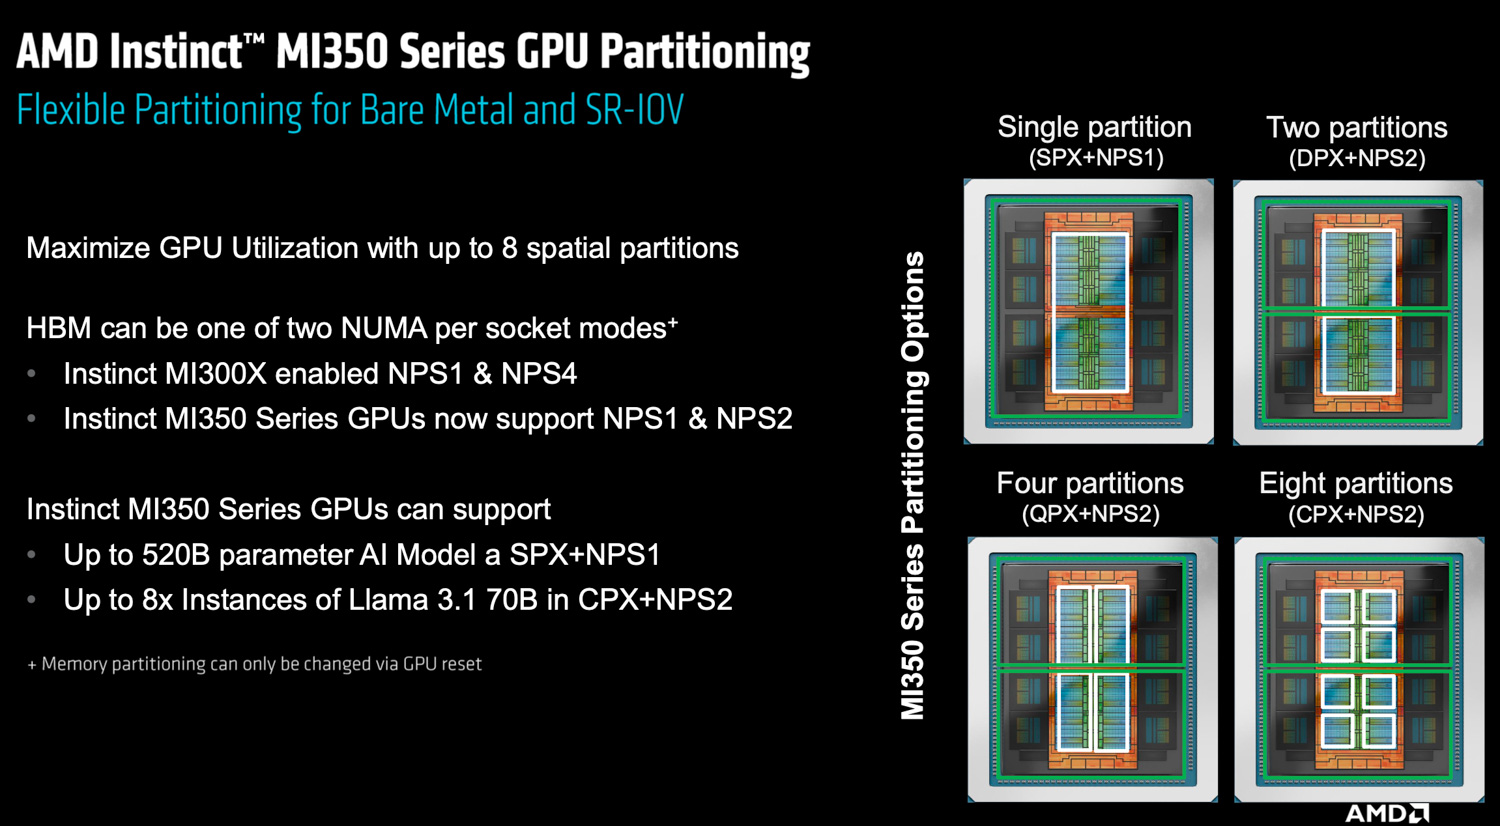
Voor geheugenbeheer biedt de MI350 twee primaire NUMA-modi (Non-Uniform Memory Access):
- NPS1: behandelt het volledige 288 GB HBM3E-geheugen als één enkel, uniform NUMA-domein door de gegevenstoegang over alle acht HBM-stacks te verdelen.
- NPS2: Verdeelt het geheugen in twee afzonderlijke NUMA-domeinen, die elk overeenkomen met een van de twee IOD's en de bijbehorende vier HBM-stacks. Terwijl de geheugentoegang binnen elke IOD in de NPS2-modus fijnmazig en interleaved blijft, wordt deze grofmazig over de IOD's. Deze modus, met name in combinatie met compute partitioning, kan optimalisaties voor ruimtelijke lokaliteit mogelijk maken.
Opvallend is dat AMD ervoor heeft gekozen om geen NPS4-modus te ondersteunen op de MI350 (die wel beschikbaar was op de MI300). Deze beslissing is het gevolg van de nauwere geheugenkoppeling binnen elk van de twee IOD's in de nieuwere architectuur, waardoor de potentiële prestatievoordelen van verdere geheugenonderverdeling werden verminderd.
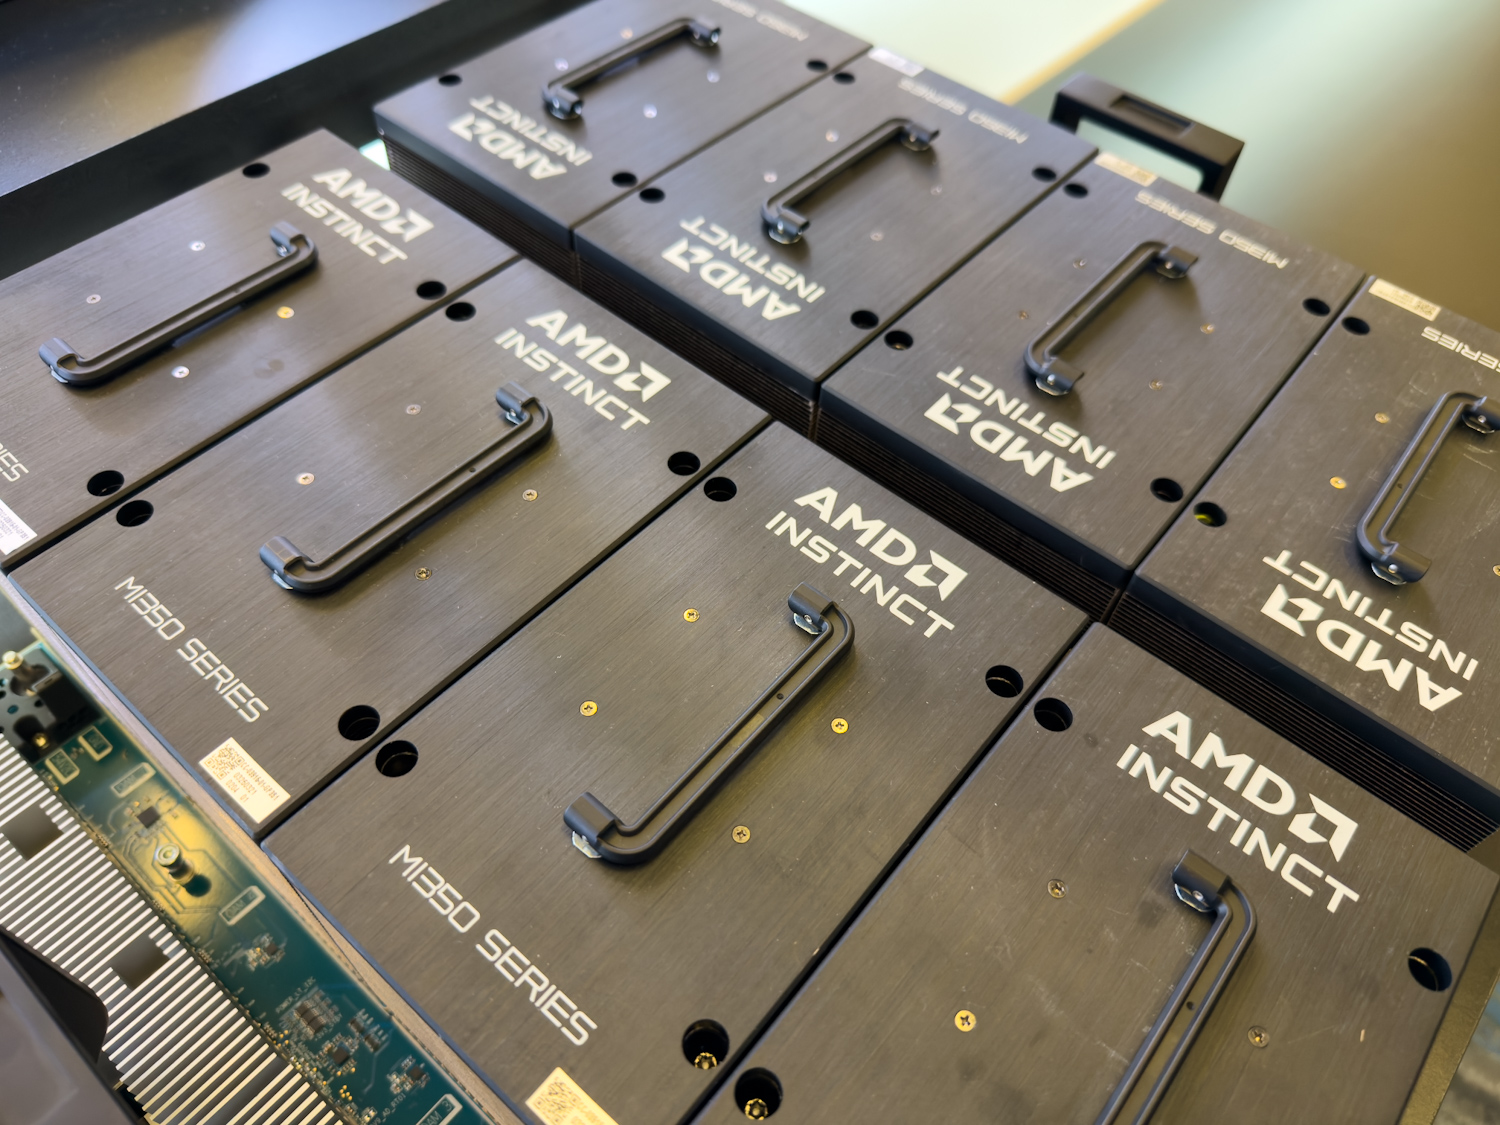
Wat de rekenkracht betreft, kan de GPU worden geconfigureerd om in verschillende modi te werken:
- SPX (Single Partition Execution): De GPU functioneert als één krachtige engine en wordt doorgaans gebruikt met de NPS1-geheugenmodus.
- DPX, QPX, OPX (Dual, Quad, Octal Partition Execution): De GPU kan respectievelijk in twee, vier of zelfs acht onafhankelijke rekenpartities worden verdeeld.
Deze rekenpartities kunnen worden gecombineerd met NPS1- of NPS2-geheugenconfiguraties, met de beperking dat de granulariteit van de rekenpartitie minstens zo fijn moet zijn als, of fijner dan, de geheugenpartitie (de SPX-modus is bijvoorbeeld niet compatibel met NPS2-geheugenpartitionering).
Deze veelzijdige partitioneringsopties worden ondersteund in zowel bare-metal implementaties als via SR-IOV (Single Root I/O Virtualization), waardoor ze ideaal zijn voor gevirtualiseerde omgevingen met meerdere tenants. In cloud- of datacenteromgevingen kan bijvoorbeeld één MI350 GPU logisch worden gesegmenteerd om meerdere gebruikers of applicaties tegelijkertijd te bedienen. Elke tenant krijgt een toegewezen geheugen- en rekenresourceslice, wat de kwaliteit van de service en beveiliging waarborgt, wat met name waardevol is in scenario's waarin verschillende virtuele machines geïsoleerde toegang tot GPU-hardware vereisen.
MI350X versus MI355X: op maat gemaakt voor verschillende implementaties
De MI350-serie wordt geïntroduceerd met twee primaire varianten, die inspelen op verschillende inzetvereisten en thermische enveloppen:
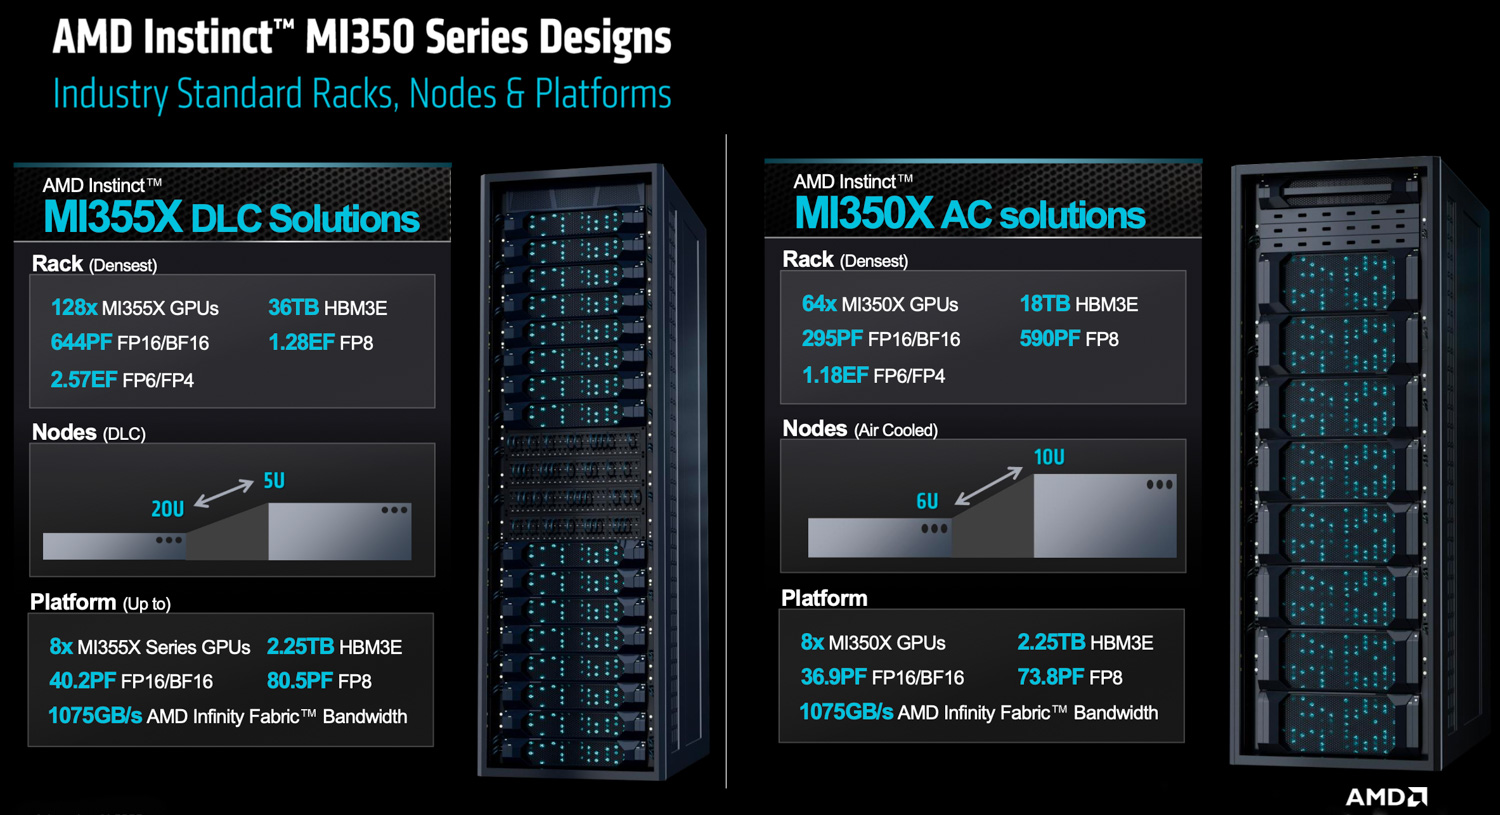
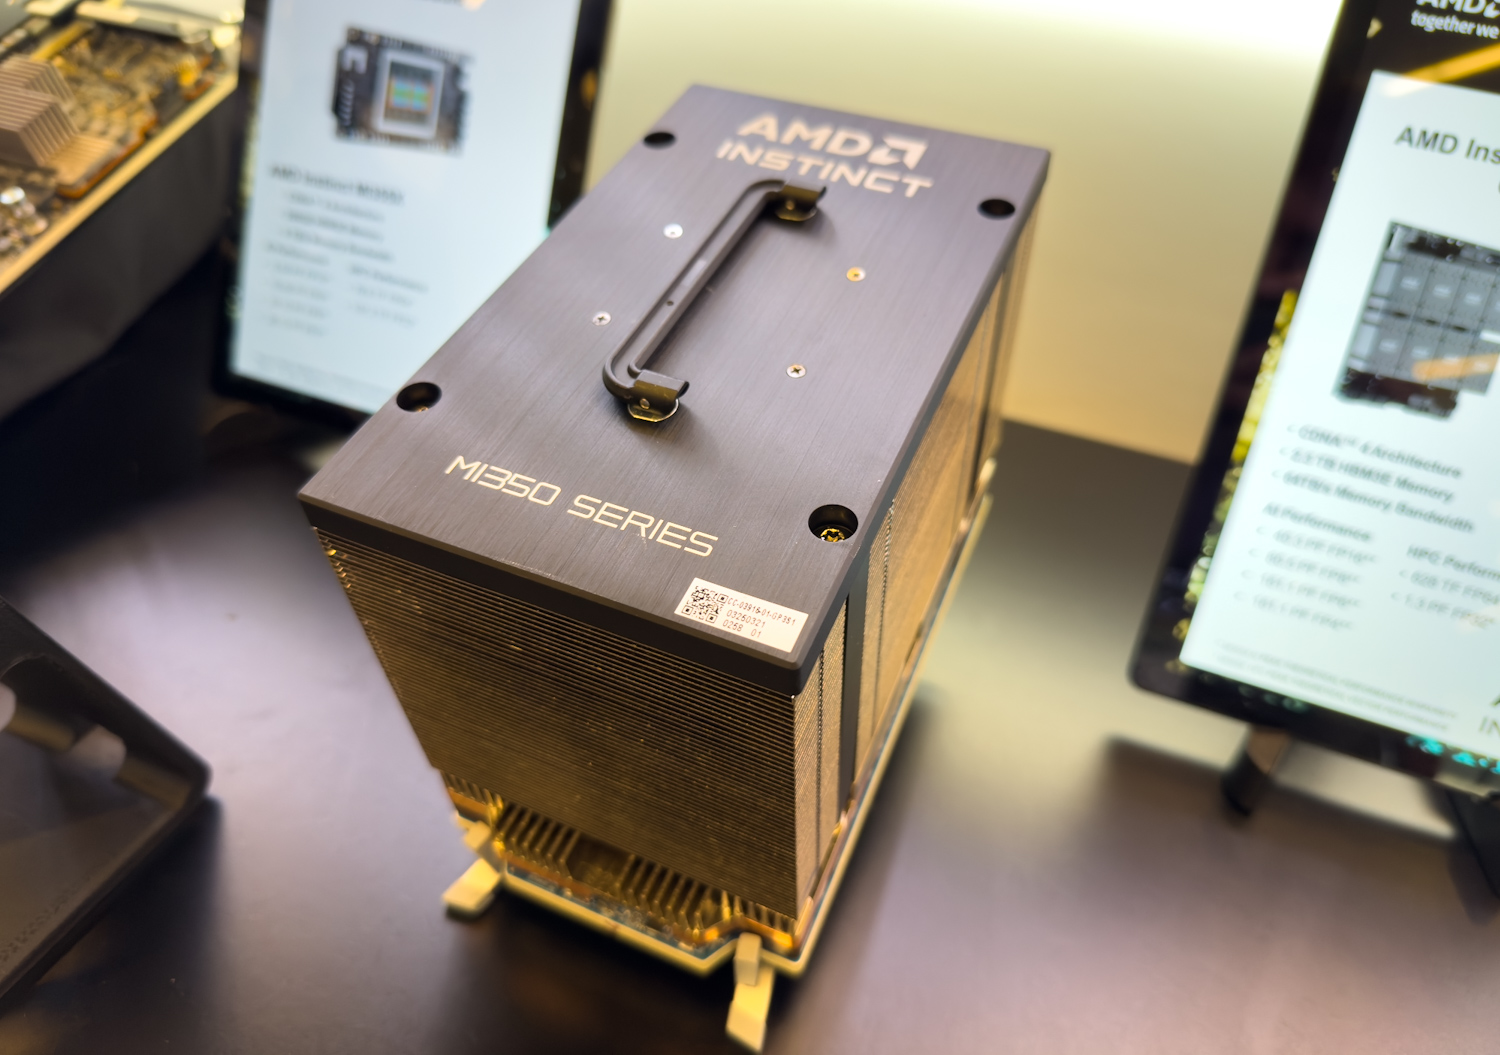
- MI350X: Deze variant is ontworpen voor een lager stroomverbruik, met een Thermal Design Power (TDP) tot één kilowatt. Hij ondersteunt luchtgekoelde implementaties en biedt bredere compatibiliteit binnen bestaande datacenterinfrastructuren.
- MI355X: De MI1.4X werkt met een hoger systeemvermogen van maximaal 355 kilowatt TDP en is primair gericht op vloeistofgekoelde implementaties, waardoor hij maximale prestaties kan leveren.
Hoewel beide varianten op dezelfde basishardware zijn gebouwd, maakt het hogere operationele vermogen van de MI355X hogere, aanhoudende klokfrequenties mogelijk. Dit vertaalt zich in een prestatievoordeel van ongeveer 20% bij real-world, end-to-end workloads ten opzichte van de MI350X. Deze zijn verkrijgbaar in drie gevalideerde rackconfiguraties.
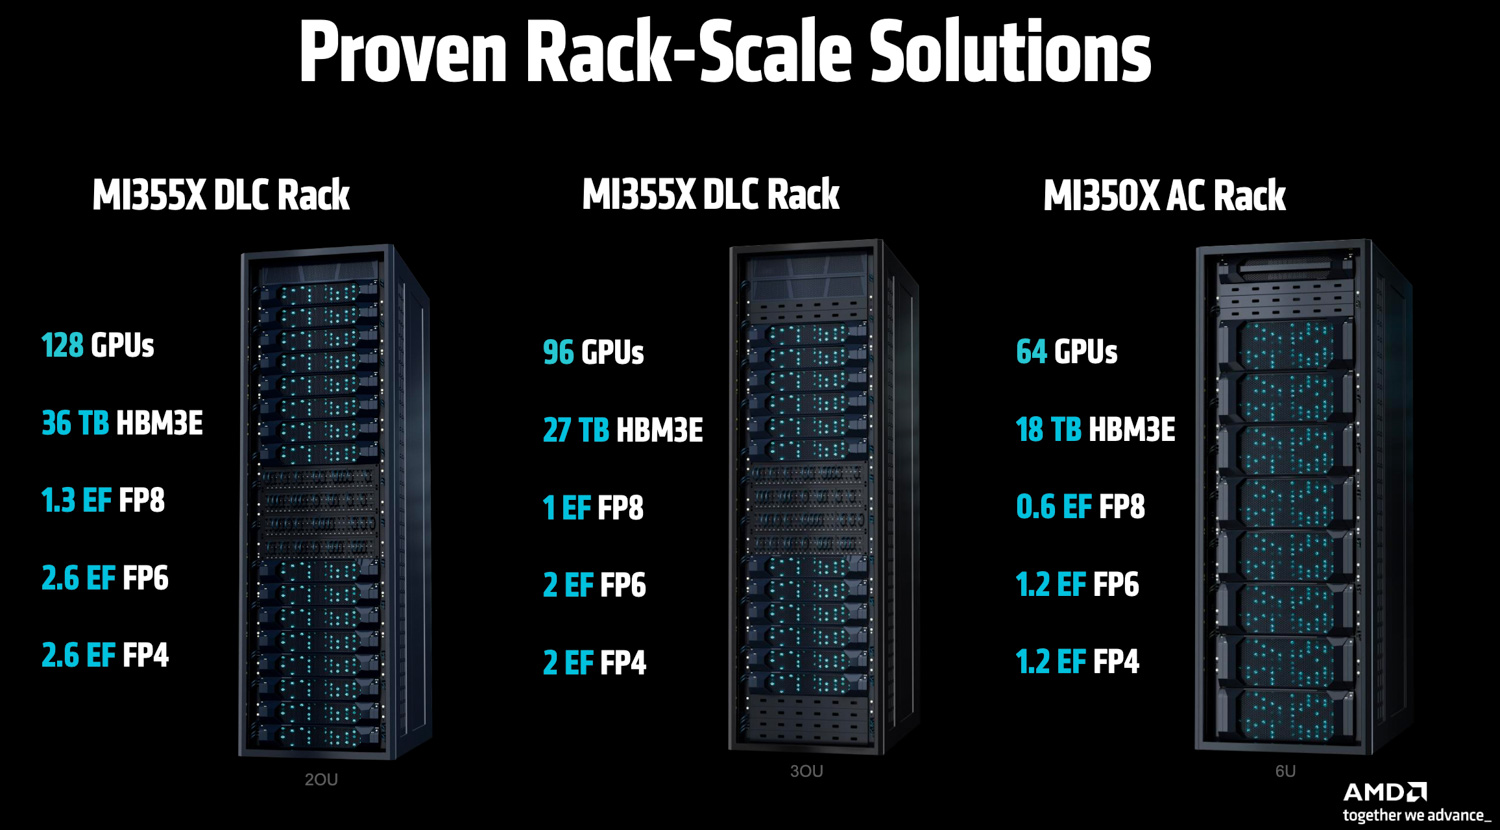
AMD Pensando Pollara-netwerken
Naast de nieuwe GPU's gaf AMD een diepgaande blik op zijn Pollara Networking-oplossingen, met belangrijke architecturale verbeteringen die zijn ontworpen om te voldoen aan de toenemende eisen van grootschalige AI-systemen. De Pollara 400 AI NIC, gebaseerd op technologie van AMD's Pensando-overname, introduceert een nieuw niveau van programmeerbaarheid en intelligentie voor AI-netwerken.

De kern van Pollara's innovatie ligt in de programmeerbare architectuur. In tegenstelling tot hardware met vaste functies beschikt de Pollara NIC over een P4-programmeerbare MPU-kern. Dit ontwerp is cruciaal omdat de vereisten voor AI-netwerken voortdurend veranderen, met nieuwe protocollen, transportmechanismen en telemetriebehoeften die snel ontstaan. Dankzij de programmeerbaarheid kan de Pollara NIC zich aanpassen via software-updates, waardoor aangepaste verkeersbeheerschema's, nieuwe load balancing-algoritmen en op maat gemaakte congestiebeheersingsmechanismen kunnen worden geïmplementeerd zonder dat hardware hoeft te worden vervangen. Deze flexibiliteit is cruciaal om AI-datacenters toekomstbestendig te maken en snel te kunnen reageren op de veranderende kenmerken van workloads.
Pollara introduceert multicast om veelvoorkomende netwerkknelpunten aan te pakken. Voor GPU-naar-GPU-communicatie kunnen gegevens van één verbinding tegelijkertijd over meerdere fysieke netwerkverbindingen worden gedistribueerd. Deze aanpak verbetert de algehele netwerkbenutting en doorvoer door congestie op één enkel pad te voorkomen. De netwerkkaart zelf beheert de complexiteit van deze distributie, inclusief het herschikken van pakketten die mogelijk niet in de juiste volgorde aankomen.
De netwerkefficiëntie wordt verbeterd door selectieve bevestiging van herverzendingen. In traditionele netwerken kan het verlies van één enkel pakket leiden tot de herverzending van een uitgebreide reeks gegevens. Pollara implementeert een nauwkeurigere methode waarbij alleen verloren pakketten opnieuw worden verzonden. Dit vermindert de hoeveelheid redundante data op het netwerk aanzienlijk, waardoor de effectieve bandbreedte verbetert. De Pollara-netwerkoplossing is bovendien ontworpen voor robuuste werking in diverse netwerkomgevingen, waaronder omgevingen met verliesrijke verbindingen. Het omvat geavanceerde, programmeerbare en padbewuste congestiecontrole. Deze mogelijkheid vermindert de afhankelijkheid van perfect verliesvrije netwerkstructuren, die complex en kostbaar kunnen zijn om te implementeren en te onderhouden op de enorme schaal die nodig is voor moderne AI-clusters.

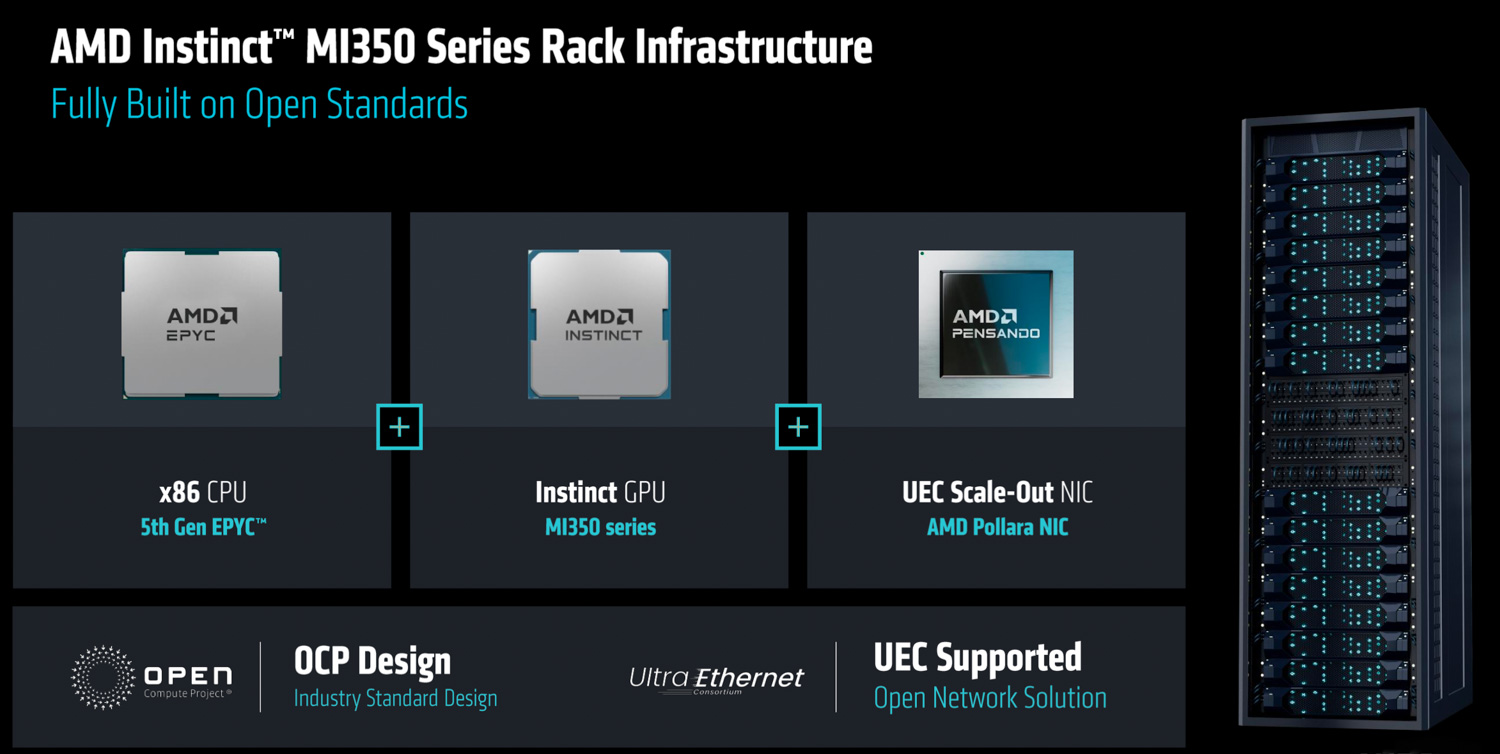
AMD is ook een actieve deelnemer aan het Ultra Ethernet Consortium en draagt bij aan en implementeert de standaarden. UEC streeft ernaar een nieuwe generatie Ethernet te definiëren die geoptimaliseerd is voor AI, met de nadruk op efficiënte load balancing, verbeterde betrouwbaarheid en AI-specifieke congestiebeheersing. Naleving van deze open standaarden bevordert de interoperabiliteit en stimuleert een breder ecosysteem.
Ten slotte is de Pollara-technologie ontworpen voor synergetische werking binnen AMD's bredere platform, waardoor co-innovatie tussen CPU-, GPU- en netwerkkaartcomponenten mogelijk wordt. Dit omvat mogelijkheden zoals collectieve offload van bewerkingen, waarbij de netwerkkaart specifieke netwerkintensieve communicatietaken afhandelt (taken waarvoor geen GPU-berekening nodig is). Dit maakt GPU-bronnen vrij voor hun primaire verwerkingstaken.
ROCm 7: Een open software-ecosysteem voor geavanceerde AI
Aan de basis van deze hardware-innovaties staat de aankondiging van ROCm 7, de nieuwste evolutie van AMD's open softwareplatform, ontworpen om prestaties en toegankelijkheid te maximaliseren. De publieke preview staat vandaag gepland, voorafgaand aan de volledige release in augustus. AMD meldt dat ROCm 7 een verbluffende 3 tot 3.5 keer betere inferentie- en trainingsprestaties levert op bestaande hardware in vergelijking met zijn voorganger.
Voor zakelijke klanten lanceert AMD ROCm AI Enterprise, een uitgebreide suite met clusterbeheer, MLOps en tools voor applicatieontwikkeling voor grootschalige implementaties. Tegelijkertijd biedt AMD individuele ontwikkelaars toegang tot een nieuwe developer cloud, compleet met gratis GPU-credits om experimenten te stimuleren. Deze toegankelijkheidsambitie wordt nog verder uitgebreid met ROCm 7, dat de ondersteuning officieel uitbreidt naar clientapparaten, waaronder laptops en werkstations met Windows. Hierdoor kunnen ontwikkelaars naadloos AI-applicaties bouwen en testen in het gehele AMD-ecosysteem.
De weg voor ons
AMD streeft naar een snelle, jaarlijkse innovatiecyclus, met een productroadmap die verder gaat dan de MI350-serie.

Met het oog op een beoogde lancering in 2026 ontwikkelt AMD de MI400-serie, die de kern zal vormen van een volledig geïntegreerde oplossing op rackschaal met de codenaam Helios. Dit platform wordt specifiek ontworpen om geavanceerde AI-modellen te trainen en grootschalige gedistribueerde inferentietaken te beheren. Het Helios-systeem wordt een geïntegreerd AMD-platform, met toekomstige EPYC CPU's met de codenaam Venice, Instinct MI400 GPU's en de volgende generatie Pensando-netwerken, met name de Vulcano 800G AI NIC. Een uitgebreide ROCm-softwarestack, inclusief een speciale Fabric Manager voor geautomatiseerde implementatie en beheer, zal eveneens deel uitmaken van deze oplossing. Het Helios-rack, dat de nadruk legt op open standaarden, zal voldoen aan de OCP-specificaties. Het maakt gebruik van Ultra Ethernet (UEC) voor het opschalen van netwerken tussen racks en introduceert de Ultra Accelerator Link (UAL 1.0) voor het opschalen van de communicatie binnen één rack.

De Instinct MI400 GPU zelf is speciaal gebouwd voor AI-toepassingen op extreme schaal. Voorlopige specificaties duiden op indrukwekkende mogelijkheden, waaronder 40 PetaFLOPS FP4-prestaties en 20 PetaFLOPS FP8-prestaties. Elke GPU zal naar verwachting 432 gigabyte HBM-geheugen bevatten, goed voor ongeveer 20 TB/s HBM-geheugenbandbreedte, en een scale-out bandbreedte van 300 gigabit per seconde. Als aanvulling op de GPU is de Vulcano 800G AI NIC UEC-ready en ondersteunt UAL naast PCIe Gen6, waarbij UAL twee keer zoveel bandbreedte biedt als PCIe Gen6. Deze NIC zal naar verwachting tot acht keer meer scale-out bandbreedte per GPU bieden in vergelijking met de eerdere Polara-generatie. AMD heeft ambitieuze prestatiedoelen voor de Helios rackoplossing en verwacht dat deze tot tien keer meer AI-prestaties zal leveren op de meest geavanceerde frontiermodellen in vergelijking met de MI355. Helios wil in 2026, in tegenstelling tot Vera Rubin, concurrerende raw FLOPS, 50% meer HBM-capaciteit, 50% meer HBM-geheugenbandbreedte en tot 50% meer scale-outbandbreedte bieden.
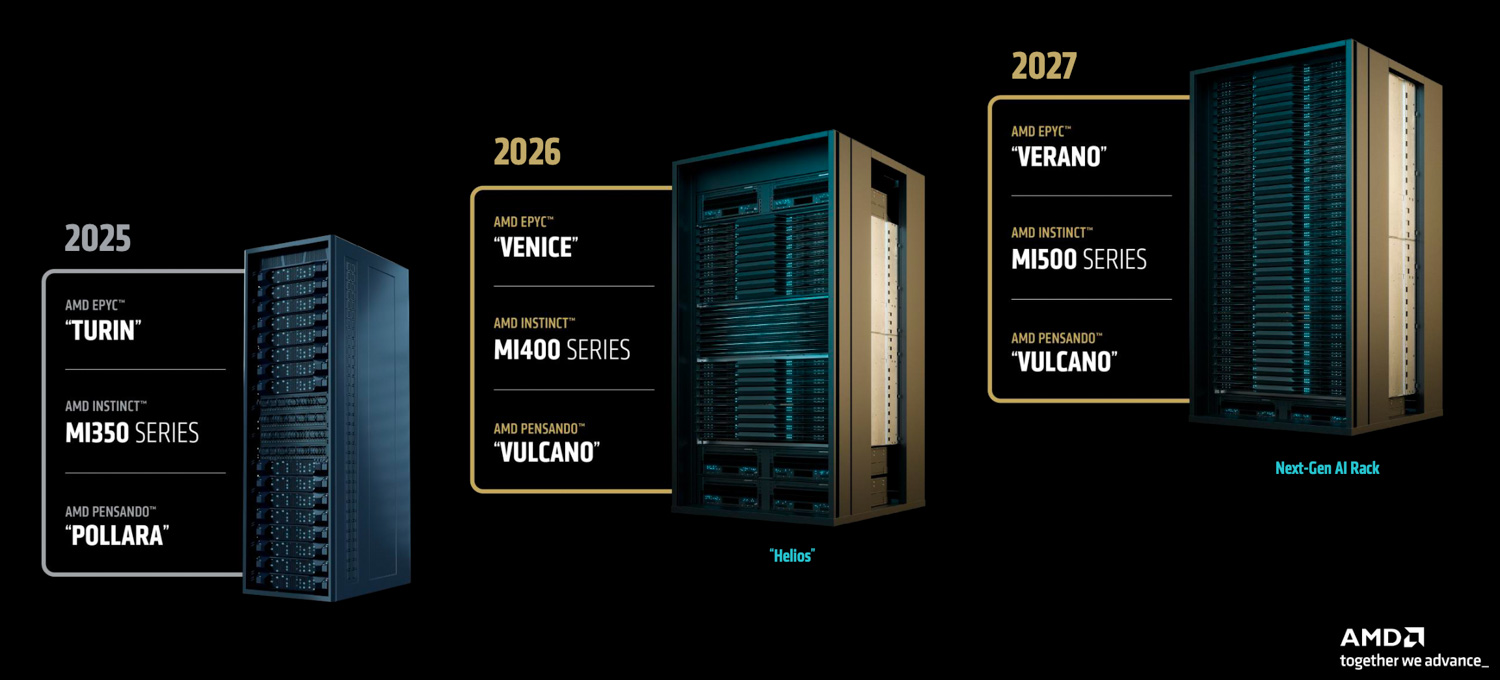
AMD's roadmap reikt nog verder, met de ontwikkeling van de MI500-serie en de daaropvolgende rack-scale architecturen die gepland staan voor 2027 en daarna. Deze toekomstige platforms zullen de MI500-serie integreren, samen met de volgende generatie EPYC CPU's met de codenaam Verano, en verdere ontwikkelingen in de Pensando-netwerktechnologie. Aanvullende informatie werd echter niet bekendgemaakt tijdens het evenement.


 Amazon