

Tijdens de RAISE Summit in Parijs benadrukte DDN de lopende samenwerking met Nebul, een Europese soevereine hybride cloudprovider, gericht op het verbeteren van de efficiëntie van grootschalige AI-inferentie-implementaties. Deze samenwerking, die vorige week werd aangekondigd, combineert het inferentieplatform van Nebul, de Infinia-data-intelligentiearchitectuur van DDN en NVIDIA Accelerated Computing om een groeiende beperking in AI-productieomgevingen aan te pakken: de kosten en prestatie-implicaties van het verplaatsen van data tijdens inferentie.
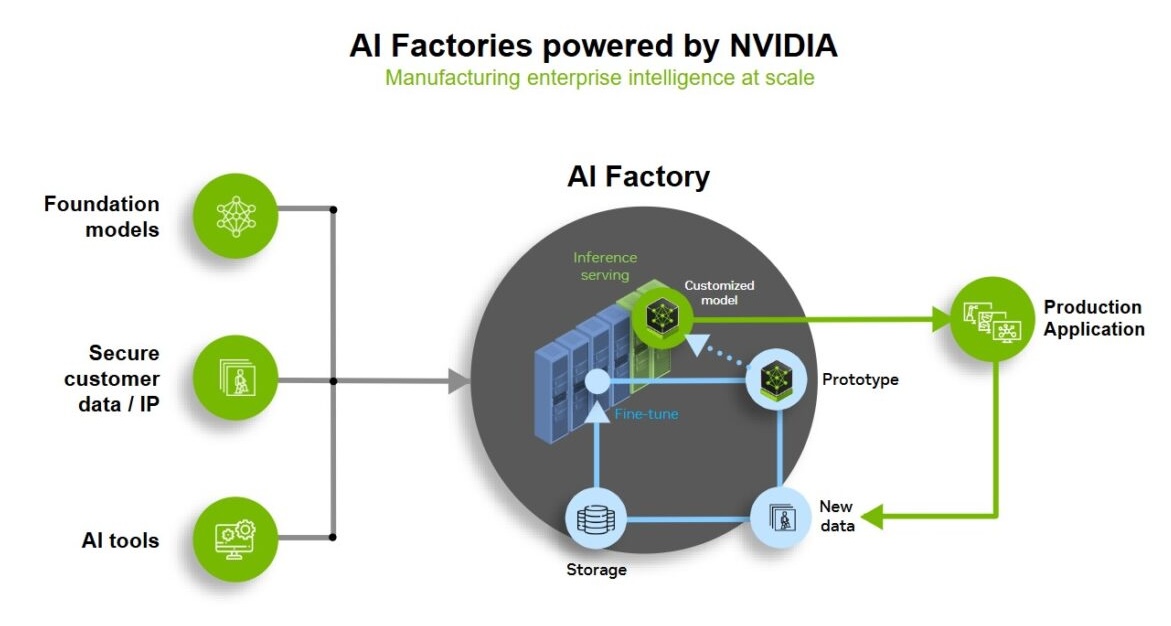
DDN baseert zijn werk op belangrijke productiemetrics, waaronder GPU-gebruik, tokendoorvoer, kosten per token en latentie. Het uitgangspunt is dat modeltraining de waarde van een AI-asset bepaalt, terwijl inferentie het operationele en commerciële rendement ervan bepaalt. Naarmate agentische AI, retrieval-augmented generation en high-concurrency inferentie vaker voorkomen, kunnen opslag- en data-infrastructuur de acceleratorbenutting en responstijd direct beïnvloeden.
Het project is een lopend proof-of-concept-project en DDN omschrijft de tot nu toe behaalde resultaten als veelbelovende vroege data. De bedrijven melden meetbare verbeteringen in de tijd tot de eerste token met ingeschakelde KV-cache en hebben de op RoCE gebaseerde infrastructuurvalidatie voltooid. De benchmarking wordt voortgezet met langere inferentiesequenties, terwijl ze verdere optimalisatiemogelijkheden binnen het Infinia-platform identificeren. Het project is tevens uitgebreid met een samenwerking met NVIDIA op het gebied van benchmarkingmethoden, schaalbaarheidsvalidatie en toekomstige technische publicaties.
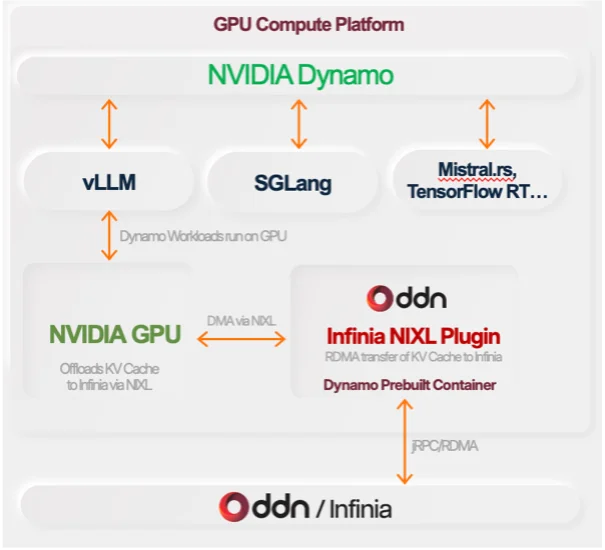
Het platform maakt gebruik van gedistribueerde KV-cacheservices, GPU-native dataverplaatsing, data-orkestratie en krachtige opslagarchitecturen. KV-cacheversnelling is met name relevant voor inferentie, omdat het de eerder berekende aandachtsstatus bewaart en snel ophaalt, waardoor herhaalde berekeningen worden verminderd en vertragingen in de dataoverdracht worden beperkt, waardoor GPU's minder vaak inactief zijn.
Leiderschap van DDN, Nebul en NVIDIA gaf een signaal af van een fundamentele verschuiving in de industrie: van de aanschaf van GPU's naar operationele efficiëntie, met de focus op het maximaliseren van de waarde van ingezette accelerators. DDN-CEO Alex Bouzari en Nebul-CEO Arnold Juffer benadrukten beiden dat, hoewel schaalvergroting van modellen historisch gezien de prioriteit had, de huidige uitdaging ligt in de economische aspecten van inferentie en het commercieel levensvatbaar maken van AI in productieomgevingen door lagere tokenkosten. Rod Evans, Vice President of Cloud Infrastructure bij NVIDIA, voegde eraan toe dat naarmate organisaties overstappen op grootschalige agentische workloads, het succes van de infrastructuur steeds vaker wordt gemeten aan de hand van GPU-gebruik en latentie in plaats van pure rekenkracht.
DDN stelt dat AI-infrastructuur verder moet evolueren dan conventionele opslagprocessen en een actieve rol moet gaan spelen in de uitvoering van AI. Het bedrijf zegt dat zijn platforms wereldwijd meer dan een miljoen GPU's ondersteunen, verspreid over hyperscalers, cloudproviders, bedrijven, overheden en onderzoeksinstellingen.
Voor infrastructuurteams omvatten de relevante productiemetrics steeds vaker:
- GPU-gebruik, waarbij wordt gemeten hoe effectief dure accelerators actief blijven tijdens inferentie.
- Kosten per tokenwaarbij de efficiëntie van de infrastructuur wordt gekoppeld aan de kosten van de modeluitvoer.
- Tokens per wattwaarbij de outputefficiëntie wordt gemeten ten opzichte van het stroomverbruik.
- Tijd tot het eerste token, wat van invloed is op de waargenomen responsiviteit van interactieve AI-toepassingen.
- De tijd die nodig is om AI-services van de testfase naar de productiefase te brengen, weerspiegelt de operationele inspanning die daarvoor nodig is. schaalbare implementatie.
Naarmate inferentie de dominante taak binnen AI wordt, zal het vermogen om gecachede context en bedrijfsgegevens met een lage, voorspelbare latentie naar GPU's te sturen steeds belangrijker worden voor het behoud van een optimale benutting en het beheersen van de kosten.


 Amazon