

WhiteFiber heeft de eerste onderzoeksresultaten bekendgemaakt van Project Redwood, een gedistribueerde GPU-superclusterarchitectuur die is ontworpen om te werken tussen geografisch gescheiden datacenters. De test, die vorige week werd aangekondigd, leverde een doorvoer van 111.2 Tbps op over 83 km aan ongebruikte glasvezel, met een gegarandeerde round-trip latency van 0.9 ms.
WhiteFiber gaf aan dat de latentie binnen 8% ligt van de fysieke voortplantingslimiet voor licht dat over die afstand door een glasvezel reist. Het bedrijf gebruikte slechts een deel van het beschikbare glasvezelspectrum in de test, een resultaat dat volgens hen al ongeveer twee keer zo hoog is als de capaciteit van vergelijkbare gepubliceerde veldproeven met het volledige spectrum. Het bedrijf is van plan het volledige spectrum te benutten vóór een beoogde commerciële lancering in het derde kwartaal van 2026.
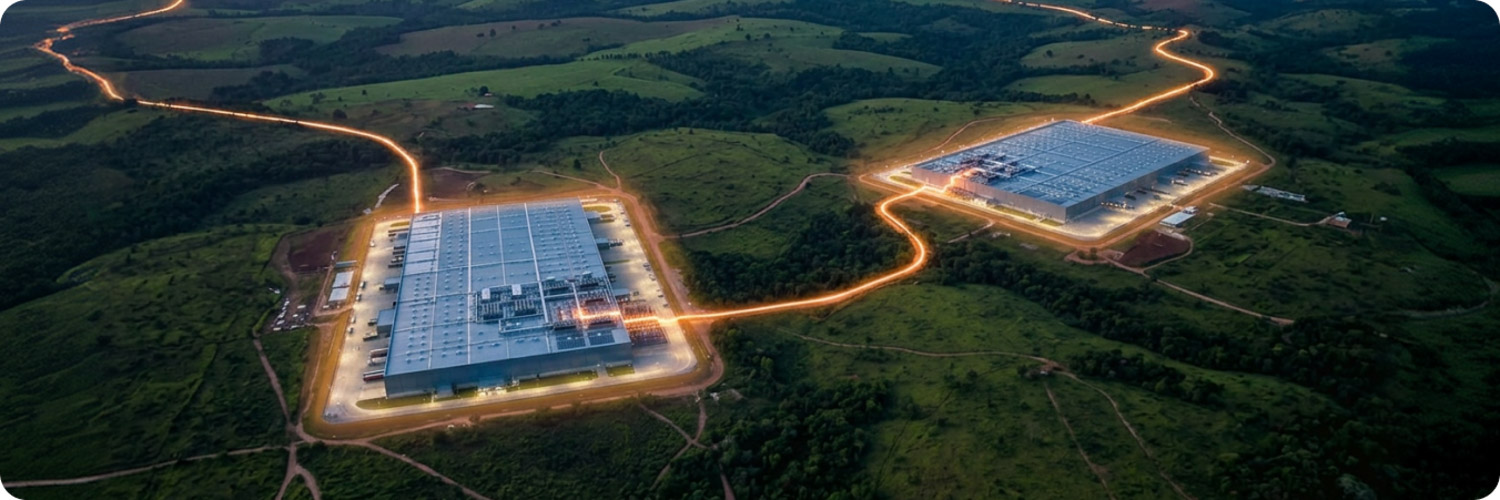
Het project werd uitgevoerd in samenwerking met DriveNets en WEKA. DriveNets verzorgt de op Ethernet gebaseerde AI-infrastructuur tussen de verschillende faciliteiten, terwijl WEKA NeuralMesh de opslag- en geheugeninfrastructuur levert die het cluster omvat. WhiteFiber heeft octrooiaanvragen ingediend met betrekking tot de implementatie.
Meerdere locaties behandelen als één GPU-cluster
De architectuur is bedoeld om twee datacenters te laten functioneren als één logisch GPU-supercluster, in plaats van twee onafhankelijk werkende clusters die via een conventionele DCI-link met elkaar verbonden zijn. Dit onderscheid is belangrijk voor AI-trainings- en inferentieworkloads, waarbij GPU-naar-GPU-synchronisatie, collectieve bewerkingen en toegang tot een gedeelde data-infrastructuur bepalend kunnen zijn voor de bruikbare schaal van het cluster.
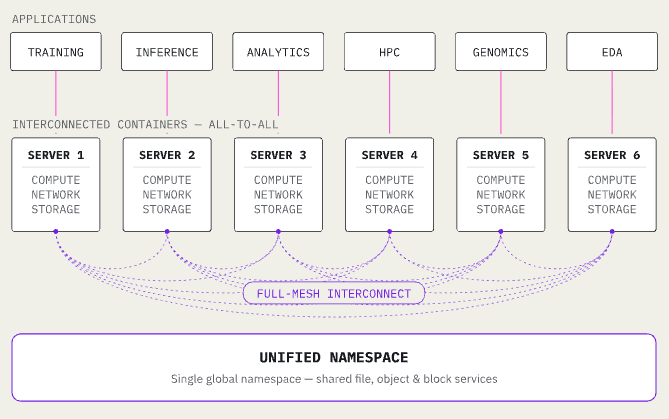
WhiteFiber positioneert het platform voor workloads die de beschikbare stroom, koeling, ruimte, redundantie of data-soevereiniteitseisen van een enkele locatie overstijgen. Het bedrijf ziet ook toepassingen in edge computing, telecommunicatie en soevereine AI-implementaties.
In de bijbehorende aankondiging van DriveNets wordt de hardware beschreven: het netwerk verbindt twee WhiteFiber NVIDIA H200 GPU-clusters die 52 kilometer van elkaar verwijderd zijn. DriveNets omschrijft de implementatie als het eerste commerciële, schaalbare AI-supercluster over lange afstanden in de branche, dat gevalideerd is op productieschaal in plaats van in een laboratorium. Als onderdeel van de validatie vergeleken de bedrijven de prestaties van rack tot rack binnen één locatie met de prestaties van rack tot rack over de twee locaties. De methodologie wordt in detail beschreven in de whitepaper van DriveNets.
DriveNets Stoffenontwerp
De inter-site-omgeving maakt gebruik van redundante dark fiber en DriveNets AI Fabric voor het transport van GPU- en opslagverkeer. DriveNets omschrijft de architectuur als een gepland Ethernet-netwerk dat is ontworpen voor voorspelbare, gedistribueerde AI-communicatie, in plaats van een traditionele langeafstands-Ethernet-uitbreiding.
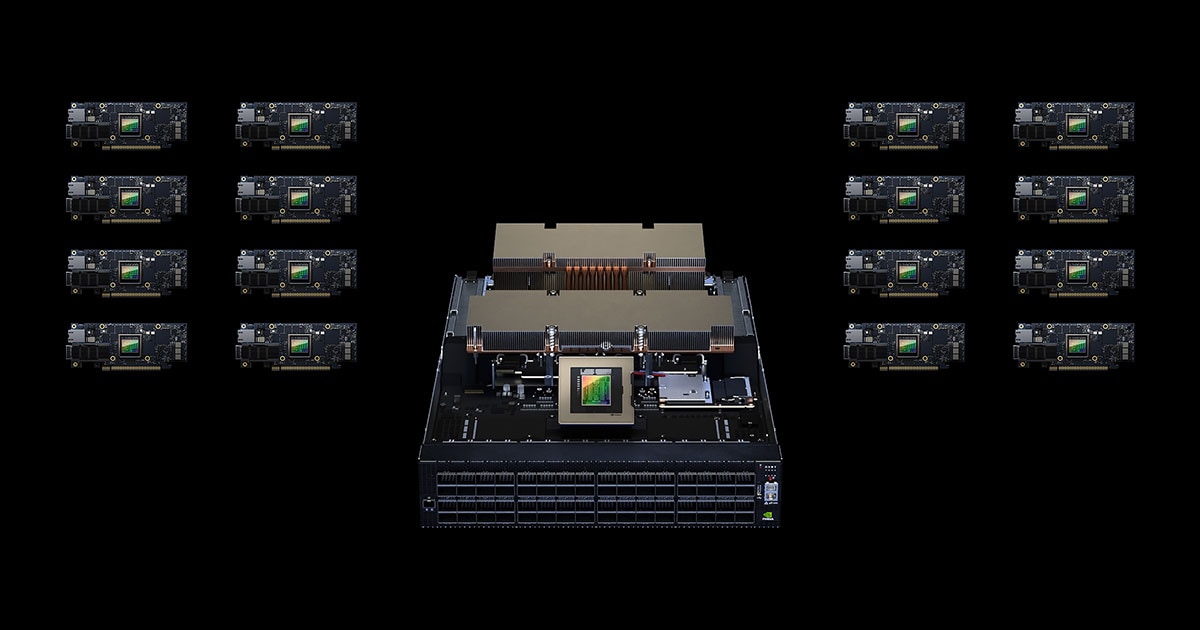
Het ontwerp breidt de AI-infrastructuur uit over meerdere locaties met behulp van DriveNets' Fabric Scheduled Ethernet-technologie, die draait op de 9300F-, 5300R- en 5301R-switches. Deze aanpak combineert load balancing op celniveau, end-to-end Virtual Output Queuing en interconnecties met diepe buffers die gesynchroniseerde AI-verkeerspieken opvangen voordat ze congestie op de verbindingen tussen de locaties veroorzaken. DriveNets stelt dat het resultaat voorspelbare, verliesvrije connectiviteit tussen locaties is, waardoor het GPU-gebruik hoog blijft, alsof het hele cluster zich onder één dak bevindt.
Gezamenlijk zijn deze mechanismen erop gericht om voorspelbaar gedrag te behouden voor collectieve communicatie over afstand, terwijl ze tegelijkertijd een uniforme reken- en opslaginfrastructuur ondersteunen. Isolatie tussen meerdere tenants maakt deel uit van de gestelde ontwerpdoelstelling.
Het resultaat is een architectuur die de glasvezelverbinding beschouwt als onderdeel van een AI-infrastructuur, en niet simpelweg als een transportverbinding tussen locaties. Het doel is om de operationele betekenis van de fysieke datacentergrens voor workloads die over het cluster draaien te verminderen.
Een andere aanpak dan NVIDIA Spectrum-XGS
Het testplatform van WhiteFiber verschilt van NVIDIA Spectrum-XGS Ethernet. Het werk sluit echter wel aan bij de bredere trend in de industrie om AI-infrastructuur op grote schaal te implementeren.
Tijdens Hot Chips 2025 beschreef NVIDIA CEO Jensen Huang de noodzaak om datacenters in steden, landen en continenten met elkaar te verbinden om grootschalige AI-fabrieken te creëren. NVIDIA's Spectrum-XGS-aanpak maakt gebruik van afstandsbewuste congestiecontrole, nauwkeurig latencybeheer en telemetrie om de voorspelbaarheid van gedistribueerde GPU-communicatie te verbeteren. CoreWeave is een van de eerste gebruikers die door NVIDIA is genoemd.
WhiteFiber heeft meer specifieke testresultaten uit de beginfase van de Spectrum-XGS-implementaties verstrekt dan NVIDIA zelf openbaar heeft gemaakt. De test over een afstand van 83 km leverde een bandbreedte van 111.2 Tbps en een round-trip latency van 0.9 ms op, hoewel de systemen verschillende architecturen gebruiken en de resultaten daarom niet direct vergelijkbaar zijn.
Gedistribueerde training gaat verder dan één enkele locatie.
De aankondiging van WhiteFiber komt op een moment dat andere cloud- en infrastructuurproviders onderzoek doen naar AI-trainings- en inferentiearchitecturen voor meerdere locaties.
Oracle Cloud Infrastructure en NVIDIA hebben onderzoek gepubliceerd waarin ze het NeMo Framework en Megatron-Core gebruiken om LLM-trainingen uit te voeren tussen datacenters die ongeveer 1,000 km van elkaar verwijderd zijn. NVIDIA rapporteerde een schaalbaarheid van de training van meer dan 96% door middel van hiërarchische all-reduce en chunked communicatie tussen datacenters. Dit onderzoek betreft voornamelijk een demonstratie van software en systemen, en geen benchmark voor transport op metropoolniveau.
Google heeft ook TPU Multislice ontwikkeld, waarmee meerdere TPU-slices kunnen functioneren als een grotere, gedistribueerde trainingsomgeving verspreid over het datacenternetwerk en de optische interconnecties. Google heeft aangegeven dat de Gemini-training gebruikmaakte van meerdere datacenters, waarbij het platform is ontworpen om de werklastverdeling en de veerkracht op grote schaal te beheren.
WhiteFiber streeft ernaar een vergelijkbaar cross-site ontwerp toe te passen op GPU-cloudinfrastructuur, met een specifieke focus op metroverbindingen met hoge bandbreedte en lage latentie. Het bedrijf is van plan om meer details over de architectuur en beschikbaarheid te verstrekken naarmate de commerciële uitrol in het derde kwartaal van 2026 vordert.


 Amazon