

Tijdens Google Cloud Next kondigde Google zijn volgende generatie AI-acceleratoren aan: de TPU 8t "Sunfish" voor training en de TPU 8i "Zebrafish" voor inferentie, samen met zijn nieuwe Virgo-datacenterinfrastructuur. Uit de blogposts van Google blijkt duidelijk dat deze chips geoptimaliseerd zijn voor "het agentische tijdperk": het trainen van geavanceerde mix-of-experts-modellen op een schaal van honderdduizenden chips, en vervolgens het leveren van diezelfde modellen met lage latentie en agressieve prijs-per-token-doelstellingen. De 8t en 8i zijn twee architectonisch verschillende chips die een hostplatform en een infrastructuur delen, maar verschillen in geheugencapaciteit, on-chip SRAM, interconnect-topologie en on-die-specialisatie. De 8t is gebouwd voor dichte matrixvermenigvuldiging (matmul) op grote schaal, terwijl de 8i is gebouwd rond KV-cache op silicium en collectieve latentie per token.
Een enkele 8t superpod schaalt op tot 9,600 chips, bevat 2 PB HBM en levert 121 EFLOPS aan FP4-rekenkracht, bijna 3x de rekenkracht per pod van een Ironwood superpod. 8i combineert 288 GB HBM met 384 MB on-chip SRAM (3x Ironwood) binnen een schaalbaar domein van 1,152 chips en claimt 80% betere prestaties per dollar dan Ironwood voor LLM-inferentie. Virgo verbindt beide chipfamilies in één datacenter-fabric die meer dan 134,000 8t-chips koppelt met een niet-blokkerende bisection-bandbreedte van 47 Pb/s, met tot 4x de bandbreedte per accelerator en 40% lagere onbelaste latentie dan de vorige generatie.
Wat een TPU eigenlijk is
Voordat we ingaan op de 8 siliciumchips, eerst wat achtergrondinformatie over wat een TPU is en hoe deze verschilt van een GPU, want de ontwerpkeuzes van de 8 zijn alleen te begrijpen in die context.
Een Tensor Processing Unit (TPU) is een op maat gemaakte ASIC waar Google sinds 2015 aan werkt. Elke generatie is gebouwd rond hetzelfde kernidee: in plaats van duizenden kleine cores dynamisch in te plannen, zoals een GPU doet, is een TPU gebaseerd op een klein aantal zeer grote MXU's (matrix multiply units), gevoed door een on-chip, softwarematig beheerd SRAM-scratchpad en aangestuurd door een ahead-of-time compiler. Elke chip bevat een handvol TensorCores, elk gebouwd rond een grote MXU met systolische array, plus een kleinere set SparseCores die zijn toegewijd aan de onregelmatige gather-scatter lookups die dominant zijn in aanbevelings-embeddings. Data stroomt van HBM via het scratchpad, via de MXU, terug naar het scratchpad en weer naar buiten, waarbij een Vector Processing Unit tegelijkertijd activaties, normalisaties en reducties afhandelt. Er is geen hardwarematige warp scheduler, geen L1- of L2-cachehiërarchie zoals bij een GPU, en geen dynamische dispatch.
Het voordeel van dit ontwerp is de efficiëntie in dichte lineaire algebra. Doordat een ahead-of-time compiler bepaalt waar elke tensor zich bevindt en wanneer elke collective wordt uitgevoerd, is er geen cache-miss jitter en geen belasting voor de warp-scheduler. Dit is belangrijker dan het lijkt wanneer tienduizenden chips gesynchroniseerd moeten blijven via een collective. Het FLOP-gebruik van realistische modellen op TPU's voor goed afgestelde trainingsworkloads is doorgaans hoger dan op traditionele GPU's. Het nadeel is dat alles wat niet netjes kan worden gemapt naar grote, dichte matrixen, met name dynamische vormen, onregelmatige sparse patronen, MoE-routing met ongelijke tokenverdeling of grafische neurale netwerken, moeilijker efficiënt te implementeren is. TPU's hebben historisch gezien ook minder HBM per chip dan hun GPU-tegenhangers en hebben een veel beperktere frameworkondersteuning. XLA en JAX zijn eersteklas frameworks; PyTorch vereiste tot voor kort een vertaallaag; bovendien blijven de compiler, runtime, netwerkbibliotheken en de multi-pod softwarestack closed source binnen Google.
Sparsiteit is het duidelijkste voorbeeld van de filosofische kloof tussen GPU's en TPU's, en de reden hiervoor is eerder structureel dan marketinggericht. NVIDIA ondersteunt al sinds Ampere 2:4 gestructureerde sparsiteit op Tensor Cores, en in theorie zijn de prestaties voor sparse workloads twee keer zo hoog als voor dense workloads. Een Tensor Core is in principe een dispatch unit: het ontvangt expliciete operand-loads per MMA-instructie, dus het toevoegen van een sparse MMA-variant die een gecomprimeerd 2-uit-4-blok plus indexmetadata accepteert, is een eenvoudige uitbreiding van de bestaande instructieset. Elke cyclus haalt de hardware alleen de niet-nulwaarden en hun indexen in de multiplier-array, waarbij de nullen impliciet worden overgeslagen.
Een systolische array werkt precies andersom. Elk verwerkingselement (PE) voert elke cyclus een berekening uit, waarbij operanden synchroon door de array stromen via directe register-naar-register-paden van het ene PE naar het volgende. Deze deterministische dataflow is precies waar het energiezuinigheidsvoordeel ten opzichte van SIMT vandaan komt: geen herhaalde SRAM-leesbewerkingen, geen overhead bij het verzenden van instructies en maximaal hergebruik van operanden. Maar het betekent ook dat de hardware geen element met waarde nul per cyclus kan overslaan zonder de pipeline te onderbreken.

Bron: Google
TPU's kunnen nog steeds gebruikmaken van sparse data op tegelniveau; als een hele tegel van MXU-formaat alleen uit nullen bestaat, plant de compiler er geen werk op in. Google heeft er echter bewust voor gekozen om geen hardwareversnelling voor gestructureerde sparse data toe te voegen. Het toevoegen van M:N gestructureerde sparse data aan een systolische array kan met verschillende technieken, elk met verschillende afwegingen, worden bereikt. Een van die technieken vereist een compressie-eenheid tussen het SRAM en de ingangspoorten van de array. Maar een systolische array is een pipeline, geen dispatcher. De efficiëntiegarantie komt voort uit het feit dat operanden in een deterministisch tempo binnenkomen, waarbij elk verwerkingselement elke cyclus bezig is. Het toestaan van het overslaan van operanden brengt twee kosten met zich mee. Ofwel blokkeert de pipeline op de nullen, wat het efficiëntievoordeel tenietdoet dat de architectuur in eerste instantie motiveerde. Ofwel voegt u speciale decompressiehardware toe om een stream met volledige breedte te reconstrueren uit de gecomprimeerde invoer voordat deze de array binnenkomt, wat chipoppervlak in beslag neemt en latentie toevoegt.
Bron: AWS
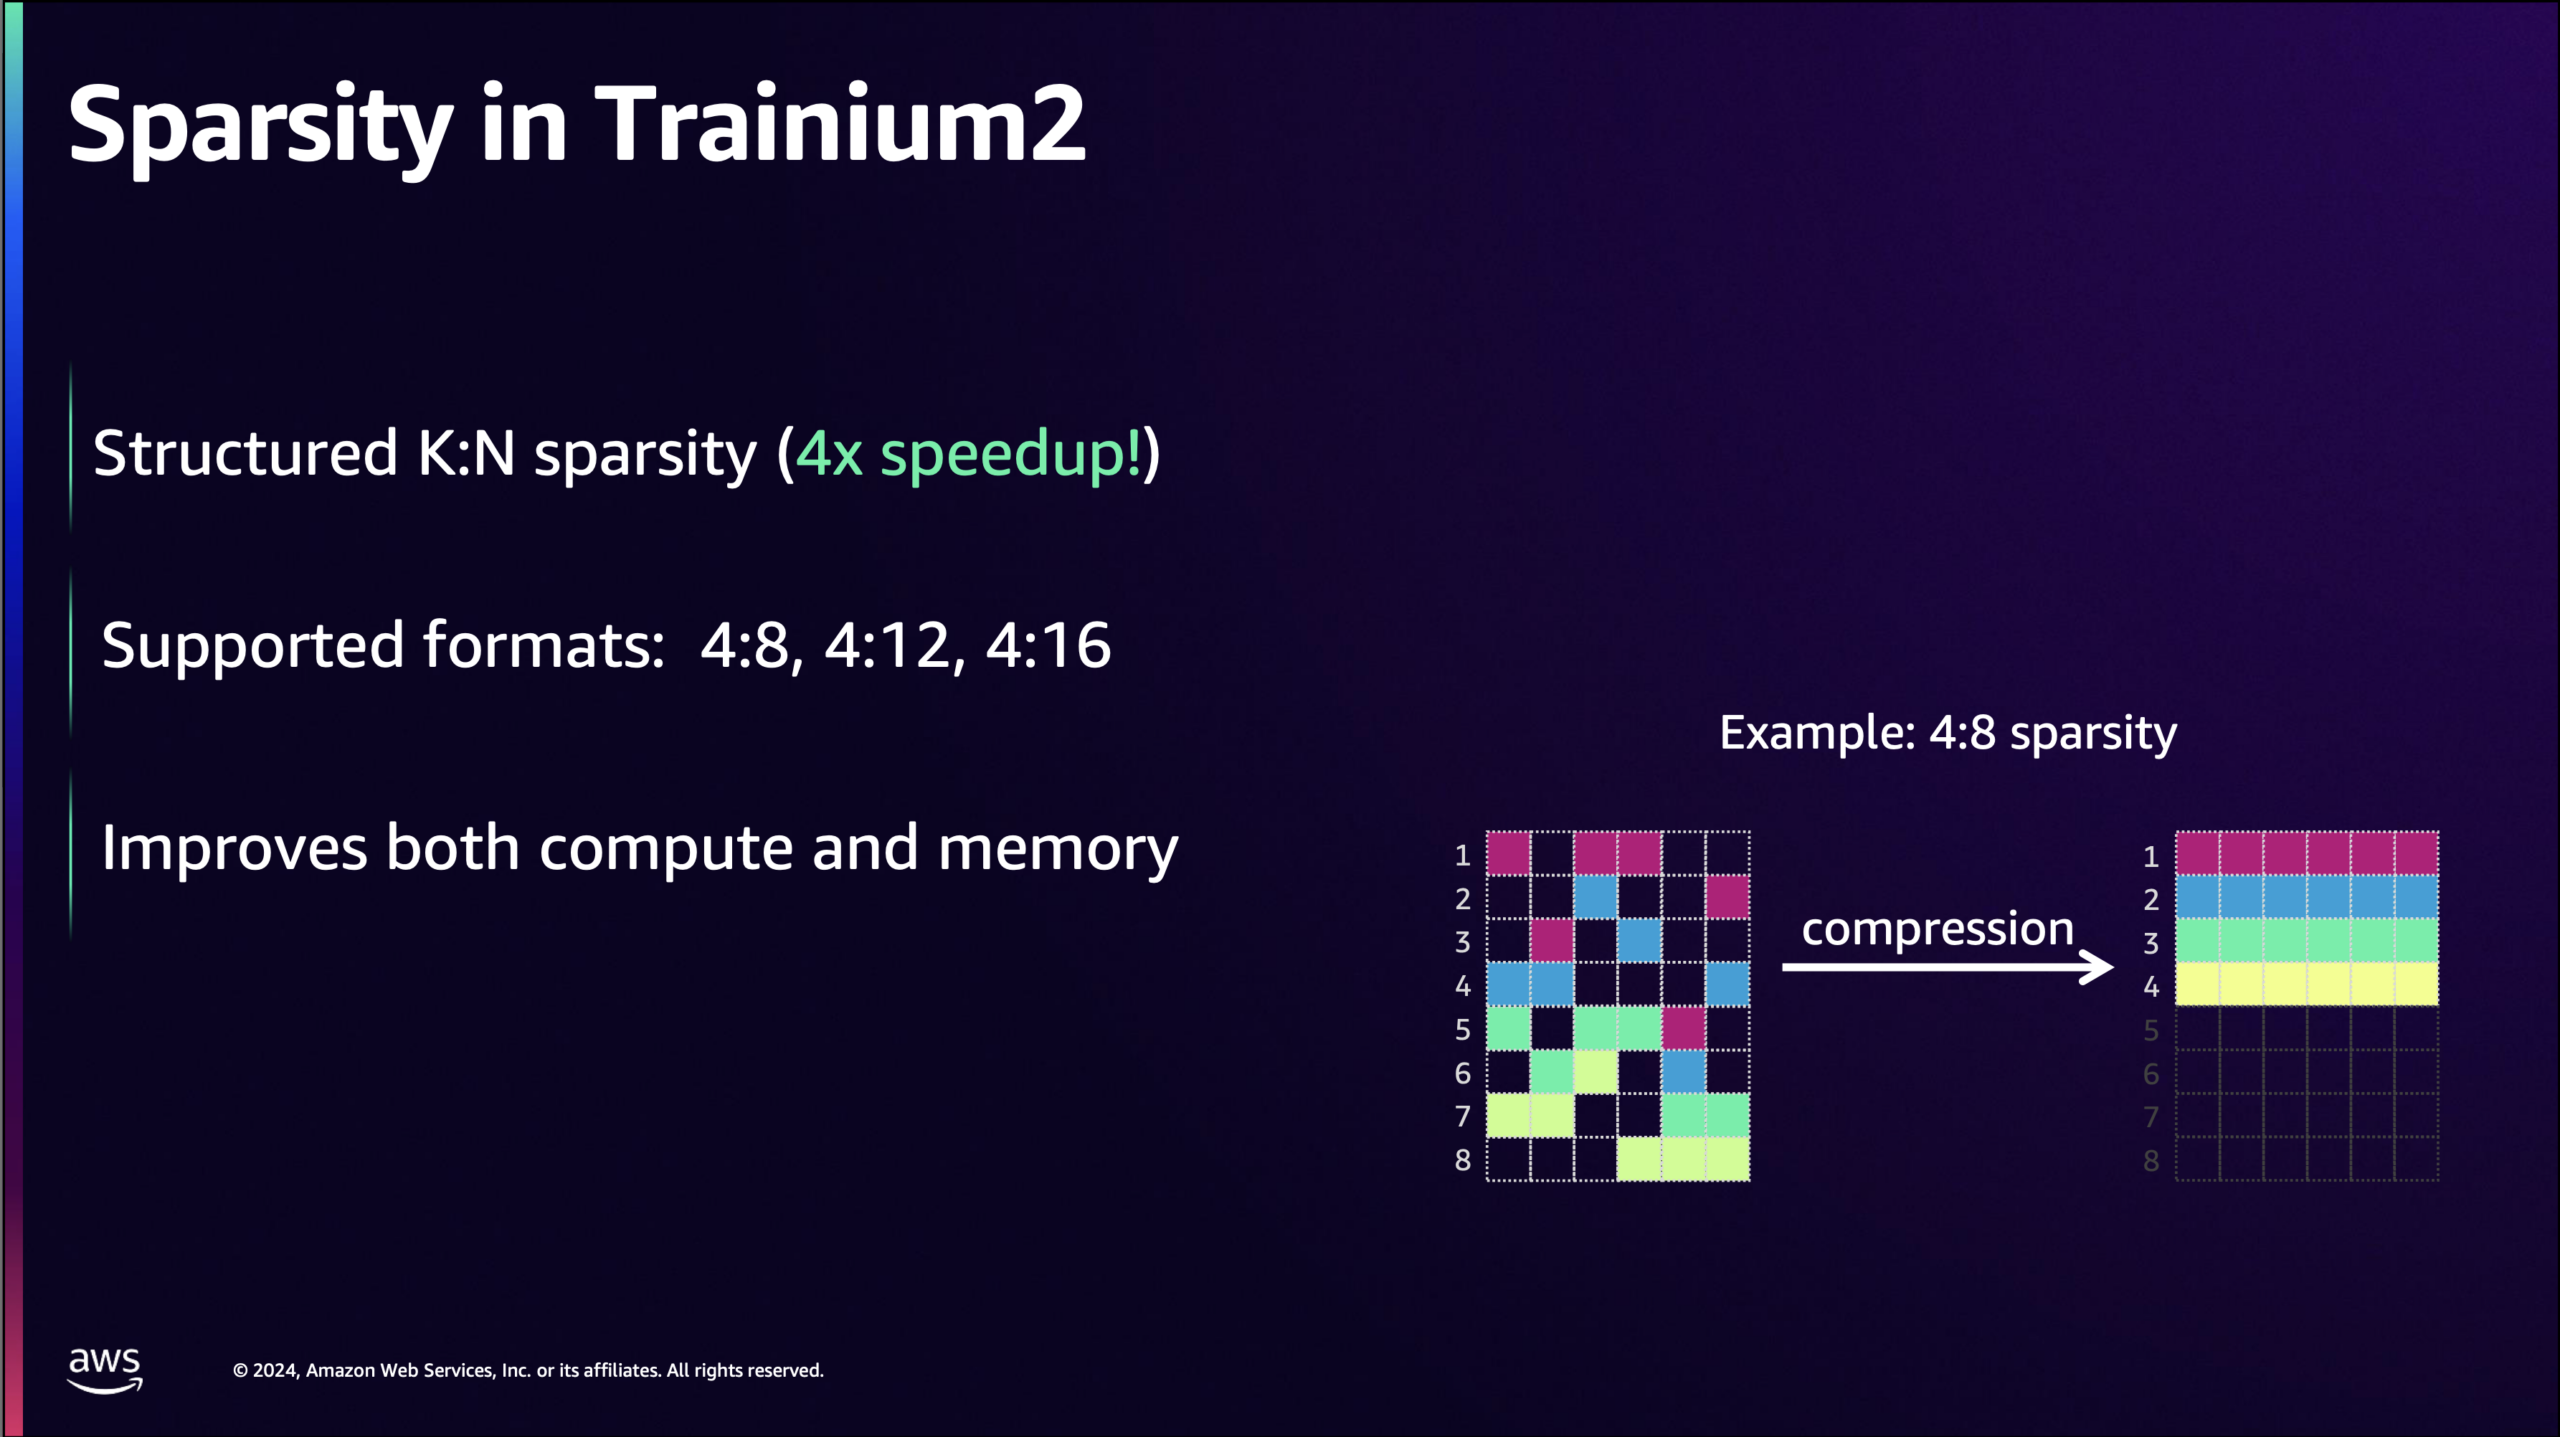
Sommige accelerators combineren systolische arrays met hardwareondersteuning voor sparse data. AWS heeft er een gebouwd, beginnend met NeuronCore-v3, de engine in Trainium2 en Trainium3. De implementatie laat zien hoe een hardware-sparse systolische array eruitziet. De NeuronCore-v3 Tensor Engine is een 128×128 systolische array die werkt met een stationaire gewichtsmatrix en een streaming activatiematrix, waarbij de contractiedimensie is uitgelijnd met de partitiedimensie van de array. In sparse modus wordt het invoerdatapad breder van 2×128 elementen per cyclus op dense BF16 en FP16 naar 5×128 elementen per cyclus, en de stationaire zijde wordt gevoed vanuit een gecomprimeerde representatie van de gewichtsmatrix in plaats van de oorspronkelijke dense gewichten. Tijdens het compileren wordt de gewichtstensor verwerkt tot een M:N-formaat. Van elke N aaneengesloten elementen langs de contractiedimensie worden er slechts M behouden, waarbij een compact bitmasker codeert welke posities niet nul zijn. De gecomprimeerde buffer slaat alleen de M waarden op en krimpt met een factor N/M. Wanneer de matmul-instructie wordt uitgevoerd, leest de hardware de gecomprimeerde gewichten en gebruikt het bitmasker om de corresponderende activaties van de stationaire tegel naar de juiste verwerkingselementen te routeren. Verwerkingselementen die met nul zouden vermenigvuldigen, ontvangen geen werk voor die sleuf. Omdat het opzoeken van het bitmasker en de routering plaatsvinden in de decompressor die de array voedt, in plaats van in de array zelf, blijft de pipeline op volle doorvoer draaien bij niet-nulwaarden in plaats van te stagneren bij nullen.
Dichte matrixvermenigvuldiging is niet het enige wat een TPU doet. TPU's bevatten al generaties lang naast de TensorCores ook een SparseCore. SparseCore is een domeinspecifieke engine die is ontworpen voor de onregelmatige gather-scatter-toegangspatronen die kenmerkend zijn voor aanbevelingsmodellen. Een YouTube-rankingmodel of een relevantiemodel voor zoekadvertenties lijkt niet op een dense transformer. De meeste parameters bevinden zich in embeddingtabellen die kunnen variëren van honderden gigabytes tot petabytes, en het grootste deel van de rekentijd wordt besteed aan het uitvoeren van kleine zoekopdrachten in die tabellen, het licht transformeren van de opgehaalde waarden en het combineren van de resultaten. Dat toegangspatroon is een worstcasescenario voor een MXU en slechts marginaal beter voor de cachehiërarchie van een GPU. SparseCores zijn hier precies op afgestemd: snelle gather-scatter-bewerkingen op HBM-embeddingtabellen, met hardwareondersteuning voor de deduplicatie- en combineerbewerkingen waar de rest van de embeddingpipeline van afhankelijk is. Dezelfde hardware helpt ook bij MoE-expertroutering, omdat, zodra de top-k-selectie expertindexen oplevert, de rest van het routeringsproces (het permuteren van tokens op basis van de expert, het verdelen ervan over de chips, het verzamelen van de expertuitvoer en het uitvoeren van de gewogen reductie) hetzelfde verzamel-/verspreid-/reduceerpatroon volgt als de embedding-pipeline, waarbij de sorteerondersteuning van SparseCore de top-k-stap zelf afhandelt.
Met die achtergrond volgen hier de aankondigingen.
TPU 8t “Sunfish”
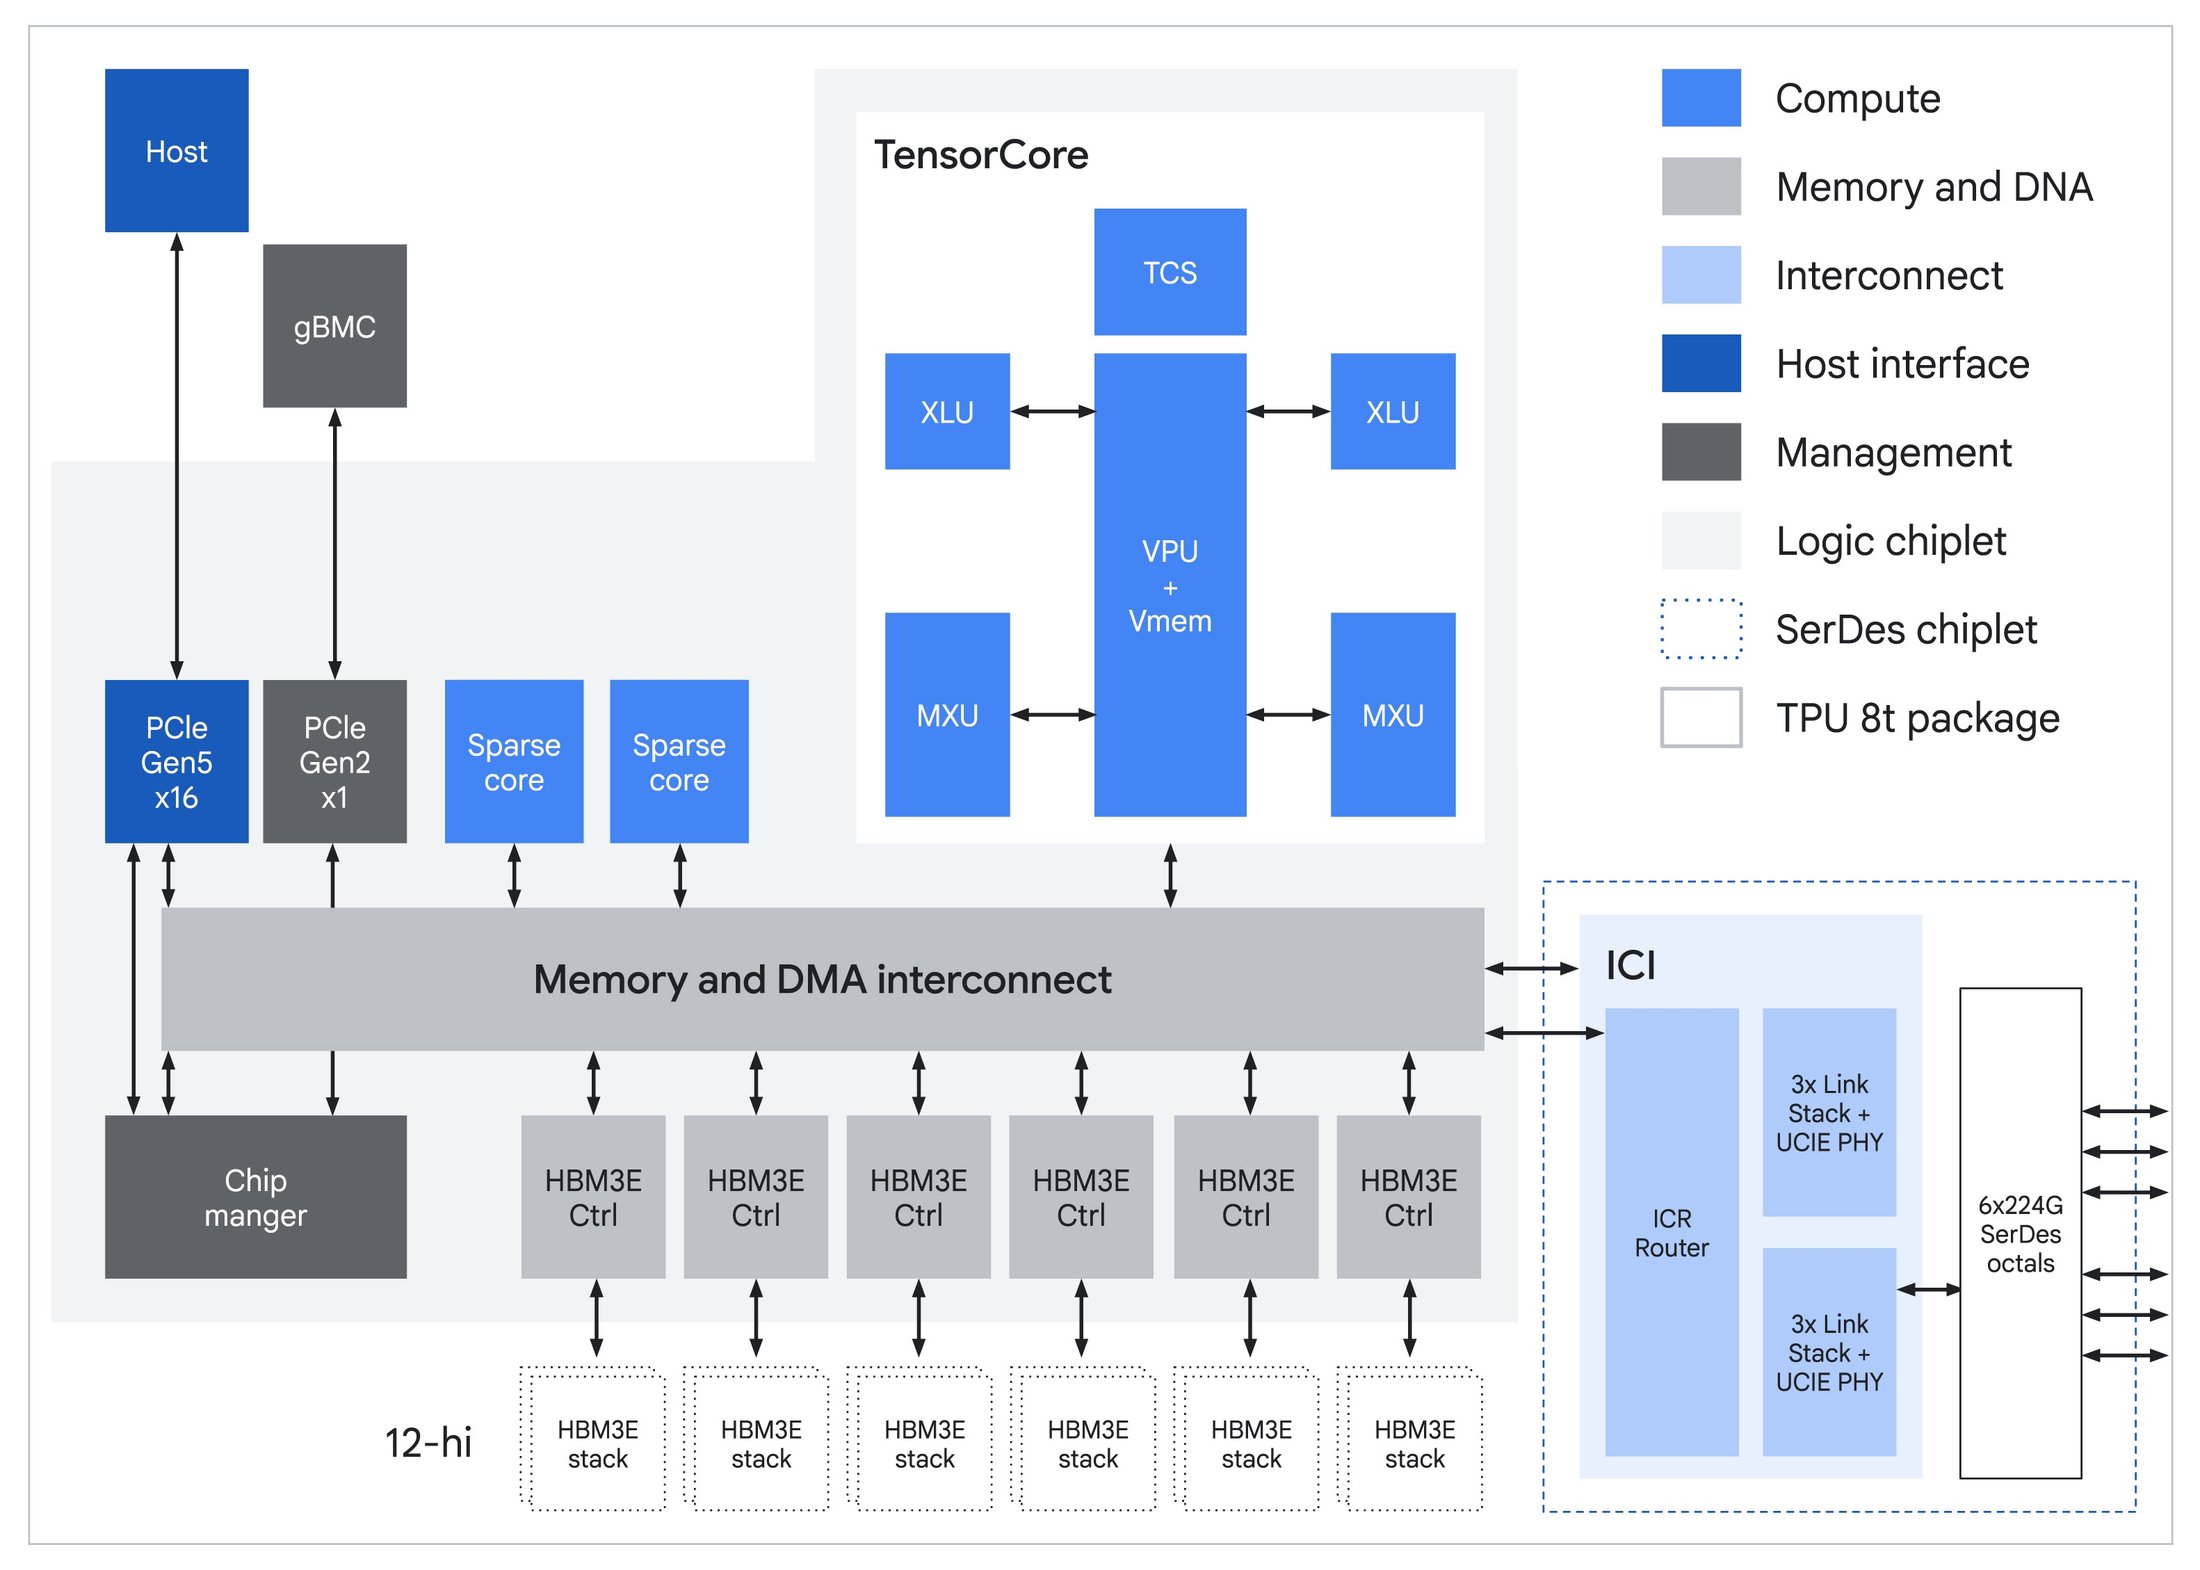
De eerste aankondiging betreft de TPU 8t met de codenaam Sunfish, de chip voor trainingen. Deze generatiewissel ten opzichte van Ironwood volgt grotendeels het verwachte traject: meer geheugen, meer bandbreedte en native ondersteuning voor een beperkter aantal gegevenstypen. Elke chip bevat een enkele TensorCore, gevoed door zes 12-Hi HBM3e-stacks met een totaal van 216 GB en een bandbreedte van 6.5 TB/s, een verbetering ten opzichte van de 192 GB verdeeld over acht stacks van Ironwood. Het on-chip Vmem SRAM blijft 128 MB.
De native FP4-ondersteuning in de MXU zorgt voor de grootste sprong in rekenkracht. Door matrixvermenigvuldigingen in 4-bits in plaats van 8-bits uit te voeren, wordt de doorvoer per cyclus verdubbeld voor dezelfde fysieke array. Zo is Google van Ironwood's 4.6 PFLOPS FP8 naar 8t's 12.6 PFLOPS FP4 gekomen. Bij training met gemengde precisie wordt nog steeds een FP32-hoofdkopie van de gewichten bewaard voor de optimalisatiestap; FP4 verkleint de werkende tensors die het grootste deel van de rekentijd in beslag nemen.
Bron: Google
Het verhaal achter de interconnectie is eenvoudig. De bandbreedte van ICI verdubbelt naar 19.2 Tb/s per chip, de superpod met 9,600 chips bundelt 2 PB HBM en 121 EFLOPS, en de 3D-torustopologie blijft behouden. De torus is logisch voor training omdat de meest geavanceerde taken worden gedomineerd door ringvriendelijke collectieven: all-reduces voor data- en tensorparallellisme, all-gathers en reduce-scatters voor FSDP, en pipeline-parallelle point-to-point-verzendingen. Al deze taken kunnen netjes worden toegewezen aan de torusassen.
Google behoudt ook de SparseCores die sinds versie 4 op elke TPU zijn meegeleverd. Hun oorspronkelijke doel was het ontwikkelen van aanbevelingsmodellen in DLRM-stijl, waarbij de meeste rekentijd wordt besteed aan onregelmatige gather-scatter-bewerkingen op basis van enorme embedding-tabellen. Dezelfde hardware verzorgt ook MoE-routing. JAX biedt ragged all-to-all en een bijbehorende ragged_dot als eersteklas bewerkingen, waarbij elke chip een chunk van een andere grootte naar elke peer kan sturen. Dit komt overeen met de daadwerkelijke structuur van MoE-dispatch, omdat top-k-routing data-afhankelijk is en het aantal tokens dat naar elke expert stroomt bij elke stap varieert. De compiler combineert de onregelmatige communicatie en de onregelmatige expert-matrixvermenigvuldiging tot één geplande bewerking, terwijl SparseCore de omliggende sortering en permutatie afhandelt. Nu mixture-of-experts de dominante architectuur is in grensverleggende modellen, bewijst deze hardware zijn waarde bij elke moderne trainingstaak, niet alleen bij de advertentie- en rankingworkloads waarvoor het oorspronkelijk is ontworpen.
Dit zijn evolutionaire stappen. De grotere veranderingen zijn TPUDirect en de overstap naar op Axion gebaseerde hosts, die beide knelpunten aanpakken die pas op grote schaal aan het licht komen.
TPUDirect RDMA en TPUDirect Storage
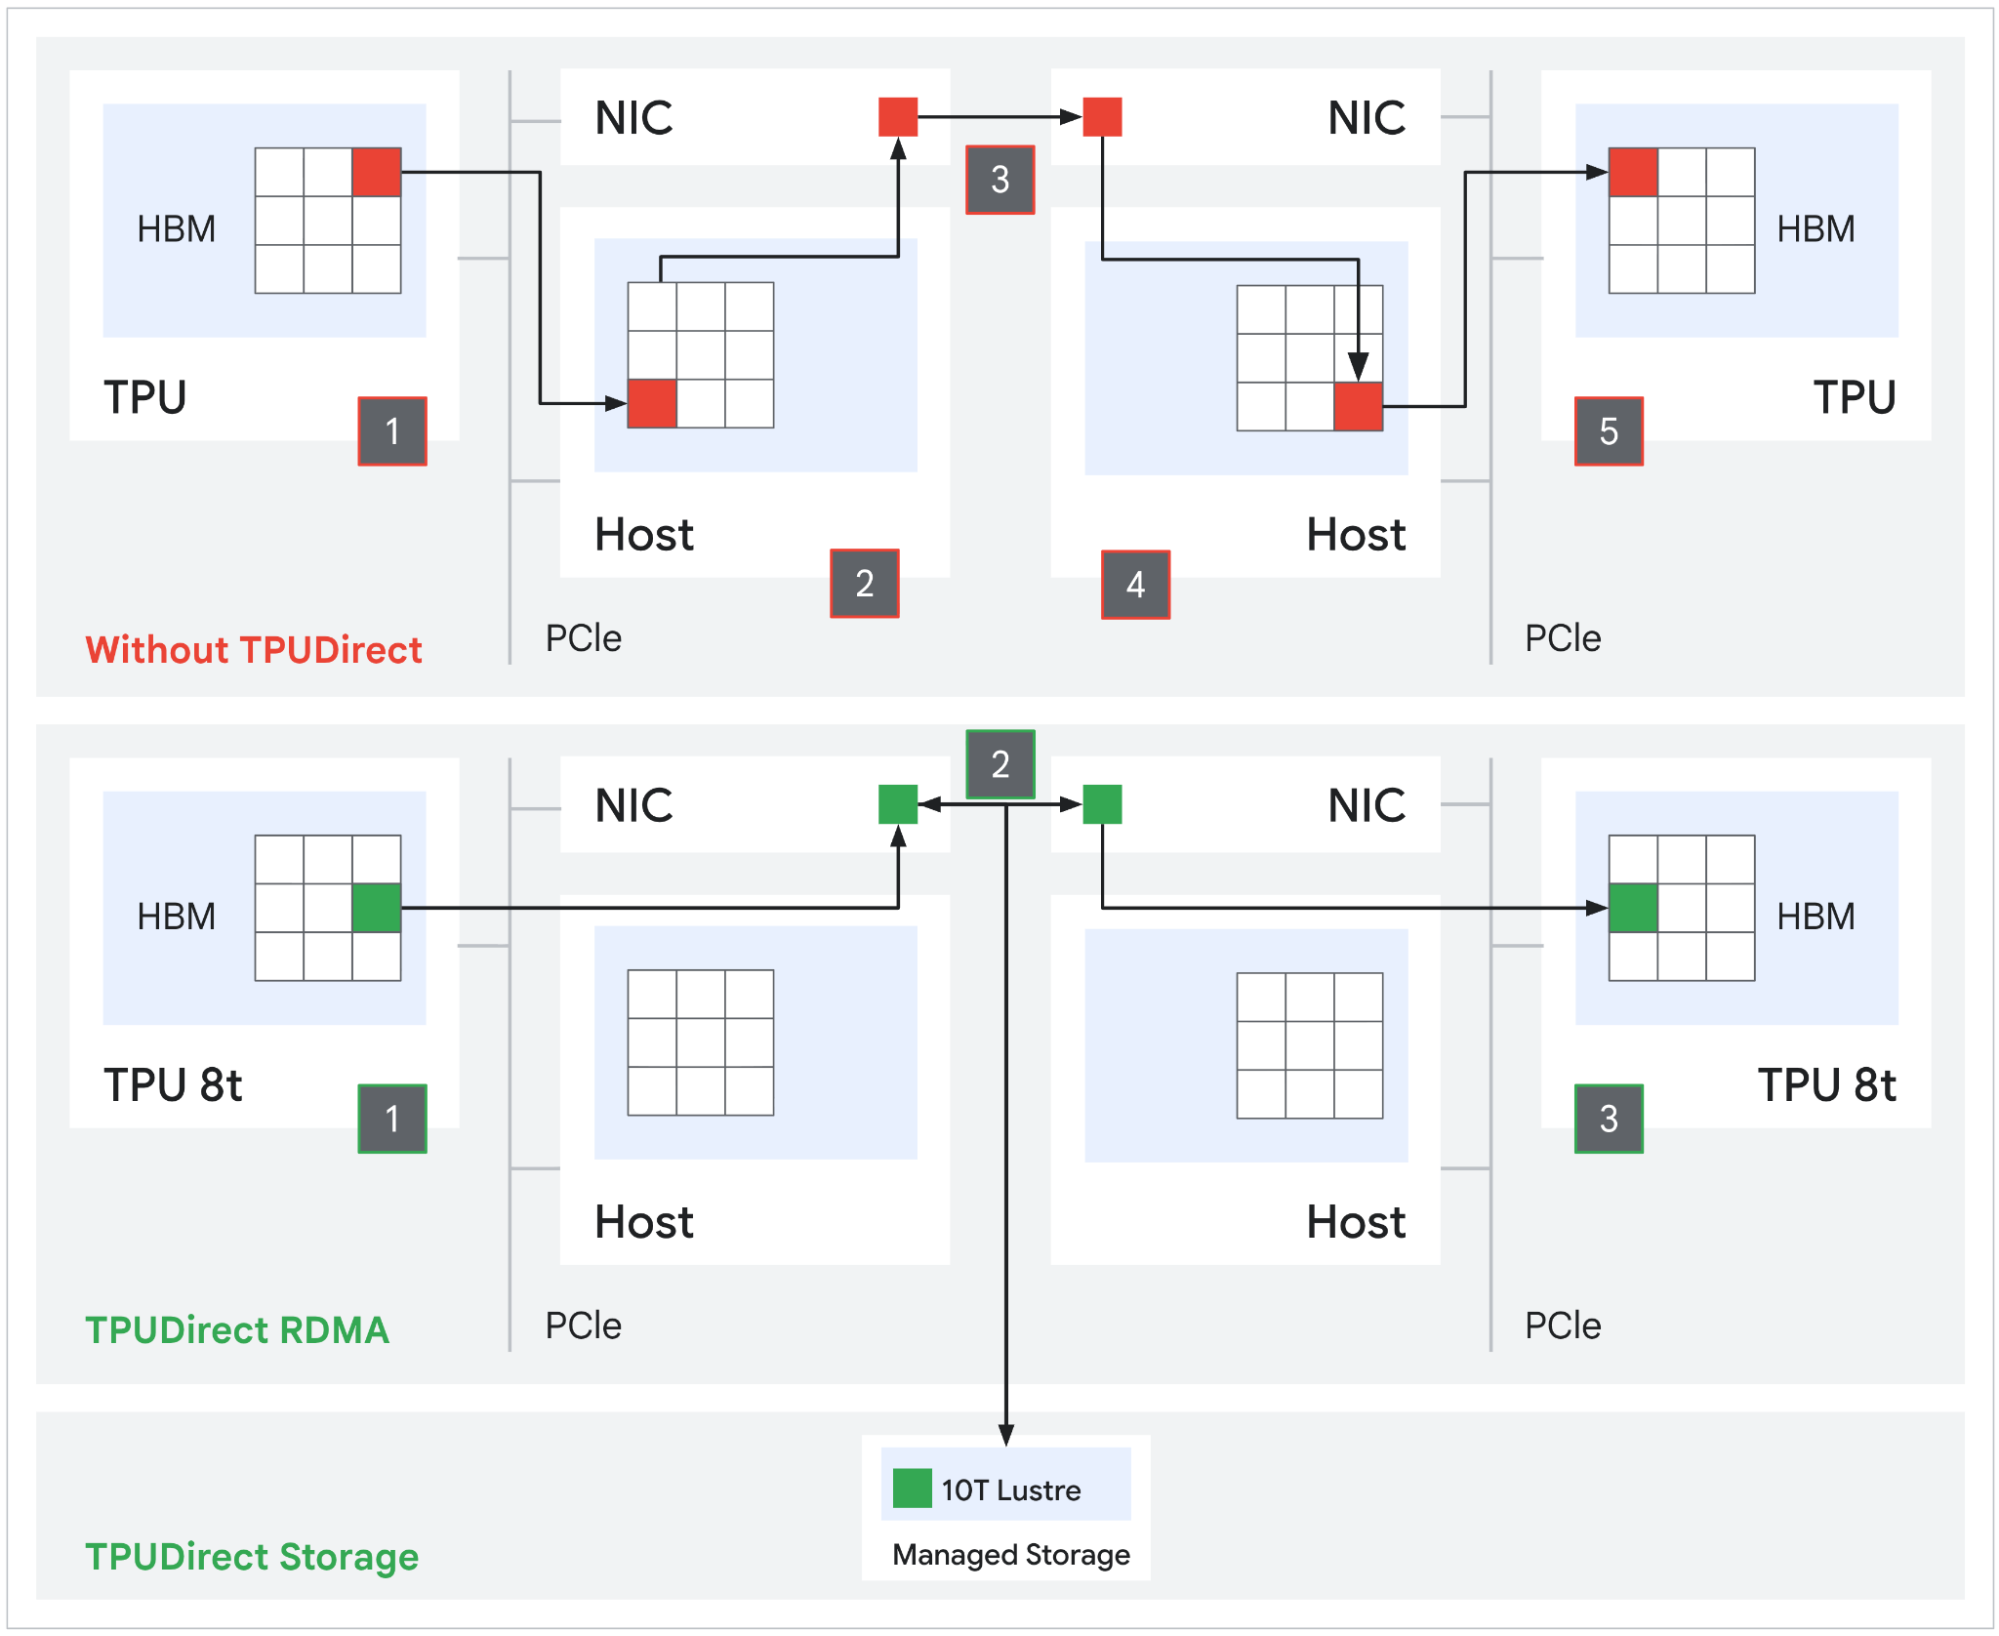
Eerdere TPU-generaties gebruikten een host-gemedieerd pad voor netwerk- en opslag-I/O: pakketten kwamen eerst in het DRAM van de host terecht, waarna een aparte DMA ze naar het HBM van de TPU kopieerde. Dat betekent twee geheugentransacties met de host-CPU erbij. TPUDirect RDMA elimineert de bounce buffer. De netwerkkaart leest en schrijft rechtstreeks naar het HBM van de TPU via PCIe peer-to-peer, waardoor de host niet langer betrokken is bij het datapad. NVIDIA biedt al jaren een vergelijkbare functionaliteit met GPUDirect RDMA en claimt een verbetering van ongeveer 10x ten opzichte van het host-gemedieerde pad. Google evenaart die prestatie nu aan de TPU-kant.
Bron: Google
TPUDirect Storage past hetzelfde principe toe op permanente opslag. Tensors worden rechtstreeks tussen TPU HBM en Managed Lustre verplaatst met een totale snelheid van 10 TB/s, wat volgens Google 10 keer snellere toegang tot de opslag oplevert dan het equivalente pad op Ironwood. Op de meest geavanceerde schaal, waar checkpoints honderden terabytes groot kunnen zijn, is het verschil of een trainingssessie van meerdere weken checkpoints en datasets met lijnsnelheid streamt of dat de MXU-pipeline vastloopt in afwachting van host-I/O.
Arm Axion Hosts
Elke voorgaande TPU-generatie draaide op x86-hosts van derden. De 8t is de eerste die Google's eigen Axion-processor gebruikt, een op Arm Neoverse V2 gebaseerde CPU, als systeemheader. De taak van de host-CPU op een TPU-pod is echt en wordt steeds complexer naarmate de schaal groter wordt: hij stuurt de inputpipeline aan, decodeert en verwerkt datasets van meerdere petabytes, beheert het JAX/XLA-controlepaneel, verzorgt de serialisatie van checkpoints en coördineert de SPMD-distributie over duizenden chips. Als de host vastloopt, blijft de MXU inactief.
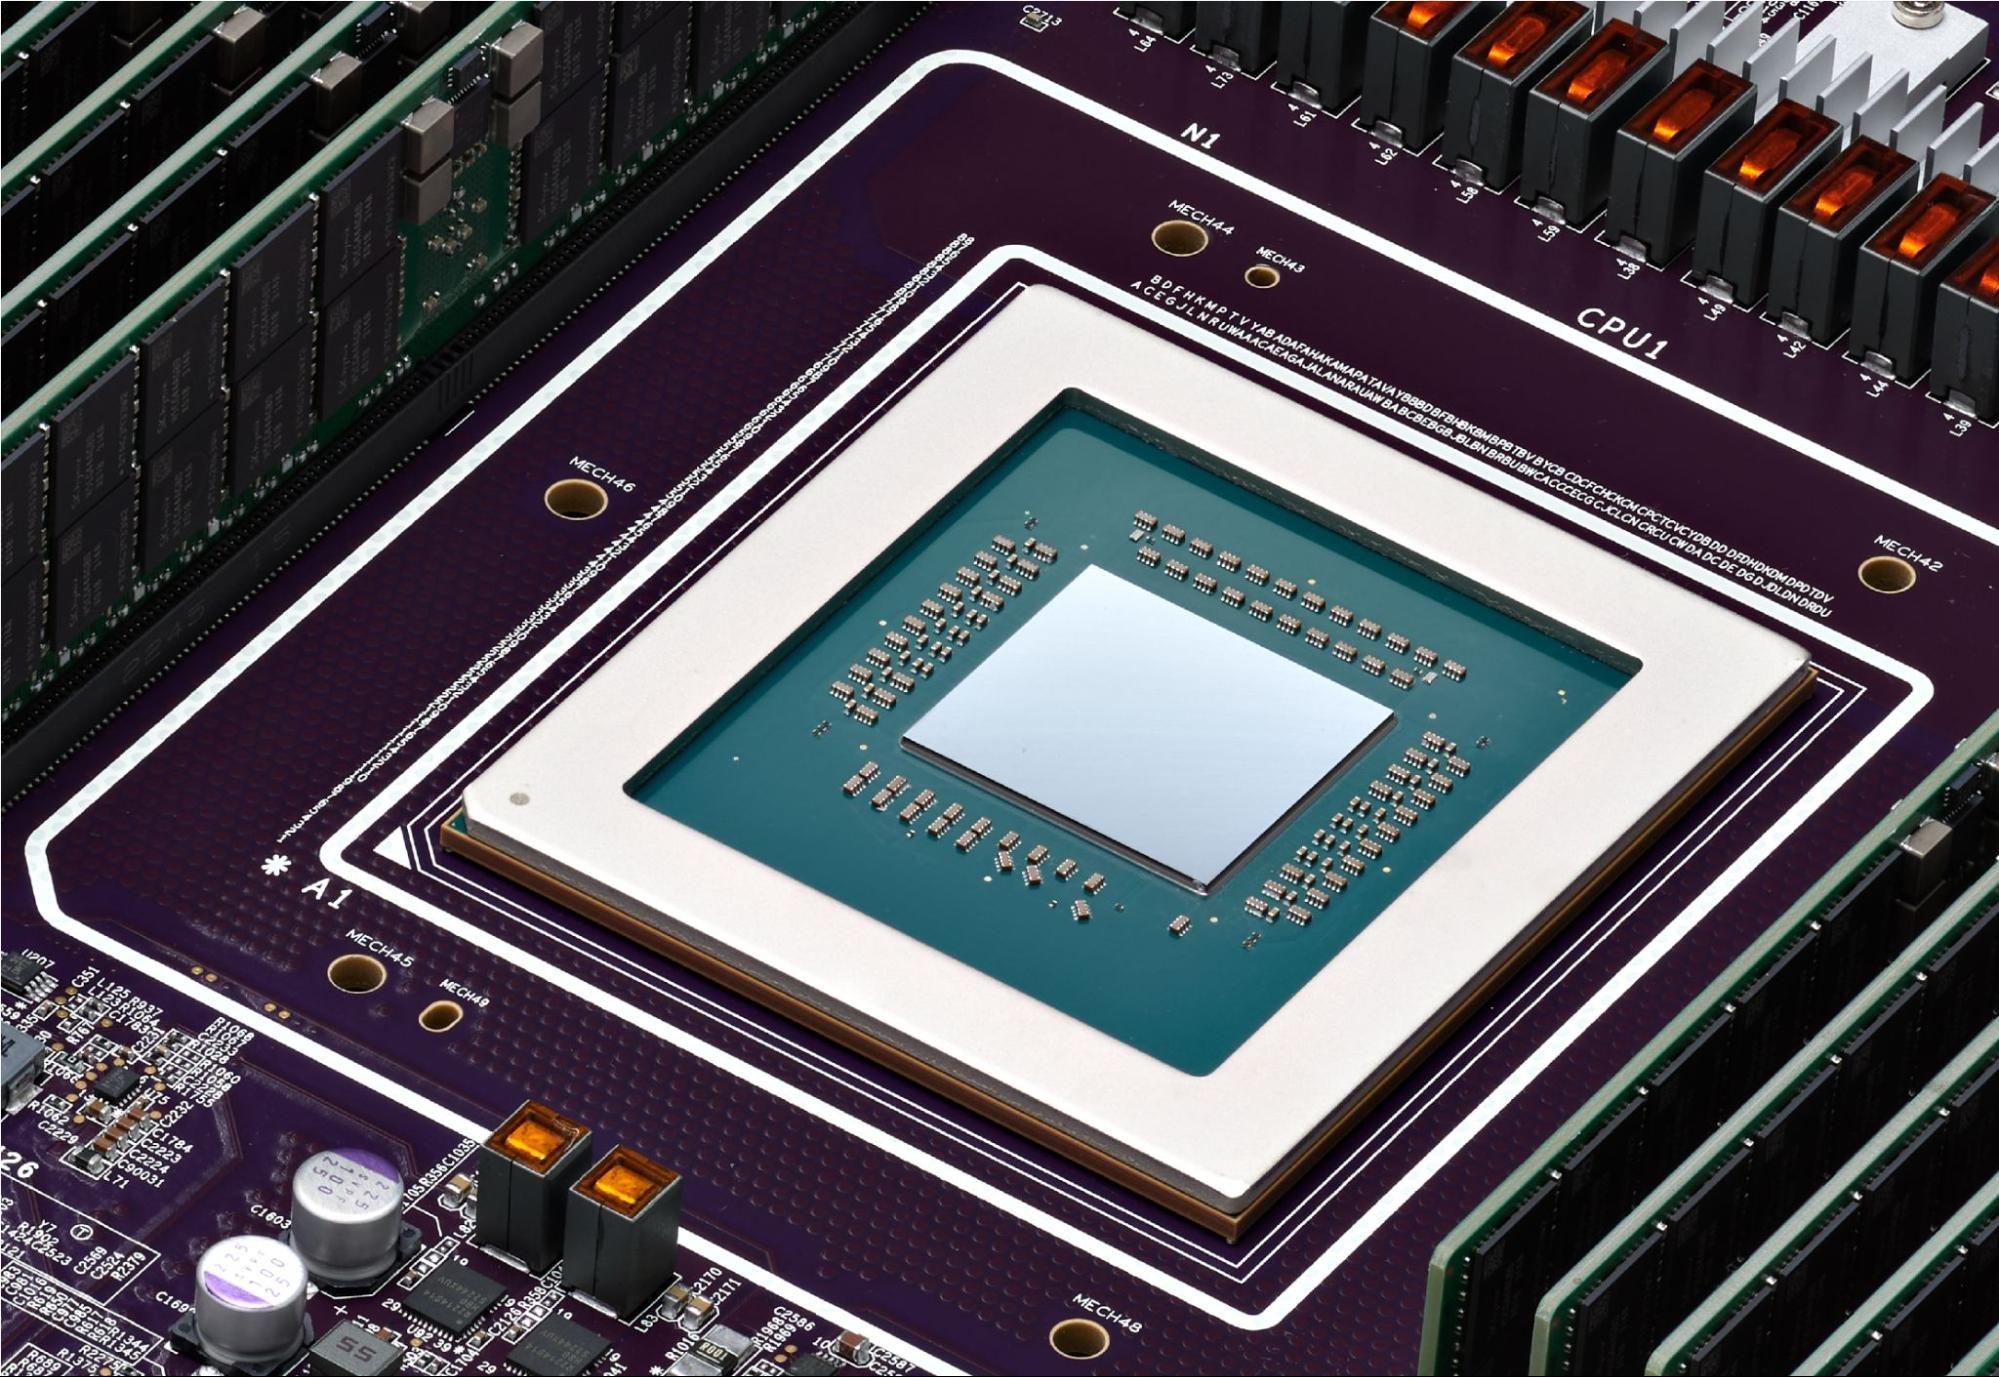
Google benadrukt specifiek de door Axion aangedreven NUMA-isolatie op 8t als het mechanisme dat voorkomt dat jitter aan de hostzijde doorsijpelt naar de gesynchroniseerde collectieve trainingsfasen. Met 9,600 chips per pod leiden zelfs kleine haperingen per host tot een meetbaar verlies aan goodput. TPUDirect regelt de dataoverdracht door de host uit bulktransfers te verwijderen. Axion regelt de controleoverdracht door elke TPU voldoende dedicated CPU-bandbreedte te geven, zodat preprocessing nooit de bottleneck wordt. Google heeft ook de verhouding tussen fysieke Axion-hosts en servers op het platform van de achtste generatie verhoogd, waardoor de overhead voor orchestratie, die schaalt met het aantal chips, meer ruimte heeft dan de hostconfiguratie van Ironwood bood.
TPU 8i “Zebrafish”
De inferentiechip deelt het Axion-hostplatform, de native FP4-architectuur en de HBM3e-geheugengeneratie met de 8t, maar de onderliggende siliciumchip is gericht op een ander knelpunt. Training is rekenintensief; inferentiedecodering is geheugenbandbreedte-intensief. De meeste architectonische verschillen van de 8i vloeien hieruit voort.
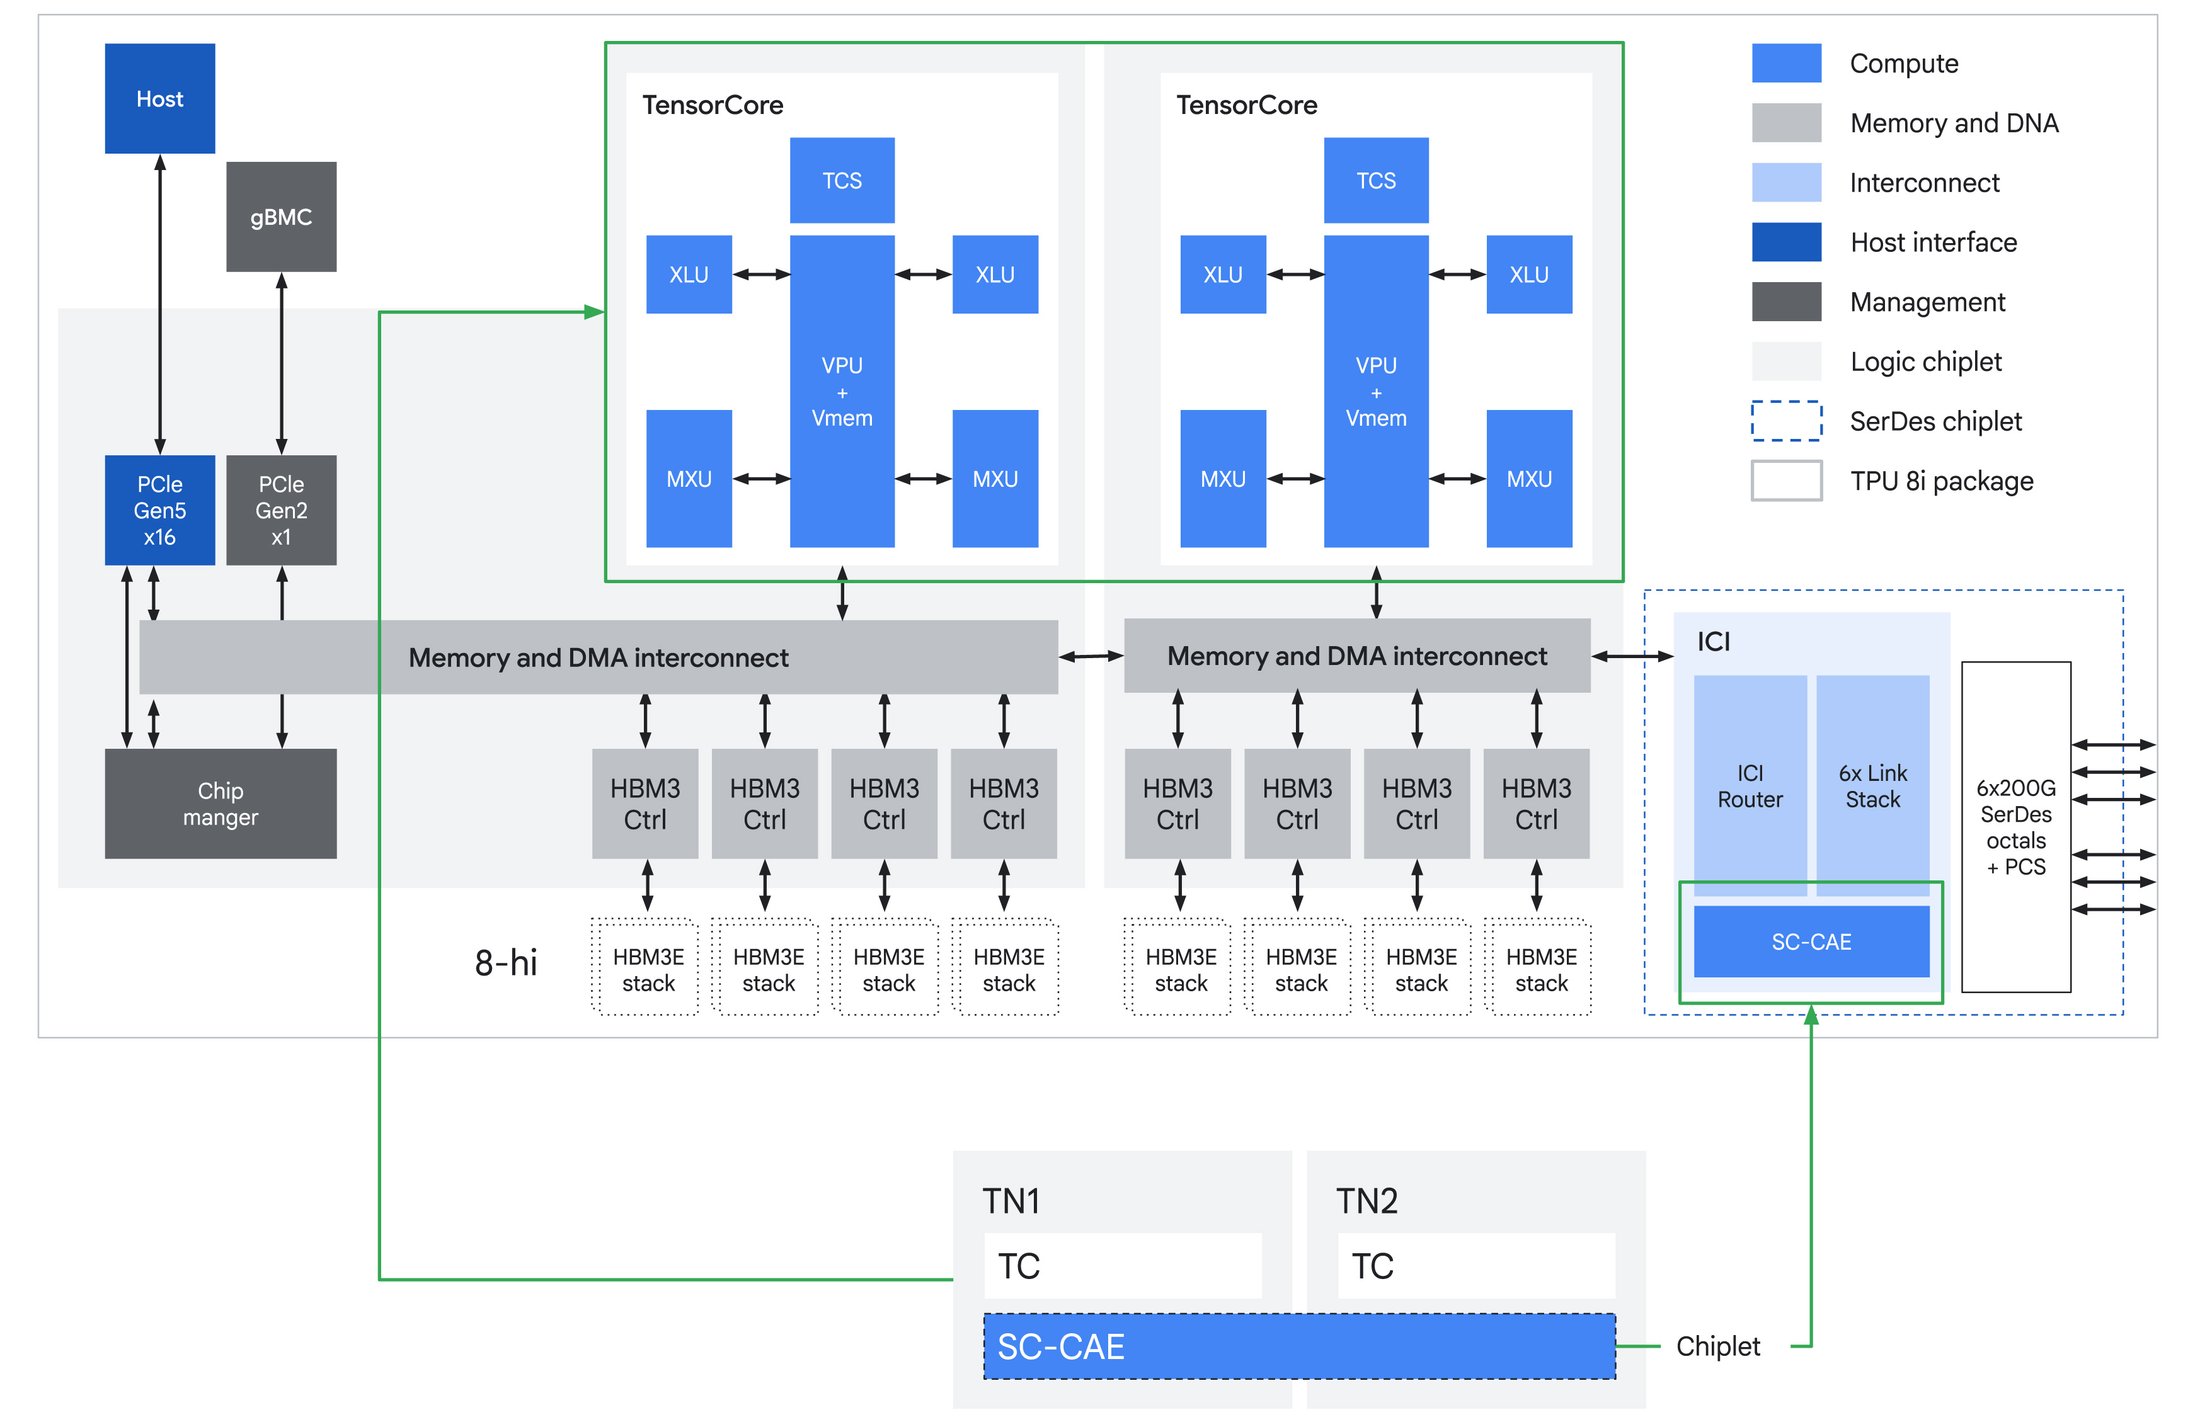
De grootste verandering is het on-chip SRAM. De 8i heeft 384 MB Vmem, drie keer zoveel als de Ironwood. Dit is belangrijk vanwege de KV-cache. Tijdens het decoderen van lange contexten vereist elk gegenereerd token het uitlezen van de geaccumuleerde sleutel-waardeparen van voorgaande tokens. Bij de meeste accelerators komt die uitlezing uit HBM, wat betekent dat de decodeersnelheid wordt beperkt door de geheugenbandbreedte in plaats van de rekenkracht. De 8i is zo ontworpen dat er voldoende KV-cacheruimte volledig op de chip aanwezig is. De bandbreedte van het on-chip SRAM is ongeveer tien keer zo groot als die van HBM, dus elke KV-leesbewerking die vanuit SRAM in plaats van HBM wordt uitgevoerd, betekent een kortere latentie per token en een hogere tokensnelheid per seconde bij hetzelfde energieverbruik.
Bron: Google
De TensorCore-configuratie is het andere grote verschil. Waar 8t één TensorCore gebruikt met 12.6 PFLOPS, verdeelt 8i de rekenkracht over twee TensorCores met een gecombineerde 10.1 PFLOPS. Een lagere piekdoorvoer klinkt als een achteruitgang, totdat je bedenkt hoe inferentie er op chipniveau daadwerkelijk uitziet. Trainingsworkloads worden gedomineerd door batchverwerking: grote matrixvermenigvuldigingen dekken de vaste overhead af en één grote MXU kan een bijna maximale benutting aanhouden. Inferentiedecodering is het tegenovergestelde. Batchgroottes zijn klein, de rekenvensters per token zijn kort en de chip besteedt een aanzienlijk deel van zijn tijd aan collectieve bewerkingen, sampling en routing in plaats van pure matrixvermenigvuldiging. Een enkele grote engine loopt vast tijdens die onregelmatige pauzes. Door de splitsing in twee TensorCores kan 8i de rekenfasen effectiever overlappen, waarbij elke TensorCore wordt gevoed door zijn eigen vier direct aangesloten HBM-stacks, met een totaal van 288 GB bij 8.6 TB/s over het hele pakket. Het resultaat is een hogere, aanhoudende benutting bij de batchgroottes die daadwerkelijk worden gebruikt bij interactieve servering.
Op het niveau van het opschalingsdomein komen de 1,024 actieve chips in een Boardfly-pod samen neer op ongeveer 295 TB HBM, 384 GB on-chip SRAM en 10.3 EFLOPS aan FP4-rekenkracht. De hoeveelheid SRAM is het belangrijkst voor inferentie: 384 GB on-chip cache over het hele domein is voldoende om een aanzienlijke hoeveelheid KV-status op te slaan zonder HBM aan te spreken, wat het mogelijk maakt om lange contexten met lage latentie te verwerken.
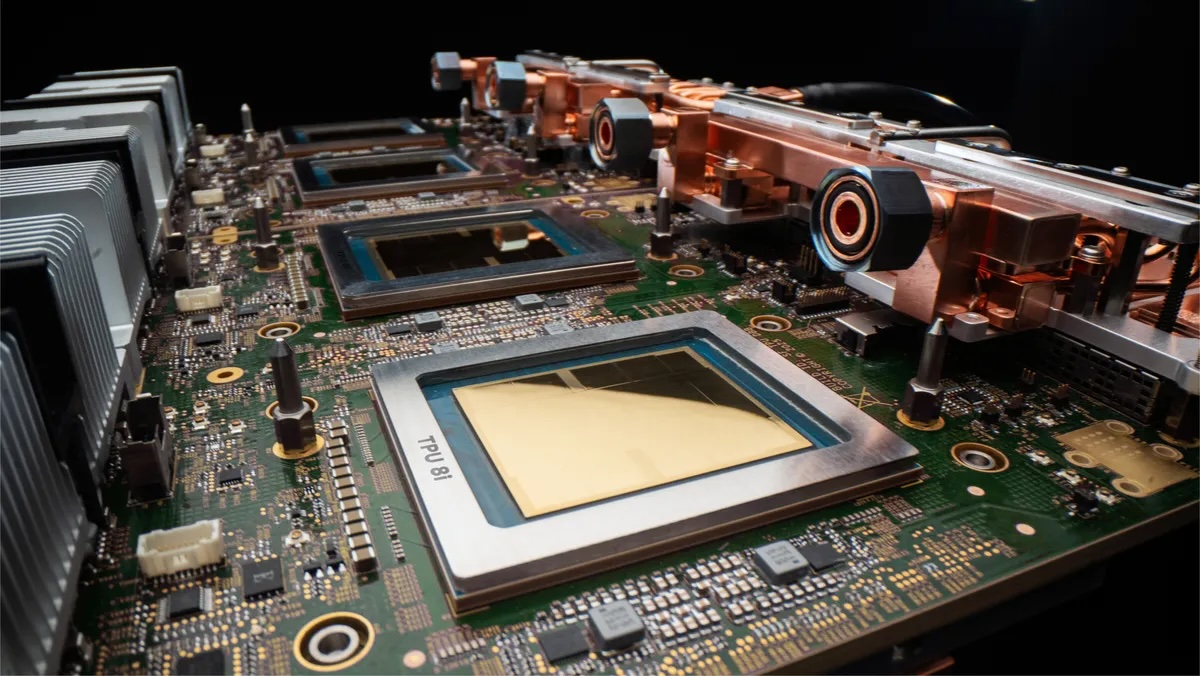
Aan de hostzijde wordt dezelfde logica gevolgd. Google zegt dat het aantal fysieke Axion-hosts per server op 8i is verhoogd ten opzichte van Ironwood. Inferentieservers besteden een aanzienlijk deel van de tijd per token aan tokenisatie, samplinglogica, routing, batchverwerking en de orkestratie van de agent-runtime. Deze overheadkosten schalen met de gelijktijdigheid in plaats van met de modelgrootte, en bij de aanvraagsnelheden die agent-workloads genereren, kan de host de bottleneck worden. Meer CPU-kracht per accelerator op de host is de meest voor de hand liggende oplossing.
Collectieve acceleratiemotor
De andere belangrijke wijziging op de chip is de Collectives Acceleration Engine, die de vier SparseCores vervangt die Ironwood had. SparseCores verzorgen MoE-routing en embedding-lookups met speciale gather-scatter-hardware, dus door ze te verwijderen uit de inferentiechip wordt een ander knelpunt aangepakt dat door 8i wordt geoptimaliseerd.
Het knelpunt dat CAE aanpakt, is de collectieve latentie. Elk gedecodeerd token vereist synchronisatie tussen de deelnemende chips: aandachtsoutputs moeten volledig gereduceerd zijn, expert routing metadata moeten worden uitgezonden en bemonsterde tokens moeten worden doorgegeven aan de volgende stap. Op GPU's vindt deze coördinatie softwarematig plaats via NCCL, dat collectieven plant als een reeks kernel-lanceringen en netwerkbewerkingen. Op 8i is de CAE een dedicated siliciumchip die zich op een eigen chiplet bevindt naast de TensorCores en deze synchronisatieprimitieven in hardware afhandelt.
Google claimt een tot wel 5x lagere collectieve latentie op de chip vergeleken met Ironwood. Bij trainingsbatches zou die verbetering echter tenietgedaan worden door de rekentijd; de collectieve latentie is slechts een klein deel van die verbetering. Bij kleine batches en korte vensters per token tijdens interactieve inferentie kan de collectieve latentie de tijd per token domineren, waardoor de 5x reductie zich vertaalt in tokens per seconde en prijs per token.
8i stapt ook over van de 3D-torustopologie naar wat Google Boardfly noemt, een op Dragonfly geïnspireerde hiërarchische topologie die de collectieve bandbreedte van de ring inruilt voor een lagere latentie tussen alle verbindingen. We zullen Boardfly hieronder in detail bekijken.
Boardfly-topologie
8i gebruikt een andere topologie dan 8t, omdat training en inferentie verschillende communicatiepatronen hebben.
De 3D-torus is ideaal voor ringcollectieven: elke chip heeft zes buren, data roteert rond de ring en geen enkele chip routeert willekeurig verkeer. Training wordt gedomineerd door deze ringvriendelijke patronen, en daarom behoudt 8t de torus. Een ring-all-reduce past perfect op één enkele torus-as. Bij geavanceerde taken wordt data-parallellisatie doorgaans op één as geplaatst, tensor-parallellisatie op een andere en pipeline-parallellisatie op de derde. De topologie en de werklast zijn op elkaar afgestemd.
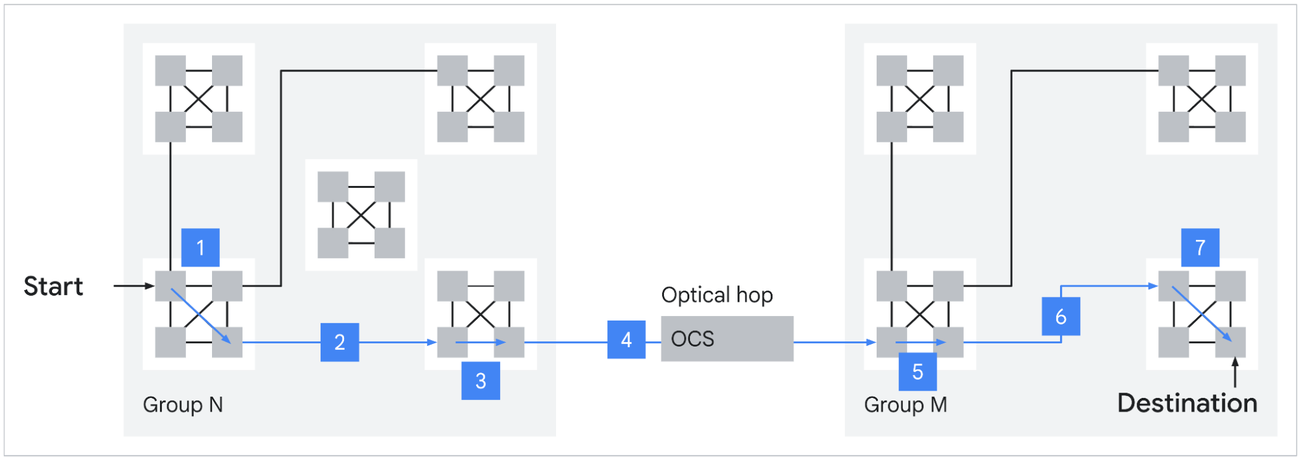
Inferentie voor een groot MoE-model heeft een ander communicatieprofiel. Experts zijn verdeeld over meerdere chips en elk gedecodeerd token activeert een all-to-all-communicatie: tokens moeten hun toegewezen experts bereiken, die verspreid over het netwerk liggen, en de output van de experts moet worden teruggestuurd. Dit is geen ring. Het is willekeurig punt-naar-puntverkeer, en in een 3D-torus met 1,024 chips is het pad tussen twee willekeurige chips in het slechtste geval 16 hops. Google legt deze berekening als volgt uit: "In een 3D-torus zijn knooppunten gerangschikt in een raster waarbij elke dimensie als een ring om de chip heen loopt. Om de verst mogelijke chip in een 8 x 8 x 16 (1024 chips) configuratie te bereiken, moet een pakket de helft van de afstand van elke ring afleggen."
3D-torus = 8/2(X) + 8/2(Y) + 16/2(Z) = 16 sprongen
Hoewel de torus zeer efficiënt is voor de communicatie tussen naburige chips die kenmerkend is voor dense training, zorgt deze voor een vertraging bij communicatie tussen alle chips. In het tijdperk van redeneermodellen en MoE, waarin elke chip met elke andere chip moet communiceren om een token door te sturen, is dit aantal hops van belang.
Bij latencygevoelige interactieve serverdiensten zorgen die extra hops ervoor dat de latency per token buiten de SLO (Service Level Objective) valt.
Bron: Google
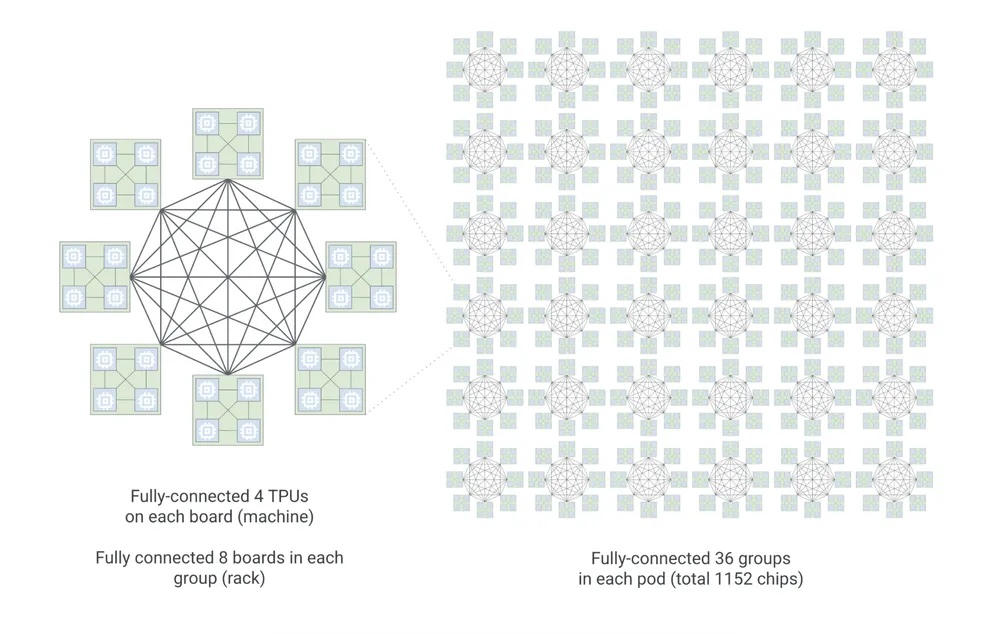
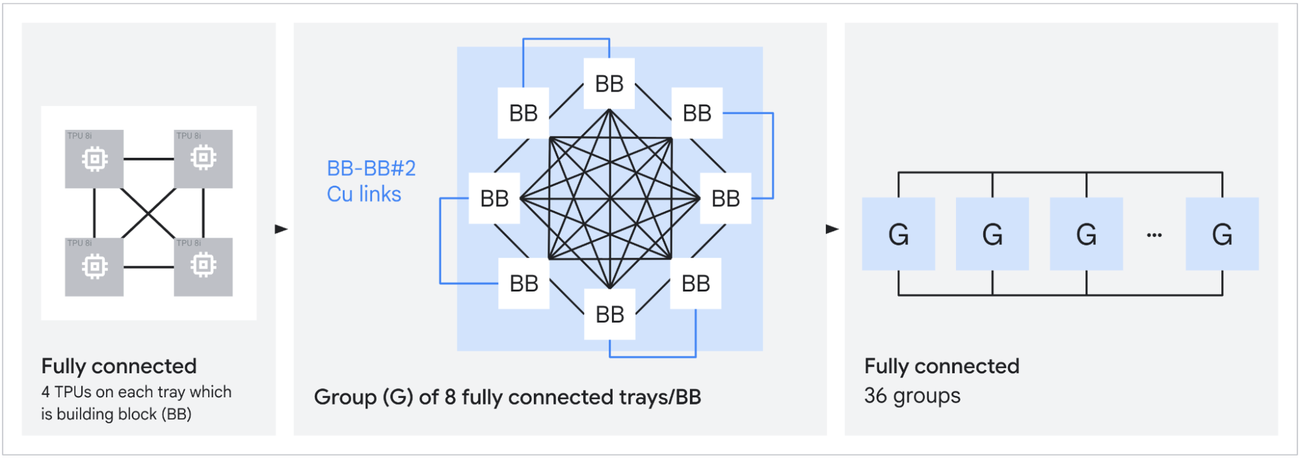
Boardfly is een op Dragonfly geïnspireerde hiërarchie die is ontworpen om die diameter te verkleinen. De structuur heeft drie niveaus. De bouwsteen is een ring van vier chips met 16 externe verbindingen. Acht van deze bouwstenen vormen een groep, volledig verbonden via koperkabels met 11 verbindingen per groep. Zesendertig groepen verbinden zich via optische circuitswitches (OCS) om een pod te vormen. Het resultaat is een schaalbaar domein van 1,152 chips (1,024 actief) met maximaal 7 hops tussen twee willekeurige chips, een reductie van 56% ten opzichte van de torus. Google beweert dat dit een verbetering van de latentie tot wel 50% oplevert voor communicatie-intensieve workloads zoals MoE all-to-all.
Het grotere schaalbereik is ook van belang voor de replicatie van experts. Meer chips per ICI-fabric betekent dat elke expert in een grote MoE vaker gerepliceerd kan worden, wat de onevenwichtigheid in de routering vermindert en de decode-latentie constant houdt wanneer de tokenverdeling scheef is. Top-k-routering is data-afhankelijk; sommige experts zullen in een bepaalde stap meer tokens zien dan anderen. Replicatie absorbeert die variatie. De ICI-bandbreedte is verdubbeld tot 19.2 Tb/s per chip, mede om het resulterende verkeer te kunnen verwerken.
Virgo Netwerk
Een superpod met 9,600 chips is groot, maar geavanceerde trainingsruns vereisen steeds meer. Virgo is het schaalbare platform dat superpods binnen een datacenter met elkaar verbindt en het oost-west RDMA-verkeer tussen pods afhandelt wanneer een taak de capaciteit van één enkel schaalbaar domein overstijgt.
Een enkele Virgo-fabric verbindt meer dan 134,000 8t-chips met een niet-blokkerende bisectionele bandbreedte van 47 Pb/s, tot wel vier keer de bandbreedte per accelerator en 40% lagere onbelaste latentie vergeleken met de vorige generatie. De architectuur is een platte, tweelaagse niet-blokkerende topologie gebouwd op high-radix switches met een multi-planair ontwerp en onafhankelijke besturingsdomeinen.
Traditionele Clos-netwerken overschrijven de hogere lagen om het aantal poorten en de kosten beheersbaar te houden. Dat werkt prima wanneer het meeste verkeer van noord naar zuid loopt, wat het patroon is in algemene cloudomgevingen: clients benaderen loadbalancers, loadbalancers benaderen applicatieservers, applicatieservers benaderen opslag. AI-trainingsworkloads verlopen bijna volledig van oost naar west, chip-naar-chip over het netwerk, en de collectieven worden gedomineerd door bisection. Elke overschrijving op welke laag dan ook leidt direct tot extra trainingstijd. Het platte tweelaagse ontwerp van Virgo met high-radix switches elimineert het knelpunt in de spine-laag door switches te bouwen met voldoende poorten per ASIC om een aanzienlijk deel van het netwerk in twee hops af te handelen.
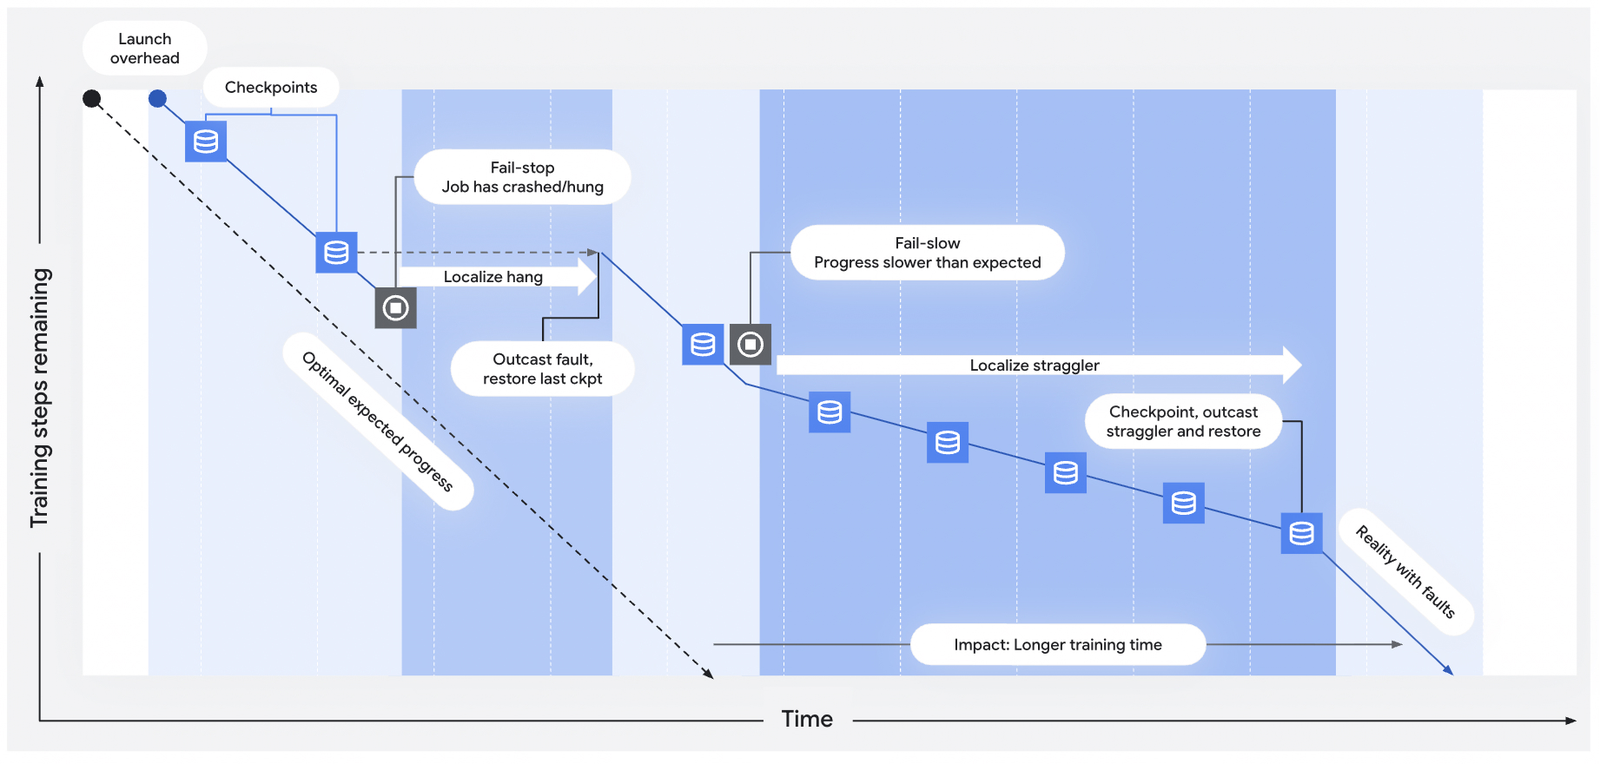
De betrouwbaarheidstechniek is van cruciaal belang op deze schaal en is sterk afhankelijk van Google's MEMS-gebaseerde optische circuitschakelaars (OCS). OCS stelt Google in staat de fysieke topologie tussen taken te herconfigureren zonder iets opnieuw te bedraden, en, nog belangrijker, defecte chips of verbindingen halverwege de uitvoering om te leiden. Wanneer een storing wordt gedetecteerd, kan OCS het getroffen deel van de fabric binnen milliseconden opnieuw in kaart brengen, waardoor handmatige tussenkomst overbodig is. Telemetrie met een nauwkeurigheid van minder dan een milliseconde voedt geautomatiseerde detectie van achterblijvers en vastgelopen systemen. De combinatie van snelle detectie en op OCS gebaseerde omleiding optimaliseert de gemiddelde tijd tussen interrupts en de gemiddelde hersteltijd op een schaal van meer dan 100,000 chips, waar de statistische zekerheid van een storing tijdens een run van meerdere weken bijna 100% bedraagt. De door Google genoemde 97% goodput voor 8t-pods is afhankelijk van deze infrastructuur. Dezelfde OCS-technologie is overal in de TPU-stack terug te vinden: het verbindt cubes tot superpods op de ICI-laag, verbindt Boardfly-groepen op de 8i-schaallaag en verwerkt inter-podverkeer op de Virgo-laag.
Met 134,000 chips bereikt de totale rekenkracht ongeveer 1,690 EFLOPS FP4, oftewel ongeveer 1.7 ZFLOPS. Google stelt dat de architectuur een bijna lineaire schaalbaarheid ondersteunt voor maximaal een miljoen chips in één logisch trainingscluster, hoewel de huidige implementaties dat plafond nog niet hebben bereikt.
Jupiter en schaalvergroting van meerdere datacenters
Virgo verwerkt het oost-westverkeer van de accelerators binnen een datacenter, maar vormt niet de top van de stack. Jupiter is Google's bestaande noord-zuidinfrastructuur, inmiddels in de vijfde generatie, die het front-endverkeer en de toegang tot gedistribueerde opslag- en rekenresources afhandelt. Jupiter werd niet aangekondigd tijdens Cloud Next; het is de bestaande infrastructuur waarop de 8e generatie voortbouwt.
De nieuwste Jupiter-versie levert 13 Pb/s bisectionele bandbreedte per datacentergebouw met een beschikbaarheid van 99.999%, met behulp van Apollo MEMS OCS-switches met een verbruik van ongeveer 108 W per OCS, vergeleken met ongeveer 3,000 W voor een vergelijkbare elektrische packet switch. Dit is de infrastructuur die de datacenters van Google verbindt met de buitenwereld en met elkaar.
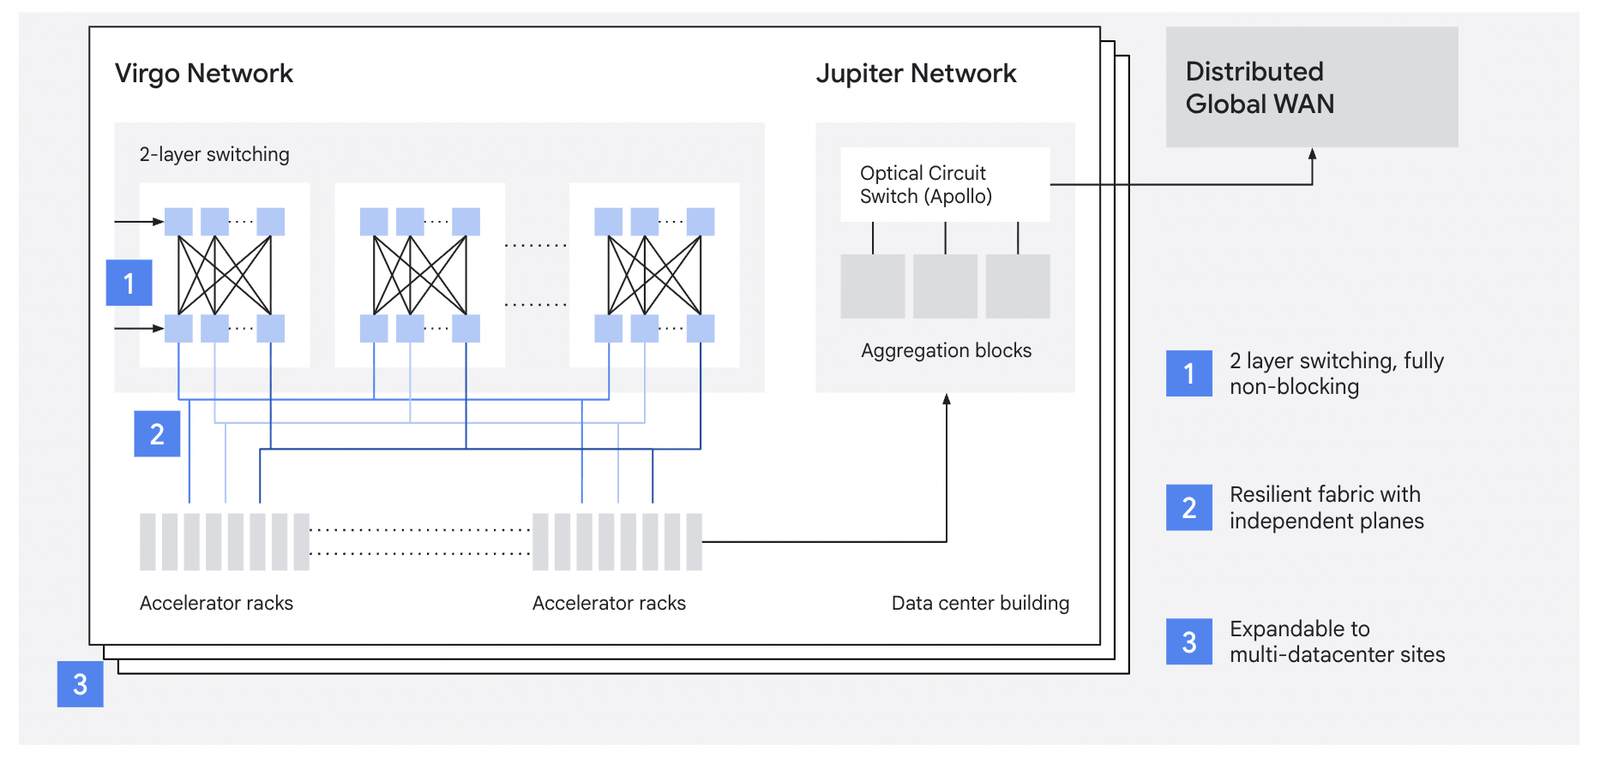
Voor trainingssessies die de capaciteit en ruimte van één datacenter te boven gaan, maakt Jupiter schaalbaarheid over meerdere locaties mogelijk. De combinatie is gelaagd: ICI binnen een pod, Virgo tussen pods binnen een locatie en Jupiter tussen locaties. Google's Pathways-softwarestack kan workloads over deze domeinen met meerdere datacenters als één logisch cluster afhandelen.
Met ongeveer 1.7 ZFLOPS is één enkele Virgo-fabric het grootste aangekondigde cluster voor AI-training. Meerdere Virgo-fabrics die via Jupiter met elkaar verbonden zijn, kunnen meer dan een miljoen TPU-chips aansturen, wat de schaal is die Google nastreeft, ook al hebben de huidige implementaties die schaal nog niet bereikt.
Goede opbrengst en benutting
Het aantal ruwe FLOPs is minder belangrijk dan het percentage FLOPs dat daadwerkelijk nuttig werk verricht. Google hanteert een streefwaarde van 97% voor 8t superpods, wat betekent dat 97% van de rekentijd wordt besteed aan productieve berekeningen in plaats van aan herstel, vertragingen of coördinatieoverhead. Dit percentage is afhankelijk van de op OCS gebaseerde fouttolerantie en de telemetrie met een nauwkeurigheid van minder dan een milliseconde, zoals hierboven beschreven.
Model FLOPs Utilization (MFU) is de andere variabele. MFU meet welk deel van de theoretische piek-FLOPs de chip daadwerkelijk behaalt bij een reële workload. SemiAnalysis schat dat bij een TPU MFU van 40% de kosten per effectieve trainings-FLOP met ongeveer 62% dalen ten opzichte van de GB300 NVL72, met een break-evenpunt bij ongeveer 15% TPU MFU. De openbaar gemaakte TPU-economie van Anthropic suggereert dat ze ruim boven dat break-evenpunt opereren. De combinatie van een hoge goodput (chips draaiende houden) en een concurrerende MFU (chips bezig houden tijdens gebruik) zorgt ervoor dat de TCO van TPU op grote schaal haalbaar is.
Waar 8 zit
Bij het vergelijken van TPU 8 met de huidige en toekomstige platforms van NVIDIA is het belangrijk om goed op de eenheden te letten. NVIDIA geeft de NVLink-bandbreedte op als bidirectionele aggregatie; een B200 met 1.8 TB/s NVLink 5 is 900 GB/s per richting. De door NVIDIA opgegeven FLOPs zijn meestal 2:4 in een sparse configuratie; in een dense configuratie is dat de helft. De TPU-cijfers van Google zijn dense en bidirectioneel. Controleer bij elke vergelijking of de bandbreedte unidirectioneel of bidirectioneel is en of de FLOPs dense of sparse zijn.
De FP4-prestaties per chip van 8t bij 12.6 PFLOPS dense liggen tussen de 10 PFLOPS sparse (5 PFLOPS dense) van de GB200 en de 20 PFLOPS sparse (15 PFLOPS dense) van de GB300. De vergelijking per chip is vergelijkbaar. De schaalvergroting daarentegen niet. Een GB300 NVL72-rack bevat 72 GPU's in één NVLink-domein. Een 8t superpod bestaat uit 9,600 chips in één enkele 3D-torus. Dat zijn 133 keer zoveel chips in één collectief domein, en dat is precies het verschil tussen de platforms voor grensverleggende training.
NVIDIA zit niet stil. Vera Rubin wordt in de tweede helft van 2026 uitgebracht met 50 PFLOPS NVFP4-inferentie per pakket (hoewel SemiAnalysis zich afvraagt of dit getal adaptieve compressie omvat), 288 GB HBM4 met een snelheid van 22 TB/s en NVLink 6 met een bidirectionele snelheid van 3.6 TB/s. Rubin Ultra, dat in de tweede helft van 2027 verschijnt, combineert vier reticle-dies voor maximaal 100 PFLOPS FP4 en 1 TB HBM4e per pakket. Kyber NVL576 zal 576 Rubin Ultra GPU's in één rack bundelen met 15 EFLOPS FP4-inferentie. Dit begint het schaalvoordeel van Google te verkleinen, hoewel 576 GPU's nog steeds een orde van grootte kleiner is dan een 8 ton zware superpod.
Waar 8 in uitblinkt: schaalvergroting van het domein (9,600 chips versus 72 GPU's, of 576 na Kyber), schaalbaarheid op één fabric (meer dan 134,000 chips met 47 Pb/s), deterministische latentie door statische XLA-scheduling en TCO voor workloads die passen bij het TPU-model.
Waar 8 aspecten van belang zijn: HBM-capaciteit per chip (216 GB versus Rubins 288 GB HBM4), schaarste (NVIDIA heeft een hardwarepad van 2:4, Google niet) en de breedte van het ecosysteem (CUDA, cuDNN, TensorRT-LLM en de PyTorch-first serving stack komen eerst op NVIDIA terecht; native PyTorch op TPU is nog in preview).
Er is vraag naar beide platforms. Meta zou naar verluidt in gesprek zijn over een deal van meerdere miljarden dollars om Google TPUs in zijn datacenters te implementeren vanaf 2027, met de mogelijkheid om al in 2026 Cloud TPUs te huren. Tegelijkertijd kondigde Google Cloud A5X-instances aan, gebouwd op NVIDIA Vera Rubin NVL72, die schaalbaar zijn tot 80,000 Rubin GPU's binnen één locatie en 960,000 GPU's in implementaties over meerdere locaties. Google bouwt beide platforms op grote schaal uit.
verpakken
De achtste generatie TPU bestaat uit twee chips in plaats van één, ontworpen voor de huidige grootschalige training en agentische inferentie, in plaats van voor algemene AI-workloads. 8t maakt schaalvergroting mogelijk tot 9,600 chips per superpod en schaaluitbreiding tot meer dan 134,000 chips per Virgo-fabric. 8i ruilt SparseCores in voor silicium met collectieve acceleratie en vervangt de 3D-torus door Boardfly om te voldoen aan de latentiedoelstellingen die nodig zijn voor MoE-diensten op grote schaal. NVIDIA's roadmap, met Vera Rubin, Rubin Ultra en Kyber, zal een aantal van deze tekortkomingen in de loop van 2026-2027 verhelpen, maar het schaalvoordeel blijft voorlopig bestaan. Voor grensverleggende laboratoria die Mixture-of-Experts-modellen draaien op honderdduizenden chips, is 8 een geloofwaardig alternatief voor Grace Blackwell, en de gesprekken met Meta suggereren dat de markt dit begint te verrekenen.


 Amazon