

Updated November 3, 2026: The AMD Instinct MI350P joins Also Tested from our first look at 450W, and its two-card results join Scale-Out Configurations; it ranks once it completes the Ministral 3 ladder at 600W. Published October 14, 2026. Five PCIe accelerators ranked on one vLLM container and one model set, with the H100 NVL and the MI350P in Also Tested; the H200 NVL carries a power note explained below.
Elke accelerator die op deze pagina wordt vermeld, is in het StorageReview-lab getest als een enkele PCIe-kaart. De markt voor enterprise GPU's is verdeeld tussen de HGX- en OAM-modules die in AI-omgevingen worden gebruikt en de uitbreidingskaarten die in de 2U- en 4U-servers worden geplaatst die de meeste datacenters al gebruiken. Deze pagina behandelt alleen de tweede groep: de datacenter-GPU die u kunt bestellen via een gangbare serverconfigurator en kunt plaatsen in een bestaand rack.
Dat is de markt voor inferentie binnen bedrijven, en inferentie binnen bedrijven is de workload waarop elke kaart hier wordt beoordeeld. Elke keuze linkt naar de review met de gegevens, en de ranking is gebaseerd op dezelfde test voor elke kaart.
Die test betreft vLLM online serving, de stack waarop de meeste inferentie in de zakelijke wereld draait, aangestuurd door 1 tot 32 gelijktijdige streams op elke kaart, en tot 128 op de twee Hopper-kaarten, op vier modellen in dezelfde NGC vLLM 26.08-container (vLLM 0.27.1 op CUDA 13.4.1) en dezelfde 595.71.05-driver.
Vijf van de zes kaarten draaiden in onze Dell PowerEdge R770 met het vermogen dat die server aan een GPU-slot levert; de RTX PRO 6000 draaide in onze Dell Pro Max Tower T2 met dezelfde behuizing en driver. De volgorde die u hieronder ziet, bleef consistent voor elk model en beide testconfiguraties die we hebben gebruikt, dus de rangschikking is niet alleen gebaseerd op de piekprestaties.
Geheugen is in deze klasse belangrijker dan rekenkracht. Een kaart van 24 GB of 32 GB is voldoende voor kleine en middelgrote modellen met lange chatsessies, maar de KV-cache raakt vol zodra er veel langere prompts binnenkomen. Een kaart van 48 GB of 96 GB is geschikt voor middelgrote modellen met ruimte voor gelijktijdige multi-tenant processen, en de 94 GB en 141 GB HBM-kaarten zijn ideaal voor modellen in de 70B tot 120B band die op één GPU draaien. De selectie is gebaseerd op deze indeling en de FAQ onderaan beantwoordt de meest gestelde vergelijkingsvragen, van RTX PRO 6000 versus H100 tot het verschil tussen 450W en 600W in een 2U-behuizing.
In een oogopslag
Het aantal uitvoertokens per seconde is afkomstig van Ministral 3 14B Instruct FP8 met 32 gelijktijdige streams, het zwaarste punt waarop elke kaart voltooid is, op de chatvorm van 512 in, 512 uit en de documentvorm van 8,192 in, 1,024 uit. FP8 is het maximaal haalbare resultaat van MAMF matmul in TFLOPS, een continue, dichte GEMM-meting, niet de piekwaarde van de leverancier.
| Categorie | Versneller | Geheugen / Bandbreedte | Slots / Vermogen zoals getest | Chat 512/512 (tok/s) | Document 8K/1K (tok/s) | MAMF FP8 (TFLOPS) | Volledige recensie |
|---|---|---|---|---|---|---|---|
| Beste PCIe AI-accelerator in het algemeen | NVIDIA H200 NVL* | 141 GB HBM3e / 4.8 TB/s | Dubbele sleuf / 450W* | 3,435 | 1,038 | 1,262 | ET900N G3 Review (H200 NVL-gegevens) |
| Beste GPU voor bedrijfsmatige inferentie | NVIDIA RTX PRO 6000 Blackwell Server-editie | 96 GB GDDR7 / 1.6 TB/s | Dubbele sleuf / 600W (capaciteit van 450W ook getest) | 2,283 | 608 | 774 | Review van de RTX PRO 6000 |
| Beste GPU met één slot | NVIDIA RTX PRO 4500 Blackwell Server-editie | 32 GB GDDR7 / 800 GB/s | Enkelvoudig slot / 165W | 1,107 | 190 | 280 | Review van de RTX PRO 4500 SE |
| Beste gangbare GPU voor inferentie die nog steeds leverbaar is | NVIDIA L40S | 48 GB GDDR6 / 864 GB/s | Dubbele sleuf / 350W | 995 | 230 | 369 | RTX PRO 4500 SE recensie (L40S-gegevens) |
| Beste slot-gevoede kaart voor 1U en Edge | NVIDIA L4 | 24 GB GDDR6 / 300 GB/s | Enkelsleufs HHHL / 72W | 364 | 42 | 116 | L4-beoordeling |
*De H200 NVL is getest op 450W, het maximale vermogen dat een Dell PowerEdge R770 GPU-slot kan leveren. De kaart heeft een nominale waarde van 600W, maar we hebben hem daar niet op getest. De cijfers op deze pagina zijn dus een minimumwaarde. De RTX PRO 6000-cijfers zijn afkomstig van de Workstation Edition; NVIDIA geeft voor beide edities een nominale waarde van 600W op, en ze presteren identiek in onze tests. De Server Edition is de passieve, headless kaart met dezelfde GPU en hetzelfde geheugen.
De Keuzes
Beste PCIe AI-accelerator in het algemeen: NVIDIA H200 NVL
De H200 NVL is de snelste insteekkaart die we hebben gemeten en de enige op deze pagina die blijft schalen voorbij 32 streams. Bij 32 gelijktijdige streams op Ministral 3 14B FP8 verwerkte hij 3,435 uitvoertokens per seconde, tegenover 3,096 voor de H100 NVL en 2,283 voor de RTX PRO 6000. Het verschil werd groter naarmate het aantal gelijktijdige streams toenam: 7,336 tokens per seconde bij 128 streams, waar de RTX-kaarten al waren gestopt. Bij het documentformaat van 8,192 tokens kwam de 141 GB HBM3e nooit tekort en presteerde de kaart 21 tot 23 procent beter dan de H100 NVL op elk model bij een gelijk aantal gelijktijdige streams.
De voorsprong ten opzichte van de Blackwell-kaart is groter dan de specificaties doen vermoeden. Bij 32 streams presteerde de H200 50 tot 81 procent beter dan de RTX PRO 6000 in de drie FP8- en BF16-modellen, en bij 8K-input haalde hij 1,038 tokens per seconde in het 14B-model tegenover 608 voor de RTX-kaart, omdat 4.8 TB/s aan HBM-feeds op een andere manier gedecodeerd kan worden dan 1.6 TB/s aan GDDR7.
Twee of vier kaarten kunnen via NVLink een verbinding tot stand brengen met een snelheid van 900 GB/s, iets wat geen enkele andere kaart hier biedt. Onze NVLink-cijfers voor de H200 staan naast die van de RTX PRO 6000 en de GB300 DGX Station in de review van de ET900N G3, waar de Station 22,041 uitvoertokens per seconde behaalde op GPT-OSS-20B bij 128 streams, tegenover 6,022 voor deze kaart.
Het stroomverbruik is belangrijk voor een koper van een 2U-systeem: deze kaart verbruikte de 450W die een PowerEdge R770-slot toelaat, en de 600W-specificatie is in ons lab nog niet getest. De enige workload waarbij de kaart geen voordeel biedt, is de NVFP4-versie van Qwen3.8-27B, waar de kaart geen FP4-hardware heeft en vLLM on-the-fly dequantiseert, met een resultaat van 467 tokens per seconde tegenover 616 voor de RTX PRO 6000. Koop hem voor het geheugen en de bandbreedte, wat essentieel is voor een 70B tot 120B-implementatie.
Lees de review van de ASUS ET900N G3, waarin onze H200 NVL-resultaten staan.
Beste GPU voor inferentie in de zakelijke markt: NVIDIA RTX PRO 6000 Blackwell Server Edition
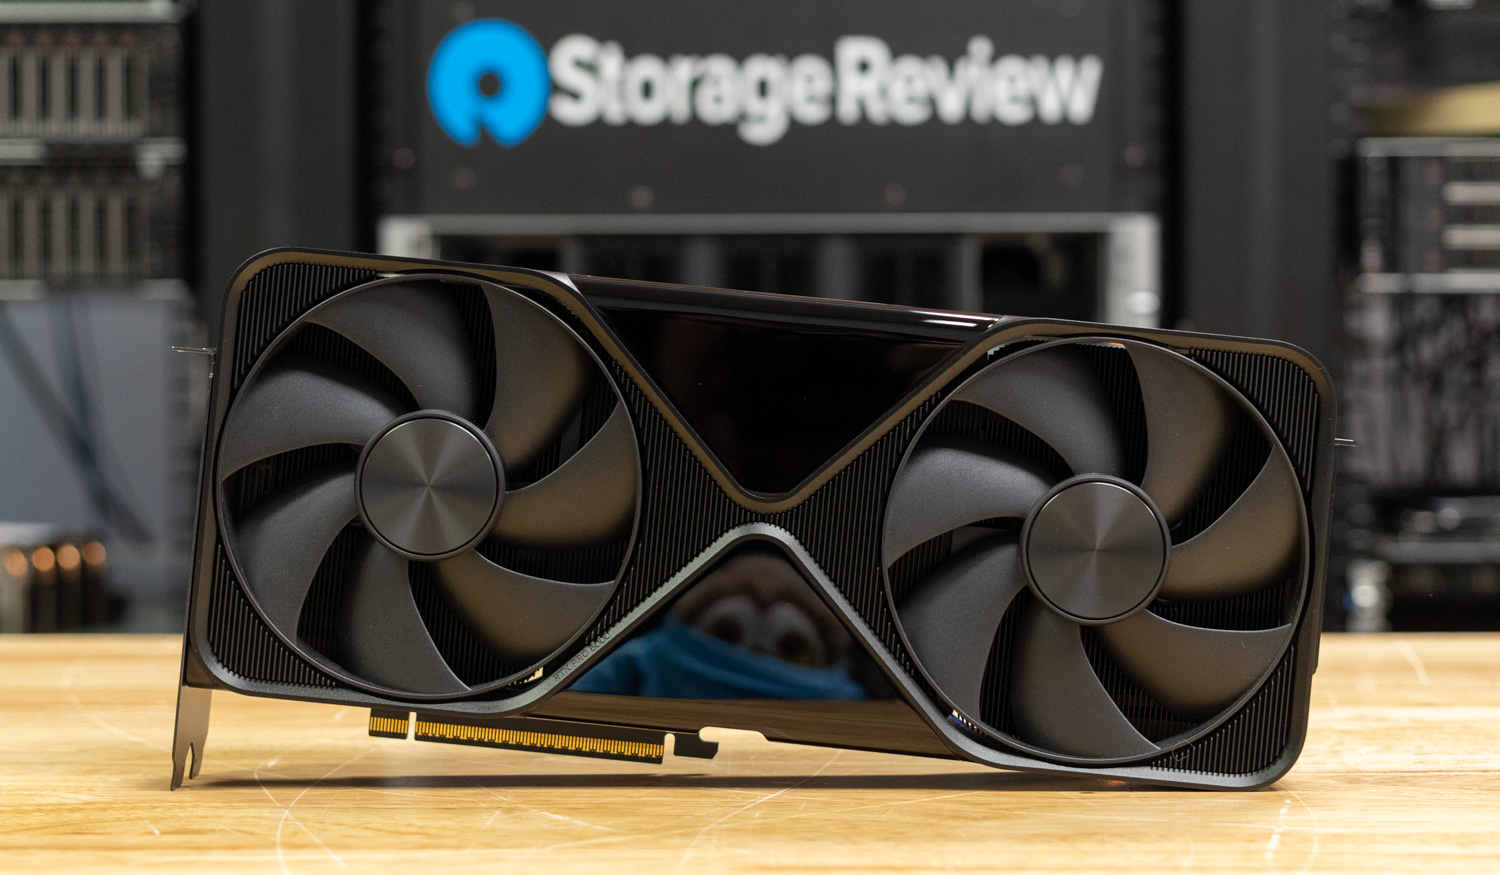
De RTX PRO 6000 is de GPU voor zakelijke inferentie op deze pagina: de Blackwell-kaart die is ontworpen voor de 2U- en 4U-inferentieservers die bedrijven momenteel aanschaffen, met de grootste framebuffer onder de HBM-laag en de meest uitgebreide functionaliteit van alle kaarten in dit overzicht. Bij 600W leverde de kaart 2,283 uitvoertokens per seconde bij 32 streams op de Ministral 3 14B FP8, 2,139 op het 8B-model en 4,155 op de 3B. Dat is ongeveer twee keer zoveel als de RTX PRO 4500 bij korte contexten en 2.7 tot 3.5 keer zoveel bij 8K-input, waar de 96GB-versie doorloopt tot 32 streams, terwijl de 32GB- en 48GB-kaarten minder presteren.
In MAMF bereikte het 774 TFLOPS in FP8 en 1,481 in NVFP4, het hoogste FP4-cijfer op de pagina.
De limiet van 450W geeft een 2U-koper inzicht in de waarde van de laatste 150W. Bij een maximaal vermogen van 450W, het maximum dat een PowerEdge R770-slot kan leveren, leverde de kaart 2 tot 5 procent in bij korte contexten en 4 tot 9 procent bij lange contexten, terwijl de FP8 MAMF-score gelijk bleef. Op het maximale vermogen levert de kaart 4.8 outputtokens per seconde per nominaal watt op het 14B-model, tegenover 3.8 bij 600W. Dit verklaart waarom een 2U-koper weinig verliest door de kaart daar te gebruiken.
Het is ook de enige kaart op deze pagina met RT-cores, vier encoders en decoders, en video-uitgangen. Een server die inferentie combineert met rendering, transcodering of virtuele werkstations onder vGPU heeft dus één kaart nodig voor al deze taken. Onze cijfers zijn afkomstig van de Workstation Edition in een Dell Pro Max Tower T2; NVIDIA geeft voor beide edities een vermogen van 600W op, ze presteren identiek in onze tests, en de Server Edition is de passieve, headless versie met dezelfde GB202 GPU en 96 GB GDDR7 met ECC.
Ook in ons lab: vier Server Edition-kaarten in de HPE ProLiant DL380a Gen12 , twee en vier kaarten in de Dell PowerEdge XE7740 in de ET900N G3-review , de enkele kaart in de Dell Pro Max Tower T2 die de bovenstaande resultaten opleverde, zowel de 300W Max-Q- als de 600W-kaarten in de Dell Pro Precision 9 T2 , waarbij de 600W-kaart de Xeon 4 tot 5 procent meer kostte bij CPU-belasting op alle cores, acht kaarten en 768 GB in de Comino Grando , en twee Max-Q-kaarten in de Dell Precision 7875 en HP Z8 Fury G6i.
Lees de volledige review van de NVIDIA RTX PRO 6000.
Beste single-slot GPU: NVIDIA RTX PRO 4500 Blackwell Server Edition

De RTX PRO 4500 Server Edition levert L40S-doorvoer vanuit een single-slot, 165W-kaart, precies wat de meeste gangbare servers al lang verwachtten. Met 32 streams op de chatvorm evenaarde of overtrof hij de L40S op elk FP8- en BF16-model: 1,107 tegen 995 tokens per seconde op de Ministral 3 14B FP8 en 2,006 tegen 1,988 op het 3B-model, en dat met een kaart die slechts 47 procent van het stroomverbruik van de L40S verbruikt en de helft van het aantal slots heeft. Ten opzichte van de L4 die hij vervangt, was hij 2.8 tot 3.6 keer sneller met 2.3 keer het stroomverbruik van de kaart, en een 2U-chassis dat vier dual-slot kaarten bevat, biedt plaats aan acht van deze kaarten.
De limiet is 32 GB: bij 8,192 token-input bleef de kaart 17 tot 33 procent achter op de L40S, en de prestatiecurves vlakte af bij acht streams, terwijl de 48 GB-kaart bleef doortrekken tot 16, omdat de KV-cache, en niet de rekenkracht, opraakte. Het is bovendien een full-height, full-length kaart met een 16-pins connector, waardoor de L4 niet in 1U- en half-height behuizingen past zonder een chassis dat speciaal is ontworpen voor FHFL-kaarten.
NVFP4 is het andere aandachtspunt, dat geldt voor elke kaart die we op deze vLLM-build hebben getest: op Qwen3.8-27B produceerde de 4500 320 tokens per seconde bij 32 streams, terwijl de FP4-hardware 569 TFLOPS haalde in MAMF. Het FP4-voordeel bestaat dus op GEMM-niveau en is nog niet doorgedrongen tot de serverstack. Twee MIG-partities van 16 GB, vertrouwelijke computing en vGPU 20 maken de datacenterfunctionaliteit compleet, die de Workstation Edition van dezelfde kaart niet heeft.
Ook in ons lab: dezelfde kaart tegen de L4-laag in een HPE ProLiant DL145 Gen11 , de edge-server die in de review aan deze voorafging.
Lees de volledige review van de NVIDIA RTX PRO 4500 Blackwell Server Edition.
Beste gangbare GPU voor inferentie die nog steeds verkrijgbaar is: NVIDIA L40S

De L40S is al twee jaar de standaard inferentiekaart voor de mainstreammarkt, en de 48 GB is de reden dat hij nog steeds een plekje verdient op een pagina over Blackwell-kaarten. Op het chatplatform verwerkte het 995 uitvoertokens per seconde bij 32 streams op de Ministral 3 14B FP8, 1,005 op het 8B-model en 1,988 op de 3B.
Dat is binnen 12 procent van de prestaties van de RTX PRO 4500 op alle vlakken, en zelfs beter bij 8K-documentatie met 230 tegen 190 voor het 14B-model, 277 tegen 185 voor het 8B-model en 475 tegen 384 voor het 3B-model. De curves blijven stijgen tot 16 streams in een lange context, waar de 32GB-kaart stopt bij acht.
De prijs voor dat geheugen is een dual-slot kaart van 350W op PCIe 4.0, en geen FP4-hardware; met de NVFP4-build van Qwen3.8-27B bereikte het 480 tokens per seconde door dequantisatie, wat 1.5 keer sneller was dan de 4500 in deze softwarebuild. De maximale MAMF-prestaties zijn 220 TFLOPS in BF16 en 369 in FP8, iets minder dan de helft van de RTX PRO 6000. Voor een vloot die al op L40S draait en waarvan de workloads een lange context vereisen, is het nog geen kaart om te vervangen; voor een nieuwe 2U-behuizing doet de single-slot 4500 hetzelfde werk met de helft van het aantal slots en het stroomverbruik.
Ook in ons lab: een enkele L40S in de Lenovo ThinkSystem SR650 V4 , en het grafische gedeelte van de kaart in ons L40S voor Omniverse -project.
Lees onze L40S-resultaten in de review van de RTX PRO 4500 Server Edition.
Beste slot-powered videokaart voor 1U- en Edge-systemen: NVIDIA L4
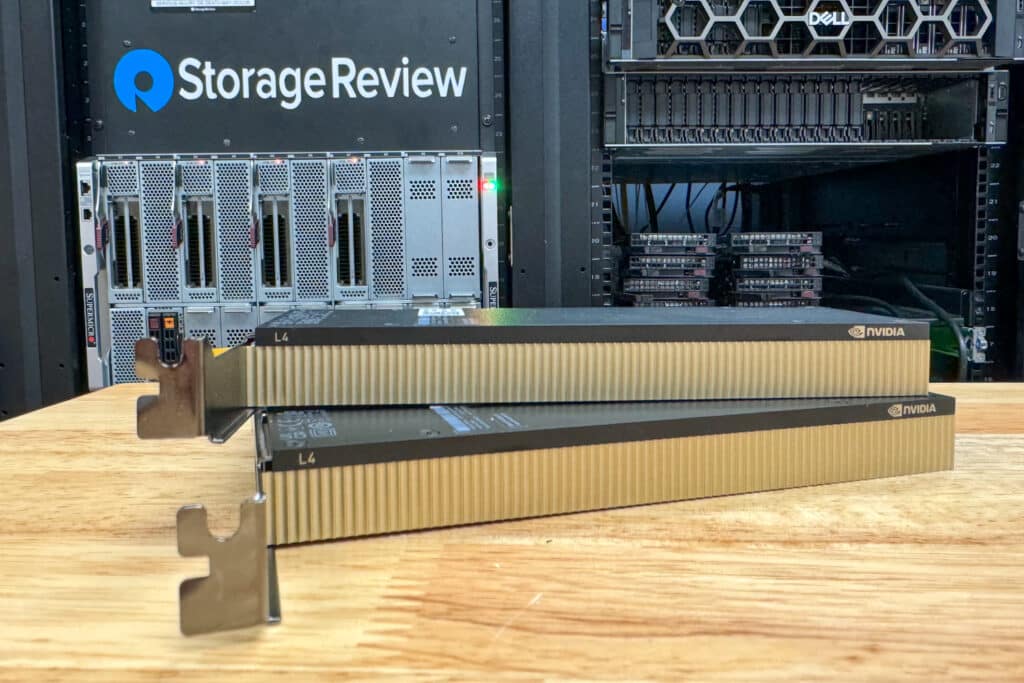
De L4 is de enige kaart op deze pagina die zijn stroom via het slot krijgt en in een halfhoge bay past, waardoor hij in 1U-servers en edge-boxen past waar geen nieuwere kaarten in passen. Met een vermogen van 72W leverde de kaart 364 outputtokens per seconde bij 32 streams op de Ministral 3 14B FP8, 279 op het 8B-model en 704 op het 3B-model. De outputtokens per seconde per watt (5.1) op het 14B-model zijn beter dan die van de L40S (2.8) en de RTX PRO 6000 (600W, 3.8).
De MAMF-limieten van 50 TFLOPS in BF16 en 116 in FP8 zijn hier de laagste, en het heeft geen FP4-pad, dus het 27B NVFP4-model paste niet in de 24GB.
Bij lange contexten houdt het op: op de 8,192-token-vorm bleef de L4-cache stabiel met vier streams op elk model, met 34 tot 130 tokens per seconde, omdat 24GB en 300GB/s slechts een klein aantal 8K-contexten tegelijk kunnen verwerken. De RTX PRO 4500 Server Edition is 2.8 tot 3.6 keer sneller, maar vereist een FHFL-slot en een 16-pins kabel, waardoor een L4-vloot in een 1U- of halfhoge behuizing geen directe vervanging is. In onze review van de RTX PRO 4500 edge hebben we beide kaarten gemeten in een HPE ProLiant DL145 Gen11, waar de 4500 2.7 keer sneller was dan de L4-cache.
Ook in ons lab: de L4 aan de rand van de Dell PowerEdge XR7620 , vier L4's in de Dell PowerEdge T560 en de kaart vergeleken met de RTX PRO 4500 in de HPE ProLiant DL145 Gen11.
Lees de volledige NVIDIA L4-recensie.
Ook getest
NVIDIA H100 NVL
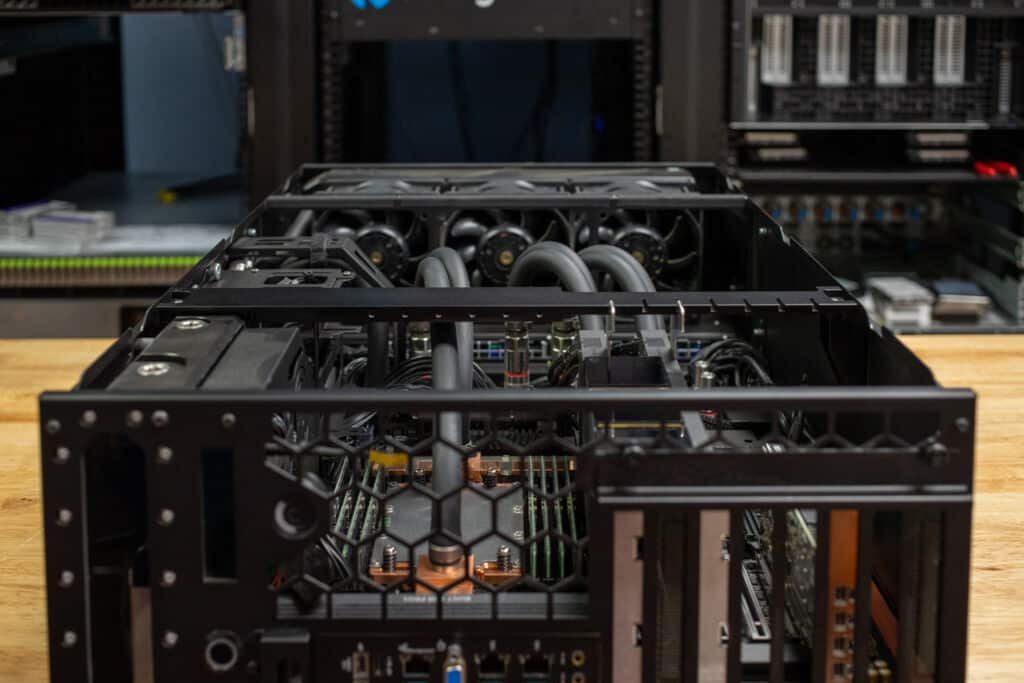
De H100 NVL draaide dezelfde ladder in dezelfde R770 en staat alleen in 'Ook getest' omdat er geen vergelijkbare Hopper op deze pagina staat om hem mee te vergelijken. Een generatie eerder was hij nog steeds 36 tot 61 procent sneller dan de RTX PRO 6000 bij gelijke gelijktijdigheid op de FP8- en BF16-modellen die we hebben getest.
In dezelfde R770, in dezelfde container, leverde de kaart 3,096 uitvoertokens per seconde bij 32 streams op Ministral 3 14B FP8, 3,449 op het 8B-redeneermodel en 5,873 op het 3B-model. Net als zijn opvolger schaalde de kaart op naar 128 streams en bereikte 6,038 op het 14B-model. Het MAMF-resultaat van 1,047 TFLOPS in FP8 ligt 35 procent hoger dan de 774 van de RTX PRO 6000.
De 94 GB HBM3 met een bandbreedte van 3.9 TB/s is de reden. Op het document behaalde het 14B-model 859 tokens per seconde bij 32 streams, 41 procent sneller dan de RTX PRO 6000 met een stroomverbruik van 600 W, met dezelfde curve als de H200, maar dan 21 tot 23 procent lager. Twee kaarten kunnen via NVLink een bridge vormen met een bandbreedte van 600 GB/s, de configuratie die we in onze review van de Comino Grando H100 bespreken. De kaart verbruikt 350 tot 400 W en is configureerbaar in een passieve dual-slot behuizing die op dezelfde risers past als een L40S.
Het schiet echter tekort op hetzelfde punt als de H200: voor NVFP4-controlepunten beschikt het niet over de benodigde hardware. Voor een koper die HBM-capaciteit nodig heeft en een offerte voor de H100 NVL heeft ontvangen, blijkt uit de gegevens dat dit de op één na snelste uitbreidingskaart is die we hebben getest, alleen de H200 NVL is sneller.
Ook in ons lab: hetzelfde paar H100 NVL's in onze R770 werd gebruikt voor de Graid SupremeRAID AE GPU Direct Storage-tests.
Lees de volledige review van de Comino Grando H100.
AMD Instinct MI350P

The MI350P is AMD’s first new PCIe Instinct card in four years, and it sits in Also Tested because it has not yet run the ranking ladder above. That ladder uses the NGC container and the Ministral 3 model set; our first look ran the card on stock vLLM for ROCm at 450W in a 2U PowerEdge R7725, against a 600W rating. It carries 144GB of HBM3E at 4TB/s, the most memory of any PCIe accelerator we have tested, 3GB above the H200 NVL.
On the tests that overlap, it lands between the two NVIDIA cards. MAMF reached 1,120 TFLOPS in FP8 and 2,228 in block-scaled FP4 at 450W, 36 to 38 percent above the 600W RTX PRO 6000 at every precision in that review’s runs and behind the H200 NVL in BF16 and FP8. On GPT-OSS-120B at 128 streams on the chat shape, one card served 5,057 output tokens per second against 3,064 for the RTX PRO 6000 and 3,376 for the H200 NVL, and on 512-token prompts it beat the RTX PRO 6000 by 35 to 65 percent on every FP8, BF16, and GPT-OSS model.
The H200 NVL stays 4 to 18 percent ahead on the dense FP8 and BF16 models at 128 streams on chat prompts, and on 8,192-token prompts the MI350P trails it by 25 to 58 percent on the same models and flattens by 16 streams on Llama 3.1 8B and MiniMax M2.7. Its two-card results, where a pair holds MXFP4 builds of MiniMax M3 and GLM-5.2 that take four RTX PRO 6000s, ran on ROCm 7.2.3 and appear under Scale-Out Configurations.
It ranks once it completes the Ministral 3 ladder at 600W in a PowerEdge XE7745, which Dell supports with eight MI350Ps. Until then, for a buyer whose models sit between 96GB and 144GB, it is one of two PCIe cards that keep them on a single GPU, and the only one past 141GB.
Read the AMD Instinct MI350P first look
Schaalbare configuraties
Een kaart verdient zijn positie op deze pagina als een enkele kaart. Resultaten van meerdere kaarten worden hier weergegeven als configuraties, zonder rangschikking, omdat ze verschillende modelsets en softwarestacks gebruiken en niet ten opzichte van elkaar of de rangschikking van enkele kaarten hierboven kunnen worden gerangschikt. Elke rij toont het gemeten resultaat en de review waaruit het afkomstig is.
| Configuratie | gastheer | Gemeten resultaat | Opstapelen | Bron |
|---|---|---|---|---|
| 4x NVIDIA RTX PRO 6000 Blackwell Server Edition (384 GB) | Dell PowerEdge XE7740 | MiniMax M3 NVFP4: 1,181 uitvoertokens/s bij 16 streams, 759 bij 32 (512/512) | NGC vLLM 26.08, MTP speculatieve decodering | Review van de ET900N G3 |
| 4x NVIDIA RTX PRO 6000 Blackwell Server Edition (384 GB) | HPE ProLiant DL380a Gen12 | GPT-OSS-120B NVFP4, TP4: 4,016 totale tokens/s bij batch 64, 3,956 bij batch 32; Llama 3.2 90B Vision: 1,372 totale tokens/s bij batch 128 | vLLM online service | Review van de DL380a Gen12 |
| 2x NVIDIA RTX PRO 6000 Blackwell Server Edition (192 GB) | Dell PowerEdge XE7740 | MiniMax M2.7 NVFP4: 1,932 uitvoertokens/s bij 128 streams (512/512), 511 op 8K/1K | NGC vLLM 26.08 | Review van de ET900N G3 |
| 4x Intel Gaudi 3 PCIe (512GB HBM) | Dell PowerEdge XE7740 | Llama 3.1 70B, TP4: ongeveer 3,600 tokens per seconde bij 128 gelijktijdige verzoeken (1,024/1,024); FP8-paden zijn trager dan BF16 in deze build. | Intel vLLM fork 2.7.1 op Gaudi Docker 1.22.2 | XE7740 Review (gesponsord door Dell) |
| 2x AMD Instinct MI350P (288GB), 450W per card | Dell PowerEdge R7725 | MiniMax M3 MXFP4: 998 output tokens/s at 16 streams, 1,509 at 32 (512/512); DeepSeek-V4-Flash FP8: 1,081 output tokens/s at 32 streams (512/512), 621 on 8K/1K | vLLM on ROCm 7.2.3 | MI350P First Look |
De Intel vLLM-fork had zijn FP8-paden ten tijde van de test nog niet geoptimaliseerd, waardoor FP8 trager draaide dan BF16. Het resultaat van de MiniMax M3 laat de maximale schaalbaarheid van PCIe zien op een model dat nauwelijks in 384 GB past. Vier kaarten presteerden beter dan een enkele GB300 DGX Station bij 16 streams, maar vielen terug bij 32 streams toen de lange prompts de cache overbelastten.
Voorbij de sleuf
Een model dat meer dan 141 GB op één kaart nodig heeft, of een serverbelasting die tientallen streams vereist op een 400B-klasse checkpoint, is niet langer geschikt voor de markt van insteekkaarten. De GB300 DGX Station-klasse staat op onze lijst met beste desktops voor lokale AI , waar een enkele Blackwell Ultra GPU met 252 GB HBM3e naast de H200 NVL in dezelfde grafiek staat. De HGX B200 en AMD Instinct MI350X-systemen uit onze Supermicro JumpStart-reviews horen thuis op de lijst met beste servers . Deze systemen worden als geheel beoordeeld, niet als afzonderlijke kaarten, en worden hier niet gerangschikt.
Hoe we rang
Er gelden drie regels voor elke StorageReview-ranglijst. De eerste is dat alleen in het lab geteste kaarten worden gerangschikt: kaarten die we niet hebben gebenchmarkd, mogen wel worden genoemd, maar kunnen geen categorie toegewezen krijgen. Ten tweede worden kaarten afzonderlijk getest in een host die ze ondersteunt, met het vermogen dat die host levert. Dit vermogen wordt bij elke vermelding vermeld; de H200 NVL-kaart in de bovenstaande opmerking is het enige geval waarin de beoordeling en het geteste vermogen verschillen.
Ten derde zijn workstation-videokaarten van deze pagina uitgesloten, met één expliciete uitzondering: wanneer NVIDIA dezelfde chip als serverchip verkoopt en de twee identieke profielen hebben, wordt de workstation-videokaart als zodanig beschouwd en wordt dit in de beschrijving vermeld.
De ranglijsten zijn gebaseerd op de doorvoer van de vLLM online serveroutput, de inferentieworkload van de onderneming, bij gelijke gelijktijdigheid op een gedeelde modelset, waarbij de documentvorm van 8,192 tokens en de MAMF-rekenresultaten de doorslag geven bij gelijke scores, en de geheugencapaciteit de haalbaarheidscategorie bepaalt. Leveranciers zien de ranglijsten niet vóór publicatie, geen enkele plaatsing op deze pagina is betaald en waar een gesponsord artikel wordt geciteerd, wordt dit als zodanig aangegeven. Nieuwe kaarten worden toegevoegd zodra ze dezelfde test op dezelfde container hebben voltooid, en het wijzigingslogboek bovenaan registreert elke wijziging.
Software stacks change every few weeks, so each figure on this page comes from the run that set the ranking, and later reviews may report newer runs of the same card. We re-rank when a newer run changes the order, not when a number moves.
Veelgestelde vragen over Enterprise GPU's
Wat is de beste GPU voor inferentie in bedrijfsomgevingen?
Voor de 2U- en 4U-inferentieservers die de meeste bedrijven aanschaffen, is de RTX PRO 6000 Blackwell Server Edition de beste keuze. Deze kaart combineert 96 GB, de hoogste FP4-rekenkracht die we ooit in een PCIe-kaart hebben gemeten, MIG, vGPU en grafische en video-engines in een kaart die slechts 2 tot 9 procent van zijn doorvoer verliest bij de 450 W die een standaard slot levert.
De H200 NVL is de snelste kaart wanneer geheugen en bandbreedte de belangrijkste factoren zijn voor de werkbelasting, en presteerde beter dan alle modellen die we hebben getest. Een implementatie met modellen van 70 tot 120 bytes die geschikt zijn voor hoge gelijktijdigheid, zou daarom daar moeten beginnen. De RTX PRO 4500 Server Edition is de beste keuze wanneer het slot slechts één breedte heeft, of wanneer het stroombudget 165W is.
RTX PRO 6000 versus H100 NVL: welke is sneller voor inferentie?
De H100 NVL is 36 tot 61 procent sneller bij gelijke gelijktijdigheid op de FP8- en BF16-modellen die we in dezelfde vLLM-container hebben getest, en 41 tot 52 procent sneller op de documentstructuur met 8,192 tokens, omdat 94 GB HBM3 met een doorvoersnelheid van 3.9 TB/s sneller decodeert dan 96 GB GDDR7 met een doorvoersnelheid van 1.6 TB/s. De RTX PRO 6000 wint het op NVFP4-checkpoints, waar de H100 geen FP4-hardware heeft, en is de enige van de twee met grafische, video- en weergavemogelijkheden. Koop de H100 NVL voor doorvoersnelheid op FP8- en BF16-modellen; koop de RTX PRO 6000 voor een gemengde workload of met het oog op FP4-implementatie.
H100 NVL versus H200 NVL: is de upgrade de moeite waard?
De H200 NVL presteerde 10 tot 12 procent beter dan de H100 NVL bij 32 streams in de chat-vorm en 21 tot 23 procent beter bij 128 streams en in de documentvorm met 8,192 tokens, met 141 GB versus 94 GB geheugen en 4.8 TB/s versus 3.9 TB/s. Deze cijfers zijn gebaseerd op de H200 met een vermogen van 450 W, het maximale vermogen dat een 2U R770-slot kan leveren. Het vermogen van 600 W is niet getest in ons lab, dus het verschil is een minimum. Het capaciteitsverschil is voor de meeste kopers doorslaggevend: een 120B-klasse model in FP8 dat 141 GB geheugen bevat, vereist twee H100 NVL's.
L40S versus RTX PRO 6000: wat levert de grotere kaart op?
In een korte context leverde de RTX PRO 6000 2.1 tot 2.3 keer de uitvoerdoorvoer van de L40S bij 32 streams op de Ministral-set. Bij een invoer van 8,192 tokens steeg de verhouding naar 2.2 tot 2.6 keer, omdat de 48GB-kaart bij 16 streams de KV-cache niet meer aankon, terwijl de 96GB-kaart bleef schalen. De 6000 biedt ook FP4-hardware, PCIe 5.0 en MIG met vier partities van 24 GB, met een stroomverbruik van 600W tegenover 350W. Voor langdurige contexten of multi-tenant-toepassingen is de 6000 de betere keuze; voor chat-lange verwerking met het vermogen van de L40S is de single-slot RTX PRO 4500 een betere optie.
L4 versus RTX PRO 4500: is een L4-vloot een upgrade waard?
De RTX PRO 4500 Server Edition behaalde 2.8 tot 3.6 keer de doorvoersnelheid van de L4 bij korte context in onze R770 en 2.7 keer in een HPE ProLiant DL145 Gen11, met een stroomverbruik van 165W tegenover 72W en met 32GB tegenover 24GB. Het verschil zit hem in de fysieke afmetingen: de 4500 is een full-height, full-length kaart met een 16-pins connector, terwijl de L4 een half-height, slot-powered kaart is. Daarom is de 4500 niet geschikt voor 1U-servers en kleine edge-boxen die rond de L4 zijn gebouwd. Upgrade naar een full-height full-length kaart waar de behuizing een FHFL-slot heeft; behoud de L4 waar dit niet het geval is.
RTX PRO 6000 Server Edition versus Workstation Edition: wat is het verschil?
Dezelfde GB202 GPU, 96 GB GDDR7 met ECC en een vermogen van 600 W; NVIDIA geeft ze identieke specificaties en ze presteren ook hetzelfde in onze tests. Daarom staan de gegevens van de Workstation Edition op deze pagina in plaats van die van de Server Edition. De Server Edition is passief en zonder monitor, ontworpen voor optimale luchtstroom in de behuizing, en beschikt over de datacenterfunctionaliteiten MIG, vertrouwelijke computing en vGPU; de Workstation Edition is actief gekoeld en heeft vier DisplayPort-uitgangen. Een serverkoper kiest voor de Server Edition; de specificaties zijn in beide gevallen hetzelfde.
Wat is het verschil tussen een PCIe GPU en een SXM- of HGX-module?
Een PCIe-accelerator is een insteekkaart die in een standaard slot wordt geplaatst en 72 tot 600 watt verbruikt. Daarom past deze in de 2U- en 4U-servers die al in een rack staan. Communicatie tussen meerdere kaarten verloopt via PCIe of een NVLink-brug. SXM- en OAM-modules worden op een basiskaart gesoldeerd in speciaal daarvoor ontworpen systemen zoals de HGX B200 of MI350X-platforms. Deze modules verbruiken 700 tot 1,400 watt per GPU en maken verbinding via een volledig NVLink- of Infinity Fabric-netwerk. Op deze pagina wordt het eerste type besproken; het tweede type wordt behandeld op onze pagina's over server- en lokale AI-desktopboards.
Hoeveel GPU-geheugen heeft een inferentieserver nodig?
Het hangt af van het model en de context. Op deze pagina konden kaarten van 24 GB en 32 GB modellen van 3 tot 14 bytes probleemloos verwerken bij een chatlengte en werden ze afgevlakt door vier tot acht streams bij een invoer van 8,192 tokens; 48 GB bleef oplopen tot 16 streams, 96 GB kwam nooit tekort bij dezelfde modellen, en de 141 GB H200 NVL kon GPT-OSS-120B verwerken op één kaart in onze ET900N G3-tests. Houd eerst rekening met de gewichten, daarna met de KV-cache voor de verwachte gelijktijdigheid, en beschouw lange contexten of multi-tenant-toepassingen als een vereiste van 48 GB of meer.
Maakt het verschil tussen 450W en 600W uit bij een 2U-server?
Less than the rating gap suggests, on the one card we have measured both ways. Capped to 450W, the most a PowerEdge R770 slot delivers, the RTX PRO 6000 gave up 2 to 5 percent of output throughput at short context and 4 to 9 percent at long context, and its FP8 MAMF result did not change, which returned 25 percent of its power budget for a 2 to 9 percent cost. The H200 NVL on this page was tested at 450W for the same reason, and its full 600W result has not yet been measured. The AMD Instinct MI350P in our first look also ran at 450W in a 2U PowerEdge R7725, against a 600W rating, and we will measure the difference in a PowerEdge XE7745.


 Amazon