

Google en AMD hebben belangrijke ontwikkelingen in kunstmatige intelligentie aangekondigd. Google introduceerde Gemma 3, de nieuwste generatie van zijn open-source AI-modelserie. Tegelijkertijd kondigde AMD integratie aan met het Open Platform for Enterprise AI (OPEA) en lanceerde het zijn Instella-taalmodellen.
Google's Gemma 3: Multimodale AI-efficiëntie op minimale hardware
De release van Gemma 12 op 3 maart bouwt voort op het succes van Gemma 2. Het nieuwe model introduceert multimodale mogelijkheden, meertalige ondersteuning en verbeterde efficiëntie, waardoor geavanceerde AI-prestaties mogelijk zijn, zelfs op beperkte hardware.
Gemma 3 is beschikbaar in vier formaten: 1B, 4B, 12B en 27B parameters. Elke variant is verkrijgbaar in zowel basis (vooraf getrainde) als instructie-afgestemde versies. De grotere modellen (4B, 12B en 27B) bieden multimodale functionaliteit en verwerken naadloos tekst, afbeeldingen en korte video's. De SigLIP vision encoder van Google converteert visuele invoer naar tokens die interpreteerbaar zijn door het taalmodel, waardoor Gemma 3 op afbeeldingen gebaseerde vragen kan beantwoorden, objecten kan identificeren en ingebedde tekst kan lezen.
Gemma 3 breidt ook zijn contextvenster aanzienlijk uit, met ondersteuning voor maximaal 128,000 tokens vergeleken met de 2 tokens van Gemma 80,000. Hierdoor kan het model meer informatie verwerken binnen één prompt. Bovendien ondersteunt Gemma 3 meer dan 140 talen, wat de wereldwijde toegankelijkheid verbetert.
LMSYS Chatbot Arena-ranglijsten
Gemma 3 is snel uitgegroeid tot een van de best presterende AI-modellen op LMSYS Chatbot Arena , een benchmark die grote taalmodellen evalueert op basis van menselijke voorkeuren. Gemma-3-27B behaalde een Elo-score van 1338, waarmee het wereldwijd de negende plaats behaalde. Dit plaatst het voor bekende concurrenten zoals DeepSeek-V3 (1318), Llama3-405B (1257), Qwen2.5-72B (1257), Mistral Large en Google's eerdere Gemma 2-modellen.
AMD versterkt Enterprise AI met OPEA-integratie
AMD heeft op 12 maart 2025 de ondersteuning voor het Open Platform for Enterprise AI (OPEA) aangekondigd. Deze integratie verbindt het OPEA GenAI-framework met de ROCm-softwarestack van AMD, waardoor ondernemingen schaalbare generatieve AI-toepassingen efficiënt kunnen implementeren op AMD-datacenter-GPU's.
De samenwerking richt zich op belangrijke AI-uitdagingen voor bedrijven, waaronder complexiteit van modelintegratie, GPU-resourcebeheer, beveiliging en flexibiliteit van de workflow. Als lid van OPEA's technische stuurgroep werkt AMD samen met leiders in de industrie om samenstelbare generatieve AI-oplossingen mogelijk te maken die in openbare en privé-cloudomgevingen kunnen worden ingezet.
OPEA biedt essentiële AI-applicatiecomponenten, waaronder vooraf gebouwde workflows, evaluatiemogelijkheden, embeddingmodellen en vectordatabases. De cloud-native, op microservices gebaseerde architectuur zorgt voor naadloze integratie via API-gestuurde workflows.
AMD lanceert Instella: volledig open 3B-parametertaalmodellen
AMD introduceerde ook Instella, een familie van volledig open-source taalmodellen met 3 miljard parameters, volledig ontwikkeld op AMD-hardware.
Technische innovaties en trainingsaanpak
Instella-modellen gebruiken een tekst-alleen autoregressieve transformerarchitectuur met 36 decoderlagen en 32 aandachtskoppen per laag, die sequenties tot 4,096 tokens ondersteunen. De modellen gebruiken een vocabulaire van ongeveer 50,000 tokens via de OLMo-tokenizer.
Na een multi-stage pipeline vond de training plaats op 128 AMD Instinct MI300X GPU's verspreid over 16 nodes. De eerste pre-training omvatte ongeveer 4.065 biljoen tokens van diverse datasets die codering, academici, wiskunde en algemene kennis omvatten. Een tweede pre-trainingsfase verfijnde de probleemoplossende capaciteiten met behulp van nog eens 57.575 miljard tokens van gespecialiseerde benchmarks zoals MMLU, BBH en GSM8k.
Na de pre-training onderging Instella supervised fine-tuning (SFT) met 8.9 miljard tokens van gecureerde instructie-responsgegevens, wat de interactieve mogelijkheden verbeterde. Een laatste Direct Preference Optimization (DPO)-fase stemde het model nauw af op menselijke voorkeuren, met behulp van 760 miljoen tokens van zorgvuldig geselecteerde gegevens.
Indrukwekkende benchmarkprestaties
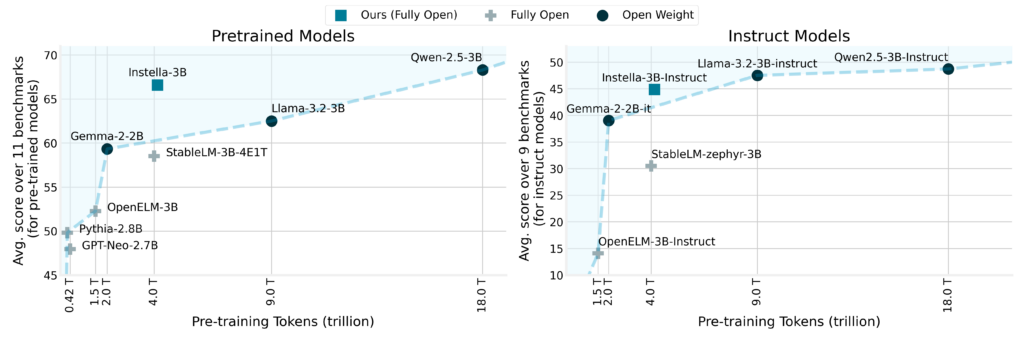
Benchmarkresultaten benadrukken de opmerkelijke prestatiewinsten van Instella. Het model presteerde gemiddeld ruim 8% beter dan bestaande volledig open modellen, met indrukwekkende resultaten in benchmarks zoals ARC Challenge (+8.02%), ARC Easy (+3.51%), Winograde (+4.7%), OpenBookQA (+3.88%), MMLU (+13.12%) en GSM8k (+48.98%).
In tegenstelling tot toonaangevende open-gewichtmodellen zoals Llama-3.2-3B en Gemma-2-2B, toonde Instella superieure of zeer competitieve prestaties bij meerdere taken. De op instructie afgestemde variant, Instella-3B-Instruct, toonde significante voordelen ten opzichte van andere volledig open op instructie afgestemde modellen met een gemiddelde prestatievoorsprong van meer dan 14%, terwijl het ook competitief presteerde ten opzichte van toonaangevende open-gewicht op instructie afgestemde modellen.
Volledige open-source release en beschikbaarheid
In lijn met AMD's toewijding aan open-sourceprincipes heeft het bedrijf alle artefacten met betrekking tot Instella-modellen vrijgegeven, inclusief modelgewichten, gedetailleerde trainingsconfiguraties, datasets en code. Deze volledige transparantie stelt de AI-community in staat om samen te werken, te repliceren en te innoveren met deze modellen.
Conclusie
Deze aankondigingen van Google en AMD vormen het decor voor een spannend jaar in AI-innovatie. Het momentum in de sector is duidelijk met Gemma 3 die multimodale efficiëntie opnieuw definieert en AMD's Instella-modellen en OPEA-integratie die enterprise AI mogelijk maken. Nu we de GTC-conferentie van NVIDIA naderen en verdere baanbrekende releases verwachten, is het duidelijk dat deze ontwikkelingen nog maar het begin zijn van wat komen gaat.


 Amazon