

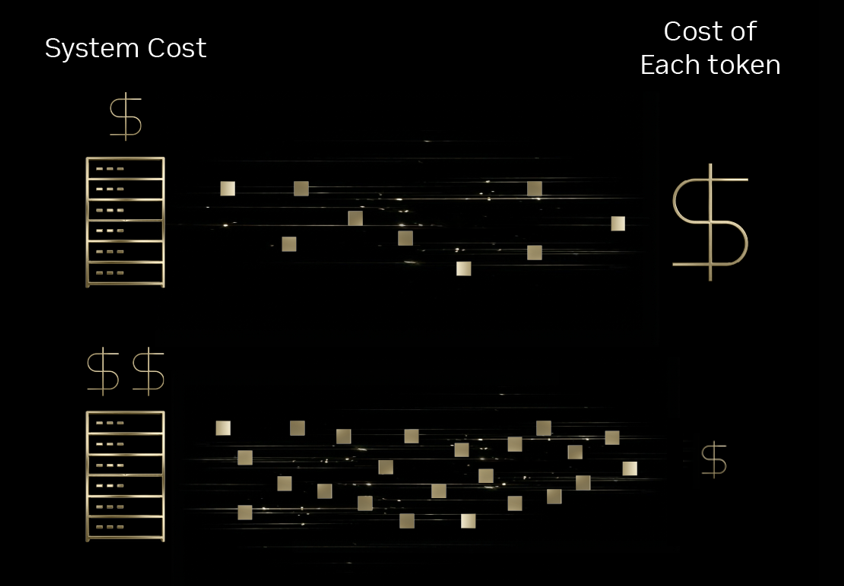
De fundamentele intelligentie-eenheid in moderne AI-interacties is het token. Of het nu gaat om klinische diagnostiek, interactieve game-dialogen of autonome klantenserviceagenten, de schaalbaarheid van deze toepassingen is sterk afhankelijk van tokenomics. Recente gegevens van MIT tonen aan dat verbeteringen in infrastructuur en algoritme-efficiëntie de inferentiekosten tot wel tien keer per jaar verlagen. Toonaangevende inferentieproviders, waaronder Baseten, DeepInfra, Fireworks AI en Together AI, gebruiken nu het NVIDIA Blackwell-platform om deze efficiëntie te bereiken, waarbij ze de vorige Hopper-generatie vaak met een factor tien overtreffen.
Efficiëntie in de gezondheidszorg via Baseten en Sully.ai
In de gezondheidszorgsector leiden administratieve lasten, zoals medische codering en documentatie, tot een aanzienlijke belemmering voor de patiëntenzorg. Sully.ai pakt dit aan door AI-agenten in te zetten om deze routinetaken te automatiseren. Voorheen kampte het bedrijf met knelpunten, waaronder onvoorspelbare latentie en inferentiekosten die de omzetgroei overtroffen bij het gebruik van eigen, gesloten modellen.
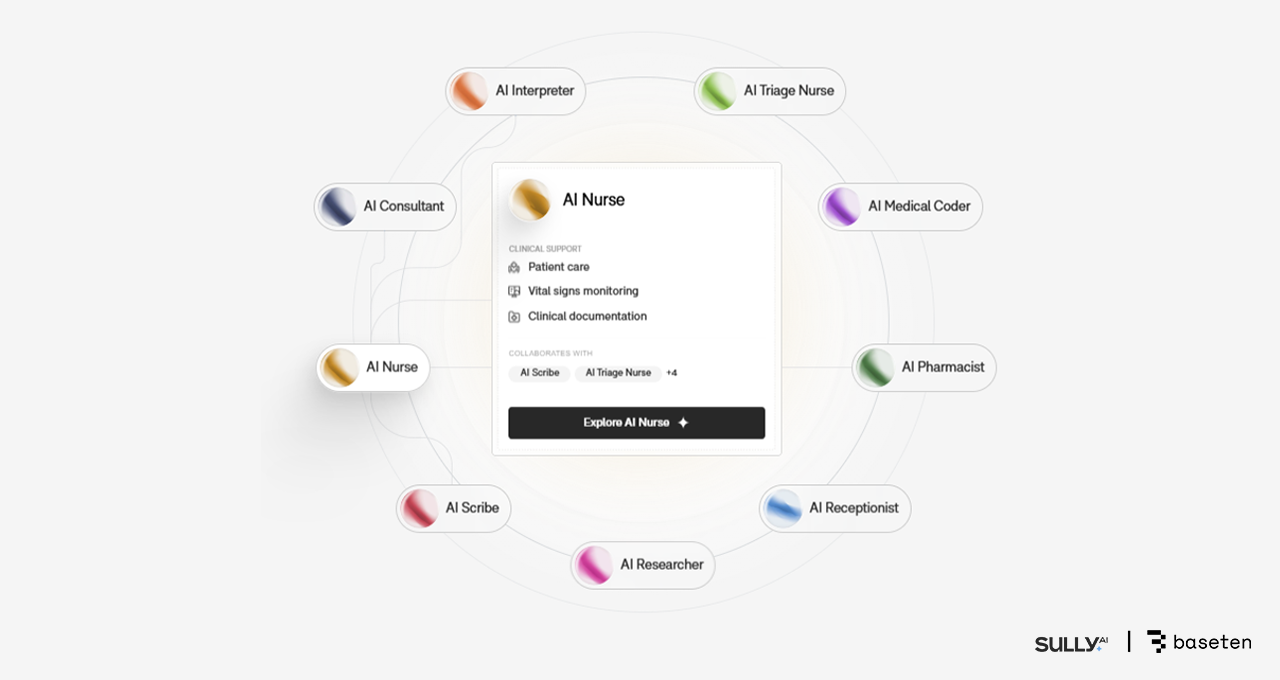
Door over te stappen op Baseten's Model API, die gebruikmaakt van open-source modellen op NVIDIA Blackwell GPU's, heeft Sully.ai een kostenbesparing van 90 procent gerealiseerd op het gebied van data-inferentie. Baseten optimaliseerde de stack met het NVFP4-dataformaat, TensorRT-LLM en het NVIDIA Dynamo-inferentieframework. De overstap leverde 2.5 keer zoveel doorvoer per dollar op in vergelijking met Hopper en een verbetering van 65% in responstijden. Tot nu toe heeft de implementatie artsen meer dan 30 miljoen minuten bespaard door handmatige data-invoer te automatiseren.
Gamingprestaties met DeepInfra en Latitude
Latitude, de ontwikkelaar achter AI Dungeon en het Voyage RPG-platform, staat voor unieke schaalbaarheidsuitdagingen omdat elke spelersactie een inferentieverzoek vereist. Om een soepele gameplay te garanderen, zijn lage latentie en kosteneffectieve tokenlevering essentieel. Door grootschalige Mixture-of-Experts (MoE)-modellen te draaien op de door Blackwell aangedreven infrastructuur van DeepInfra, heeft Latitude aanzienlijke kostenbesparingen gerealiseerd.
DeepInfra verlaagde de kosten per miljoen tokens van 20 cent op Hopper naar 10 cent op Blackwell. Door gebruik te maken van Blackwells eigen NVFP4-formaat met lage precisie, werden de kosten verder gehalveerd tot 5 cent per miljoen tokens. Deze verviervoudiging stelt Latitude in staat om complexere modellen te implementeren en pieken in het verkeer op te vangen zonder dat dit ten koste gaat van de gebruikerservaring of de nauwkeurigheid.
Schaalbare agentische workflows met Fireworks AI en Sentient
Sentient Labs ontwikkelt open-source AI-systemen voor redenering, zoals Sentient Chat, die workflows met meerdere agenten orkestreren. Deze complexe interacties leiden vaak tot een cascade van autonome taken, wat aanzienlijke infrastructuurkosten met zich meebrengt. Door gebruik te maken van het inferentieplatform van Fireworks AI op NVIDIA Blackwell, behaalde Sentient een kostenbesparing van 25 tot 50 procent ten opzichte van implementaties op basis van Hopper.
De verhoogde doorvoer per GPU stelde Sentient in staat om enorme aantallen gelijktijdige gebruikers te verwerken. Tijdens een virale lanceringsfase verwerkte het platform 1.8 miljoen gebruikers op de wachtlijst binnen 24 uur en verwerkte het 5.6 miljoen zoekopdrachten in één week. De door Blackwell geoptimaliseerde stack handhaafde een consistent lage latentie ondanks het hoge queryvolume.
Zakelijke spraakondersteuning via Together AI en Decagon
Decagon levert AI-agenten voor zakelijke klantenservice, waar spraakinteracties reactietijden van minder dan een seconde vereisen om effectief te blijven. Together AI host Decagons multimodel spraakstack op NVIDIA Blackwell en implementeert optimalisaties zoals speculatieve decodering en caching van herhaalde gesprekselementen.
Deze technische verbeteringen brachten de responstijden terug tot minder dan 400 milliseconden, zelfs voor query's met duizenden tokens. Door open-source en eigen modellen te combineren met Blackwells co-design van hardware en software, verlaagde Decagon de kosten per query met een factor 6 ten opzichte van propriëtaire, gesloten alternatieven.
De toekomst van tokenomics
De overstap naar NVIDIA Blackwell, met name het GB200 NVL72-systeem, markeert een verschuiving in de manier waarop redeneringsmodellen voor MoE (Model of Excellence) op grote schaal worden ingezet. Het vermogen van het platform om de kosten per token met een factor 10 te verlagen, is het resultaat van een diepe integratie tussen de reken-, netwerk- en softwarelagen. Naar verwachting zal het aankomende NVIDIA Rubin-platform deze trend voortzetten en een verdere verbetering van de prestaties en de kostenefficiëntie per token met een factor 10 realiseren ten opzichte van de Blackwell-architectuur.


 Amazon