

Intel presenteerde zijn plannen voor high-performance computing (HPC) tijdens SC26, met Diamond Rapids, de volgende generatie Xeon-serverarchitectuur, als centraal element. Intel zegt dat het platform schaalbaar zal zijn tot 256 prestatiekernen met een geheugenbandbreedte tot 1.6 TB/s en tot 1.28 GB last-level cache. De uiteenzetting kwam van Jeff McVeigh, vicepresident en algemeen directeur van Data Center Strategic Programs, en omvat ook de Intel GPU D-serie, HPC-software, siliciumfotonica en kwantumontwikkeling. Intel heeft geen lanceringsdatum voor Diamond Rapids bekendgemaakt.
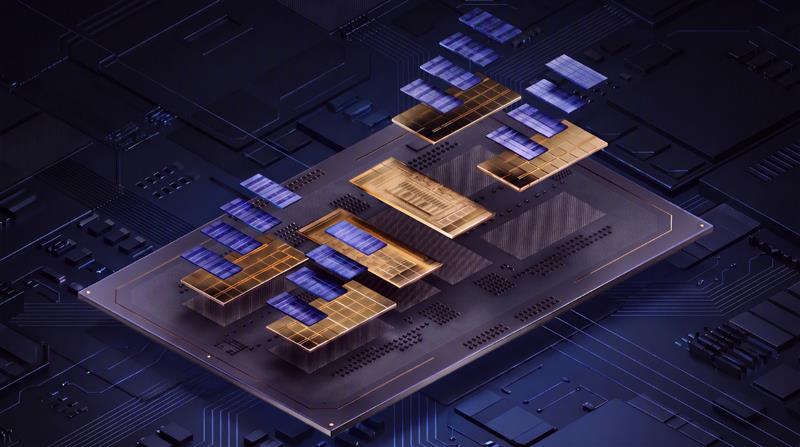
Diamond Rapids CPU-architectuur
Intel beschrijft Diamond Rapids , dat het tijdens Hot Chips als een 18A-P-ontwerp presenteerde, als een combinatie van een hogere rekendichtheid met meer geheugenbandbreedte, grotere caches en verbeterde CPU-acceleratie. Intel Advanced Performance Extensions (APX) zijn gericht op prestaties per thread, en wat Intel een uniforme geheugenstructuur noemt, levert de 1.6 TB/s op. Intel heeft niet bekendgemaakt hoeveel geheugenkanalen of welke geheugensnelheid er achter dit getal schuilgaan, of dat het per socket geldt.
De architectuur ondersteunt ook Intel AVX 10.2 en verbeterde Intel Advanced Matrix Extensions (Intel AMX). Intel noemt de volgende generatie Xeon de enige x86-server-CPU met ingebouwde matrixcomputing voor HPC- en AI-workloads. Ter referentie: de beste AMD EPYC Venice- processors die we hebben getest, hebben 256 Zen 6c-cores per socket.
McVeigh schetste de routekaart rondom gemengde systemen waarin CPU's workflows orkestreren en parallelle communicatiebibliotheken uitvoeren, terwijl accelerators het AI-werk voor hun rekening nemen. Hij schreef dat de toekomst van HPC "open, heterogeen en evenwichtig" is.
Intel GPU D-serie en HPC-software
De Intel GPU D-serie combineert AI-acceleratie met dubbele-precisie (FP64) berekeningen in een luchtgekoelde PCIe-kaart, met ondersteuning voor datatypes van FP4 en MXFP4 tot en met FP64. De Intel GPU D270 heeft 160 GB LPDDR5X-geheugen met een bandbreedte van 1.5 TB/s, en door partners ontworpen configuraties schalen op tot 480 GB. Intels argument voor onderzoeksomgevingen is gebaseerd op de geheugencapaciteit, omdat het bewaren van grotere datasets op de kaart de partitionering en de overdracht van host naar accelerator vermindert die wetenschappelijke workflows vertragen. Intel promoot de kaart ook voor altijd actieve AI-agenten die code genereren en rekentaken uitvoeren.
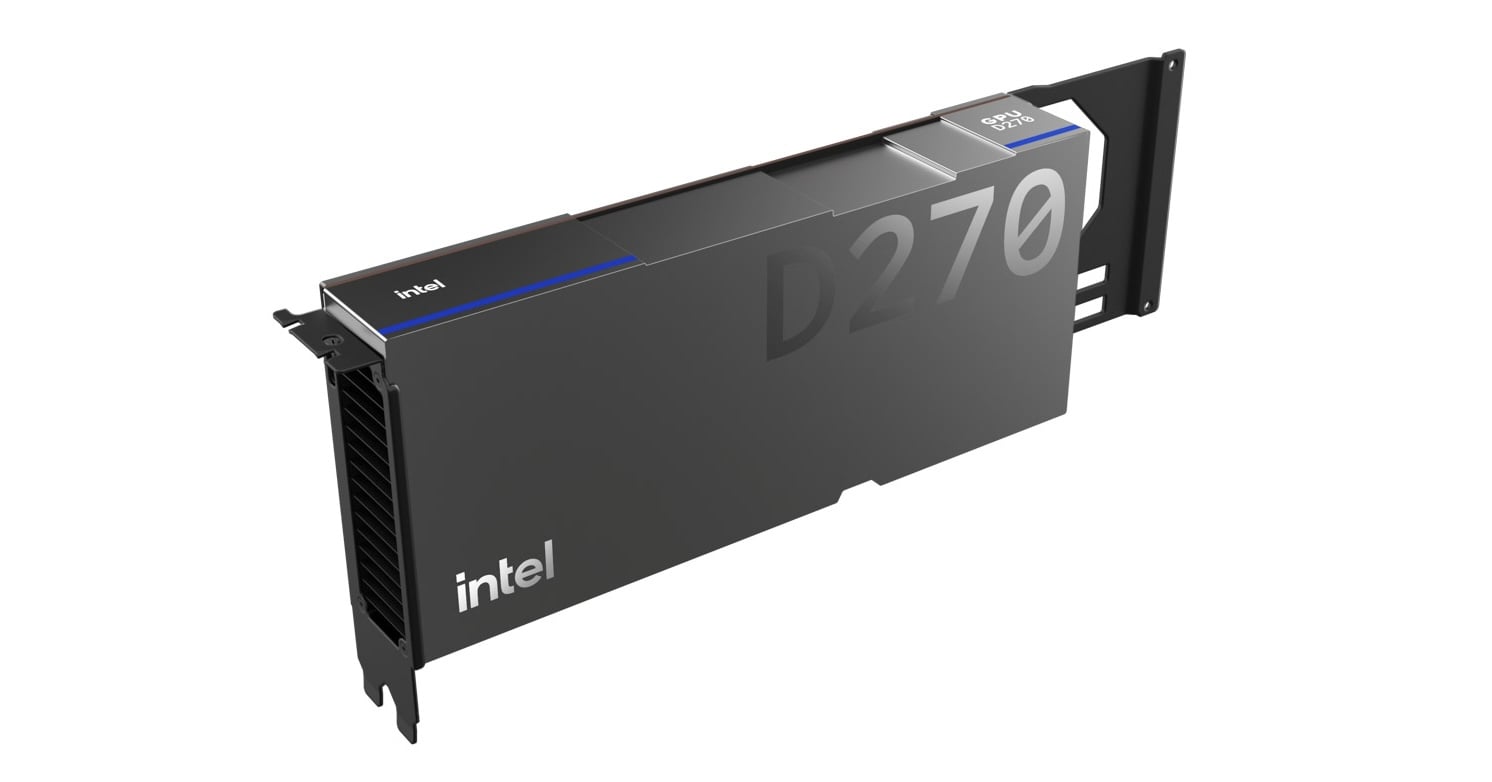
Intel geeft op zijn SC26-stand twee live demonstraties van de GPU D270, de D-serie kaart die voorheen bekend stond onder de codenaam Crescent Island. De eerste is een mini-applicatie voor seismische beeldvorming van Veridien, die in minder dan een maand van HIP en CUDA naar SYCL is geporteerd. Intel geeft aan dat 90% van de kernels probleemloos draaide zonder Intel-specifieke optimalisaties. De tweede demonstratie verdeelt een inferentiepipeline over D270-kaarten die de prefill-bewerkingen uitvoeren en SambaNova SN50-eenheden die de decodering verzorgen, waarbij Xeon 6- en Xeon 6+-processors de processen coördineren.
Intel publiceerde ook vergelijkingen met NVIDIA's RTX PRO 6000 Blackwell Server Edition. Bij FP64-financiële workloads claimt Intel tot 5.9x hogere doorvoer op European Monte Carlo, 5.6x op European Black-Scholes, 4.6x op binomiale prijsstelling en 1.92x op American Black-Scholes, waarbij de D270 350W verbruikt en de NVIDIA-kaart 600W. Voor inferentie claimt Intel tot 29% lagere latentie op Drex v2.0 en 1.12x hogere uitvoertokendoorvoer op Qwen3-30B-A3B bij FP8.
Dit zijn resultaten van de leverancier op pre-productiechips, en wij hebben deze niet zelf uitgevoerd of gecontroleerd. De financiële testconfiguratie van Intel vermeldt acht NVIDIA-kaarten tegenover één D270 en geeft niet aan of de resultaten per kaart zijn genormaliseerd. De inferentietests van NVIDIA werden uitgevoerd op een virtuele machine van AWS.
Wat software betreft, zegt Intel dat het blijft investeren in Intel MPI, Fortran, compileroptimalisaties en oneAPI, zodat bestaande parallelle codebases goed blijven draaien op systemen met een combinatie van CPU en GPU. Het bedrijf werkt ook aan upstream-integratie met AI-frameworks, inferentie-runtimes en implementatieomgevingen. Het doel is dat standaardmodellen en -tools vanaf de eerste dag van implementatie op nieuwe hardware zoals de D-serie draaien.
Optische connectiviteit en kwantumontwikkeling
Intel wees ook op zijn werk met siliciumfotonica, waarbij licht wordt gebruikt om data over langere afstanden te verzenden met een energieverbruik dat volgens het bedrijf een fractie is van dat van koperen verbindingen. Intel gaf geen concrete cijfers of een tijdlijn voor de productontwikkeling bij deze bewering.
Wat kwantumtechnologie betreft, herhaalde Intel de argumenten voor de voorgestelde overname van Classiq . Deze overname zou het geautomatiseerde platform voor de synthese van kwantumalgoritmen van Classiq combineren met Intels siliciumspin-qubittechnologie en chipfabricage. Intel heeft aangegeven dat de deal naar verwachting in de eerste helft van 2027 zal worden afgerond, mits de regelgevende instanties hiervoor toestemming geven.


 Amazon