

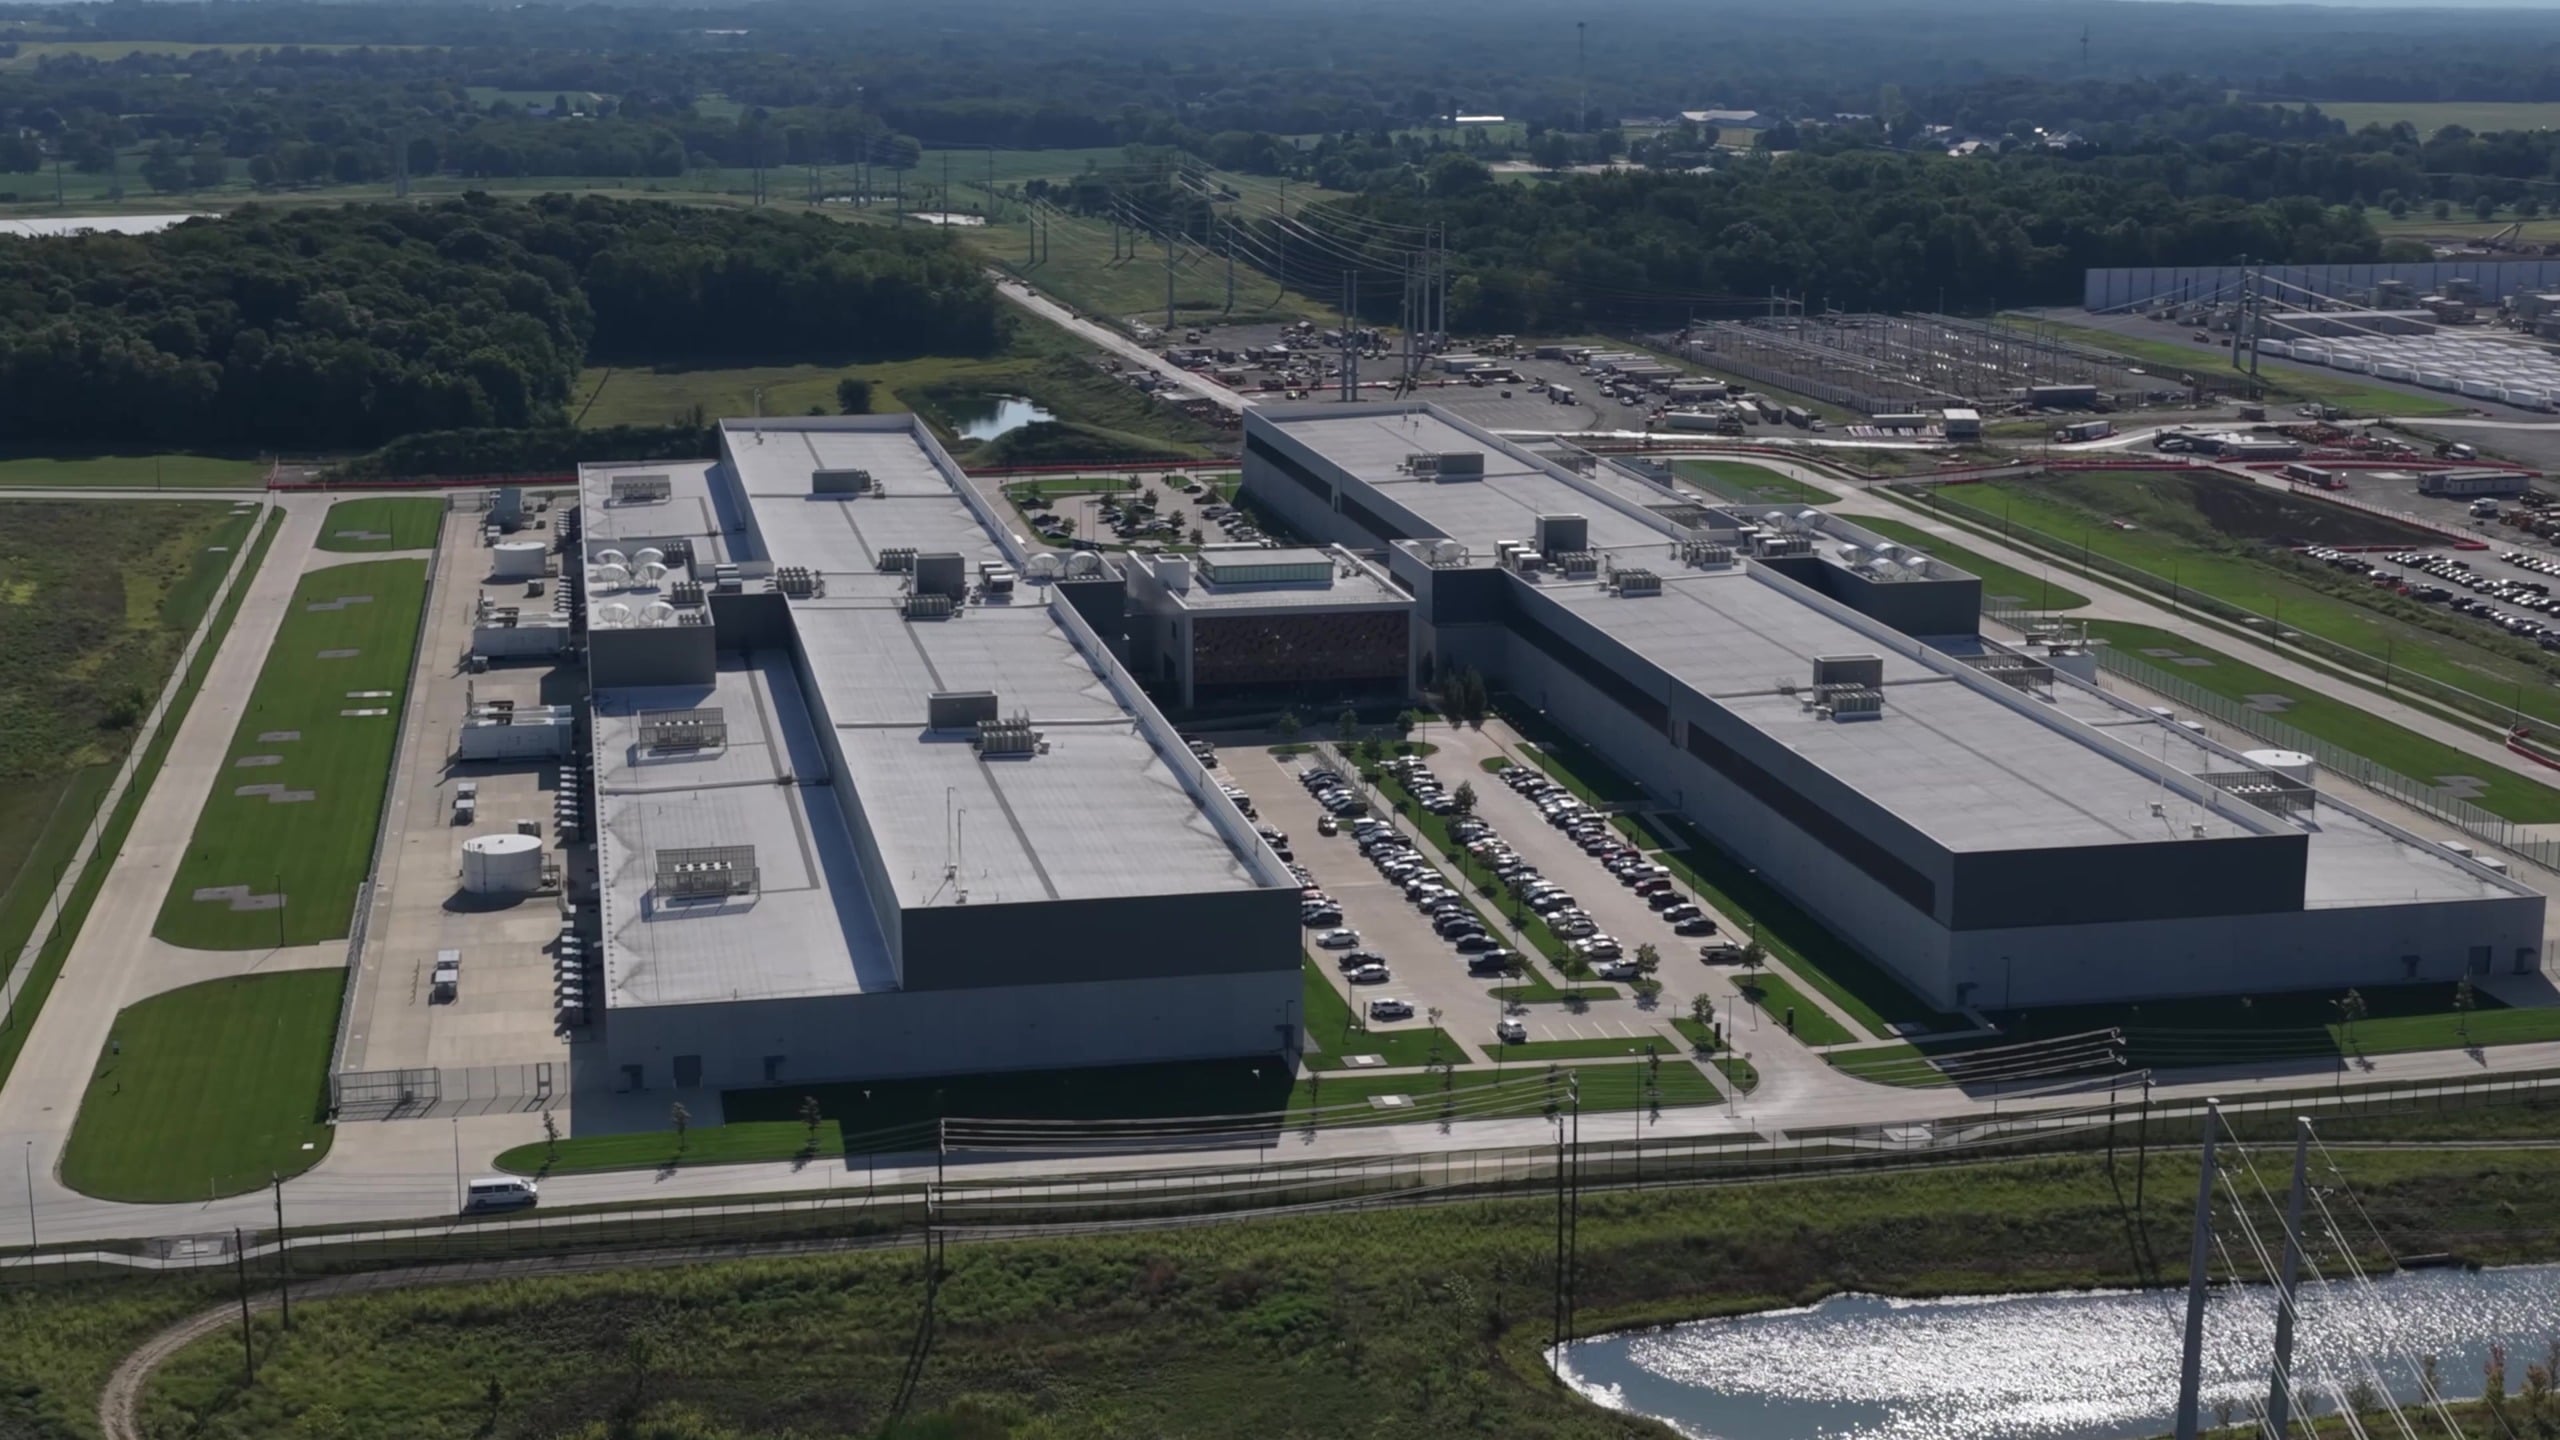
Meta publiceerde vandaag een gedetailleerd artikel over Prometheus, het AI-supercluster van gigawatt-formaat dat het bedrijf bouwt in New Albany, Ohio. De eerste fase is voltooid en heeft de Muse-familie van basismodellen getraind, waaronder de Muse Wonder-modellen. Meta zegt dat de locatie wordt opgeschaald naar ongeveer 1 miljoen GPU's. Twee jaar geleden was dezelfde campus nog een conventioneel datacenter dat webverkeer verwerkte. Het artikel, geschreven door Meta-ingenieurs Kevin Lee, Yashar Bayani, Ahmed Sharif en Yee Jiun Song, beschrijft de hardware, het netwerk en de betrouwbaarheidswerkzaamheden die ervoor zorgen dat trainingstaken blijven draaien.
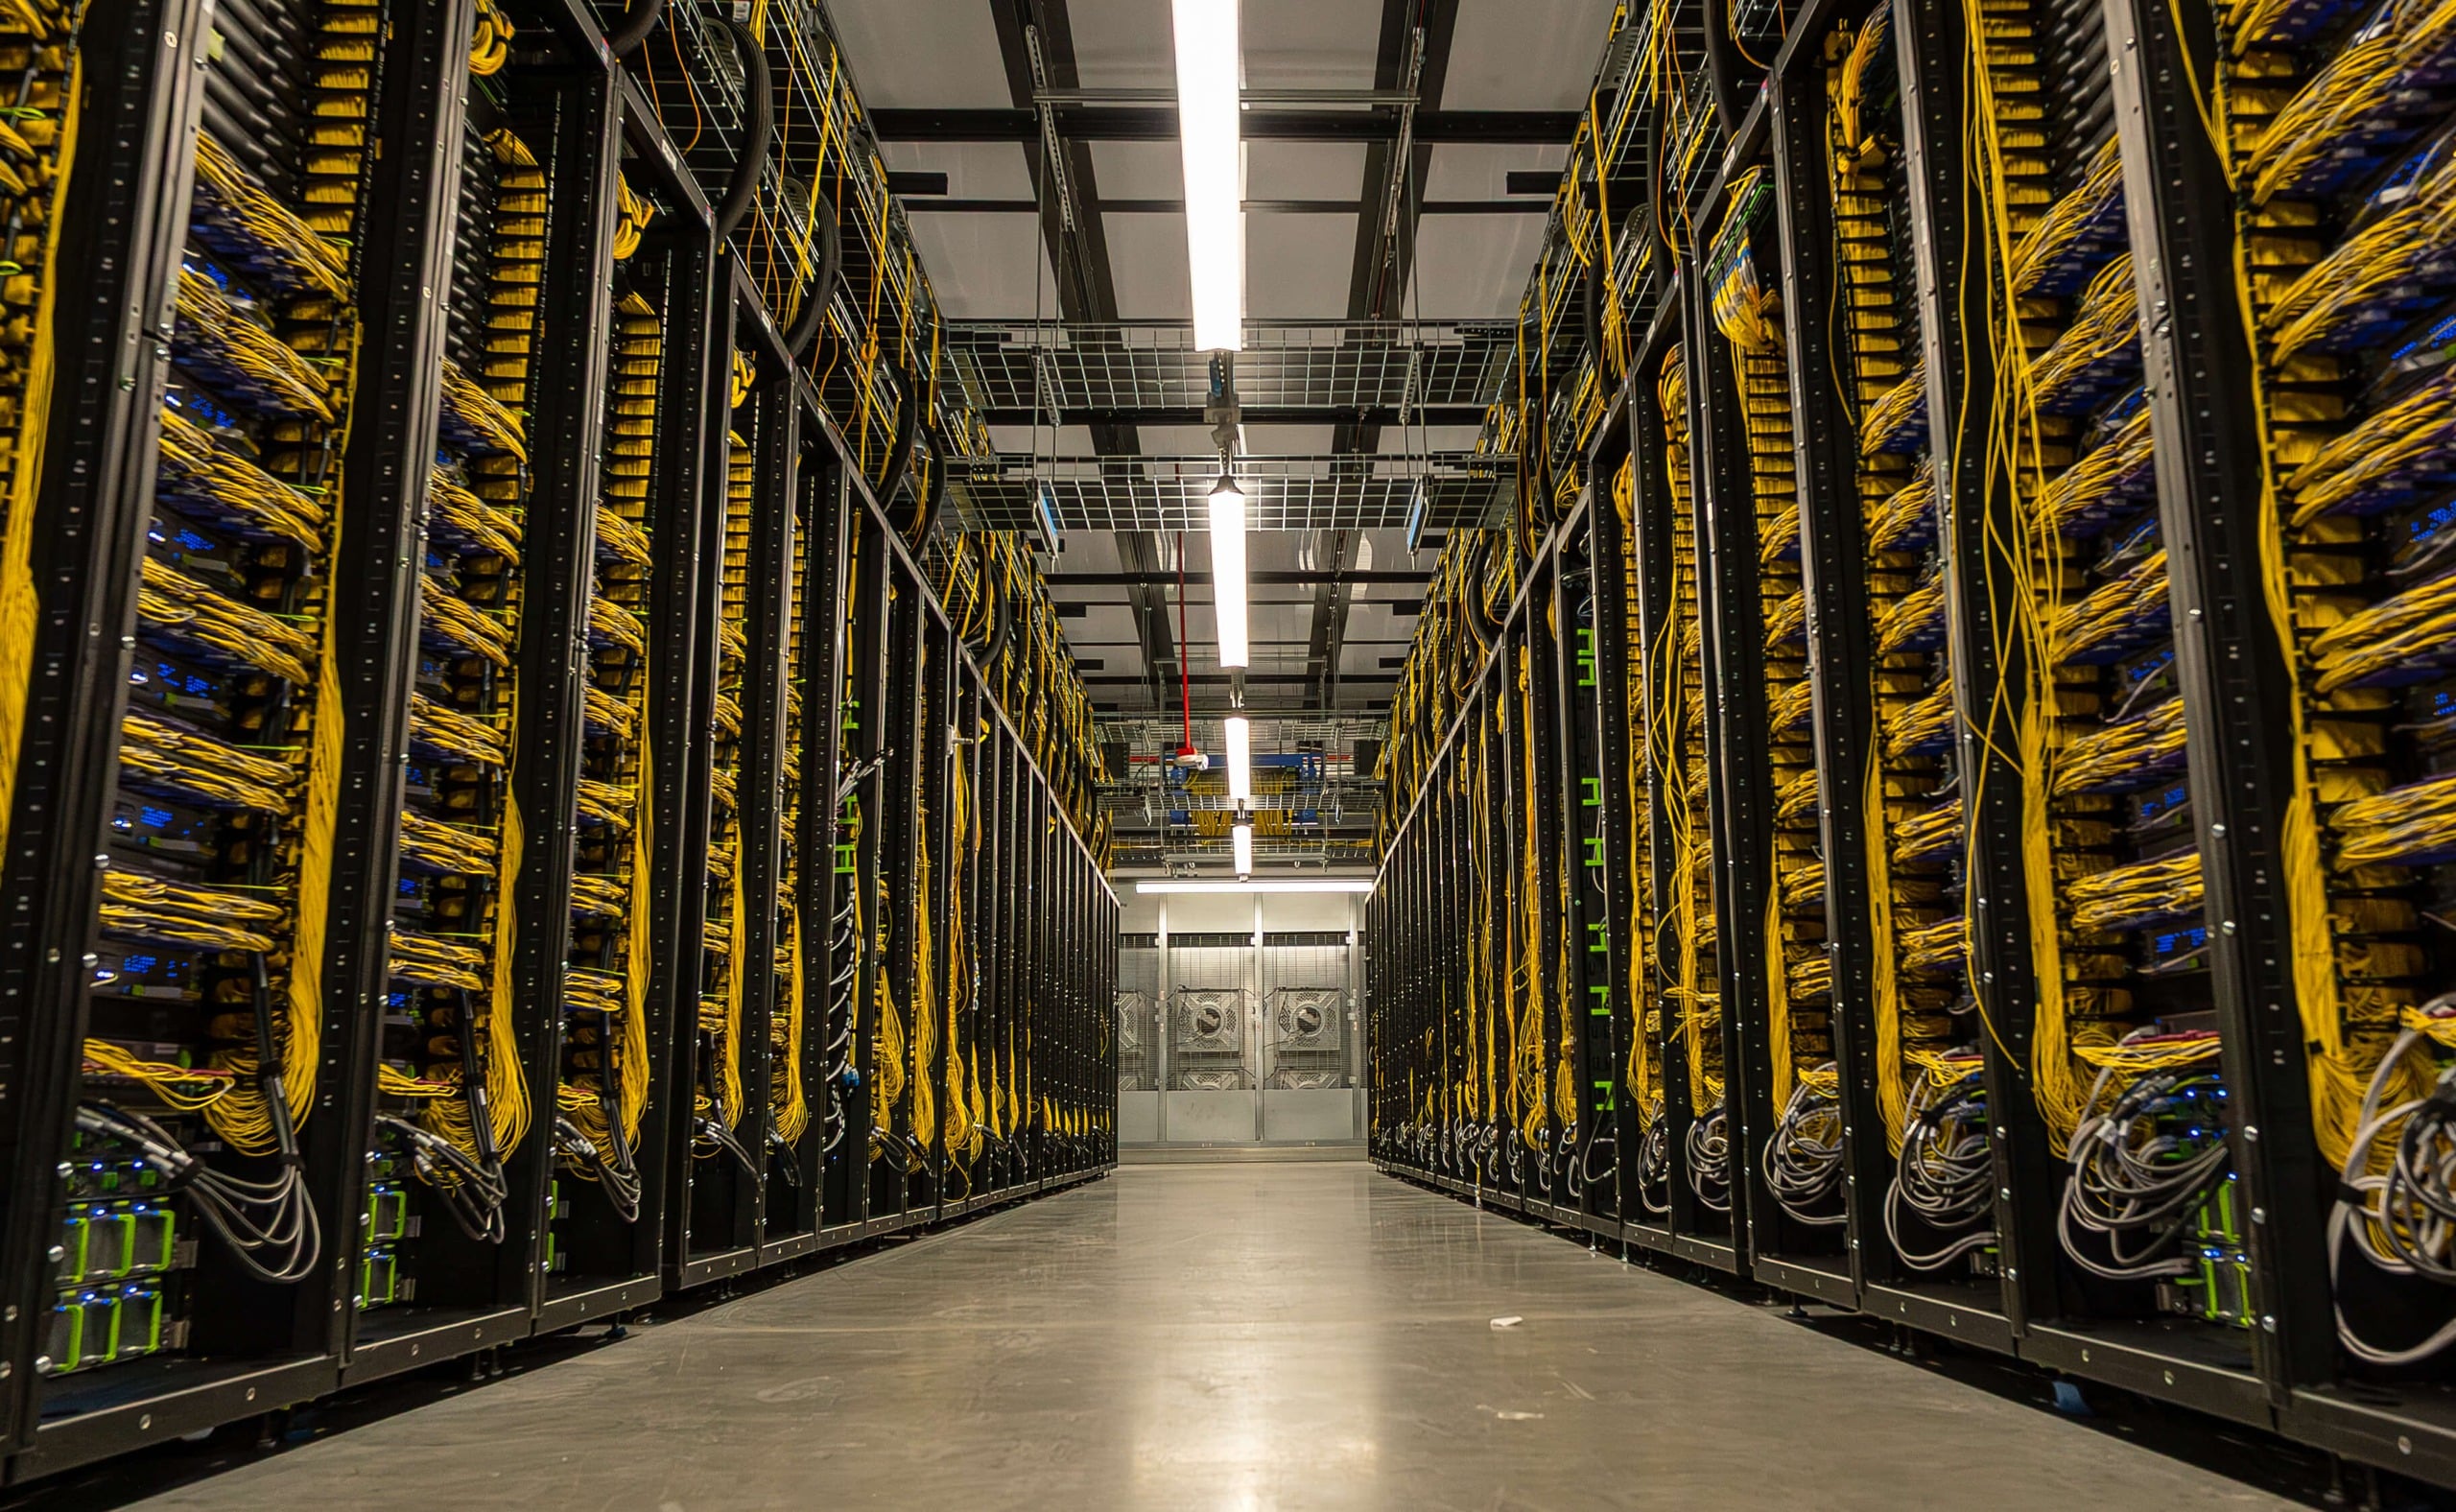
Meta heeft ook enkele van de meest interessante gegevens over het uitvoeren van grote trainingstaken openbaar gemaakt: de betrouwbaarheidscijfers. Meta meldt een goodput van meer dan 85 procent bij Muse Wonder pre-trainingsruns en meer dan 90 procent bij reinforcement learning-runs, met een gemiddelde tijd tussen onderbrekingen van ongeveer 47,000 GPU-uren gedurende die runs. Firmware-updates die sindsdien zijn uitgebracht, hebben de MTBI (Mean Time Between Interruptions) verhoogd tot meer dan 54,000 GPU-uren. Meta streeft naar twee onderbrekingen per 8,000 GPU's per dag, wat neerkomt op ongeveer 100,000 GPU-uren tussen onderbrekingen.
Twee NVL72-generaties in productie, Vera Rubin Next
Prometheus draait momenteel op twee NVIDIA GPU-platformen, beide gebouwd op de NVL72-rackarchitectuur waarbij 72 GPU's één NVLink-domein delen. Een derde platform, gebaseerd op de Vera Rubin NVL72, komt binnenkort beschikbaar. Het eerste platform, dat Meta Catalina noemt, gebruikt de GB200 NVL72 in de Ariel-variant: een configuratie met twee racks en 36 GPU's per rack, gebouwd op Meta's Open Rack V3-rackontwerp voor hoge snelheden, dat is bijgedragen aan het Open Compute Project. Elke Blackwell GPU is gekoppeld aan een Grace CPU en twee ConnectX-7 400G NIC's, een CPU-GPU-verhouding van 1:1 die elke GPU 800 GB aan schaalbare bandbreedte geeft.
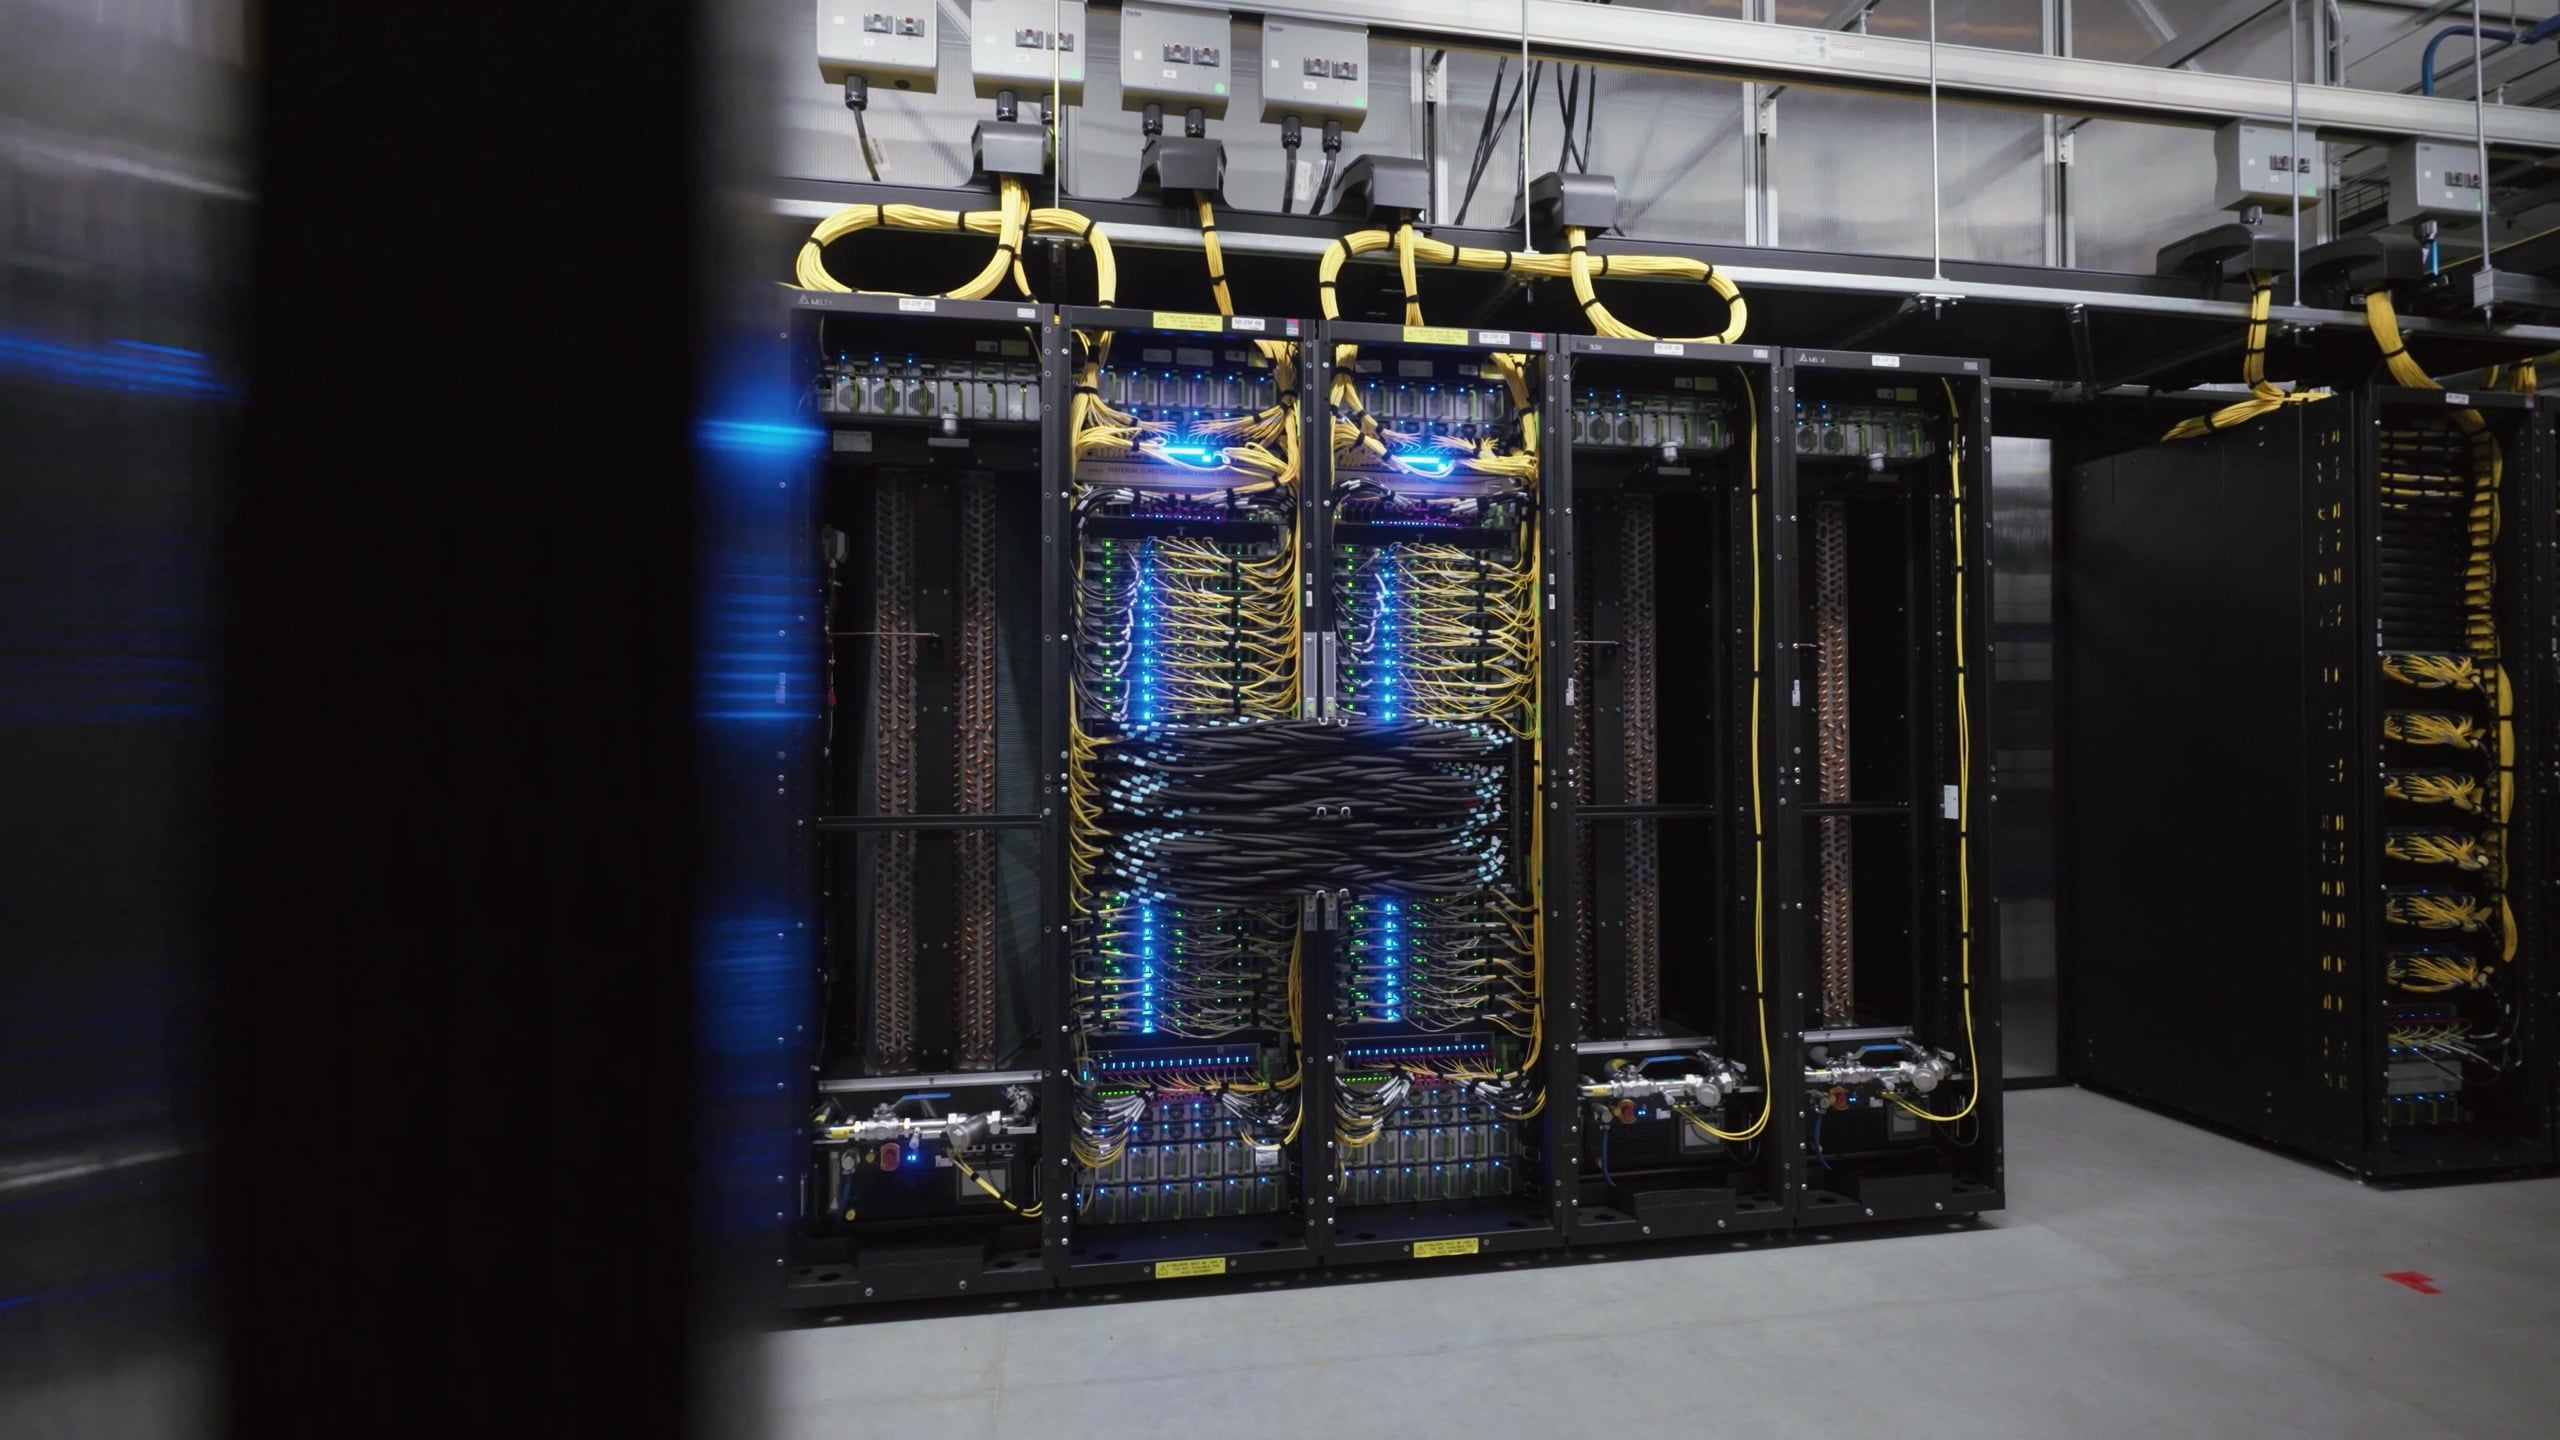
Meta zegt dat ze voor Ariel hebben gekozen omdat de GB200 NVL72 de FLOPS, HBM-bandbreedte, opschalingsbandbreedte en domeingrootte aanzienlijk overtrof ten opzichte van de H100, terwijl de standaard opschaling beperkt zou blijven tot 400 GB per GPU. Meta verwachtte dat deze onbalans ten koste zou gaan van de prestaties. Volgens Meta bevat een Catalina-paar 72 Blackwell GPU's met 13.4 TB HBM3e (192 GB per GPU), 720 PFLOPS piekvermogen voor FP8-training (1,440 PFLOPS bij FP4), 130 TB/s NVLink-bandbreedte binnen het domein, 576 TB/s totale geheugenbandbreedte en verbruikt het ongeveer 120 kW verdeeld over de twee racks.
Het tweede platform, Clemente, maakt gebruik van de GB300 NVL72. Het HBM-geheugen per GPU stijgt met een factor 1.5 naar 288 GB, de doorvoer voor dense FP4 neemt met een vergelijkbare factor toe en de aandachtversnelling verdubbelt ruwweg. ConnectX-8 SuperNIC's leveren native 800 Gbps per GPU, waardoor de schaalbaarheid die Meta in Ariel heeft ingebouwd de basis vormt. Een GPU-CPU-verhouding van 2:1 zorgt ervoor dat het volledige domein met 72 GPU's in één rack past. Meta geeft 20.7 TB HBM3e op, meer dan een exaFLOP aan piek-FP4-rekenkracht, 130 TB/s NVLink-bandbreedte (1.8 TB/s bidirectioneel per GPU), ongeveer 135 kW per rack en een prestatiewinst van 5 tot 10 procent ten opzichte van de GB200 NVL72.
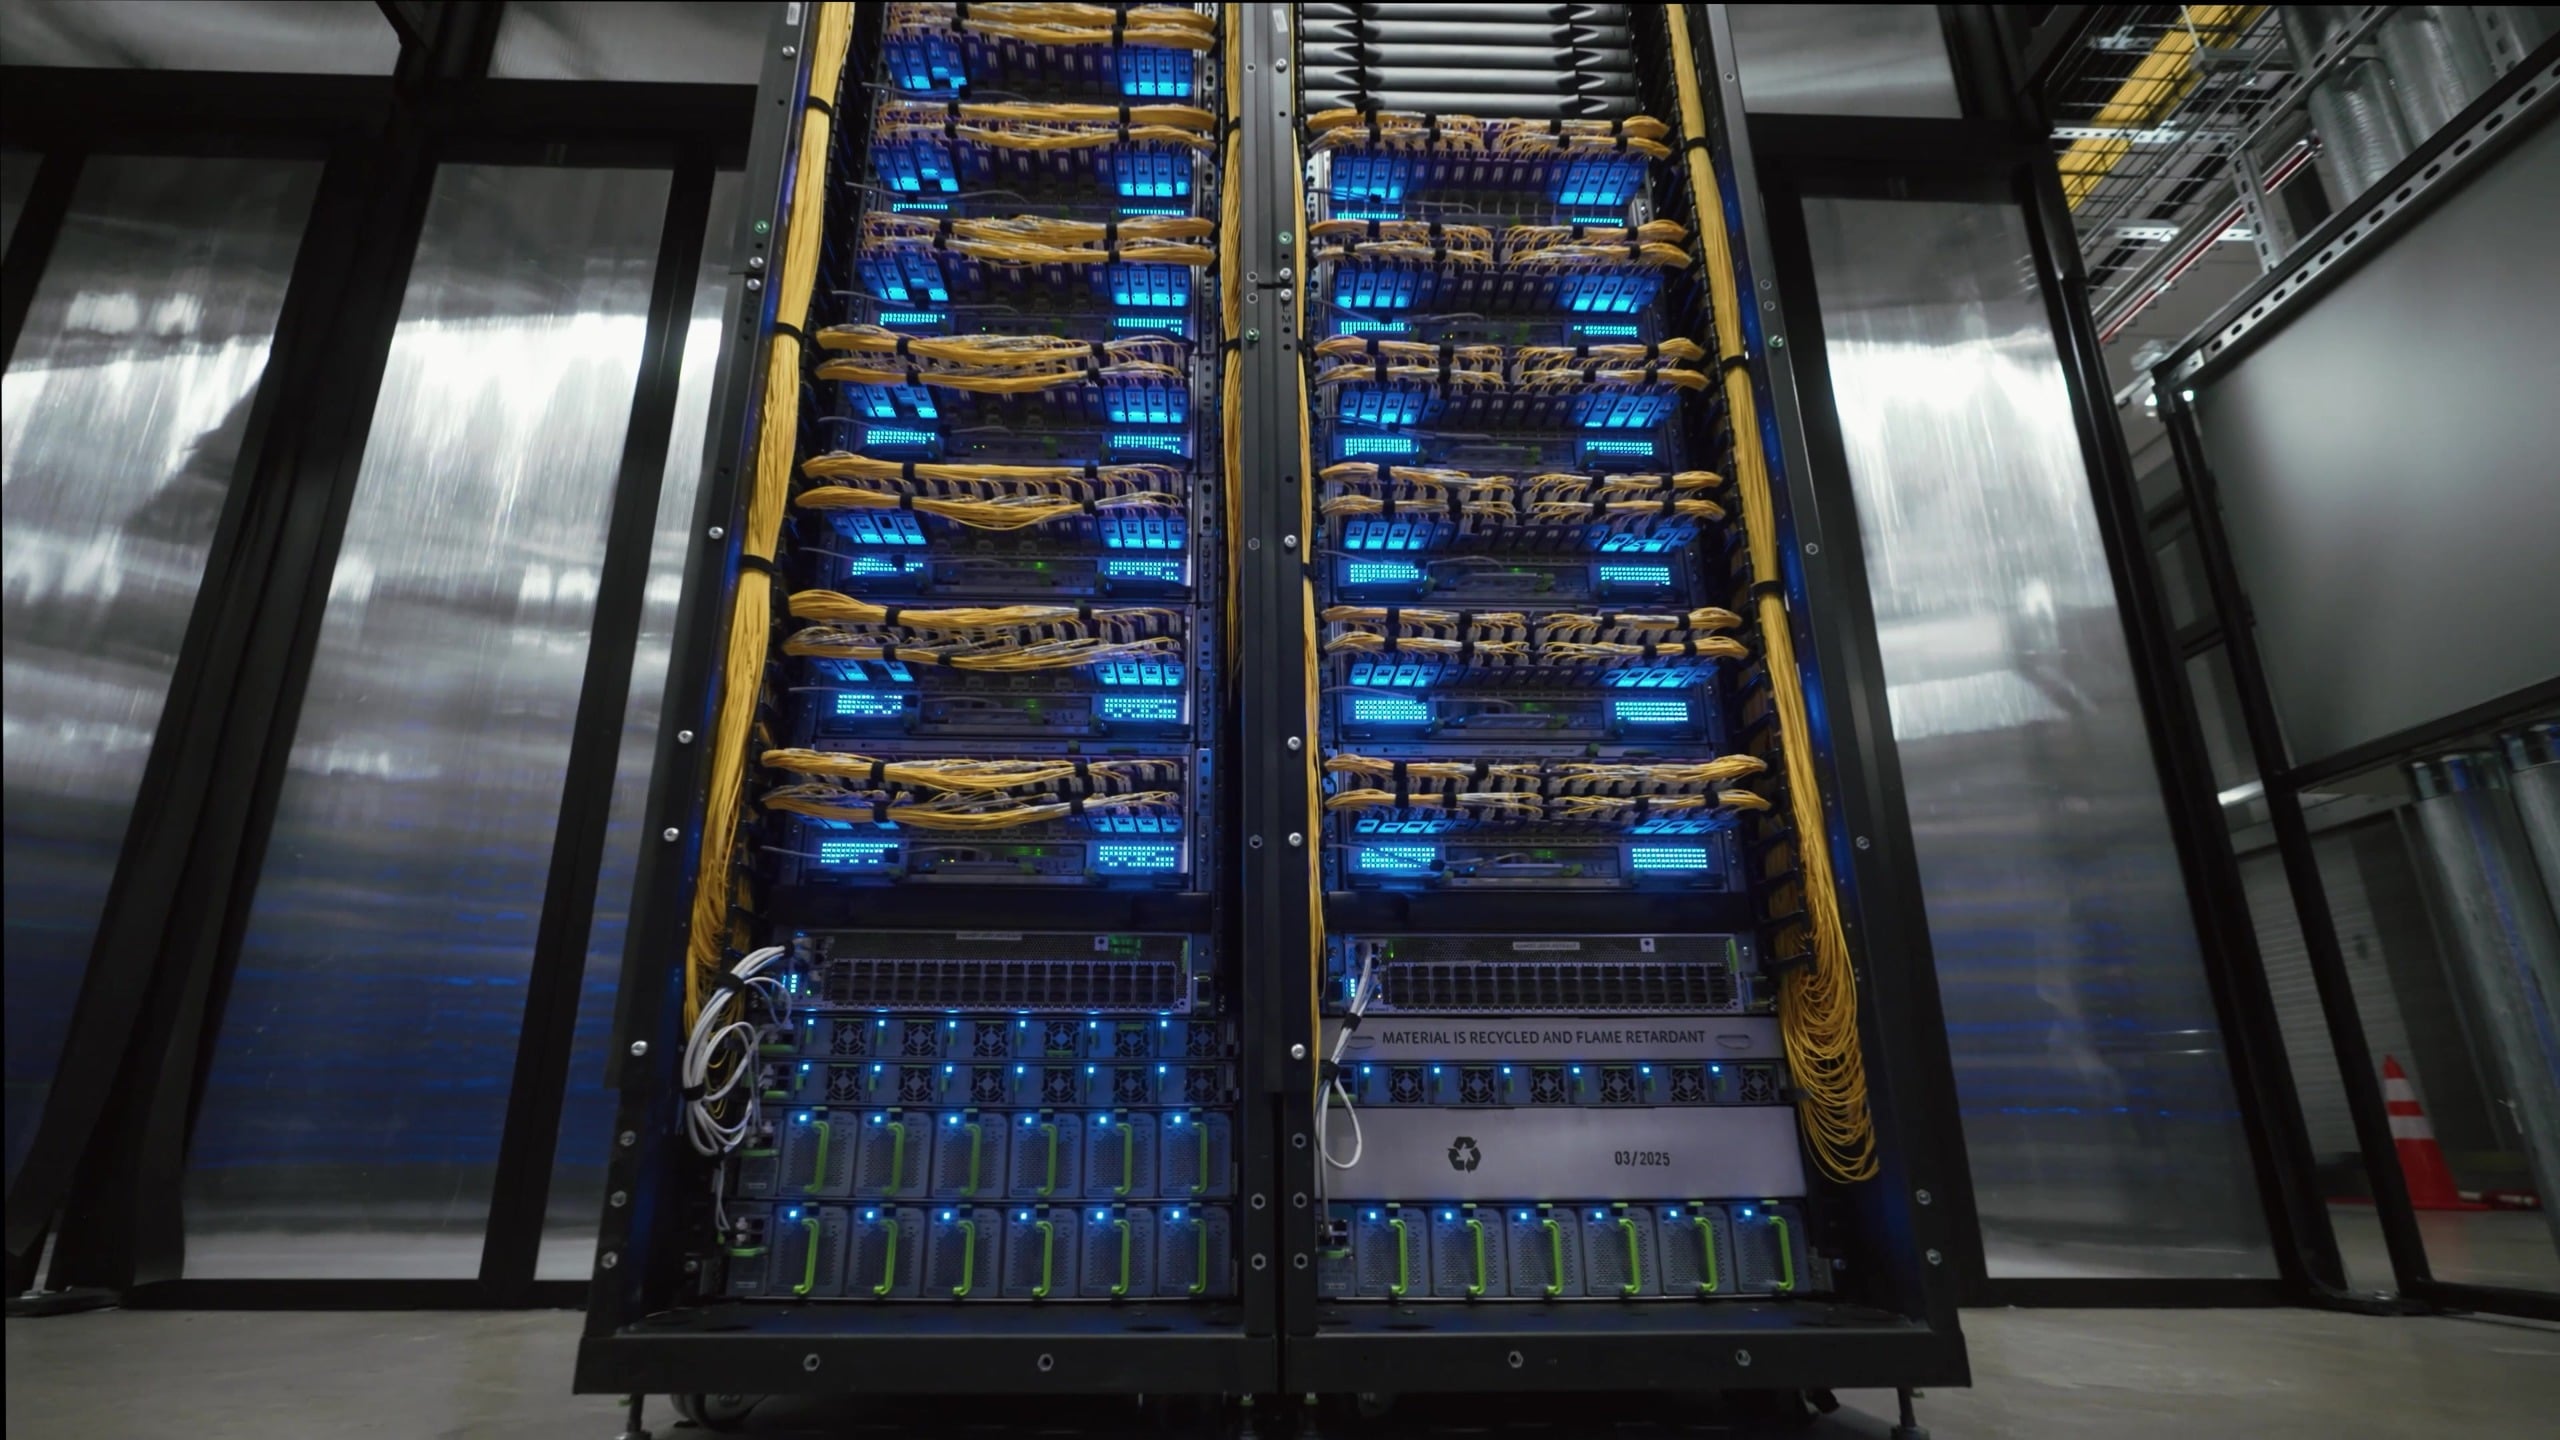
Clemente maakt in zijn nieuwere, AI-geoptimaliseerde gebouwen gebruik van Meta's modulaire, luchtondersteunde vloeistofkoeling of van de vloeistofkoeling van de betreffende faciliteit, en Meta stelt dat het onderhoudsgemak verbetert door minder bekabeling.
Meta's volgende platform, San Miguel, zal de Vera Rubin NVL72 in hetzelfde netwerk integreren. De specificaties van Meta voor dat rack zijn: 288 GB HBM4 per GPU met een bandbreedte van 19.2 TB/s, een piekvermogen van 2.52 exaFLOPS voor FP4-training en 1.26 exaFLOPS voor FP8, een NVLink-bandbreedte van 216 TB/s (3 TB/s per GPU), een totale geheugenbandbreedte van ongeveer 1,500 TB/s, volledig vloeistofgekoelde rekenmodules met een vermogen van meer dan 170 kW per rack, en een prestatiewinst van 10 tot 20 procent per watt ten opzichte van de GB300 NVL72. CoreWeave heeft de Vera Rubin NVL72 eerder deze maand in productie genomen.
Een speciale Ethernet-backend die gebouwen overspant
Trainingsverkeer verloopt via een tweede datacenternetwerk over Ethernet, gescheiden van het front-endnetwerk dat het reguliere serviceverkeer verwerkt. Het ontwerp volgt de structuur van een trainingstaak: data-parallelle replica's houden hun latencygevoelige, bandbreedte-intensieve collectieven binnen een gebouwstructuur, terwijl het meer tolerante verkeer tussen replica's een aggregatielaag oversteekt die gebouwen met elkaar verbindt. Meta bouwde dezelfde hiërarchie in zijn eerdere clusters op gebouwniveau met 24,000 GPU's en zijn regionale cluster met meer dan 100,000 GPU's, voordat deze werd uitgebreid naar Prometheus.
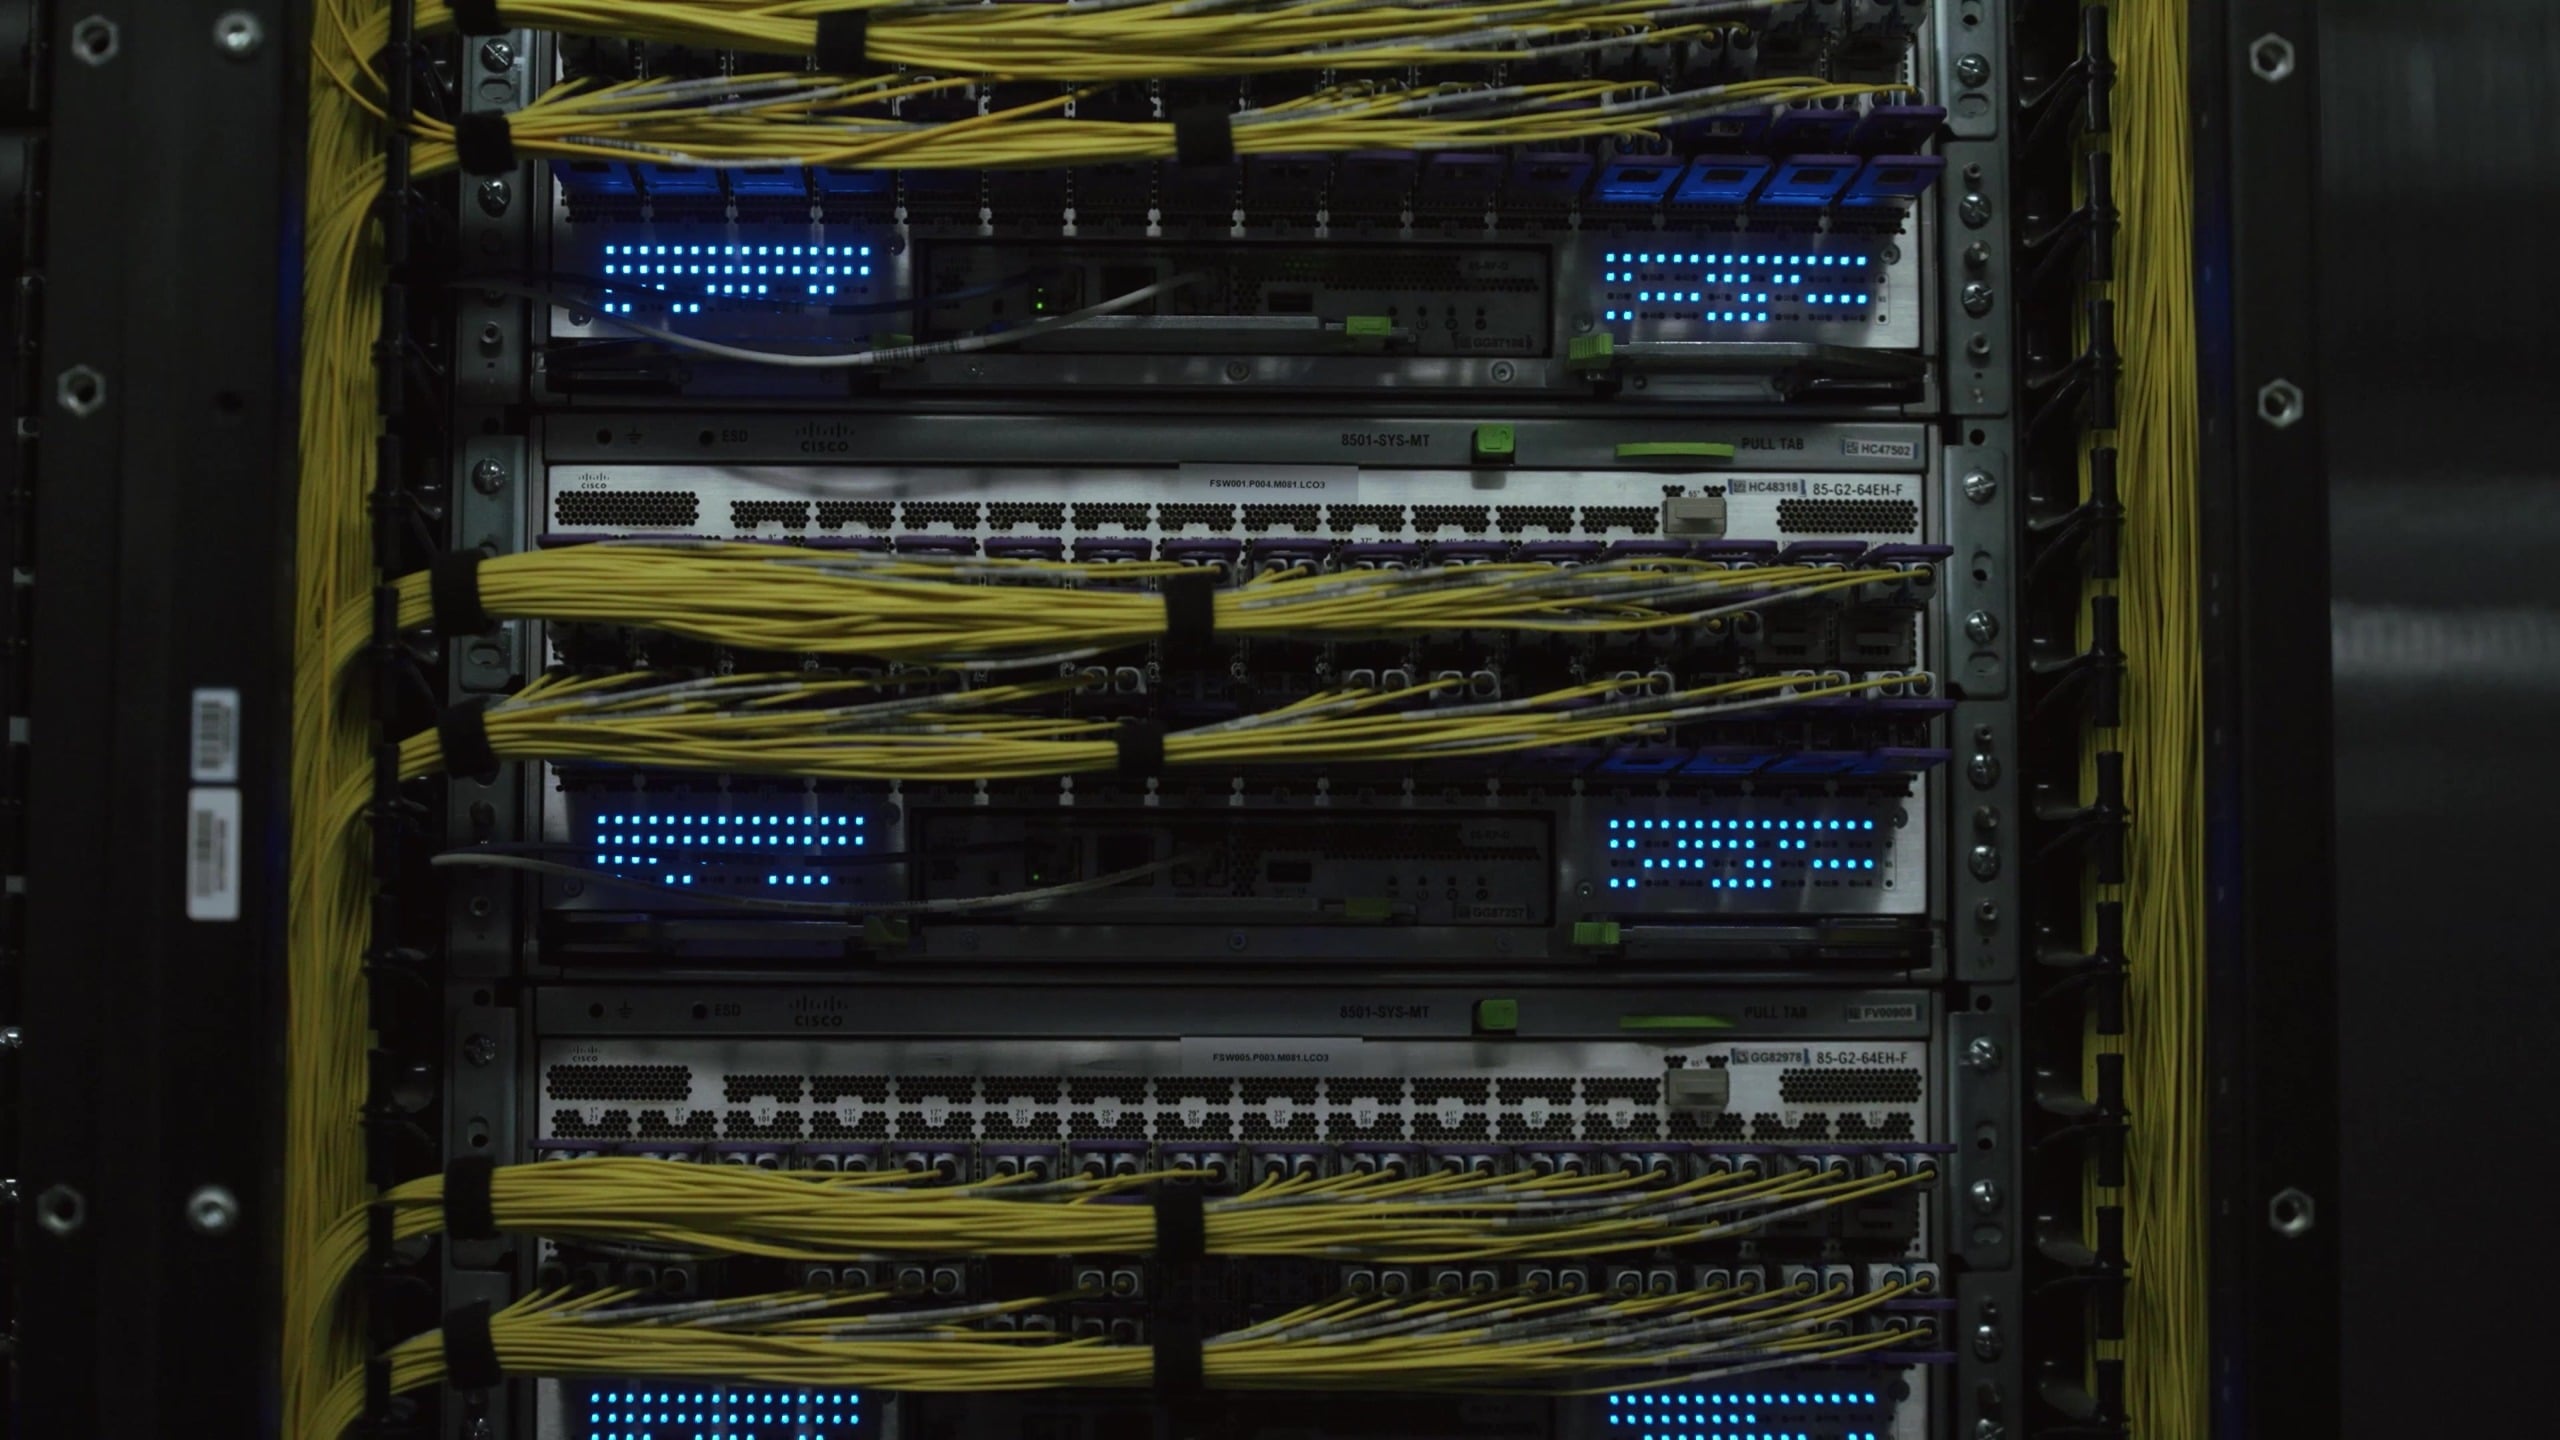
Elk gebouw verbindt tot wel 20,736 GPU's. Meta's eerste ontwerp was een Disaggregated Scheduled Fabric die gebruikmaakte van sub-packet multipath routing, in-fabric herordening, virtuele uitvoerwachtrijen en op credits gebaseerde flow control om te voorkomen dat de weinige grote, langlopende flows van een trainingscollectief met elkaar in botsing kwamen. Toen NIC's de mogelijkheid kregen om pakketten aan het eindpunt te herordenen, stapte Meta over op een Non-Scheduled Fabric gebouwd op 51.2T-switches met ondiepe buffers: Minipack3 met dynamische load balancing en Minipack3N, die gebruikmaakt van de NVIDIA Spectrum-4 ASIC met Adaptive Routing op ConnectX NIC's, waarbij beide Meta's FBOSS-netwerkstack draaien.
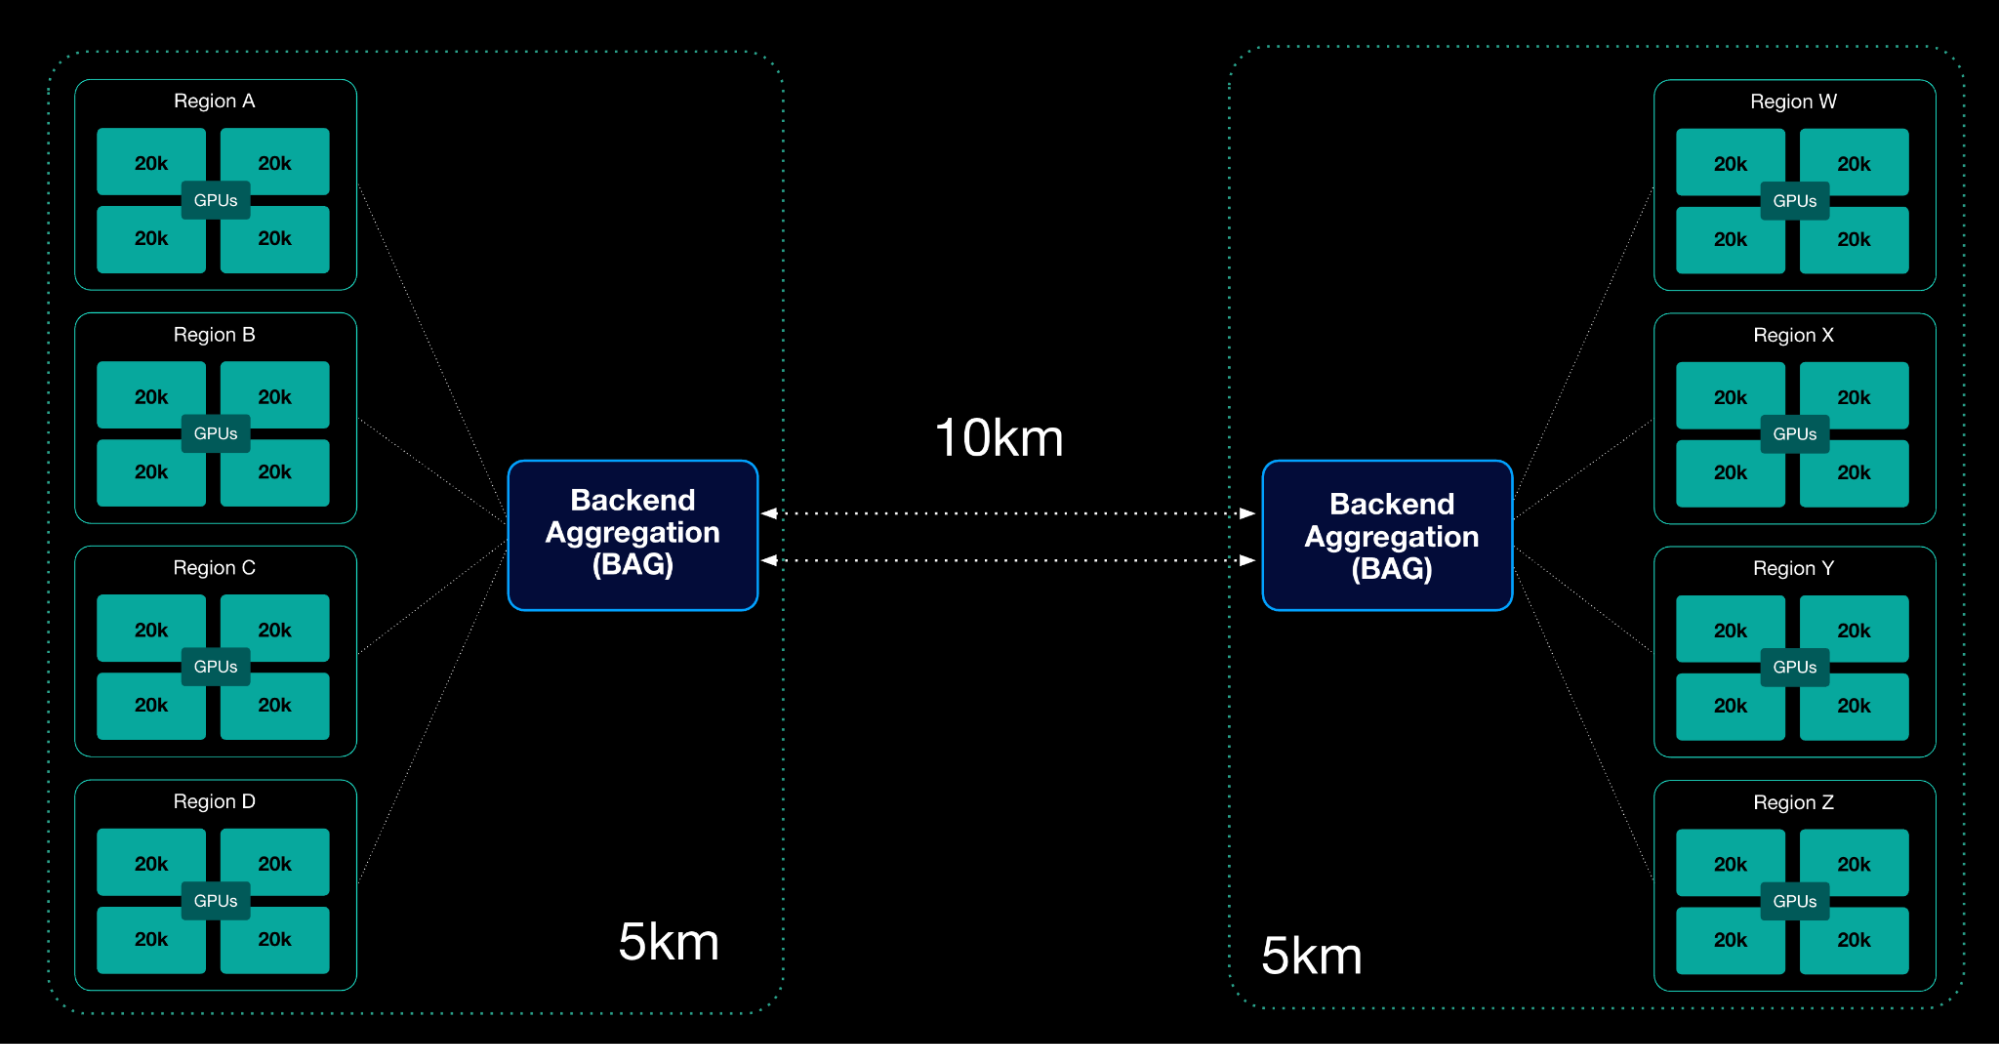
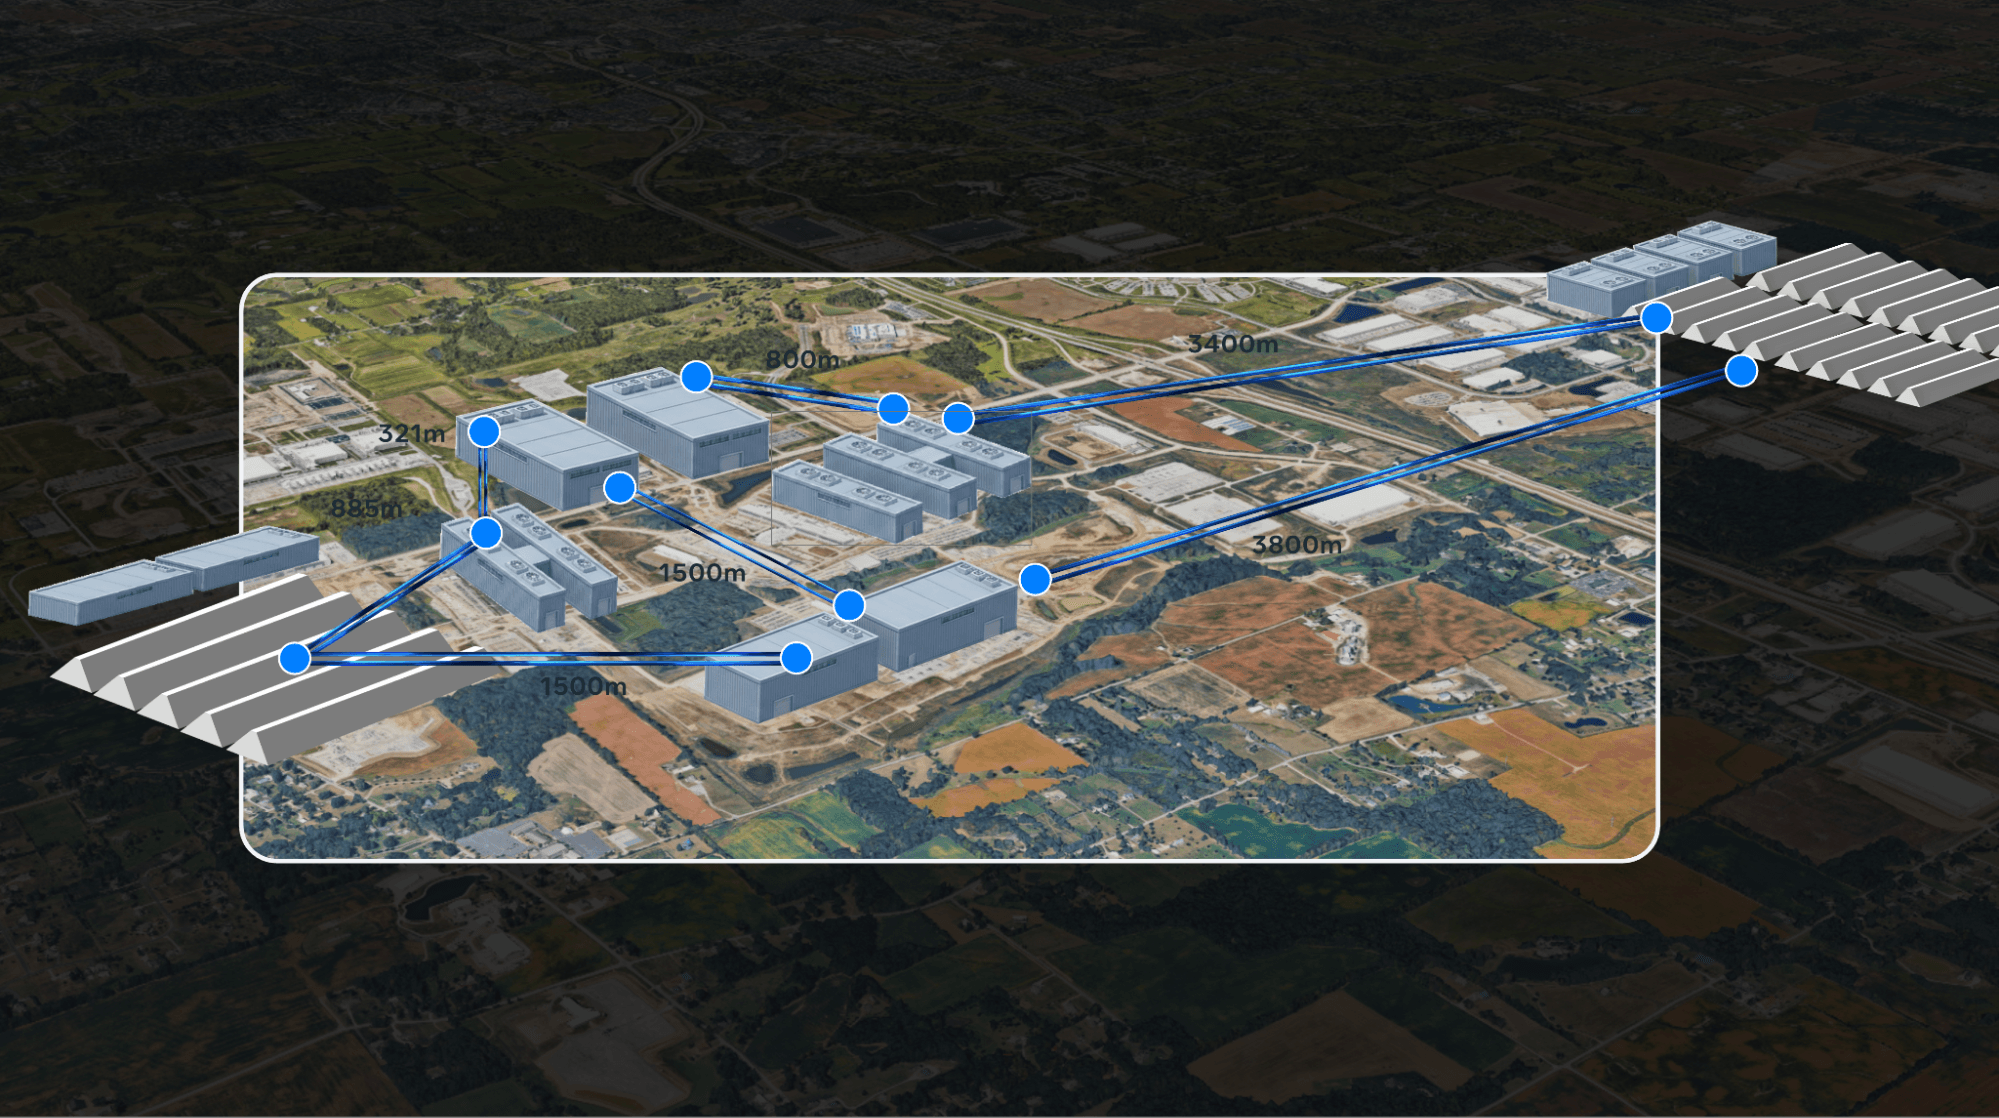
Boven de gebouwen bevindt zich het Backend Aggregation-netwerk, een meerlaags hub-and-spoke-ontwerp gebouwd op Arista 7800-serie chassis met diep gebufferde Broadcom Jericho3-chips. Het netwerk strekt zich uit over afstanden van 2 km tot meer dan 100 km en levert meerdere petabits per seconde tussen regioparen. Meta geeft aan dat het uitvoeren van pre-training over deze afstanden een speciale optimalisatie-inspanning vereiste in samenwerking met Meta Superintelligence Labs vanwege de extreem hoge latentie. De infrastructuur erachter omvat miljoenen kilometers glasvezel, tienduizenden switches en miljoenen optische modules, van 2x400G FR4 LITE-modules in gebouwen tot 800G-ZR coherente optische modules voor verbindingen van meer dan ongeveer 10 km.
64 van de 72 GPU's doen het werk.
De overstap van het NVLink-domein met acht GPU's van de H100-generatie naar NVL72 heeft de impact van een storing vernegenvoudigd. Meta plant de capaciteit nu rond het rack met 72 GPU's. Omdat parallelle training het beste werkt met groepsgroottes die een macht van twee zijn, draait elk NVL72-domein een slice met 64 GPU's en worden de overige acht GPU's als reserve in het rack bewaard. Als een GPU uitvalt, neemt een reserve het over en wordt de taak hervat vanaf het laatste controlepunt zonder te hoeven wachten op een reparatie. Voor het geval een volledig rack uitvalt, houdt Meta ongeveer 2 procent extra racks in reserve.
Voor een trainingssessie met 32,768 GPU's: 523 NVL72-racks, oftewel 37,656 GPU's, ongeveer 13 procent meer dan de actieve footprint, waarvan 11 procentpunten afkomstig zijn van de 64-van-72 slice-geometrie. De signaalintegriteit die nodig is voor die betrouwbaarheid is aanzienlijk; een enkel NVL72-domein bevat 5,184 afgestemde differentiële paarverbindingen met een snelheid van 200 Gbps, die elk GPU SerDes, printplaten van de compute trays, kabelcassettes en interfaces van de switch trays kruisen.
Twee herstelpaden vangen de fouten op die zich voordoen. Wanneer een storing kan worden geïsoleerd tot één data-parallelle replica, zorgt Meta's fouttolerantie, die rekening houdt met parallellisme, ervoor dat die replica offline gaat, terwijl de rest van het cluster de stap herhaalt en doorgaat met trainen. De slice start vervolgens opnieuw op reservehosts en synchroniseert opnieuw. Grotere fouten sturen de hele taak terug naar het laatste checkpoint. Daarom maakt Meta regelmatig checkpoints, waarbij de modelstatus, inclusief gradiënten en optimizergegevens, asynchroon wordt opgeslagen in een meerlaagse opslag met delta-checkpointing en in-memory staging om de impact op de doorvoer te beperken.
Een daling van 99 procent in het aantal onderbrekingen.
Ondanks alle vooruitgang die deze cijfers laten zien, was Prometheus in het begin niet stabiel. Medio 2025, tijdens de eerste fase, piekte het aantal onderbrekingen op bijna 1,000 gebeurtenissen per 8,000 GPU's per dag. Een jaar van samenwerking tussen verschillende teams heeft dat met 99 procent teruggebracht, en het cluster ondersteunt nu parallel meerdere trainingstaken met elk tienduizenden GPU's. Meta schrijft dit succes toe aan een co-engineeringmodel met NVIDIA, waarbij NVIDIA-teams op de locatie in New Albany zitten, telemetriegegevens delen en gezamenlijke triagesessies houden om elke storing tot op de oorzaak te ontleden. Meta is verantwoordelijk voor de planning en infrastructuurverbeteringen, terwijl NVIDIA de firmware, signaaldiagnostiek en geheugenbeheer voor zijn rekening neemt.
De signaalintegriteit van NVLink was het eerste knelpunt bij GB200. Met meer dan 600,000 NVLink-verbindingen in het cluster veroorzaakten zwakke verbindingen frequent herstelcycli. Daarom voegde Meta continue telemetrie, geautomatiseerde signalering en L11-diagnostische tests toe om zwakke verbindingen vóór de productie op te sporen. Geheugenfouten in HBM en LPDDR werden de belangrijkste oorzaak toen GB300 met meer geheugen op de markt kwam. De oplossing hiervoor bestaat uit verfijnde HBM-firmware-instellingen, geheugenreiniging, een verbeterd LPDDR-foutcorrectiealgoritme en het voorspellend uitfaseren van apparaten die in slechte staat verkeren. De status van de switches wordt met millisecondenresolutie bewaakt en linkgebeurtenissen in de aggregatielaag worden hardwarematig omgeleid zonder het GPU-verkeer te onderbreken.
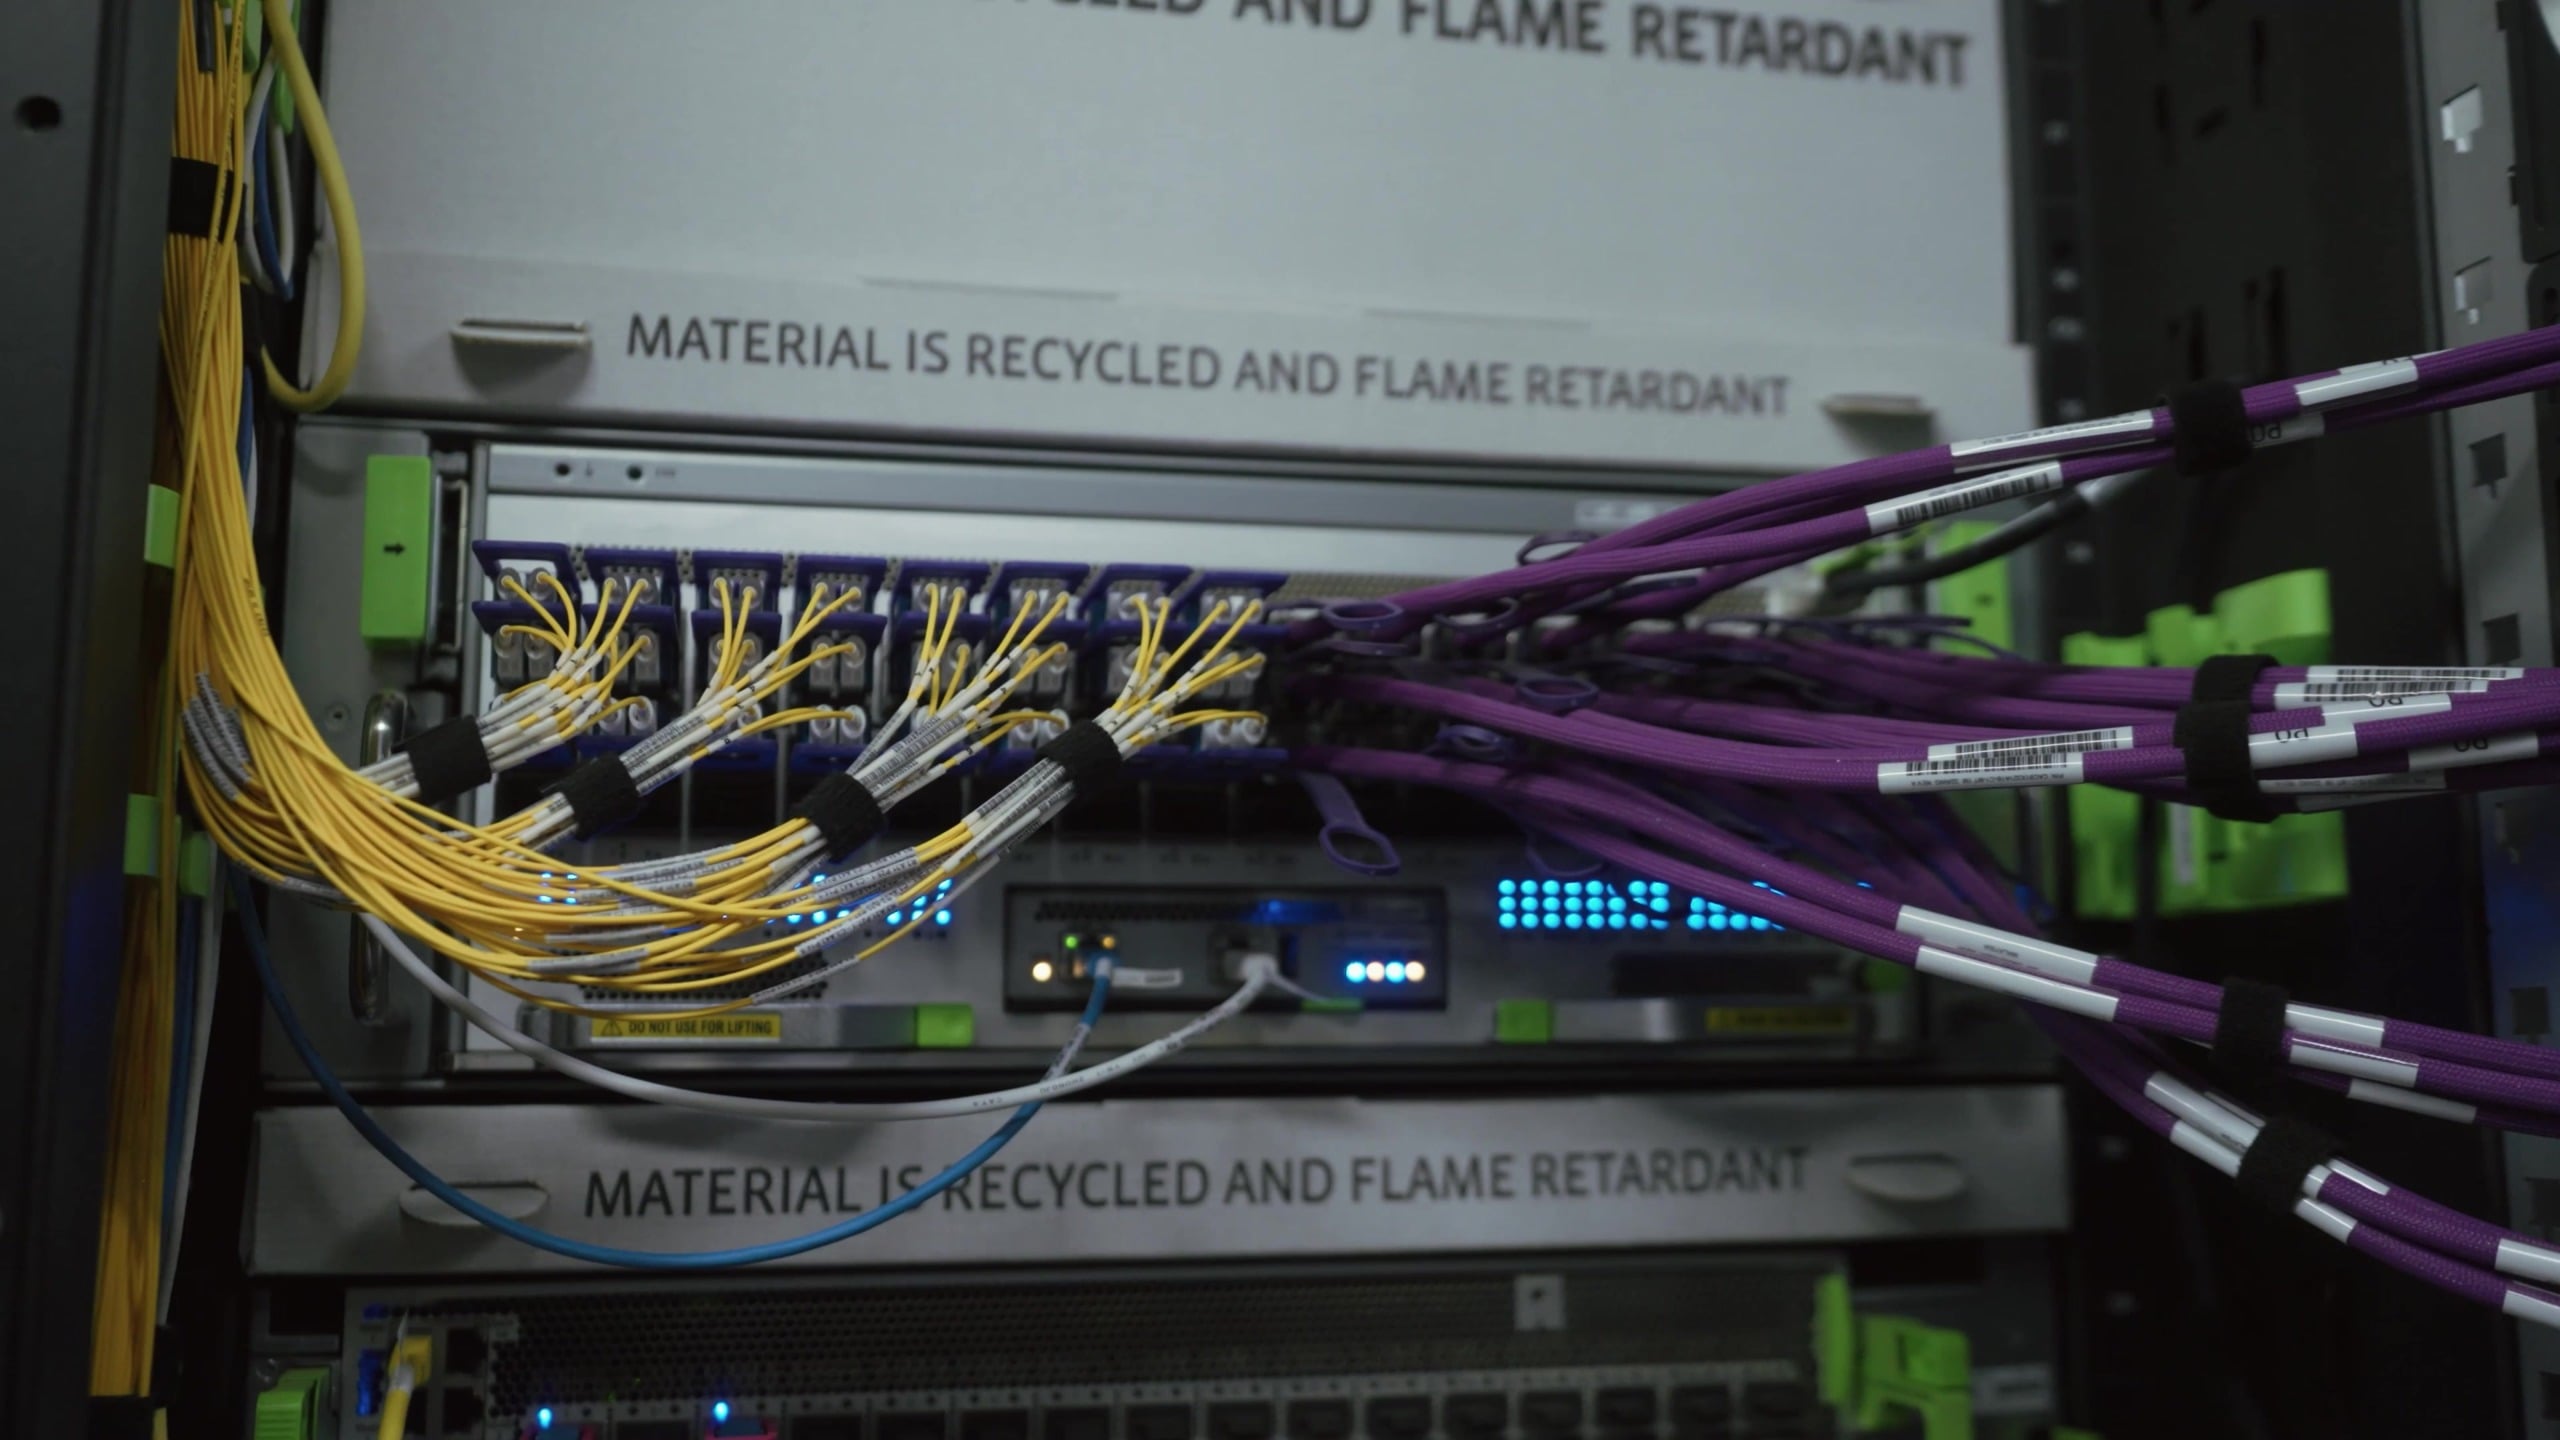
Het beheren van honderdduizenden eerstegeneratie-acceleratoren heeft de ontwikkeling van hardware tot een eigen discipline gemaakt. Meta's firmwareautomatisering kan binnen enkele uren driver- en firmware-updates naar meer dan 100,000 GPU's pushen, en de tijd die nodig is om een enkele pod te upgraden met de P90 is gedaald van meer dan zeven uur in de beginperiode van de GB200-introductie naar twee uur. Stresstests voor de stroomvoorziening onderzoeken hoe voedingsmodules en spanningsregelaars zich gedragen onder de belasting van 1,400 W van een enkele GPU, en elk gerepareerd systeem wordt in quarantaine geplaatst totdat het de validatie doorstaat. Meta's stabiliteitssprint in maart synchroniseerde updates voor de gehele stack.
Stroompieken en een gemengd koelwagenpark
Synchrone training zorgt voor een gecoördineerde stroomverdeling, en tienduizenden GPU's die tegelijkertijd een rekenfase of communicatiefase ingaan, zorgen voor een schommeling van 30 tot 40 procent in de clusterbelasting. Het starten of pauzeren van een grote taak kan binnen enkele seconden tientallen megawatt aan stroom verschuiven. Dynamo Dimmer, Meta's energiebeheersysteem voor de hele cluster, beperkt het GPU-vermogen geleidelijk naarmate de cluster zijn maximale capaciteit nadert, zodat taken kunnen blijven draaien. Batterijback-upmodules op rackniveau absorberen pieken, condensatorbakken egaliseren pieken, grootschalige batterijopslag bevindt zich daarachter en Meta coördineert met nutsbedrijven het belastingprofiel.
De koeling verschilt per gebouw omdat Prometheus snel is opgebouwd in datacenters met open lucht, snel inzetbare structuren, gehuurde capaciteit en een speciaal voor AI gebouwd gebouw. De oudere ruimtes maken gebruik van modulaire, luchtondersteunde vloeistofkoeling; het voor AI geoptimaliseerde gebouw gebruikt vloeistofkoeling in een gesloten circuit, wat volgens Meta de meest efficiënte en waterzuinige manier is om GPU-servers te koelen. Meta heeft ontwerpen zoals IcePack, hun vloeistofgekoelde netwerkrack, gedeeld via OCP. Voor een kijkje in een veel kleinere, vloeistofgekoelde GB300 NVL72-implementatie, zie het GAIFA-testplatform van Giga Computing.
Hyperion komt hierna
Meta zal Prometheus blijven uitbreiden met een mix van GB300 NVL72- en Vera Rubin NVL72-racks, waarbij Vera Rubin via het San Miguel-platform op het bestaande netwerk wordt geïnstalleerd. De lessen die in New Albany zijn geleerd, vormen de basis voor Hyperion, het supercluster dat Meta volledig opnieuw ontwerpt in Richland Parish, Louisiana, met gesloten vloeistofkoeling, volledige netaansluiting via Entergy en een geavanceerd netwerkontwerp. Meta geeft aan dat het de volledige energiekosten op beide locaties betaalt en het verbruik compenseert met nieuwe, schone en hernieuwbare energieopwekking.
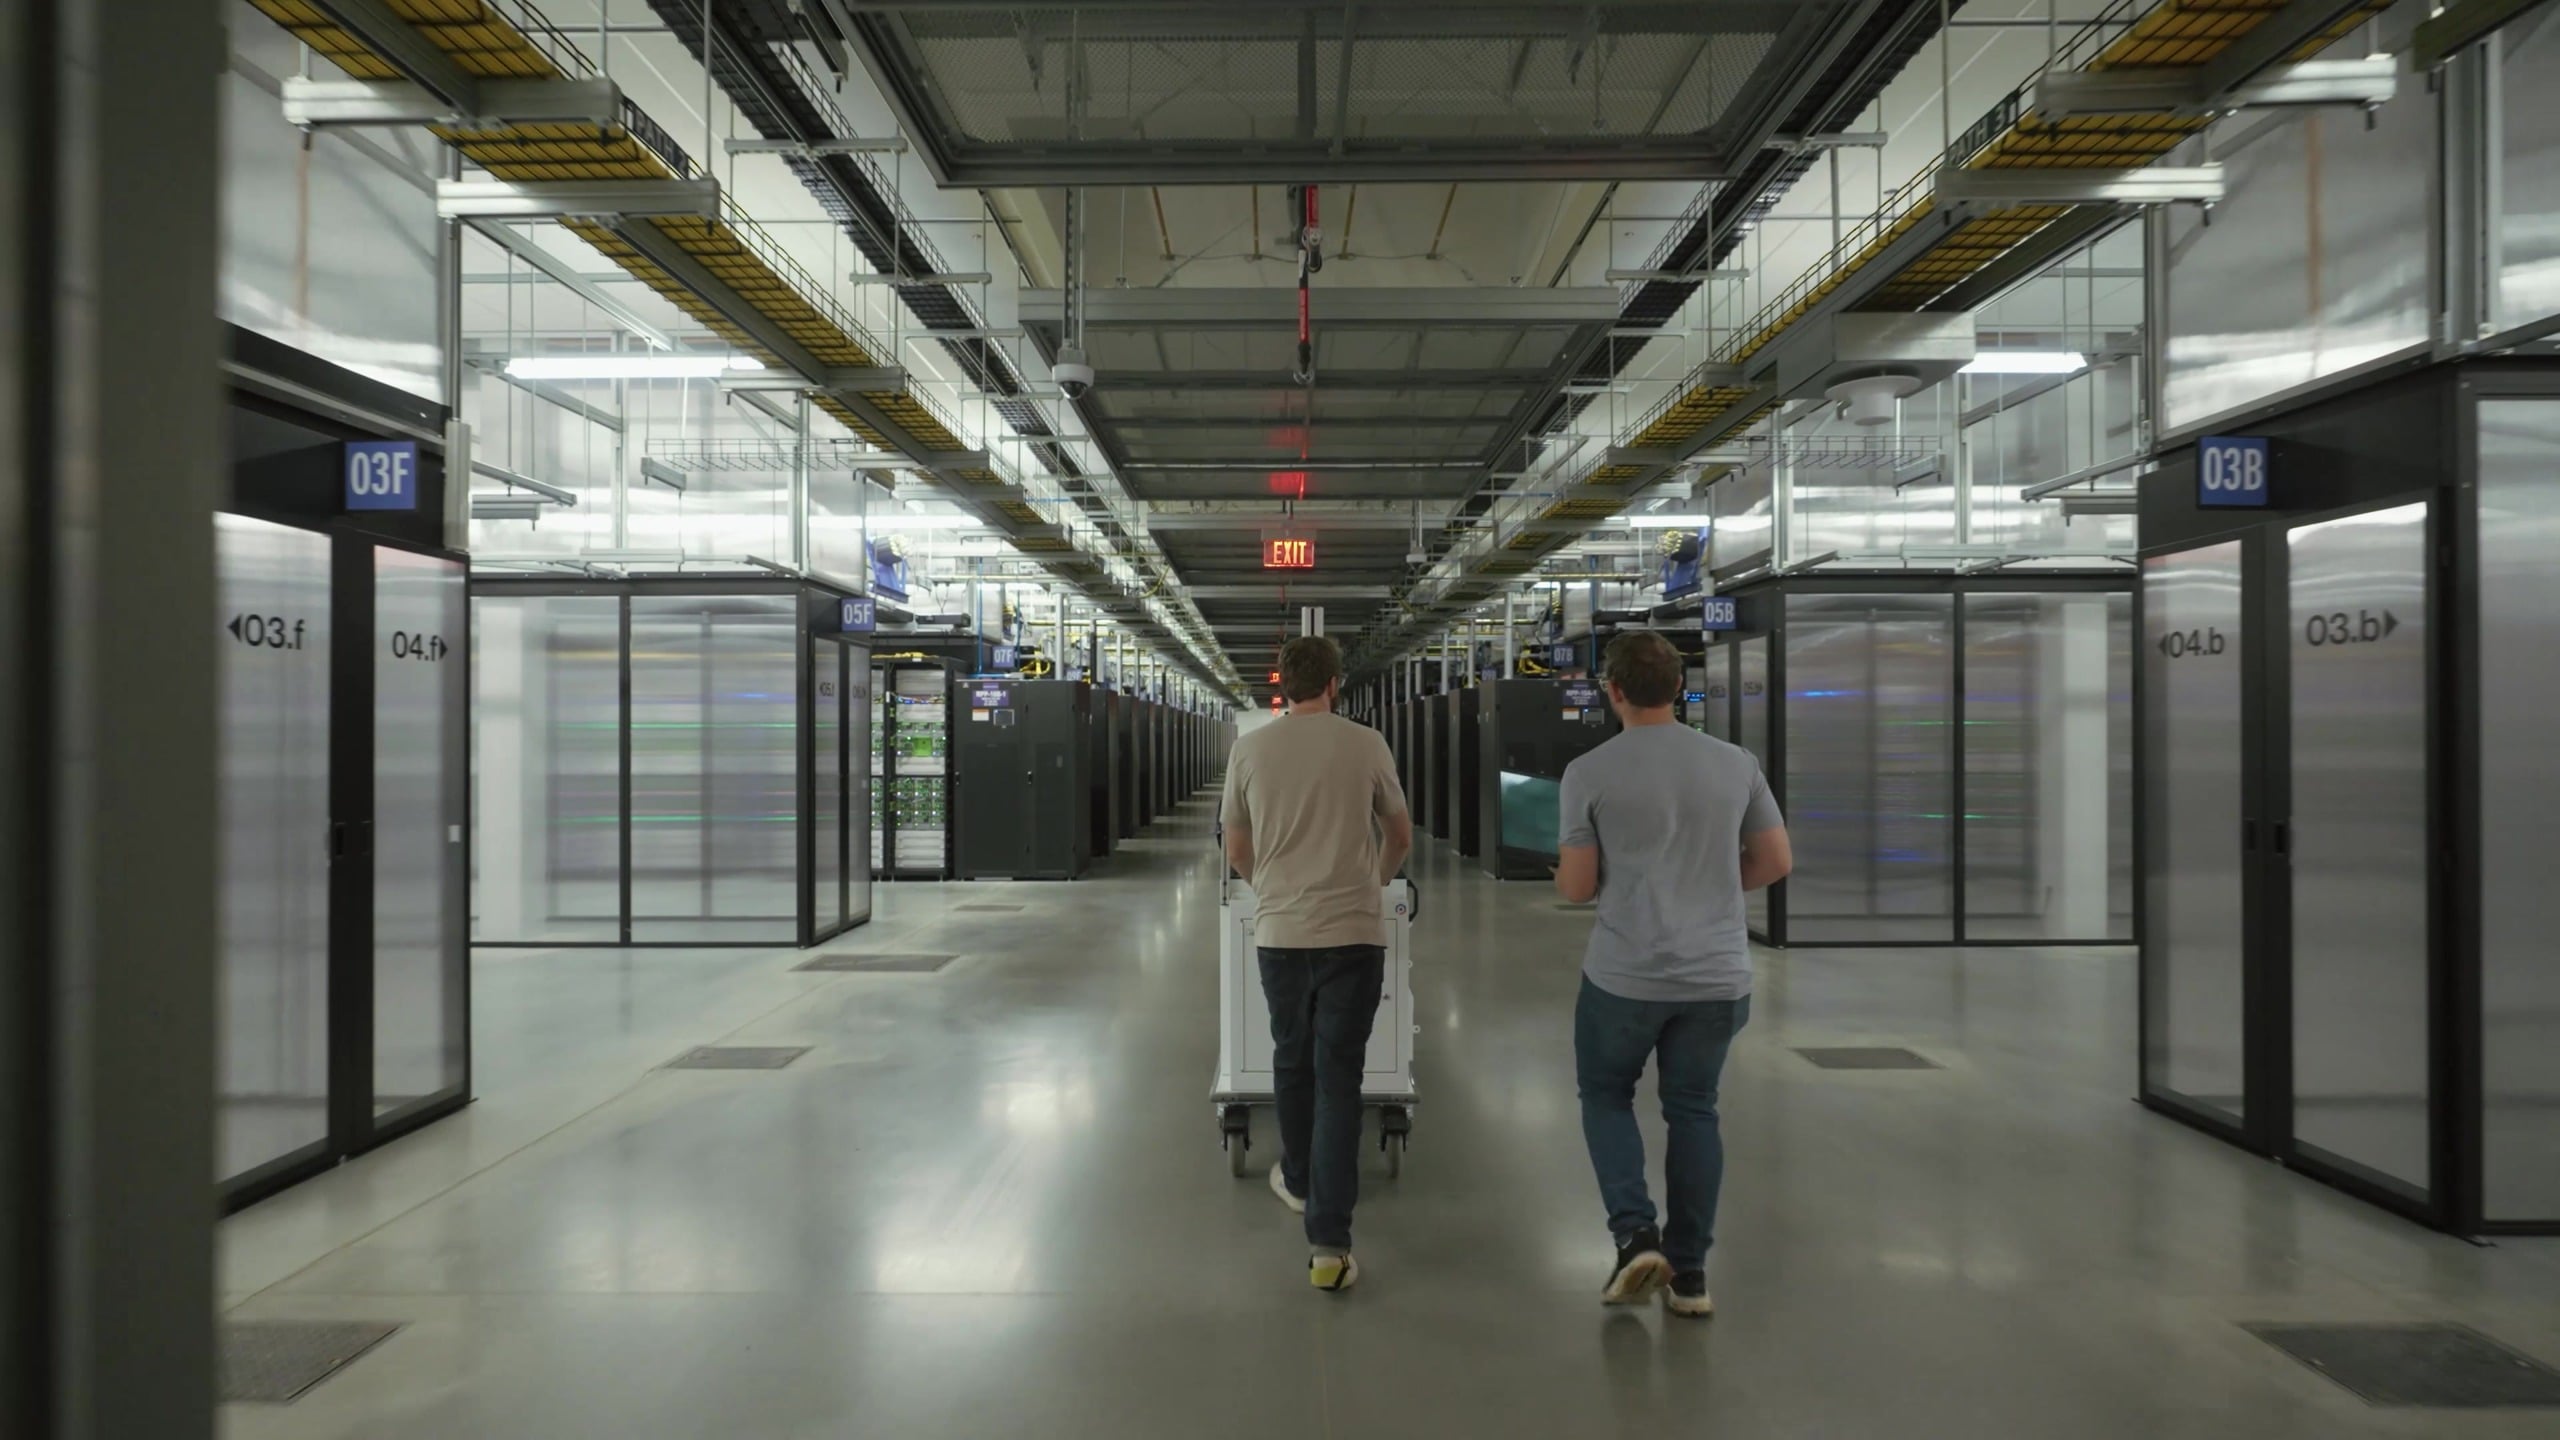
Het grootste deel van wat Meta publiceerde, betreft operationele details die hyperscalers doorgaans voor zichzelf houden: de configuratie van reserve-GPU's, de uitvalpercentages, de uitroltijden van firmware en de redenen achter de keuze voor de Ariel-configuratie. De rode draad is dat op deze schaal de hardware slechts het beginpunt is, en dat het werk dat honderdduizenden GPU's omzet in bruikbare trainingscapaciteit, zich afspeelt in het netwerk, de fouttolerantie en de telemetrie. Voor bedrijven die AI op grote schaal willen implementeren, is deze diepgaande analyse van Meta een goed uitgangspunt om in ieder geval te begrijpen waar problemen zich kunnen voordoen, zodat organisaties vooruit kunnen plannen voor hun gehele datacenteromgeving.



 Amazon