

Microsoft heeft vandaag op de OCP Global Summit de Azure Maia 300 onthuld, de derde generatie van hun eigen inferentieversneller en de eerste die is gebouwd als een multi-chiplet-component. Elke versneller combineert een TSMC N2P-rekenchip met acht HBM4-stacks voor 288 GB geheugen met een doorvoersnelheid van 18 TB/s binnen een TDP van 950 W. Een Maia 300-rack biedt plaats aan 96 van deze versnellers met een TDP van 167 kW. Microsoft claimt 40% meer tokens per megawatt dan toonaangevende GPU-gebaseerde systemen en tot 7 keer de tokendoorvoer op rackschaal van de Maia 200. De implementatie in productieomgevingen begint in 2027 als onderdeel van wat Microsoft omschrijft als Maia-implementaties van meerdere gigawatt.
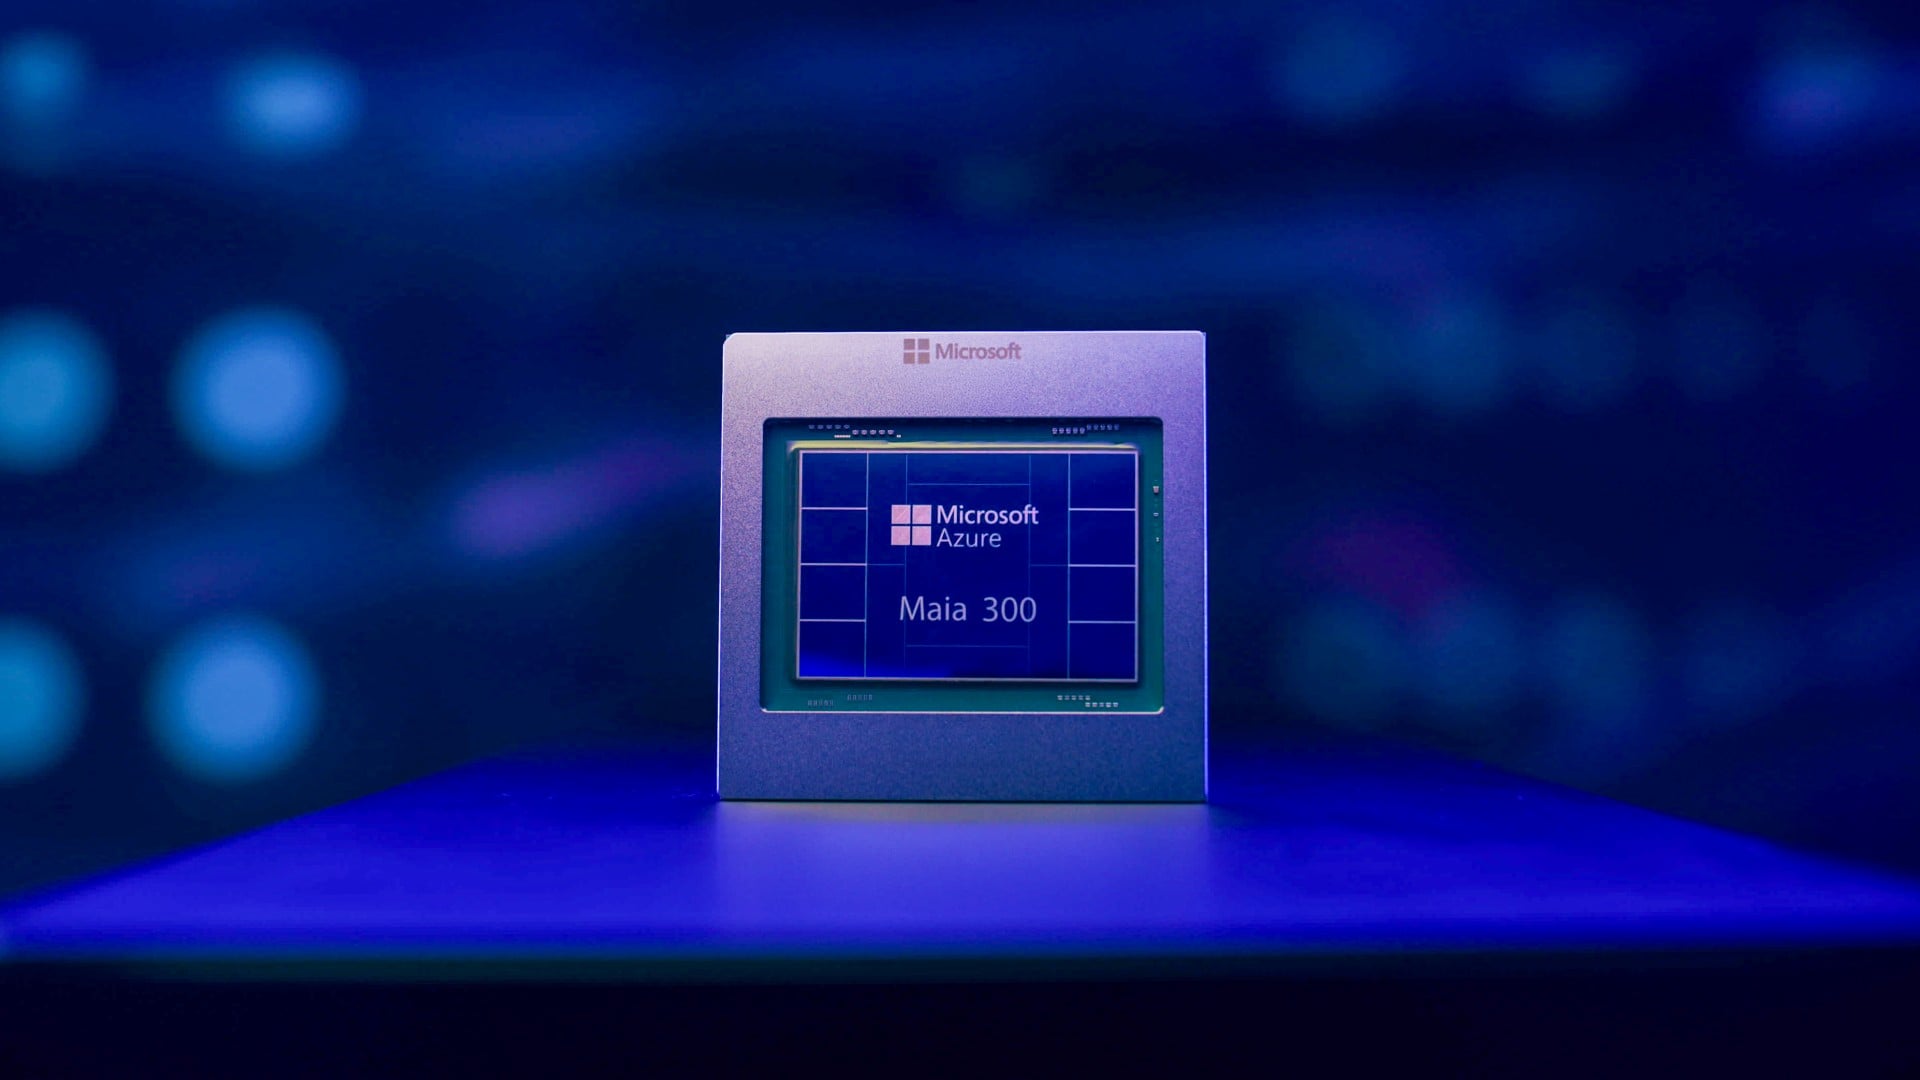
Maia 300 Silicon: N2P-rekenchip, acht HBM4-stacks, 32 poorten van 400G
De Maia 200 was een monolithische N3P-chip met zes HBM3E-stacks. De Maia 300 splitst het ontwerp op in een hoofd-rekenchip op N2P, twee I/O-chips en vier geheugenchips, waarbij de acht HBM4-stacks de capaciteit verhogen van 216 GB naar 288 GB en de bandbreedte van 7.1 TB/s naar 18 TB/s. De piekrekenkracht blijft gelijk: 13.8 POPS bij FP4 en 6.9 POPS bij FP8, tegenover respectievelijk 10.1 en 5.1. De generatie levert dus een winst van 37% in FP4-rekenkracht, terwijl de geheugenbandbreedte met een factor 2.5 toeneemt. Volgens Microsoft biedt de chip 2.5 keer zoveel bandbreedte, 33% meer capaciteit en ongeveer twee keer zoveel HBM-bandbreedte per watt als de Maia 200.
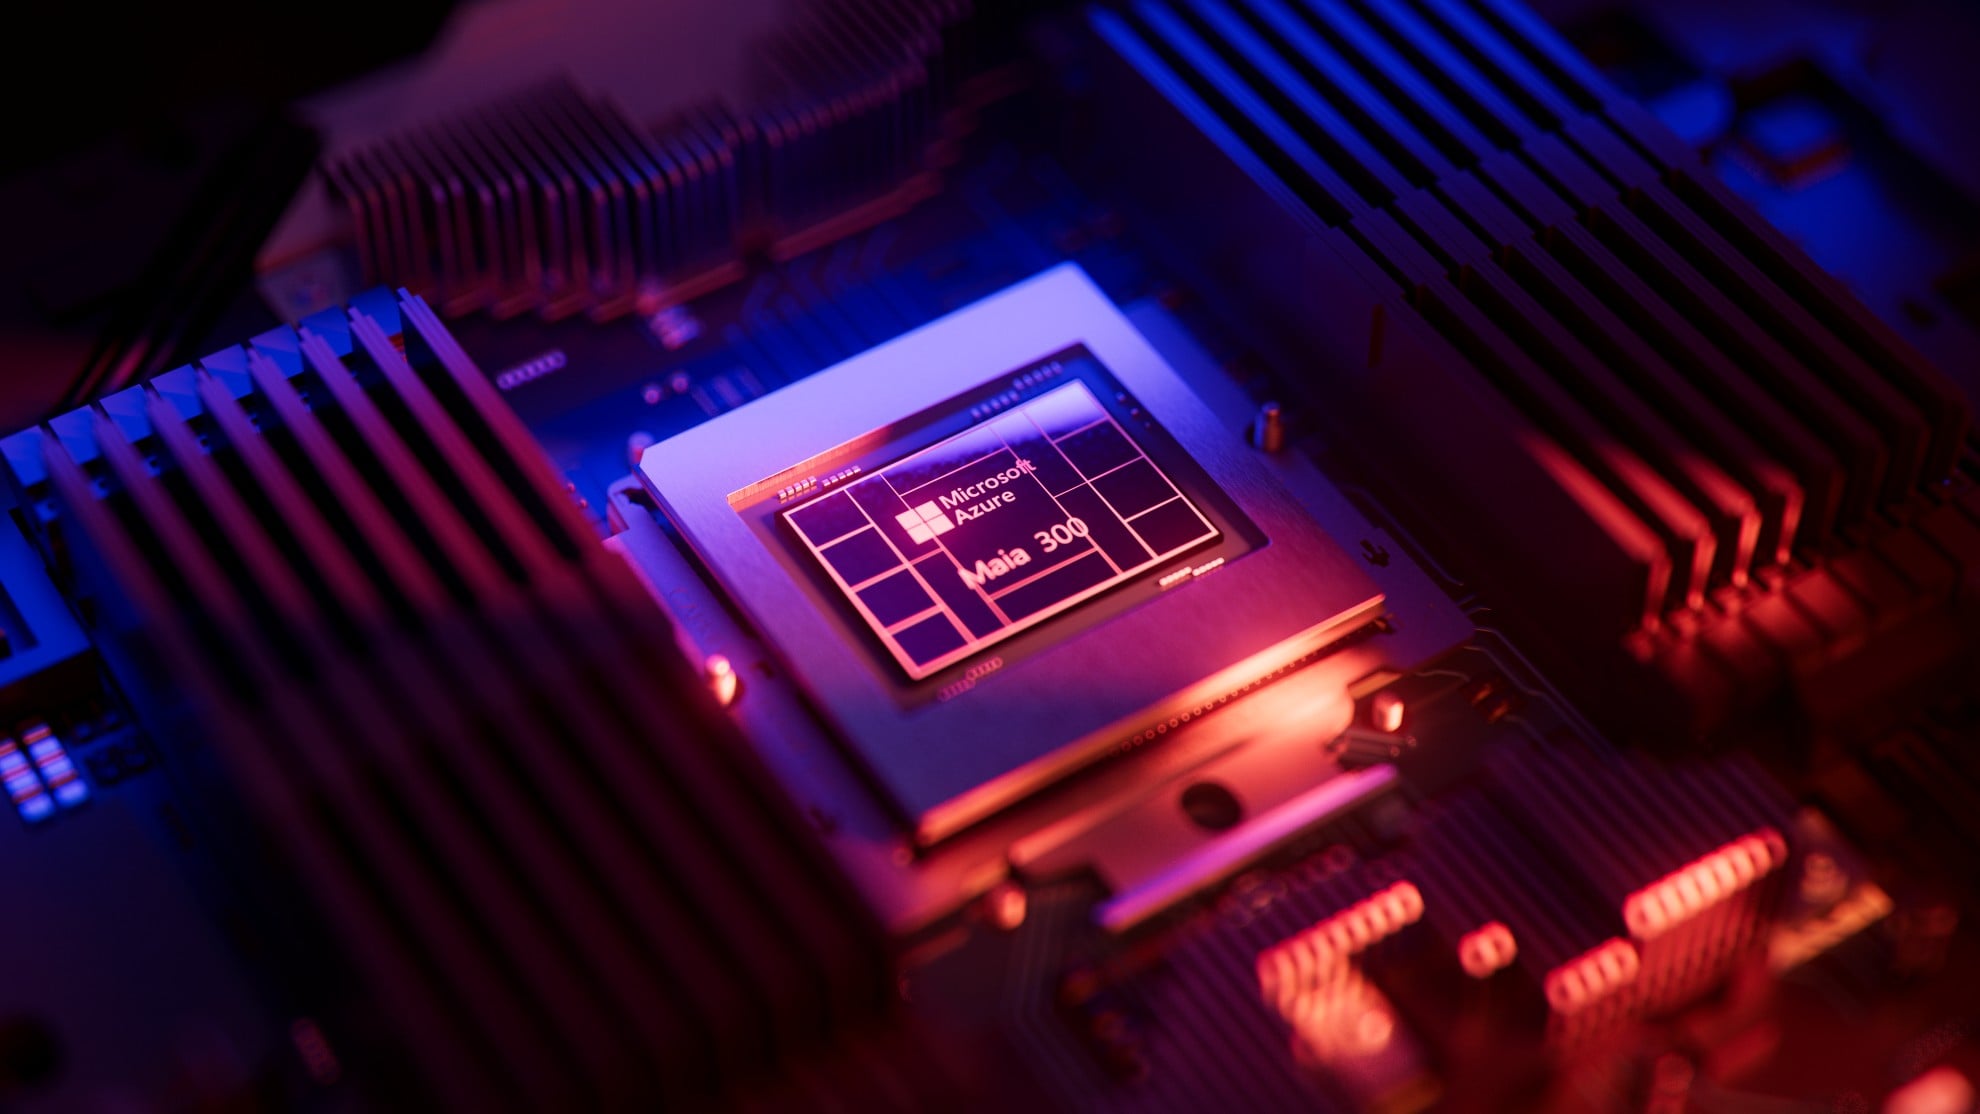
De rekenkern is georganiseerd in vier clusters van 12 tegels, waarbij elke tegel een tensor-eenheid, een vectorprocessor, een reshaper, een DMA-engine en lokaal SRAM bevat, met daarboven een gedeeld cluster-SRAM en een network-on-chip. Microsoft noemt deze aanpak een software-defined dataflow-architectuur: software plaatst data over deze lokale geheugens, DMA-engines en het netwerk. De SoC biedt PCIe Gen6 x16 aan de host en 32 poorten van 400 Gb/s Ethernet via een on-die AI-netwerkcontroller, die fungeert als schaalbaarheidsfabric.
Op de Maia 300 verandert de geheugenorganisatie van uniforme toegang naar een NUMA-indeling over de chiplets, waardoor data dichter bij de rekenkern kan worden geplaatst. De precisie neemt verder af door verbeterde MXFP4-technologie en hardwarematige datatypeconversie, met als doel het aantal bytes dat per token wordt verplaatst te verminderen, zowel voor de rekenkern als voor de KV-cache. Kernels kunnen ook on-die SRAM gebruiken als een softwarematig beheerd scratchpad om dataverkeer van HBM af te houden. Microsoft schrijft de prestatiewinst per watt toe aan deze veranderingen, aangezien de TDP stijgt van 750W naar 950W, terwijl het bedrijf claimt dat de prestaties per watt meer dan 2.5 keer zo hoog zijn.
96 Accelerators per Rack, 12,288 in een Superpod
Een Maia 300-rack verdubbelt het aantal accelerators naar 96 en verhoogt het stroomverbruik van het rack van 64 kW naar 167 kW, wat neerkomt op ongeveer 1.74 kW per accelerator-slot inclusief netwerken, koeling en stroomconversie. Over het hele rack is dat 27.6 TB aan HBM, een totale HBM-bandbreedte van 1,728 TB/s en 1,324 POPS aan FP4 volgens de cijfers van Microsoft, tegenover 10.4 TB, 341 TB/s en 485 POPS voor een Maia 200-rack. De bidirectionele schaalbandbreedte per accelerator stijgt van 2.8 TB/s naar 3.2 TB/s, en het tweelaagse Ethernet-schaalnetwerk met Microsofts aangepaste AI-transport bereikt nu een superpod van 12,288 accelerators, het dubbele van de ongeveer 6,000 van de vorige generatie.
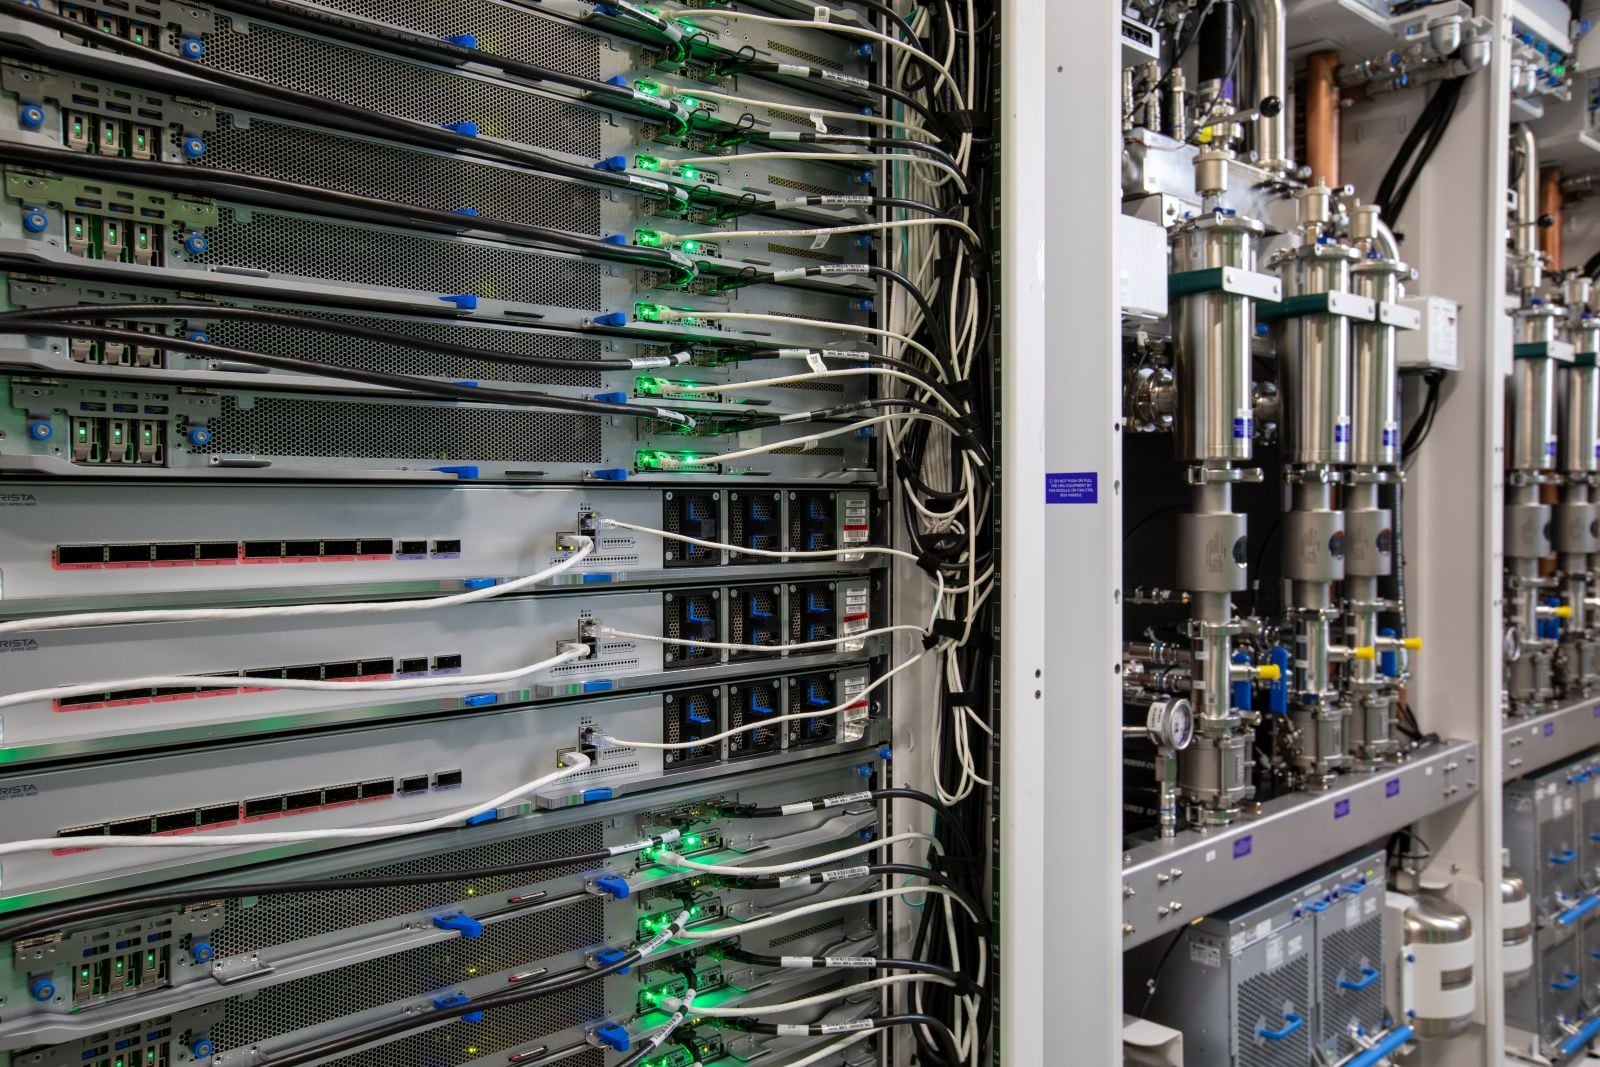
Het rackdiagram van Microsoft laat zien dat taken over racks zijn verdeeld via de scale-up fabric, met expert-parallel verkeer tussen de shards. Dit is het verkeerspatroon dat grote modellen met een mix van experts genereren tijdens de serverfase. Het bedrijf zegt dat hetzelfde communicatiemodel van toepassing is op elke accelerator in de superpod, dus een taak met 16 accelerators en een taak die zich over vier racks uitstrekt, gebruiken dezelfde semantiek.
Specificaties van de Maia 300
| Specificaties | 300 mei | 200 mei |
|---|---|---|
| Versneller | ||
| Proces | Multi-chiplet, N2P-rekenmatrijs | Monolithische N3P |
| FP4-piek | 13.8 POPPEN | 10.1 POPPEN |
| FP8-piek | 6.9 POPPEN | 5.1 POPPEN |
| SoC TDP | 950W | 750W |
| HBM | 8 x HBM4, 288 GB, 18 TB/s | 6 x HBM3E, 216 GB, 7.1 TB/s |
| Host-interface | PCIe Gen6 x16 | Niet vermeld |
| Bandbreedte opschalen (bidirectioneel) | 3.2 TB/s | 2.8 TB/s |
| Back-end netwerk | Tweelaagse Ethernet-schaalvergroting met AI-transport, 32 x 400 Gb/s | Tweelaagse Ethernet-schaalvergroting met AI-transport |
| Rack- en Scale-Up-domein | ||
| Acceleratoren per rack | 96 | 48 |
| Rack-voeding | 167 kW | 64 kW |
| Rack HBM-capaciteit | 27.6TB | 10.4TB |
| Rack HBM-bandbreedte | 1,728 TB/s | 341 TB/s |
| Rack FP4 piek | 1,324 POPPEN | 485 POPPEN |
| Opschalingsdomein | Ongeveer 12,288 versnellers | Ongeveer 6,000 versnellers |
Waar Maia 300 in past en waarop de beweringen gebaseerd zijn.
Maia 200 wordt nu gebruikt in productieomgevingen van Microsoft Copilot en het MAI-modelteam. GitHub Copilot en Microsoft Foundry zullen er naar verwachting eind dit jaar ook op overstappen. Microsoft geeft aan dat de chip wordt uitgerold in de Verenigde Staten, Europa en Australië en tot 1.7 keer meer tokens per watt levert dan de GPU-infrastructuur voor de ingebouwde AI-functies in Teams, Copilot en Cowork.
"We zullen onze Azure Maia-familie vanaf 2027 opschalen naar implementaties van meerdere gigawatt, waardoor Maia het primaire inferentiesysteem wordt voor Microsoft-producten en -services", schreef Scott Guthrie, executive vice president van Cloud + AI, bij de aankondiging van Maia 300. NVIDIA en AMD blijven onderdeel van Microsofts trainingsvloot en het bedrijf heeft Maia niet aangeboden als een instantietype dat Azure-klanten kunnen huren. De claim over de efficiëntie, 40% meer tokens per megawatt dan toonaangevende GPU-gebaseerde systemen, noemt de GPU, het model of de serverconfiguratie niet, en omdat Maia alleen binnen Microsoft draait, kan niemand buiten het bedrijf het testen.
De gepubliceerde specificaties ondersteunen het ontwerp: de geheugenbandbreedte per accelerator is met een factor 2.5 toegenomen, terwijl de FP4-rekenkracht met 37% is gestegen. Bovendien levert het rack 5.1 keer de HBM-bandbreedte van een Maia 200-rack met 2.6 keer het stroomverbruik. Dit is een chip die is ontworpen voor de decodeerfase van lange-context- en agent-inferentie, waar de bottleneck de aanvoer naar de rekeneenheden is. Het laat zien hoe een hyperscaler een inferentie-onderdeel dimensioneert wanneer het de volledige workload beheert. We berichtten in januari over de lancering van de Maia 200 en Microsoft zegt dat er in november tijdens Ignite meer details bekend zullen worden gemaakt.




 Amazon