

MLPerf Inference v5.1 biedt strenge benchmarks voor AI-inferentie voor LLM's, visie en multimodale taken. Hier vindt u de technische analyse van NVIDIA's Blackwell Ultra-resultaten en AMD's Instinct MI300X/MI325X/MI355X-inzendingen. Het bevat gedetailleerde benchmarkgegevens, software-optimalisaties, architectuurstrategieën en implicaties voor hyperscalers en ondernemingen.
MLPerf Benchmarking Framework
MLPerf Inference benchmarks dienen als scorebord voor AI-accelerators en bieden een gestandaardiseerde, vergelijkbare methode voor het meten van prestaties binnen beeldclassificatie, taalmodellen en aanbevelingssystemen. Voor bedrijven die GPU's op grote schaal implementeren, zijn deze cijfers vaak bepalend voor grootschalige aankoopbeslissingen.
MLPerf Inference wordt beheerd door MLCommons en definieert de regels voor gesloten versus open deling. Scenario's zijn onder andere:
- offline: Gericht op doorvoer (zoveel mogelijk query's in batch verwerken).
- Server: Latency-compatibele multi-stream inferentie.
- Interactief: Strikte TTFT (Time-to-First-Token) en TPS (tokens per seconde @ 99e percentiel).
De v5.1 workloadsuite bevatte:
- Diep zoeken-R1: Een 671B-model met een mix van experts (stresstest voor redeneer-inferentie).
- Lama-3.1-405B en 8B: Nieuwste LLM's in meerdere inferentiemodi.
- Fluisteren: ASR vervangt RNN-T.
- Stabiele Diffusie XL (SD-XL): Tekst-naar-afbeelding generatieve AI.
- Gemengd, DLRMv2, plus oudere workloads zoals ResNet-50.
Wanneer grafieken van doorvoer (tokens/sec of samples/sec) worden getoond, benadrukken deze doorgaans de aanhoudende dominantie van NVIDIA in absolute aantallen, met name per GPU. De vooruitgang van AMD op het gebied van relatieve efficiëntie en soepele schaalbaarheid laat echter zien dat ze de kloof ronde na ronde dichten, vooral in serverscenario's en multi-node-implementaties.
NVIDIA Blackwell Ultra-resultaten
Blackwell Ultra-systemen behaalden een recorddoorvoer voor alle nieuwe workloads. Belangrijkste voordelen:
- NVFP4-precisie: aangepaste 4-bit float, versnelling van DeepSeek en Llama.
- FP8 KV-cache: geheugenbesparing voor aandachtslagen.
- Gedesaggregeerde weergave: gesplitste context versus generatiefasen over 72 GPU's via 1,800 GB/s NVLink.
- Software: CUDA-grafieken, TensorRT-LLM, ADP-balans.
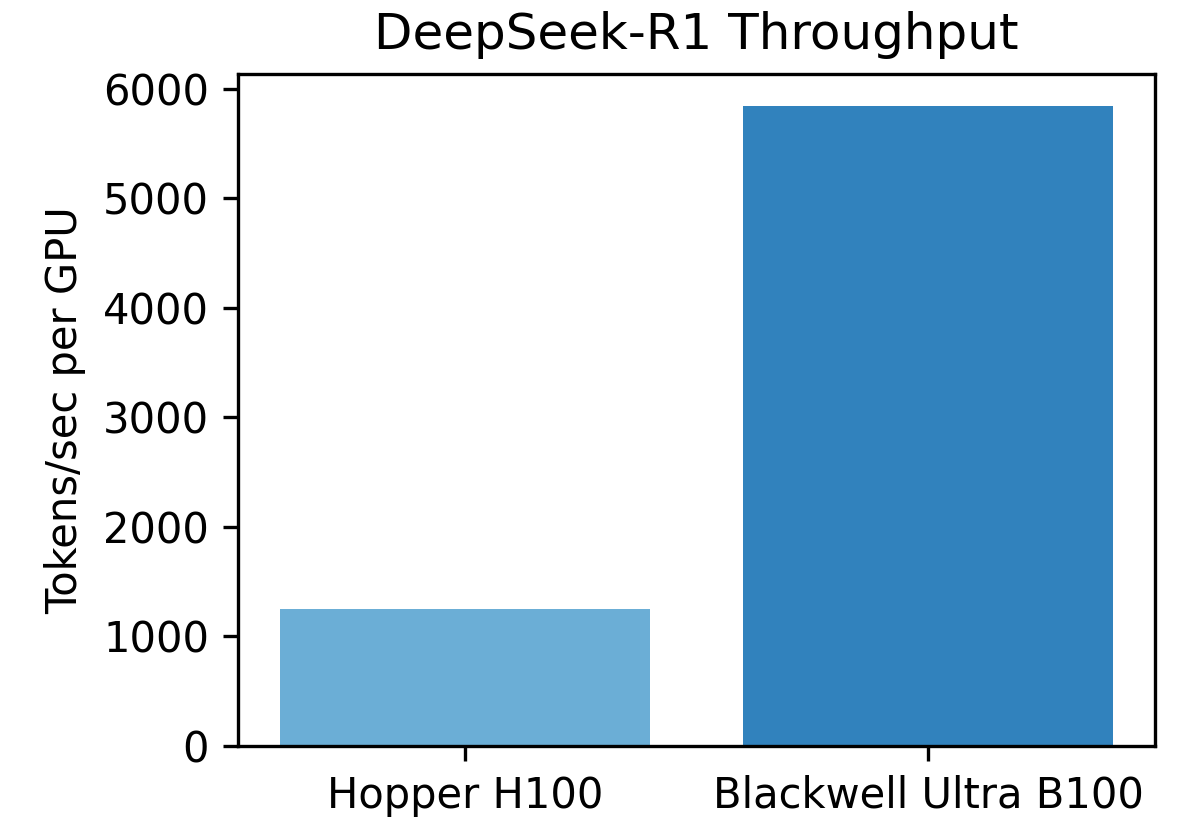
De onderstaande staafgrafiek, die Hopper en Blackwell Ultra per GPU vergelijkt, toont een bijna 5x hogere doorvoersnelheid op DeepSeek-R1, wat bevestigt dat fijnmazige dataformaten (NVFP4) en rackbrede bandbreedte lineair schalen voor enorme inferentieworkloads. Een andere grafiek, gebaseerd op de recordresultaten van de interactieve Llama-405B, laat zien hoe NVIDIA NVLink-netwerk en gedesaggregeerde servering gebruikt om latentie-SLA's te handhaven en tegelijkertijd eerdere doorvoerlimieten te doorbreken. De conclusie: NVIDIA blijft de koploper in de branche als het gaat om pure snelheid en latentiegevoelige workloads.
Resultaten van AMD Instinct MI300X/MI325X/MI355X
AMD richtte zich op efficiëntie en flexibiliteit:
- FP4 op MI355X: levert 2.7× meer Llama-2-70B-doorvoer vergeleken met de MI325X FP8.
- Gestructureerd snoeien: Op de Llama-405B zorgde snoeien met 21–33% voor een reductie van FLOP's zonder dat dit de nauwkeurigheid beïnvloedde, waardoor de doorvoer met ~82–90% toenam.
- scaling: Soepele lineaire schaalbaarheid bewezen tot 8 knooppunten; eerste heterogene cluster (4 × MI300X + 2 × MI325X) behaalde een schaalefficiëntie van 94%.
- Reproduceerbaarheid van het ROCm-ecosysteem: Partnerinzendingen liggen consistent binnen 1–3% van AMD's eigen resultaten.
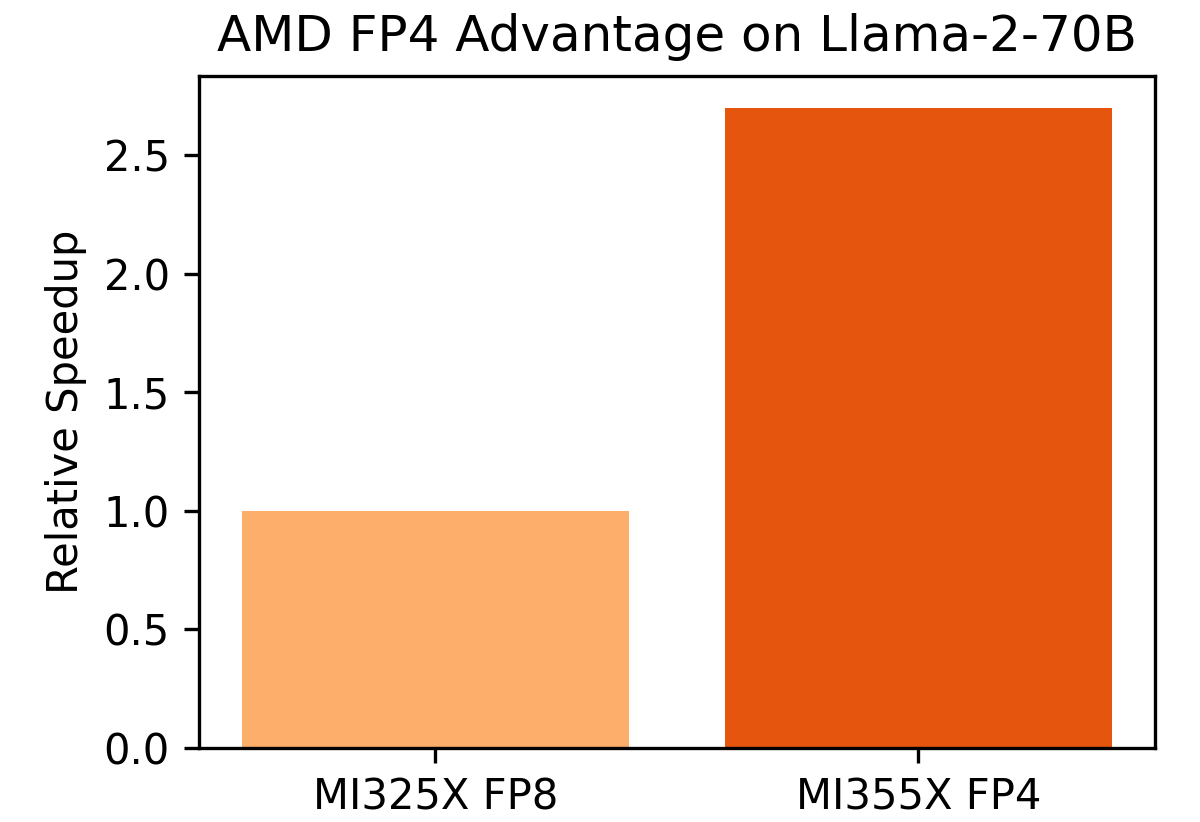
De bovenstaande grafiek, waarin de MI325X FP8 wordt vergeleken met de MI355X FP4, illustreert de baanbrekende voordelen van FP4: hogere tokens/sec met minimaal verlies aan nauwkeurigheid. Hieruit blijkt dat FP4 niet experimenteel is, maar klaar voor implementatie.
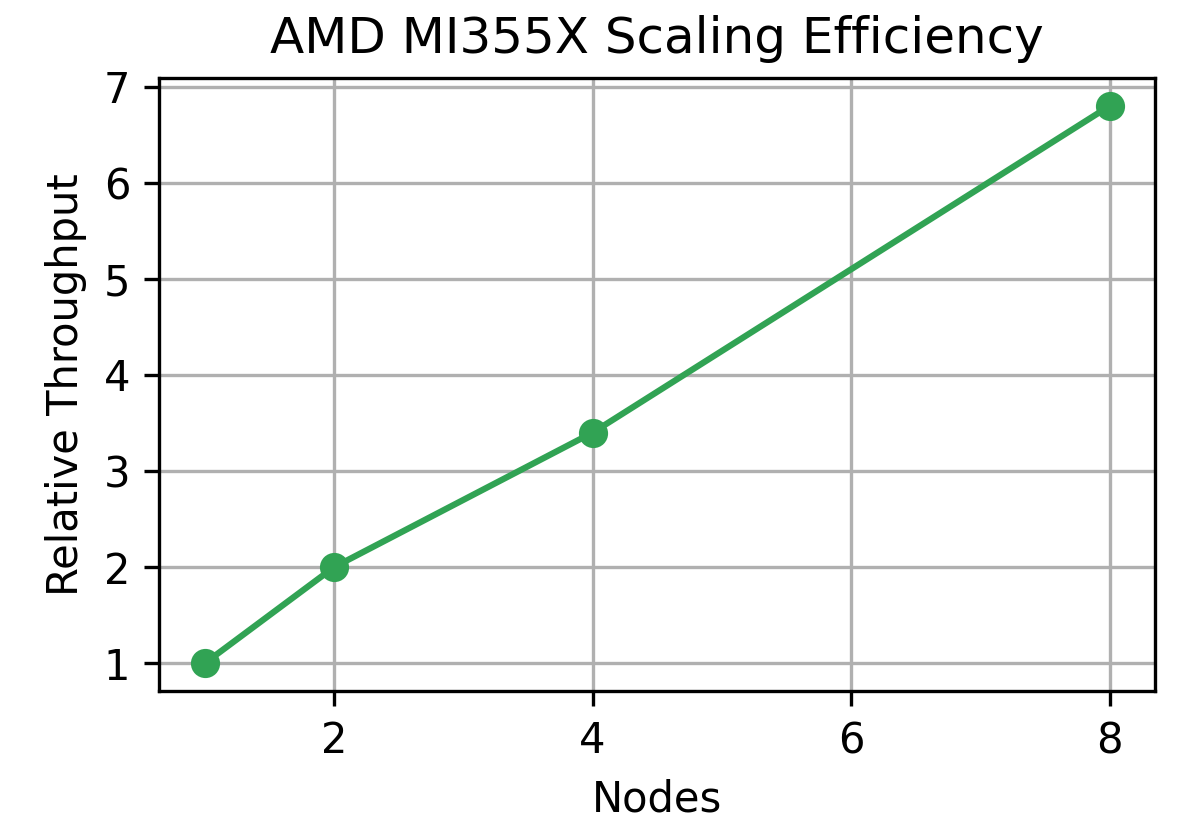
Deze schaalcurve (1 → 8 knooppunten) laat een bijna lineaire schaalbaarheid zien, iets wat hyperscalers waarderen omdat het zich vertaalt in voorspelbare uitbreidingskosten. Het schema van gestructureerd snoeien toont ondertussen aan dat AMD zich niet alleen richt op brute hardware, maar ook op algoritmische efficiëntie, cruciaal voor inferentieclusters in de praktijk die beperkt worden door stroom en ruimte.
AMD-NVIDIA directe vergelijking
|
metrisch |
NVIDIA Blackwell Ultra |
AMD MI355X |
Notes |
Winnaar |
|
Tokens/sec per GPU |
5842 (DeepSeek-R1) |
~2200 (geschaald FP4) |
Hogere NVIDIA raw-prestaties |
NVIDIA |
|
Geheugen per GPU |
192 GB HBM3e |
288 GB HBM3e |
AMD past 520B-model op één GPU |
AMD |
|
Precisieondersteuning |
FP16, FP8, NVFP4 |
KP16, KP8, KP4 |
Beide 4-bits lead |
Binden |
|
Schaalstof |
72 GPU NVLink |
Lineaire knooppuntschaling naar 8 |
Verschillende schaalstrategieën |
Binden |
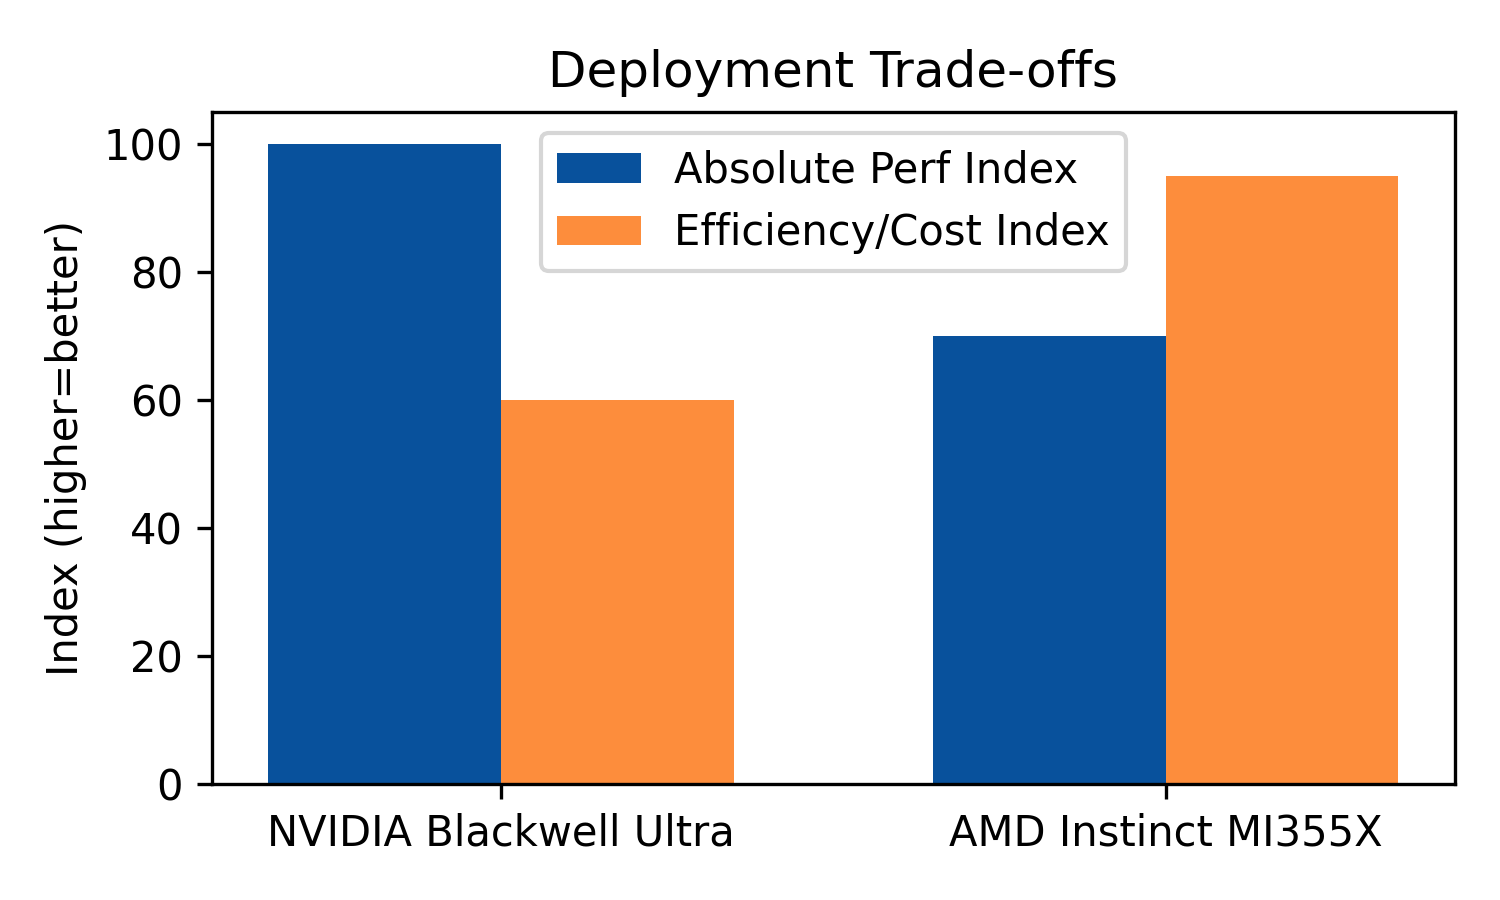
Naast elkaar geplaatste visualisaties benadrukken de afwegingen.
- NVIDIA domineert de per-GPU-doorvoer, waardoor het ideaal is voor AI-fabrieken waar flopdichtheid van belang is.
- AMD blinkt uit als het gaat om kosten per token en flexibiliteit bij de implementatie, met een groter geheugen (288 GB) en FP4-pruning.
Implicaties voor de industrie
- hyperscalersNVIDIA blijft de tool bij uitstek voor AI-fabrieken die topprestaties nastreven. AMD's groeiende efficiëntie-innovaties maken echter kostengeoptimaliseerde schaalbaarheid mogelijk, wat aantrekkelijk is voor het verdelen van workloads over verschillende niveaus.
- Cloud Providers: Verwacht heterogene aanbiedingen, krachtige NVIDIA-lagen versus kostenefficiënte AMD Kubernetes-pods.
- Bedrijven: Gestructureerde pruning, FP4 en ondersteuning voor heterogene clusters stellen AMD in staat om modelinferentie van 405B+ te leveren tegen een lagere TCO. NVIDIA-innovaties (gedisaggregeerde servering en Dynamo) blijven gunstig voor latentiegevoelige apps (bijv. realtime LLM-chatbots).
- Toekomstblik: Verwacht universele acceptatie van 4-bits inferentie als basis, breder gebruik van heterogene GPU-pools en nieuwe systeemontwerpen, waaronder NVIDIA's Rubin CPX voor lange sequenties en AMD's ROCm-uitbreiding om meer frameworks te bestrijken.
NVIDIA blijft de toon zetten op het gebied van ruwe doorvoer, met H200 GPU's die inferentie leiden in ResNet-50 en BERT in gesloten divisiebenchmarks. AMD's MI300 blijft echter niet ver achter, met concurrerende cijfers in server- en offline scenario's en een sterke verbetering in energie-efficiëntie. Het echte verhaal is niet alleen dat NVIDIA de koppositie behoudt, maar ook dat AMD de achterstand aanzienlijk heeft ingelopen ten opzichte van slechts één MLPerf-ronde geleden. Voor kopers betekent dit dat de tijd dat ze alleen naar groene GPU's keken, voorbij is: ROCm wordt volwassen en MI300 is levensvatbaar in praktische inferentie-implementaties.


 Amazon