

Tijdens de AI Infra Summit worden de resultaten van MLPerf Inference van AMD en NVIDIA belicht, evenals de Vera Rubin-routekaart van NVIDIA voor 2026, met name Rubin CPX.
Op de AI Infra Summit 2025 toonde NVIDIA momentum op twee fronten: indrukwekkende nieuwe MLPerf Inference-resultaten van zijn Blackwell Ultra-systemen en, belangrijker nog, een gedetailleerde roadmap voor de Vera Rubin-generatie van 2026, inclusief Rubin CPX, een nieuwe klasse GPU's die speciaal is ontworpen voor grootschalige contextuele inferentie.
Blackwell Ultra stelt nieuwe prestatienormen vast
NVIDIA's GB300 NVL72 rack-scale systemen hebben al opmerkelijke prestaties geleverd in MLPerf Inference v5.1, wat de architectonische volwassenheid van het Blackwell Ultra-platform aantoont, terwijl software zijn volledige potentieel blijft ontsluiten. Deze kracht wordt duidelijk getoond in de Llama 2 70B benchmark, waar het platform een indrukwekkende 12,934 tokens per seconde per GPU leverde in offline scenario's. De prestaties in de online servertest waren vrijwel identiek met 12,701 tokens per seconde, wat wijst op de uitzonderlijke efficiëntie van de architectuur bij verschillende workloads.
De gereedheid van het platform voor praktische toepassingen werd verder aangetoond in de nieuw geïntroduceerde interactieve categorie, die aanzienlijk strengere latentiebeperkingen oplegt, waaronder vereisten voor de time-to-first-token van minder dan 500 ms en een drempel van 33 tokens per seconde per gebruiker. Zelfs onder deze strenge eisen voor de kwaliteit van de service behield Blackwell Ultra een hoge doorvoersnelheid van 7,856 tokens per seconde per GPU. In de DeepSeek-R1-benchmark vestigde het platform opnieuw een definitieve basislijn met 5,842 tokens per seconde per GPU.
Uiteindelijk geven deze resultaten aan dat de mogelijkheden van de hardware die van de huidige softwarestack overtreffen. Er is nog aanzienlijke prestatieruimte te winnen nu frameworks zoals TensorRT-LLM en NVIDIA Dynamo zich verder ontwikkelen om de architectuurvoordelen van Blackwell Ultra, zoals de verbeterde NVFP4-rekenpaden en de enorme HBM288e-capaciteit van 3 GB per GPU, volledig te benutten.
Versnelling van het innovatietempo: het Vera Rubin-platform
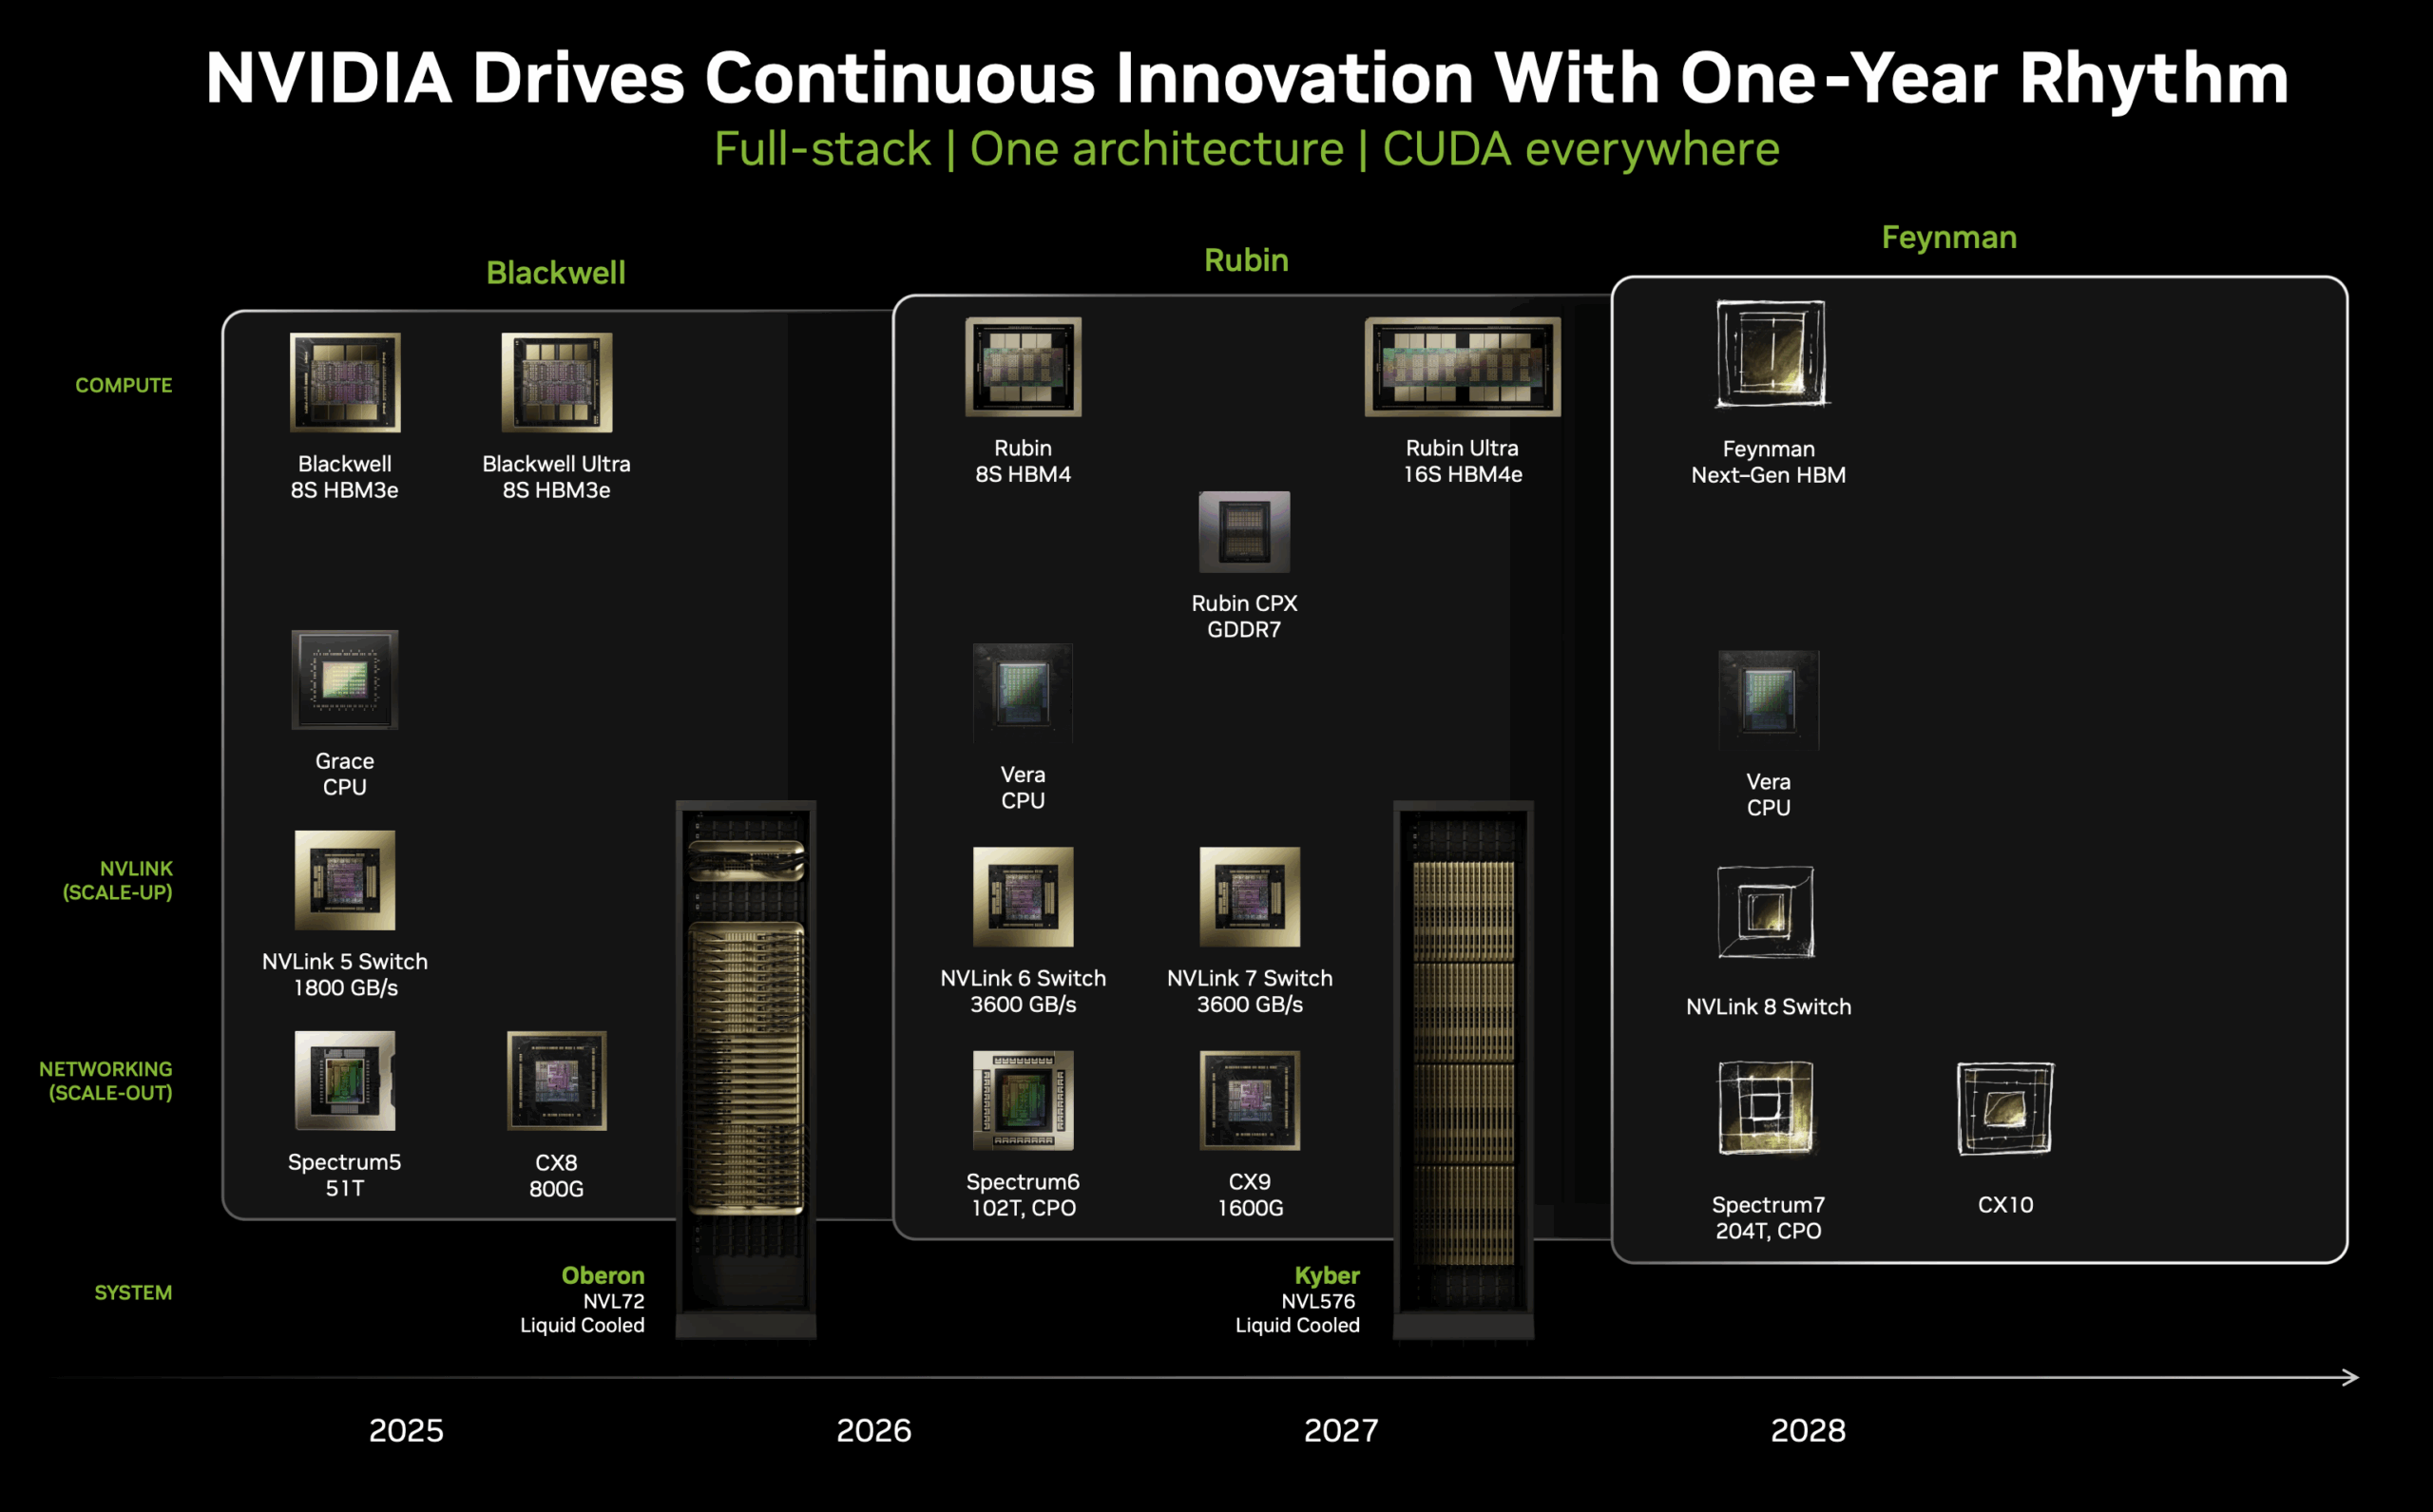
NVIDIA heeft een jaarlijkse architectuurvernieuwingscyclus ingevoerd als strategische reactie op de exponentiële groei van de vraag naar AI-computers. NVIDIA heeft deze ambitieuze planning aangehouden en onthuld dat de Vera Rubin-generatie al klaar is en gepland staat voor implementatie in bedrijven in de tweede helft van 2026.
De Vera Rubin-architectuur introduceert een uitgebreide platformvernieuwing, gericht op de integratie van nieuwe Vera CPU's en Rubin GPU's. De Vera CPU vertegenwoordigt een significante evolutie ten opzichte van de Grace-modellen van de laatste drie generaties NVIDIA-systemen. De Vera CPU's beschikken over 88 ARM-cores die 176 threads ondersteunen. Deze processoren verdubbelen ook de chip-to-chip (C2C) linkbandbreedte tot 1,800 GB/s, wat een snellere verbinding tussen de CPU, GPU en hun gedeelde geheugenbronnen mogelijk maakt.

Op de interconnectlaag levert de NVLink van de zesde generatie een bidirectionele bandbreedte van 3,600 GB/s, waarmee de bandbreedte van de huidige NVLink-switches van de vijfde generatie wordt verdubbeld. Deze verbeterde connectiviteit wordt met name cruciaal naarmate modellen steeds verder worden geschaald dan de geheugencapaciteit van individuele apparaten, wat geavanceerde parallelle uitvoeringsstrategieën vereist die minimale communicatielatentie en maximale doorvoer tussen knooppunten vereisen.
Als aanvulling op de NVLink-ontwikkeling bereikt de Spectrum-6-switch, met co-packaged optics (CPO)-technologie, een schakelcapaciteit van 102 TB/s. De integratie van optische componenten direct in de switchbehuizing elimineert traditionele knelpunten bij de conversie van elektrisch naar optisch, waardoor de latentie wordt verminderd en de energie-efficiëntie aanzienlijk wordt verbeterd – cruciale overwegingen nu AI-fabrieken opschalen naar gigawatt-stroomverbruik.

De VR NVL144-systemen maken nog steeds gebruik van het bewezen Oberon-rackplatform dat momenteel de basis vormt voor de implementaties van Grace Hopper, Grace Blackwell en Grace Blackwell Ultra.
Evolutie van de architectonische nomenclatuur: van verpakkingen tot matrijzen
NVIDIA verschuift zijn naamgevingsconventie van een pakketgebaseerd naar een chipgebaseerd aantal. Hoewel deze verandering controversieel kan zijn, is het een vooruitstrevende stap die meer duidelijkheid zal scheppen, vooral met de verwachte lancering van Rubin Ultra GPU's eind 2026, die naar verwachting vier chipgrootte chips zullen hebben.

Met de Rubin-generatie hanteert NVIDIA een nomenclatuur per chip die de beschikbare rekenkracht direct weerspiegelt. De NVL144-aanduiding verwijst expliciet naar 144 GPU-chips, terwijl de fysieke configuratie van 72 pakketten behouden blijft, en biedt een nauwkeurigere meting van de rekencapaciteit. Dit is vergelijkbaar met de huidige generatie GB200 en GB300 NVL72-systemen, die 72 GPU-pakketten bevatten, elk met twee GPU-chips, voor een totaal van 144 rekenchips.
Het aanpakken van de uitdaging van contextverwerking
De aankondiging van Rubin CPX, gepland voor beschikbaarheid eind 2026, is NVIDIA's architecturale antwoord op een van de meest urgente uitdagingen in LLM-inferentie: de fundamentele mismatch tussen rekenpatronen tijdens verschillende fasen van tokengeneratie. Om deze innovatie te begrijpen, moeten we de onderscheidende kenmerken van LLM-inferentieworkloads en de beperkingen van huidige homogene GPU-architecturen bij het voldoen aan deze uiteenlopende rekenbehoeften onderzoeken.
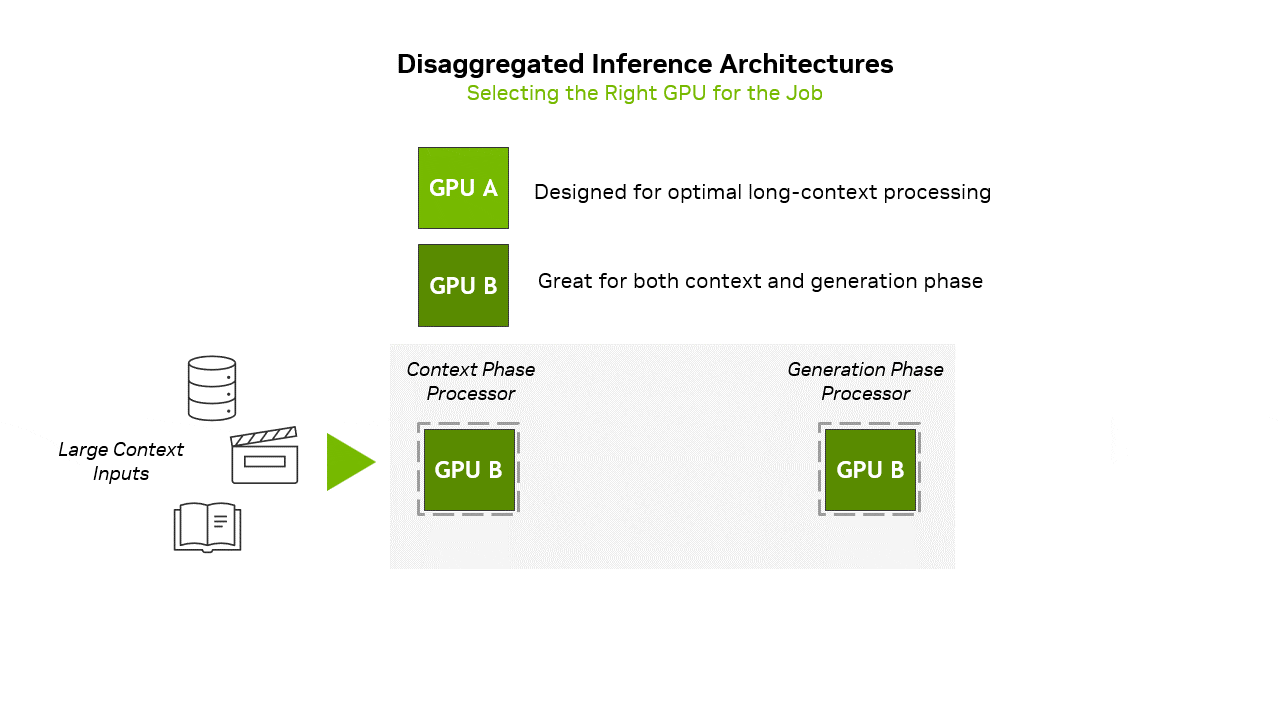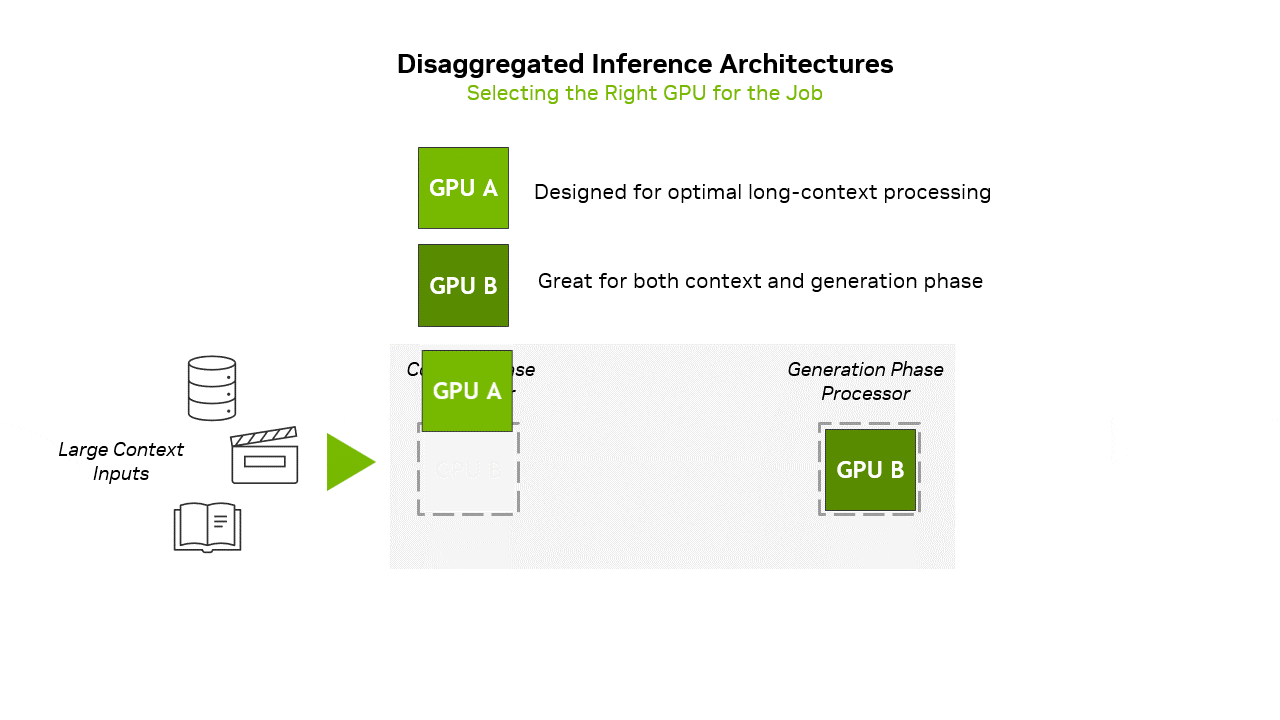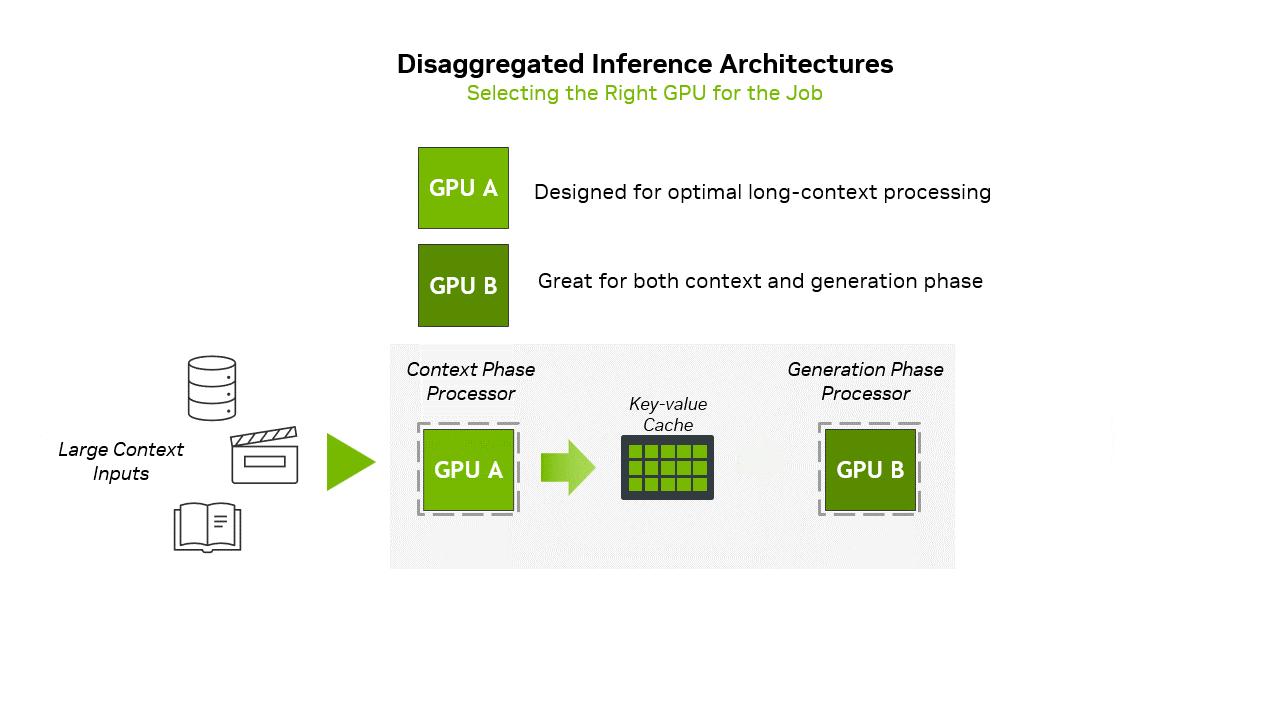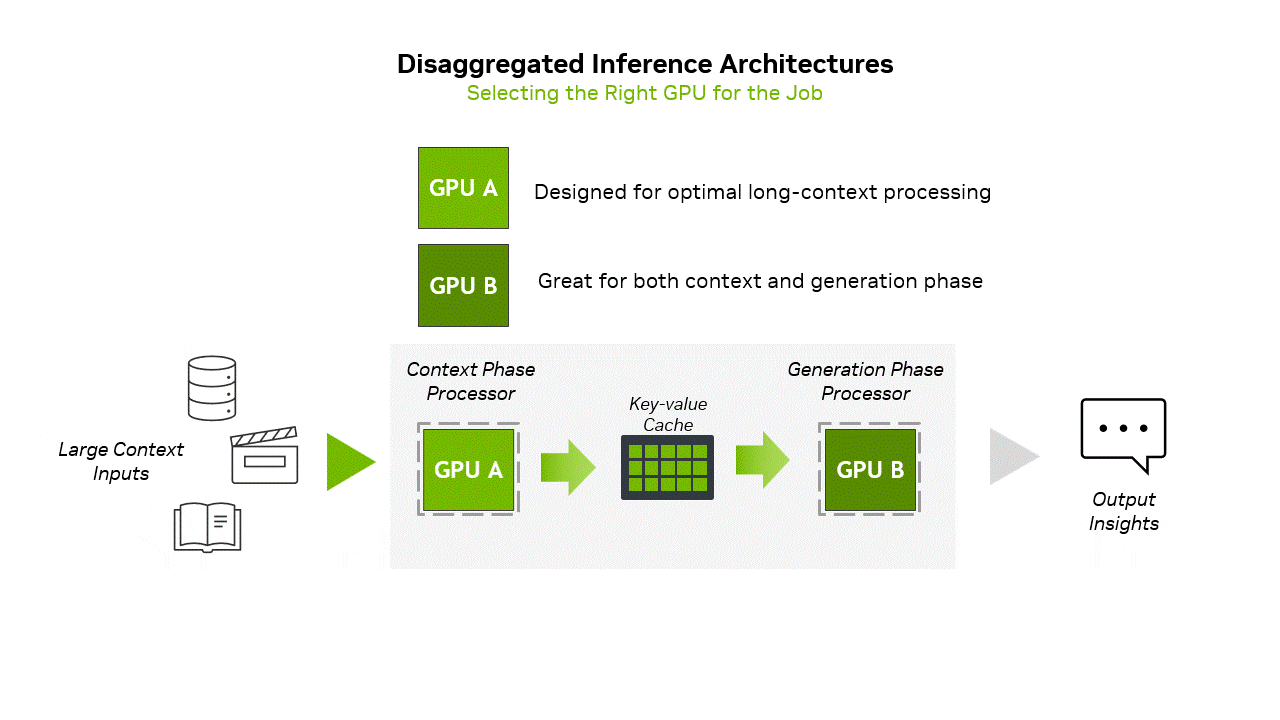
Inferentie van grote taalmodellen verloopt via twee fundamenteel verschillende rekenfasen die aanzienlijk verschillende eisen stellen aan hardwarebronnen. De prefill-fase verwerkt de initiële invoerprompt en berekent de sleutel- en waardematrices voor de volgende generatie. Deze fase is rekenintensief en maakt efficiënt gebruik van de enorme floating-point-doorvoer van moderne GPU's.
De decoderingsfase brengt een geheel andere rekenuitdaging met zich mee. Tijdens het decoderen genereert het model autoregressief uitvoertokens, waarbij één token tegelijk wordt geproduceerd door rekening te houden met de vorige context. Elk nieuw token vereist het aandachtsmechanisme om de volledige sequentiegeschiedenis te verwerken en de relatie met alle voorgaande tokens te berekenen. Dit creëert een uniek rekenpatroon waarbij de geheugenbandbreedte, in plaats van de rekencapaciteit, de primaire bottleneck wordt. De KV-cache, die de tussenliggende representaties opslaat die nodig zijn om de context te behouden, wordt de belangrijkste geheugenconsument.
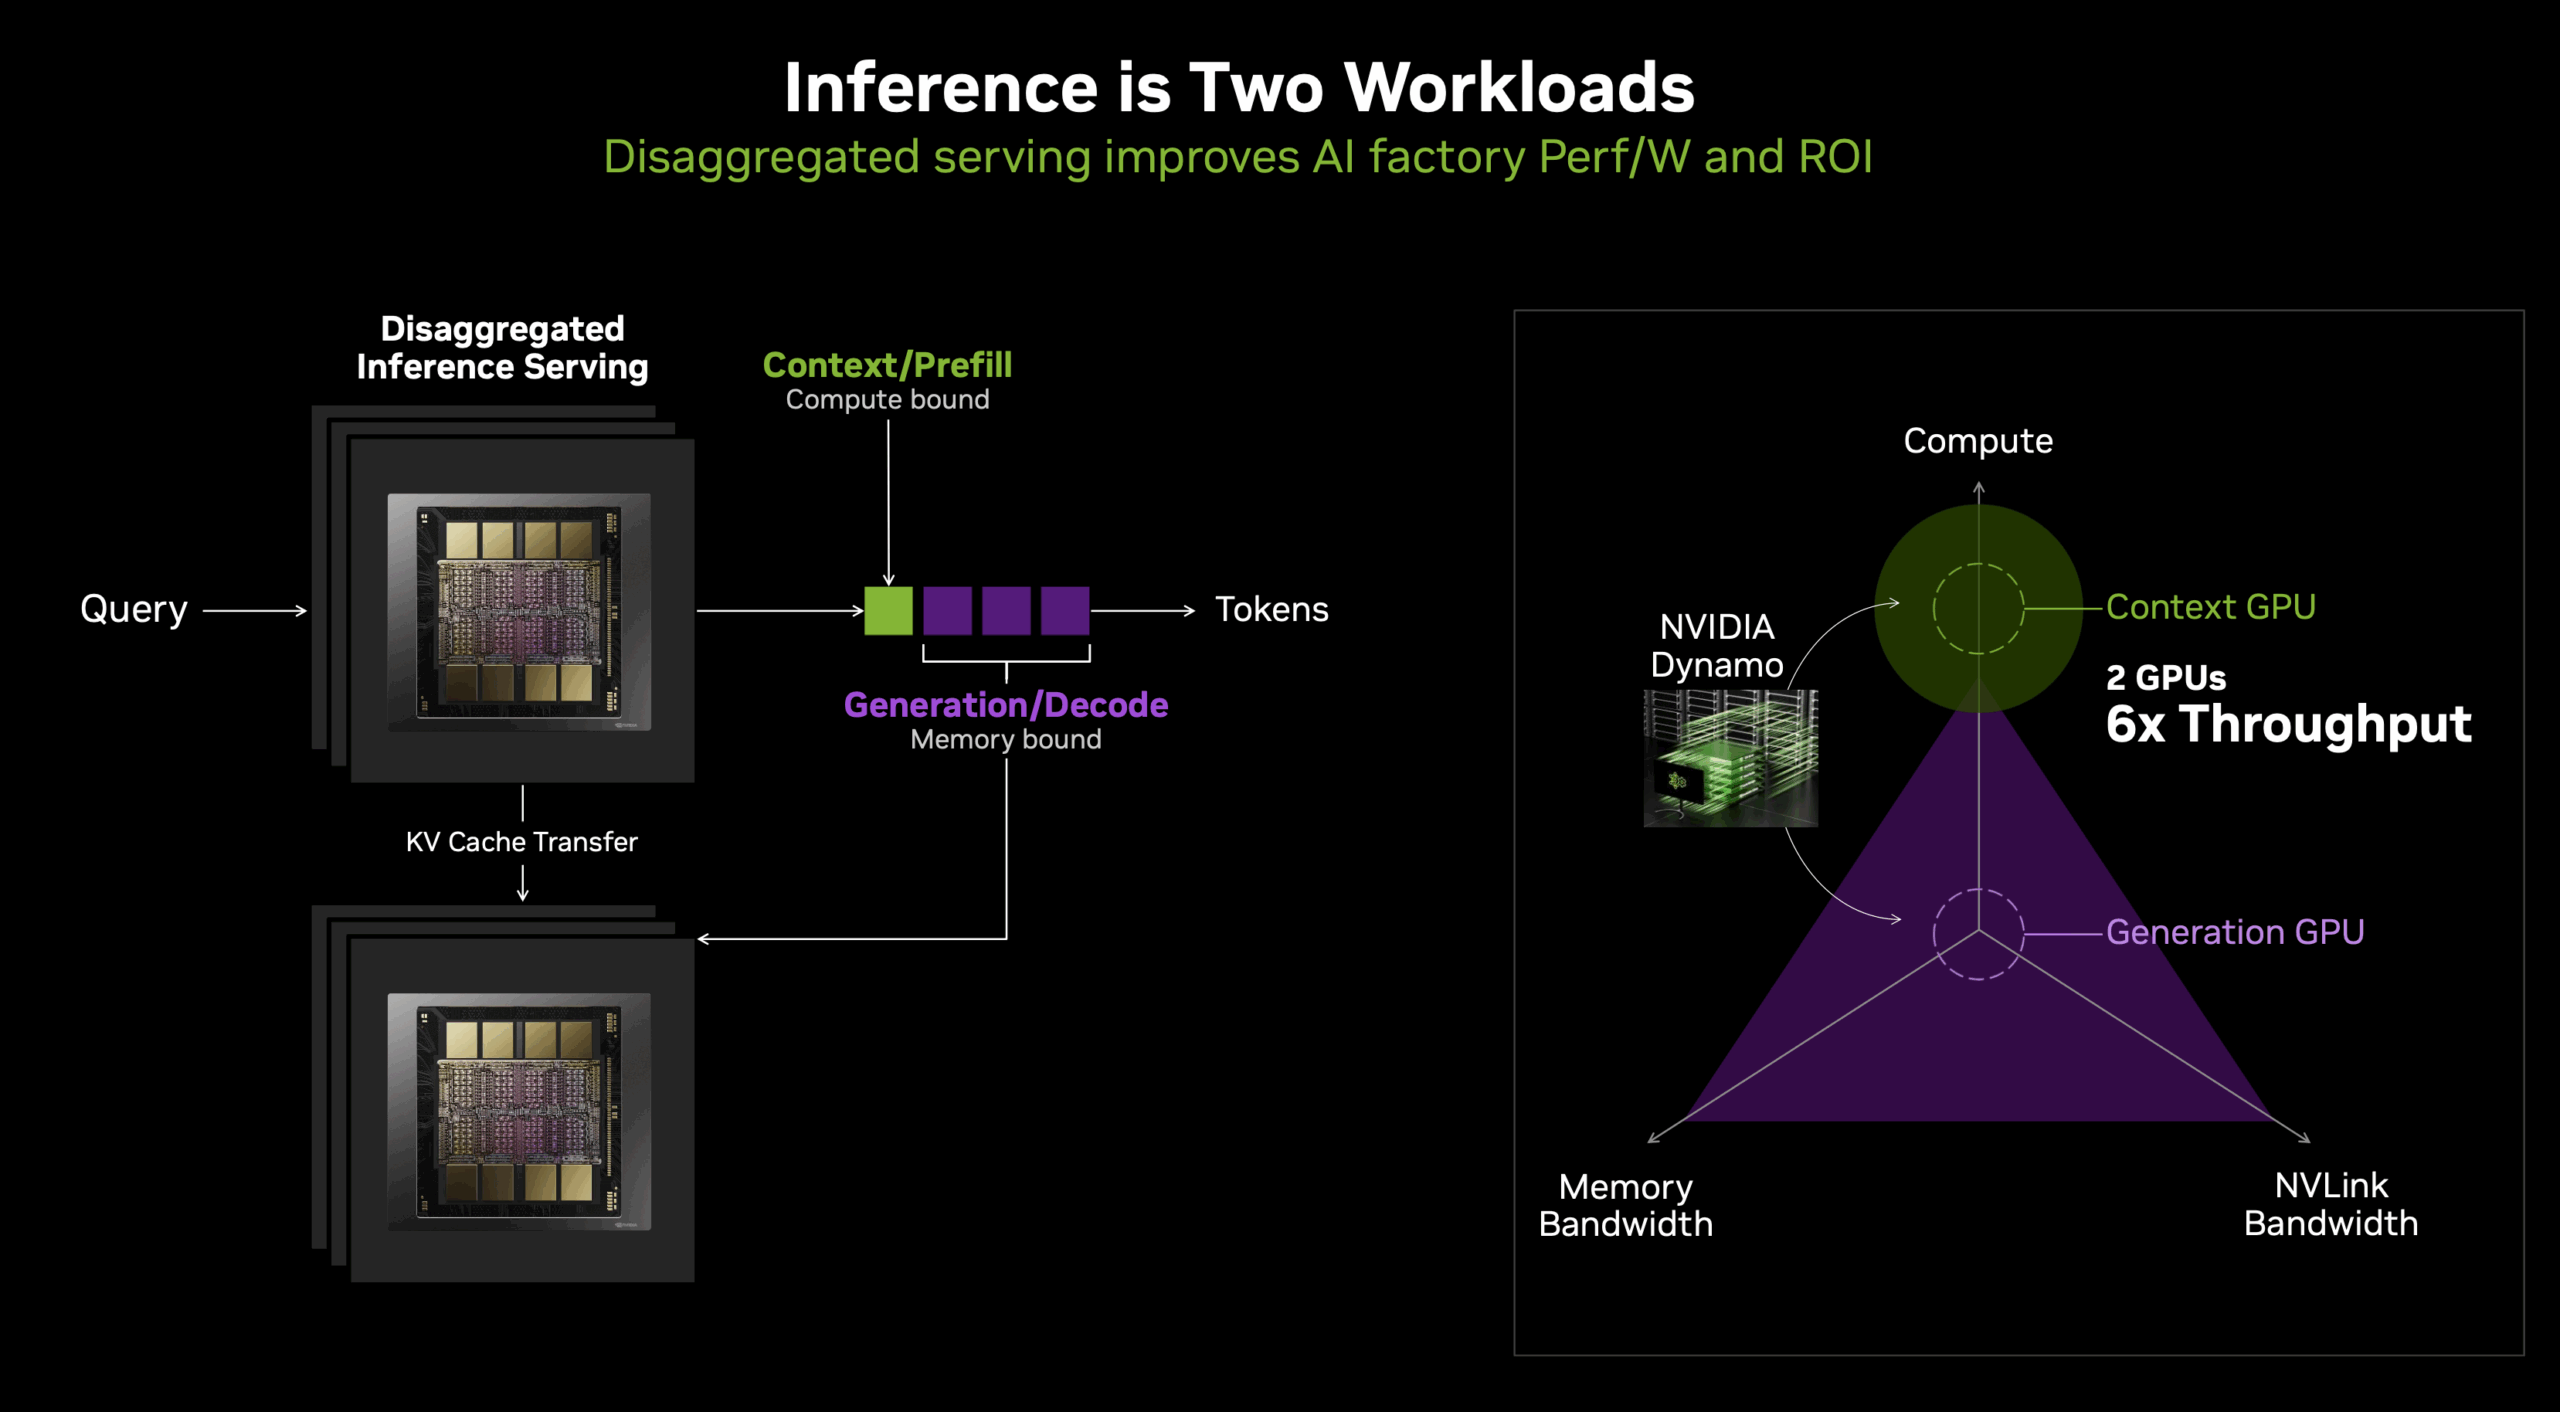
De schaalbaarheid van de KV-cache vormt een bijzondere uitdaging in productieomgevingen. Voor een model zoals Llama 3.1 405B dat uitgebreide contexten verwerkt, kan de KV-cache gemakkelijk tientallen gigabytes per sequentie verbruiken. In batch-inferentiescenario's, die essentieel zijn voor het bereiken van een hoge doorvoer in productie, overschrijdt de totale KV-cachegrootte vaak die van de modelgewichten zelf. Met de grote batchgroottes die mogelijk zijn in grootschalige NVL72-implementaties, kan de KV-cache meerdere terabytes groot worden. Hoewel deze gegevens met een redelijke latentie toegankelijk moeten blijven, vereisen niet alle KV-cachetoegangen de extreme bandbreedte van HBM-geheugen. Veel aandachtbewerkingen vertonen toegangspatronen die geschikt zijn voor hiërarchische geheugenarchitecturen.
Rubin CPX: Speciaal gebouwde architectuur voor contextverwerking
Rubin CPX pakt deze architectuurverschillen aan met een speciaal ontworpen ontwerp voor LLM-inferentie met lange context. De architectuur is gebaseerd op 128 GB GDDR7-geheugen, wat een grote en kosteneffectieve geheugenpool biedt voor KV-cachebewerkingen. De bandbreedte van GDDR7, hoewel lager dan die van HBM4, is voldoende voor de meeste aandachtsbewerkingen, vooral in combinatie met intelligente cachestrategieën.
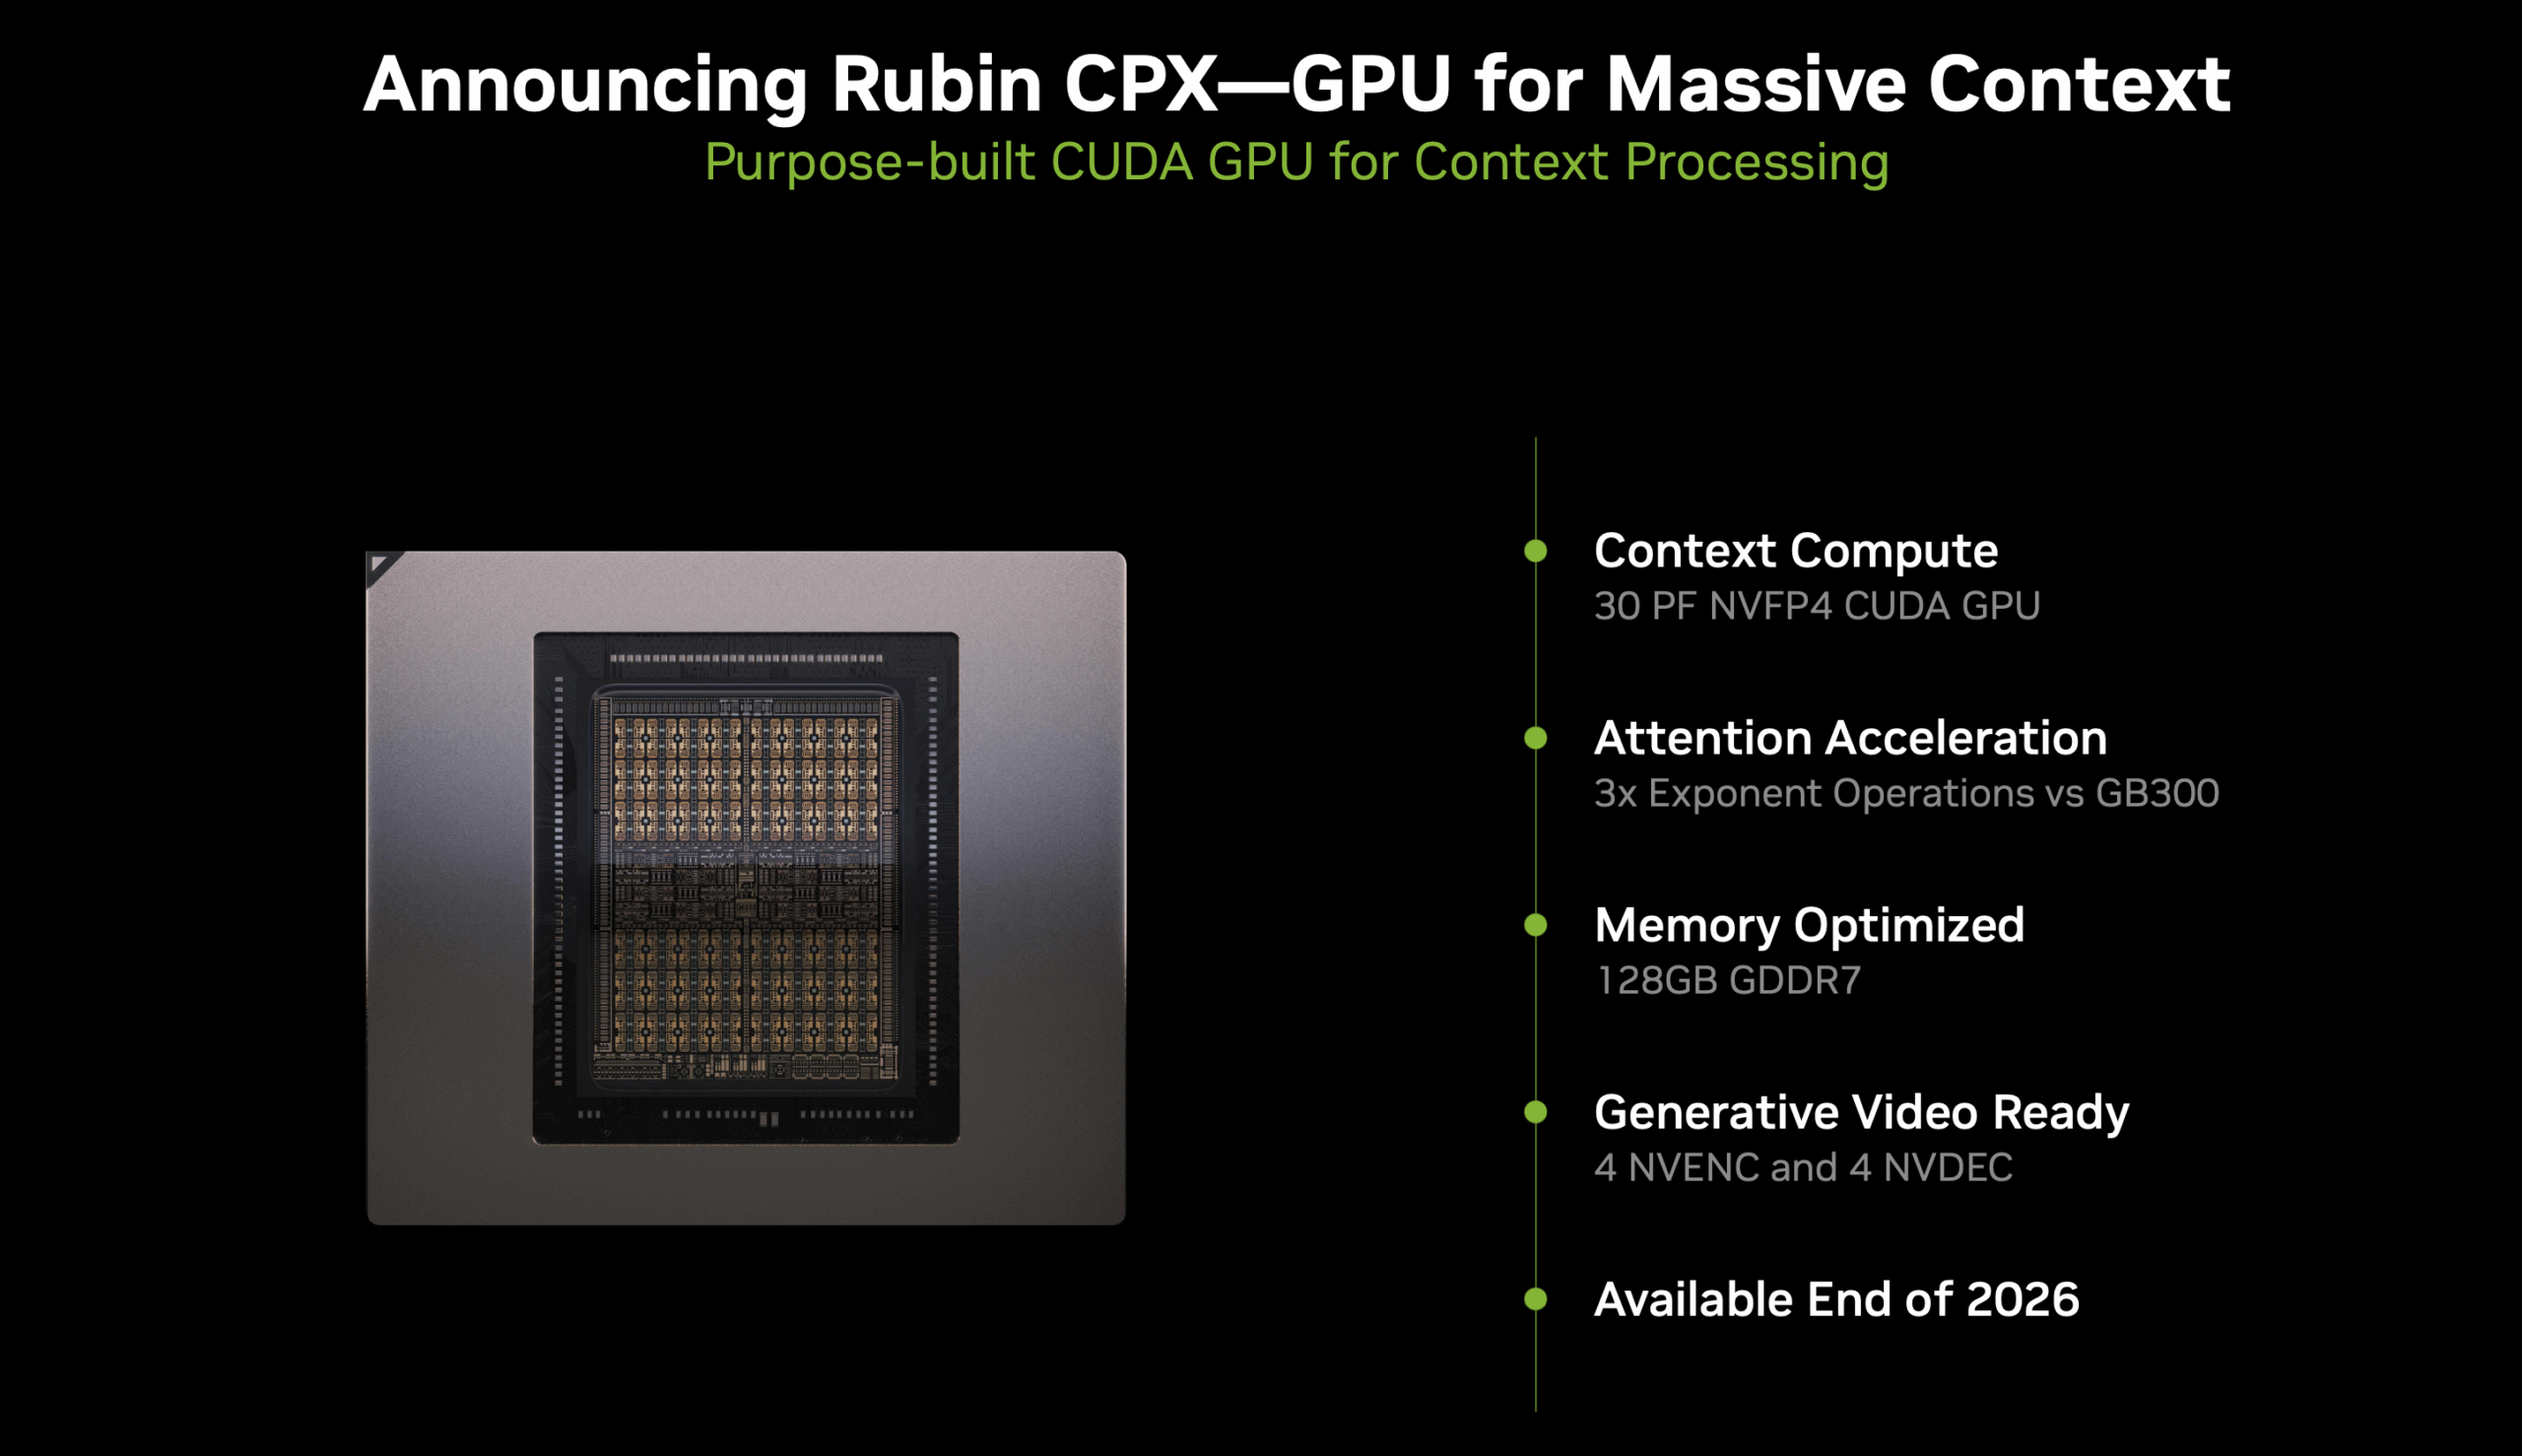
Integratie met het bredere Vera Rubin-platform in het VR NVL144 CPX-rack vindt plaats via PCIe-koppelingen via de ConnectX-9 NIC's en switchchips, waardoor hybride uitvoeringsmodellen mogelijk worden waarbij rekenintensieve bewerkingen plaatsvinden op traditionele GPU's. Geheugenintensief contextbeheer migreert naar CPX-processors.
Flexibele implementatiearchitecturen en configuratieopties
De modulaire architectuur van het Vera Rubin-platform biedt flexibiliteit in de implementatie, waardoor organisaties configuraties kunnen optimaliseren voor specifieke workloadkenmerken. De standaard VR NVL144-rackconfiguratie is voorzien van Vera Rubin GPU's met acht ConnectX-9 NIC's, wat een evenwichtige architectuur biedt die geschikt is voor diverse AI-workloads. Deze configuratie levert 3.6 ExaFLOPS NVFP4-rekenkracht, een verbetering van 3.3x ten opzichte van de huidige GB300 NVL72-systemen, naast 1.4 PB/s HBM4-bandbreedte (2.5x de huidige generatie) en 75 TB HBM4-geheugencapaciteit (2x de huidige generatie).
Voor organisaties die optimaliseren voor inferentie en long-context RL na training is de ultra-dichte VR NVL144 CPX compute tray beschikbaar. Elke tray bevat vier VR GPU-pakketten, elk met acht GPU-chips, waardoor de rekendichtheid van de standaardconfiguratie behouden blijft en tegelijkertijd acht Rubin CPX GPU's worden toegevoegd. De acht ConnectX-9 NIC/switch-chips zorgen voor de naadloze gegevensstroom die essentieel is voor gedistribueerde inferentie.
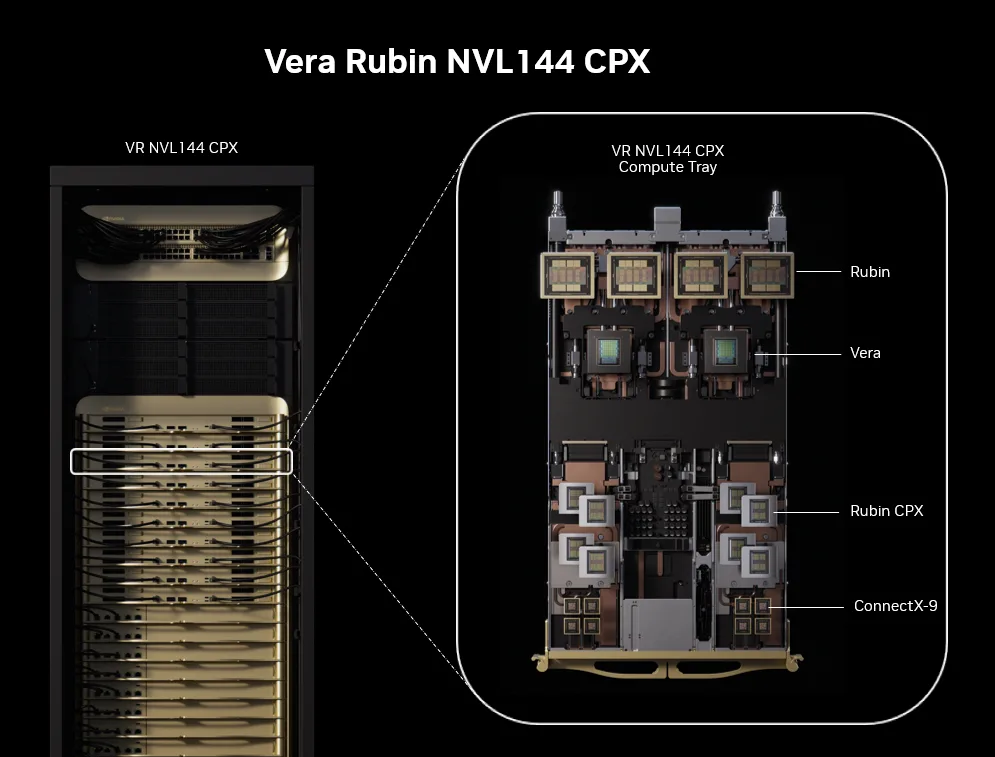
De modulaire aard van de architectuur maakt uitzonderlijk flexibele implementatiestrategieën mogelijk. Organisaties kunnen in eerste instantie standaard VR NVL144-racks implementeren en deze vervolgens uitbreiden met speciale Rubin CPX-racks naarmate hun vereisten voor contextverwerking toenemen. Deze aanpak zorgt ervoor dat de infrastructuur mee kan evolueren met de mogelijkheden van het model, waardoor overprovisioning wordt voorkomen.
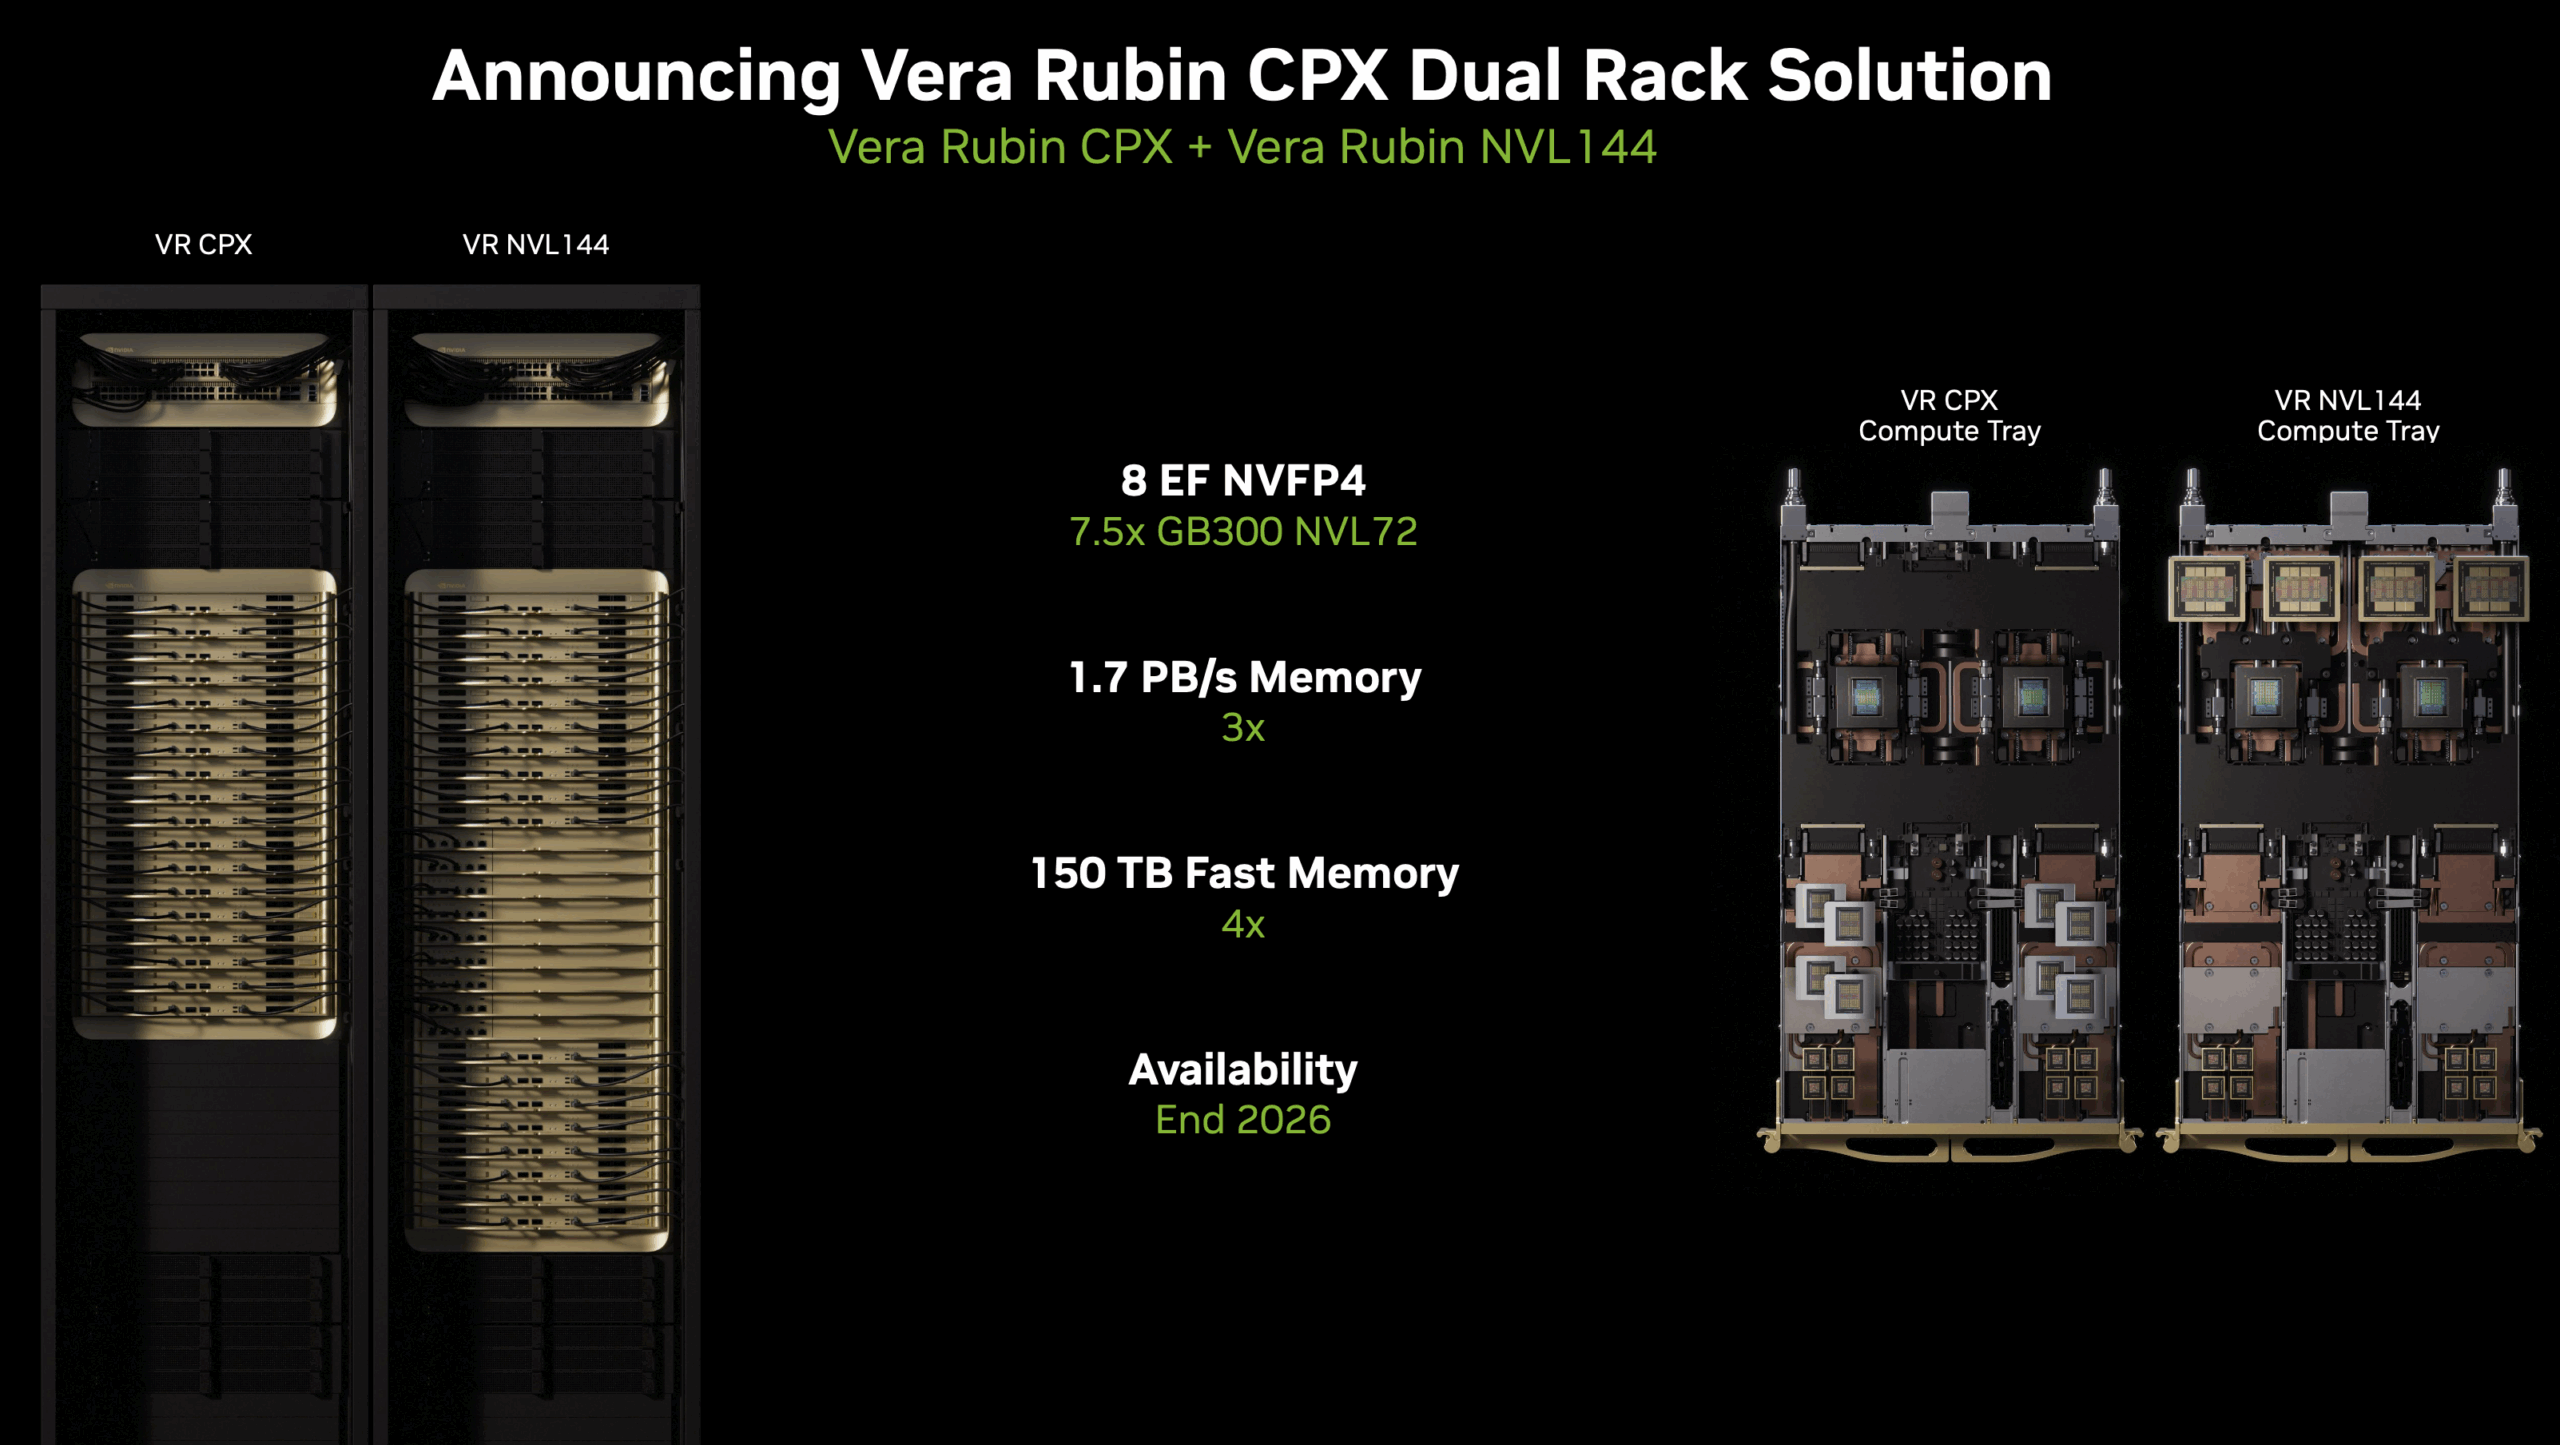
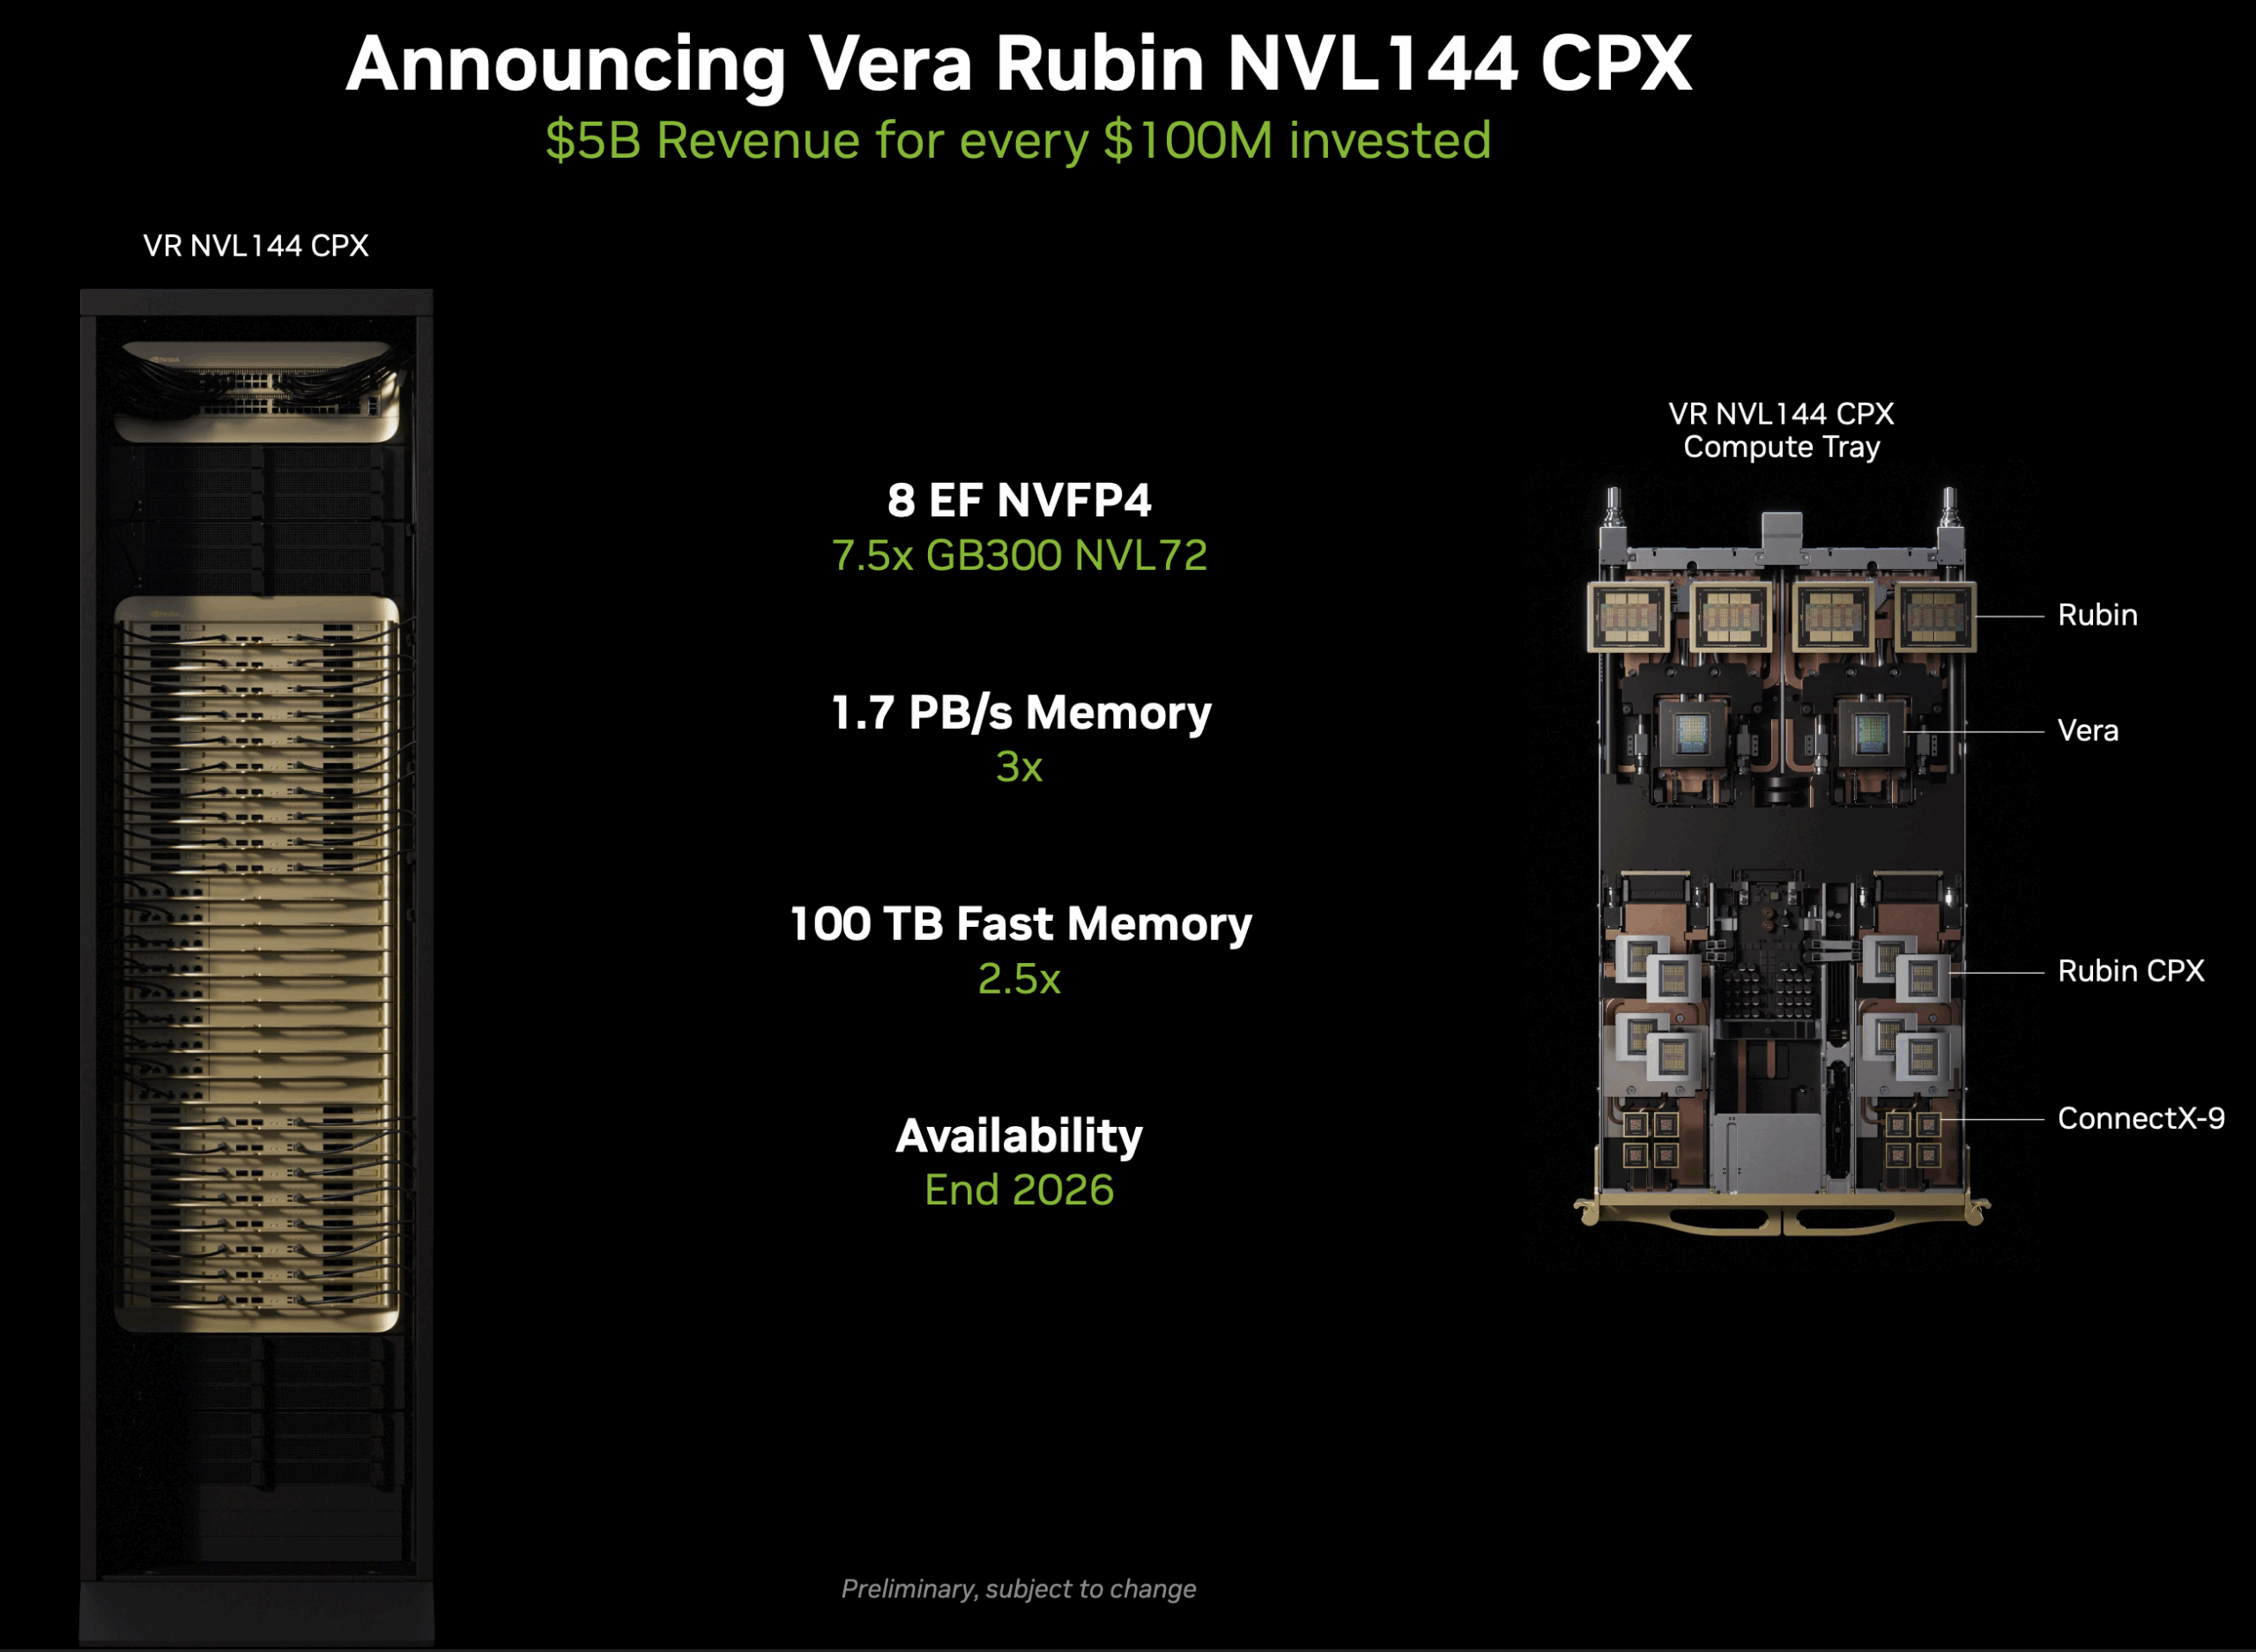
De complete VR NVL144 CPX-configuratie legt een nieuwe basis voor rekenkracht. Het systeem levert 8 ExaFLOPS NVFP4-rekenkracht, een verbetering van 7.5x ten opzichte van de huidige generatie GB300 NVL72-systemen. Deze enorme rekencapaciteit wordt gecombineerd met een totale geheugenbandbreedte van 1.7 PB/s, waarbij zowel HBM4 als GDDR7 worden gebruikt om een drie keer zo hoge geheugendoorvoer te bereiken als huidige systemen. De totale geheugencapaciteit bedraagt 100 TB, wat 2.5x meer geheugenbronnen biedt dan de huidige generatie platforms.
NVIDIA mikt op beschikbaarheid eind 2026. Dit maakt nieuwe categorieën AI-toepassingen mogelijk en maakt contextvensters van een miljoen tokens praktisch voor productie, waardoor AI-systemen hele codebases of lange documenten in één keer kunnen verwerken. Deze innovaties stellen organisaties ook in staat om grotere batchgroottes te ondersteunen, waardoor de inferentiekosten dalen en een gunstigere OPEX-berekening ontstaat.
Blauwdruk voor infrastructuur op gigawattschaal
Naast individuele systeeminnovaties onthulde NVIDIA ook referentiearchitecturen voor AI-fabrieken op gigawattschaal. Deze blauwdrukken, ontwikkeld in samenwerking met infrastructuurpartners zoals Jacobs, Schneider Electric, Siemens Energy en Vertiv, bestrijken de volledige infrastructuur, van energieopwekking tot rekenkracht. De referentieontwerpen erkennen dat AI-implementaties van de volgende generatie een holistische optimalisatie vereisen die veel verder gaat dan de rekencomponenten zelf.
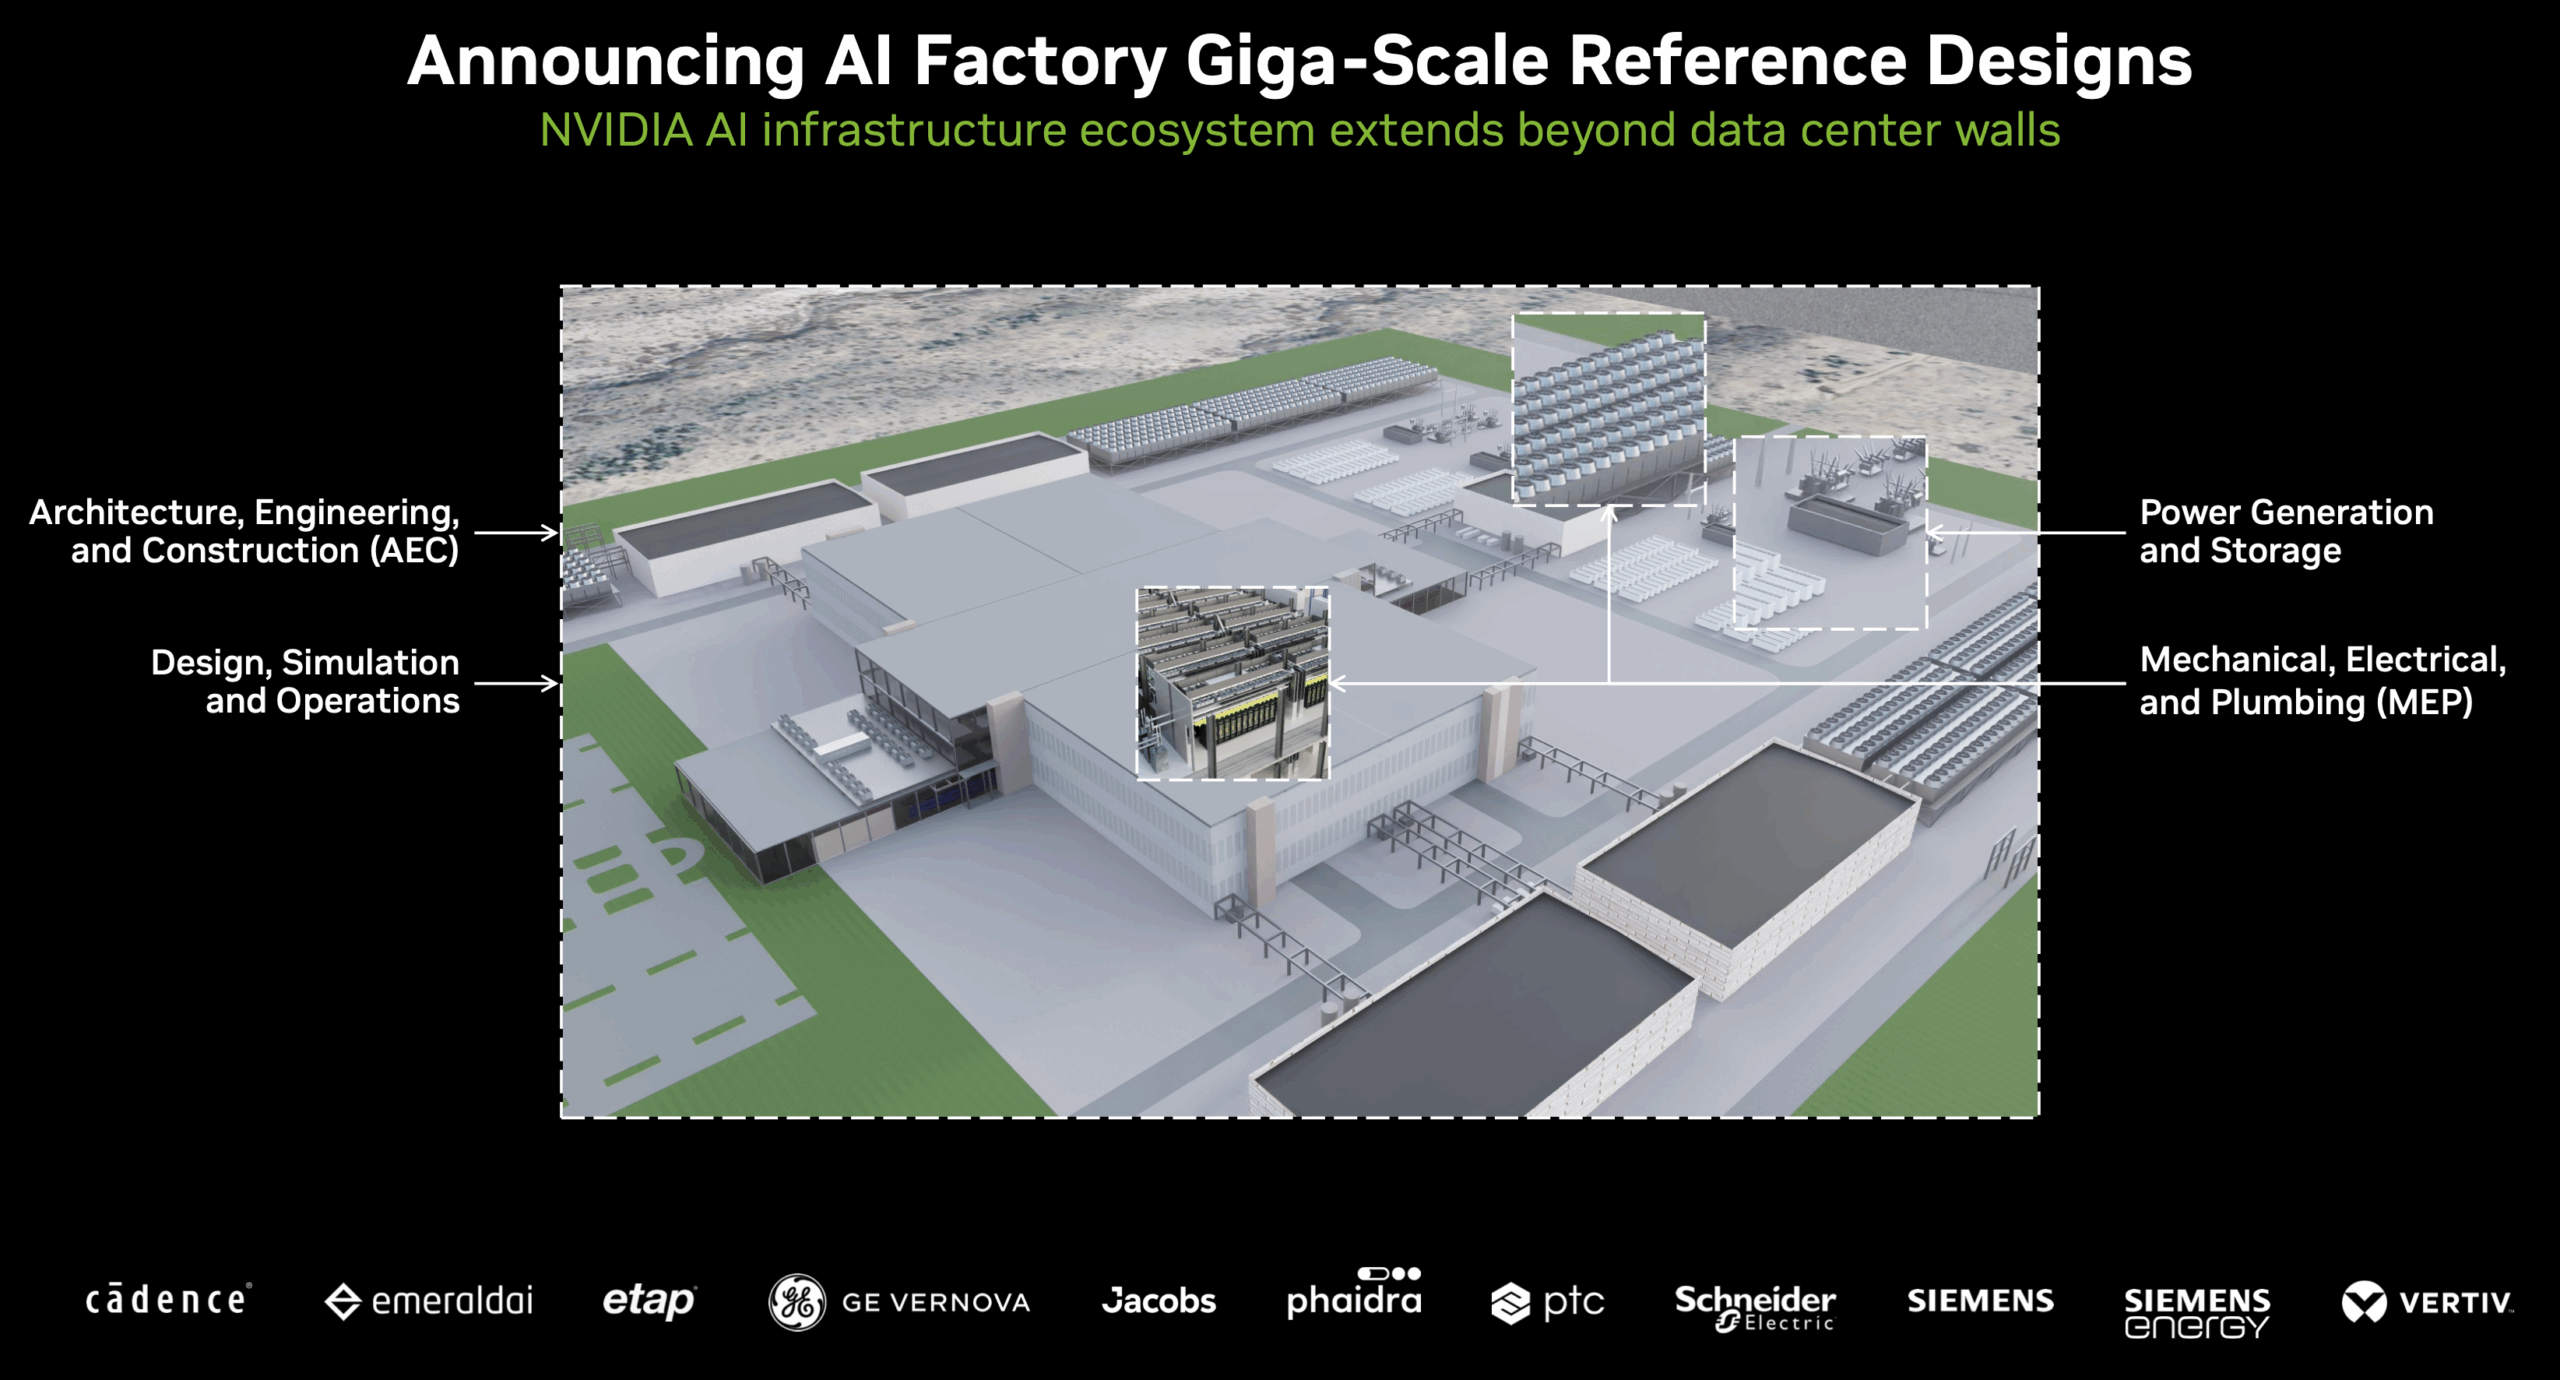
Deze architectuurblauwdrukken maken gebruik van digitale tweelingen van NVIDIA Omniverse om uitgebreide simulaties van faciliteiten mogelijk te maken vóór de fysieke implementatie. Organisaties kunnen stroomverdeling, koelsystemen en rekenkracht modelleren in uniforme simulaties, waardoor knelpunten worden geïdentificeerd en aangepakt voordat ze overgaan tot fysieke infrastructuur.
Conclusie
NVIDIA blijft toonaangevend in de AI-infrastructuursector met een vooruitstrevende, ontwikkelaarsgerichte aanpak die direct inspeelt op de knelpunten waarmee organisaties en AI-labs te maken hebben. De overgang van algemene acceleratie naar workloadspecifieke architecturen, geïllustreerd door Rubin CPX's gerichte aanpak van contextverwerking, geeft aan dat toekomstige AI-systemen in toenemende mate heterogene rekenkracht zullen bevatten die geoptimaliseerd is voor elke fase van AI-workflows. Deze architectuurevolutie vereist dat organisaties die meerjarige investeringen in AI-infrastructuur plannen, niet alleen rekening houden met de ruwe rekencapaciteit, maar ook met de afstemming tussen hardwarecapaciteit en evoluerende modelarchitecturen.
De versnelde innovatiecadans, van Blackwell Ultra via Vera Rubin naar Rubin CPX binnen een korte tijdlijn, is werkelijk indrukwekkend. Zo'n snel tempo vereist dat organisaties systemen ontwerpen die in staat zijn om nieuwe architectuurparadigma's te integreren zodra deze zich voordoen, en zo de lock-in te vermijden die kenmerkend was voor eerdere generaties datacenterinfrastructuur. Om deze uitdaging aan te gaan, bieden NVIDIA's AI Factory-referentieontwerpen en Omniverse digitale tweelingen de essentiële blauwdrukken en simulatietools om deze kritieke investeringen toekomstbestendig te maken. Terwijl AI-modellen hun traject naar schaalgroottes van biljoenen parameters en contexten van miljoenen tokens voortzetten, vormen de architectuurinnovaties die tijdens de AI Infrastructure Summit werden onthuld de essentiële basis voor deze toekomst van computing. Ze vormen de kaders en technologieën die de AI-mogelijkheden van bedrijven in het komende decennium zullen definiëren.
Geraadpleegde artikelen: Nvidia GTC25 Nieuws
Alle dia's en afbeeldingen zijn afkomstig van Nvidia


 Amazon