

NVIDIA heeft twee belangrijke stappen aangekondigd gericht op high-performance computing en AI: de overname van SchedMD, het bedrijf achter de Slurm workload manager, en de lancering van de Nemotron 3-familie van open modellen, data en tools voor multi-agent AI. Samen versterken deze inspanningen de positie van NVIDIA op het gebied van HPC, generatieve AI en AI-infrastructuur voor bedrijven, met behoud van een sterke focus op open, leveranciersneutrale software.
Slurm en SchedMD: het versterken van open, leveranciersneutrale HPC-planning
SchedMD is de belangrijkste ontwikkelaar van Slurm, een van de meest gebruikte open-source workloadmanagers voor HPC- en AI-clusters. Slurm wordt gebruikt om rekenresources in de wachtrij te plaatsen, in te plannen en toe te wijzen aan grootschalige clusters die nauw gekoppelde parallelle workloads uitvoeren. Naarmate de clustergrootte en de complexiteit van de modellen toenemen, wordt efficiënte planning cruciaal om de benutting en doorvoer te behouden.
Slurm heeft een aanzienlijke invloed op HPC. Het wordt gebruikt in meer dan de helft van de top 10 en top 100 systemen op de TOP500-lijst, dankzij de schaalbaarheid, hoge doorvoer en ondersteuning voor complex beleidsbeheer. Voor AI-workloads is Slurm een essentieel onderdeel geworden van de infrastructuur die door ontwikkelaars van basismodellen en AI-bouwers wordt gebruikt om grootschalige modeltraining en inferentie te orkestreren op GPU-versnelde systemen.
Na de overname is NVIDIA van plan Slurm verder te ontwikkelen en te distribueren als open-source, leveranciersneutrale software. Het bedrijf stelt dat Slurm toegankelijk zal blijven voor de bredere HPC- en AI-gemeenschap en heterogene omgevingen op een breed scala aan hardware- en softwareplatformen zal blijven ondersteunen. NVIDIA werkt al meer dan tien jaar samen met SchedMD en deze formele overname is bedoeld om die samenwerking te versnellen in plaats van een strategische koerswijziging te betekenen.
De leiding van SchedMD ziet de deal als een bevestiging van de centrale rol van Slurm in HPC en AI. Het bedrijf merkte op dat NVIDIA's expertise in versneld computergebruik Slurm zal helpen om te voldoen aan toekomstige eisen op het gebied van AI en supercomputing, met behoud van het open-source model en de betrokkenheid van de community.
Impact op de klant en platformondersteuning
Voor bestaande SchedMD-klanten is NVIDIA van plan de continuïteit van Slurm-ondersteuning, -training en -ontwikkeling te waarborgen. Slurm wordt momenteel ingezet bij cloudproviders, fabrikanten, AI-bedrijven en onderzoeksinstellingen in sectoren zoals autonoom rijden, gezondheidszorg en biowetenschappen, energie, financiële dienstverlening, overheid en algemene productie.
NVIDIA verwacht ook dat SchedMD sneller toegang krijgt tot nieuwe systemen en architecturen. Voor klanten die standaardiseren op NVIDIA's platform voor versnelde computing, zou dit moeten leiden tot snellere ondersteuning voor nieuwe GPU-generaties en systeemconfiguraties. Tegelijkertijd herhaalt NVIDIA dat Slurm een breed scala aan heterogene omgevingen zal blijven ondersteunen, waardoor clusters van verschillende leveranciers nieuwe Slurm-functionaliteiten kunnen gebruiken zonder gebonden te zijn aan één enkele hardwarestack.
De gezamenlijke inspanning van NVIDIA en SchedMD wordt gezien als onderdeel van een breder initiatief om het open-source software-ecosysteem in HPC en AI te versterken, waardoor innovatie in diverse sectoren en op verschillende schaalniveaus mogelijk wordt.
Nemotron 3: Open MoE-modellen voor multi-agent, agentische AI
Tegelijkertijd heeft NVIDIA de Nemotron 3-familie geïntroduceerd , een open ecosysteem van modellen, datasets en bibliotheken voor het bouwen van transparante en efficiënte AI-systemen met agenten. Naarmate organisaties overstappen van chatbots met één model naar complexere multi-agentarchitecturen, stuiten ze op uitdagingen zoals communicatieoverhead tussen agenten, contextverschuivingen bij lange workflows en stijgende inferentiekosten. Er is ook een groeiende vraag naar transparantie om inzicht en vertrouwen te creëren in AI-systemen die zijn ingebed in cruciale bedrijfsprocessen.
Nemotron 3 speelt in op deze eisen met een hybride architectuur gebaseerd op een latent mengsel van experts (MoE), ontworpen voor grootschalige multi-agent workloads. De modellen zijn bedoeld om samenwerkend agentgedrag, gespecialiseerde vaardigheden en efficiënte taakroutering te ondersteunen, terwijl tegelijkertijd voorspelbare prestatie- en kostenprofielen worden gewaarborgd.
Jensen Huang, oprichter en CEO van NVIDIA, benadrukte dat open innovatie essentieel is voor de vooruitgang van AI. Hij wees erop dat Nemotron geavanceerde AI omzet in een toegankelijk platform, waardoor de transparantie en efficiëntie worden verbeterd en de ontwikkeling van grootschalige agentsystemen wordt ondersteund.
Nationale en regionale AI-initiatieven in Europa, Zuid-Korea en andere regio's overwegen Nemotron al als basis voor open, lokaal beheerde AI-ontwikkeling. Pioniers, waaronder Accenture, Cadence, CrowdStrike, Cursor, Deloitte, Palantir, Perplexity en anderen, integreren Nemotron-modellen in workflows die zich uitstrekken over productie, cybersecurity, softwareontwikkeling, media en communicatie.
Modelreeks: Nano, Super en Ultra
Nemotron 3 bestaat uit drie hoofdlagen van het MoE-model, elk gericht op verschillende soorten workloads:
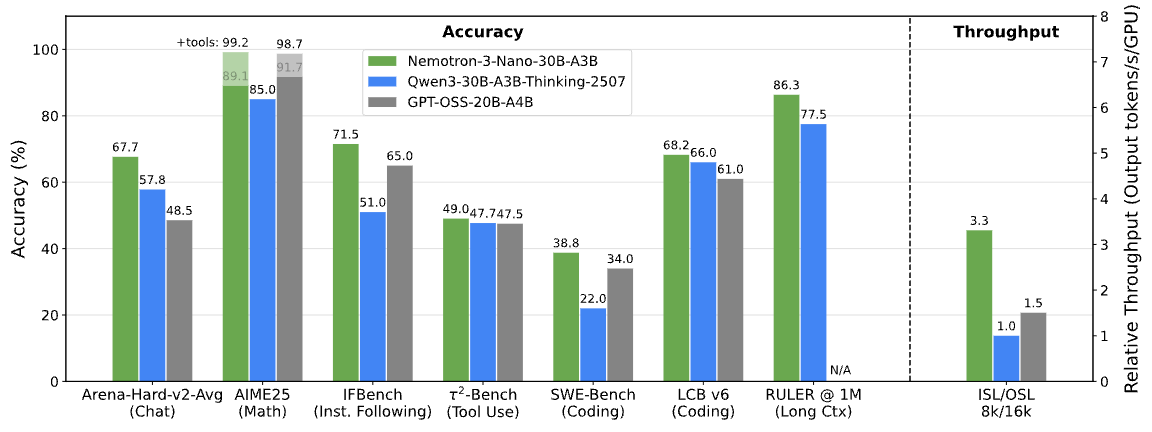
- Nano is een klein model met ongeveer 30 miljard parameters dat activeert tot wel 3 miljard parameters per token besteld, efficiënte inferentie. Het is geschikt voor taken like debuggen, samenvatting, AI pijpleidingenen informatieopvraging, waarbij lage latentie en kosten zijn van cruciaal belang. Haar Het hybride MoE-ontwerp levert tot 4x de tokendoorvoer van Nemotron 2 Nano en verlaagt de redeneerkosten met maximaal 60 procent, waardoor de totale inferentiekosten dalen.Met een contextvenster van 1 miljoen tokens, Nemotron 3 Nano onderhoudens meer staat overal lang workflows, het verbeteren van de nauwkeurigheid en het verbinden van contexten die verder weg liggen. Onafhankelijke benchmarks rangschikken het een van de meest open en efficiënte modellen in zijn soort klassemet top nauwkeurigheid onder turens.
- Super is een zeer nauwkeurig redeneermodel met ongeveer 100 miljard parameters en tot 10 miljard actieve parameters per token. Het is ontworpen voor multi-agent-toepassingen waarin veel agenten samenwerken om complexe doelen te bereiken onder lage latentie-eisen. Super is geschikt voor scenario's waarin de redeneerdiepte, het gebruik van tools en de coördinatie tussen agenten moeten schalen zonder de kosten van de grootste modellen.
- Ultra is het topmodel en functioneert als een grote redeneermachine met ongeveer 500 miljard parameters en tot 50 miljard actieve parameters per token. Het is bedoeld voor de meest veeleisende AI-workflows, waaronder diepgaand onderzoek, strategische planning en complexe beslissingsondersteunende systemen die hoogwaardige redenering over zeer lange contexten vereisen.
Nemotron 3 Super en Ultra worden getraind met behulp van NVIDIA's 4-bits NVFP4-formaat op de Blackwell-architectuur. Dit trainingsformaat vermindert het geheugenverbruik aanzienlijk en verbetert de trainingsdoorvoer, terwijl de nauwkeurigheid vergelijkbaar blijft met formaten met een hogere precisie. Voor bedrijven en serviceproviders kan dit het mogelijk maken om grotere modellen te trainen op bestaande infrastructuur of de benodigde hardware voor een bepaalde schaal te verminderen.
Met deze gelaagde modelfamilie kunnen ontwikkelaars de grootte en mogelijkheden van modellen afstemmen op specifieke workloads en kostendoelen, en schalen van tientallen naar honderden agents, terwijl tegelijkertijd snellere en nauwkeurigere langetermijnanalyses worden gewaarborgd bij complexe workflows met meerdere stappen.
Routing, tokeneconomie en hybride modelstrategieën
Naarmate multi-agentsystemen volwassener worden, kiezen veel organisaties voor hybride modelstrategieën. Eigen modellen van Frontier worden gebruikt voor de meest complexe redeneertaken, terwijl efficiënte, aanpasbare open modellen routinematige of domeinspecifieke taken afhandelen. Nemotron 3 is specifiek ontworpen voor dit soort routeringsgebaseerde architectuur.
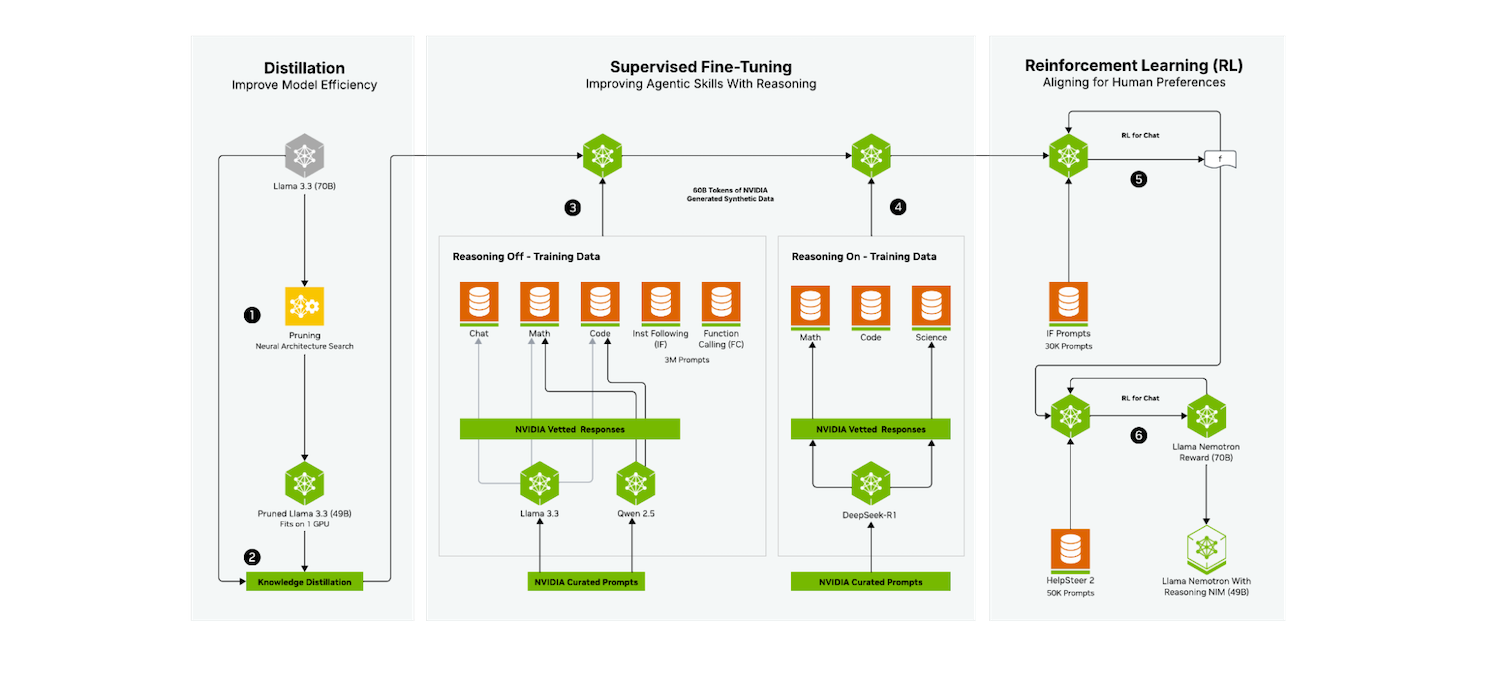
In een typische configuratie analyseert een agentrouter taken in realtime. Deze stuurt de taken door naar een verfijnd Nemotron-model, zoals Nemotron 3 Ultra, of naar een eigen model wanneer dat unieke waarde biedt. Deze aanpak helpt de tokeneconomie te optimaliseren door dure, geavanceerde capaciteit te reserveren voor de meest veeleisende gevallen en Nemotron in te zetten voor workloads met een hoge doorvoer en efficiëntie.
Partners die AI-assistenten en agentplatformen ontwikkelen, melden dat deze routeringsstrategie hen in staat stelt sneller te reageren en de kosten beter te beheersen, terwijl ze tegelijkertijd de flexibiliteit behouden om in de loop der tijd verschillende modelaanbieders en trainingsstrategieën te integreren.
Open data, bibliotheken en veiligheidstools
Naast de modellen zelf brengt NVIDIA een aanzienlijke hoeveelheid open bronnen uit ter ondersteuning van de ontwikkeling van aangepaste agents:
Trainings- en RL-datasets
NVIDIA stelt 3 biljoen tokens van Nemotron-datasets beschikbaar voor pre-, post- en reinforcement learning. Deze datasets bevatten een breed scala aan voorbeelden met betrekking tot redeneren, programmeren en workflows met meerdere stappen, die kunnen worden gebruikt om domeinspecifieke agents te trainen of te verfijnen. De Nemotron Agentic Safety Dataset biedt realistische telemetriegegevens die teams kunnen gebruiken om de veiligheid van complexe, autonome systemen te evalueren en te verbeteren.
NeMo Gym en NeMo RL
Om reinforcement learning en post-training te vereenvoudigen, heeft NVIDIA NeMo Gym en NeMo RL als open-sourcebibliotheken uitgebracht. Deze bieden trainingsomgevingen en post-trainingsbasis die zijn afgestemd op Nemotron-modellen, en die bovendien kunnen worden uitgebreid of aangepast voor andere architecturen. NeMo Evaluator is inbegrepen om de veiligheid en prestaties van modellen te beoordelen aan de hand van diverse benchmarks en gebruiksscenario's.
Al deze tools en datasets zijn beschikbaar op GitHub en Hugging Face, waardoor teams ze kunnen integreren in bestaande MLOps-pipelines en trainingsworkflows. Spelers in het ecosysteem zoals Prime Intellect en Unsloth integreren NeMo Gym-trainingsomgevingen al in hun platforms om reinforcement learning voor zakelijke gebruikers te vereenvoudigen.
Nemotron 3-modellen zijn ook compatibel met populaire inferentie- en implementatie-frameworks, waaronder LM Studio, llama.cpp, SGLang en vLLM, waardoor het eenvoudiger wordt om lokaal te experimenteren en te implementeren in verschillende omgevingen.
Beschikbaarheid
De Nemotron 3 Nano is vanaf vandaag verkrijgbaar via diverse distributiekanalen, zoals hieronder beschreven.
Modelhubs en inferentieproviders: Het Nemotron 3 Nano-model is beschikbaar op Hugging Face en via inferentieproviders zoals Baseten, DeepInfra, Fireworks, FriendliAI, OpenRouter en Together AI. Deze services bieden teams een snelle manier om het model te evalueren en te integreren in bestaande applicaties.
Enterprise-platformen: Nemotron-modellen worden geïntegreerd in AI- en dataplatformen voor bedrijven, waaronder Couchbase, DataRobot, H2O.ai, JFrog, Lambda en UiPath. Hierdoor kunnen klanten de door Nemotron aangedreven functionaliteiten rechtstreeks in hun data-, orchestratie- en automatiseringsstacks integreren.
Openbare cloud en NIM-microservices: Voor gebruikers van de openbare cloud zal Nemotron 3 Nano beschikbaar zijn op AWS via Amazon Bedrock voor serverloze inferentie, en zal ook beschikbaar zijn op Google Cloud, CoreWeave, Crusoe, Microsoft Foundry, Nebius, Nscale en Yotta.
Nemotron 3 Nano wordt ook aangeboden als een NVIDIA NIM-microservice voor veilige, schaalbare implementatie op door NVIDIA versnelde infrastructuur, waardoor bedrijven meer controle krijgen over privacy, datalocaliteit en prestaties.
De Nemotron 3 Super en Ultra zullen naar verwachting in de eerste helft van 2026 beschikbaar zijn, waardoor organisaties de tijd krijgen om te standaardiseren op de Nano-variant voor vroege agentische toepassingen en toekomstige migraties naar grotere modellen te plannen naarmate de behoeften toenemen.


 Amazon