

NVIDIA GTC 2023 begon met de introductie van nieuwe producten, partners, innovaties en software. Om u een idee te geven van de omvang van de aankondigingen, duurde de keynote 78 minuten. Er zijn vier nieuwe platforms aangekondigd, elk geoptimaliseerd voor een specifieke generatieve AI-inferentiewerklast en gespecialiseerde software.
De platforms combineren NVIDIA's volledige stapel inferentiesoftware met de nieuwste NVIDIA Ada-, Hopper- en Grace Hopper-processors. Twee nieuwe GPU's, de NVIDIA L4 Tensor Core GPU en H100 NVL GPU, zijn vandaag gelanceerd.
De NVIDIA L4 voor AI-video levert 120 keer betere AI-gestuurde videoprestaties dan CPU's, gecombineerd met een 99 procent lagere energie-efficiëntie. De L4 fungeert als een universele GPU voor vrijwel elke workload en biedt verbeterde mogelijkheden voor videodecodering en -transcodering, videostreaming, augmented reality, generatieve AI-video en meer.
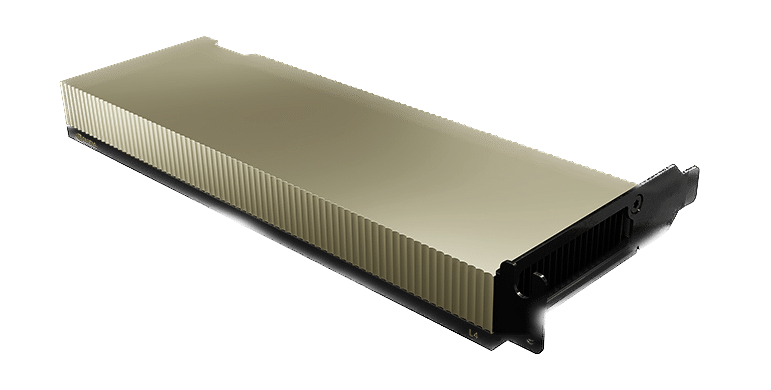
De NVIDIA Ada Lovelace L4 Tensor Core GPU levert universele acceleratie en energie-efficiëntie voor video, AI, gevirtualiseerde desktop- en grafische toepassingen in de onderneming, in de cloud en aan de edge. Met NVIDIA's AI-platform en full-stack
benadering, is L4 geoptimaliseerd voor inferentie op schaal voor een breed scala aan AI-toepassingen, waaronder aanbevelingen, op stem gebaseerde AI-avatarassistenten, generatieve AI, visueel zoeken en automatisering van contactcentra.
De L4 is de meest efficiënte NVIDIA-versneller voor algemeen gebruik, en servers die zijn uitgerust met L4 leveren tot 120x hogere AI-videoprestaties en 2.7x meer generatieve AI-prestaties ten opzichte van CPU-oplossingen, evenals meer dan 4x meer grafische prestaties dan de vorige GPU-generatie. NVIDIA L4 is een veelzijdige, energiezuinige single-slot, onopvallende vormfactor, waardoor het ideaal is voor grote implementaties en edge-locaties.
De NVIDIA L40 voor beeldgeneratie is geoptimaliseerd voor grafische toepassingen en AI-gestuurde 2D-, video- en 3D-beeldgeneratie. Het L40-platform vormt de motor van NVIDIA Omniverse, een platform voor het bouwen en beheren van metaverse-applicaties in datacenters. Het levert 7x hogere inferentieprestaties voor Stable Diffusion en 12x hogere Omniverse-prestaties ten opzichte van de vorige generatie.
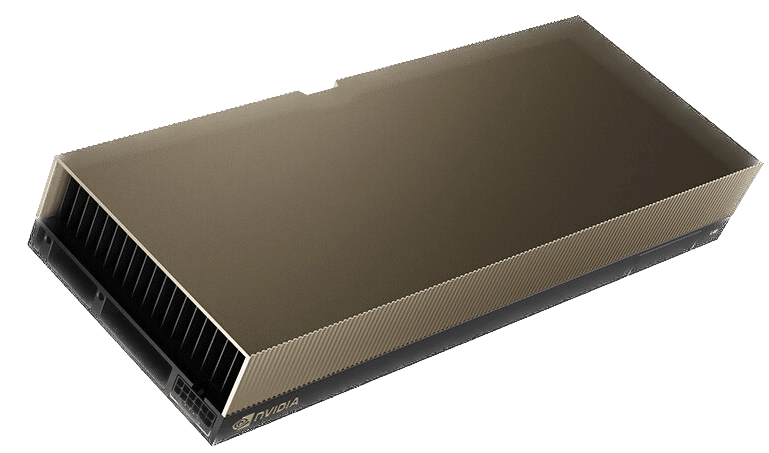
De NVIDIA L40 GPU levert high-performance visual computing voor het datacenter, met next-generation graphics, computing en AI-mogelijkheden. Gebouwd op de NVIDIA Ada Lovelace-architectuur, maakt de L40 gebruik van de kracht van de nieuwste generatie RT-, Tensor- en CUDA-kernen om visualisatie en computerprestaties te leveren voor veeleisende datacenterworkloads.
De L40 biedt verbeterde doorvoer en gelijktijdige ray-tracing- en shading-mogelijkheden die de ray-tracing-prestaties verbeteren en renders voor productontwerp en architectuur-, engineering- en constructieworkflows versnellen. De L40 GPU levert hardware-ondersteuning voor structurele schaarsheid en geoptimaliseerd TF32-formaat voor out-of-the-box prestatieverbeteringen voor snellere AI- en datawetenschapsmodeltraining. De versnelde AI-verbeterde grafische mogelijkheden, waaronder DLSS, leveren een opgeschaalde resolutie met betere prestaties in bepaalde toepassingen.
Het grote GPU-geheugen van de L40 pakt geheugenintensieve applicaties en workloads aan, zoals datawetenschap, simulatie, 3D-modellering en rendering met 48 GB ultrasnel GDDR6-geheugen. Geheugen wordt toegewezen aan meerdere gebruikers met vGPU-software om grote werklasten te verdelen over creatieve, datawetenschaps- en ontwerpteams.
De NVIDIA L24 is ontworpen voor 7×40 bedrijfsdatacenteroperaties met energiezuinige hardware en componenten en is geoptimaliseerd om op schaal te worden ingezet en maximale prestaties te leveren voor uiteenlopende datacenterworkloads. De L40 omvat veilig opstarten met de root of trust-technologie, die een extra beveiligingslaag biedt, en voldoet aan NEBS Level 3 om te voldoen aan datacenterstandaarden.
De NVIDIA H100 NVL voor de implementatie van grote taalmodellen is ideaal voor het grootschalig uitrollen van enorme taalmodellen zoals ChatGPT. De nieuwe H100 NVL beschikt over 94 GB geheugen met Transformer Engine-acceleratie en levert tot 12x snellere inferentieprestaties bij GPT-3 vergeleken met de vorige generatie A100 op datacenterschaal.
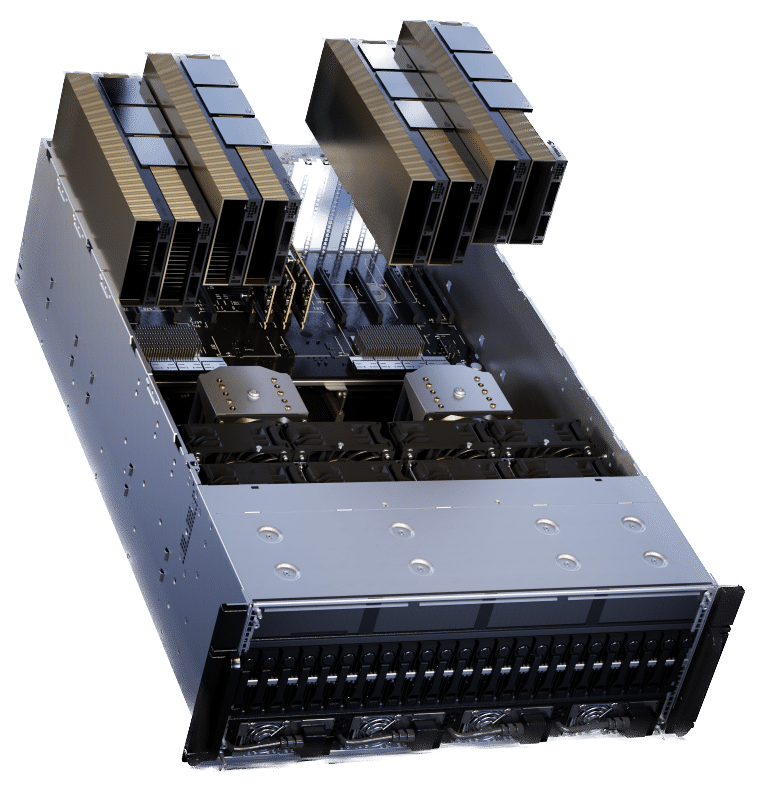
De op PCIe gebaseerde H100 NVL met NVLink-bridge maakt gebruik van Transformer Engine, NVLink en 188 GB HBM3-geheugen voor optimale prestaties en schaalbaarheid tussen datacenters. De H100 NVL ondersteunt grote taalmodellen tot 175 miljard parameters. Servers die zijn uitgerust met H100 NVL GPU's verhogen de prestaties van het GPT-175B-model tot 12x ten opzichte van NVIDIA DGX A100-systemen, terwijl de latentie laag blijft in datacenteromgevingen met beperkte stroomvoorziening.
NVIDIA Grace Hopper voor aanbevelingsmodellen is ideaal voor grafische aanbevelingsmodellen, vectordatabases en grafische neurale netwerken. Dankzij de NVLink-C2C-verbinding van 900 GB/s tussen CPU en GPU kan Grace Hopper 7 keer snellere gegevensoverdracht en query's leveren dan PCIe Gen 5.
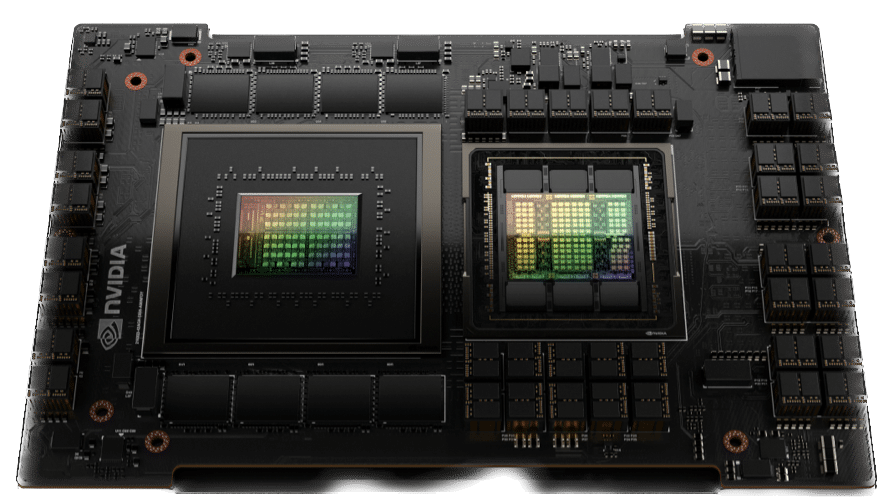
De NVIDIA Grace Hopper Superchip is een baanbrekende versnelde CPU die vanaf het begin is ontworpen voor gigantische AI- en high-performance computing (HPC)-toepassingen. De superchip zal tot 10x hogere prestaties leveren voor toepassingen met terabytes aan gegevens, waardoor wetenschappers en onderzoekers ongekende oplossingen kunnen vinden voor 's werelds meest complexe problemen.
De NVIDIA Grace Hopper Superchip combineert de Grace- en Hopper-architecturen met behulp van NVIDIA NVLink-C2C om een CPU+GPU coherent geheugenmodel te leveren voor versnelde AI- en HPC-toepassingen. Grace Hopper bevat een coherente interface van 900 gigabytes per seconde (GB/s), is 7x sneller dan PCIe Gen5 en levert 30x hogere totale systeemgeheugenbandbreedte voor GPU in vergelijking met NVIDIA DGX A100. Bovendien draait het alle NVIDIA-softwarestacks en -platforms, inclusief de NVIDIA HPC SDK, NVIDIA AI en NVIDIA Omniverse.
Moderne aanbevelingssysteemmodellen vereisen aanzienlijke hoeveelheden geheugen voor het opslaan van inbeddingstabellen. Inbeddingstabellen bevatten semantische representaties voor items en gebruikersfuncties, waardoor consumenten betere aanbevelingen kunnen doen.
Over het algemeen volgen deze inbeddingen een machtswetverdeling voor gebruiksfrequentie, aangezien sommige inbeddingsvectoren vaker worden gebruikt dan andere. NVIDIA Grace Hopper maakt aanbevelingssysteempijplijnen met hoge doorvoer mogelijk die
bewaar de meest gebruikte inbeddingsvectoren in het HBM3-geheugen en de resterende inbeddingsvectoren in het LPDDR5X-geheugen met hogere capaciteit. De NVLink C2C-interconnect biedt Hopper GPU's toegang met hoge bandbreedte tot hun lokale LPDDR5X-geheugen. Tegelijkertijd breidt het NVLink Switch-systeem dit uit om Hopper GPU's toegang met hoge bandbreedte te bieden tot al het LPDDR5X-geheugen van alle Grace Hopper Superchips in het NVLink-netwerk.


 Amazon