

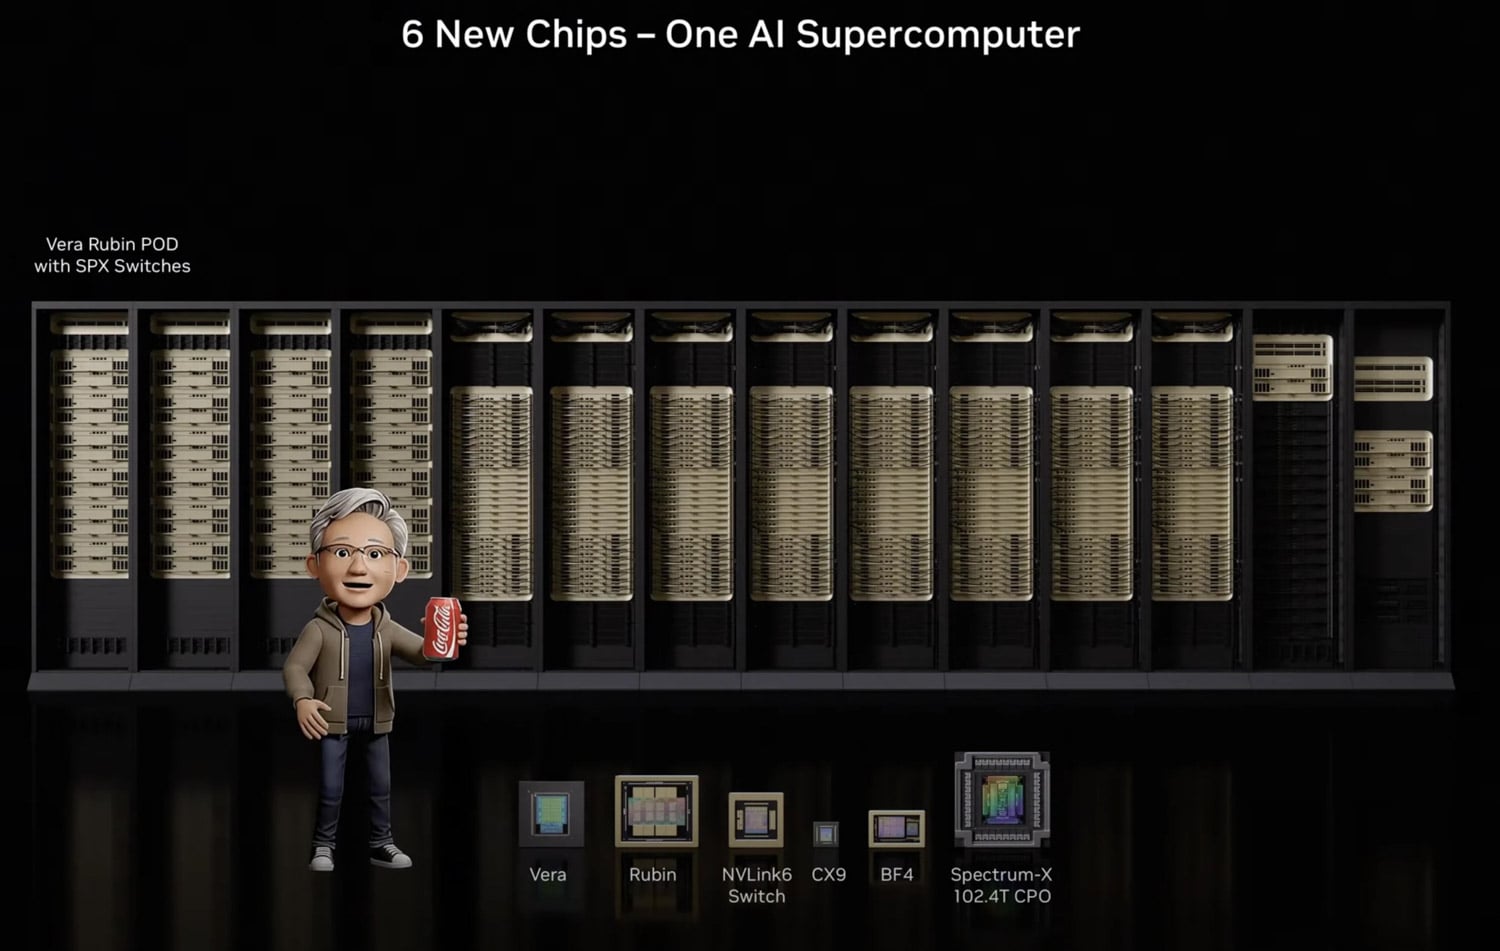
Op CES 2026 onthulde NVIDIA het Rubin-platform, gebaseerd op het Vera Rubin NVL72 rack-scale systeem. Dit is NVIDIA's derde generatie rack-scale architectuur, die zes gezamenlijk ontworpen chips combineert in één geïntegreerd systeem. Het platform zal in de tweede helft van 2026 beschikbaar zijn via partners. Alle zes chips zijn al terug van de productie en worden momenteel gevalideerd met behulp van echte workloads.
Vera Rubin NVL72: Zes chips, één geïntegreerd systeem
De Vera Rubin NVL72 maakt gebruik van wat NVIDIA "extreme co-design" noemt, waarbij zes afzonderlijke chips samen worden ontwikkeld om als één systeem te functioneren.
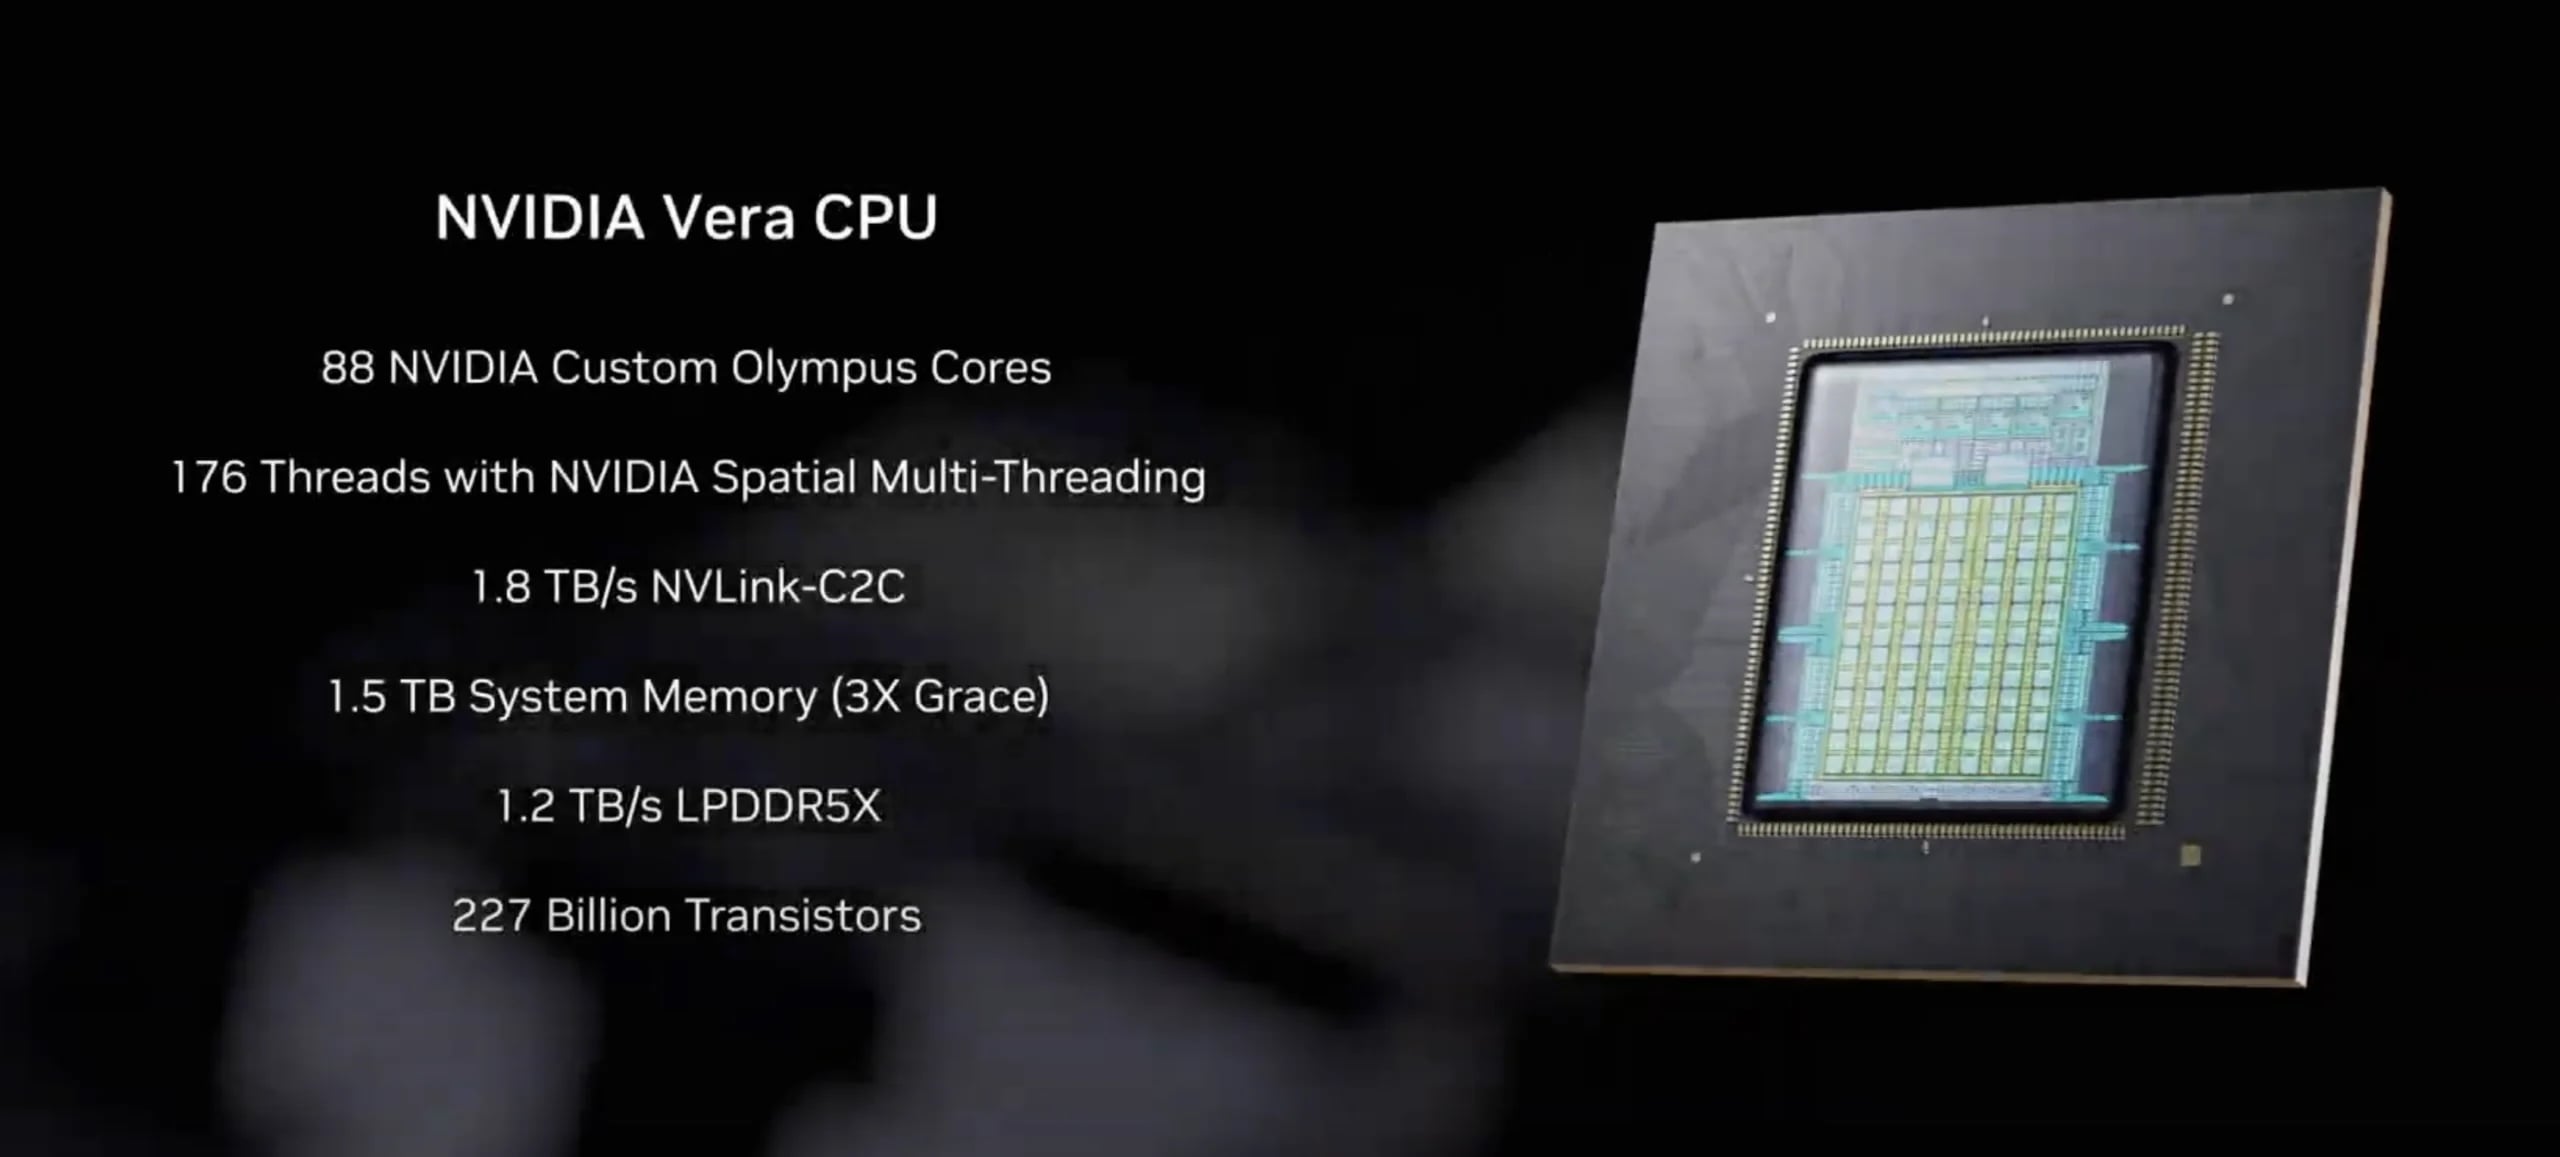
Vera CPU: ARM-silicium ontworpen voor AI-fabrieken
De eerste chip die werd getoond was de NVIDIA Vera CPU, waarmee NVIDIA zijn investeringen in op maat gemaakte ARM-chips voor AI-toepassingen voortzet. De Vera is gebouwd op 88 op maat gemaakte Olympus ARM-cores met volledige Armv9.2-compatibiliteit en is specifiek ontworpen voor de dataverwerking en agentverwerkingseisen van moderne AI-omgevingen. Hij beschikt over NVLink-C2C-connectiviteit, die een bandbreedte van 1.8 TB/s levert aan Rubin GPU's, waarmee de C2C-bandbreedte ten opzichte van eerdere generaties wordt verdubbeld en die zeven keer sneller is dan PCIe Gen 6. De Vera CPU verdubbelt de prestaties van dataverwerking, compressie en codecompilatie in vergelijking met de vorige generatie Grace CPU.
Generatievergelijking: Blackwell Ultra versus Vera Rubin NVL72
| Specificaties | GB300 NVL72 (Blackwell Ultra) | VR NVL72 (Vera Rubin) |
|---|---|---|
| GPU-aantal | 72 Blackwell Ultra GPU's | 72 Rubin GPU's |
| CPU-telling | 36 Grace CPU's | 36 Vera CPU's |
| CPU-cores | 72 ARM-cores per CPU | 88 Olympus ARM-cores per CPU |
| FP4-inferentieprestaties | 1.44 ExaFLOPS | 3.6 ExaFLOPS |
| NVFP4 per GPU (inferentie) | 20 PFLOPS | 50 PFLOPS |
| NVFP4 per GPU (Training) | 10 PFLOPS | 35 PFLOPS |
| GPU-geheugentype | HBM3e | HBM4 |
| GPU-geheugenbandbreedte | ~8 TB/s | ~22 TB/s |
| NVLink-generatie | NVLink 5 | NVLink 6 |
| NVLink-bandbreedte (per GPU) | 1.8 TB / s | 3.6 TB / s |
| NVLink-bandbreedte op rackschaal | 130 TB / s | 260 TB / s |
| Scale-Out NIC | ConnectX-8 (800 Gb/s) | ConnectX-9 (1.6 TB/s) |
| CPU-GPU-interconnect | NVLink-C2C (900 GB/s) | NVLink-C2C (1.8 TB/s) |
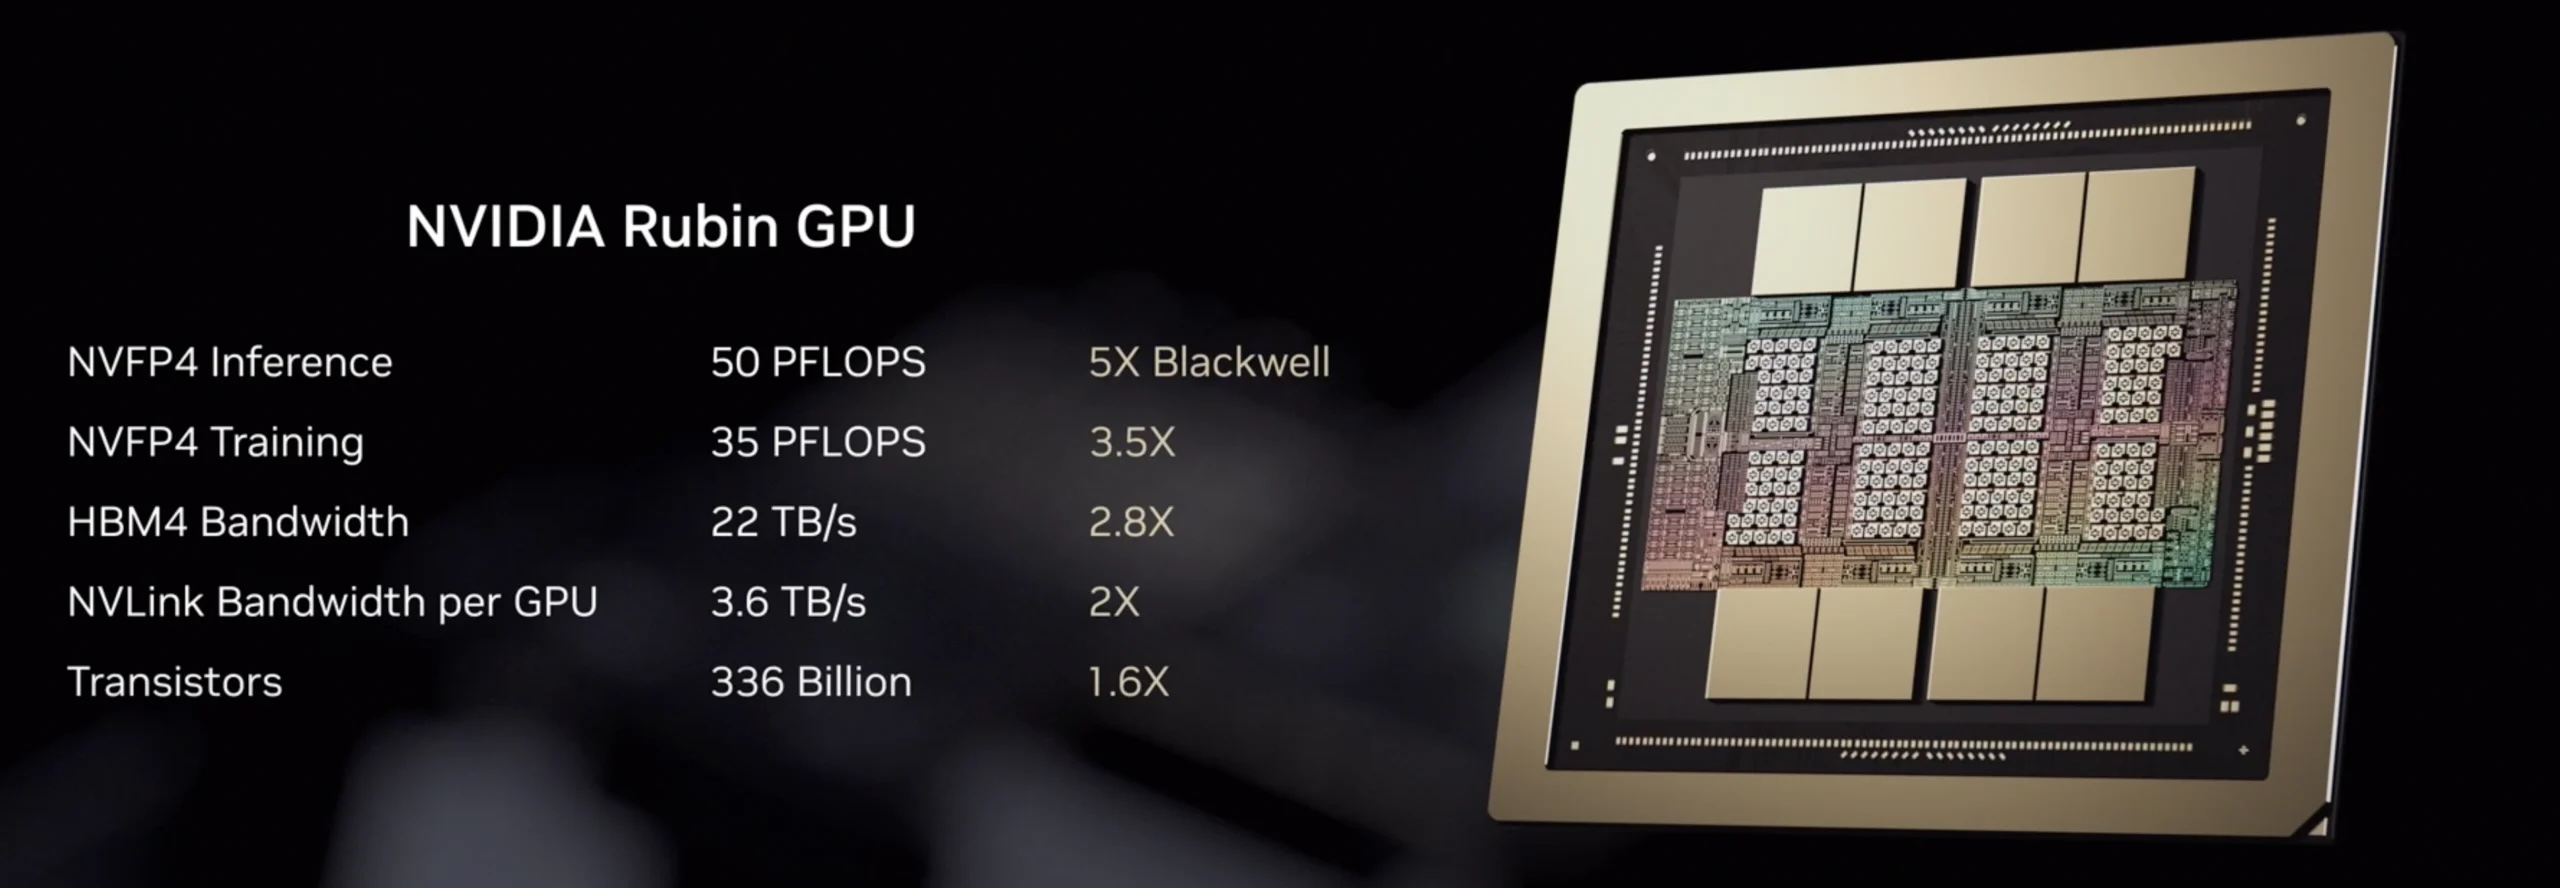
Rubin GPU: Transformer Engines, NVFP4 en HBM4
Vervolgens was het de beurt aan de ster van de show: de NVIDIA Rubin GPU, die is voorzien van een derde generatie Transformer Engine met hardwareversnelde adaptieve compressie. Deze past de precisie dynamisch aan over de verschillende transformerlagen, waardoor een hogere doorvoer wordt bereikt waar de precisie kan worden verlaagd, terwijl de nauwkeurigheid behouden blijft waar dat nodig is. Deze NVFP4-implementatie levert 50 petaflops aan rekenkracht voor inferentie (5x Blackwell) en 35 petaflops voor training (3.5x Blackwell). De Rubin GPU is de eerste die HBM4-geheugen integreert met een bandbreedte tot 22 TB/s, een aanzienlijke sprong voorwaarts die de beperking van de geheugenbandbreedte aanpakt waarmee grote MoE-modellen te maken hebben.
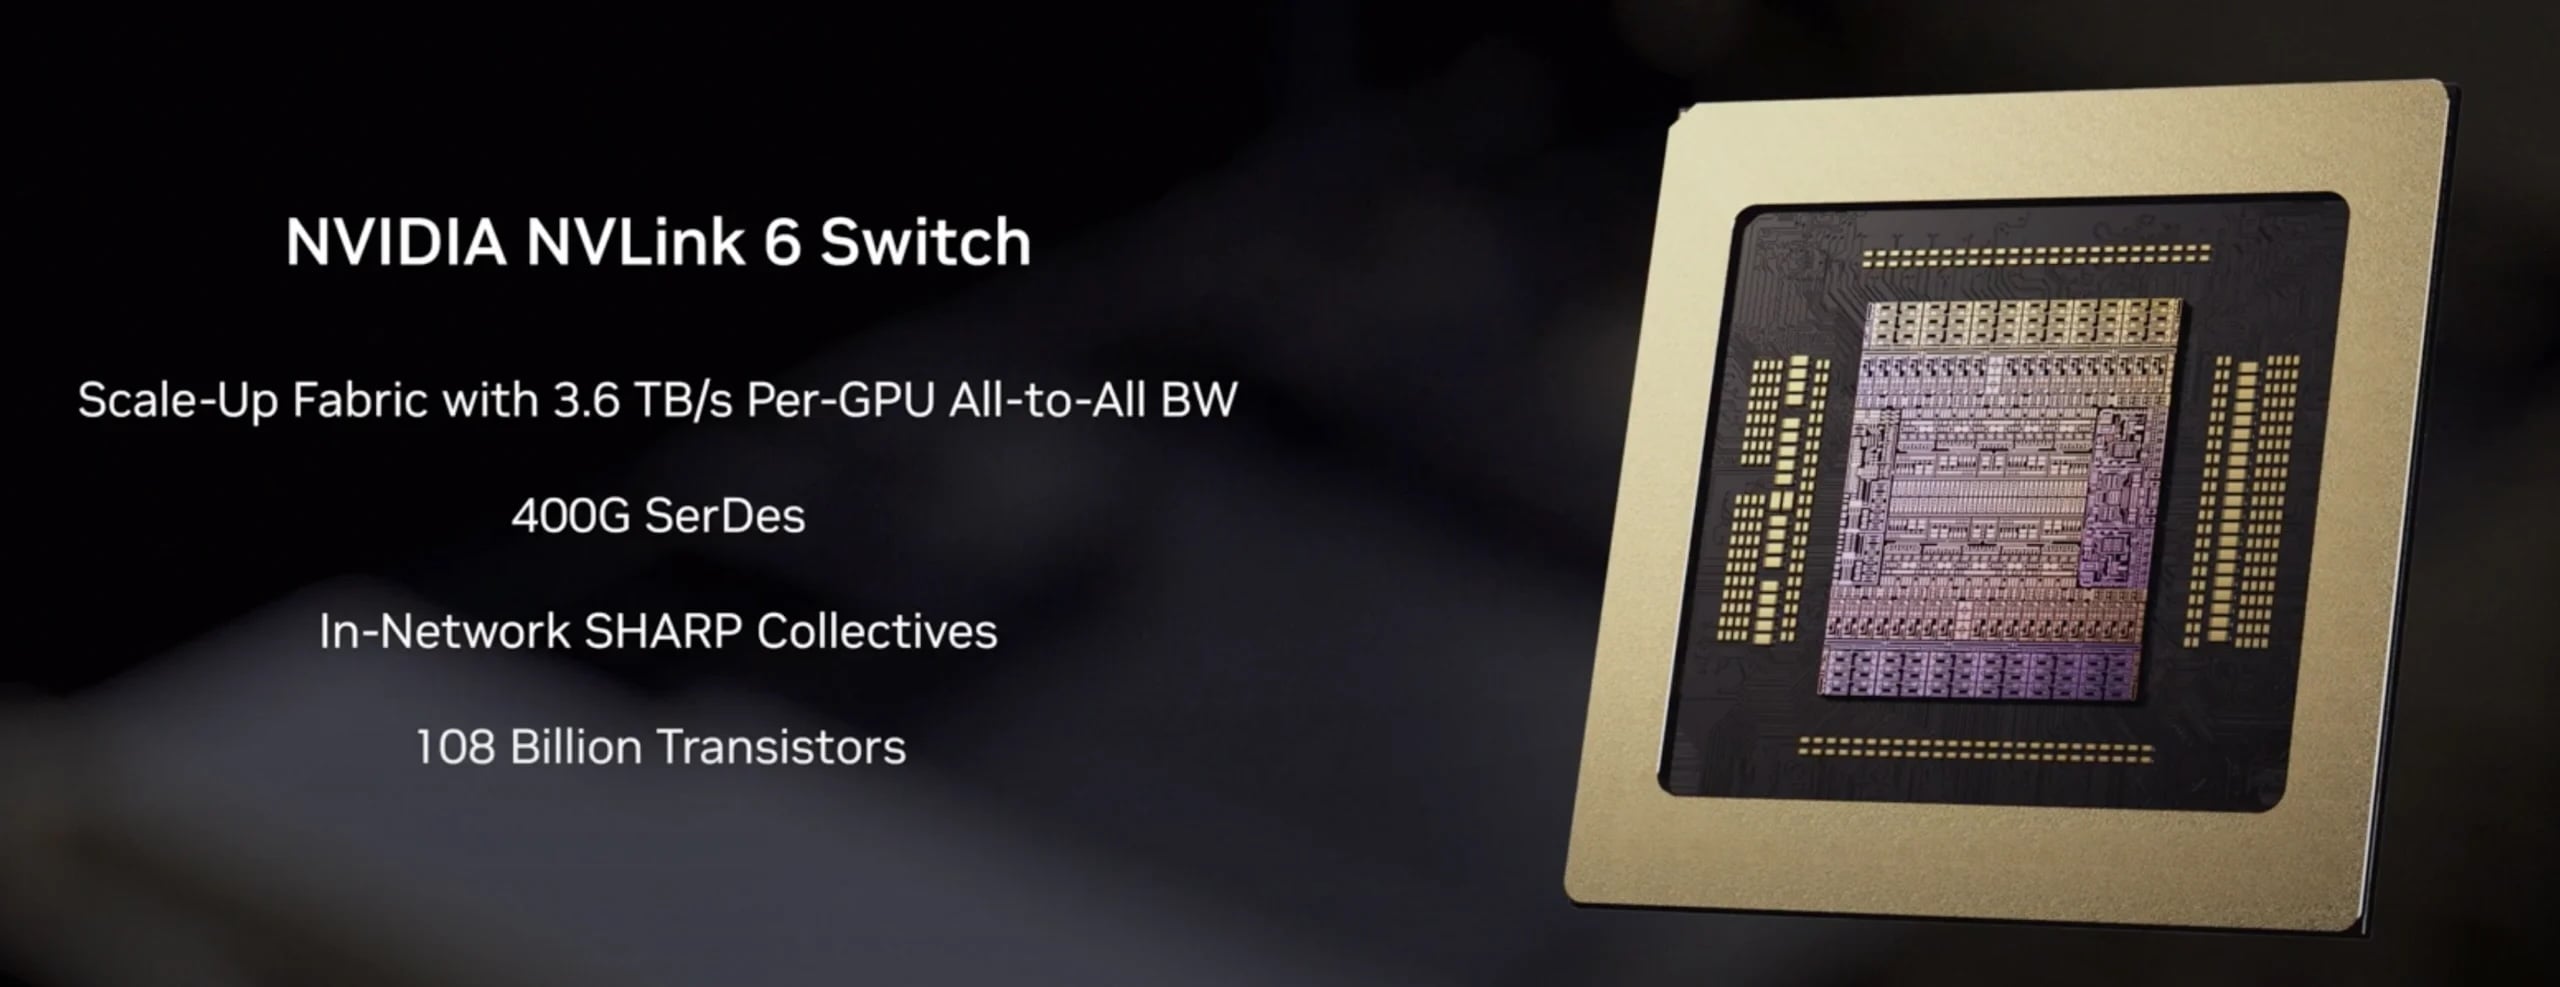
NVLink 6: Rack-schaalbare alles-naar-alle-communicatie
De NVIDIA NVLink 6 Switch verdubbelt de bandbreedte per GPU tot 3.6 TB/s, en het volledige rack biedt 260 TB/s aan schaalbare netwerkcapaciteit – meer dan twee keer de totale bandbreedte van het wereldwijde internet. Deze schaalbare infrastructuur maakt het mogelijk dat elke GPU gelijktijdig met elke andere GPU communiceert (een vereiste voor parallelle verwerking door experts binnen het MoE-systeem), waarbij alle experts resultaten moeten delen binnen het cluster. De ingebouwde rekenkracht binnen het netwerk versnelt collectieve bewerkingen en vermindert congestie, waardoor taken die anders GPU-cycli zouden verbruiken, worden uitbesteed.
ConnectX-9 SuperNIC: een nieuwe definitie van schaalbare netwerken
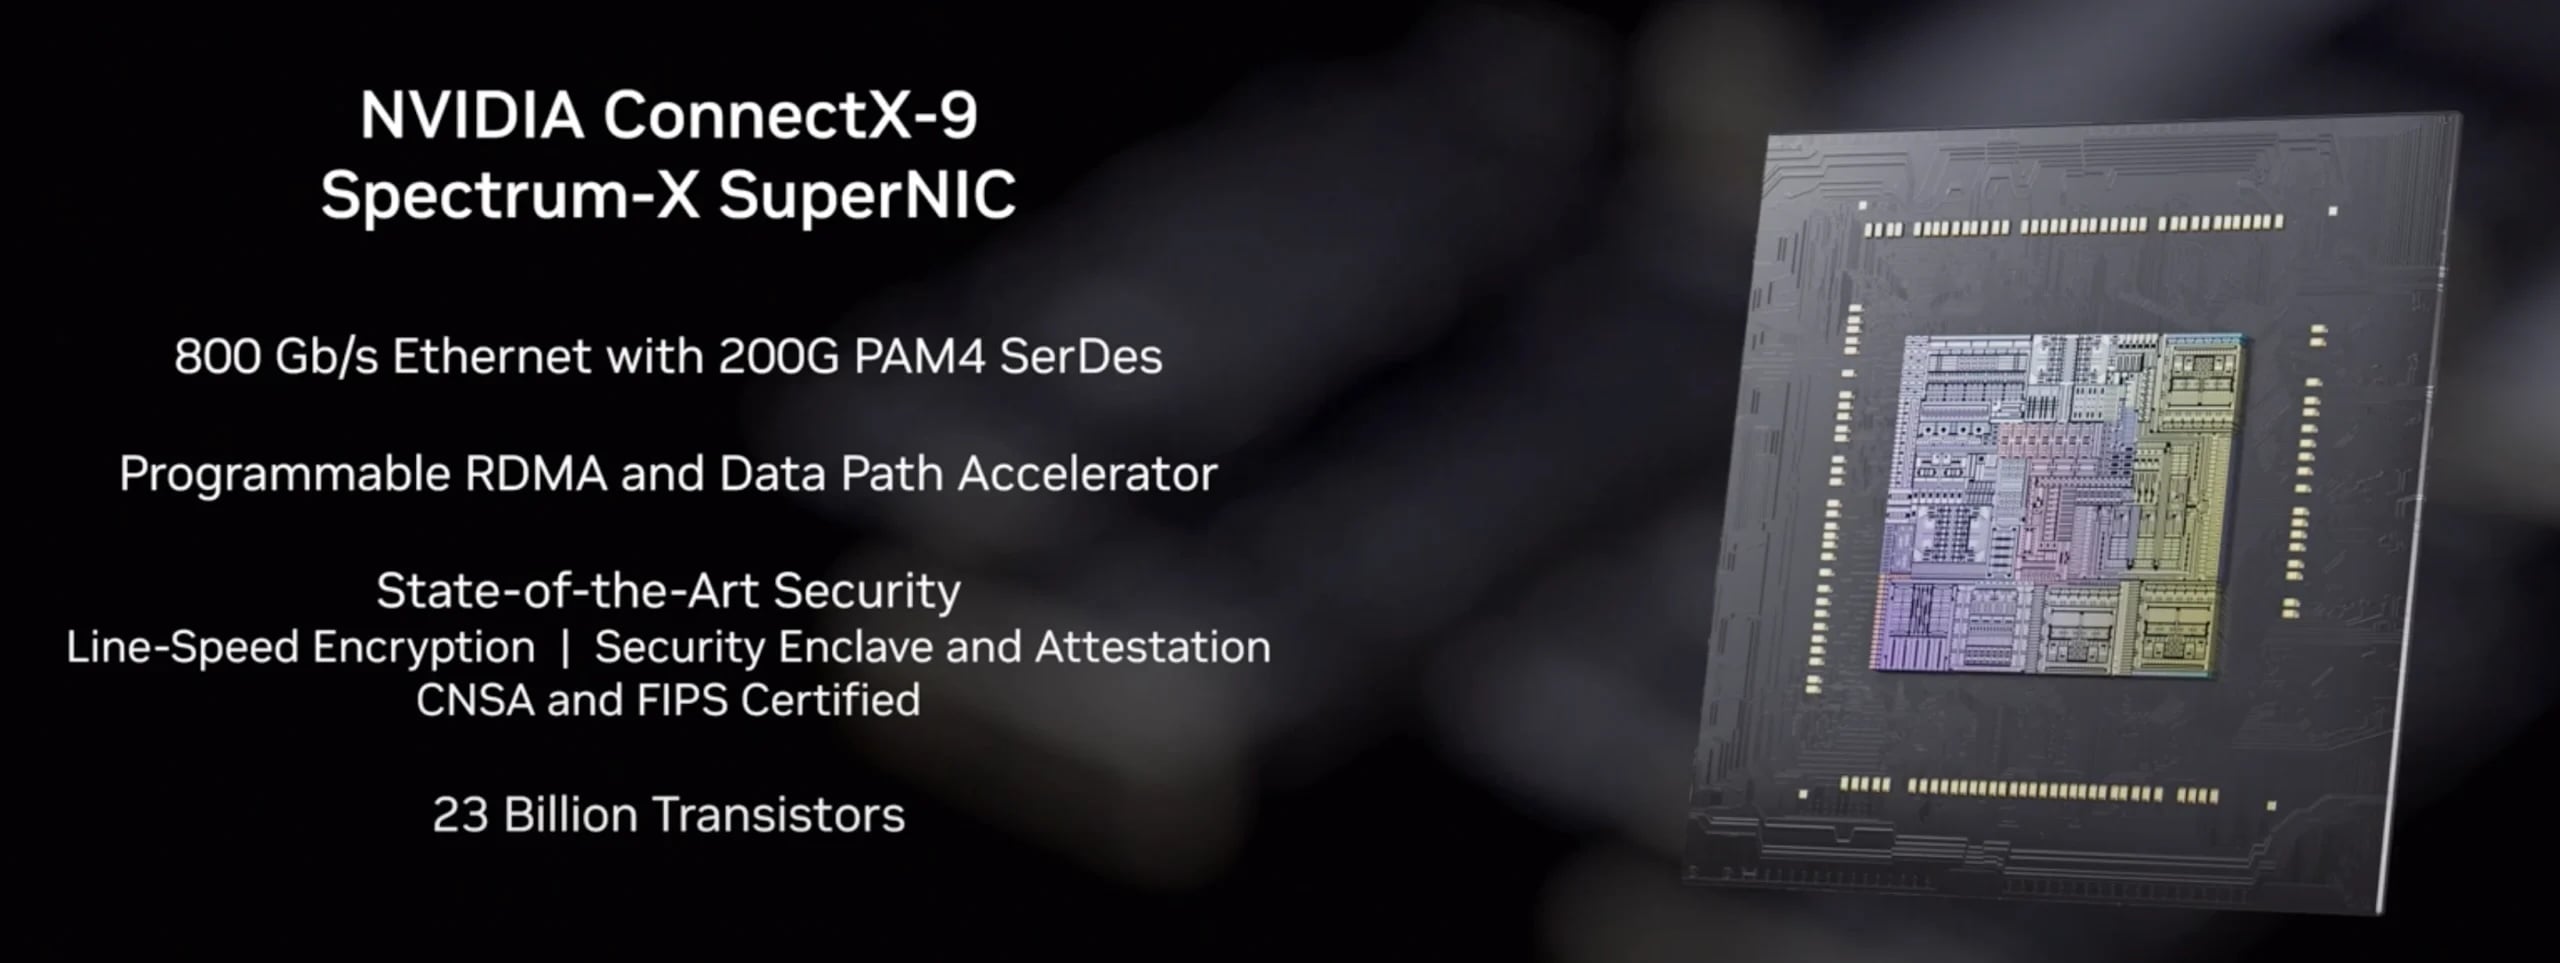
De NVIDIA ConnectX-9 SuperNIC verzorgt schaalbare netwerken en levert 1.6 TB/s RDMA-bandbreedte per GPU voor communicatie buiten het rack. ConnectX-9 is samen met de Vera CPU ontworpen om de efficiëntie van het datapad te maximaliseren en introduceert een volledig softwarematig gedefinieerd, programmeerbaar en versneld datapad waarmee AI-labs aangepaste algoritmen voor dataverplaatsing kunnen implementeren die zijn geoptimaliseerd voor hun specifieke modelarchitecturen.
BlueField-4 DPU en ASTRA Secure Architecture
BlueField-4 is NVIDIA's vierde generatie dataverwerkingseenheid en vertegenwoordigt een fundamentele herziening van opslag en netwerken voor AI-workloads. De nieuwe DPU beschikt over een 64-core NVIDIA-processor, vergeleken met de 16 ARM Cortex-A78-cores van BlueField-3, en levert daarmee 6x meer rekenkracht. Het bevat een geïntegreerde ConnectX-9 SuperNIC in plaats van ConnectX-7 in BlueField-3, waardoor de netwerkbandbreedte verdubbelt tot 800 Gb/s. De GPU-toegang tot dataopslag is 2x sneller dan bij de vorige generatie. Naast de verbeteringen in specificaties ligt het belang van BlueField-4 in wat het mogelijk maakt: een nieuwe laag AI-native opslaginfrastructuur die NVIDIA positioneert als essentieel voor agentische AI op grote schaal.
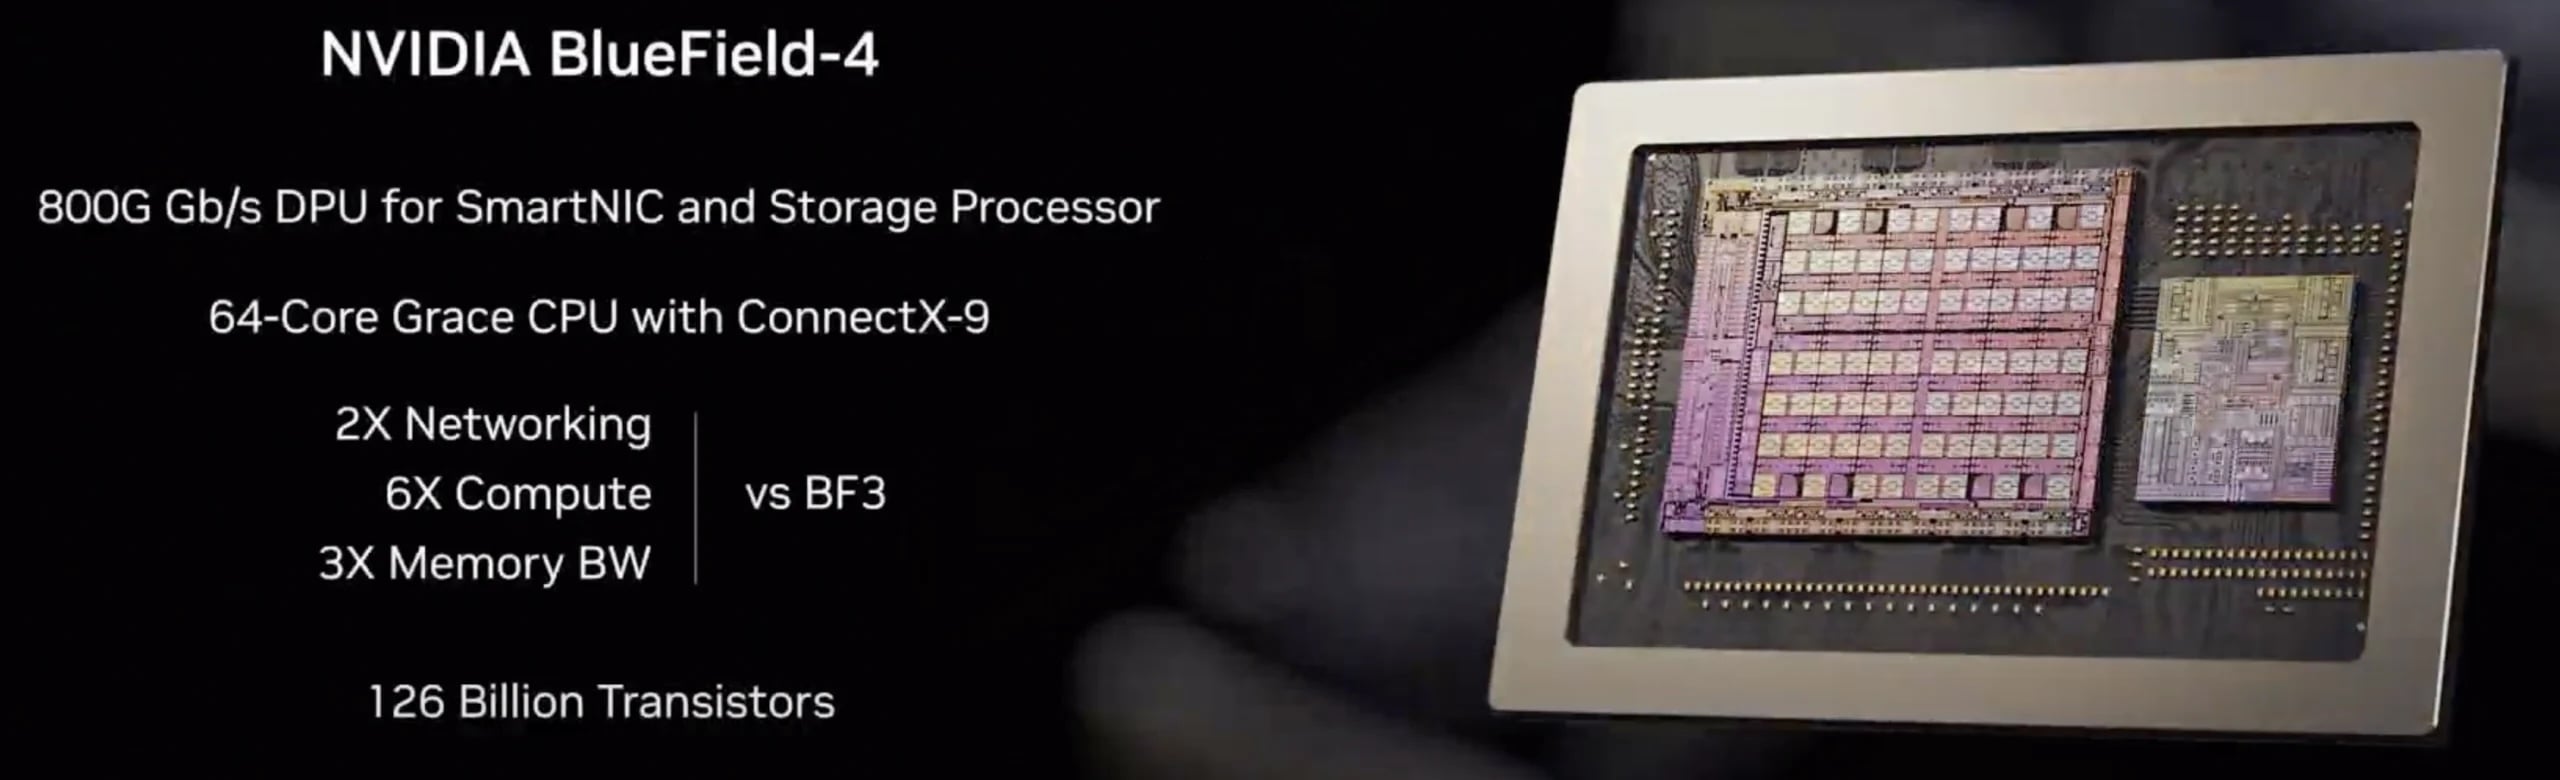
BlueField-4 ontlast de netwerk-, opslag- en beveiligingsverwerking, zodat Rubin GPU's en Vera CPU's zich kunnen blijven richten op de uitvoering van modellen. Het is volledig geïntegreerd in het door NVIDIA Enterprise AI Factory gevalideerde ontwerp, met ecosysteemondersteuning van Red Hat, Palo Alto Networks, Fortinet en anderen.
BlueField-4 introduceert ook ASTRA (Advanced Secure Trusted Resource Architecture). Deze vertrouwensarchitectuur op systeemniveau biedt één centraal controlepunt voor het veilig inrichten, isoleren en beheren van grootschalige AI-omgevingen zonder prestatieverlies.
Vertrouwelijke computerverwerking over het gehele rack.
Vera Rubin NVL72 is het eerste rack-scale platform dat NVIDIA Confidential Computing over het gehele systeem levert. De derde generatie Confidential Computing waarborgt de gegevensbeveiliging over de CPU, GPU en het gehele NVLink-domein, waarbij elke bus tijdens de overdracht versleuteld is. Dit beantwoordt een groeiende zorg bij bedrijven en AI-labs die eigen modellen draaien op gedeelde infrastructuur: de garantie dat modellen, trainingsdata en inferentieworkloads beschermd blijven, zelfs wanneer ze worden ingezet op systemen van derden.
De NVIDIA Spectrum-6 Ethernet-switch vormt de basis van Nvidia's schaalbare netwerken. Hij is gebouwd op 200G SerDes-technologie met co-packaged optics (CPO), waarmee een schakelcapaciteit van 102 TB/s wordt bereikt en oost-westverkeer over VR NVL72-racks mogelijk wordt gemaakt. De overstap naar CPO is significant. Door de optische componenten direct in de switchchip te integreren, claimt NVIDIA een 10x hogere betrouwbaarheid, een 5x langere uptime en een 5x betere energie-efficiëntie in vergelijking met traditionele insteekbare optische modules.

Kosten- en efficiëntieverbeteringen voor MoE-modellen
NVIDIA stelt dat de VR NVL72 een zevende van de tokenkosten biedt voor inferentie met grote Mixture-of-Experts-modellen bij dezelfde latentie als Blackwell. Het vereist slechts een kwart van het aantal GPU's om hetzelfde grote MoE-model in dezelfde tijd te trainen. Het platform behaalt 8 keer zoveel rekenkracht per watt voor inferentie.
Deze verbeteringen spelen in op de eisen van MoE-modellen, die slechts een deel van hun experts activeren voor een bepaald token. Modellen zoals Kimi K2 Thinking gebruiken 384 experts, maar activeren er slechts acht tegelijk, wat enorme GPU-communicatie tussen alle experts vereist. De schaalbare netwerkcapaciteit van 260 TB/s van de VR NVL72 kan dit communicatiepatroon aan.
Een kabelvrij rack ontworpen voor grootschalige toepassingen
De VR NVL72 introduceert een modulair, kabelvrij, ventilatorvrij en slangvrij tray-ontwerp dat alleen gebruikmaakt van printplaten en connectoren in plaats van interne bekabeling. De compute trays worden via blind-mate connectoren in het rack geplaatst, waardoor handmatige kabelgeleiding overbodig is. De enige externe aansluitingen zijn twee vloeistofinlaat- en -uitlaatslangen die op de vloeistofkoelingsblokken zijn aangesloten.

Eerdere systemen, zoals de GB300 NVL72, vereisten ongeveer 100 minuten om één enkele compute tray te assembleren. Elke kabelverbinding was een potentieel storingspunt, wat significant wordt bij honderdduizenden GPU's. Kabelgeleiding beperkte de koelingsmogelijkheden en nam ruimte in beslag, terwijl ventilatoren de mechanische complexiteit en het geluid verhoogden.
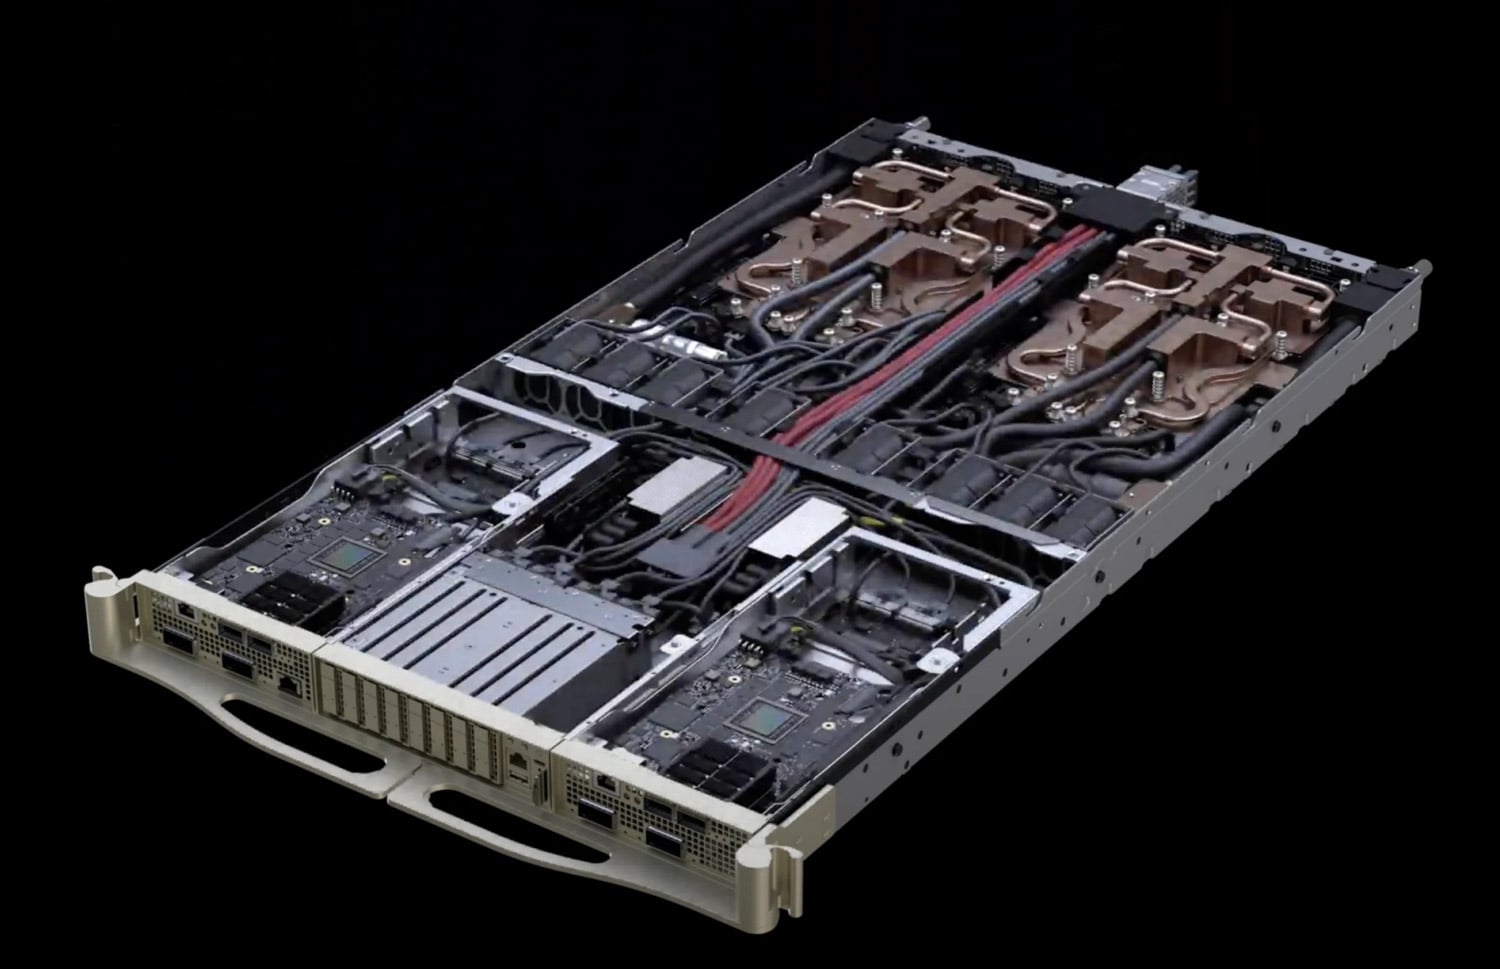
Het nieuwe ontwerp verkort de montage- en onderhoudstijd met een factor 18. Het platform beschikt ook over een tweede generatie RAS-engine (Reliability, Availability, Serviceability) voor GPU's, CPU's en NVLink, die realtime statuscontroles, fouttolerantie en proactief onderhoud biedt. NVLink-switchtrays ondersteunen nu onderhoud zonder downtime, waardoor racks operationeel kunnen blijven terwijl switchtrays worden verwijderd of gedeeltelijk worden gevuld. Op een schaal van honderdduizenden GPU's vertalen deze verbeteringen in onderhoudbaarheid zich direct in een hogere clusterbeschikbaarheid en -doorvoer.
Deze architectuur maakt toekomstige configuraties met een hogere dichtheid mogelijk. Dit is ook cruciaal voor de eerder aangekondigde Vera Rubin CPX-rackontwerpen die we tijdens de AI Infra Summit hebben besproken , waarbij Context Processing GPU's aan dezelfde compute sled worden toegevoegd in een toch al compact ontwerp.
Inferentie Context Geheugen Opslagplatform
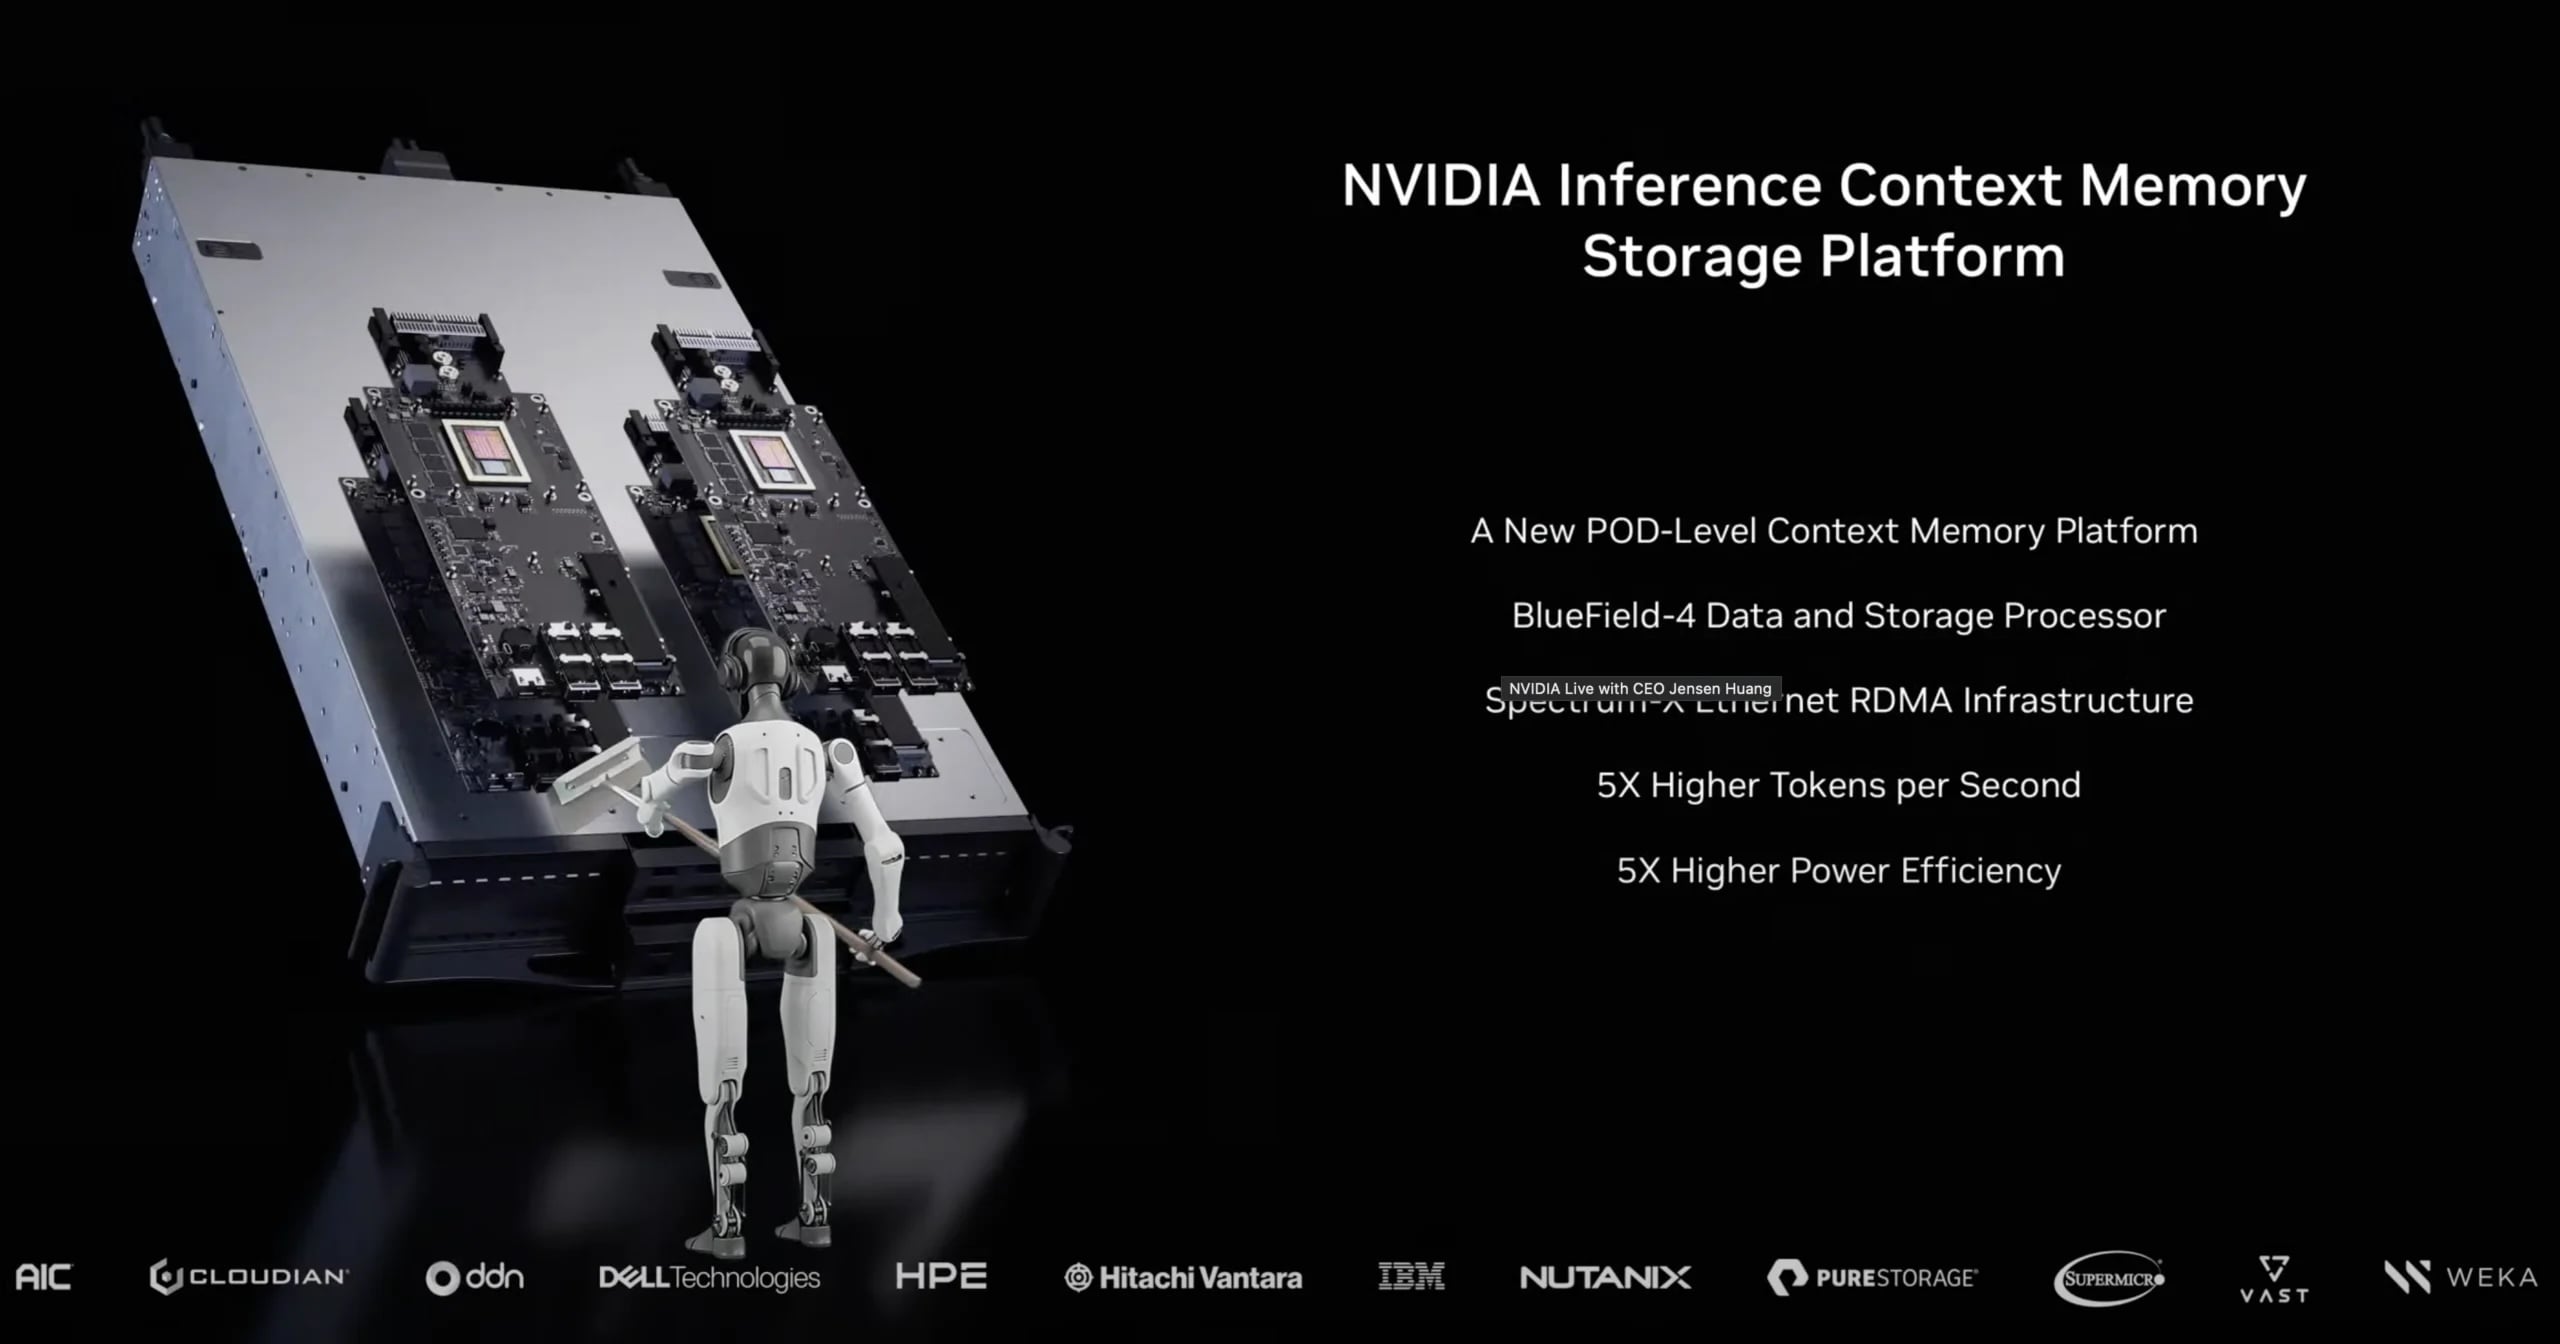
NVIDIA kondigde op CES 2026 het Inference Context Memory Storage Platform aan, een nieuwe klasse van AI-native opslaginfrastructuur die specifiek is ontworpen voor KV-cache. Het platform maakt gebruik van BlueField-4 en Spectrum-X Ethernet-netwerken. Het levert tot 5x meer tokens per seconde dan traditionele netwerkopslag voor inferentiecontext, tot 5x betere prestaties per TCO-dollar, tot 5x betere energie-efficiëntie en een 20x snellere time-to-first-token. De hardware-versnelde KV-cacheplaatsing van BlueField-4 elimineert overhead aan metadata en vermindert dataverplaatsing, terwijl Spectrum-X Ethernet de hoge bandbreedte en lage latentie biedt voor RDMA-gebaseerde toegang.
Dit platform pakt een groeiend knelpunt aan in LLM-inferentie: KV-cachebeheer. Transformer-modellen gebruiken een aandachtmechanisme waarbij elk gegenereerd token rekening moet houden met alle voorgaande tokens. Zonder caching vereist dit het opnieuw berekenen van sleutel- en waardevectoren voor elk token, wat resulteert in een complexiteit van O(n²). KV-caching slaat deze vooraf berekende matrices op in het geheugen voor hergebruik, waardoor de complexiteit wordt teruggebracht tot O(n). Het probleem is dat de grootte van de KV-cache lineair groeit met de sequentielengte en de batchgrootte. Een enkel gesprek met een lange context kan gigabytes aan geheugen verbruiken. In multi-tenantomgevingen, waar duizenden gelijktijdige verzoeken worden verwerkt over contextvensters die miljoenen tokens omvatten, raakt de GPU HBM uitgeput. Operators moeten dan ofwel de batchgrootte verkleinen, de contextvensters verkorten, of meer GPU's aanschaffen.
Traditionele netwerkopslag is niet ontworpen voor KV-cache-toegangspatronen, die snelle, willekeurige toegang vereisen tot potentieel terabytes aan tijdelijke data, verspreid over vele gelijktijdige sessies. Het Inference Context Memory Storage Platform biedt een speciale opslaglaag die is geoptimaliseerd voor deze workload, tussen GPU HBM en conventionele opslag. Hierdoor kunnen AI-fabrieken de contextcapaciteit onafhankelijk van de GPU-rekenkracht schalen. We hebben eerder besproken hoe KV-cache-offloading werkt met NVIDIA Dynamo met behulp van een KV Cache-accelerator van Pliops. NVIDIA schaalt dit op met het NVIDIA Inference Context Memory Storage Platform en integreert het in hun open-source Dynamo-project. Dit biedt het softwareframework dat de gedisaggregeerde prefill/decode-fasen, slimme routing en gelaagde opslag-offloading van dit nieuwe platform met elkaar verbindt.
Opslagpartners, waaronder VAST Data, NetApp, DDN, Dell Technologies, HPE, Hitachi Vantara, IBM, Nutanix, Pure Storage en WEKA, bouwen platforms met BlueField-4. Deze zullen in de tweede helft van 2026 beschikbaar komen.
Alpamayo: Op redenering gebaseerde fysieke AI voor autonome voertuigen
NVIDIA heeft de Alpamayo-familie aangekondigd, een reeks open AI-modellen, simulatietools en datasets die zijn ontworpen om de ontwikkeling van veilige, op redenering gebaseerde autonome voertuigen (AV's) te versnellen. De Alpamayo-familie introduceert op redenering gebaseerde modellen voor beeld-taal-actie, die een mensachtige manier van denken integreren in de besluitvorming van AV's. Het NVIDIA Halo-veiligheidssysteem vormt de basis van deze systemen.
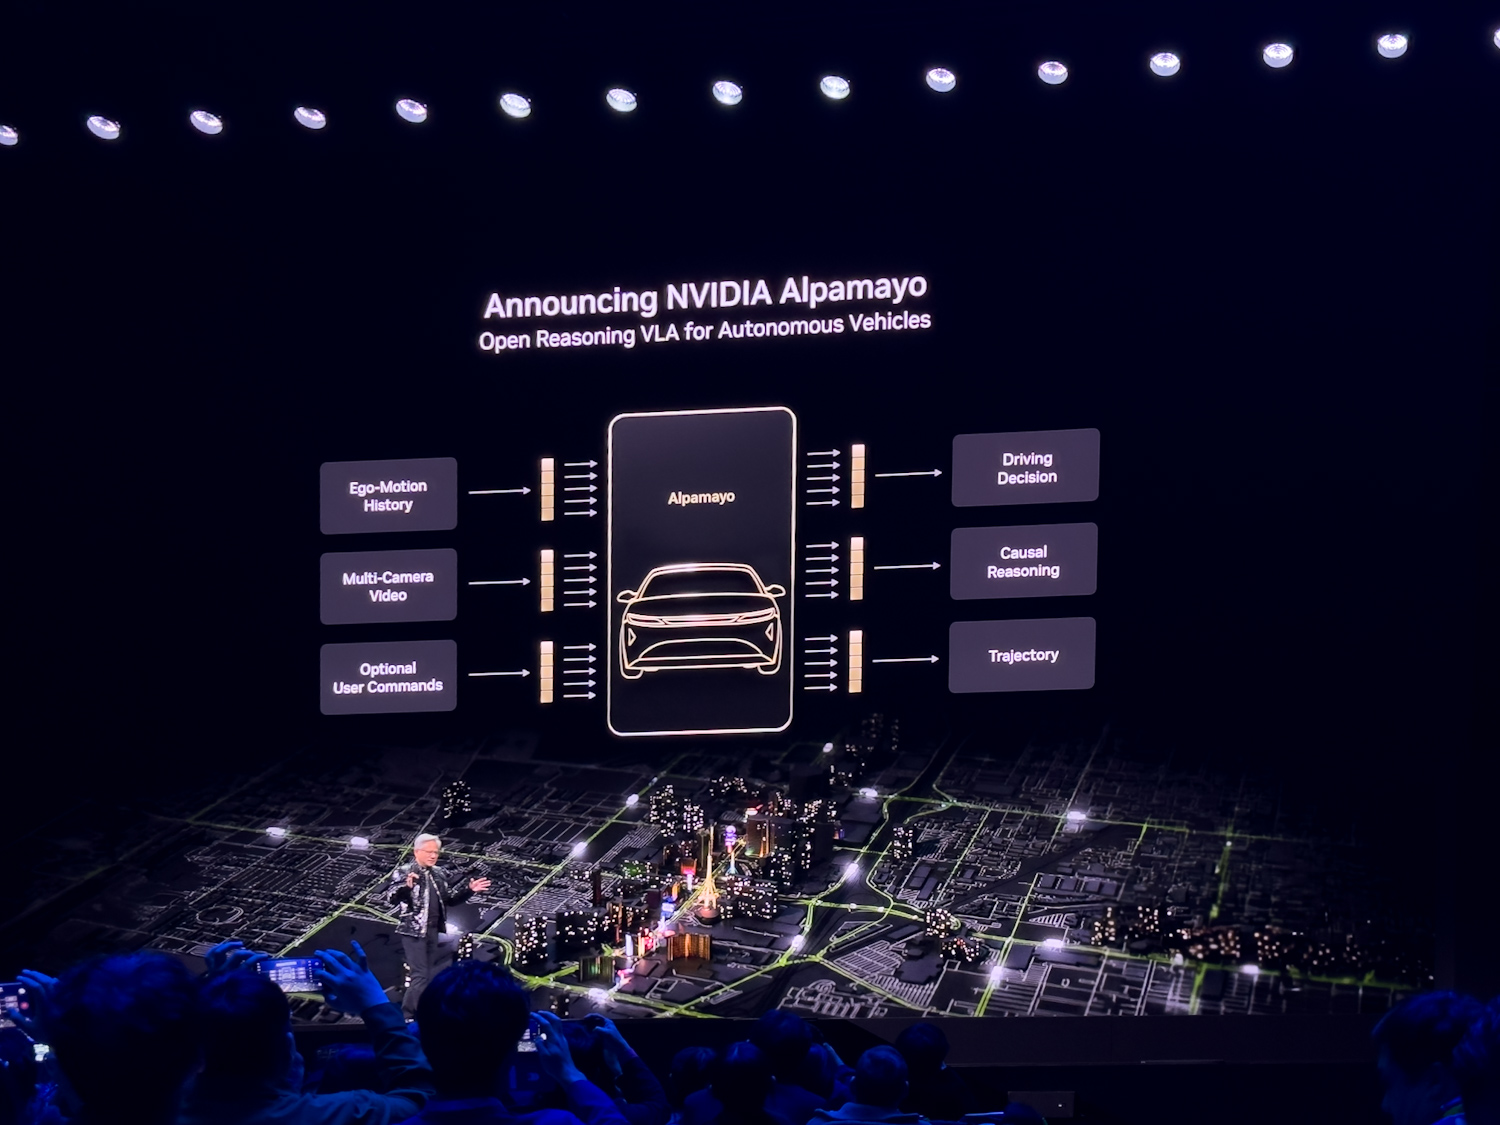
Traditionele AV-architecturen scheiden waarneming en planning, wat de schaalbaarheid kan beperken wanneer zich nieuwe of ongebruikelijke situaties voordoen. De "lange staart" van zeldzame, complexe scenario's blijft een van de grootste uitdagingen voor autonome systemen om veilig te beheersen. Alpamayo pakt dit aan door modellen in staat te stellen te redeneren over oorzaak en gevolg, en nieuwe scenario's stap voor stap te doorgronden om de rijcapaciteit en verklaarbaarheid te verbeteren.
In plaats van direct in het voertuig te draaien, fungeren Alpamayo-modellen als grootschalige leermodellen die ontwikkelaars kunnen verfijnen en verwerken tot de basis van hun complete AV-stacks. Ontwikkelaars kunnen Alpamayo aanpassen tot kleinere runtime-modellen voor voertuigontwikkeling, of het gebruiken als basis voor AV-ontwikkeltools zoals op redenering gebaseerde evaluatoren en automatische labelsystemen.
Alpamayo-modellen, simulaties en open datasets
Alpamayo 1 is het eerste VLA-model in de branche dat een gedachteketen als basis gebruikt en is ontworpen voor de AV-onderzoeksgemeenschap. Het is beschikbaar via Hugging Face. Met een architectuur van 10 miljard parameters gebruikt Alpamayo 1 video-input om trajecten te genereren, samen met redeneringssporen die de logica achter elke beslissing weergeven. Alpamayo 1 biedt open-source modelgewichten en inferentiescripts. Toekomstige modellen in deze reeks zullen een hoger aantal parameters, gedetailleerdere redeneermogelijkheden, grotere flexibiliteit in input en output en opties voor commercieel gebruik bieden.
AlpaSim is een volledig open-source, end-to-end simulatieplatform voor de ontwikkeling van hoogwaardige autonome voertuigen, beschikbaar op GitHub. Het biedt realistische sensormodellering, configureerbare verkeersdynamiek en schaalbare testomgevingen met gesloten lus, waardoor snelle validatie en beleidsverfijning mogelijk zijn.
De Physical AI Open Datasets bevatten meer dan 1,700 uur aan rijgegevens, verzameld in een breed scala aan geografische gebieden en onder uiteenlopende omstandigheden. Deze gegevens omvatten zeldzame en complexe praktijkgevallen die essentieel zijn voor de ontwikkeling van redeneerarchitecturen. Deze datasets zijn beschikbaar op Hugging Face.
Ontwikkelaars kunnen Alpamayo-modelreleases verfijnen op basis van eigen vlootgegevens, ze integreren in de NVIDIA DRIVE Hyperion-architectuur die is gebouwd met NVIDIA DRIVE AGX Thor-versnelde rekenkracht, en de prestaties in simulaties valideren vóór commerciële implementatie.
NVIDIA DRIVE, redundante AV-stacks en Mercedes-Benz CLA
NVIDIA werkt al acht jaar met een team van enkele duizenden mensen aan zelfrijdende auto's. Het bedrijf heeft de volledige stack ontwikkeld: chips (dubbele Orins, de volgende generatie dubbele Thors), infrastructuur (Omniverse en Cosmos), modellen (Alpamayo) en de applicatielaag. Mercedes-Benz is vijf jaar geleden een samenwerking met NVIDIA aangegaan om deze stack te implementeren.
De eerste volledig door NVIDIA ontwikkelde autonome auto, de Mercedes-Benz CLA, wordt in het eerste kwartaal van 2026 in de Verenigde Staten, in het tweede kwartaal in Europa en in het derde/vierde kwartaal in Azië gelanceerd. Euro NCAP gaf de CLA de hoogste score voor actieve veiligheid van alle auto's die in 2025 werden ingediend. Elke regel code en elke chip in het systeem is veiligheidsgecertificeerd.

Het systeem draait twee complete AV-stacks parallel. De Alpamayo-stack gebruikt redenering op basis van gedachteketens en behandelt complexe rijscenario's. Een tweede, klassieke AV-stack is volledig traceerbaar en de ontwikkeling ervan heeft zes tot zeven jaar geduurd. Een beleids- en veiligheidsevaluator bepaalt welke stack gebruikt moet worden op basis van het betrouwbaarheidsniveau. Als Alpamayo een scenario tegenkomt waarbij het systeem niet zeker is van de situatie, schakelt het terug naar de klassieke stack. Deze diversiteit en redundantie in de software weerspiegelt de manier waarop veiligheidskritische systemen omgaan met hardwareredundantie.
NVIDIA zal het systeem blijven updaten met nieuwe versies van Alpamayo. Mobiliteitspartners, waaronder JLR, Lucid, Uber en Berkeley DeepDrive, gebruiken Alpamayo voor de ontwikkeling van op redenering gebaseerde autonomie op niveau 4.
Nieuwe aankondigingen over fysieke AI-modellen en robotica
Naast de aankondigingen over infrastructuur en systemen, gebruikte NVIDIA CES 2026 ook om zijn strategie voor fysieke AI verder te ontwikkelen door nieuwe open modellen, frameworks en edge-platforms te introduceren die de ontwikkeling van robotica versnellen. Het bedrijf presenteerde updates voor zijn Cosmos-wereldmodellen en GR00T-redeneermodellen voor robotleren, samen met nieuwe open-source tools (waaronder Isaac Lab-Arena) voor grootschalige robotevaluatie. OSMO is een edge-to-cloud orchestratie-framework dat is ontworpen om trainingsworkflows in heterogene computeromgevingen te vereenvoudigen.

NVIDIA benadrukte de brede acceptatie van zijn robotica-stack in de industrie, waarbij partners zoals Boston Dynamics, Caterpillar, LG Electronics en NEURA Robotics de volgende generatie autonome machines presenteerden die gebouwd zijn op NVIDIA-technologieën. Het bedrijf kondigde ook een nauwere samenwerking aan met Hugging Face om NVIDIA Isaac- en GR00T-modellen te integreren in het open-source LeRobot-framework, waardoor de toegang voor de wereldwijde robotica-ontwikkelaarsgemeenschap verder wordt uitgebreid.
Aan de rand van het netwerk bevestigde NVIDIA de beschikbaarheid van de Jetson T4000-module met Blackwell-processor, die een aanzienlijke verbetering biedt in AI-rekenkracht en energie-efficiëntie voor autonome machines en industriële robotica. Samen versterken deze aankondigingen NVIDIA's streven om zijn complete AI-platform uit te breiden tot buiten het datacenter, met toepassingen voor simulatie, modellen, edge computing en implementatie in de praktijk voor robotica en autonome systemen.


 Amazon