

AI-infrastructuren zijn notoir resource-intensief en bedrijven worstelen voortdurend met de uitdaging om het GPU-gebruik te optimaliseren. Dell Technologies pakt deze uitdaging aan met zijn AI Factory-platform door de onlangs door NVIDIA overgenomen orchestratieoplossing Run:ai te integreren . In een recent blogbericht van Dell werd benadrukt hoe Run:ai het resourcegebruik maximaliseert en AI-resultaten versnelt, waardoor de manier waarop bedrijven GPU-resources op grote schaal inzetten en beheren, verandert.
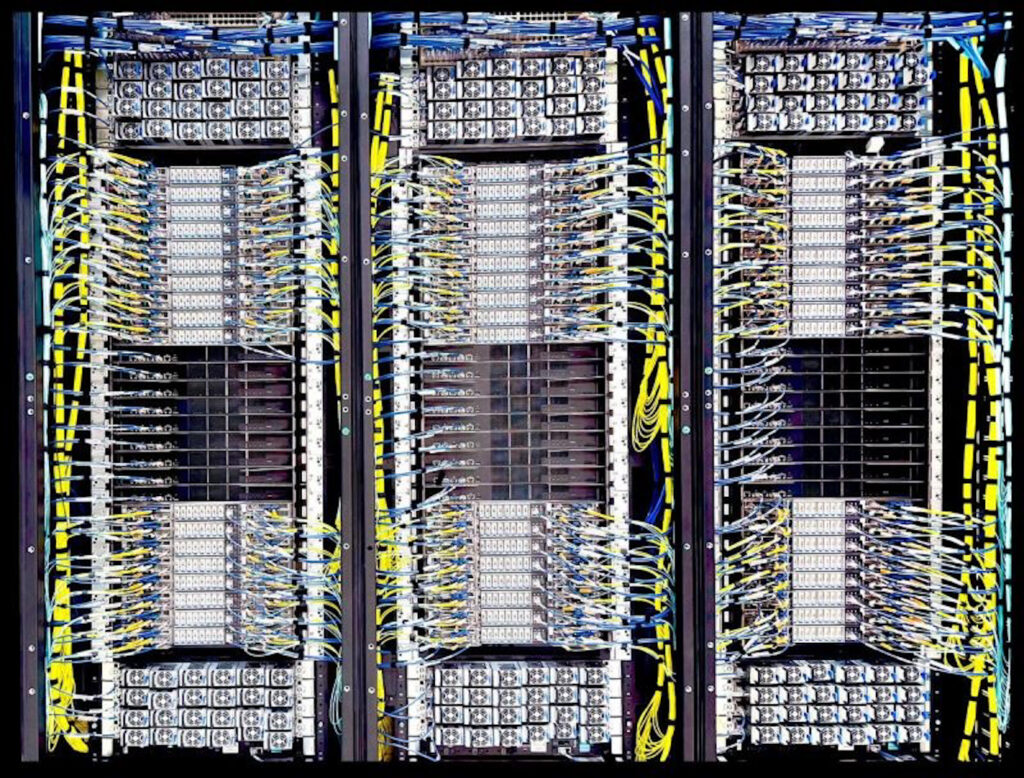
Dell NVL72-cluster
Wat is Run:ai precies?
Run:ai is een orkestratieplatform gebouwd op Kubernetes, specifiek ontworpen voor GPU-gerichte workloads. Run:ai, opgericht in 2018, kreeg voet aan de grond door een wijdverbreide uitdaging in de sector aan te pakken: inefficiënt gebruik van GPU's. Traditioneel blijven GPU's die zijn toegewezen aan AI-workloads vaak ongebruikt of onderbenut. Run:ai lost dit op door GPU-resources dynamisch te poolen en intelligent te plannen, wat fractionele GPU-toewijzing, efficiënte multi-GPU-implementaties en naadloos beheer in hybride, cloud- en on-premises omgevingen mogelijk maakt.
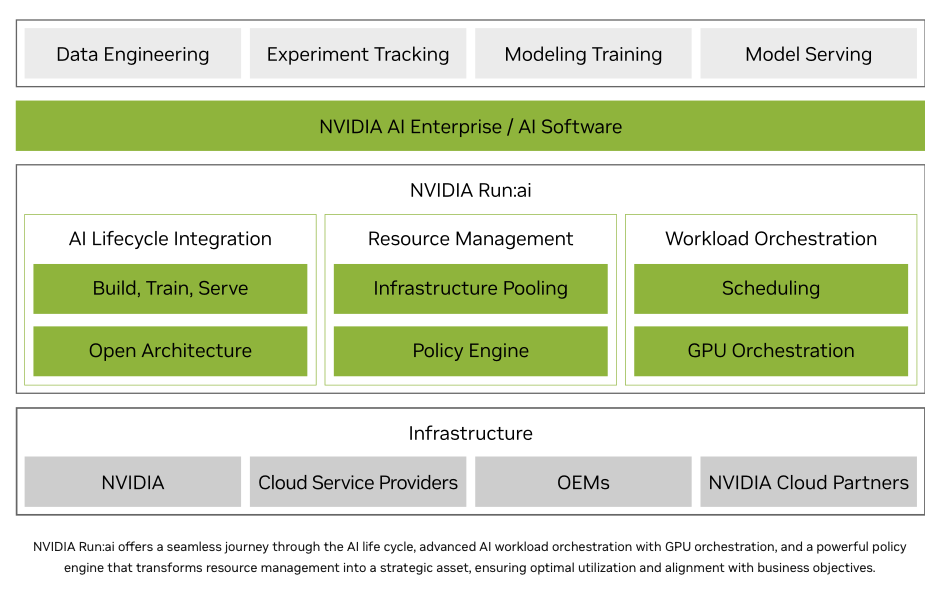
NVIDIA erkende het potentieel van Run:ai om de AI-infrastructuur ingrijpend te veranderen en voltooide de overname van het bedrijf in december 2024 voor ongeveer 700 miljoen dollar. Opvallend is dat NVIDIA zich ertoe heeft verbonden Run:ai uiteindelijk open source te maken, waarmee het bedrijf aangeeft een breed ecosysteem te willen stimuleren, ook buiten zijn eigen hardwareplatforms. Deze stap zal naar verwachting de innovatie en de efficiëntie in de hele sector verder versnellen.
Voor diegenen die een dieper technisch inzicht in resourcebeheer zoeken, beschrijft de documentatie van NVIDIA hoe Run:ai essentieel is voor het orkestreren van workloads op GB200 NVL72-systemen. De documentatie wijst op een cruciaal hiaat: Kubernetes herkent de MNNVL-architectuur van NVIDIA niet standaard, waardoor het beheren en plannen van workloads over deze krachtige domeinen complexer wordt. Run:ai abstraheert deze complexiteit door automatisch NVLink-domeinen te detecteren en het indienen van gedistribueerde workloads te vereenvoudigen. Dit zorgt ervoor dat pods correct worden geplaatst op nodes met NVLink-interconnecties, waardoor diepgaande hardwarekennis of handmatige configuratie voor elke taak overbodig wordt. Deze mogelijkheden laten zien hoe het platform de operationele processen in trainingsomgevingen met een hoge dichtheid stroomlijnt, waardoor organisaties de kracht van geavanceerde hardwareconfiguraties, zoals de GB200 NVL72, volledig kunnen benutten.
Waarom dit belangrijk is voor het bedrijfsleven
Voor organisaties die GPU-intensieve workloads uitvoeren, met name die met generatieve AI en grote taalmodellen, vormt onderbenutting van de GPU een aanzienlijk risico: verspilling van investering. Run:ai pakt deze inefficiënties direct aan. NVIDIA meldt dat organisaties die het platform gebruiken een verbetering van de GPU-benutting tot wel vijf keer kunnen realiseren.
Dit optimalisatieniveau verbetert niet alleen de ROI, maar verandert ook fundamenteel de operationele efficiëntie. Teams die voorheen beperkt waren door beperkte resources en complexe planningsprocessen, beschikken nu over de tools om meer modellen tegelijkertijd te implementeren, snel te schalen en agressiever te experimenteren, en dat alles zonder extra hardware-investeringen. Hoewel deze methodologieën gebruikelijk zijn bij grootschalige HPC-implementaties, is het efficiëntieniveau dat vereist is om het GPU-gebruik te maximaliseren minder gebruikelijk in bedrijven.
Brede industriële dynamiek
Verschillende grote infrastructuuraanbieders omarmen het platform, wat wijst op een groeiende populariteit in het IT-landschap van ondernemingen.
Dell blijft zijn AI Factory-framework uitbreiden, met NVIDIA-technologieën als kern, waaronder Run:ai. Het gebruik van Run:ai door Dell illustreert hoe bedrijven kunnen overstappen van gefragmenteerde, handmatige toewijzing van resources naar een meer dynamische, geautomatiseerde planning die zorgt voor een hogere efficiëntie in omgevingen met meerdere tenants.
HPE biedt Run:ai aan als onderdeel van de GreenLake Marketplace en integreert het met het Ezmeral-platform om geavanceerde GPU-planning, fractionele toewijzing en hybride infrastructuurorkestratie mogelijk te maken. Hierdoor kunnen klanten AI-workloads met grotere precisie en schaalbaarheid implementeren en beheren.
Cisco integreert Run:ai met zijn UCS X-Series servers en het Intersight cloud-operationsplatform. Hun oplossing biedt onder andere quotabeheer, fractioneel GPU-gebruik en realtime monitoring ter ondersteuning van grootschalige AI-implementaties op locatie.
We hebben slechts enkele van de Run:ai-partners uitgelicht. NVIDIA heeft een uitgebreide lijst met logo's, zoals hierboven te zien is. Toonaangevende OEM's en aanbieders van cloudplatforms sluiten zich over de hele linie aan bij Run:ai in hun streven naar innovatievere en efficiëntere AI-infrastructuuroplossingen.



 Amazon