

NVIDIA heeft resultaten gepubliceerd voor MLPerf Inference v6.0, waarbij de systeemverbeteringen worden benadrukt die zijn bereikt door nauwe samenwerking tussen hardware, software en modellen. Het bedrijf positioneert de inferentiedoorvoer en de kostenefficiëntie als de belangrijkste meetinstrumenten voor de prestaties van AI-fabrieken, waarbij niet langer alleen de piekspecificaties van de accelerators worden gebruikt, maar vooral de gemeten output onder reële workloads.
In deze ronde leverden systemen gebouwd op NVIDIA Blackwell Ultra GPU's de hoogste doorvoersnelheid voor alle ingediende modellen en scenario's. Het ecosysteem rond het platform breidde zich ook uit, met 14 partners die resultaten indienden, waaronder grote OEM's, cloudproviders en integrators zoals ASUS, Cisco, CoreWeave, Dell Technologies, GigaComputing, Google Cloud, HPE, Lenovo, Nebius, Netweb Technology, QCT, Red Hat, Supermicro en Lambda.
Uitgebreidere benchmarkdekking weerspiegelt opkomende werkbelastingen
MLPerf Inference v6.0 introduceert verschillende nieuwe benchmarks om de huidige AI-implementaties beter weer te geven. NVIDIA was de enige leverancier die voor alle nieuwe tests in aanmerking kwam, waaronder grote taalmodellen, multimodale systemen, generatieve video en aanbevelingssystemen.
Belangrijke toevoegingen zijn onder andere DeepSeek-R1 Interactive, dat een hogere interactiviteit evalueert met snellere tokenlevering en een kortere tijd tot het eerste token in vergelijking met eerdere serverscenario's. De suite omvat ook Qwen3-VL-235B-A22B, het eerste multimodale visie-taalmodel in MLPerf Inference, en GPT-OSS-120B, een redeneermodel gebaseerd op een mix van experts, getest in offline, server- en interactieve scenario's.
| Scenario | DeepSeek-R1 | GPT-OSS-120B | Qwen3-VL | Wan2.2 | DLRMv3 |
|---|---|---|---|---|---|
| offline | 2,494,310 tokens/sec* | 1,046,150 tokens/sec | 79 monsters / sec | 0.059 monsters / sec | 104,637 monsters / sec |
| Server | 1,555,110 tokens/sec* | 1,096,770 tokens/sec | 68 zoekopdrachten/sec | 21 seconden** (Enkele stream) |
99,997 zoekopdrachten/sec |
| Interactief | 250,634 tokens/sec | 677,199 tokens/sec | *** | *** | *** |
* Dit is geen nieuw scenario in MLPerf Inference v6.0
**WAN 2.2 maakt gebruik van een scenario met één stream, waarbij de end-to-end-latentie van de aanvraag wordt gemeten in plaats van een serverscenario. Hoe lager de waarde, hoe beter.
*** Niet getest in MLPerf Inference v6.0
Generatieve media en aanbevelingsworkloads zijn nu inbegrepen. Het Wan 2.2 tekst-naar-video-model bevat zowel latency-gevoelige als doorvoergerichte tests, terwijl DLRMv3 eerdere aanbevelingsbenchmarks vervangt door een op transformers gebaseerde architectuur die de rekenintensiteit en modelcomplexiteit verhoogt.
Softwareoptimalisatie leidt tot meetbare resultaten.
Een opvallend aspect van deze inzending is de prestatieverbetering die is bereikt op bestaande hardware door middel van software-updates. NVIDIA meldt een tot 2.7 keer hogere tokendoorvoer op het GB300 NVL72-platform voor DeepSeek-R1-serverscenario's in vergelijking met de resultaten van zes maanden eerder. Deze verbetering vertaalt zich in aanzienlijk lagere kosten per token en een hogere benutting van de ingezette infrastructuur.
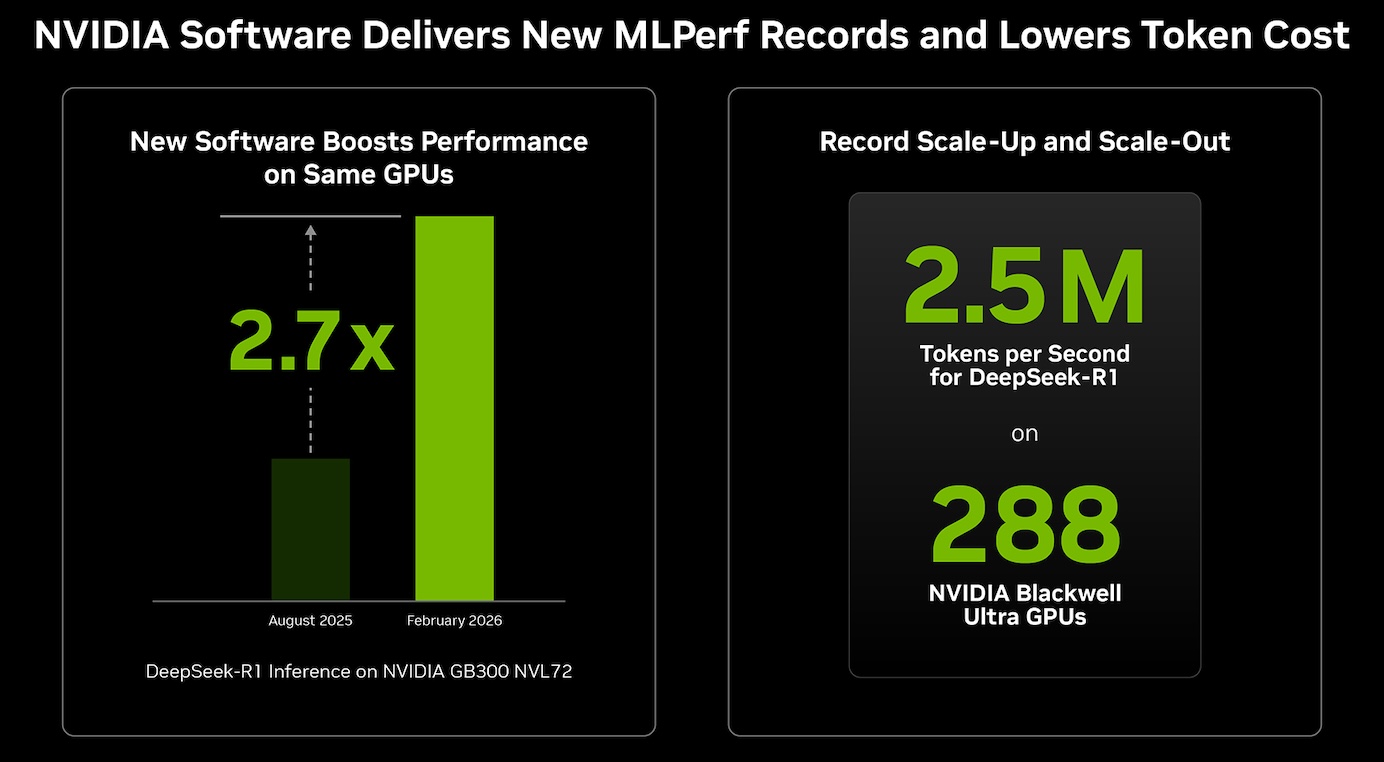
Deze verbeteringen zijn te danken aan updates in de TensorRT-LLM-stack en bijbehorende frameworks. Optimalisaties op kernelniveau en fusietechnieken verminderen de overhead van de uitvoering, terwijl verbeterde aandachtsdata-parallellisatie de werklast effectiever verdeelt over de GPU's. Aanvullende verbeteringen in het Dynamo-framework voor gedistribueerde inferentie maken gedisaggregeerde serving mogelijk, waardoor onafhankelijke optimalisatie van de prefill- en decode-fasen mogelijk is.
Bij modellen met een combinatie van experts verdelen technieken zoals Wide Expert Parallel de gewichten van de experts over de GPU's om geheugenknelpunten te verminderen. Multi-token-predictie verhoogt de rekenefficiëntie in scenario's met lage batchgroottes en lage latentie door meerdere tokens tegelijk te genereren en te valideren. KV-bewuste routing verbetert de planning verder door inferentieverzoeken te sturen op basis van geschatte rekenkosten.
| criterium | GB300 NVL72 v5.1 |
GB300 NVL72 v6.0 |
Versnellen |
|---|---|---|---|
| DeepSeek-R1 (Server) |
2,907 tokens/sec/gpu | 8,064 tokens/sec/gpu | 2.77x |
| DeepSeek-R1 (Offline) |
5,842 tokens/sec/gpu | 9,821 tokens/sec/gpu | 1.68x |
| Lama 3.1 405B (Server) |
170 tokens/sec/gpu | 259 tokens/sec/gpu | 1.52x |
| Lama 3.1 405B (Offline) |
224 tokens/sec/gpu | 271 tokens/sec/gpu | 1.21x |
NVIDIA demonstreerde ook voortdurende schaalvergroting op bestaande modellen. Op Llama 3.1 405B behaalde het GB300 NVL72-platform een prestatieverhoging van 1.5x in serverscenario's, wat wijst op voortdurende optimalisatie voor compacte LLM's in combinatie met nieuwere architecturen.
Open ecosysteem en frameworkintegratie
Bij de inzendingen voor de nieuwe workloads werd gebruikgemaakt van een mix van NVIDIA- en open-source frameworks. De Qwen3-VL benchmark gebruikte het vLLM framework, wat de snelle ontwikkeling in multimodale inferentieoptimalisatie weerspiegelt. De Wan 2.2 tekst-naar-video resultaten werden mogelijk gemaakt door TensorRT-LLM VisualGen, gericht op diffusiegebaseerde pipelines op GPU's.
Voor DLRMv3 combineerde NVIDIA zijn recsys-example framework met GPU-versnelde embedding lookup-technologieën om te voldoen aan de toegenomen eisen van op transformers gebaseerde aanbevelingsmodellen. Deze integraties benadrukken de rol van het bredere software-ecosysteem bij het maximaliseren van de prestaties van de onderliggende hardware.
Schaalbare prestaties met InfiniBand
NVIDIA demonstreerde ook grootschalige inferentieprestaties met behulp van vier GB300 NVL72-systemen die via Quantum-X800 InfiniBand met elkaar verbonden waren. Deze configuratie, met in totaal 288 Blackwell Ultra GPU's, is de grootste MLPerf Inference-inzending tot nu toe en behaalde een systeemdoorvoer van miljoenen tokens per seconde op DeepSeek-R1.
| DeepSeek-R1 | 4x GB300 NVL72 | Tokens/seconde |
|---|---|
| offline | 2,494,310 |
| Server | 1,555,110 |
De resultaten benadrukken het belang van hoogwaardige interconnecties voor het schalen van inferentieworkloads, met name voor gedistribueerde LLM-servers en batchverwerking met hoge doorvoer.
Naar een benchmark voor dienstverleningsniveaus
Vooruitkijkend helpt NVIDIA mee aan de ontwikkeling van de MLPerf Endpoints binnen het MLCommons-consortium. Deze aankomende benchmark is bedoeld om geïmplementeerde inferentieservices te meten met behulp van echt API-verkeer, waardoor inzicht wordt verkregen in latentie, doorvoer en efficiëntie op serviceniveau in plaats van alleen op componentniveau.
Naarmate AI-workloads zich ontwikkelen tot agentsystemen met langere contextvensters, zullen benchmarks die de end-to-end serviceprestaties meten naar verwachting steeds belangrijker worden voor zowel cloudproviders als bedrijfsimplementaties.


 Amazon