

Supermicro heeft vandaag samen met IBM en NVIDIA een KV-cache-opslagoplossing aangekondigd die de key-value-status achter lange-context-inferentie verplaatst van de GPU naar een gedeelde all-flash-laag. Het pakket combineert Supermicro Petascale-opslagservers op AMD EPYC 9005-processors, IBM Storage Scale, NVIDIA Dynamo en NVIDIA Spectrum-X Ethernet. De bedrijven ondersteunen het met een gevalideerde referentiearchitectuur die IBM als Redbook heeft gepubliceerd. Het belangrijkste resultaat is een 56x snellere tijd tot het eerste token bij prompts met 130,000 tokens, vergeleken met een GPU die de context volledig opnieuw berekent.
Waarom KV Cache een opslaglaag nodig heeft
Inferentie verloopt in twee fasen: prefill zet de prompt om in tokens en verwerkt deze door het model om de tussentijdse sleutel-waardeparen te genereren, en decode genereert het antwoord token voor token op basis van deze paren. Door de sleutel-waardeparen in een permanente cache op te slaan, kan het systeem ze hergebruiken voor de volgende beurt, de volgende agentstap of het volgende verzoek met dezelfde context, waardoor herberekening wordt overgeslagen.
Agentische workflows, codeerassistenten, RAG met lange contexten en applicaties met meerdere beurten genereren voldoende van deze toestand om het GPU- en CPU-geheugen snel te overbelasten. Daarom ontwikkelen Supermicro, IBM en NVIDIA een netwerkopslaglaag.
In dit ontwerp beheert NVIDIA Dynamo de cachehiërarchie en verplaatst blokken via NIXL; IBM Storage Scale Erasure Code Edition levert de gedeelde bestandslaag; en de Petascale-servers leveren de flashgeheugen en de PCIe Gen5-lanes daarachter. Supermicro zegt dat de drie bedrijven de stack op clusterniveau hebben getest onder hoge gelijktijdigheid en met netwerkverkeer van 'noisy-neighbor'-servers, en presenteert het resultaat als een kant-en-klare oplossing met rackintegratie in de fabriek en implementatie op locatie, waardoor de implementatietijd volgens hen wordt verkort van weken tot dagen.
De geteste configuratie
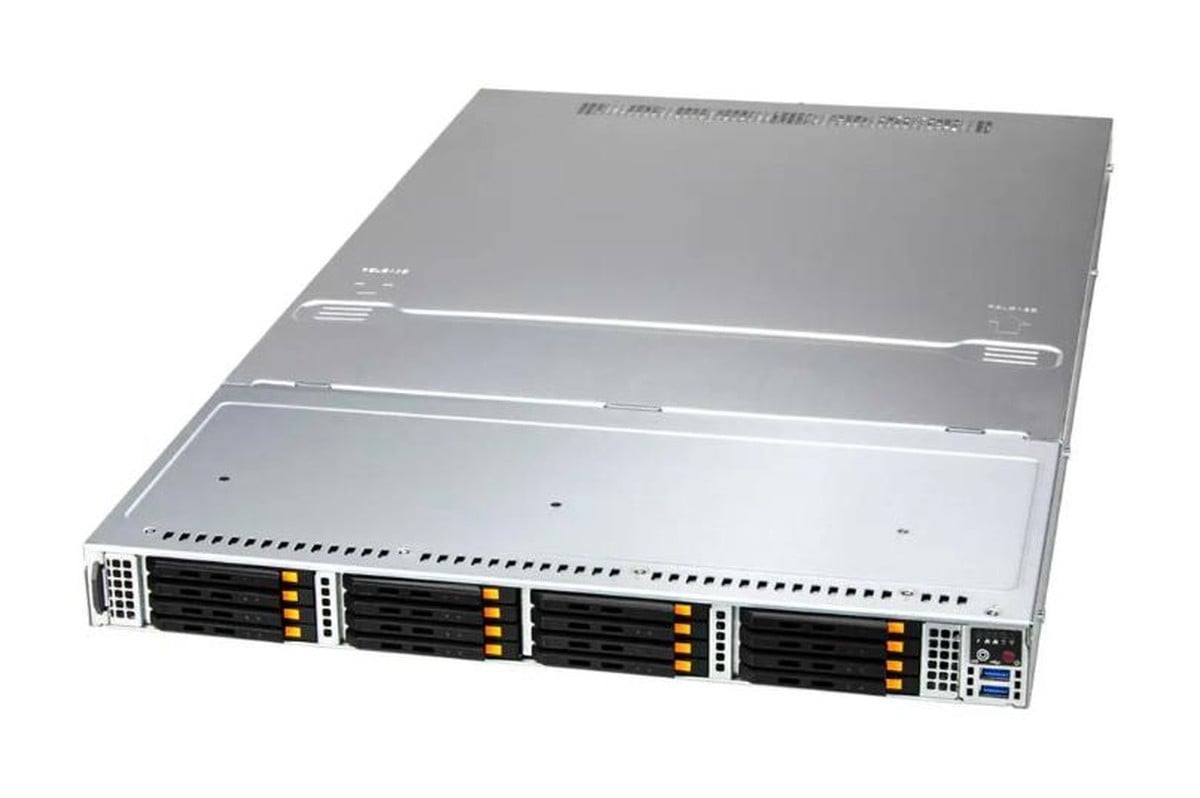
De referentiearchitectuur maakt gebruik van acht Supermicro ASG-1115S-NE316R Petascale-nodes, elk een 1U-systeem met een enkele AMD EPYC 9535 en 16 Micron 7.68TB E3.S NVMe-schijven. Dit resulteert in 122.88TB aan ruwe flashgeheugen per node en ongeveer 983TB over de acht nodes samen. Elke node is voorzien van een dual-port 200Gb NVIDIA BlueField-3 B3220 aan de clientzijde en een 400Gb ConnectX-7 voor de opslagbackend, met drie Spectrum-X SN5600-switches in een spine-and-leaf-configuratie en 800Gb/s-uplinks.
De opslagknooppunten draaien RHEL 9.6 en IBM Storage Scale ECE 6.0.0.1 in een 8+2P-configuratie met erasure code. IBM schat de leesdoorvoer van deze laag met acht knooppunten op 315 GB/s op basis van eerdere tests.
| Bestanddeel | KV Cache Referentiearchitectuur (zoals getest) |
|---|---|
| Opslaglaag | |
| Opslagknooppunten | 8x Supermicro ASG-1115S-NE316R (1U, enkelvoudige socket) |
| CPU per node | AMD EPYC 9535, 128 PCIe Gen5-lanes (64 naar NVMe, 64 naar netwerk) |
| Flash per node | 16x Micron 7.68 TB E3.S NVMe (122.88 TB ruwe opslag) |
| Netwerk per knooppunt | NVIDIA BlueField-3 B3220, dual-port 200Gb (clientzijde) NVIDIA ConnectX-7 400Gb (opslagbackend) |
| Schakelen | 3x NVIDIA Spectrum-X SN5600, spine and leaf, 800Gb/s uplinks |
| Opslagsoftware | IBM Storage Scale Erasure Code Edition 6.0.0.1, 8+2P RHEL 9.6 |
| Inferentieclient | |
| Systeem | Supermicro SYS-212GB-FNR (NVIDIA MGX), Ubuntu 24.04 |
| GPU gebruikt voor de benchmarks | 1x NVIDIA RTX PRO 6000 Blackwell, 19.6 GiB resterend voor KV-cache na gewichten en CUDA-grafieken |
| Klantennetwerken | 2x NVIDIA BlueField-3 B3140H 400Gb/s, tot 80GB/s bandbreedte voor de client |
| Model en software | openai/gpt-oss-120b (MXFP4) vLLM 0.14.1 NVIDIA Dynamo 0.9.0 met NIXL NVIDIA AIPerf benchmarkclient |
| Cachelagen | De host- en lokale niveaus zijn op nul gezet; alle 1.4 miljoen gecachede tokens worden vanuit het Storage Scale-niveau aangeboden. |
De benchmarkclient is een enkel Supermicro SYS-212GB-FNR MGX-systeem, en de resultaten zijn afkomstig van één NVIDIA RTX PRO 6000 Blackwell GPU in dat systeem, waarop het openai/gpt-oss-120b-model in MXFP4 draait onder vLLM 0.14.1 en Dynamo 0.9.0.
Na de gewichten en CUDA-grafieken bleef er 19.6 GiB GPU-geheugen over voor de KV-cache, genoeg voor ongeveer 1.14 miljoen tokens op de GPU zelf. Voor de tests werden het hostgeheugen en de lokale lagen op nul gezet, zodat elk gecached blok terugkwam van Storage Scale. De resultaten meten dus alleen het opslagpad, zonder de invloed van een gemengde hiërarchie.
56x snellere tijd tot eerste token, 22x snellere doorvoer.
Zonder cache steeg de tijd tot het eerste token voor het 120B-model van 0.572 seconden bij 10,000 invoertokens naar 32.14 seconden bij 130,000, omdat de GPU de volledige context opnieuw moest berekenen. Met de KV-cache op Storage Scale bleef de TTFT tussen 0.193 en 0.57 seconden binnen hetzelfde bereik, wat overeenkomt met de 56x hogere waarde bij 130,000 tokens en de spreiding van 0.377 seconden die Supermicro in zijn aankondiging noemt. IBM, Supermicro en NVIDIA hebben deze tests uitgevoerd; wij hebben de resultaten niet zelf uitgevoerd of gecontroleerd.
De doorvoertest verstuurde 200 verzoeken via 28 gelijktijdige verbindingen, afkomstig van 100 unieke prompts met in totaal 24 miljoen tokens en 825 GB aan KV-cachegegevens, waarbij de cache aanvankelijk leeg was. De herberekeningsbasislijn voltooide de test met 0.19 verzoeken per seconde in 1,048 seconden; de Storage Scale-laag voltooide de test met 4.26 verzoeken per seconde in 46.94 seconden, een winst van 22x, inclusief de opstartkosten voor het vullen van de cache.
Bij een derde test werden vier clients toegevoegd die 200 GB/s aan niet-gerelateerd netwerkverkeer over hetzelfde netwerk verstuurden. De configuratie met cache verwerkte 3.6 verzoeken per seconde en de verwerkingstijd voor de 200 verzoeken bedroeg 55.56 seconden, ongeveer negen seconden trager dan de test zonder cache en nog steeds 18 keer zo traag als de basislijn. IBM schrijft de geringe vertraging toe aan het feit dat het Spectrum-X-netwerk het cacheverkeer isoleert van de achtergrondbelasting.
"Agentische AI en toepassingen met een lange context zijn afhankelijk van het efficiënt hergebruiken van context over meerdere stappen, en NVIDIA Dynamo helpt bij het orkestreren van gedistribueerde inferentie, zodat bedrijven meer bruikbare doorvoer uit elke GPU kunnen halen", aldus Shruti Koparkar, NVIDIA AI Inference Product Lead. "Door NVIDIA Dynamo en Spectrum-X Ethernet te combineren met Supermicro Petascale-opslagservers en IBM Storage Scale, creëert deze KV-cacheoplossing een krachtige gedeelde opslaglaag die redundante berekeningen kan verminderen, de time-to-first-token kan verbeteren en klanten kan helpen bij het schalen van robuuste AI-inferentiediensten."
Maatvoering en wat niet in de cijfers staat
Volgens de dimensioneringsgids van IBM heeft een configuratie met vier nodes een capaciteit van 4+2P met 67 procent bruikbare capaciteit voor modellen van 7B tot 34B en tot 64 GPU's. De geteste configuratie met acht nodes heeft een capaciteit van 8+2P met 80 procent bruikbare capaciteit voor modellen van 70B tot 120B en 100 tot 256 GPU's die een leesbandbreedte van 100 tot 300 GB/s nodig hebben. Een configuratie met 16 of meer nodes heeft een capaciteit van 16+3P met 84 procent bruikbare capaciteit voor grotere modellen en 300 of meer GPU's met een bandbreedte van 300 GB/s en hoger. Storage Scale ECE zelf schaalt van drie tot 256 opslagservers.
De testopstelling met één GPU is het belangrijkste aandachtspunt. De referentiearchitectuur is ontworpen voor honderden GPU's, maar alle resultaten in het artikel zijn afkomstig van één RTX PRO 6000 in combinatie met een flashgeheugenlaag van acht nodes en 983 TB, die volgens IBM een snelheid van 315 GB/s haalt. De opslagcapaciteit was dus verre van verzadigd en de tests laten niet zien hoe de TTFT (Time To First Time) presteert wanneer een volledig GPU-cluster tegelijkertijd cachegeheugen gebruikt.
Supermicro heeft nog geen prijs of beschikbaarheidsdatum voor de totaaloplossing bekendgemaakt, en de aankondiging bevat geen cijfers over het GPU-gebruik. De aanpak bevindt zich in hetzelfde segment als DDN's Dynamo-geïntegreerde KV-cacheversnelling op de AI400X3M , met als verschil dat deze stack draait op standaard Supermicro-servers en Ethernet onder het bestandssysteem van IBM.
"Naarmate AI-workloads zich uitbreiden van training naar inferentie, moeten bedrijven en neoclouds die workloads met hoge doorvoer voor inferentie inzetten, zoals die kenmerkend zijn voor agentische AI en generatieve AI met lange contexten en meerdere beurten, knelpunten wegnemen om de GPU-efficiëntie te verbeteren", aldus Charles Liang, president en CEO van Supermicro. "Onze oplossing met IBM en NVIDIA laat deze prestatievoordelen duidelijk zien."



 Amazon