

Er zijn tegenwoordig verschillende opties beschikbaar voor opslag op de markt. De meeste onderscheidende factoren die er zijn, hebben betrekking op verschillende snelheden, meer 9's in beschikbaarheid of verschillende GUI-ondersteuning. Al met al lijken de arrays erg op elkaar; ze bieden gewoon verschillende prijzen en ondersteuning of functies die gericht zijn op een vaste groep klanten. DataGravity is in beeld gekomen en biedt iets dat echt anders is. De focus van DataGravity ligt niet op hoe snel gegevens kunnen worden opgeslagen of opgehaald, en ook niet op hoeveel schijven u in een 2U-vormfactor kunt passen; in ieder geval nog niet. DataGravity gaat over het kunnen begrijpen van uw gegevens en om klanten te helpen deze gemakkelijk te vinden, erover te rapporteren en te zorgen voor naleving van branche- of intern beleid.
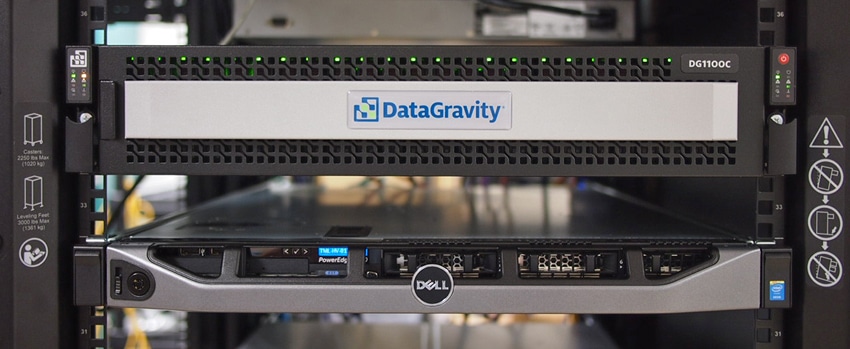
Het is belangrijk om de nuance te begrijpen van waar DataGravity past. Binnen de onderneming zijn er vaak big data-analyse- en beveiligingsteams die belast zijn met het vinden en beveiligen van gegevens, maar dat is niet de markt waar DataGravity op uit is. DataGravity is gericht op de midrange-markt die in de meeste gevallen een beperkt IT-personeel heeft, maar dezelfde data-uitdagingen als grote ondernemingen. Waarom zou DataGravity zo'n gecompliceerd proces richten op iemand die slecht toegerust lijkt om het te gebruiken? Omdat Paula Long, oprichter van DataGravity, stelt: als je op internet kunt surfen, kun je dit product gebruiken. Automatisering is de sleutel tot het oplossen van deze problemen.
De DataGravity Discovery Series-familie werkt door de gegevens in bestanden te begrijpen. Door bijvoorbeeld in een Word-document te kunnen zoeken om te controleren op burgerservicenummers, biedt de DataGravity-array direct inzicht in de bestanden die een bedrijf opslaat. DataGravity kan deze gegevens vervolgens begrijpen, erover rapporteren en ervoor zorgen dat gevoelige informatie niet wordt gedeeld met ongepaste partijen. Naast inzicht in de gegevens die op de array zijn opgeslagen, wordt alle bestandstoegang en gebruikersactiviteit gecontroleerd, waardoor bedrijven kunnen voldoen aan hun nalevings- en beveiligingsvereisten. Dit is een belangrijk onderscheid om te begrijpen wat DataGravity is en wat het niet is. DataGravity is erg gefocust op deze ongestructureerde data use case, wat een veelvoorkomend speelveld is voor NAS's en dergelijke. Hoewel ze iSCSI, NFS en SMB ondersteunen, is de primaire use case voor DataGravity niet de mainstream use cases van zakelijke applicaties zoals e-mail, transactionele database en dergelijke. Het platform kan daar uiteindelijk naartoe gaan, en zal dat waarschijnlijk ook doen, maar vandaag is hun doel buitengewoon goed gedefinieerd.
Gegevens zoals burgerservicenummers, patiënt-ID's, telefoonnummers, creditcardnummers en dergelijke zijn eenvoudig te definiëren en te begrijpen. DataGravity ondersteunt in feite veelvoorkomende compliance-tags uit de doos. Het is echter niet beperkt tot die. Voor organisaties die unieke behoeften hebben, zoals veel bedrijven, biedt DataGravity een editor waarmee organisaties hun eigen tags kunnen maken. Dit zorgt ervoor dat gebruikers van het platform snel kunnen reageren op beveiligings-, compliance- en eDiscovery-vereisten die specifiek zijn voor hun branche. De zichtbaarheid van opgeslagen gegevens biedt ook een betere bedrijfswaarde door alles doorzoekbaar te maken, uiteraard op basis van toegangsregels.
DataGravity biedt arrays in verschillende configuraties die gebruikmaken van nearline HDD's voor capaciteit en flash als leescache. De units hebben een dubbele controller, waarbij elke controller "actief" is en een specifieke taak uitvoert, waarop we hieronder meer zullen ingaan. De DG1100 wordt geleverd met een onbewerkte schijfcapaciteit van 18 TB en de DG1200 wordt geleverd met een onbewerkte schijf van 36 TB. De DG2200 biedt 48TB en de DG2400 brengt 96TB op tafel. Momenteel zijn deze niet uitbreidbaar, maar DataGravity ziet duidelijk de noodzaak om dit aan te pakken; waarschijnlijk met uitbreidingsplanken en/of een beheerinterface die meerdere systemen verenigt tot één beheeroverzicht. Onze tests voor deze review zijn volledig gericht op bruikbaarheid; we brachten twee dagen door met DataGravity in hun kantoor in Nashua, NH en sloten het vervolgwerk op afstand af. Dit gaf ons wat hands-on tijd met een DG1100-eenheid.
Architectuur
DataGravity heeft dubbele actief-actieve controllers met een twist. Normaal gesproken betekent een active-active dual controller dat beide controllers actief zijn met I/O-verwerking. Met DataGravity bootst de architectuur echter actief-passief na, waarbij het primaire knooppunt gegevens levert en het intelligentieknooppunt gegevensanalyse verwerkt. DataGravity noemt dit 'actief-proactief'. De basisconfiguratie ziet er als volgt uit: meerdere GB's DRAM, NVRAM met batterijvoeding, SSD's voor de metadata en cache, en dan nearline HDD's.
Met een niet zo onbelangrijke hoeveelheid gegevens die door DRAM en NVRAM met batterijvoeding stroomt, schrijven DataGravity-spiegels tussen het primaire knooppunt en het intelligentieknooppunt als een eerste orde van zaken. Dit gebeurt via een interne PCIe-bridge, die een hoge bandbreedte en communicatie met lage latentie biedt. Deze snelle koppeling wordt gebruikt in de DataGravity-architectuur voor zijn continue gegevensbescherming en gegevensanalyse. Gegevens tijdens de vlucht worden gespiegeld totdat het primaire knooppunt deze op schijf kan vastleggen. Door beide controllers aan het werk te zetten, maakt de Discovery Series gebruik van een primair opslagknooppunt voor productie-I/O, en zet het doorgaans inactieve secundaire knooppunt aan het werk als een intelligentieknooppunt. Het intelligentieknooppunt maakt gebruik van de metadata en fijnkorrelige schrijfbewerkingen die naar deze controller worden gespiegeld voor continue bescherming en gegevensbewuste analyseverwerking.
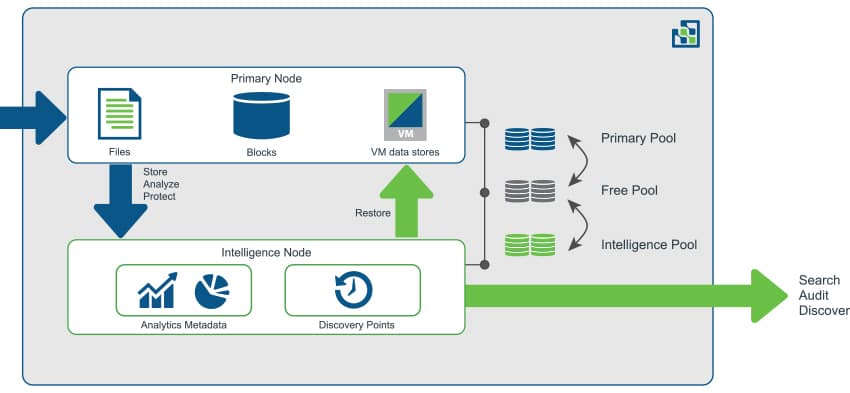
Hoewel actief-actief (of actief-proactief in dit geval) het voordeel heeft dat het gebruikt waarvoor is betaald (versus actief-passief waarbij het tweede knooppunt inactief is totdat het primaire uitvalt), komt er altijd een vraag naar voren: wat gebeurt er met de prestaties als een knooppunt faalt? Als DataGravity twee nodes nodig heeft om zijn magie te laten werken en één gaat verloren, waar blijven klanten dan? In het geval van een storing in een knooppunt, neemt het resterende knooppunt de basis voor de productie over. Gebruikers kunnen bestanden nog steeds openen en gebruiken zoals ze dat bij hun normale dagelijkse werkzaamheden zouden doen. Het grootste deel van de analyses wordt echter opgeschort totdat het defecte knooppunt is hersteld. Met andere woorden, de beschikbaarheid blijft bestaan, maar de op metadata gerichte functies worden verminderd totdat het knooppunt is hersteld.
Usability
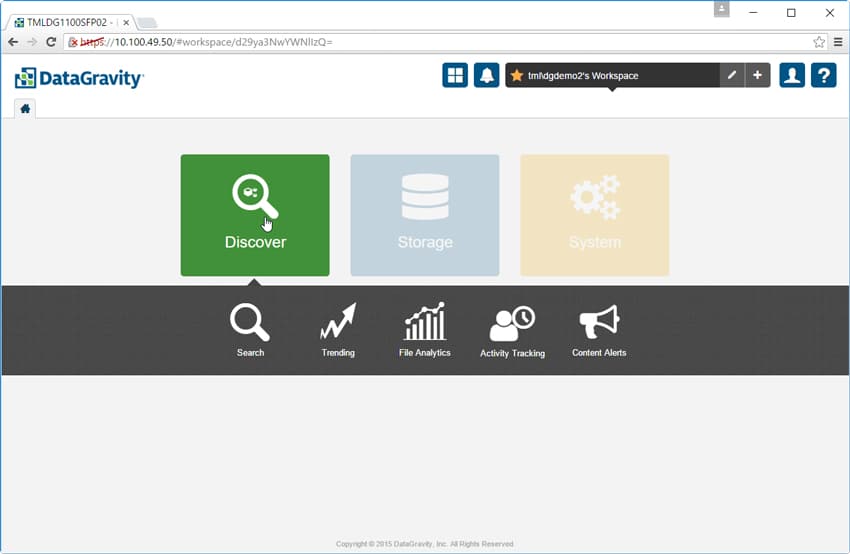
De GUI van DataGravity is gebaseerd op HTML 5 en heeft een zeer eenvoudige en bruikbare lay-out. Het starttabblad heeft slechts drie opties om uit te kiezen: Ontdekken, Opslag of Systeem. Rechtsboven lopend zien we het Global Access Panel, dat pictogrammen bevat voor het systeemdashboard en waarschuwingen, werkruimte, profiel en online hulp.
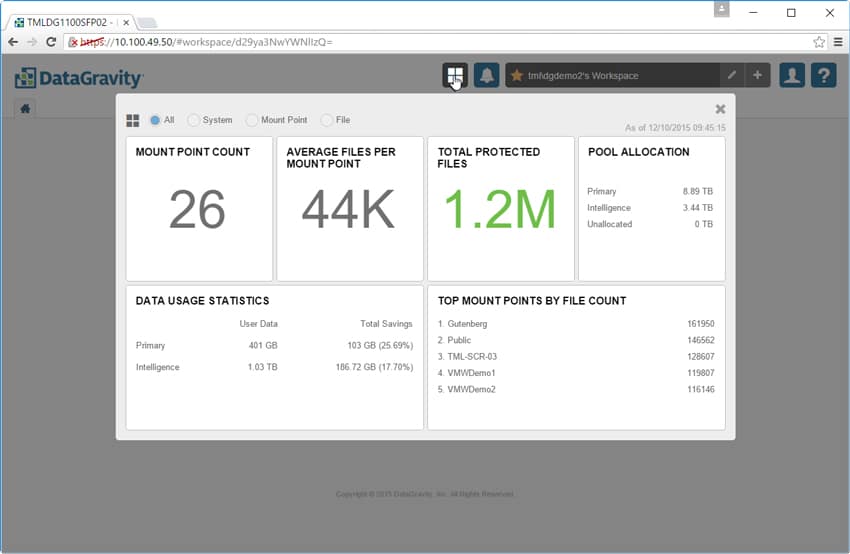
Het systeemdashboard geeft gebruikers een snelle blik op statistieken zoals het aantal koppelpunten, het totale aantal beschermde bestanden, pooltoewijzing en statistieken over gegevensgebruik.
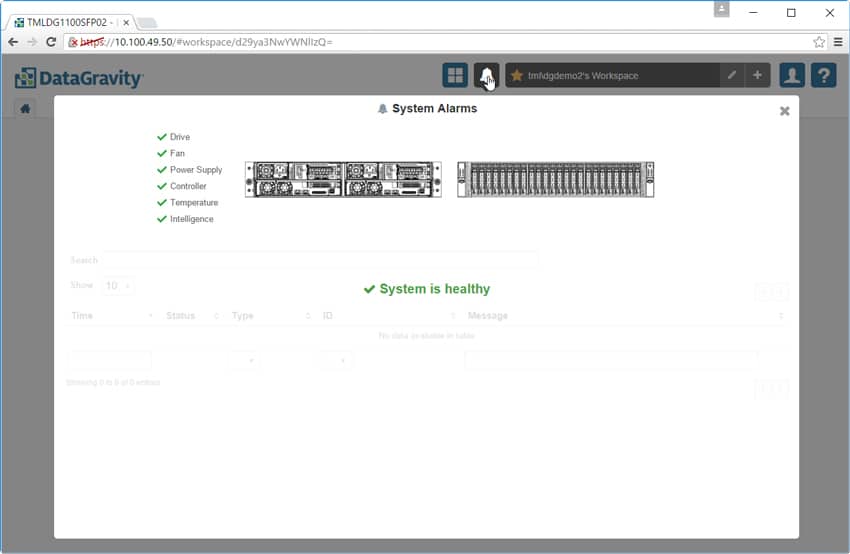
Het tabblad Systeemalarmen is zoals het klinkt en geeft gebruikers een lijst met alarmen en waar ze zich binnen het systeem hebben voorgedaan.
Rechts van het alarmtabblad bevindt zich het tabblad Werkruimte. Hier kunnen gebruikers werkruimten hernoemen of toevoegen. Met werkruimten kunnen gebruikers hun privéweergave van het systeem configureren en beheren. Gebruikers kunnen meerdere werkruimten configureren, afhankelijk van hun behoeften.

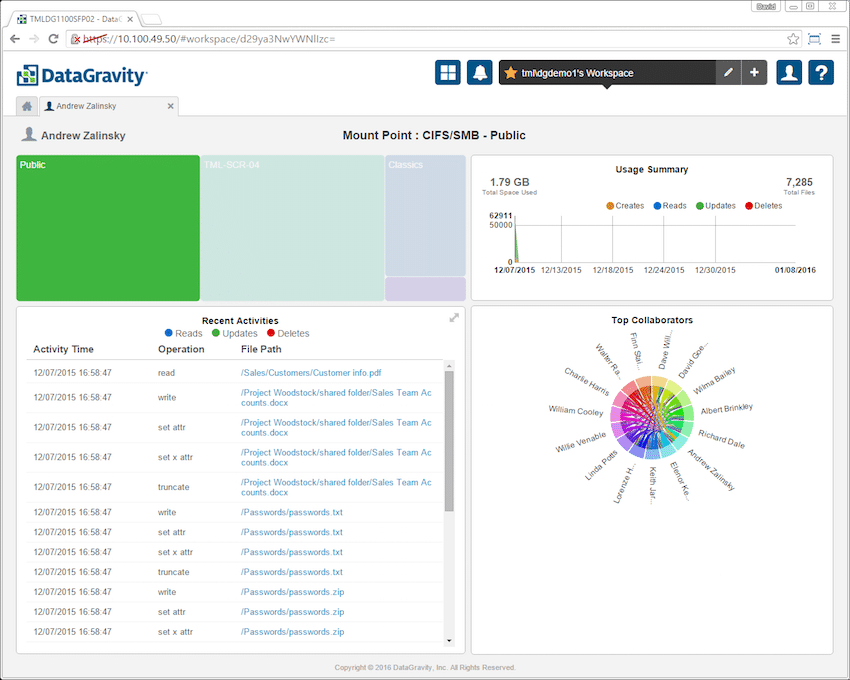
Het volgende pictogram is het pictogram Profielen. Door op het pictogram Profielen te klikken, kan een geautoriseerde gebruiker zijn profiel beheren; e-mailabonnementen voor opgeslagen zoekopdrachten en kan uitloggen van het systeem. Bij het inloggen biedt de GUI verschillende tegels die informatie weergeven, zoals een gebruiksoverzicht in de loop van de tijd en recente activiteit (elk uitgesplitst naar gelezen, bijgewerkt, verwijderd en in het geval van gebruik gemaakt. Er is ook een akkoorddiagram dat laat zien wie elke gebruiker mee samenwerkt en in welke hoedanigheid.
Terugkerend naar het starttabblad, is het meest linkse pictogram het brood en de boter van DataGravity, het tabblad Ontdekken. Door op het tabblad te klikken, krijgen gebruikers opties zoals zoeken, trending, bestandsanalyse, activiteiten volgen en inhoudswaarschuwingen.
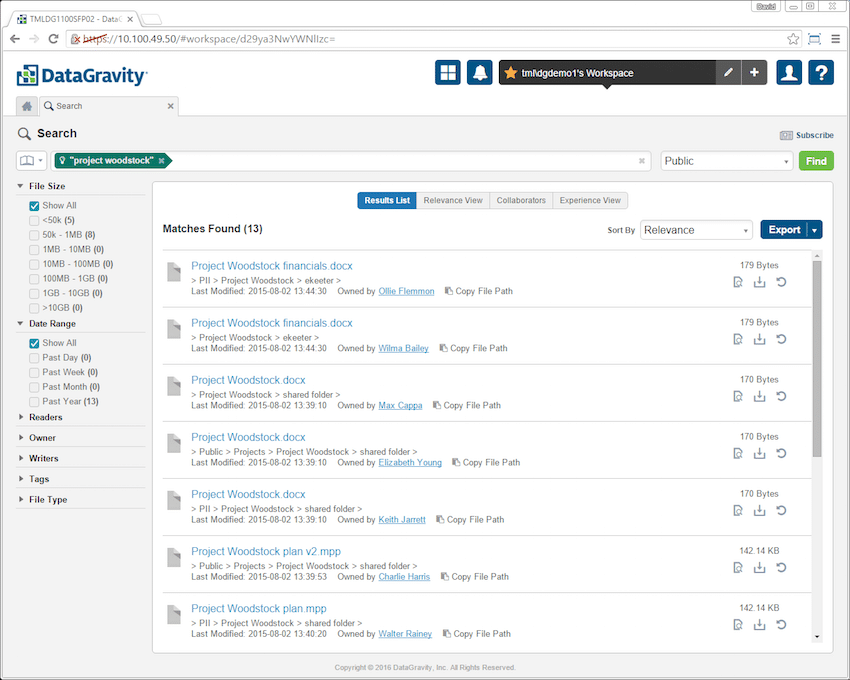
Zoeken is zoals het klinkt. Er verschijnt een zoekbalk en gebruikers hoeven alleen maar het trefwoord of de bestandsnaam in te voeren waarnaar ze zoeken. Voordat gebruikers kunnen zoeken, moeten ze het bevestigingspunt selecteren waarin ze willen zoeken. In de onderstaande afbeelding wordt gezocht naar 'project woodstock'. Dit retourneerde alle bestanden in het openbare koppelpunt die deze voorwaarden bevatten. Filters aan de linkerkant maken het mogelijk om de resultaten verder aan te scherpen.
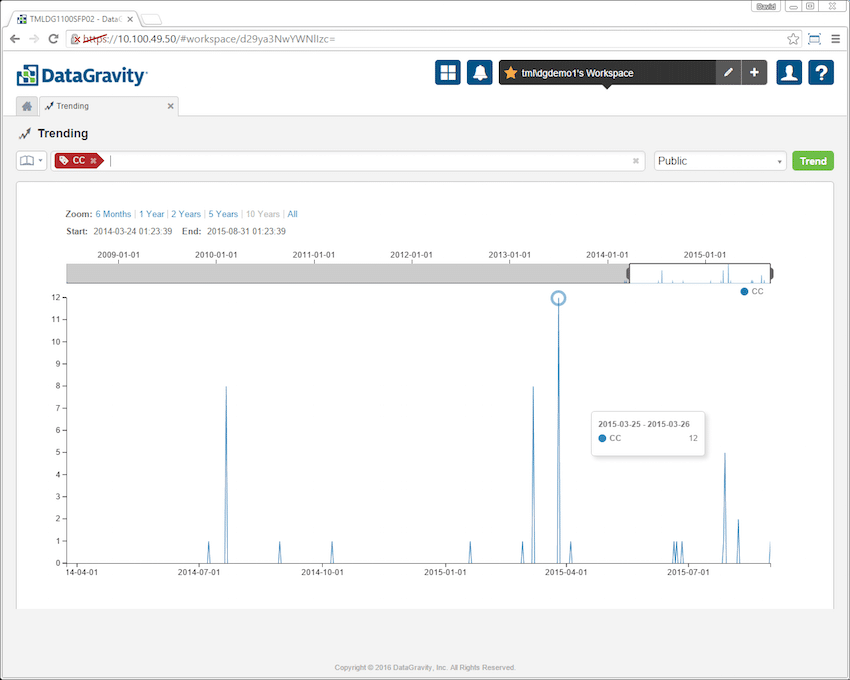
Trending is vergelijkbaar met zoeken, alleen hier voeren gebruikers het trefwoord of de tag in waarnaar ze op zoek zijn en de oplossing geeft hen een grafische weergave van de gegevens. Hierdoor kunnen bedrijven zien hoe de gegevens in de loop van de tijd worden geopend in zowel live als verwijderde bestanden. In de schermkap hieronder werd de creditcardtag (CC) ingevoerd in trending. De resultaten laten zien hoe creditcardnummers zich in de loop van de tijd hebben ontwikkeld in het openbare koppelpunt.
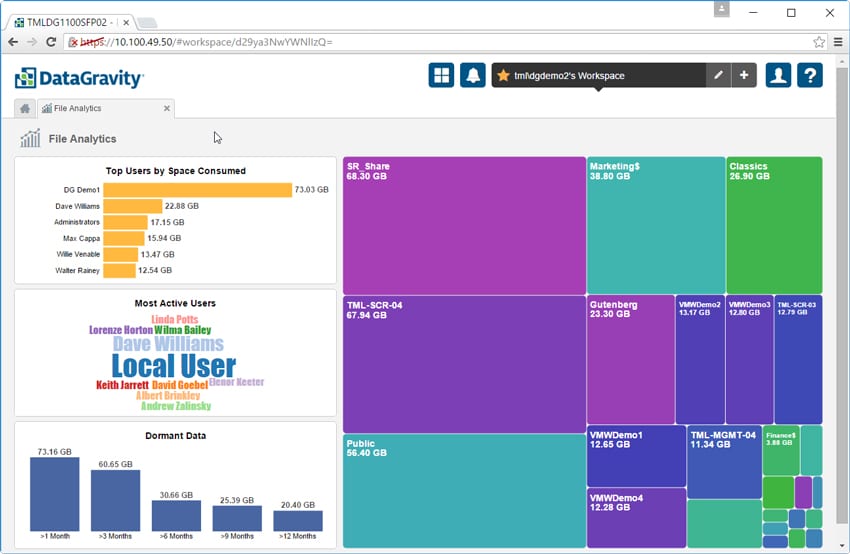
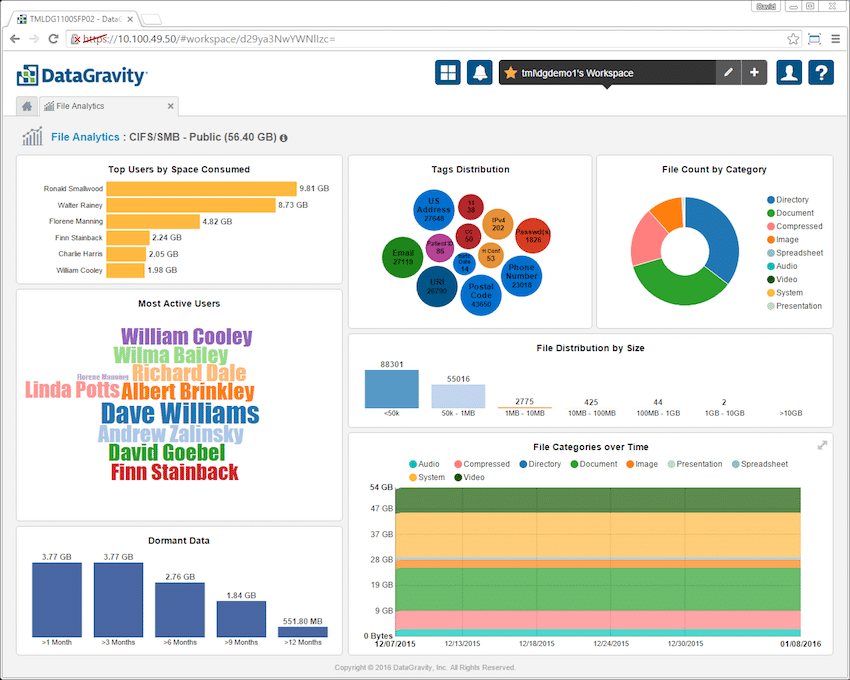
Bestandsanalyse is een andere plek waar DataGravity zich onderscheidt van de rest van de opslagleveranciers. Via dit dashboard kunnen gebruikers eenvoudig bestandsshares en virtuele machines zien die worden weergegeven door gekleurde blokken aan de rechterkant. Hoe groter het aandeel, voor zover de verbruikte capaciteit, hoe groter het gekleurde blok. Gebruikers kunnen ook de top 10 gebruikers zien op verbruikte ruimte in een staafdiagram, meest actieve gebruikers (hoe actiever de gebruiker, hoe groter hun naam wordt weergegeven), en de slapende gegevens en hoe lang gegevens inactief zijn geweest, gegroepeerd op 1, 3, 6 categorieën , 9 en 12 maanden.
Als u op een afzonderlijke bestandsshare of VM klikt, wordt deze informatie verder uitgesplitst. Aan de linkerkant vindt u informatie over de meest actieve gebruikers (gemeten aan de hand van lees-/schrijf-/verwijderbewerkingen) en de topgebruikers per ruimte binnen de share of VM. Er is ook een lijst met slapende gegevens. Aan de rechterkant zijn vier extra tegels: tagsdistributie, aantal bestanden per categorie, bestandsdistributie per grootte en bestandscategorieën in de loop van de tijd. Door op elke tegel te klikken, krijgt u meer details.
Het volgende tabblad in de ontdekkingssectie is Activity Tracking. Zoals de naam al aangeeft, kunnen beheerders en beveiligingsgebruikers snel zien welke gebruiker welke activiteit gedurende een bepaalde periode heeft uitgevoerd. Beheerders hoeven alleen maar te kiezen welk koppelpunt ze willen zoeken en de gebruiker en het datumbereik.

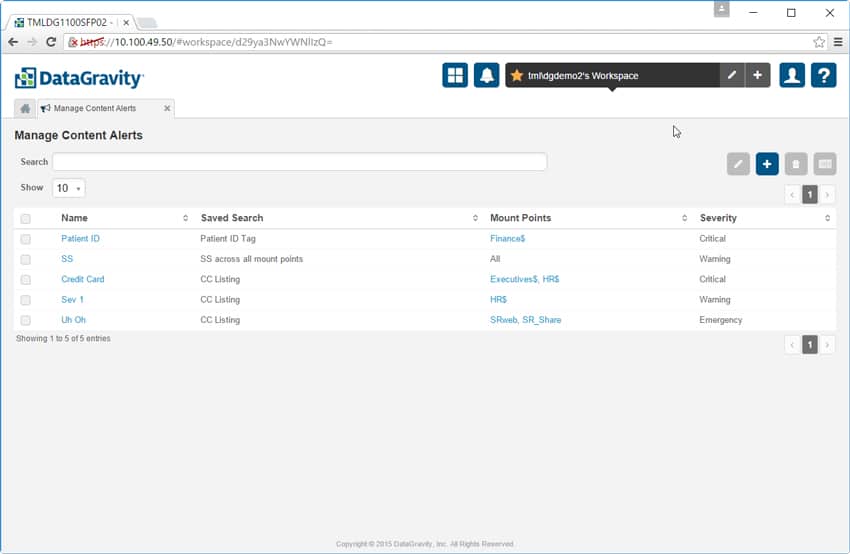
Op het laatste tabblad in het gedeelte Ontdekken kunnen beheerders inhoudswaarschuwingen beheren. In het onderstaande voorbeeld heeft de beheerder waarschuwingen ingesteld om te worden gewaarschuwd wanneer burgerservicenummers of creditcardnummers worden gevonden in open tekst, niet-versleutelde formaten en op plaatsen waar ze niet thuishoren. Dit geeft bedrijven de mogelijkheid om kritieke gegevens die op onbeveiligde locaties zijn geplaatst snel te vinden en te verplaatsen.
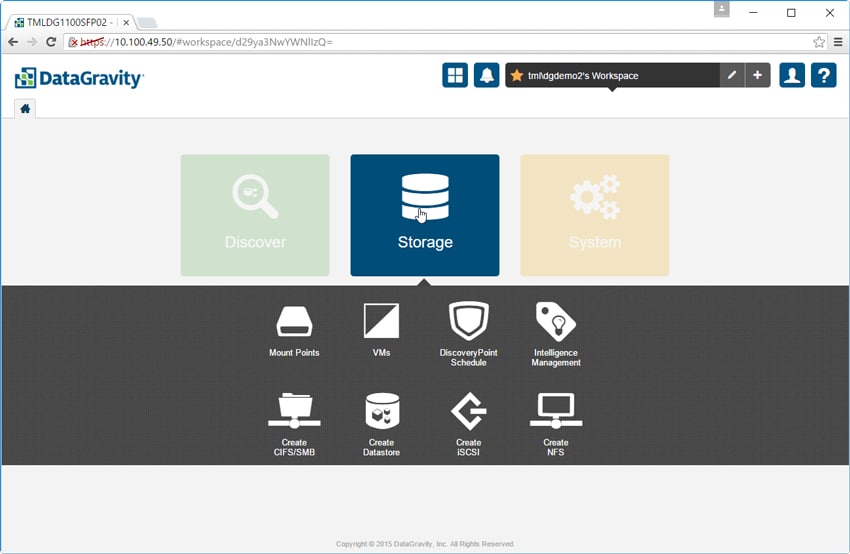
Het volgende hoofdtabblad is het tabblad Opslag. Er zijn hier 8 subtabbladen: Mount Points, VM's, DiscoveryPoint Schedule, Intelligence Management, Create CIFS/SMB, Create Datastore, Create iSCSI en Create NFS.
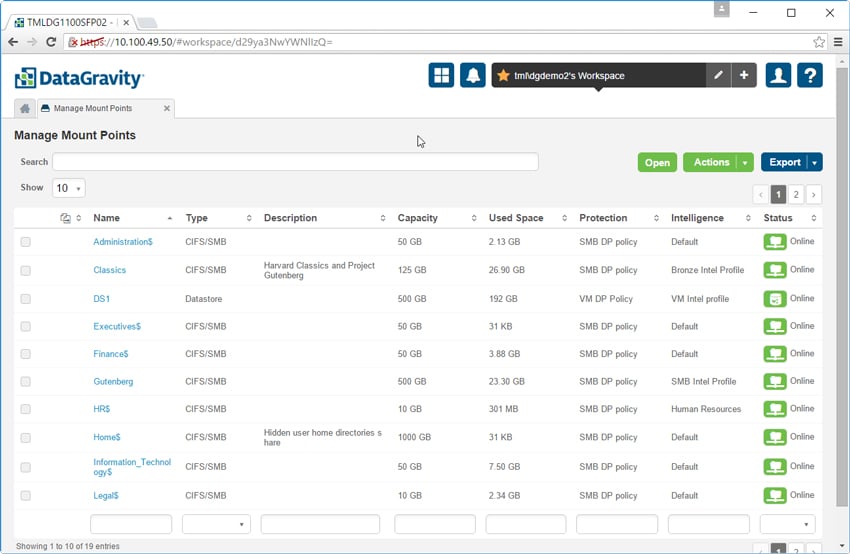
Op het tabblad Koppelingspunten beheren kunnen gebruikers de instellingen van elk koppelpunt bekijken en nieuwe maken. Hier kunnen gebruikers de capaciteit van elk koppelpunt zien (evenals de gebruikte hoeveelheid), een korte beschrijving van elk punt, het beveiligingsbeleid en de status. Voor elk nieuw aankoppelpunt dat hier wordt gemaakt, kunnen deze instellingen naar behoefte worden aangepast.
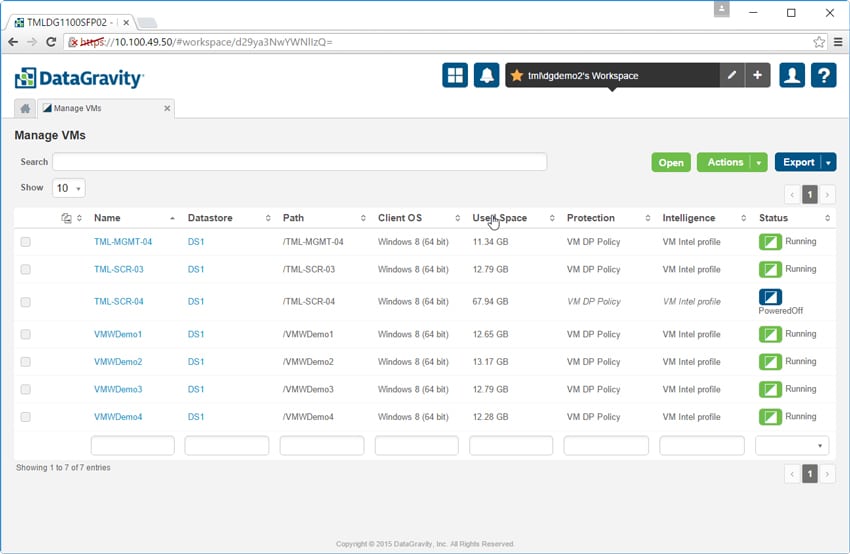
Het tabblad VM's beheren is vergelijkbaar met het bovenstaande. Hier is het mogelijk om informatie over de VM's te bekijken en te configureren. De VM-naam wordt weergegeven, evenals de locatie, het besturingssysteem, de gebruikte capaciteit, het beveiligingsbeleid, het intelligentieprofiel en of de VM actief of uitgeschakeld is. Als u op een VM klikt, krijgt u aanvullende details.
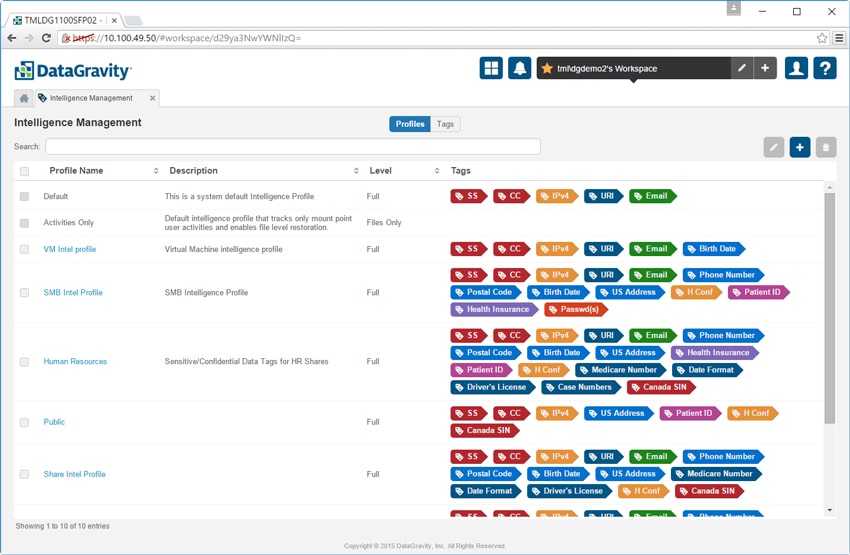
Op het tabblad Intelligentiebeheer kunnen beheerders intelligentieprofielen configureren voor specifieke gebruiksscenario's en deze toepassen op koppelpunten en VM's. Met de knop Tags kunnen beheerders patronen of inhoudsgroepen definiëren die gevoelige gegevens bevatten met behulp van een ingebouwde editor voor reguliere expressies.
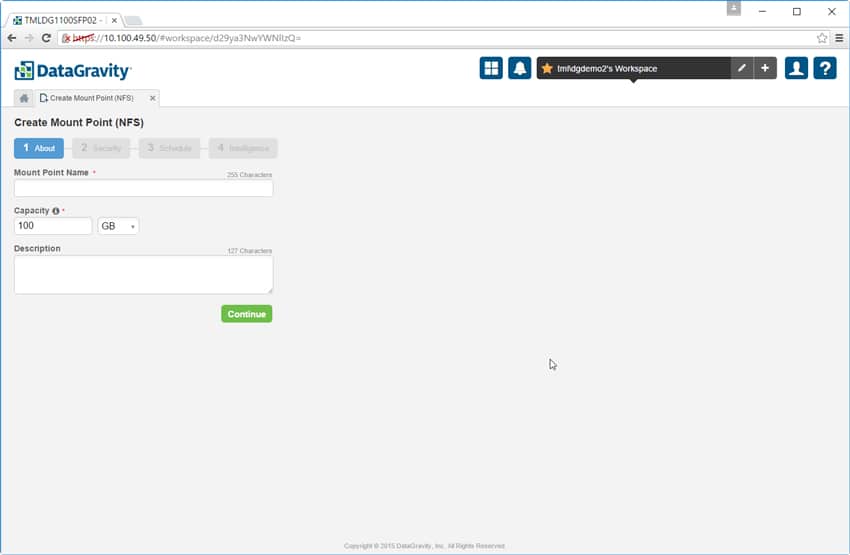
De volgende vier tabbladen gaan allemaal over het maken van een koppelpunt en het bijbehorende toegangsprotocol, of het nu CIFS/SMB, VM-aware NFS DataStore, iSCSI of NFS is (hieronder afgebeeld). Beheerders voegen een naam toe aan het koppelpunt, voegen desgewenst een beschrijving toe, selecteren de capaciteit, stellen het beveiligingsbeleid in, definiëren het DiscoveryPoint-schema en kiezen het intelligentieprofiel.
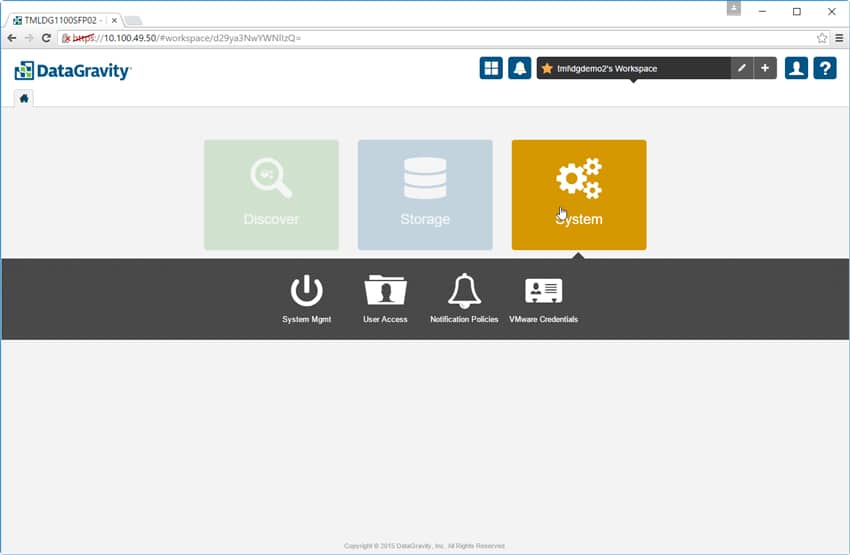
Het laatste hoofdgedeelte is het tabblad Systeem. Als u erop klikt, krijgt u vier subtabbladen: Systeembeheer, Gebruikerstoegang, Meldingsbeleid en VMware-referenties.
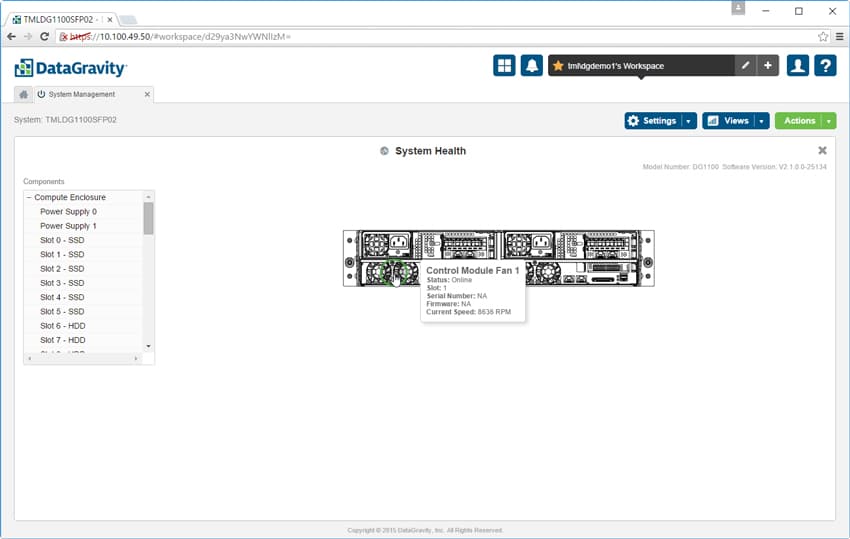
Het tabblad Systeembeheer heeft meerdere opties, waaronder Systeemgezondheid dat een beeld geeft van de gezondheid van het fysieke systeem. Aan de linkerkant ziet u een lijst met alle componenten in de oplossing. Aan de rechterkant is een grafische weergave die de gebruiker meer informatie geeft door erover te bewegen.
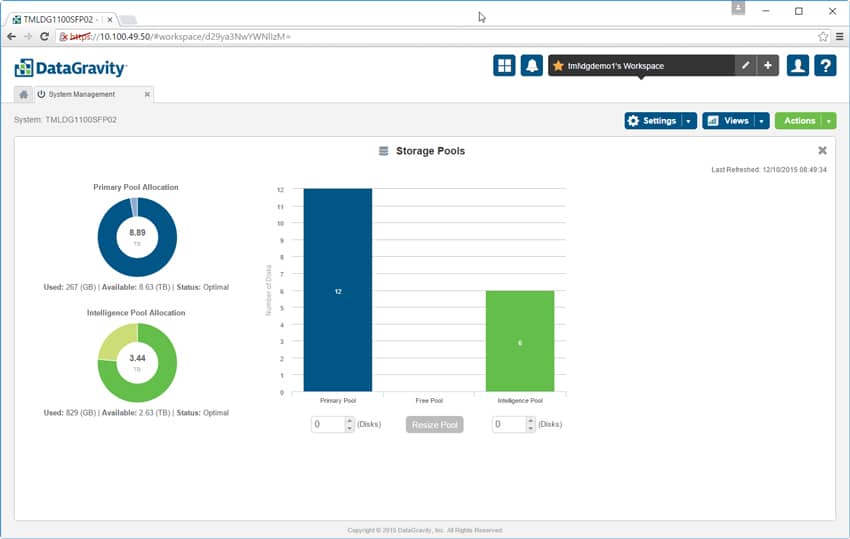
Ook binnen System Mgmt is de Storage Pools-sectie, die een beeld geeft van drie verschillende pools in het DataGravity-systeem: de primaire pool of de pool die is toegewezen voor dagelijks gebruik, de intelligentiepool en de gratis pool voor opslag die heeft nog te verdelen. Vanuit dit scherm kunnen gebruikers de grootte van de pools naar behoefte wijzigen.
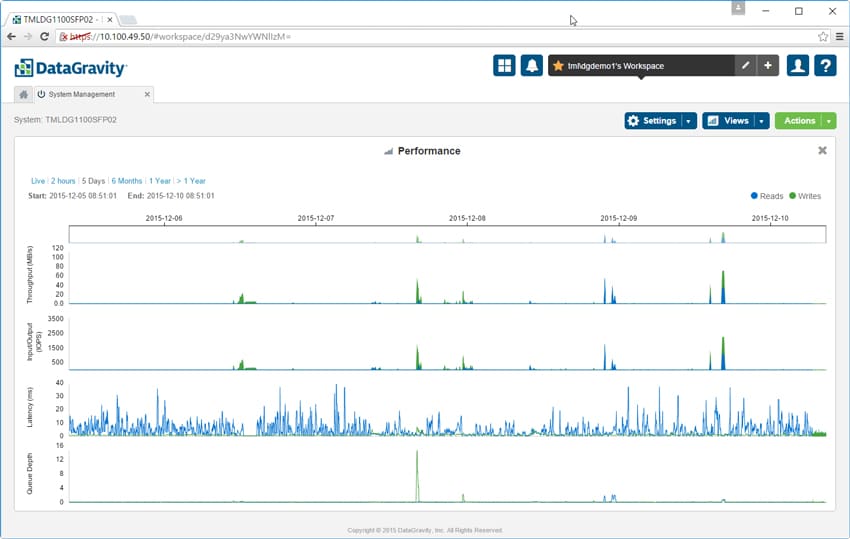
Er is ook een optie om de systeemprestaties te bekijken. De prestatieweergave toont zowel lees- als schrijf-I/O en biedt details zoals doorvoer in MB/s, IOPS, latentie en wachtrijdiepte. Gebruikers kunnen de prestaties over een bepaalde periode bekijken of de prestaties in realtime bekijken.
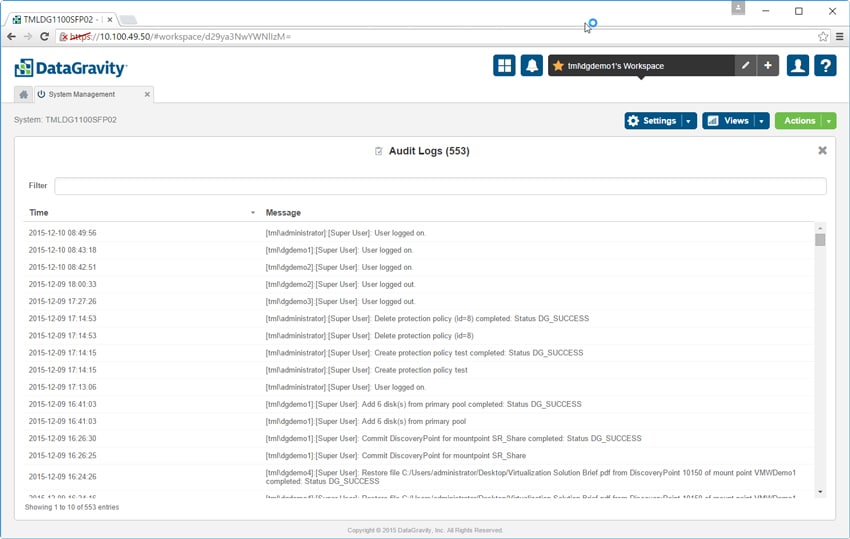
En ten slotte kunnen beheerders onder Systeembeheer de auditlogboeken bekijken. Ze kunnen niet alleen zien wie zich heeft aangemeld en wat ze van plan waren, de logboeken kunnen worden gefilterd om de toegang te vergemakkelijken en kunnen worden doorgestuurd naar een ander systeem voor verdere verwerking.
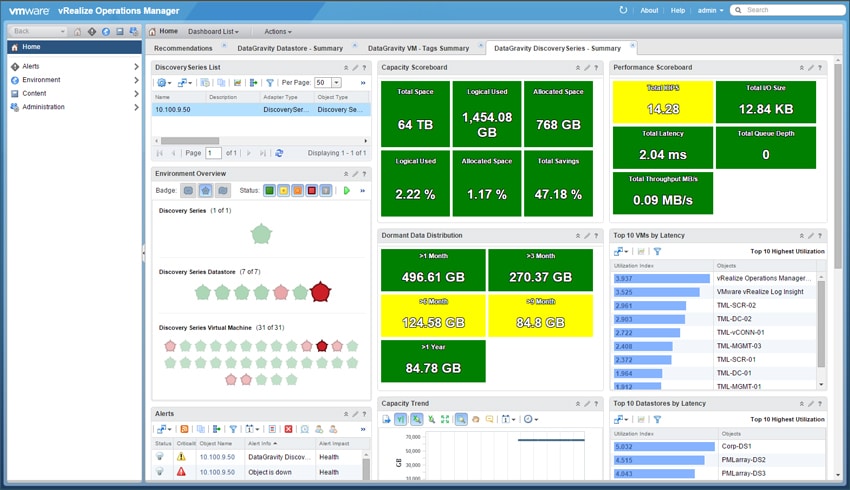
DataGravity kan ook worden geïntegreerd met VMware vRealize Operations Manager (vROPS) om de analyses van het DataGravity-systeem naar boven te halen in de gecentraliseerde console die vROPS biedt. DataGravity heeft niet per se een virtuele aanwezigheid, dus deze integratie geeft de virtualisatiebeheerder zicht op het systeem zonder ingelogd te zijn op de gebruikersinterface van DataGravity. Hoewel alle informatie aanwezig is, zijn datavisualisaties beperkt in vergelijking met de DataGravity GUI.
De vROPS-integratie geeft overzichtsweergaven weer van de Discovery Series, DataStore of VM. Hieronder ziet u een overzicht van het Discovery Series-overzichtsdashboard dat de algehele capaciteit en prestaties van het systeem laat zien, evenals de latentie voor de datastores en VM's die op het systeem zijn opgeslagen, met de risicoscore voor elk.
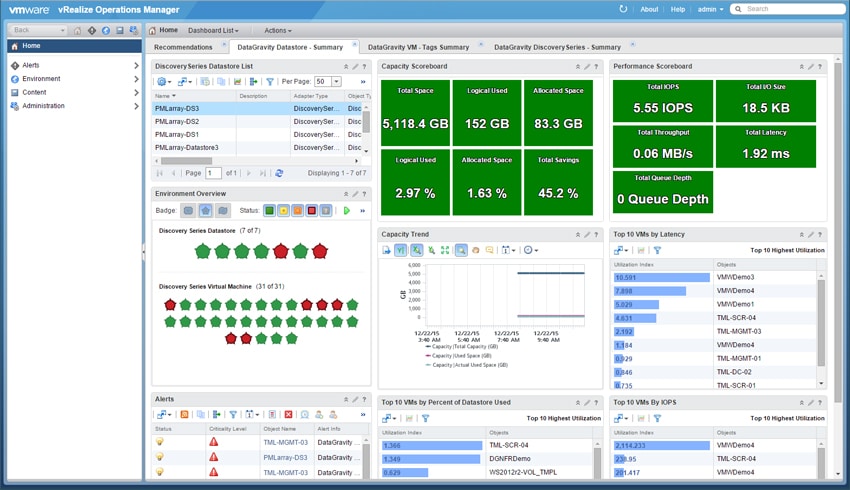
Bij het bekijken van het DataGravity Datastore Summary-dashboard worden vergelijkbare statistieken weergegeven voor DataGravity data-aware, NFS-datastores.
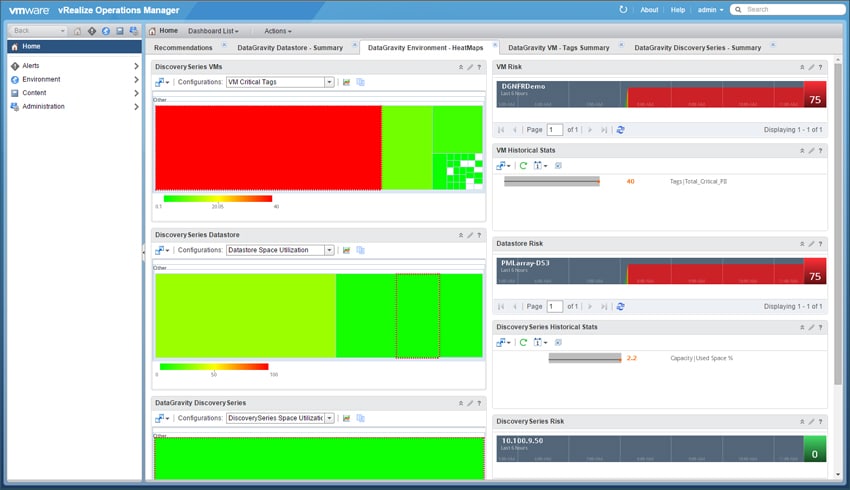
De vROPS-integratie geeft ook "heat"-kaarten weer die potentiële probleemgebieden tonen op basis van vooraf gedefinieerde waarden voor ruimtegebruik en kritieke intelligentietags die zijn gevonden in VM's, datastores en het Discovery Series-systeem.
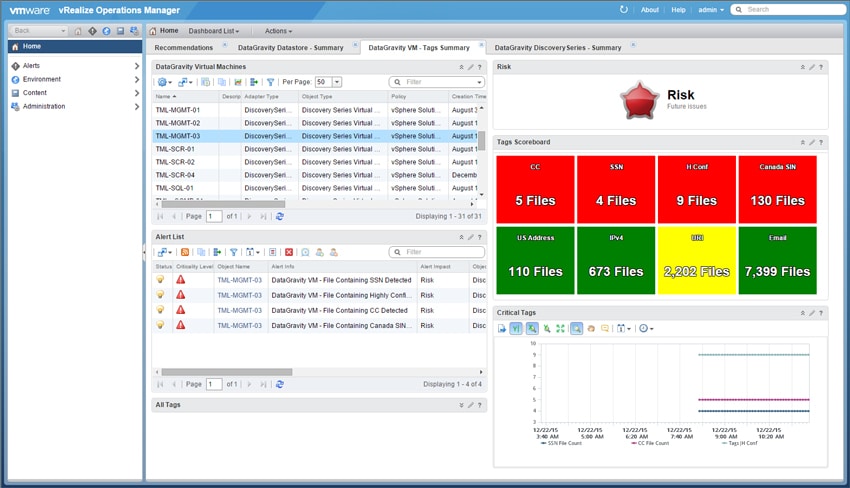
En virtualisatiebeheerders kunnen zien welke gegevens in welke VM gevaar lopen. Via het tagging-systeem kunnen ze zelfs specifieker zien welk type gegevens gevaar loopt.
Conclusie
De Discovery-serie van DataGravity is een opslagarray die de focus verlegt van pure prestaties en back-up- en herstelvensters naar databewustzijn. Met andere woorden, DataGravity heeft een systeem gebouwd dat gebruikers inzicht geeft in al hun gegevens via een gebruiksvriendelijke GUI. Het stelt gebruikers niet alleen in staat om te zien waar hun gegevens zich in het systeem bevinden, het geeft hen ook een diepgaande methode om de gegevens te volgen, wie er toegang toe heeft en of gevoelige gegevens mogelijk worden blootgesteld. Met DataGravity kunnen gebruikers de meeste bestandstypen taggen, wat helpt bij het snel lokaliseren en bewaken van specifieke gegevensbestanden. Dit kan niet alleen de gegevens van een bedrijf veiliger maken door problemen op te sporen (onbedoeld of kwaadwillig), het stelt een bedrijf ook in staat om al zijn opgeslagen gegevens volledig te gebruiken door inzicht te krijgen in de locatie van de gegevens, toegang, bewaarbehoeften en naleving.
Normaal gesproken kijken we bij StorageReview naar de onderliggende hardware en testen we de prestaties ervan door middel van een reeks benchmarks. In het geval van DataGravity is de software het sterkste verkoopargument. Hoewel het bedrijf meerdere capaciteiten biedt van 18 TB tot 96 TB, en ze een combinatie van RAM, NVRAM, SSD's en nearline HDD's in hun oplossing hebben, bestaat de onderliggende hardware om het DataGravity-analyseplatform te ondersteunen. Natuurlijk bestaat alle hardware om software te ondersteunen, maar de meeste leveranciers gebruiken de twee naast elkaar om klassieke opslagmogelijkheden te leveren. DataGravity beweert niet dat het de best presterende of de laagste latentie is. In plaats daarvan ligt de focus van DataGravity op databewustzijn en gebruiksgemak. Op dit punt blinkt het bedrijf duidelijk uit.
Het StorageReview-team ging ter plaatse om de oplossing uit te testen. Aangezien onze focus deze keer op bruikbaarheid lag, hadden we geen fysiek apparaat in ons lab nodig om onze prestatietests tegen uit te voeren. Voordat we aankwamen, nam DataGravity een groot deel van onze website-inhoud op in hun array, waardoor we gegevens kregen om te doorzoeken waarmee we goed vertrouwd waren. Met slechts een basisoverzicht van het systeem konden we de oplossing intuïtief gaan gebruiken om te zoeken naar trefwoorden in verschillende soorten bestanden, gedeelde mappen te maken, datapools opnieuw toe te wijzen en te zien hoe ons gebruik van de oplossing werd bijgehouden.
Uiteindelijk is wat DataGravity doet uitzonderlijk anders dan de rest van de opslagindustrie. Het ervaren team besloot om eerst de legitieme zakelijke pijn op te lossen, met inzicht in de naleving van de opslag als de haak. Deze nadruk op intelligentie is fundamenteel voor waar het bij DataGravity om draait, wat enorm verschilt van traditionele opslagaankopen die zijn gebaseerd op een capaciteits- of doorvoerbehoefte. Hoewel de DataGravity-benadering heel logisch is in gereguleerde sectoren, zag zelfs onze gebruikssituatie voor kleine bedrijven onmiddellijk voordelen toen we een diepgaand beeld kregen van zelfs maar een deel van onze naar buiten gerichte inhoud. Koppel dat inzicht aan hetzelfde voor home-mappen van gebruikers, gedeelde mappen voor werkgroepen en de rest van de bedrijfsmiddelen en de voordelen worden snel groter. Het is ook zeer intuïtief in gebruik, waardoor DataGravity goed past bij kleine of overbelaste IT-winkels.
The Bottom Line
DataGravity's Discovery Series stelt bedrijven in staat om volledig gebruik te maken van al hun gegevens terwijl ze veilig en bruikbaar blijven via een gebruiksvriendelijke interface. De nadruk op analyse en zichtbaarheid van gegevens is echt uniek in de opslagindustrie, waardoor DataGravity een belangrijk onderscheidend vermogen heeft in een sector die vaak een gebrek aan creativiteit heeft.


 Amazon