

Intels Project Battlematrix vertegenwoordigt een aantrekkelijk aanbod voor toegankelijke AI-infrastructuur en biedt aanzienlijke GPU-geheugencapaciteit voor werkstationbehuizingen via een multi-GPU-ontwerp. Dit platform, gebouwd rond de codenaam Battlemage Arc Pro B60 professionele GPU, richt zich op organisaties die grote taalmodellen lokaal willen implementeren zonder cloudabonnementskosten of zorgen over gegevensprivacy. Met maximaal 192 GB VRAM verdeeld over acht GPU's in één systeem, positioneert Battlematrix zich als een relatief kosteneffectief alternatief voor andere professionele GPU-ecosystemen voor AI-inferentieworkloads.
Bekijk dit bericht op Instagram
Wat Battlematrix onderscheidt van traditionele workstationconfiguraties, is Intels dual-GPU-kaartontwerp, waarbij twee volledige B60 GPU's op één printplaat worden geplaatst en PCIe-bifurcatieondersteuning nodig is. Deze dichtheidsgeoptimaliseerde aanpak maakt configuraties mogelijk die anders servermoederborden zouden vereisen, terwijl de 24 GB GDDR6 per GPU van de Arc Pro B60 hem bijzonder geschikt maakt voor geheugenintensieve transformatormodellen. Eerste tests tonen veelbelovende mogelijkheden, hoewel software-optimalisatie nog steeds achterblijft bij de mogelijkheden van de hardware.
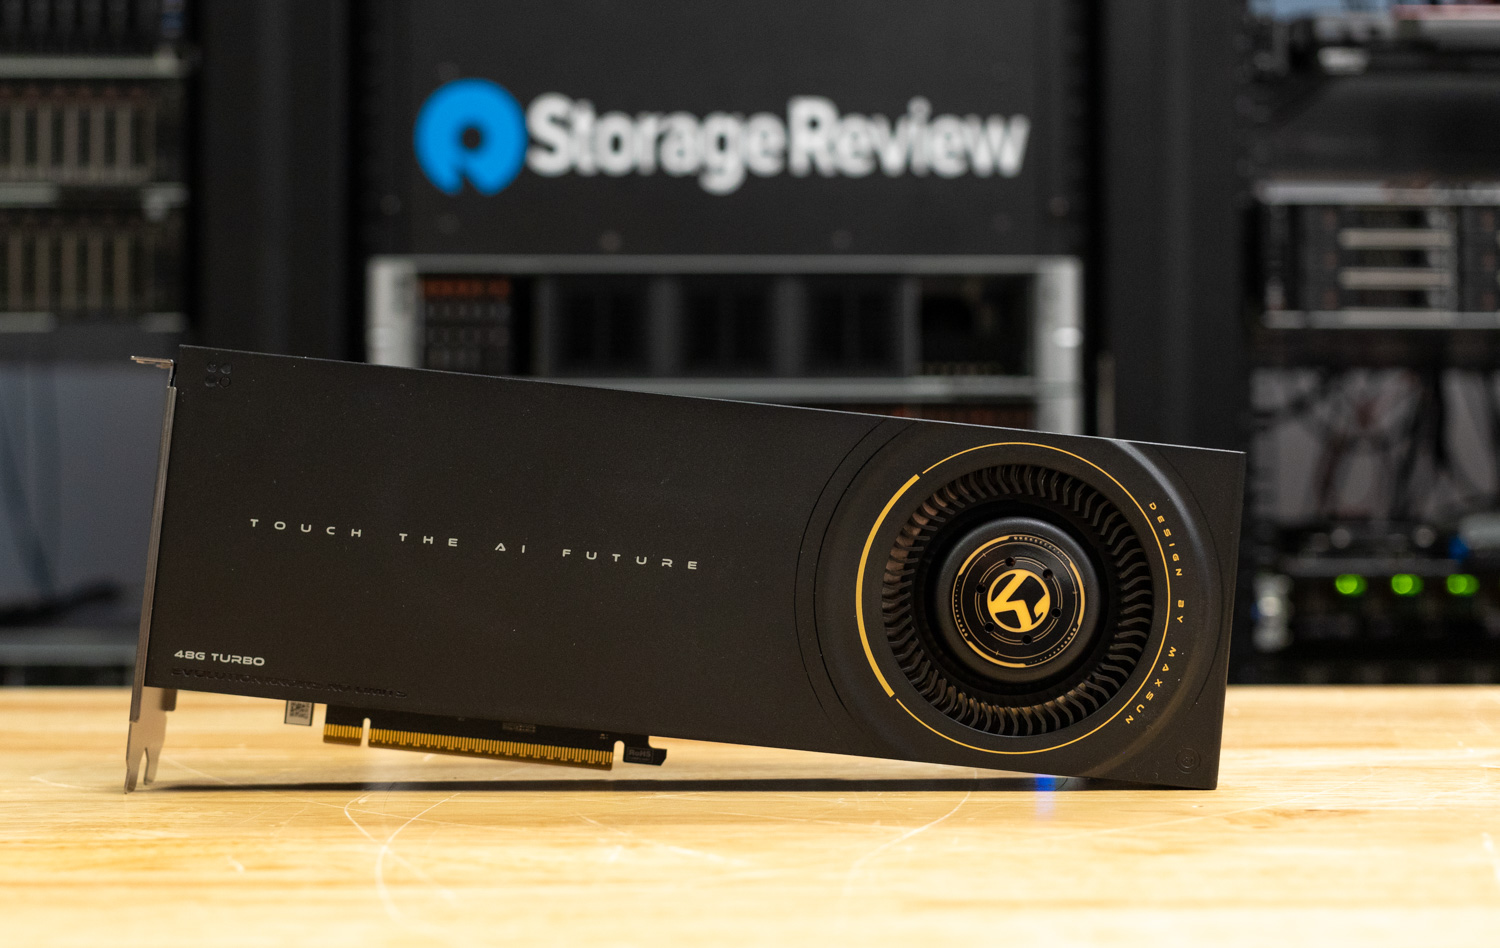
openbaring
De tests zijn uitgevoerd met eerdere software- en driverrevisies, waaronder de ontwikkeltakken van Intel LLM Scaler. Bovendien maakt ons testplatform gebruik van AMD EPYC-processors in plaats van Intels Xeon-platform. Intel positioneert Battlematrix als een volledig Intel-oplossing met Xeon 6-processors, en productiesystemen met Intel CPU's kunnen hogere prestaties leveren dan onze resultaten suggereren. Lezers dienen deze resultaten voorlopig te overwegen, in de wetenschap dat de softwarevolwassenheid en platformoptimalisatie in de loop van 2026 zullen verbeteren.
Specificaties en architectuur
| Specificaties | Detail |
|---|---|
| Product collectie | Intel® Arc™ Pro B-serie grafische kaart |
| Codenaam | battlemage |
| GPU-architectuur | Xe2 (TSMC N5) |
| Xe-kleuren | 20 |
| Geef segmenten weer | 5 |
| Ray-tracing-eenheden | 20 |
| XMX-motoren | 160 |
| Xe Vector Engines | 160 |
| Grafische klok | 2400 MHz |
| Grafische klok (LP-modus) | 2000 MHz |
| GPU FP32-prestaties | 12.28 TFLOPS |
| GPU Peak TOPS (INT8) | 197 |
| Totaal bordvermogen (TBP) | 200w |
| Geheugen | 24 GB GDDR6 |
| Geheugeninterface | 192-bit |
| Geheugenbandbreedte | 456 GB / s |
| Geheugensnelheid | 19 Gbps |
| PCIe-interface | PCIe 5.0 x8 |
| Ondersteunde schermen | 4 |
| Grafische uitvoer | HDMI 2.1 | DP2.1 (UHBR 13.5) | DP2.1 (UHBR10) |
| Maximale resolutie (HDMI) | 7680 x 4320 @ 120Hz |
| Maximale resolutie (DP) | 7680 x 4320 @ 60Hz |
| HDMI variabele vernieuwingsfrequentie | Ja |
| VESA adaptieve synchronisatie | Ja |
| H.264 / H.265 / AV1 coderen/decoderen | Ja |
| Ray Tracing-ondersteuning | Ja |
| oneAPI-ondersteuning | Ja |
| OpenVINO-ondersteuning | Ja |
| Intel IPEX-ondersteuning | Ja |
| Intel XeSS-ondersteuning | Ja |
De Intel Arc Pro B60 deelt zijn siliciumfundament met de op gaming gerichte Intel Arc B580, beide gebruikmakend van dezelfde chip, geproduceerd met behulp van TSMC's 5nm-proces. Deze 272mm² chip bevat 19.6 miljard transistors en integreert 20 Xe2-cores, die naar verwachting 12.28 TFLOPS FP32-computing en 197 TOPS INT8 AI-prestaties per GPU leveren. Het cruciale verschil zit in de geheugenconfiguratie: terwijl de B580 wordt geleverd met 12 GB GDDR6, verdubbelt de B60 de capaciteit tot 24 GB.
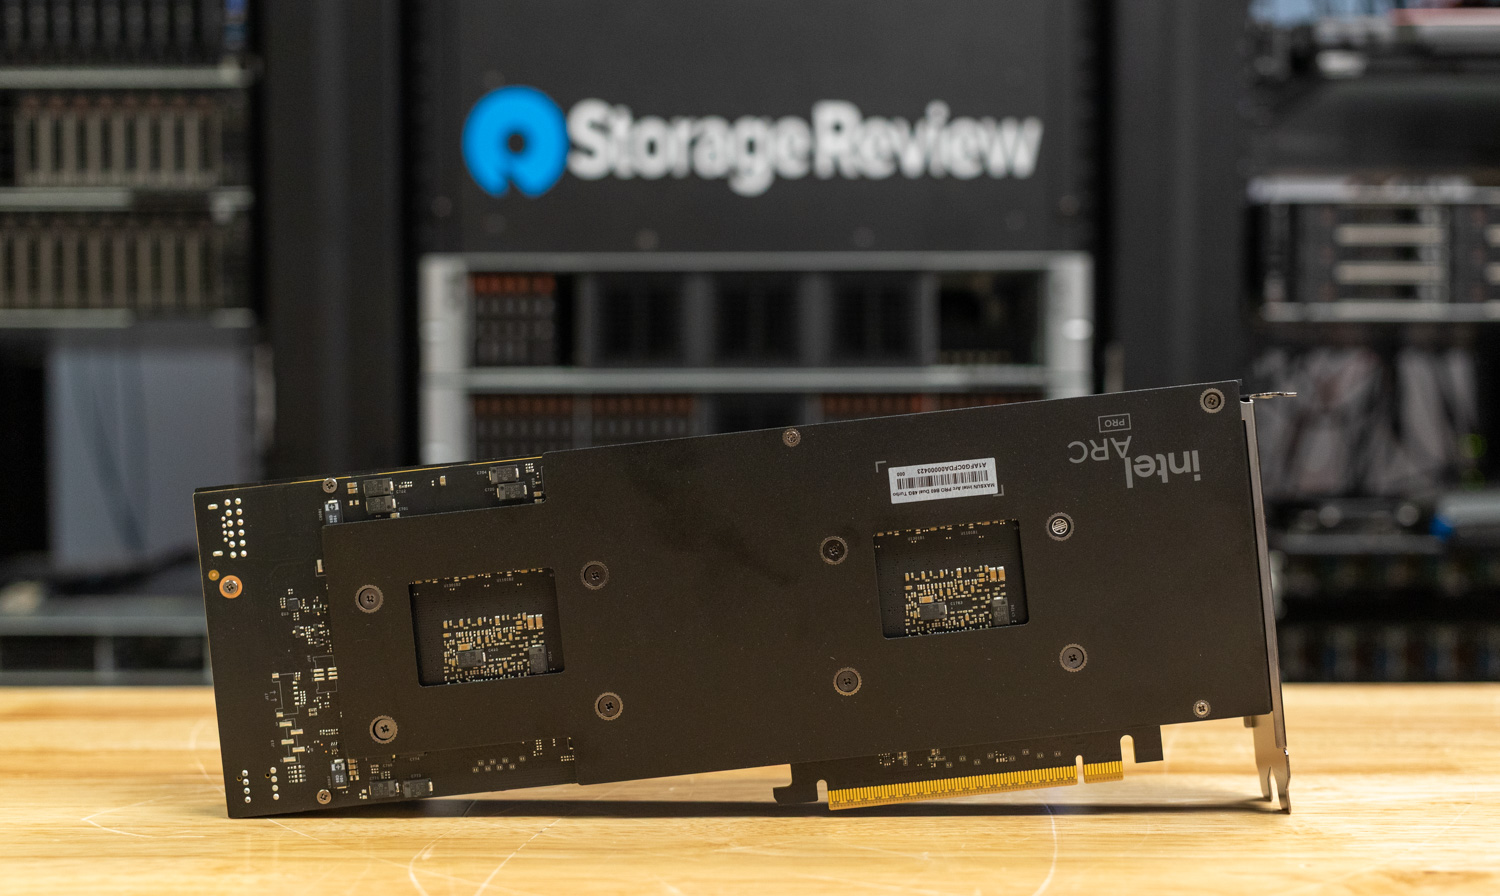
Elke B60 GPU werkt op 2,400 MHz via een 192-bits geheugeninterface en biedt een bandbreedte van 456 GB/s per GPU. De architectuur beschikt over 160 XMX (Xe Matrix Extensions) AI-engines per GPU, speciaal ontwikkeld voor het versnellen van matrixbewerkingen bij AI-inferentie.
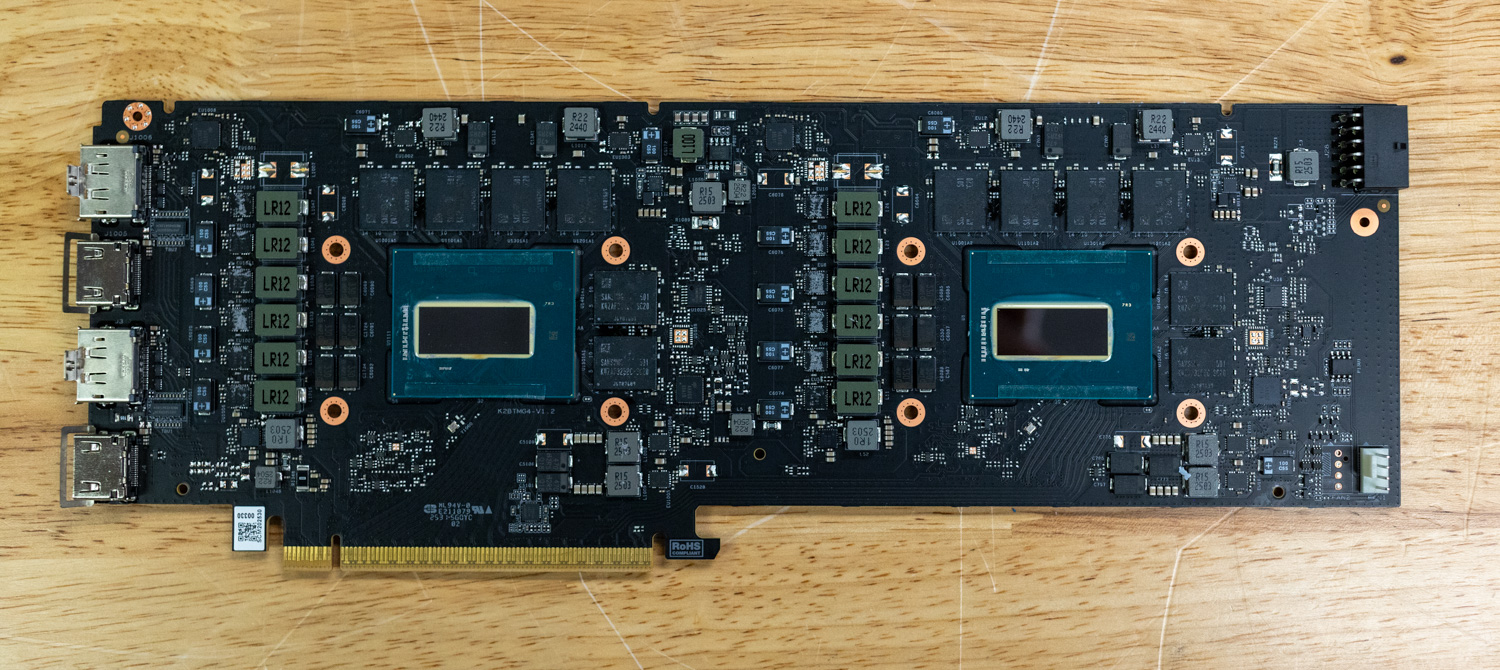
Dual GPU-ontwerp en PCIe-bifurcatie
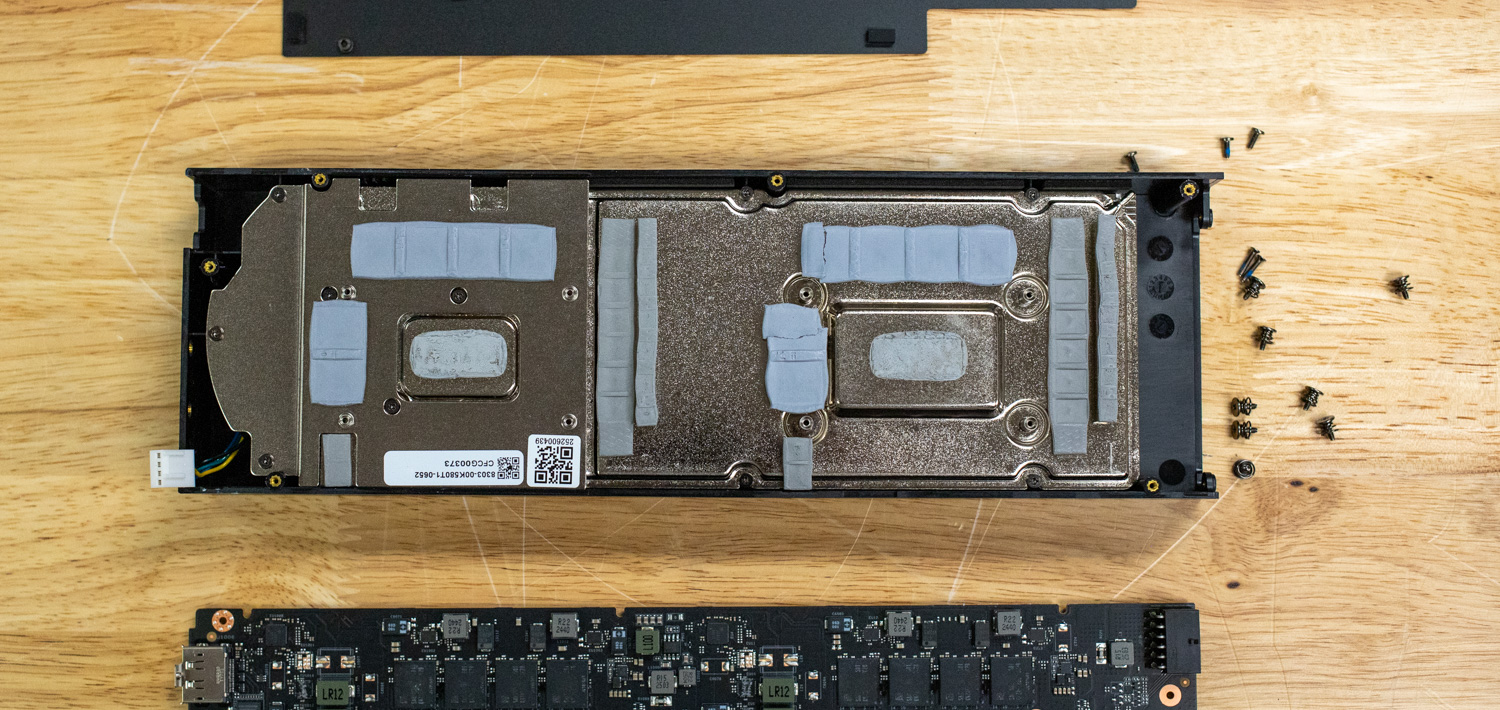
De Maxsun Arc Pro B60 Dual 48G Turbo is een perfect voorbeeld van Intels strategie voor hoge dichtheid: twee complete GPU's gemonteerd op één dual-slot kaart, onafhankelijk verbonden via PCIe 5.0 x8-interfaces. In tegenstelling tot traditionele dual-GPU-ontwerpen waarbij chips worden overbrugd om als één GPU te functioneren, presenteert elke B60 GPU zich als een afzonderlijk apparaat aan het systeem, waardoor moederbordondersteuning voor PCIe x8/x8-bifurcatie vereist is. Een enkel x16-slot splitst zich elektrisch in twee x8-verbindingen, waarbij elke GPU een eigen bandbreedte krijgt.
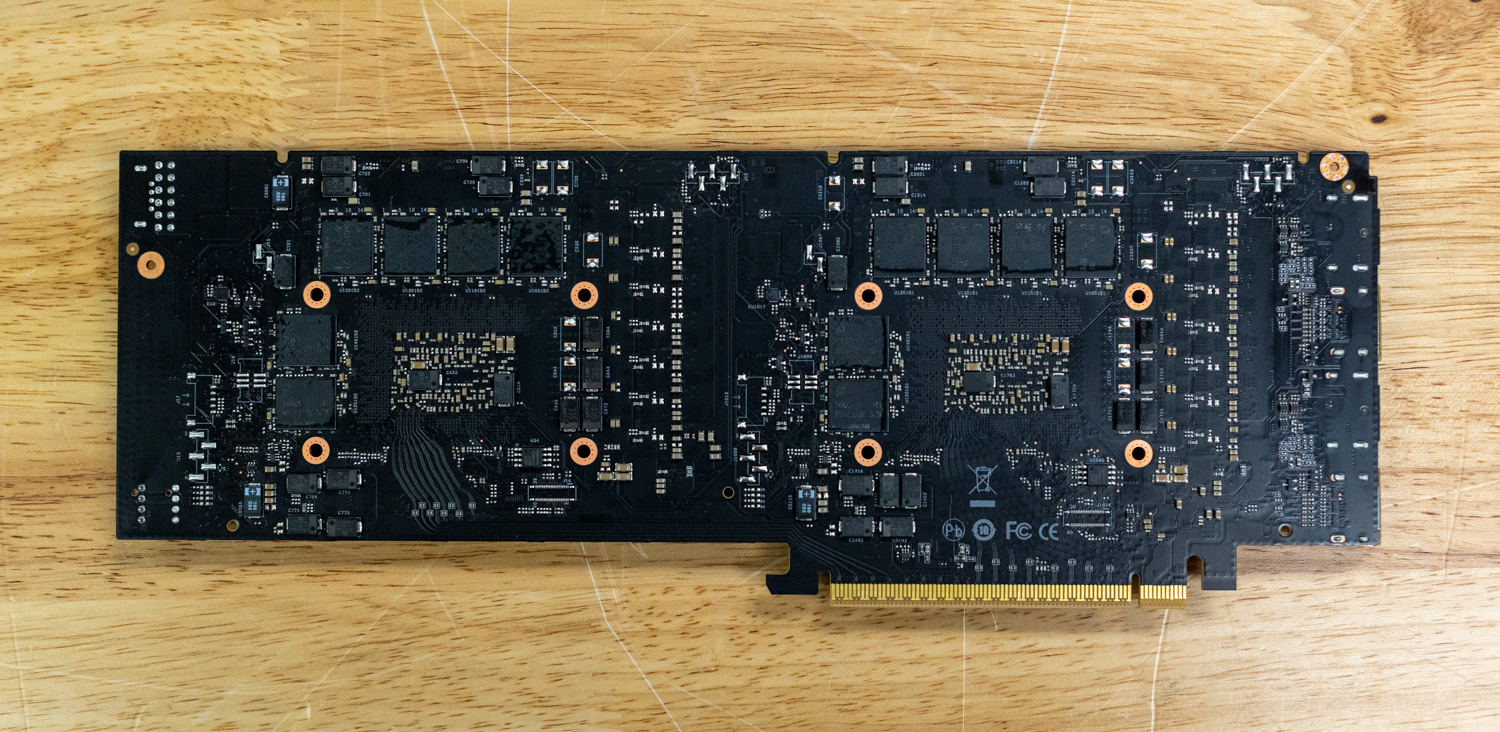
PCIe 5.0 x8 levert een bidirectionele bandbreedte van 128 GB/s per GPU, wat overeenkomt met PCIe 4.0 x16. De configuratie met twee kaarten is 300 mm lang, neemt twee slots in beslag met blower-koeling en verbruikt in totaal 400 W aan stroom via een enkele 12V-2×6-connector met een nominale waarde van 600 W.
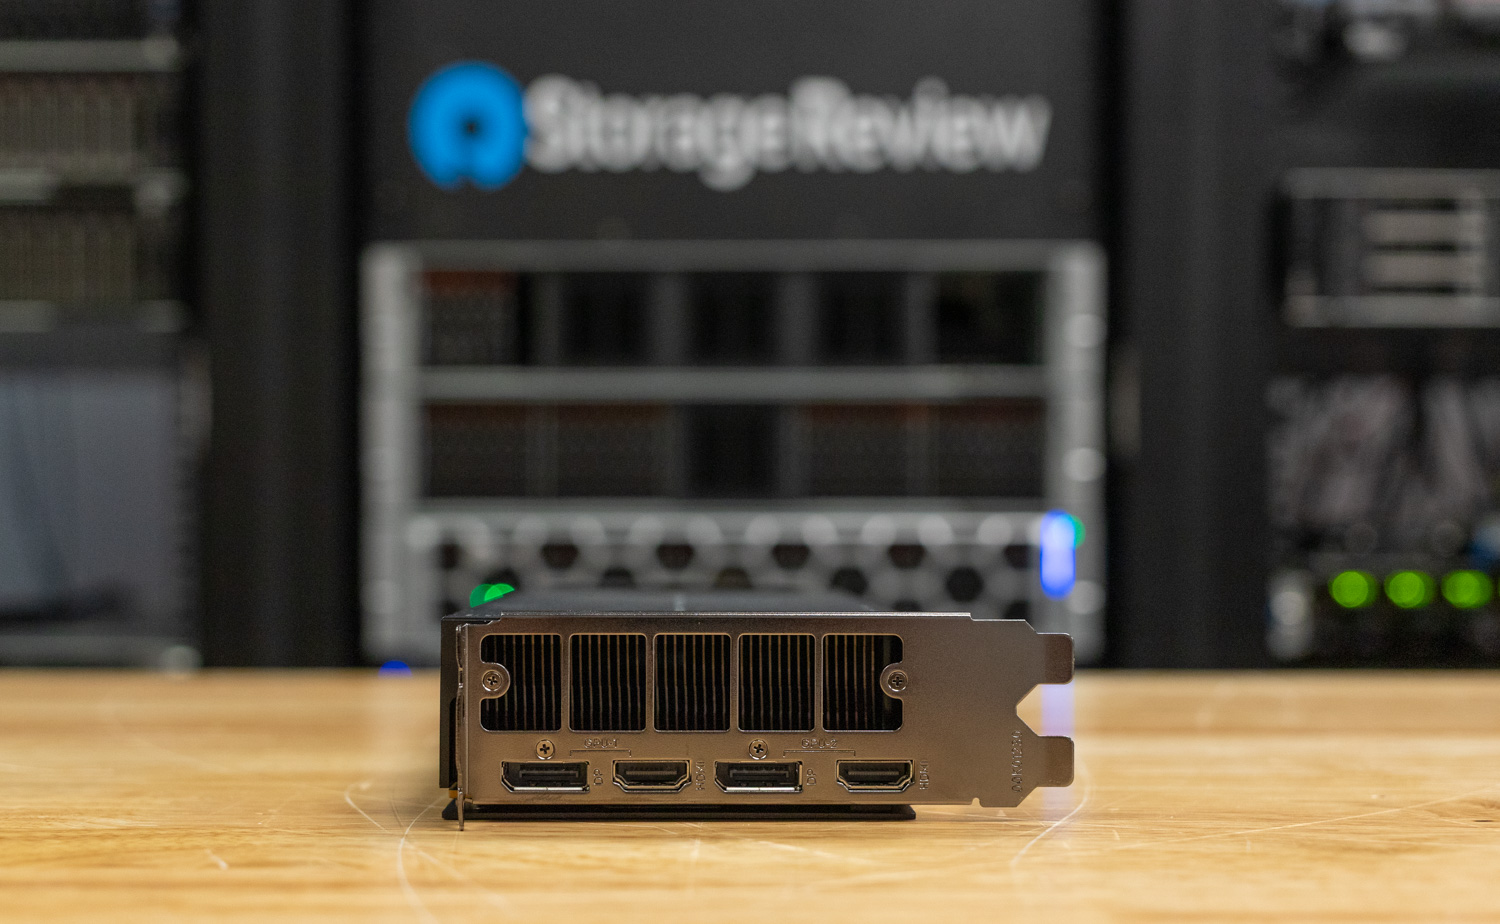
Elke dubbele kaart biedt vier beeldschermuitgangen: twee DisplayPort 2.1 UHBR20- en twee HDMI 2.1a-poorten, één set per GPU, waardoor afzonderlijke video-uitgangsconfiguraties mogelijk zijn voor gevirtualiseerde desktopomgevingen of systemen met meerdere gebruikers. Belangrijk om te weten is dat slechts één van de twee beeldschermuitgangen tegelijk per GPU kan worden gebruikt.
Bekijk dit bericht op Instagram
Acht GPU Battlematrix-configuratie
De referentiespecificatie van Intel voor de Battlematrix ondersteunt tot acht Arc Pro B60 GPU's in een workstationbehuizing, door gebruik te maken van vier dual-GPU-kaarten. Deze configuratie levert het volgende op:
- 192 GB totaal systeem-VRAM (8 × 24 GB)
- 1,280 XMX AI-engines
- 1,576 INT8 TOPS aggregaat berekenen
- 3.6 TB/s gecombineerde geheugenbandbreedte
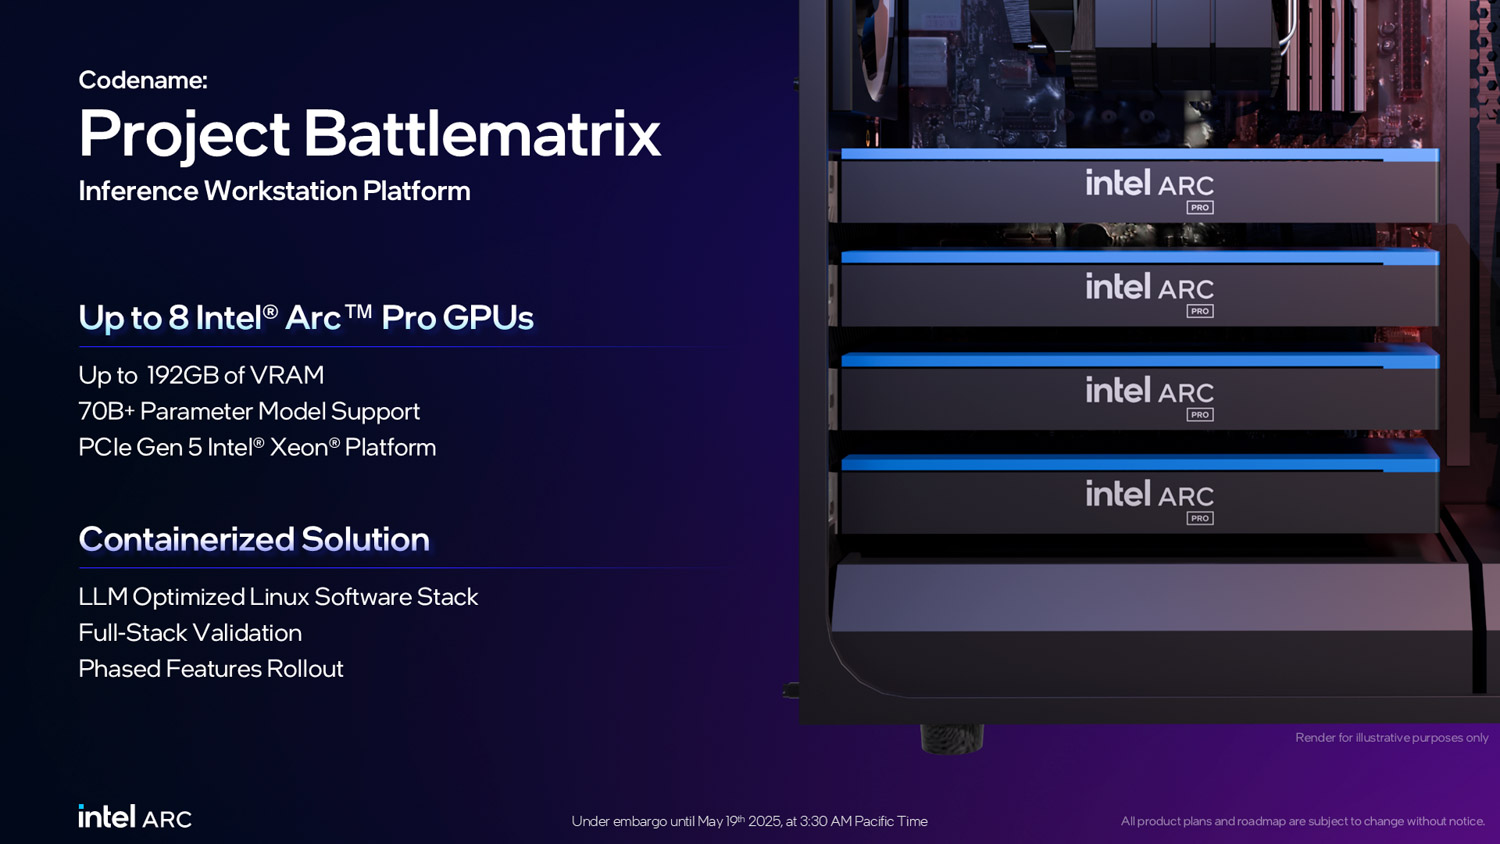
Voor het platform zijn moederborden nodig met vier PCIe 5.0 x16-slots die bifurcatie ondersteunen. De Battlematrix-specificatie omvat daarnaast een Xeon 6-processor. Meer informatie over de Battlematrix-configuratie is momenteel echter niet beschikbaar.
Gebruiksscenario's en waardepropositie
Doelgroep
Intels Project Battlematrix richt zich op drie marktsegmenten: AI-ontwikkelteams die on-premise infrastructuur nodig hebben, software engineering-organisaties die AI-ondersteunde workflows met gevoelige codebases implementeren, en organisaties die op zoek zijn naar kosteneffectieve alternatieven voor cloudgebaseerde inferentiediensten. De kernwaarde van het platform is gericht op datasoevereiniteit en voordelen op het gebied van totale eigendomskosten ten opzichte van meerjarige cloudabonnementen.
Private AI en Agent Development
De belangrijkste kracht van het Battlematrix-platform ligt in de ondersteuning van ontwikkelworkflows voor grote taalmodellen die uitgebreide contextvensters en een groot aantal parameters vereisen.
Ontwikkelteams die agentische systemen bouwen, profiteren met name van de beschikbare geheugenruimte. Implementaties van RAG-agenten onderhouden doorgaans meerdere componenten tegelijkertijd in het GPU-geheugen: het basistaalmodel, embeddingmodellen voor vectorzoekopdrachten en rerankingmodellen. Daarnaast voeren agentische workflows meerstapsredeneringen, toolgebruik en zelfcorrectie uit, waardoor aanzienlijke contextvensters worden gegenereerd door iteratie. Een codeeragent die een grote codebase analyseert, kan gedurende zijn operationele levenscyclus meer dan 100 tokens verzamelen.
Toekomstige VDI en gevirtualiseerde gaming
Intel's roadmap omvat het mogelijk maken van SR-IOV (Single Root I/O Virtualization)-ondersteuning op Arc Pro B60 GPU's, waardoor de hardware wordt getransformeerd tot een grafisch platform voor meerdere gebruikers. SR-IOV maakt het mogelijk om een fysieke GPU op te splitsen in meerdere virtuele GPU's, die elk kunnen worden toegewezen aan aparte virtuele machines met directe hardwaretoegang en geïsoleerde geheugenruimtes.
Deze mogelijkheid maakt licentievrije Virtual Desktop Infrastructure-scenario's mogelijk, waarin één Battlematrix-systeem met acht GPU's tientallen gelijktijdige gebruikers ondersteunt met speciale GPU-versnelling voor CAD-toepassingen, videobewerking of gematigd gamen. Traditionele VDI-oplossingen vereisen hoge licentiekosten bovenop de hardwarekosten, waarvoor vaak duurdere professionele of datacenter-GPU's nodig zijn. Intels toewijding aan licentievrije virtualisatie elimineert deze operationele kosten.
Prijzen en waardepropositie
Intel heeft aangekondigd dat de Arc Pro B60 rond de $ 600 per GPU zal kosten. Voor de eerste tests en ontwikkeling bieden configuraties met één of twee kaarten ($ 600 tot $ 1,200) toegankelijke instappunten. Een enkele kaart met twee GPU's en 48 GB VRAM biedt voldoende capaciteit voor gekwantiseerde modellen en dekt een aanzienlijk deel van de populaire open-source LLM-toepassingen.
De Maxsun Dual Arc Pro B60 Dual 48G Turbo-configuratie die we testten, kost $ 1,200 rechtstreeks bij Maxsun, in lijn met de oorspronkelijke aankondiging van Intel. Recente schommelingen in geheugenprijzen kunnen hier echter invloed op hebben.
Uitzonderlijke waarde bij instapprijzen
De configuraties met één of twee kaarten bieden aantrekkelijke economische voordelen voor kleine teams, individuele ontwikkelaars en thuiswerkers. Met $ 600 voor 24 GB GPU-geheugen en $ 1,200 voor 48 GB is dit platform aanzienlijk goedkoper dan professionele GPU-alternatieven, die meestal minstens twee keer zo duur zijn.
Deze waardepropositie is met name interessant voor organisaties die AI-integratie onderzoeken zonder dat ze hiervoor een groot budget hoeven te betalen.
vLLM Online Serving Benchmark Prestaties
vLLM is de populairste high-throughput inferentie- en serverengine voor LLM's. De vLLM online serverbenchmark is een prestatie-evaluatietool die real-world serverprestaties meet bij gelijktijdige aanvragen. Het simuleert productieworkloads door aanvragen te versturen naar een actieve vLLM-server met configureerbare parameters zoals aanvraagsnelheid, invoer-/uitvoerlengte en het aantal gelijktijdige clients. De benchmark meet belangrijke statistieken, waaronder doorvoer (tokens per seconde), tijd tot eerste token (TTFT) en tijd per uitvoertoken (TPOT), waardoor gebruikers beter begrijpen hoe vLLM presteert onder verschillende belastingsomstandigheden.
Testplatform:
- server: Supermicro AS-4125GS-TNRT
- processoren: AMD EPYC9374F
- Geheugen: 512 GB Samsung 4800 MT/s DDR5
- GPU's: 4x Maxsun MS-Intel ARC Pro B60 Dual 48G Turbo
Ondersteuning en beperkingen van kwantificering
Deze GPU's zouden moeten uitblinken in lage-precisie-inferentie gericht op INT4-kwantisering voor optimale prestaties. Vanwege de zeer vroege ontwikkelingsversie van Intel's LLM Scaler die we testten, functioneerden echter alleen de GPT OSS-modellen die aanvankelijk waren getraind met het MXFP4-microschalingsformaat correct. Andere kwantiseringsformaten, waaronder standaard INT4, FP8 en AWQ, startten niet volledig op. Deze beperking beperkte ons aanzienlijk in onze mogelijkheid om deze GPU's grondig te testen, hoewel we een bredere ondersteuning voor kwantisering verwachten naarmate de softwarestack zich verder ontwikkelt.
We hebben de meeste modellen getest met twee configuraties: de volledige Battlematrix-opstelling met acht GPU's en het minimale aantal GPU's dat nodig is om het model in het geheugen te plaatsen. Deze vergelijking laat interessante schaalkenmerken zien, met name wat betreft communicatieoverhead bij lagere batchgroottes.
Microschaling-gegevenstypen
Microscaling is een geavanceerde kwantiseringsmethode die fijnmazige schaalfactoren toepast op kleine blokken gewichten in plaats van uniforme kwantisering over grote parametergroepen. Het MXFP4-formaat implementeert deze techniek met behulp van een geblokkeerde floating-point representatie, waarbij elk microschaalblok een gemeenschappelijke exponent als schaalfactor deelt. Dit zorgt voor behoud van numerieke precisie en een precisie van 4 bits. Een belangrijk voordeel van het MXFP4-gegevenstype is dat het kwantiseren van modellen naar INT4 de responskwaliteit niet ernstig aantast, in tegenstelling tot kwantisering vanuit formaten met hogere precisie zoals BF16. De GPT OSS-modellen worden uitgevoerd met INT4-kwantisering op de B60's, omdat deze geen native ondersteuning bieden voor MXFP4.
OpenAI GPT-OSS 20B
Het 20B-parametermodel toont duidelijk het fenomeen van communicatieoverhead aan. Bij een batchgrootte van 1 levert een enkele GPU 49.22 tok/s per gebruiker, vergeleken met slechts 22.83 tok/s wanneer verdeeld over alle acht GPU's. De configuratie met één GPU presteert meer dan 2x beter. De configuratie met acht GPU's blinkt echter uit in een hogere gelijktijdigheid, met een totale doorvoer van 511.99 tok/s bij een batchgrootte van 16.
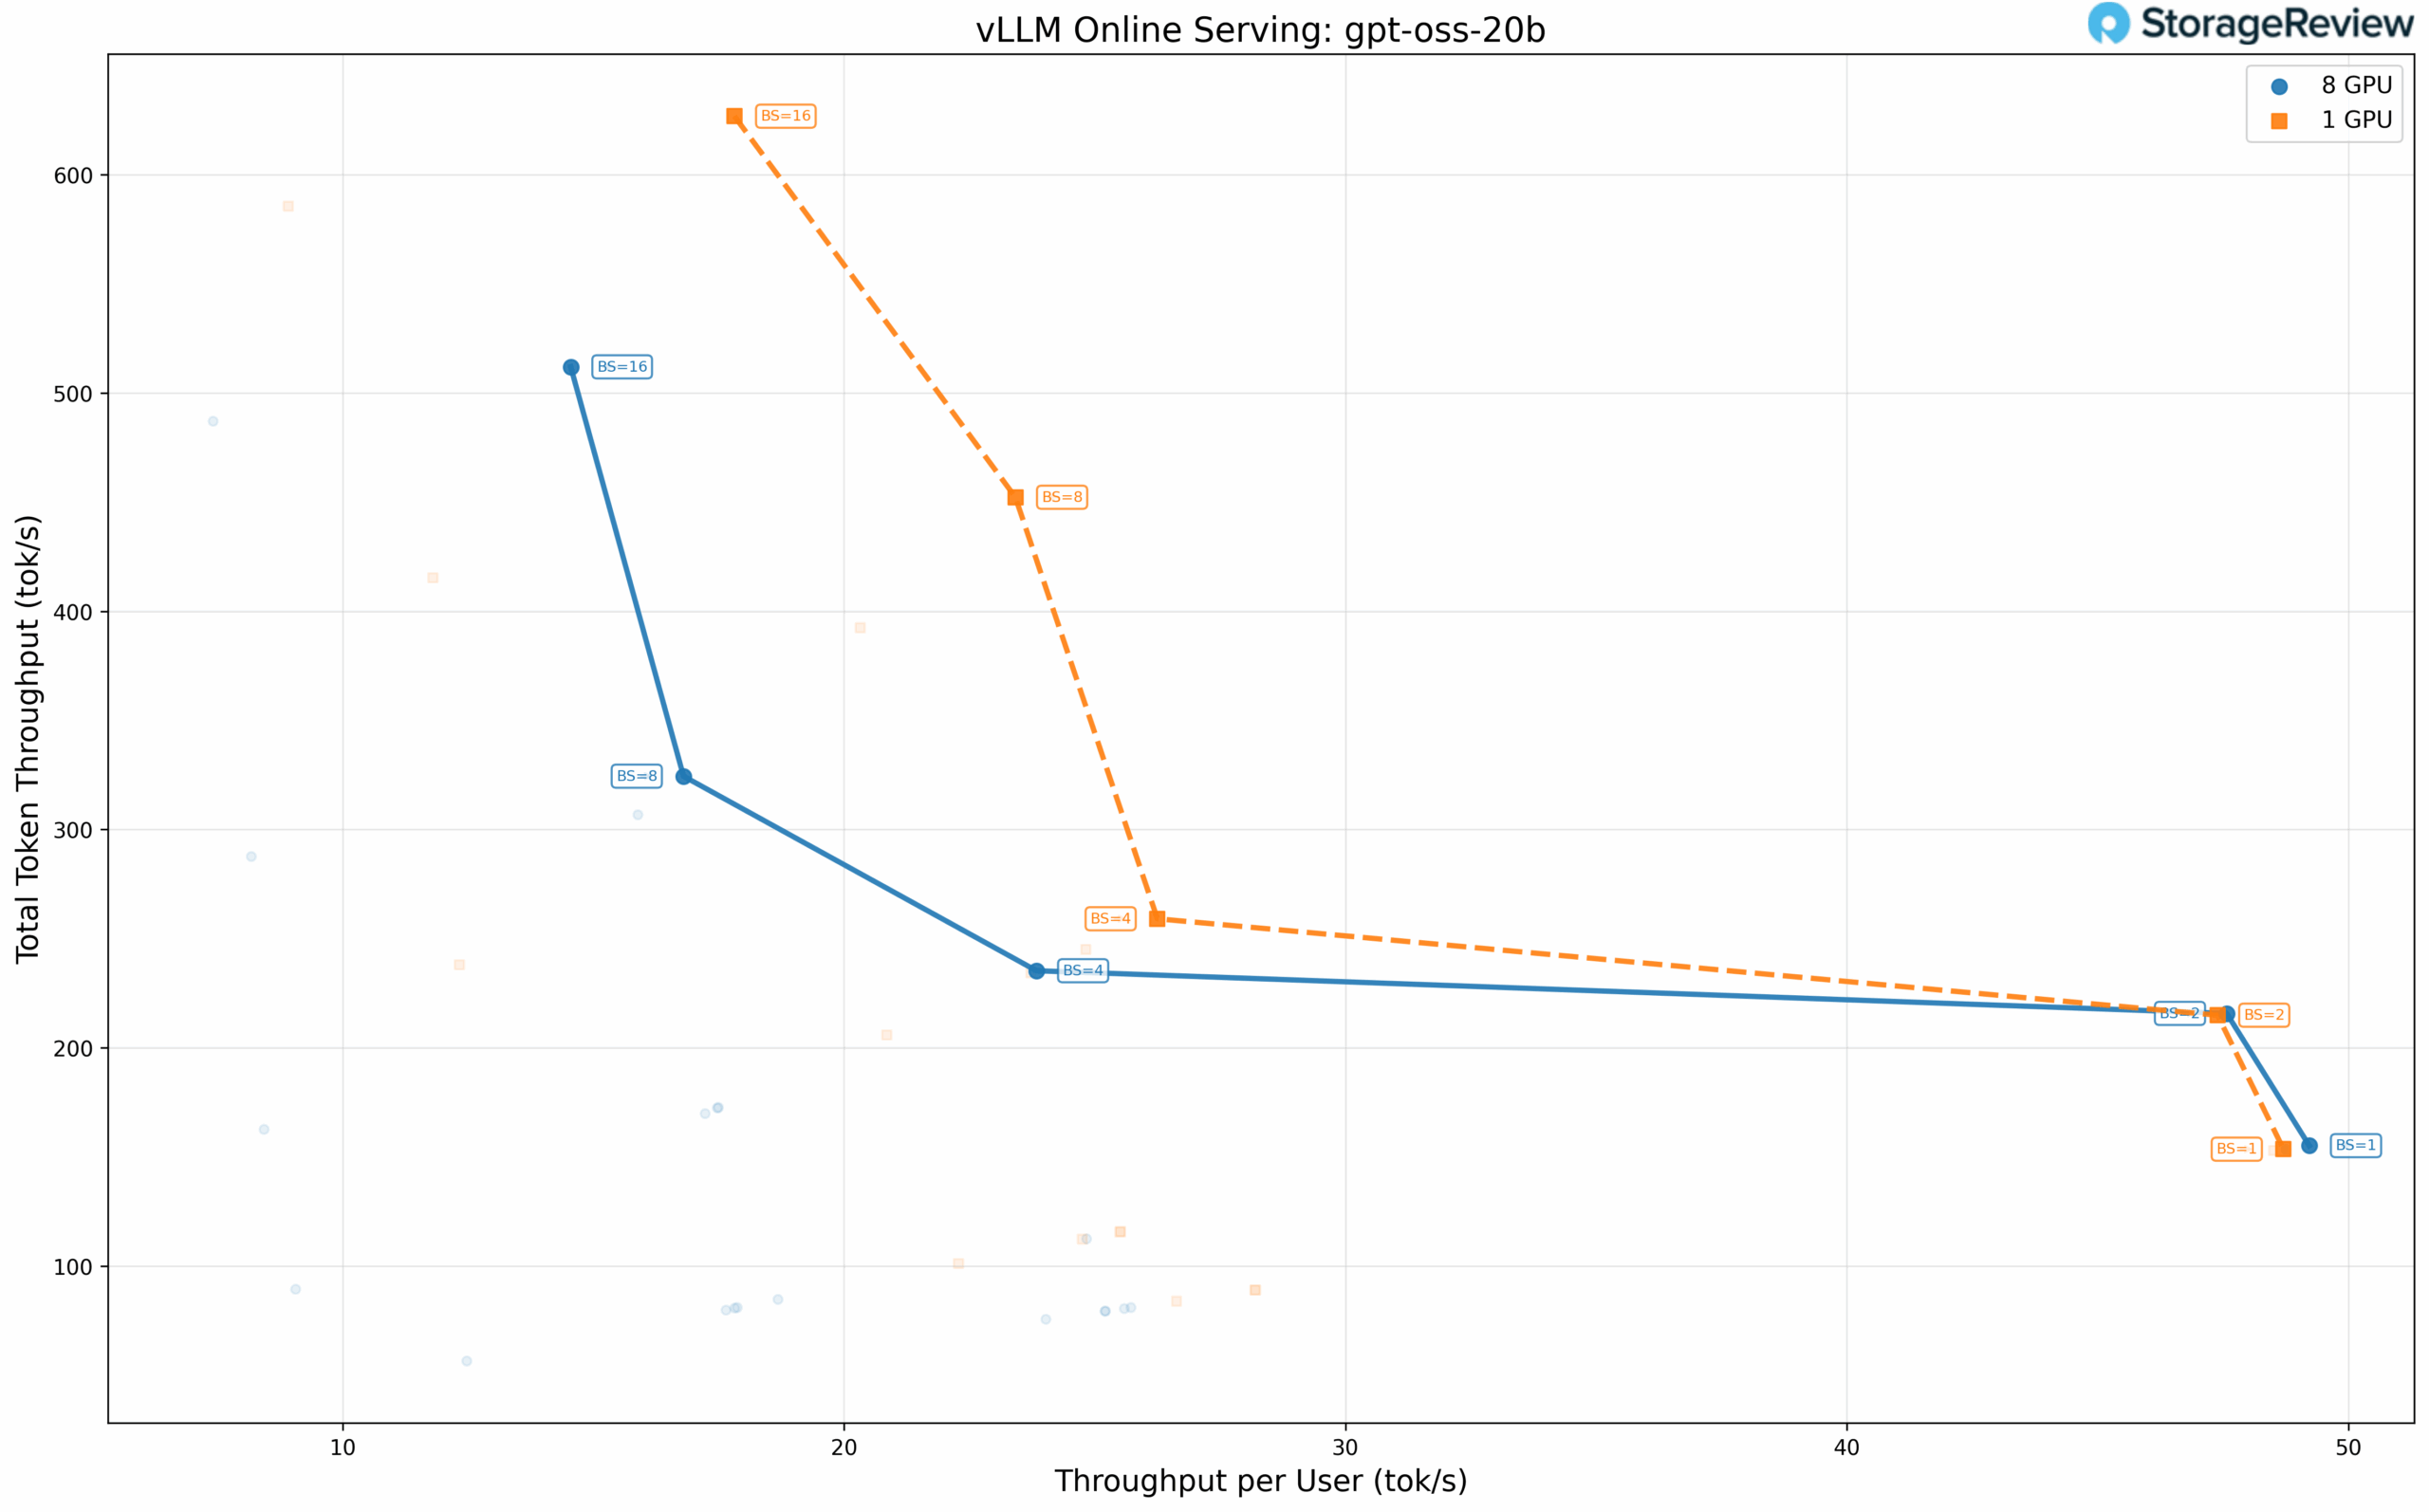 De minimale GPU-configuratie behaalt daadwerkelijk een hogere totale doorvoer bij batchgrootte 16: 626.84 tok/s met TP=4 versus 511.99 tok/s met TP=8. Dit onlogische resultaat onderstreept dat voor modellen en contextlengtes die comfortabel op minder GPU's passen, het toevoegen van meer hardware communicatieoverhead introduceert zonder evenredige prestatieverbetering.
OpenAI GPT-OSS 120B
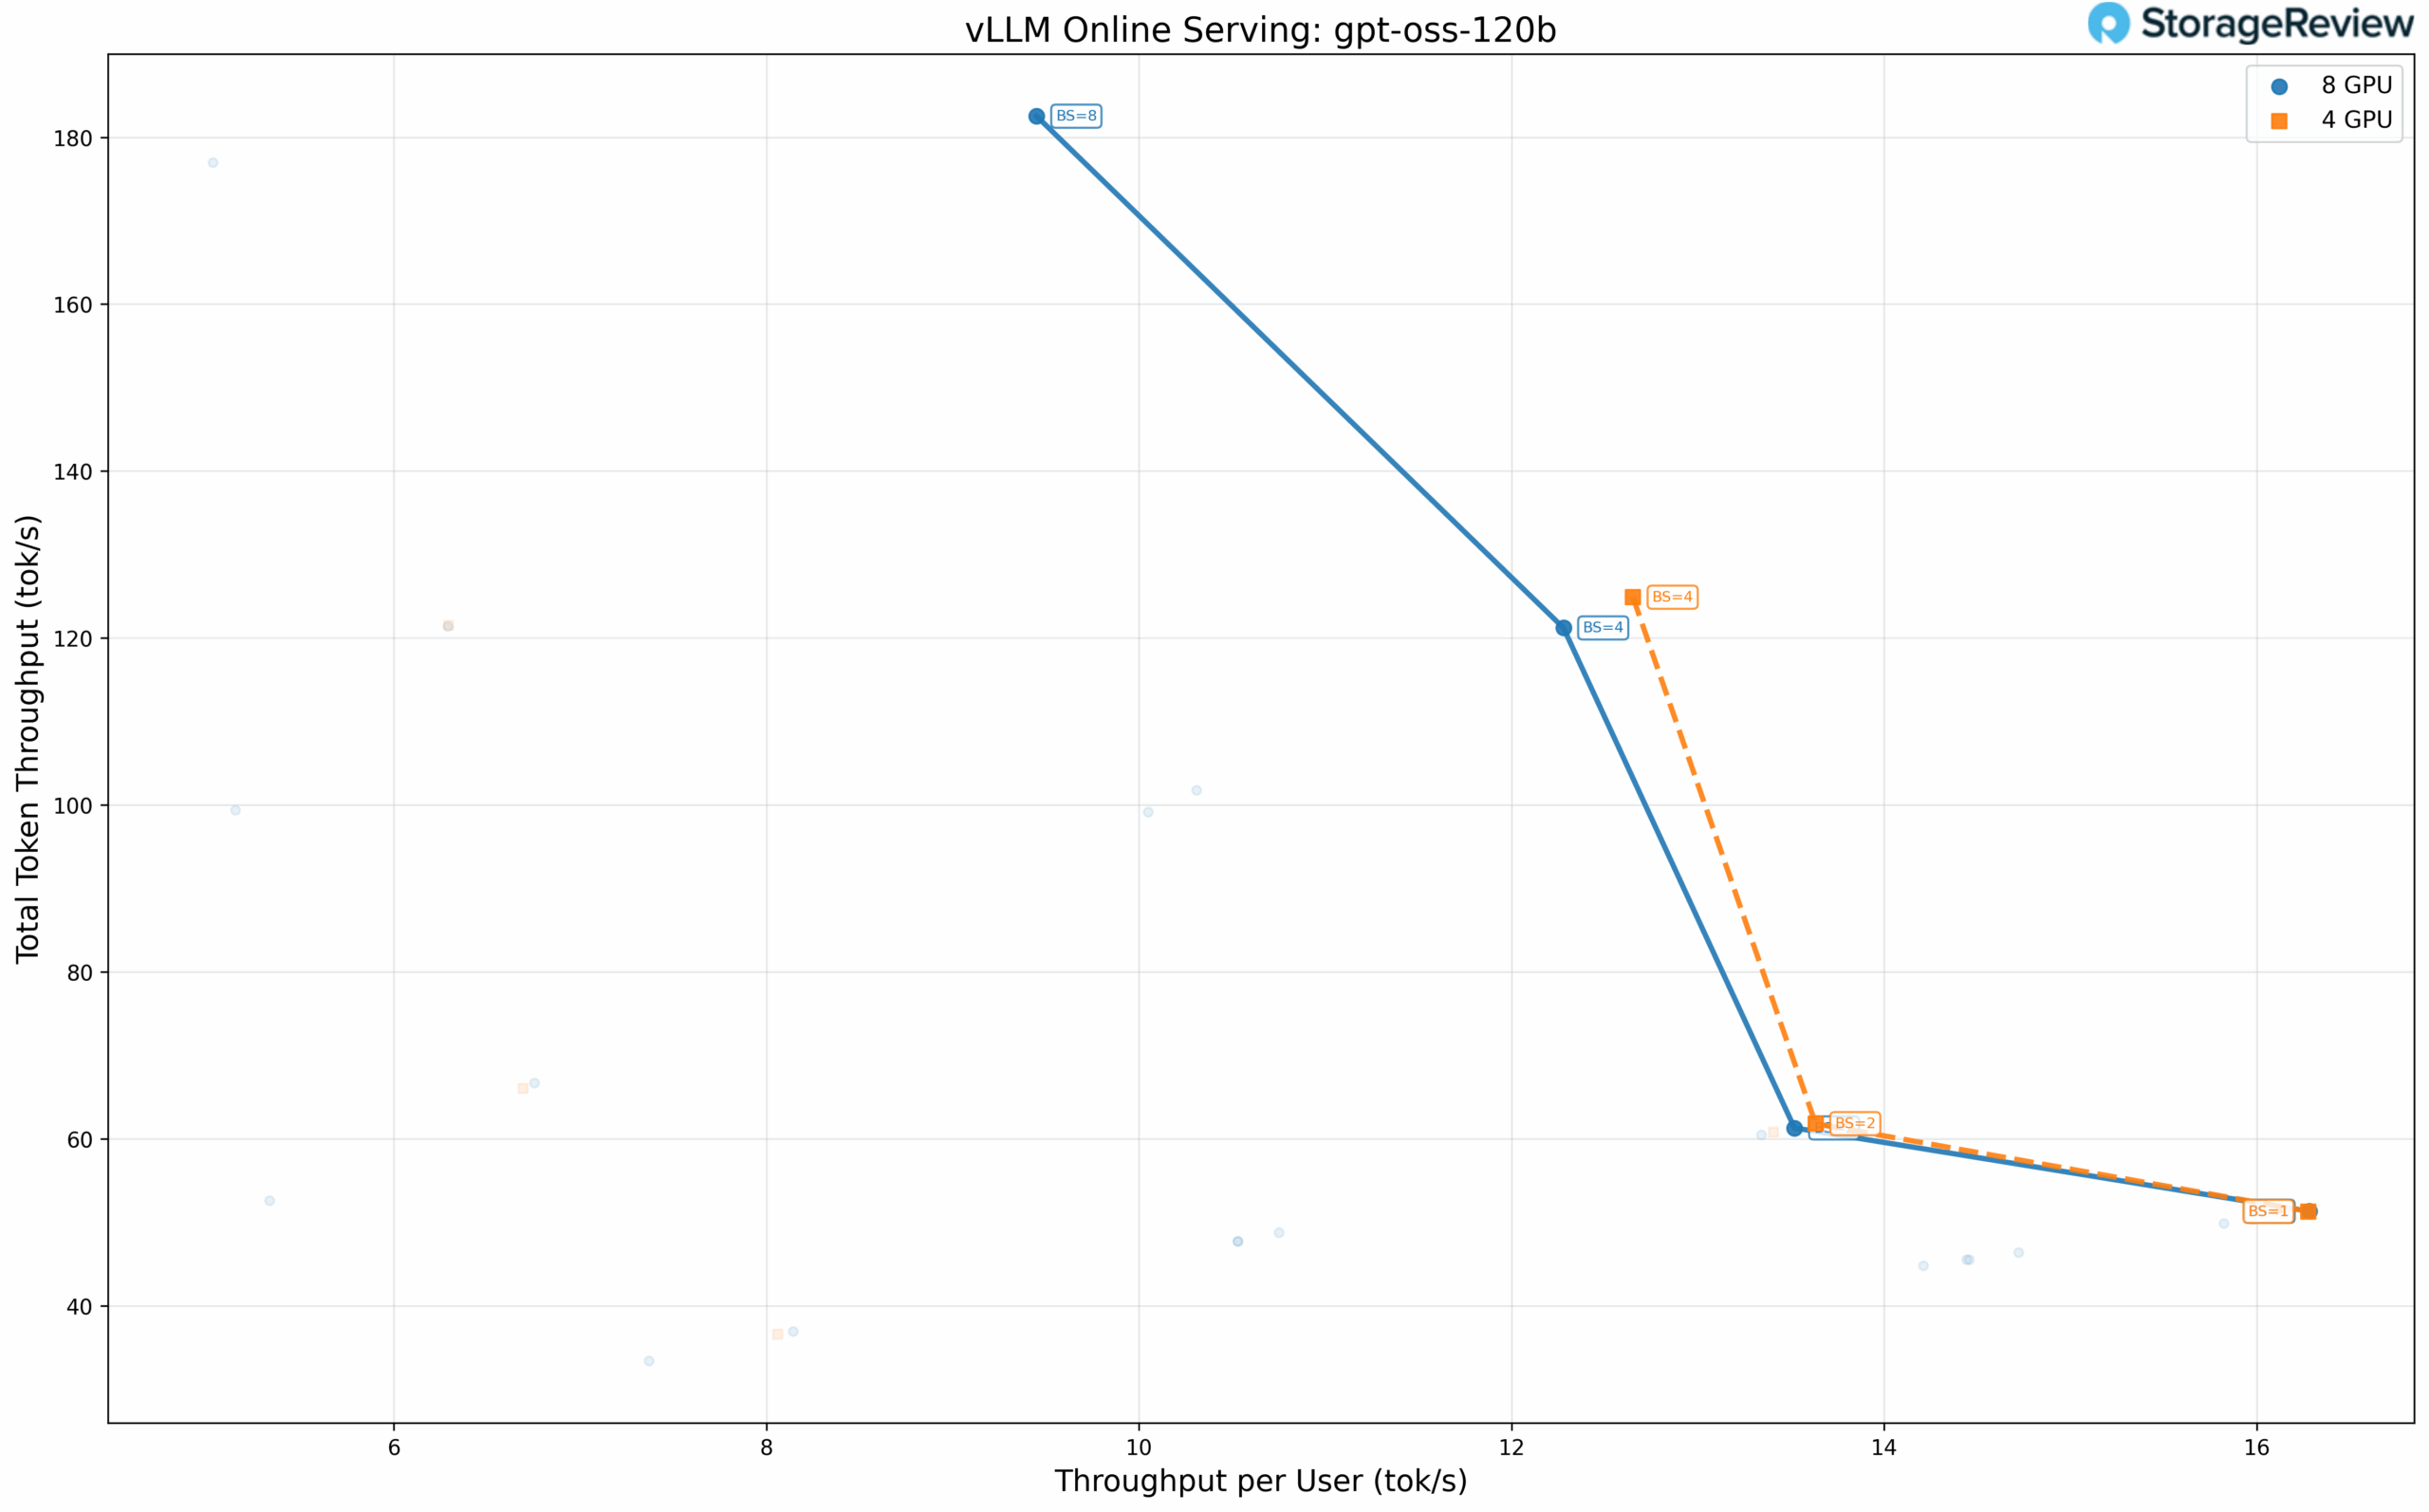
Het grotere 120B-model vereist minimaal 4 GPU's, waardoor de vergelijking met één GPU niet meer nodig is. De prestaties van configuraties met vier en acht GPU's komen dichter bij elkaar, met een vrijwel identieke doorvoer per gebruiker bij batchgrootte 1 (16.28 tok/s voor beide). De configuratie met acht GPU's biedt bescheiden voordelen bij hogere batchgroottes dankzij dataparallellisme.
Mix van experts: Qwen3 Coder 30B-A3B
Sparse MoE-architecturen behouden een groot aantal parameters, terwijl ze slechts een subset activeren tijdens de inferentie. Qwen3 Coder 30B-A3B activeert ongeveer 3 miljard parameters per token uit zijn volledige parameterpool van 30 miljard, waardoor het populair is voor lokale implementaties van coderingsassistenten.
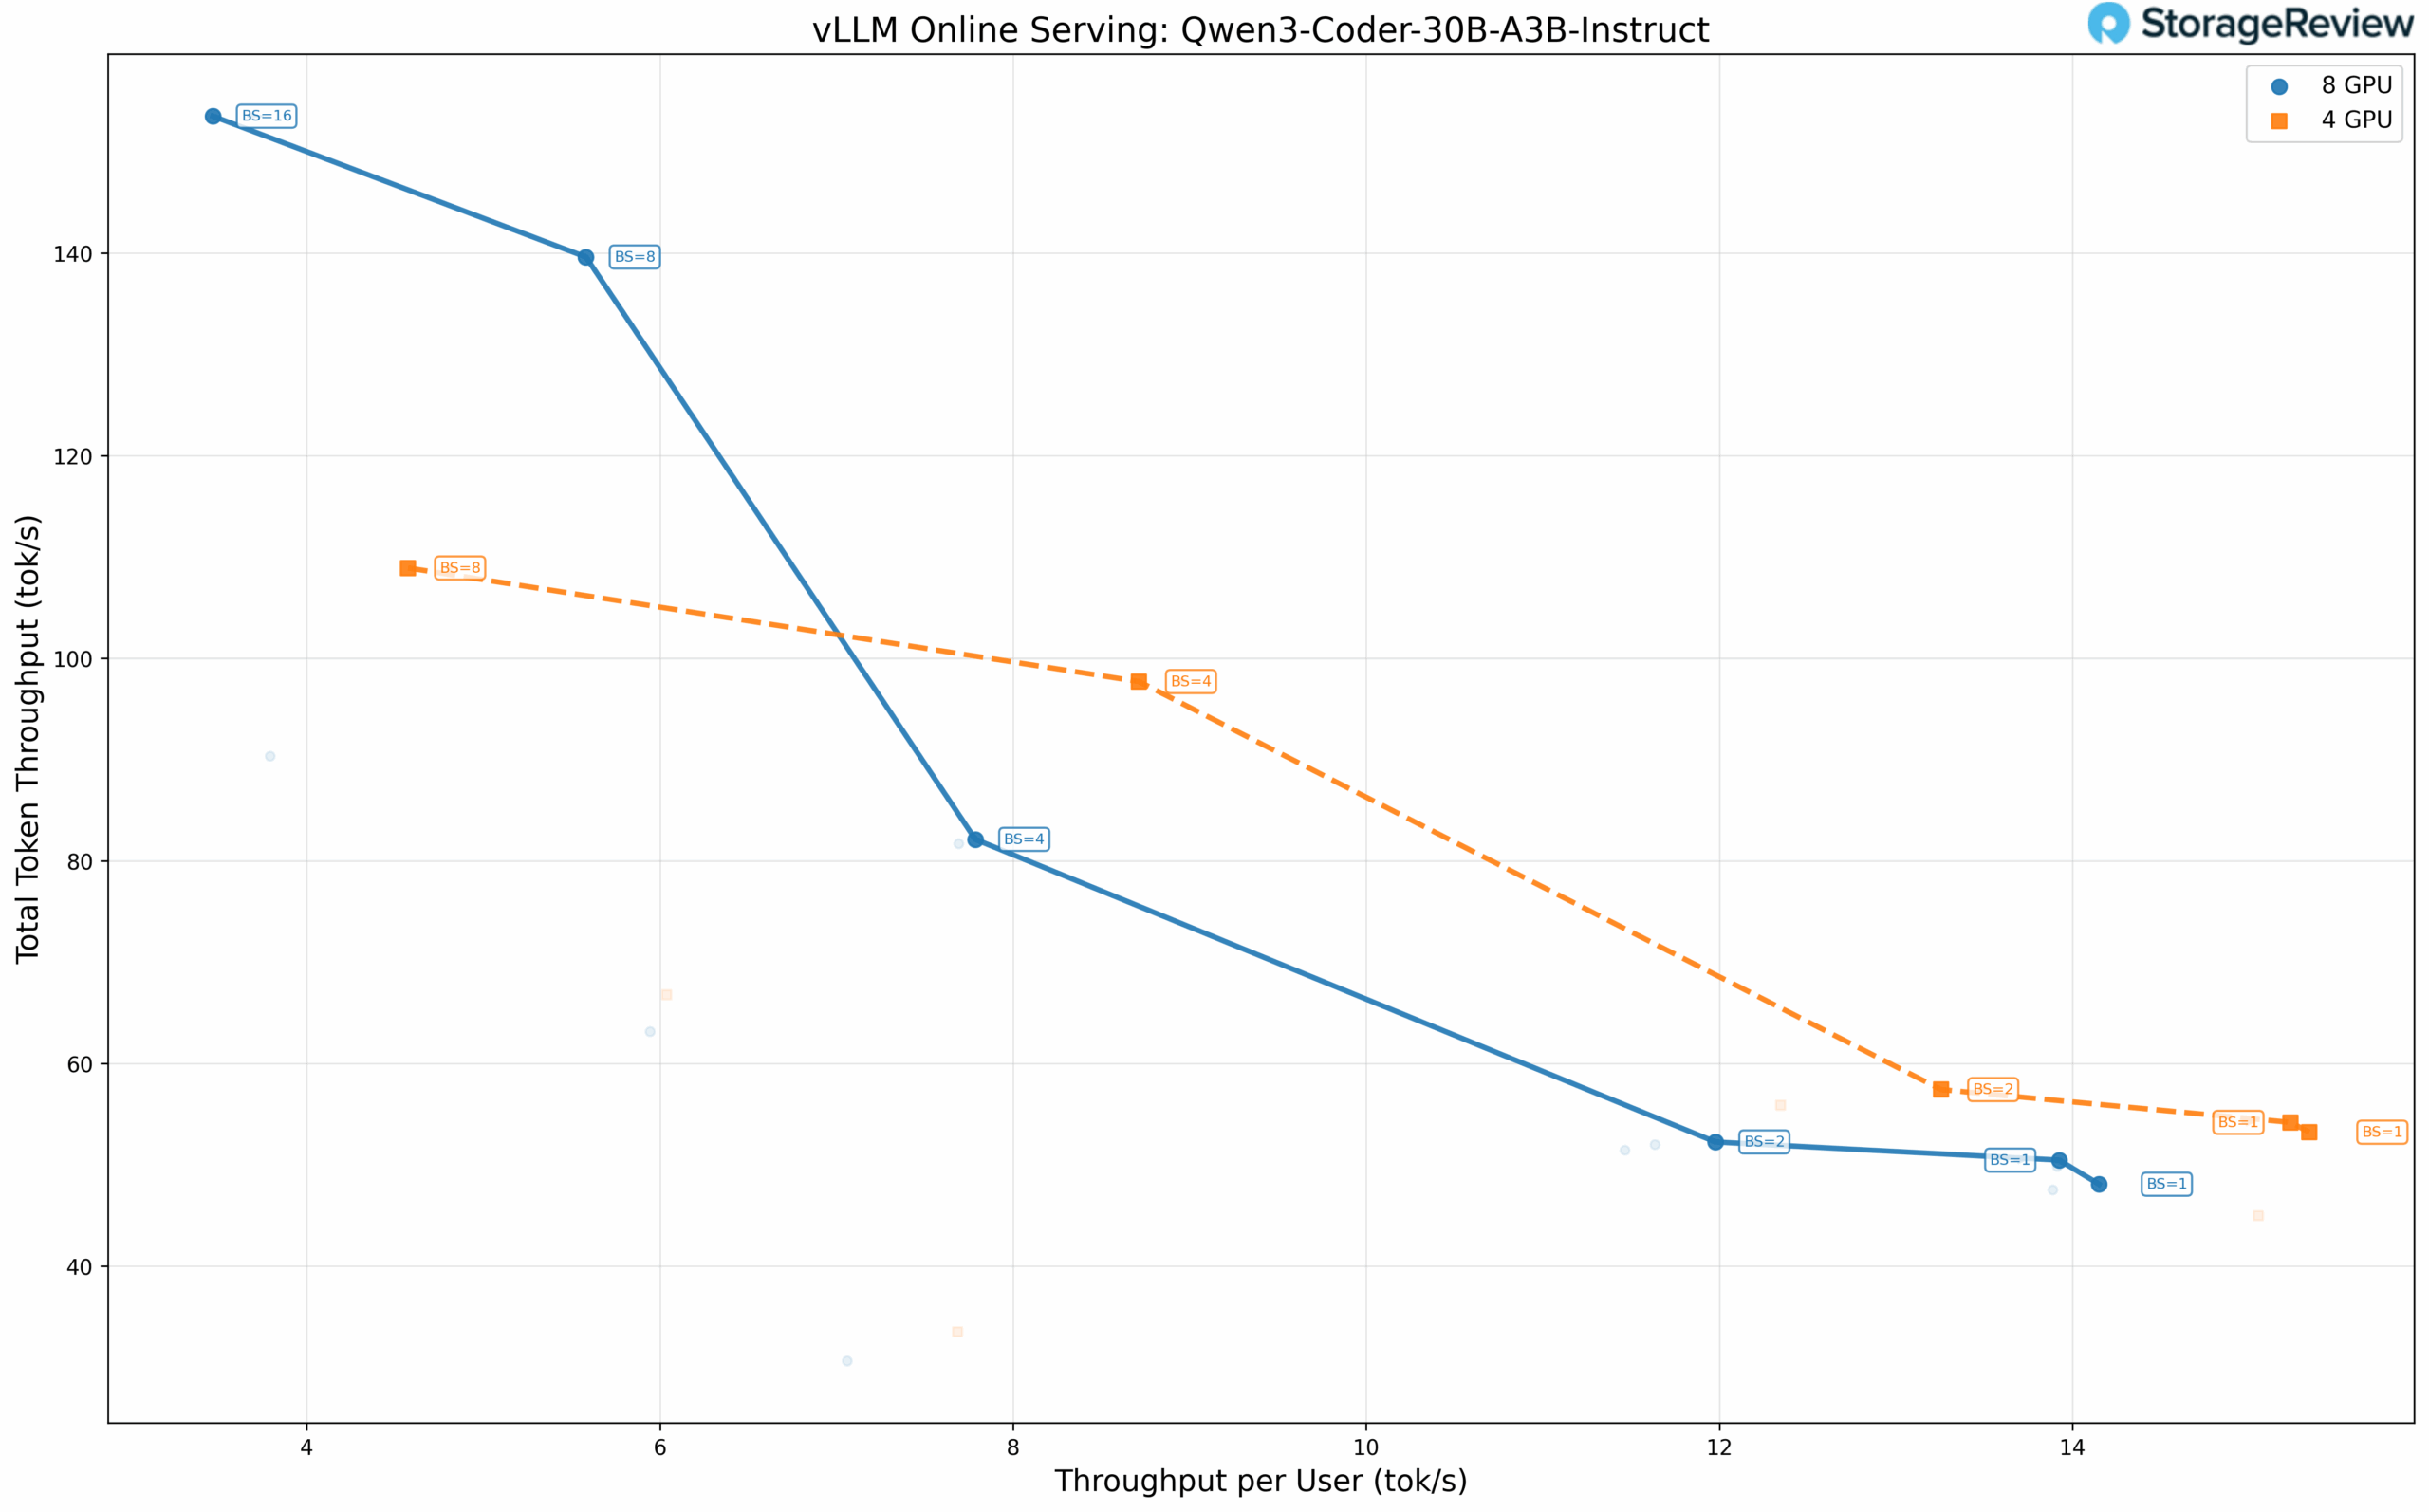
Testen met BF16-precisie tonen opnieuw voordelen aan voor de configuratie met vier GPU's bij lagere batchgroottes. De doorvoer per gebruiker bereikt 15.34 tok/s met TP=4, versus 14.15 tok/s met TP=8, bij een batchgrootte van 1.
Dichte modellen
Dichte modellen volgen de conventionele LLM-architectuur, waarbij alle parameters en activaties tijdens de inferentie worden gebruikt. Dit resulteert in een rekenintensievere verwerking dan bij hun sparse tegenhangers. Zonder werkende INT4-kwantisatie tijdens onze testperiode draaiden deze modellen op BF16-precisie.
Lama 3.1 8B Instrueer
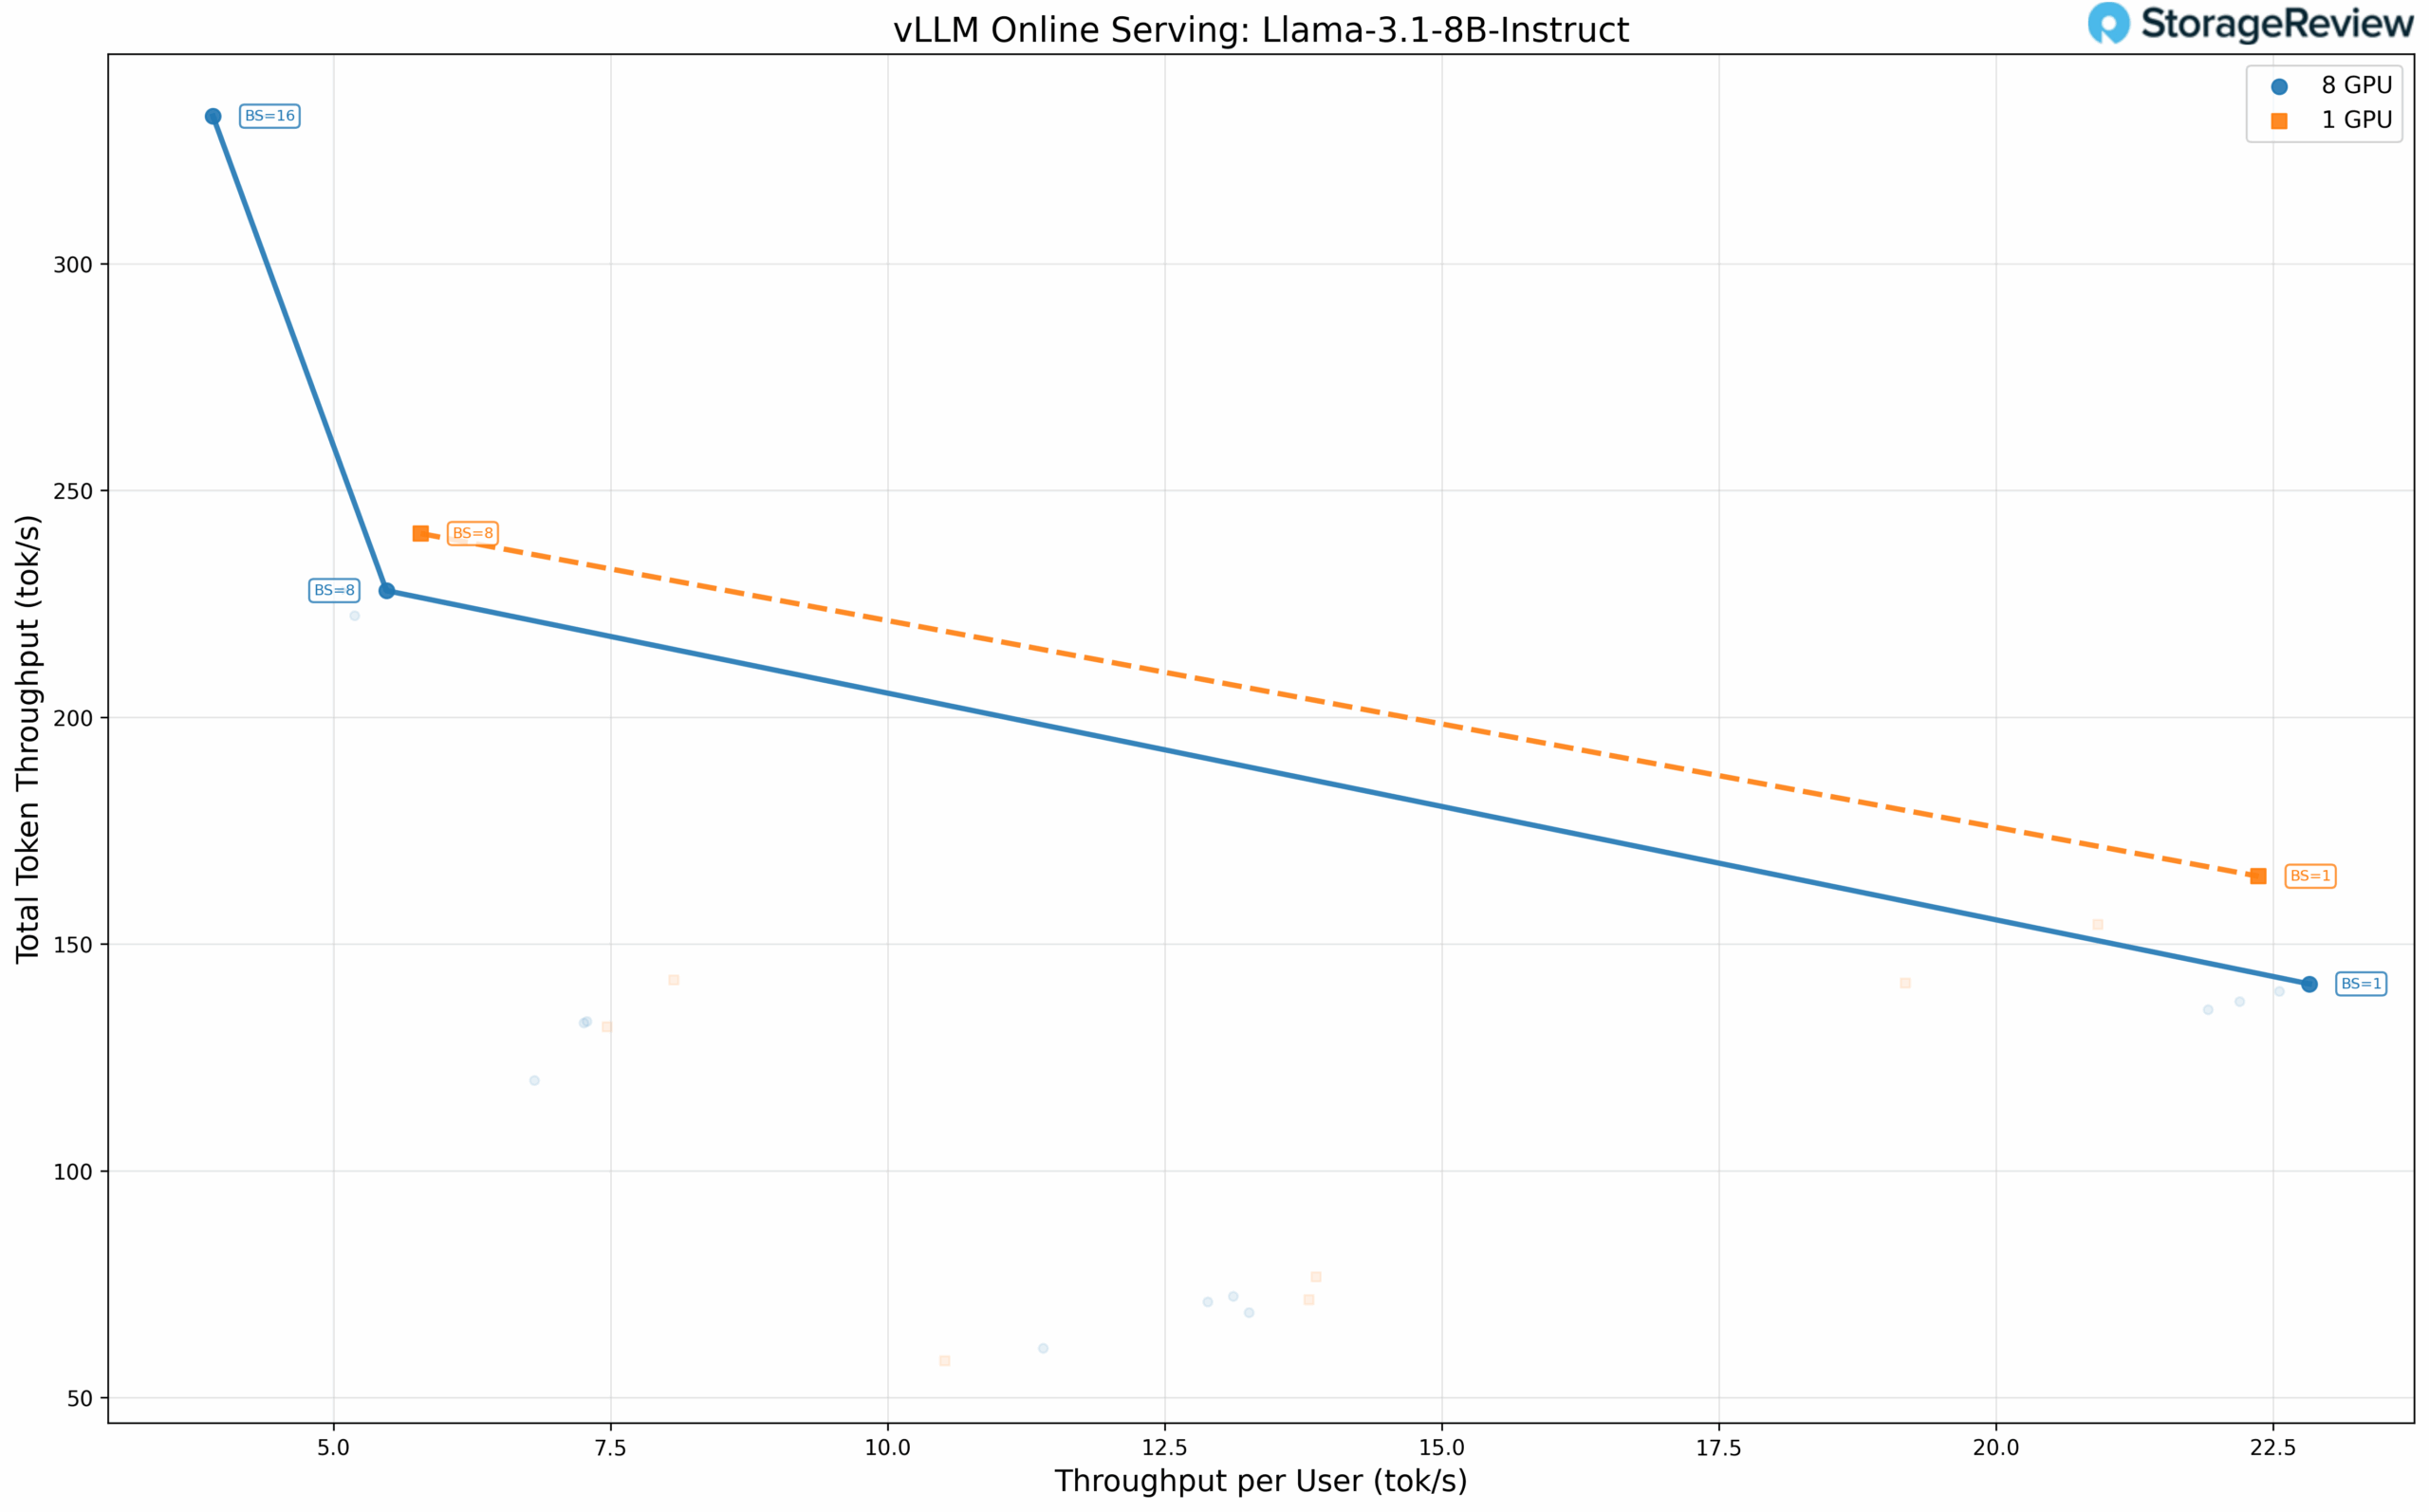
Het compacte 8B-model past comfortabel op één GPU, maar werd getest in verschillende configuraties om het schaalgedrag te karakteriseren. De resultaten bevestigen het patroon: vier GPU's leveren een totale doorvoersnelheid van 240.48 tok/s bij batchgrootte 8, vergeleken met 227.90 tok/s bij acht GPU's met dezelfde batchgrootte. De doorvoersnelheid per gebruiker bij batchgrootte 1 blijft vrijwel identiek (22.37 tok/s versus 22.83 tok/s).
Mistral Small 3.1 24B Instrueren
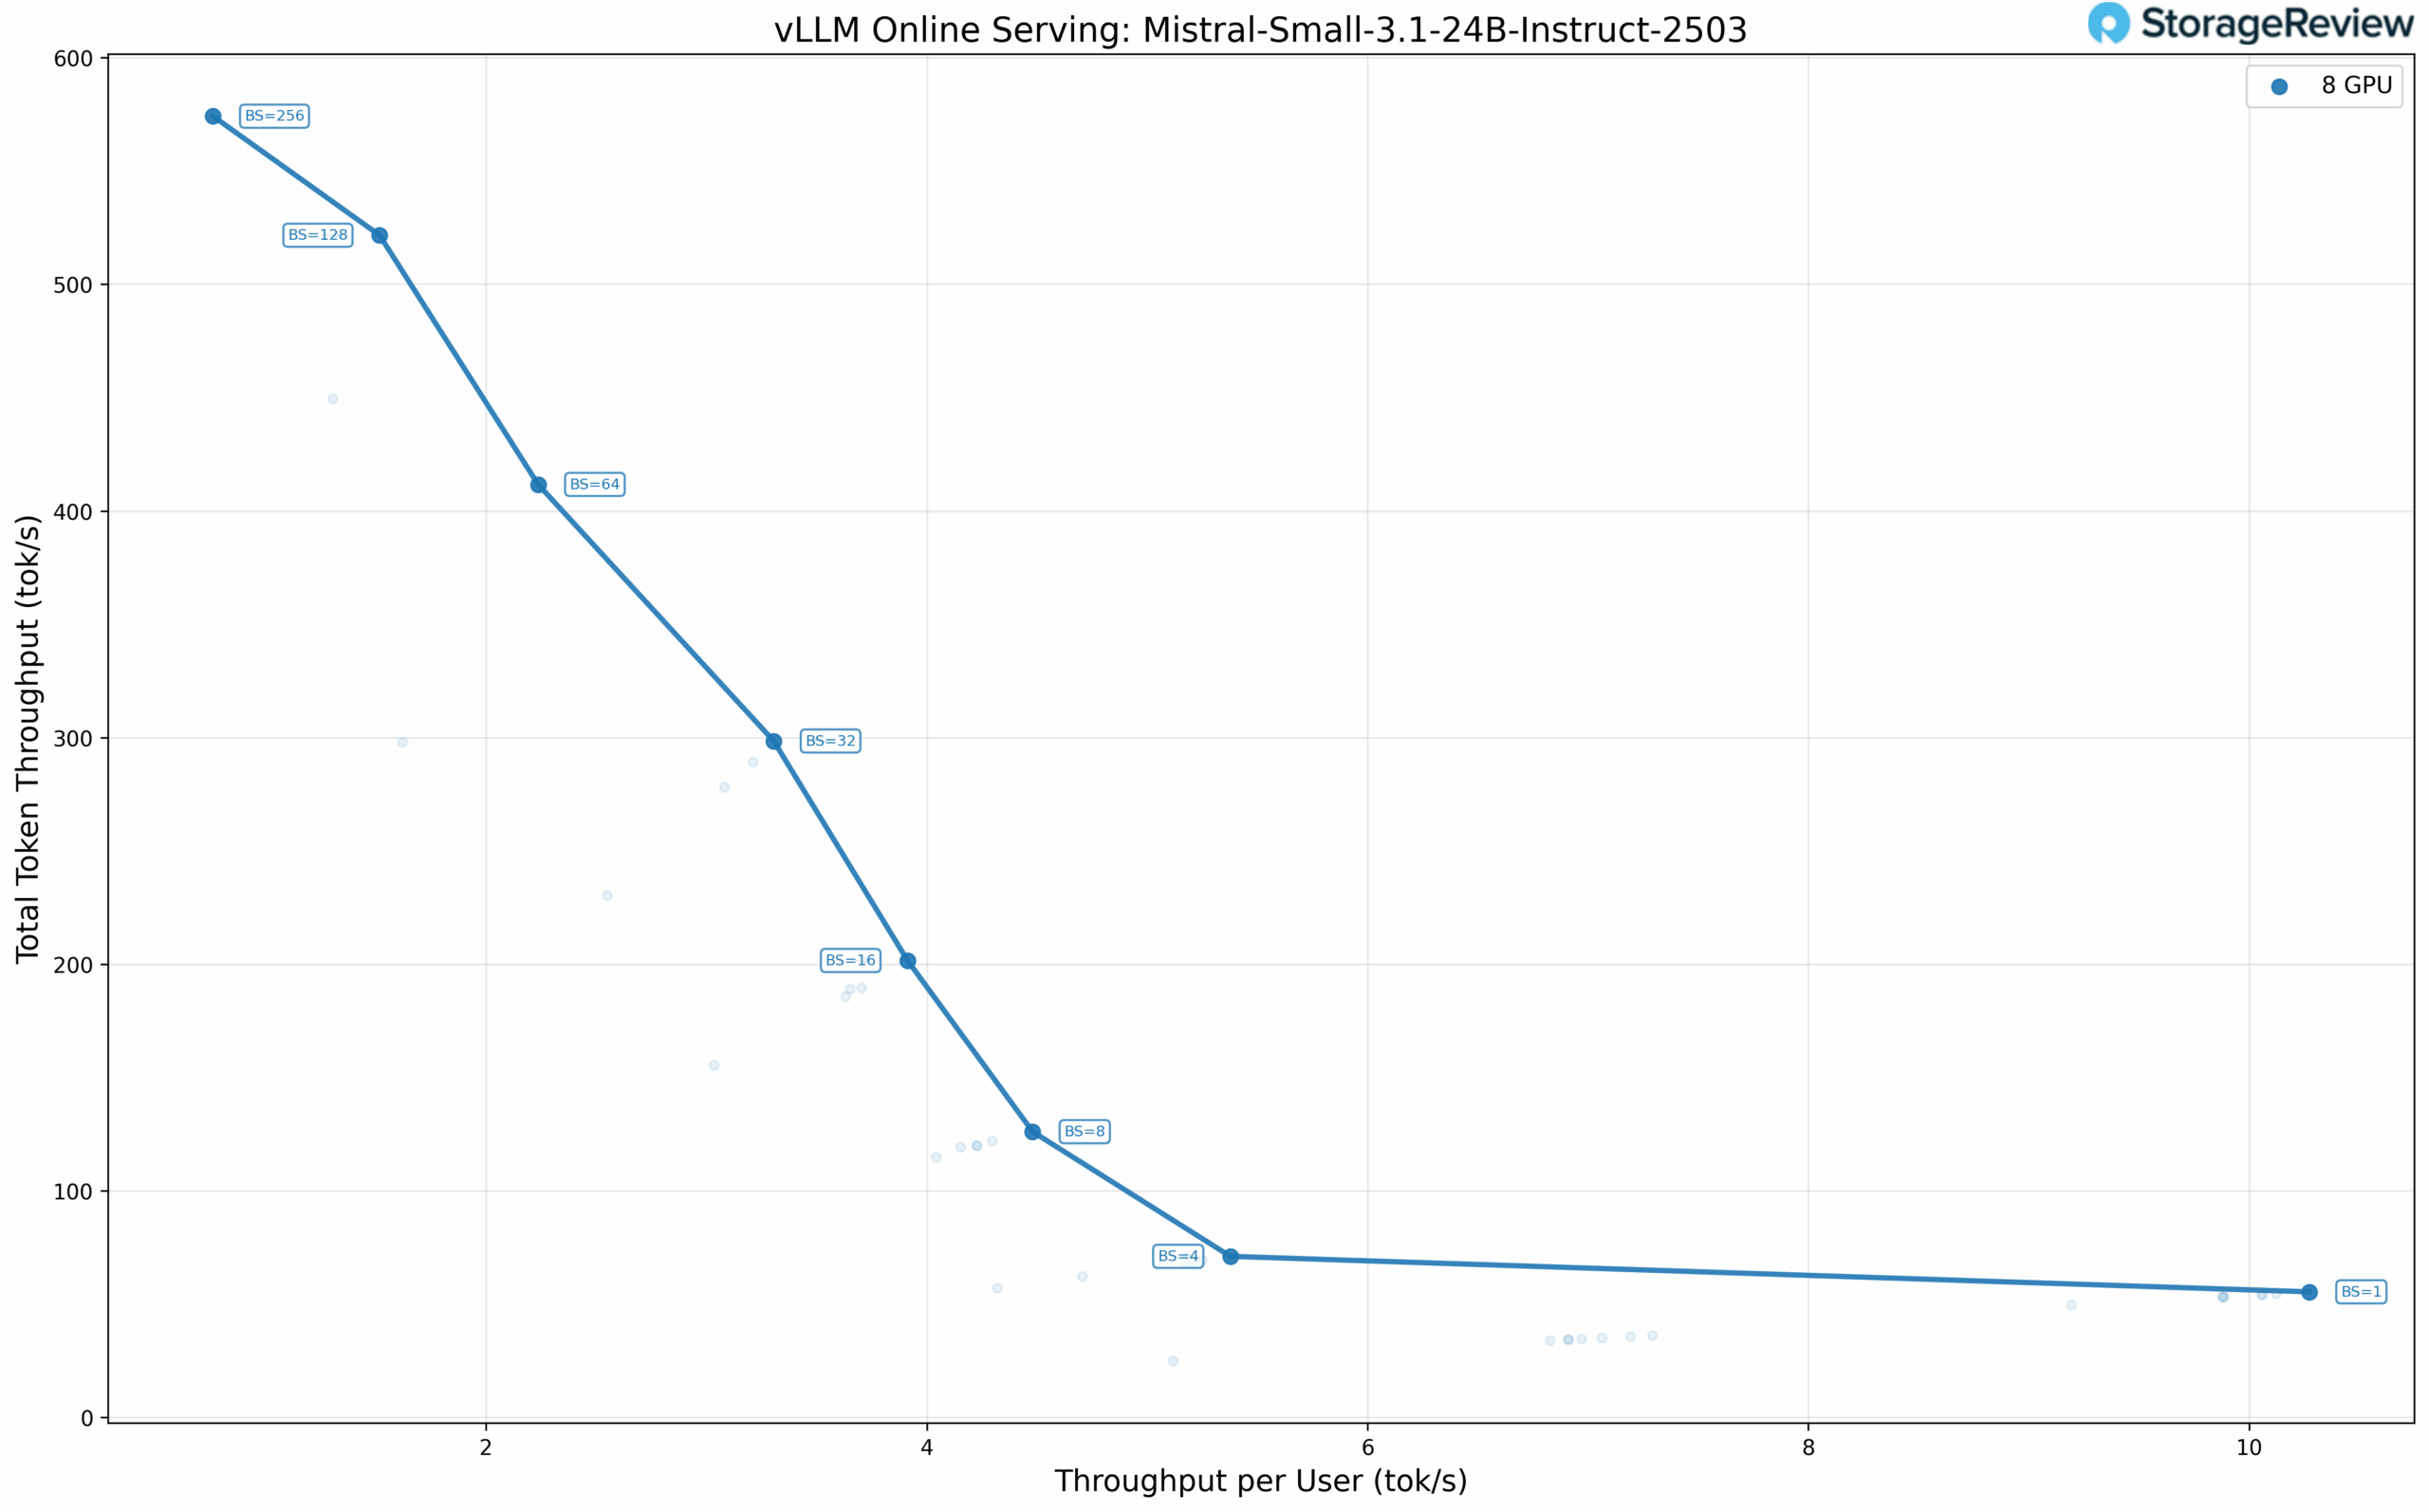
Het Mistral-model met 24B-parameters vertegenwoordigt een veeleisendere werklast. Met BF16-precisie bereikt het model een sterke doorvoerschaling bij hogere batchgroottes, met een snelheid van 574.16 tok/s bij een batchgrootte van 256 over alle acht GPU's.
Bevindingen
Bij alle geteste modellen komt een consistent patroon naar voren: bij kleine batchgroottes met onze configuratie van 256 input/output-tokens levert het gebruik van het minimale aantal GPU's dat nodig is om het model te laten werken, betere prestaties per gebruiker op dan verdeling over alle acht GPU's . De overhead van de communicatie tussen de GPU's via PCIe, zelfs bij PCIe 5.0-snelheden, introduceert latentie die de voordelen van parallelisatie voor scenario's met één gebruiker of lage gelijktijdigheid tenietdoet.
Deze bevinding heeft praktische implicaties voor de implementatieplanning. Organisaties die single-user coding assistants of agent workflows met lage gelijktijdigheid gebruiken, kunnen met kleinere GPU-configuraties toch acceptabele prestaties behalen. De volledige Battlematrix-configuratie met acht GPU's is het meest voordelig voor batch-inferentieworkloads, synthetische datageneratie of scenario's met hoge gelijktijdigheid waarbij de totale doorvoer belangrijker is dan de latentie per aanvraag, vooral bij gebruik van grotere modellen die meer geheugen vereisen.
Ervaring met Arc Pro B60s
Tijdens de beperkte tests die we uitvoerden, verliep de ervaring opmerkelijk soepel. Het opstarten van de kaarten was eenvoudig en het instellen van LLM-Scaler, de ontwikkeltak van vLLM met Battlemage-ondersteuning, bleek even eenvoudig. De software bevindt zich echter nog in een zeer vroeg stadium van ontwikkeling. Toen we begonnen met testen, konden we geen GPU-statistieken ophalen en, afgezien van tensorparallellisme, hadden we geen succes met andere parallellismestrategieën, zoals expertparallellisme of pipelineparallellisme, voor schaalbaarheid over meerdere systemen. Gezien de pre-releasestatus van de softwarestack hadden we deze beperkingen echter wel verwacht.
De koeling zorgde voor veel discussie na onze eerste korte YouTube-video , waarbij veel reageerders hun bezorgdheid uitten over mogelijke oververhitting van de kaarten op onze open testopstelling. Omdat we geen thermische monitoring hadden, hebben we de kaarten uiteindelijk in een serverbehuizing geplaatst om voldoende luchtstroom te garanderen. We zijn wel van plan om de koelprestaties in de workstationconfiguratie te testen voor onze volledige review, aangezien de uiteindelijke Battlematrix-configuratie, zoals te zien in de marketingafbeeldingen van Intel hierboven, deze kaarten in een workstationbehuizing plaatst, dicht op elkaar gestapeld.
Wat de vormfactor betreft, zijn deze kaarten iets langer dan standaard workstation-GPU's, wat kan leiden tot problemen met de compatibiliteit van de behuizing. Ze passen echter probleemloos in serverbehuizingen, aangezien de meeste serverbehuizingen extra ruimte bieden aan de voorkant van de kaart voor ondersteuningsbeugels.
Toekomstige testplannen
We zijn van plan de Intel Battlematrix opnieuw te bekijken en een uitgebreidere review uit te voeren na de volledige release en algemene beschikbaarheid van de B60's. We zullen de prestaties van LLM-inferentie evalueren door middel van aanvullende vLLM-tests in een breed scala aan modellen en implementatieconfiguraties. Hoewel dit niet in deze preview wordt getoond, hebben we vastgesteld dat deze GPU's, in hun huidige softwarestatus, beter presteren op prefill- dan op decodeerbewerkingen. De volledige review zal dieper ingaan op inferentieworkloads met veel prefill en veel decodering om dit gedrag te karakteriseren.
De homelab-community heeft interesse getoond in het gebruik van deze GPU's voor een van de populairste homelab-toepassingen: mediaservers. We willen deze testen met Plex en mogelijk Jellyfin met leden van onze Discord-server . Professionele toepassingen staan ook op onze radar, waaronder SolidWorks en Autodesk voor CAD-prestatietests. Daarnaast zijn we van plan om SR-IOV met Proxmox te gebruiken voor het opzetten van een VDI-server voor meerdere gebruikers, zodat Discord-leden de gelijktijdige desktopdichtheid en cloudgaming kunnen evalueren.
Conclusie
Intels Arc Pro B60 Battlematrix is een spannend platform dat GPU-geheugen met hoge capaciteit toegankelijk maakt voor werkstationprijzen. Het ontwerp met twee GPU's biedt een oplossing voor dichtheidsbeperkingen, de toewijzing van 24 GB per GPU is geschikt voor LLM-inferentieworkloads en de prijsstructuur biedt aantrekkelijke alternatieven voor gevestigde professionele GPU-ecosystemen. Voor organisaties die datasoevereiniteit en kostenefficiëntie belangrijker vinden dan baanbrekende prestaties, verdient dit platform zeker de aandacht.
Softwarevolwassenheid blijft de belangrijkste beperking. Intels investering in framework-optimalisatie via LLM Scaler en voortdurende verbetering van drivers wijst op een toewijding om de Arc-lijn van GPU's als een waardevolle toevoeging te behouden.
Het is onbekend hoe populair de Battlematrix-configuratie met acht GPU's zal zijn in vergelijking met de ongelooflijke prestaties van de NVIDIA DGX Spark . De echte doorbraak zou wel eens kunnen komen bij de configuraties met één of twee kaarten, waar instapprijzen van $600 tot $1,200 de drempel voor het verkennen van particuliere AI-infrastructuren aanzienlijk verlagen.
We zullen onze tests blijven uitbreiden naarmate er driverupdates verschijnen en softwareframeworks zich verder ontwikkelen. Als je dit zelf wilt uitproberen, kun je lid worden van onze Discord-server , waar we een communityserver hebben met beperkte toegang tot de B60.


 Amazon