

De NVIDIA DGX Spark vertegenwoordigt een keerpunt in toegankelijke AI-infrastructuur. In 2017 werd de Transformer-architectuur geïntroduceerd in het baanbrekende artikel "Attention is All You Need", dat gebaseerd was op een P100-serverconfiguratie met acht GPU's, die tientallen kilowattuur verbruikte en aanzienlijke ruimte in beslag nam in datacenters. Tegenwoordig levert de DGX Spark superieure rekenprestaties in een compacte desktopvormfactor van 240 watt. Deze dramatische evolutie in energie-efficiëntie en vormfactorcompressie maakt AI-mogelijkheden die voorheen exclusief voor datacenters waren, toegankelijk voor individuele onderzoekers, kleine teams en verspreide ontwikkelorganisaties.
Wat Spark onderscheidt van eerdere desktop AI-oplossingen, is de allesomvattende benadering van de volledige ontwikkelingscyclus. In plaats van compromissen te forceren tussen experimenteren, finetunen en implementeren, biedt Spark echte mogelijkheden in alle fasen. De 128 GB unified memory-architectuur maakt volledige parameterfinetuning van modellen mogelijk waarvoor cloudresources op conventionele werkstations nodig zouden zijn, en levert tegelijkertijd honderden tokens per seconde, geschikt voor batch-inferentieworkloads, inclusief het genereren van synthetische data. De integratie van ConnectX-7-netwerken met 200 Gb fabric-capaciteit betekent dat organisaties meerdere Spark-systemen kunnen clusteren voor nog uitgebreidere modelexploratie, hoewel, zoals we zullen aantonen, zelfs één unit opmerkelijk capabel blijkt.
Key Takeaways
Datacenterkracht in een desktop : GB10 Grace Blackwell in een behuizing van 1.13 liter en 240 W, geprijsd op $ 3,999, met een sparse-prestatie tot 1 petaFLOP FP4.
Geheugen dat workflows verandert : 128 GB aan uniform geheugen maakt volledige parameterfijnafstelling van 8B-modellen lokaal mogelijk, evenals inferentie met hoge doorvoer. Tijdens tests zagen we dat Llama 3.1 8B FP4 een snelheid van ongeveer 924 tok/s bereikte bij 128 gelijktijdige processen, en Qwen3 Coder 30B-A3B FP8 ongeveer 483 tok/s bij batch 64.
Klaar voor schaalbaarheid en aansluiting van snelle opslag : de geïntegreerde ConnectX-7 biedt een 200G-fabric voor clustering of NVMe-oF. De interne 2242 Gen5 NVMe is handig, maar beperkt voor zware I/O-bewerkingen. Externe NVMe-oF via RDMA is daarom de betere optie voor een constante doorvoer.
Software vanaf dag één volledig operationeel : wordt geleverd met DGX OS, CUDA, cuDNN, TensorRT, AI Workbench, containers en workflow-playbooks, zodat teams direct met echte workloads aan de slag kunnen.
Bewezen prestaties in de praktijk : MAMF mat ~99.8 TFLOPs BF16 en ~207.7 TFLOPs FP8. GDSIO-leessnelheden piekten intern op ~11.4 GiB/s, met een hogere limiet die verwacht wordt over het 200G-netwerk.
Wat is DGX Spark en voor wie is het geschikt?
De NVIDIA DGX Spark is in wezen een compleet AI-ontwikkelplatform en niet zomaar een GPU-component. De kern bestaat uit de GB10 Grace Blackwell Superchip, die een GPU met Blackwell-architectuur integreert met vijfde-generatie Tensor Cores en een 20-core Arm CPU (10× Cortex-X925 + 10× Cortex-A725), verbonden via NVLink-C2C. Deze coherente interconnectarchitectuur maakt volgens NVIDIA een tot 5× hogere bandbreedte mogelijk in vergelijking met PCIe Gen 5, waardoor een uniforme rekenstructuur ontstaat in plaats van afzonderlijke verwerkingsdomeinen.
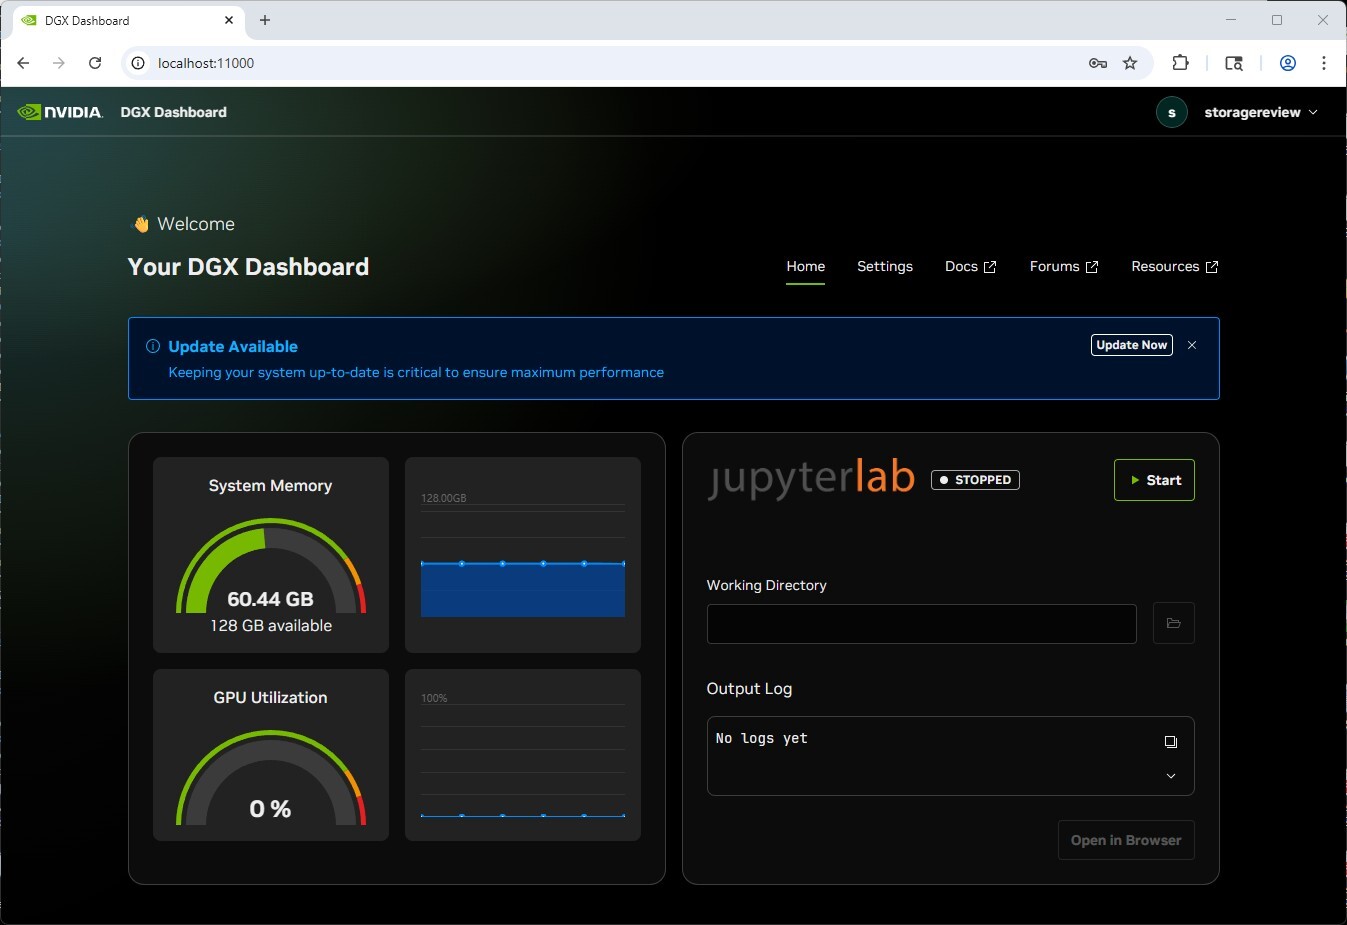
Om gebruikers op weg te helpen, levert NVIDIA DGX OS, gebouwd op Ubuntu Desktop, met de volledige AI-softwarestack vooraf geconfigureerd, inclusief CUDA, cuDNN, TensorRT, NVIDIA Container Runtime en AI Workbench. Dit elimineert de typische driveruitdagingen en overhead voor omgevingsconfiguratie die gepaard gaan met aangepaste workstation builds. Het systeem biedt flexibele implementatiemodellen: sluit randapparatuur aan en gebruik het als een compact workstation met de volledige Ubuntu desktop-ervaring, of implementeer het als een headless netwerkapparaat dat toegankelijk is via NVIDIA Sync, dat naadloze integratie biedt met JupyterLab, VS Code, Cursor IDE en SSH-terminals.
Dit is een speciaal gebouwde infrastructuur voor AI-professionals, onderzoekers die taalmodellen verfijnen, datawetenschappers die RAPIDS-workflows versnellen, ontwikkelaars die agentische systemen implementeren of teams die op kleine schaal experimenteren met architecturen met ablatieve modellen. Spark richt zich op professionals die serieuze AI-rekencapaciteit nodig hebben zonder datacentercomplexiteit.
Technische specificaties van NVIDIA DGX Spark
| Specificaties | Details |
|---|---|
| Architectuur | |
| GPU | NVIDIA Blackwell-architectuur |
| CPU | 20-core Arm (10x Cortex-X925 + 10x Cortex-A725) |
| Tensor kernen | 5th Generation |
| RT Cores | 4th Generation |
| NVENC/NVDEC | 1× / 1× |
| Geheugen | |
| Systeemgeheugen | 128 GB LPDDR5X (Unified System-geheugen) |
| Geheugeninterface | 256-bit |
| Geheugenbandbreedte | 273 GB / s |
| Prestaties | |
| FP4 | tot 1 petaFLOP (met Sparsity) |
| Opslag | |
| Opslag | 1 TB of 4 TB NVMe M.2 (zelfversleuteld) |
| Connectiviteit | |
| USB | 4× Type-C USB 3.2 Gen 2×2 (20 Gbps) |
| Ethernet | 1× 10GbE RJ-45 |
| NIC | ConnectX-7 Smart NIC – 2x 200G QSFP (maakt maximaal 200G bandbreedte mogelijk) |
| Wireless | Wifi 7, Bluetooth 5.3 |
| Audio uitgang | HDMI-multikanaals audio-uitgang |
| Display-connectoren | 1× HDMI 2.1a |
| Mechanisch | |
| Afmetingen | 150 × 150 × 50.5 mm (5.9 × 5.9 × 1.98 inch) |
| Gewicht | 1.2 kg |
| Energieverbruik | 240w |
NVIDIA DGX Spark ontwerp en bouw
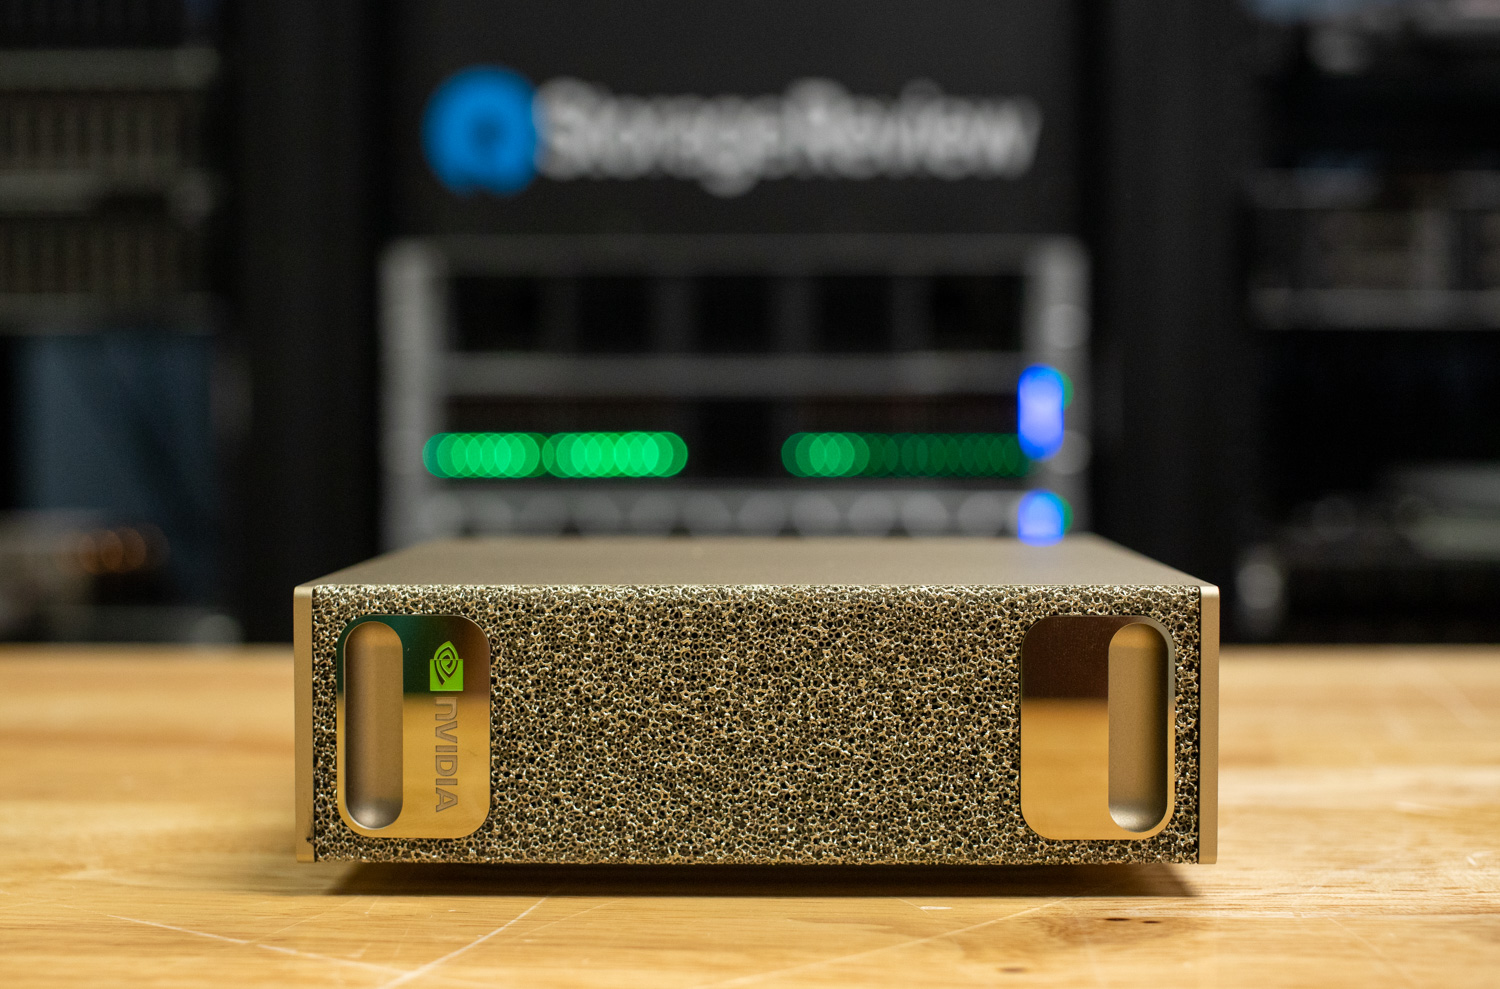
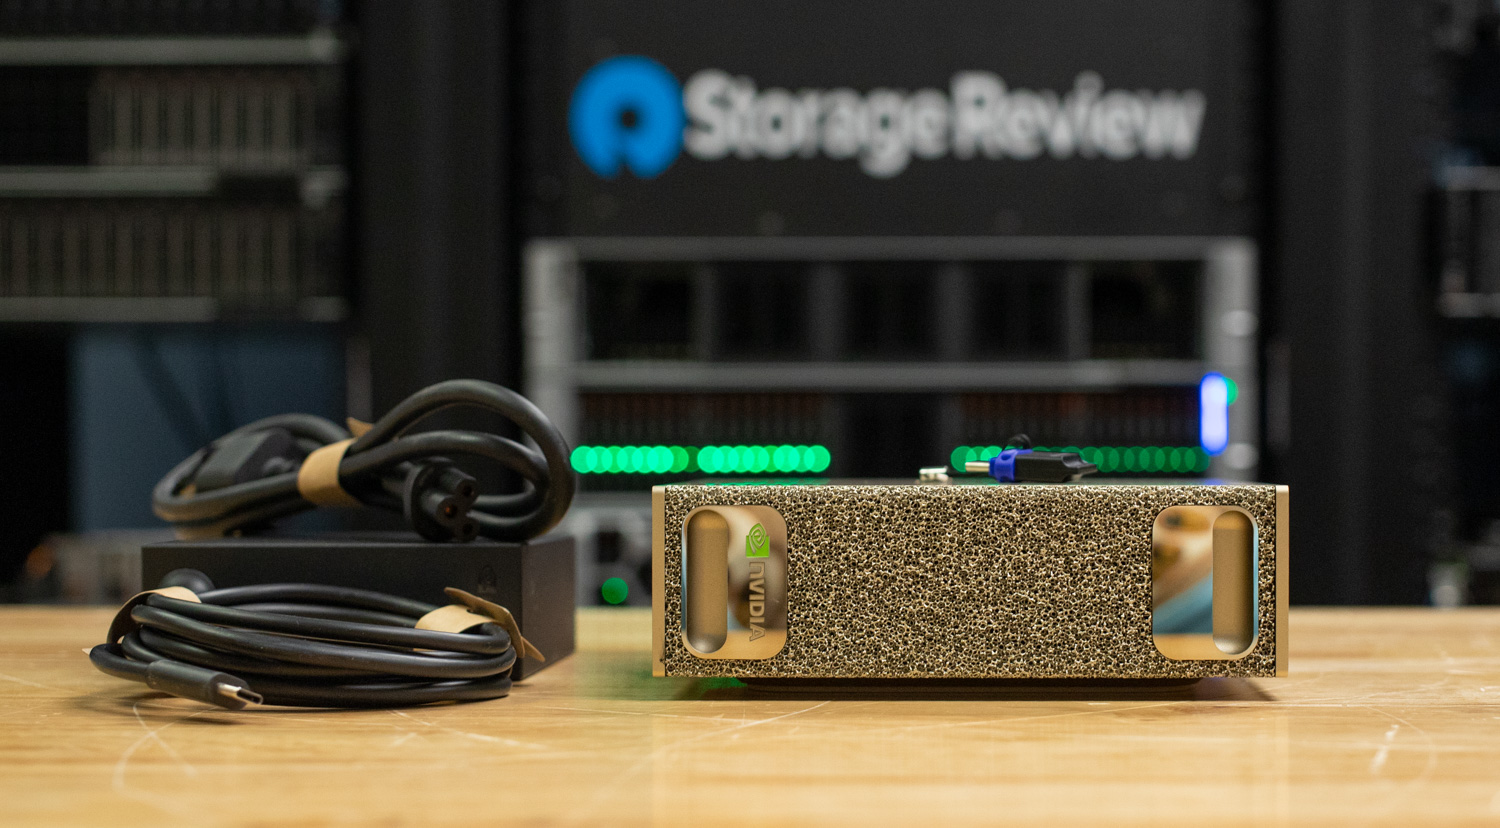
De NVIDIA DGX Spark zet NVIDIA's onmiskenbare industriële design voort, met een compacte behuizing die de look en feel van de grotere DGX-systemen weerspiegelt. Het frontpaneel is voorzien van miniatuur uitsparingen voor handgrepen, een knipoog naar de originele handgrepen van de DGX-units op ware grootte, en een goudkleurige metallic afwerking die zorgt voor een verfijnde, hoogwaardige textuur, geaccentueerd door NVIDIA's iconische groene logo.
De DGX Spark meet 150 × 150 × 50.5 mm (5.9 × 5.9 × 1.98 inch) en weegt 1.2 kg (2.6 pond), wat neerkomt op een totaal intern volume van 1.13 liter. Dit plaatst hem stevig in de 1-liter-klasse van kleine pc's. Ondanks zijn minimale afmetingen voelt het systeem compact en robuust aan dankzij een volledig metalen behuizing die ook als passieve warmteverdeler fungeert, met aandacht voor zowel vorm als functie.
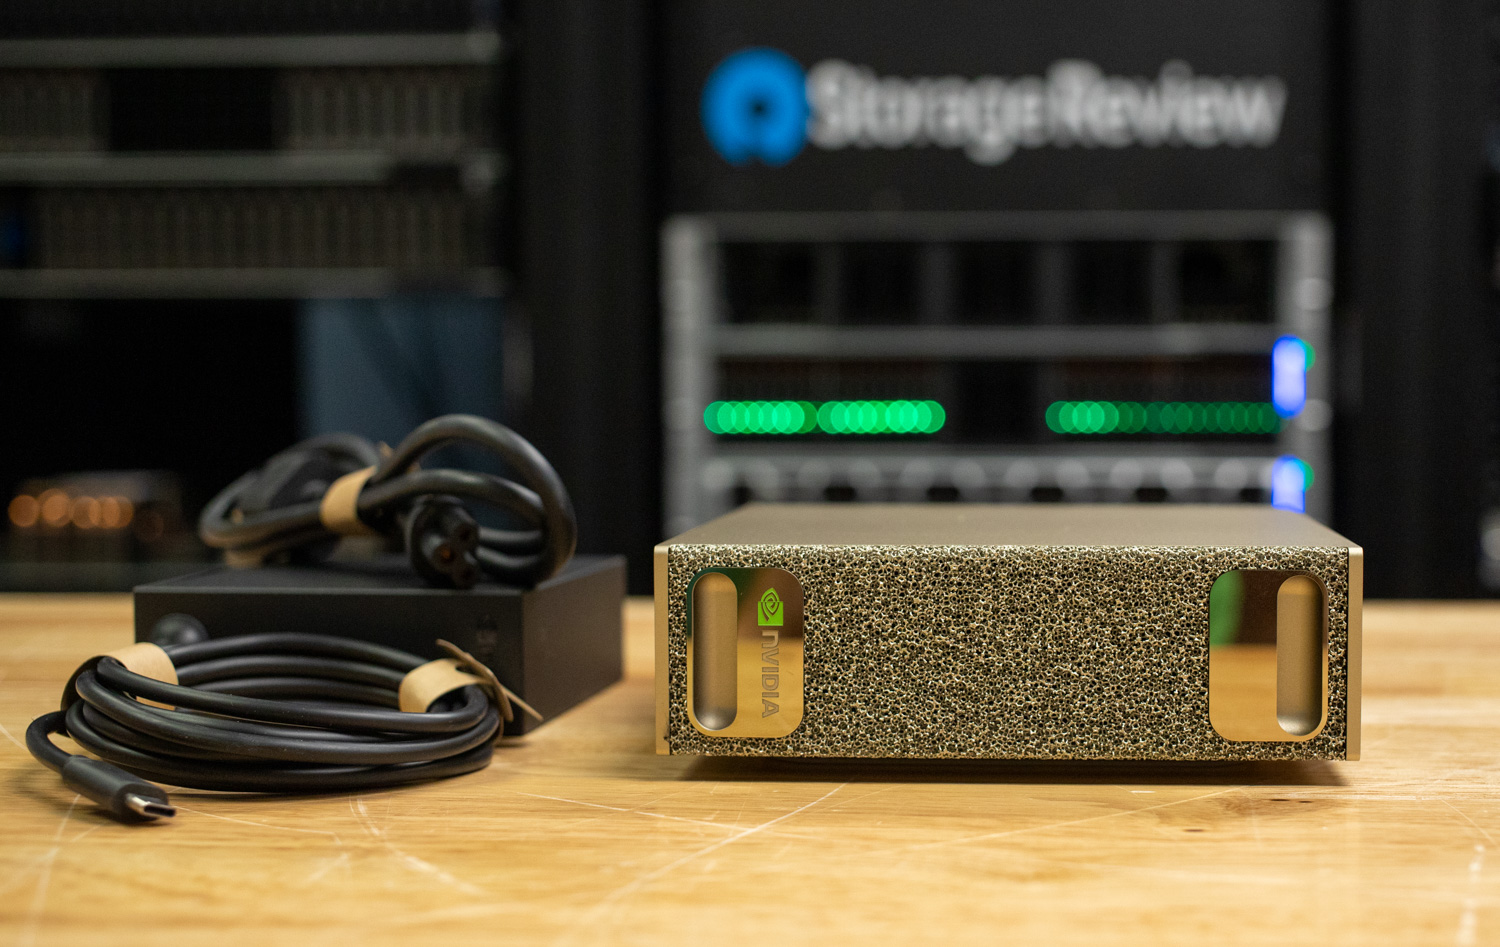
De voeding wordt geleverd door een externe USB-C-voeding van 240 W, die naast de hoofdeenheid op de afbeelding te zien is. De voeding is compact en degelijk gebouwd, met een standaard C5-connector (klaverblad) voor de netstroom en passend bij het strakke, efficiënte ontwerp van de DGX Spark.
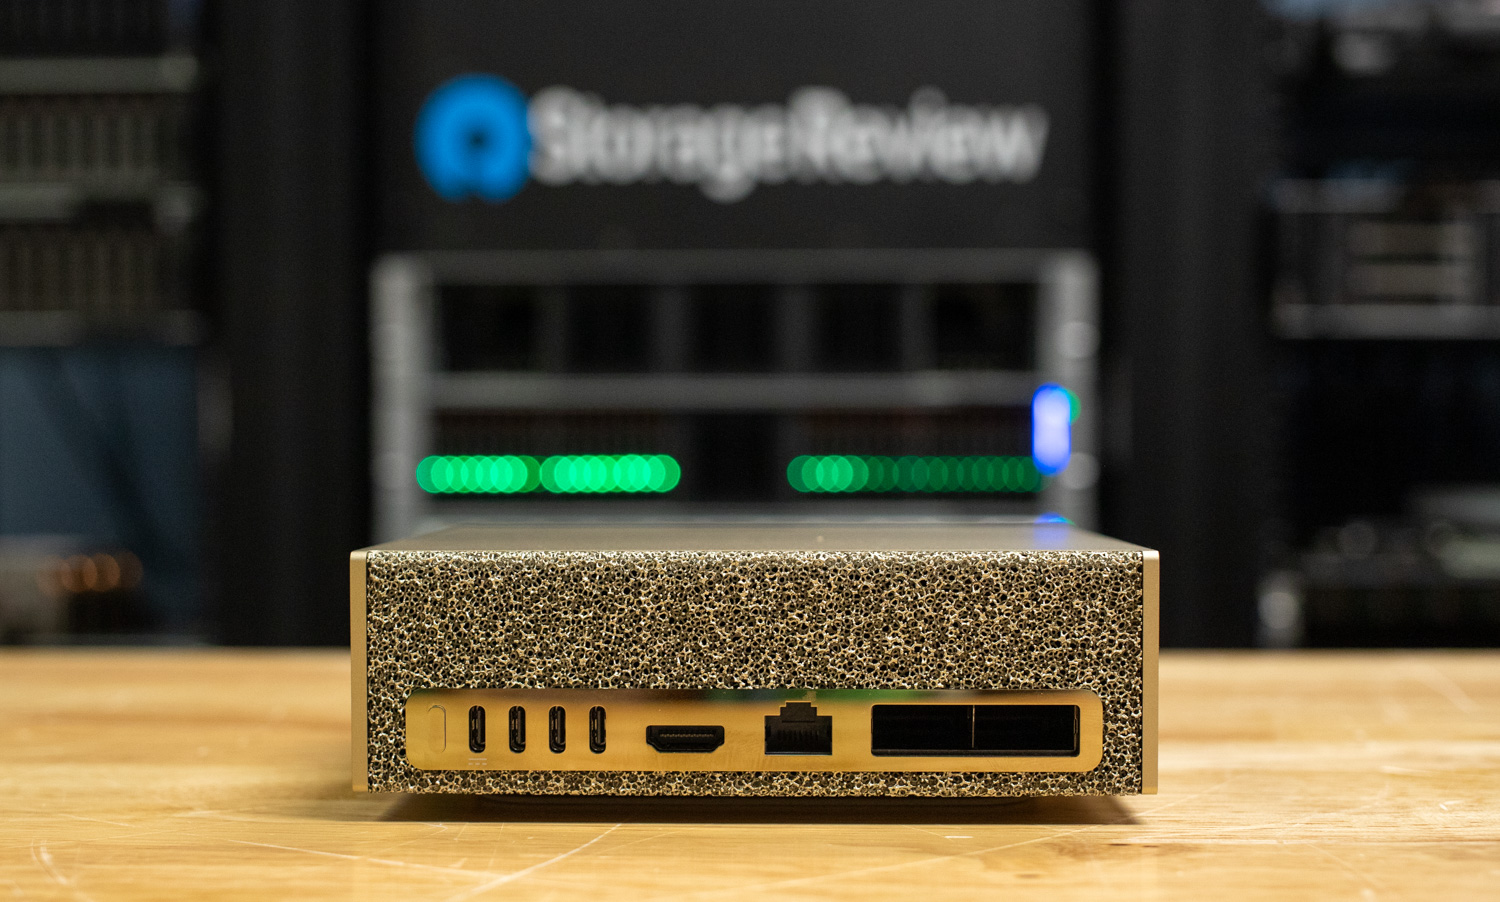
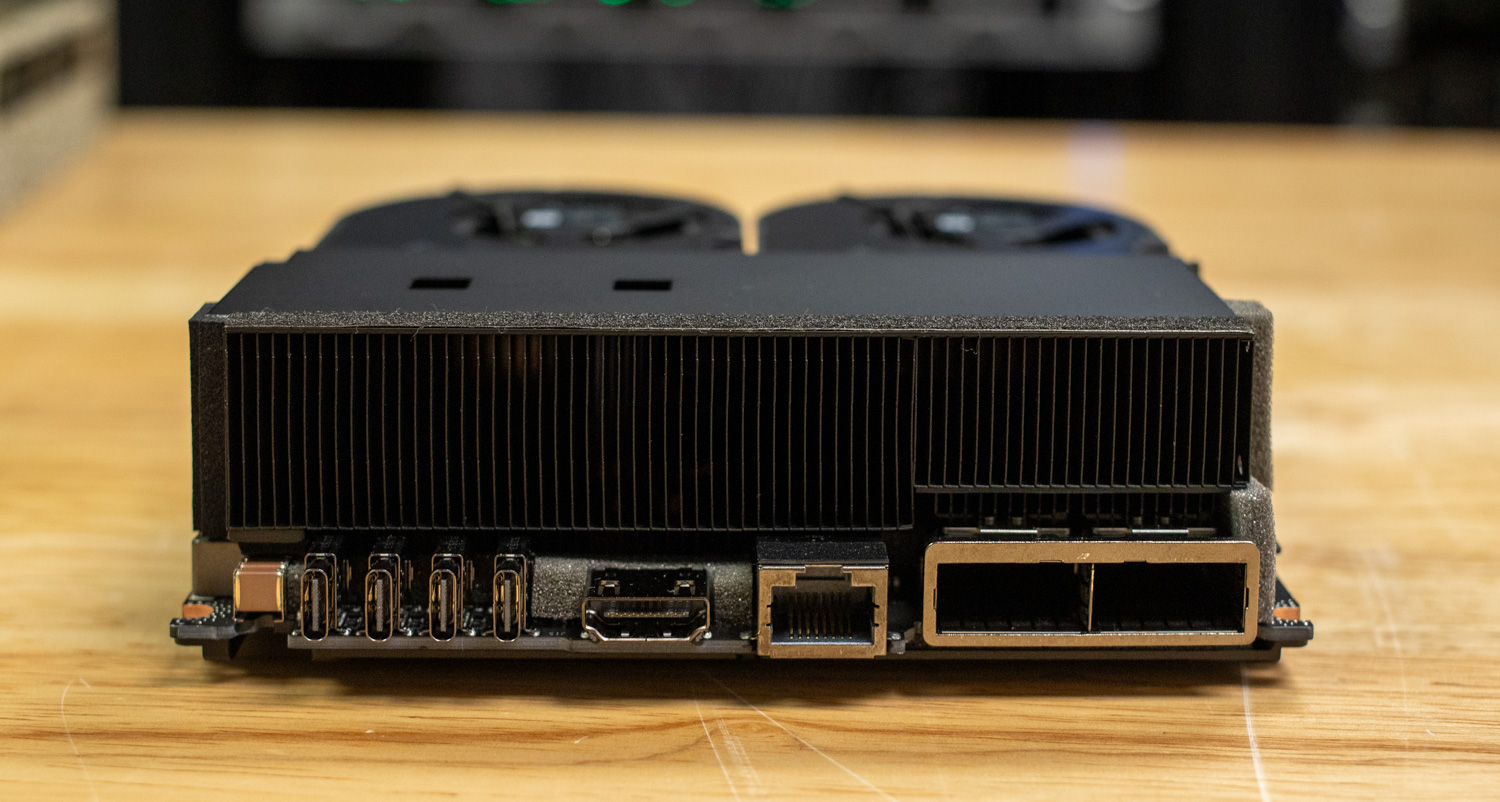
Kijken we naar de achterkant, dan heeft de DGX Spark dezelfde goudkleurige textuur als de voorkant, waardoor een samenhangend ontwerp over de hele behuizing behouden blijft. Vanaf links gezien bevindt de aan/uit-knop zich naast vier USB-C-poorten, waarvan er één Power Delivery voor het apparaat verzorgt. Deze worden gevolgd door een enkele HDMI 2.1a-uitgang, een 10 GbE RJ-45-poort en wat dit apparaat interessant maakt, zijn de twee 200 GbE QSFP56-interfaces, aangestuurd door een geïntegreerde NVIDIA ConnectX-7 SmartNIC.
Op het eerste gezicht zou je kunnen afleiden dat de Spark 400G connectiviteit ondersteunt; helaas biedt de Spark, vanwege PCIe-beperkingen, slechts 200G connectiviteit. Om meer te weten te komen, zijn we dieper ingegaan op de topologie van de Spark:
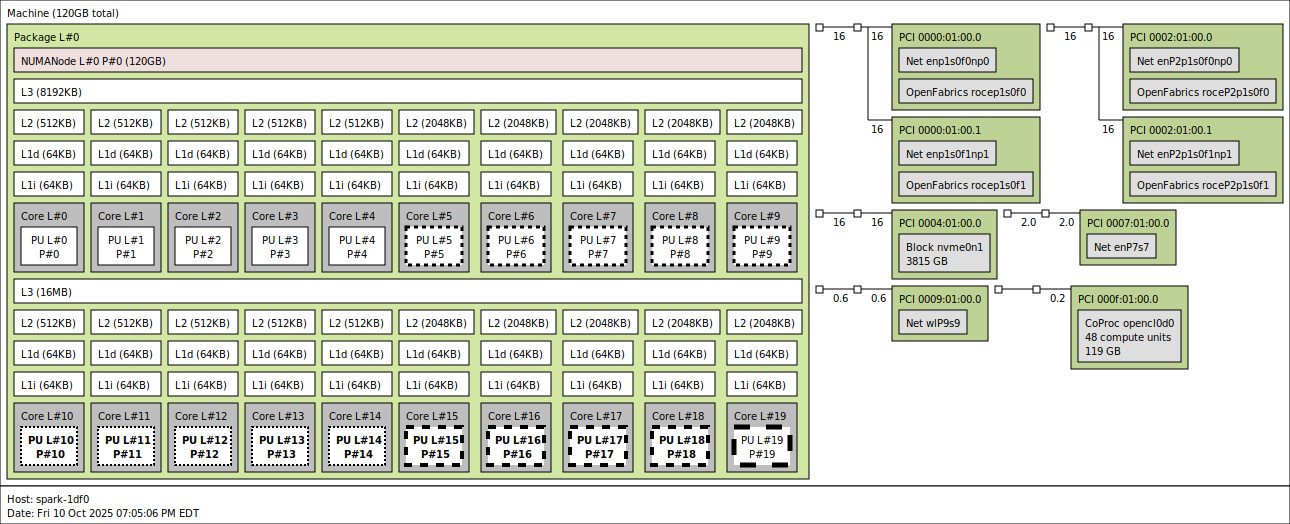
Met behulp van lstopo observeren we de twee interconnects van de CX7 NIC. Elektrisch gezien is de CX7 verbonden via twee Gen5 x4-verbindingen. Binnen het besturingssysteem verschijnen deze verbindingen als vier interfaces, die elk een maximale bandbreedte van 200G ondersteunen. Vanwege de beperkte testtijd konden we niet alle netwerkkenmerken van dit platform ontdekken buiten onze NVMe-oF-tests, die later in dit artikel worden beschreven. We zijn echter van plan dit platform verder te onderzoeken en zullen in toekomstige artikelen dieper ingaan op de mogelijkheden ervan, zoals het clusteren van meerdere sparks voor een minicluster.
Als we naar de andere aangesloten apparaten kijken, is de kleine 2242 form factor M.2 SSD aan de beurt, verbonden met een Gen5 x4, gevolgd door de Realtek RJ45 10GbE-controller verbonden met een PCIe Gen4 x1-verbinding en de MediaTek Wi-Fi-controller verbonden met een PCIe Gen3 x1-verbinding.
De Spark bevat een 20-core Arm-processor met een heterogene Big Little-architectuur, vergelijkbaar met Intels nieuwste processors, bestaande uit 10 efficiënte Cortex-A725-cores en 10 prestatiegerichte Cortex-X925-cores, verdeeld over twee L3-cacheclusters. Het eerste cluster (8 MB L3) bevat CPU's 0-4 (Cortex-A725, max. 2808 MHz) en CPU's 5-9 (Cortex-X925, max. 3900 MHz), terwijl het tweede cluster (16 MB L3) CPU's 10-14 (Cortex-A725, max. 2860 MHz) en CPU's 15-19 (Cortex-X925, max. 3978-4004 MHz) bevat. Elke core heeft een eigen L1-datacache van 64 KB en een L1-instructiecache van 64 KB, maar de L2-cache verschilt aanzienlijk per coretype: de efficiënte Cortex-A725-cores hebben een L2-cache van 512 KB, terwijl de prestatiegerichte Cortex-X925-cores aanzienlijk grotere L2-caches van 2 MB hebben (4× groter). De snelste cores zijn CPU's 15-19, die profiteren van zowel de grotere L3-cache van 16 MB als hogere frequenties, waarbij CPU 19 de core met piekprestaties is op 4004 MHz. Deze verschillende vermogens-/frequentieniveaus worden aangegeven door de stippellijnen op de core in de hierboven weergegeven topologie.
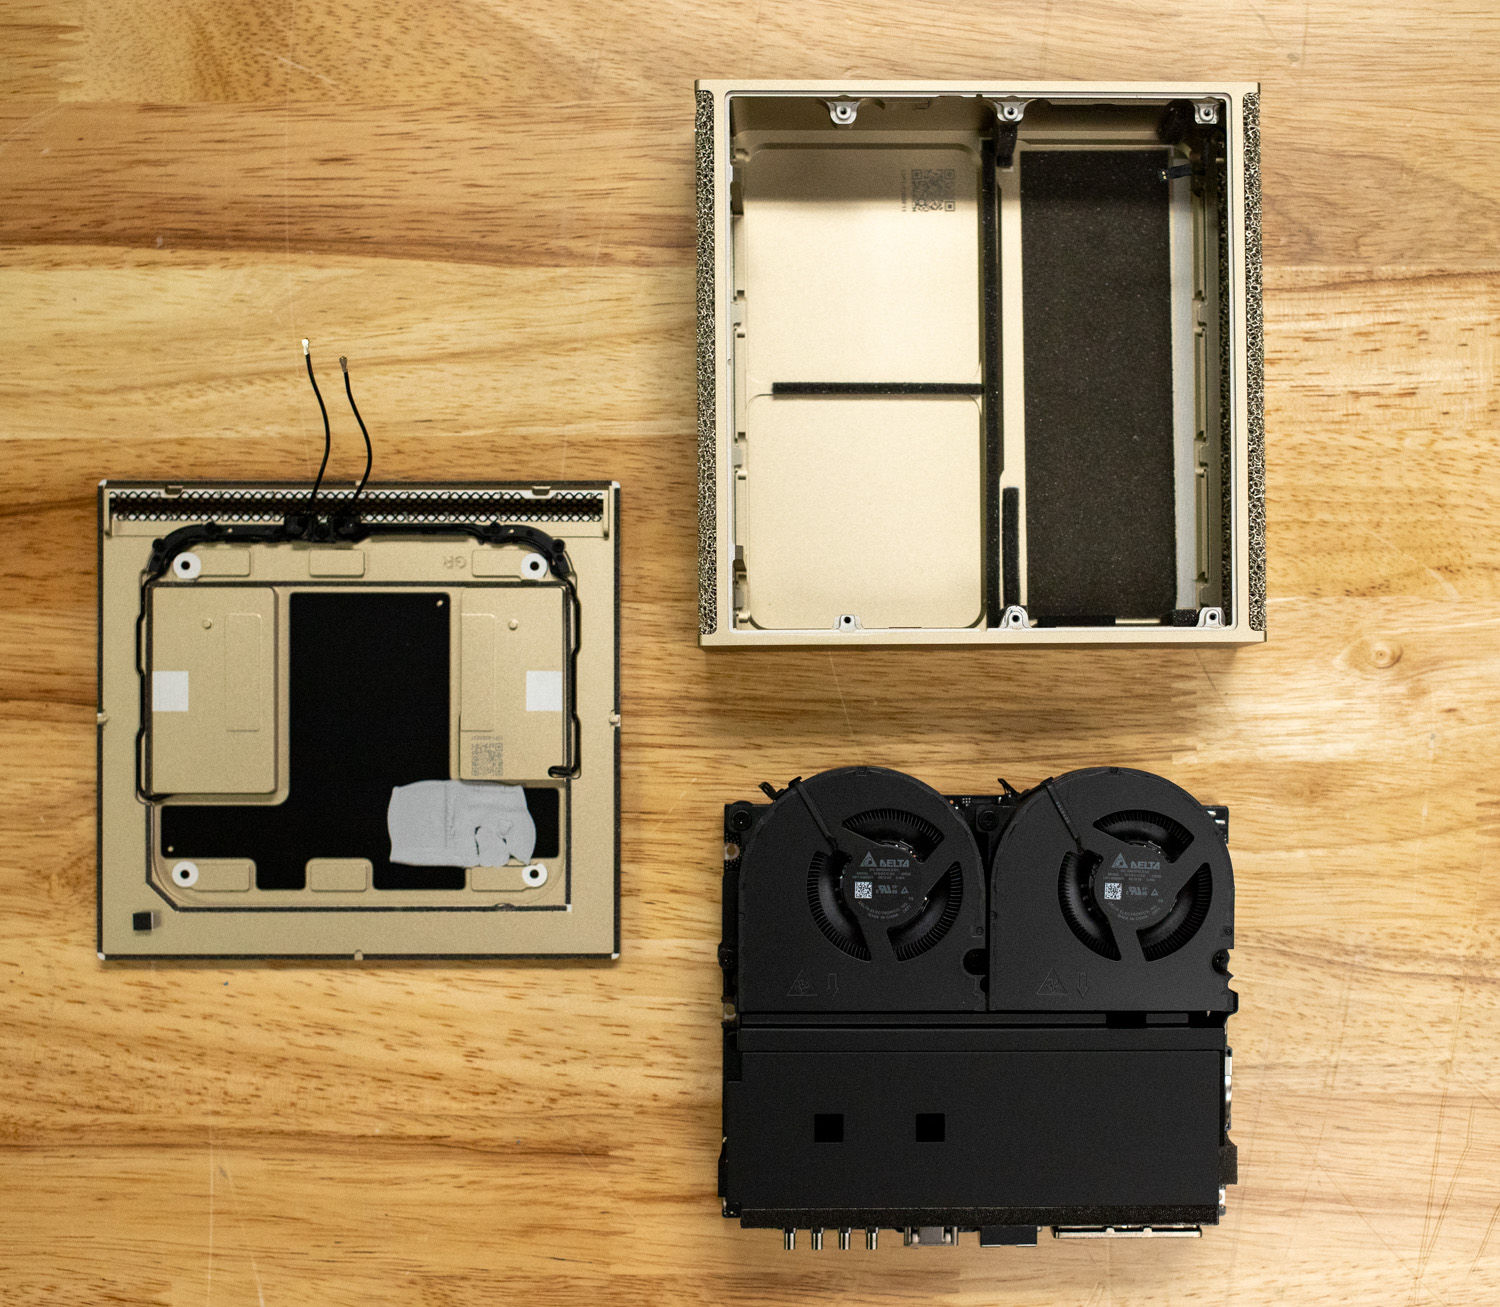
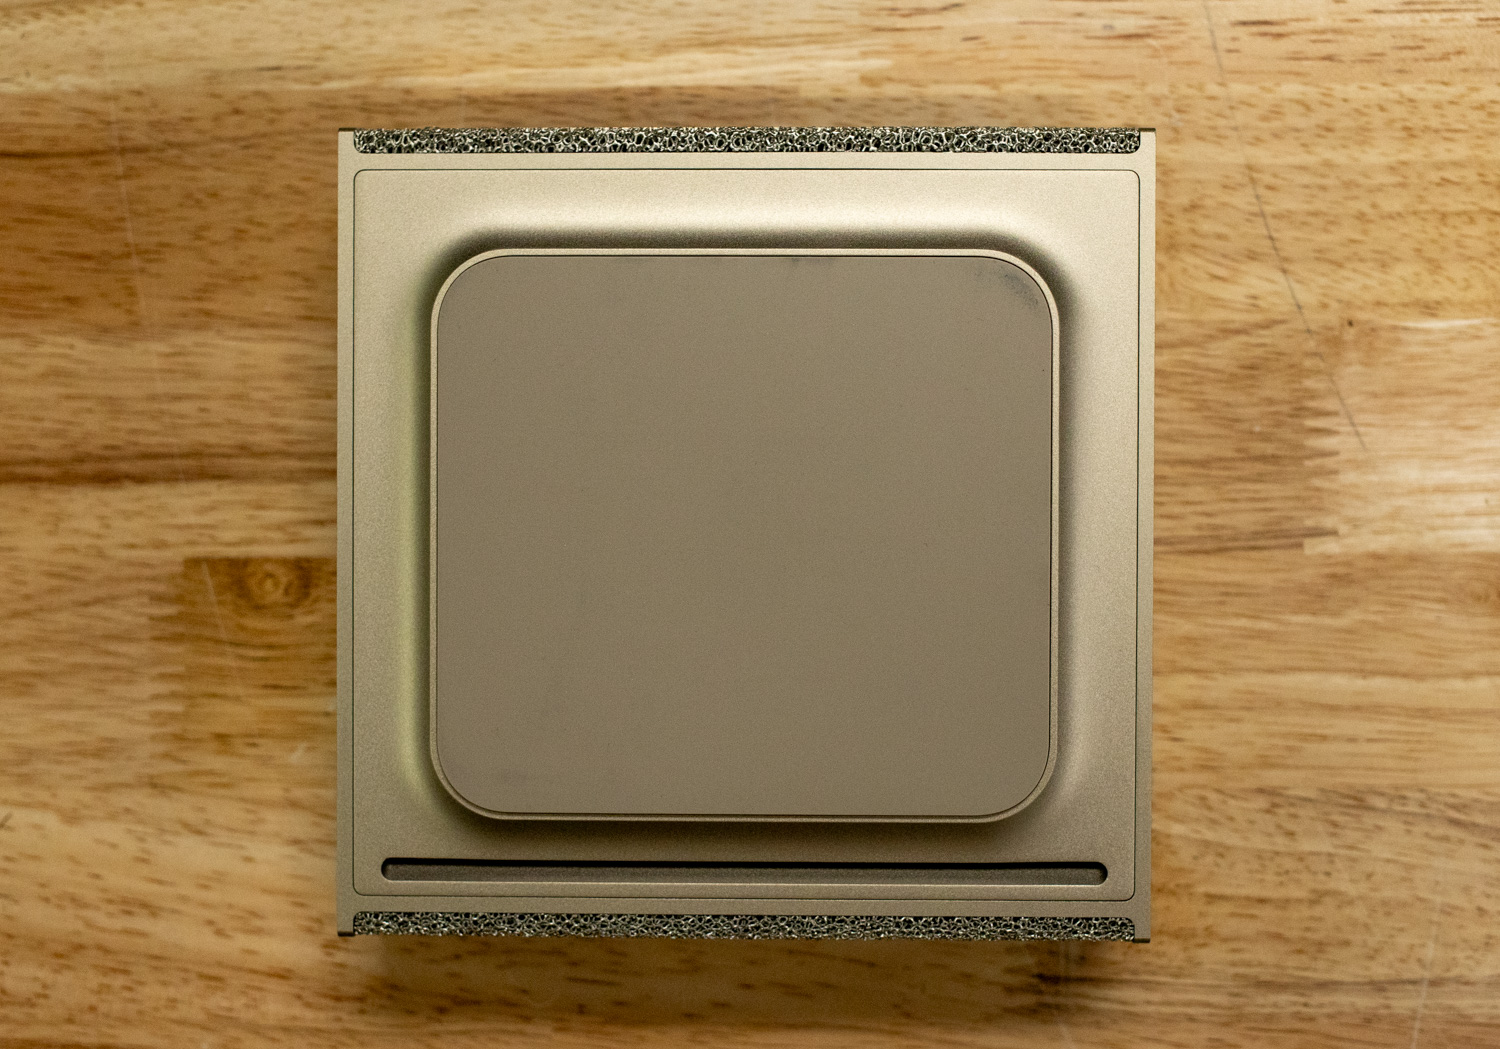
Zoomen we weer uit, dan draaien we de DGX Spark om; het enige zichtbare plastic onderdeel is de bodemplaat, die magnetisch aan de onderkant van de behuizing is bevestigd. Dit ontwerp houdt de buitenkant schoon en biedt tegelijkertijd snelle toegang tot de interne onderdelen. Zodra de magnetische basis is verwijderd, komen vier schroeven tevoorschijn die toegang geven tot het belangrijkste interne compartiment.
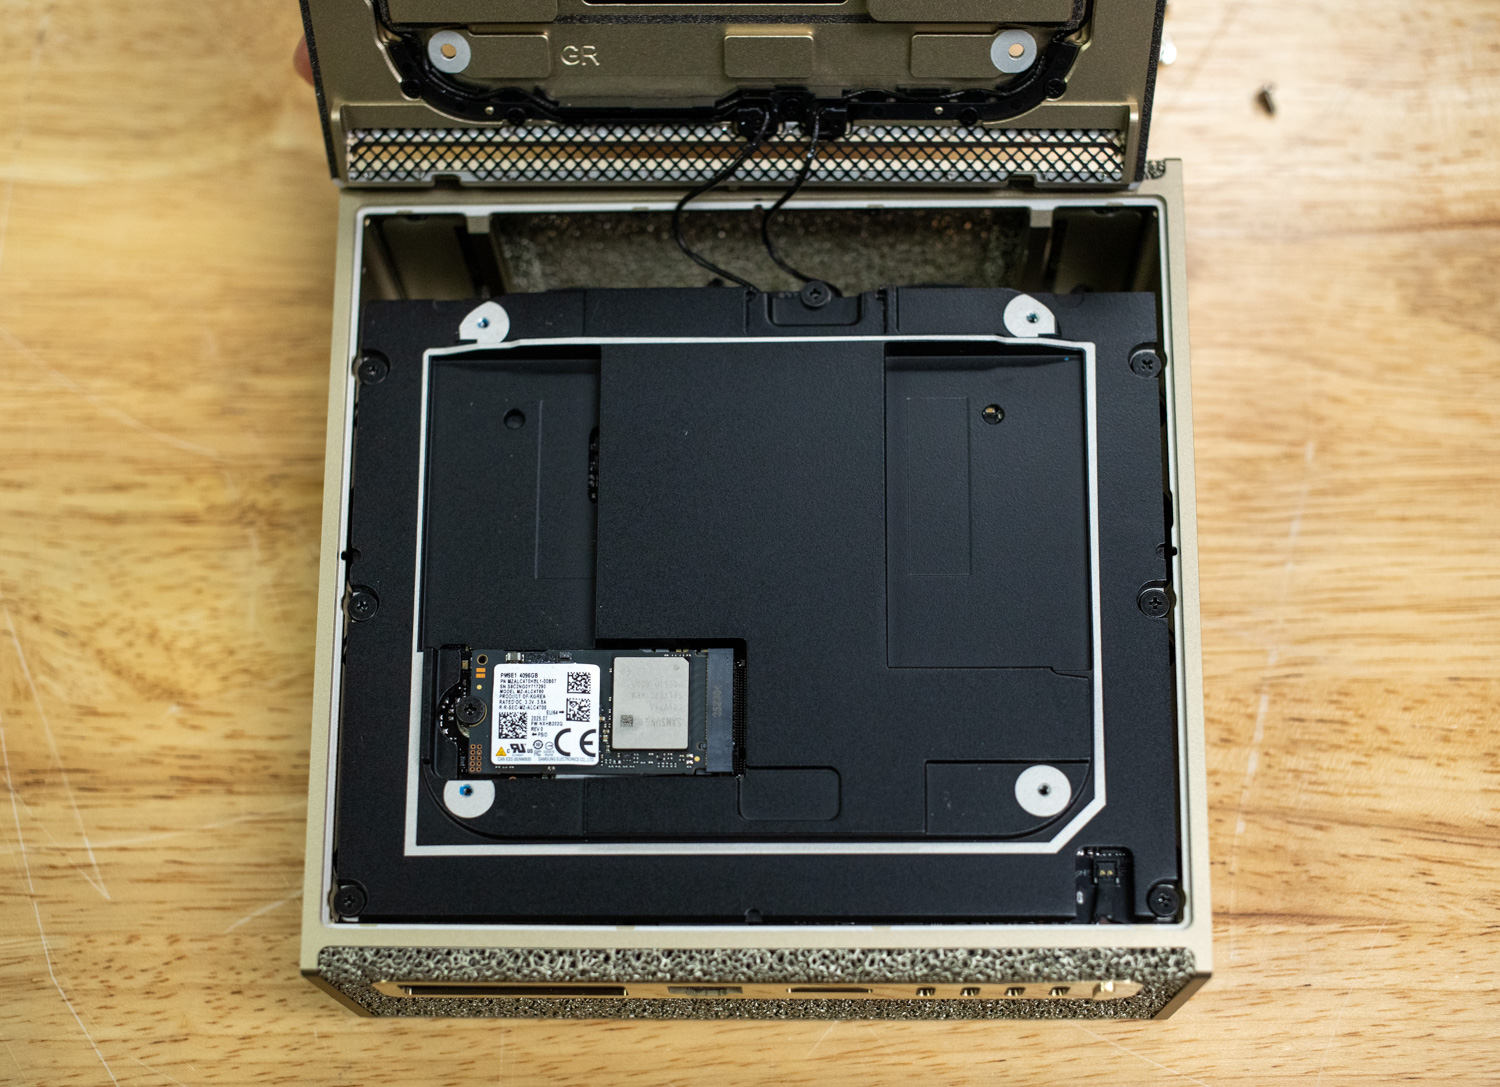
Binnenin zien we antennebedrading die naar het bovenste gedeelte van het apparaat is geleid, wat de aanwezigheid van wifi 7 en Bluetooth 5.3-connectiviteit bevestigt. Dit biedt flexibele netwerkopties, met name handig voor mobiele of laboratoriumomgevingen waar bekabelde toegang mogelijk niet beschikbaar is.
Ook zichtbaar is de opslagoplossing van het apparaat, een PCIe Gen5 2242 M.2 SSD, een minder gebruikelijke vormfactor voor dergelijke krachtige hardware. De hier getoonde configuratie bevat een 4TB Samsung NVMe-schijf in onze configuratie.
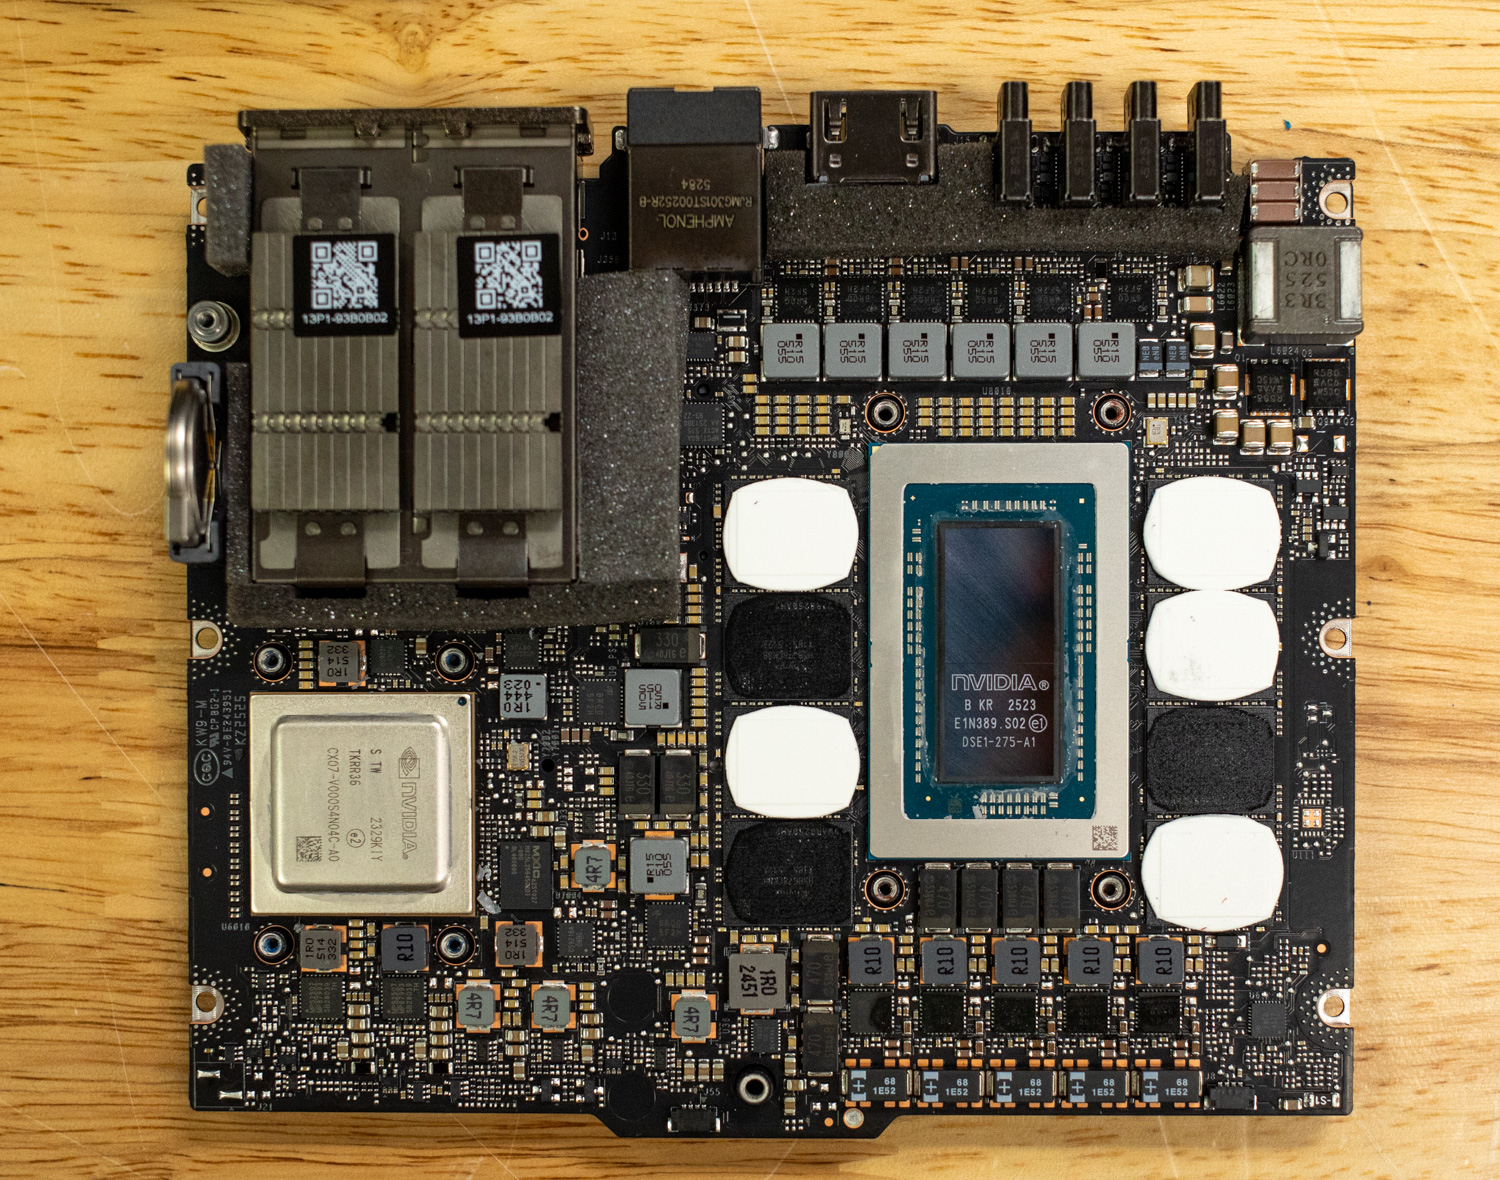
Een diepere blik op de DGX Spark onthult het hart van het systeem: de GB10 Superchip van NVIDIA Grace Blackwell. Naast de GB10 Superchip bevinden zich 8 gesoldeerde LPDDR5X unified systeemgeheugens met een bandbreedte van 273 GB/s, wat zorgt voor snelle gegevenstoegang via zowel CPU als GPU.
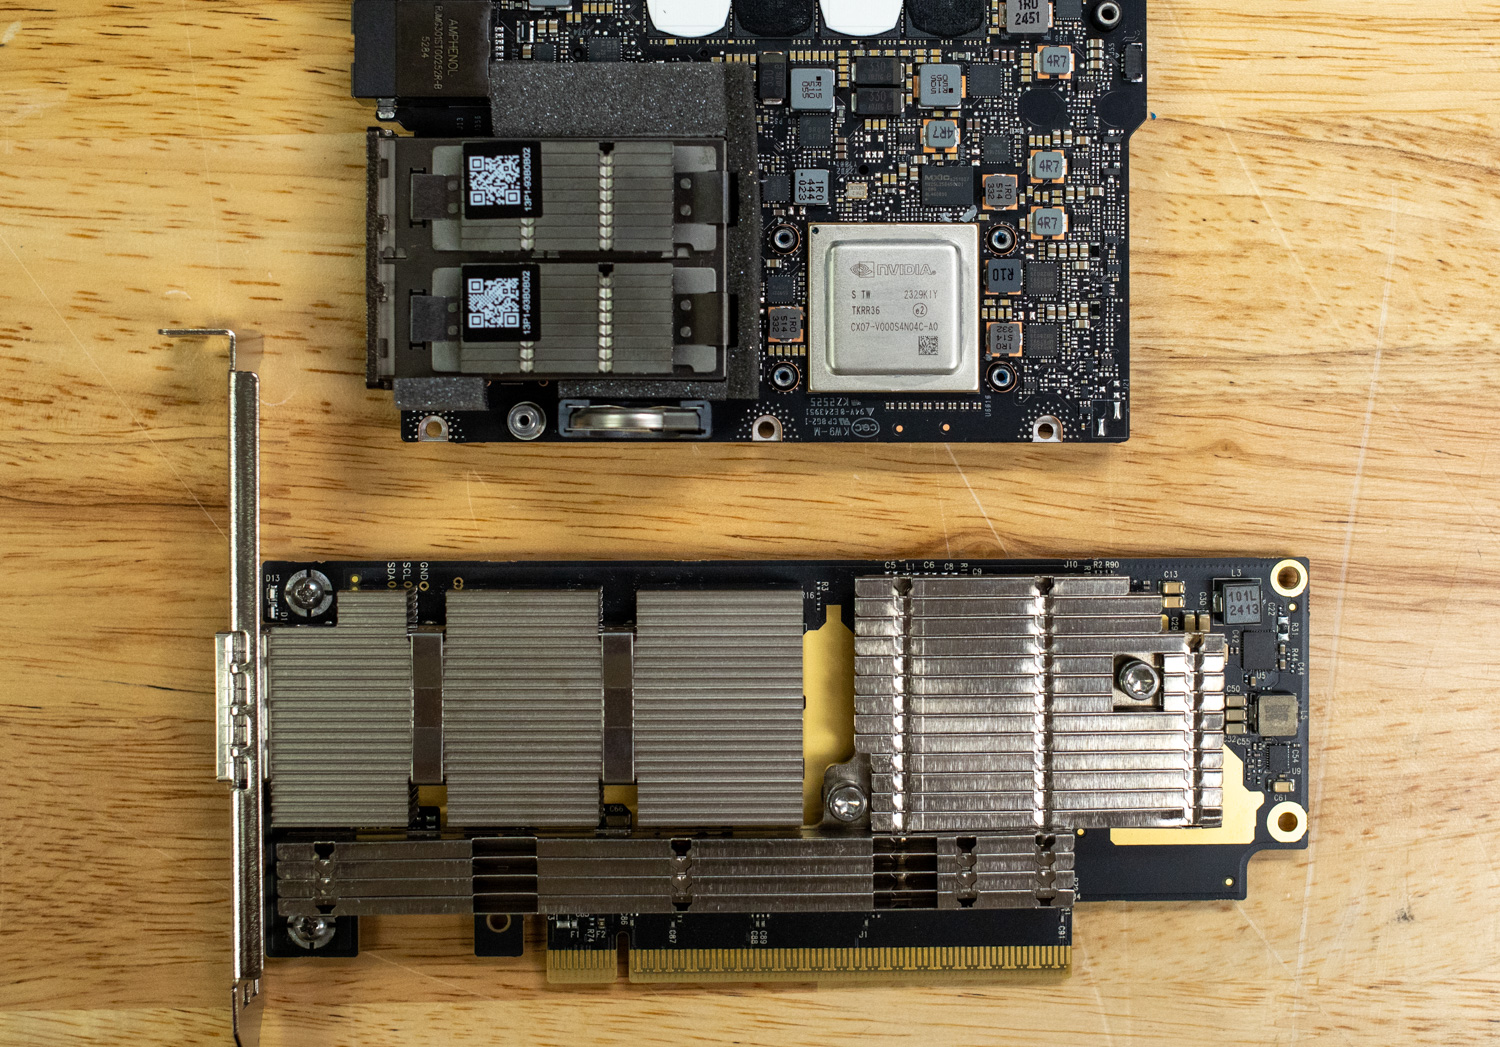
Direct naast de chip bevindt zich de CX7 NIC, die, zoals eerder vermeld, 200G connectiviteit biedt. Dit stelt gebruikers in staat om de Spark aan te sluiten op supersnelle opslag of zelfs meerdere Spark-exemplaren te clusteren. NVIDIA heeft een cluster van twee Sparks gevalideerd en verkoopt deze, die direct kunnen worden aangesloten ter ondersteuning van nog grotere AI-modellen.
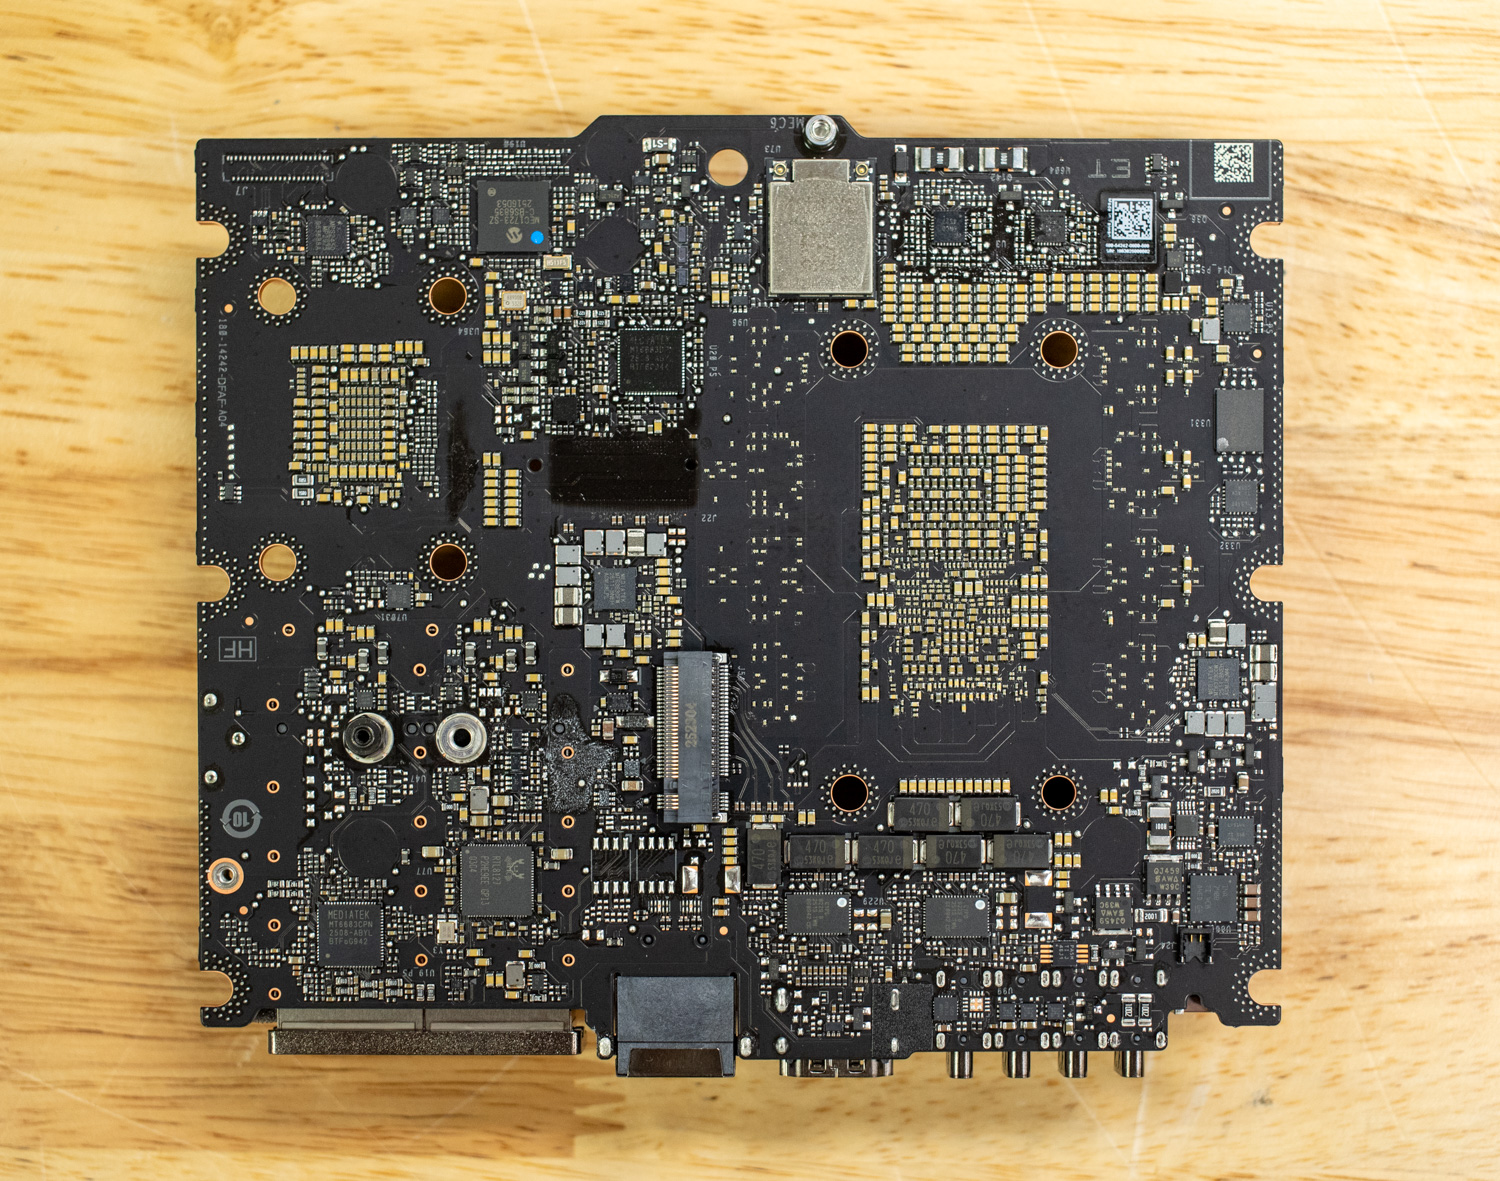
Als je het bord omdraait, zie je alle PCIe-connectiviteit, inclusief de PCIe Gen5 x4 2242 M.2 SSD en de PCIe Gen3x1 MediaTek Wi-Fi-adapter.
Waar Spark onmisbaar wordt: de moderne AI-ontwikkelingstoepassing
De DGX Spark is met name geschikt voor diverse professionele toepassingen, waarbij de unieke combinatie van uniform geheugen, compacte vormfactor en uitgebreide software-integratie de doorslag geeft.
Versnelling van datawetenschap: van panda's naar productie
Voor datawetenschappers vertegenwoordigt de NVIDIA DGX Spark een enorme verbetering in workflowsnelheid en -ervaring. Het ConnectX-7-netwerk met een bandbreedte van 200 Gbps, gecombineerd met CUDA X-acceleratiebibliotheken, transformeert datavoorbewerking. AI en data science zijn gebaseerd op de basis van goede data-invoer en goede data-uitvoer. Traditioneel gezien is de meest tijdrovende fase van elk conventioneel ML-project datacleaning en feature-extractie. Conventionele workflows omvatten doorgaans het laden van datasets in tools zoals Pandas en het uitvoeren van transformaties op CPU-cores, wat over het algemeen traag is. Handmatige exploratie en feature-engineering kunnen ook een aanzienlijke belemmering vormen. Spark maakt end-to-end GPU-acceleratie mogelijk via RAPIDS.
Een typisch scenario voor data science in bedrijven omvat feature engineering op datasets van 40-80 GB: het samenvoegen van meerdere tabellen, het berekenen van aggregaties over tijdvensters, het verwerken van categorische codering en het normaliseren van distributies. Op de CPU-infrastructuur kan deze voorverwerking uren duren. Met RAPIDS cuDF die de volledige dataset in het 128 GB grote unified memory van Spark laadt, worden deze bewerkingen binnen enkele minuten voltooid met een versnelling van 10x of hoger. De daaropvolgende modeltraining profiteert evenzeer van klassieke ML met cuML als van deep learning met PyTorch, waardoor de traditionele bottleneck wordt geëlimineerd waarbij datawetenschappers wachten op infrastructuur in plaats van te itereren op hypothesen.
Synthetische datageneratie: robotica en simulatie
De integratie van vierde-generatie RT Cores positioneert Spark uniek voor een opkomende workflow: het genereren van synthetische data voor het trainen van wereldmodellen. Het trainen van robuuste manipulatiestrategieën vereist traditioneel tienduizenden realistische demonstraties, wat buitengewoon duur en tijdrovend is. Fotorealistische simulaties in platforms zoals Isaac Sim of Omniverse bieden een alternatief, maar het renderen van raytracing-beelden met fysiek accurate belichting, reflecties en materialen vereiste historisch gezien dure workstation-GPU's zoals de NVIDIA L40S en RTX 6000 Ada.
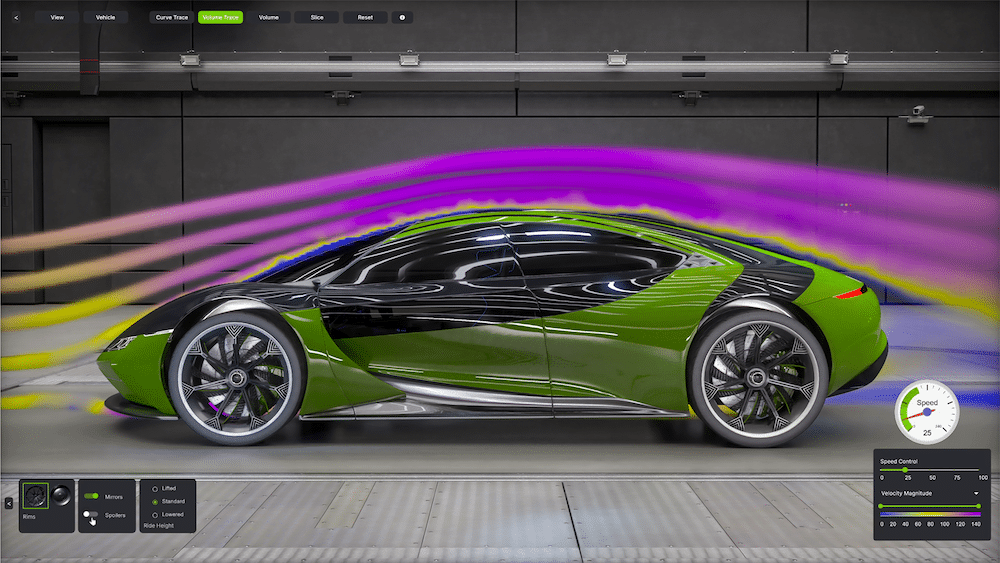
Bron: NVIDIA
Spark consolideert deze workflow. RT Cores stellen OpenUSD-workloads in staat om synthetische data te genereren, terwijl Tensor Cores worden gebruikt voor AI-inferentie in een blauwdruk/workflow. Voorheen konden organisaties meerdere machines inzetten voor rendering en een aparte, voor inferentie geoptimaliseerde server. Nu is dit haalbaar in één apparaat van 240 W. Voor robotica-startups, universitaire laboratoria of autofabrikanten die autonome manipulatie verkennen, verkort deze integratie de ontwikkeltijd en kapitaaluitgaven aanzienlijk.
We hebben eerder vergelijkbare pijplijnen voor het genereren van synthetische data onderzocht met behulp van speciale L40S-renderingsystemen in combinatie met H100 voor inferentie, zoals beschreven in onze eerdere berichtgeving over NVIDIA L40S. De architecturale samenvoeging van deze mogelijkheden in de GB10 in één ontwikkelomgeving vertegenwoordigt een veelbelovende evolutie van deze workflow. We zijn van plan om in een toekomstige analyse de prestaties van Spark's RT Core te testen ten opzichte van deze afzonderlijke configuraties, waarbij we rendering en andere workloads voor representatieve robotmanipulatiescenario's zullen onderzoeken.
De Vibe-coderingsrevolutie
Andrej Karpathy, voormalig AI-directeur van Tesla en oprichter van OpenAI, bedacht de term 'vibe coding' om een opkomende aanpak voor snelle softwareontwikkeling met AI-ondersteuning te beschrijven. In plaats van code minutieus regel voor regel te schrijven, maakt vibe coding gebruik van LLM's als interactieve pair programmeurs: beschrijf functionaliteit in natuurlijke taal, genereer implementatie-scaffolding, itereer door conversatieverfijning en maak snel prototypes van functies. Deze workflow transformeert coderen van doelbewuste constructie naar begeleide conversatie met een AI die context, API's en architectuurpatronen begrijpt, waardoor individuele ontwikkelaars opmerkelijk geavanceerde systemen kunnen bouwen met ongekende snelheid.
De omvang van de adoptie van AI-ondersteund programmeren blijkt uit de gebruiksstatistieken van OpenRouter , waar modellen die zich richten op programmeren consequent het grootste deel van de inferentievolumes uitmaken. Technische professionals, de belangrijkste doelgroep voor 'vibe coding', fungeren doorgaans als gevorderde gebruikers en draaien meerdere programmeeragents parallel in verschillende contexten. En naarmate open-source modellen steeds beter presteren dan propriëtaire alternatieven op belangrijke benchmarks , onderzoeken ontwikkelaars lokale implementaties van inferentie om snelheidsbeperkingen te elimineren, beschikbaarheid te garanderen tijdens cruciale ontwikkelfasen en de vertrouwelijkheid van code voor propriëtaire projecten te waarborgen.
De r/LocalLLaMA-community presenteert werkelijk indrukwekkende maatwerkconfiguraties, variërend van multi-GPU-werkstations tot met ducttape aan elkaar geplakte servers met lokale modellen, gedistribueerde inferentie over consumentenhardware en uitgebreide koeloplossingen die een continue hoge doorvoer mogelijk maken. Deze configuraties brengen echter aanzienlijke barrières met zich mee: kapitaaluitgaven die vaak meer dan tienduizenden dollars bedragen, een hoog stroomverbruik, uitdagingen op het gebied van thermisch beheer die speciale ruimtes vereisen in plaats van standaard kantooromgevingen, en aanzienlijke technische expertise voor configuratie, optimalisatie en probleemoplossing.
Spark verandert deze waardepropositie fundamenteel. Voor $ 3,999 met 128 GB unified memory levert het indrukwekkende modelinferentieprestaties in een stil, compact en energiezuinig apparaat dat slechts 240 W verbruikt. Gebruikers die een lokale infrastructuur voor codeerassistenten willen opzetten, hebben geen uitgebreide thuislabs meer nodig die kilowattuur verbruiken en een aanzienlijke warmteafgifte genereren. De gevalideerde appliance-aanpak met vooraf geconfigureerd DGX OS elimineert de configuratiecomplexiteit die voorheen de lokale LLM-implementatie beperkte tot gebruikers met diepgaande Linux- en CUDA-expertise.
Spark elimineert niet alleen infrastructuurproblemen, maar pakt ook kritieke aandachtspunten aan rondom codeprivacy en modelaanpassing. Cloudgebaseerde codeerassistenten verzenden broncode noodzakelijkerwijs naar externe servers, wat een no-go is voor organisaties die werken met bedrijfseigen algoritmen, beveiligingskritieke infrastructuur of gereguleerde data. Lokale inferentie in Spark zorgt ervoor dat code de ontwikkelomgeving nooit verlaat. Bovendien maakt de geheugencapaciteit van 128 GB volledige parameterafstemming van codeermodellen mogelijk, waardoor ervaren ontwikkelaars modellen kunnen specialiseren op interne codebases. Deze mogelijkheid is met name waardevol voor organisaties met domeinspecifieke talen, aangepaste frameworks of architectuurpatronen die onvoldoende worden gerepresenteerd in openbare trainingsdata.
Fine-tuning met NVIDIA NeMo op DGX Spark
Het 128 GB unified geheugen van de DGX Spark maakt volledige parameterfine-tuning van 8B-modellen mogelijk, waarvoor traditioneel dure multi-GPU cloudconfiguraties nodig waren. Volledige fine-tuning van Qwen3 8B met standaard Adam-optimalisatie vereist ongeveer 132 GB (16 GB modelgewichten, 96 GB optimizerstatussen, 16 GB gradiënten, plus activeringen), wat meer is dan dual H100 80 GB-configuraties. Door gebruik te maken van geheugenefficiënte 8-bit Adam-technologie, wordt de vereiste teruggebracht tot ongeveer 70 GB, afhankelijk van de batchgrootte, wat ruimschoots binnen de geheugenpool van Spark past. Dit is belangrijk omdat volledige fine-tuning 4-6% betere nauwkeurigheid oplevert dan LoRA bij complexe redeneertaken. Waar cloudgebaseerde 2× H100 80 GB-configuraties ongeveer $ 5 per uur kosten met gedistribueerde trainingscomplexiteit, biedt Spark training voor één systeem tegen een eenmalige investering van $ 3,999.
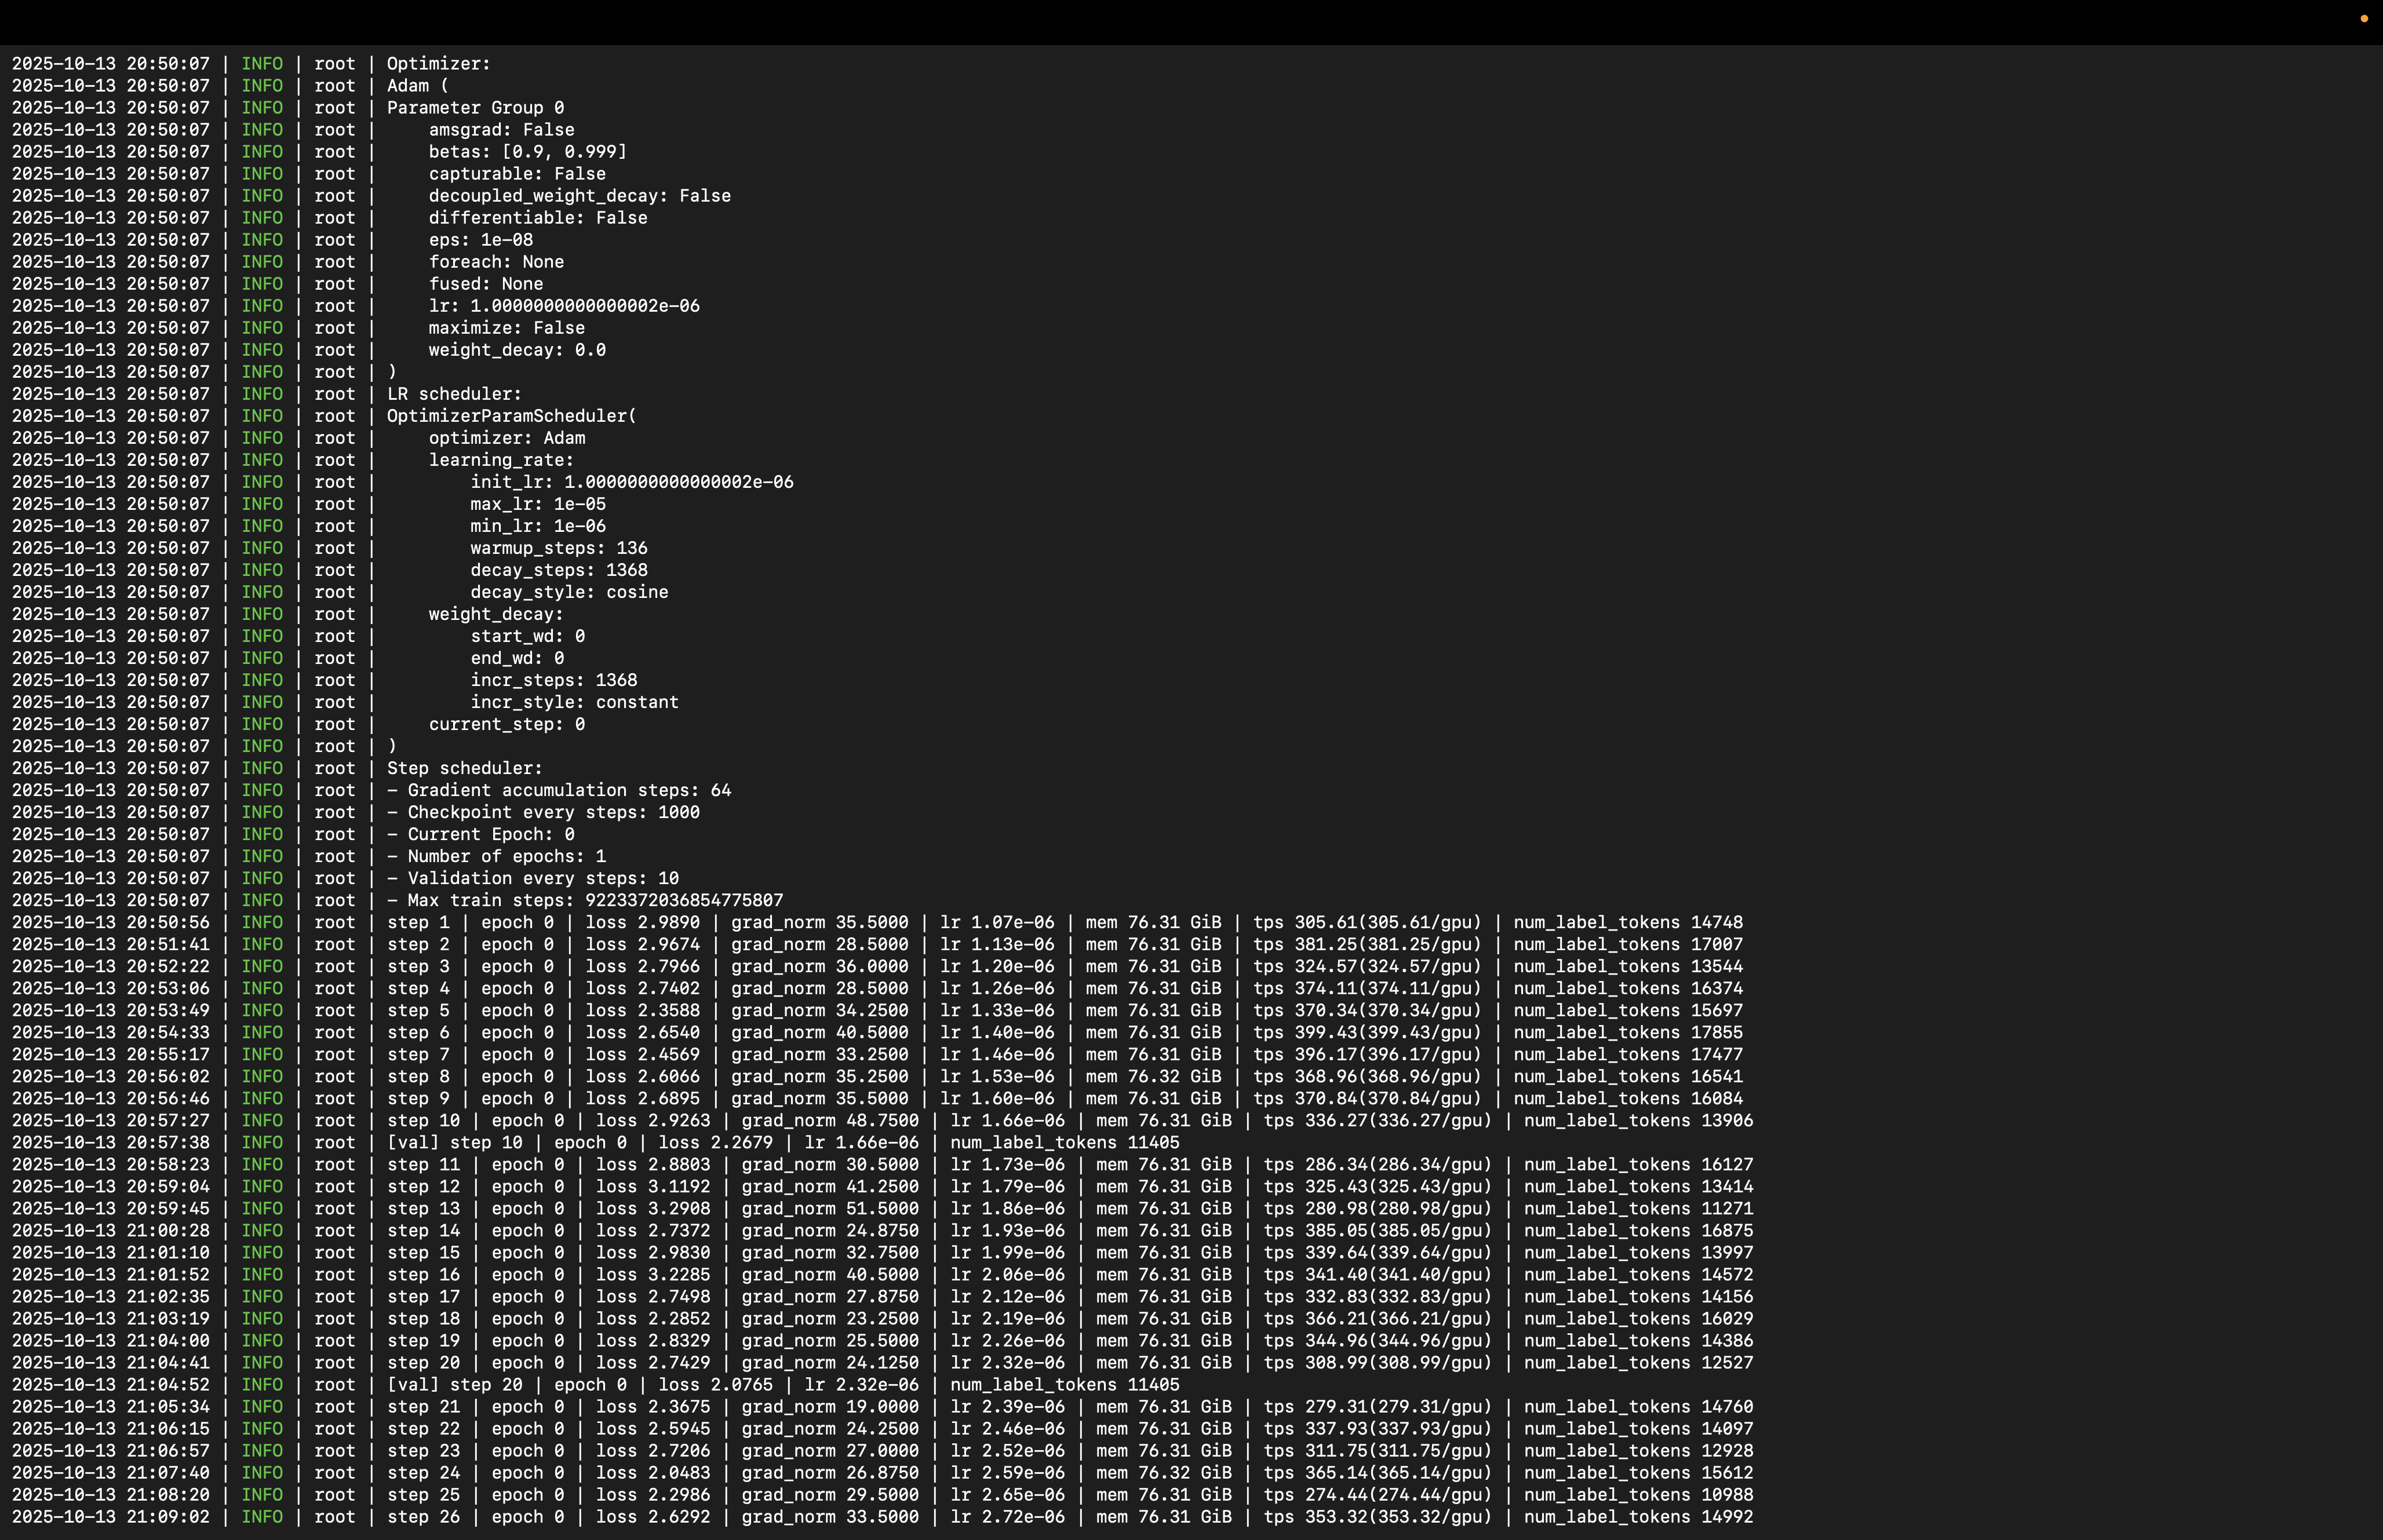
NVIDIA NeMo Automodel elimineert de frictie van het enterprise training framework door Day-0-ondersteuning te bieden voor elk Hugging Face-model zonder checkpointconversie. Laad Qwen3 8B rechtstreeks vanuit HuggingFace Hub en configureer de finetuning via YAML-bestanden met datasetbronnen, optimizerinstellingen en LoRA-doelen. NeMo automatiseert gedistribueerde checkpointing met safetensorcompatibiliteit, implementeert gefuseerde CUDA-kernels voor 2-5x snellere prestaties en verwerkt gradiëntaccumulatie.
Afbeeldingen genereren met Comfy UI
ComfyUI biedt een knooppuntgebaseerde grafische interface die stabiele diffusie en gerelateerde diffusiemodellen omzet in zeer aanpasbare creatieve pipelines. In tegenstelling tot traditionele webinterfaces die complexiteit abstraheren achter vereenvoudigde parameterschuifregelaars, maakt ComfyUI gebruik van een visuele grafiekarchitectuur waarbij gebruikers workflows construeren door afzonderlijke functionele knooppunten te verbinden, die elk specifieke bewerkingen vertegenwoordigen, zoals modelladen, promptcodering, latente diffusiebemonstering, VAE-decodering of opschalingstransformaties. Dit modulaire ontwerp maakt gedetailleerde controle over de gehele generatiepipeline mogelijk, waardoor elke rekenstap transparant en aanpasbaar is. Het stelt gebruikers ook in staat om meerdere modellen aan elkaar te koppelen, aangepaste bemonsteringsschema's te implementeren of geavanceerde technieken zoals ControlNet-begeleiding te integreren, wat onmogelijk zou zijn in vereenvoudigde interfaces.
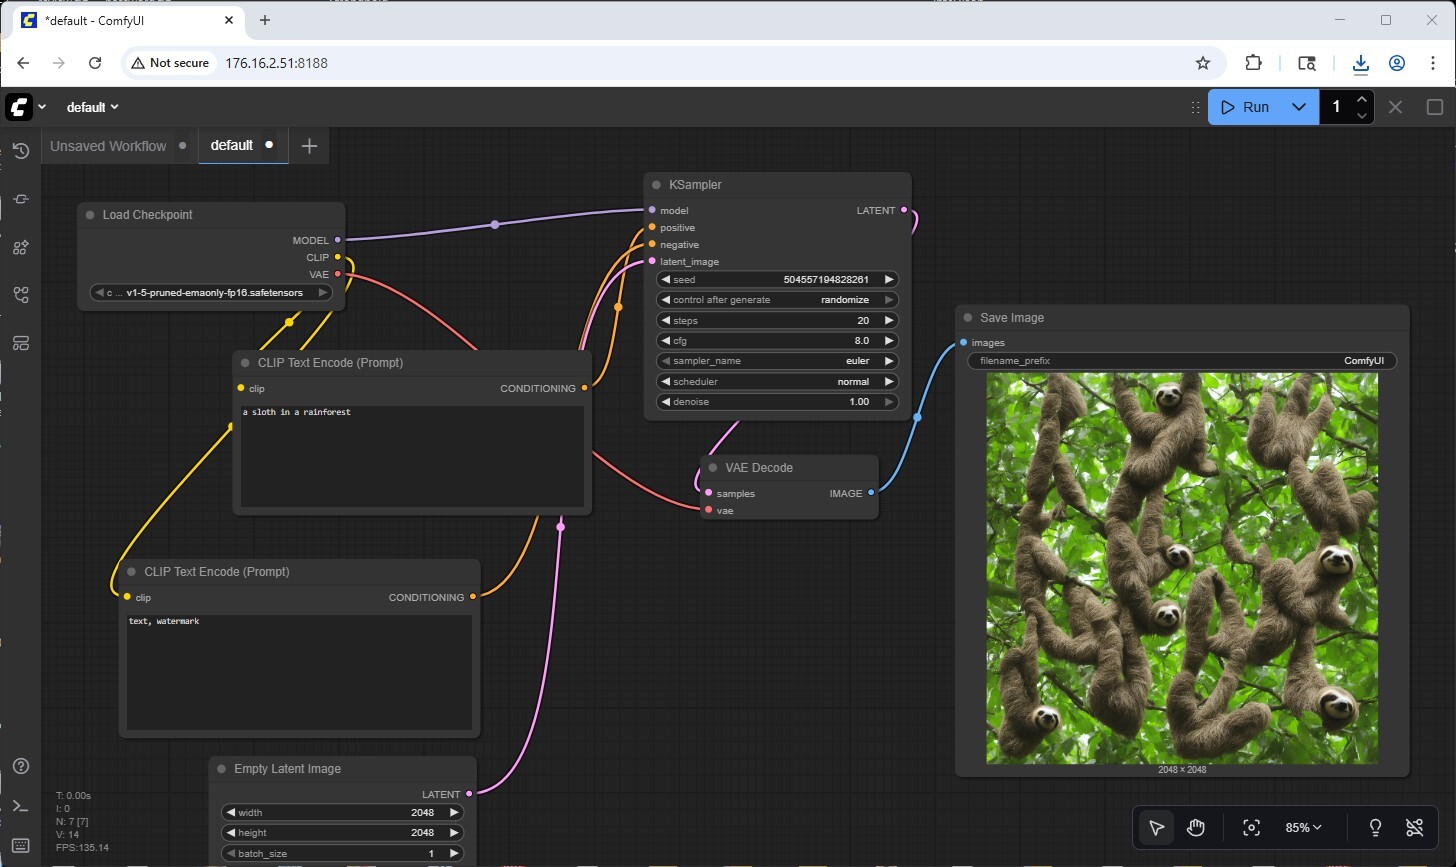
Op DGX Spark maakt ComfyUI gebruik van de Tensor Cores van de Blackwell GPU voor versnelde diffusiesampling, waarbij generaties doorgaans binnen 15-30 seconden worden voltooid, afhankelijk van de complexiteit van de sampling. De 128 GB unified memory-architectuur blijkt bijzonder voordelig te zijn, omdat meerdere checkpoint-modellen, LoRA-adapters en VAE-decoders gelijktijdig in het geheugen worden bewaard, waardoor de herlaadoverhead die systemen met VRAM-beperkingen teistert, wordt geëlimineerd. Gebruikers kunnen effectief onbeperkt AI-illustraties lokaal genereren, zonder API-snelheidslimieten, cloudkosten per generatie en privacyproblemen die gepaard gaan met gepatenteerde creatieve workflows. Het workflow-persistentiemodel voegt operationele waarde toe: complete pipelines worden geserialiseerd naar JSON-bestanden die versiebeheer kunnen krijgen, tussen teams kunnen worden gedeeld of direct als metadata in gegenereerde afbeeldingen kunnen worden ingesloten. Dit maakt reproduceerbaarheid cruciaal voor organisaties die synthetische dataset-pipelines bouwen of een consistente artistieke stijl voor gegenereerde assets behouden.
NVIDIA DGX Spark-prestatietests
vLLM Online Serving – LLM Inferentietest
vLLM is de populairste high-throughput inferentie- en serverengine voor LLM's. De vLLM online serverbenchmark is een prestatie-evaluatietool die is ontworpen om de real-world servercapaciteiten van deze inferentie-engine te meten bij het verwerken van gelijktijdige verzoeken. Het simuleert productieworkloads door verzoeken te sturen naar een actieve vLLM-server met configureerbare parameters, zoals verzoeksnelheid, invoer-/uitvoerlengtes en het aantal gelijktijdige clients. De benchmark meet belangrijke statistieken, waaronder doorvoer (tokens per seconde, tijd tot eerste token en tijd per uitvoertoken), waardoor gebruikers beter begrijpen hoe vLLM presteert onder verschillende belastingsomstandigheden.
We hebben de inferentieprestaties getest in een uitgebreid pakket modellen die de populairste architecturen en modeltypen in productieomgevingen van dit moment vertegenwoordigen.
Mix van Expertmodellen
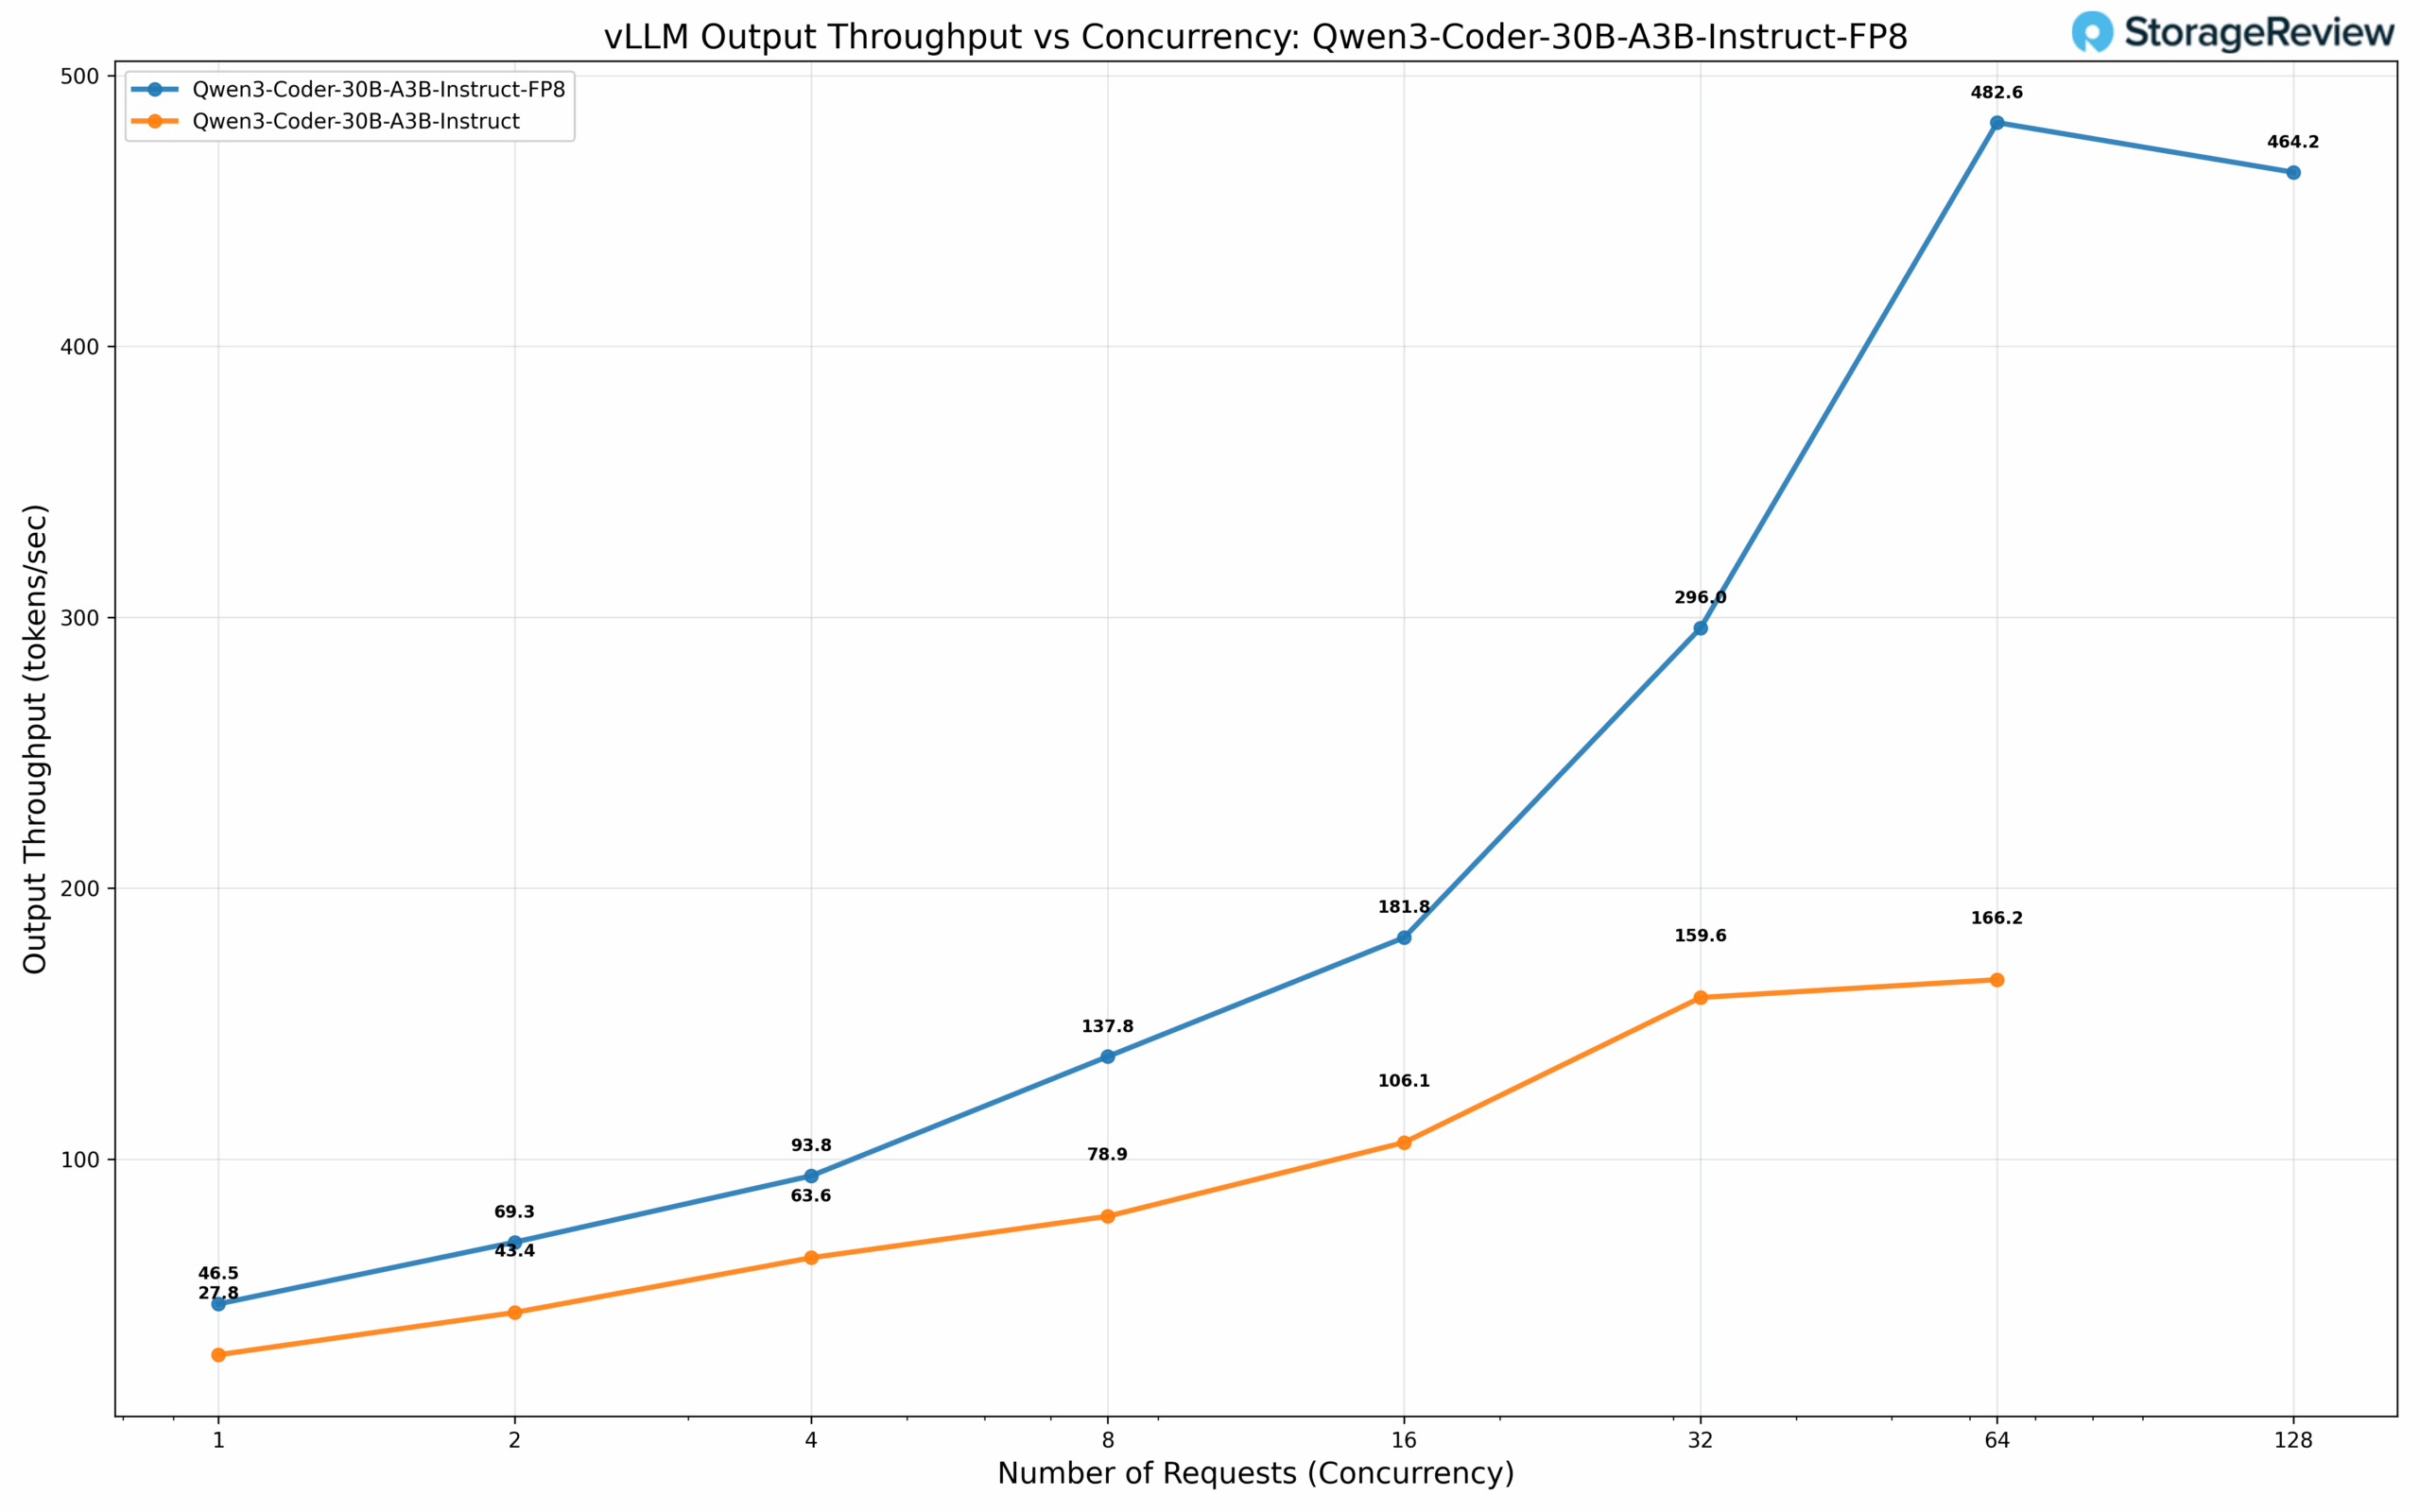
We hebben de Qwen3 Coder 30B-A3B geëvalueerd, een van de populairste coderingsmodellen voor lokale inferentie-implementaties. Deze spaarzame architectuur handhaaft een volledige modelgrootte van 30B parameters met BF16-precisie, terwijl er slechts 3B parameters per gegenereerd token worden geactiveerd. We hebben zowel het standaardmodel als een FP8-gekwantiseerde variant van Qwen gebenchmarkt. Het FP8-gekwantiseerde model laat aanzienlijke prestatieverbeteringen zien: het behaalt 46.5 tok/s bij gelijktijdigheid 1, en schaalt op naar een indrukwekkende 482.6 tok/s bij batchgrootte 64. Het standaard BF16-model levert 27.8 tok/s bij gelijktijdigheid 1, en bereikt 166.2 tok/s bij batchgrootte 64, een prestatieverschil van bijna 3x.
Dichte modellen
Dichte modellen vertegenwoordigen de conventionele LLM-architectuur waarbij alle parameters en activaties tijdens de inferentie worden geactiveerd, wat resulteert in een meer rekenintensieve verwerking in vergelijking met hun spaarzame tegenhangers. Om de prestatiekenmerken op verschillende modelschalen en kwantiseringsstrategieën uitgebreid te evalueren, hebben we vijf dichte modelconfiguraties gebenchmarkt.
Onze testsuite omvatte Mistral Small 3.1 24B van Mistral AI met BF16-precisie, naast een dynamisch gekwantiseerde Mistral Small 3.1 24B FP8-variant van RedHat AI. Dynamische kwantisering maakt gebruik van selectieve gewichtskwantiseringstechnieken om de afweging tussen prestatie en nauwkeurigheid te optimaliseren, waarbij de precisie strategisch wordt verlaagd en de modeldegradatie tot een minimum wordt beperkt. We hebben deze grotere, compacte modellen aangevuld met Meta Llama 3.1 8B-evaluaties in drie precisieformaten: de standaard BF16-configuratie, plus gekwantiseerde FP8- en FP4-versies van NVIDIA. Deze modelselectiestrategie maakt directe prestatievergelijking over modelschalen mogelijk, terwijl de impact van progressieve kwantisering op de inferentiedoorvoer wordt geïsoleerd.
Prestatieanalyse: grote dichte modellen
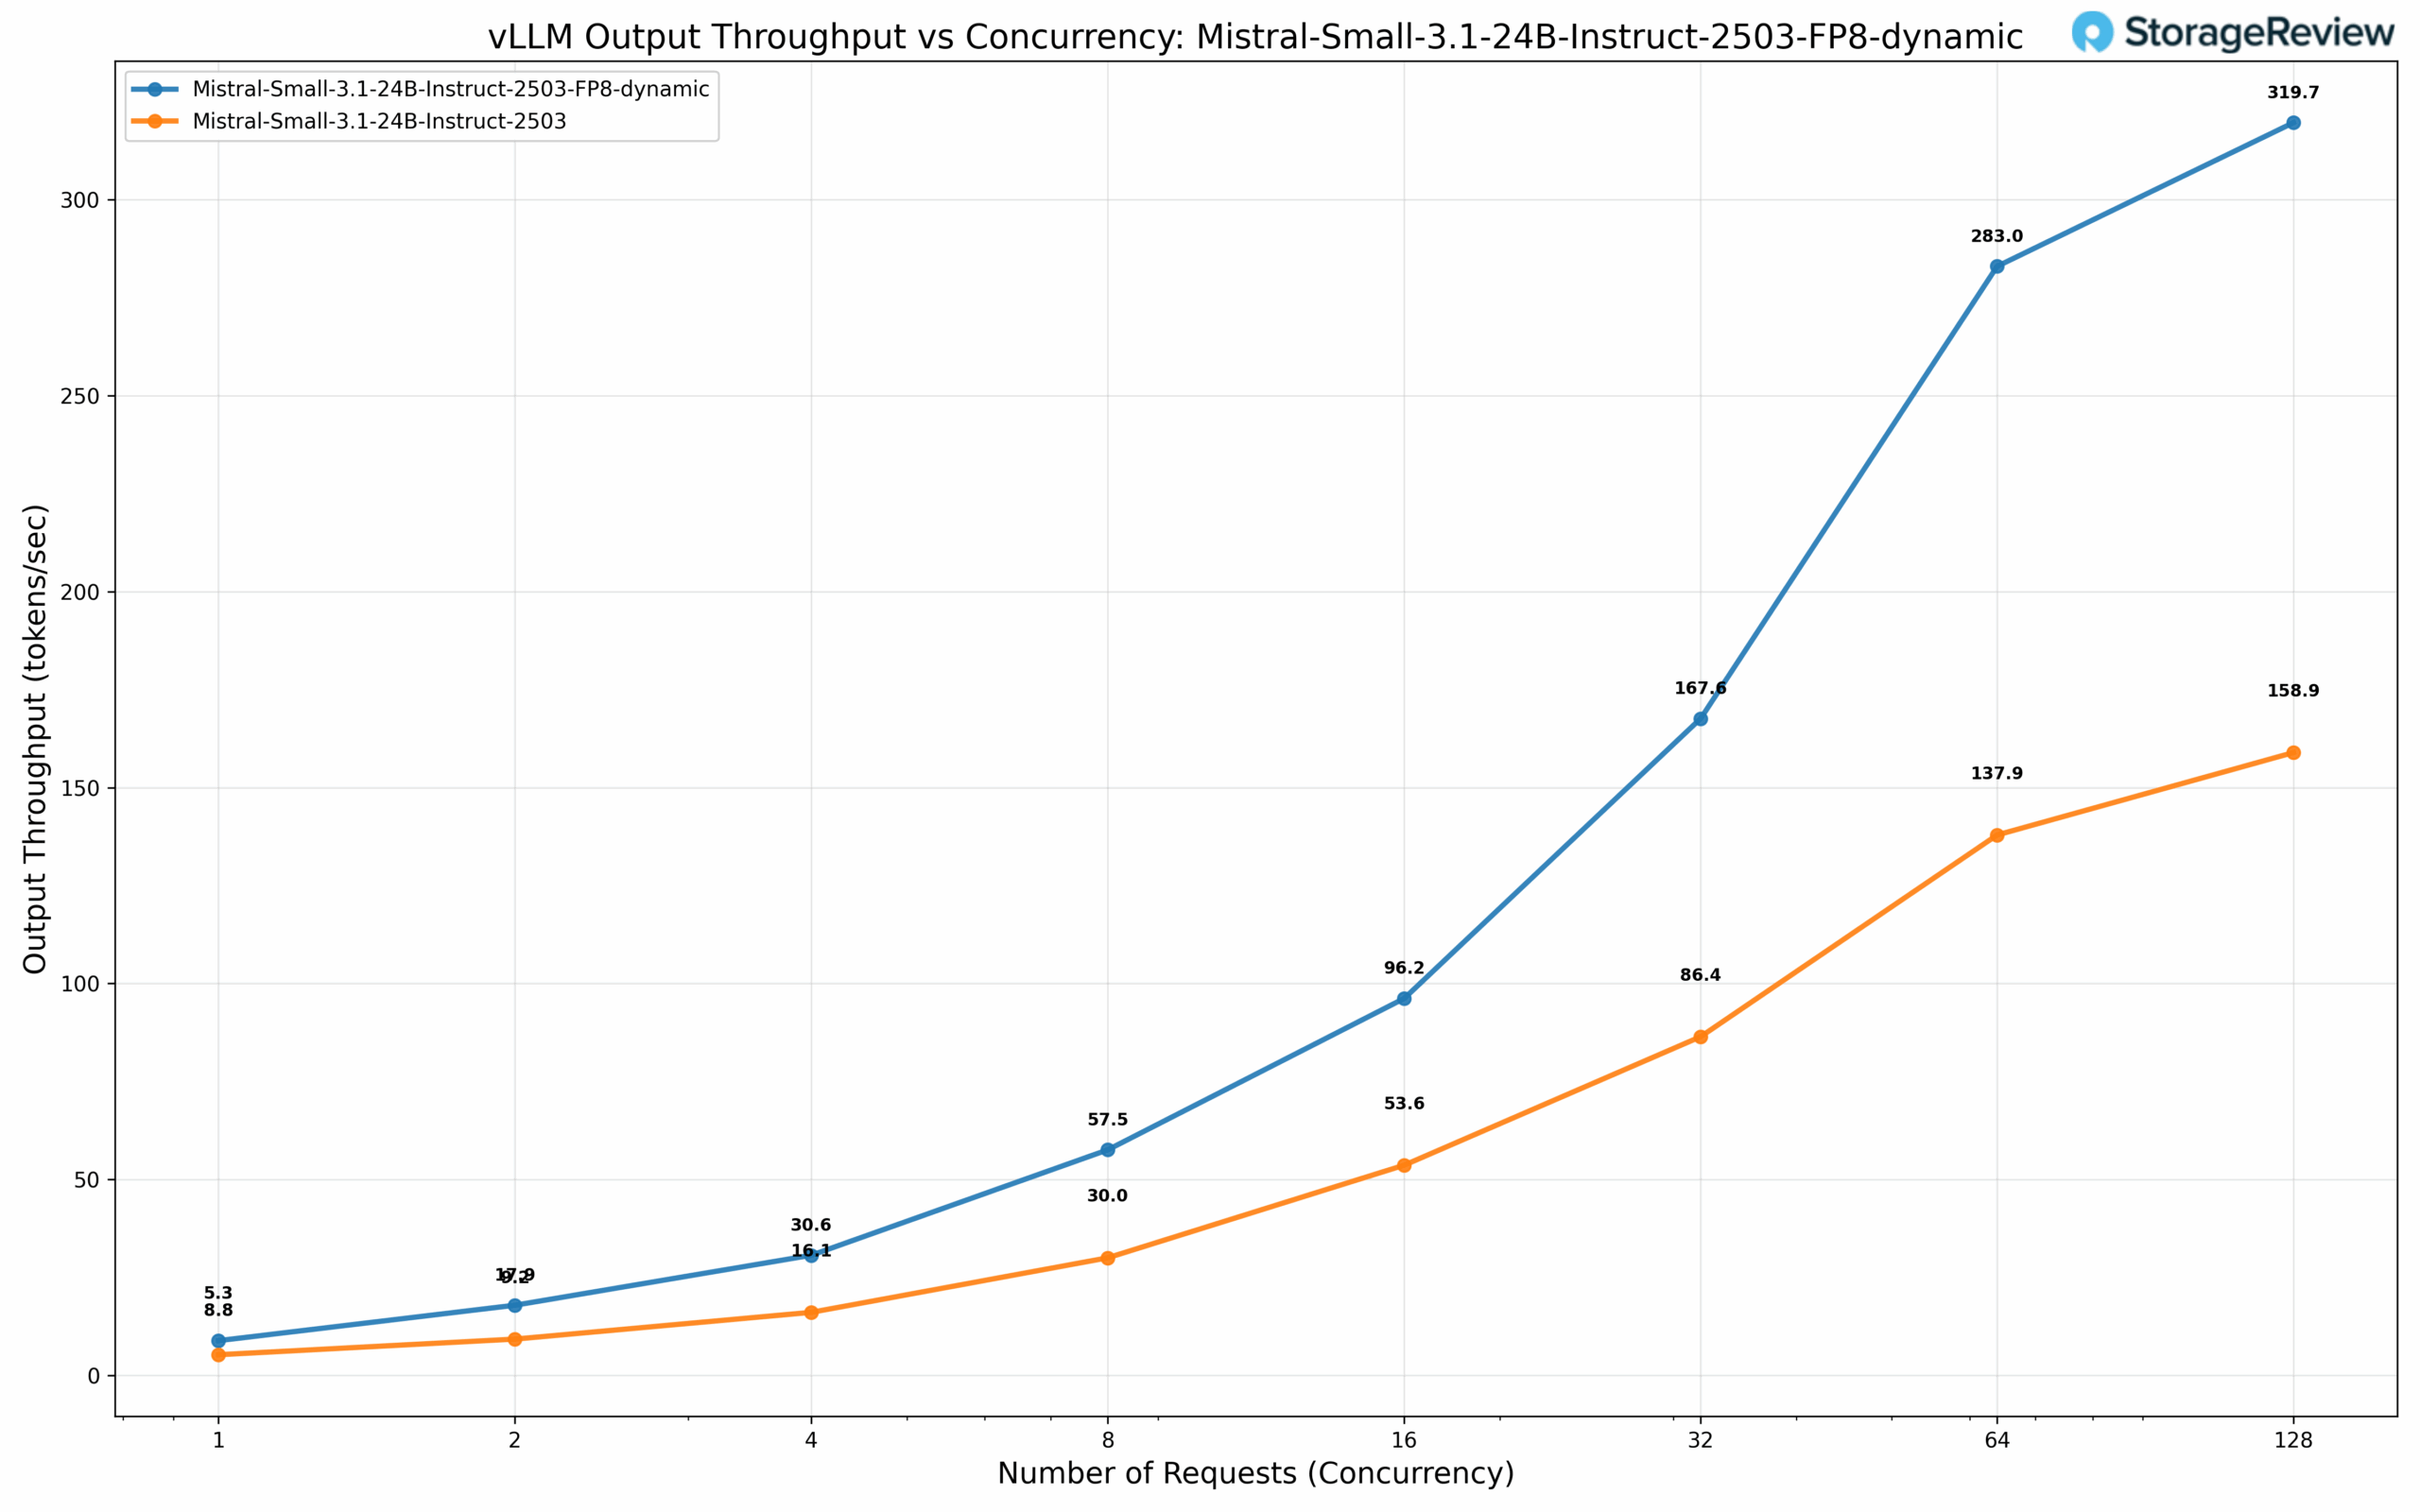
De Mistral Small 3.1 24B met BF16-precisie vertoont een basisdoorvoer van 5.3 tok/s bij gelijktijdigheid 1, wat opschaalt naar een aanzienlijke 158.9 tok/s bij 128 gelijktijdige verzoeken. De dynamisch gekwantificeerde FP8-variant laat bescheiden winst zien bij een lagere gelijktijdigheid met 8.8 tok/s, maar levert een overtuigende prestatievermenigvuldiger van 2x op schaal, met een snelheid van 319.7 tok/s bij 128 gelijktijdigheid – wat de effectiviteit van dynamische kwantificering voor scenario's met een hoge doorvoer onderstreept.
Prestatieanalyse: compacte, dichte modellen
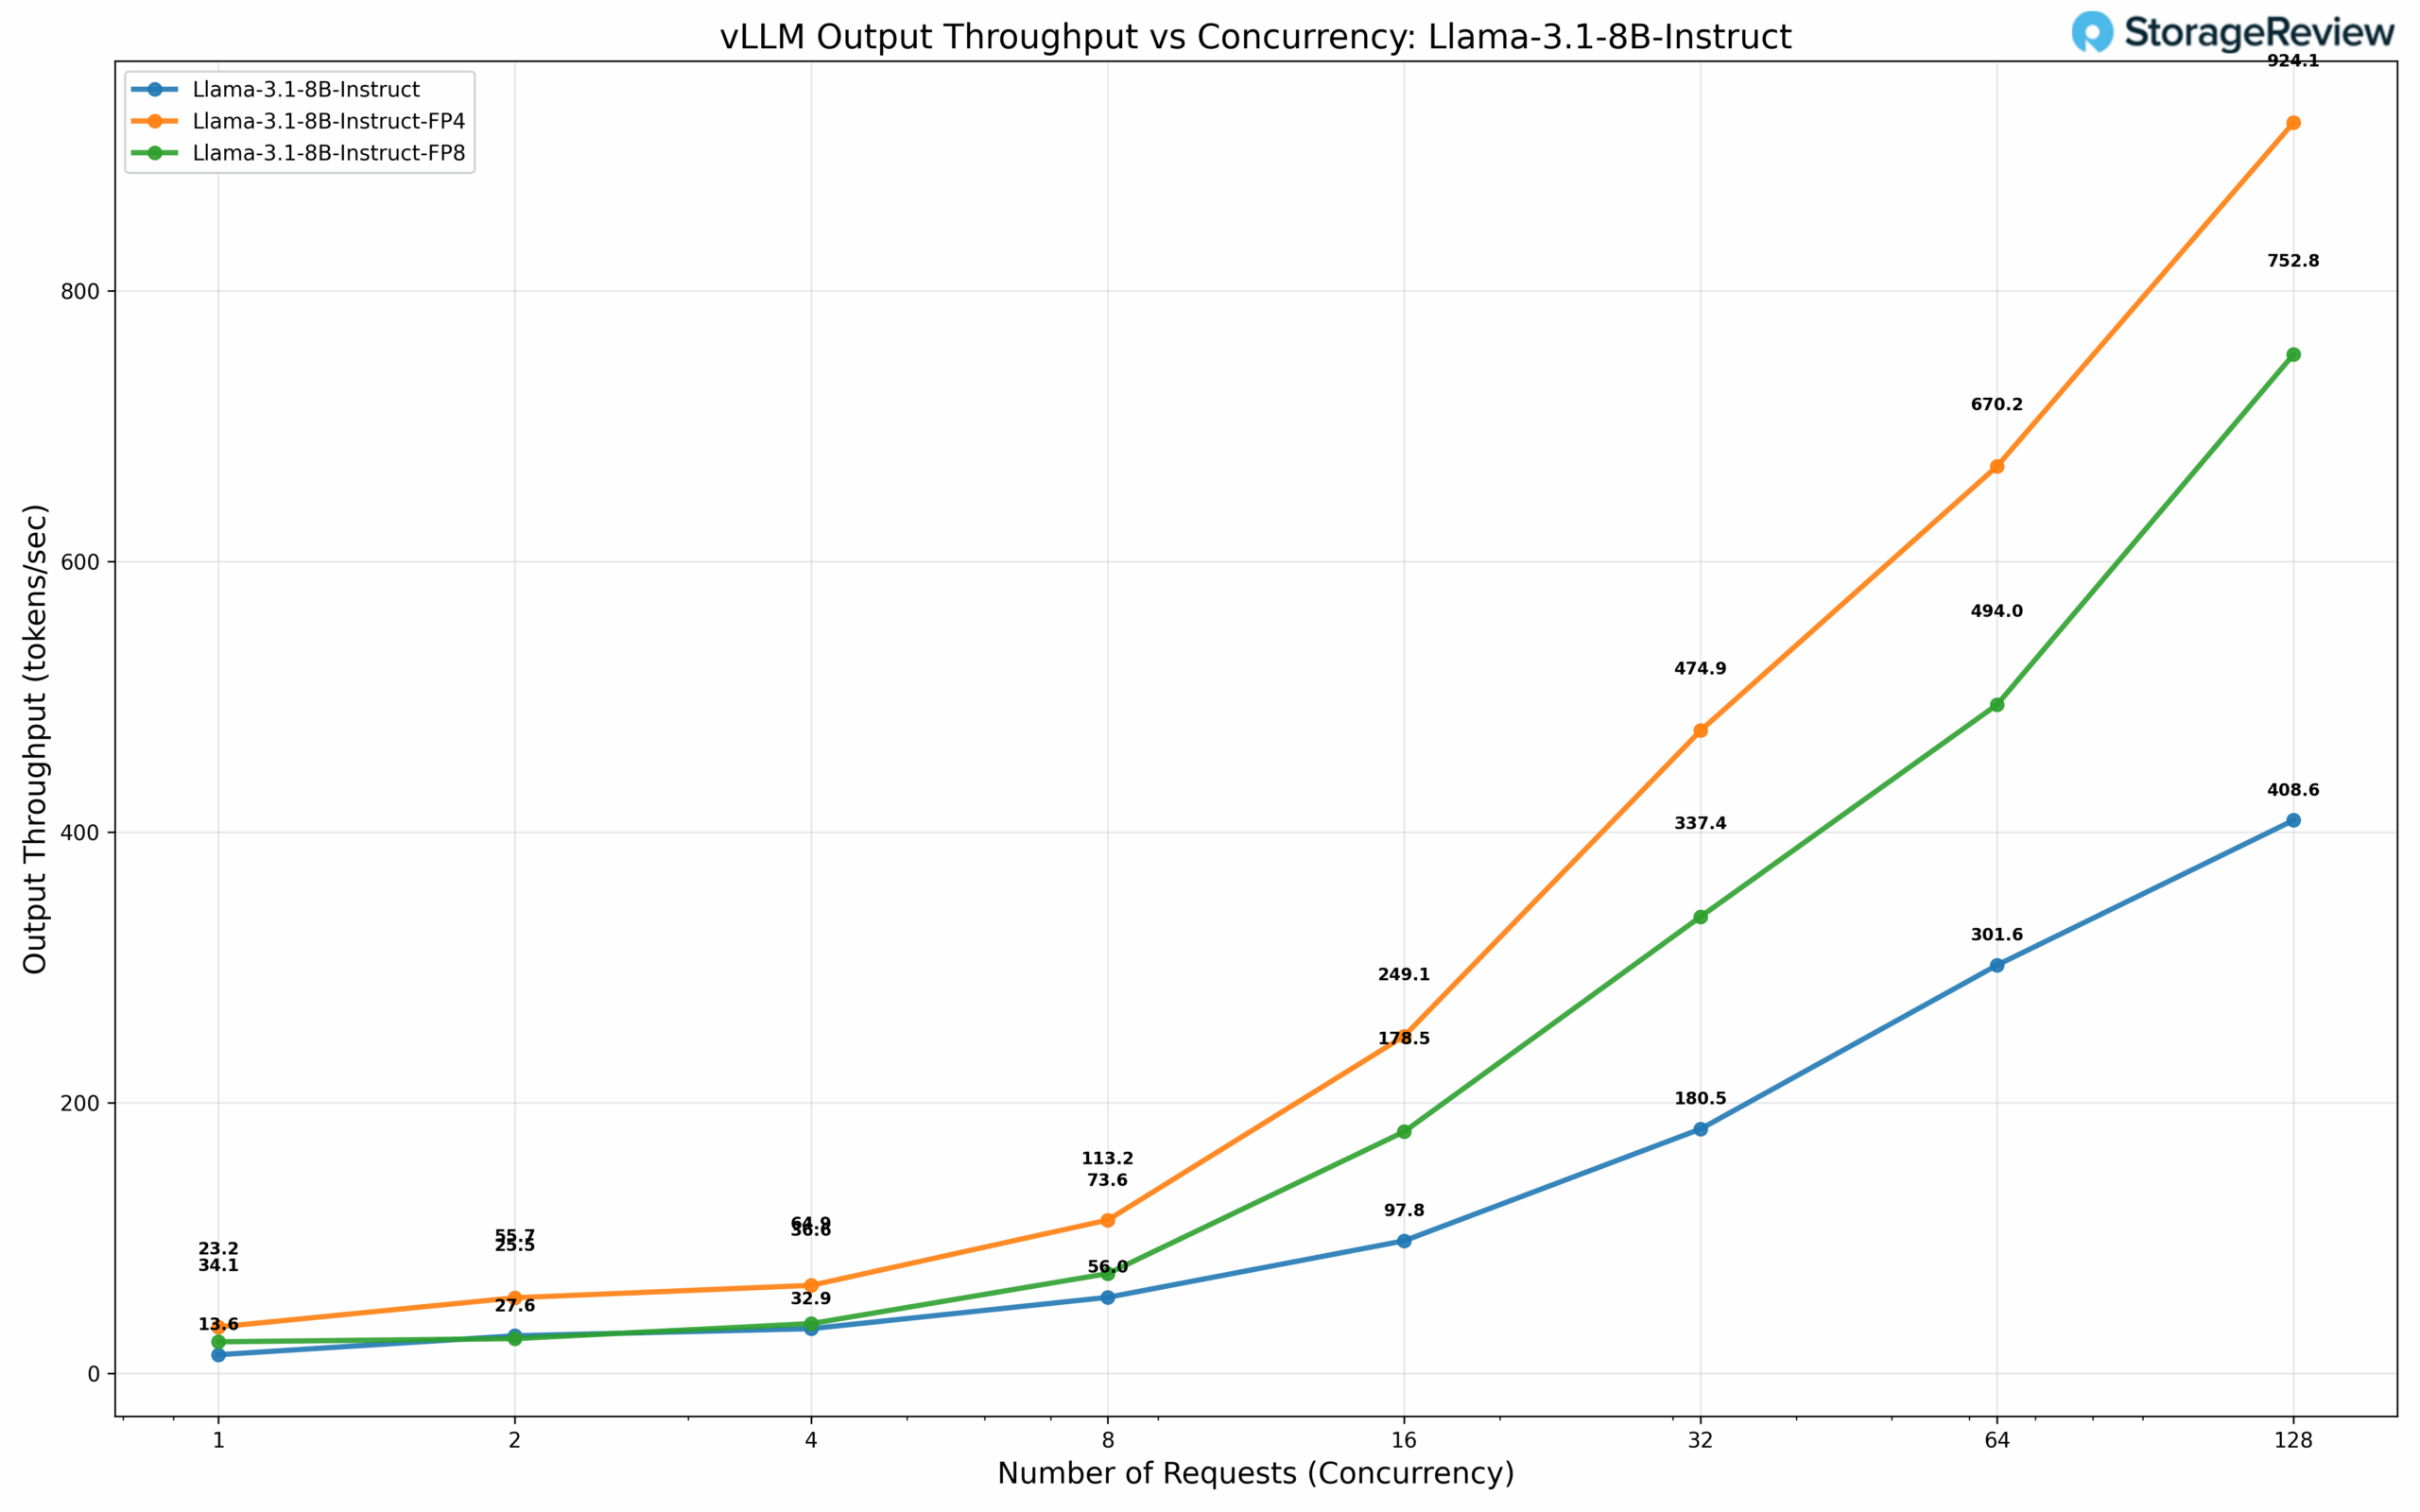
De Llama 3.1 8B-architectuur vertoont opvallend verschillende prestatiekenmerken voor verschillende kwantiseringsstrategieën. Met BF16-precisie levert het model 13.6 tok/s bij gelijktijdigheidsniveau 1, en dit loopt op tot 408.6 tok/s bij 128 gelijktijdige verzoeken. De overstap naar FP8-kwantisering levert respectievelijk 23.2 tok/s en 752.8 tok/s op bij gelijktijdigheidsniveau 1 en 128 – wat neerkomt op een verbetering van de doorvoer met 84% op schaal. De FP4-configuratie tilt de prestaties naar een hoger niveau en bereikt 34.1 tok/s en 924.1 tok/s bij dezelfde gelijktijdigheidsniveaus. Dit toont aan dat agressieve kwantiseringsstrategieën 2.3x meer prestatiewinst kunnen opleveren dan de basisprecisie, terwijl de acceptabele modelkwaliteit voor veel productieworkloads behouden blijft.
Microschaling-datatype
Microscaling is een geavanceerde kwantiseringsmethode die fijnmazige schaalfactoren toepast op kleine blokken gewichten in plaats van uniforme kwantisering over grote parametergroepen. NVIDIA's NVFP4-formaat implementeert deze techniek via een geblokkeerde floating-point representatie, waarbij elk microschaalblok van 8-32 waarden een gemeenschappelijke exponent als schaalfactor deelt. Deze gedetailleerde aanpak behoudt de numerieke precisie en bereikt tegelijkertijd een 4-bits representatie, waardoor het dynamische bereik dat cruciaal is voor transformatorarchitecturen behouden blijft. Het formaat integreert met NVIDIA's Tensor Core-architectuur, wat efficiënte berekeningen met gemengde precisie mogelijk maakt met on-the-fly decompressie tijdens matrixbewerkingen.
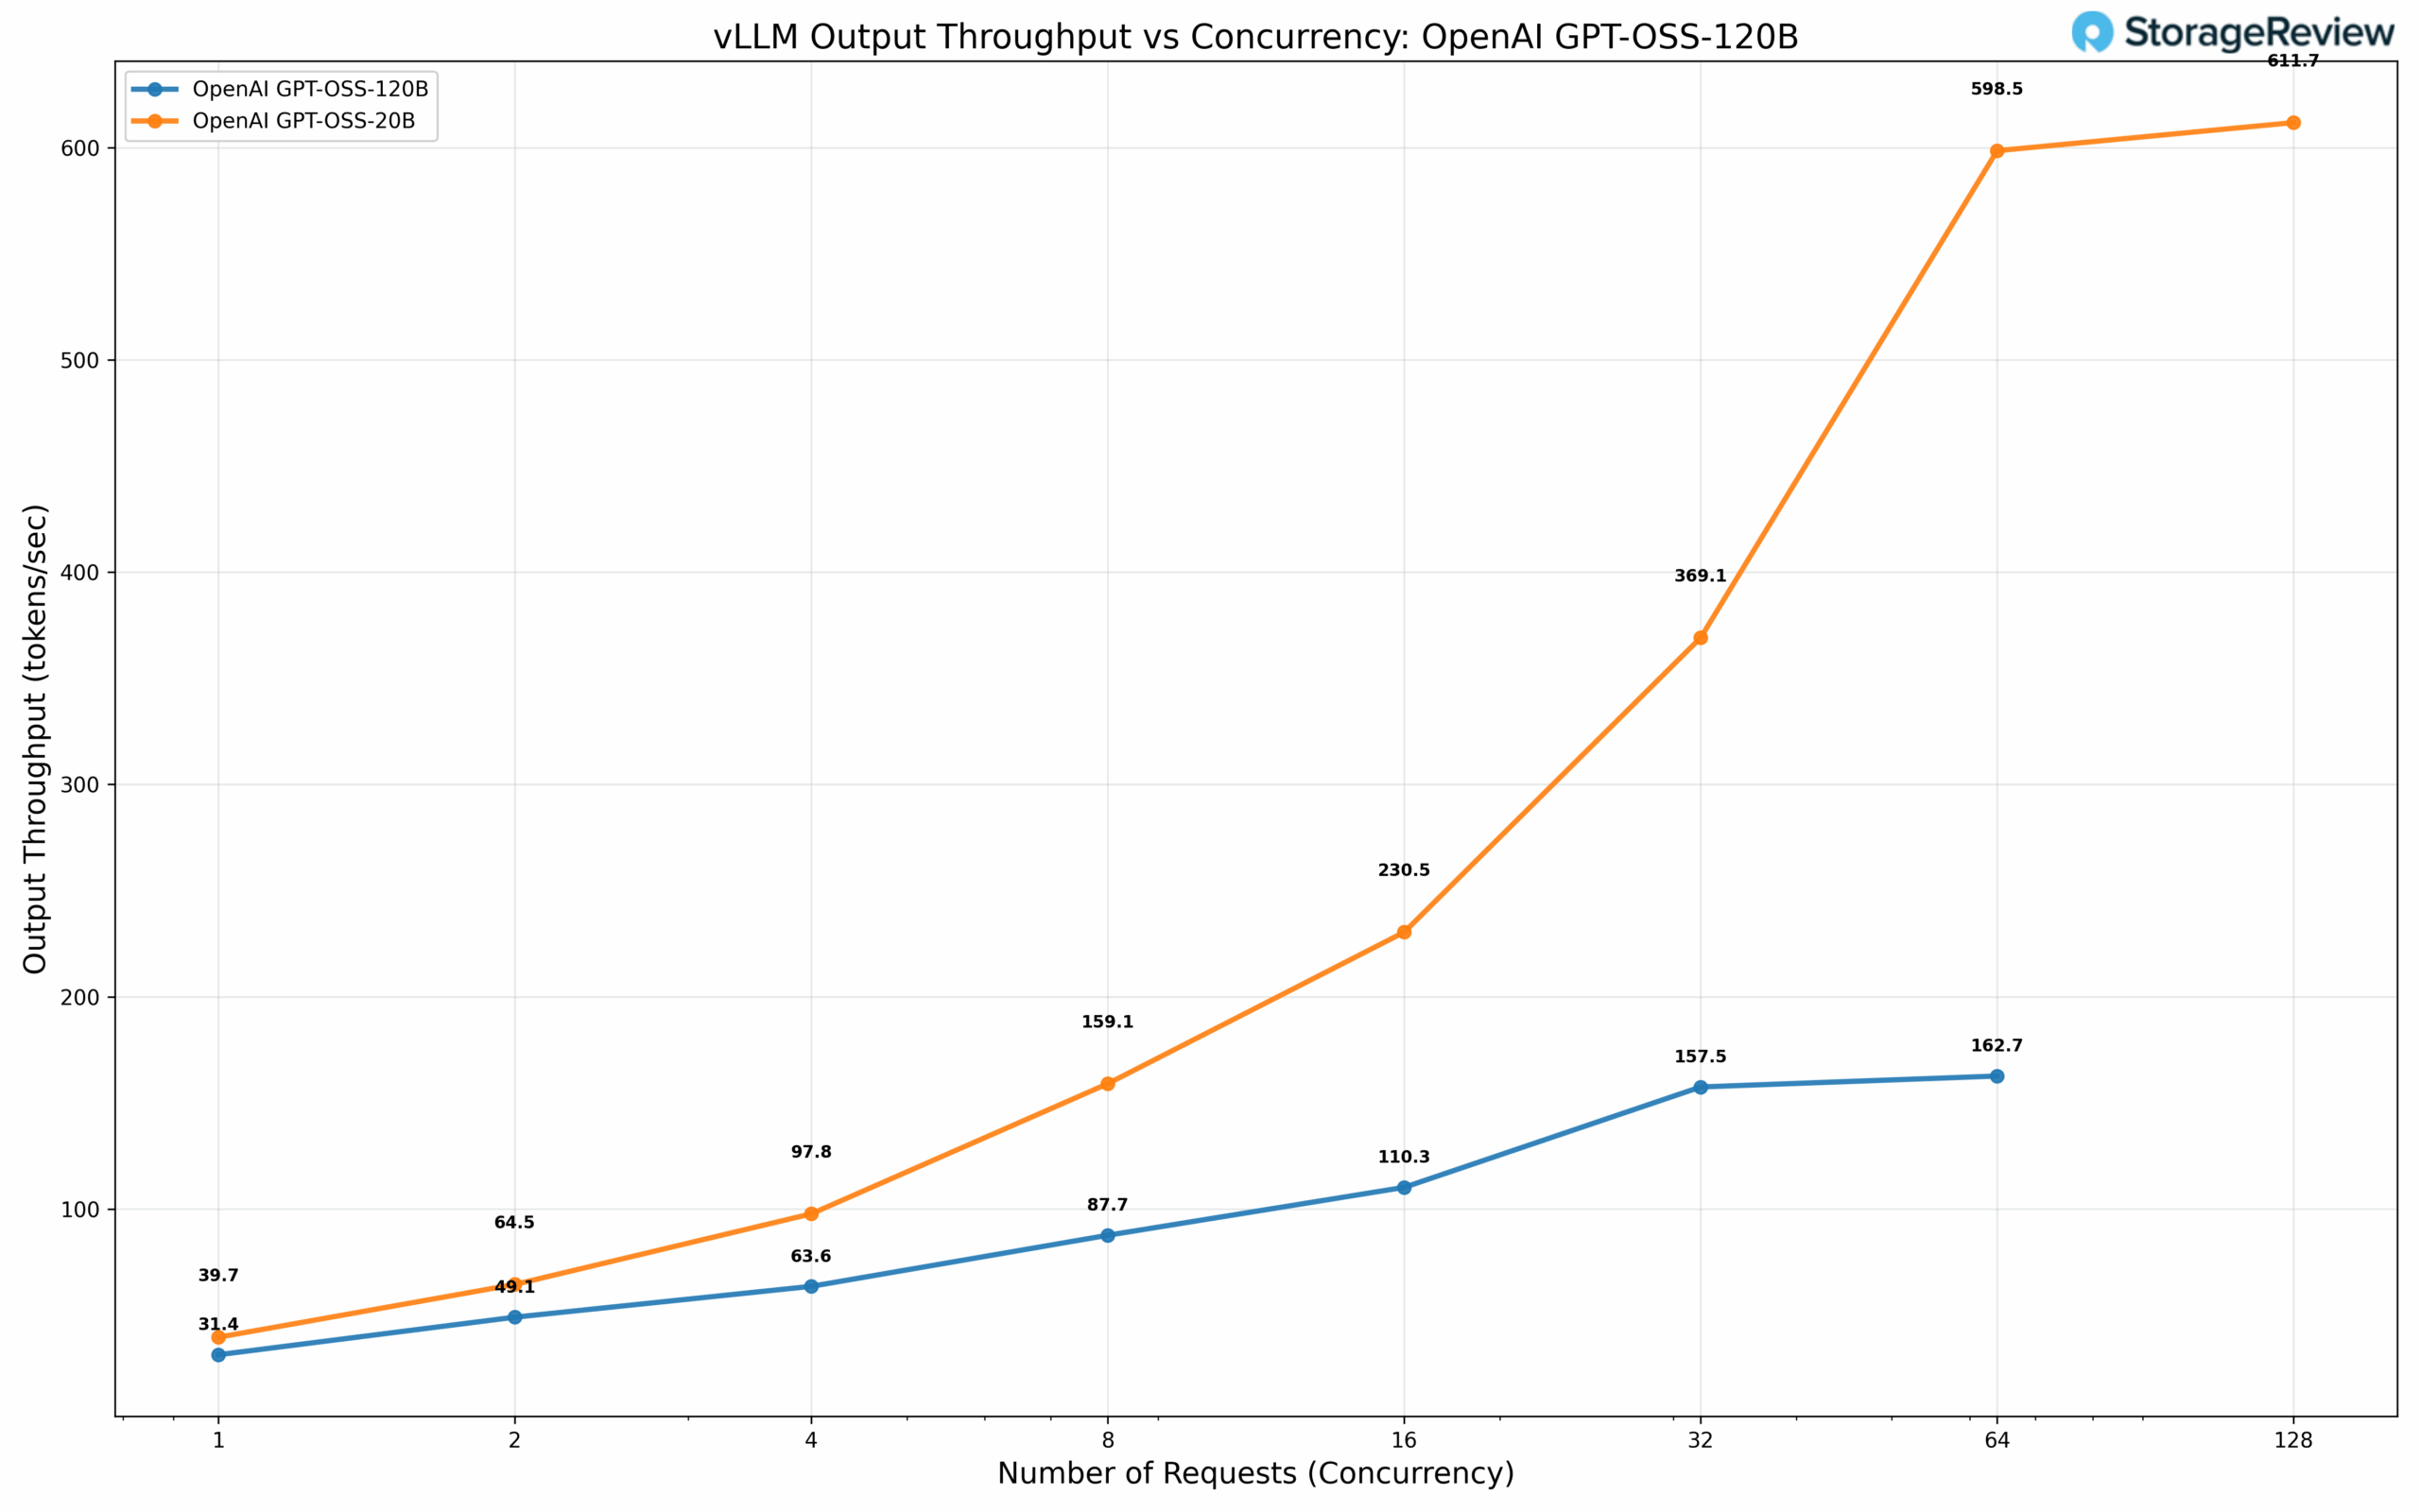
We hebben de GPT OSS-modellen van OpenAI geëvalueerd op parameterschalen van 20 en 120 B met behulp van NVFP4-kwantisering. Het model met 20 B-parameters behaalt 39.7 tok/s bij gelijktijdigheid 1, en schaalt op tot 611.7 tok/s bij 128 gelijktijdige verzoeken. De variant met 120 B-parameters levert 31.4 tok/s bij gelijktijdigheid 1 en 162.7 tok/s bij 64 gelijktijdige verzoeken.
Let op: de uitvoerdoorvoer is de doorvoer over alle verzoeken heen, niet de doorvoer per verzoek.
Vanwege de beperkte tijd konden we onze TensorRT-tests niet afronden. Houd de vervolgstukken met de Spark in de gaten, waarin we de prestaties van meer inferentieframeworks zullen onderzoeken.
Vooraf invullen en decoderen van zware inferentie
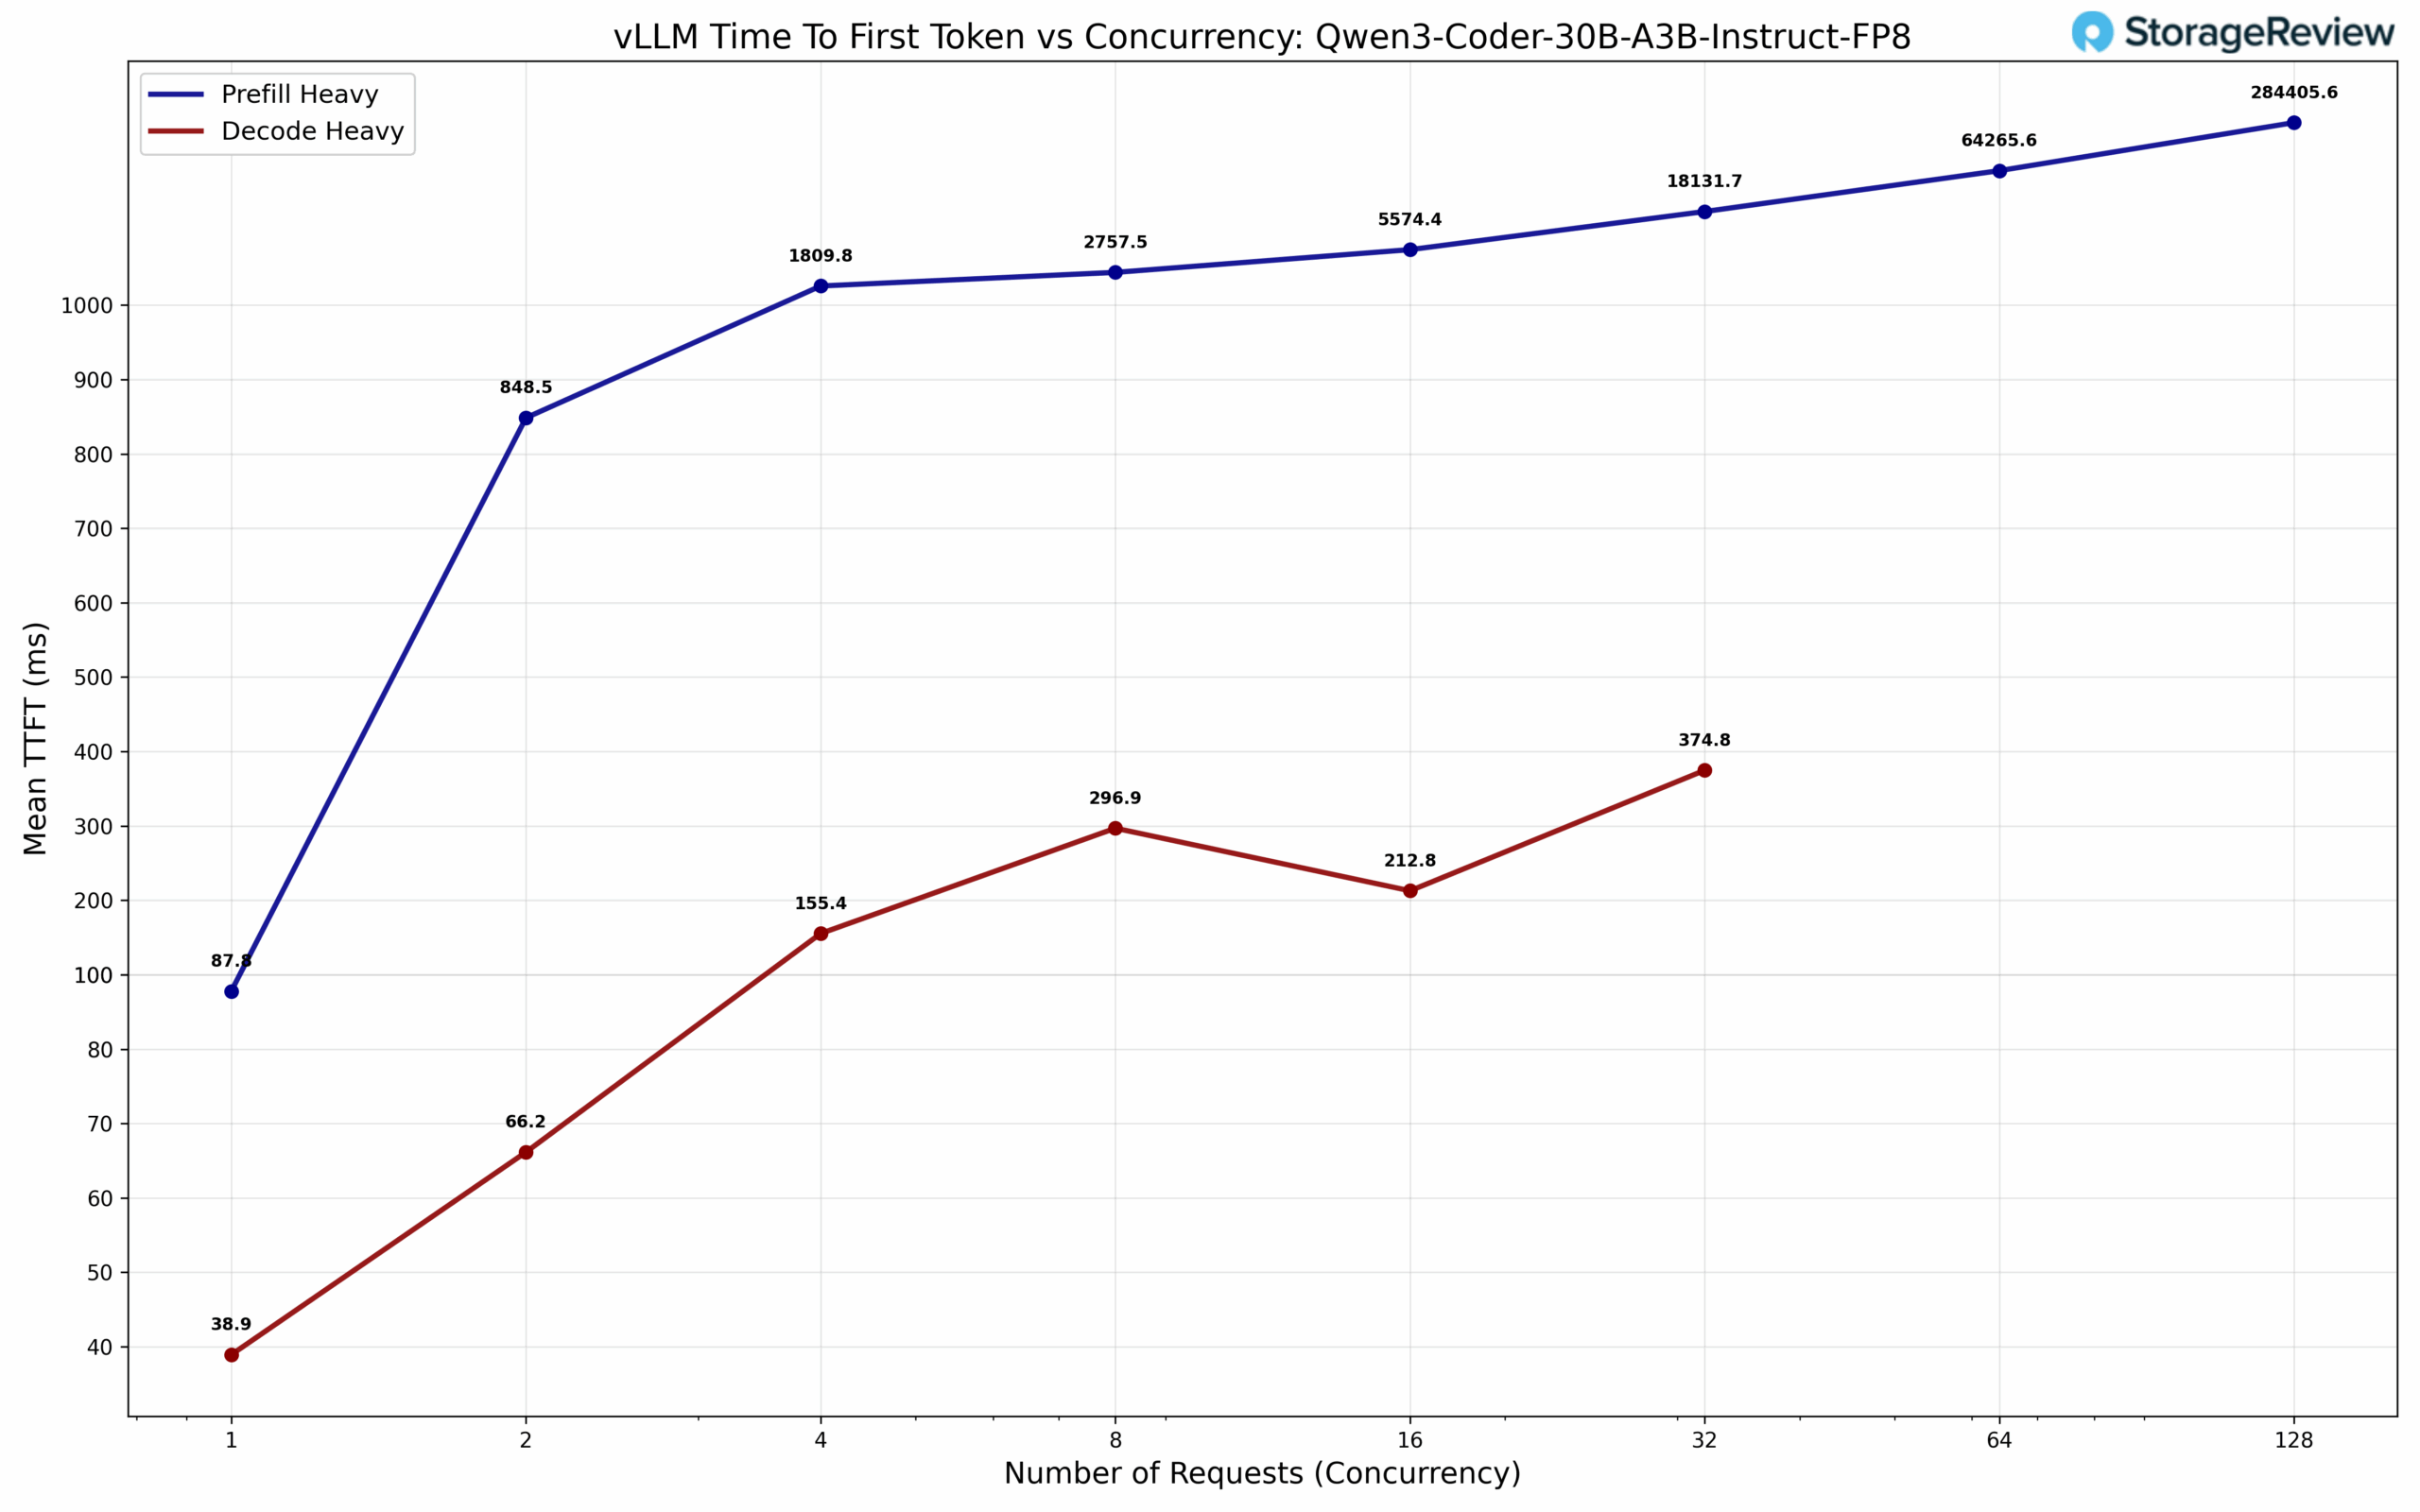
LLM-inferentie kan fundamenteel worden opgesplitst in twee afzonderlijke rekenfasen, die elk opvallend verschillende prestatiekenmerken en resourcegebruikspatronen vertonen. De prefill-fase verwerkt de volledige invoerprompt in één parallelle bewerking, waarbij de aandachtsmechanismen voor alle invoertokens gelijktijdig worden berekend - een rekenintensieve bewerking die tensorkernen en rekeneenheden volledig verzadigd. De decodeerfase daarentegen genereert uitvoertokens op autoregressieve wijze, waarbij één token tegelijk wordt geproduceerd via sequentiële bewerkingen die een lagere rekenintensiteit hebben, maar aanzienlijke eisen stellen aan de geheugenbandbreedte, omdat het model herhaaldelijk gewichten en de groeiende sleutel-waardecache moet raadplegen. Dit creëert fundamenteel verschillende knelpuntprofielen: prefill-bewerkingen zijn doorgaans rekenintensief, terwijl decodeerbewerkingen geheugenbandbreedte-intensief worden, waardoor ze bijzonder gevoelig zijn voor beperkingen van geheugensubsystemen.
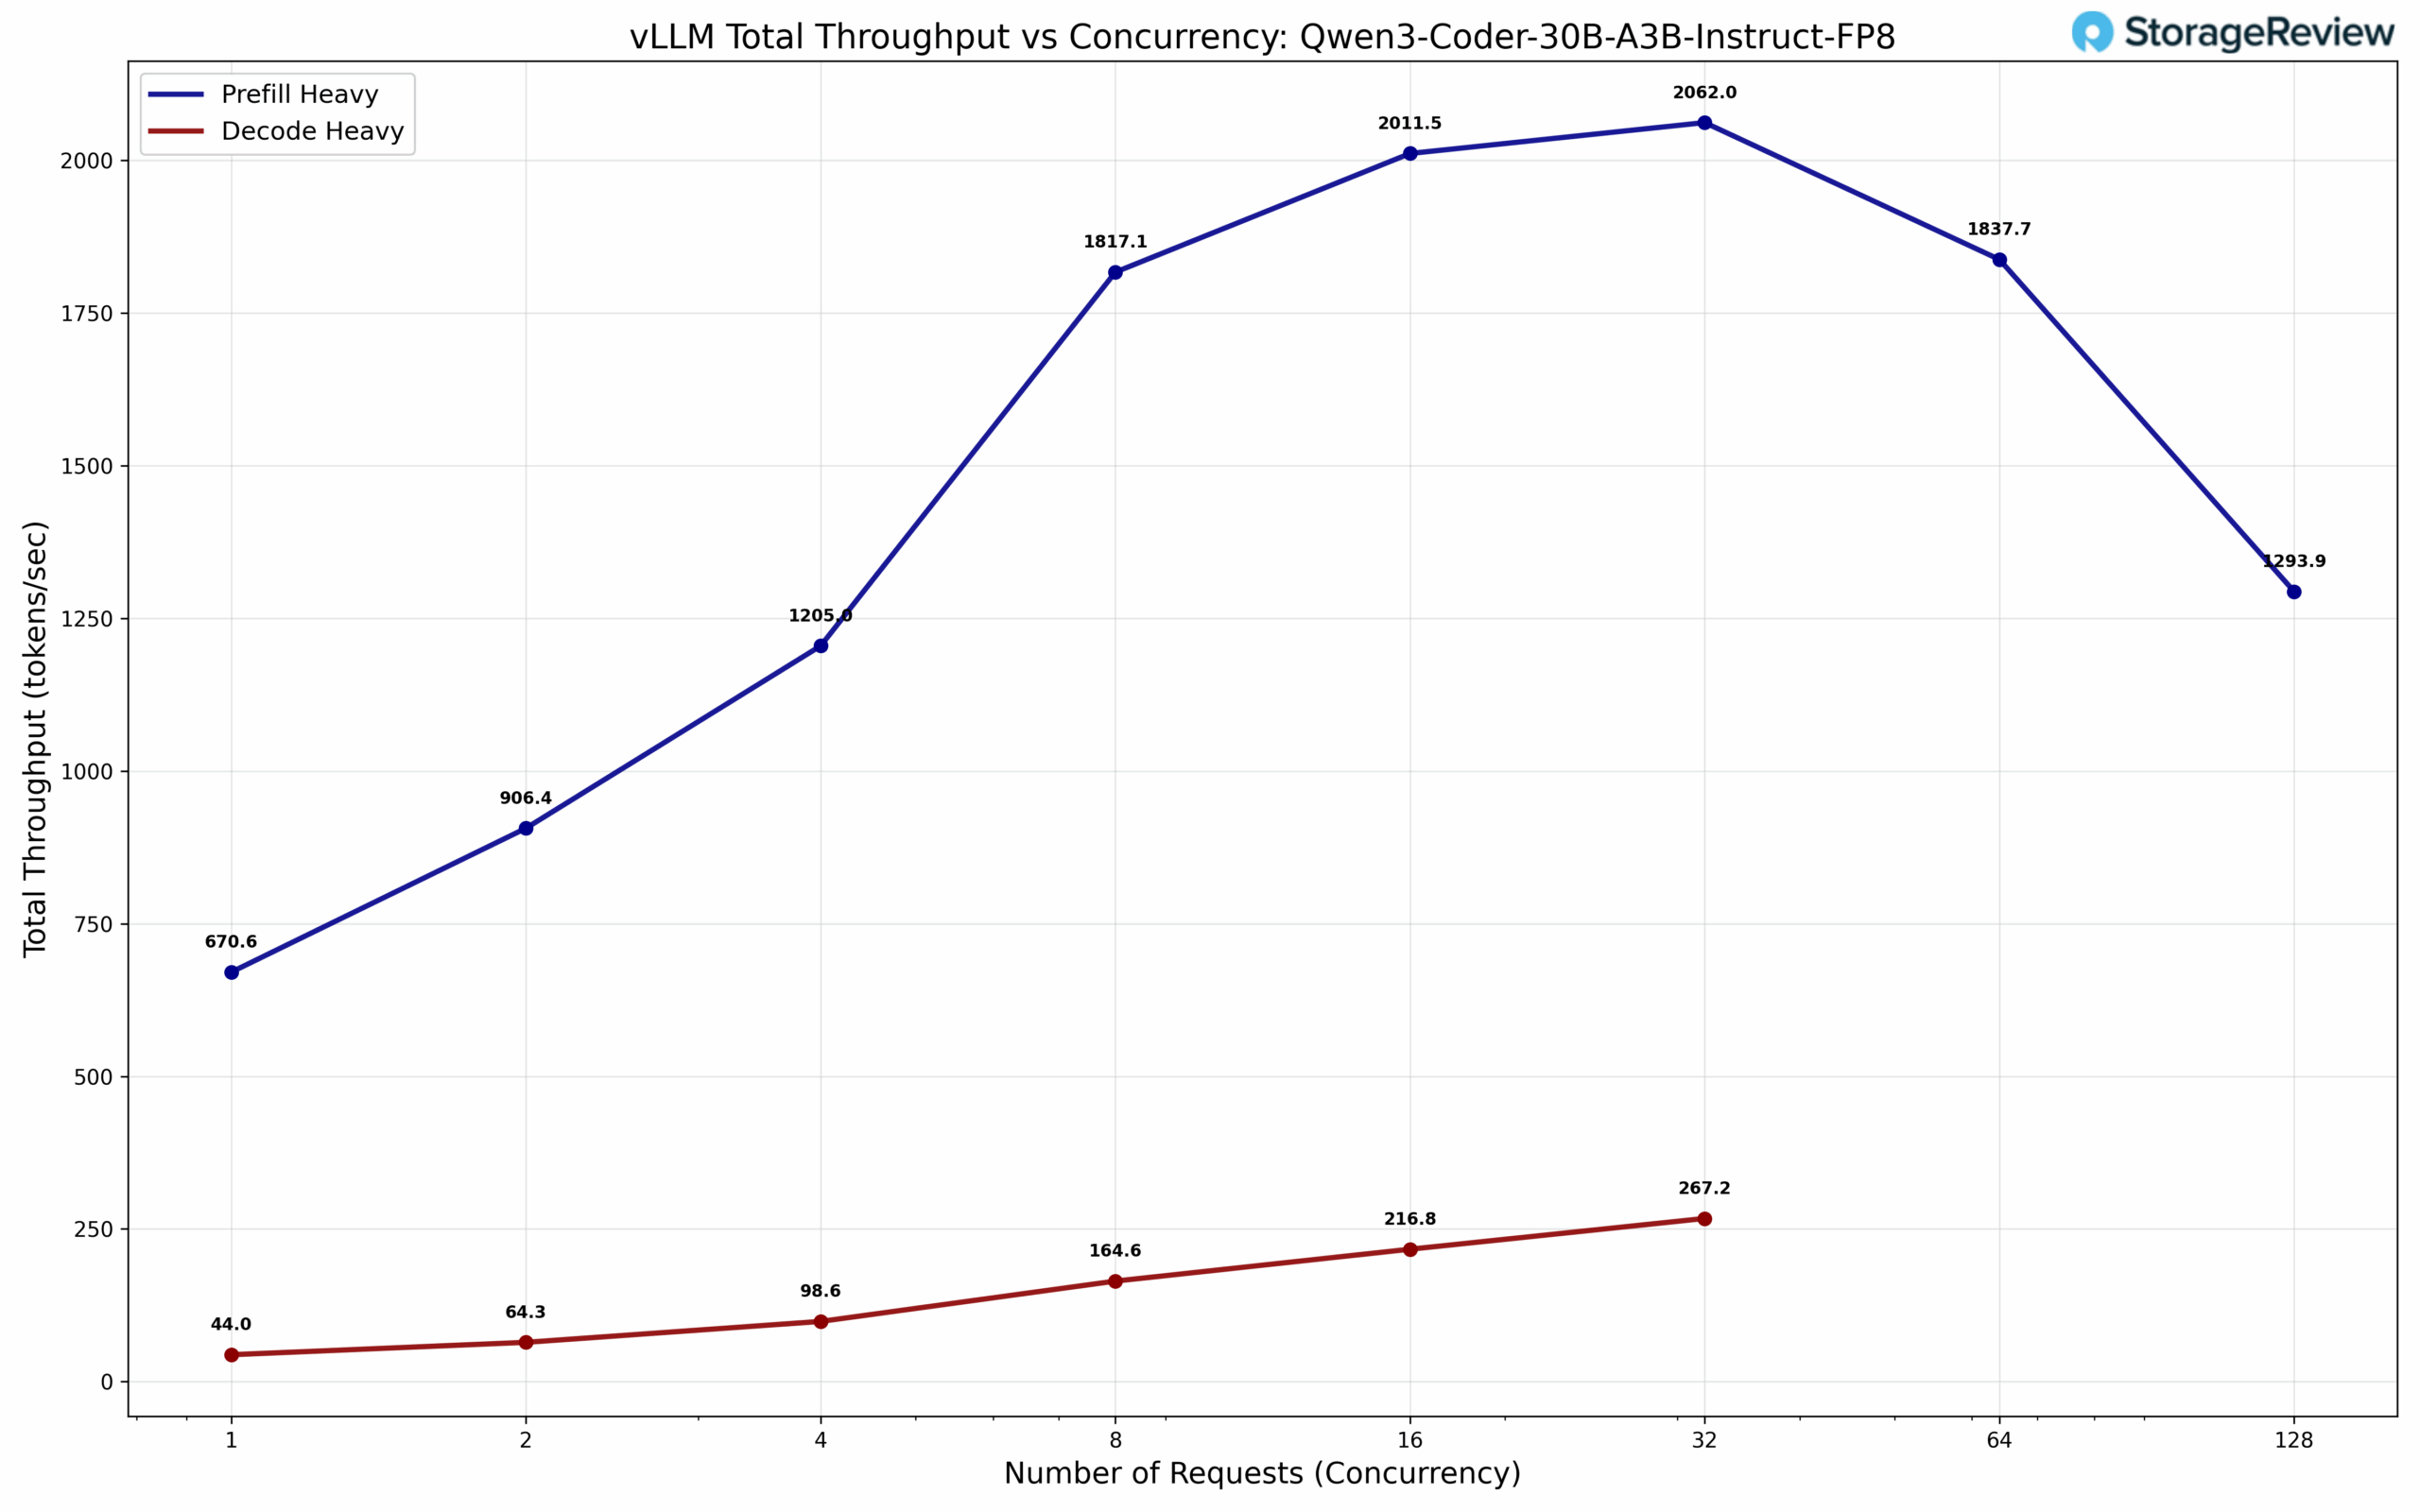
We hebben uitgebreide tests uitgevoerd met twee verschillende workloadprofielen: inferentie met veel decodering met 512 invoertokens en 8,192 uitvoertokens, en inferentie met veel prefill met 8,192 invoertokens en 512 uitvoertokens. De prestatiekarakterisering onthult de verwachte architecturale afwegingen: de Spark demonstreert een concurrerende doorvoersnelheid bij workloads met veel prefill, waarbij rekenkracht de grootste bottleneck blijft, maar vertoont lagere prestaties in scenario's met veel decodering. Dit prestatieverschil sluit nauw aan bij de beperkingen van de geheugenbandbreedte. Het sequentiële karakter van de decoderingsbewerkingen en de intensieve patronen voor geheugentoegang leggen direct de bandbreedtebeperkingen bloot die inherent zijn aan de architectuur van de Spark. Deze resultaten bieden cruciale context voor de interpretatie van de MAMF-metingen in de volgende sectie, aangezien beide benchmarksuites de geheugenbandbreedte consistent identificeren als de fundamentele prestatiebeperkende factor in praktische inferentie-implementaties.
Maximaal haalbare Matmul FLOPS (MAMF)
MAMF (Maximum Achievable Matmul FLOPS) is een praktische prestatiemaatstaf die is ontworpen om het realistische piekvermogen van drijvende-komma-bewerkingen per seconde te meten dat kan worden bereikt op machine learning-acceleratoren tijdens matrixvermenigvuldigingsbewerkingen. Dit biedt een nauwkeurigere benchmark dan het theoretische piekvermogen in FLOPS dat vaak in hardwarespecificaties wordt vermeld. We gebruiken de mamf-finder benchmark van Stas Beckman.
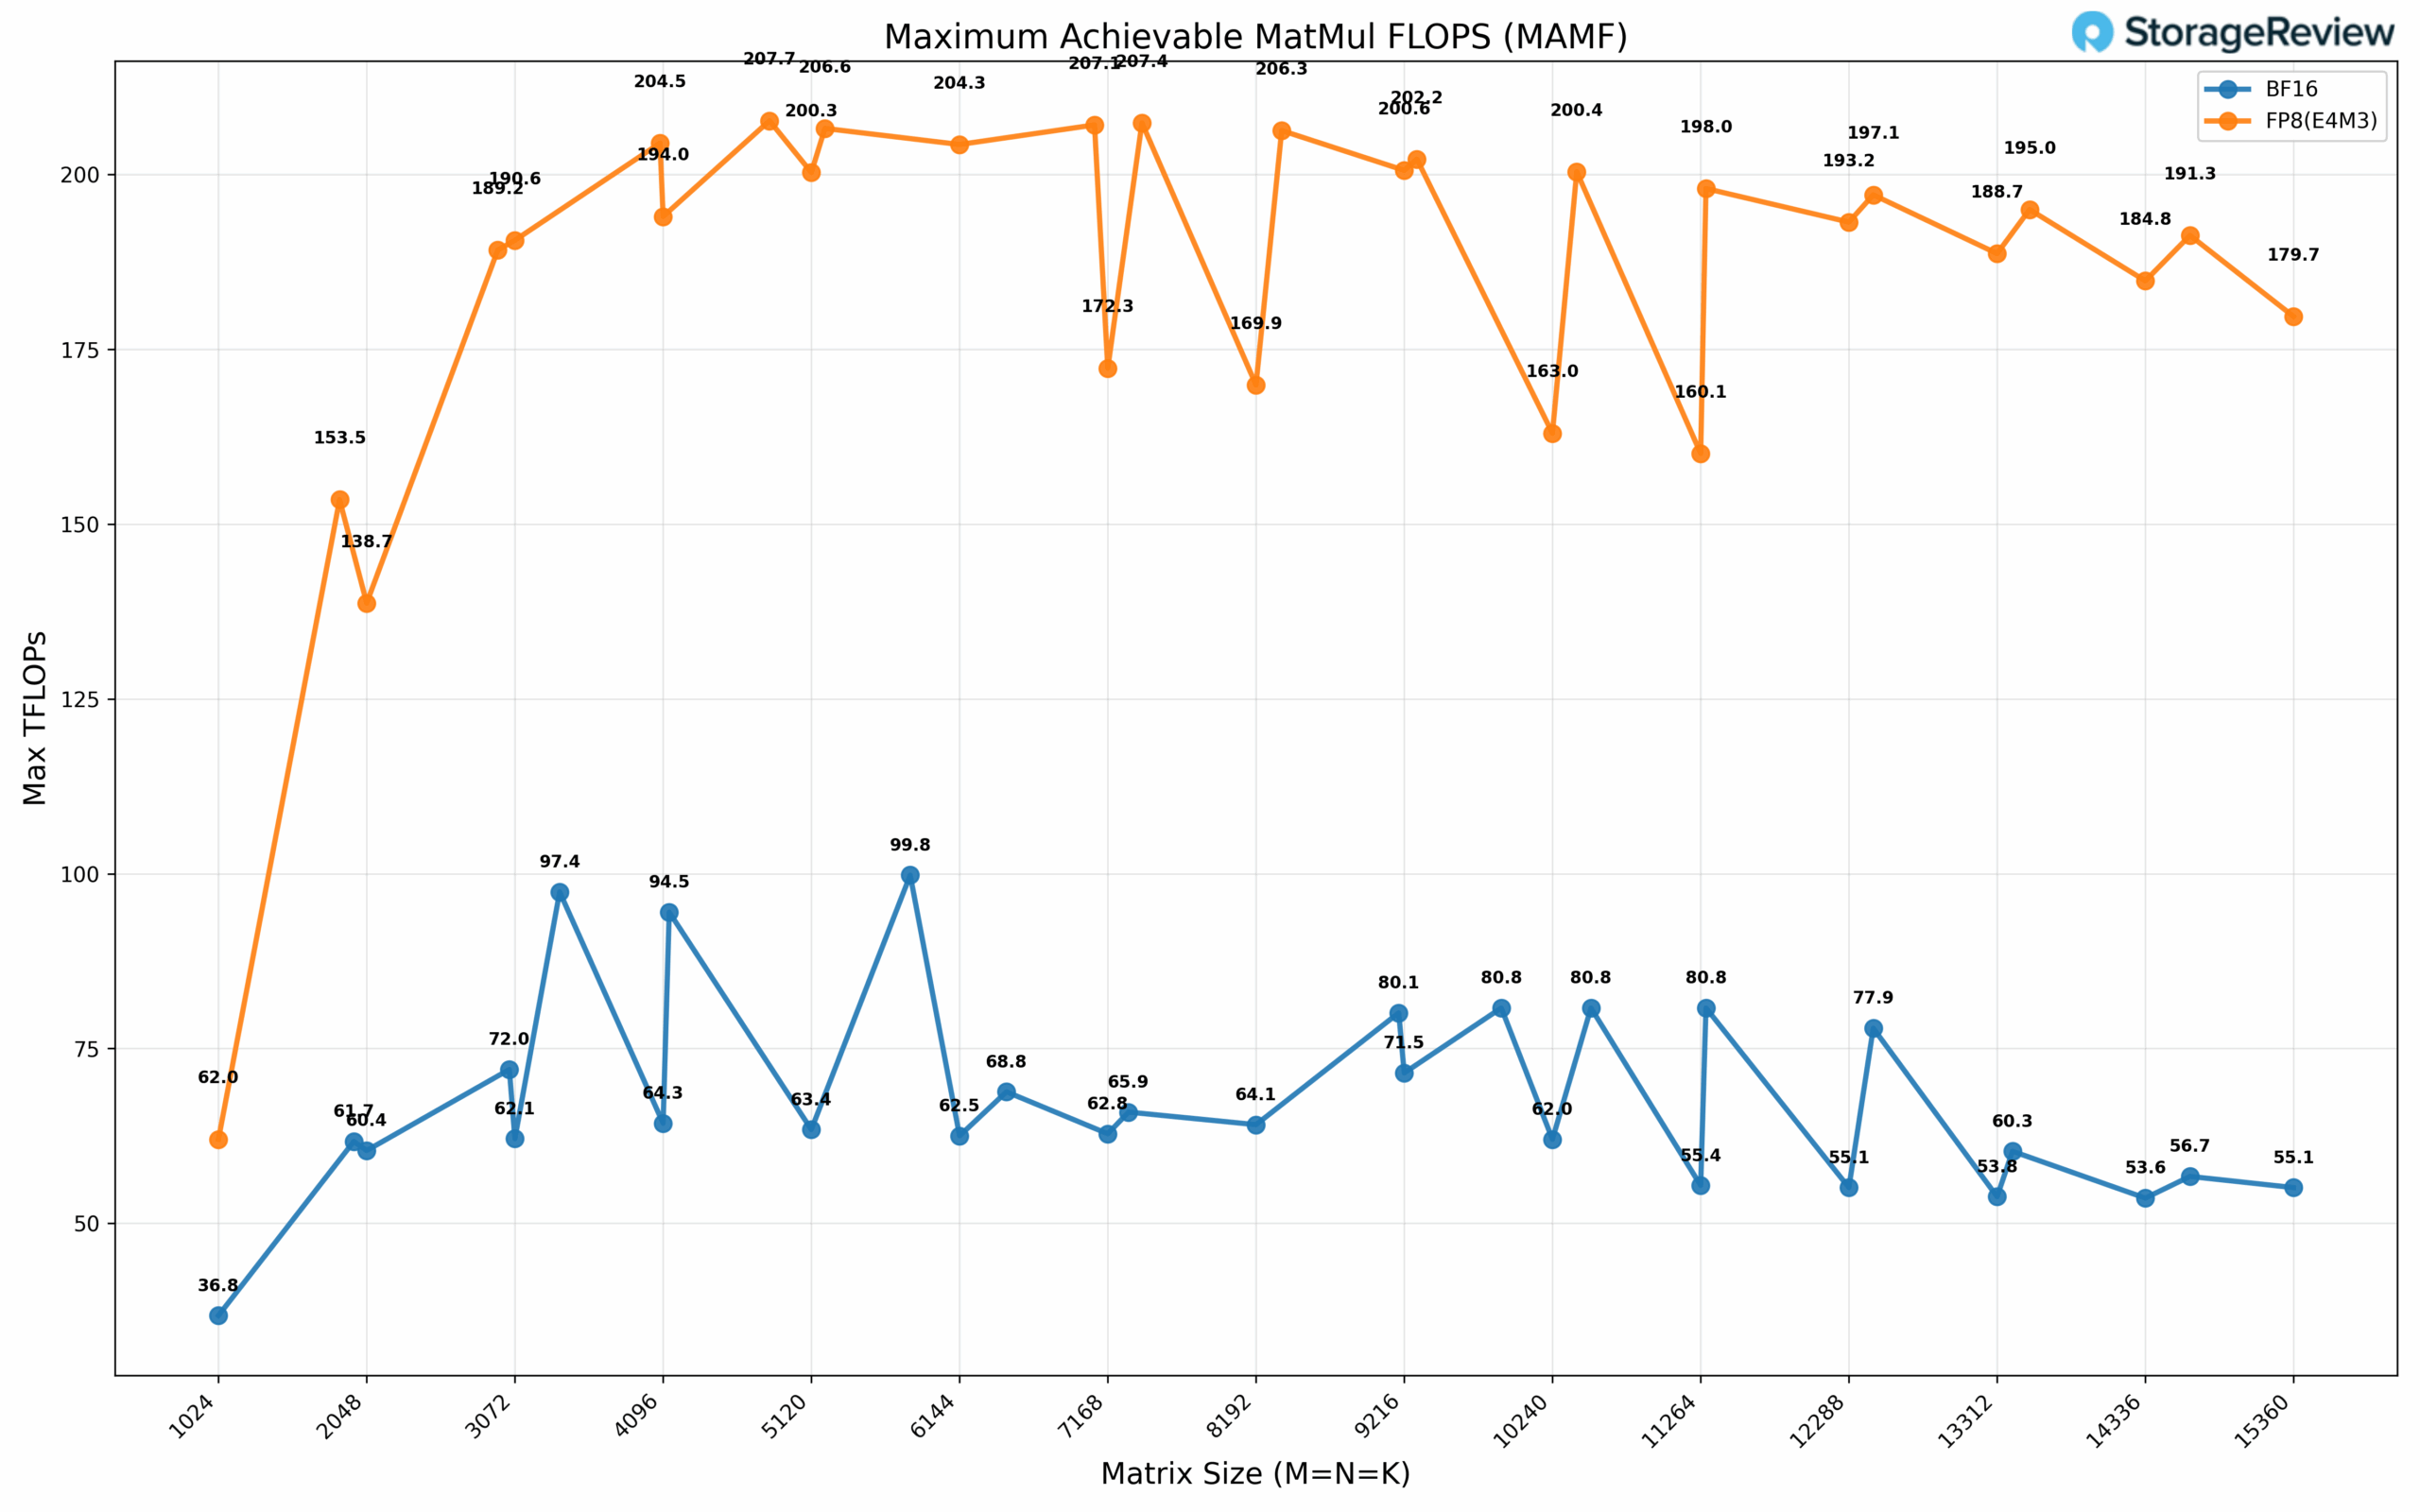
Met BF16-precisie observeren we een MAMF van 99.8 TFLOP's, terwijl FP8 (E4M3) een MAMF van 207.7 TFLOP's laat zien. Vanwege tijdsbeperkingen konden we geen uitgebreide FP4 MAMF-karakterisering uitvoeren; door echter te extrapoleren op basis van de waargenomen precisiegebaseerde schaalpatronen, verwachten we een extra prestatiewinst van 2× ten opzichte van FP8, wat neerkomt op ongeveer 400 TFLOP's voor dichte FP4-bewerkingen. Wanneer we rekening houden met 2:1 gestructureerde sparsity-optimalisatie, vertaalt dit zich in ongeveer 80% van de theoretische FP4-prestatiemogelijkheden, met een bereik van ongeveer 800 TFLOP's bij een spaarzame rekenbelasting. Het is belangrijk om op te merken dat deze MAMF-metingen mogelijk onder de theoretisch geadverteerde specificaties vallen om vele redenen die we in deze review niet zullen bespreken.
GPU directe opslag
Een van de tests die we op de Spark hebben uitgevoerd, was de MagnumIO GPU Direct Storage (GDS)-test. GDS is een door NVIDIA ontwikkelde functie waarmee GPU's de CPU kunnen omzeilen bij het benaderen van gegevens die zijn opgeslagen op NVMe-schijven of andere snelle opslagapparaten. In plaats van gegevens via de CPU en het systeemgeheugen te routeren, maakt GDS directe communicatie tussen de GPU en het opslagapparaat mogelijk, wat de latentie aanzienlijk vermindert en de gegevensdoorvoer verbetert.
Hoe GPU Direct Storage werkt
Traditioneel, wanneer een GPU gegevens verwerkt die zijn opgeslagen op een NVMe-schijf, moeten de gegevens eerst door de CPU en het systeemgeheugen reizen voordat ze de GPU bereiken. Dit proces introduceert knelpunten, omdat de CPU een tussenpersoon wordt, latentie toevoegt en waardevolle systeembronnen verbruikt. GPU Direct Storage elimineert deze inefficiëntie door de GPU in staat te stellen om rechtstreeks vanaf het opslagapparaat toegang te krijgen tot gegevens via de PCIe-bus. Dit directe pad vermindert de overhead die gepaard gaat met gegevensverplaatsing, wat snellere en efficiëntere gegevensoverdrachten mogelijk maakt.
AI-workloads, met name die met deep learning, zijn zeer data-intensief. Het trainen van grote neurale netwerken vereist het verwerken van terabytes aan data, en elke vertraging in dataoverdracht kan leiden tot onderbenutte GPU's en langere trainingstijden. GPU Direct Storage pakt deze uitdaging aan door ervoor te zorgen dat data zo snel mogelijk naar de GPU wordt geleverd, waardoor inactieve tijd wordt geminimaliseerd en de rekenefficiëntie wordt gemaximaliseerd.
Bovendien is GDS met name gunstig voor workloads die het streamen van grote datasets omvatten, zoals videoverwerking, natuurlijke taalverwerking of realtime-inferentie. Door de afhankelijkheid van de CPU te verminderen, versnelt GDS de databeweging en maakt CPU-bronnen vrij voor andere taken, wat de algehele systeemprestaties verder verbetert.
GDSIO – Interne 4 TB M.2
De NVIDIA DGX Spark biedt een interessante keuze voor opslag. Vanwege de beperkte ruimte in de kleine behuizing koos NVIDIA voor de minder gebruikelijke Gen5 2242 M.2 SSD. Voor lezers die niet bekend zijn met dit type SSD: dit is een kortere 42mm-versie vergeleken met de 80mm-versie, die vaker voorkomt in desktops. Er zijn minder schijfopties, waarbij 4 TB de topcapaciteit is in dit formaat. Het grootste probleem zijn echter de prestaties. Bij kleine SSD's, zoals de 2242- en 2230-modellen, is de grootte doorslaggevend, terwijl de snelheid een ondergeschikte rol speelt. Ze worden veel gebruikt in draagbare spelcomputers, tablets en sommige notebooks.
Er is niet veel ruimte op de PCB van de 2230 en 2242 SSD, wat resulteert in minder ruimte voor controllers, DRAM en NAND-behuizingen. We hebben enkele van deze nadelen tijdens onze tests opgemerkt. Bij het toepassen van onze GDSIO-workload op een 1 TB of 128 GB-behuizing liep de SSD vast en moest de Spark opnieuw worden geïmplanteerd. Door de testbehuizing te verlagen naar 64 GB en het aantal threads te verlagen, werd dit probleem omzeild. Deze problemen doen zich over het algemeen niet voor bij de meer gangbare high-performance 80mm SSD's.
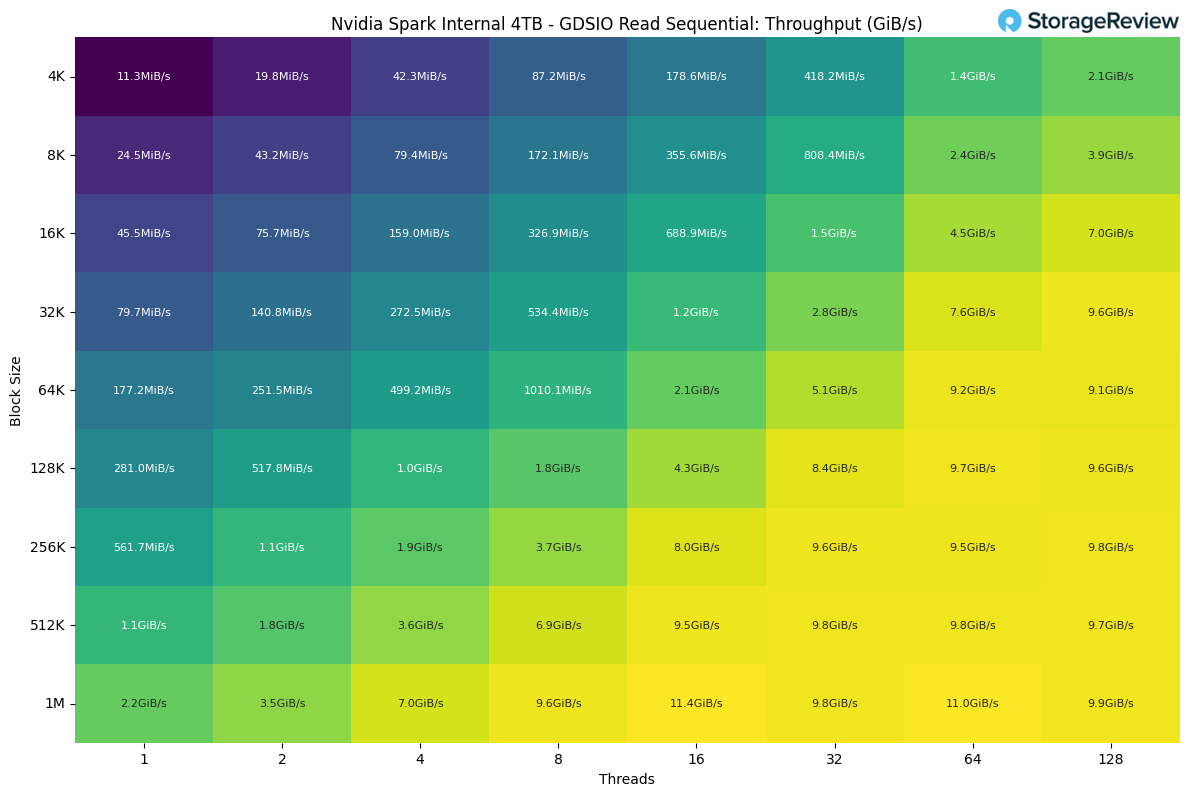
Als we kijken naar de sequentiële leesprestaties van de interne schijf, zien we de hoogste doorvoer bij een blokgrootte van 1M met 16 threads, goed voor 11.4 GiB/s.
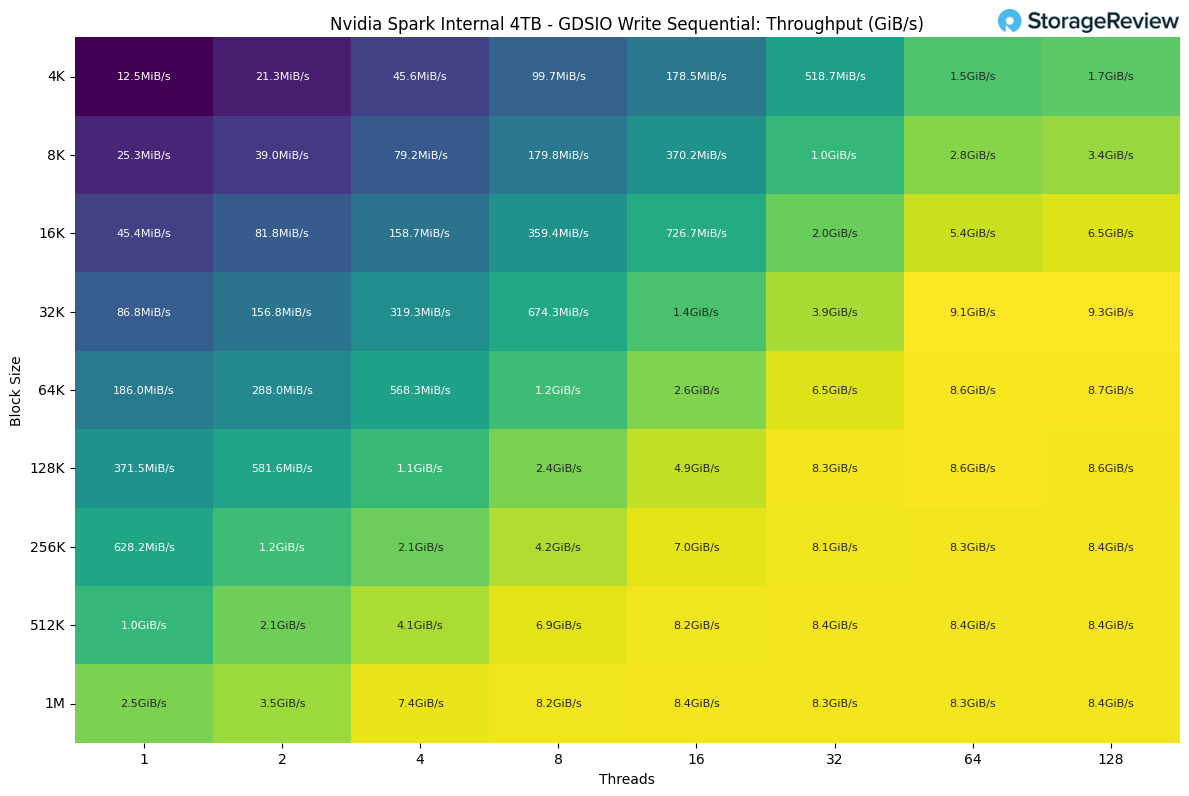
Kijkend naar de sequentiële schrijfprestaties, behaalt de schijf de hoogste doorvoersnelheid bij een blokgrootte van 32 kB met 128 threads. Bij grotere blokgroottes lijkt de prestatie te stabiliseren, met een gemiddelde van ongeveer 8.3 GiB/s.
Voor kopers die de NVIDIA DGX Spark willen aanschaffen voor zwaardere ontwikkeltaken, met name bedrijven die er kleine clusters van willen maken, raden we ten zeerste aan om de ingebouwde 200Gb NVIDIA ConnectX-7 NIC te gebruiken.
GDSIO – NVMe-oF over RDMA
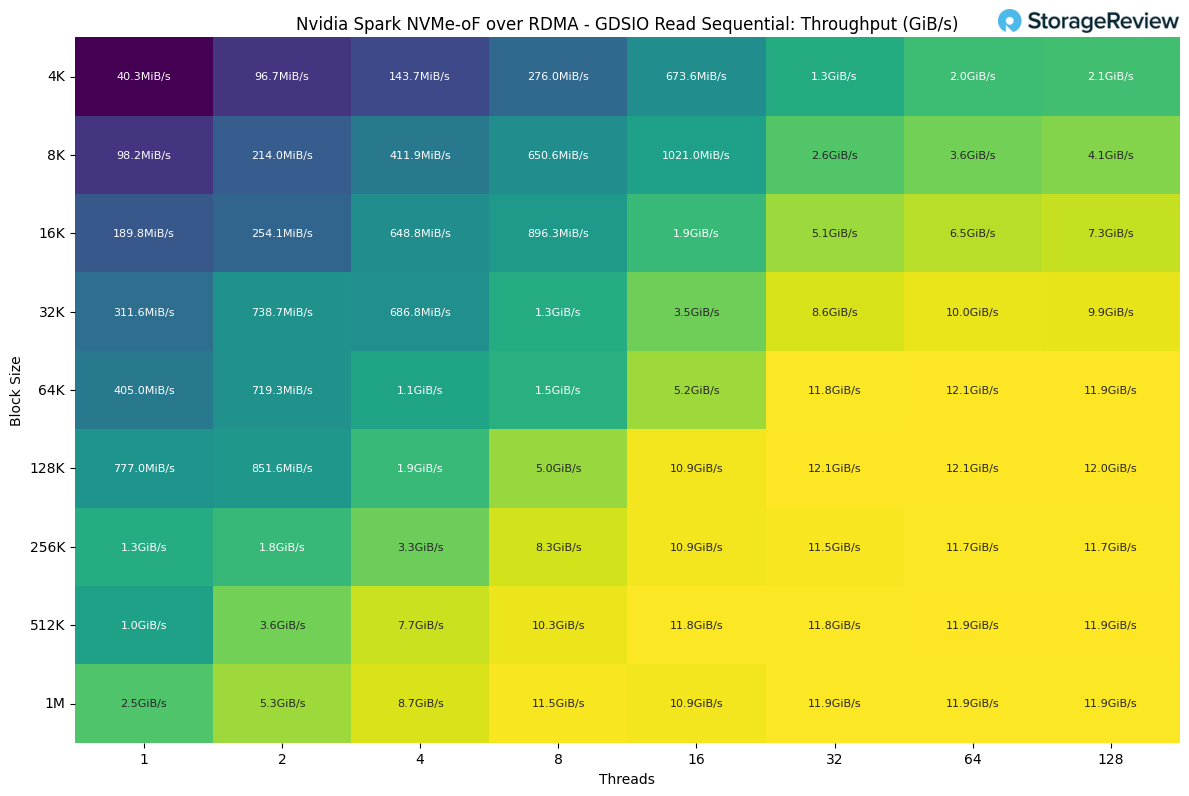
Voor NVMe-oF RDMA-tests met de NVIDIA DGX Spark hebben we de software van PEAK:AIO gebruikt om een NVMe-oF-target te creëren op een Dell PowerEdge R770 met zes Micron 9550 3.84TB SSD's en verbonden via RDMA. Zoals we eerder al aangaven, heeft de CX7 NIC van de Spark zijn eigenaardigheden en vanwege tijdsbeperkingen konden we de Spark alleen testen met 100G-connectiviteit. Zowel de Spark als de PEAK:AIO kunnen aanzienlijk hogere waarden bereiken. We zullen in volgende delen aanvullende opslag- en netwerktests uitvoeren met de Spark.
Als we kijken naar de sequentiële leesprestaties van de interne schijf, zien we de hoogste doorvoer bij een blokgrootte van 128k met 32 threads, wat een snelheid van 12.1 GiB/s oplevert.
Kijkend naar de sequentiële schrijfprestaties, behaalt de schijf de hoogste doorvoersnelheid bij een blokgrootte van 128 kB met 16 threads. Bij grotere blokgroottes lijkt de prestatie te stabiliseren, met een gemiddelde van ongeveer 11.3 GiB/s.
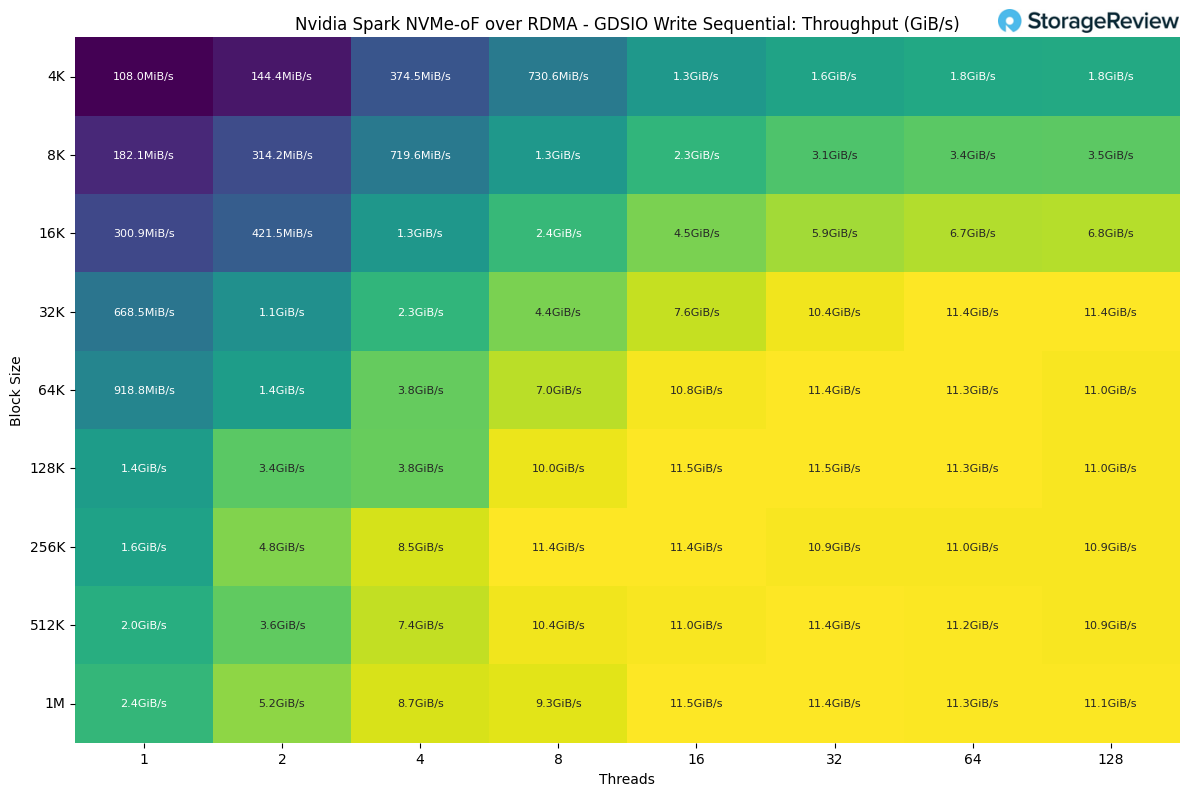
Deze resultaten zijn zeer genuanceerd; we zien slechts de helft van het theoretische maximum vanwege de eerder genoemde tijd- en netwerkgerelateerde redenen. Bovendien wordt de hoogste doorvoersnelheid bij een blokgrootte van 128k beïnvloed door meerdere factoren, zoals de gebruikte enterprise-schijven of hoe PEAK:AIO deze IO verwerkt. Uw ervaring kan variëren en we zijn van plan om in de toekomst meer te testen met Spark.
Software-ecosysteem van dag één
NVIDIA en andere leveranciers hebben aanzienlijk geïnvesteerd in softwaregereedheid, een duidelijke afwijking van typische hardwarelanceringen, waarbij early adopters te maken krijgen met onvolledige documentatie en ontbrekende tools. Spark wordt gelanceerd met uitgebreide playbooks die veelgebruikte workflows behandelen: ComfyUI voor diffusiemodellen, TRT-LLM voor geoptimaliseerde inferentie, Ollama met Open WebUI voor lokale modelweergave, Unsloth voor finetuning en multi-agent architecturen met LangGraph.
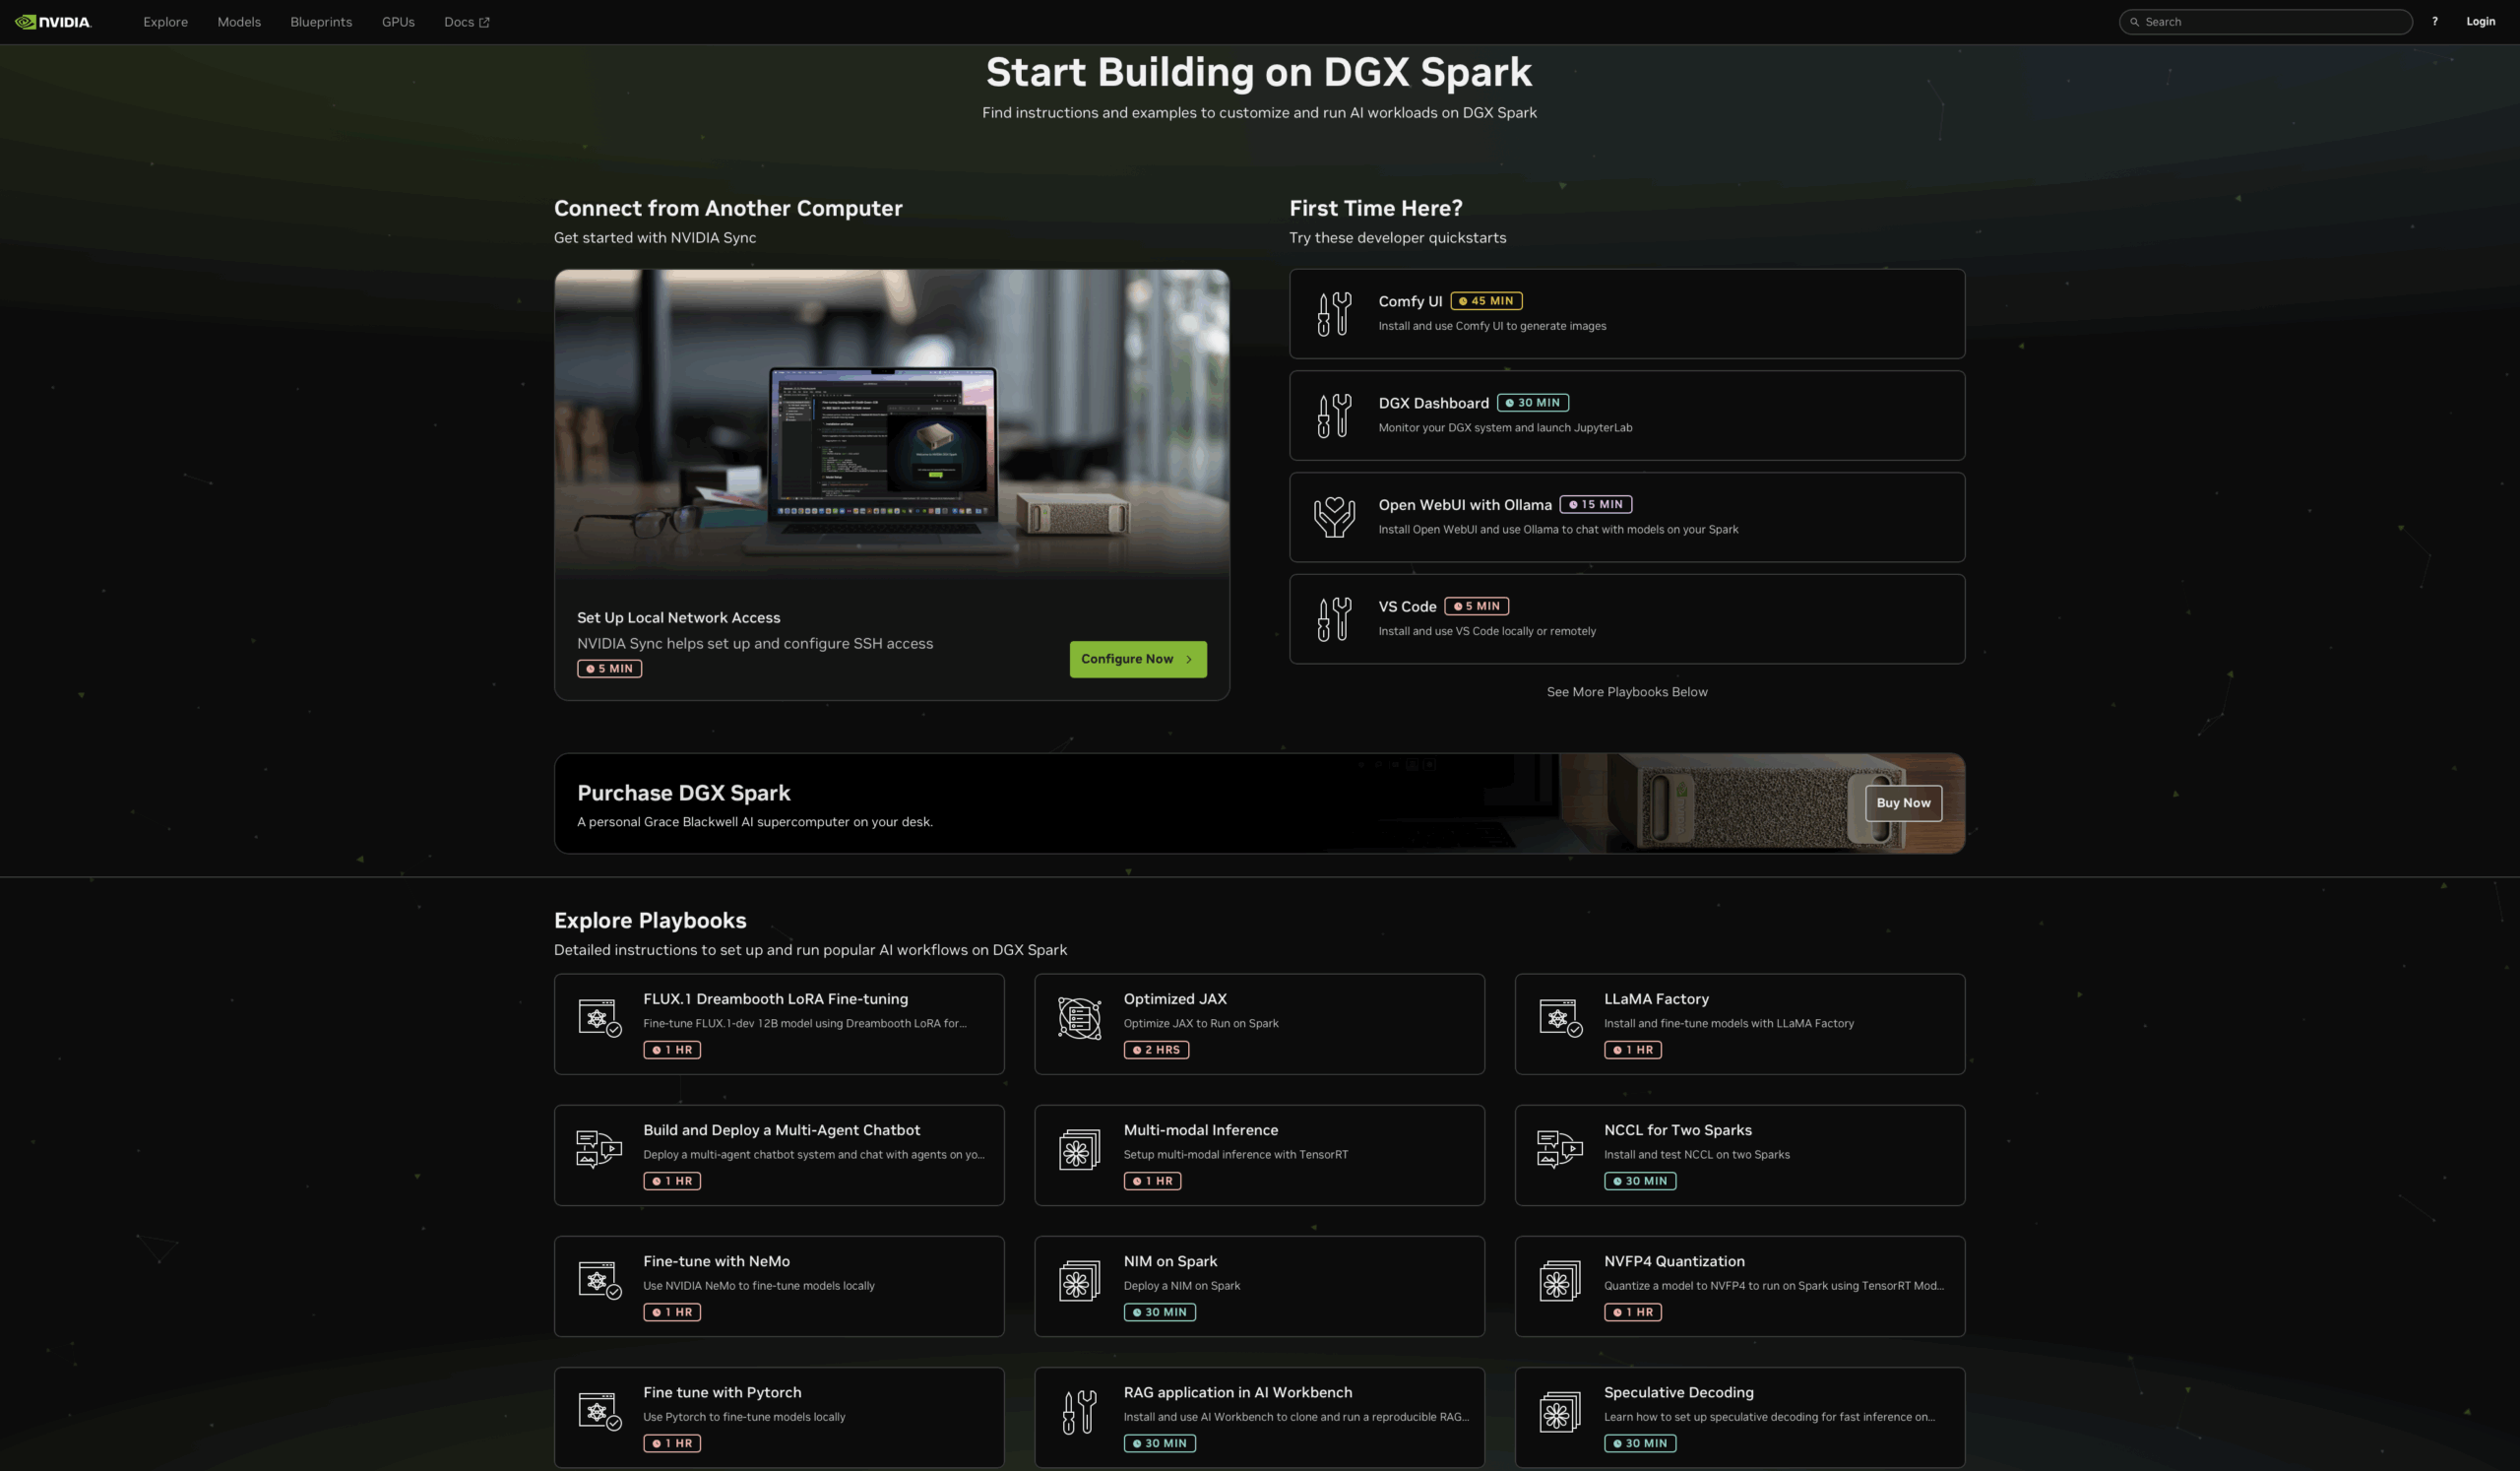
Deze volwassenheid van de software transformeert de evaluatie-ervaring. In plaats van dagen te besteden aan het configureren van omgevingen, kunnen ontwikkelaars direct beoordelen of Spark aan hun eisen voldoet door representatieve workloads uit te voeren. De playbooks bieden niet alleen instructies, maar ook gecontaineriseerde omgevingen, voorbeeldgegevenssets en verwachte prestatiemetingen.
Beschikbaarheid en OEM-systemen
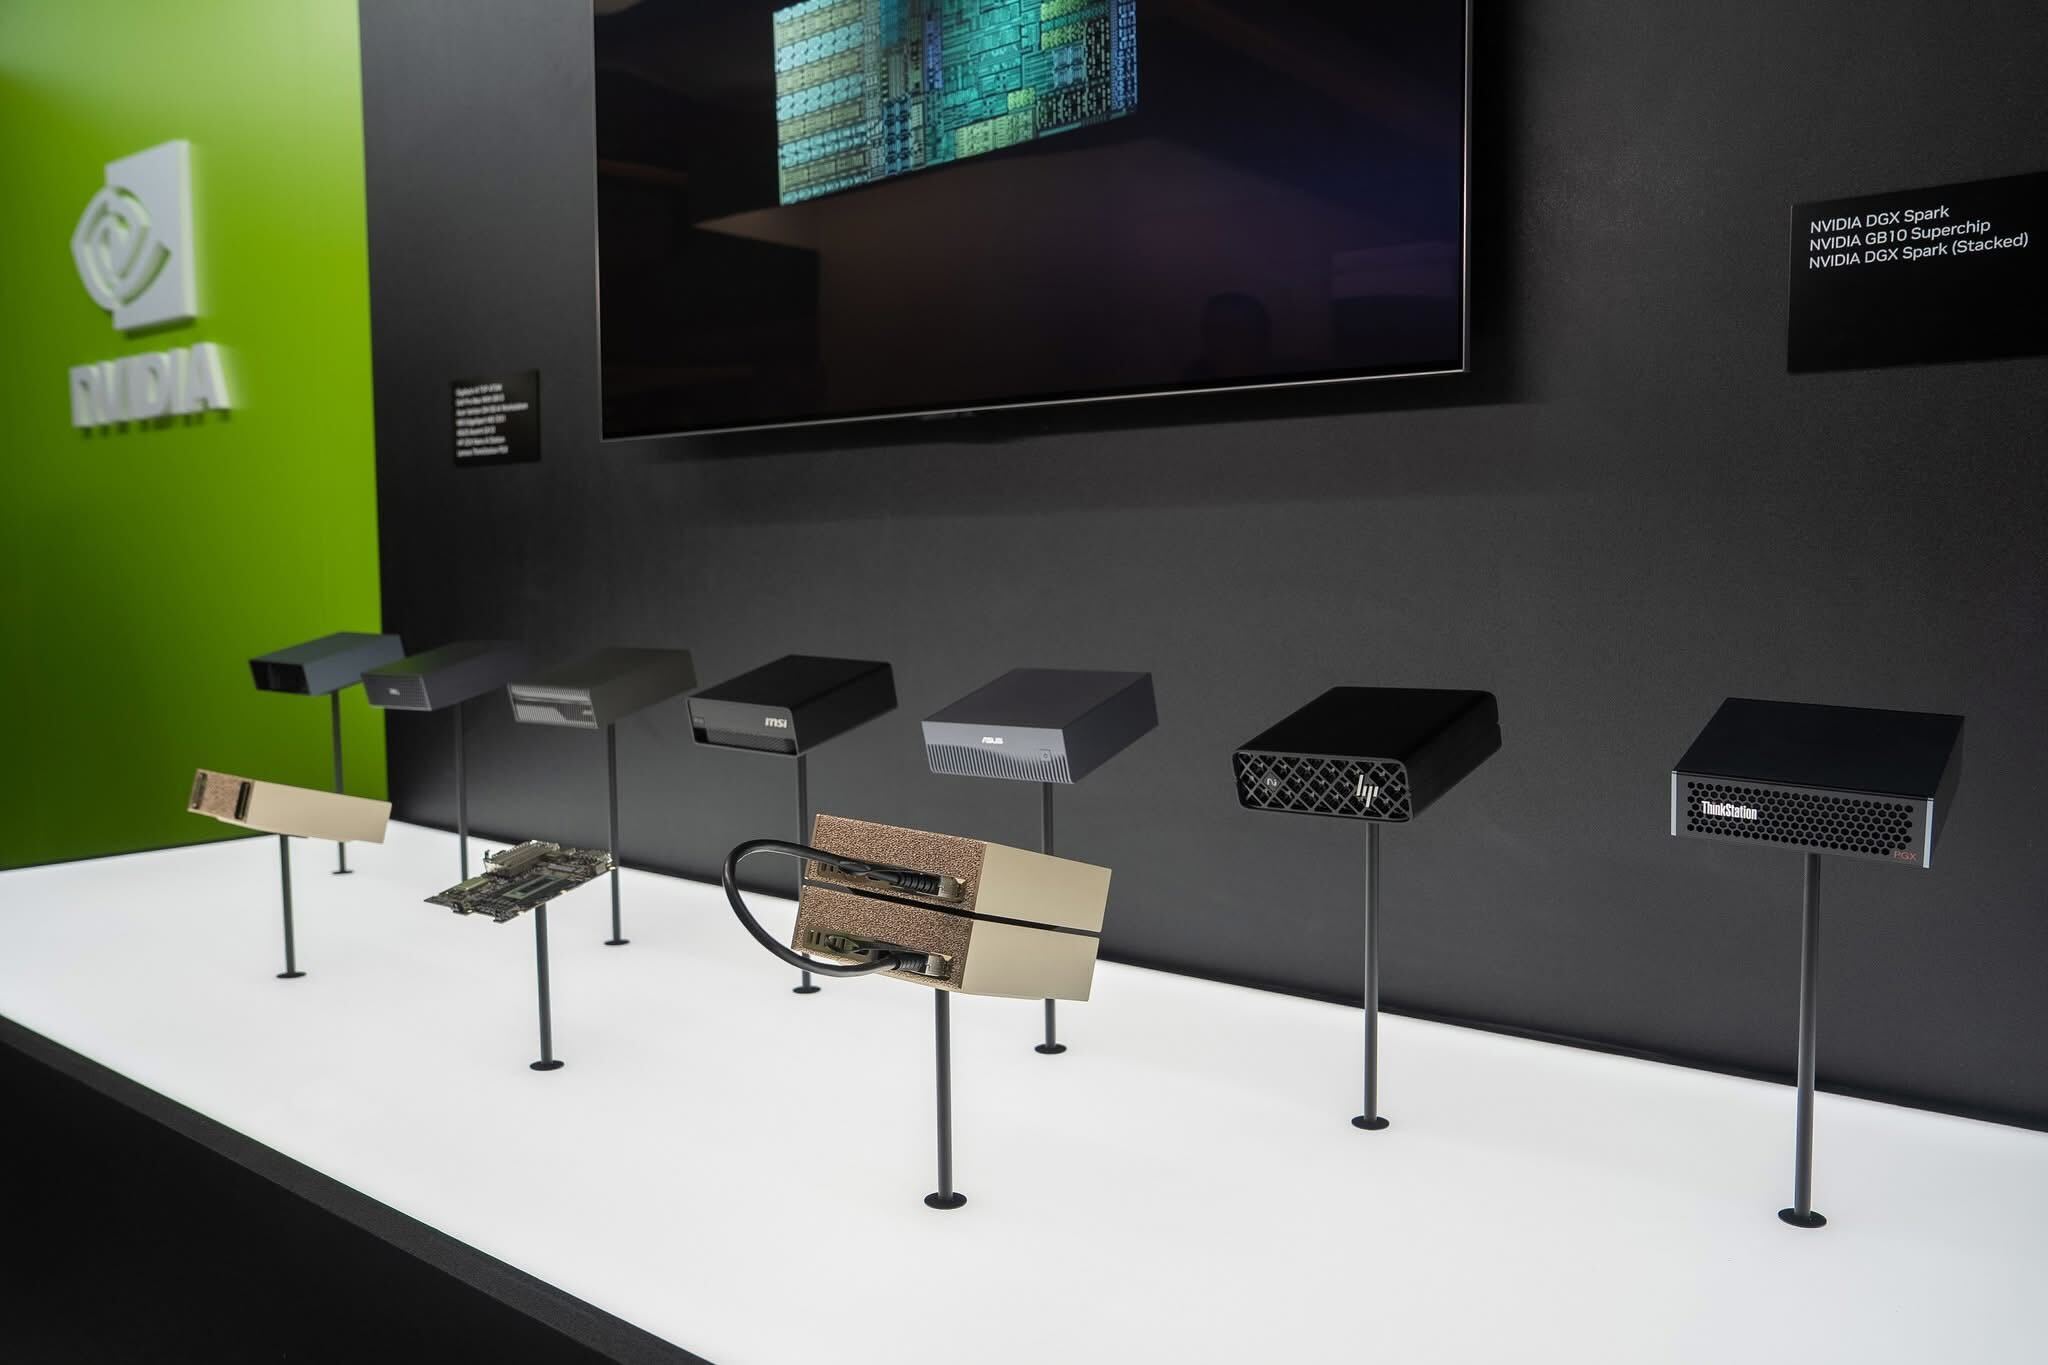
NVIDIA's Founders Edition is te bestellen voor $ 3,999 voor de 4TB-configuratie en is vanaf 15 oktober algemeen verkrijgbaar. Naast NVIDIA's eigen versie komen er ook verschillende GB10-desktops van de grote OEM's. De kernhardware zal bij alle OEM's vrijwel gelijk zijn, maar er is mogelijk wat ruimte om te differentiëren, hoewel de meeste prijsverschillen waarschijnlijk voortkomen uit de opslagselectie. We hebben al veel aankondigingen gezien, waaronder de Dell Pro Max met GB10, de Lenovo ThinkStation PGX, de Acer Veriton GN100 en de ASUS Ascent GX10.
Bron: Nvidia
Conclusie
De NVIDIA DGX Spark vertegenwoordigt een fundamenteel keerpunt in het toegankelijkheidsparadigma van geavanceerde AI-computerinfrastructuur. Door de mogelijkheden van de GB10 Grace Blackwell Superchip te consolideren – 128 GB unified memory, 1 petaFLOP sparse FP4-prestaties, vierde-generatie RT-cores en ConnectX-7-netwerken – in een 240W, 1.13-liter apparaat met een prijs van $ 3,999, heeft NVIDIA effectief de barrières geslecht die van oudsher de mogelijkheden van datacenter-AI scheidden van individuele onderzoekers en kleine ontwikkelteams.
De gevalideerde appliance-aanpak pakt een hardnekkig knelpunt aan bij de implementatie van AI-infrastructuur: de operationele overhead van het onderhouden van aangepaste configuraties. Organisaties die Spark-units implementeren, profiteren van NVIDIA's uitgebreide tests en validatie van de volledige stack, inclusief DGX OS, CUDA-toolkit, frameworkcontainers en hardwarefirmware, waardoor de configuratieproblemen die gepaard gaan met aangepaste workstation-builds worden geëlimineerd. Het geïntegreerde updatebeheer, de systeemmonitoring en de JupyterLab-provisioning van het DGX Dashboard verminderen de operationele last verder, terwijl de automatische SSH-sleuteldistributie en tunnelbeheer van NVIDIA Sync de toegang op afstand echt soepel maken. Voor schaalbare organisaties vertaalt dit zich in een meetbaar snellere onboarding: nieuwe onderzoekers ontvangen gestandaardiseerde hardware, maken verbinding met de bestaande infrastructuur via de gevalideerde clusterconfiguratie met twee knooppunten en beginnen binnen enkele uren met productief werk in plaats van dagenlang bezig te zijn met het oplossen van driverconflicten of de configuratie van de netwerkstructuur.
DGX Spark levert al echte AI-kracht in een compacte, stille appliance, en onze eerste resultaten laten zien waarom dit belangrijk is voor teams die serieuze functionaliteit willen zonder datacenteroverhead. Het verhaal begint nog maar net. We zijn van plan onze tests uit te breiden met de 200G-fabric, NVMe-oF-targets en multi-node clustering om schaalbaarheid, grotere model footprints en gedeelde storagearchitecturen te verkennen. Naarmate het software- en partnerecosysteem zich ontwikkelt, verwachten we dat Spark-implementaties zullen evolueren van krachtige single-node-opstellingen naar nauw geïntegreerde miniclusters met hoge doorvoer die dit platform verder verbeteren.
Klassement: De NVIDIA DGX Spark staat bovenaan als beste desktop-AI-systeem in ons klassement van beste desktops voor lokale AI.
Klassement: Richtlijnen voor de dimensionering van dit type systeem vindt u in onze handleiding RAM, GPU en opslag voor Agentic AI .


 Amazon